RouteWeaver:将模式选择与执行编织进统一的 LLM 路由 RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing
统一三种路由范式与模型选择,COMET-GRPO 分层信用分配提升 11.03%
前置知识
LLM 路由(LLM Routing)
给定用户查询和一组候选模型池,由一个路由器决定调用哪个(些)模型、以什么顺序和结构调用,并整合输出为最终答案。目标是利用不同模型各自的能力与成本优势:便宜的小模型处理简单问题,强大的大模型处理难题。路由可以是查表/分类器式(Router-KNN、RouterDC、GraphRouter),也可以把 LLM 本身作为策略做序列决策(Router-R1、R2-Reasoner),本文属于后者。
本文的研究对象就是路由:它把路由从「选哪个模型」扩展到「选哪种执行范式」。读懂动机、基线和方法设计,都需要先理解路由要解决的核心问题。
GRPO(组相对策略优化)
DeepSeekMath 提出的 RL 算法:对同一查询采样一组 rollout,用组内奖励的均值 $\mu$ 和标准差 $\sigma$ 把每条轨迹的奖励标准化为相对优势 $A=(r-\mu)/(\sigma+\epsilon)$,代替 critic 基线估计,再把该优势应用到轨迹的所有策略 token 上做 PPO 式裁剪更新。无需价值网络、训练简单稳定,是 DeepSeek-R1 等推理模型的主力训练算法。
COMET-GRPO 是本文的核心训练算法,它在 GRPO 基础上把优势按决策层级分解。读者必须知道原始 GRPO 如何给 token 分配信用,才能理解分解的必要性和 $A^{mode}+A^{inner}=A^{GRPO}$ 这一恒等关系。
信用分配(Credit Assignment)
RL 经典难题:一条轨迹最终只得到一个标量奖励,但轨迹由许多决策(选模式、选模型、写子查询、写答案)共同产生,如何把奖励恰当归因到每个决策上直接决定学习效率与稳定性。粗粒度归因(整条轨迹共享同一个优势值)会让好决策被坏决策拖累,产生高方差梯度,甚至导致策略坍缩到某一种行为模式。
本文的核心学习难题正是两级决策的信用歧义:低奖励轨迹可能源于选错范式,也可能是范式选对但执行糟糕。COMET-GRPO 的模式级/模式内两个优势信号就是为拆解这一歧义而设计的。
单轮/多轮/Agentic 三种执行范式
按模型调用的组织方式划分:单轮路由为每个查询只调用一个模型一次,决策在执行前完成;多轮路由根据中间输出串行多次调用模型,用历史 $h_{t-1}$ 决定下一次选择;Agentic 路由把调用组织成带显式角色(规划/执行/验证/汇总)与依赖边 $(j,k)\in E_t$ 的工作流,同层调用可并行。三者对应不同的成本-能力折中:单轮最便宜,Agentic 能力最强但调用最多。
RouteWeaver 的全部创新围绕「把范式选择变成策略动作」展开,Figure 1 和公式 (1)-(3) 用这三种范式定义了问题的动作空间,不理解范式的差异就无法理解为什么统一它们是难题。
PPO 裁剪目标与 KL 正则
PPO 用重要性比率 $r=\pi_\theta(z|H)/\pi_{old}(z|H)$ 乘以优势构成替代损失 $\ell=-\min(rA,\mathrm{clip}(r,1-\eta^-,1+\eta^+)A)$,通过裁剪防止单步更新过猛;KL 正则项把策略拉向冻结的参考策略防止漂移崩溃。GRPO 类算法都在此框架上改动,例如双裁剪(dual clipping)额外限制负优势 token 的损失上界。
公式 (8)-(10) 的训练损失直接建立在 PPO 裁剪与 KL 罚之上。论文的超参细节($\eta^\pm=0.2$、双裁剪 $c=3$、$\beta=0.001$)只有在这一背景下才有意义。
研究动机
现有 LLM 路由方法普遍围绕某一种预定义执行范式构建:单轮路由(RouteLLM、RouterDC、GraphRouter、Router-KNN/MLP)为每个查询一次性选定一个模型;多轮路由(Router-R1、R2-Reasoner)根据中间输出串行地多次选模型;Agentic 路由(MasRouter、GraphPlanner)把多个模型组织成带角色和依赖的工作流。问题在于范式本身在系统搭建前就被写死:路由器只能自适应「选哪个模型」,无法自适应「如何组织模型调用」。论文的基线实验直接量化了这一缺陷:固定范式的最强者随任务类型改变——多轮路由在 Math(Router-R1 66.3%)、Code(52.8%)、Knowledge(48.9%)上领先,而单轮路由在 Reason(GraphRouter 69.2%)和 Recall(Router-KNN 40.4%)上更强,没有任何范式能在五个域上同时占优,跨范式差距高达约 20 个百分点(如 Knowledge 上 Router-R1 48.9% vs R2-Reasoner 28.3%)。
本文的目标是本文目标是构建一个统一路由策略 RouteWeaver,把执行范式本身(单轮/多轮/Agentic)变成路由决策的一部分,让同一个策略对每个查询同时学会「何时用什么范式」与「范式内如何选模型、组织调用」。具体需要解决三件事:其一,三种异构执行结构需要一个公共表示,使它们能在同一个序列策略中被表达与采样;其二,模式选择与模式内执行共同决定最终性能,需要可区分的学习信号把奖励恰当归因到两级决策;其三,模式选择需要先积累各范式的执行经验,避免训练早期偏好坍缩到某一模式。最终目标是在数学、代码、知识、逻辑推理、事实召回五个域的九个基准上超过全部固定范式基线,并支持可调节的准确率-成本工作点。
与已有工作不同的是,本文的独特切入是「把范式当动作」。先前工作把执行范式视为架构层面的固定选择,本文将其提升为策略可采样的一等决策,与模型选择一起由 RL 端到端优化。这带来两个此前未被处理的学习问题:一是信用分配歧义——标准 GRPO 给模式 token 和所有后续执行 token 同一个轨迹级优势,无法区分「范式选错」和「执行糟糕」两种失败原因,本文的 COMET-GRPO 首次按「决策语义层级」而非时间步分解组相对优势;二是探索次序——若从第一步就自由选模式,早期偏好会剥夺其他模式的训练机会,本文提出「先学怎么执行、再学何时使用」的三阶段渐进课程,并配合模式概率下限支持项防止过早集中。这两个组件共同填补了统一路由在训练方法上的空白。
核心方法
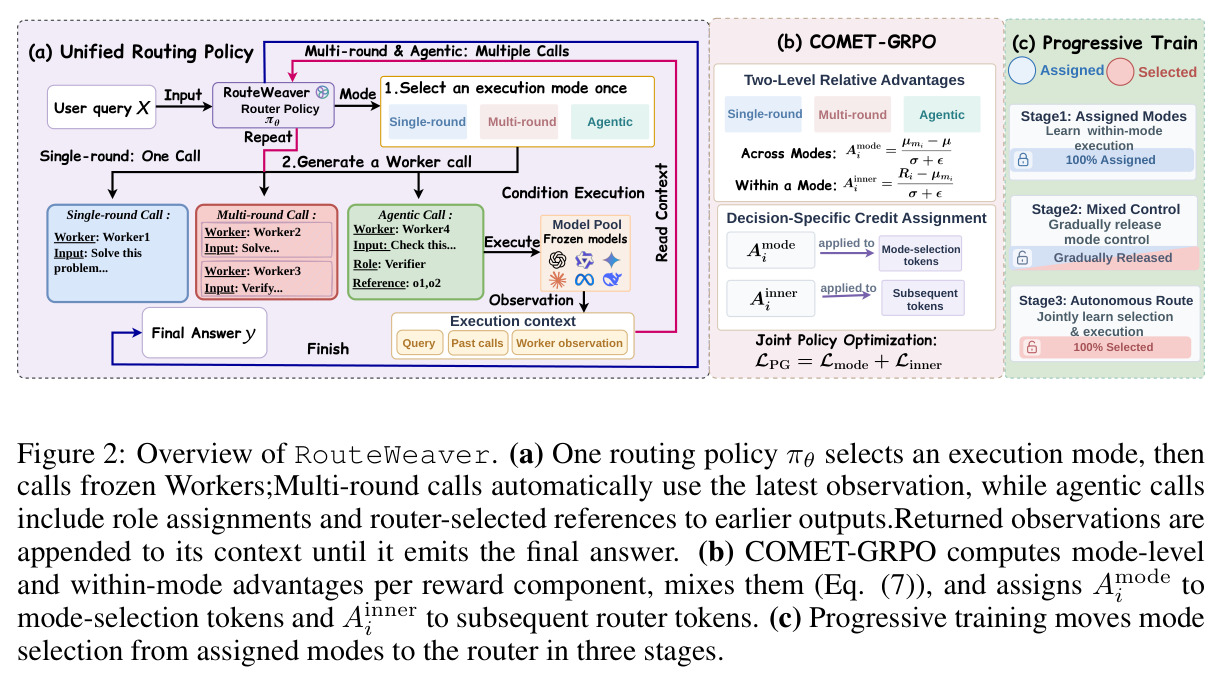
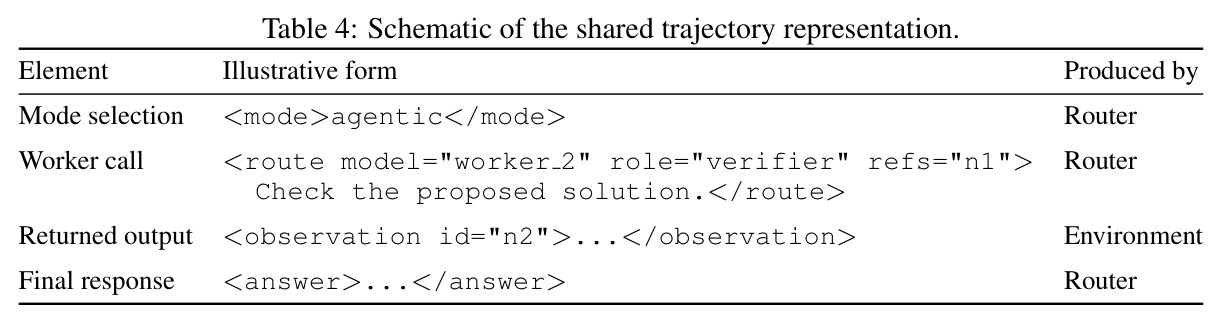
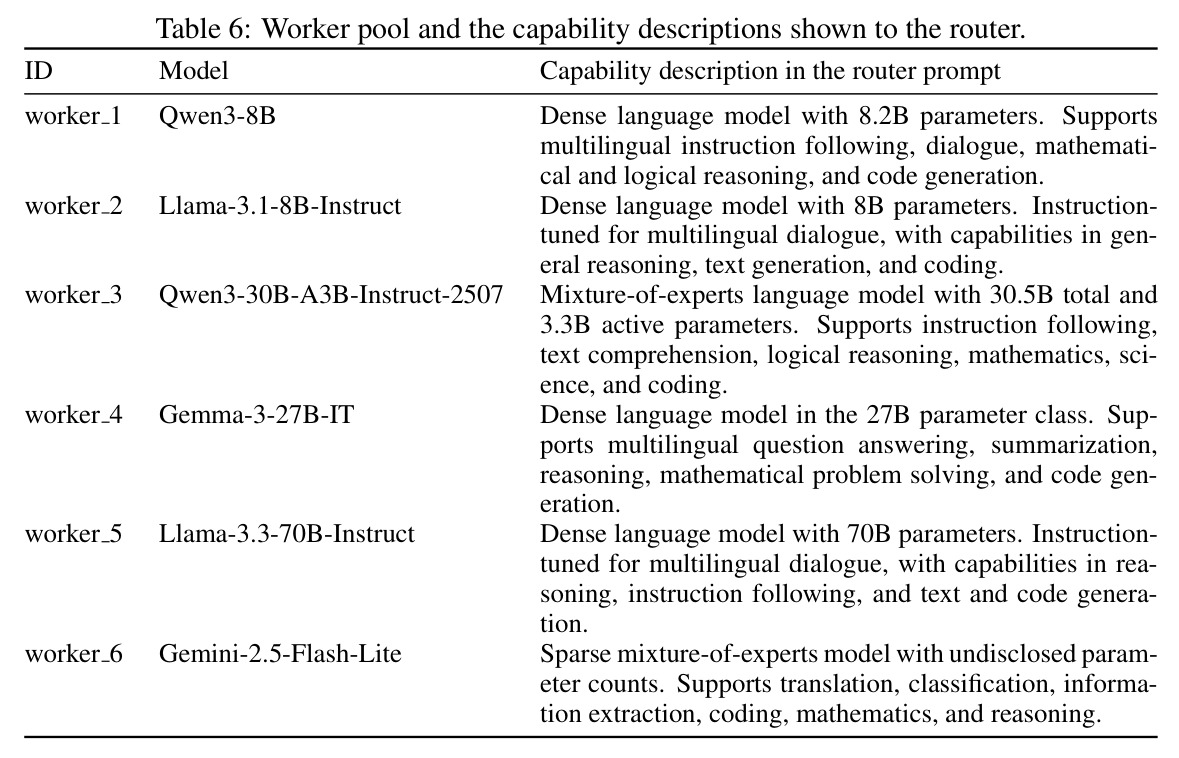
直觉上,不同问题需要不同的「组织计算的方式」:事实召回一次调用即可,复杂推理需要拆解-执行-验证-汇总的完整流程。RouteWeaver 的实现前提是为三种范式设计公共的动作语法,把每次路由过程表示为模式条件轨迹 $\tau=(m,a_1,o_1,\dots,a_T,o_T,y)$。技术上,路由器是 Qwen3-4B-Instruct-2507(全参数微调),先输出 mode 标签选定范式,再逐轮生成 route 标记调用六个冻结 Worker(Qwen3-8B、Llama-3.1-8B-Instruct、Qwen3-30B-A3B-Instruct-2507、Gemma-3-27B-IT、Llama-3.3-70B-Instruct、Gemini-2.5-Flash-Lite;路由器只见匿名 ID 和能力描述,不知模型名与价格);环境把 Worker 输出作为 observation 插入路由器上下文,直到路由器给出 answer。训练用 COMET-GRPO 做分层信用分配,用渐进探索从指定模式过渡到自主选择;奖励由任务正确性与 Worker 推理成本两部分组成,整个过程是纯 RL 端到端学习,不需要任何范式标注数据。
核心创新有两点。第一,COMET-GRPO 将轨迹级组相对优势按决策层级分解:对同一查询采样 $K$ 条 rollout,$A^{mode}_i=(\mu_{m_i}-\mu)/(\sigma+\epsilon)$ 度量所选模式的组平均回报相对全组均值的高低(跨模式比较),$A^{inner}_i=(r_i-\mu_{m_i})/(\sigma+\epsilon)$ 度量该轨迹相对同模式均值的优劣(模式内比较),且恒有 $A^{mode}+A^{inner}=A^{GRPO}$。两个信号分别只作用于模式 token 与后续执行 token,各自按有效 token 数独立归一化,解决模式 token 少、混同平均会被长度稀释的问题。第二,渐进探索把模式选择从 100% 外部指定经线性退火过渡到 100% 自主,配合单侧支持惩罚 $L_{support}=\frac{1}{|\mathcal{M}|}\sum_m \max(0,\log\delta-\log(\bar p_m+\epsilon))$ 维持每个模式的概率下限 $\delta=0.05$。本质区别在于:范式不再是架构常量,而是与执行联合优化的策略变量,两个决策层级各自获得语义正确的信用信号。
方法步骤详情
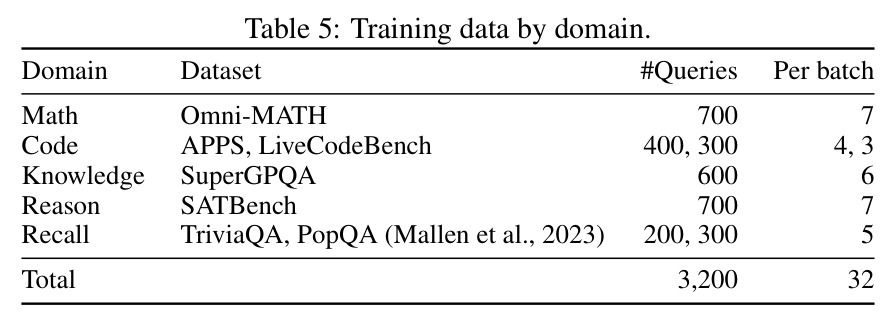
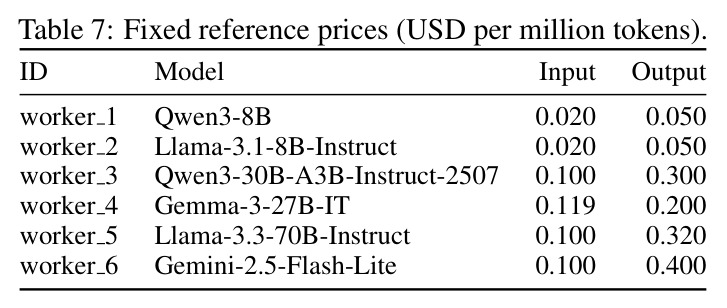
方法分五步。第一步,统一轨迹表示与执行约束:单轮恰好 1 次 Worker 调用;多轮 2-4 次顺序调用,后续调用自动附带上一个观察;Agentic 调用形如 ,角色取 planner/executor/verifier/summarizer 之一,refs 指向早前层节点,同层并行,至多 8 次调用、10 个动作轮;首个违规动作终止轨迹并给奖励 $(-1,-1)$。第二步,定义奖励:正确得 $(1, S_{cost})$,$S_{cost}=1/(1+C(\tau)/C_{ref})$,$C(\tau)$ 按固定定价表累计 Worker 推理成本,$C_{ref}=0.0070716653$ 美元为 1024 条 rollout 的 95 分位;错误得 $(0,0)$。第三步,采样:每查询 $K=8$ 条 rollout,每批 32 个查询,域配额固定 7/7/6/7/5。第四步,COMET-GRPO 更新:按公式 (6) 算两级优势并按 $A^l=(1-\alpha)A^l_{task}+\alpha A^l_{eff}$ 逐分量混合,分别施加到模式 token 与执行 token 且各自归一化,辅以 PPO 裁剪与 KL 正则。第五步,渐进课程:step 1-25 全强制模式冷启动(任务奖励 GRPO);25-75 强制比例 $\rho_b$ 线性 1→0 并启用支持项;75-90 完全自主,联合优化模式选择与执行。学习率 $10^{-6}$,共 90 步,每步 256 条轨迹单次 on-policy 更新。
技术新颖性
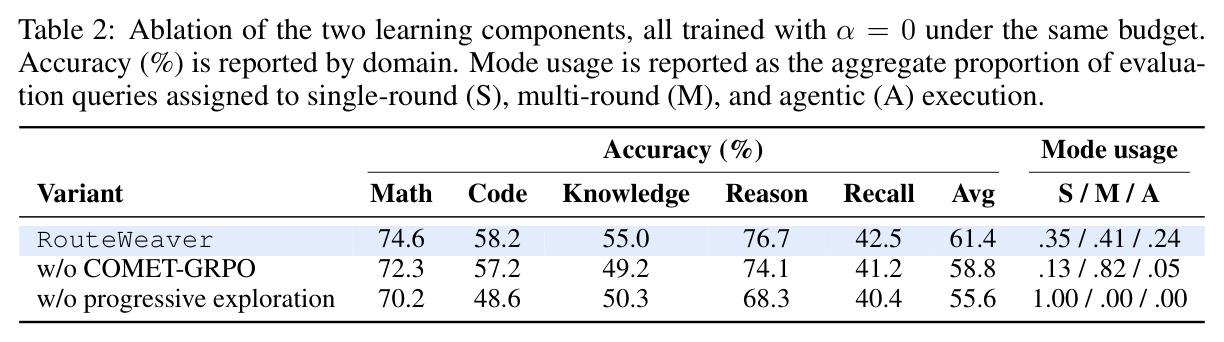
技术新颖性体现在三处。其一,统一动作语法:用 XML 风格元素(mode/route/observation/answer)把三种异构范式编码进同一个序列策略,使「范式」成为可与模型选择一起优化的离散变量,这在此前路由文献中没有先例——RouteLLM、RouterDC 等只输出模型选择,MasRouter、GraphPlanner 则把工作流结构固定在系统层。其二,信用分配粒度的创新:GiGPO 按 episode/时间步分层,GDPO 按奖励分量解耦归一化,而 COMET-GRPO 按「决策语义层级」(选模式 vs 模式内执行)分解组相对优势,保持 $A^{mode}+A^{inner}=A^{GRPO}$ 的恒等分解,并用分段归一化消除长度偏置;这三种机制正交,可以叠加使用(本文同时采用了 GDPO 式的逐分量混合)。其三,面向离散结构选择的课程学习:渐进探索不是教技能而是先强制体验各模式再移交选择权,消融实验证明去掉它策略完全坍缩到单轮(1.00/.00/.00),去掉 COMET-GRPO 则过度集中到多轮(.13/.82/.05),说明两个组件分别防止了不同方向的模式坍缩,缺一不可。
实验结果
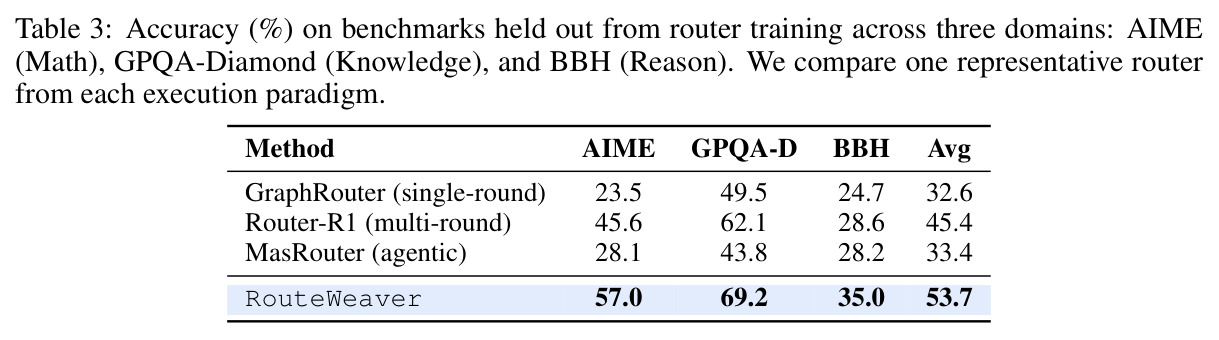
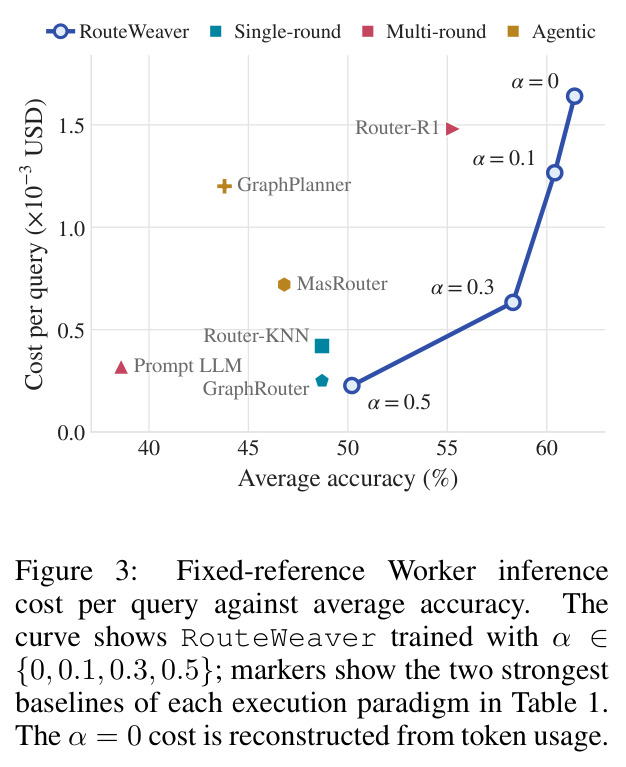
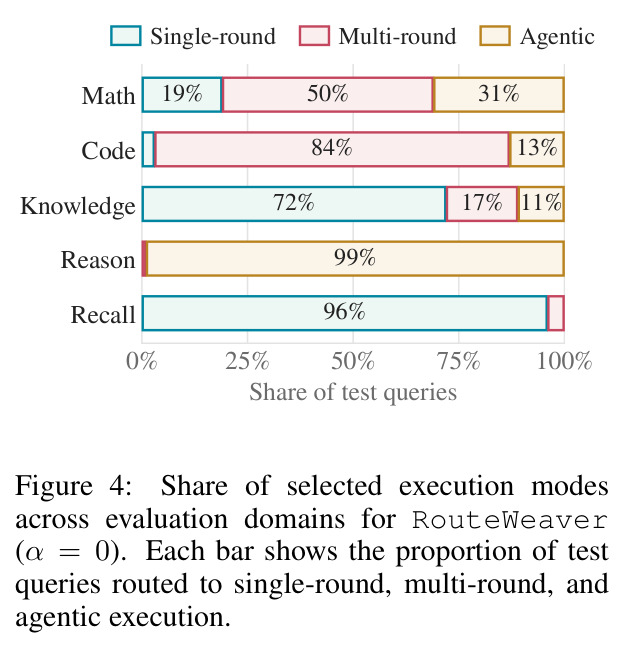
主实验(Table 1)覆盖五域九基准、10 个基线:RouteWeaver 平均准确率 61.4%,较最强基线 Router-R1(55.3%)相对提升 11.03%,且在每个域领先:Math 74.6%、Code 58.2%、Knowledge 55.0%、Reason 76.7%、Recall 42.5%(相对提升 12.52%/10.23%/12.47%/10.84%/5.20%);对最强单轮/多轮/Agentic 基线分别相对提升 26.08%/11.03%/31.20%。成本分析(Figure 3):仅改效率权重 $\alpha$ 即得连续工作点——$\alpha=0.1$ 使 Worker 成本降 23% 仅损 1.0 点精度,$\alpha=0.3$ 降 61% 损 3.1 点,$\alpha=0.5$ 降 86% 损 11.2 点。消融(Table 2):去 COMET-GRPO 降至 58.8%(模式使用 .13/.82/.05,过度集中多轮,Knowledge -5.8 点);去渐进探索降至 55.6% 且完全坍缩到单轮(1.00/.00/.00,Code -9.6、Reason -8.4);两消融版仍高于最强基线。泛化(Table 3):训练未见基准平均 53.7%,较 Router-R1 的 45.4% 相对提升 18.28%,AIME/GPQA-D/BBH 分别 57.0/69.2/35.0,Agentic 占比在 AIME 75%、BBH 12% 间自适应变化。路由行为(Figure 4):Reason 99% 走 Agentic、Recall 96% 走单轮、Code 84% 多轮、Knowledge 72% 单轮,证明策略按任务自适应选择执行模式。
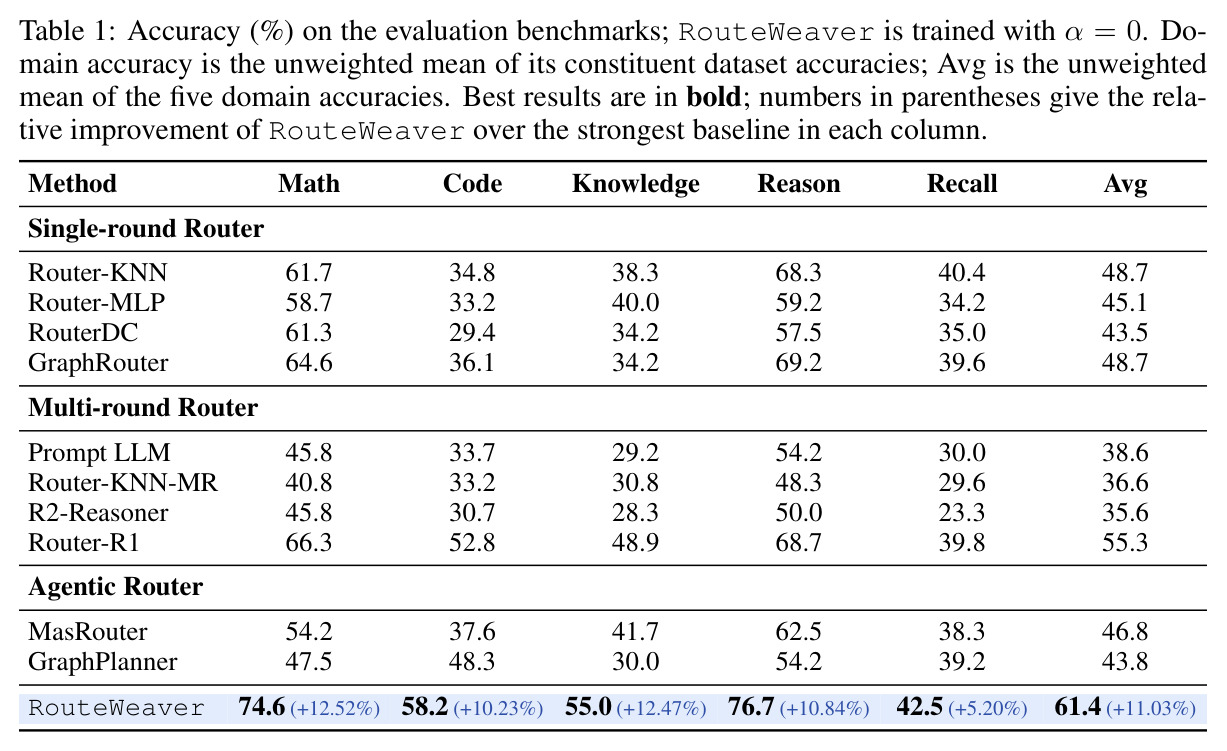
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五域九基准平均 | 平均准确率 (%) | 61.4 | 55.3(最强基线 Router-R1) | 相对提升 11.03% |
| Math(MATH + Omni-MATH) | 准确率 (%) | 74.6 | 66.3(Router-R1) | 相对提升 12.52% |
| Code(APPS + LiveCodeBench + TACO) | 准确率 (%) | 58.2 | 52.8(Router-R1) | 相对提升 10.23% |
| Knowledge(SuperGPQA) | 准确率 (%) | 55.0 | 48.9(Router-R1) | 相对提升 12.47% |
| Reason(SATBench) | 准确率 (%) | 76.7 | 69.2(GraphRouter,最强单轮基线) | 相对提升 10.84% |
| Recall(TriviaQA + SimpleQA-Verified) | 准确率 (%) | 42.5 | 40.4(Router-KNN,最强单轮基线) | 相对提升 5.20%(五域中最小) |
| AIME(训练未见泛化,Math) | 准确率 (%) | 57.0 | 45.6(Router-R1) | +11.4 点 |
| GPQA-Diamond(训练未见泛化,Knowledge) | 准确率 (%) | 69.2 | 62.1(Router-R1) | +7.1 点 |
| BBH(训练未见泛化,Reason) | 准确率 (%) | 35.0 | 28.6(Router-R1) | +6.4 点;三基准平均 53.7 vs 45.4,相对提升 18.28% |
| 成本-精度权衡(Worker 推理成本,Figure 3) | 成本降幅 / 精度损失 | α=0.1:成本 -23%、精度 -1.0 点;α=0.3:-61%/-3.1 点;α=0.5:-86%/-11.2 点 | α=0(全力精度模式) | 同一策略仅改 α 即可连续调节工作点 |
局限与改进
局限性可从几方面看。其一,成本口径只计 Worker 推理 Token 费用(按固定参考定价表折算为美元),不含路由器自身计算与延迟,Agentic 模式多轮调用可能实际时延更高;且效率权重 $\alpha$ 在单次训练中固定,不同工作点需要各训一个模型($\alpha\in\{0,0.1,0.3,0.5\}$ 四次独立训练)。其二,评测规模有限:每个数据集仅 120 题(TACO 100 题,共 1,060 题),Worker 带温度 0.2 采样且固定 Seed 42 但供应商可能忽略,系统级评测并非完全确定。其三,模式集合封闭于三种范式,调用预算硬上限(Agentic 8 次 Worker 调用、10 个动作轮、每个观察截断 2,048 Token)可能限制最难任务的上限;Recall 域提升最小(+5.20%),说明对简单任务收益有限。作者在结论中承认未来需扩展到更丰富的执行结构与工具增强环境。此外全文未报告多随机种子的方差,61.4% 与 55.3% 的差距虽明显但稳定性缺乏直接证据;奖励为二元正确性,对开放式生成任务的适配性未验证。
独立分析的弱点
独立分析出四个弱点。第一,模式粒度粗糙:三种范式内部的执行结构(多轮的调用次数范围、Agentic 的角色模板 planner/executor/verifier/summarizer)是人工预设的,策略无法自适应调整工作流深度与角色组合,改进方向是让模式可分层组合(先选粗范式再细化结构参数)或在动作空间中开放化。第二,成本调参低效:$\alpha$ 固定于单次训练,想在线调节准确率-成本权衡必须重训四个模型,可引入 $\alpha$ 条件化策略或偏好条件 RL,在单一模型内编码多个工作点。第三,信用分配仍有盲区:$A^{inner}$ 把最终答案与中间子查询、Worker 选择同等对待,未区分「选错 Worker」与「子查询写差」两种执行失误,可借鉴 GiGPO 的步级优势细化到每次调用。第四,Worker 池静态且匿名:路由器只见固定 ID 与能力描述,Worker 增删或版本更新需要重训路由器,且二元奖励不感知部分正确;可引入 Worker 嵌入的在线适应与部分信用奖励。另外,支持项是对批量平均分的单侧惩罚,不保证每批都采样到所有模式,模式数增大时探索保障会变弱。
未来方向
作者明确提出的方向:把统一视角扩展到更丰富的执行结构与工具增强环境(如把搜索引擎、代码执行器纳入可路由的动作空间,与 Search-R1、ReTool 一脉相连)。基于本文成果还可延伸:其一,延迟感知与 SLA 约束路由——当前成本只按 Token 定价,可将排队时延与并行度纳入 $C(\tau)$,服务真实生产场景;其二,结构搜索空间扩展——加入自我反思、辩论、树搜索等范式,或开放角色集合,检验 COMET-GRPO 的层级优势分解在更多模式数下是否稳定(支持项下限 $\delta=0.05$ 可能需随模式数调整);其三,域配额自动化——训练批次固定 7/7/6/7/5 的域配额是人工设定的,可探索按训练进度自动调整的课程;其四,理论分析——$A^{mode}+A^{inner}=A^{GRPO}$ 的恒等分解为何比整体优势更稳,值得从梯度方差角度给出解释;其五,反向影响 Worker 池构建——路由器的调用统计可指导哪些能力缺口需要补充新模型;其六,在线持续学习以应对 Worker 能力随版本升级的漂移。
复现评估
复现条件较好。代码开源(GitHub: LaughKing/RouteWeaver),附录给出完整细节:A.1 动作格式与执行约束、B.1-B.3 数据与评测协议、C.1-C.3 奖励/优化/全部超参(batch 32 查询 × 8 rollout、学习率 $10^{-6}$、90 步、AdamW、裁剪 0.2、双裁剪 3、KL 0.001 等)。训练集仅 3,200 查询(Omni-MATH 700、SATBench 700、SuperGPQA 600、APPS 400、PopQA 300、LiveCodeBench 300、TriviaQA 200),评测 1,060 题,全部公开。算力门槛中等:路由器 Qwen3-4B 全参微调,每 run 约 2.3 万次 rollout,Worker 中两个 8B 模型本地部署在 2 张 A100 上,其余四个经 OpenRouter API 调用——RL 采样阶段每条轨迹都要真实调用 Worker,需要一定 API 预算。不确定因素:Worker 温度采样使系统级结果非完全确定;十个基线需复现或用原作者实现。总体为中等难度,熟悉 OpenRLHF/verl 类框架的团队数周内可复现主表。
论文图表
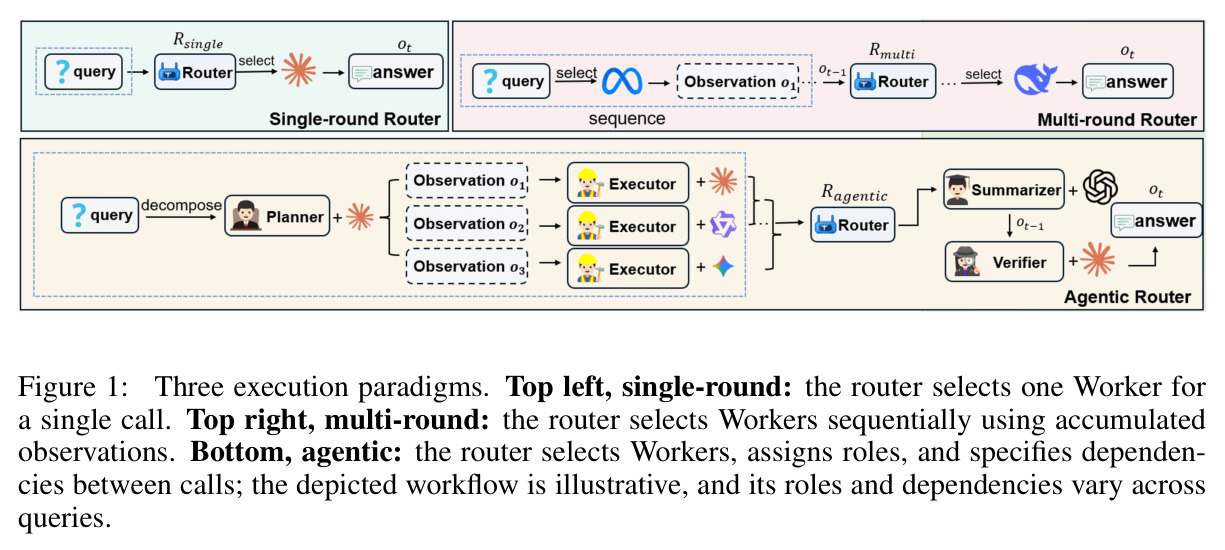
三种执行范式的示意图:单轮(路由器选一个 Worker 调用一次)、多轮(路由器利用累积的观察串行选择 Worker)、Agentic(路由器为 Worker 分配角色并用依赖边组织成工作流,角色与依赖随查询变化)。
定义了全文的问题空间与动作类型,公式 (1)-(3) 的形式化描述都对应这张图,是理解「统一三种范式」这一目标的前提。
报告模型在三种模式下的真实轨迹样例(省略观察主体):单轮直接提问一次调用得答案 4;多轮先计算再验证总数 224 的末两位得 24;Agentic 依次走 planner→executor→verifier→summarizer 四个角色,通过 refs 引用早前节点,最终答案 9。
把抽象的动作语法落成具体输出格式,帮助读者理解 route/observation/answer 元素如何串成轨迹,以及角色与引用机制在实践中的样子,对复现者尤其有用。