VeriSpoof:以单一音频大语言模型统一语音深伪检测、溯源与可核查推理 VeriSpoof: Beyond Real or Fake with One Audio LLM
单模型统一深伪检测、生成器溯源与同源验证,并给出可逐句核查的取证依据
前置知识
EER(等错误率)
二分类取证系统的标准指标:调整判决阈值,使“把真实语音误判为伪造”与“把伪造误判为真实”两类错误率相等,该相等处的错误率即 EER,越低越好。pooled EER 指在所有测试集上共用一个阈值再统计错误,对模型的跨域校准更敏感;逐集均值 EER 则反映分离能力。
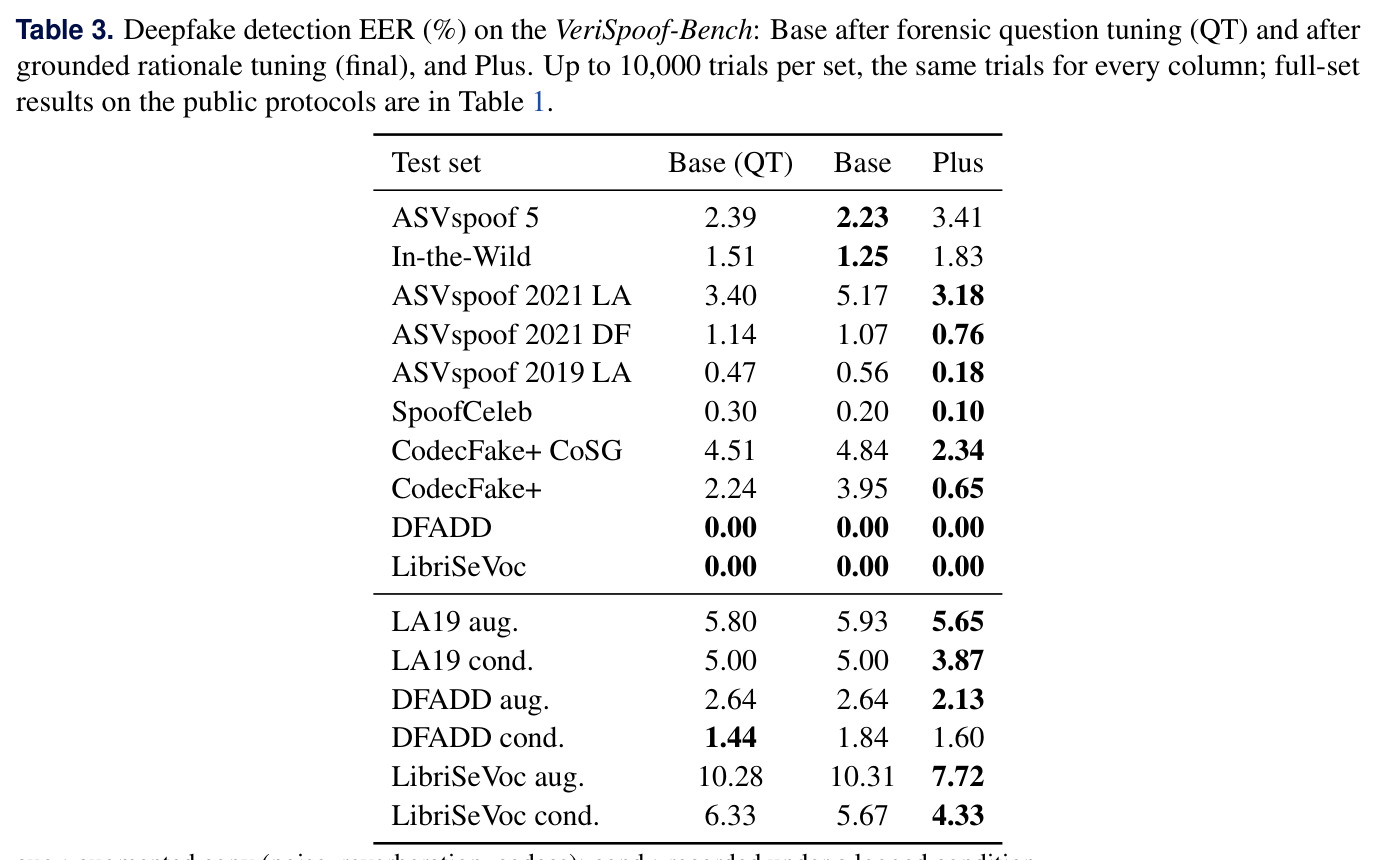
本文所有检测与同源验证结果均以 EER 报告(如 Speech-DF-Arena 上 pooled EER 2.14%),且模型分数是答案句似然差,需按 EER 阈值化使用;不熟悉 EER 与 pooled/mean 之别就无法读懂任何一张实验表。
音频大语言模型(Audio Language Model, ALM)
将波形经音频编码器与分词器转成 token 序列,与文本 prompt 一起输入 LLM,使语言模型能“听”音频并用文字回答问题的模型范式,代表工作有 Qwen3-Omni、Kimi-Audio、Audio Flamingo 等。本文用 Qwen3-ASR 编码器+自研音频分词器+MiniCPM5-2B。
VeriSpoof 本身就是一个 ALM,其“取证问题即选择题”的统一接口、答案句似然打分与文字 rationale 全部建立在 ALM 的生成与似然机制之上。
参数高效微调(LoRA / DoRA)
冻结大模型基座权重、只训练少量新增参数的微调方法。LoRA 在权重旁加低秩增量 $\Delta W = BA$;DoRA 把更新进一步分解为幅度与方向,常用于适配编码器。本文 2.85B 参数中仅训练 29.7M(约 1%):分词器 17.85M、编码器 DoRA 3.24M、LLM LoRA 8.60M。
理解图 3 中“哪些部件在哪个训练阶段被训练”、表 15 的显存拆解,以及“单张 24GB GPU 可跑完整个训练配方”这一核心卖点,都必须先懂 LoRA/DoRA。
自监督语音前端与层混合(layer mix)
wav2vec/ASR 类编码器有几十层隐状态,浅层偏声学伪迹、深层偏语义内容。对各层隐状态做学习到的加权求和(本文对 Qwen3-ASR 的 25 层做两个学习混合头)可同时保留合成伪迹与信道、说话人信息。
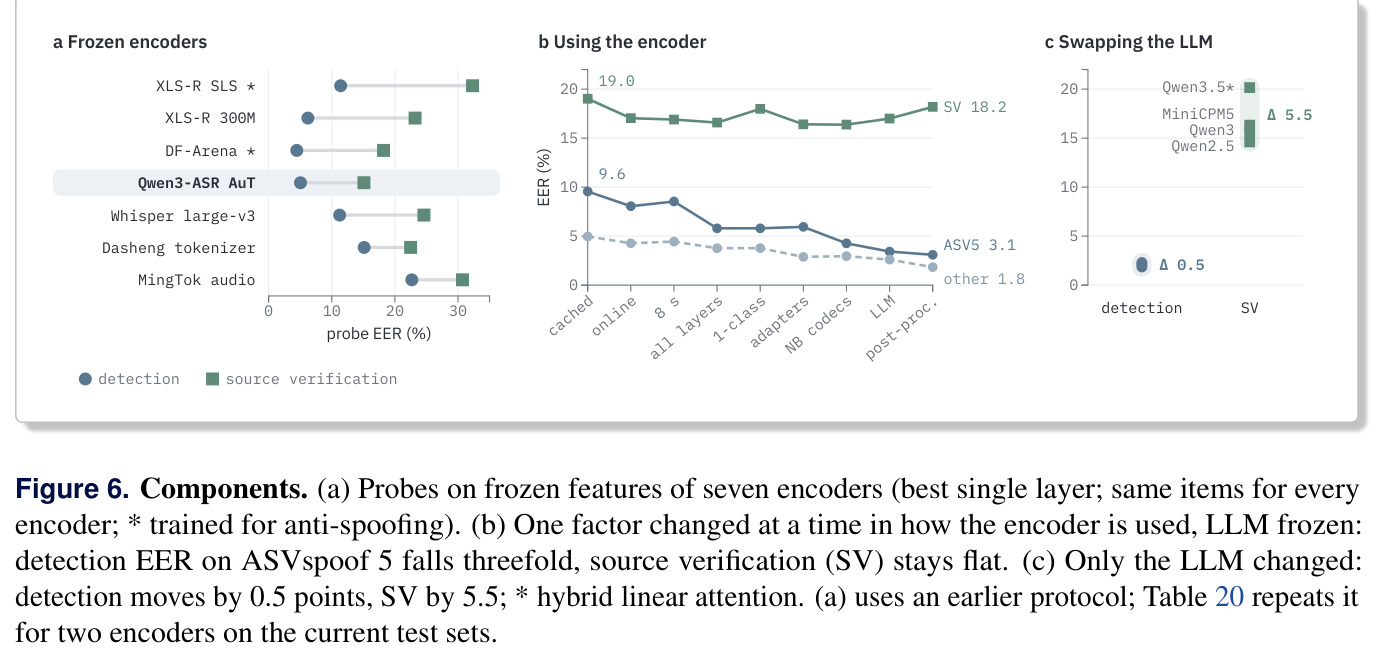
本文的受控发现是“检测由表征及其用法决定”(改变用法使 ASVspoof 5 EER 从 9.6% 降至 3.1%),并用探针实验反驳了“语音识别编码器会丢弃合成伪迹”的流行观点,这些都需要层混合的概念背景。
部分伪造与标注 span
PartialSpoof、HAD、PartialEdit 类语料只在录音的一小段进行拼接或单词替换,并附带伪造发生位置的秒级区间标注;IoU(交并比)衡量模型写出的 span 与标注区间的重合程度,是定位质量的量化指标。
rationale 的 LOCALIZATION 字段、反事实训练与忠实性测试全部围绕 span 标注定义——“决策必须跟随所述定位”这条规则就是以 span 为载体实现的。
神经编解码器伪造(neural codec fake)
用神经编解码器对真实语音做有损再合成(CodecFake+ 的 codec 再合成部分),或直接以编解码器为骨架的生成器(CoSG)产生的伪造语音。它听感类似“被压缩过的真实语音”,与真实语音的信道失真高度相似,仅靠真/伪二分类标签很难学会区分。
§6.5 的关键结论——源监督对神经编解码伪迹是必需的(多任务 2.2% vs 五倍二分类标签 12.6% EER)——正是针对这类伪造;不理解 codec 伪造与信道失真的相似性,就无法理解该消融的意义。
研究动机
一段可疑录音进入取证流程时,分析员要问的不只是“是不是合成的”:是哪个系统生成的、与案件中另一段录音是否同源、结论依据什么。现有工具链把这些问题拆给不同模型——检测器只输出一个真伪分数;源追踪把录音归入封闭的已知系统集合(基于 MLAAD、SpoofCeleb 等多生成器语料训练);判断两段录音是否同源需要单独训练的孪生/双分支网络,每个新问题都要一个新模型、一套新数据。音频语言模型虽开始给深伪检测加解释(HoliAntiSpoof、ThinkOmni、ICLAD),但其解释是教师模型撰写或蒸馏的自由文本:陈述是否符合录音本身无人核查,决策是否依赖该陈述也未经检验——ICLAD 自己报告了幻觉解释,ThinkOmni 的训练解释由看过标签的模型代写,因此可能“流畅但错误”或“正确但与决策无关”。此外研究投入方向不明:有工作主张语音识别编码器会丢弃合成伪迹,也有工作假设源标签必然帮助检测,但都没在控制真实性标签数量与训练步数的前提下验证过。
本文的目标是本文要把语音取证从“一个分数”升级为“一个可审计的分析员”:用一套权重同时完成五类任务——真伪检测、生成器归因(生成器、声学模型、声码器三级)、录音条件分析(噪声、混响、编解码器)、合成片段定位、以及两段录音的同源验证——且每个决策附带可逐句独立核查的依据:observations 用波形测量验证、localization 用标注 span 验证、source profile 用生成器元数据验证;并通过反事实训练保证决策确实由所述证据驱动,而不是“先猜答案、再配一段说得通的解释”。同时通过一次只改一个组件或一种监督形式的控制实验,量化回答“编码器、分词器、LLM 各自决定什么”“源监督到底带来什么”。工程上还要求轻量:只训练约 1% 的参数,单张 24GB GPU 即可完成全部训练阶段,8GB GPU 即可推理。
与已有工作不同的是,独特切入有三点。第一,把所有取证问题统一为“带候选答案句的问答题”,用答案句的对数似然差 $s_q(u)=\log p_\theta(a^+ \mid u,q)-\log p_\theta(a^- \mid u,q)$ 作为分数,检测与同源验证因此不需要任何专用输出头,同一组权重即可在任意工作点阈值化。第二,解释不是自由文本而是固定字段的 rationale,每个字段配一个完全不依赖模型的检查器(在模型实际听到的窗口上测 SNR/电平、从增广日志读信道、把标注 span 映射到窗口时间、从生成器元数据读来源),使“解释正确性”成为可逐句测量的指标,而不是主观印象。第三,把 NLP 忠实性文献中的干预式测试(编辑解释、观察决策是否跟随)系统移植到音频,用训练中从未出现的编辑形式做 held-out 检验,并进一步用反事实训练主动塑造这种依赖——教模型“决策必须跟随给定的定位”,却从不教它对音频说假话。
核心方法
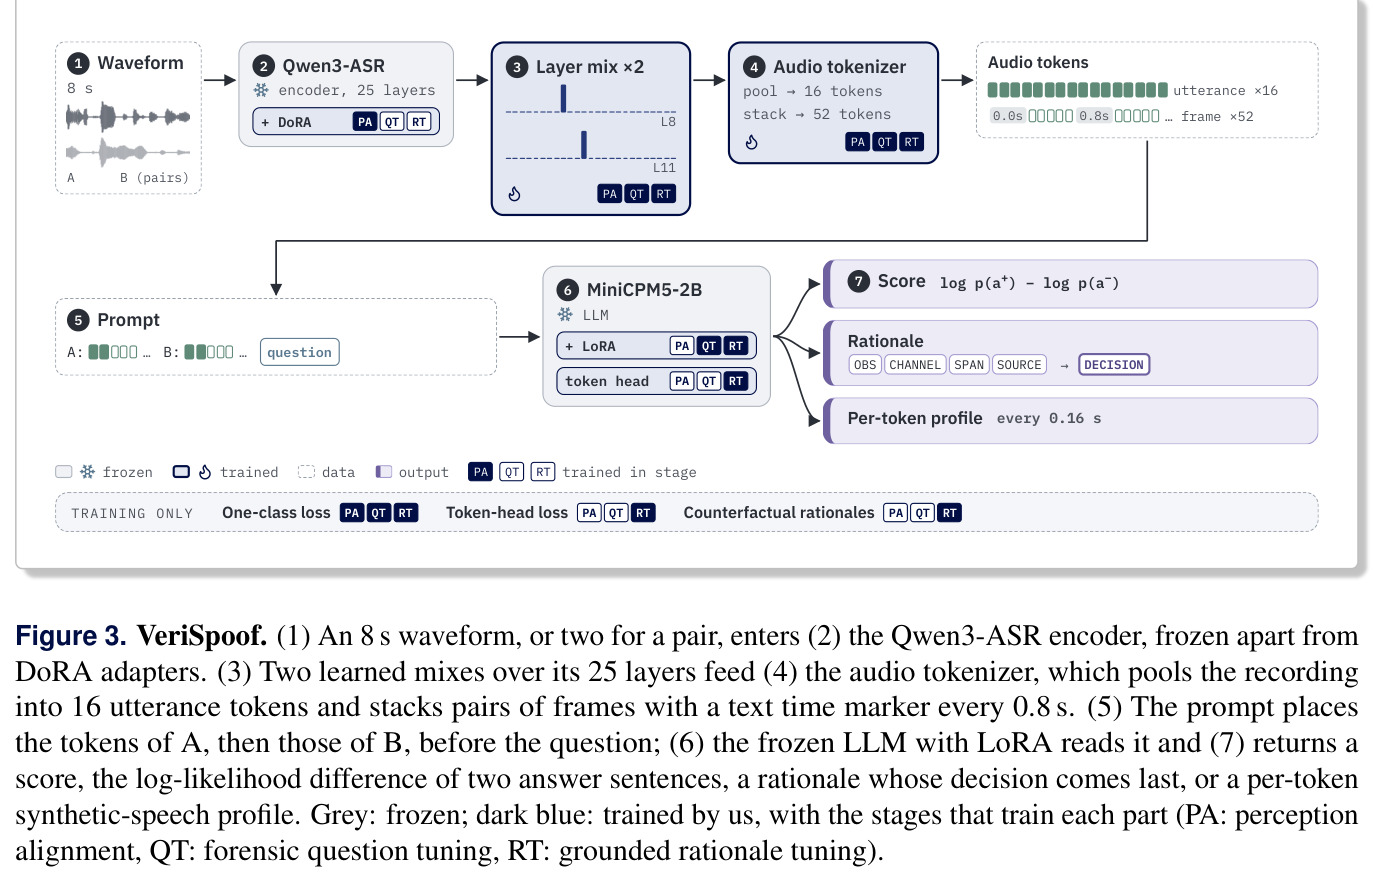
直觉:法庭分析员的每个问题都能改写成选择题——“这段是真人还是伪造?”“两段录音是否出自同一生成器?”——若模型能给每个候选答案句打似然,就既能回答闭式问题,又能输出连续分数供阈值化。技术路线(图 3):8 秒波形进入基本冻结的 Qwen3-ASR 编码器(25 层,仅第一阶段用 DoRA $r=16$ 适配);对 25 层隐状态做两个学习到的加权混合,送入音频分词器得到两种分辨率——16 个 utterance token(承载整段恒定属性,服务归因与同源比较)与 52 个 0.16 秒的 frame token(保留时间结构,每 0.8 秒插入文本时间标记,使 LLM 能用“秒”表述 span);成对输入时把两段录音的 token 先后拼进同一 prompt。LLM 为 MiniCPM5-2B,在注意力投影上加 LoRA($r=16$, $\alpha=32$)。全模型 2.85B 参数仅训练 29.7M。两个辅助损失支持感知:池化音频 token 上的 OC-softmax 单类损失(把真实语音拉向一个学习到的中心),以及从 LLM 隐状态预测每帧真伪的 per-token 头——后者免费产出逐帧伪造概率剖面。输出两种模式:一步答案(按式(1)似然差打分)与“依据在前、决策在后”的 rationale。
核心创新是“可核查的接地解释+反事实对齐”。与 HoliAntiSpoof、ThinkOmni、ICLAD 的自由文本解释有本质区别:VeriSpoof 的 rationale $r=(r_1,\dots,r_k;d)$ 中每个字段类型 $\tau$ 都配一个模型外检查器 $c_\tau(x,r_i)\in\{\text{true},\text{false}\}$——OBSERVATIONS 对照波形测量(带宽类、SNR、语音电平、削波、数字静音),CHANNEL_STATUS 对照增广日志,LOCALIZATION 对照标注 span,SOURCE_PROFILE 对照生成器元数据;决策写在最后,且由定位逻辑蕴含:陈述了至少一个合成 span 当且仅当判为伪造。但接地并不保证忠实——模型完全可能从音频直接猜答案、再配一段一致的依据。为此在 20% 的 rationale 样本上做反事实训练:把定位反转(span 与 none 互换)后只训练紧随其后的决策,让“决策跟随所述定位”成为学到的规则,而模型从未被教过对音频陈述假话。这是把 NLP 的忠实性检验首次系统移植到音频取证,并用训练中未见的编辑形式(改写定位、插入 span、反驳信道/观察陈述)检验泛化。
方法步骤详情
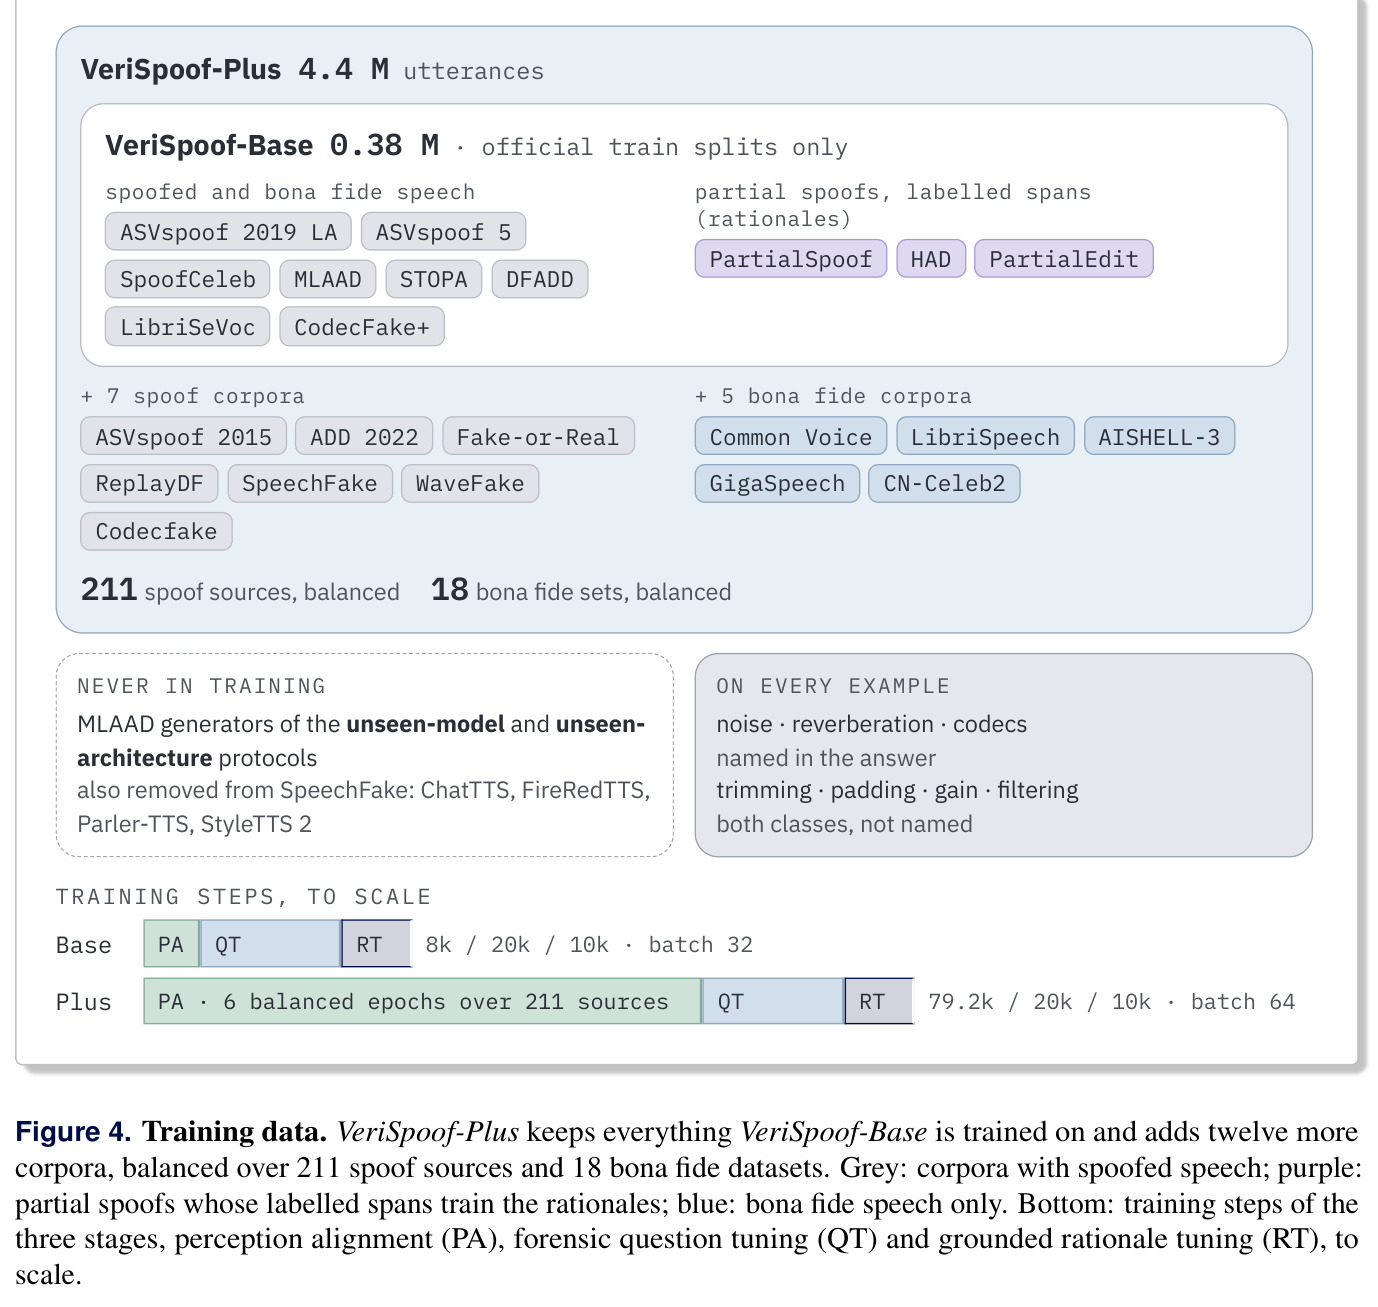
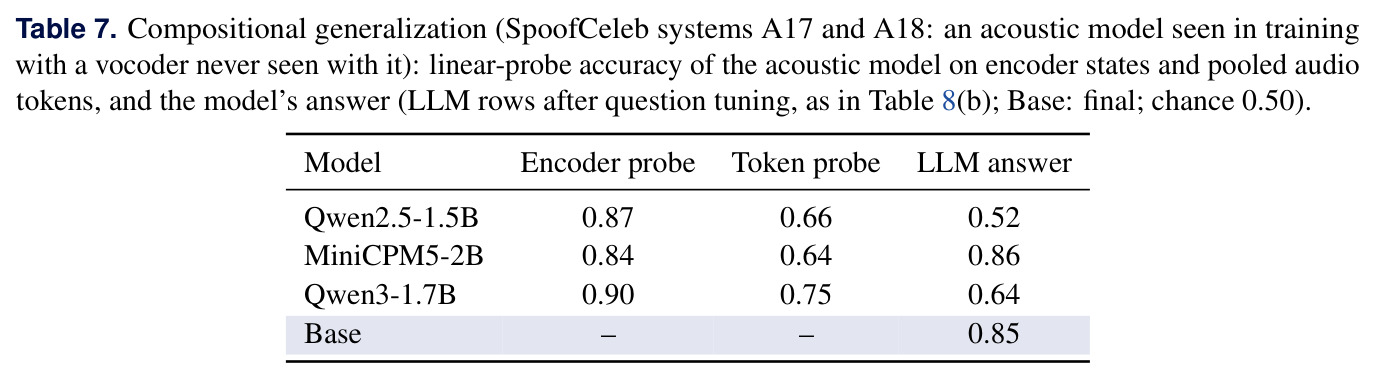
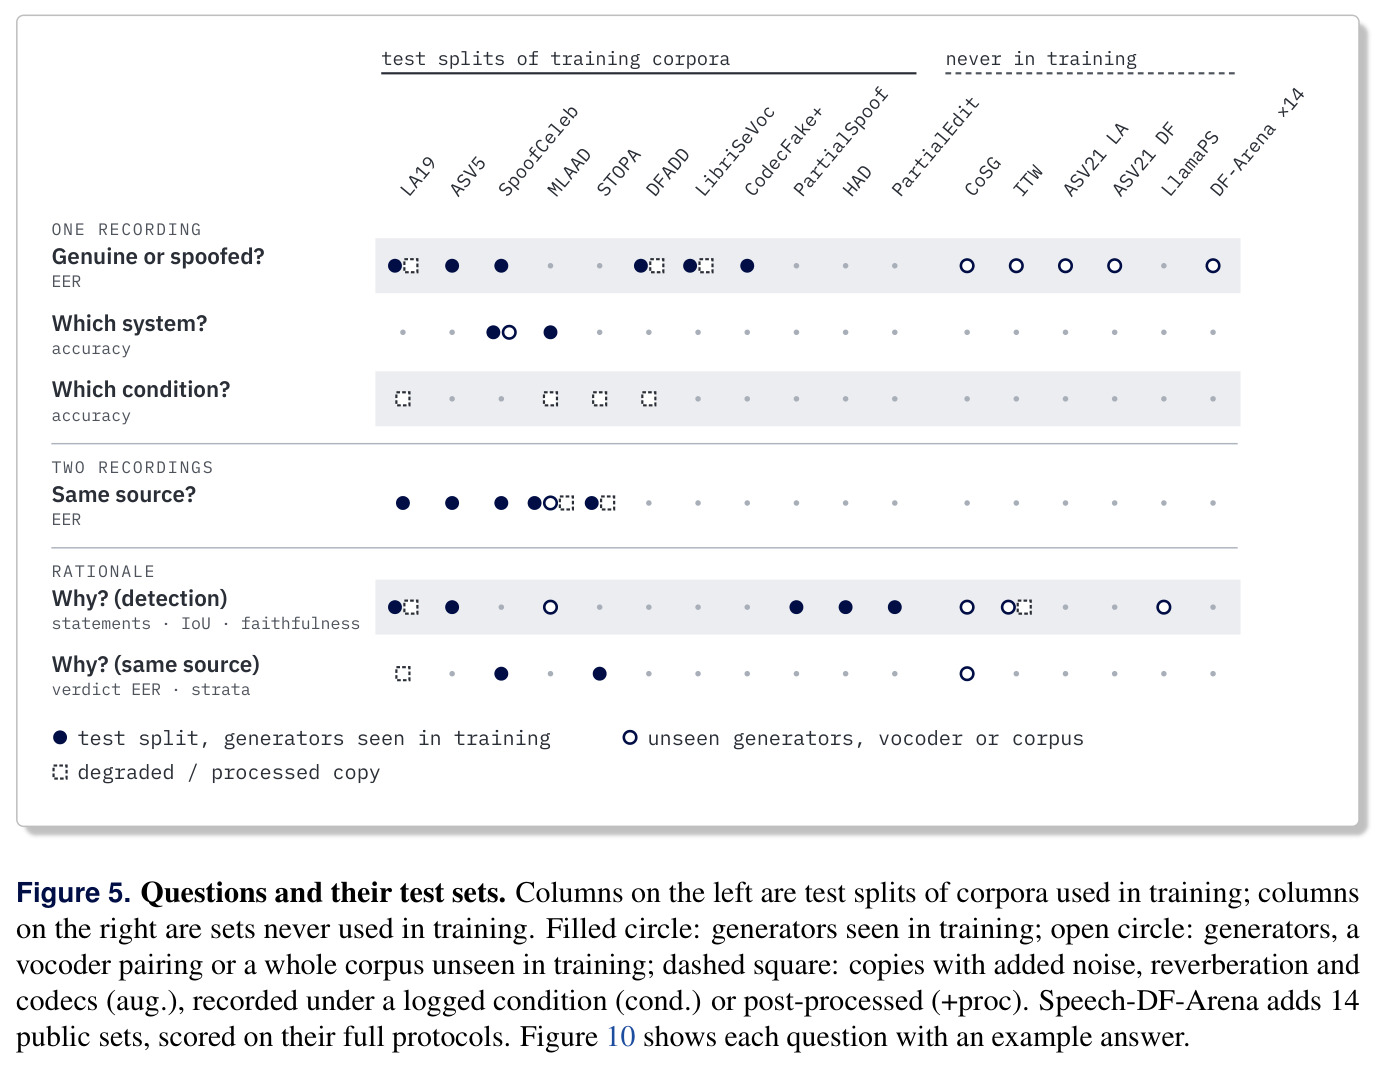
训练分三阶段(图 3、图 4、表 19)。(1) 感知对齐 PA:冻结 LLM,只训音频分词器与编码器 DoRA,用检测与源问题训练,让音频表征先学会携带关键信息,避免 LLM 过早补偿弱音频 token;Base 跑 8k 步,Plus 跑 79.2k 步(6 个平衡 epoch,全局 batch 64、两卡)。(2) 取证问题调参 QT:给 LLM 加 LoRA,多任务指令微调全部感知问题——声学模型、声码器、来源剖面、录音条件,以及成对问题(同生成器/同声学模型/同声码器/两段各自真伪);20k 步。(3) 接地依据调参 RT:引入检测与验证 rationale 及反事实样本,学习率降到 $2\times10^{-5}$,并全程回放 QT 任务以保住一步作答能力;10k 步。数据上,Base 只用 8 个检测语料(ASVspoof 2019 LA、ASVspoof 5、SpoofCeleb、MLAAD、STOPA、DFADD、LibriSeVoc、CodecFake+)的官方训练划分加 3 个部分伪造语料(PartialSpoof、HAD、PartialEdit),约 0.38M 句,不用任何评测划分;Plus 再加 12 个语料共 4.0M 句,伪语音在 211 个源上平衡(MLAAD 生成器归并为 82 个架构族)、真实语音在 18 个数据集上平衡。每次增广(MUSAN 噪声、混响、含窄带的编解码器)都在训练循环内逐样本重抽;后处理(静音裁剪/填充、增益削波、滤波)同施两类且不在答案中点名。推理时一步答案按式(1)评分、rationale 贪心生成;发布包提供 detect/explain/same_source/compare 接口与 vLLM 后端。
技术新颖性
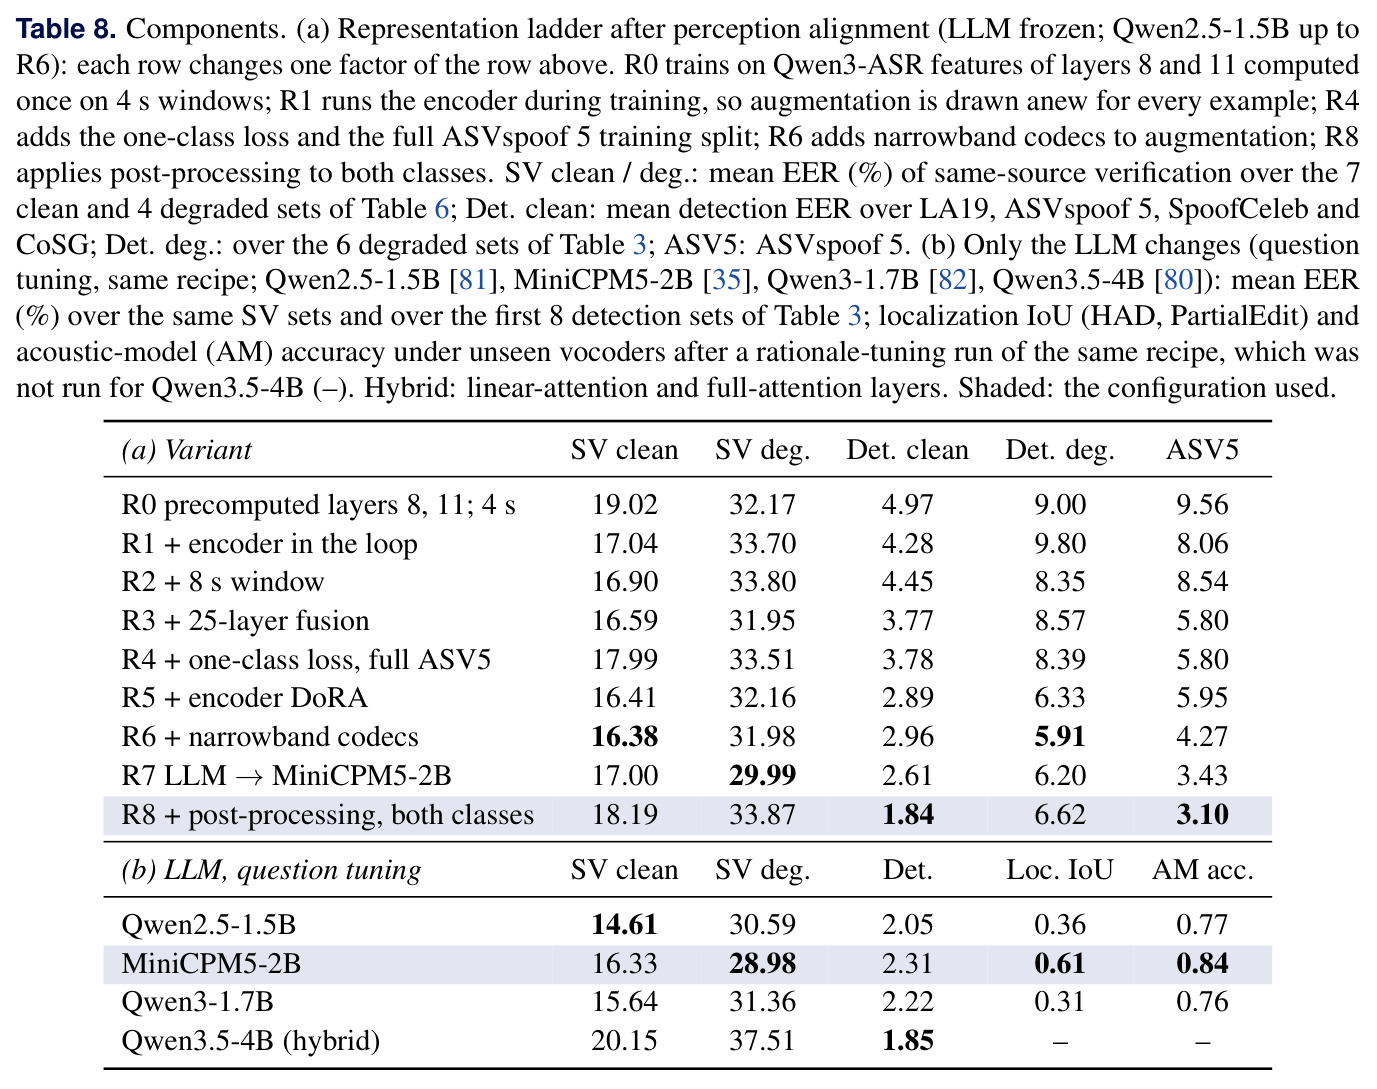
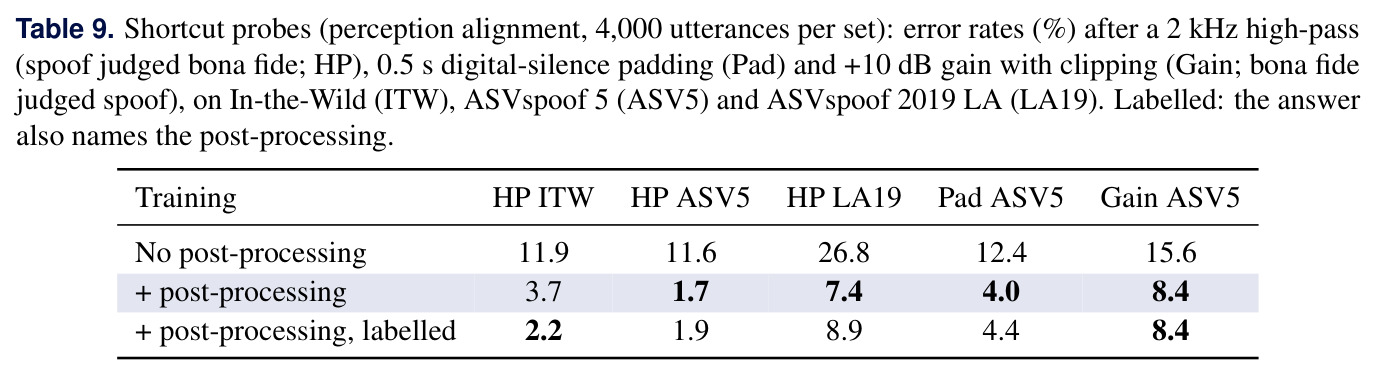
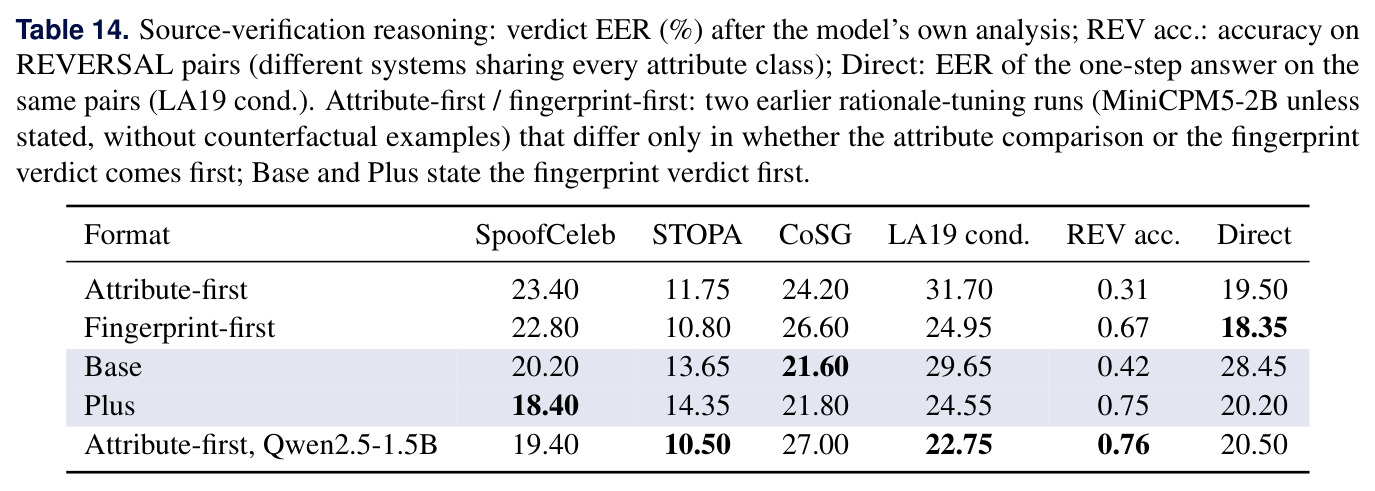
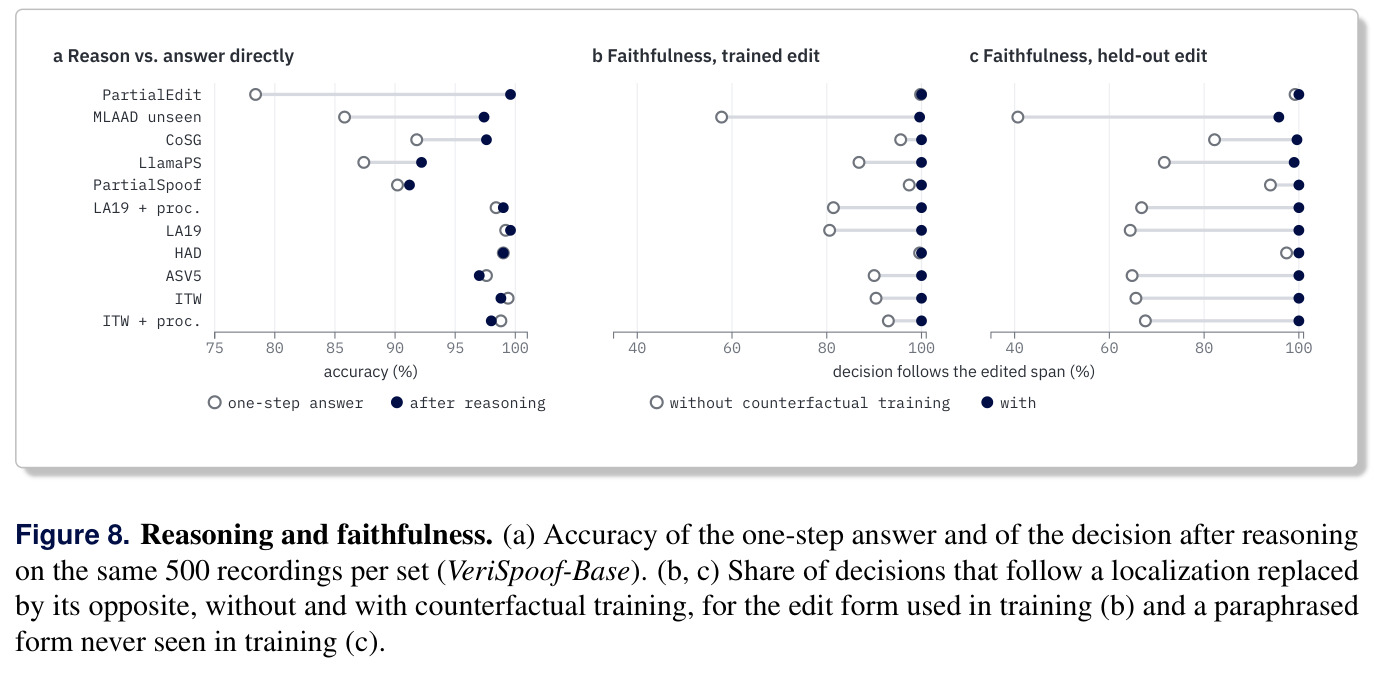
新颖性可分四层。(1) 任务统一机制:以答案句似然为统一评分接口,五任务零附加头——此前同源验证必须单独的孪生网络、归因必须闭集分类头,这在深伪检测文献中是新的。(2) 接地解释的形式化:首次给出“每条陈述有独立检查器”的可判定定义并逐句测量正确率(语音电平正确率 95–100%、SNR 88–99%),把可解释性从主观评价变成可审计指标;错误陈述会明确“未通过检查”(如图 2 中带宽陈述失败而 span 与决策成立)。(3) 忠实性训练:反事实训练只改变决策目标的条件(给定反转的定位),不污染对音频的感知学习;训练后改写定位的跟随率从 73.8% 升至 99.5%,且非证据的信道/观察陈述被反驳时决策保持不变(100% stay rate),证明依赖被精确限制在证据字段上。(4) 方法论贡献:控制变量拆解(固定编码器改用法使 ASVspoof 5 EER 9.6%→3.1%;固定用法只换 LLM,检测仅动 0.5 点而同源验证动 5.5 点)、等标签/等步数的源监督消融(CodecFake+ 上 2.2% vs 12.6%)、通道捷径系统探测(2kHz 高通让 11.6–26.8% 的伪冒漏网,后处理同施两类可压到 1.7–8.4%),为社区提供了可复用的实验范式。
实验结果
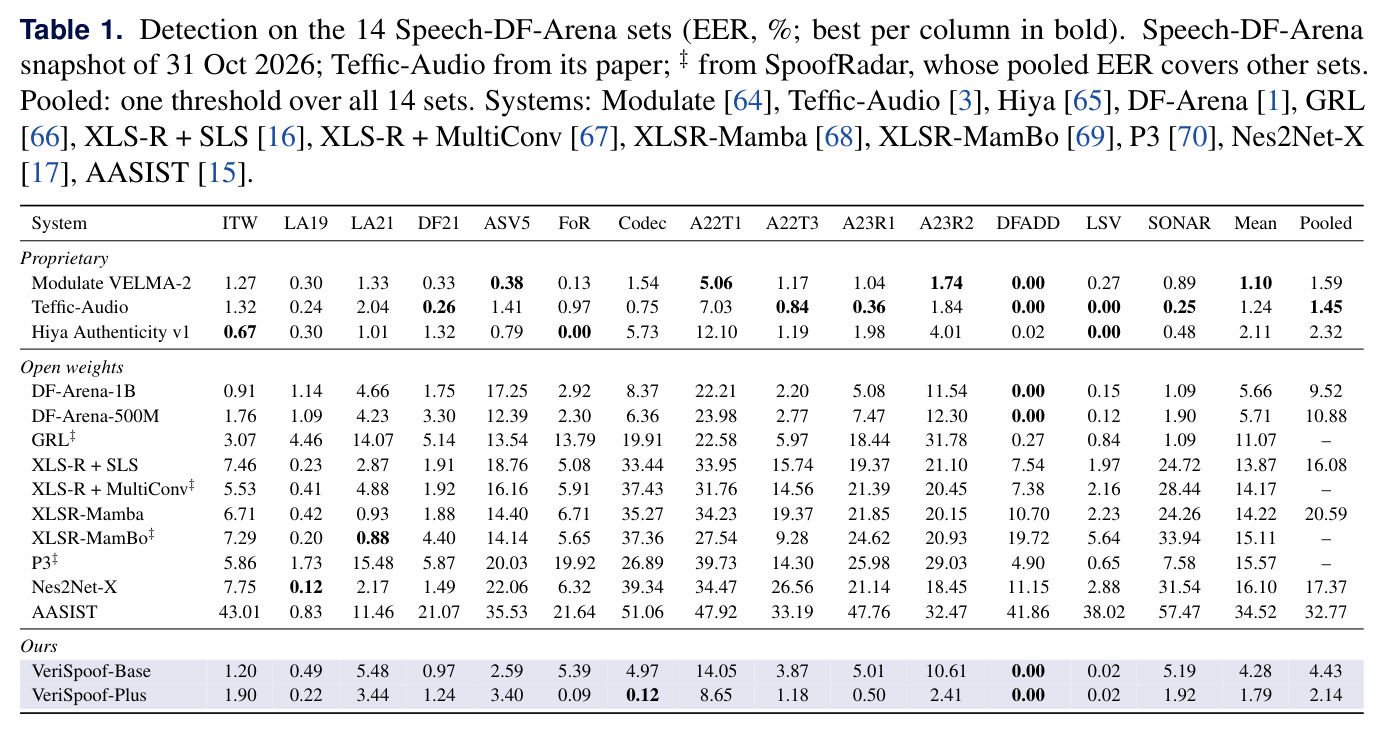
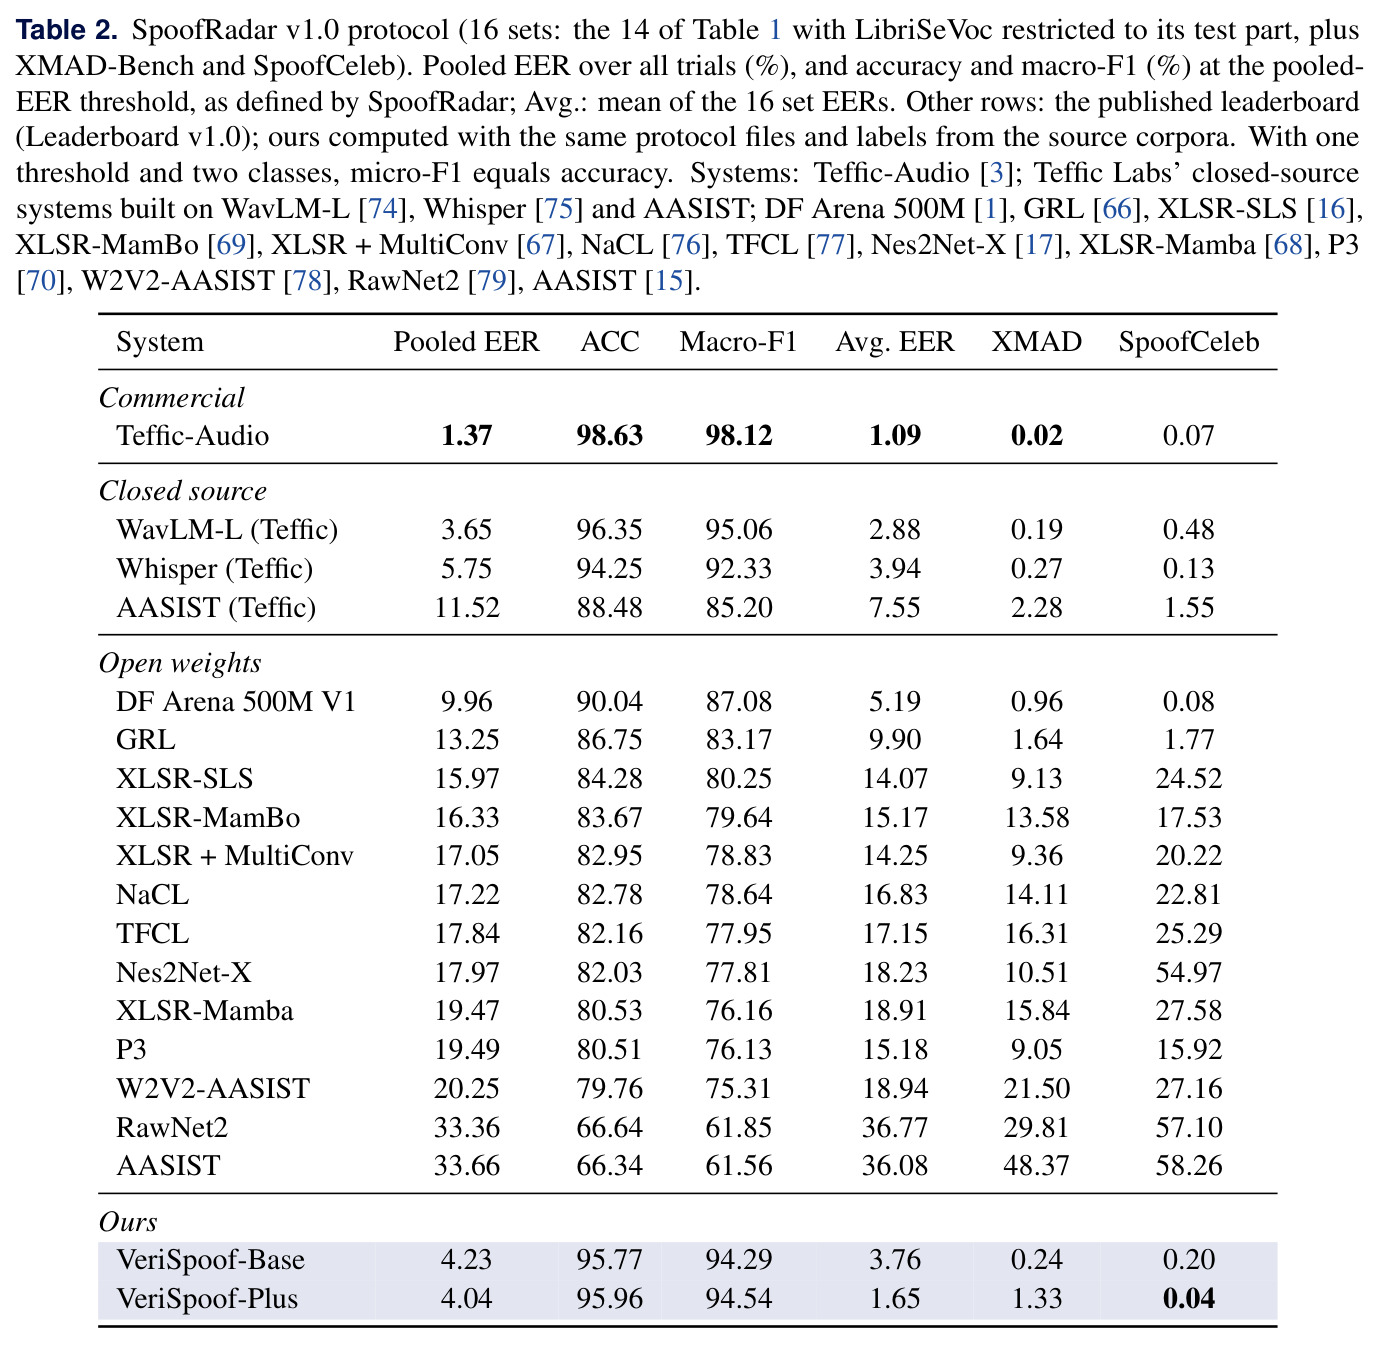
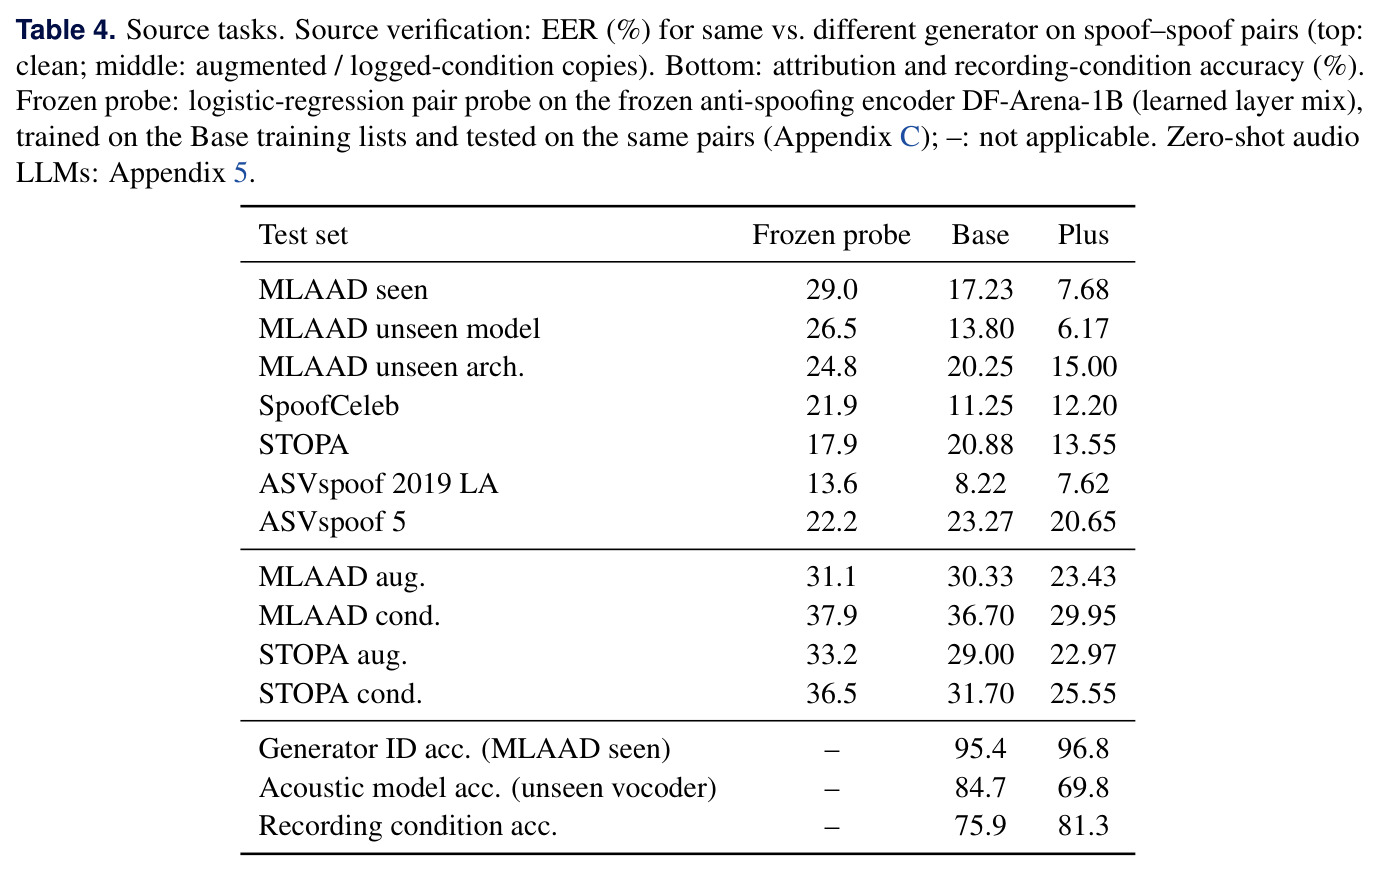
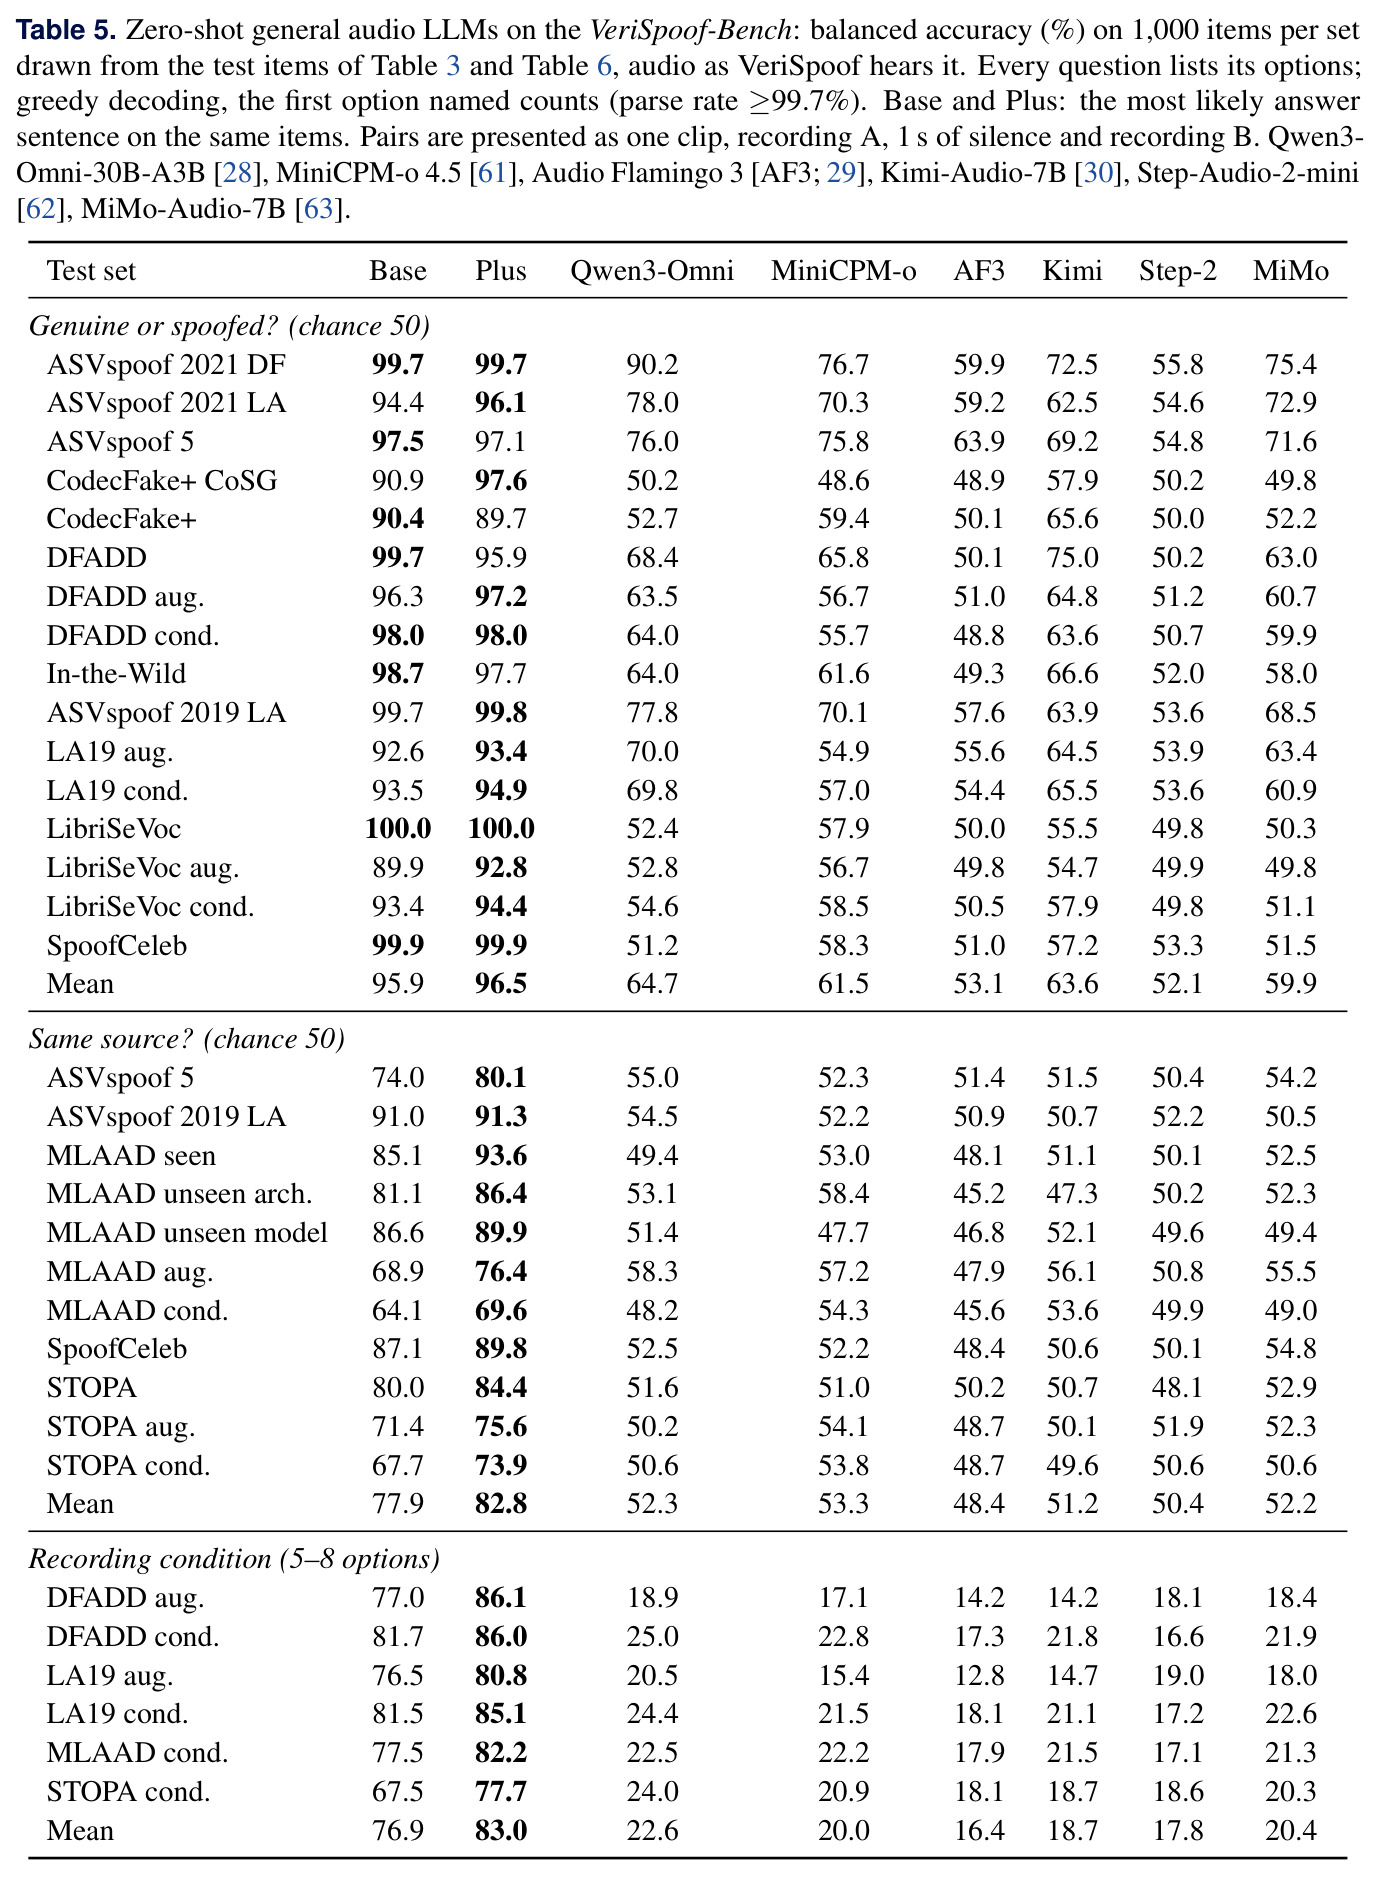
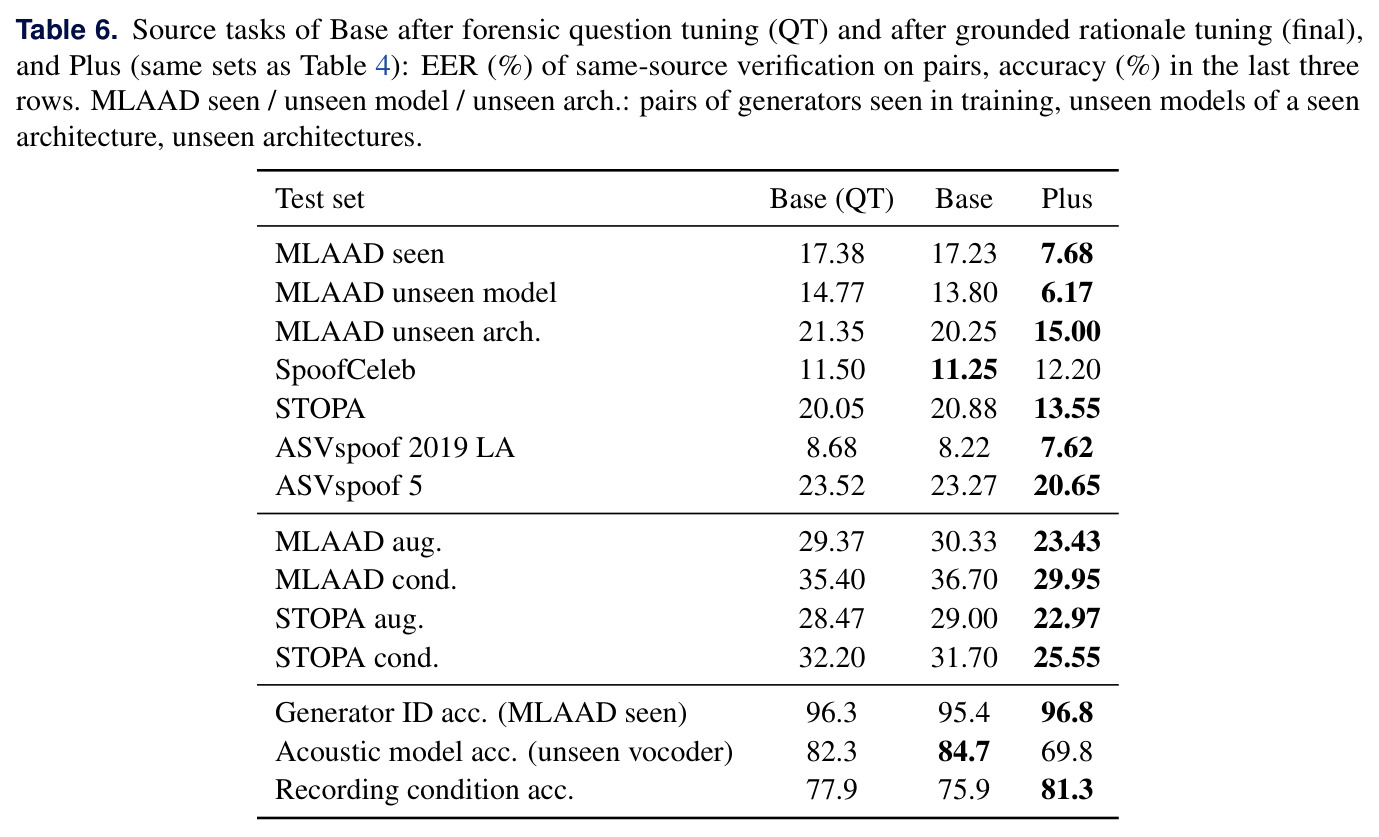
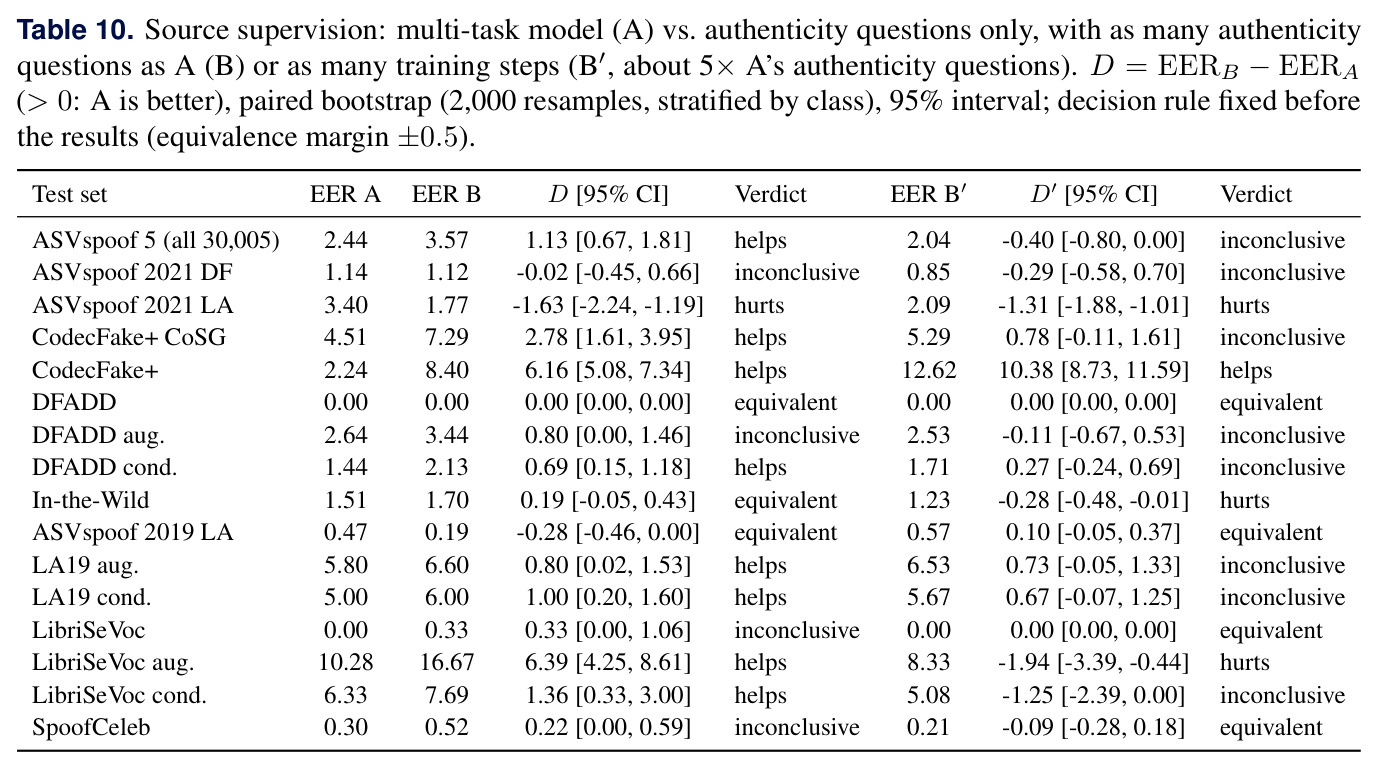
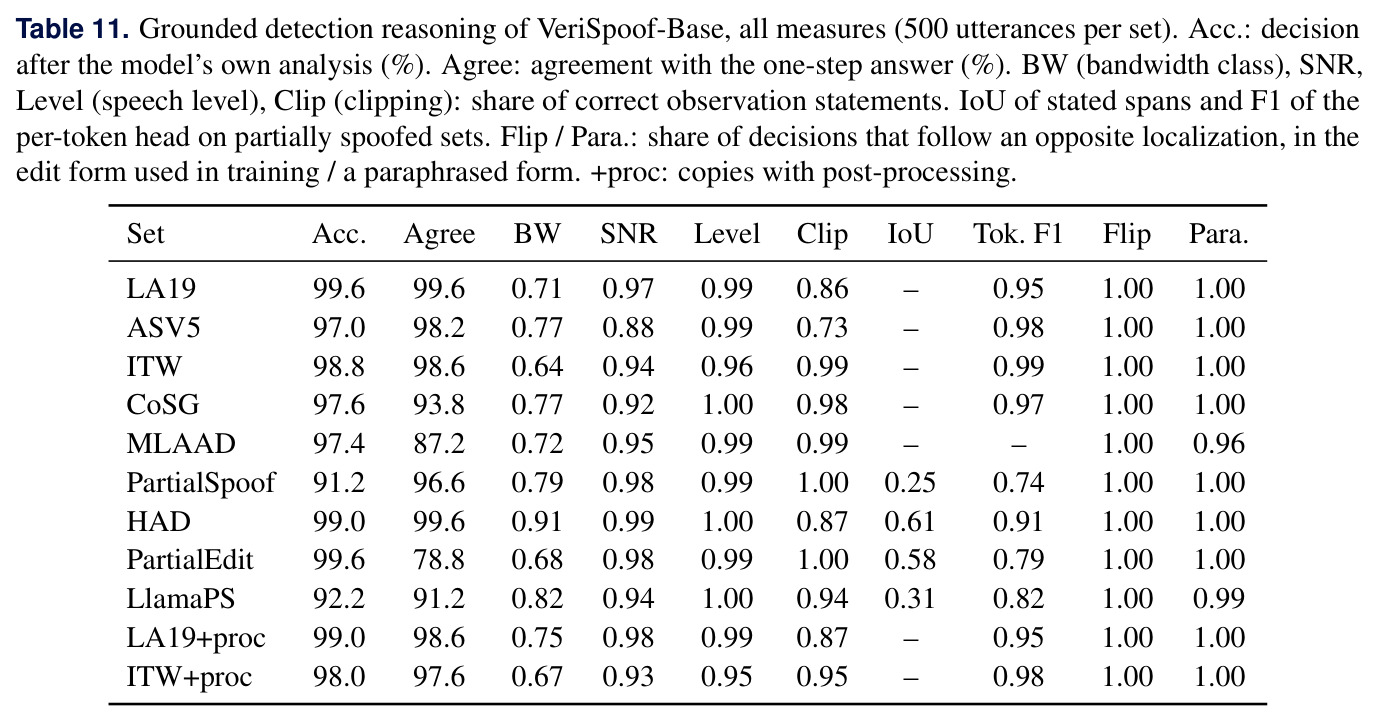
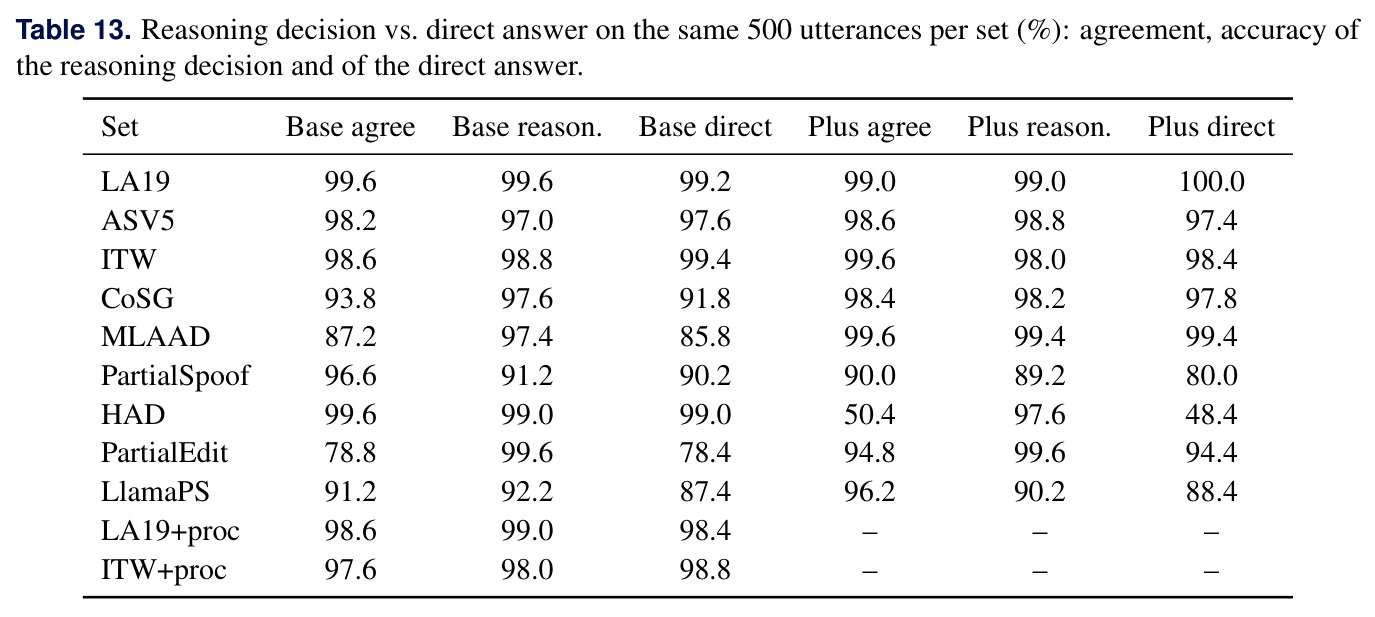
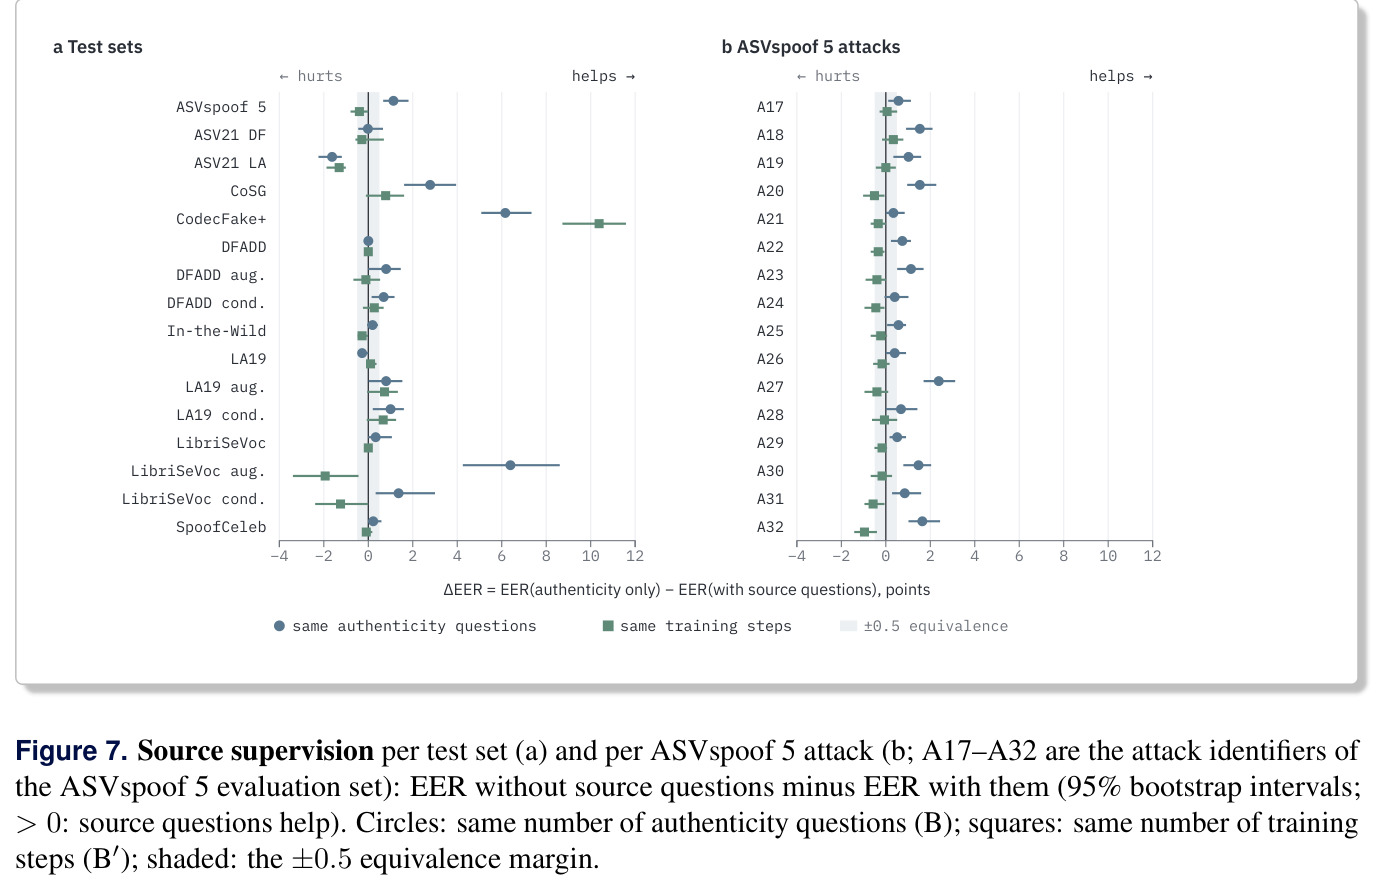
核心结果有六组。(1) 公开检测榜:在 Speech-DF-Arena 全部 14 个官方协议(共 234 万试次)上,VeriSpoof-Plus pooled EER 2.14%、逐集均值 1.79%,按 2026-10-31 公开快照在 28 个系统中列第 3,仅落后两个专有系统(Modulate VELMA-2 1.59%、Resemble 3B-Omni 2.10%),是开源第一;次优开源 DF-Arena-1B pooled 9.52%。仅用 0.38M 官方训练句的 Base 也达 4.43%,不到其他开源系统一半。SpoofRadar 16 集上 Base/Plus pooled 4.23/4.04%(榜单开源最佳 9.96%);未见语言 XMAD-Bench 上 Base 0.24%。但 Plus 的 pooled 4.04% 远高于其均值 1.65%:统一阈值把 92.9% 的俄语、32.2% 西班牙语、15.4% 阿拉伯语真实语音误判为伪造——校准漂移被 pooled 指标暴露。(2) 同源验证:同一权重对未见生成器对判同源,MLAAD unseen model 6.17%、unseen architecture 15.00% EER,大幅优于冻结编码器 pair probe(26.5/24.8%);六个通用音频 LLM 零样本接近随机(同源 48.4–53.3%),Base/Plus 达 77.9/82.8% balanced accuracy。(3) 组件研究:改变“特征怎么用”使 ASVspoof 5 EER 从 9.56% 降至 3.10% 而同源验证稳在 16–19%;只换 LLM 检测动 0.5 点、同源验证动 5.5 点;混合线性注意力的 Qwen3.5-4B 检测最好(1.85)但比较最差(20.15)。(4) 源监督:等标签量下 16 集中 8 集有益、16 个 ASVspoof 5 攻击中 12 个有益且无一受害;等步数下大多等价;但 CodecFake+ 上五倍二分类标签仍只到 12.6%,多任务模型 2.2%(D=10.4 [8.7, 11.6])。(5) 推理价值:PartialEdit 上推理后决策 99.6% vs 一步 78.4%;Plus 在 HAD 上一步仅 48.4% 而推理后 97.6%。忠实性:反事实训练后改写定位跟随率 99.5%(无训练 73.8%),非证据陈述被反驳时决策 100% 不变。(6) 成本:仅训 29.7M/2.85B 参数,Base 全程约 14 GPU 时,推理 6–7GiB 显存即可。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语音深伪检测(Speech-DF-Arena,14 个官方协议,234 万试次) | pooled EER (%) | VeriSpoof-Plus 2.14(逐集均值 1.79) | 次优开源 DF-Arena-1B 9.52;专有系统 Modulate VELMA-2 1.59、Resemble 3B-Omni 2.10 | 较次优开源低 7.38 个百分点(约 4.4 倍),开源第一、总榜 28 系统中第三 |
| 语音深伪检测(仅 0.38M 官方训练句的小数据设定) | pooled EER (%) | VeriSpoof-Base 4.43 | DF-Arena-1B 9.52(更大规模训练) | 不到基线一半,验证小数据配方的有效性 |
| 语音深伪检测(SpoofRadar v1.0,16 集) | pooled EER (%) | Base 4.23 / Plus 4.04 | 公开榜单开源最佳 DF Arena 500M 9.96 | 降低约 6 个百分点;XMAD-Bench 未见七语言上 Base 0.24% EER |
| 同源验证(MLAAD,未见模型、已知架构的生成器对) | EER (%) | VeriSpoof-Plus 6.17 | 冻结 DF-Arena-1B 编码器上的 pair probe 26.5 | 降低 20.3 个百分点 |
| 同源验证(MLAAD,未见架构生成器对) | EER (%) | VeriSpoof-Plus 15.00 | pair probe 24.8;Base 20.25 | 较 pair probe 低 9.8 个百分点,说明源线索与架构绑定 |
| 零样本对比:真伪判断(VeriSpoof-Bench 17 集均值) | balanced accuracy (%) | Base 95.9 / Plus 96.5 | 六个通用音频 LLM 中最佳 Qwen3-Omni 64.7 | 提高约 31 个百分点;同源题通用模型仅 48.4–53.3%(接近随机) |
| 部分伪造决策(PartialEdit,每集 500 句) | 决策准确率 (%) | 推理后 99.6 | 一步直答 78.4 | +21.2 个百分点,推理能抓出一票式判决漏掉的局部拼接伪迹 |
| 忠实性(改写式反转定位,训练中未见的编辑形式) | 决策跟随率 (%) | 99.5(有反事实训练) | 73.8(无反事实训练) | +25.7 个百分点,且非证据陈述被反驳时决策 100% 保持不变 |
| 源监督消融(CodecFake+ 神经编解码伪迹) | EER (%) | 多任务模型 A 2.24 | 五倍真伪标签量的纯二分类模型 B′ 12.62 | 低 10.38 个百分点(D=10.4 [8.7, 11.6]),证明源监督对 codec 伪迹不可替代 |
| 生成器归因(MLAAD 已见生成器) | top-1 准确率 (%) | Plus 96.8(Base 95.4) | 无开源系统可做该任务 | 录音条件判断 81.3%,为首个同权重支持归因+验证+检测的模型 |
局限与改进
作者承认的局限:(a) 校准漂移——Plus 在未见语言/域的真实语音上分数整体偏移,pooled 阈值下 92.9% 俄语、32.2% 西班牙语、15.4% 阿拉伯语真实录音被误判为伪造,部署必须按域重设阈值;(b) 退化副本上的同源验证仍难(增广/带日志条件副本 23–30% EER),噪声与编解码掩盖生成器细节;(c) ASVspoof 2021 LA 是源监督唯一造成伤害的集合(对 B −1.63、对 B′ −1.31),损失集中在三个未见攻击(A10/A11/A18),机制未明;(d) 带宽类是最不可靠的陈述(0.64–0.91),更细的 0.5kHz 分级从音频 token 不可恢复(探针仅 38%);(e) 数据混合决定强项,Plus 加入大数据后在 ASVspoof 5(2.59→3.40)、In-the-Wild(1.20→1.90)、ASVspoof 2021 DF 上反而退步。我补充的观察:(f) 8 秒窗口限制长录音分析,长音频需外部切片与跨窗聚合策略,跨窗口边界的编辑定位会断裂;(g) 归因本质是闭集的——96.8% 生成器识别只对训练见过的生成器成立,真实取证面对未知工具;(h) LOCALIZATION 检查器依赖标注 span、CHANNEL_STATUS 依赖增广日志,真实数据没有这些标签,推理时“每句可查”只对可测量的 observations 完全成立;(i) VeriSpoof-Bench 是自建评测,增广分布与训练一致,作者明言未提交 leaderboard,缺少第三方独立复现;(j) 语料以英语为中心,中文等语言的真实语音覆盖有限。
独立分析的弱点
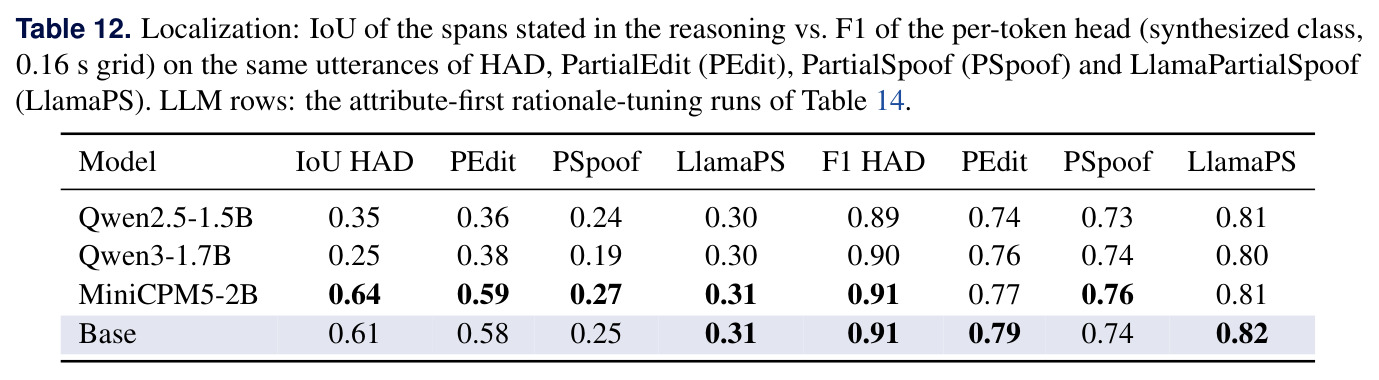
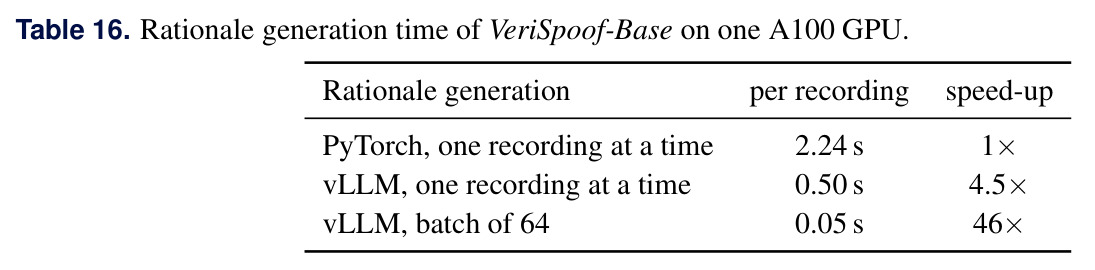
独立分析五个弱点并给出改进方向。(1) 长音频与流式缺失:8 秒窗口意味着一小时录音需数百次推理与跨窗聚合,边界处的编辑会被切分——可引入滑动窗口加分段级联聚合,或在训练中加入长上下文变体。(2) 文本化是定位瓶颈:帧级证据本可分(per-token 头 F1 在多短 span 的 PartialSpoof/LlamaPS 上达 0.74–0.82,在 HAD 上 0.91),但写出的 span IoU 只剩 0.25–0.31,说明把帧级信息翻译成秒级文本是 LLM 的短板——可改用结构化输出(指针/JSON 区间)或让 per-token 剖面直接参与决策而非仅作参考。(3) 单一全局阈值不可部署:Plus 的域外校准漂移(92.9% 俄语真实语音被误判)表明 pooled 部署危险——可引入分数归一化(如 AS-Norm)或按域校准的轻量适配层。(4) 未见架构同源验证差距大:unseen model 6.17% vs unseen architecture 15.00%,源指纹与架构强绑定——可加入对比学习式的开集指纹表征,或对生成器属性做层级式零样本推理。(5) rationale 的推理开销:需生成数百 token,A100 上 vLLM 单条 0.50 秒(PyTorch 逐条 2.24 秒),大规模筛查只能退回一步分数——可蒸馏轻量 rationale 变体或自适应决定是否展开推理(一步分数不确定时才写依据)。此外反事实训练只用 20% 比例、单一反转形式,提高比例与多样化编辑形式可能进一步加固忠实性。
未来方向
作者提出或暗示的方向:在新语言/新域上用该域真实语音校准阈值再部署;构建能支撑更细带宽分级的更强音频分词器;测试 8/4-bit 量化与 fp16 以触达 T4/V100 等更低端 GPU;把评测协议交给社区、正式提交 Speech-DF-Arena 与 SpoofRadar leaderboard。基于本文成果可延伸的方向:把检查器机制推广到无标注场景——用源分离或编解码伪迹检测器自动生成 span 伪标签,让“每句可查”摆脱对人工标注的依赖;把反事实训练与忠实性干预测试移植到图像/视频深伪取证与语音反欺骗攻击;研究对抗鲁棒性——攻击者可以伪造“自然信道”特征欺骗观察陈述,检查器本身是否可被对抗性欺骗值得量化;与说话人验证统一(类比 SpeakerLLM 的思路),实现“谁在说+是否合成+是否同源”三合一的证卡级模型;开集生成器归因与增量学习——新生成工具出现后做零样本归因而非闭集拒绝;扩展 VeriSpoof-Bench 为纳入新生成器的持续更新公共榜;探索 rationale 长度与决策准确率的最优权衡(更短字段、结构化 span 输出以提高 IoU)。
复现评估
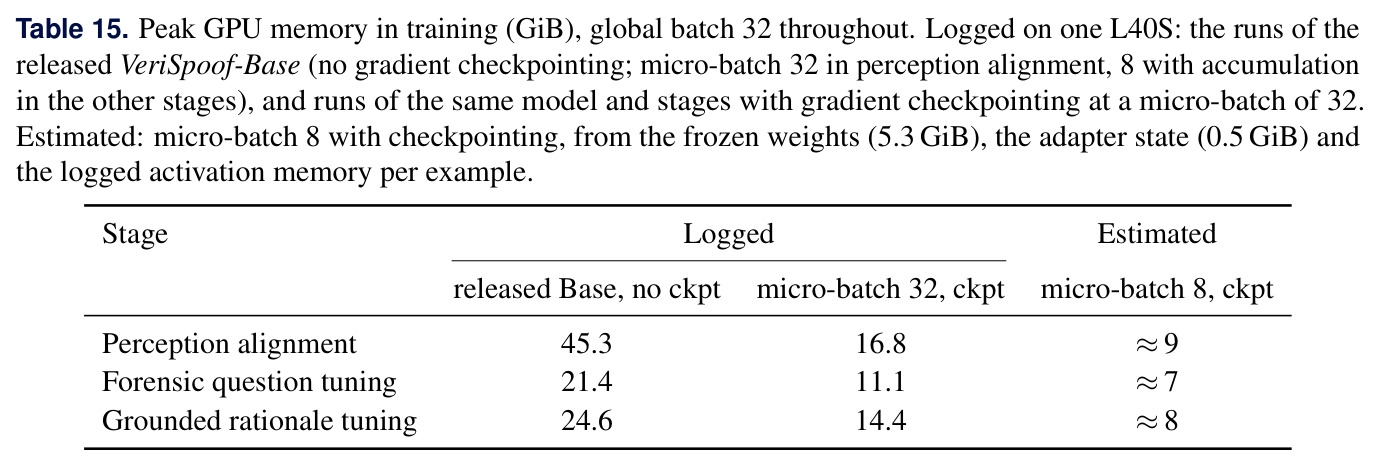
复现条件在同类工作中属最好之列。发布物完整:Base 与 Plus 两个模型权重、含 vLLM 后端的推理代码、在线 demo,以及 VeriSpoof-Bench 评测套件(54 个子集、177,852 项,含打分脚本与两模型的逐项输出),训练数据全部是公开数据集的官方训练划分(未用任何评测划分),held-out 生成器(MLAAD 未见协议中的系统及 SpeechFake 中的 ChatTTS、FireRedTTS、Parler-TTS、StyleTTS 2)明确从训练数据剔除。算力门槛低:仅 29.7M 参数受训,Base 三阶段约 14 GPU 时(单卡 L40S 48GB、无梯度检查点峰值 21–45GiB);开启梯度检查点后峰值 11–17GiB,整个配方(含全局 batch 32)可在单张 RTX 3090/4090(24GB)复现;估算 micro-batch 8 加检查点约 7–9GiB 可入 12GB 卡(作者未实测);推理 6–7GiB,8GB 消费级卡即可,vLLM 批量生成 rationale 每条 0.05 秒。注意事项:代码用 bf16,需 Ampere 及以上 GPU(T4/V100 需改 fp16/fp32,未测试);Plus 的感知对齐在两卡上跑 79.2k 步,单卡时间成本更高;增广在训练循环内逐样本重抽,对数据管线工程有一定要求;论文数字为作者按官方协议文件自算而非榜单提交。总体复现难度:中低。
论文图表
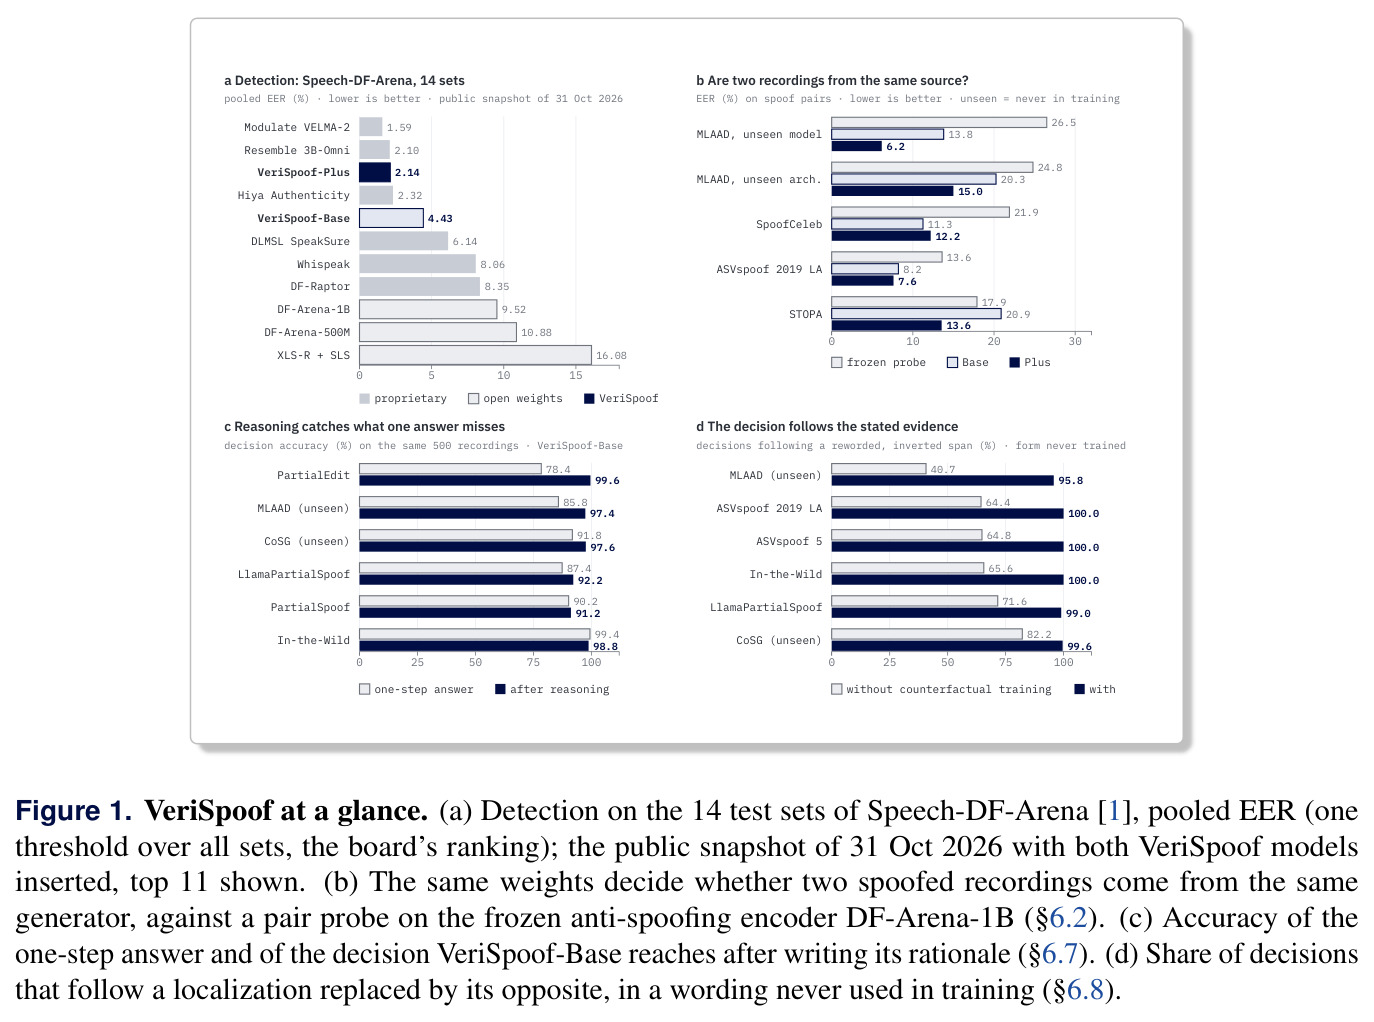
四联图总览:(a) Speech-DF-Arena 14 集 pooled EER 排行(2026-10-31 公开快照 top 11),VeriSpoof-Plus 2.14% 列第三、开源第一,Base 4.43%;(b) 同源验证 EER,五个协议上 Plus(6.2/15.0%)对冻结探针(26.5/24.8%)与 Base 的对比;(c) 同样 500 条录音上一步直答与推理后决策的准确率对比(PartialEdit 78.4→99.6%);(d) 有/无反事实训练时决策跟随改写反转定位的比例(如 MLAAD 40.7→95.8%)。
一张图浓缩了论文四大卖点:开源最强检测、同权重同源验证、推理优于直答、忠实性可训练,是快速把握全文贡献与量级的入口。
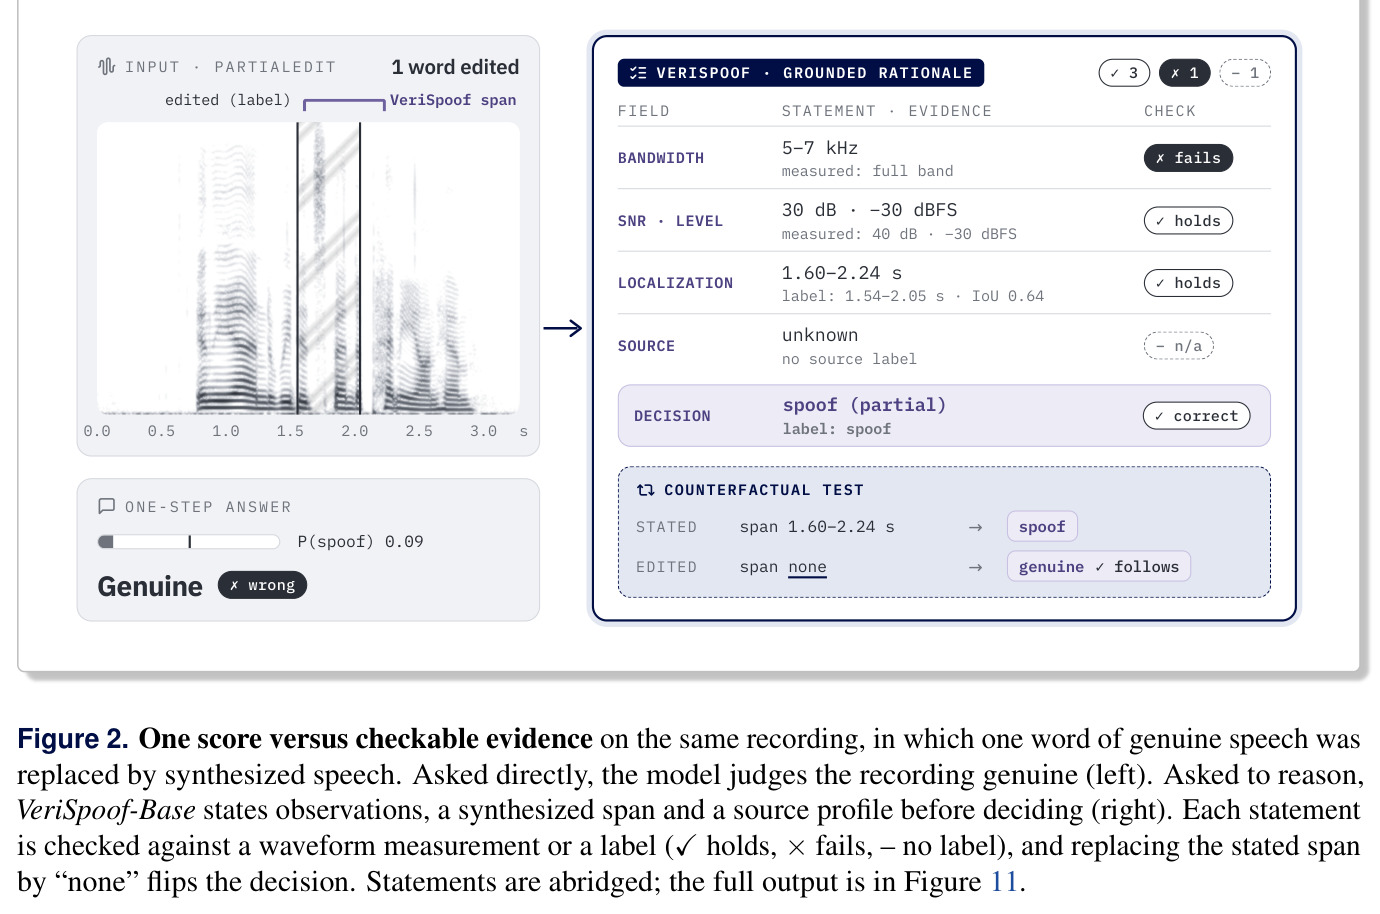
同一 PartialEdit 录音的两种处理:左侧一步直答给出 P(spoof)=0.09、误判为真实;右侧写接地 rationale——带宽陈述(5–7kHz,实测全频带)未通过检查,SNR/电平陈述通过,定位 span 1.60–2.24s 与标注 IoU 0.64 通过,决策 spoof(部分伪造)正确;反事实测试显示把所述 span 换成 none 后决策翻转为 genuine。
最直观地展示论文核心主张:一票式判决会漏掉局部伪造,而逐字段可核查的依据既定位了伪造区间,又能证明决策确实由该证据驱动。