Venus-DefakerOne2:覆盖更广威胁谱系的视觉取证基础模型 Venus-DefakerOne2: A Vision-Forensics Foundation Model with Broader Coverage
用潮汐式调参与模态协同,把数字与物理伪造、图像与视频检测统一进单个2B参数模型
前置知识
LoRA(低秩适配)微调
LoRA 冻结预训练权重 $W$,只训练一个低秩增量 $\Delta W = BA$($B\in\mathbb{R}^{d\times r}$,$A\in\mathbb{R}^{r\times k}$,秩 $r \ll d$),推理前可把 $BA$ 合并回原权重。它大幅降低可训练参数量、显存与训练成本,并因改动受限而天然保护预训练知识;代价是参数预算有限,面对超大规模、高度异质的数据时容易欠拟合。
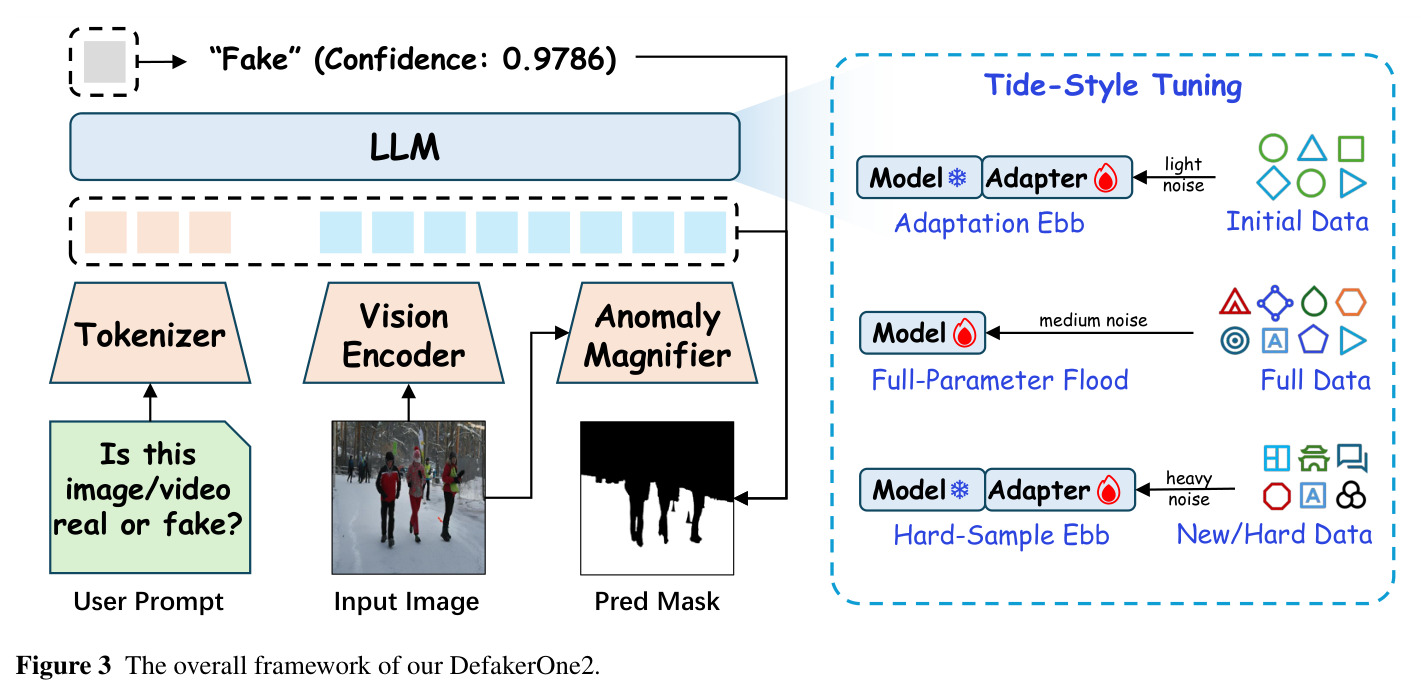
本文的 Tide-Style Tuning 就是在 LoRA(退潮)与全参数微调(涨潮)之间交替涨落,理解 LoRA 的容量-成本-遗忘权衡是读懂该方法和其消融实验的前提;实现细节里明确给出 LoRA 秩 $r=64$、$\alpha=128$。
多模态大语言模型(MLLM)
以大语言模型为核心、外接视觉编码器的生成式模型,把图像/视频编码为 visual token 与文本一起送入 Transformer,通过自回归解码逐 token 输出答案。由于输出是词表上的概率分布,二分类任务的置信度可以直接从单个答案 token 的概率读出。
DefakerOne2 以 Qwen3.5-2B 为骨架,把检测改造成"只输出一个 Real/Fake token"的问题;论文里的检测损失、熵路由和校准环全部建立在 MLLM 的单 token 概率之上,不懂这个机制就无法理解其推理流程。
灾难性遗忘
在新任务上微调大模型时,梯度更新会覆盖预训练阶段学到的通用知识,导致旧能力急剧退化;全参数微调比 LoRA 更容易触发,而困难样本产生的大梯度会进一步侵蚀预训练知识。
Tide-Style Tuning 的第一阶段(LoRA 适应退潮)和第三阶段(LoRA 硬样本退潮)的核心目的之一就是抑制遗忘、保住 Qwen3.5 的世界知识与视频理解先验,作者用这一点解释为什么先 LoRA 再全参数的顺序能避免破坏性梯度。
展示攻击与物理伪造
伪造不只发生在数字域。物理伪造指对真实采集设备的欺骗,例如人脸防伪中的打印照片、屏幕重放、3D 面具等展示攻击,以及证件领域的打印-翻拍/屏幕翻拍攻击;其痕迹是摩尔纹、屏幕边框、镜面反光、重采样模糊等成像链条伪影,与数字篡改的拼接边界、生成指纹完全不同。
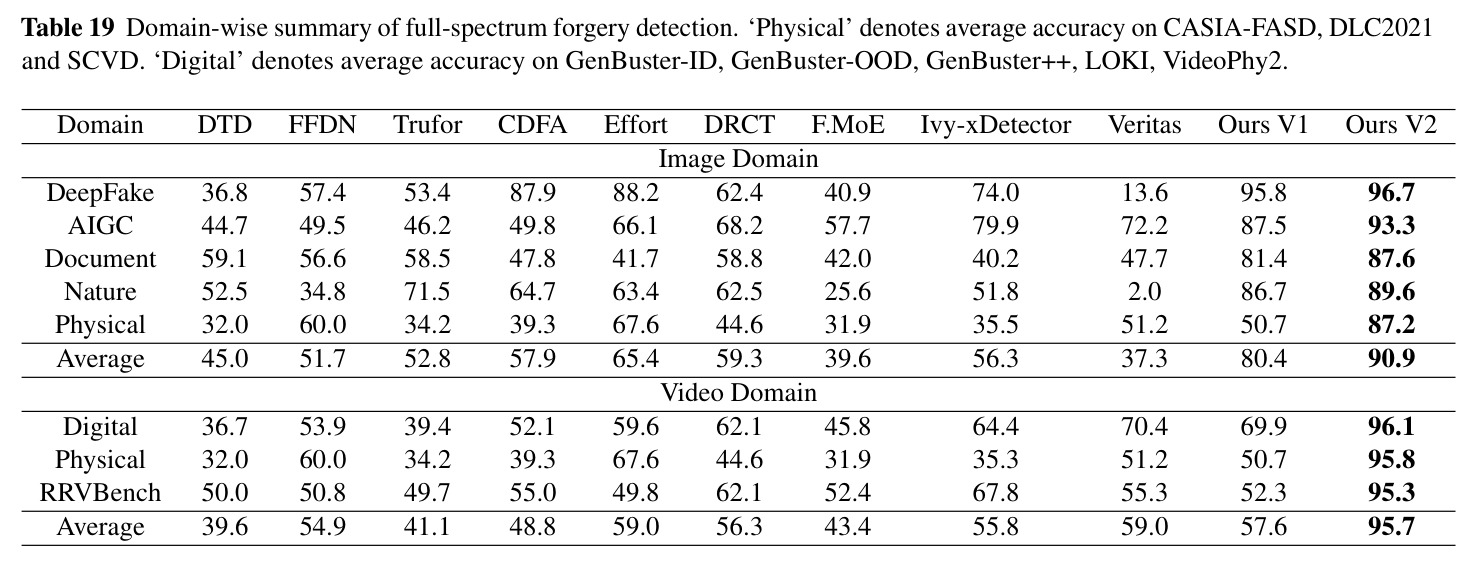
本文首次把物理伪造与数字伪造统一进同一个基础模型,物理域正是上一代模型的最大短板(50.7 提升到 87.2),CASIA-FASD、DLC2021、SCVD 等大量实验都来自这一威胁类型。
香农熵
香农熵 $H=-\sum_i p_i \log p_i$ 衡量概率分布的不确定性:分布越尖锐熵越低,代表模型越"笃定"。对一个二分类 Real/Fake 预测,熵只由正类概率 $c$ 决定。
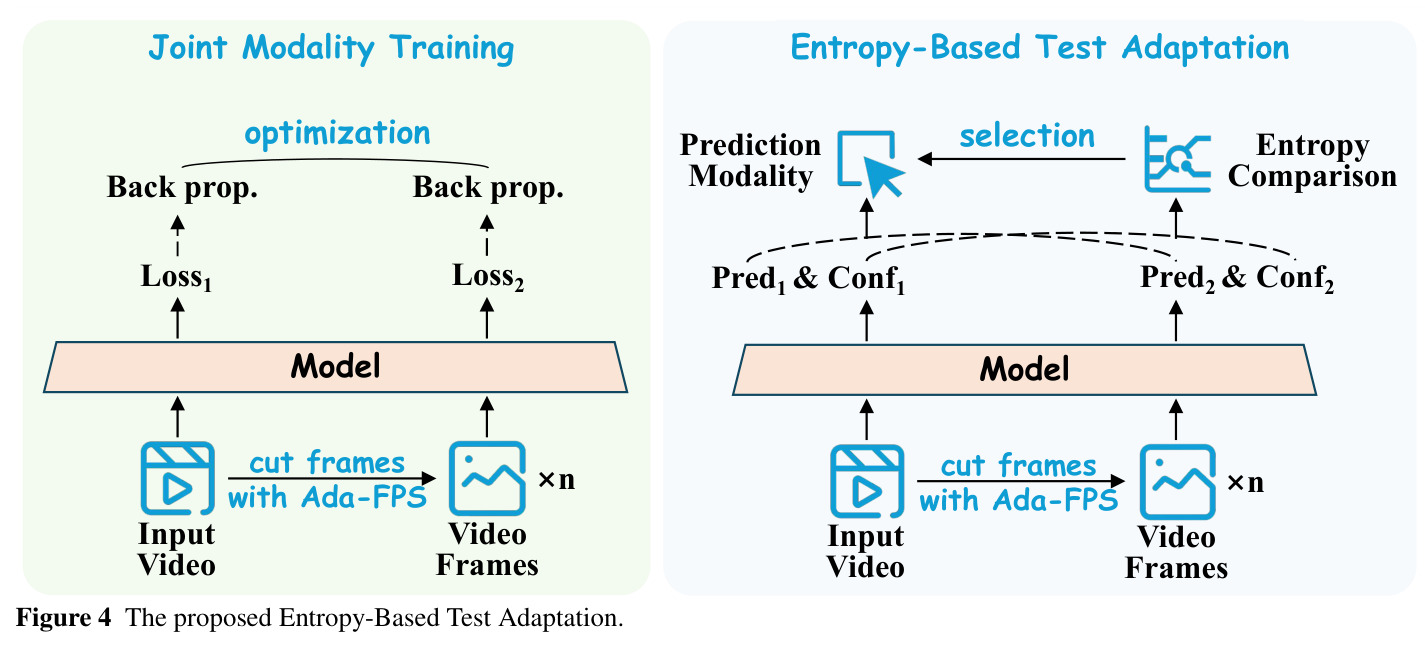
Modality Synergism 的推理端用 $H_m=-c_m\log c_m-(1-c_m)\log(1-c_m)$ 分别计算视频模态与帧模态预测的熵,选择熵更小(更确定)的一方作为最终输出,这是全文免训练逐样本路由规则的核心公式。
AUC / balanced accuracy / HTER 三种评估指标
AUC 是 ROC 曲线下面积,与判定阈值无关;balanced accuracy(bACC)$=(TPR+TNR)/2$,对类别不平衡鲁棒;HTER $=(FPR+FNR)/2$,越低越好。只看 accuracy 可能被"把所有样本判成多数类"的策略刷高,而 HTER 和 bACC 会暴露这种偏斜。
论文 53 个检测基准分域使用这三种指标(DeepFake/自然图像用 AUC,AIGC/文档/物理/视频用 accuracy 或 bACC),作者还专门用 HTER 与 accuracy 的差距论证自己的判定在真/伪两类间是平衡的,而多数基线存在系统性偏斜。
研究动机
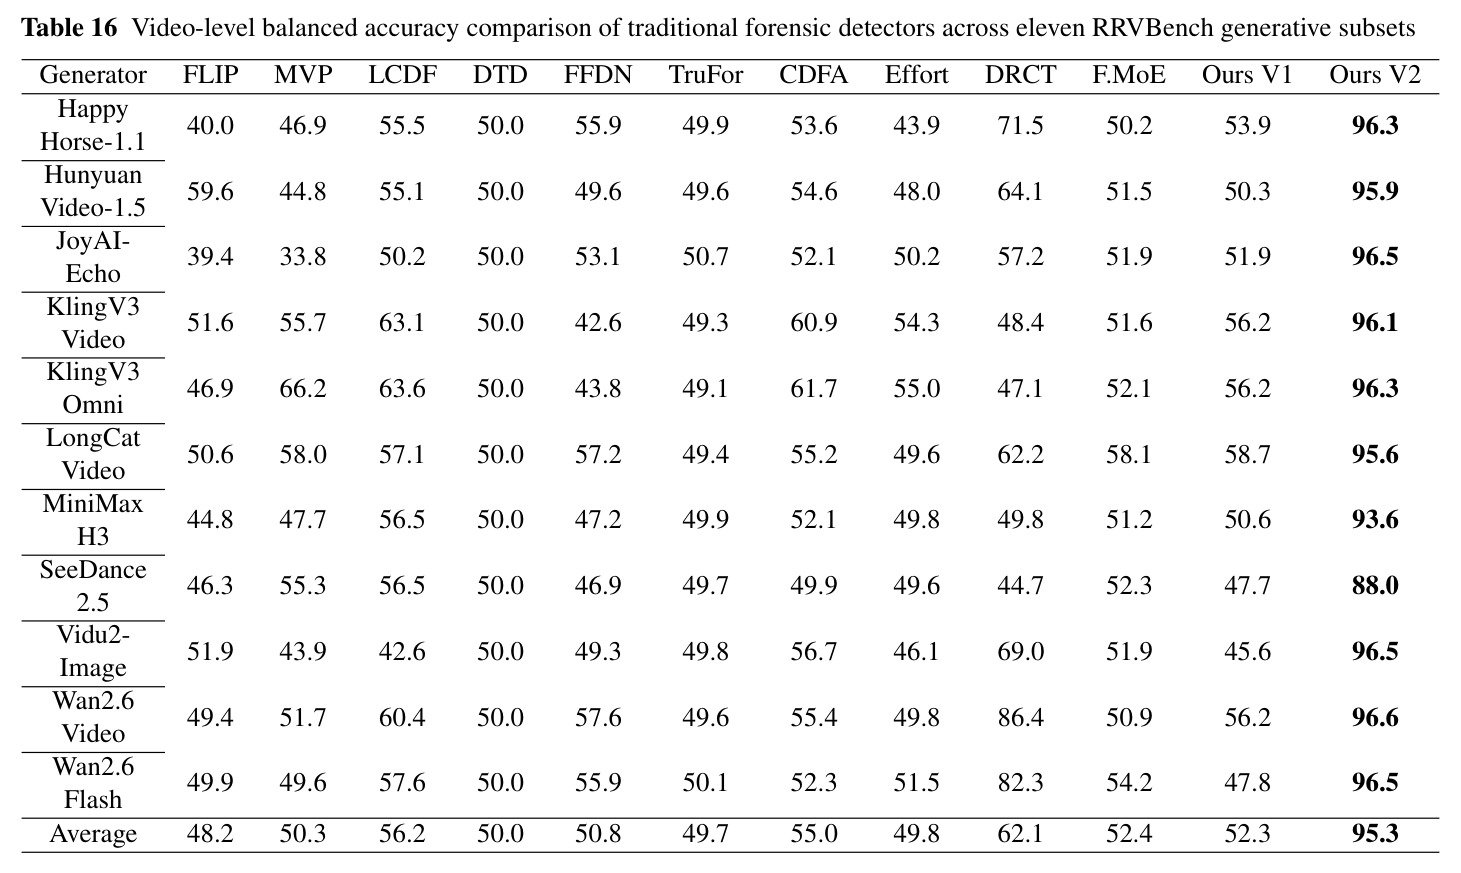
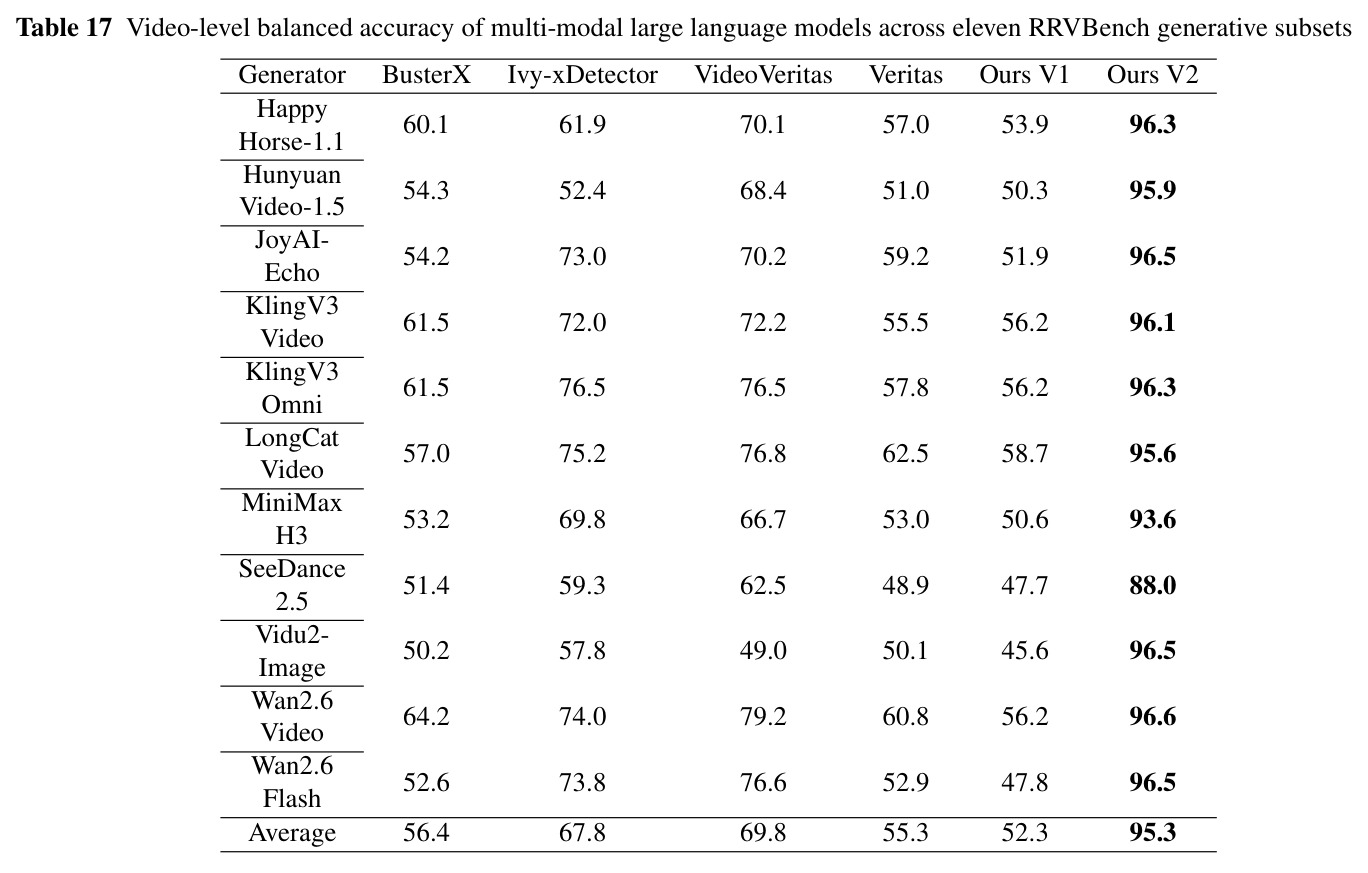
现实世界的伪造天然是异质的:既包括像素/潜空间的数字操作——拼接、inpainting、AI 生成图像、DeepFake 换脸,也包括物理形式的欺骗——面具/打印照片/屏幕重放等人脸展示攻击与证件打印-翻拍、屏幕翻拍攻击;载体既可以是静态图像,也可以是证据散布在时空动态中的视频。而现有研究高度碎片化:数字图像取证、人脸防伪、文档欺诈、视频取证四个社区各自维护独立的基准、假设与模型设计,绝大多数检测器只针对单一操作类型、固定媒体格式或狭窄采集场景设计,跨分布泛化差。定量来看,上一代 DefakerOne 虽统一了多场景数字图像检测,但能力边界止步于此:物理伪造仅 50.7 分(比最强专用模型 Effort 的 67.6 低 16.9),三个视频域分别只有 69.9/50.7/52.3;RRVBench 上 10 个传统检测器中 9 个落在 48.2–56.2 的随机水平(DTD 恒为 50.0、TruFor 波动不足 2 个点),即便 7B 参数的视频取证 MLLM VideoVeritas 也只有 69.8。一个实用的反伪造系统必须应对 {数字, 物理}×{图像, 视频} 的完整矩阵,而此前没有一个模型做到。
本文的目标是本文的目标是训练第一个同时覆盖数字与物理伪造、图像与视频两种载体的视觉取证基础模型 Venus-DefakerOne2:用单一 2B 参数的 MLLM 输出图像/视频级的二值真伪判定(附置信度)与像素级篡改定位掩码,并在 53 个检测基准与 14 个定位基准上做到全面领先(分别 40/53 与 11/14 个基准第一,8 个域全部第一),且"从不在任何域专家自己的主场输给它"。同时把这一目标落到可部署形态:单次训练覆盖全部威胁类型,推理时单 token 判定保证效率与置信度稳定性,视频自动选择更有把握的输入模态,定位掩码与全局判定相互校准。为此必须具体解决三件事:约 50M 异质语料下朴素全参数训练的算力成本;样本难度极不均衡(显眼伪影几步就拟合、微弱痕迹一遍学不会)导致的"要么浪费容量、要么灾难性遗忘";以及视频伪造证据逐样本在空间纹理与时间动态之间摆动、固定输入模态必然次优的模态困境。
与已有工作不同的是,本文的独特之处不在于发明新的检测算子,而在于重新组织"统一"的三个层面。第一,在训练调度层面,作者不把 LoRA 与全参数微调当二选一,而是把"可训练参数预算"当作像潮汐一样涨落的调度对象,并以强度递增的对抗噪声同步抑制对简单样本的记忆——消融证明仅凭容量释放顺序不同就能带来相对误差 25–39% 的下降。第二,在推理层面,作者把视频取证的模态选择从"训练前的人为先验"改写为"逐样本的测试时决策":联合双模态训练保证两条通路都可用,再用预测分布的 Shannon 熵免训练路由,无需任何可学习路由模块。第三,在数据与评测层面,用 Creative Proposer++ 让 MLLM 反向描述真实媒体再交给生成器合成,从构造上保证真假样本语义对齐、堵死内容捷径;并交付 RRVBench(1,319 条真实视频 + 11 个 2026 年最新闭源/开源生成器产出的 11,000 条假视频,覆盖军事、政治、公共卫生等谣言场景)弥补公开视频基准生成器过旧的空档。三个层面共同指向"一个模型、全部威胁、一次训练"。
核心方法
先说直觉:作者相信各类伪造存在共享的底层取证特征,值得用一个大模型一次学会。技术路线分四块。(1)架构:以原生多模态的 Qwen3.5-2B 为骨架,用固定提示词引导模型单 token 输出 Real/Fake 及置信度;另配取证专用的 Anomaly Magnifier(DINOMAC:DINOv3-Large 加 LoRA 并经取证策略微调)作为辅助像素级编码器,两者特征经卷积 mask decoder 输出篡改掩码,并通过校准环与全局判定耦合。(2)训练调度:Tide-Style Tuning 三阶段交替——LoRA 热身(15M 数据+轻噪声)→ 全参数微调(40M+中噪声)→ 新/难样本 LoRA(40M+重噪声),噪声为强度递增的 DINOMAC 对抗噪声。(3)视频:Modality Synergism 在优化端让每个视频同时以原生片段与 Ada-FPS 抽帧两种形式输入、各算交叉熵损失 $\mathcal{L}=\ell(p_{vid},y)+\ell(p_{img},y)$,推理端用熵路由选更确定的模态。(4)数据:约 50M 样本覆盖 9 个取证域,由公开数据、Creative Proposer++ 自合成数据与人工标注线上攻击样本构成,并有 agent 驱动的坏例-合成-再训练闭环。全程使用 320 张 NVIDIA A100。
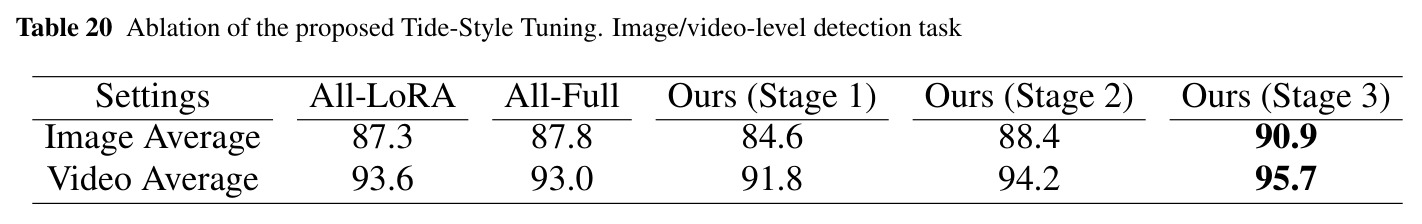
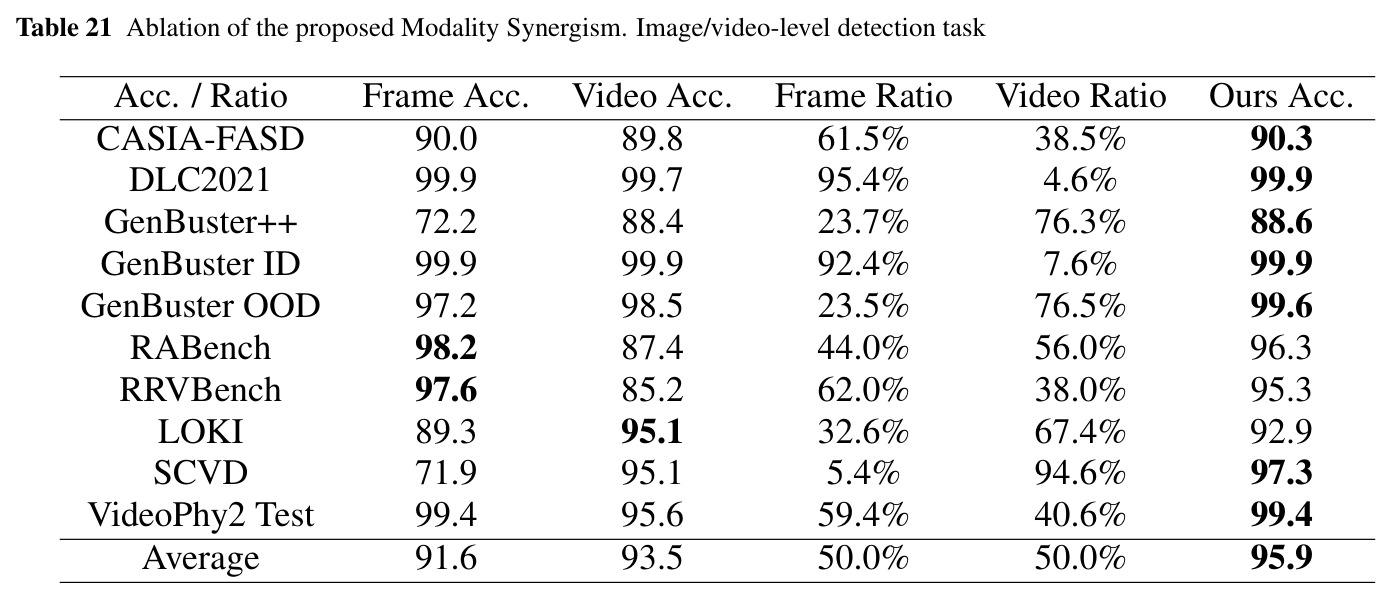
核心创新有三处。其一,Tide-Style Tuning 证明微调的关键不是参数预算的大小而是释放顺序:全程 LoRA(图像 87.3/视频 93.6)与全程全参数(87.8/93.0)总体打平且各有更弱的一侧——参数受限保住预训练知识却吃不下 50M 数据,全量释放拟合力强却易灾难性遗忘;潮汐调度先 LoRA 热身,合并后全参数释放容量,最后回到新 LoRA 以受限预算作隐式正则聚焦难样本,最终 90.9/95.7 全面超越两个静态基线。其二,Modality Synergism 把模态选择推迟到推理时:训练端双模态各自算损失迫使共享骨架同时内化空间与时间证据,测试端以 $H_m=-c_m\log c_m-(1-c_m)\log(1-c_m)$ 比较两模态预测的熵、取熵小者免训练地逐样本路由,且在四个基准上"超可加"(SCVD 从 71.9/95.1 升到 97.3),证明选择发生在样本级。其三,校准环用 $\tau(p)=0.75-p/2$ 让分割阈值随全局判定 $p$ 平移,等价于 log-odds 空间上有界($\pm\log 3$)且反对称的偏置:$p\to1$ 时阈值降到 0.25 抢救弱弥散响应,$p\to0$ 时升到 0.75 抑制过分割,$p=0.5$ 时退化为固定阈值,先验只按全局证据强度注入。
方法步骤详情
流程分五步。第一步构建数据:汇总公开数据集、Creative Proposer++ 自合成数据(MLLM 对真实媒体写"复现级"描述再喂给 GPT-Image-2、SeeDance 2.5 等生成器,真假语义对齐)与人工标注线上攻击样本,共约 50M、9 个域,其中 AIGC 图像 16M、DeepFake 24.4M、文档篡改 3.3M、自然图像 3.7M、防伪图像约 1.4M、AIGC 视频 1.3M,另有人脸/文档防伪视频各约 2K。第二步 Adaptation Ebb:冻结骨干,挂 LoRA($r=64,\alpha=128$,batch 1280,lr $1\times10^{-4}\to0$),在 15M 数据+轻对抗噪声上热身。第三步 Full-Parameter Flood:合并 LoRA 后全参数微调 40M 数据(batch 640,lr $1\times10^{-5}\to0$),中等噪声。第四步 Hard-Sample Ebb:再冻结骨干、挂全新 LoRA 只训新收集与欠拟合的难样本(40M,重噪声),即最终模型;AM 与 mask decoder 先在定位数据预训练 20 epoch 再端到端联合训练。视频全程按 Ada-FPS 处理:默认 1 FPS,帧数超上限降速、稀缺源提速(上限 10 FPS)。第五步推理:检测直接读单 token 概率;视频同时跑视频模态与"去头尾 10%、取中段 80%"抽帧的帧模态,取预测熵小者输出;可疑样本再由校准环 $\mathcal{M}_{cal}=\mathbb{1}[M>\tau(p)]$ 生成定位掩码。
技术新颖性
技术新颖性有六点。(1)覆盖面:首个同时覆盖 {数字, 物理}×{图像, 视频} 全矩阵的取证基础模型,把四个长期割裂的社区合入单一权重;此前 Omni-IML、ForensicHub 等统一尝试受限于学术级数据规模,DefakerOne 一代则完全不含物理与视频。(2)训练调度:"参数预算潮汐"是新的调度视角,消融证明相同参数预算、相同数据下仅凭释放顺序不同就带来 +3.1/+2.7 的差距,并配合光→中→重的渐进对抗噪声抑制对简单样本的记忆。(3)测试自适应:熵路由免训练、无路由模块;联合双损失保证两条通路各自可用是路由"超可加"的前提,这一耦合设计是新的。(4)校准环:全局-局部证据耦合写成有界、关于中性点反对称的 log-odds 偏置,数学性质明确且零参数。(5)数据工程:Creative Proposer++ 用 MLLM 反向描述真实媒体生成语义对齐的真假样本对,从数据层面堵死内容捷径;Agent 闭环把失败案例自动转成定向合成数据。(6)评测交付:RRVBench 用 7 个最新闭源与 4 个开源生成器构造 11,000 条谣言场景假视频,并以语义匹配策略消除真/伪语义分布差异的混淆。
实验结果
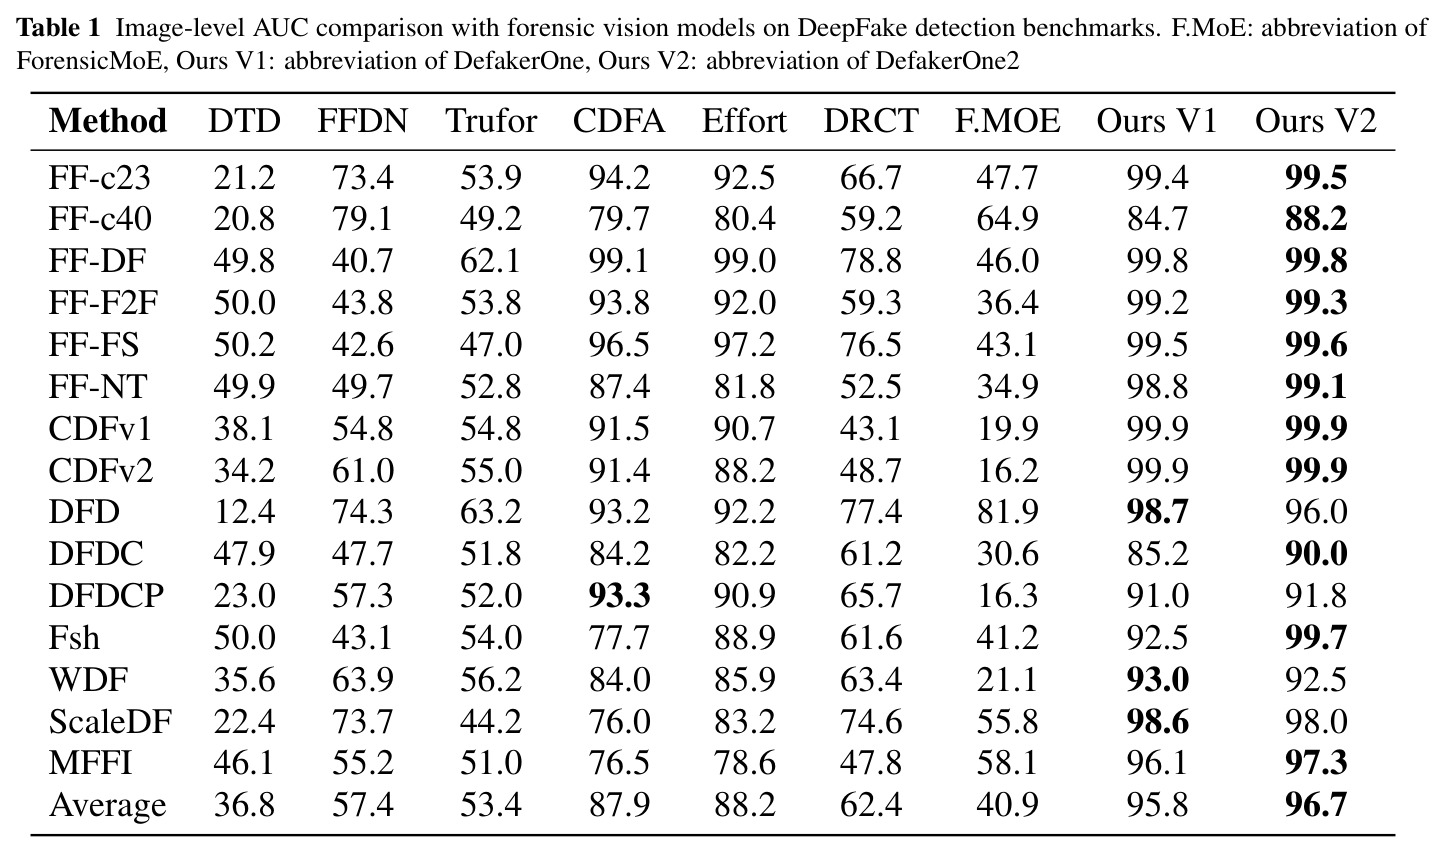
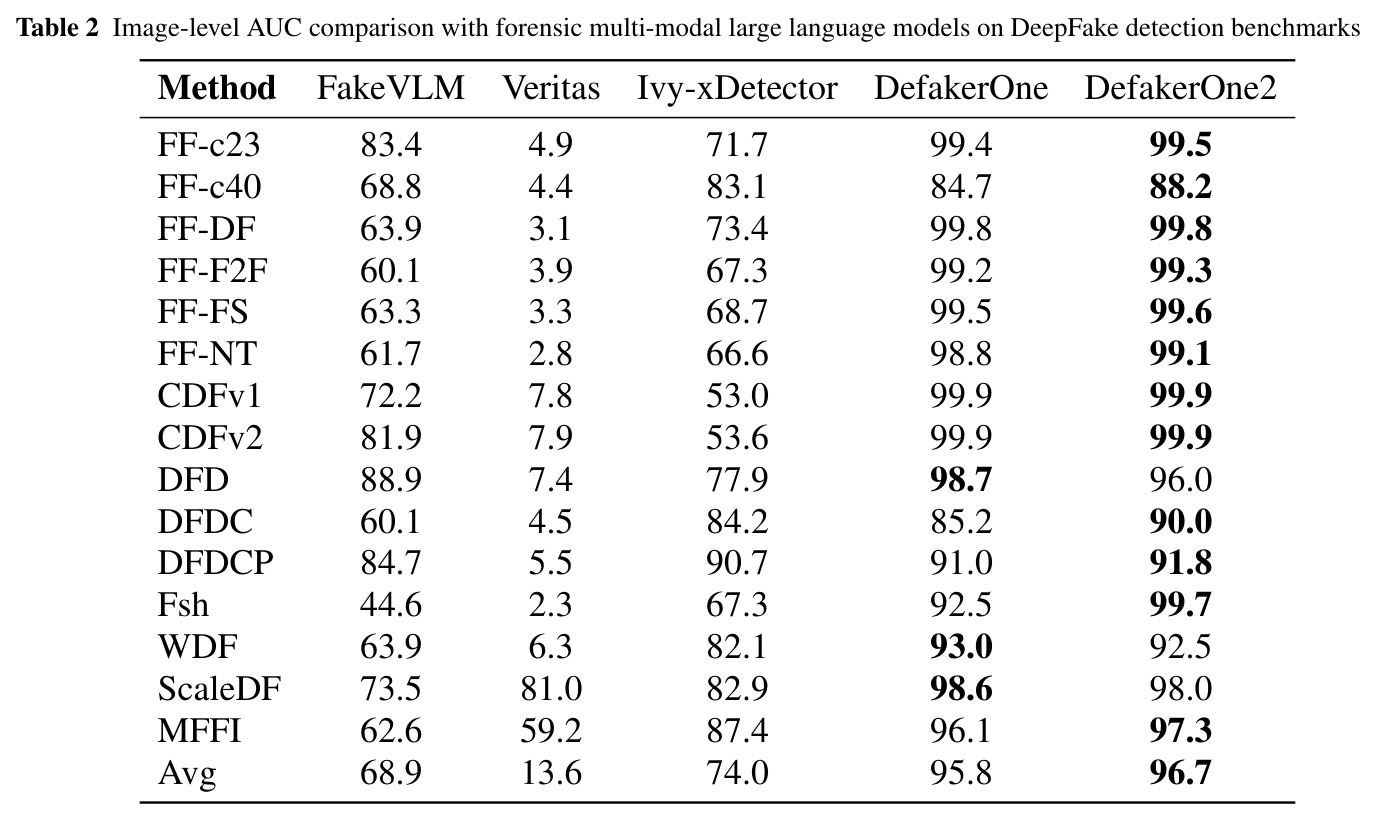
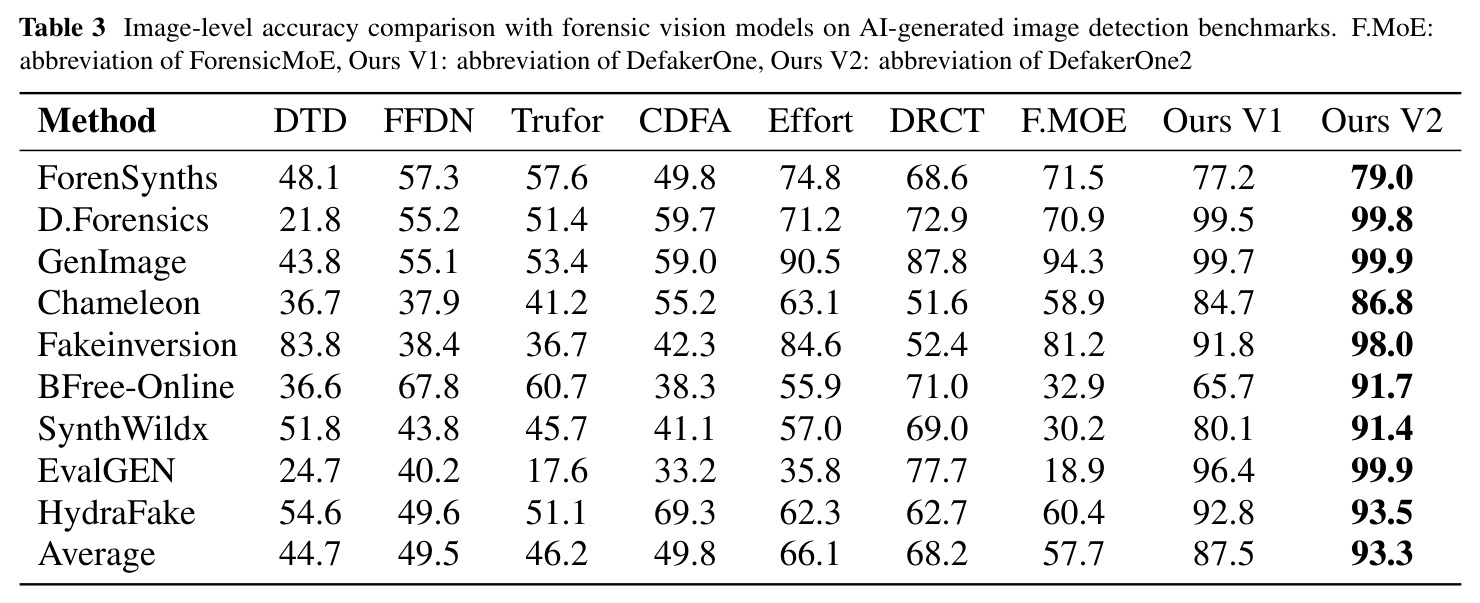
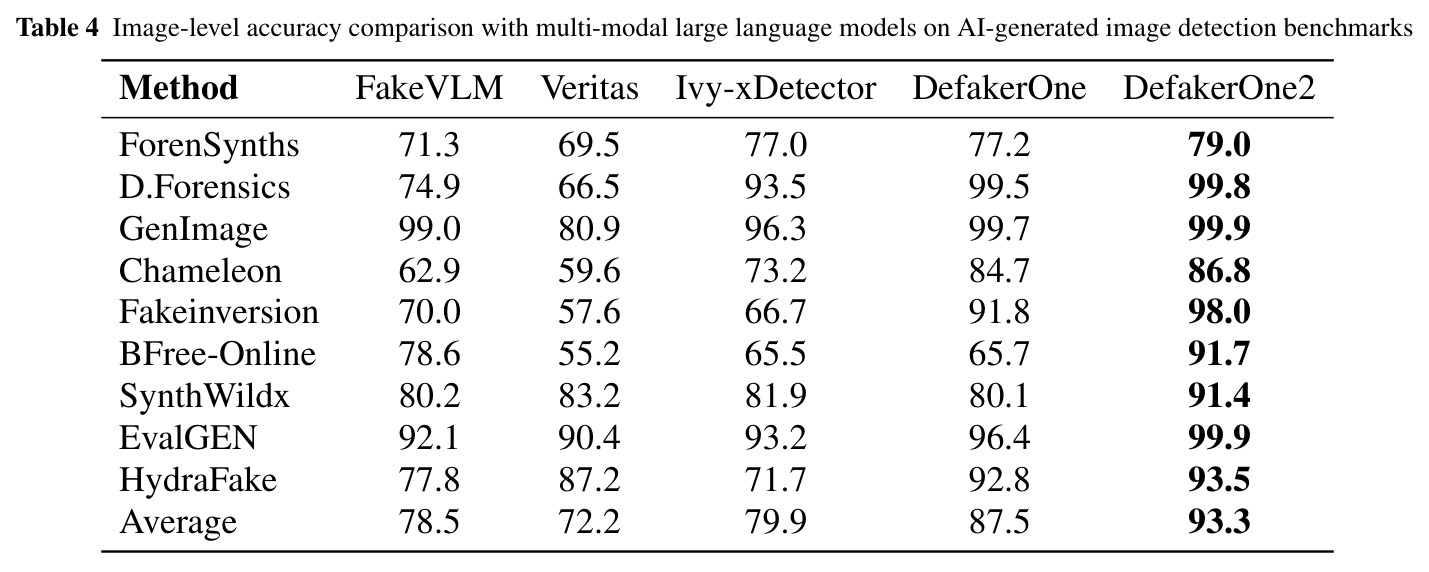
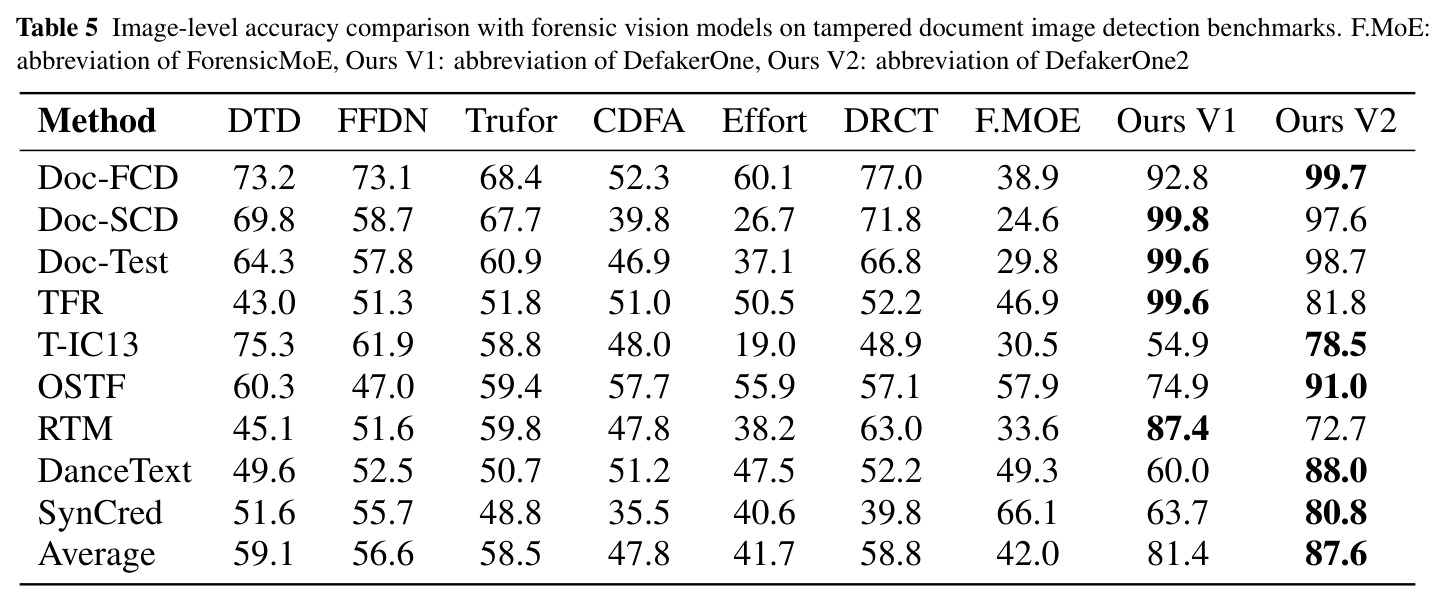
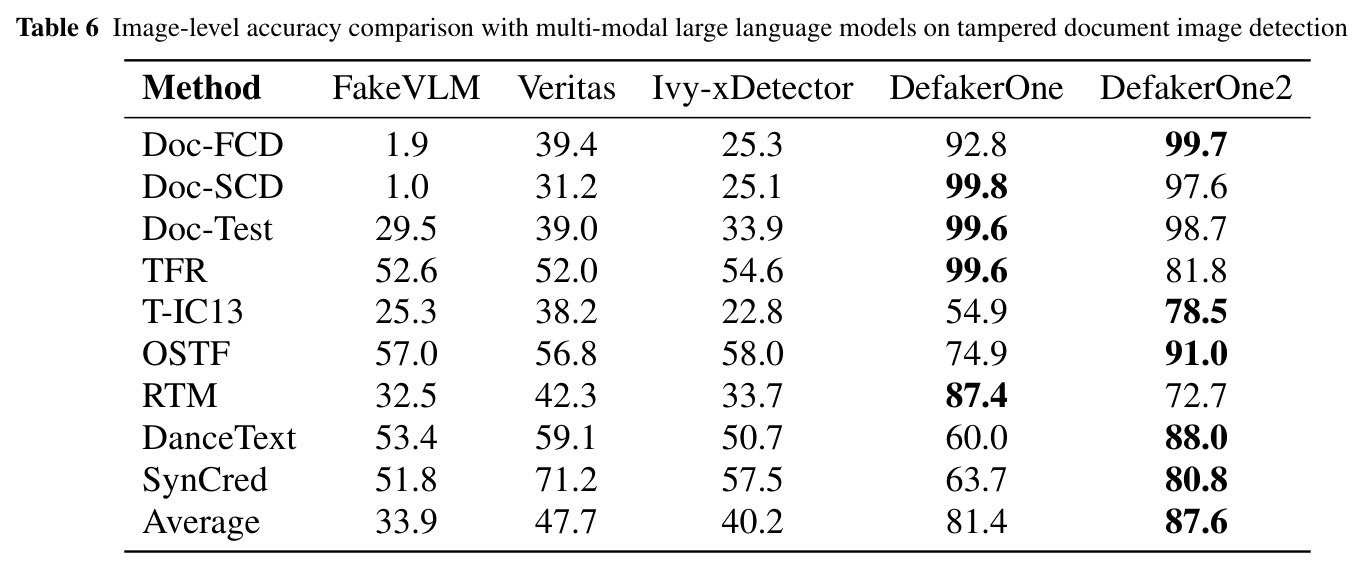
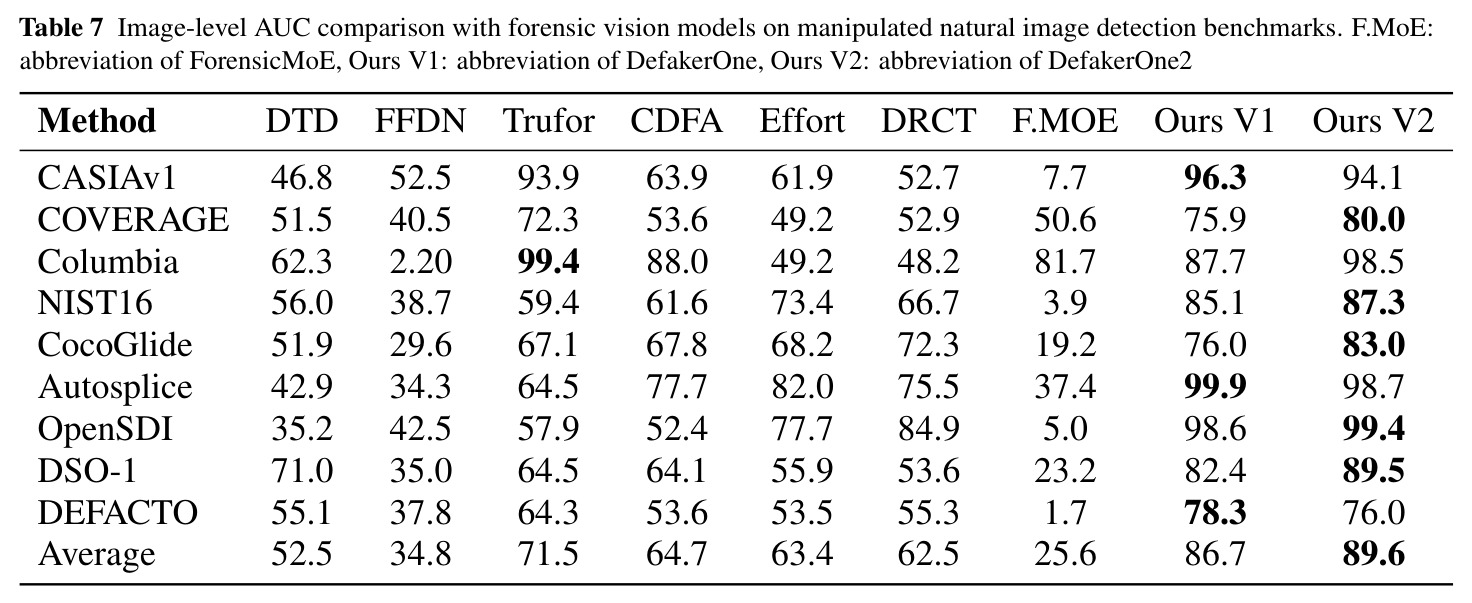
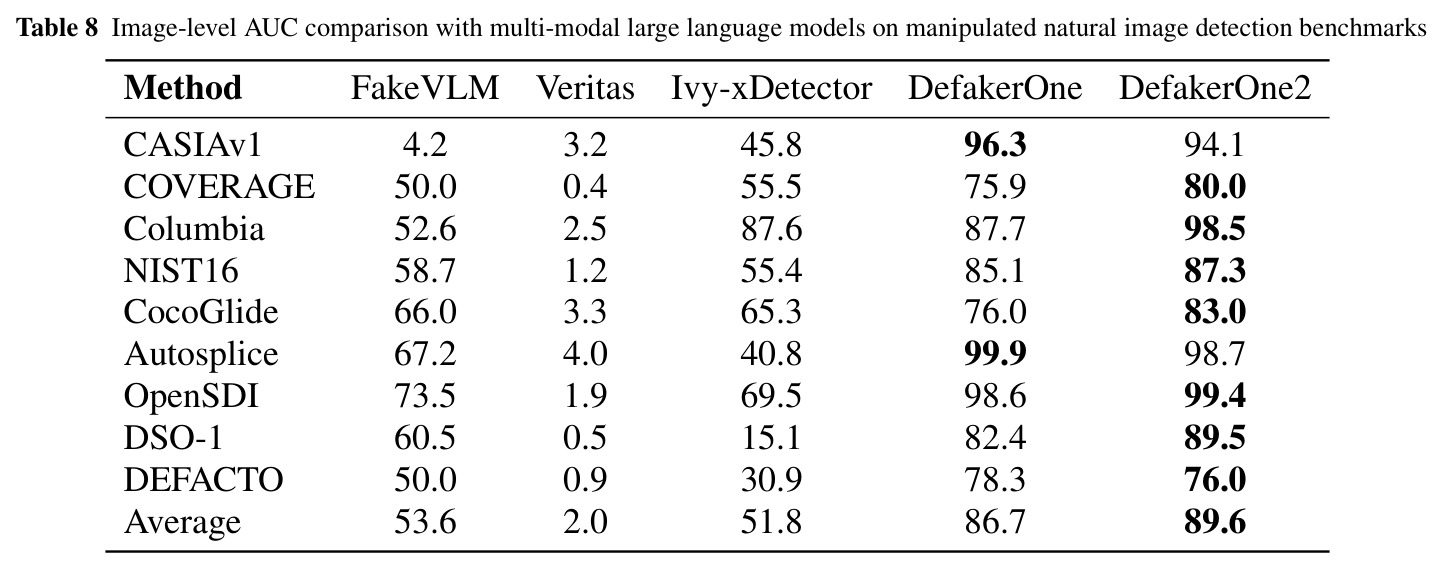
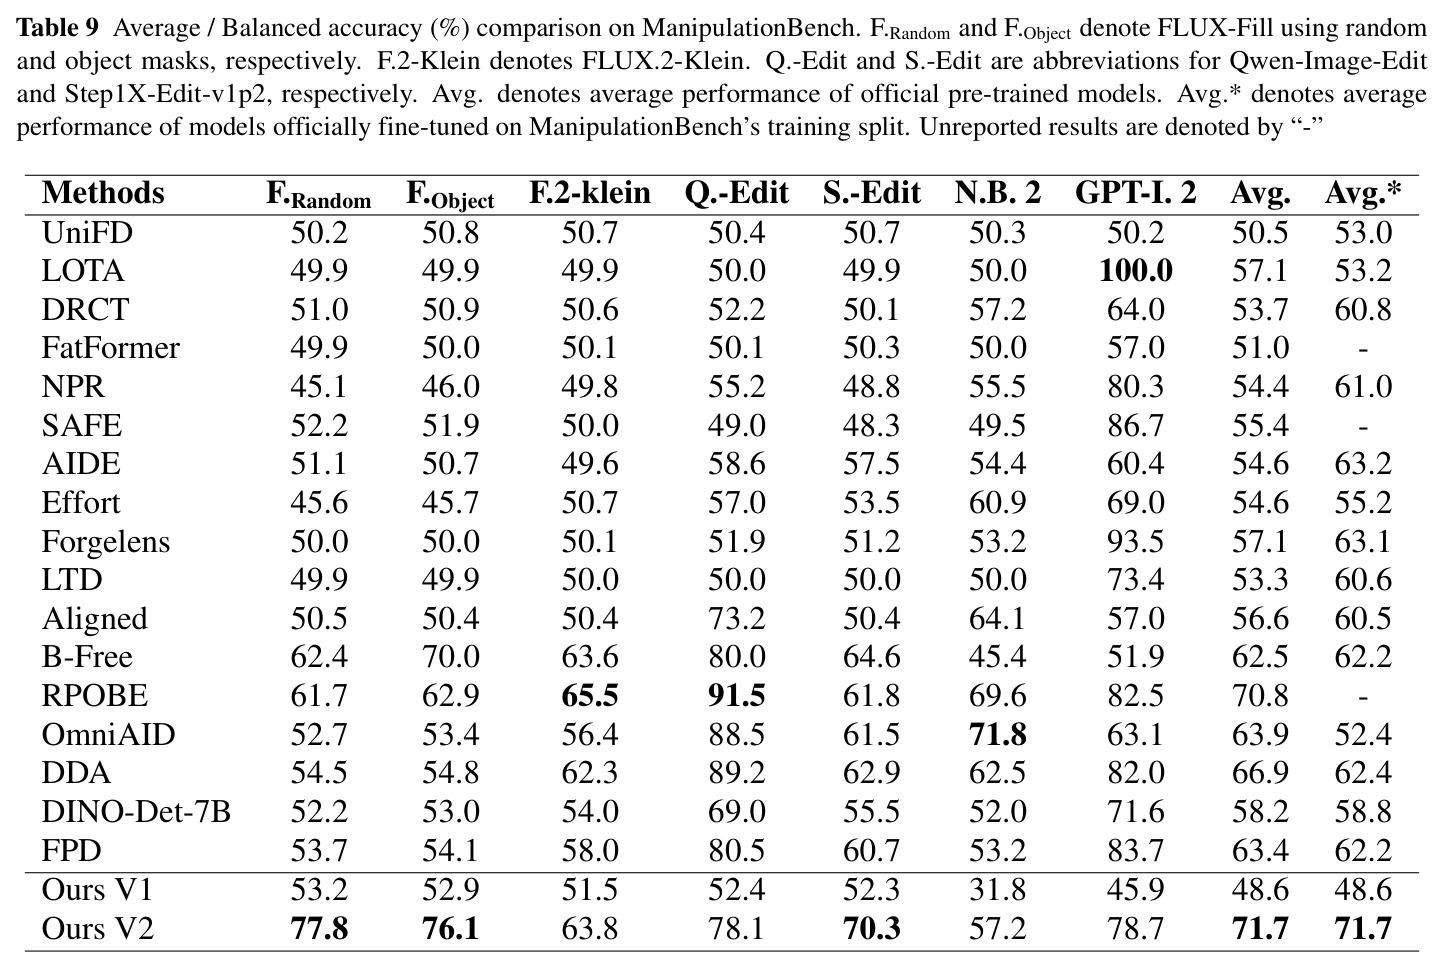
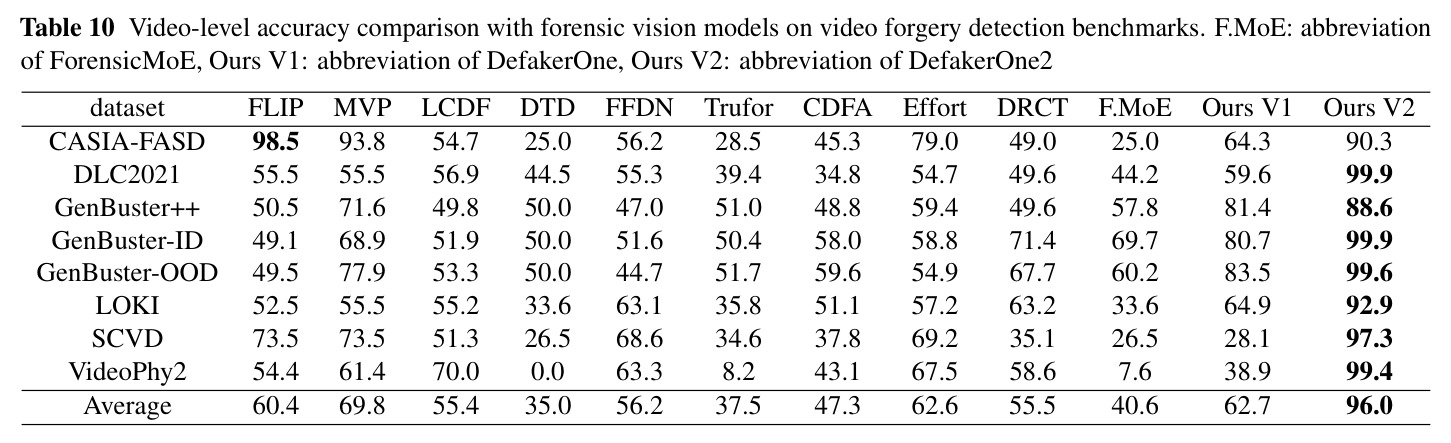
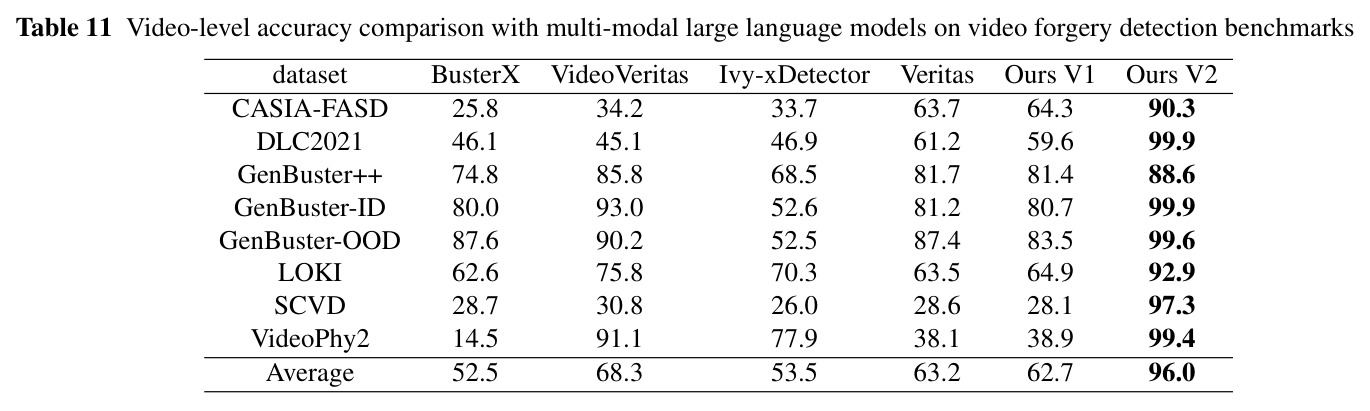
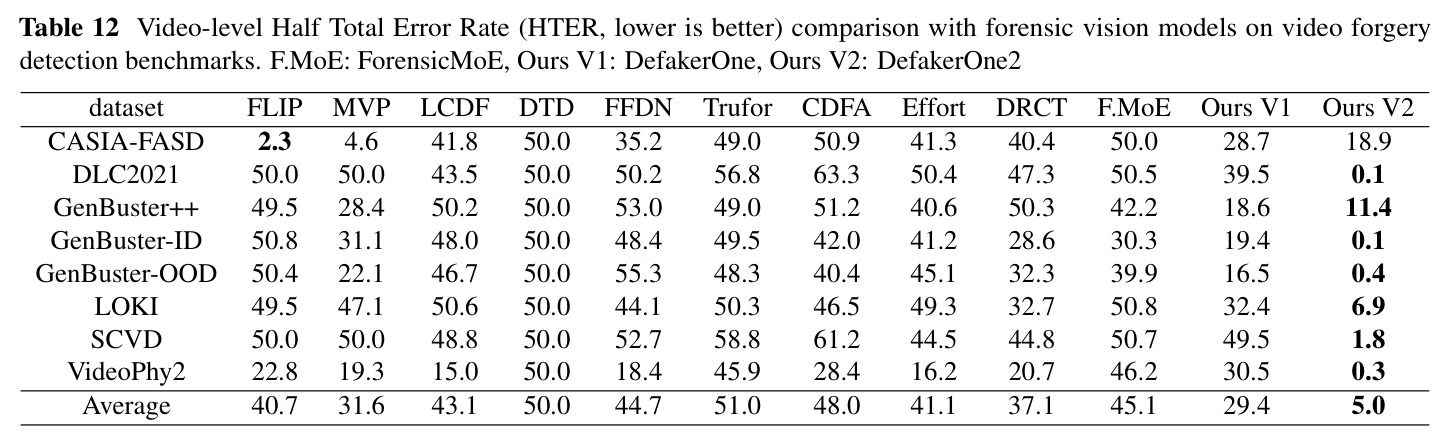
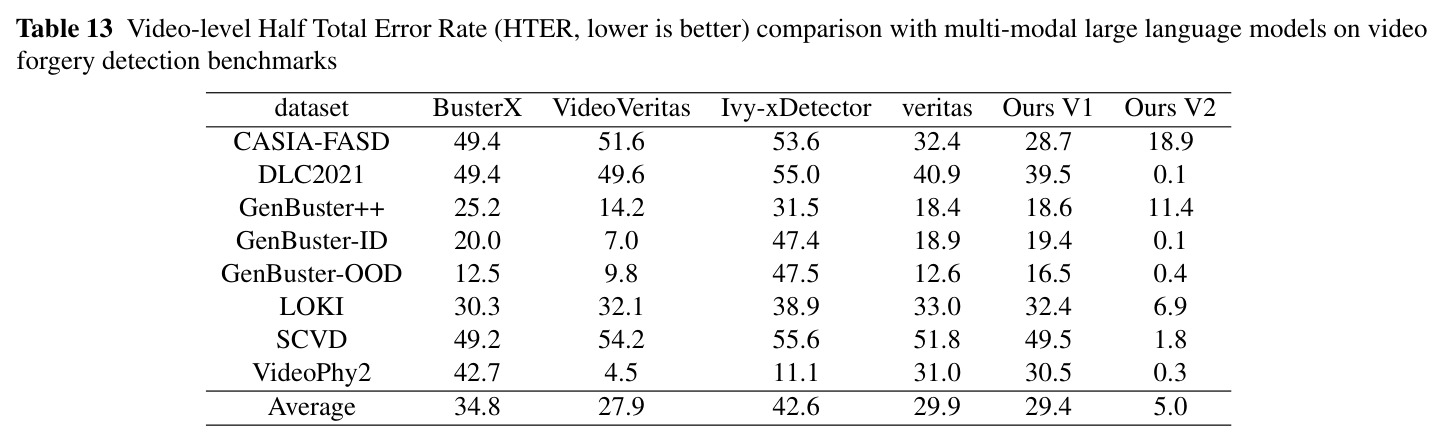
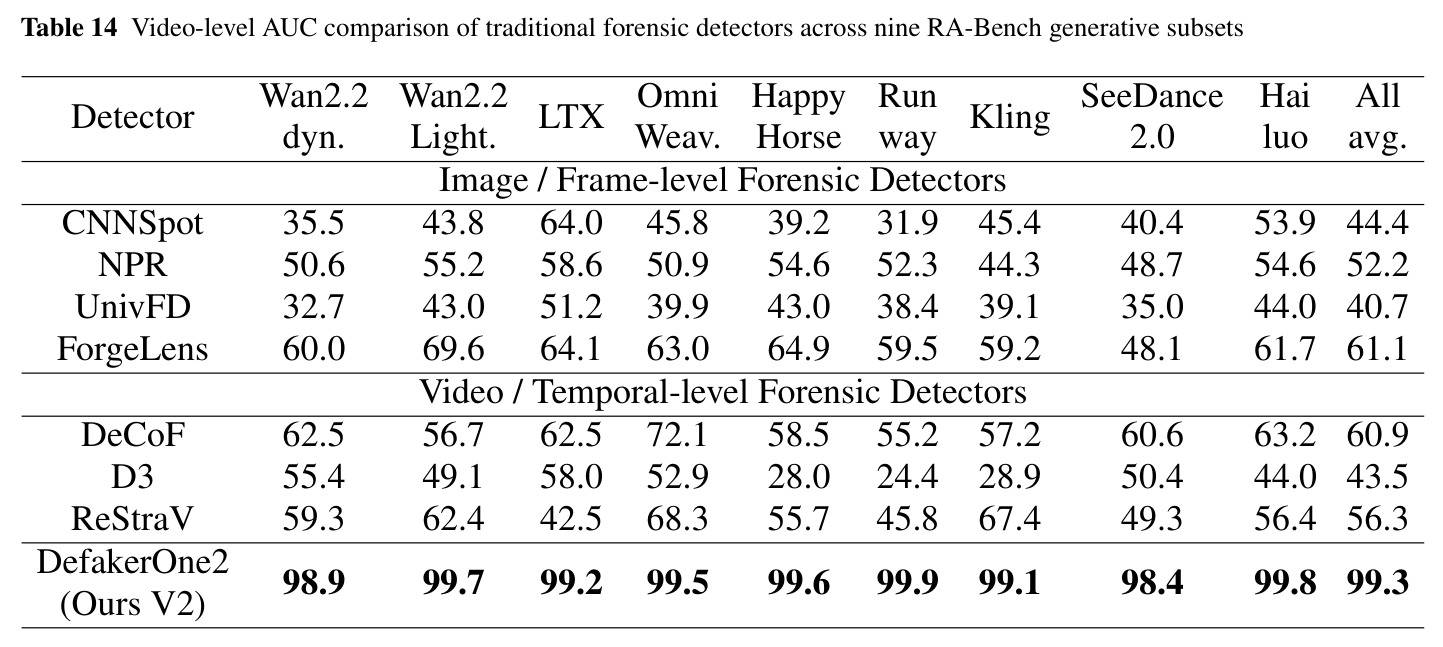
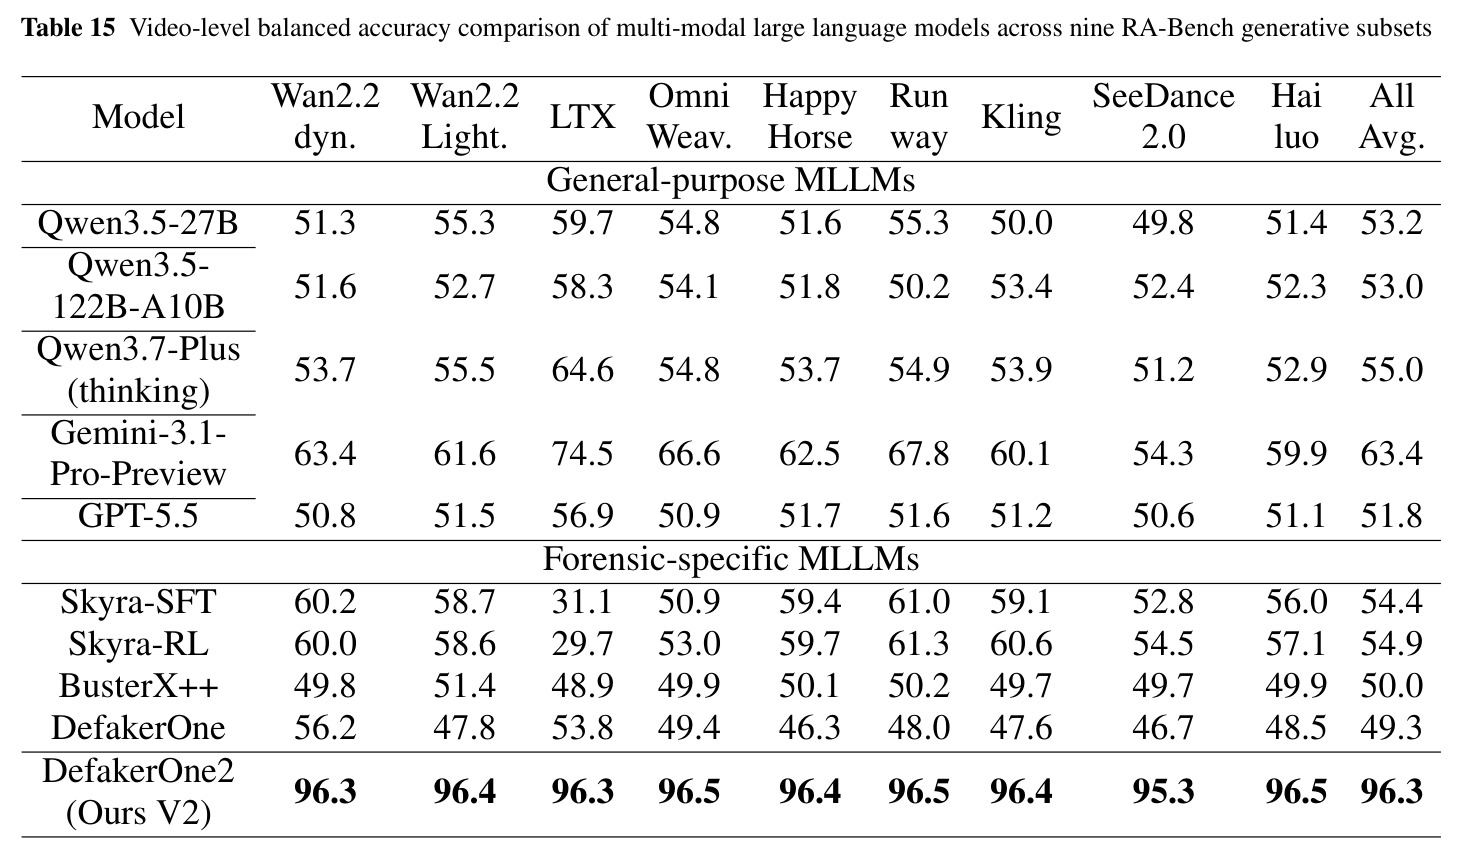
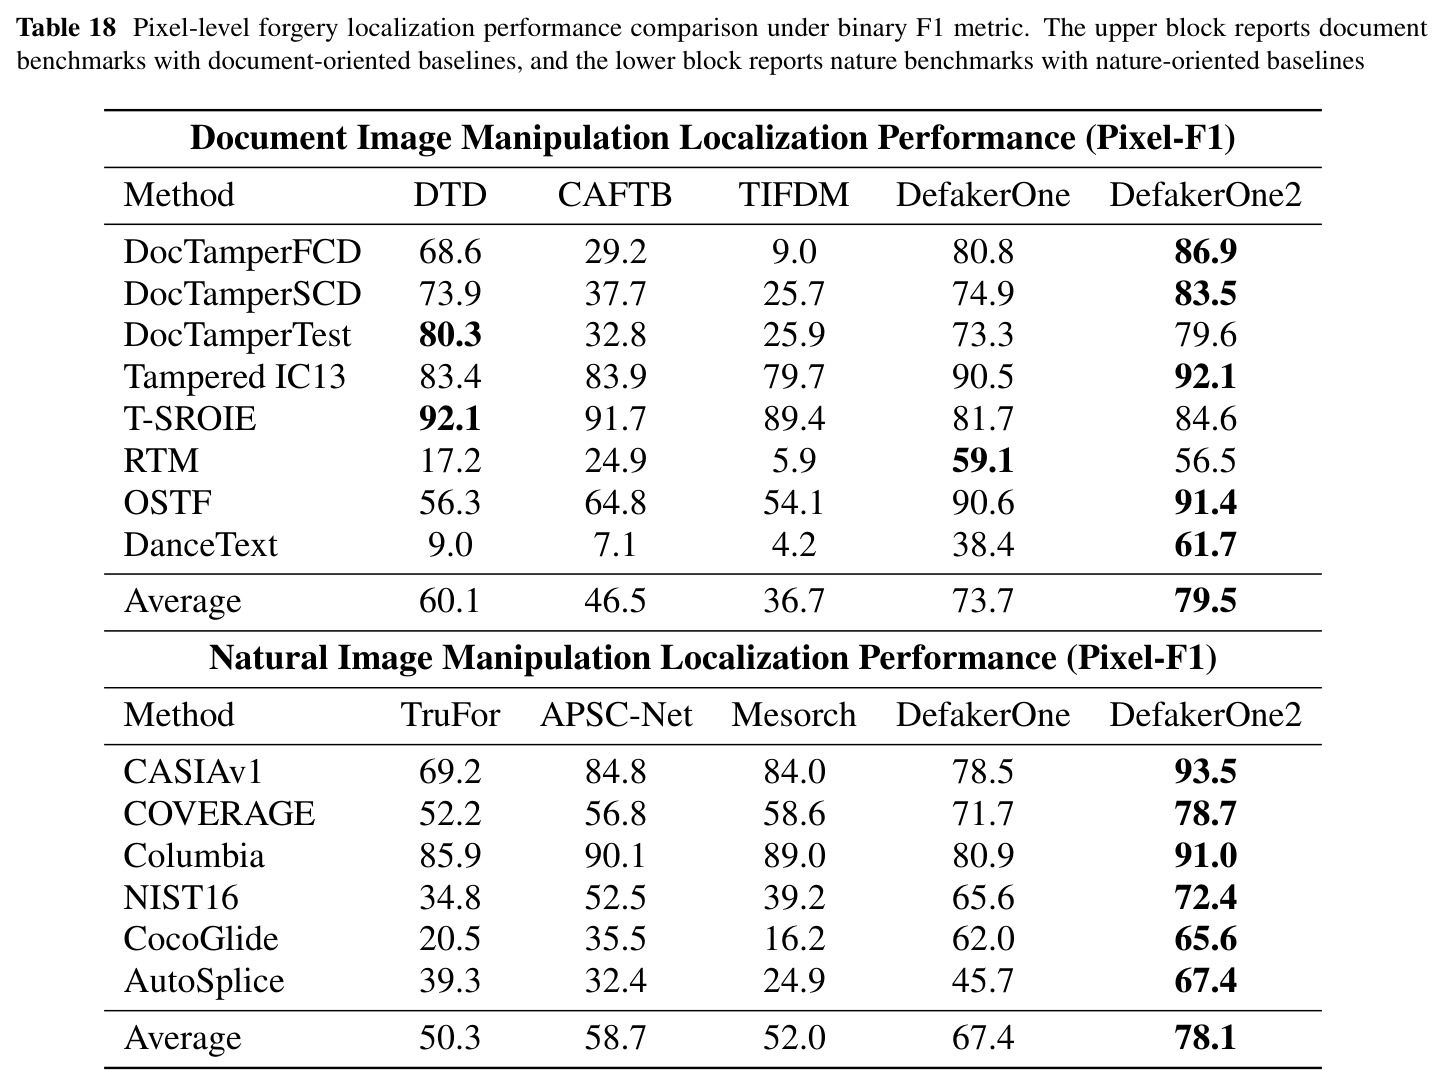
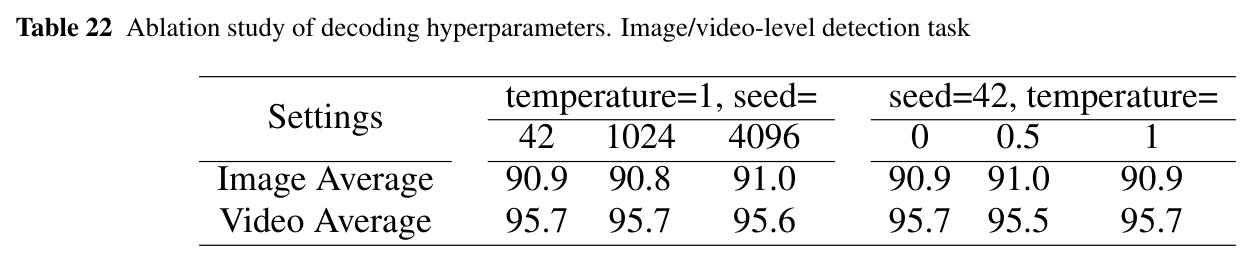
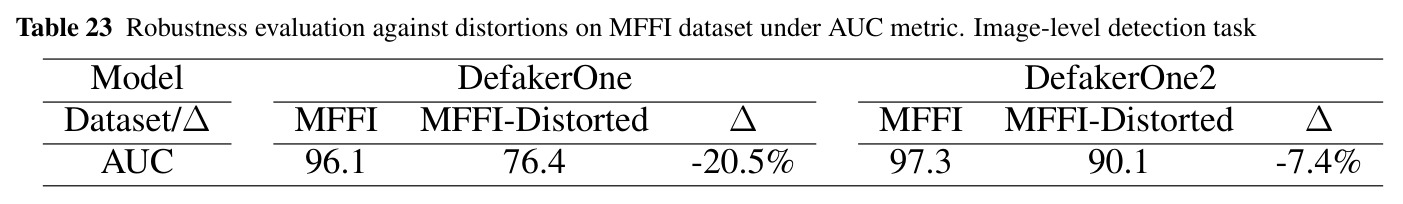
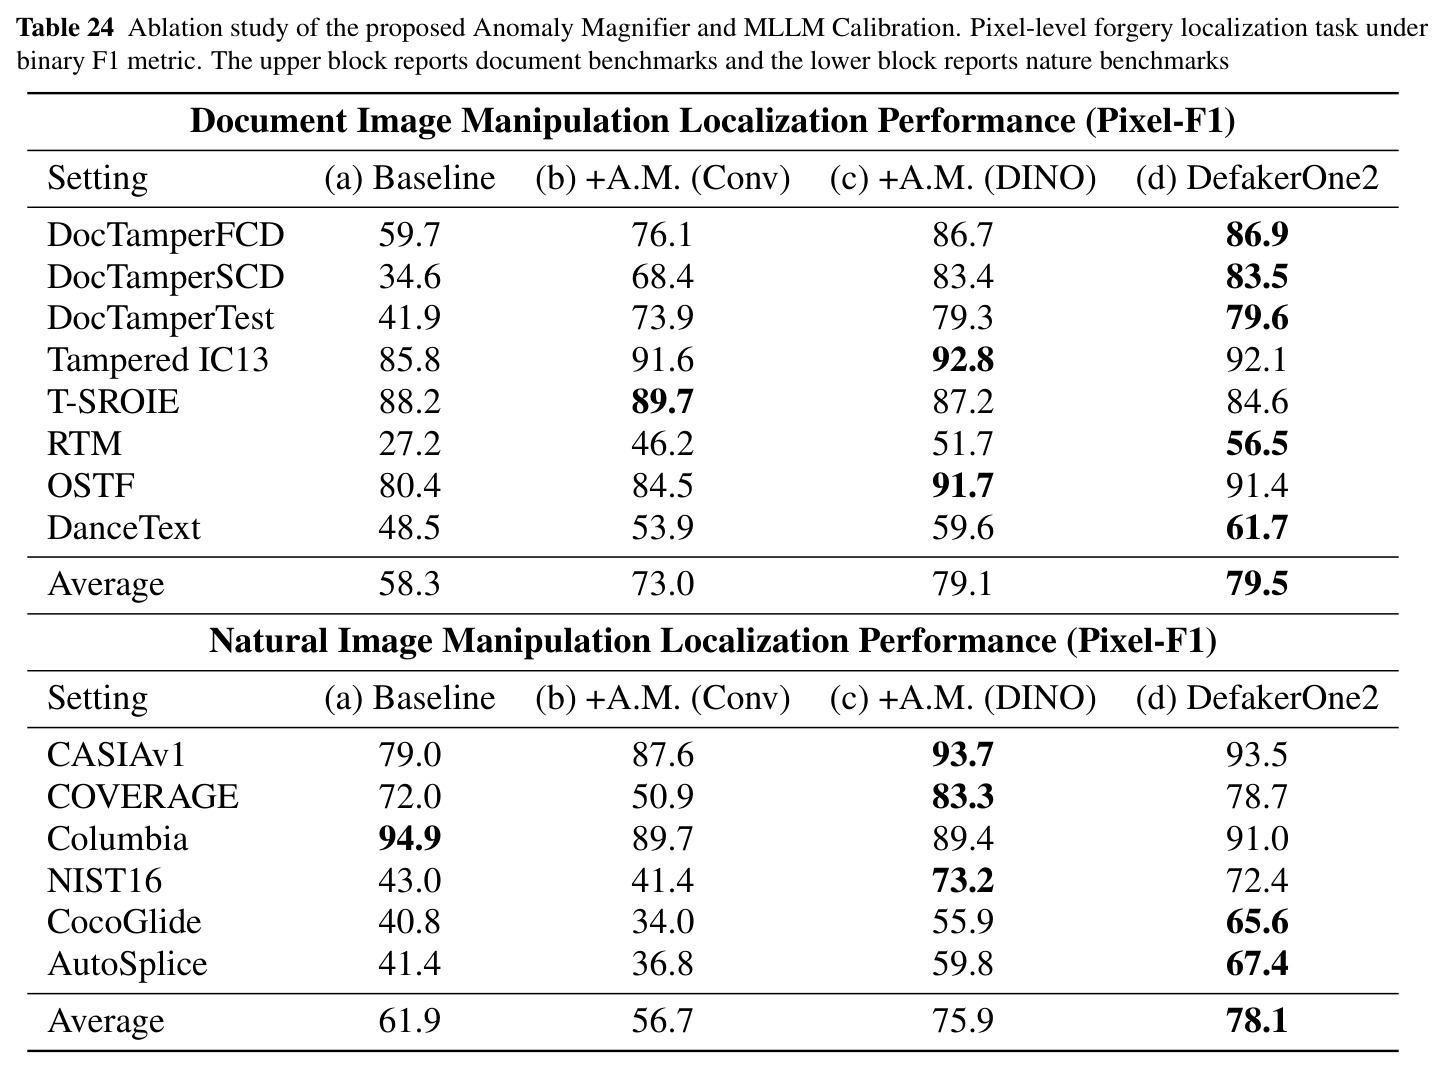
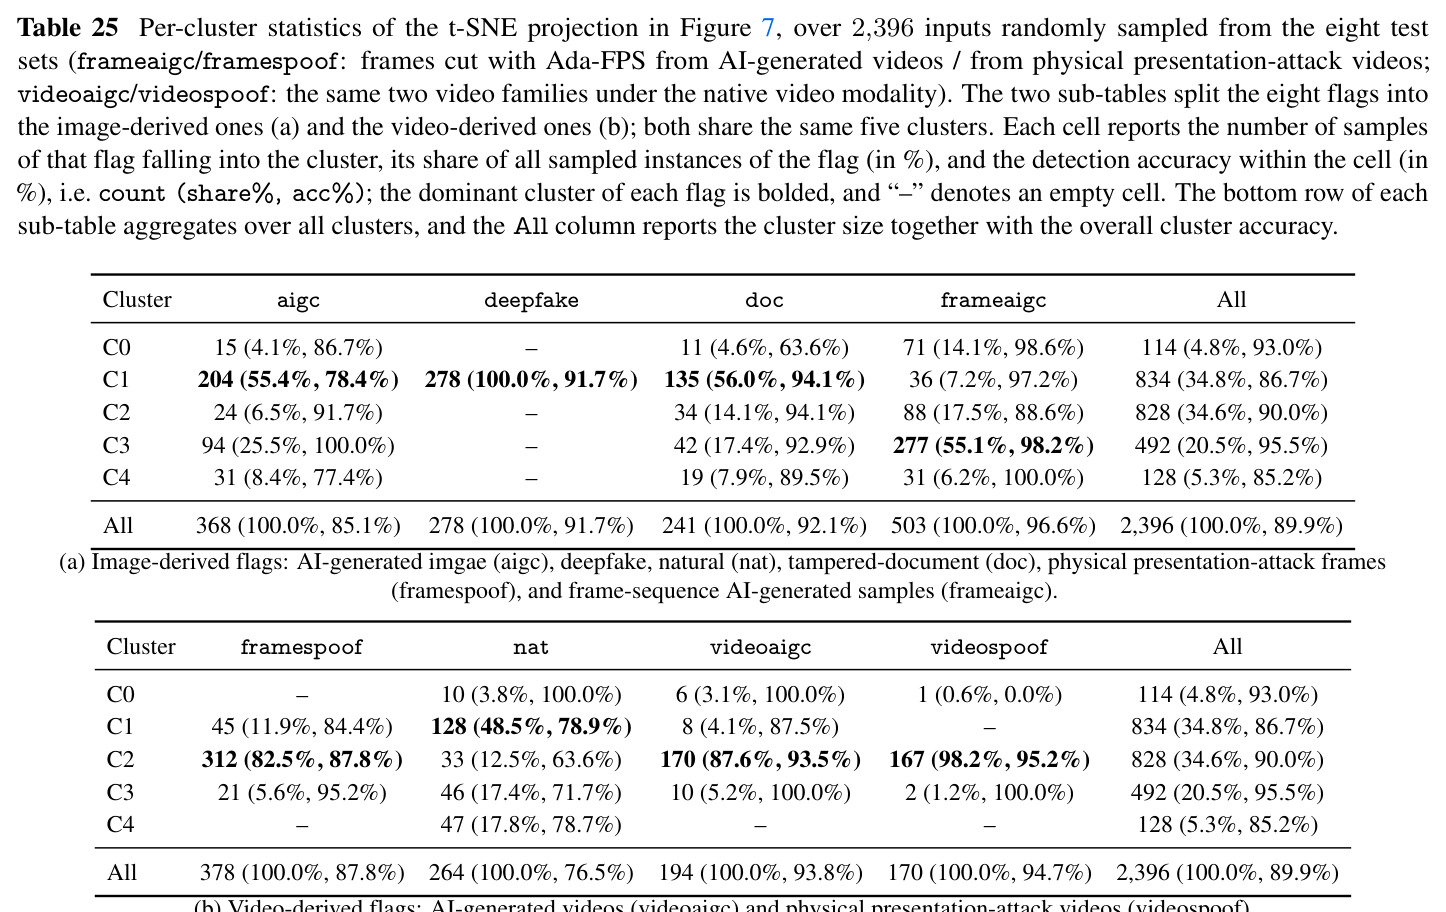
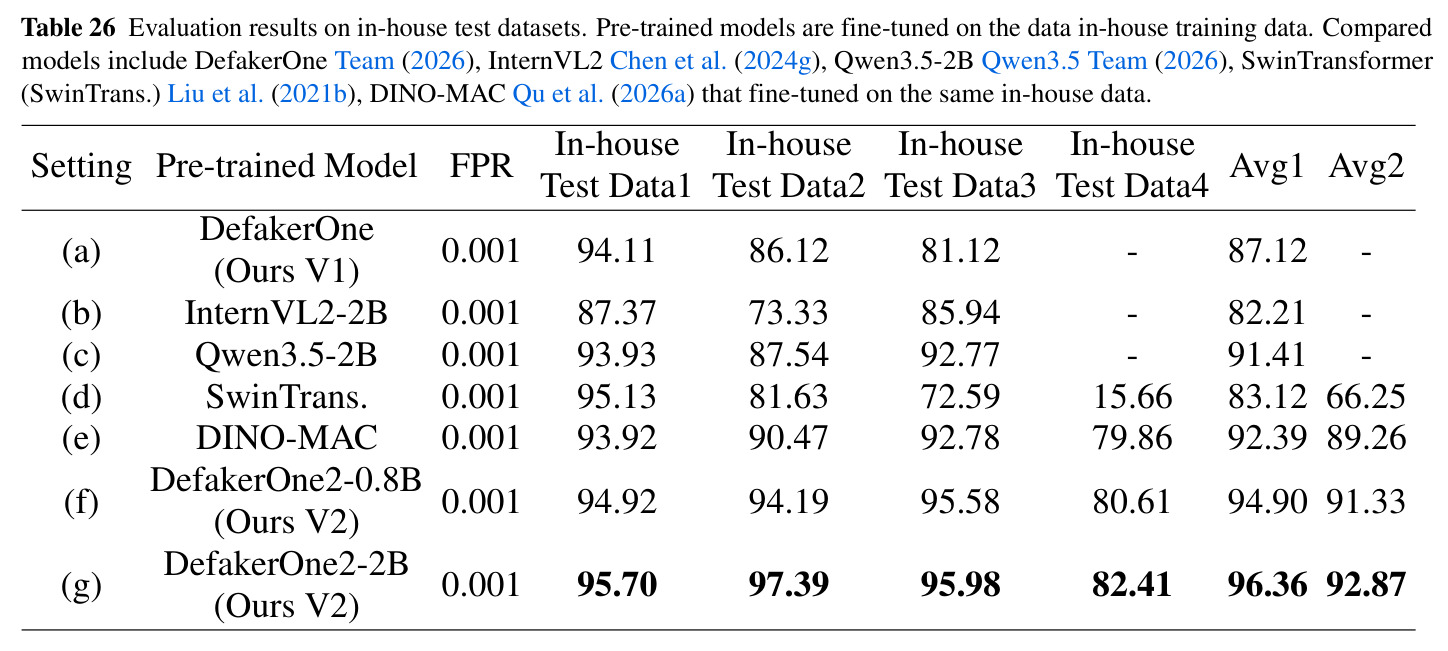
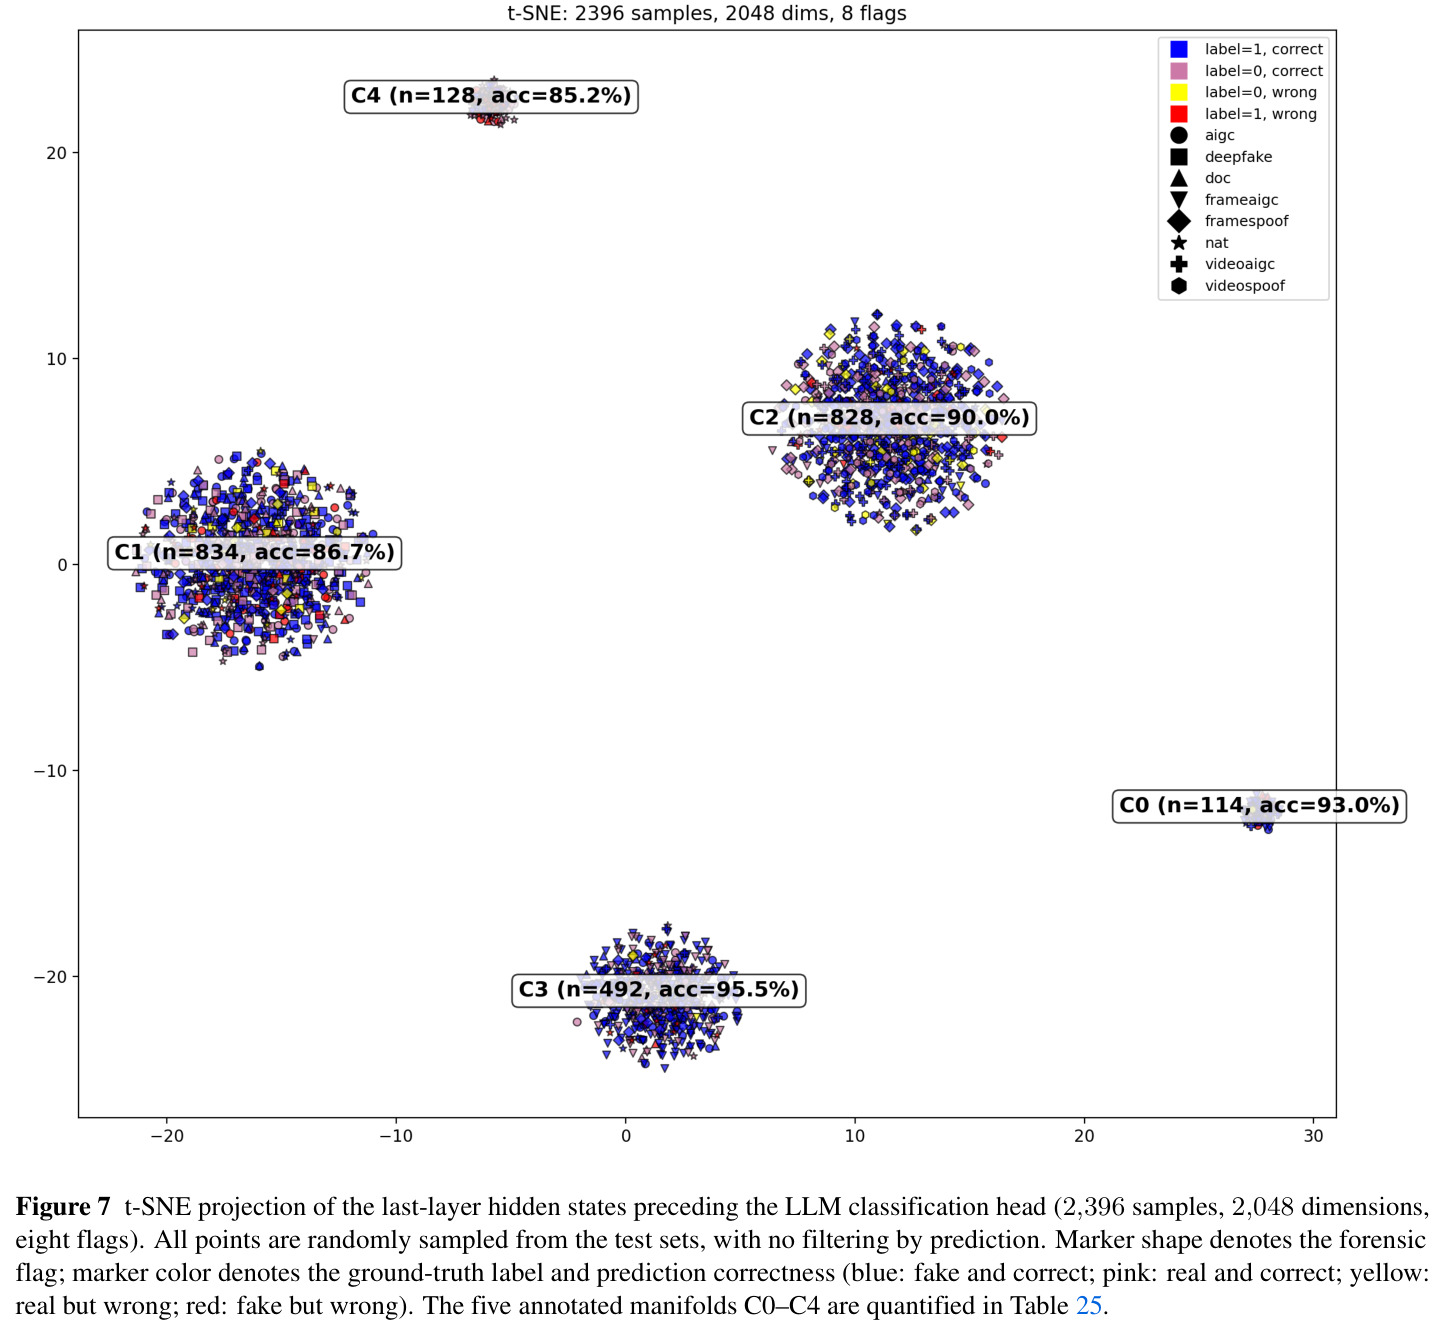
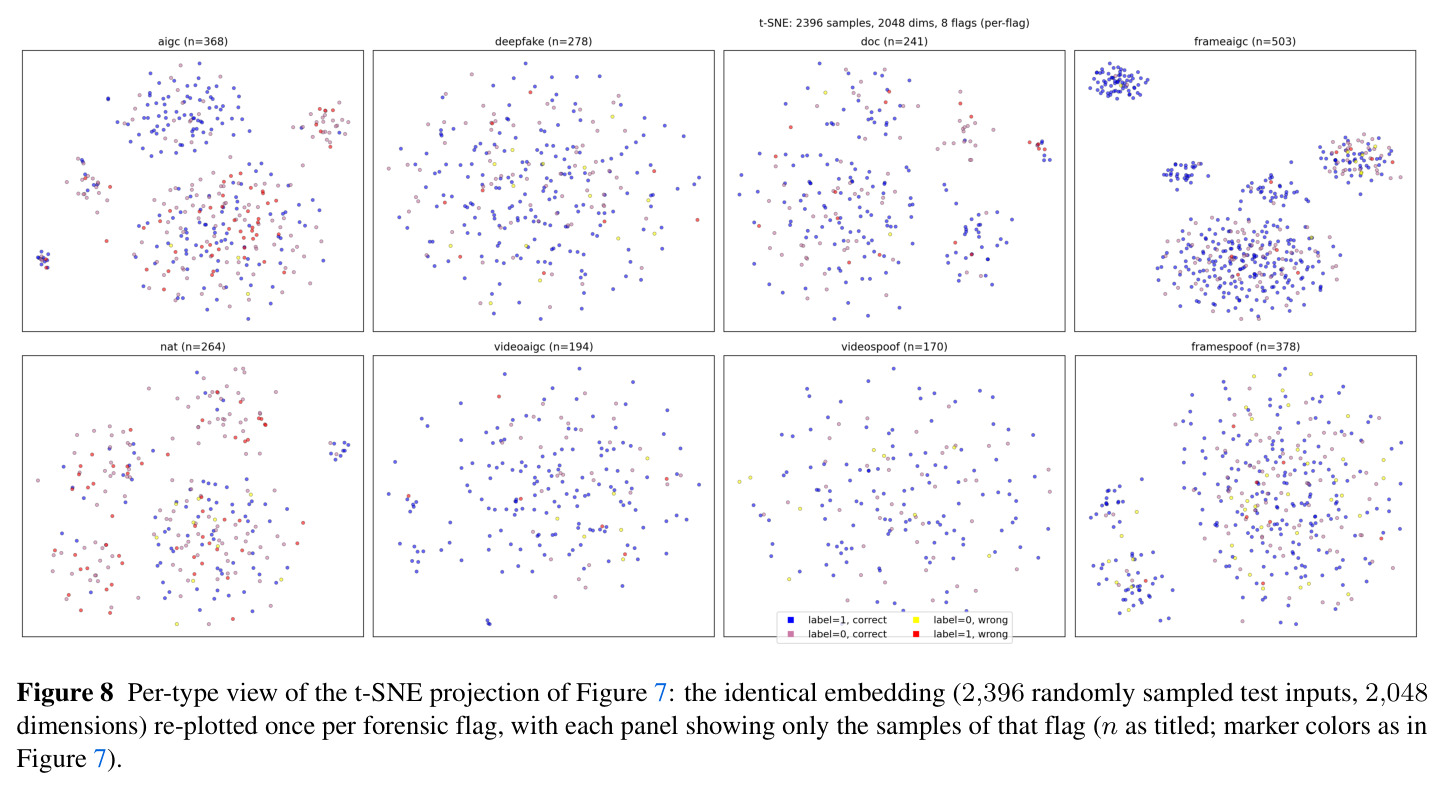
DefakerOne2 在 53 个检测基准上 40 个第一、14 个定位基准上 11 个第一,8 个域全部第一,且从未被任何域专家在自己的域上击败。图像域五项平均:DeepFake AUC 96.7(比最强外部 Effort 高 8.5、比最强取证 MLLM Ivy-xDetector 高 22.7)、AIGC 精度 93.3(比 DRCT 高 25.1,在生成器更迭的 BFree-Online 上从 65.7 升至 91.7)、文档 87.6(比专用 DTD 高 28.5)、自然图像 AUC 89.6(比 TruFor 高 18.1)、ManipulationBench 71.7(比 V1 +23.1,超最强对手 RPOBE 70.8)。视频域:8 个经典基准平均精度 96.0(V1 仅 62.7),平均 HTER 5.0(V1 29.4,误差降 83.0%),且判定在真/伪两类间平衡;RABench 零样本 AUC 99.3、balanced accuracy 96.3(超 Gemini-3.1-Pro 32.9 分);RRVBench 95.3,比最强 7B 视频 MLLM VideoVeritas(69.8)高 25.5 分、比 V1 高 43.0 分。定位:文档平均 pixel-F1 79.5(DTD 60.1)、自然图像 78.1(TruFor 50.3)。消融:潮汐调度把静态基线的 87.3–87.8 提到 90.9,熵路由 95.9 高于任一固定模态(91.6/93.5),校准环零参数再 +1.2,MFFI 扰动下 AUC 只降 7.4(V1 降 20.5)。内部数据统一 FPR=0.001 下平均 96.36,超 DINO-MAC-0.3B 3.97 分,最难的 Data4 上 82.41(SwinTrans 15.66)。t-SNE 显示表征按取证域组织、真假边界隐式(纯度-精度 $\rho=+0.80$)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeepFake 人脸伪造检测(15 基准) | AUC | 96.7(平均) | 前代 DefakerOne 95.8;最强外部 Effort 88.2 | +0.9(对 V1)/ +8.5(对 Effort) |
| AI 生成图像检测(9 基准) | Accuracy | 93.3(平均) | 前代 87.5;最强外部 DRCT 68.2 | +5.8(V1)/ +25.1(DRCT) |
| 文档篡改检测(9 基准) | Accuracy | 87.6(平均) | 前代 81.4;最强专用 DTD 59.1 | +6.2(V1)/ +28.5(DTD) |
| 自然图像篡改检测(9 基准) | AUC | 89.6(平均) | 前代 86.7;TruFor 71.5 | +2.9(V1)/ +18.1(TruFor) |
| 物理伪造检测(人脸/证件翻拍,图像级) | Accuracy | 87.2 | 前代 50.7;最强外部 Effort 67.6 | +36.5(V1)/ +19.6(最强外部) |
| 经典视频伪造检测(8 基准:CASIA-FASD、DLC2021、SCVD 等) | Accuracy | 96.0(平均) | 前代 62.7;最强外部 MVP 69.8 | +33.3(V1)/ +26.2(MVP) |
| 经典视频伪造检测 | HTER(越低越好) | 5.0(平均) | 前代 29.4;MVP 31.6 | 误差下降 83.0%(对 V1) |
| RABench 零样本 AI 视频检测(9 个未见生成器) | AUC | 99.3(平均) | ForgeLens 61.1;DeCoF 60.9 | +38.2 / +38.4 |
| RABench(对 MLLM) | Balanced Accuracy | 96.3 | Gemini-3.1-Pro 63.4;Skyra-RL 54.9;前代 49.3 | +32.9(Gemini)/ +47.0(V1) |
| RRVBench(11 个最新生成器的谣言视频,零样本) | Balanced Accuracy | 95.3 | VideoVeritas(7B) 69.8;DRCT 62.1;前代 52.3 | +25.5(VideoVeritas)/ +43.0(V1) |
| ManipulationBench(最新生成器的局部编辑) | Balanced Accuracy | 71.7 | RPOBE 70.8(预训练最好);AIDE 63.2(微调最好) | +23.1(V1 48.6) |
| 像素级篡改定位(文档,8 基准) | Pixel-F1 | 79.5(平均) | 前代 73.7;DTD 60.1 | +5.8(V1)/ +19.4(DTD) |
| 像素级篡改定位(自然图像,6 基准) | Pixel-F1 | 78.1(平均) | 前代 67.4;APSC-Net 58.7;TruFor 50.3 | +10.7(V1)/ +19.4(APSC-Net) |
| MFFI 鲁棒性评测(MFFI-Distorted 扰动子集) | AUC 降幅 | -7.4(97.3→90.1) | 前代 -20.5(96.1→76.4) | 退化幅度缩小 13.1 个百分点 |
| 内部真实攻击数据(统一 FPR=0.001) | Accuracy | 96.36(三集平均) | DINO-MAC-0.3B 92.39;SwinTransformer 83.12 | +3.97(DINO-MAC)/ +13.24(SwinTrans) |
局限与改进
作者承认的局限有三:模型仍会失败,甚至对人眼显而易见的伪造也可能漏检,需补充同特性的定向数据;出于防御白盒攻击的考虑,训练只用了小部分过期的内部数据;分割模块只在区域级篡改样本上训练,未包含真实与全生成样本,掩码可能与分类判定不一致,此时应以分类为准。我的观察还有:(1)视频输入上限 4 帧、256 个 visual token,长视频的长程运动不一致证据覆盖有限;(2)文档域多处 V1→V2 回退(TFR 99.6→81.8、RTM 87.4→72.7),统一训练在部分专业域并非无损;(3)CASIA-FASD 上仍输给人脸防伪专用模型 FLIP(90.3 vs 98.5),与"不在专家主场输给专家"的宣称不完全一致;(4)物理图像域 87.2 仍是图像域最低分,RRVBench 上最低的 SeeDance 2.5 子集也只有 88.0,对最新闭源生成器仍有追赶空间;(5)训练集含多个公开基准的官方训练划分,虽做了阶段间互斥,仍应留意跨基准泄漏的可能;(6)单 token 输出高效但牺牲可解释性,判 fake 时缺乏推理链,证据呈现只能依赖定位掩码;(7)320 张 A100 的训练规模和 50M 数据工程远超学术实验室可负担范围。
独立分析的弱点
独立分析的弱点及改进方向:(1)长视频时序覆盖不足——4 帧/256 token 上限使超过数秒的缓变不一致可能漏检;改进方向是关键帧检索、多路 clip 聚合或流式时序编码器二级筛查。(2)文档域回退——TFR 99.6→81.8、RTM 87.4→72.7,说明域间梯度干扰真实存在;改进方向是 Hard-Sample Ebb 阶段引入域平衡采样,或为高冲突域挂独立专家 LoRA 分支按需路由。(3)分割与分类不一致——分割模块从未见过真实与全生成样本,对全生成图像会输出无意义掩码;改进方向是把全图/空掩码纳入分割监督,或用全局判定做弱监督对齐两分支。(4)熵路由只在两模态间硬二选一;改进方向是扩展为多分辨率、多帧数的多路路由或置信度加权软融合。(5)校准环假设全局判定 $p$ 可靠,全局误判会以有界但单向的方式传递到掩码;改进方向是引入不确定性估计,置信低时自动退化为固定阈值。(6)Creative Proposer++ 依赖 MLLM 描述,其识别错误可能成为噪声标签;改进方向是加生成-识别一致性过滤。(7)鲁棒性评测仅 MFFI-Distorted 一个子集,截图、加水印、多轮转码等线上退化缺乏系统评测;改进方向是构建分级退化矩阵并纳入训练噪声调度。
未来方向
作者提出的方向有二:其一,可扩展取证基础模型与持续数据工程——作者发现单纯堆同质数据收益递减,核心挑战是搭建自动、高吞吐的数据管线持续生成高保真、多样的取证数据,并以持续学习协议动态更新训练分布、增强对开放世界扰动和未见操作伪影的鲁棒性;其二,智能体取证与混合知识注入——平衡结果级监督(标签稀缺、不可解释)与过程级监督(CoT 受限于人工提示与领域启发式),设想多模态 agent 调用可验证的取证工具与真实 ground-truth 线索,走向可解释的多步取证调查。此外,t-SNE 分析章节给出了两个具体优化提议:以取证类型标签为类别的聚类感知度量学习(监督对比或中心+间隔损失),把 aigc、nat 这类缺乏外观先验、流形分散的域压紧;以及在每个域簇内部加显式的真假二值对比或加性角度间隔损失,把目前只在分类头权重中隐式存在的真假决策面变得线性可读。基于本文成果还可自然延伸:把熵路由推广为多分辨率/多帧数/多模态的通用测试自适应;把校准环推广到视频时序定位与证据链生成(检测+定位+自然语言解释一体化);RRVBench 可作为生成器-检测器军备竞赛的滚动基准,定期纳入新发布生成器。
复现评估
开源情况较好:代码、模型权重与数据在 GitHub(inclusionAI/DefakerOne2)公开,项目页 venus-guangjiang.github.io/Venus-DeFakerOne2,RRVBench 基准随论文发布;骨干 Qwen3.5-2B 与 DINOv3-Large 权重均为公开模型,2B 推理门槛低(单 token 输出、单卡可跑),评测侧的复现难度不大。但训练复现门槛很高:需要 320 张 NVIDIA A100、约 50M 样本、三阶段调度加 agent 数据闭环,且各阶段样本量(15M/40M/40M)、LoRA 秩与学习率调度、Ada-FPS 参数等披露充分但私有数据(0.1M 文档样本、2.7M 私有 AIGC 样本、9.3M 私有 DeepFake 等)不公开,涉及内部数据的实验(如 Table 26 的 in-house 评测)第三方无法复现。论文还报告了华为昇腾 A3 的适配(单步训练提速约 11%、端到端提速 12–13%、20 epoch 总时长缩短 13.4%),说明其内部流水线部分依赖国产硬件栈,第三方若无同类环境对齐成本不低。总体评估:推理、评测与 RRVBench 复现容易,完整训练复现属于工业级投入。
论文图表
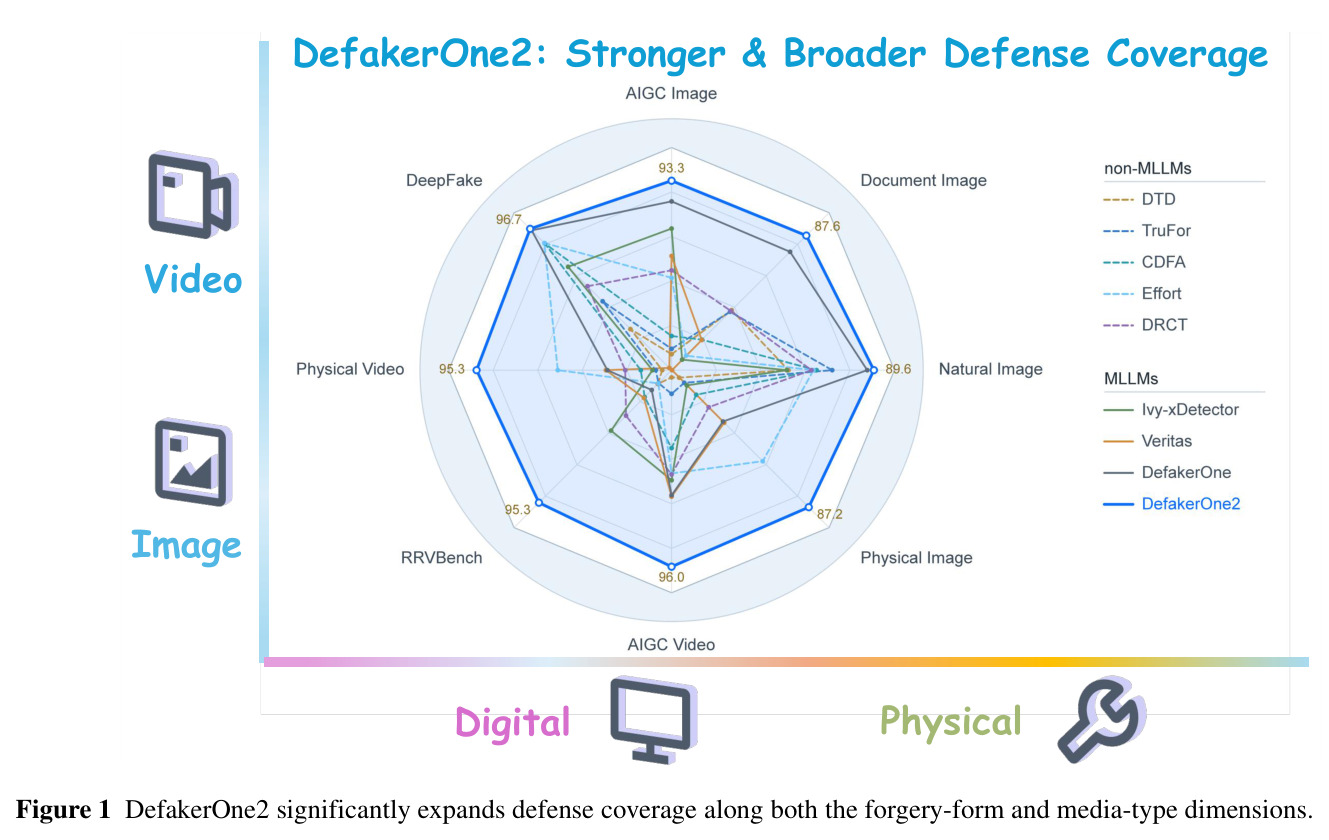
用二维矩阵示意模型防御覆盖范围的扩展:从上一代仅覆盖"数字×图像",扩展到"数字/物理 × 图像/视频"的完整矩阵,四象限分别对应图像伪造、视频伪造、物理展示攻击与物理视频攻击。
一张图讲清论文的核心定位——把能力边界沿伪造形式与媒体类型两个维度同时外推,这是与 DefakerOne 一代最本质的差异。
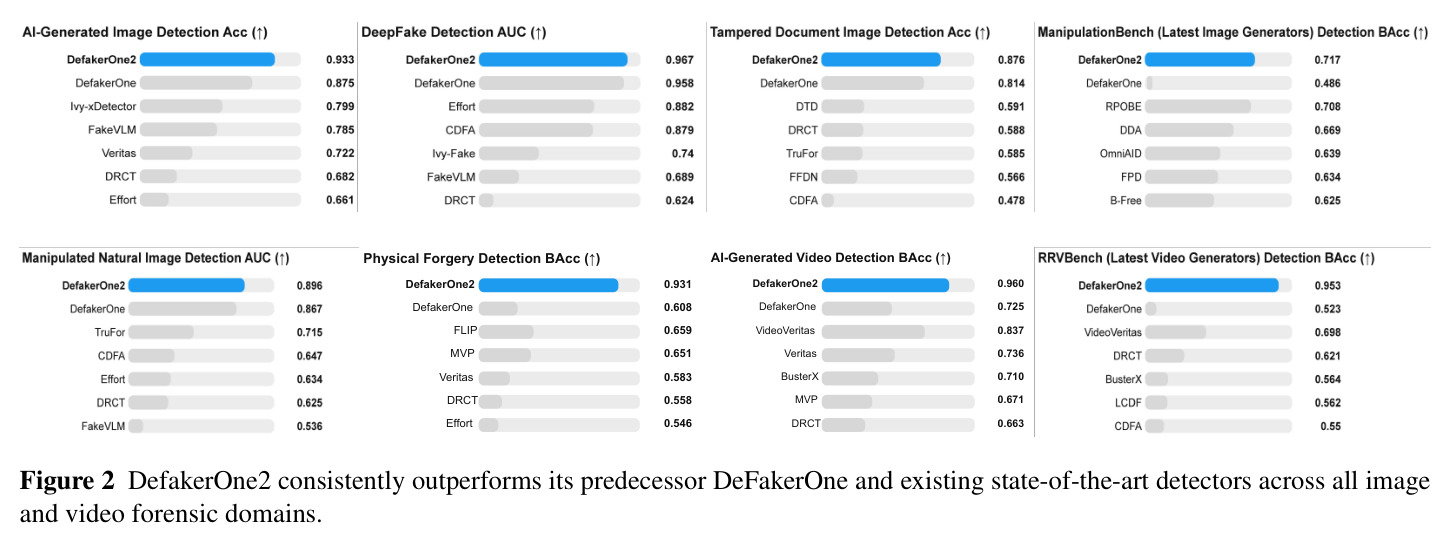
两张条形图:物理伪造检测 BAcc 上 DefakerOne2 得 0.931,远超前代 0.608、FLIP 0.659、MVP 0.651、Veritas 0.583 等;AI 生成视频检测 BAcc 上得 0.960,远超前代 0.725、VideoVeritas 0.837、Veritas 0.736、BusterX 0.710 等。
直观展示模型在两大新增域(物理伪造与 AI 视频)上对前代与全部 SOTA 竞品的碾压式优势,是摘要核心结论的可视化。
50M 异质语料的构成图:公开数据集 + 野外攻击样本 + 自动生成管线,覆盖 9 个取证域;右侧展示 Creative Proposer++(MLLM 详述真实媒体→生成器合成语义对齐真假样本)与 Agent-Based 数据生成闭环(训练→失败案例分析→定向合成→回填再训练)。
数据工程是本文性能的根基,此图解释 50M 数据从哪里来、如何保证真假语义对齐、以及如何随新伪造方法持续更新。
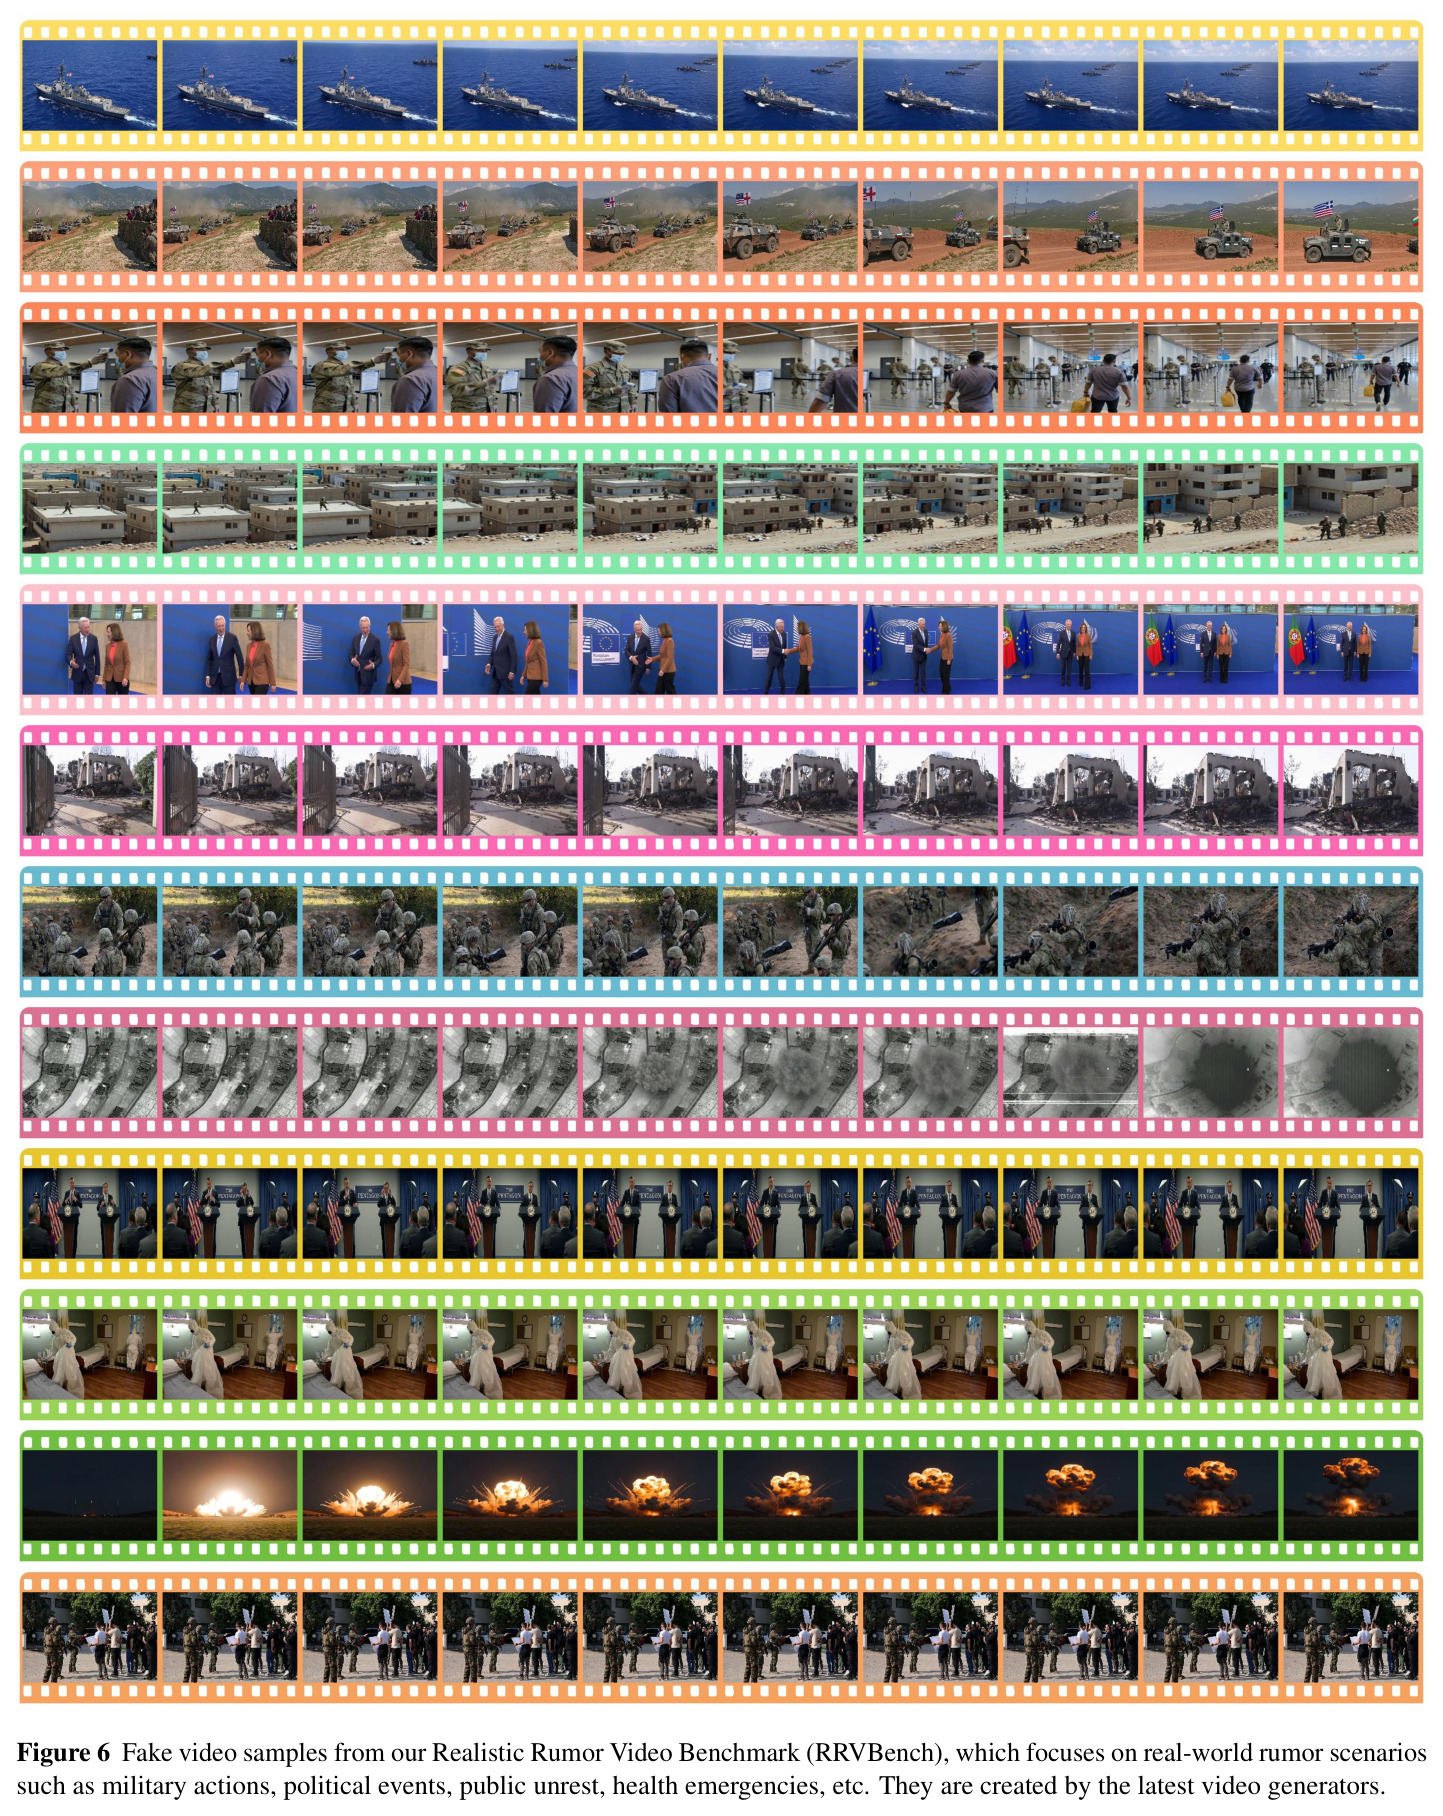
展示 RRVBench 中的假视频样例,内容聚焦军事行动、政治事件、公共骚乱、突发公共卫生事件等高风险谣言场景,均由最新视频生成引擎(SeeDance 2.5、Kling-V3、Wan 2.6 等)合成。
说明新基准直面真实高风险谣言场景并用最新生成器构造,弥合了学术评测与真实 AIGC 威胁之间的应用差距,也是模型最严苛的泛化测试来源。