近零词元嵌入静默停滞门控序列模型训练 Near-Zero Token Embeddings Silently Stall Training in Gated Sequence Models
未见词元嵌入被权重衰减缩至近零,在门控模型放大梯度30个数量级并静默清零批次更新
前置知识
Pre-RMSNorm 与数值地板 $\varepsilon$
RMSNorm 对词元向量做 $\mathrm{RMSNorm}(h)=\frac{h}{\sqrt{\frac{1}{d}\sum_i h_i^2+\varepsilon}}\odot w$,其中 $\varepsilon$(本文取 $10^{-6}$ 或 $10^{-5}$)是防除零的下限。Pre-RMSNorm 指先归一化再做子层(注意力/SSM/FFN)计算、最后残差相加的布局。当残差向量的均方根远小于 $\sqrt{\varepsilon}$ 时,归一化直接除以 $\sqrt{\varepsilon}$,反向梯度被放大 $1/\sqrt{\varepsilon}$ 倍($\varepsilon=10^{-6}$ 时每层约 1000 倍)。
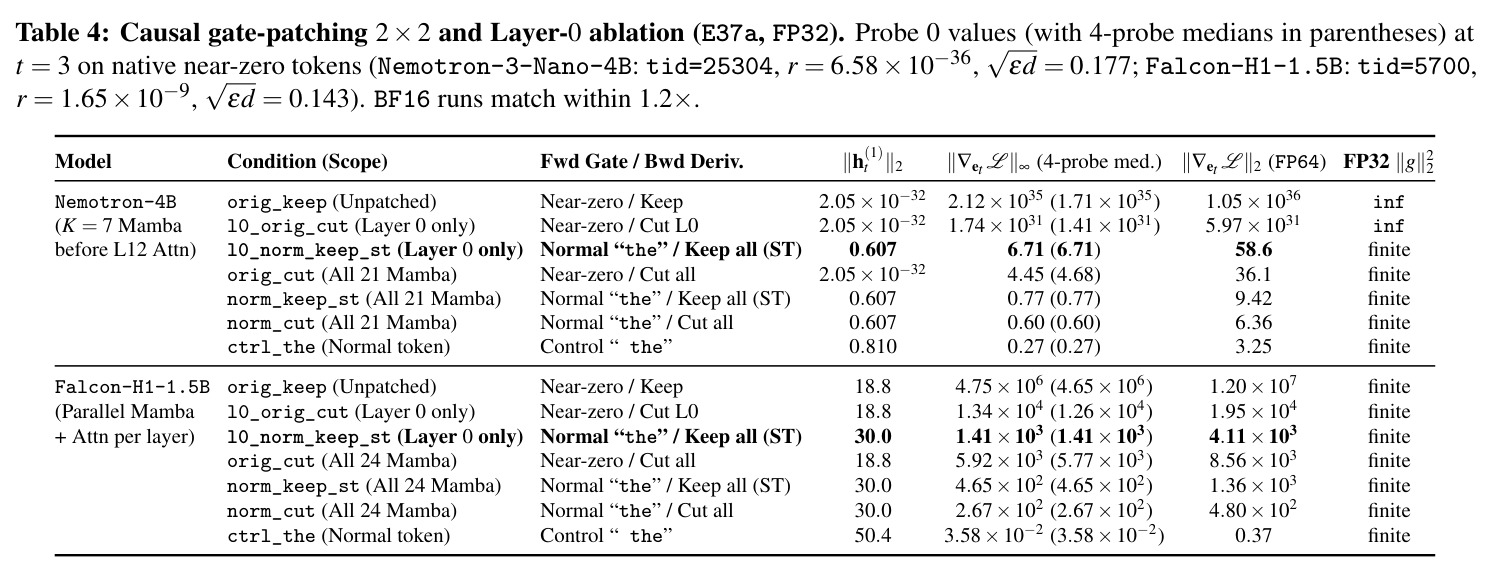
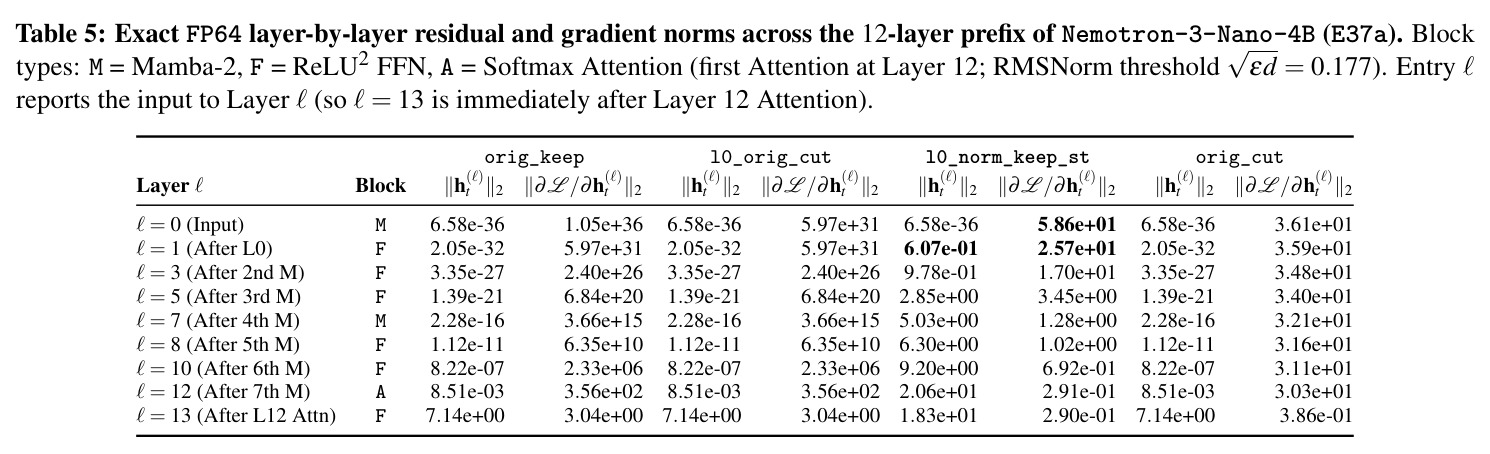
本文的核心放大机制正是「近零残差 × RMSNorm 地板」逐层复合,读懂 Proposition 1、Figure 4 和 Table 5 的逐层数值都必须先掌握这个除法行为。
权重绑定与 AdamW 解耦权重衰减
语言模型有输入嵌入表 $E_{in}\in\mathbb{R}^{V\times d}$ 和输出矩阵 $E_{out}$;权重绑定(Press & Wolf, 2017)令两者共享同一矩阵。AdamW 的解耦权重衰减每步把参数乘以 $(1-\eta_t\lambda)$($\lambda$ 通常 0.1)。训练语料中从未出现的词元,其输入行梯度恒为 0,而输出行因 softmax 对全词表归一化每步都收到非零梯度。于是绑定模型中输出梯度把行范数维持约 1,非绑定模型的输入行则按 $\|e_v^{(T)}\|=\|e_v^{(0)}\|\prod_t(1-\eta_t\lambda)$ 指数缩小。
这是近零嵌入的产生来源(第 2 节),也解释了普查结果:0% 的绑定模型出问题,而 52.6% 的非绑定门控模型中招。
门控循环架构与零点消失的读出因子
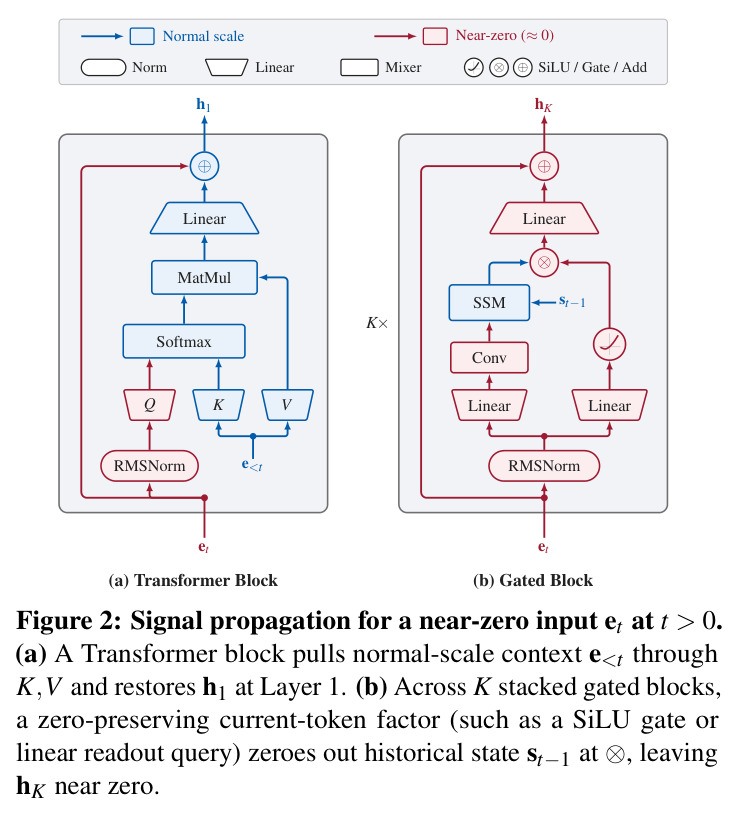
Mamba/Mamba-2/Gated DeltaNet/xLSTM 等线性复杂度模型维护历史状态 $s_{t-1}$,但历史读出 $y_t$ 会乘上一个只依赖当前词元的因子 $\phi_\ell(\tilde h_t)$:SiLU 门 $\phi=\mathrm{SiLU}(W_z\tilde h_t)$ 满足 $\mathrm{SiLU}(0)=0$,mLSTM 的线性查询 $q_t=W_q\tilde h_t$ 在零输入时也为 0。当前词元嵌入近零时该因子趋零,历史信息在 ⊗ 处被清空,残差流在连续多层保持近零——这是门控模型独有、Transformer 没有的乘性瓶颈。
Figure 2b 的信号传播和「为什么梯度放大只发生在门控模型」完全由这个因子决定,是理解全文机理的钥匙。
FP32 全局范数梯度裁剪与 IEEE-754 溢出
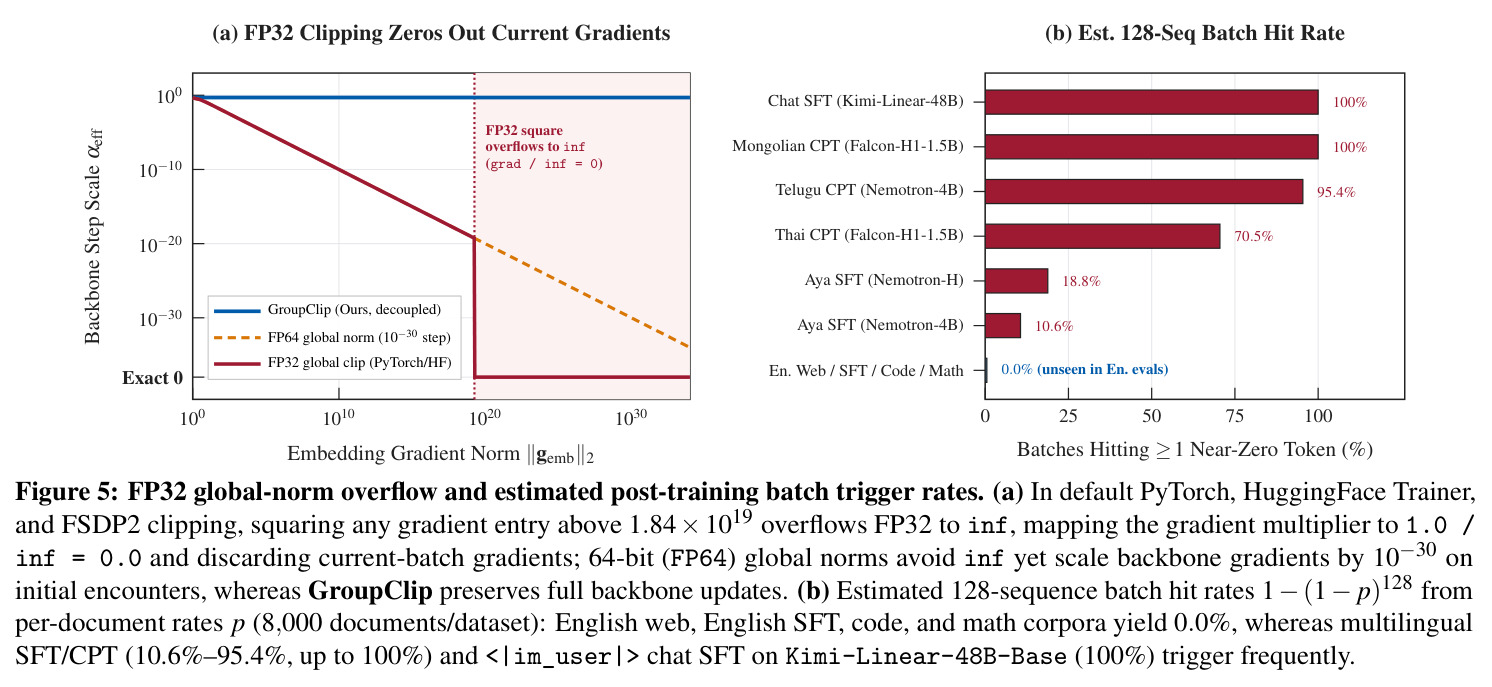
优化器更新前通常用全局范数裁剪把所有梯度缩放到范数 $\le c$(通常 1.0)。PyTorch、HuggingFace Trainer、FSDP2 在 FP32(最大约 $3.4\times10^{38}$)中累加梯度平方和;任何单个梯度项超过 $\sqrt{\mathrm{FLT\_MAX}}\approx1.84\times10^{19}$ 时平方即溢出为 $\mathrm{inf}$,裁剪系数 $c/\mathrm{inf}$ 在 IEEE-754 下精确等于 $0.0$,逐元素相乘后所有梯度变成精确零——不抛异常、不产生 NaN。
这是「静默丢失整批更新」的直接原因(论文第 4 节),也是 GroupClip 采用 FP64 范数/解耦裁剪设计所针对的故障点。
混合架构与首个注意力层位置 $K$
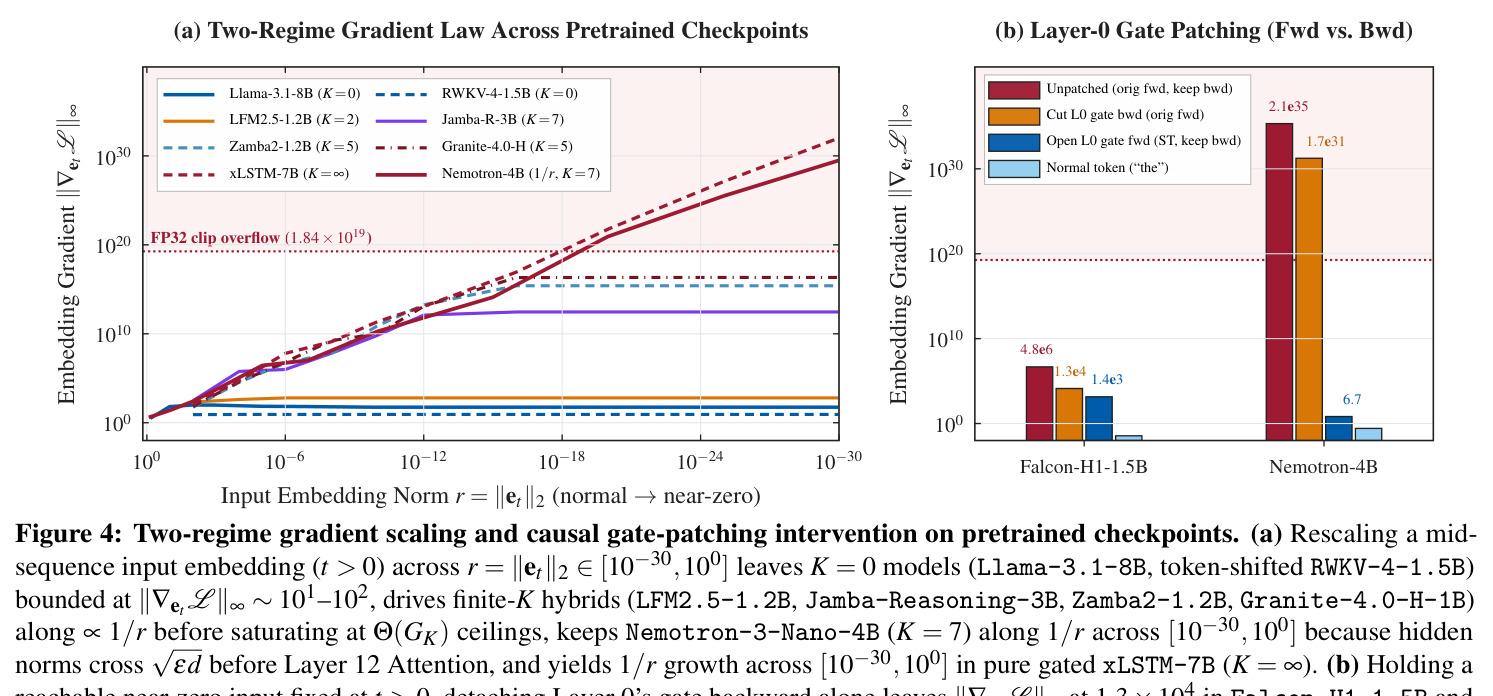
混合模型(Jamba、Nemotron-H、Falcon-H1、Zamba、Bamba 等)把 $K$ 个门控块与少量 Softmax 注意力层交错。注意力在第 $K$ 层首次出现:即使当前查询近零,softmax 仍会给历史词元分配非零权重、拉回正常尺度的 value 向量,一层内终止放大。$K$ 越大(纯门控 $K=\infty$),参与复合的放大层数越多,梯度天花板 $G_K$ 越高——实测 Jamba-R-3B($K=7$)$2.8\times10^{12}$、Zamba2($K=5$)$2.5\times10^{15}$。
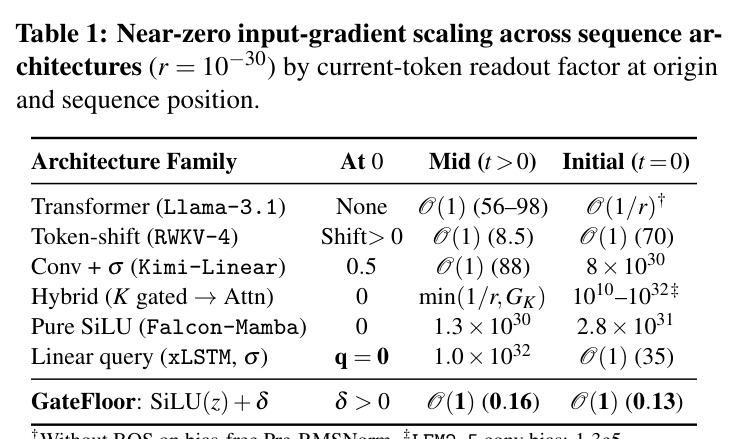
两段式缩放律($1/r$ 段 + $G_K$ 天花板)与 Table 1 的架构安全性分类都由 $K$ 和读出因子在零点的取值决定。
研究动机
近年开源社区大量用门控循环架构(Mamba、Gated DeltaNet、xLSTM)替代或混插注意力(Jamba、Nemotron-H、Falcon-H1、Kimi Linear 等),并普遍用 AdamW 把检查点继续预训练到新语言或聊天模板。本文审计 291 个 HuggingFace 仓库(280 个独立嵌入表):52.6% 的非绑定门控/混合检查点(20/38)含可达近零输入嵌入(行范数 $<10^{-6}$,最低 $10^{-36}$),绑定模型为 0%,非绑定 Transformer 30.9%(47/152)但训练安全。中招的是普通字符串:Nemotron 的泰卢固/巴斯克子词、Falcon-H1 的西里尔蒙古语词、Mamba-Codestral 的 CRLF 片段、Kimi-Linear-48B 的聊天标签。在 Nemotron-3-Nano-4B 泰卢固继续预训练中,一个近零词元就把嵌入梯度放大超 30(最高 35)个数量级,FP32 裁剪溢出后整批梯度被精确清零——无报错、无 NaN,约 19.8% 的训练步在静默空转,新数据完全没学进去。
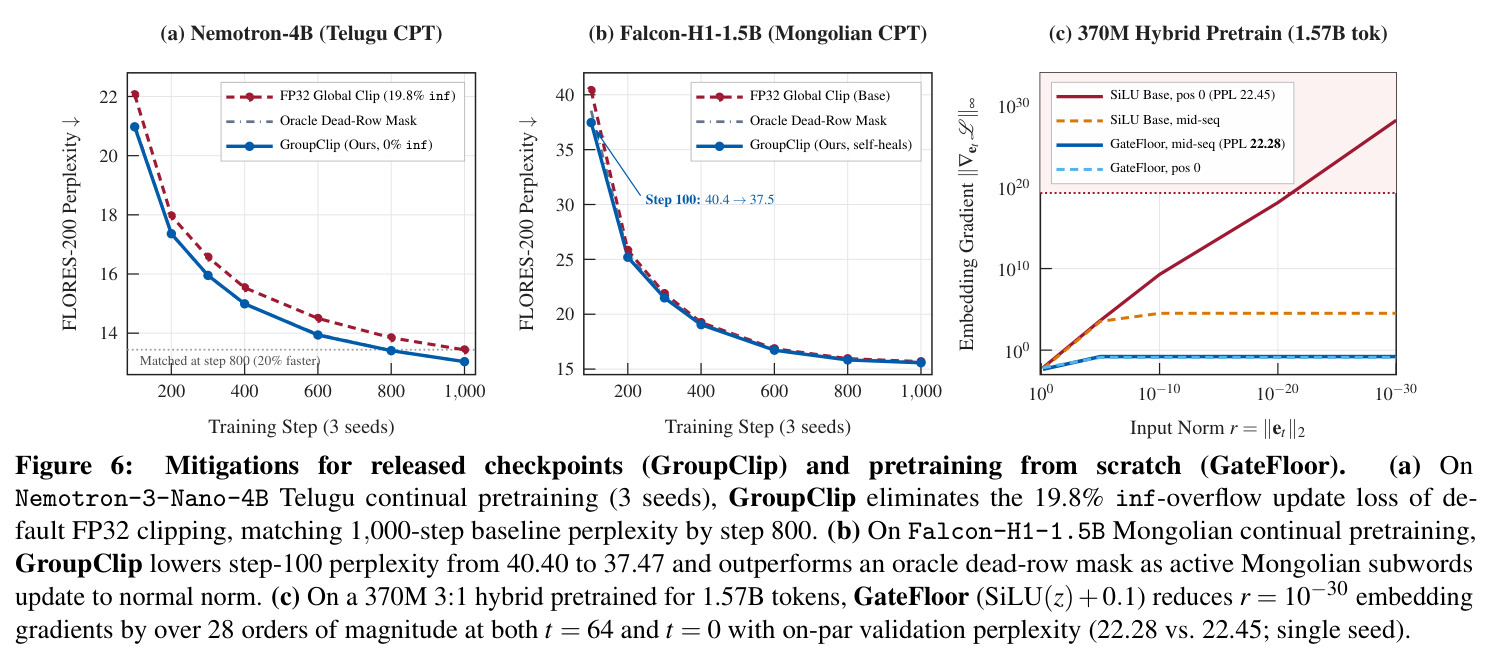
本文的目标是论文要把这个无人察觉的故障做成完整闭环。第一,量化问题面:用 HTTP 字节范围请求直接审计主流开源检查点,统计近零行流行率与权重绑定方式的关系,并用往返编码测试筛掉对齐 padding 等不可达行。第二,定位成因:验证「非绑定嵌入 + AdamW 权重衰减 + 未见过词元的零输入梯度」就是衰减到 $10^{-30}$ 量级的原因(在 OLMoE-1B-7B 上用 3.64 亿词元语料抽样核对衰减公式预测)。第三,建立可预测的放大定律:推导并实证输入嵌入范数 $r$、RMSNorm 地板 $\varepsilon$、首个注意力层位置 $K$ 与梯度幅度之间的两段式缩放律。第四,量化训练后果:测出 PyTorch/HF/FSDP2/Megatron 的 FP32 溢出行为、15 个真实语料的批次触发率、以及 AdamW 参数更新分解。第五,给出两个可落地的修复——面向已发布检查点的 GroupClip 和面向从零预训练的 GateFloor——并验证修复后困惑度不劣化、吞吐不下降。
与已有工作不同的是,已有工作只看到问题的碎片:SolidGoldMagikarp 事件与 Land & Bartolo(2024)记录了「欠训练词元」现象;Takase et al.(2025)发现衰减 Transformer 嵌入会温和抬升浅层 LayerNorm 梯度,促使 OLMo 2 把嵌入排除出权重衰减。但没人把三件事连起来:(1) 非绑定的开源门控检查点中大量存在近零输入行,绑定模型因输出梯度共享而完全幸免;(2) 门控架构「在零点消失」的当前词元读出因子(SiLU 门、线性查询)叠加 Pre-RMSNorm 的 $1/\sqrt{\varepsilon}$ 增益,会跨层乘性放大到 $10^{30}$ 以上——而 Transformer 的注意力在非初始位置一层就恢复尺度;(3) IEEE-754 中除以 $\mathrm{inf}$ 得精确 0.0,使 FP32 裁剪「精确清零且无任何警告」,这是静默失败而非崩溃。本文的独特之处在于把普查、机理(含前向/反向解耦的因果门控补丁实验)、缩放律、框架审计与两个修复整合成一条完整证据链。
核心方法
直觉上是「四个无害环节相乘成灾」:未见词元的输入行被权重衰减缩到近零(一)→ 门控块用零点消失的因子读出历史状态,残差被压到近零(二)→ Pre-RMSNorm 除以 $\sqrt{\varepsilon}$,每层放大反向梯度千倍,$K$ 层复合超 $10^{30}$(三)→ FP32 裁剪平方溢出、除以 inf 得精确零更新(四)。技术路线:(1) 291 个仓库的字节级嵌入普查;(2) 4 层 Mamba 的 $2\times2$「绑定×衰减」消融与 OLMoE 语料审计验证衰减律;(3) 8 个模型扫描 $r\in[10^{-30},1]$,Taylor 展开证明缩放律 $\|\nabla_{e_t}L\|=\Theta(\min\{\sqrt{\varepsilon d}/r,\ G_K\})$,并用前向/反向解耦的门控补丁确立因果;(4) 框架溢出审计、触发率估计与 AdamW 更新分解;(5) 提出并评估 GroupClip 与 GateFloor。
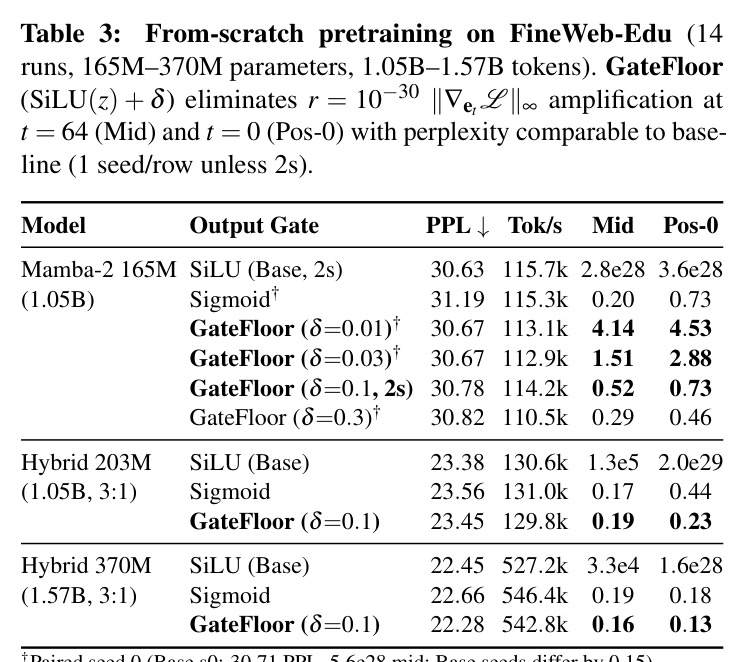
创新分两层。诊断层面:这是一类「反向的稳定性问题」——已有研究都针对过大状态(massive activations、attention sink),本文发现近零状态会把 RMSNorm 的除法变成多层放大器,且只有读出因子零点消失的门控架构受害:Transformer 的注意力从历史词元拉回正常尺度 value、一层即恢复;RWKV 的 token-shift、Kimi 的短卷积使因子零点非零,同样免疫;再加上 IEEE-754「除以 inf 得精确零、无 NaN」,构成静默失败链。修复层面:GroupClip 把 $E_{in}$ 与骨干解耦裁剪——放大只出现在 $\nabla E_{in}$(骨干梯度通常 1–10),分开裁剪后骨干更新永不受损,触发行获单位范数梯度、一步 AdamW 即自愈。GateFloor 让读出因子零输入处为正:$g_\delta(z)=\mathrm{SiLU}(z)+\delta$,$\delta\in[0.01,0.1]$,零参数;同时保留 SiLU 无上界的表达力——Sigmoid 门虽零点安全但正向上界使 PPL 恶化 0.18–0.56。
方法步骤详情
第一步(普查):HTTP byte-range 只读 291 个仓库的 $E_{in}$、$E_{out}$ 与 tokenizer,FP64 算行范数,对 $\|e_v\|<10^{-6}$ 的行做 8 模板往返编码可达性测试。第二步(溯源):4 层 Mamba $2\times2$「绑定×衰减」消融确认非绑定+衰减使行一致衰减 $(1-\eta\lambda)^{3000}$(CV=0.0085);OLMoE 的 251 个近零行在 3.64 亿词元样本中零出现,250 行聚在 $3.36\times10^{-12}$,与累计衰减吻合。第三步(机理):8 个模型重设中段词元范数 $r$ 记录梯度;$2\times2$ 门控补丁证明放大来自前向读出消失而非反向切断;FP64 逐层记录残差与梯度。第四步(后果):单步探针测各框架溢出;8000 文档/语料估批次触发率;1000 步泰卢固 CPT 追踪「词表占比→ppm→触发→溢出→零更新」漏斗并做 AdamW 分解。第五步(修复):GroupClip 三行代码;GateFloor 预训练 14 个模型扫 $\delta$。
技术新颖性
新颖性有四点。(1) 两段式缩放律(Proposition 1):$\|\nabla_{e_t}L\|_2=\Theta(\min\{\sqrt{\varepsilon d}/r,\ G_K\})$,$G_K$ 为前 $K$ 个门控块小信号映射增益,同时解释 $1/r$ 反比段(实测斜率 $-0.81$ 至 $-1.22$)与深度饱和天花板(Nemotron-4B 峰值 $4.5\times10^{34}$、Zamba2 $2.5\times10^{15}$)。(2) 因果门控补丁方法学:直通补丁把 Layer 0 前向门值换成「the」而保留全部反向导数,把「前向读出消失」从相关性升级为因果证据——$\|\nabla\|_\infty$ 从 $2.1\times10^{35}$ 降到 6.71,仅断反向几乎无效。(3) 架构分类学:按「当前词元因子零点取值」排序——SiLU/线性查询为 0(危险)、Sigmoid 为 0.5(安全但伤 PPL)、token-shift/卷积非零(Kimi 中段仅 88)。(4) 修复工程友好:三行代码、不改架构、零参数、无词表扫描。
实验结果
普查:绑定模型 0/101(0%)含可达近零行;非绑定 Transformer 47/152(30.9%,安全);非绑定门控/混合 20/38(52.6%,脆弱);979 个抽样近零词元中 92% 输出行范数仍正常。机理:$K=0$ 模型平坦(Llama-3.1-8B 56–98、RWKV-4 8.5);混合沿 $1/r$ 后饱和(Jamba $2.8\times10^{12}$、Zamba2 $2.5\times10^{15}$);Nemotron-4B 峰值 $4.5\times10^{34}$;Falcon-Mamba $1.3\times10^{30}$、xLSTM-7B $1.0\times10^{32}$。后果:梯度超 $1.84\times10^{19}$ 即 FP32 溢出静默清零;批次触发率英文 0%、Aya 10.6–18.8%、泰语 70.5–97.4%、泰卢固 95.4%、蒙古语 100%;泰卢固漏斗:62 行→22.5% 批次命中→88.1% 溢出→19.8% 步零更新。GroupClip:泰卢固停滞步 198.3±9.9→0、PPL 13.44→13.04(800 步追平);蒙古语 step-1000 PPL 15.58 胜 FP32 15.68 与 Oracle 15.63,触发行首触即自愈;Skip-on-Inf/ZClip 仍停滞 57 步,Mean Re-init 使尾部 NLL 3.8→9.8。GateFloor:370M 混合梯度 3.3e4→0.16、位置 0 1.6e28→0.13(降 28 个数量级),PPL 22.28 vs 22.45,吞吐不降。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 泰卢固语继续预训练(Nemotron-3-Nano-4B,1000 步,3 seeds) | FLORES-200 devtest 困惑率 ↓;停滞步数($\alpha_{eff,other}<10^{-4}$) | GroupClip (FP64):PPL 13.04±0.19,停滞 0.0±0.0 步 | FP32 全局裁剪:PPL 13.44±0.17,停滞 198.3±9.9 步 | PPL −0.40,零更新步数 198→0,800 步即追平 1000 步基线(省 20% 计算) |
| 蒙古语继续预训练(Falcon-H1-1.5B,1000 步,3 seeds) | FLORES-200 devtest 困惑率 ↓ | GroupClip:15.58±0.10(step-100 PPL 40.40→37.47) | FP32 全局裁剪 15.68±0.11;Oracle 死行掩码 15.63±0.10(需预扫描词表) | −0.10 且无需词表扫描;早期骨干新批位移保持 27.1% vs 被抑制时的 0.55% |
| 300 步 10 方法消融(Nemotron-4B 泰卢固,59.3±7.8 个触发批次) | FLORES-200 困惑率 ↓;停滞步数 | GroupClip (FP64):15.95±0.25,0 停滞,触发行全部自愈 | Skip-on-Inf 16.63±0.36 / ZClip 16.57±0.39(57 步停滞);FP64 全局范数 16.09(18 步丢骨干更新);GradientStabilizer 16.23($v_t=\mathrm{inf}$ 永久冻结行);Mean Re-init 15.96(尾部 NLL 3.8→9.8) | 唯一同时保住骨干更新并自愈触发行的方法,且不改动 logits 分布 |
| 370M 3:1 混合模型从零预训练(FineWeb-Edu,1.57B 词元) | 验证困惑率 ↓;$r=10^{-30}$ 输入嵌入梯度 | GateFloor ($\delta=0.1$):PPL 22.28;中段梯度 0.16、位置 0 为 0.13;542.8k tok/s | SiLU 基线:PPL 22.45;中段 $3.3\times10^{4}$、位置 0 $1.6\times10^{28}$;527.2k tok/s | 梯度降超 28 个数量级,PPL −0.17,吞吐还略升;Sigmoid 门替代方案 PPL 恶化 0.18–0.56 |
局限与改进
作者承认:审计与梯度探针覆盖到 48B 级模型,但继续预训练只做 1.5B–4B,GateFloor 从零预训练只验证到 370M 且每配置 1–2 种子,「困惑度相当」在小样本下统计功效有限。我的观察:(1) 触发率基于每语料 8000 文档抽样,分布偏斜时可能失真;(2) GroupClip 依赖「放大只出现在 $\nabla E_{in}$」这一前提,若卷积偏置、SSM 参数等也出现极端行,按张量解耦的裁剪未必覆盖;(3) FP64 范数在大词表($131072\times3136$)时产生 3.1 GB 瞬时拷贝,虽有免拷贝变体(与 FP64 最大相对差 $2.3\times10^{-7}$)但主实验全用 FP64 版;(4) 修复效果只用 PPL/FLORES/Belebele(30.67% vs zero-shot 29.78%)评估,缺下游推理/代码任务;(5) 普查限于 HuggingFace 可读仓库,量化部署(GGUF/AWQ)中近零行行为未研究;(6) 可达性判定是启发式往返测试;(7) 多语言 CPT 只测了泰卢固、蒙古语、泰语三个方向。
独立分析的弱点
(1) 规模缺口——GateFloor 只在 370M/1.57B 词元验证,随规模增长逐层增益 $\gamma_\ell$ 分布会否改变、$\delta$ 是否需随宽度缩放未检验;改进方向是补 1–2B 参数对照。(2) 种子过少——370M 的 PPL 差 0.17 只有单种子,而 165M 双种子基线间差异就有 0.15,结论接近噪声边缘;应至少 3 种子并报置信区间。(3) GroupClip 是反应式修复——须等触发批次出现才自愈,每行浪费一步;可与发布前嵌入健康扫描组合,或对近零行做不伤 logits 的受控重初始化。(4) 裁剪阈值未消融——解耦后 $E_{in}$ 与骨干共用 max_norm=1.0,但两组梯度尺度差异巨大,独立阈值可能更优。(5) 与量化交互空白——近零行在 INT8/4-bit 权重下被映射成什么、推理是否异常未涉及,而这正是这些检查点的主要使用方式。(6) 只系统研究了输入嵌入——与 logits 直接相关的输出行/lm_head 病态值得同样审计。(7) 触发率估计假设文档独立,未考虑课程学习或近零词元聚集场景。
未来方向
作者提出/暗示:把「对 $E_{in}$ 关闭权重衰减(OLMo 2 做法)+ GateFloor($\delta=0.1$)」作为从零预训练默认配方;GroupClip 顺带解释了 state-spaces/mamba 的 inf 梯度范数 issue #529,可推广到更多框架。可延伸方向:(1) 把 GateFloor 移植到其他门控家族(Gated DeltaNet、RWKV、Kimi Linear)并研究 $\delta$ 与 $d$、$K$ 的理论缩放;(2) 把 $G_K$ 与架构超参显式连接,推导「安全混合比」设计准则;(3) 在 PyTorch/HF Trainer/FSDP2 上游加入 FP64 范数选项或 inf 告警,根除静默零更新;(4) 把扫描脚本做成 HuggingFace CI「嵌入体检」;(5) 词表扩展与 GateFloor/无衰减的联合方案;(6) 全参数 RL 会被含近零聊天标签的 prompt 触发,RLHF 稳定性值得研究;(7) 视觉/多模态 SSM 的 padding token 是否形成同样近零行;(8) 近零行对模板泛化的行为学影响。
复现评估
复现条件较好。数据与代码:附录 F 给出完整 291 仓库清单、扫描协议与 CSV,扫描用 HTTP byte-range 读 safetensors,无需下载整模型;GroupClip 核心 3 行代码(附录含免拷贝变体),GateFloor 是把 MambaRMSNormGated 内 SiLU(z) 换成 SiLU(z)+δ,一行改动、零参数。检查点与语料全公开:Nemotron-3-Nano-4B、Falcon-H1-1.5B、OLMoE-1B-7B;FineWeb-2、FineWeb-Edu、OLMoE-mix-0924。算力:CPT 1000 步单张 H100 80GB 可跑,370M 从零预训练 1.57B 词元用 8×H100;统一 FP32 主权重 + BF16 autocast + fused AdamW。难度:普查与单步溢出探针容易(数小时单 GPU);CPT 对比(3 seeds×2 模型×10 方法)中等(数 GPU 天);完整复现 14 个从零模型较高(8×H100 数天)。论文未明确给出统一代码仓库链接,但实验编号(E22–E37)与超参记录完整。
论文图表
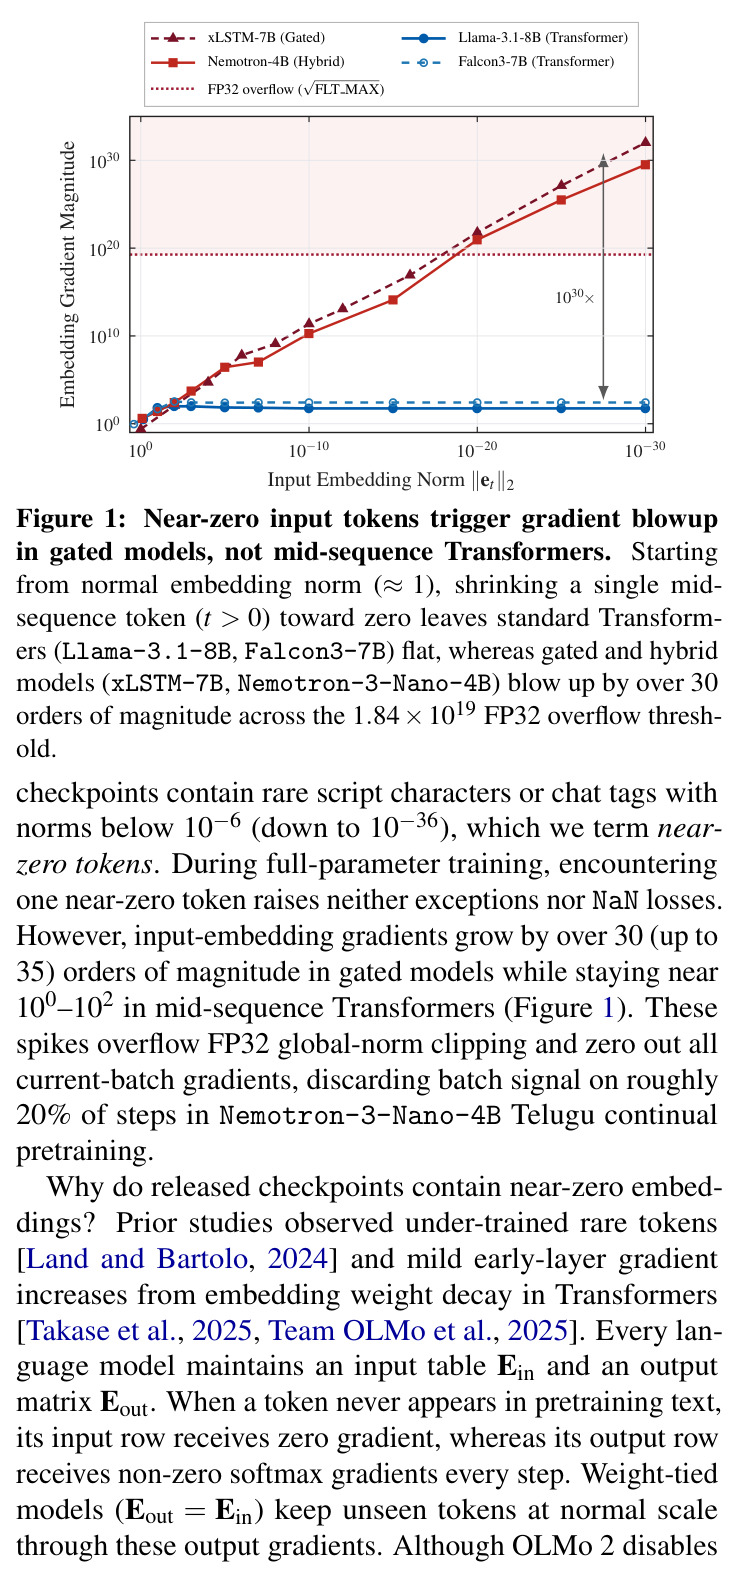
对数-对数坐标:横轴把中段输入嵌入范数 $\|e_t\|_2$ 从正常值 $\approx1$ 扫到 $10^{-30}$,纵轴为输入嵌入梯度幅度。xLSTM-7B(门控)与 Nemotron-4B(混合)的梯度跨越 FP32 溢出阈值 $1.84\times10^{19}$ 放大超过 30 个数量级,而 Llama-3.1-8B、Falcon3-7B(Transformer)在相同扫描下保持 $10^0\text{–}10^2$ 平坦。
一张图给出全文核心现象:问题特定于门控/混合架构、只在词元处于序列中段时发生、幅度足以击穿 FP32,是理解后续所有分析的入口。
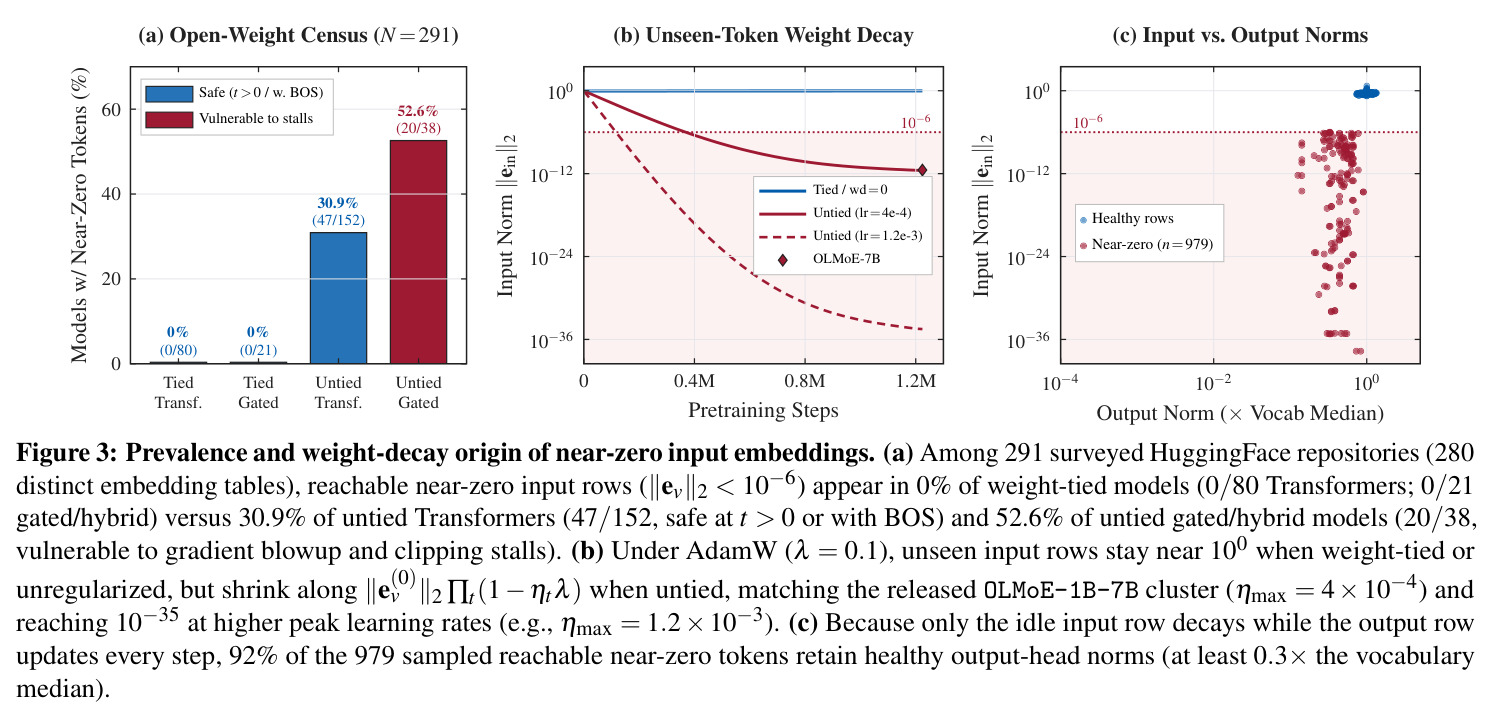
三联图。(a) 291 仓库普查:可达近零行出现在 0% 权重绑定模型(0/80 Transformer、0/21 门控)、30.9% 非绑定 Transformer(47/152,$t>0$ 或有 BOS 时安全)、52.6% 非绑定门控/混合(20/38,易触发梯度爆冲)。(b) AdamW($\lambda=0.1$)下未见输入行按 $\|e_v^{(0)}\|\prod_t(1-\eta_t\lambda)$ 衰减的模拟曲线与 OLMoE-1B-7B 实测簇吻合($\eta_{max}=4\times10^{-4}$ 衰减到 $10^{-12}$,$1.2\times10^{-3}$ 到 $10^{-35}$)。(c) 979 个抽样近零词元中 92% 输出行范数 $\ge0.3\times$ 词表中位数。
同时呈现问题规模(哪些模型中招)、成因的定量验证,以及「输出行完好」这一关键事实——它解释了为什么推理正常、为什么触发行可以被一步 AdamW 自愈。
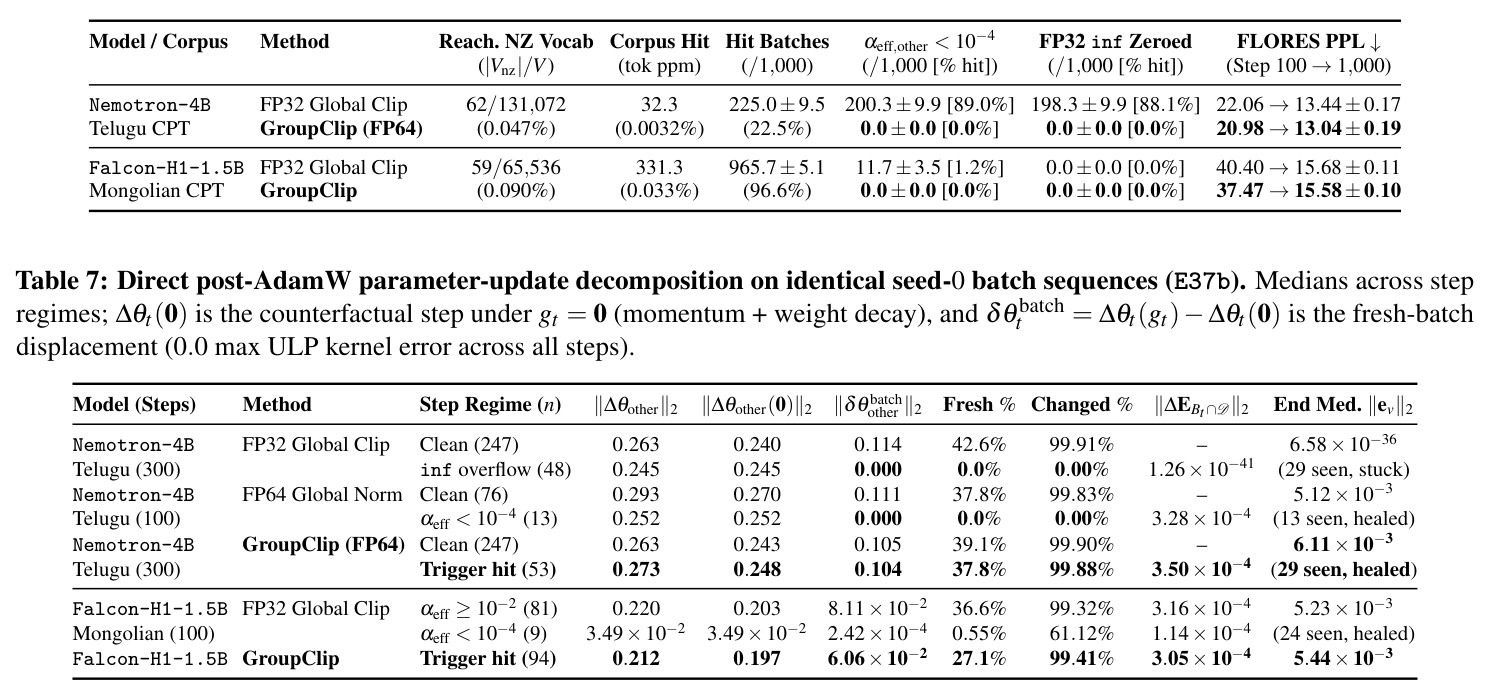
上半部 1000 步:Nemotron-4B 泰卢固 GroupClip (FP64) 停滞 0.0±0.0 步、PPL 13.04±0.19,vs FP32 裁剪 198.3±9.9 步、13.44±0.17;Falcon-H1 蒙古语 GroupClip 15.58±0.10,vs FP32 15.68±0.11、Oracle 掩码 15.63±0.10。下半部 300 步 10 方法消融(59.3±7.8 触发批次):Skip-on-Inf 16.63±0.36、ZClip 16.57±0.39 仍停滞 57.0±7.5 步;GradientStabilizer 16.23±0.30 但在 52.0±8.2 步跳过 $E_{in}$ 缩放($v_t=\mathrm{inf}$ 永久冻结行);Freeze $E_{in}$ 16.16±0.24;FP64 全局范数 16.09±0.35(18.0±1.0 步丢骨干更新);Mean Re-init 15.96±0.24(尾部 NLL 3.8→9.8);Oracle 掩码 15.94±0.26;GroupClip FP32/FP64 15.97/15.95。
论文核心修复的完整定量对比,涵盖所有强优化器基线,证明 GroupClip 是唯一同时保住骨干更新、自愈触发行且不改动 logits 的方案。
泰卢固(Nemotron-4B,FP32 裁剪):62/131,072 可达近零行(0.047% 词表)→语料 32.3 ppm→225.0±9.5 命中批次(22.5%)→200.3±9.9 被抑制(命中批次的 89.0%)→198.3±9.9 FP32 溢出清零(命中批次的 88.1%)→PPL 22.06→13.44;GroupClip 全链条归零、PPL 13.04。蒙古语(Falcon-H1):59/65,536 行(0.090%)→331.3 ppm→965.7±5.1 命中(96.6%)但仅 11.7±3.5 被抑制、0 溢出→PPL 40.40→15.68 vs GroupClip 15.58。
把「词表占比→语料频率→批次触发→优化器后果→最终 PPL」整条漏斗量化到同一张表,并揭示两类混合架构的不同失败形态:串行门控以 FP32 溢出为主,并行混合以梯度抑制为主。