反思SFT的Token重加权:抑制、反转与外推已学特征 Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features
SCALE冻结SFT增量,仅用预测熵学习有符号门控,实现特征的抑制、反转与外推
前置知识
监督微调(SFT)与token级交叉熵
SFT在示范数据上最小化负对数似然 $\mathcal{L}_{SFT}=-\frac{1}{|T|}\sum_t \log \pi_\theta(y_t|c_t)$,参考token的logit梯度为 $\pi_\theta(y_t|c_t)-1$:token概率越低修正越强,因此噪声token反而受到最强更新。
全文的分析对象正是这一损失的token级重加权,理解其梯度结构才能明白为何非负权重无法反转已学到的有害特征。
预测熵
模型下一token分布 $\pi_t$ 上的香农熵 $H_t=-\sum_a \pi_t(a)\log\pi_t(a)$,度量预测不确定性。对logits求导有 $\partial H_t/\partial z_t(a)=-\pi_t(a)A_t^{ent}(a)$。本文Stage II仅用top-100归一化熵作训练信号。
SCALE的核心前提是:支持任务的增量降低不确定性、干扰的增量升高不确定性,熵因此成为无需标签的特征选择信号。
策略梯度与优势函数
把前缀视为状态、词表token视为动作,损失可写成 $\mathcal{L}_{policy}=-\frac{1}{|T|}\sum_{t,a}\mathrm{sg}[\mu_t(a)A_t(a)]\log\pi_\theta(a|c_t)$;熵优势 $A_t^{ent}(a)=\log\pi_t(a)+H_t$ 零均值,当 $\pi_t(a)>\exp(-H_t)$ 时为正。
论文的Lemma 1和信用分配公式都建立在这个策略损失视角上,是读懂第3至5节理论推导的钥匙。
LoRA与增量算子
LoRA把微调增量参数化为低秩矩阵 $\Delta W_m=\frac{\alpha}{r}B_mA_m$,只训练因子 $A_m,B_m$。SCALE在Stage I用它学习任务增量,Stage II将其冻结,只学习标量门 $\lambda_{m,s}$ 来调制 $\Delta W_m h$ 的贡献强度。
SCALE所说的'冻结增量、稳定参考系'直接依赖LoRA把增量从基座权重中显式分离出来的能力。
任务向量与模型算术
任务算术把微调模型表示为相对预训练模型的参数位移(任务向量),可通过加减缩放组合多个任务向量;TIES-Merging等进一步解决向量间干扰,AdaMerging、WEMoE学习组合系数。
SCALE属于增量操控这一研究脉络,但对象是单个已完成SFT增量的逐token有符号缩放,理解脉络才能把握其差异化定位。
研究动机
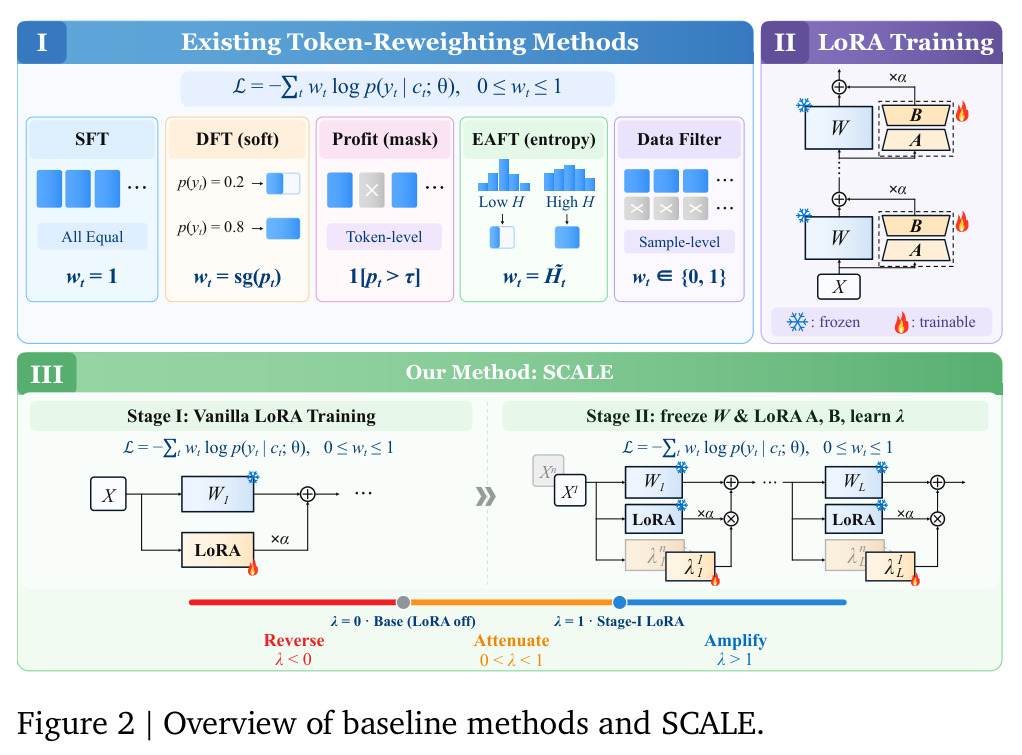
标准SFT对所有示范token一视同仁地最小化负对数似然 $\mathcal{L}_{SFT}=-\frac{1}{|T|}\sum_t \log \pi_\theta(y_t|c_t)$,其对参考token的logit梯度为 $\pi_\theta(y_t|c_t)-1$:模型认为越不可能的token获得的修正越强。然而自然语言监督天然一对多,同一条示范中既有核心推理也有可替换的措辞、格式偏好乃至偶发的事实或逻辑错误;低概率token既可能携带宝贵的新知识,也可能只是与模型已有偏好冲突的噪声,而SFT恰恰把最强的修正给了可靠性最模糊的token,容易覆盖有用的预训练知识并放大噪声监督。DFT、ProFit、EAFT等训练侧重加权和数据侧过滤虽能缓解,但作者证明它们共享非负系数结构,存在无法逾越的表述边界。
本文的目标是本文目标是把SFT的事后修正从'只调监督梯度大小'扩展到三种对已学特征的操作:抑制($0\le\lambda<1$,削弱有害增量)、反转($\lambda<0$,抵消有害增量)与外推($\lambda>1$,放大有益增量)。作者指出,反转与外推只有在一个稳定参考系下才有良定义,即预训练模型与SFT增量都被冻结之后。据此提出SCALE:冻结基座与LoRA增量,仅以预测熵为无监督信号,学习有界的逐token、逐模块门控 $\lambda_{\ell,t}$,并在数学推理、通用能力保持、代码生成三类任务上,对比LoRA、DoRA、ProFit、DFT、EAFT、TALR等强基线进行系统验证。
与已有工作不同的是,本文的独特切入是统一策略损失视角:把SFT与各类token重加权统一写成 $\mathcal{L}_{policy}=-\frac{1}{|T|}\sum_{t,a}\mathrm{sg}[\mu_t(a)A_t(a)]\log\pi_\theta(a|c_t)$,从而揭示DFT、ProFit、EAFT都是示范动作目标、参考token系数 $w_t\ge0$ 的特例,只能缩放CE分量而不能使其反号。第二个关键区分是时间性:训练时改 $w_t$ 改变的是优化轨迹本身,并非缩放一个固定的SFT方向,因此更大的训练权重不等于特征外推;反转与外推必须在冻结的'基座到SFT'坐标系中定义。与任务算术、TIES-Merging等组合多个任务向量的工作相比,SCALE研究的是对单个已完成SFT增量做token条件、模块条件的有符号缩放,这是此前未被触及的问题设定。
核心方法
SCALE的直觉是:SFT学到的增量中既有支持任务的成分也有干扰成分,可以事后根据每个位置、每个模块的增量对模型不确定性的影响来调节其强度,而不必重新训练增量本身。方法分两阶段:Stage I用标准SFT目标训练LoRA适配器(rank $r=16$、缩放 $\alpha=16$、零dropout、作用于所有线性层、1个epoch、总batch 128、AdamW、峰值学习率数学 $5\times10^{-4}$、代码 $5\times10^{-5}$、cosine退火加10% warmup),得到 $\phi^\star$。Stage II冻结基座、输出头与 $\phi^\star$,为每个目标模块添加一个线性投影门控,仅最小化top-100归一化预测熵 $F_k$,不含CE、KL或预算项;每个模块仅新增 $d_m+1$ 个可训练参数,相对LoRA因子 $r(d_m+d_m')$ 的开销可以忽略。
核心创新是把'增量如何被学'与'增量如何被用'解耦,并引入有符号、有界的门控系数。门控调制 $u_{m,s}=W_m h_{m,s}+\lambda_{m,s}\Delta W_m h_{m,s}$:$\lambda=1$ 保持原增量、$[0,1)$ 抑制、$<0$ 反转、$>1$ 外推。参数化为 $g_{m,s}=w_m^\top\mathrm{sg}(h_{m,s})+b_m$、$v_{m,s}=\tanh(g_{m,s}/\tau)$、$\lambda_{m,s}=1+(1-L)\min(v_{m,s},0)+(U-1)\max(v_{m,s},0)$,其中 $L<0<1<U$,零门参数精确恢复Stage-I模型。训练信号只用预测熵:Lemma 1给出熵优势 $A_t^{ent}(a)=\log\pi_t(a)+H_t$ 的精确策略梯度恒等式,它是有符号、零均值的动作级信用而非正确性oracle。与已有方法的本质区别在于:DFT等在训练中修改非负 $w_t$,只能单向缩放监督梯度,永远无法反号一个已经学到的有害特征方向。
方法步骤详情
第一步(Stage I):在NuminaMath-CoT或Magicoder-OSS上做标准LoRA SFT(rank 16、alpha 16、全线性层、1 epoch、batch 128、峰值学习率数学 $5\times10^{-4}$、代码 $5\times10^{-5}$),输出适配器 $\phi^\star$。第二步:冻结基座、输出头与 $\phi^\star$,用 $10^{-6}$ 尺度确定性扰动初始化门参数并校验与Stage-I输出一致。第三步(前向):在响应位置上计算top-100归一化熵 $F_k$。第四步(反传):由Lemma 1,熵优势提供有符号信用,经门坐标切向 $d_{t,i}=\partial z_t/\partial\lambda_i$ 以协方差形式传导到所有受影响位置,只更新门参数。第五步:在门子空间熵-任务一致性假设($\rho<1$)下,Theorem 1保证小步长熵下降使任务价值 $V_k$ 增加。评估时对全部42组 $(L,U)$ 区间各训练一个门控做扫描。
技术新颖性
技术上有多重新意。其一,Lemma 1给出熵的精确策略梯度恒等式 $\nabla_\theta H_t=-\mathbb{E}_{a\sim\pi_t}[A_t^{ent}(a)\nabla_\theta\log\pi_t(a)]$,使熵从启发式信号升格为有符号、零均值的策略损失。其二,Proposition 1证明非负加权的CE下降方向 $w_t(e_{y_t}-\pi_t)$ 无法反号,从形式上刻画了DFT、ProFit、EAFT的共同单边性。其三,Proposition 2证明若 $\bar{\lambda}$ 是 $[0,1]^M$ 上的局部极小且梯度非零,则开区间 $(L,U)^M$ 内任意近处存在更小值,为反转($\bar{\lambda}_i=0$ 处正导数)与外推($\bar{\lambda}_i=1$ 处负导数)提供了理论必要性。其四,token×模块粒度的有符号门控、每模块仅 $d_m+1$ 参数的极端参数效率,以及只用熵、无任何CE或KL的训练目标,在SFT修正文献中均为首次出现。
实验结果
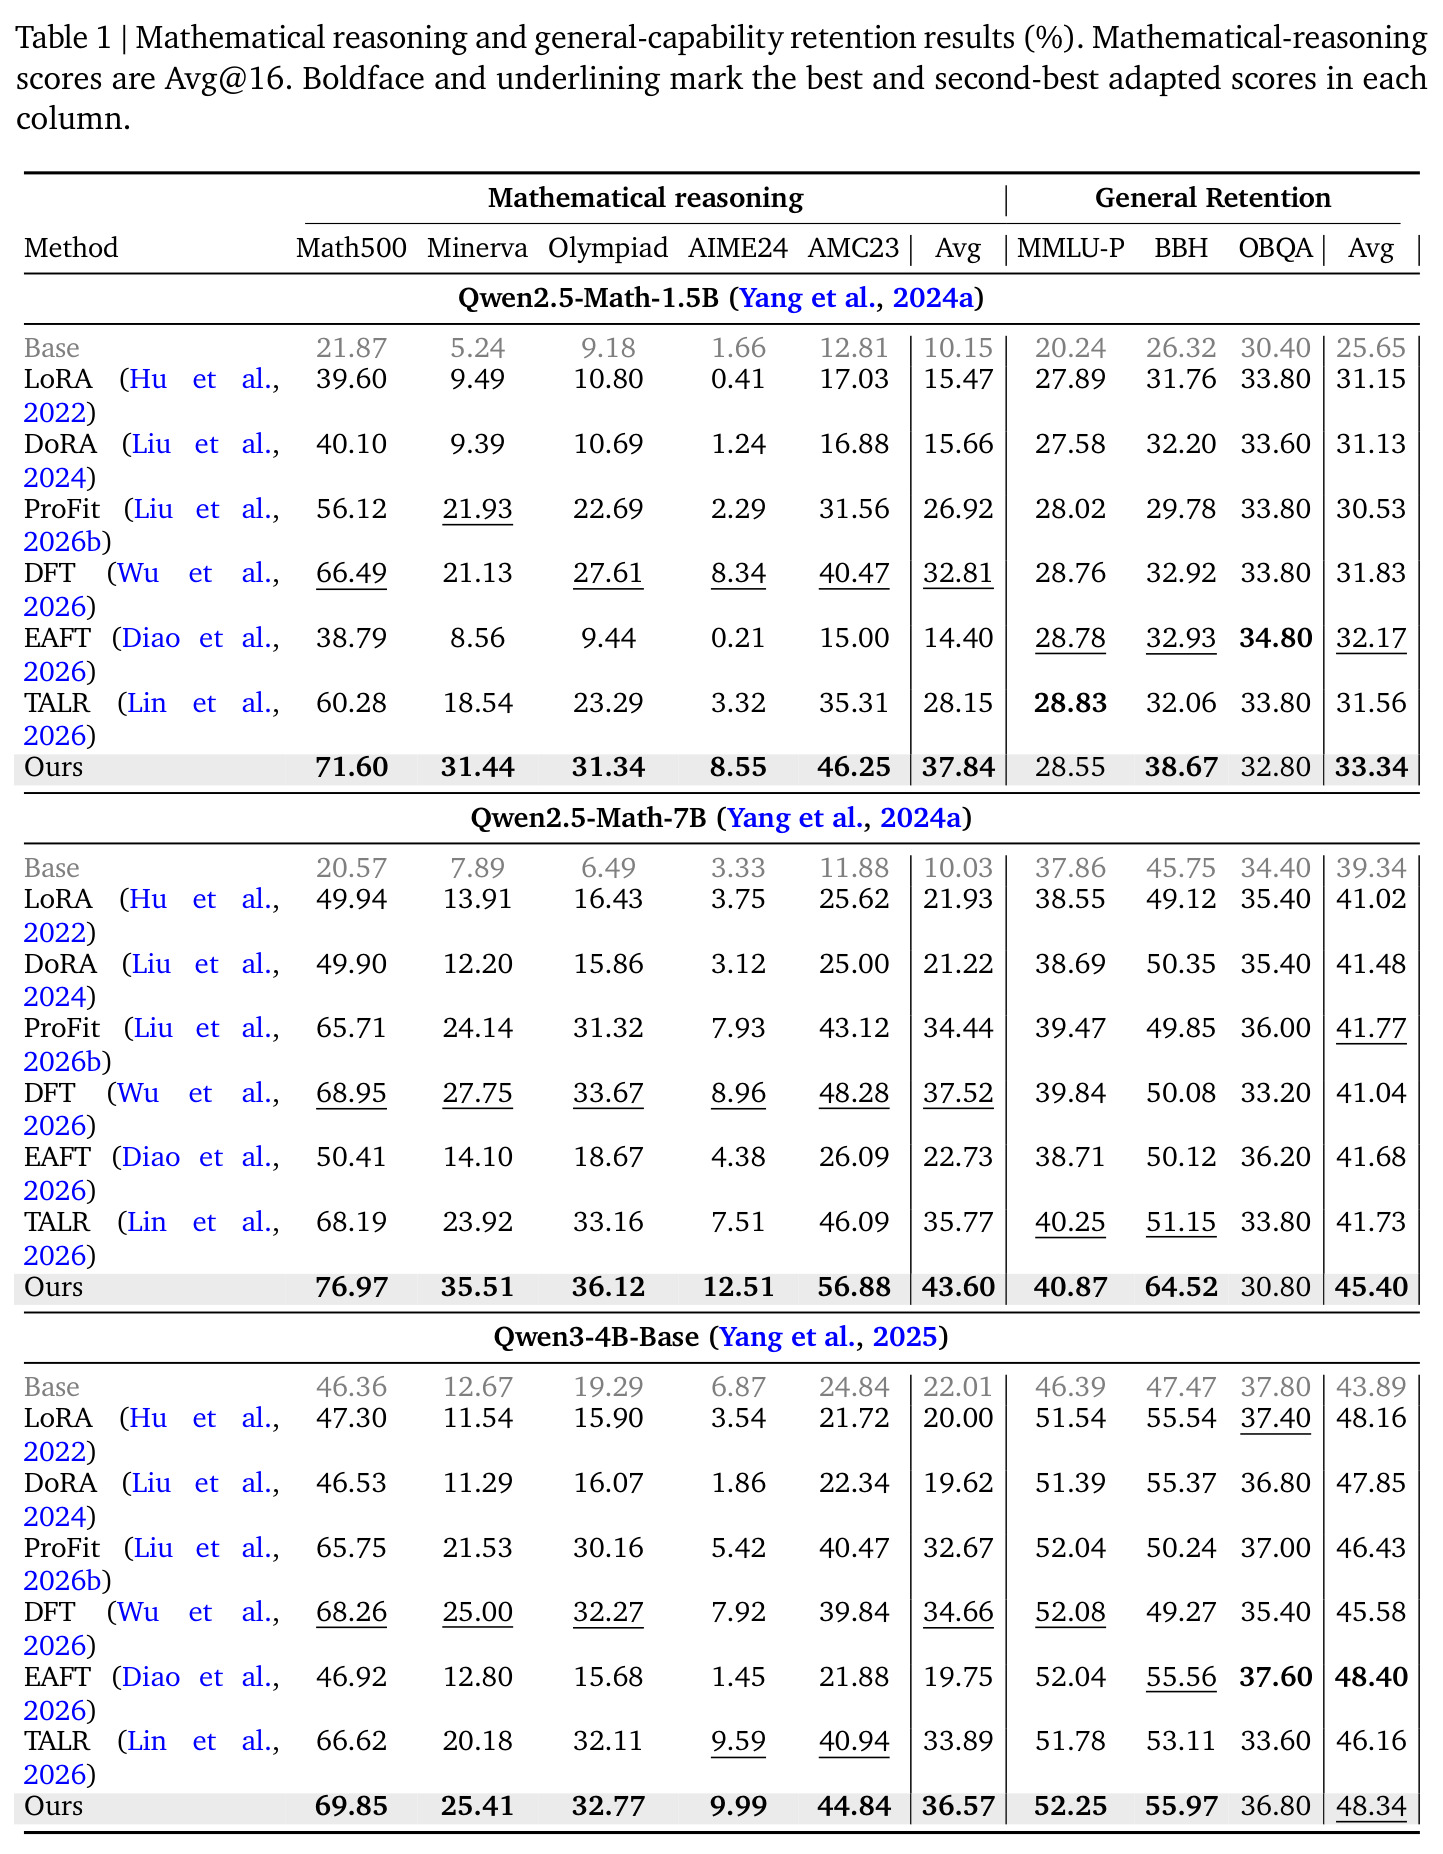
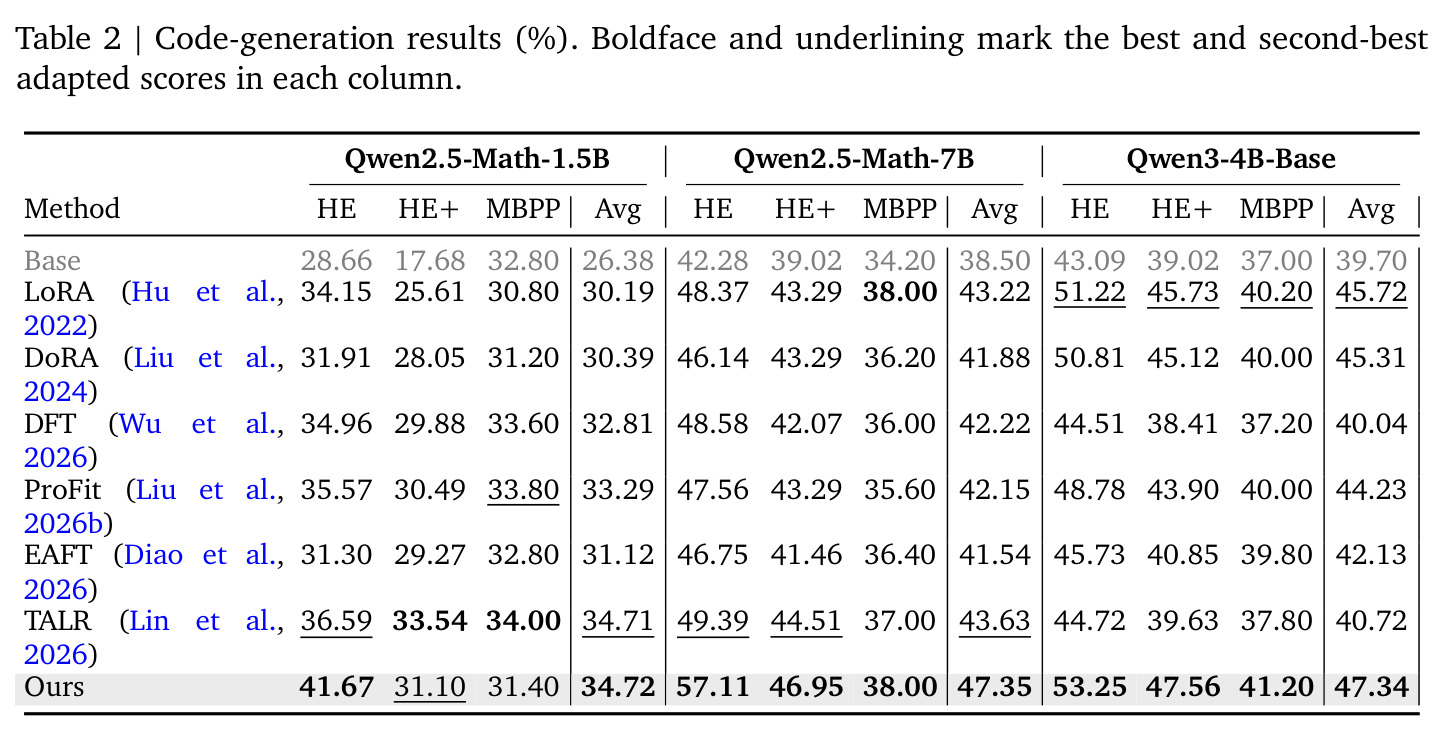
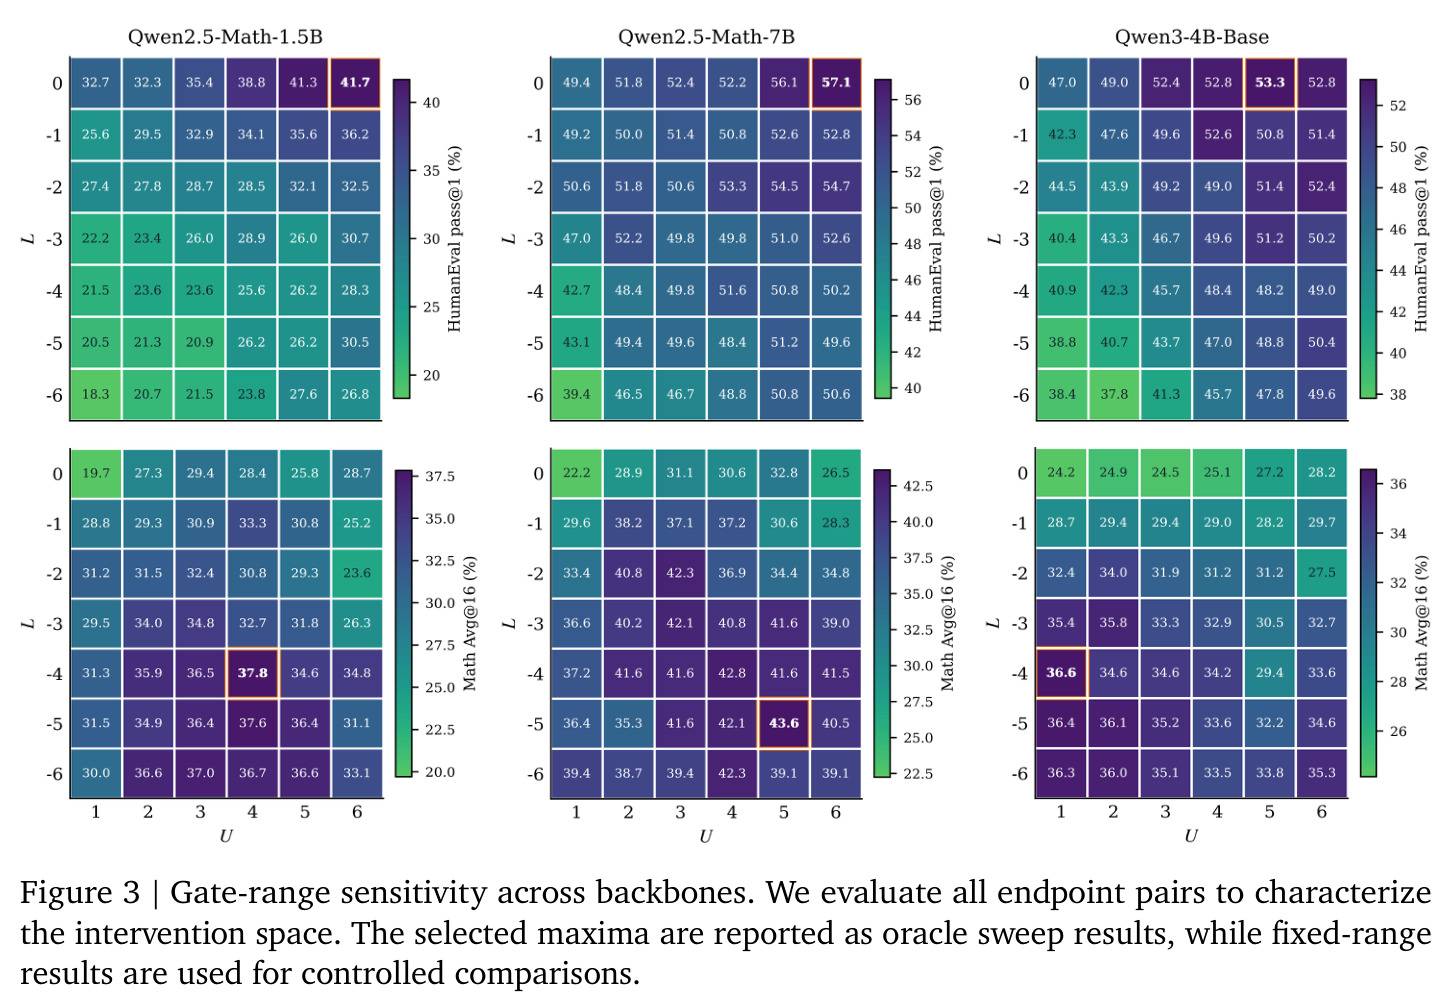
数学推理(Avg@16):Qwen2.5-Math-1.5B五基准平均37.84%,超DFT(32.81%)5.03分(Math500 71.60、Minerva 31.44、Olympiad 31.34、AIME24 8.55、AMC23 46.25);7B平均43.60%,超DFT(37.52%)6.08分(Math500 76.97、AMC23 56.88);Qwen3-4B-Base平均36.57%,超DFT(34.66%)1.91分,全部数学基准最优。通用保持:两个Qwen2.5-Math上平均最高(33.34%、45.40%,7B的BBH达64.52%),Qwen3-4B-Base上48.34%居第二。代码生成:三骨干平均均最高——1.5B为34.72、7B为47.35(HumanEval 57.11)、4B为47.34。范围分析:数学高分配置集中在负 $L$ 区(反转关键),Qwen2.5-Math还偏好 $U>1$(外推),代码高分在 $L\approx0$ 且 $U$ 较大,仅 $[0,1]$ 区间数学上已超LoRA。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(Qwen2.5-Math-1.5B,NuminaMath-CoT微调) | 五基准Avg@16平均(%) | 37.84 | DFT 32.81(LoRA 15.47) | +5.03 |
| 数学推理(Qwen2.5-Math-7B) | 五基准Avg@16平均(%) | 43.60 | DFT 37.52(TALR 35.77) | +6.08 |
| 数学推理(Qwen3-4B-Base) | 五基准Avg@16平均(%) | 36.57 | DFT 34.66(TALR 33.89) | +1.91 |
| 代码生成(Qwen2.5-Math-1.5B,Magicoder-OSS微调) | HumanEval/HumanEval+/MBPP平均(%) | 34.72 | TALR 34.71(DFT 32.81) | +0.01 |
| 代码生成(Qwen2.5-Math-7B) | HumanEval/HumanEval+/MBPP平均(%) | 47.35 | TALR 43.63(LoRA 43.22) | +3.72 |
| 代码生成(Qwen3-4B-Base) | HumanEval/HumanEval+/MBPP平均(%) | 47.34 | LoRA 45.72(TALR 40.72) | +1.62 |
| 通用能力保持(Qwen2.5-Math-7B,MMLU-Pro/BBH/OBQA) | 三基准平均(%) | 45.40 | TALR 41.73(DFT 41.04) | +3.67 |
局限与改进
作者承认的局限:Theorem 1只在门子空间熵-任务一致性假设(Assumption 1)下保证局部代理值提升,熵并非正确性oracle;有界范围限制的是模块级干预幅度而非输出发散保证;主表Ours行报告的是图3中42个 $(L,U)$ 区间扫描的最佳结果(oracle sweep),固定范围结果另作对照。我的补充观察:其一,需要两阶段训练且效果上限受Stage-I增量质量制约,若增量方向本身错误,缩放无济于事;其二,持续最小化熵可能使模型过度自信,论文未报告校准指标或熵值随训练的轨迹;其三,主结论依赖逐区间训练再挑选,实际部署成本被低估;其四,实验限于1.5B至7B的数学与代码域,指令遵循、多语言等泛化性未知;其五,门控在推理时需要对每个token位置做额外线性投影与tanh,长序列下有一定延迟开销。
独立分析的弱点
弱点一:oracle式范围选择。主表报告的是42个 $(L,U)$ 区间中的最佳结果,用户在实际使用时无法预知任务对应的最优区间,削弱了即插即用性;改进方向是为 $(L,U)$ 引入可学习的松弛参数或按任务/模型自动推荐区间的元模型。弱点二:熵最小化的副作用未量化。压低预测熵会牺牲探索性与校准度,论文未报告ECE等校准指标;改进方向是给 $F_k$ 加熵下界或与KL正则联用,观察精度-校准权衡曲线。弱点三:门控输入使用stop-gradient的隐藏态 $\mathrm{sg}(h_{m,s})$,门无法影响上游表示,信用只能在冻结特征空间内传播;改进方向是允许梯度有限穿透或做多轮交替精调。弱点四:仅在LoRA适配器上验证,对全参SFT或DoRA等其他PEFT形态的增量是否同样有效未做实验;改进方向是在全参微调场景用低秩投影近似增量再套用SCALE。
未来方向
作者提出的方向包括:multiclass情形的熵-前提分析扩展(附录H)、与自训练避免伪特征理论的联系(Chen et al., 2020)、以及附录G.3展示的推理时门控干预行为。基于本文成果可自然延伸:其一,把SCALE推广到RLVR或在线蒸馏之后的增量校准,比较熵信号与验证集正确率信号的信用分配质量;其二,与任务算术结合,对多次SFT产生的多个增量做选择性有符号融合;其三,理论侧放松Assumption 1,刻画熵下降的全局收敛行为以及门控范围的自动确定;其四,扩展到更大规模模型、多语言与多领域混合微调,检验'任务-增量对齐'假说的普适性;其五,探索门控与模型合并、MoE路由的联合训练,实现更细粒度的能力调控。
复现评估
论文给出较完整的实现细节:Stage I的LoRA配置(rank 16、alpha 16、零dropout、全线性层、1 epoch、batch 128、AdamW、峰值学习率 $5\times10^{-4}$ 数学 / $5\times10^{-5}$ 代码、cosine退火、10% warmup)、Stage II的门控参数化与 $10^{-6}$ 确定性初始化扰动、$k=100$ 的top-k熵、响应位置限制、42组 $(L,U)$ 扫描协议,数据集(NuminaMath-CoT、Magicoder-OSS)与全部评测基准均公开可得。不足:正文未提及开源代码仓库,Stage II训练时长与GPU资源未说明,且主表结果依赖42次独立门控训练加事后挑选,完整复现主表的算力开销可观。综合评估:细节足以支持独立实现,复现难度中等偏上,主要障碍是代码未开源与范围扫描的算力成本。
论文图表
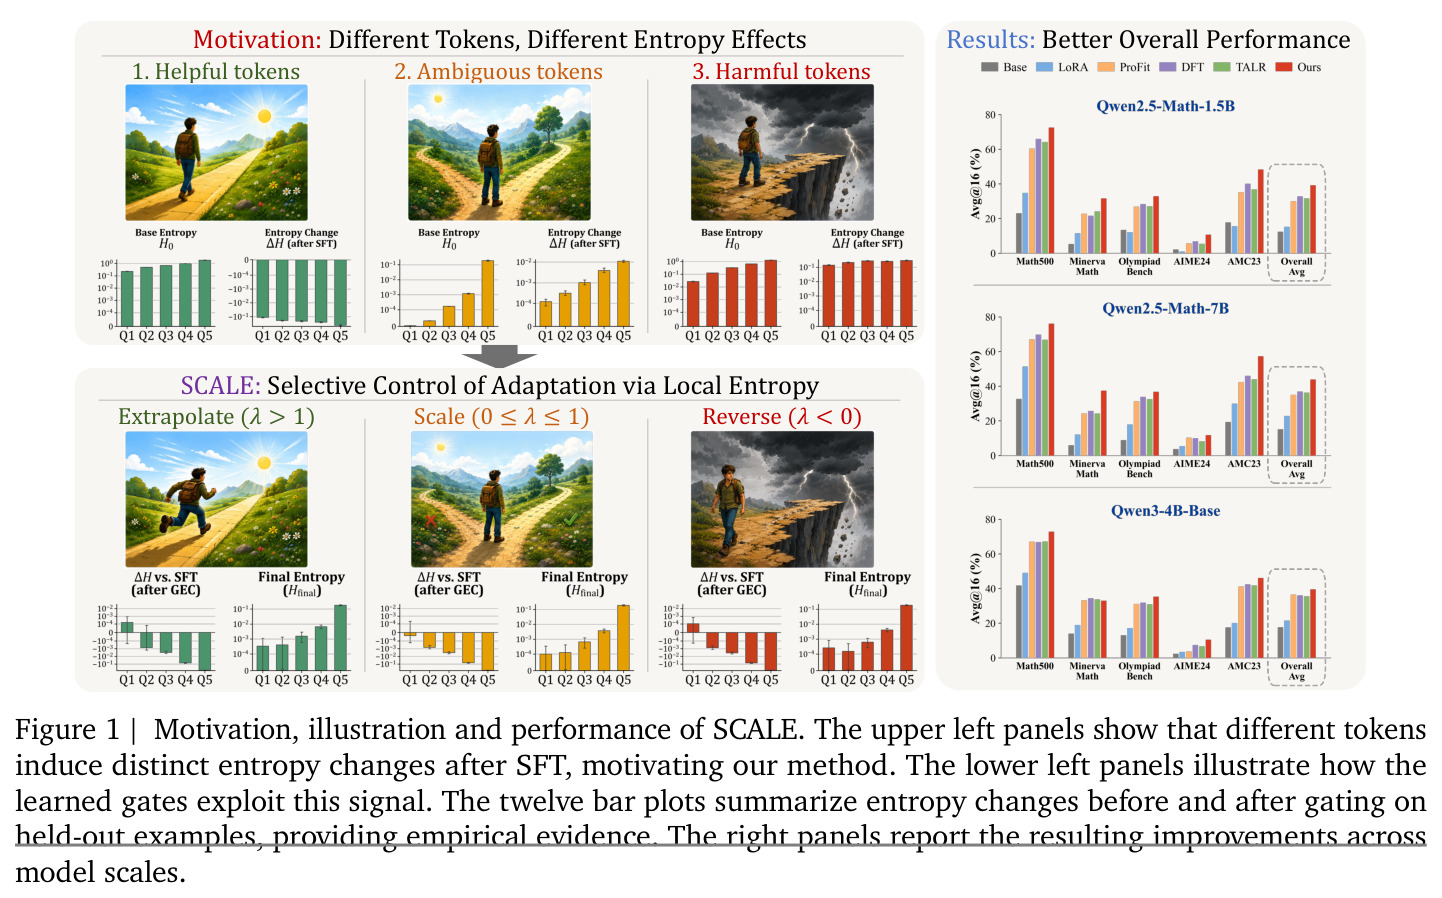
组合图。左上三组面板展示SFT后不同类型token(有益、模糊、有害)引起截然不同的熵变化,构成方法动机;左下面板示意学到的门控如何利用该熵信号,按对齐方向对冻结增量做外推($\lambda>1$)、缩放($0\le\lambda\le1$)或反转($\lambda<0$);中间十二个柱状图给出held-out样本上门控前后熵变化的实证证据;右侧面板报告三个模型规模上的性能提升。
一图浓缩了论文的动机、机制与结果:理解'不同token有不同熵效应'这一前提以及门控如何据此操作冻结增量,是把握全文逻辑的起点。