Halley:面向光学AI数据中心网络的预测式控制平面 Halley: A Predictive Control Plane for Optical AI Data Center Networks
为CPO光互连四层各配预测控制器并提前于失效行动,集群有效吞吐从65.2%升至76.5%
前置知识
共封装光学(CPO)与外部激光池
CPO把光引擎从机柜边缘搬到交换/加速器封装旁,光源改为共享的外置激光模块:NVIDIA每个ELSFP模块装8颗激光器,为交换机576条发射通道中的32条供光。激光器无法在封装内单独更换,只能整模块热插拔,池化备用与相关失效因此成为核心可靠性问题。
全文四个组件都挂在这条共享激光池→光引擎→微环→OCS链路上;不理解模块内激光器共享温控与电源,就无法理解失效为何相关、Theorem 1为何成立。
共因失效与Beta-Binomial模型
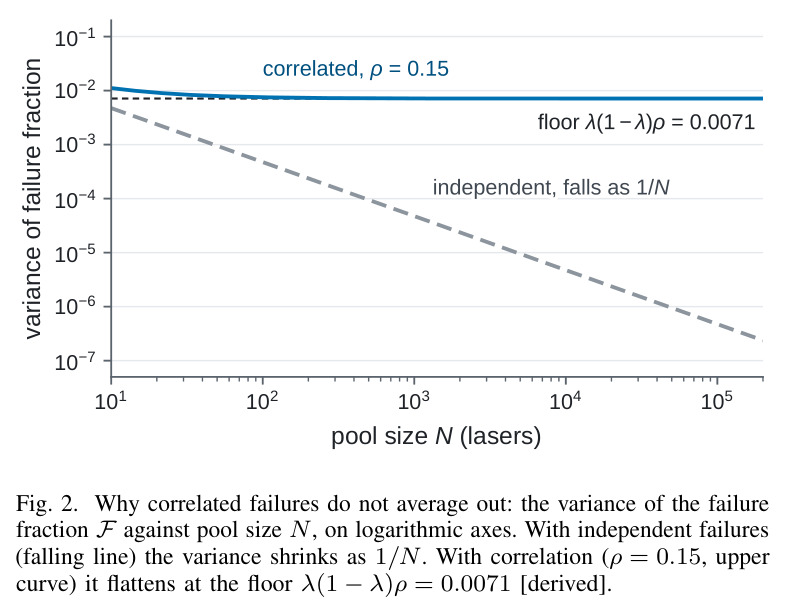
当多个器件的失效由同一温度、电源或批次事件驱动时,失效不再独立。可交换失效可用隐变量刻画:每个补给窗口先抽严重程度 $\Theta\sim\mathrm{Beta}(a,b)$,再让每颗激光器以概率 $\Theta$ 独立失效,得到beta-binomial计数分布,参数由 $\lambda$ 与 $\rho$ 决定。
Theorem 1的相关性天花板、LightReserve的覆盖计算、goodput尾部的耦合模型全部建立在这个模型上,是全文的数学骨架。
FIT率与补给窗口
FIT是可靠性工程单位:每 $10^9$ 器件小时的失效数。给定补给窗口 $t_w$,单激光器每窗失效概率 $\lambda=1-\exp(-\varphi t_w 10^{-9})$。OIF对激光源的目标50 FIT代入一年窗口约得 $4.4\times10^{-4}$。论文所有覆盖与可用度都是每窗口量。
论文的一切数字(压力点 $\lambda=0.05$、$2.4\times10^{-4}$ 阈值)都由这条换算产生,不掌握它就无法核对任何结论。
微环调制器与热失锁
微环调制器只在共振波长附近调制信号,共振点随温度漂移约70 pm/°C(硅波导实测约77 pm/°C)。偏移超过接收机锁定阈值即失锁,链路中断约200 µs直到重新捕获。现役dither锁定是反应式的:先观测漂移方向再修正。
ThermaLead的全部价值在于把修正从事后提前为一步预测,使接收机只承担预报残差 $\sigma_x\sqrt{1-R^2}$;不懂失锁物理就无法评估其门控结果。
OCS、BvN分解与MoE all-to-all
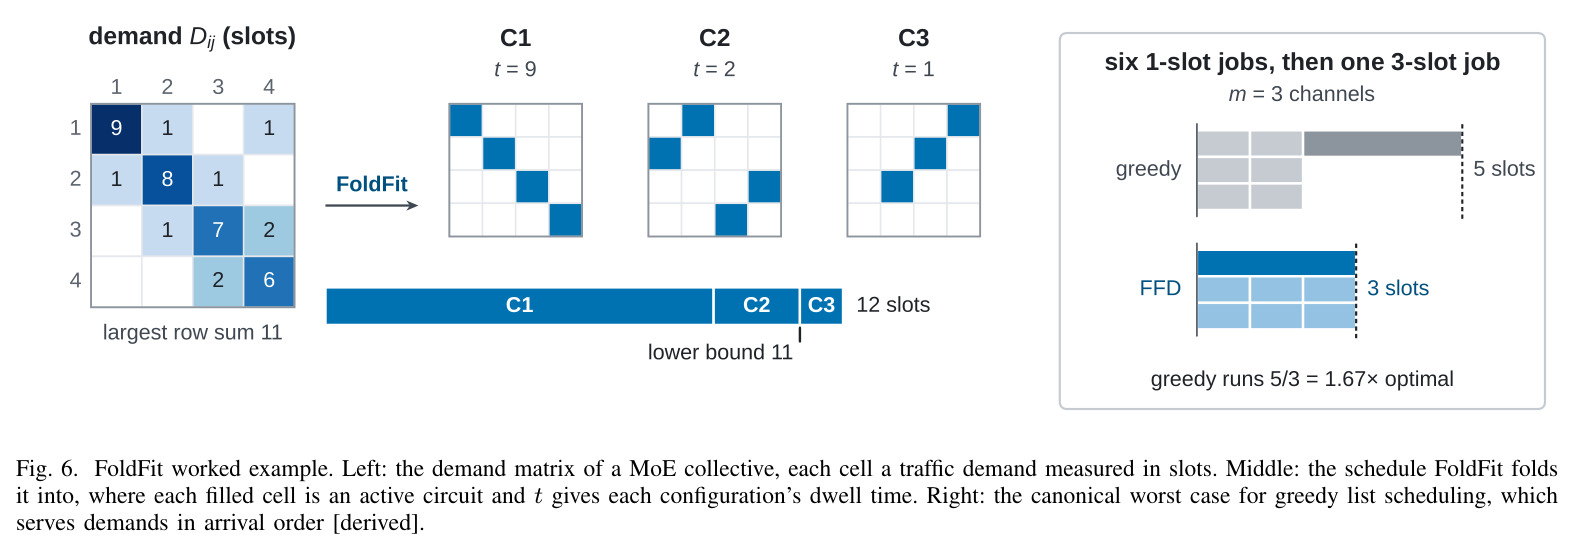
光电路交换机一次持有一组端口不相交的电路(一个configuration),切换付固定时延 $\delta$(商用约10–20 ms)。MoE训练的专家分发是all-to-all集合通信,需求矩阵块状且随专家热度漂移。经典BvN分解把矩阵拆成置换矩阵串,但配置数可达 $(P-1)^2+1$。
FoldFit正是把该调度改写为装箱以获得11/9最坏情况界;理解它替换的对象及切换时延为何被排除在界外,才能评价其边界条件。
MULTIFIT装箱与LPT调度
把任务装上 $m$ 台相同机器最小化makespan:LPT列表调度有Graham界 $4/3-1/(3m)$;MULTIFIT对截止时间二分加首次递减适配(FFD),$q$ 步后 $T^*\le(13/11+2^{-q})\mathrm{OPT}$,$q\ge5$ 时低于11/9≈1.222。FFD把任务按长度降序放入第一台还装得下的机器,截止时间不可行则上调重试。
FoldFit直接继承MULTIFIT定理,论文最硬的调度保证就是这条经典结果在OCS上的移植(外加对齐条件)。
有效集群goodput与同步屏障
训练是批量同步的:每步以集合通信收尾并充当屏障,最慢链路决定步时长,任何一次失锁、失效或重构都让全体加速器空转。有效集群goodput是理想吞吐在fabric损失后幸存的比例,本文把它分解为可用度、热损失、重构损失三个乘性因子,并区分覆盖与lit-share两种读数。
头条数字65.2%→76.5%是该量的算术组合而非联合仿真;分清两种读数才能正确解读提升幅度及其对真实训练的含义。
研究动机
AI数据中心的光互连已把光源改为共享的外置激光池:NVIDIA Quantum-X交换机有18个光子引擎、36路激光输入,由8颗激光器组成的ELSFP可更换模块供电,一个模块负责576条发射通道中的32条。问题在于同一模块内的激光器共享封装、温控与电源,一个热或电源故障会同时应力邻近激光器,失效成簇到达。而训练是批量同步的:每步以集合通信收尾并充当屏障,任何一次微环失锁、激光失效或交换重构都让全部加速器在屏障处空转。生产数据说明这不是小概率事件:Llama 3约78%的意外中断源于硬件;Meta在3.2万GPU任务中观测到每千台服务器每天2.3次中断,估计10万GPU规模每18分钟一次失效;两集群研究测得1024-GPU任务平均无故障时间仅7.9小时,且InfiniBand链路失效常在少数节点上短时爆发。现网控制面对激光池、OCS、微环、可更换模块四层各自运行固定或事后策略:备用比例一次定死、BvN分解不计切换时延、dither锁定事后修正、热备均匀分发。尤其致命的是,固定备用比例下加大池子并不能摊薄相关风险——下一轮失效同样相关,备用照样被一波打光。
本文的目标是本文要为CPO光互连数据平面的四层——共享激光池、光电路交换机、微环调制器、现场可更换模块——各配一个预测式控制器:读取每层资源的下一时刻状态,在失效发生之前行动;当预报过期或不可信时退回它所替换的现行反应式策略,使这类预报下的最坏结果不劣于现状。具体到每层,要回答四个在线分配决策:给定失效率与相关系数,备用激光池应持多少备用才能达到覆盖目标(99%、99.9%、99.999%);OCS应把需求矩阵折叠成哪些配置、各保持多久才能让总驻留时间接近最优;每个微环的加热器应预置到哪一档以抵消下一步热漂移;有限的模块级热备应优先给哪些最可能失效的模块。此外还要回答一个更根本的容量规划问题:在相关性存在时,买更多备用与物理去相关(分散热/电域、多批次采购)哪条路更便宜,以及在备用比例预算上限(2×池)约束下,99.999%这类运营商级目标是否根本不可达、需要把相关性降到多少。
与已有工作不同的是,现有工作的缺口非常具体:软件定义网络(Google Jupiter、TPUv4、MixNet、Opus)对流量或并行阶段做预测与重构,但没有任何控制面预报共封装光学硬件本身的失效——激光器失效或微环漂移。可插拔光模块的失效预测虽已在生产数据上验证(F1约0.89),却没人回答池化备用的容量问题:已知的调谐激光器备用分析(4–8颗共享备用恢复32波长链路)都默认失效独立($\rho\to0$),而分布式存储的教训表明忽略相关失效会把可用度高估约两个数量级。本文的独特切入是把可靠性工程的经典数学——de Finetti可交换性、beta-binomial共因模型、核工业共因模型——搬到AI数据中心激光池上,证明固定备用比例下存在可用度天花板,并进一步证明层级相关结构(模块内0.30、模块间0.05)下天花板由模块间相关主导,从而把去相关变成可定价、可执行的设计动作。第二个独特点是证明优先:三个组件带形式化保证(覆盖界、11/9装箱界、交换论证最优性),安全关键的回退电路经FPGA综合、130 nm签核与Yosys时序归纳机器证明。
核心方法
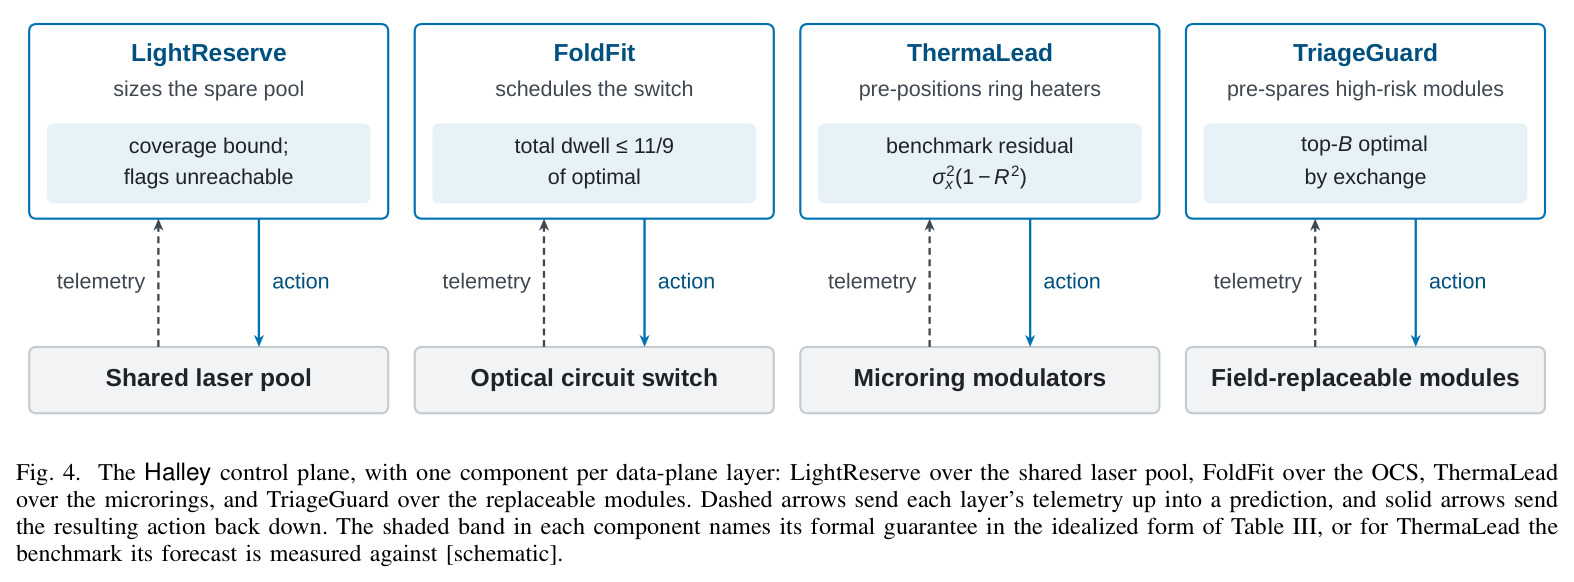
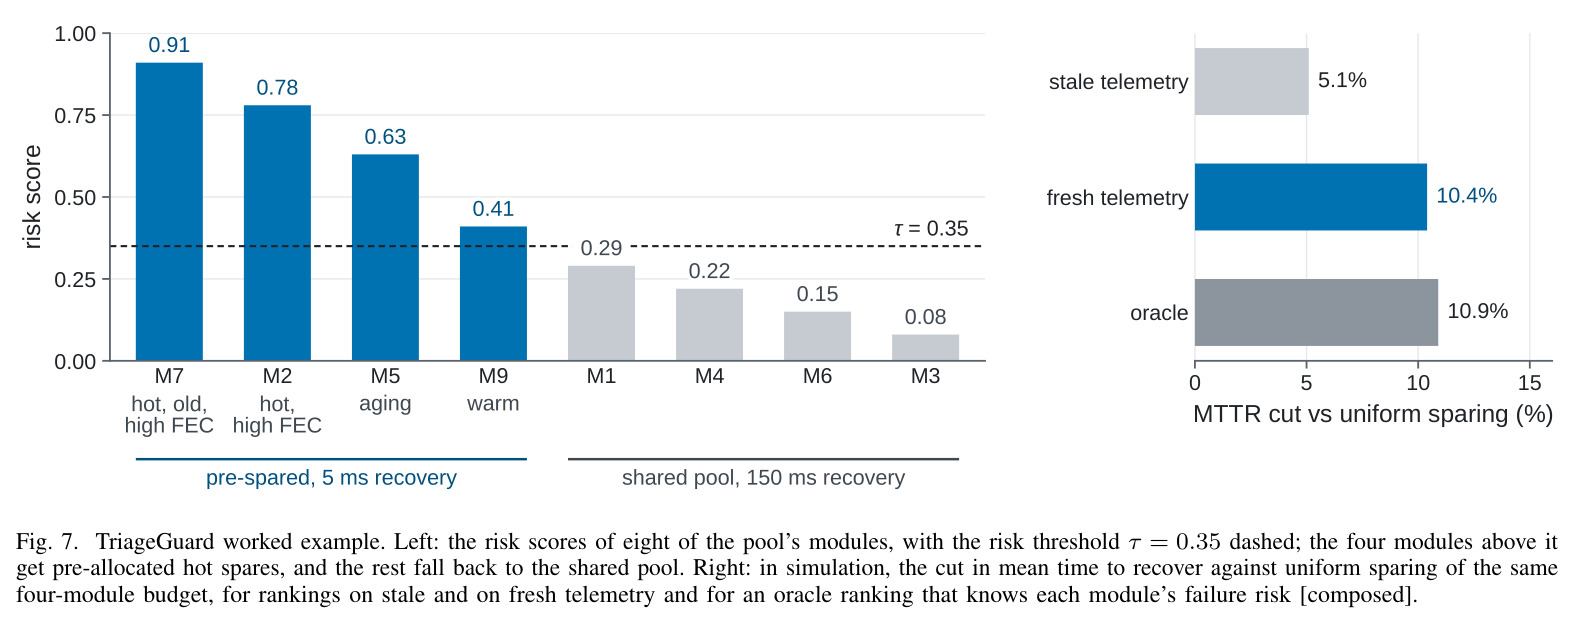
Halley的直觉是保险学式的:预测、冗余加分级回退。fabric四层各自面对一个可预测的随机过程(失效计数、需求矩阵、热漂移、模块风险),现行系统要么把策略一次定死,要么只在事件发生后反应。Halley给每层配一个预测控制器:读遥测、预报下一状态、提前行动;每个控制器带一条被证明或被基准化的保证,并共用一条回退规则——当预报过期、置信度低或超时时,一个20 µs级硬件看门狗把执行器切回现行反应式策略,使最坏情况不劣于现状。技术上四条腿走路:LightReserve用beta-binomial覆盖模型按 $\lambda$ 与 $\rho$ 计算最少备用数,预算内不可达则输出去相关目标;FoldFit把OCS调度改写成 $m$ 台并行机的装箱问题,对截止时间二分并运行FFD,继承MULTIFIT的 $(13/11+2^{-q})\mathrm{OPT}$ 界;ThermaLead用8样本滑动平均预报下一步温漂并预置加热器,把接收机看到的偏移压缩为预报残差;TriageGuard按温度、役龄、FEC bin给模块打风险分,用交换论证证明保护风险最高的 $B$ 个模块恰好最优。
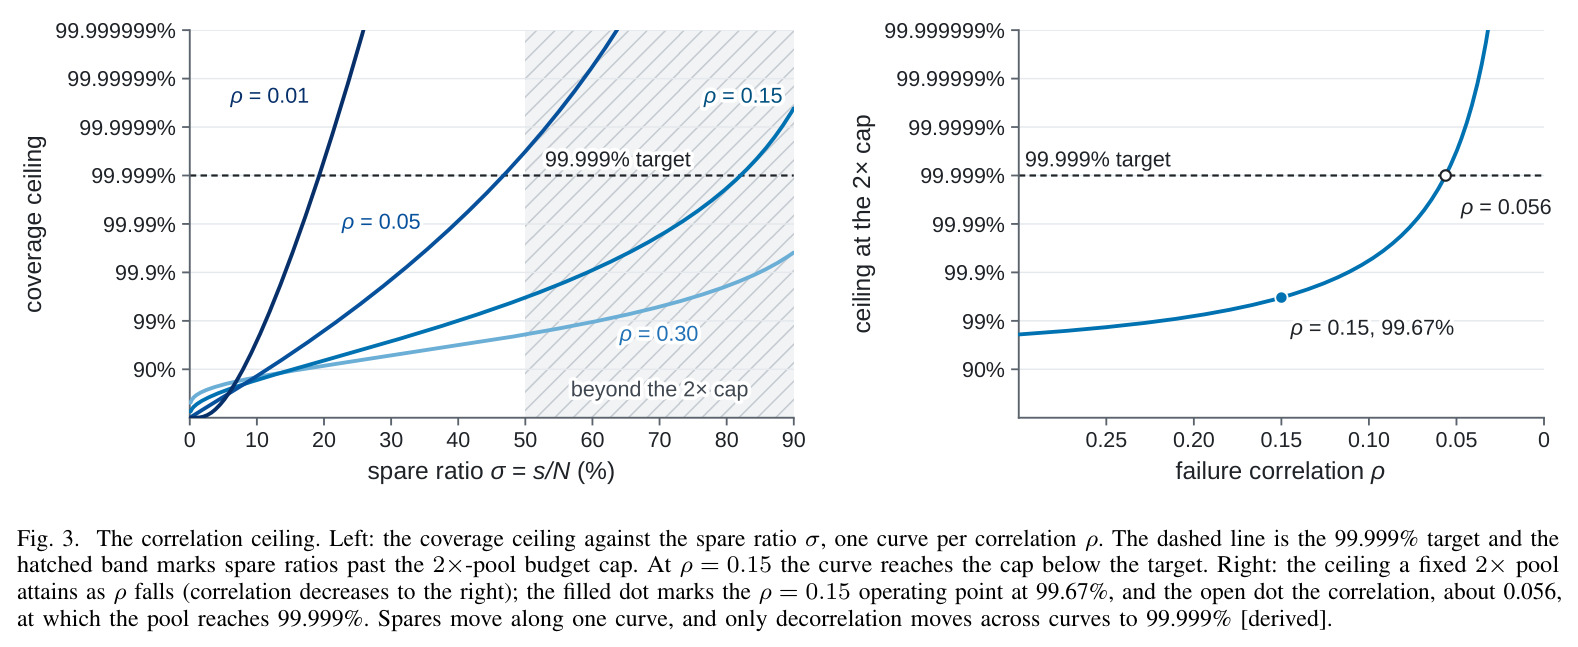
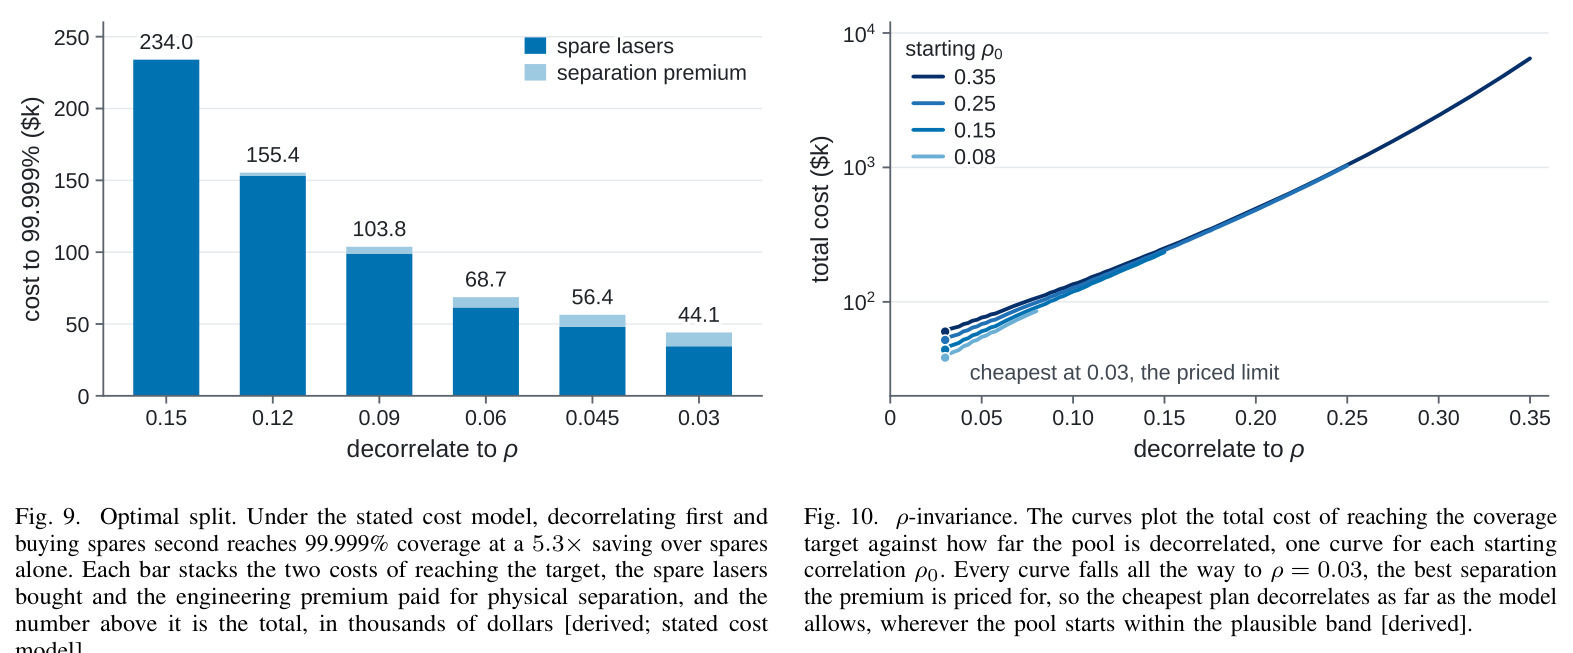
核心创新是把预测控制与形式化保证绑定,并把失效相关性当作一等设计对象。区别有三。第一,LightReserve的备用数来自覆盖界而非固定比例:Theorem 1证明可交换正相关失效使失效比例收敛到随机水平 $\Theta\sim\mathrm{Beta}(a,b)$,固定备用比例的可用度有闭式天花板 $A^*=F_{\mathrm{Beta}}(\sigma;a,b)<1$——压力点($\lambda=0.05$、$\rho=0.15$)下2×池的天花板是99.670%,池再大也到不了99.999%。于是加备用不是可行方向,唯一出路是降 $\rho$:成本模型证明先分散热/电域再按剩余相关性买备用比纯买备用便宜5.3倍,且方向在 $\rho_0\in[0.08,0.35]$ 全带内不反转。第二,FoldFit把MoE需求矩阵调度从无界启发式或配置数可达 $(P-1)^2+1$ 的BvN分解改为装箱,首次给出不依赖流量假设的OCS最坏情况界 $T^*\le(11/9)\,\mathrm{OPT}$。第三,ThermaLead把微环稳频从反应式dither改为一步前馈预置,接收机只承担预报残差 $\sigma_x\sqrt{1-R^2}$,并配门控回退:预报误差大于原始漂移时自动退回dither。
方法步骤详情
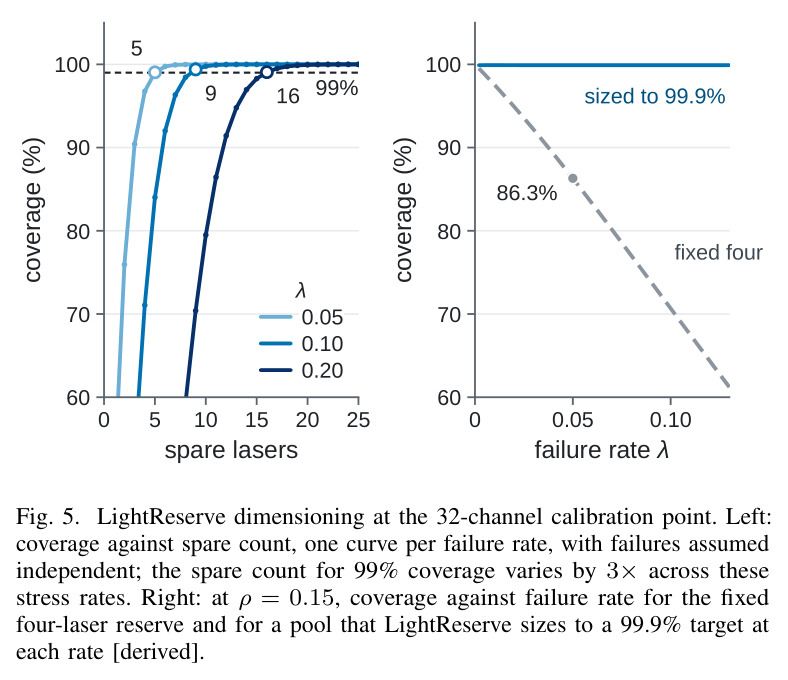
(1) LightReserve:输入 $n$、$\lambda$、$\rho$、目标 $A_{tgt}$;把总池 $N=n+s$ 建模,算覆盖 $A(s)=\Pr[F\le s]$(Beta-Binomial),二分搜索最小 $s^*$;超过预算上限 $\sigma_{max}$ 则报UNREACHABLE并输出去相关目标 $\rho'$。32通道标定点:独立失效99%目标要5颗备用,$\rho=0.15$ 时23颗;99.9%要49颗;99.999%要156颗被标记不可达,改输出 $\rho\le0.046$。(2) FoldFit:输入需求矩阵 $D$、通道数 $m$、MoE块结构;先算三个下界(最大单需求、平均负载、最忙端口行列和),二分搜索截止时间 $T$,每个候选下FFD从长到短装箱,$q\ge5$ 步后 $T^*\le(11/9)\mathrm{OPT}$;平局时保持同一专家块同配置以便复用;4×4算例用3个配置达1.09倍,BvN需5个配置。(3) ThermaLead:输入每环温度历史、斜率70 pm/°C、阈值25 pm;8样本滑动平均预报下一步 $dT/dt$ 并预置加热器;近16步误差高于原始漂移时门控退回dither。(4) TriageGuard:输入风险分排序、预算 $B$、阈值 $\tau$(算例0.35)、切换5 ms对未命中150 ms;预置风险最高的 $B$ 个模块,其余回落共享池。
技术新颖性
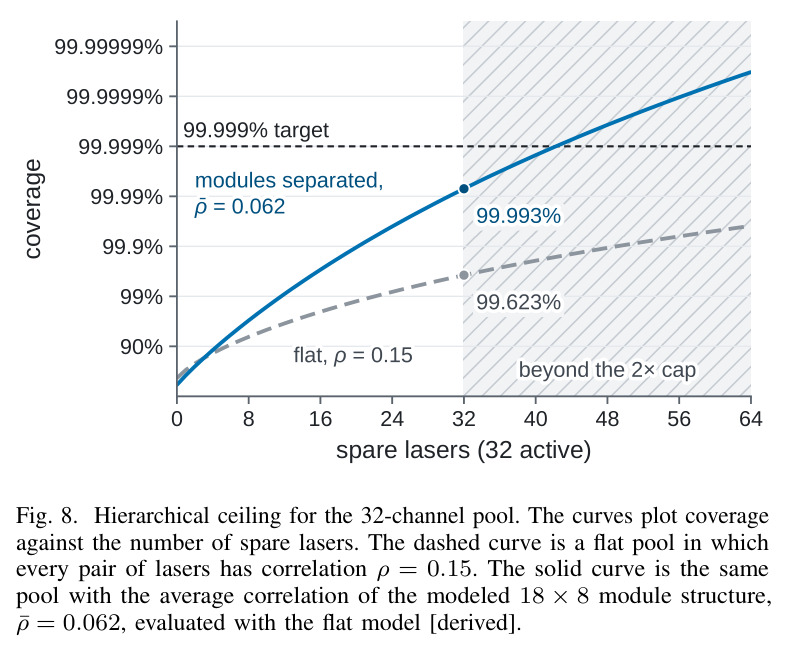
技术新颖性可从四个维度评估。概率建模上,把de Finetti可交换性与beta-binomial共因模型从核安全、存储可靠性搬到CPO激光池,并给出层级版Theorem 2:18模块×8激光器、模块内 $\rho=0.30$、模块间 $\rho=0.05$ 时天花板由模块间相关主导(模块内项被 $1/M$ 压掉),池平均相关约0.062使覆盖从99.623%升到99.993%——把去相关从模糊建议变成模块间分离优先于模块内分离的明确设计规则。调度上,首次把MULTIFIT的11/9界引入OCS调度($q\ge5$ 步二分加Yue精确常数13/11),比Graham LPT的 $4/3-1/(3m)$ 更紧($m\ge4$ 时),并针对MoE块结构加了保持专家块同配置的平局规则;对齐步在可分裂需求下精确、不可分裂下留作开放问题,论文诚实标注。控制上,ThermaLead的预置加门控提供了不比现状差的可验证回退路径。实现上,安全核心按测试驱动开发写RTL,四条Yosys时序归纳机器证明逐一验证,每个数字都带溯源标签([derived]/[composed]/[synth; pnr; verified]),这种纪律少见;主要弱点是组合goodput是算术组合而非联合仿真,组件间交互未被建模。
实验结果
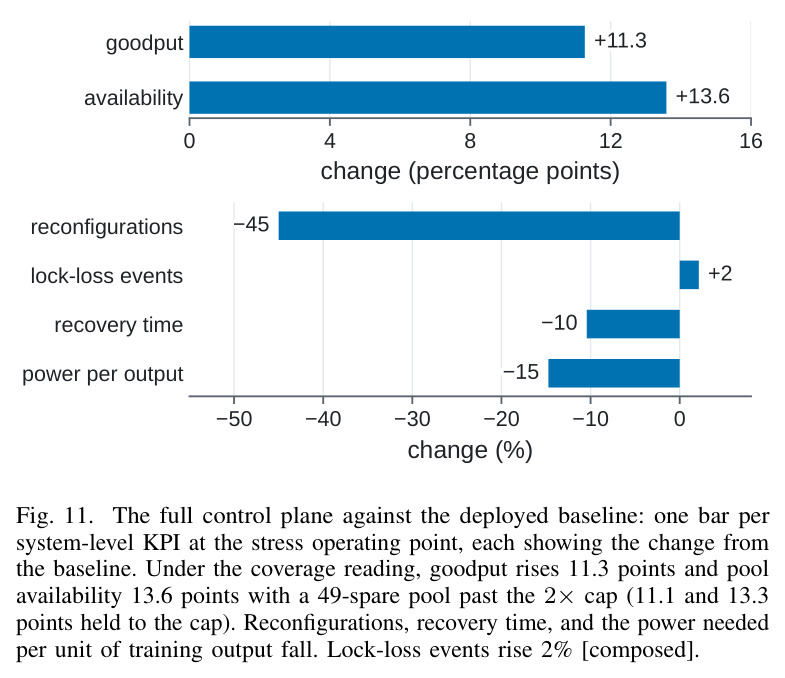
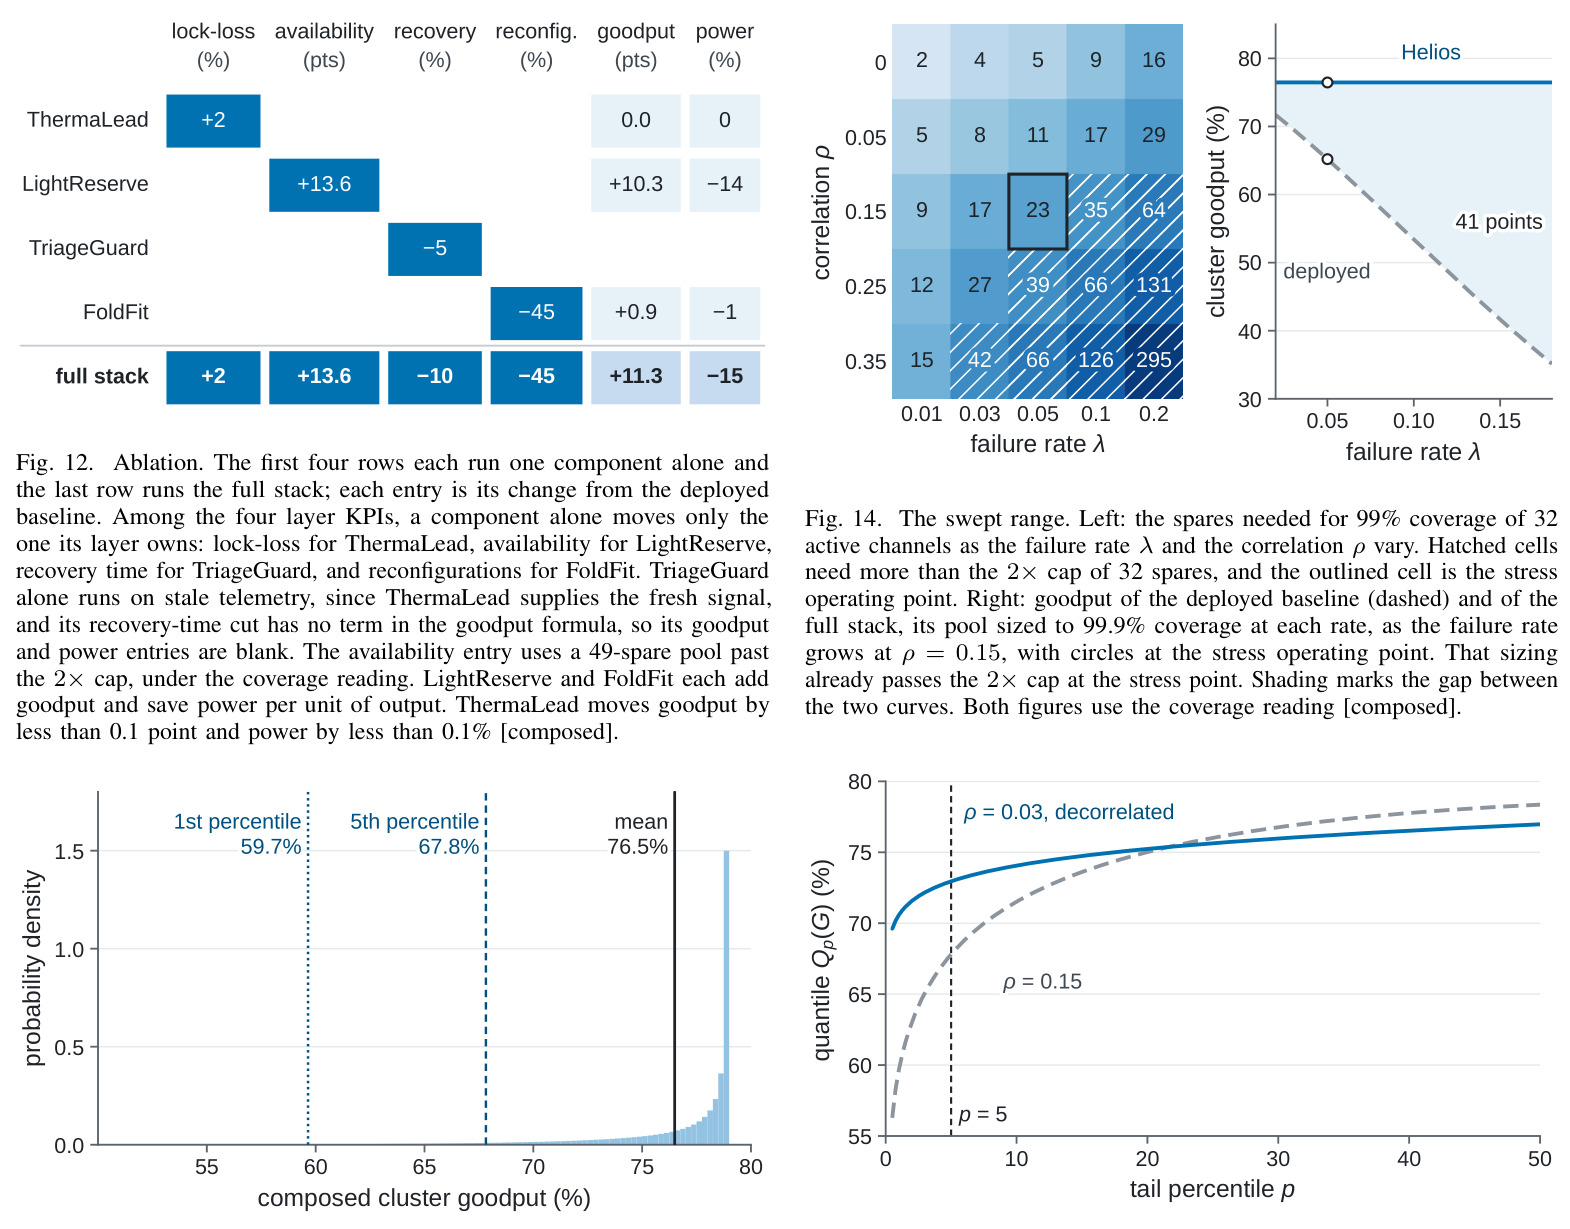
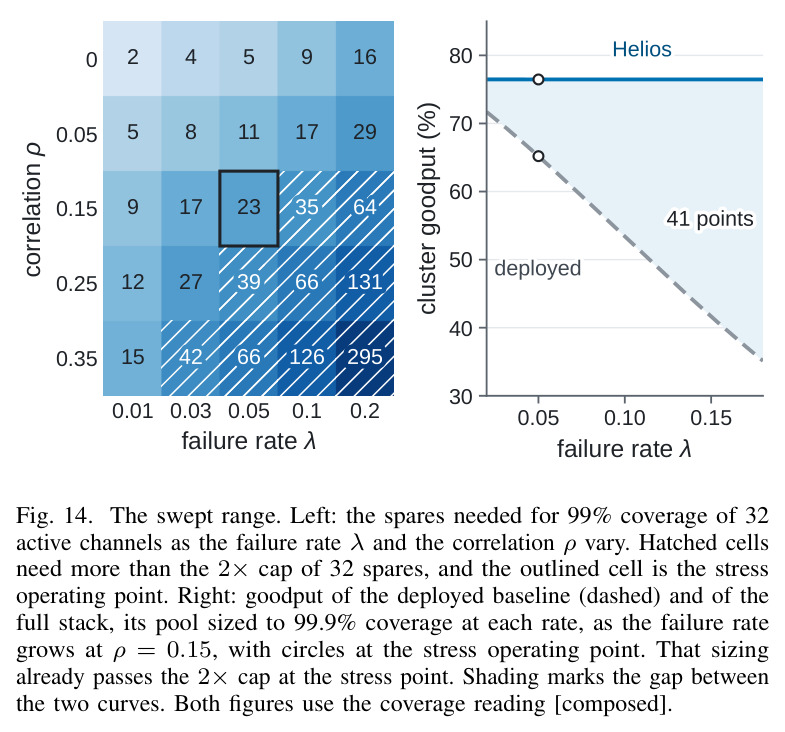
(1) 天花板:压力点 $\lambda=0.05$、$\rho=0.15$ 下2×池天花板 $A_{crit}=99.670\%$;32通道池固定4颗备用覆盖仅86.3%;99.999%在2×上限内不可达当且仅当 $\lambda$ 超过约 $2.4\times10^{-4}$(50 FIT下补给窗口超约200天即跨过)。(2) 层级模型:模块内 $\rho=0.30$、模块间 $\rho=0.05$ 时池平均相关约0.062,覆盖从99.623%升至99.993%,18×8嵌套模型在2×上限达99.997%。(3) 成本:先去相关到 $\rho=0.03$ 再买23颗备用共$44,100,纯备用路径$234,000,省5.3倍,且在 $\rho_0\in[0.08,0.35]$ 内方向不变。(4) FoldFit:makespan距下界全部实例不超过6%、16引擎起平均约1%;专家块保持规则把重构代理指标比LPT降45%。(5) ThermaLead:dither失锁462/2000步,裸预测472($p=0.003$),门控后452;噪声突发降到10%步时少22%、无突发少78%;oracle为315。(6) TriageGuard:拦截质量从0.222升到0.307(oracle 0.311),MTTR降10.4%。(7) 组合goodput:覆盖读数65.2%→76.5%(+11.3点,相对+17.3%),可用度因子独占10.3点;lit-share读数仅67.4%;耦合尾部第5百分位67.8%、第1百分位59.7%;50 FIT下增益缩至约1.3%;$\lambda=0.18$ 时上限内73.2%对基线35.1%。(8) 硬件:133 LUT(2.52%),10种子68.97–74.69 MHz闭合,130 nm版图过9个签核角,回退最坏延迟20.02 µs。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 激光池覆盖度(32通道,λ=0.05,ρ=0.15,99%目标) | 每窗口覆盖概率 | 99%(LightReserve定容:23颗备用) | 固定4颗备用 | 覆盖86.3%→99%(备用4→23颗) |
| 99.999%覆盖的获取成本 | 总成本(备用+分离溢价,所述成本模型) | $44,100(先去相关到ρ=0.03,再买23颗备用) | $234,000(156颗备用,ρ=0.15不变) | 成本降为约1/5.3 |
| 有效集群goodput(压力点,覆盖读数) | 理想吞吐幸存比例 | 76.5%(第5百分位67.8%) | 65.2%(标定锚点) | +11.3个百分点(相对+17.3%) |
| OCS调度(MoE all-to-all,16引擎) | 重构次数代理指标与最坏makespan界 | 比基线少45%;界 T*≤(11/9)OPT | LPT随机放置(Graham界4/3−1/(3m));BvN分解配置数无界 | 重构−45%;最坏界从约1.33收紧到1.22 |
| 微环防失锁(压力热轨迹,2000步) | 失锁事件数 | 452(门控ThermaLead) | 462(dither锁定) | −2.1%;平滑漂移下最多−78% |
| 模块热备分配(18模块,预算4) | MTTR相对均匀分配的降幅 | −10.4%(ThermaLead新鲜遥测排名) | 均匀热备(拦截质量0.222) | 拦截质量0.222→0.307,MTTR降幅约翻倍 |
| 回退电路硬件(iCE40UP5K / SkyWater 130nm) | 闭合频率与占用面积 | 133 LUT(2.52%),68.97–74.69 MHz(10种子);130nm块0.022 mm²过9个签核角 | 50 MHz目标频率 | 时序裕量≥38%;通过DRC/LVS/天线检查(未流片) |
局限与改进
作者承认的局限:失效输入是假设——$\rho=0.15$ 没有该形态激光器的实测支持,$\lambda=0.05$ 是压力设定(约1000 FIT六年不换),外部锚点(OIF 50 FIT目标、Broadcom约3000 FIT端口抖动上限)口径不一;FoldFit的11/9界依赖三个条件,其中对齐步只在需求可分裂时精确、不可分裂情形证明开放,且界不含切换时延 $\delta$(商用OCS 10–20 ms,仅3–6 s以上相位可忽略);ThermaLead是唯一在压力轨迹上输给现状的组件(472对462次失锁),价值取决于现场漂移平滑度,突变瞬态下未门控赤字扩至49–67%;Proposition 1只覆盖goodput中相关驱动的系统部分;覆盖与lit-share两读数是情形而非界。我的观察:65.2%基线是标定锚点而非仿真值,全栈76.5%由算术组合而非联合仿真得出,组件间交互未建模;两个损失份额各设3%纯属假设,相对增益对2倍扫动稳健(16.5–18.9%)但绝对值带宽很宽;TriageGuard的风险误差0.30/0.05是假设,且oracle与新鲜遥测仅差0.004,说明4/18的预算太小、排名再准收益也有限;收益折算到真实训练取决于fabric的归因份额——按Llama 3口径(约1/10中断源于网络)覆盖读数增益缩到约1.7%。
独立分析的弱点
(1) 全文无硬件测量——所有系统数字来自Python仿真与闭式求值,微环伺服虽在FPGA闭环验证,被控对象却是二阶热模型,70 pm/°C、8°C热循环、25 pm阈值都是文献拼接。(2) $\rho$ 不可测使核心建议悬空:5.3倍节省依赖 $\rho_0\in[0.08,0.35]$ 先验带,作者自认需几千池·年暴露才能估计;若实测 $\rho$ 远低于0.08,固定4颗备用已够用,LightReserve失去对象。(3) goodput组成把三个因子当乘性独立项;看门狗只防过期、低置信预报,不防自信但错误的系统性误报导致的过度重构,论文承认这类预报没有任何下界。(4) FoldFit的MoE平局保持规则(−45%重构代理)在11/9证明覆盖之外,仿真又省略端口条件与对齐步,makespan证据与重构证据之间有裂缝。(5) 2×预算上限是外部假设,论文扫了 $\lambda$ 与 $\rho$ 却没扫 $\sigma_{max}$;训练之外场景(推理KV缓存迁移、RL权重同步)明确无保证,标题略宽于实际证明范围。改进方向:为不可分裂对齐找常数近似;用真实封装遥测替换两个3%假设;把TriageGuard与LightReserve在统一计数下联合优化。
未来方向
作者列出的开放问题:最关键的测量是跨车队记录每颗激光器的失效时间戳,按补给窗口统计计数相对二项期望的过散程度来估计 $\rho$,需几千池·年暴露;记录候选共因(温度、电源、批次)可把 $\rho$ 归因到机理,且应报告完整每窗分布,因为Theorem 1与Proposition 1都依赖 $\Theta$ 的尾部而非方差;一个仪表化封装可标定两个组合损失份额,一个真实任务可确定fabric的归因份额。ThermaLead需要匹配现场漂移的预报器并感知状态切换,与最快反应环路(BER驱动跟踪71.4 nm/s、内核启动的加热器预驱)的比较仍开放。FoldFit在不可分裂需求下的对齐证明、把切换时延 $\delta$ 纳入界、与Sunflow的 $\min((11/9)\mathrm{OPT}+k_r\delta,2\times\mathrm{Sunflow})$ 组合调度;自信但错误预报的形式化伤害界。遥测接口标准化:OIF与ELSFP管理框架都未定义每环温度和锁定状态,作者呼吁发布每激光器健康与失效时间戳、每环温度与锁定状态、交换重构钩子的管理接口。可延伸方向:把层级天花板反向用作封装布局约束(按风险分组摆放激光器以直接设计模块间相关);用分位数规划替代均值规划做容量设计;统一两层备用的联合优化;推理与RL流量的可用度收益建模。
复现评估
复现条件相当好。软件与硬件实现公开在作者页面(IIT Madras,文献[13]的zip包,密码在文献中注明为halley123):包含RTL源码、testbench、机器证明、构建脚本、130 nm版图流程、组件模拟器(含ThermaLead基线、门控与突变扫描)、组合模型、跨工作负载仿真和画图脚本。开源工具链版本全部钉死:Icarus Verilog 12.0、Yosys 0.33、nextpnr 0.6、Project IceStorm icetime、LibreLane 3.0.14;FPGA目标iCE40UP5K是低价量产芯片(另有ECP5-25移植),作者独立重建的每个种子都能闭合时序。仿真用NumPy/SciPy固定种子,每张图带溯源标签,四条Yosys时序归纳证明的日志随包发布,400万次蒙特卡洛与闭式分位数一致到 $2\times10^{-4}$。算力门槛低:闭式与仿真在笔记本可跑,FPGA综合几分钟级。难点在三处:闭式结果依赖假设参数($\lambda$、$\rho$、成本模型),复现数字容易、验证结论需接受这些先验;硬件闭环的热对象是模型植物,无真实CPO封装可测;$\rho$ 的现场测量需要超大规模运营者的数千池·年数据,学术界无法独立完成。总体评级:模拟与RTL复现为容易到中等,结论的外部验证在论文范围之外。
论文图表
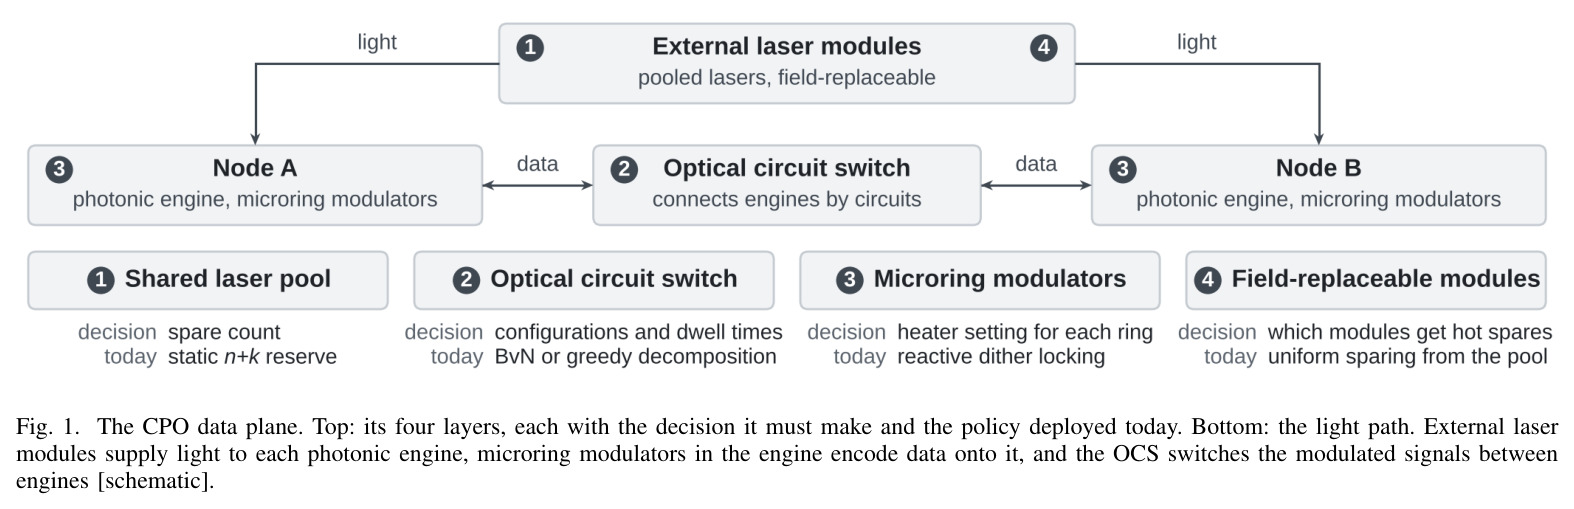
上半部画出数据平面四层(共享激光池、OCS、微环调制器、现场可更换模块)各自必须做的在线决策与今天部署的固定/事后策略;下半部画出光路:外置激光模块给每个光子引擎供光,微环调制器把数据编码到波长上,OCS在引擎之间交换整条光路。
一图定义全文研究对象——四层决策与被替换的现行策略,与Fig. 4的控制面一一对应,是理解后文组件划分的地图。
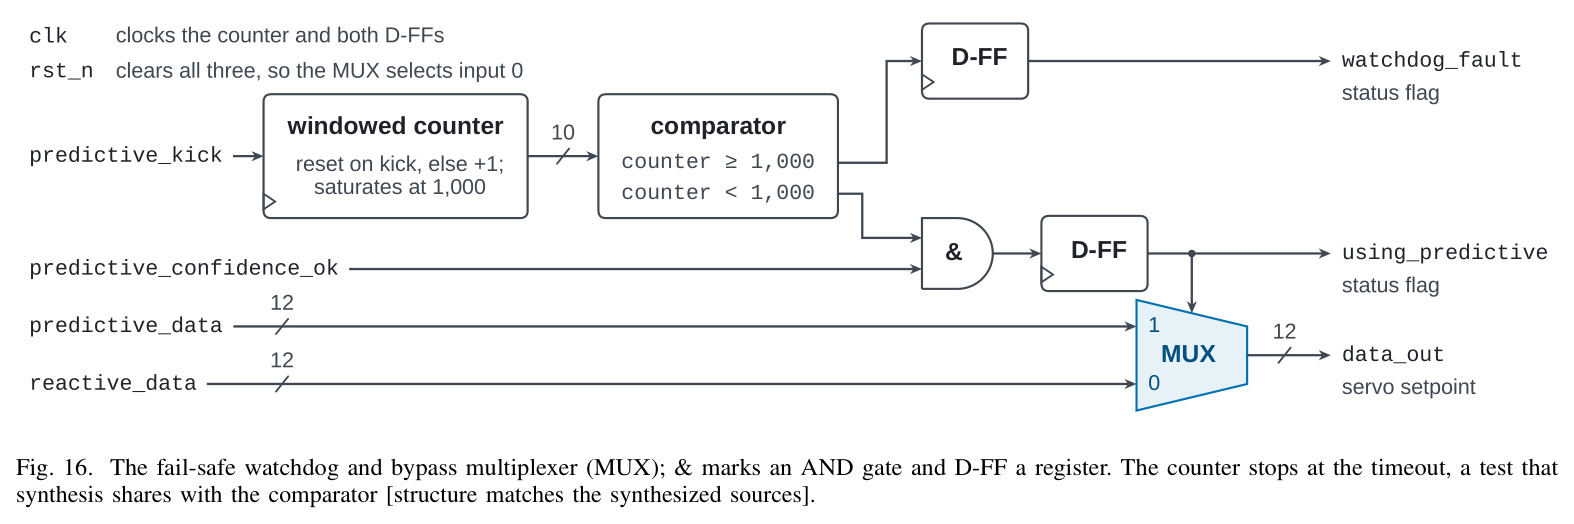
看门狗与旁路复用器电路:窗口计数器(predictive_kick复位、否则加一并饱和于1000周期)、比较器、寄存的using_predictive标志与输出MUX;崩溃、挂起、低置信或复位都会让反应式路径在至多一个信任窗口(50 MHz下20 µs,合计20.02 µs)内接管执行器,新kick后2个时钟恢复预测路径。
回退规则是最坏不劣于现状这一承诺的硬件执行者,也是全文唯一被机器证明(对独立黄金模型)的路径。
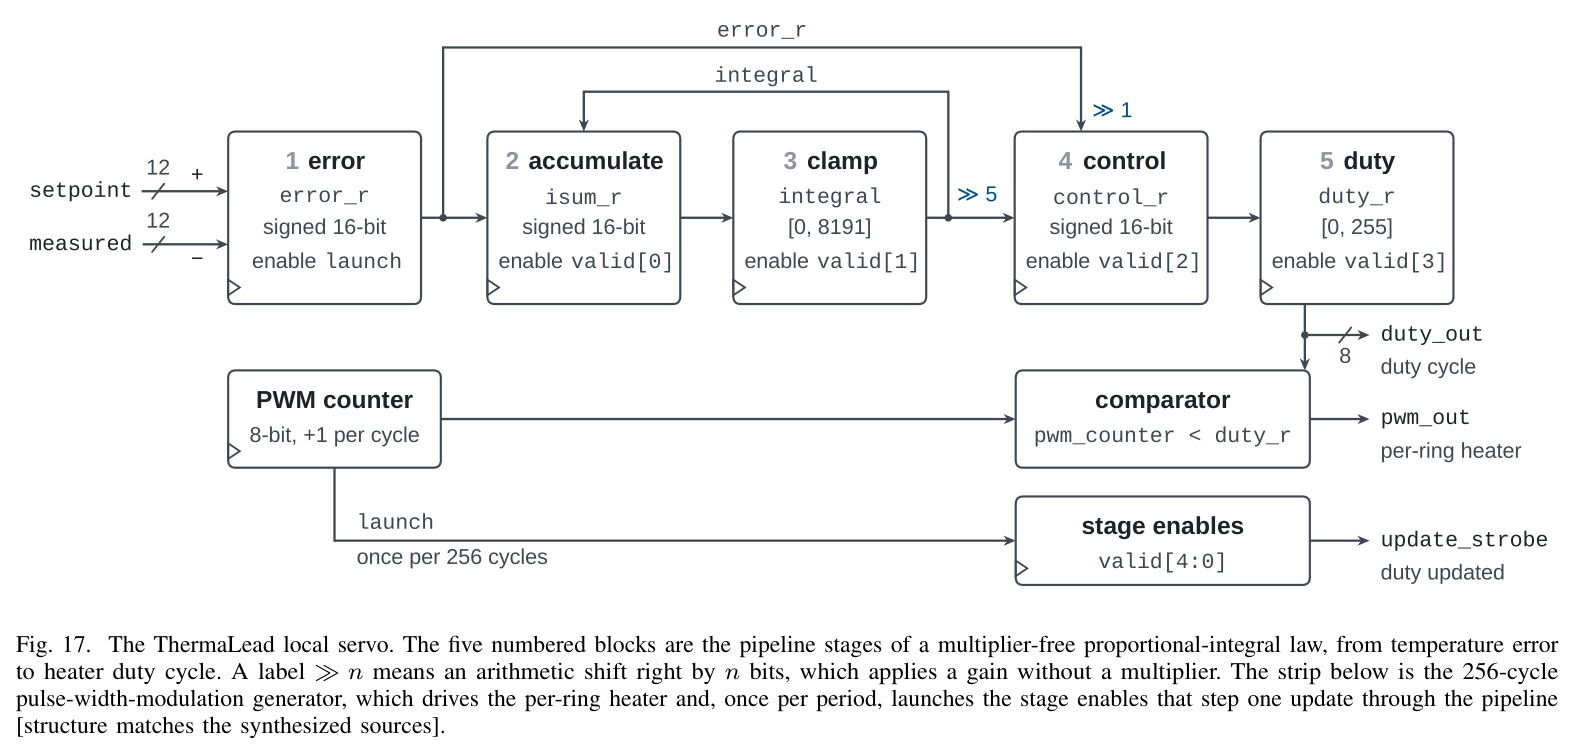
ThermaLead本地伺服的五级流水:误差→累加→钳位→控制→占空比,实现无乘法器的PI律(1位算术移位做比例增益、5位做积分增益),累加器钳位于[0,8191]、控制量钳位于[0,255];下方256周期PWM发生器(50 MHz下5.12 µs)驱动每环加热器并按周期启动流水线。
展示预测控制如何在2.52%的LUT预算内落地,也是闭环稳定性扫描(31个可行角点、0.2–3.7 ms整定)的对象。
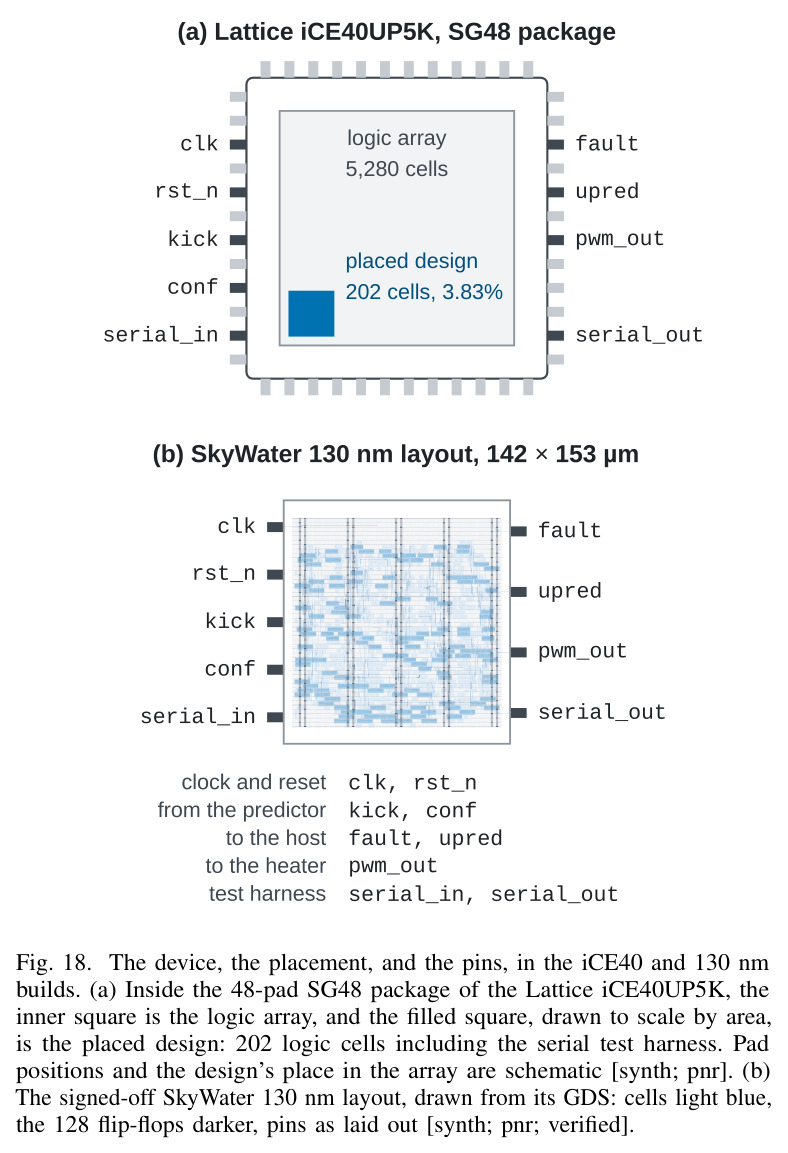
(a) iCE40UP5K的48脚SG48封装内部:逻辑阵列中已布局设计占202个逻辑单元(3.83%,含串行测试壳);(b) 签核的SkyWater 130 nm版图(由GDS绘制):142×153 µm、0.022 mm²、128个触发器、995个标准单元,通过DRC/LVS/天线检查但未流片。
证明可今天构建的部分不止是FPGA演示,还能以可签核形式映射到商用130 nm工艺,大幅增强硬件主张的可信度。
全文符号表:池规模 $N$、活动通道 $n$、备用数 $s$ 与比例 $\sigma$、每窗失效概率 $\lambda$、FIT率 $\varphi$ 与窗口 $t_w$、相关系数 $\rho$、Beta参数 $a/b$、隐变量 $\Theta$、天花板 $A^*$ 与目标 $A_{tgt}$、预算上限 $\sigma_{max}$、模块数 $M$ 与每模块激光器 $L$、模块内/间相关、阈值 $\tau$、切换时延 $\delta$、环偏移标准差 $\sigma_x$ 与自相关 $R$ 等。
论文符号密度高且横跨概率、调度、控制三个领域,查阅定理、算法与公式时是必备的对照表。
把激光FIT率(50/250/500/976)与补给窗口(90天/1年/6年)换算成每窗失效概率 $\lambda$,给出2×池的大池天花板 $A_{crit}$ 与99.999%所需备用数($\rho=0.15$ 对独立失效)。例如50 FIT+1年:$\lambda=4.4\times10^{-4}$、$A_{crit}=99.9985\%$、需39颗(独立只需2颗);压力行976 FIT×6年:$\lambda=0.05$、$A_{crit}=99.6697\%$、需156颗对10颗。
一张表把运营商目标何时不可达的边界条件定量化:2.4×10⁻⁴阈值、200天/40天的补给窗口临界值都由此表读出。
四个组件的对照表:各自的数据面层、决策(备用数 $s^*$、配置与驻留时间、加热器预置、热备分配)、理想化形式的保证(覆盖界、总驻留不超过最优的11/9、MMSE残差 $\sigma_x^2(1-R^2)$、交换论证下top-B最优)与反应式回退(静态n+k备用、BvN或贪婪分解、dither锁定、共享池均匀分配)。
方法的权威索引:每个组件替换什么、保证是什么、失效时退到哪里,一表看全;也明确标出ThermaLead没有保证只有基准。
综合占用与时序:看门狗36 LUT/12 FF/92.54 MHz;伺服97 LUT/78 FF/81.98–87.01 MHz;合计133 LUT/90 FF(占2.52%),10个布局种子闭合于68.97–74.69 MHz;加SPI传感器路径161 LUT、10/10种子闭合且高于50 MHz;独立icetime分析给出71.33–74.79 MHz。另有ECP5移植196.97–211.91 MHz。
硬件主张的全部定量证据:面积可忽略、时序在所有种子和两种时序模型下都闭合,直接支撑回退路径今天可建的结论。