FlowTranslator:基于流编辑的免训练图像内机器翻译 FlowTranslator: Training-Free In-Image Machine Translation with Flow-Based Editing
免训练流编辑框架,用RCR与CE轨迹控制破解文本区编辑点火失败,图像内翻译超越训练系统
前置知识
流匹配与校正流
流匹配是一类生成建模方法:训练一个速度场 $v_\theta(z,t,c)$,把高斯噪声沿常微分方程(ODE)输运到数据分布;校正流进一步把这条路径拉直,使采样只需几十步。Z-Image-Turbo 这类蒸馏后的 6B 流匹配文生图模型即以此为基础,给定文本条件 $c$ 与噪声水平 $t$,网络预测该点的速度方向。
本文的渲染器完全建立在冻结流模型预测的速度之上,所有创新都作用于速度差和采样轨迹。
FlowEdit 免训练图像编辑
FlowEdit 在源条件 $c_{\mathrm{src}}$ 与目标条件 $c_{\mathrm{tgt}}$ 之间构造一条免反演的 ODE:每步用同一个冻结模型分别评估源分支和目标分支的速度,取速度差 $\Delta v_t = v_\theta(\hat{z}^{\mathrm{tar}}_t,t,c_{\mathrm{tgt}}) - v_\theta(\hat{z}^{\mathrm{src}}_t,t,c_{\mathrm{src}})$ 来更新编辑潜变量。两分支共享同一噪声 $\epsilon$,其语义差驱动编辑发生。
FlowTranslator 直接以 FlowEdit 为渲染底座,理解分支耦合机制才能看懂 RCR 与 CE 两个改进。
图像内机器翻译(IIMT)
IIMT 要求把图像中嵌入的文字替换为译文,同时保持背景、字体、透视和光照不变。主流级联方案分三步:OCR 定位并识别文字、机器翻译、把译文渲染回原区域。渲染环节最难:早期擦除原文再贴字会留下接缝,后来的 GAN/扩散场景文字编辑器需要成对的跨语言训练图像。
本文正是要替换级联中最脆弱的渲染环节,问题定义与全部评测协议都围绕 IIMT 展开。
多语言文字渲染的 T2I 模型
新一代流匹配文生图骨干(如 Z-Image-Turbo)已能根据描述直接生成清晰的非拉丁与 CJK 文字。这意味着无需专门训练,只要给对条件,冻结模型本身就把中文等文字画进图像的能力,这是免训练 IIMT 得以成立的前提;反过来,骨干不认识的文字系统就写不出来。
免训练方案的脚本覆盖完全继承自骨干模型,论文中西里尔文渲染失败正源于此。
BLEU、COMET 与 SSIM
BLEU 用 n-gram 重合度衡量生成文本与参考译文的相似度(本文用 sacreBLEU 13a 分词,EasyOCR v1.7 回读);COMET 是基于跨语言编码器的语义质量评分,更接近人工判断;SSIM 衡量编辑前后图像的结构相似度,反映背景保持能力。ScenePair 上还用 PP-OCRv6 识别器计算整图精确匹配率 ACC。
三个指标分别度量文本正确性、语义质量与视觉保真,论文全部结论都围绕它们展开。
研究动机
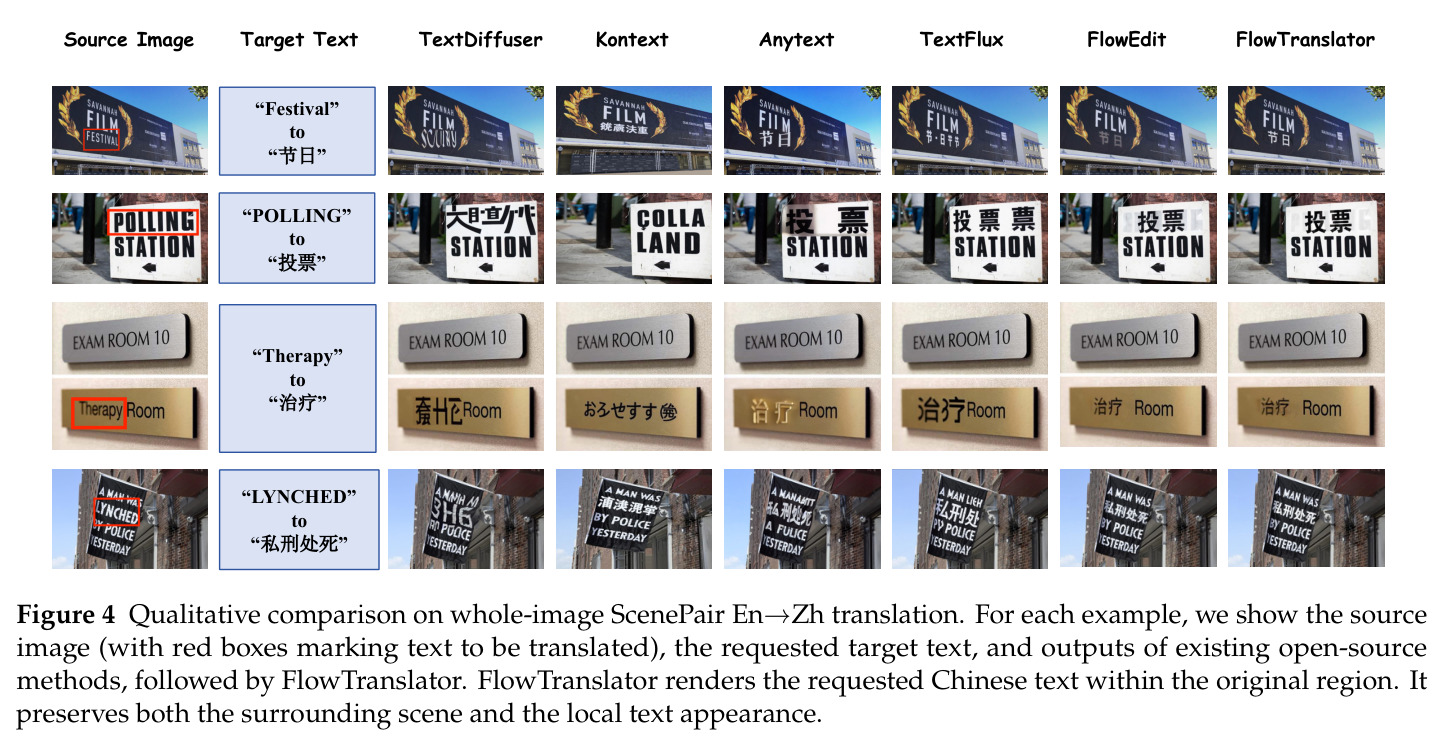
图像内机器翻译(IIMT)的级联方案(OCR→翻译→渲染)中,前两步已相当成熟,瓶颈集中在渲染环节。现有场景文字编辑器从 GAN 进化到扩散模型(AnyText、TextFlux、DiffSTE 等),但它们都需要“同一场景、源语言与目标语言文字并存”的配对训练图像——这种跨语言配对除少数高资源语向外极其稀缺,训练管线只能退而使用合成贴字图片,导致编辑器见过的字体、版式与背景种类严重受限。作为对比,最强的 IIMT 专用系统 UniTranslator 需要在约 700 万领域样本对上微调。更麻烦的是,真实照片里文字往往只占画面极小比例(招牌上几个字),训练出来的编辑器在这种小文字区场景上非常脆弱:论文在 1280 张 ScenePair 真实照片上实测整图英译中时,TextDiffuser、DiffSTE、FLUX.1-Fill、Kontext 四个已发布系统的精确匹配率全部低于 0.4%。
本文的目标是本文要把 IIMT 级联中的训练渲染环节彻底替换为免训练方案:不更新、不微调任何参数,只用冻结的公开预训练模型完成“定位—翻译—回写”全流程,并在三个公开基准上与训练型系统正面比拼。具体量化目标:在 TTV 四个方向上平均 BLEU 不低于最强训练系统 UniTranslator 的 21.17;在 PRIM 五个方向上平均 BLEU 与 COMET 全面领先;在 1280 张真实 ScenePair 照片的整图英译中任务上,精确匹配 ACC 显著超过支持中文的 AnyText 的 36.80%。最终它以平均 BLEU 23.19、PRIM 20.6/57.2、ACC 40.08% 达成全部目标,且全程只跑在一块 RTX 4090 上。
与已有工作不同的是,作者的独特切入点是诊断出耦合流编辑在“文字少数派”场景下的点火失败:FlowEdit 的更新由源/目标两分支的速度差驱动,其演示场景(换物体、改风格)会改动画面大片区域,速度差早早出现;而 IIMT 只改一小块文字,两分支在 $t\approx 1$ 附近几乎重合,$\Delta v_t$ 与位移都趋近零——零位移是这个更新的不动点,单纯调大速度增益 $\gamma$ 无济于事,因为没有信号可供放大。此前 TextFlow 只验证了免训练流编辑在单词条裁剪上能与训练编辑器打平,没有人把免训练编辑推到“自动定位+全图多区域+跨语言”的完整 IIMT 任务,也没人系统研究过小编辑区的点火问题。RCR 与 CE 这对掩码内轨迹控制正是针对这一被忽视的机制空档提出的。
核心方法
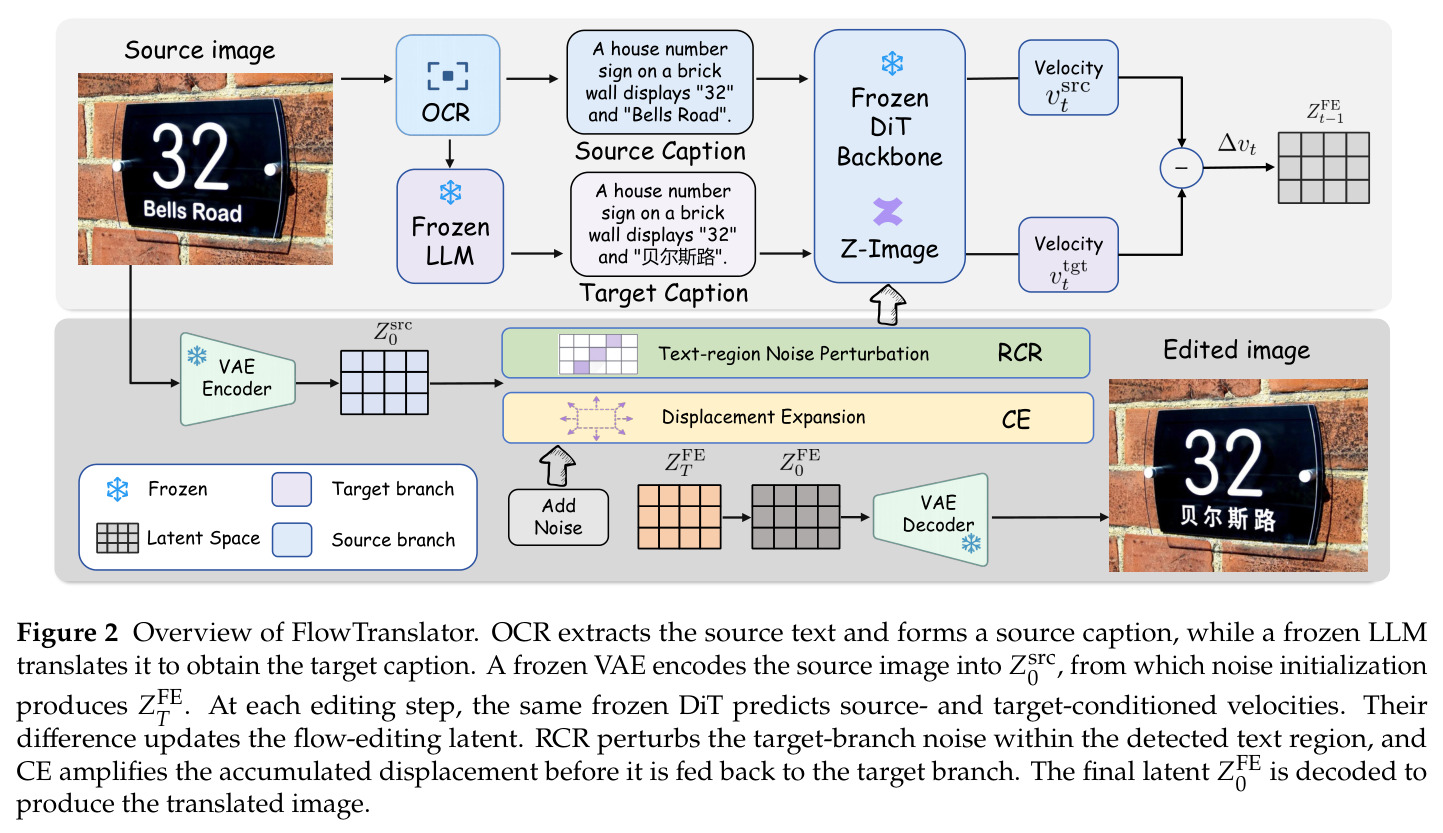
直觉上,FlowTranslator 像请一位“绝不动笔到文字区以外”的画师重写招牌:把原图连同“画面里有引号原文”的描述交给冻结的文生图模型,再给它一份只把引号内文字换成译文的描述,让模型内部两条推理路径的速度差自动把文字改写出来。技术路线分四步:(1) PP-OCRv5 检测并识别所有文字框;(2) 一次调用 LLM(Doubao-Seed-2.0-lite)完成翻译,并产出严格同构的源/目标两条场景描述 $c_{\mathrm{src}}$、$c_{\mathrm{tgt}}$,两者只有引号内文字不同;(3) VAE 把原图编码为 $Z_{\mathrm{src}}^0$,文字框在潜空间分辨率栅格化并膨胀 15% 得到掩码 $M$;(4) 在 Z-Image-Turbo(6B 蒸馏流模型,$T=50$ 步)上运行区域掩码版 FlowEdit,并叠加 RCR 与 CE 两个轨迹控制,最后 VAE 解码输出译文图像。
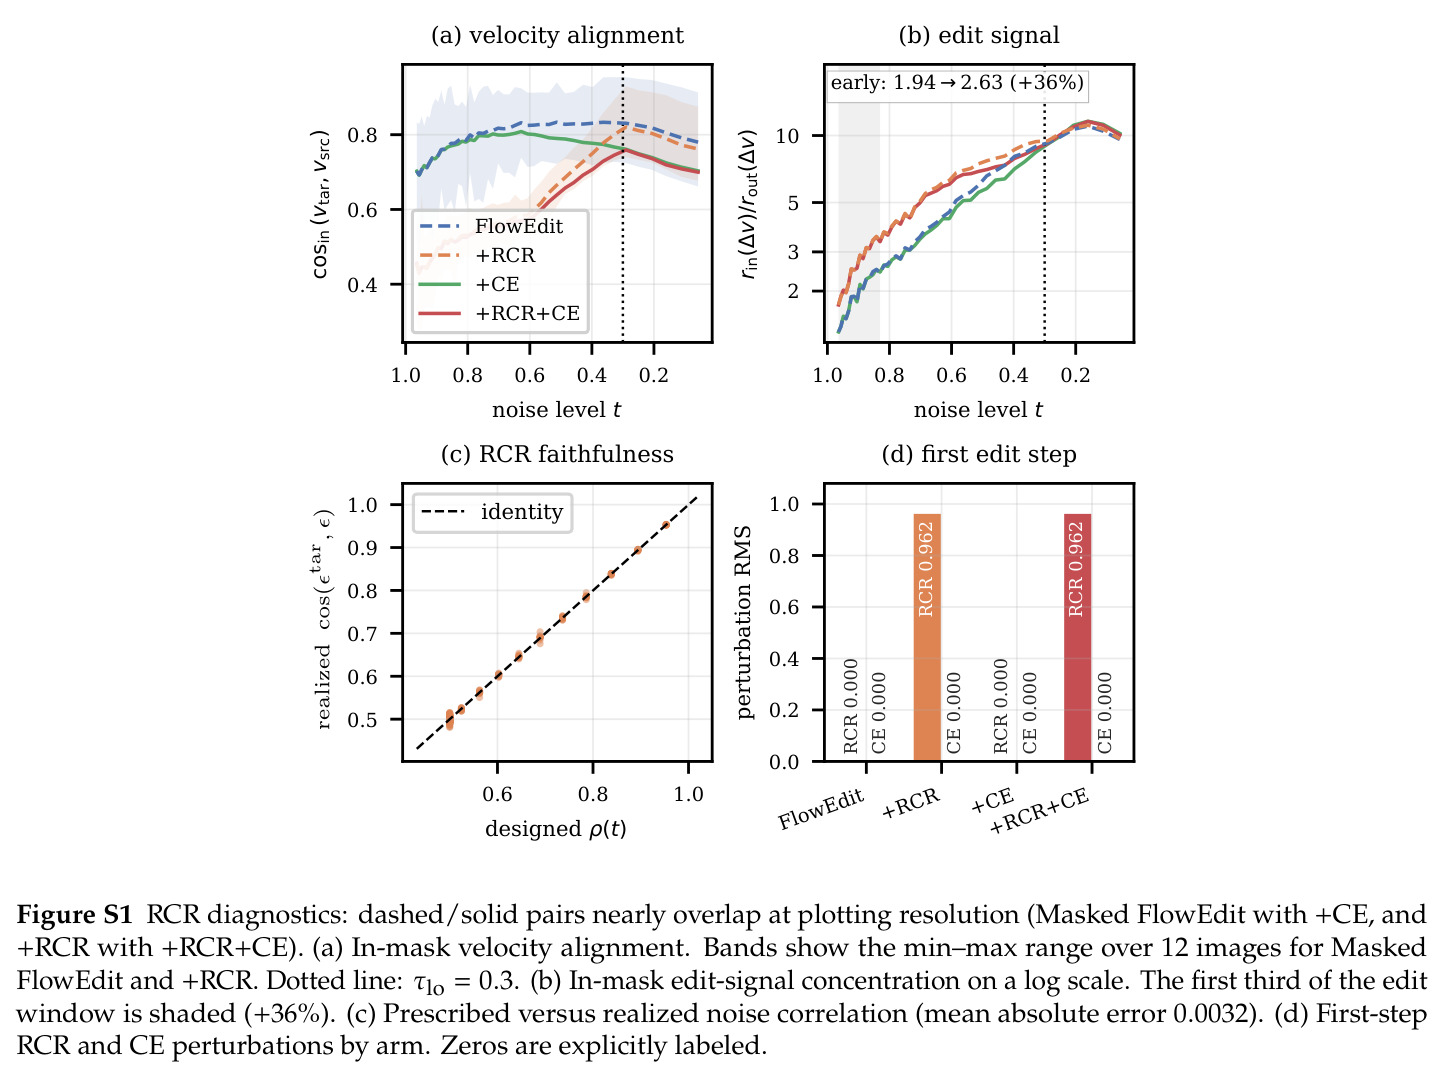
核心创新是诊断并修复“点火失败”。FlowEdit 的更新量 $\Delta v_t$ 依赖两分支速度差,而两分支共享噪声 $\epsilon$、仅在掩码内不同,文字区又只占画面极小部分,导致高噪声端速度差几乎为零,位移 $Z_{\mathrm{FE}}^t - Z_{\mathrm{src}}^0$ 恒为零——这是更新的不动点,加大增益 $\gamma$ 也无法逃离。论文提出两个互补的掩码内轨迹控制:区域耦合释放 RCR 在轨迹早期给目标分支喂部分去相关的噪声 $\epsilon_{\mathrm{tar}} = \rho\,\epsilon + \sqrt{1-\rho^2}\,\epsilon'$,其中 $\rho = 1-\kappa s(t)$ 按线性调度从 0.5 升回 1,让两个速度真正在不同点上取值;耦合扩张 CE 用 $\sin^2(\pi t)$ 门控把已累积的位移 $c\sin^2(\pi t)\,M\odot(Z_{\mathrm{FE}}^t - Z_{\mathrm{src}}^0)$ 正反馈回目标分支,让初生的编辑“显得更先进”从而被模型补完。RCR 负责开门、CE 负责推门,二者都不增加任何前向传播次数。
方法步骤详情
完整流程如下。第一步输入准备:OCR 返回 $K$ 个文字框与识别文本,LLM 一次调用返回译文对和两条 caption(源 caption 逐字引用原文,目标 caption 只改引号内容,其余场景描述严格不变);原图长边缩放到 1024(取 16 的倍数),VAE 编码一次得 $Z_{\mathrm{src}}^0$,文字框膨胀 15% 后栅格化为潜空间掩码 $M$。第二步区域掩码流编辑:从 $Z_{\mathrm{FE}}^T = Z_{\mathrm{src}}^0$ 出发,每步计算 $\Delta v_t = v_\theta(\hat{z}^{\mathrm{tar}}_t,t,c_{\mathrm{tgt}}) - v_\theta(\hat{z}^{\mathrm{src}}_t,t,c_{\mathrm{src}})$,按 $Z_{\mathrm{FE}}^{t-\Delta t} = Z_{\mathrm{FE}}^t - \Delta t\,\gamma\,M\odot\Delta v_t$ 更新(增益 $\gamma=1.3$),掩码外潜变量永不改动;编辑只在前 $n_{\max}=45$ 步内进行。第三步轨迹控制:早期($t\ge 0.6$)RCR 以 $\kappa=0.5$ 部分释放噪声耦合,$t\le 0.3$ 后恢复完全耦合以便精修字形;中段 CE 以 $c=0.4$ 放大位移。第四步 VAE 解码输出译文图像,PRIM 条带再缩回原尺寸。
技术新颖性
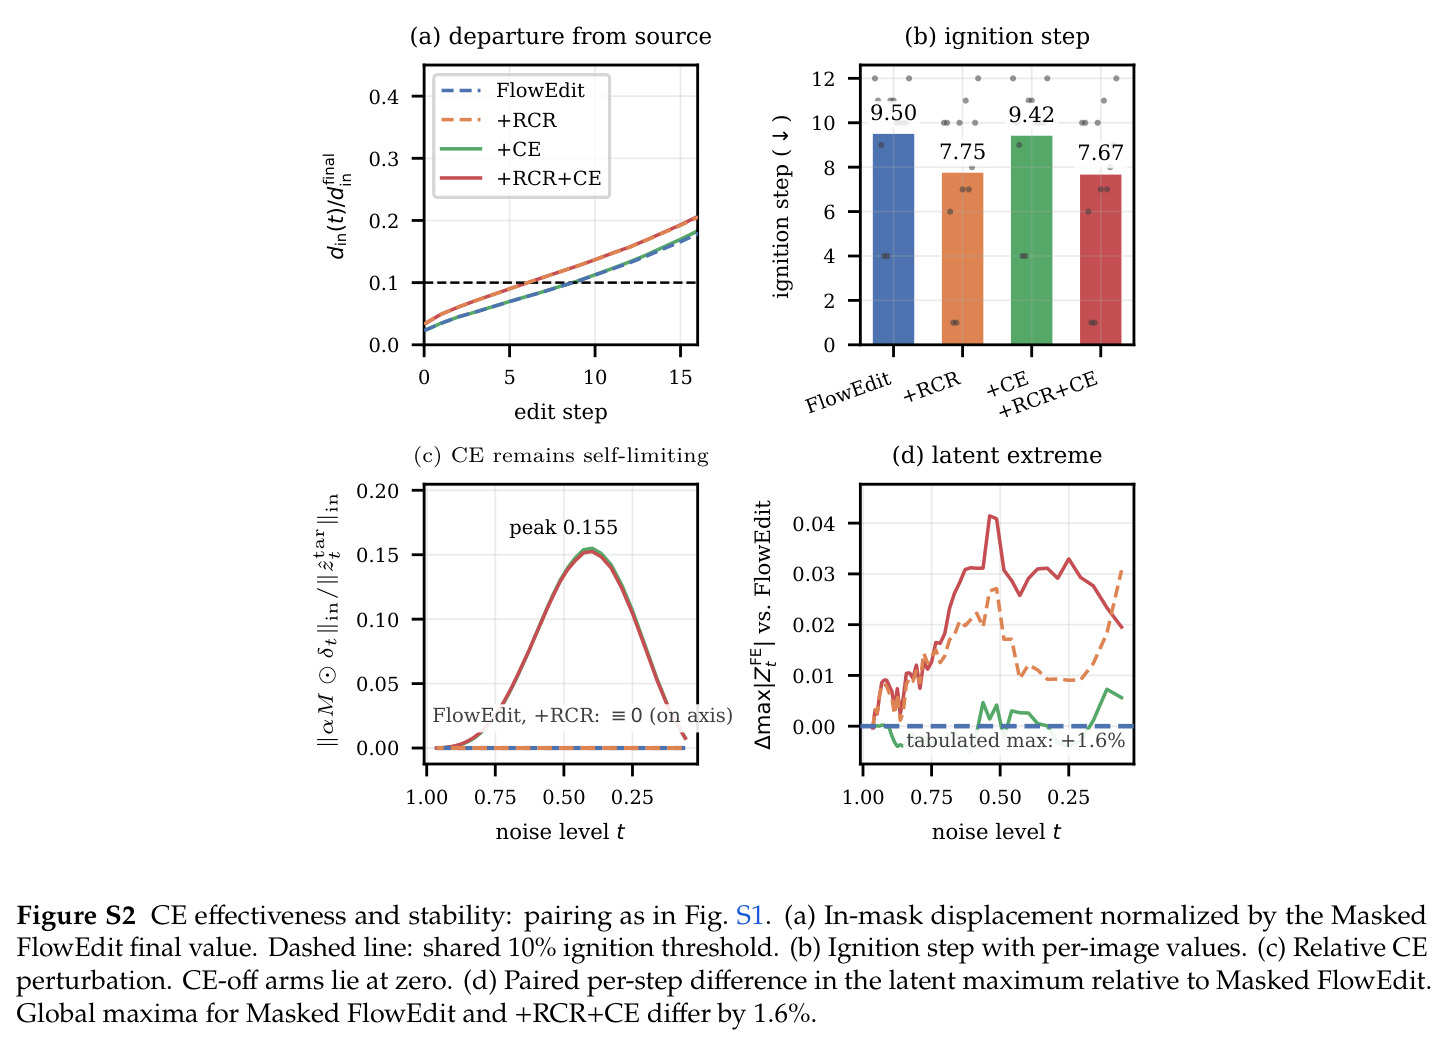
技术新颖性有三层。其一,任务层面首次把免训练流编辑从“单词条裁剪”(TextFlow)提升到完整 IIMT:自动 OCR 定位、LLM 翻译、全图多区域一次编辑,且不训练任何参数,与所有已发表 IIMT 系统(至少微调一个组件)形成范式差异。其二,机制层面首次指出并形式化耦合流编辑的不动点问题,论证它是文本少数派场景的内在属性而非实现缺陷。其三,控制层面 RCR 采用部分去相关($\kappa<1$)并保持噪声边缘分布不变、以加性扰动而非衰减式引导实现,避免把已有编辑进度一起缩水;CE 则是利用自身累积位移的自限性正反馈,峰值相对扰动仅约 0.155、潜变量最大值只变化 1.6%。二者属于从“构造新 ODE”转向“控制既有轨迹”研究潮流中,专门面向文字少数派点火的设计。
实验结果
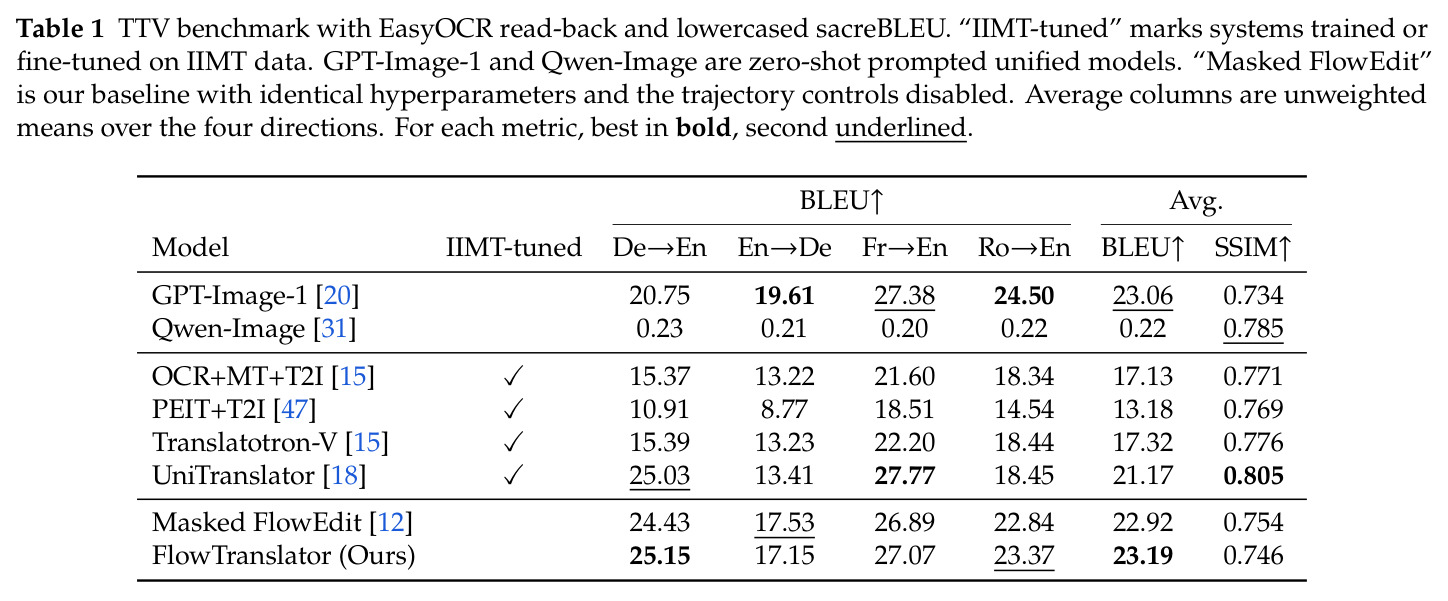
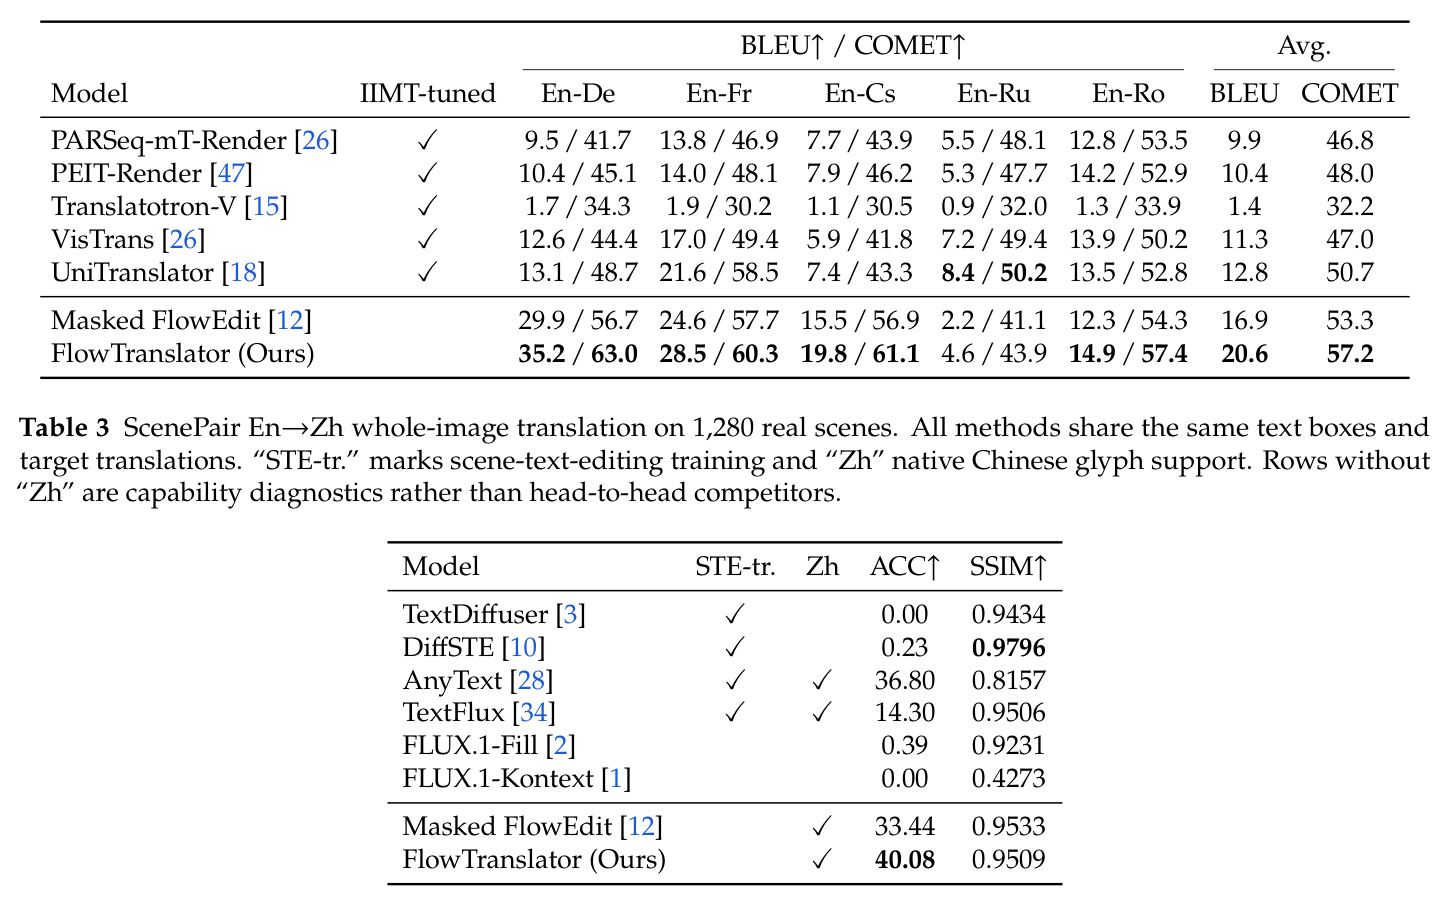
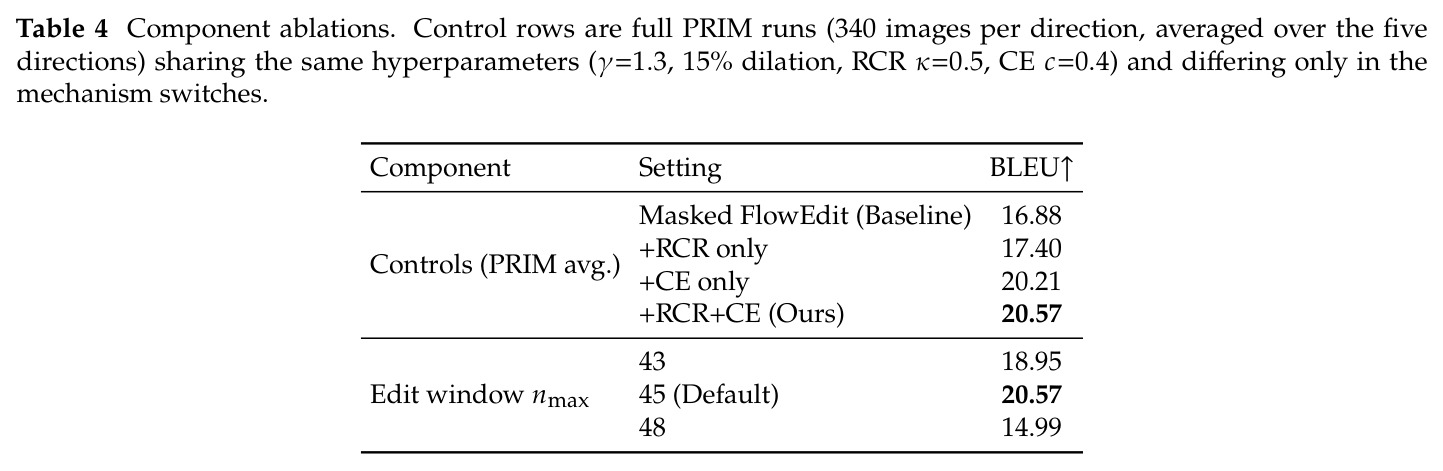
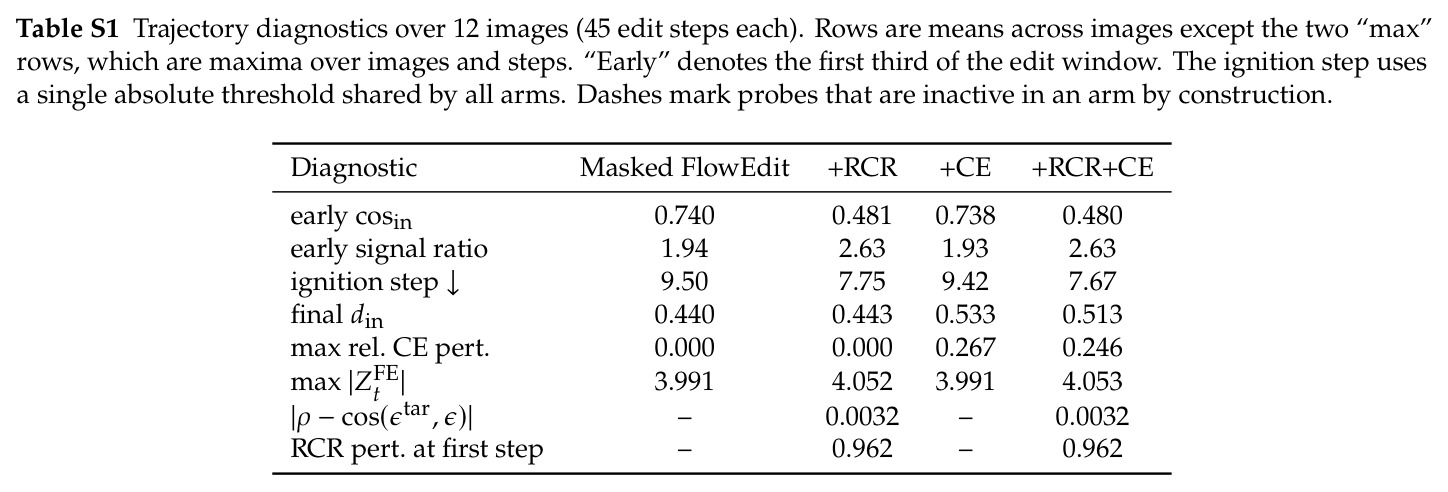
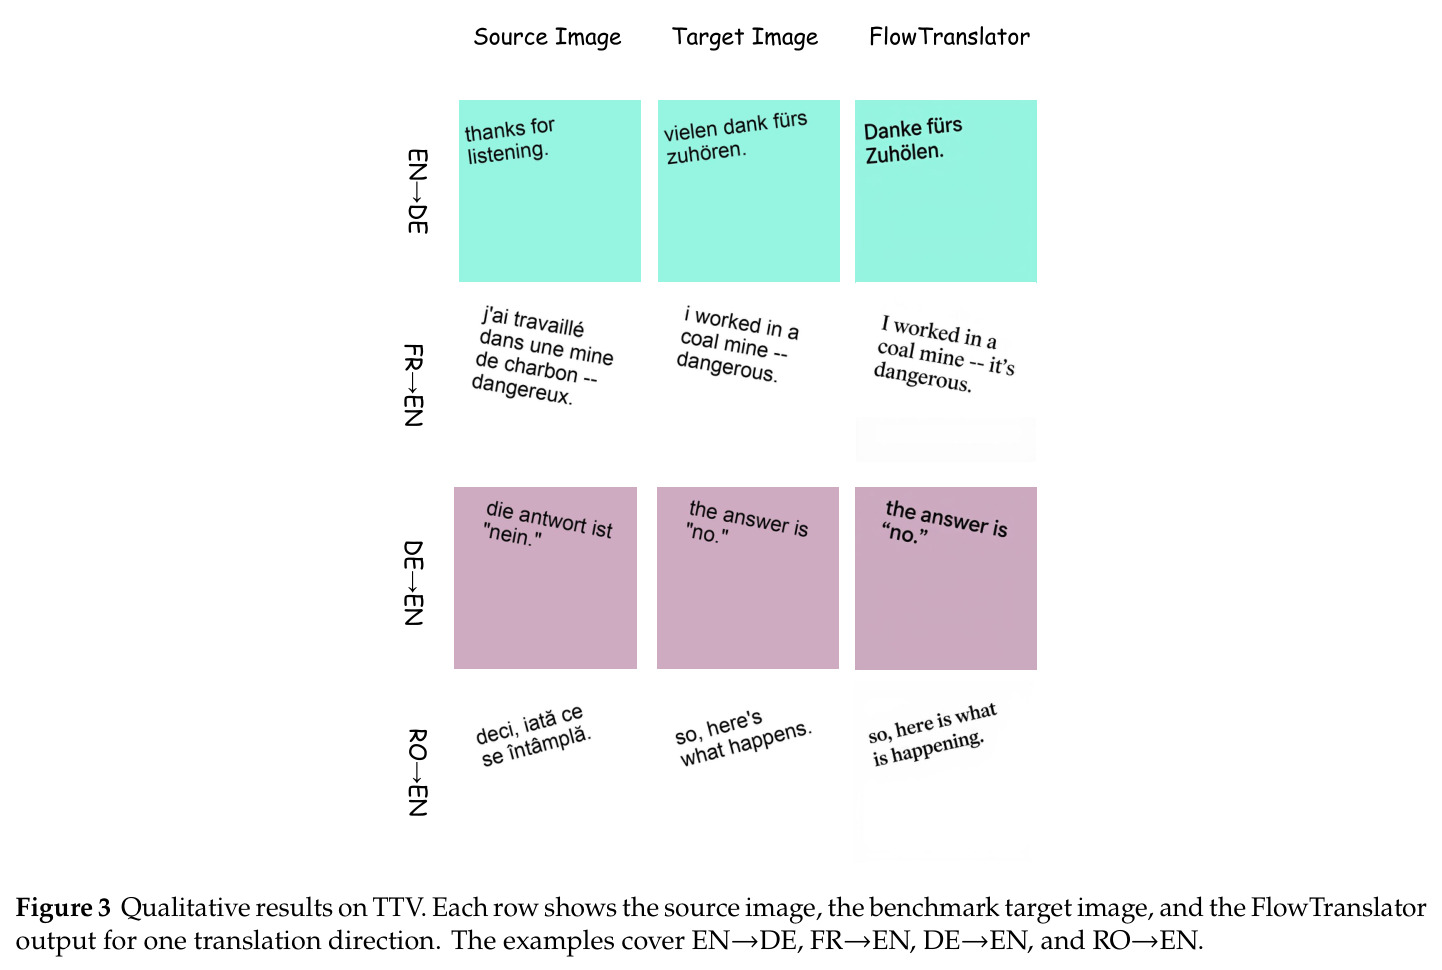
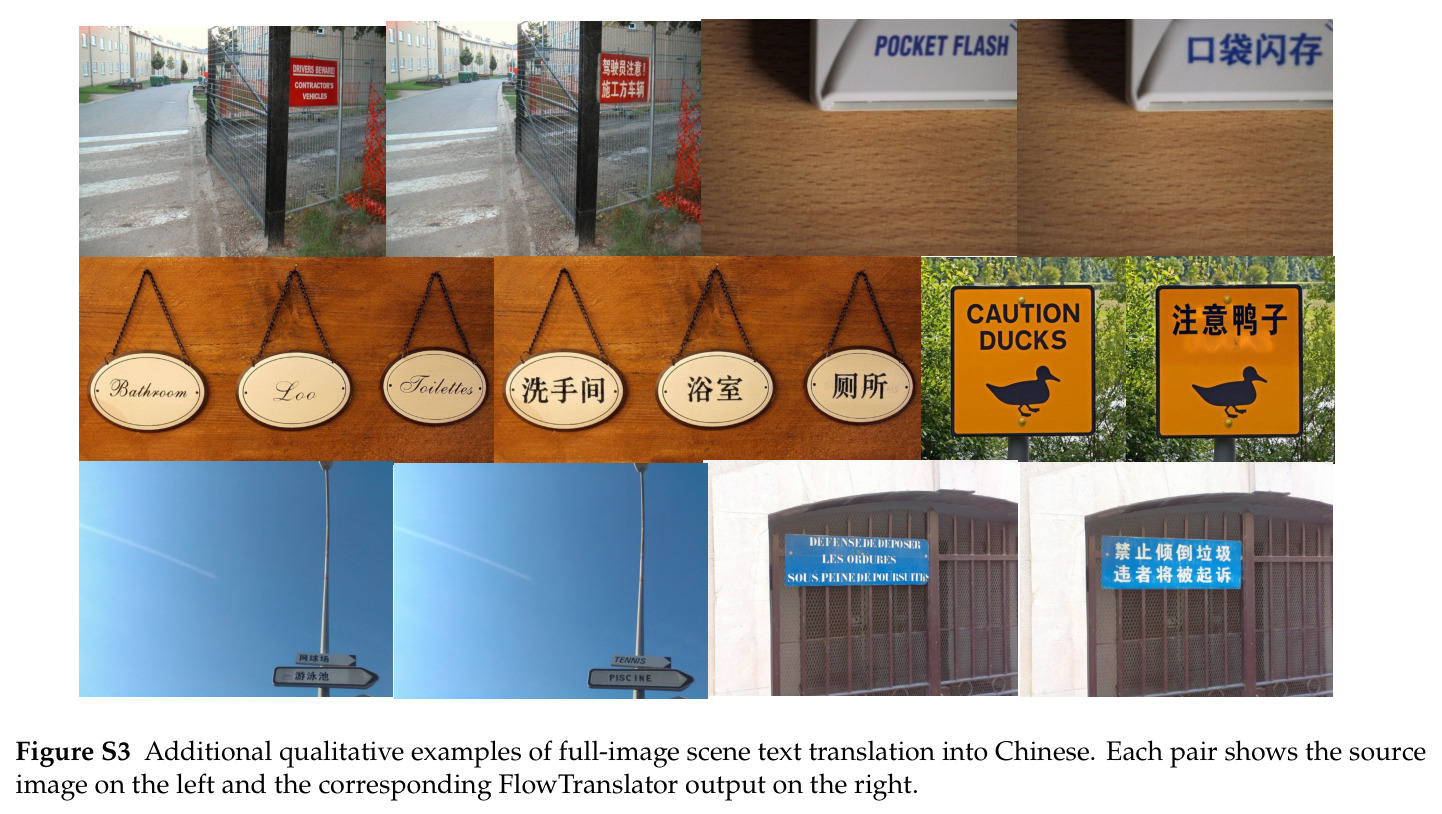
三组主实验均支持免训练路线的竞争力。TTV(5122 张合成图,De→En/En→De/Fr→En/Ro→En 四方向):FlowTranslator 平均 BLEU 23.19,超过 IIMT 专用训练系统 UniTranslator 的 21.17 与零样本 GPT-Image-1 的 23.06,其中 De→En 25.15、En→De 17.15、Ro→En 23.37 三个方向领先,Fr→En 27.07 略逊于 UniTranslator 的 27.77;SSIM 0.746 低于训练系统的 0.77–0.80,编辑越强偏离参考渲染越多。PRIM(真实拍摄文字条,五个方向):平均 BLEU 20.6 对 UniTranslator 的 12.8、平均 COMET 57.2 对 50.7,例如 En→De 达 35.2/63.0 对 13.1/48.7;唯一失败方向是 En→Ru(4.6 BLEU),因骨干模型渲染西里尔字母不可靠。ScenePair 整图英译中(1280 张真实照片):ACC 40.08%、SSIM 0.9509,超 AnyText 3.28 个点、TextFlux 25.78 个点,其余四个系统 ACC 低于 0.4%;相对同配置 Masked FlowEdit 基线,两个控制把 ACC 从 33.44% 提到 40.08%。消融显示 CE 单独贡献约 90% 增益(PRIM 16.88→20.21),再加 RCR 到 20.57;编辑窗口 $n_{\max}$ 在 45 处有明显峰值(43→18.95,48→14.99)。轨迹诊断证实 RCR 把早期掩码内速度对齐余弦从 0.740 降到 0.481、点火步从 9.50 提前到 7.75,CE 把最终位移提高 21%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TTV 图像内翻译(De→En/En→De/Fr→En/Ro→En) | 平均 BLEU(EasyOCR 回读 + sacreBLEU) | 23.19(SSIM 0.746) | UniTranslator(IIMT 训练)21.17;GPT-Image-1 零样本 23.06 | 较最强训练系统 +2.02 |
| PRIM 真实文字条翻译(5 方向) | 平均 BLEU / COMET | 20.6 / 57.2 | UniTranslator 12.8 / 50.7;Masked FlowEdit 基线 16.9 / 53.3 | BLEU +7.8(相对 +22%),COMET +6.5 |
| ScenePair 整图英译中(1280 张真实照片) | 精确匹配 ACC(PP-OCRv6) | 40.08%(SSIM 0.9509) | AnyText 36.80%;TextFlux 14.30%;Masked FlowEdit 33.44% | 较 AnyText +3.28 点,较自家基线 +6.64 点 |
| PRIM 组件消融 | 平均 BLEU | 20.57(+RCR+CE) | Masked FlowEdit 16.88;+CE 单独 20.21;+RCR 单独 17.40 | 相对 +22%,CE 贡献其中约 90% |
局限与改进
作者承认的局限:方法完全继承冻结骨干的脚本覆盖,Z-Image-Turbo 渲染西里尔字母失败导致 En→Ru 只有 4.6 BLEU;TTV 上 SSIM 0.746 低于 IIMT 训练系统的 0.77–0.80,编辑强度与背景保真存在权衡;En→De 是最弱方向(17.15),可能因 EasyOCR 对变音符与复合词的回读脆弱。我的独立观察:其一,级联结构未消除误差传播,OCR 漏检或误识的文字永远不会被翻译,且评测固定了文本框,掩盖了真实使用中定位错误的影响;其二,编辑依赖随机噪声,论文需多种子取均值才能稳定报告,部署时单次结果的方差不可忽视;其三,PRIM 条带需从 512×46 上采样到 1024×80 再编辑,小字号字形细节可能损失;其四,caption 由 LLM 一次生成、全部文字区同时编辑,任一译文措辞不当会连带破坏整图;其五,论文未报告与训练编辑器的推理耗时对比,每步需两次 DiT 前向的实际成本可能高于单次前向的扩散编辑器。
独立分析的弱点
独立分析四个弱点。第一,方差与可控性:编辑由随机噪声 $\epsilon$ 驱动,同一输入不同种子结果差异明显(论文靠多种子均值掩盖),生产环境需要批量生成加 OCR 回读筛选,或引入方差缩减技术。第二,语义漂移风险:CE 是自反馈放大,若早期位移方向错误(例如 LLM caption 把场景描述写偏),正反馈会把错误编辑同样放大;论文只验证了自限性而未分析方向错误时的行为,可在中段加轻量识别器做回读校验并触发重采样。第三,背景“潜空间冻结”不等于像素冻结:掩码外潜变量不动,但 VAE 解码与长边 1024 重缩放仍引入全局损失,TTV 上 SSIM 低于训练系统可能部分来自高噪声阶段全局上下文被重写;可研究解码阶段对掩码外像素原值回贴。第四,多语言覆盖受制于骨干:换多脚本骨干或对西里尔/阿拉伯文字微调会侵蚀“完全免训练”的卖点,也可以退一步在失败语向回退到传统贴字渲染形成混合系统。
未来方向
作者明确提出的方向是把轨迹控制扩展到脚本覆盖更广的骨干模型,修复西里尔文渲染失败。顺着本文成果还能延伸:把 RCR/CE 的“部分去相关+位移正反馈”框架迁移到其他掩码受限编辑任务,如 logo 替换、水印清除、界面文本本地化;把点火失败分析推广为“编辑区域占比与所需控制强度”的定量理论,按掩码面积自动调度 $\kappa$ 与 $c$;与识别感知编辑(如 RS-STE 用识别器校验内容)结合,形成回读—重试闭环;用开源 LLM 替换商用 Doubao-Seed-2.0-lite 实现全开源复现;以及把区域掩码流编辑扩展到视频 IIMT,用轨迹控制保持时序一致性。
复现评估
复现门槛较低。算力:全部实验在单卡 RTX 4090 完成,$T=50$ 步、每步两次 6B DiT 前向,无需任何训练。数据:TTV、PRIM、ScenePair 均为公开基准,评测协议(EasyOCR v1.7 回读、sacreBLEU 13a、wmt22-comet-da、PP-OCRv6 ACC)在论文中描述完整。超参数全部给出:$\gamma=1.3$、掩码膨胀 15%、RCR $\kappa=0.5$($\tau_{\mathrm{hi}}=0.6$、$\tau_{\mathrm{lo}}=0.3$)、CE $c=0.4$、$n_{\max}=45$。组件:Z-Image-Turbo 与 PP-OCRv5 开源可下载,但翻译与 caption 依赖商用 LLM Doubao-Seed-2.0-lite,这是主要复现障碍(换开源 LLM 后 caption 质量需重新调 prompt);论文未明确说明代码是否开源。附录的配对轨迹诊断协议(专用固定种子生成器、符号检验)描述细致,有利于忠实复现。总体难度中等,熟悉 diffusers 的工程师数天内可跑通主流程。
论文图表
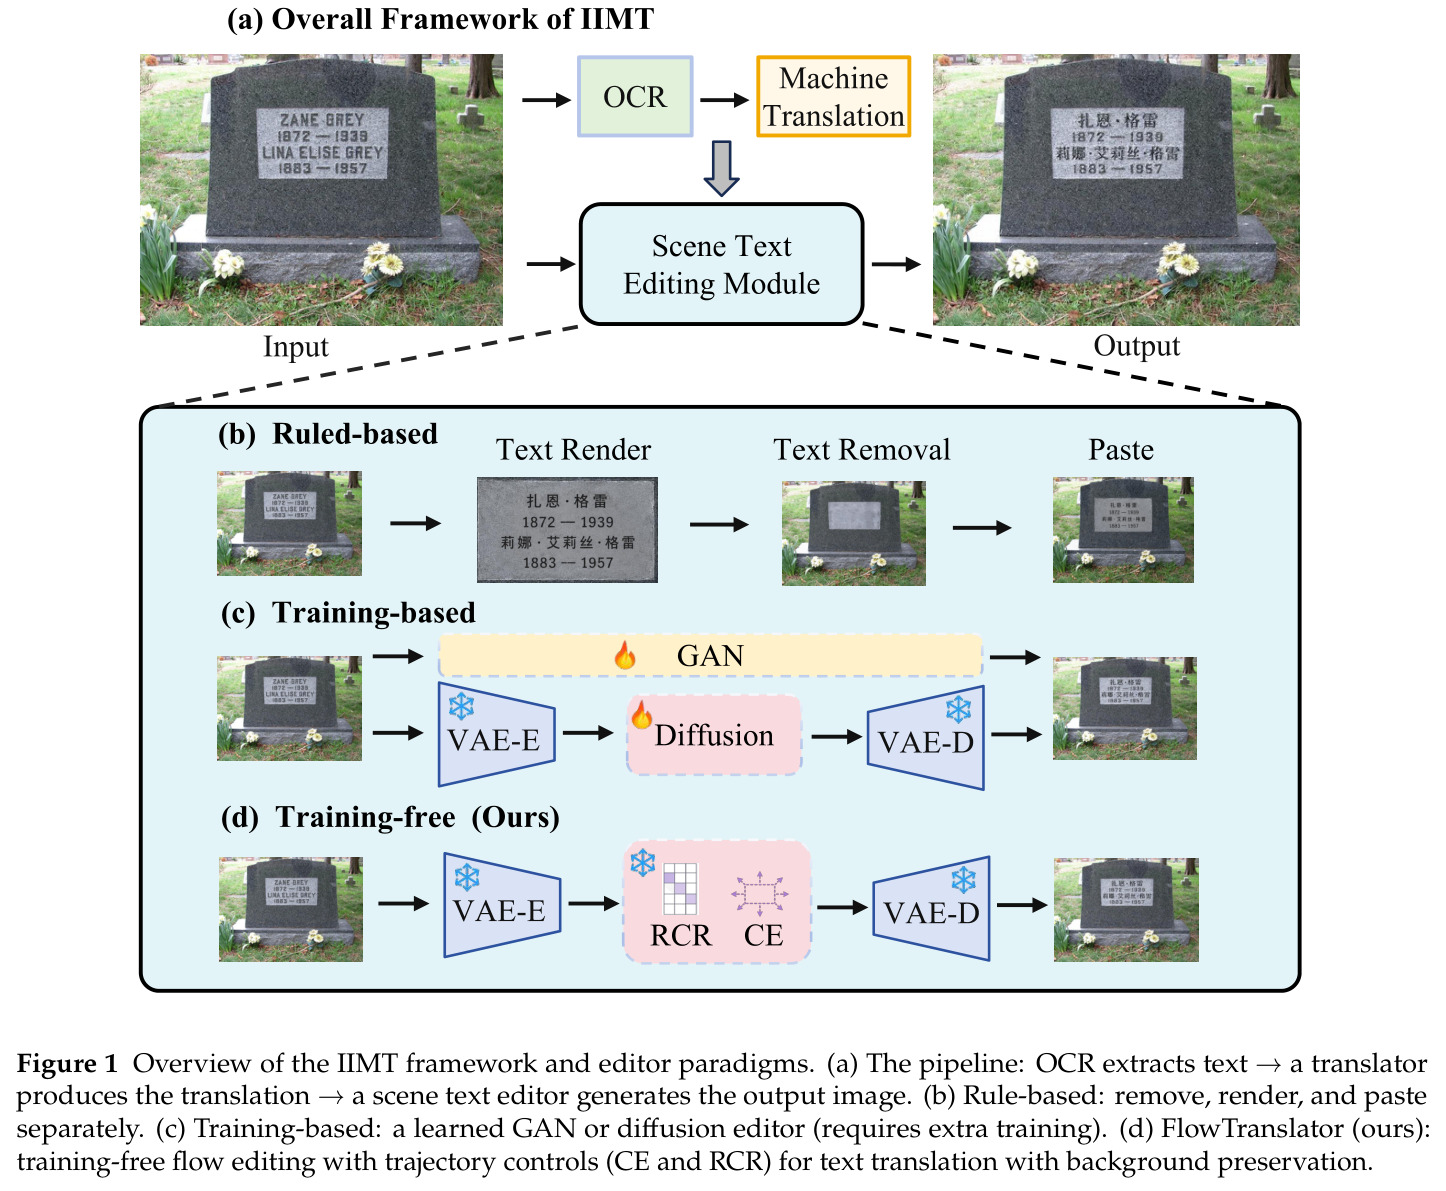
(a) IIMT 级联流水线:OCR 提取文字→翻译器翻译→场景文字编辑器生成输出图;(b) 规则式方法先擦除原文再单独渲染粘贴;(c) 训练式 GAN/扩散编辑器需要额外配对训练;(d) FlowTranslator 用免训练流编辑配合 CE 与 RCR 轨迹控制完成翻译并保持背景。
一张图看懂 IIMT 任务定义与三类编辑范式的演进,是理解本文定位与研究缺口设计的入口。
五个 En→X 方向的 BLEU/COMET:FlowTranslator 平均 20.6/57.2,除 En→Ru(4.6,西里尔文渲染失败)外全部方向领先,UniTranslator 为 12.8/50.7;同时给出 Masked FlowEdit 基线 16.9/53.3 以隔离两个轨迹控制的贡献。
真实拍摄场景上的关键胜利,也是消融分析与西里尔文失败讨论的数据来源。