真实进,真实出:仅用真实数据训练的场景文本编辑 Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
用乱序加裁剪构造自配对真实数据训练扩散模型,首次摆脱合成数据的场景文本编辑
前置知识
场景文本编辑(Scene Text Editing, STE)
STE 要求给定一张包含文字的真实场景图像和一个目标字符串,生成一张新图像:新文字按目标内容渲染,但保留原文字的字体风格、笔画粗细、透视形变、光照和背景。它被形式化为生成任务 $I_{tgt}=M(I_{src},T_{tgt})$,主要应用包括艺术创作中的文字替换,以及为场景文本识别(STR)生成同风格不同内容的新训练样本。
本文的全部动机与评测都围绕 STE 展开,理解这个任务的输入输出定义和「真实配对数据不可得」这一根本困难,是看懂为何要造自配对数据的前提。
条件扩散模型与 ControlNet 注入
扩散模型通过逐步去噪学习数据分布,训练目标是噪声预测损失 $\mathcal{L}=\|\epsilon-\epsilon_\theta(z_t,t,\text{cond})\|^2$。ControlNet 是一种条件注入机制:把条件图像特征经过多层零初始化卷积(zero-convolution)后以多尺度方式加到 U-Net 的中间特征上,训练初期不破坏预训练权重,能精细地保留空间结构信息。
TextRIRO 的生成器就是一个 ControlNet 式条件扩散模型,风格条件走 ControlNet 通路、文本条件走交叉注意力通路,论文还实测了 DiT 替代方案并证明多尺度注入更适合细粒度文字编辑。
自配对(self-paired)监督
STE 训练需要「源图-目标文本-目标图」三元组,但真实世界中同一背景不同文字的配对几乎无法采集,以往只能靠渲染工具合成。自配对的思路是:对一张真实图像施加某种扰动(打乱、裁剪、遮罩),把扰动后的图当作伪源图 $I_{src}$,原图本身当作目标图 $I_{tgt}$,其标注文本当作目标文本,从而凭空造出配对监督,训练集中不含任何合成图。
这是本文的核心机制,论文大部分消融(Shuffle/Crop/Mask/Block/None、p_shuffle 取值)都在回答「什么样的扰动才能既毁掉语义又保住风格」。
场景文本识别(STR)与 Union14M 基准
STR 是从场景图像中读出文字的任务,常用评测集包括 IIIT、SVT、IC13、IC15、SVTP、CUTE(合称 Common Benchmarks)以及更大规模的 Union14M-Benchmark(含曲线、多向、艺术字、多词等七个子集)。MAERec 和 SVTRv2 是基于真实数据训练的主流 STR 模型。本文既借用 STR 预训练来初始化文本编码器,也用「拿编辑图训练 STR」作为编辑质量的代理评测。
STR 在本文中身兼三职:文本编码器的预训练来源、编辑结果的过滤器与裁判、以及验证编辑数据价值的下游任务,不懂 STR 就无法理解论文的评测闭环。
FID 与感知质量指标
FID(Fréchet Inception Distance)衡量生成图像与真实图像在深度特征分布上的距离,越低越接近真实分布,但对单张图不敏感;LPIPS、SSIM、PSNR 则是逐图像的感知/结构/像素相似度指标。STE 论文常用 FID 检测「合成味」:识别准确率可以靠迎合识别器刷高,但 FID 难以作弊,因此两者结合才能判断编辑结果是否真实。
论文的核心论点「真实进真实出」就建立在 FID 证据上:RS-STE 准确率更高但 FID 更差,TextRIRO 反之,理解这组指标才能读懂准确率与真实感的权衡分析。
研究动机
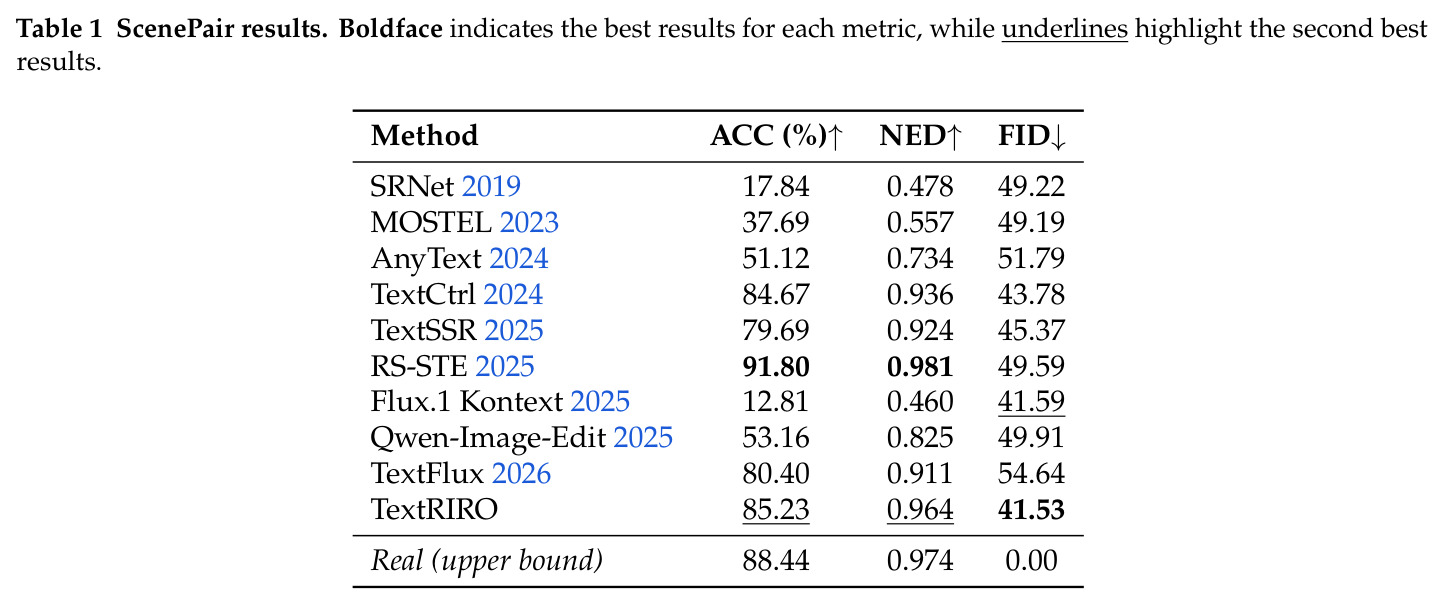
场景文本编辑要求把图像中的文字替换成新内容,同时保留字体风格、透视和光照,但主流方法几乎全部依赖合成配对数据,产生顽固的合成-真实域差。具体表现为三类失败:显式解耦方法(SRNet、MOSTEL、SwapText)用渲染工具合成「同风格不同文字」的图像对再做前景-背景分离与融合,但文字与背景分不干净,导致源文字擦除不全、留下残影;隐式解耦方法(TextStyleBrush、TextCtrl)借助预训练特征直接生成,可控性差,容易产生拼写错误、字符缺失等幻觉;半监督路线(RewriteNet、RS-STE)虽引入真实图像(擦除写回、反向编辑),但合成数据仍占主导,结果常带风格不匹配与伪影;修补式方法(AnyText、TextSSR)把编辑当作文本区域修复,周围缺少相似风格参照时难以恢复目标外观。论文在 ScenePair 真实测试集上量化了这一差距:最好的合成数据方法 TextCtrl 虽有 84.67% 词准确率,FID 却停在 43.78;RS-STE 为换取 91.80% 识别准确率甚至把 FID 推高到 49.59,结果带明显「合成味」,而真实图像上界的 FID 是 0。
本文的目标是作者问了一个极简但根本的问题:如果完全不使用合成三元组、也不做昂贵的真实配对采集,只用真实数据做场景文本编辑,能做到什么程度?具体目标分三层。第一,把每一张真实文本图像转化为自身的配对监督——通过破坏语义、保留风格的扰动构造自配对训练数据,从数据源头消除合成-真实域差,摆脱对渲染工具、前景标注和解耦模块的依赖。第二,在 ScenePair、RIROCommon 等真实基准上同时追求正确性与真实感:等长编辑准确率逼近真实图像上界 88.44%,FID 做到全场最佳,并显著超越基线的变长编辑能力。第三,验证编辑数据对下游任务的实际价值:用 TextRIRO 构造 300 万规模的长文本识别数据集 TextRIRO-3M,让 STR 模型在 Union14M-Benchmark 上的平均准确率超过纯真实数据基线(86.09%)至少约 1.9 个百分点,证明真实感编辑能切实推动下游识别性能。
与已有工作不同的是,作者的独特切入点是一个此前被低估的观察:STE 的域差首先是数据问题,其次才是架构问题。真实数据迟迟没被用于 STE 训练,症结在于「同一背景不同文字」的真实配对在自然场景中几乎不可能存在,于是所有人都默认必须造合成数据。本文抓住了一个被忽视的视觉先验:场景文字的风格主要体现在颜色、纹理、光照等低层线索上,而文字语义是高层序列结构——两者可以通过简单的图像操作分离。既然如此,不必真正「擦除再重写」,只需把原图沿长轴切成条带打乱(Shuffle)、再随机裁剪(Crop),就能把一张真实图像拆成「语义已毁、风格完好」的伪源图加真目标图。与 RewriteNet/MOSTEL 的擦除写回不同,这种扰动不要求模型先学会擦除,也不引入任何渲染痕迹;与 RS-STE 的反向自监督不同,它不需要预训练的统一多模态模型;与修补式方法的区别在于保留了完整的风格参照,而非遮罩后让上下文去猜。
核心方法
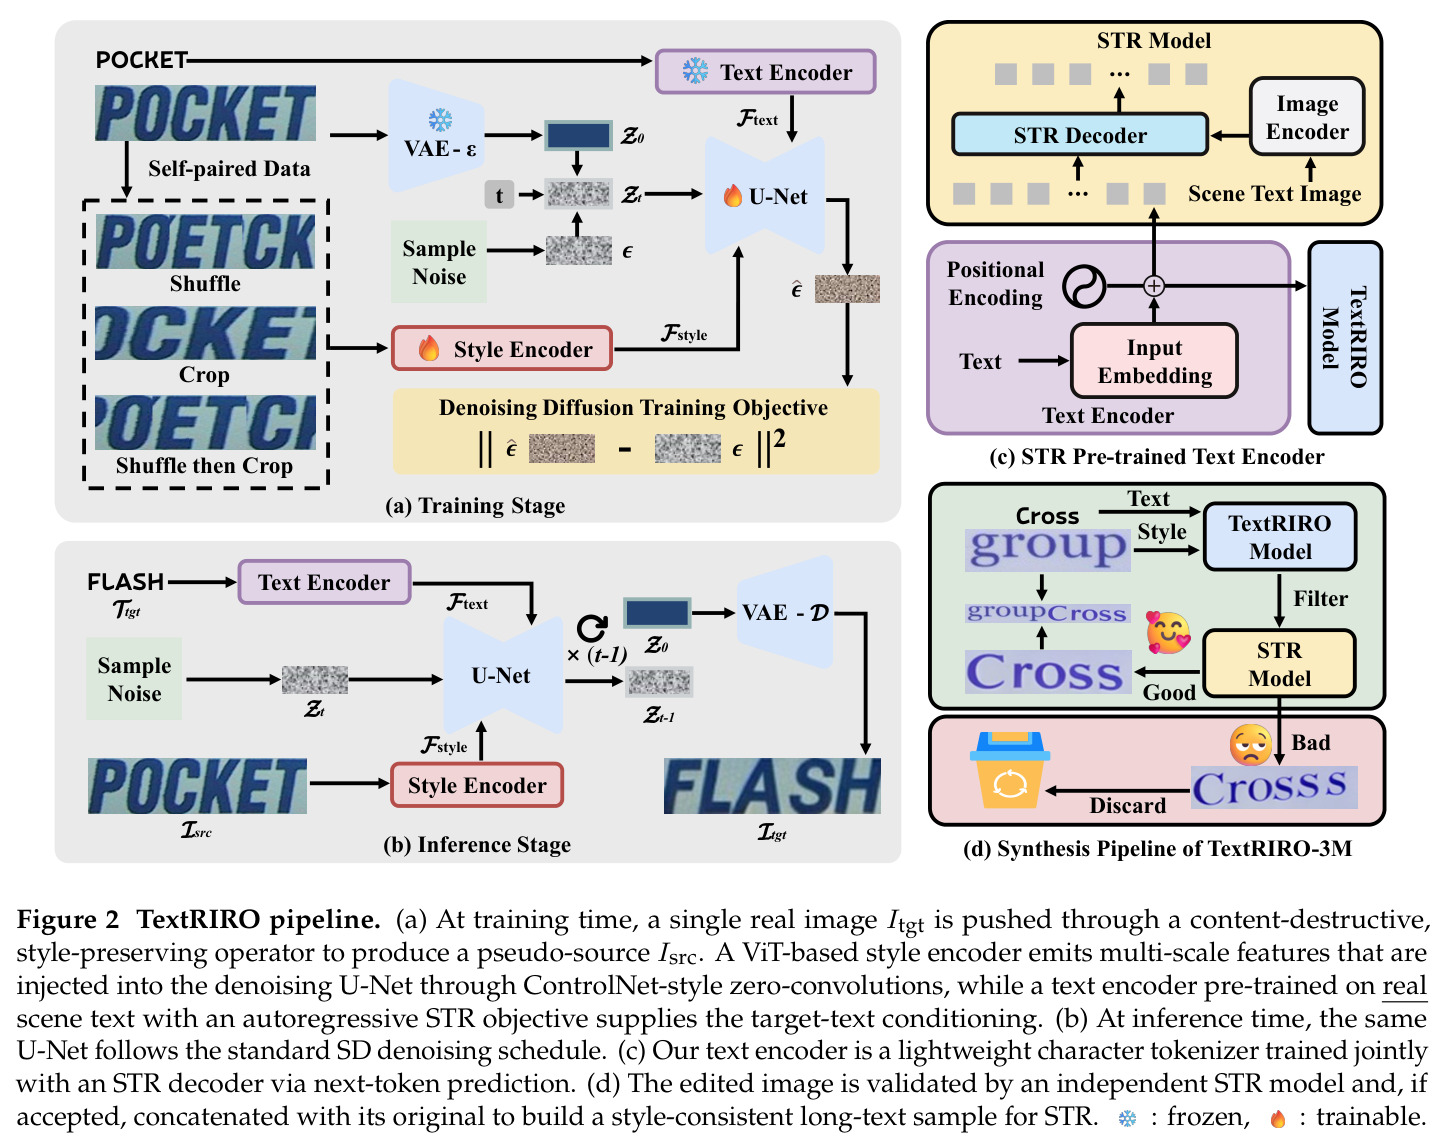
直觉上,TextRIRO 像「把打乱的拼图复原」:拿一张真实场景文字图,把字符条带打乱顺序、再截取局部,得到一张语义已毁但风格完好的伪源图,然后训练条件扩散模型从伪源图加目标文本出发还原原图。模型被迫学的是「根据风格条件和新文本重新渲染文字」而非复制源图——若想走捷径复制,会发现源图文字是乱序的,与目标文本对不上。技术上,生成器组合 Stable Diffusion 组件:SD 2.1 的 VAE 负责潜空间映射(重建后六基准平均 STR 准确率 96.11%,优于 SD 1.5 的 95.58%),SD 1.5 的 U-Net 做去噪(768 维便于与文本编码器对齐)。风格编码器沿用 TextCtrl 的 ViT 主干加空间金字塔,产生 4 个尺度特征,经 ControlNet 式零卷积分层注入 U-Net;文本编码器是与 MAERec 解码器联合自回归预训练的字符级编码器(94+1 词表、最大长度 25),经交叉注意力进入 U-Net。训练目标是噪声预测损失 $\mathcal{L}=\|\epsilon-\epsilon_\theta(z_t,t,F_{style},F_{text})\|^2$。全部训练只用真实数据,8×V100 训 15 轮、batch 256,约 180 GPU 小时。
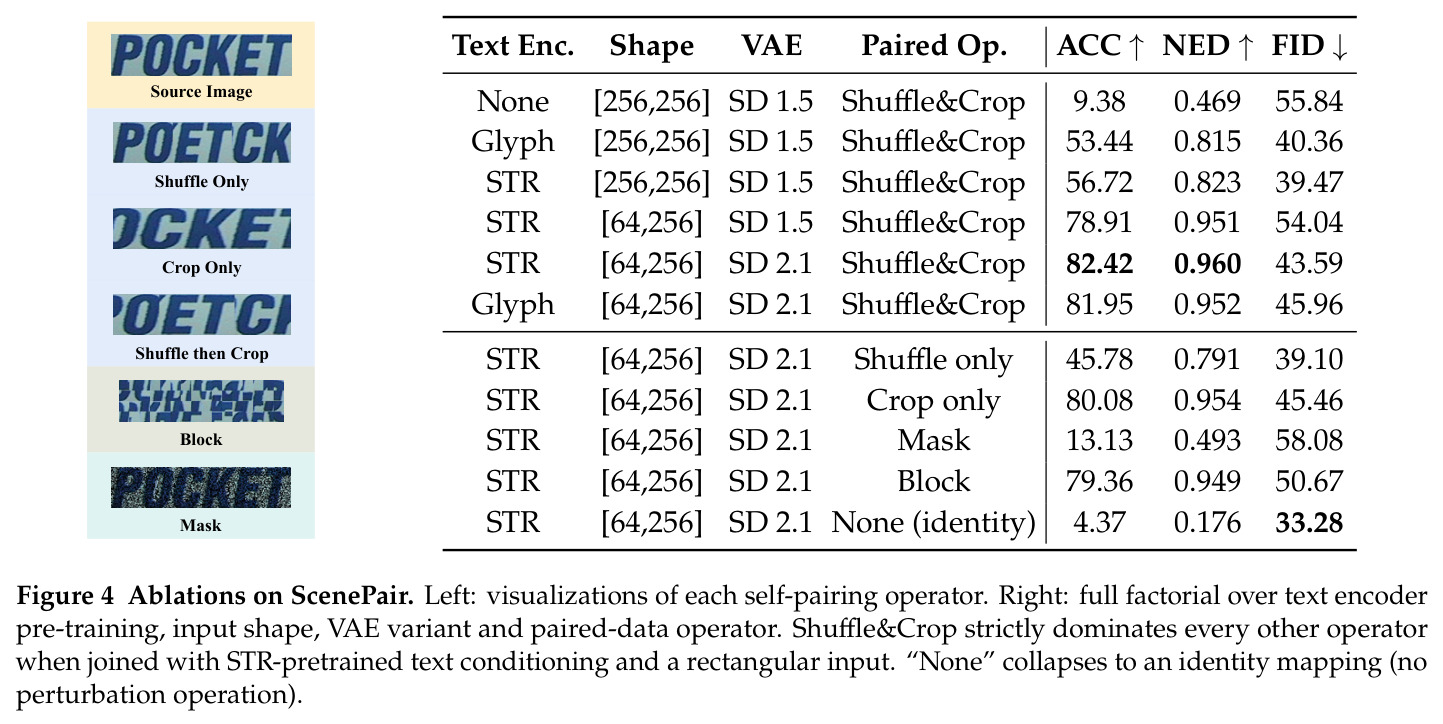
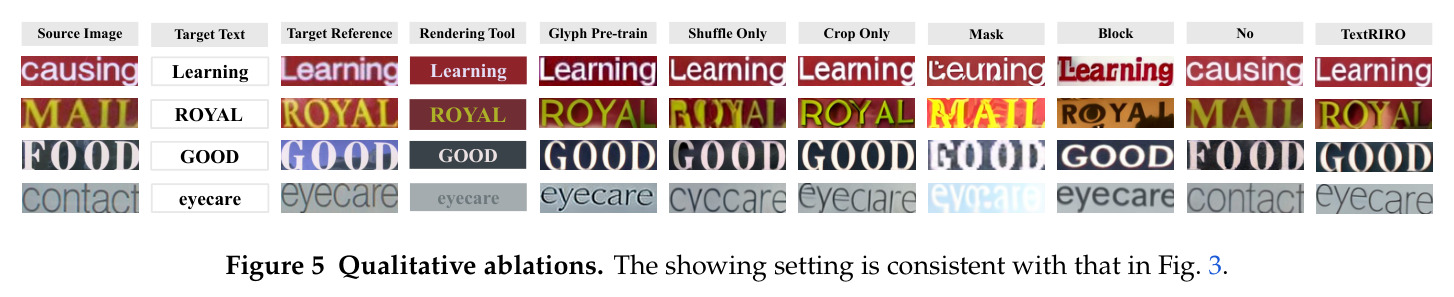
核心创新是把配对监督的来源从合成域搬回真实域本身:此前所有工作都在回答「如何建模风格-内容解耦」,本文回答「如何不依赖合成数据构造监督信号」。关键洞察有二。其一是利用「文本长度 L」这一免费的结构先验:文字通常沿图像长轴排列且标注已知,把图像沿长轴均分为 $L=|T_{tgt}|$ 个等宽条带再随机重排,即可打断从左到右的语义连续性,而每个条带内部的笔画粗细、倾斜、曲率、光照原封不动——风格天然保真。其二是识别出扰动方式是一个精细的权衡:消融显示不加扰动(None)时模型退化为复制、准确率仅 4.37%;只 Shuffle 变长能力不足(ScenePair 45.78%);只 Crop 多样性不够(80.08%);Mask 同时毁掉内容与风格(13.13%);而 Shuffle&Crop 达到 82.42%(完整配置最终 85.23%),并以概率 $p_{shuffle}=0.7$ 混合两种操作。更深一层,这本质上是把解耦从「模型架构问题」转化为「数据构造问题」:若风格通路泄漏语义,模型会复现乱序内容而非按文本条件渲染,因此风格-内容解耦被训练目标隐式强制,无需显式的前景分离模块,也无需任何预训练的解耦特征。
方法步骤详情
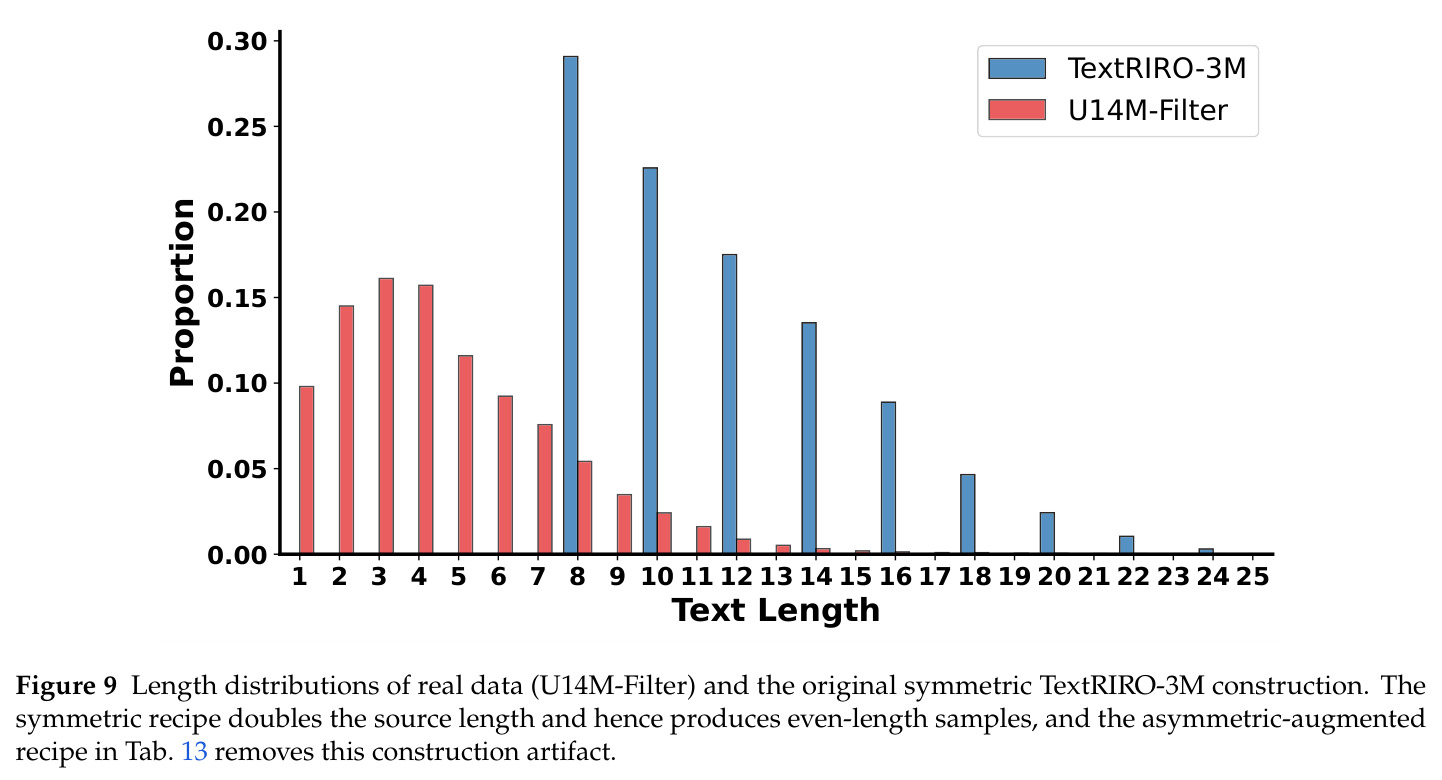
第一步,自配对数据构造(算法 1):输入真实文本图 $I_{tgt}$ 与标注 $T_{tgt}$,令 $L=|T_{tgt}|$,沿长轴切成 $L$ 个等宽段;以概率 $p_{shuffle}=0.7$ 随机重排,再选连续的 $N\le L$ 段拼接成伪源图 $I_{src}$。宽高比小于 1:2 的图先逆时针旋转 90°,统一缩放到 64×256(矩形输入避免方形畸变,消融显示比 256×256 高 22 个百分点)。第二步,条件特征提取:ViT 风格编码器(16×16 patch、12 层、768 维)从 $I_{src}$ 提取特征,经自适应池化和 1×1 零卷积生成 4 尺度金字塔特征 $F_{style}$;目标文本经字符嵌入加位置编码得到 $F_{text}$。第三步,扩散训练:VAE 与文本编码器冻结,风格编码器和 U-Net 联合训练,最小化噪声预测损失,学习率 $10^{-5}$,15 轮。第四步,推理:输入未扰动真实图与新文本,20 步采样、CFG $\omega=2.2$,V100 约 0.20 秒/张。第五步,数据集生成:对 U14M-Filter 的 3.22M 真实图做等长编辑,用独立 STR 模型过滤只保留识别与目标一致的样本(人工抽检 300 张准确率 99.33%),再把编辑图与原图拼接成倍增长文本长度的 TextRIRO-3M。
技术新颖性
与已有工作的本质区别体现在三个层面。数据层面:SRNet-Datagen、MJ、ST 全靠渲染工具;RewriteNet/MOSTEL 的擦除-写回和 RS-STE 的反向自监督虽使用真实图,但仍以合成数据为主导且需要模型先掌握擦除能力;TextRIRO 完全绕开渲染与擦除,用零参数的 Shuffle&Crop 图像操作生成监督信号,训练集中不含一张合成图,这是 STE 领域第一次实现纯真实数据训练。编码层面:此前文本条件多用字形渲染预训练或 CLIP 特征(TextCtrl、UDiffText、AnyText),本文改用真实场景文本上的自回归 STR 目标预训练,消融显示 STR 预训练(82.42%)优于字形预训练(81.95%),更远超无预训练(9.38%);t-SNE 可视化表明它天然学到 1024/l024 这类字形相似但语义不同的细粒度区分,以及 there/There/THERE 的大小写分离。架构层面:作者实测 OminiControl 式 DiT 条件注入(ACC 52.89%)明显落后于 ControlNet 多尺度注入(85.23%),说明场景文字这类细粒度任务需要空间分辨率更高的条件通路,为「扩散架构是否要全面转向 DiT」提供了反例证据。
实验结果
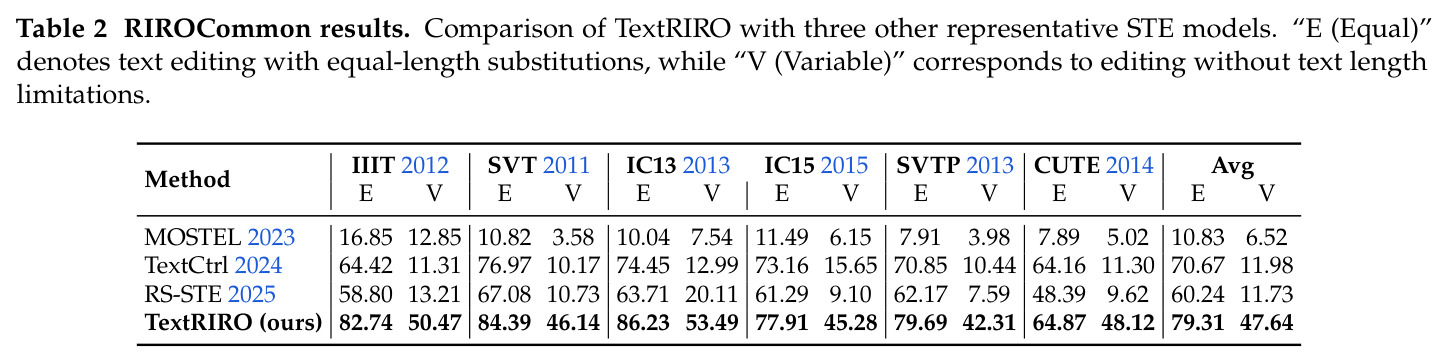
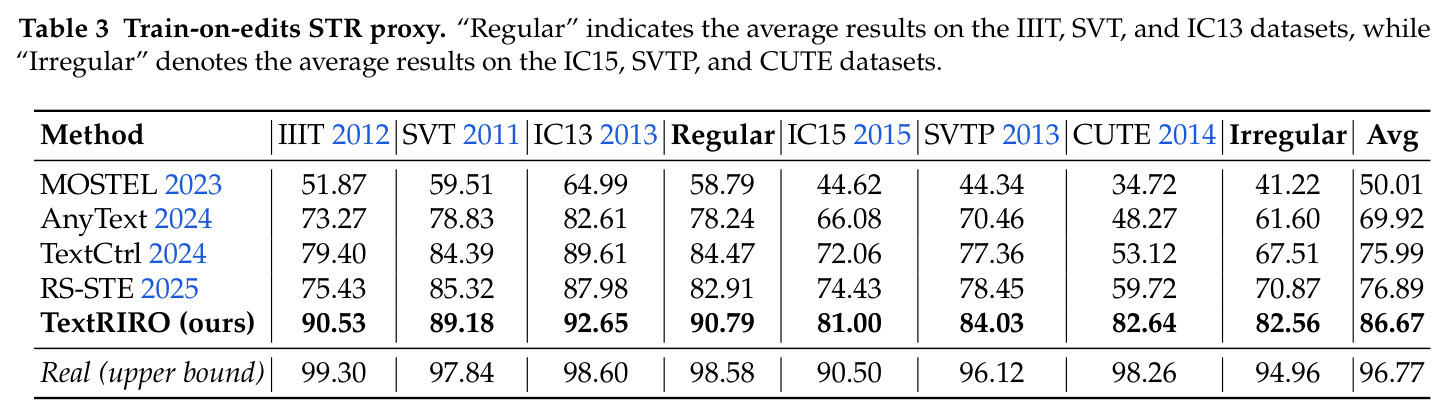
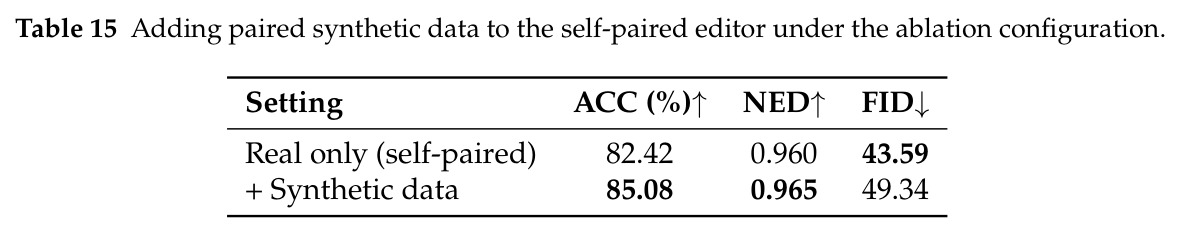
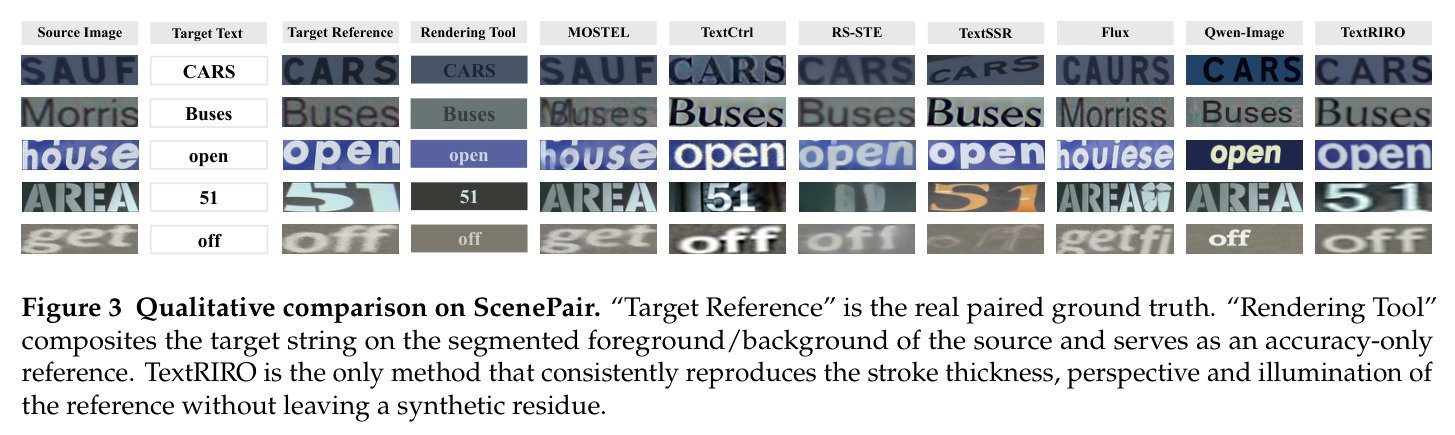
ScenePair(1280 对真实图像):TextRIRO 取得 ACC 85.23%、NED 0.964、FID 41.53,FID 全场最佳;RS-STE 的 ACC 更高(91.80%,甚至超过真实上界 88.44%)但 FID 恶化到 49.59。作者用三个独立识别器(TRBA/SVTRv2/PPOCR-v6)交叉验证了这一「准确率换真实感」的权衡:TextRIRO 三种识别器下都贴近真实上界(85.23/85.86/86.25)。通用大模型差距明显:Flux.1 Kontext 仅 12.81%,Qwen-Image-Edit 53.16%。RIROCommon(SVTRv2 评测):等长编辑平均 79.31%,比 TextCtrl(70.67%)高 8.64、比 RS-STE(60.24%)高 19.07 个百分点;变长编辑 47.64%,约为基线(11.73-11.98%)的 4 倍,得益于自配对数据的长度多样性。STR 代理评测:用各方法编辑图训练 STR 模型,TextRIRO 平均 86.67%,领先次优 RS-STE(76.89%)9.78 个百分点,不规则子集优势扩大到 11.69%(CUTE 82.64 vs 59.72),但仍比真实数据低 10.10%,主要来自漏过过滤器的失败样本。数据集层面:MAERec 混入 TextRIRO 1M 后 Union14M-Benchmark 平均从 86.09% 升至 87.98%,扩到 3M 达 88.00%(+1.91%),Multi-words 从 86.89% 升至 90.17%(+3.28%);SVTRv2-S 同样受益(+0.81/+1.34)。补充实验显示加入合成数据虽把 ACC 提到 85.08% 但 FID 恶化到 49.34,而与 TextSSR、ST 三源混合可将 Union14M 推到 88.69%,说明真实路线与既有合成资源互补。
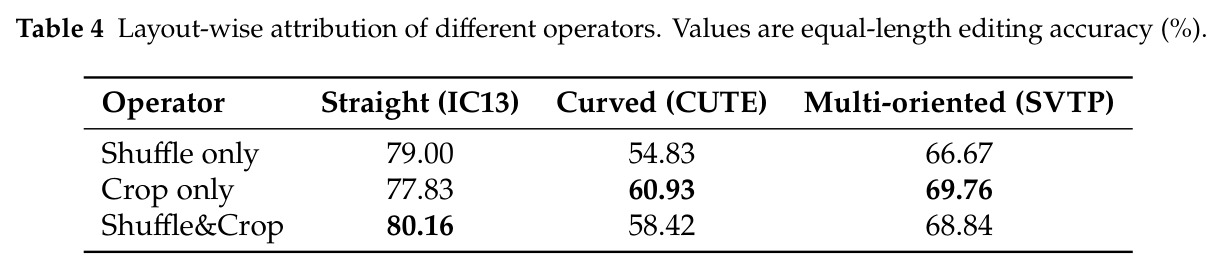
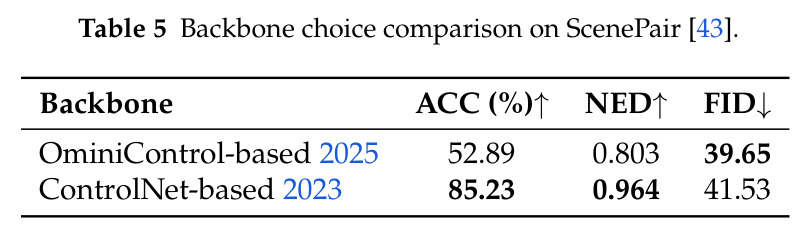
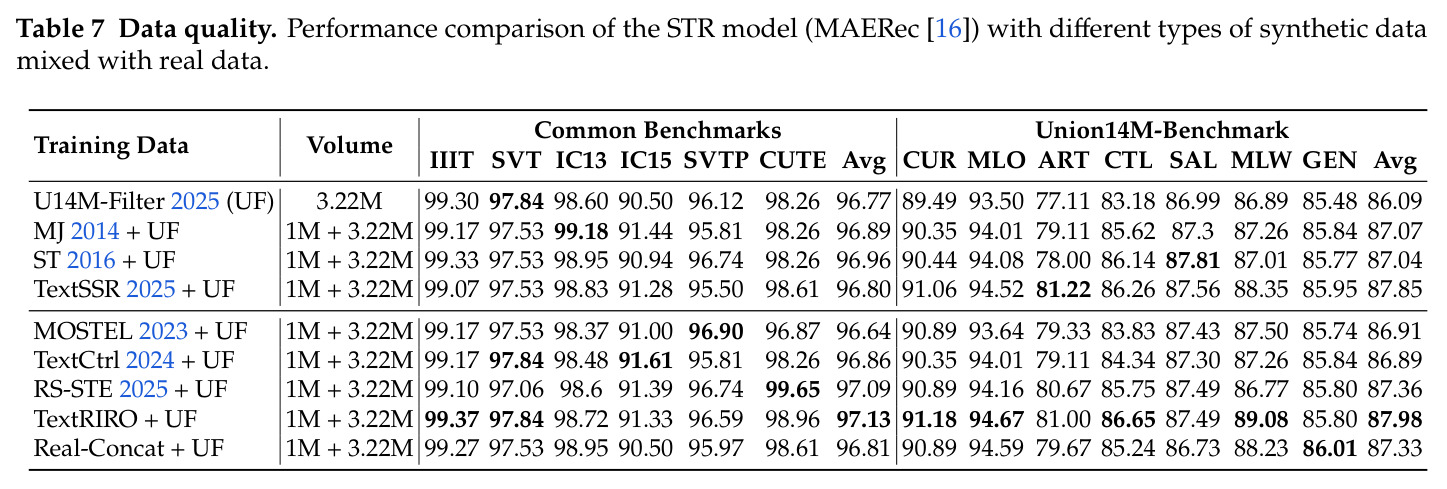
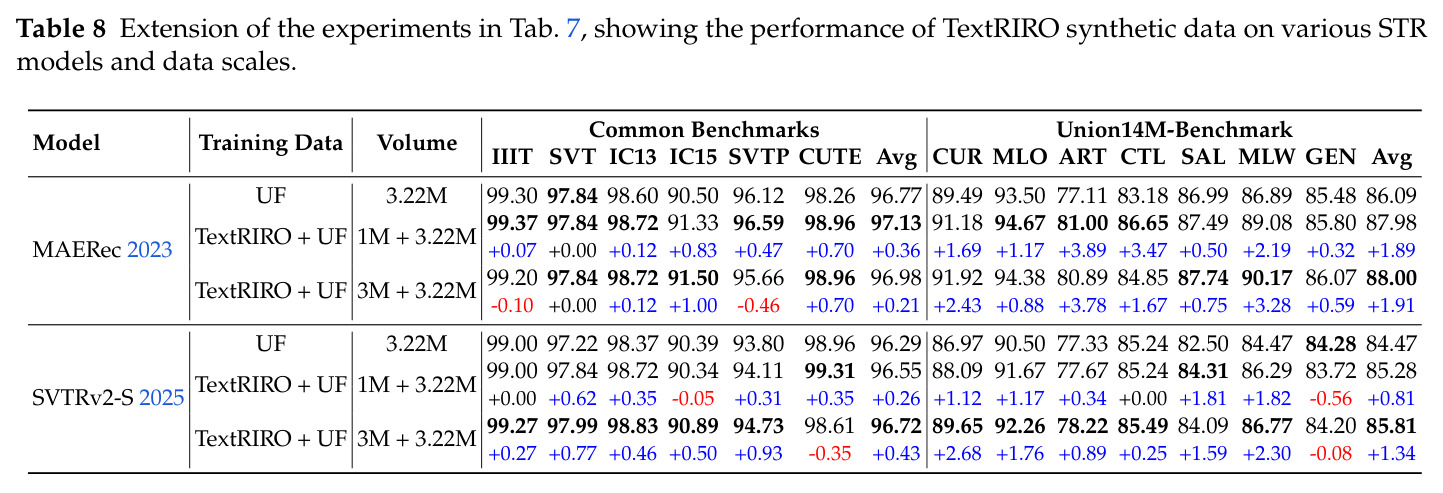
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ScenePair 真实场景文本编辑(视觉真实感) | FID(越低越好) | 41.53 | TextCtrl 43.78 / RS-STE 49.59 | 比最佳基线低 2.25,全场最佳且最接近真实分布 |
| ScenePair 真实场景文本编辑(文字正确率) | 词准确率 ACC(%) | 85.23 | TextCtrl 84.67(真实上界 88.44) | +0.56,贴近真实上界 |
| RIROCommon 等长编辑(六基准平均) | 归一化准确率(%) | 79.31 | TextCtrl 70.67 / RS-STE 60.24 | 比最强基线 +8.64,比 RS-STE +19.07 |
| RIROCommon 变长编辑(六基准平均) | 归一化准确率(%) | 47.64 | TextCtrl 11.98 / RS-STE 11.73 | 约为基线的 4 倍(+35.66) |
| STR 训练代理评测(拿编辑图训练识别模型) | STR 平均准确率(%) | 86.67 | RS-STE 76.89 / TextCtrl 75.99 | +9.78(不规则子集 +11.69) |
| Union14M-Benchmark 数据增益(MAERec + TextRIRO-3M) | 平均准确率(%) | 88.00 | 纯真实数据 U14M-Filter 86.09 | +1.91(Multi-words 子集 +3.28) |
局限与改进
作者承认三方面局限:其一,长文本编辑受限——文本编码器沿用 STR 预训练权重而 STR 数据以短文本为主,长文本依赖关系捕捉不足,对策是切分后逐段编辑再拼接;其二,极端弯曲和复杂几何文字仍困难,模型可能把高曲率误判为倾斜,CUTE 上等长编辑 64.87% 已是最佳但绝对值不高,作者提议引入 TPS 式控制点;其三,特殊符号和跨语言泛化受限于真实标注数据分布,94 字符词表外覆盖稀疏,多语言真实数据稀缺。此外编辑数据与真实数据训练间仍有 10.10% 准确率差距,主要来自漏过 STR 过滤器的失败样本。我的补充观察:训练与推理存在残余失配——训练时风格条件永远是扰动图,推理时却是未扰动真实图,None 消融证明这是必要设计,但意味着模型从未在「真实图作条件」的分布上训练;强过滤带来选择偏差,会系统性拒绝罕见风格的正确样本;TextRIRO-3M 对称拼接使标签长度全为偶数,与真实长度分布不符,主数据集仍带此偏差;CFG 消融($\omega=5.0$ 时 ACC 88.05% 但 FID 恶化到 50.24)说明正确率与真实感尚未同时最优。
独立分析的弱点
第一,训练-推理条件失配是结构性弱点:模型训练时风格条件永远是被扰动的图,推理时却要处理任意未扰动真实图,遇到与扰动分布差异大的输入(密集背景、遮挡、极端长宽比)时鲁棒性存疑;改进方向是把真实图与轻微扰动图按比例混合作为条件,或引入条件感知的归一化模块。第二,Shuffle 依赖文本长度标注且假设文字沿长轴均匀分布,标注长度一旦出错,切分就会错位、破坏条带完整性,长文本尤其脆弱;可改用文本检测器的字符框估计切分位置,摆脱对标注长度的精确依赖。第三,强 STR 过滤造成选择偏差:过滤模型在罕见风格上失败时会错杀视觉上正确的样本,长尾场景的数据增益受限;可用多识别器投票或置信度阈值放宽过滤,再辅以小规模人工抽检。第四,拼接式扩充只把序列长度翻倍,且对称配方产生全偶数长度伪影,与真实长度分布不符;非对称配方论文只在小规模实验(0.5M)验证,应纳入主流水线并用长度分布对齐损失约束。第五,扩散模型推理 0.20 秒/张,生成 300 万样本耗时显著,且 FID 随 CFG 提升而恶化,说明真实感与正确率的帕累托前沿尚未探索充分,可考虑蒸馏加速或引导函数改进。
未来方向
作者明确提出的方向包括:低资源多语言 STE——自配对操作本身语言无关,瓶颈在真实标注语料,需要收集字符与语言覆盖更均衡的真实数据,并为多语言和通用 OCR 提供合成数据;DiT 时代的细粒度条件控制——当前 OminiControl 式 token 级注入太粗糙,需要空间分辨率更高的 DiT 条件机制处理字符级细节;引入 TPS 式控制点实现更精确的几何控制以处理极端弯曲文本;把长文本切分-逐段编辑-拼接固化为标准流水线以突破长度上限。基于本文成果可以延伸的方向:一是把「扰动-重建」范式迁移到其他需要配对监督的编辑任务,如 logo 编辑、手写风格模仿、图表文字修改——凡风格在低层、语义在高层的任务都可套用;二是把 TextRIRO-3M 式拼接数据与课程学习结合,专门强化长文本和多词识别;三是结合水印与溯源技术研究 STE 对文档防伪的影响,论文已明确提示文本篡改滥用风险;四是用更大规模真实语料加更强基础模型(SD 3.5 的 VAE 消融已显示 PSNR 30.77 的更优重建)继续缩小与真实上界的差距。
复现评估
复现条件较为友好。论文承诺开源代码、数据构建脚本与 TextRIRO-3M(GitHub: YesianRohn/TextRIRO),训练数据 U14M-Filter(3.22M 标注)与评测集 ScenePair、RIROCommon、Union14M-Benchmark 全部公开。算力门槛中等:STR 预训练 36 GPU 小时加 U-Net 微调 180 GPU 小时(8×V100、batch 256、15 轮),用更大显存的现代卡可压缩;推理仅 20 步扩散、V100 上 0.20 秒/张,单卡即可批量生成数据集。关键超参数齐全:$p_{shuffle}=0.7$、CFG $\omega=2.2$、64×256 输入、SD 1.5 U-Net 加 SD 2.1 VAE、词表 94+1 字符、最大长度 25,附录还给出 p_shuffle、CFG、VAE、DiT 等完整消融数字,对齐成本低。难点在细节还原:STR 预训练基于 OpenOCR/MAERec 框架,需复现其训练配置;自配对切分(列宽、旋转预处理、长度对齐)虽有算法 1 伪代码仍需仔细处理边界;数据集生成依赖 SVTRv2 过滤模型,需额外准备。总体判断:拥有单机 8 卡资源的团队可在数天内复现主结果。
论文图表
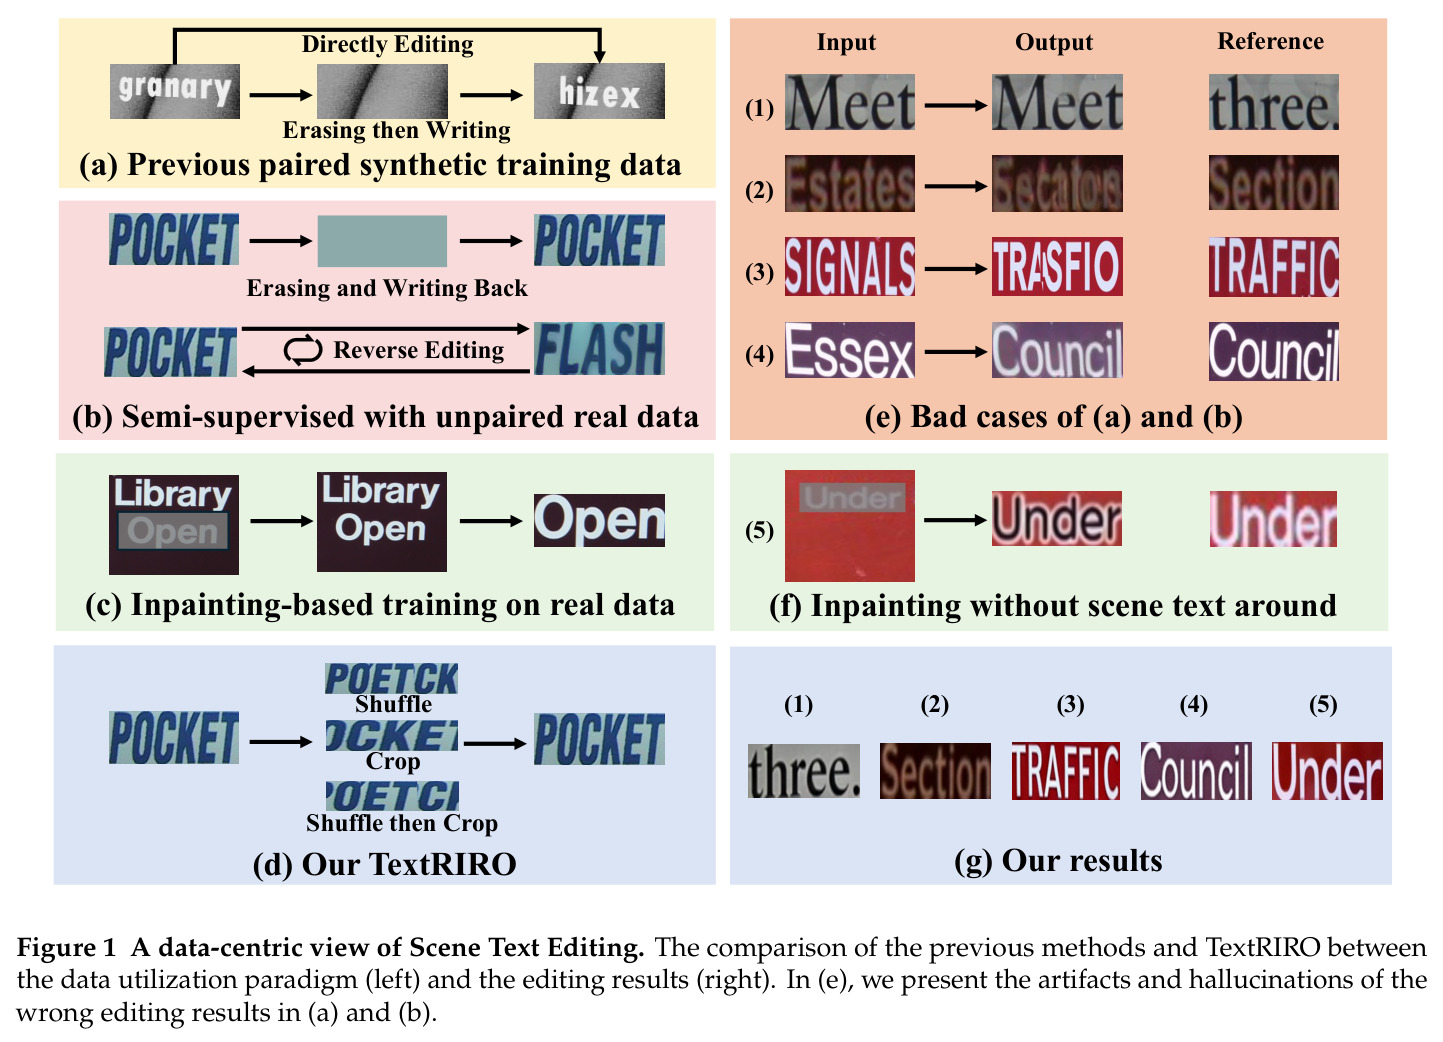
从数据中心视角对比已有方法与 TextRIRO:(a) 依赖合成配对数据的直接编辑/先擦后写两阶段范式;(b) 利用无配对真实数据的半监督;(c) 基于修补的真实数据训练;(d) 本文的 Shuffle/Crop/Shuffle-then-Crop 自配对构造。右侧展示各类方法的失败案例(伪影、幻觉)与本文结果。
这张图一页讲清了全文的问题定义与分类框架:为什么合成数据路线会失败、修补路线为何缺风格线索、而本文的扰动构造如何不同,是理解动机的最佳入口。
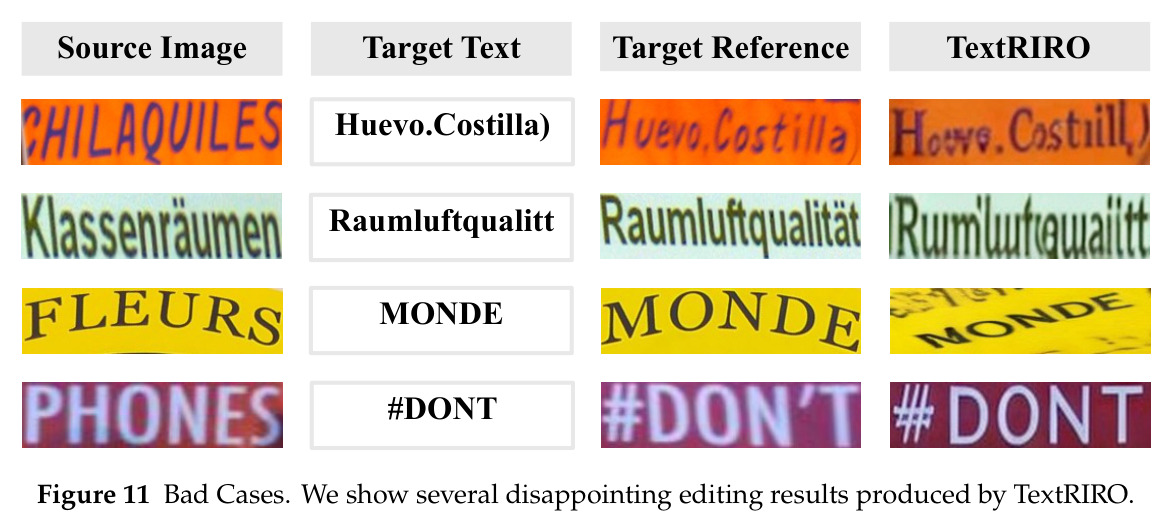
展示 TextRIRO 的三类典型失败:长文本(Huevo.Costilla 等长序列编辑出错)、极端弯曲文字(Raumluftqualitt 几何失真)、特殊符号与生僻字符串(#DONT、MONDE)编辑失败。
诚实的失败案例展示划定了方法的适用边界,配合附录对三类失败的成因分析(STR 预训练短文本偏差、曲率误判、词表覆盖),是判断能否在自己场景使用的关键参考。