言同行异:推理型视觉-语言-动作模型中文本-动作分歧的诊断与调控 Say the Same, Act Differently: Diagnosing and Steering Text-Action Divergence in Reasoning VLAs
视觉扰动可在推理文本逐字不变时改变模型动作,理由监控无法认证具身安全
前置知识
推理型 VLA(Reasoning Vision-Language-Action 模型)
视觉-语言-动作模型把视觉观察与语言指令映射为具身动作;推理型 VLA 额外自回归生成自然语言的理由、场景描述或计划,并与连续动作头共享同一份中间隐藏状态。本文研究两个代表:NVIDIA Alpamayo-1.5(10B 参数,驾驶,输出 6.4 s / 64 个路径点的轨迹加驾驶理由)与 InstructVLA(机械臂操作,流匹配动作专家输出 16 步 7-DoF 动作块加一句任务意图)。
论文的全部问题都围绕这条语言通道:它能否作为动作安全的凭证。不理解“文本与动作共享隐藏状态”这一架构前提,就无法理解为什么可以做到言同而行异。
流匹配动作头与欧拉积分
流匹配是一种连续生成范式:从高斯噪声出发学习一个速度场,用欧拉法数值积分若干步得到动作序列。两个模型都用固定 10 步欧拉求解器与配对共享的初始噪声(seed 42)解码,保证干净/扰动两次前向只在干预上有差别:Alpamayo 积分加速度-曲率控制成 64×2 平面路径点,InstructVLA 直接输出 16×7 归一化动作块。
论文所有动作度量($\Delta\mathrm{ADE}$、$\Delta\mathrm{IVLA}$)与攻击损失都要穿过这个可微分解码过程反传到隐藏状态,配对噪声设计是控制变量、隔离扰动效应的关键。
教师强制与前向 KL 散度
教师强制指把真实上文 token 喂入模型、只预测下一个 token。本文用前向 KL $KL_{\mathrm{tf}}=\frac{1}{|R|}\sum_{t\in R}\sum_v p^{\mathrm{cln}}_{t,v}\log\frac{p^{\mathrm{cln}}_{t,v}}{p^{\mathrm{adv}}_{t,v}}$(单位 nat)度量扰动前后下一 token 分布在活跃文本跨度上的平均漂移;与“自由生成逐字精确匹配”互补——一个测分布层面漂移,一个测采样后的字面一致性。
诊断探针用固定 KL 预算定义“文本不变”,攻击评估用其下降幅度衡量 TNAS 引导的效果,全文核心主张都建立在这个指标上。
雅可比、SVD 与子空间投影
雅可比 $J_A=\partial A_{\mathrm{hook}}/\partial\delta\,|_{\delta=0}$ 刻画动作输出对隐藏状态微小加性扰动的局部线性敏感度,其顶右奇异向量(thin SVD 给出)$d_{\mathrm{act}}$ 即局部最动作敏感方向。对两个干净点梯度非零的文本损失梯度 $\{g_{\mathrm{NLL}},\,g_{\mathrm{margin}}\}$ 做 Gram-Schmidt 正交化得秩 2 基,正交投影算子 $P_{\mathcal{T}}$ 剥离 $d_{\mathrm{act}}$ 中的文本成分,残差归一化即 $d_{\mathrm{TNAS}}$。
TNAS 的构造、投影率 $\rho$、以及“投影后保留 >99.8% 动作方向范数”等全部关键数字,都是这三个线性代数工具的直接推论。
PGD 投影梯度下降攻击
最经典的白盒对抗攻击:每步沿损失梯度符号更新输入扰动 $\delta^{(k+1)}=\Pi_{\mathcal{S}}\big[\delta^{(k)}+\alpha\,\mathrm{sign}\,\nabla_\delta\mathcal{L}\big]$,再投影回 $\ell_\infty$ 半径 $\varepsilon$ 的球与允许的空间掩码。本文跑 200 步,梯度端到端穿过视觉编码器、语言主干与动作头;全图 $\varepsilon=0.05$,局部 patch $\varepsilon=0.5$。
TNAS 引导项就是加在 PGD 目标上的一个余弦正则;不了解 PGD 就无法理解攻击实现与 $\lambda_{\cos}$ 扫描的含义。
研究动机
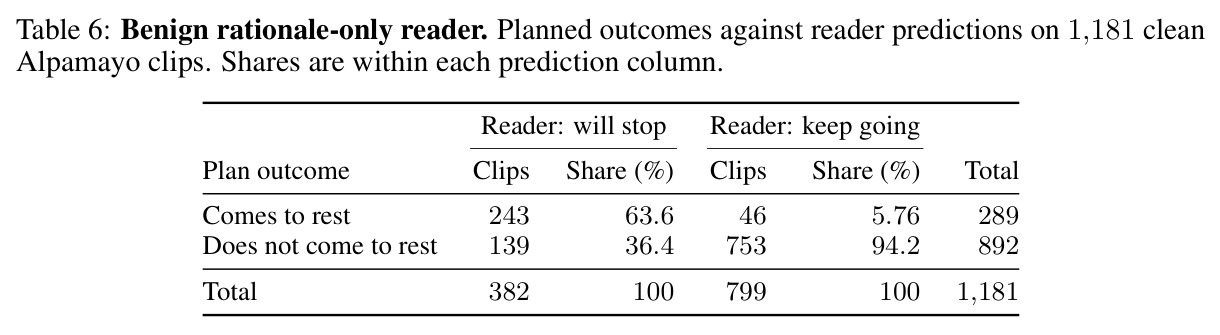
推理型 VLA(如自动驾驶模型 Alpamayo-1.5、机械臂操作模型 InstructVLA)在输出连续动作的同时生成人类可读的自然语言理由,监督者依赖这条文本通道在动作执行前审计安全隐患。然而现有针对推理 VLA 的攻击——如 TRAP 用对抗 patch 劫持思维链、Trinh 等直接篡改推理文本中的对象名——都必然改写文本本身,在监督者阅读的通道里留下可见痕迹,因此实践中默认“文本没变约等于动作安全”。良性数据也支持这一直觉:用冻结的 Qwen3-14B 仅读 Alpamayo 的理由预测是否停车,在 1,181 个片段上达到 84.3% 准确率(AUROC 0.882)。但这个直觉掩盖了结构性风险:语言是连续隐藏状态的离散、多对一读出——1,181 个片段只共享 258 个不同理由,36.9% 的片段的理由同时伴随相反的停车结局,最高频理由(“与前车保持距离,因为它在我们车道正前方”)单独覆盖 245 个片段,前向位移横跨 10.1 m 到 208 m。既然正常情况下同一句理由就能对应截然不同的动作,“文本不变能否作为安全凭证”就成了一个必须被对抗性检验的开放问题。
本文的目标是论文要回答的核心问题是:共享隐藏状态中是否存在“改变动作但文本读出不变”的方向,而且仅修改视觉输入能否端到端地到达它?目标分三层。第一,构造诊断工具 TNAS:在文本-动作共享接口上找出局部最动作敏感的方向,度量它与活跃文本损失梯度的重叠比例 $\rho$,并投影出文本中性动作方向 $d_{\mathrm{TNAS}}$。第二,用两类受控隐藏状态干预验证该方向的因果作用——Probe 2 在固定文本 KL 预算下比较动作位移,Probe 3 在等扰动范数下同时观测文本与动作两个通道,以排除“步长更大”的混淆解释。第三,把诊断转化为输入层攻击:在 PGD 目标中加入隐藏状态偏移与 $d_{\mathrm{TNAS}}$ 的余弦对齐项,在自由生成条件下同时最大化动作偏移与逐字文本保持,并在 154 个有障碍标注的驾驶片段上用“静默碰撞率”(干净计划无碰撞、扰动后碰撞且理由逐字不变)量化真实安全危害,最终给出“理由监控不能认证动作安全、必须直接验证动作通道”的防御结论。
与已有工作不同的是,独特切入角度是把安全审计的失效模式从“文本输出层”下移到“共享表征的局部几何层”。以往工作在两个输出端做文章:推理劫持攻击改变文本从而连带动作(留下可见痕迹),联合损失方法同时约束动作与文本(两组梯度在同一像素上竞争,本文证明输出级文本惩罚反而使词汇级 KL 从 $2.78\times10^{-1}$ 升到 $3.26\times10^{-1}$)。本文绕开输出读出,直接问几何问题:在 $\delta=0$ 处,动作雅可比的顶奇异方向与活跃文本梯度张成的子空间夹角有多大?答案是近乎正交——范数重叠仅 1.87%(Alpamayo)与 5.28%(InstructVLA),投影掉文本子空间后仍保留 >99.8% 的动作方向范数。这个视角一举三得:解释了为什么理由监控在对抗条件下结构性失效;为攻击提供了化解动作-文本梯度冲突的正交引导方向;也与表示工程、激活导向、线性概念擦除等文献形成方法论衔接——把“子空间投影擦除”用于导向方向本身。
核心方法
直觉上,理由是隐藏状态的离散多对一读出,动作是同一状态的连续读出,连续空间比离散文本空间“大得多”,必然存在大量动作敏感但文本一阶不变的自由度。技术路线分三步。第一步搭建共享接口:钩住若干连续 transformer 层(Alpamayo 第 32–35 层的推理 token、InstructVLA 第 14–17 层的响应 token),把每层在活跃 token 跨度 $R$ 上的均值拼接成池化状态 $h\in\mathbb{R}^{Kd}$,作为文本与动作两个头的共同读出点。第二步构造方向:对动作输出(Alpamayo 的 64×2 平面路径点、InstructVLA 的 16×7 动作块)在 $\delta=0$ 处求雅可比,取顶右奇异向量为 $d_{\mathrm{act}}$;用干净点梯度非零的两个文本损失——目标 NLL $\mathcal{L}_{\mathrm{NLL}}$ 与符号化目标边距差 $\mathcal{L}_{\mathrm{margin}}$——张成秩 2 文本子空间 $\mathcal{T}$,正交投影得到 $d_{\mathrm{TNAS}}=\mathrm{normalize}\big((I-P_{\mathcal{T}})\,d_{\mathrm{act}}\big)$。第三步双向验证:先直接干预隐藏状态确认几何性质,再把视觉输入的 PGD 目标加上余弦对齐项,在全图与局部 patch 两种威胁模型下端到端地诱导“言同而行异”。
核心创新是文本中性动作子空间(TNAS)这个几何对象及其双重用途。与已有方法的本质区别有三。其一,与推理劫持攻击(TRAP、推理痕迹篡改)方向相反:它们改文本、连带改动作,在监控通道留痕;本文证明存在与活跃文本梯度近正交的动作敏感方向(重叠仅 1.87%/5.28%,随机向量参照均值 0.978%),沿它扰动可以保持理由逐字不变而动作大幅偏移——“文本未变”由此失去认证能力。其二,与输出级联合优化相反:把动作位移最大化与文本 NLL/边距惩罚写进同一个像素目标,是梯度打架的根源;TNAS 引导项 $\lambda_{\cos}\cos(\Delta h,\,d_{\mathrm{TNAS}})$ 从几何源头化解冲突——沿 $d_{\mathrm{TNAS}}$ 移动隐藏状态对两个文本损失一阶不变,却持续推动动作读出,而且这个余弦项完全不接触 token logits。其三,与激活导向把方向直接写入隐藏状态不同,攻击只扰动视觉输入,靠端到端反传让输入诱导的偏移 $\Delta h$ 自发对齐 $d_{\mathrm{TNAS}}$;诊断(干预探针)与利用(输入攻击)由同一个几何对象统一。
方法步骤详情
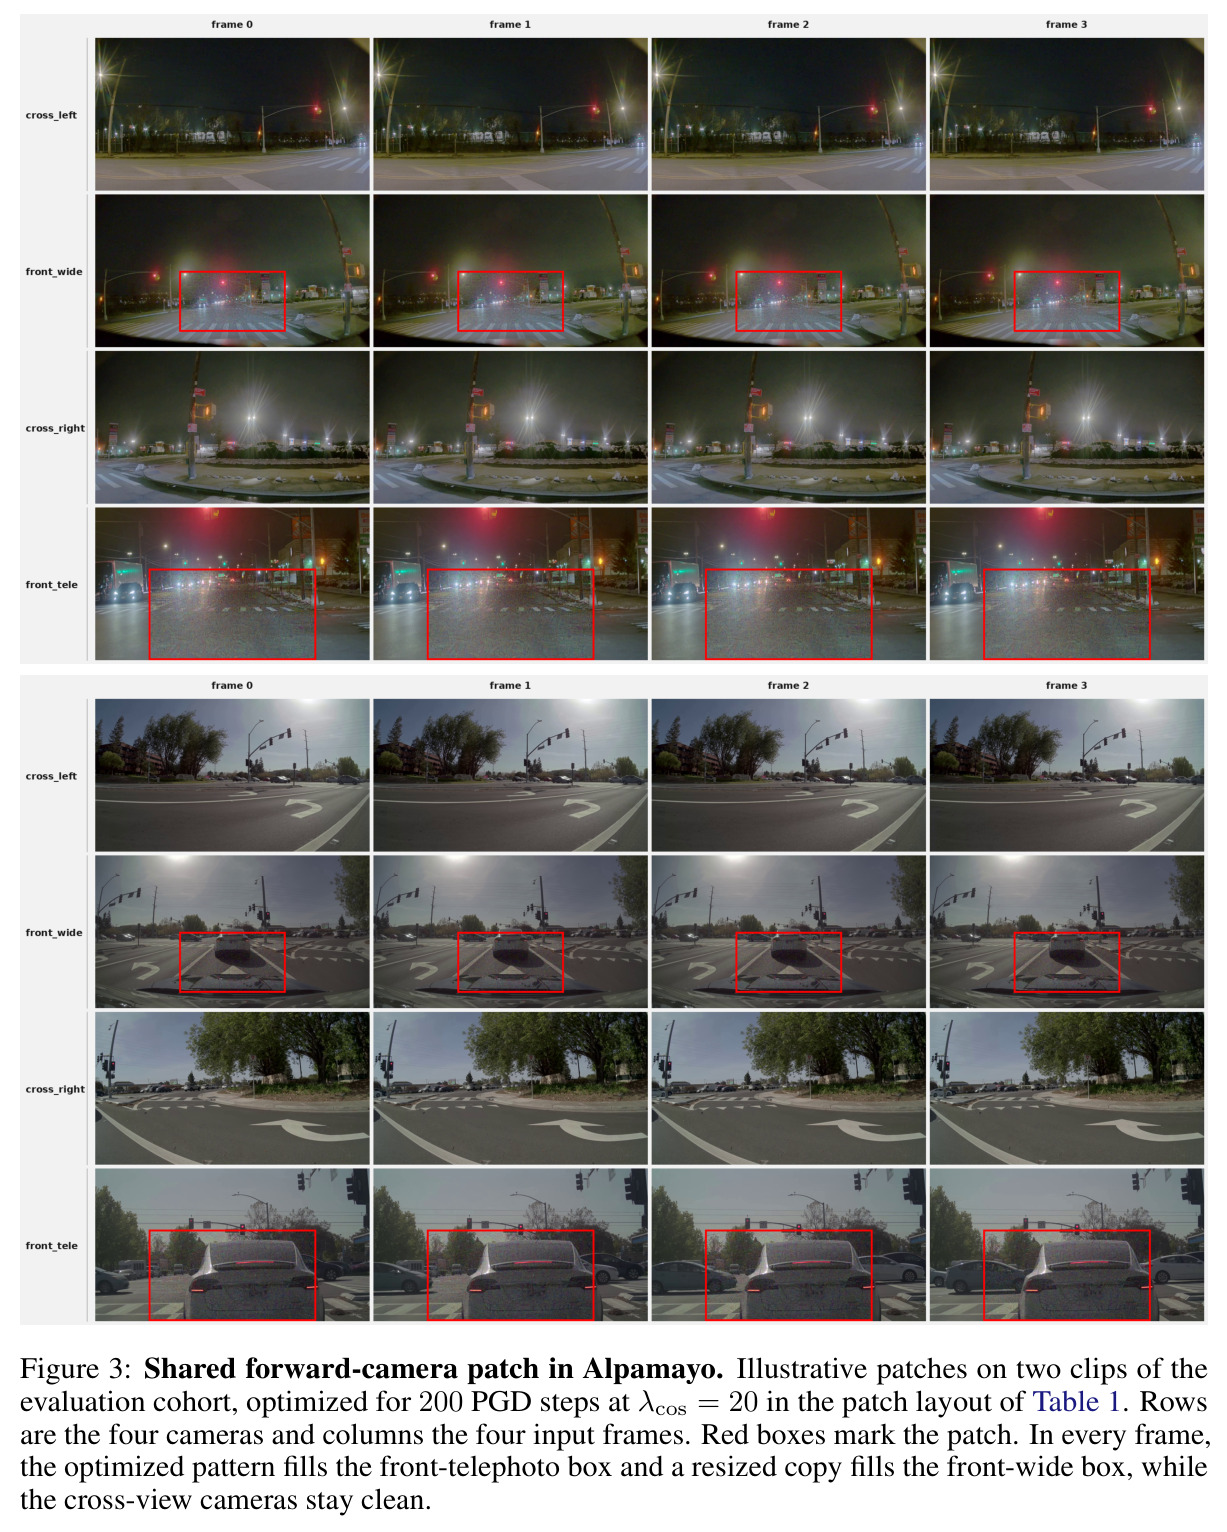
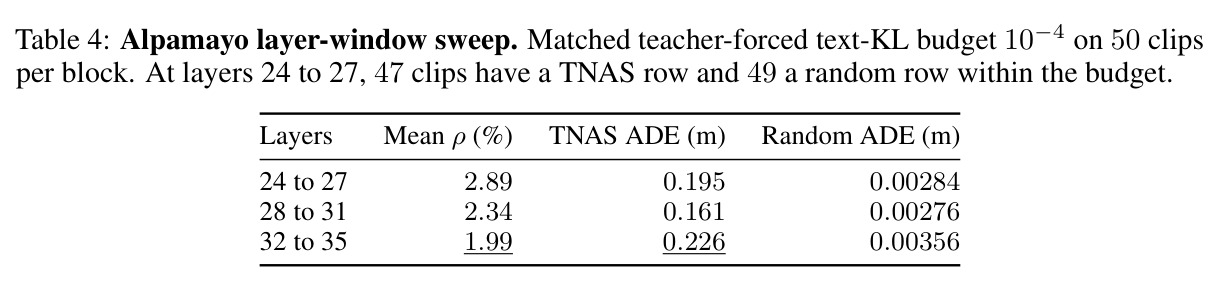
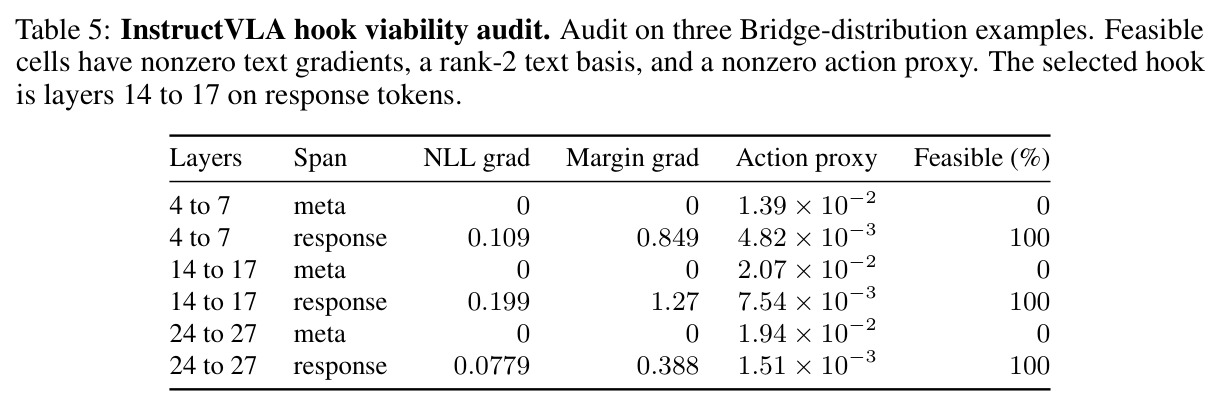
完整流程六步。第一步选钩子:Alpamayo 在三个层窗(24–27 / 28–31 / 32–35)上按 KL 预算 $10^{-4}$ 做 50 片段扫描,第 32–35 层动作响应最强且投影率最小(1.99%)故入选;InstructVLA 经可行性审计选响应 token 第 14–17 层(元 token 跨度文本梯度为零,不可行)。第二步建读数:动作头用固定 10 步欧拉流匹配求解器与配对初始噪声解码,动作变化 $\Delta\mathrm{ADE}=\frac{1}{T}\sum_{t}\|\tau_t(\delta)-\tau_t(0)\|_2$($T{=}64$,6.4 s@10 Hz)或 16 步 7-DoF 归一化位移;文本漂移取活跃跨度上教师强制前向 KL。第三步造方向:$d_{\mathrm{act}}$ 取动作雅可比 $J_A=\partial A_{\mathrm{hook}}/\partial\delta|_{\delta=0}$ 的顶右奇异向量;$\mathcal{L}_{\mathrm{NLL}}$ 与 $\mathcal{L}_{\mathrm{margin}}$ 的干净点梯度经 Gram-Schmidt 得秩 2 文本基,投影出 $d_{\mathrm{TNAS}}$。第四步隐藏状态验证:Probe 2 调步长使各方向达到同一 KL 预算后比较动作位移;Probe 3 给所有方向加等范数 $|q|S_{\mathrm{clip}}$($q\in\{0.5,1,2\}$)同时观测 KL 与动作。第五步输入攻击:200 步 PGD 最大化 $\mathcal{L}_{\mathrm{TNAS}}=\mathcal{L}_{\mathrm{act+txt}}+\lambda_{\cos}\cos(\Delta h,d_{\mathrm{TNAS}})$,其中 $\mathcal{L}_{\mathrm{act+txt}}=\mathcal{L}_{\mathrm{act}}-\lambda_{\mathrm{txt}}[\Delta\mathcal{L}_{\mathrm{NLL}}+\Delta m]$;全图 $\varepsilon{=}0.05$、patch $\varepsilon{=}0.5$(Alpamayo 前向相机路面 patch 占 13.1% 视觉 token,InstructVLA 占 16% 图像面积)。第六步评估:固定前缀读数、自由生成逐字精确匹配、154 个标注片段上的开环静默碰撞检测(BEV 有向包围盒+分离轴定理,0.1 s 步长,6.4 s 视野)。
技术新颖性
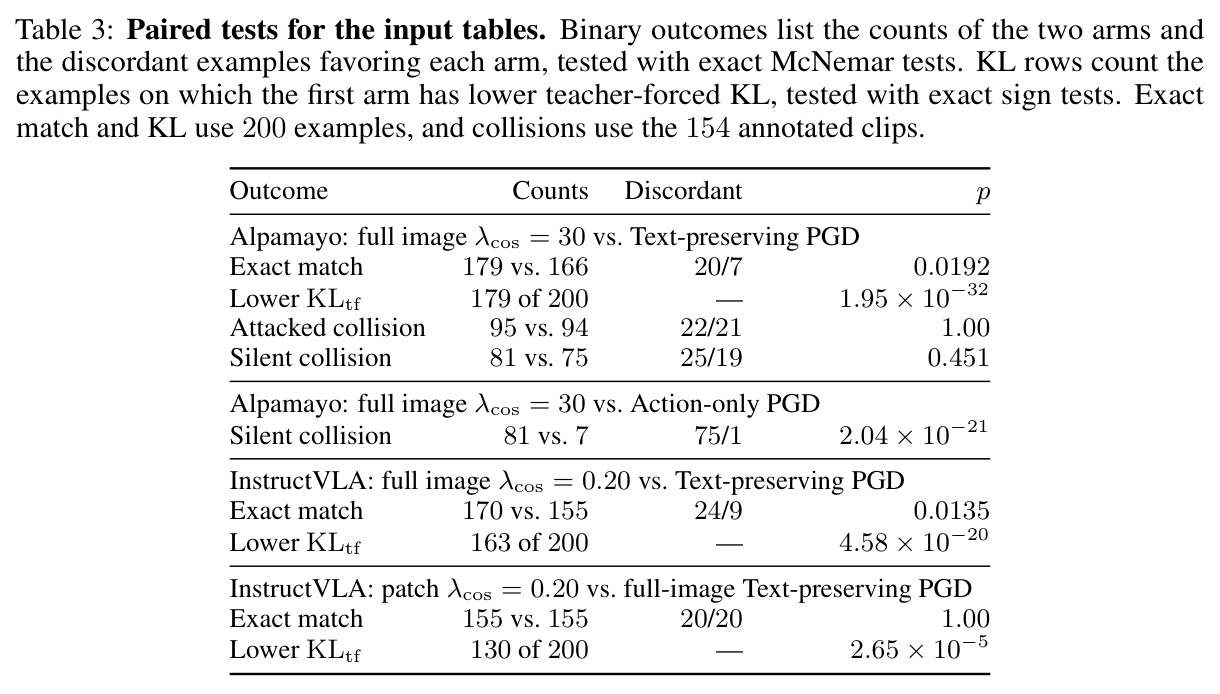
技术新颖性体现在四个层面。诊断方法上,TNAS 把线性概念擦除/子空间投影的方法论迁移到导向方向本身:以往投影用于让读出器读不到受保护属性,本文投影掉文本梯度子空间、使导向方向对文本读出一阶不可见,这在文本-动作共享接口上是新用法。损失设计上,作者严格筛选“在干净点活跃”的文本损失——教师强制 KL 在分布重合处梯度为零、hinge 损失在边距满足时梯度饱和,均不能定义局部文本敏感度;改用目标 NLL 与符号化目标边距差,保证文本子空间在 $\delta=0$ 处梯度非零且秩恰为 2,这一细节决定整个诊断的成立。攻击机制上,余弦对齐项作为纯几何正则加入 PGD,不接触任何 token logit 或文本损失,却把教师强制 KL 单调拉低 68.4%(Alpamayo)/40.5%(InstructVLA),证明几何引导系统性优于输出级惩罚。评估设计上,“静默碰撞率” $\frac{1}{154}\sum_i \mathbf{1}\{M_i\wedge A_i\wedge\neg C_i\}$ 把几何发现转译为安全语义,并配合配对 McNemar/符号检验(如精确匹配 179 vs 166,$p=0.0192$;KL 更低 179/200,$p=1.95\times10^{-32}$)给出可复核的统计支撑。
实验结果
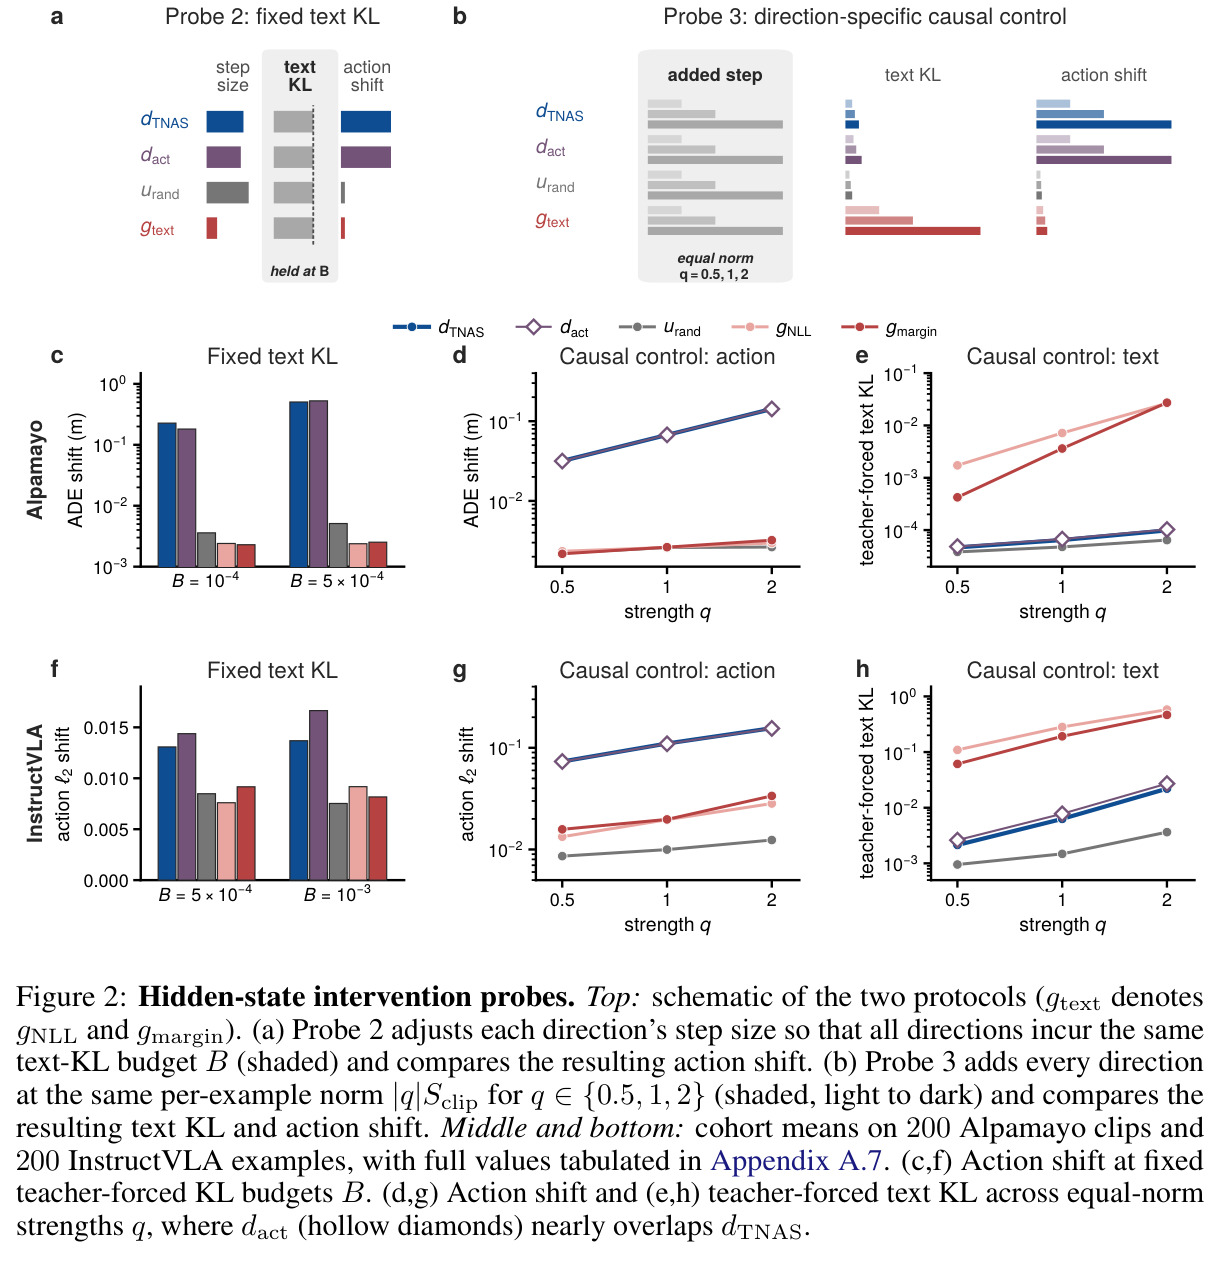
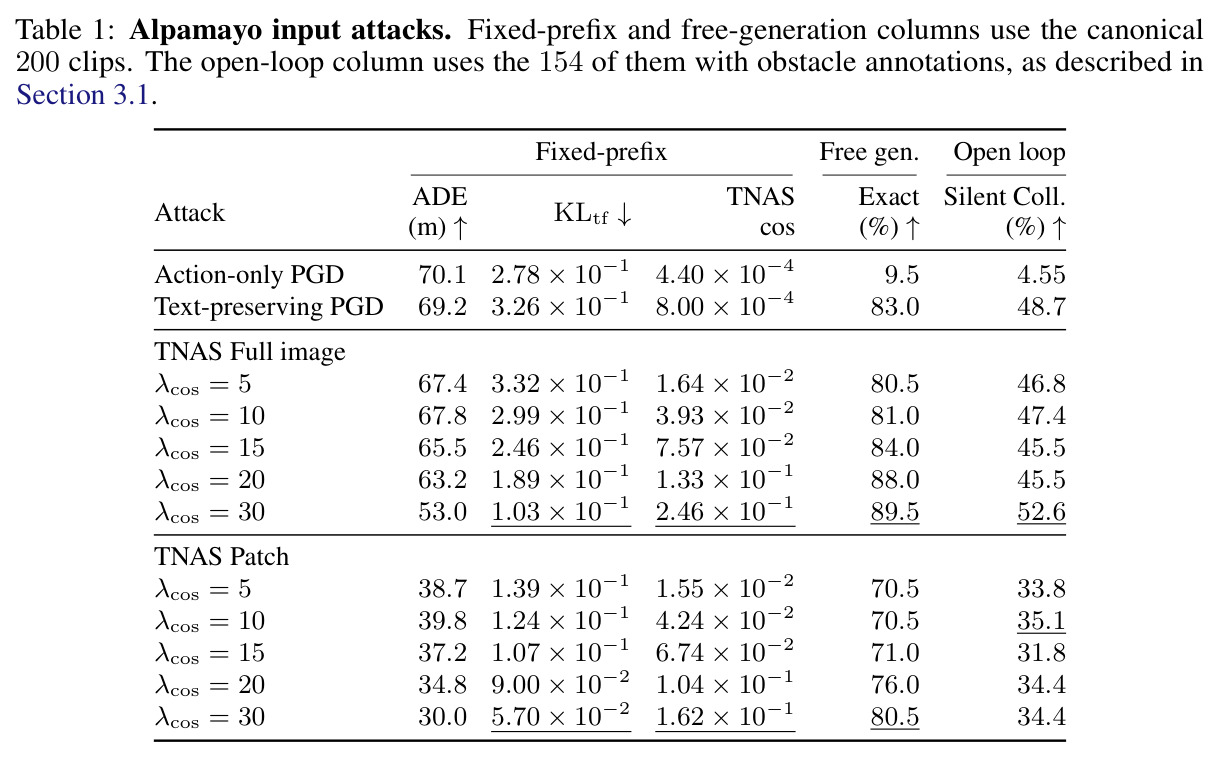
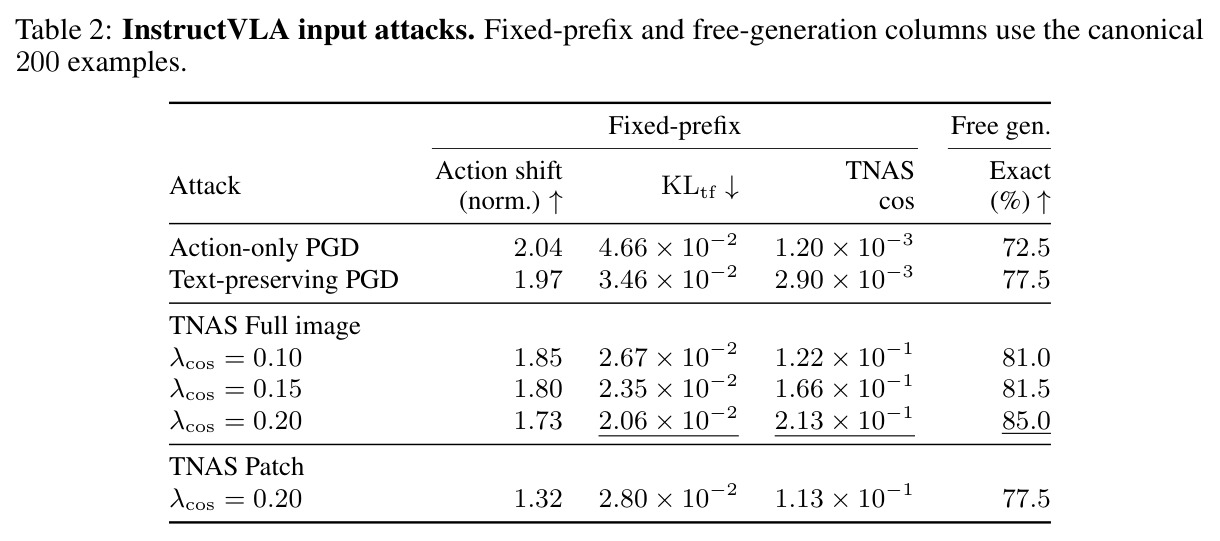
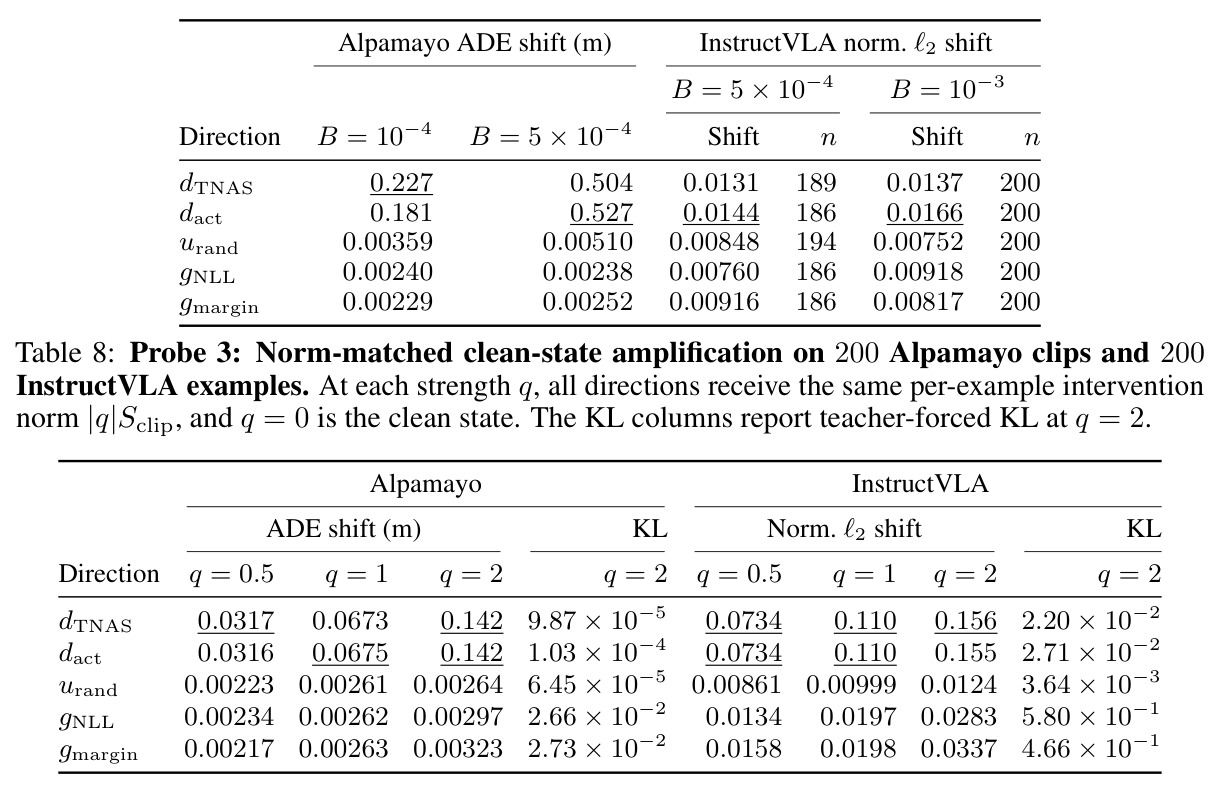
核心发现按实验顺序。探针 1(良性几何):Qwen3-14B 只读理由预测停车在 1,181 片段上达 84.3%(AUROC 0.882),但 258 个不同理由中 36.9% 的片段与相反停车结局共存;动作方向对文本子空间的投影率 $\rho$ 均值为 1.87%(Alpamayo 200 片段)与 5.28%(InstructVLA 200 样本),随机向量参照 0.978%,投影后保留 >99.8% 范数。探针 2(固定 KL 预算):沿 $d_{\mathrm{TNAS}}$ 扰动使 Alpamayo 轨迹移动 0.227 m($B{=}10^{-4}$)与 0.504 m($B{=}5\times10^{-4}$),超控制方向($\le$5.10 mm)63.3–212 倍;InstructVLA 在 $B{=}10^{-3}$ 达 $1.66\times10^{-2}$,控制最高 $9.18\times10^{-3}$。探针 3(等范数):$q{=}2$ 时 $d_{\mathrm{TNAS}}$ 动作位移超文本梯度控制 44.0–47.8 倍、超随机 53.9 倍,而其 KL 仅 $9.87\times10^{-5}$(控制高 269–277 倍);InstructVLA 位移 0.156、超控制 4.64–5.51 倍。输入攻击(表 1):Action-only PGD 偏移 70.1 m ADE 但 90.5% 片段理由被改写、静默碰撞仅 4.55%;Text-preserving PGD 精确保持 83.0%、静默碰撞 48.7%;TNAS 全图 $\lambda_{\cos}{=}30$ 精确保持升至 89.5%、KL 降 68.4%、静默碰撞 52.6%(全场最高);前向相机 patch 静默碰撞最高 35.1%、精确保持 80.5%、KL 降 59.0%。InstructVLA(表 2):TNAS 全图 $\lambda_{\cos}{=}0.20$ 精确保持 77.5%→85.0%、KL 降 40.5%、动作块偏移 1.73;patch 偏移 1.32、精确 77.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 静默碰撞(Alpamayo 开环安全,154 个有障碍标注片段) | 静默碰撞率 (%):干净计划无碰撞 → 扰动后碰撞且理由逐字不变 | 52.6%(TNAS 全图引导,λcos=30) | 4.55%(Action-only PGD);48.7%(Text-preserving PGD) | 较 Action-only 约 11.6 倍;较 Text-preserving +3.9 个百分点且文本指标全面更优 |
| 驾驶理由逐字保持(Alpamayo 自由生成,200 片段) | Exact match (%) | 89.5%(λcos=30) | 83.0%(Text-preserving PGD);9.5%(Action-only PGD) | +6.5 个百分点,教师强制 KL 同时下降 68.4%(至 1.03×10⁻¹) |
| 操作响应逐字保持(InstructVLA 自由生成,200 样本) | Exact match (%) | 85.0%(λcos=0.20) | 77.5%(Text-preserving PGD);72.5%(Action-only PGD) | +7.5 个百分点,KL 下降 40.5%(至 2.06×10⁻²),动作块偏移保持 1.73 |
| 隐藏状态等范数干预(Alpamayo,q=2,200 片段) | 轨迹平均位移 ADE (m) | 0.142 m(dTNAS) | 0.00264 m(随机方向);0.00297–0.00323 m(文本梯度方向) | 超随机 53.9 倍、超文本梯度 44.0–47.8 倍,且 KL 反而低 269–277 倍 |
| 隐藏状态固定 KL 预算干预(Alpamayo,B=5×10⁻⁴) | 轨迹平均位移 ADE (m) | 0.504 m(dTNAS) | ≤0.00510 m(全部控制方向) | 63.3–212 倍 |
| 局部 patch 攻击(Alpamayo 前向相机,13.1% 视觉 token) | 静默碰撞率 (%) / Exact match (%) | 35.1% / 80.5% | 全图 Text-preserving PGD:48.7% / 83.0% | 受限于 13.1% 扰动面积仍诱导大量静默碰撞,KL 较全图 patch 扫描起点降 59.0% |
| 良性理由-动作一致性探针(1,181 片段) | 只读理由的停车预测准确率 (%) | 84.3%(Qwen3-14B 只读理由,AUROC 0.882) | AUROC 0.820(仅按入口车速排序的无文本基线) | 良性时理由确有信息量,但 36.9% 片段理由与相反停车结局共存——对抗条件下不可依赖 |
局限与改进
作者承认或隐含的局限:其一,威胁模型是白盒数字扰动——扰动施加在归一化预处理后的输入张量上,需要访问模型软件管线与梯度;patch 攻击虽向物理场景迈进(跨相机、跨时刻绑定),但没有做打印-拍摄-视角变化的物理实验。其二,安全评估是开环的:碰撞检测假设 logged 交通参与者沿录制轨迹运动(标准开环协议),没有闭环仿真或实车验证,静默碰撞是规划层面的危害度量而非端到端事故。其三,攻击是逐 clip 优化的:每个片段 200 步 PGD 约需 14 GPU 分钟,未展示跨片段/跨模型的通用或可迁移扰动;作者还明确不发布攻击管线与扰动张量以规避滥用。我的补充观察:样本规模有限——200 片段/样本、154 个有标注,最强引导下静默碰撞 81 vs 75 的配对差异并不显著($p=0.451$),即 TNAS 相对文本保持基线的碰撞增益统计上持平,主要收益在文本侧。第二具身的文本瓶颈天然很粗:InstructVLA 平均 9.60 词的意图句覆盖整个 16 步动作块,Action-only PGD 已有 72.5% 精确保持,其文本保持难度远低于驾驶场景,几何结论在文本更细粒度模型上的普适性待验证。诊断是一阶局部分析($\delta=0$ 处雅可比),实验中 $d_{\mathrm{TNAS}}$ 与 $d_{\mathrm{act}}$ 曲线几乎重合,投影的增益主要体现在攻击优化阶段而非干预阶段,何时投影增益显著缺乏理论刻画。最后,论文只给出“必须验证动作通道”的监控结论,未提出或评估任何具体防御。
独立分析的弱点
独立分析的弱点与改进方向。第一,白盒+逐样本优化使现实威胁与防御推演受限:真实攻击者难以获取梯度,防御者也难以假设攻击形式;改进方向是研究跨片段、跨模型的通用 patch 与黑盒迁移版本,这同时能检验 $d_{\mathrm{TNAS}}$ 是否为模型的不变几何属性而非逐样本巧合。第二,开环碰撞指标可能失真:交通参与者按录制轨迹运动、ego 航向由相邻路径点推断,未建模他车反应;改进方向是在 CARLA/nuPlan 等闭环仿真中复测静默碰撞率。第三,只验证了两个模型、两种具身:驾驶与操作各一,且 InstructVLA 的文本读出极短;改进方向是在更多推理 VLA(尤其带长思维链的驾驶模型)上复现 $\rho$ 分布与静默攻击成功率,找出投影增益显著的层位。第四,投影的边际价值存疑:Probe 3 中 $d_{\mathrm{act}}$ 与 $d_{\mathrm{TNAS}}$ 几乎重合,说明测试范围内直接用 $d_{\mathrm{act}}$ 或许可达到类似动作效果,投影收益集中于降低 KL;改进方向是理论刻画文本子空间与动作敏感方向的夹角分布,预测何时必须投影。第五,防御侧空白:论文止步于监控建议;改进方向是设计运行时动作-文本一致性校验器(从动作反推意图再与理由比对)、沿 $d_{\mathrm{TNAS}}$ 的对抗训练、或对 $\Delta h$ 做子空间监控。第六,统计功效:核心安全指标的提升未达显著,扩大标注规模或采用更灵敏的危害度量(最近逼近距离、碰撞时间 TTC)会更有说服力。
未来方向
作者提出的方向:既然不变的理由不能认证安全动作,具身安全监控必须在文本之外直接验证预测动作通道;TNAS 几何为“理由监控+执行通道监控”的配对架构提供了依据。基于本文成果可延伸的方向包括:防御研究——把 $d_{\mathrm{TNAS}}$ 用于对抗训练(训练时沿该方向加扰动并强制文本-动作一致)、推理时对隐藏状态偏移做 $\mathcal{T}$ 子空间分量监控或投影抑制,以及把动作读出反推为意图再与理由比对的运行时一致性校验器。泛化研究——在更多推理 VLA 上度量 $\rho$,建立“哪些模型/层位存在可利用的文本中性方向”的预测性判据;研究 $d_{\mathrm{TNAS}}$ 的跨样本可迁移性与通用 patch。物理验证——把已跨相机跨时刻绑定的 patch 优化搬到打印-拍摄流程,测试物理可实现性。良性失配研究——36.9% 混合结局理由说明语言瓶颈结构性欠约束,可研究如何迫使理由携带可区分的定量信息(速度、距离、让行意图),把“多对一”压成“近似一一对应”。方法论延伸——将文本-动作解耦度量化为思维链忠实性的一种几何度量,推广到其他共享表征的多头模型(对话机器人、多任务智能体),刻画“一个头能否静默劫持另一个头”的一般条件。
复现评估
复现评估。资产可得性:Alpamayo-1.5-10B 是 gated HuggingFace checkpoint(NVIDIA 许可,限非商业研究/评估),PhysicalAI-Autonomous-Vehicles 数据集同样 gated;InstructVLA 使用公开 checkpoint 与固定的 VLA-IT 评估划分(许可状态未明,VLM 底座 Eagle2-2B 为 CC-BY-NC-4.0);Qwen3-14B 为 Apache-2.0——门禁账号申请是复现第一道门槛。发布策略:作者明确不随论文分发可运行的攻击管线与优化后的扰动张量(滥用风险),但附录 A.1–A.10 把协议写得极其细致:固定种子(数据 shuffle seed 0、生成/流 seed 42)、层窗扫描、步长网格、预算选择规则、碰撞几何协议、甚至读者 prompt 全文都在。算力:单节点至多 4×A100-80GB,Alpamayo 每 worker 约 25 GB 显存;隐藏状态探针约 75–85(Alpamayo)+ 20–24(InstructVLA)A100 小时;输入攻击每个引导权重约 47 GPU 小时/200 片段(约 14 分钟/片段),InstructVLA 每臂约 13 GPU 小时。难度评估:诊断部分(探针 1–3)研究组级别可复现,协议清晰、算力可控;攻击部分需要 gated 访问加大量 GPU 时间,且需按附录自行实现钩子与可微分动作 rollout(训练用 4 步、评估用 10 步求解器等细节);统计检验可直接从表格复算。总体难度中等偏高,无官方代码发布是最大不确定性。
论文图表
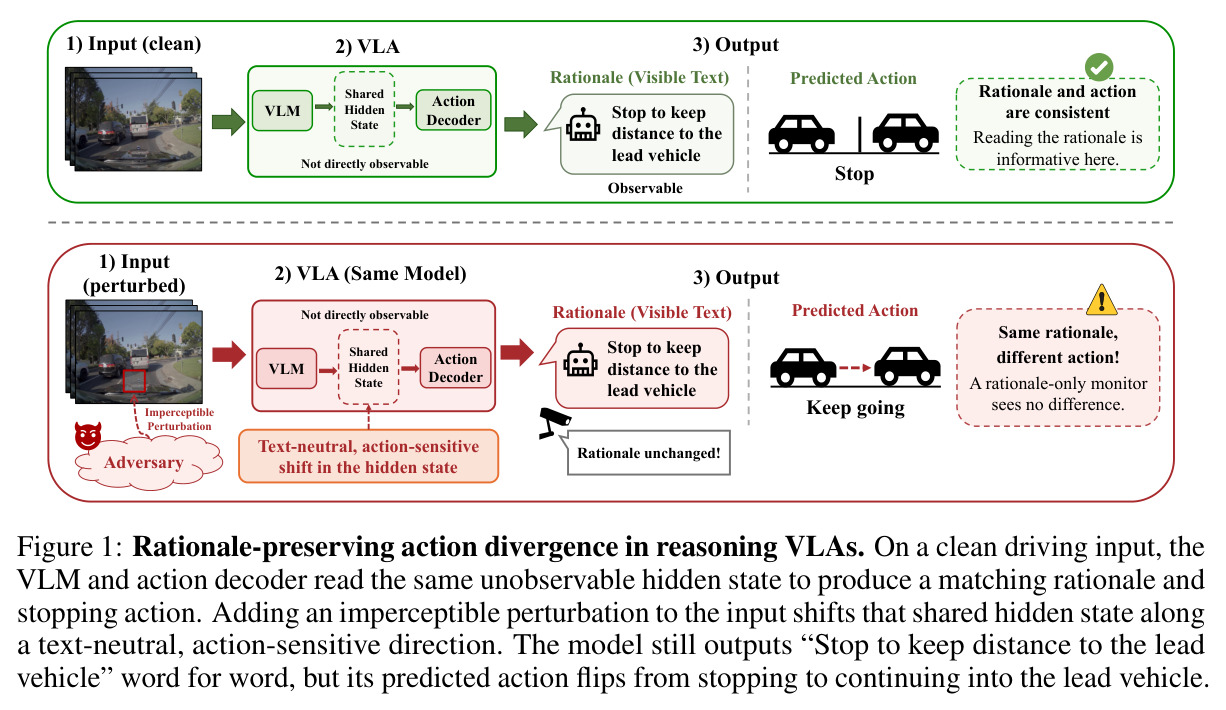
上半部分(干净输入):VLM 与动作解码器读取同一不可观测的隐藏状态,产生理由“Stop to keep distance to the lead vehicle”和停车动作,二者一致,此时读理由是有信息量的。下半部分(扰动输入):对输入加入不可感知的扰动,使共享隐藏状态沿“文本中性、动作敏感”的方向偏移,模型仍逐字输出同一句理由,但预测动作从停车翻转为继续驶向前车——只读理由的监控者看不到任何差异。
一图概括论文的核心威胁模型与标题含义(言同而行异):这是全文论证的起点——理由通道在对抗条件下可以完全失真而不可察觉。
固定 KL 预算下五个方向(dTNAS、dact、urand、gNLL、gmargin)的动作位移完整数值。Alpamayo(ADE 米):dTNAS 在 B=10⁻⁴ 为 0.227、B=5×10⁻⁴ 为 0.504,dact 相当,而全部控制方向 ≤0.00510 m;InstructVLA(归一化位移):dTNAS/dact 在 B=10⁻³ 达 1.37×10⁻² / 1.66×10⁻²,控制最高 9.18×10⁻³。
为“相同文本预算下 TNAS 动作位移大 63.3–212 倍”的核心声明提供完整数值,是 Figure 2c/f 的表格版。