多层索引器:DeepSeek 稀疏注意力中选择与注意力的重叠执行 Multi-layer Indexer: Overlapping Selection and Attention in DeepSeek Sparse Attention
让每层直接复用上一层索引选择、扫描与注意力并行,DSA 解码提速最高 14.5%
前置知识
稀疏注意力(Sparse Attention)
让每个 query 只对序列的一个子集计算注意力而非全部 token,把注意力矩阵变稀疏以省算力与显存带宽。子集可由固定模式(滑窗、条带)预先确定,也可由可学习的打分器按 query 动态选出;后者是当前生产级长上下文 LLM 的主流路线。
本文加速的对象正是这类机制:稀疏化让注意力本身变便宜后,瓶颈转移到为其挑选 token 的打分器上,理解这一因果链才能看懂论文动机。
DeepSeek 稀疏注意力(DSA)与 lightning indexer
DSA 是 DeepSeek-V3.2 与 GLM-5/5.1/5.2 所用的注意力:每层前置一个轻量索引器,用 $H_I$ 个小头按 $I_{t,n}=\sum_{h=1}^{H_I} w_{t,h}\,\mathrm{ReLU}(q^I_{t,h}\cdot k^I_{n,h})$ 给缓存中每个 token 打分,保留得分最高的 $k{=}2048$ 个作为该层注意力的支集,再做稀疏 MLA。
论文的调度改动完全围绕 indexer 的扫描与 top-k 展开;不先弄清打分→top-k→稀疏注意力这三步流程,就无法理解方法改的是哪一环。
KV 缓存与自回归解码
自回归生成每一步只用当前 token 的 query 与缓存中全部历史 token 的 K/V 交互;缓存随上下文线性增长,长上下文时 KV 显存直接限制同批解码的请求数(论文节点上 128K 只能 6 个、195K 只能 2 个请求同时解码)。
它解释了两件事:indexer 扫描成本为何随 $L$ 增长,以及 MLI 的收益为何恰好集中在长上下文、少并发的服务区间。
跨层选择复用(IndexCache / IndexShare)
利用相邻层选择高度重叠的事实,只在 $1/r$ 的层保留 indexer(full layer),其余 shared layer 直接复制最近前驱 full layer 的选择。GLM-5.2 以 IndexShare 之名采用 uniform r=4,IndexCache 论文还给出用校准损失搜出的非均匀模式。
它是本文的主对比基线与组合对象;MLI 与它的本质区别(减少等待时间 vs 减少运行数量)是全文的核心论证线索。
CUDA 流与 CUDA Graph
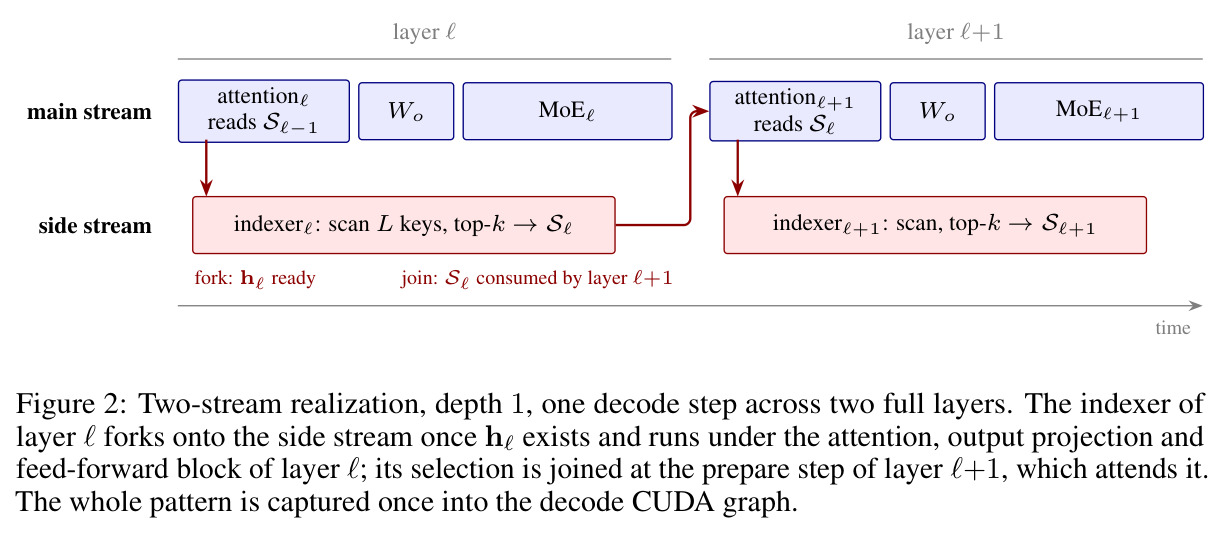
CUDA 流是 GPU 上的任务队列,多条流可并发执行无依赖的 kernel;CUDA Graph 把一串 kernel 及其依赖捕获成图后整体重放,消除每次发射的 CPU 开销,是生产级解码服务的标配。跨流依赖在图里就是普通的有向边。
MLI 的实现就是把 indexer 放到第二条流上、把整个双流模式一次性捕获进 decode CUDA graph;不懂流与图就看不懂它的工程落地方式。
知识蒸馏与 ListMLE 排序损失
蒸馏用冻结教师模型的输出监督学生参数:KL 散度对齐 softmax 概率分布,ListMLE(Plackett–Luce)对齐列表排序,保证 top-k 边界附近的次序正确。本文只蒸馏约占参数 0.5% 的 indexer,两项按 $\lambda{=}0.5$ 混合。
第 3.3 节的质量恢复机制和第 5.5 节「在悬崖保留率救回崩溃」的关键结果都建立在这套损失函数上。
研究动机
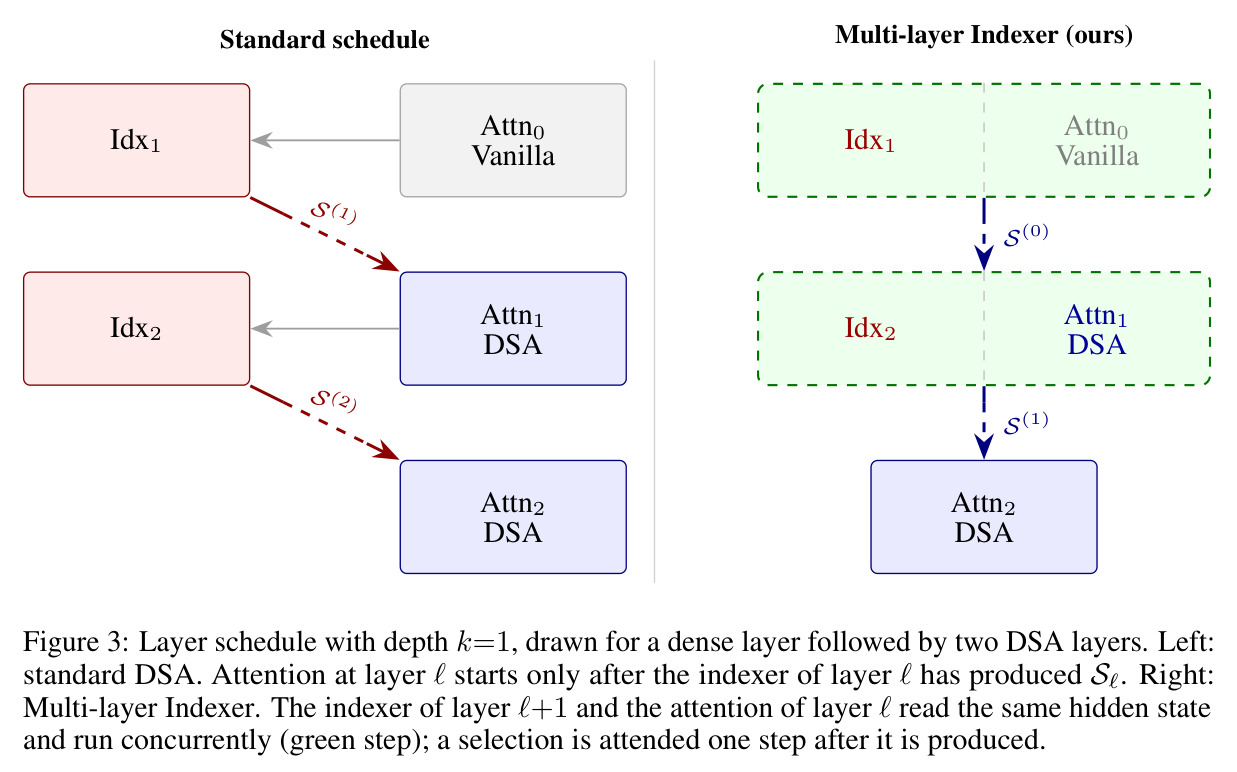
DSA 是 DeepSeek-V3.2 与 GLM-5 系列的注意力机制:每层前置一个 lightning indexer,用 $H_I$ 个小头给缓存中全部 $L$ 个 token 打分 $I_{t,n}=\sum_{h=1}^{H_I} w_{t,h}\,\mathrm{ReLU}(q^I_{t,h}\cdot k^I_{n,h})$,取 top-$k{=}2048$ 作本层注意力支集。稀疏注意力只 gather 2048 个 key、成本对 $L$ 近似平坦,而 indexer 要扫全部 $L$ 个 index-key,是唯一随上下文线性增长的项:128K 时占注意力路径时间的三分之二(Figure 1)。且注意力必须等 top-k 完成才能开始,串行依赖逐层累加,长上下文解码大量时间耗在等扫描上。IndexCache(GLM-5.2 以 IndexShare 之名产品化)只在 $1/r$ 的层保留 indexer 来减少扫描次数,但保留层仍要等自己的扫描,shared layer 用的还是从未为当前 token 重算的旧选择。
本文的目标是本文的目标是消除 indexer 与注意力之间的逐层串行依赖:让每一层的 indexer 与该层注意力并发执行,把扫描时间藏进注意力、输出投影与 MoE 前馈的执行窗口里,同时不重训、不新增任何权重、各层实际读到的 top-k 与生产 kernel 逐位一致。方法还需与 IndexCache 正交组合——两者分别作用于「跑多少个 indexer」与「每个 indexer 被等多久」这两个相乘的独立因子——并在 10K 到 195K 上下文、1/2 到 1/32 保留率的完整区间内给出可测的解码吞吐增益;质量上要求 LongBench、RULER、LongBench v2 相对 IndexCache 的变化控制在几个百分点内,必要时用只动 indexer 权重的蒸馏来补偿。
与已有工作不同的是,现有工作(IndexCache、TidalDecode、Kascade)都从「减少 indexer 运行次数」入手,本质是删掉一些层的扫描;本文换了一个正交维度:利用相邻 DSA 层选择高度重叠的实测事实——GovReport、k=2048 下连续层选择的 Jaccard 相似度在 DeepSeek-V3.2 稳定在约 0.42、GLM-5 约 0.26,从 16K 到 128K 基本不变——让层 $\ell$ 直接读上一个 full layer 已经算好的选择,而把自己的 indexer 挪到旁路流上与注意力同时跑。关键洞察是:indexer 与注意力之间的依赖只存在于 softmax 的支集上,支集提前可得依赖即消失。由于「数量」与「等待」两个因子相乘,该方法与 IndexCache 天然可组合;又因每个保留的 indexer 仍逐步重算 fresh 选择,MLI 的 staleness 有 $k$ 个 full layer 的硬上界,而 IndexCache 的 shared layer 用的是从未重算的旧选择。
核心方法
直觉上,相邻层几乎选同一批 token,所以本层可以直接用上一层的选择,自己的 indexer「晚一层交货」,正好藏进本层注意力的执行时间里。技术上 MLI 是纯调度改动:定义 $\sigma(\ell)=\pi^k(p(\ell))$,即每层读取其所属 full layer 沿 $F$ 往前数 $k$ 个 full layer 的选择;retention $r$ 与 lag depth $k$ 相互独立。在 SGLang 的 DSA 解码路径里用第二条 CUDA 流实现:层输入 $h_\ell$ 一就绪就把 indexer(投影、扫描、top-k)enqueue 到旁路流,主流用 $\sigma(\ell)$ 指定的选择做注意力,整个模式一次性捕获进 decode CUDA graph,不改动任何生产 kernel。DeepSeek-V3.2 上另有把稀疏注意力与扫描合进单次 launch 的 fused decode kernel,128K、1/4 时把组合收益从 +27.5% 推到 +32.3%。质量上只需蒸馏约 0.5% 的 indexer 参数即可补偿。
核心创新是把「何时计算选择」与「何时消费选择」解耦。indexer 与注意力之间的依赖只在于注意力 softmax 的支集(top-k 集合),除此之外两者不共享任何计算;因此只要让注意力读一个「已经存在」的选择,依赖即消失。与 IndexCache 的本质区别在于:IndexCache 让 shared layer(最远 $r{-}1$ 层)复制一个从未为当前 token 重算的旧选择,靠减少 indexer 数量省钱;MLI 下每个 full layer 的选择仍每个解码步重算,只是消费时间后移 $k$ 个 full layer,staleness 有硬上界,靠隐藏等待时间省钱。两者正交:MLI 作用于 full layers,IndexCache 的复制作用于 shared layers,组合时 IndexCache 留下的扫描被 MLI 藏掉。此外 fused kernel 实验揭示更深一层的观察:indexer 打分与注意力 logit 同为层输入的低秩双线性交互,二者本可围绕同一 primitive 协同设计。
方法步骤详情
第一步定调度:保留率 $r$ 给出 full layer 集合 $F$,$p(\ell)$ 为 $\ell$ 前最近的 full layer,$\pi^k$ 沿 $F$ 回退 $k$ 步,每层按 $\sigma(\ell)=\pi^k(p(\ell))$ 读对应选择;$k{=}0$ 即标准 DSA 或 IndexCache,$k{\ge}1$ 为 MLI,前 $k$ 个 full layer 仍串行。第二步双流实现:full layer 输入就绪后,把 indexer 的投影、扫描与 top-k enqueue 到第二条 CUDA 流;主流用 $\sigma(\ell)$ 的选择做稀疏 MLA、输出投影与 MoE;$k$ 个 full layer 后首次消费新选择的层 join,join 前持有引用防内存复用,整体捕获进 decode CUDA graph。第三步(可选):DeepSeek-V3.2 换 fused kernel,单次 launch 同时做稀疏注意力与扫描,选择逐位一致。第四步(可选):只蒸馏 full layer 的 indexer(约 0.5% 参数),损失为 KL 与 ListMLE 按 $\lambda{=}0.5$ 混合,teacher 为原模型各消费层冻结 indexer,同配方也用于 IndexCache 保证成对公平。
技术新颖性
技术新颖性体现在三个层面。其一,它是免训练、零新权重、默认不改 kernel 的纯调度改动,却切中了 DSA 服务在长上下文下的真实瓶颈——扫描而非注意力——并以「选择滞后 $k$ 个 full layer 消费」这种极轻的方式消除了关键路径上的串行依赖,与 IceFormer 一类可部署加速的思路一脉相承。其二,与 IndexCache、TidalDecode、Kascade 等复用方法正交且可组合:那些方法减少扫描次数,MLI 减少扫描等待,实验显示组合在同保留率下全面更快,且 1/r 组合胜过 1/2r 的 IndexCache,等于白赚一档保留率。其三,fused kernel 实验把工程观察上升为架构设计论点:indexer 分数 $I_{t,n}$ 与注意力 logit 同为层输入的低秩双线性交互,DeepSeek-V3.2 上一次 launch 同时计算两者能再快 4 到 6 个百分点,说明 DSA 应围绕这一共享 primitive 做协同设计,而不是把选择器硬放在注意力前面;作者明确表示只是论证并部分实现了这个方向,并未训练新模型。
实验结果
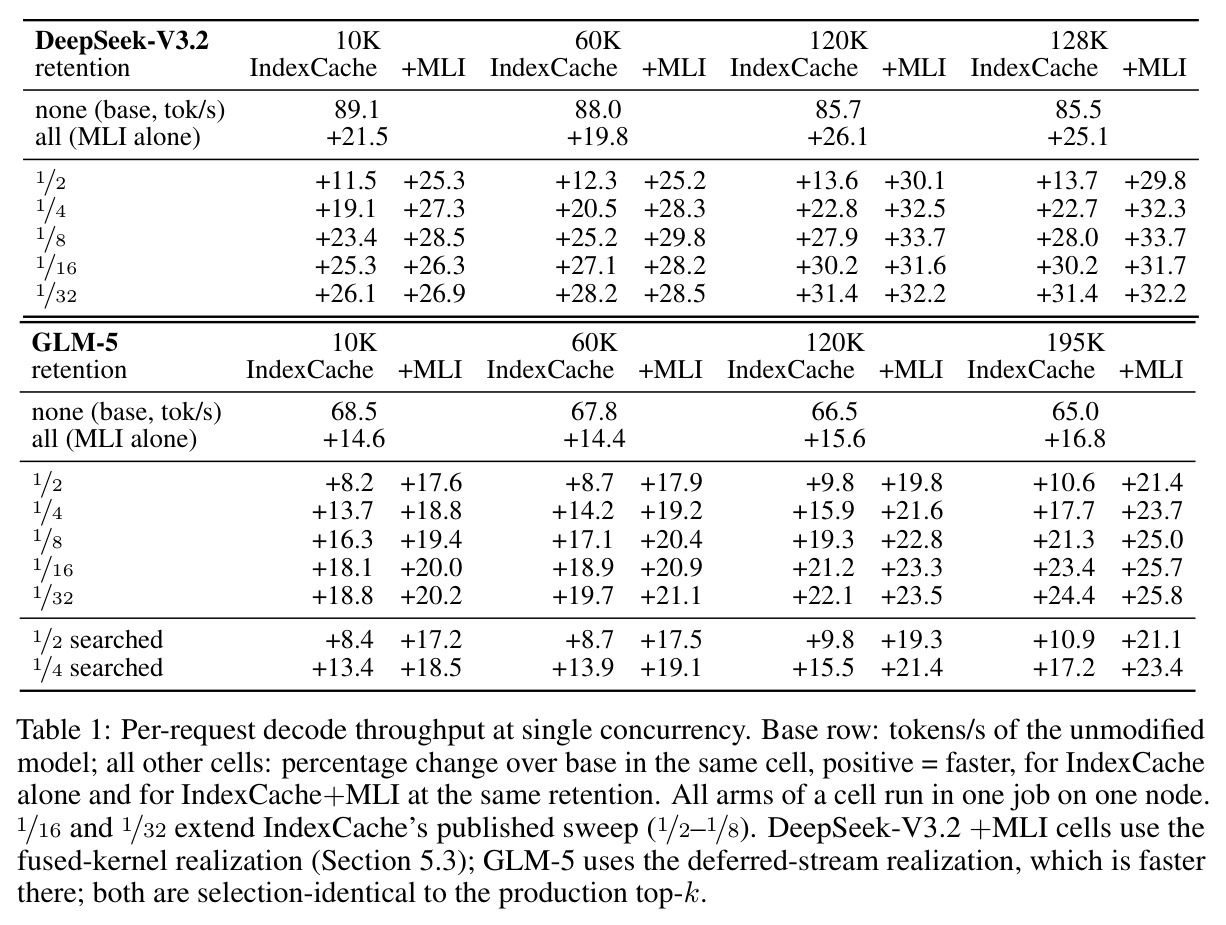
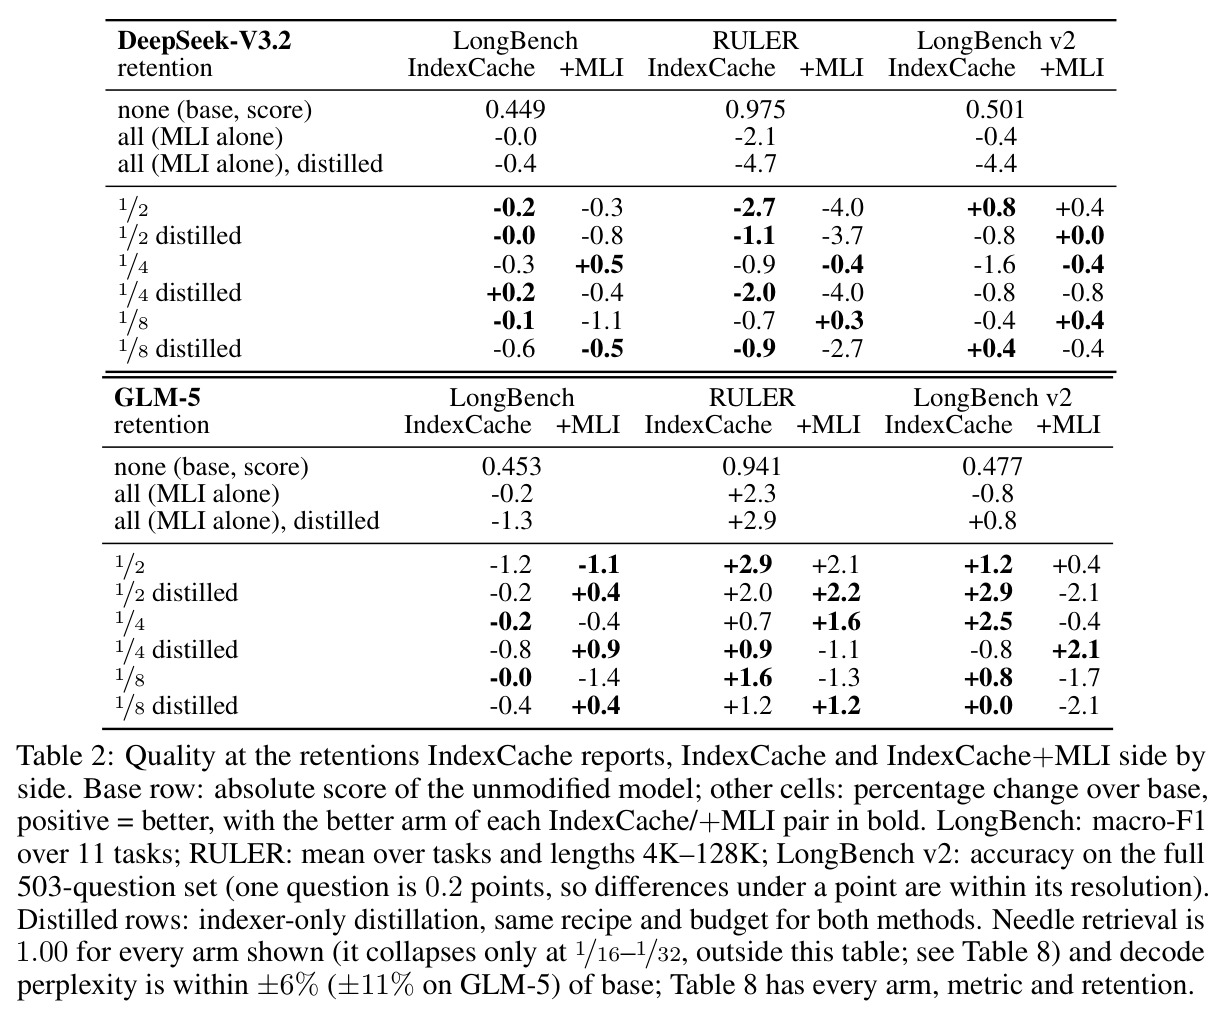
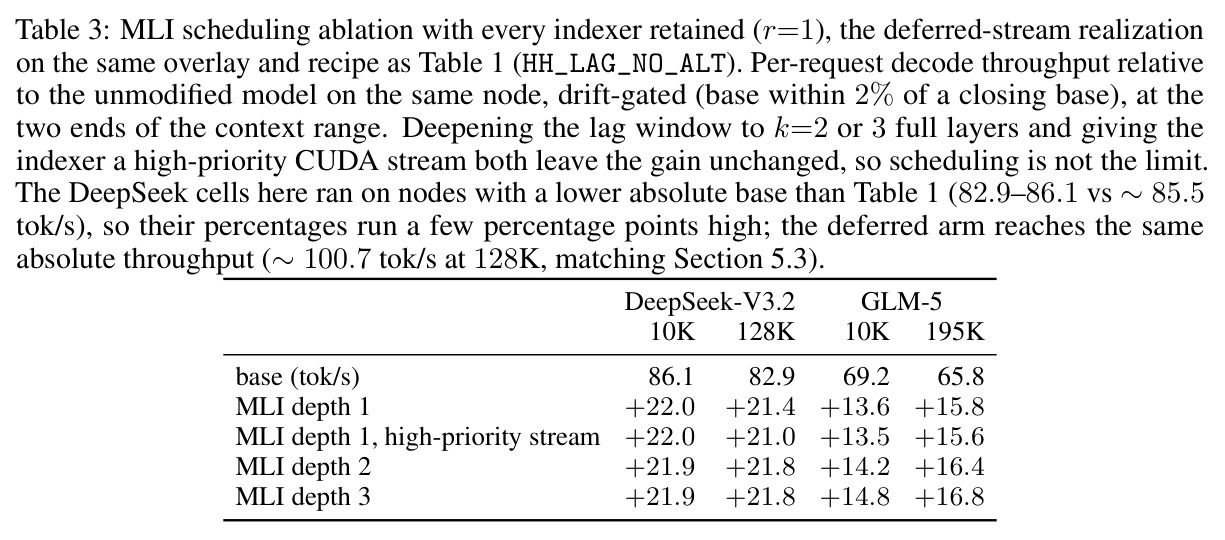
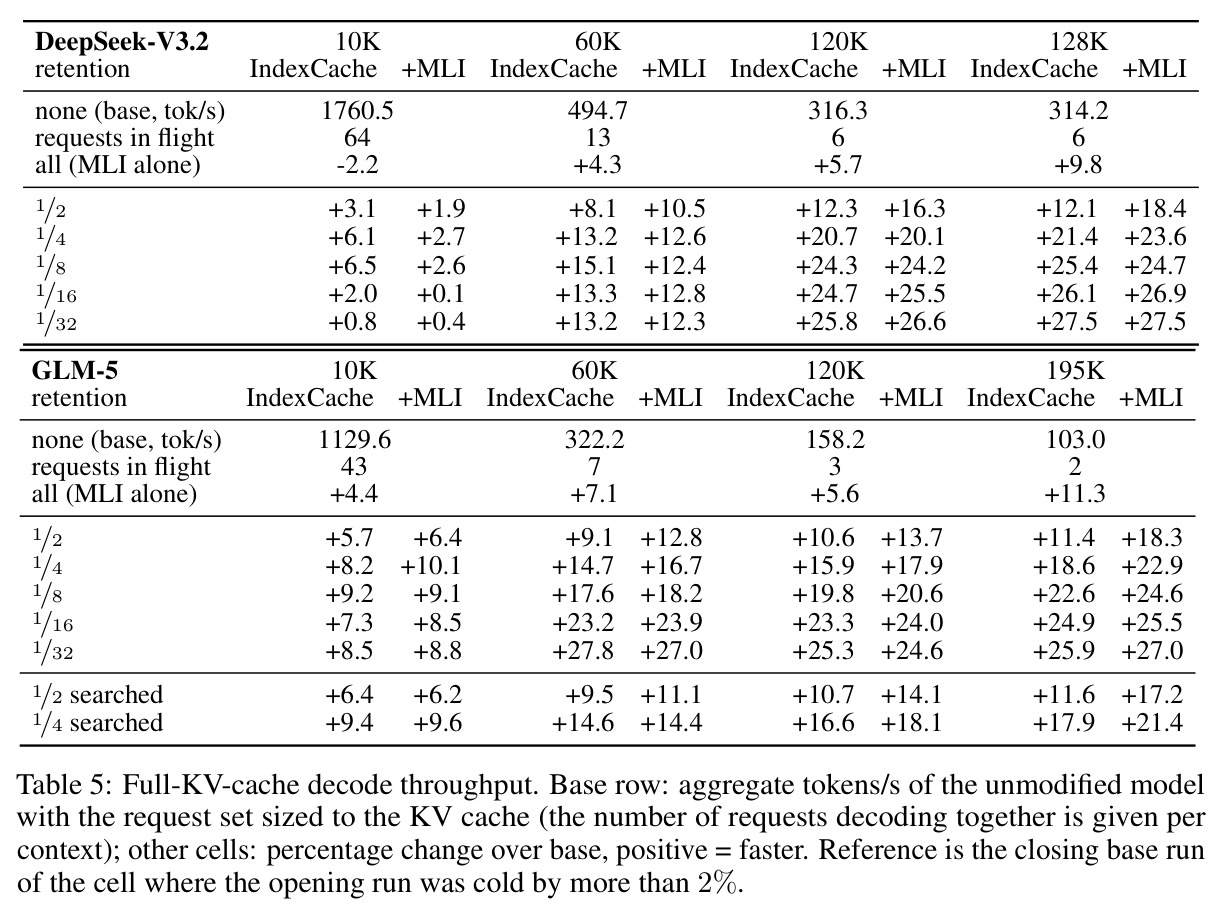
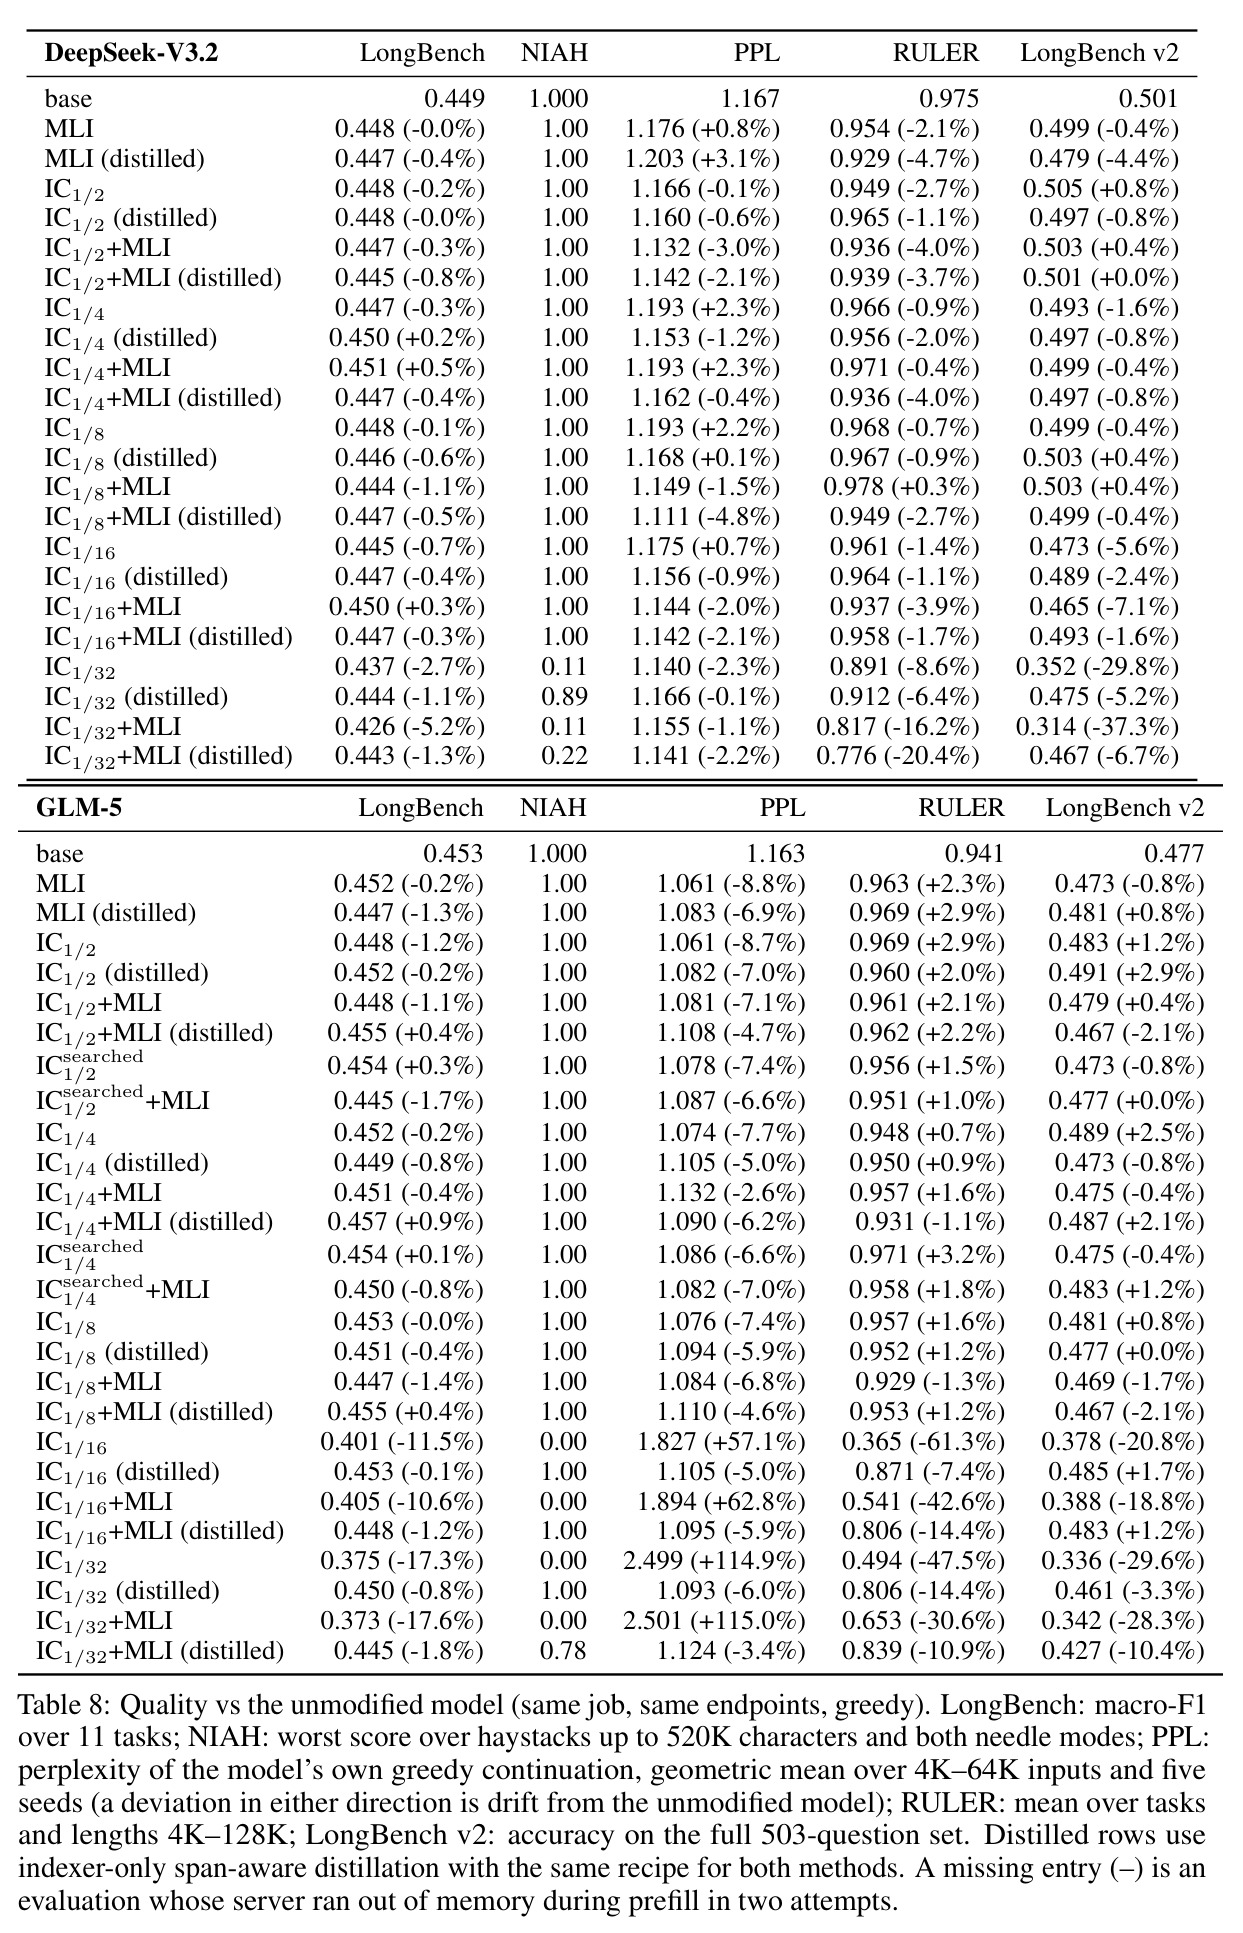
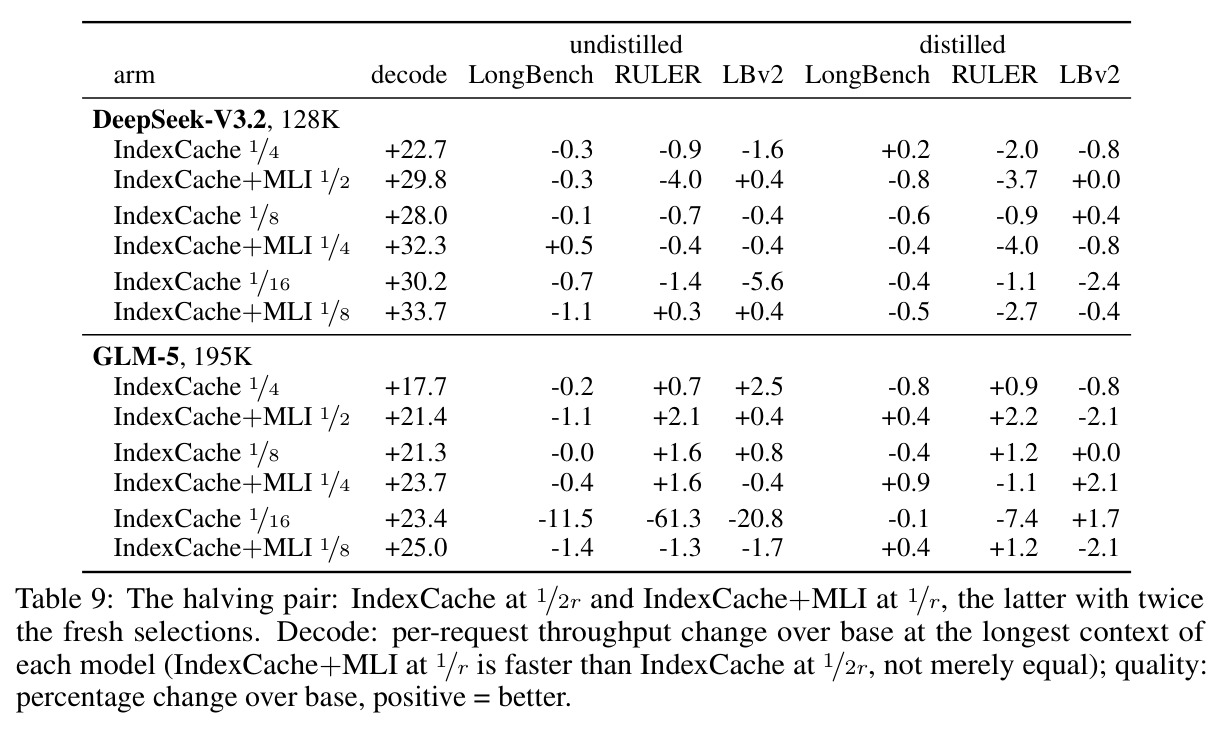
实验在 8×H200、SGLang v0.5.16、8 路张量并行下服务 DeepSeek-V3.2 与 GLM-5($k{=}2048$)。单请求解码吞吐(Table 1):MLI 单独使用在 DeepSeek-V3.2 提升 +19.8% 至 +26.1%、GLM-5 +14.4% 至 +16.8%;组合 IndexCache+MLI 同保留率全面更快,1/2 时 128K 为 +29.8% 对 IndexCache 的 +13.7%、195K 为 +21.4% 对 +10.6%;组合 1/4 在 128K 达基线 1.32 倍,超过 IndexCache 1/8 的 1.28 倍,白赚一档保留率。质量(Table 2,DeepSeek-V3.2 基线 LongBench/RULER/LBv2 为 0.449/0.975/0.501):MLI alone 变化在 ±0.8 点内,组合与 IndexCache 差约一两点,needle retrieval 全为 1.00。蒸馏在温和保留率近乎中性,但在悬崖处决定性:GLM-5 1/16 把 IndexCache 的崩溃(LongBench −11.5、RULER −61、needle 0.00)救回至 −0.1、−7.4、1.00。fused kernel 在 DeepSeek-V3.2 多赚 4–6 个百分点、GLM-5 反而慢 2–4 点;消融(Table 3)显示高优先级流与 k=2/3 均无增益,瓶颈是 HBM 带宽(64 并发时收益消失)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单请求解码吞吐(DeepSeek-V3.2, 128K, retention 1/2) | 相对未修改基线的吞吐变化 | IndexCache+MLI +29.8% | IndexCache +13.7%(基线 85.5 tok/s) | 同保留率下快 16.1 个百分点 |
| 单请求解码吞吐(GLM-5, 195K, retention 1/2) | 相对未修改基线的吞吐变化 | IndexCache+MLI +21.4% | IndexCache +10.6%(基线 65.0 tok/s) | 同保留率下快 10.8 个百分点 |
| 解码吞吐(DeepSeek-V3.2, 128K, 组合 1/4 vs IndexCache 1/8) | 相对基线的倍数 | 1.32×(+32.3%) | IndexCache 1/8 为 1.28×(+28.0%) | 一半 indexer 预算下仍快 3%,等于免费多降一档保留率 |
| MLI 单独使用(r=1, DeepSeek-V3.2, 10K–128K) | 解码吞吐提升 | +19.8% 至 +26.1% | 未修改模型 | 已达到 IndexCache 1/32 上限(+31%)的约五分之四 |
| 长上下文质量(LongBench, DeepSeek-V3.2, 1/4) | 11 任务 macro-F1 | +MLI +0.5 | IndexCache −0.3(基线 0.449) | +0.8 点,质量不降反升(区间跨零) |
| 大海捞针检索(needle retrieval, 32K–520K 字符干草堆) | 命中率 | 表中所有臂均为 1.00 | 未修改模型 1.00 | 无退化;仅 1/16–1/32 悬崖处崩溃,蒸馏后恢复 1.00 |
| 蒸馏救回悬崖(GLM-5, retention 1/16) | LongBench / RULER / needle | −0.1 / −7.4 / 1.00 | IndexCache −11.5 / −61 / 0.00 | 完全恢复崩溃,把可用保留率再推低一档 |
局限与改进
作者承认的局限:收益随并发请求数增加而衰减——KV 显存决定 128K 只能六个、195K 只能两个请求同批解码,一旦大量短请求把 HBM 带宽打满,扫描便无处可藏(Table 5 的 64 请求场景,作者也未直接 profile);fused kernel 只在 DeepSeek-V3.2 有效,GLM-5 上反而慢 2–4 点;每步第一个 full layer 的扫描仍串行,连理论天花板都够不到(IndexCache 1/32 的 +31%/+24%);质量上 RULER 在 DeepSeek-V3.2 有一处 −3.1 的差异其 95% 区间不含零。我的观察:收益完全寄生于「相邻层选择高度重叠」的经验事实,Jaccard 0.42/0.26 是在 GovReport 上测的,换数据分布或未来架构层间差异变大时可能缩水;1/16、1/32 极端保留率的对比是单次运行,部分差异在 LongBench v2 的 0.2 点分辨率下难辨;MLI 不动 prefill,长 prefill 场景无收益;作为纯推理期方法,它也无法降低 indexer 扫描本身的算术量下界。
独立分析的弱点
第一,收益对批量敏感:满 KV 64 请求时收益消失,方法只在少请求长上下文区间有效;改进方向是与 prefill/decode 分离调度结合,或直接压低扫描算术量(index-key 低秩化、量化)以减少对空闲带宽的依赖。第二,fused kernel 的收益依赖每 rank indexer 头数与 FFN 窗口大小,GLM-5 上为负收益(慢 2–4 点);改进方向是按模型配置自动选择实现,或设计对头数不敏感的分块融合策略。第三,蒸馏在温和保留率下中性偏负(DeepSeek-V3.2 的 RULER 蒸馏后 −3 到 −4 点),只在悬崖处起效;改进方向是仅在激进保留率启用,或改用只在 top-k 边界加权的排序损失。第四,lag depth $k$ 是全局超参,但各深度层间重叠度不同;可按层自适应分配 $k$ 或学习每层应消费哪一层的选择。第五,首个 full layer 的扫描仍串行;若模型前几层用稠密注意力,可与最后的稠密层并行发射,作者已指出这条路径。
未来方向
作者提出的方向很明确:既然 indexer 分数与注意力 logit 同为层输入的低秩双线性交互(与 Selective Attention 的训练期观点呼应),下一步应从预训练起就让 indexer 与注意力共享这一 primitive,甚至彻底合并两者,让「选择」成为注意力的副产品,而不是在注意力前面挂一个独立选择器;这是作者「论证并部分实现、但未训练」的方向。基于本文成果还可延伸:把 MLI 与更多复用方法(TidalDecode、Kascade)及 searched patterns 之外的调度组合并系统评测;在 GLM-5.2 原生 IndexShare 上做产品级集成与公平对比(作者因不对等而主动排除);为 prefill 阶段设计类似的 overlap;在持续批处理下做带宽感知调度,动态调整保留率与 lag depth;蒸馏侧可探索针对悬崖保留率的鲁棒训练,或让学生 indexer 直接预测多个消费层选择的联合分布而非逐层 KL;此外把 MHI 的双流调度推广到其他「前置打分器」型稀疏注意力(NSA、MoBA、SeerAttention)也值得验证。
复现评估
复现条件较好但有算力门槛。代码开源(github.com/ArjunKrishnak/dsa-multi-layer-indexer),实现于 SGLang v0.5.16 的 DSA 解码路径,两个模型的 fp8 checkpoint 公开。公平性协议写得极细:同一 cell 所有 arm 同 job 同节点;漂移对照(基线首尾两次启动需 2% 内一致,实测 0.4%);engagement 标记(各 TP rank 记录 overlapped path 已捕获、无 fallback);IndexCache parity 对照(自建与官方 release 基线差 0.2%、IndexCache 臂慢 0.4–1.1%);质量差异配成对 bootstrap 95% 区间。门槛在吞吐主表需单节点 8×H200 加 8 路张量并行;Figure 1 的 kernel 计时单张 H100 即可,质量评测(LongBench、LongBench v2、RULER)小配置可跑但耗时。总体属于「代码可得、协议透明、但需旗舰级 GPU 节点」的中高难度复现。
论文图表
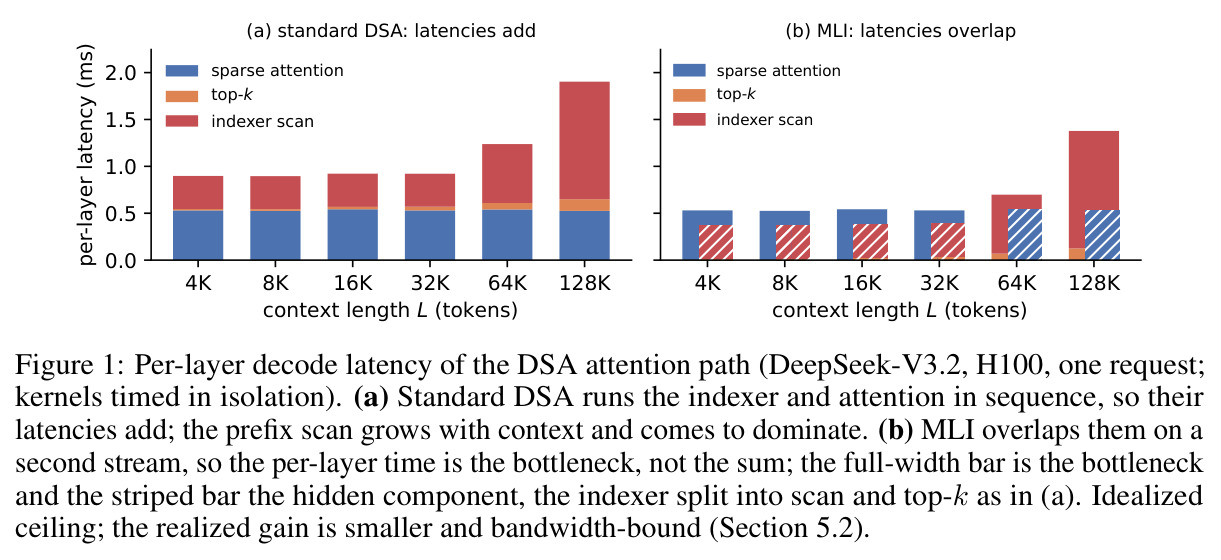
左图为标准 DSA:sparse attention、top-k 与 indexer scan 逐层串行执行、延迟相加,其中 indexer 的 prefix scan 随上下文增长并在 128K 时占到注意力路径时间的三分之二;右图为 MLI 的理想化重叠:indexer scan 被藏进注意力执行窗口,每层耗时由瓶颈组件而非各组件之和决定。
这是全文动机的核心证据:它直观展示了「扫描而非注意力」才是长上下文解码瓶颈,并给出重叠执行的理想化收益上限,后续所有实测加速都应对照这张图理解。