基于检索增强生成的股票市场信息检索系统 Enhancing Stock Market Information Retrieval with Retrieval-Augmented Generation
混合检索+Gemini 生成构建越南股市 RAG,ROUGE-L 达 0.9436
前置知识
检索增强生成(RAG)
一种把外部知识检索与 LLM 生成结合的架构:用户提问后,系统先从知识库中检索相关文档,再把文档作为上下文拼入 prompt,让模型基于证据生成回答。相比纯参数化的 LLM,RAG 能缓解幻觉问题、支持知识热更新(只需往知识库里加新文档而无需重训模型)、并且不用微调就能把通用模型垂直化到特定领域。
本文的全部工作就是搭建并评估一个面向越南股市新闻的 RAG 系统,理解检索与生成两段式流程是读懂其架构设计与实验的前提。
LaBSE 多语言句子嵌入
Language-agnostic BERT Sentence Embedding,Google 提出的多语言句子嵌入模型,支持 109 种语言,把不同语言的句子映射到同一个向量空间中,语义相近的句子向量距离更近。它基于 BERT 结构训练,对越南语这类需要专门处理的语言有较好的编码质量,常用于跨语言检索和语义相似度计算。
本文选择 LaBSE 作为文档与查询的共同嵌入模型,向量质量直接决定 FAISS 召回的召回效果,是理解其嵌入与检索环节的关键选型。
FAISS 与 L2 距离
FAISS(Facebook AI Similarity Search)是 Meta 开源的向量相似度检索库,支持毫秒级的近似最近邻搜索。L2 即欧氏距离 $d(q,d)=\sqrt{\sum_{i=1}^{n}(q_i-d_i)^2}$,衡量两个向量的直线距离,值越小表示越相似;FAISS 据此从海量向量中快速找出与查询向量最近的 top-k 个文档向量。
FAISS 是本文向量召回的引擎,理解 L2 距离才能明白语义相似在系统中是如何被量化和计算的。
BM25 排序算法
经典的词频类检索排序算法,基于 TF-IDF 思想:对查询中的每个词,用逆文档频率 $IDF(t)=\log\frac{N-n(t)+0.5}{n(t)+0.5}$ 乘以带饱和项的词频得分,参数 $k_1$ 控制词频饱和速度、$b$ 控制文档长度归一化强度。它擅长精确的关键词匹配,与语义向量检索形成互补。
本文用 BM25 对 FAISS 召回的候选文档做重排,构成其混合检索策略的另一半;金融查询常含股票代码和数字,词面匹配不可缺少。
ROUGE 评估指标
面向召回的文本生成评估指标族:ROUGE-1 统计一元词重叠 $\frac{\sum_{w}\min(count_{gen}(w),\,count_{ref}(w))}{\sum_{w}count_{ref}(w)}$,ROUGE-2 统计二元短语重叠,ROUGE-L 基于最长公共子序列 $LCS(gen,ref)/length(ref)$ 衡量句子级结构相似度,通常与精确率、召回率、F 值一起报告。
ROUGE-1/2/L 是本文唯一的质量指标,理解其计算方式才能批判性地解读 0.95 量级分数背后的真实含义。
研究动机
通用大语言模型虽然已被广泛用于金融文本分析,但直接用于股票市场信息检索存在三类硬伤。一是幻觉问题(Dale 等 2022):模型会生成流畅连贯但事实错误的回答,而金融场景中一个错误的数字或结论就可能误导投资决策。二是知识更新困难:LLM 把知识固化在内部参数里(Meng 等 2022),而股市受经济指标、公司财报、地缘政治事件和投资者情绪驱动,高度动态,靠重新训练或微调来更新知识的成本极其高昂。三是领域专精能力缺失:通用模型在垂直领域表现不佳,为越南股市这类特定领域定制模型又面临高质量语料稀缺、数据安全要求和微调复杂度等难题。与此同时,传统 NLP 系统(如基于 LSTM 的股价预测、FinBERT 情感分析)在快速变化的金融数据面前也难以保证实时性、上下文准确性和可解释性。这正是本文要解决的具体场景:如何让模型基于最新的越南股市新闻给出准确、及时、可解释的回答。
本文的目标是本文的目标是为越南股票市场构建一个可落地的检索增强生成(RAG)问答系统:以越南主流新闻网站 VnExpress 的股市新闻为外部知识源,让用户用自然语言提问(论文设计了 100 条股市相关测试查询),系统能自动检索到最相关的新闻内容,并据此生成事实上有据可依、语言上连贯流畅的回答。同时作者希望给出一个兼顾质量与效率的评估方案——用 ROUGE-1、ROUGE-2、ROUGE-L 三个指标衡量生成文本与参考文本之间的词汇重叠和结构相似度,用端到端延迟衡量系统的实时可用性,最终验证 RAG 范式在越南语金融信息检索中的可行性,为投资者、分析师和决策者提供一个低幻觉、易更新、响应迅速的股市问答工具原型。
与已有工作不同的是,本文的独特切入角度在于把 RAG 落到了一个此前较少被覆盖的组合上:越南语加股票市场。现有金融 RAG 工作——如 AlphaFin 数据集与 Stock-Chain 框架(Li 等 2024)、时间感知的 FinTMMBench 基准(Zhu 等 2025)——几乎都以英文语料为主,而越南语是多音节、天然没有空格分词的语言,在分词和嵌入环节都有额外工程挑战。作者的应对是:选用对越南语支持较强的 LaBSE 多语言嵌入模型,用 Underthesea 库做越南语分词和停用词过滤;检索上不依赖单一向量相似度,而是采用 FAISS 语义召回加 BM25 关键词重排的混合策略,兼顾语义相关与词面精确匹配。虽然方法本身是标准组件的集成而非算法创新,但针对低资源语言金融场景的完整系统化实践、以及自建的 30 篇 VnExpress 新闻四分类数据集,对类似市场的 RAG 落地仍有参考价值。
核心方法
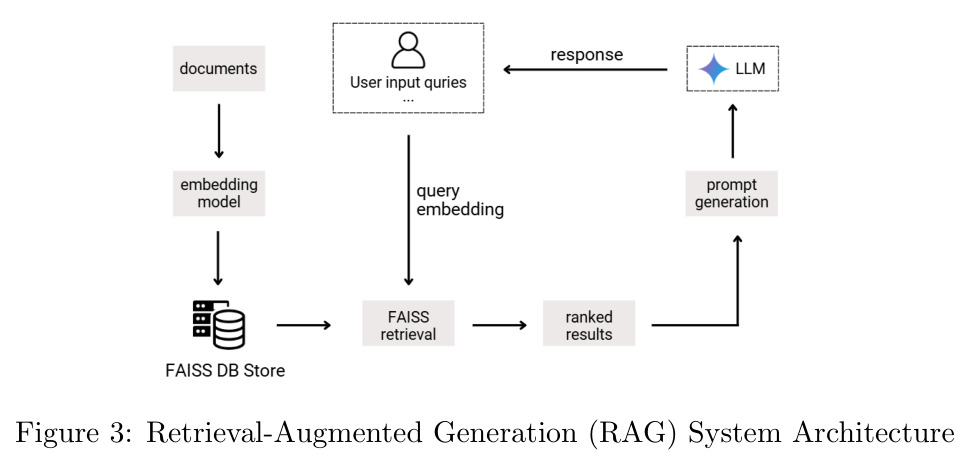
整个系统是一条经典的三段式 RAG 流水线。第一段文本嵌入:对从 VnExpress 爬取的 30 篇股市新闻做预处理(正则去除 URL 和特殊字符、转小写、Underthesea 分词、按自建停用词表过滤越南语虚词),再用 LaBSE 模型编码成稠密向量写入 FAISS 数据库建立索引。第二段信息检索:查询经同一 LaBSE 嵌入后,先由 FAISS 按 L2 欧氏距离 $d(q,d)=\sqrt{\sum_{i=1}^{n}(q_i-d_i)^2}$ 召回 top-k 近邻文档,再用 BM25 公式 $\sum_{t\in Q}IDF(t)\cdot\frac{f(t,D)(k_1+1)}{f(t,D)+k_1(1-b+b\cdot|D|/avgdl)}$ 按词频重排,得到语义与关键词双重相关的文档集。第三段答案生成:把指令、用户问题和检索文本拼装成结构化 prompt,交给 Gemini-1.5-Flash 基于证据生成回答。100 条查询的端到端评估显示 ROUGE-1 F 值 0.9555、平均延迟 1.1626 秒,质量与效率均达到实时金融应用的可接受水平。
核心思想是用外部知识库替代参数记忆:生成模型不依赖自身参数里过时或缺失的金融知识,而是每次回答前先从新闻向量库中检索证据,再把证据塞进 prompt 让 Gemini 基于证据作答,从机制上压制幻觉,并把知识更新简化为往库里添加新文档。与已有方法的本质区别体现在检索环节的混合策略上:FAISS 的稠密向量检索擅长捕捉语义相似(例如市场波动与指数震荡的语义关联),但对越南语特有的关键词、股票代码、具体数字等词面信号不敏感;BM25 作为 TF-IDF 系排序模型(其 $IDF(t)=\log\frac{N-n(t)+0.5}{n(t)+0.5}$ 度量词的区分度)恰好补上关键词精确匹配这一环。先用向量召回缩小候选集、再用 BM25 精排的两阶段设计,是本文相对纯向量 RAG 的主要差异化点,尤其适配金融查询中大量出现具体标的与数字的特点。
方法步骤详情
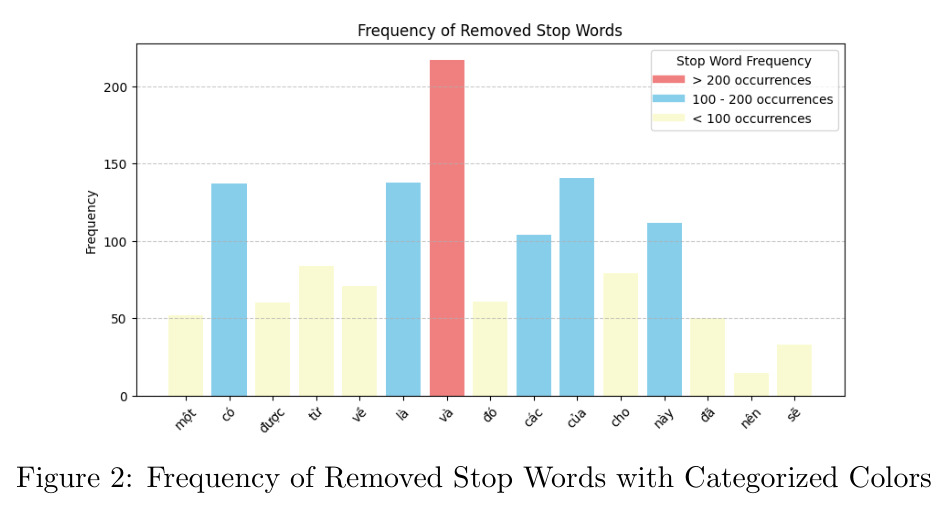
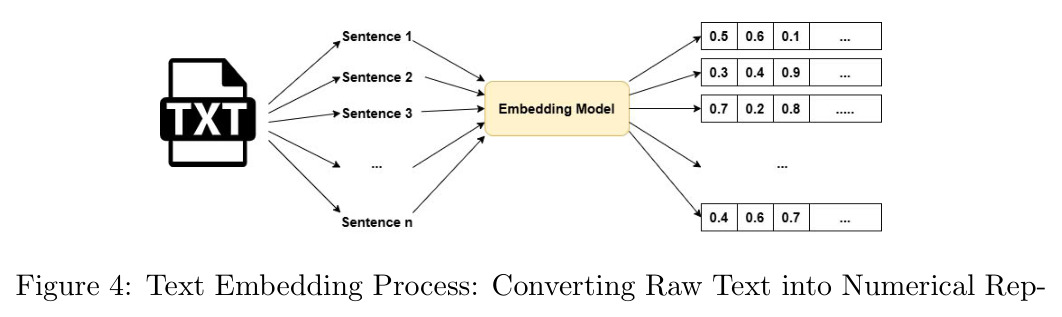
第一步数据采集:从 VnExpress 爬取 30 篇股市新闻,按主题分四类——市场趋势与指数表现 8 篇、个股与板块 9 篇、外资与流动性 7 篇、监管与公司行为 6 篇(Table 1)。第二步预处理:去除首尾空白,用正则表达式删除 URL 和特殊字符,全文转小写;由于越南语词汇由多音节构成、不像英文那样天然按空格切分,使用 Underthesea 的分词工具把文本切成有意义的词元,再基于人工整理的越南语停用词表过滤代词、连词、助词等虚词(Figure 2 展示了被删停用词的频次分布),清洗后的文本存入语料库。第三步建库:LaBSE 将每篇文档编码为稠密向量并写入 FAISS 索引(Figure 4)。第四步在线检索:查询经同一 LaBSE 嵌入后,FAISS 以 L2 距离召回 top-k 候选文档,BM25 再按词频与 IDF 重排。第五步生成:拼装指令、用户问题和检索文本构成的结构化 prompt,由 Gemini-1.5-Flash 生成最终回答。整条链路对 100 条查询评测,平均延迟 1.1626 秒、最快 0.917 秒、最慢 2.455 秒。
技术新颖性
坦率地说,本文的技术新颖性有限,本质上属于成熟组件的工程集成而非方法创新:LaBSE(Feng 等 2020)、FAISS(Douze 等 2024)、BM25(Robertson 2010)和 Gemini API 都是现成的开源或商用组件,整体流水线也是 RAG 领域的标准范式——向量召回、关键词重排、LLM 生成,三件套缺一不可也多一不可。相对有新意的点有三处:一是面向越南语金融语料的完整本地化实践,包括 Underthesea 分词、越南语停用词表构建和 LaBSE 多语言嵌入选型,对低资源语言的 RAG 落地有示范意义;二是 FAISS 加 BM25 的两阶段混合检索在股市查询场景的针对性论证——金融查询常含股票代码、成交量和具体数字,纯语义检索容易漏掉这些词面信号;三是同时报告质量(ROUGE 三指标)与延迟(平均 1.1626 秒)的双维度评估框架,把实时性纳入考量。但需要指出,混合检索在信息检索领域早已是常规做法,且论文没有做任何消融实验来证明混合策略相对单一检索的增益。
实验结果
实验在 100 条股市相关查询上进行,计算生成答案与参考答案之间的 ROUGE 分数。质量方面(Table 2):ROUGE-1 的精确率 0.9616、召回率 0.9597、F 值 0.9555,说明生成文本几乎覆盖了参考答案中的全部关键单词;ROUGE-2 三项分别为 0.9374、0.9356、0.9314,表明二元短语结构也高度保留,上下文连贯性较好;ROUGE-L 为 0.9496、0.9478、0.9436,反映最长公共子序列层面的句法结构与流畅度对齐良好。三项 F 值全部超过 0.93,作者据此声称生成结果与参考文本高度一致、能完整正确地保留股市关键信息。效率方面(Table 3):100 条查询的平均延迟为 1.1626 秒,最快 0.917 秒,最慢 2.455 秒,波动约 2.7 倍,主要来自检索耗时与 Gemini API 调用的随机性,作者认为这对实时金融应用是可接受的响应速度。必须指出的是,如此高的 ROUGE 分数在开放域生成任务中极为罕见,很可能是因为参考答案本身就出自系统检索的同一批新闻文档,任务实际更接近基于证据的抽取式改写,而非自由生成。
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 股市新闻问答生成(词汇重叠) | ROUGE-1 F 值 | 0.9555 | 无(论文未设基线) | 无对比实验 |
| 股市新闻问答生成(短语结构) | ROUGE-2 F 值 | 0.9314 | 无(论文未设基线) | 无对比实验 |
| 股市新闻问答生成(句级结构) | ROUGE-L F 值 | 0.9436 | 无(论文未设基线) | 无对比实验 |
| 端到端响应效率(100 条查询) | 平均延迟(秒) | 1.1626 | 无(仅报告绝对值) | 范围 0.917–2.455 秒 |
局限与改进
作者承认的局限包括:模型处理复杂金融查询的能力仍需提升、需要集成更多外部知识源来增强准确性、计算效率与延迟仍有优化空间。我自己的观察则更为根本。其一,语料库仅 30 篇静态新闻,只是越南股市极小的一个切片,无法代表真实市场的动态与规模。其二,评估设计有循环论证之嫌:参考答案大概率出自系统检索的同一批文档,0.95 量级的 ROUGE 更像接近照抄原文的证据而非生成质量的证明,且论文完全没有说明 100 条查询和参考答案是如何构建的、是否经过人工撰写与校验。其三,没有任何基线对比和消融实验,无法知道纯 FAISS、纯 BM25、去掉重排、更换 LLM 时的表现差异,混合检索的价值停留在设计动机层面。其四,只有词汇重叠类指标,没有事实准确性、忠实度评估或人工评审,而金融场景恰恰最怕数字错误。其五,论文内部存在矛盾:预处理一节说用 Underthesea 分词,4.1 节却说用中文分词工具 Jieba 做越南语切分,方法描述的可信度因此打了折扣。
独立分析的弱点
第一,检索质量完全黑盒:论文没有报告任何召回率@k、MRR 之类的检索指标,无法判断混合检索是否真的优于单一检索。改进方向是补做消融实验(FAISS-only、BM25-only、混合三种设置对比),并考虑加入交叉编码器重排器(如 bge-reranker)进一步提升精排质量。第二,评估体系单薄:ROUGE 对这种基于证据的抽取式任务天然虚高,应引入 RAGAS 类忠实度与答案相关性指标,加上人工事实核查,尤其要专门检验股价、成交量、涨跌幅等数字是否与原文一致。第三,知识库静态且极小:30 篇文档意味着检索到的内容几乎就是答案本身,系统从未在真实规模(数千至数万篇)语料上接受考验,应在更大语料上重测并加入增量索引更新机制对接实时新闻流。第四,生成端单一:只测了 Gemini-1.5-Flash,缺少与 GPT 系列、Claude、开源多语言模型(如 Qwen)的横向对比,也没有 prompt 模板的敏感性分析。第五,方法描述自相矛盾:预处理用 Underthesea 还是 Jieba 前后不一,复现者无从判断真实流水线,需要规范方法章节并公开代码消歧。
未来方向
作者提出三个方向:增强复杂金融查询的处理能力、集成更多外部知识源以提升准确性、优化计算效率进一步降低延迟。在此基础上可以延伸出更有价值的路线。其一,把静态新闻库升级为实时管道:定时爬取新闻并增量更新索引,甚至接入行情 API,让系统真正具备实时性,而非依赖 30 篇静态文档。其二,构建越南语金融评测基准:包含人工标注的问答对与事实核查标签,从根源上弥补当前评估的循环论证问题,也能让后续工作有可比性。其三,引入多跳推理与 Agent 架构,让系统能回答某项监管政策对外资流入板块有何影响这类需要跨文档推理的复合问题。其四,融合多模态金融数据(K 线图、财报表格、行情时间序列),对标 FinTMMBench 的时间感知 RAG 设定,覆盖趋势分析与事件检测。其五,做系统性的消融与对比研究:量化混合检索、不同嵌入模型、不同 LLM 对 ROUGE、忠实度和延迟各自的贡献,把工程实践沉淀为可复用、可推广的结论。
复现评估
复现难度总体较低,所有核心组件都公开可得:LaBSE 可从 SentenceTransformers 或 HuggingFace 直接加载,FAISS 有官方 Python 包,BM25 可用 rank_bm25 库实现,越南语分词用 Underthesea(pip 即装),Gemini-1.5-Flash 走 Google API(有免费额度,100 条查询的调用成本可以忽略不计),VnExpress 新闻可按论文描述的四个类别自行爬取。算力需求极小:30 篇文档的嵌入在 CPU 上几秒即可完成,在线推理主要是 API 调用。最大的复现障碍是评估协议不透明:100 条测试查询如何生成、参考答案是人工撰写还是直接从新闻中抽取、检索的 k 值取多少、prompt 模板长什么样,论文均未披露,而这直接决定能否复现出 0.9555 的 ROUGE-1。论文没有提供代码或数据的开源链接,也没有附录说明 BM25 的 $k_1$、$b$ 超参数取值。总体估计:搭建一套同款系统约需 1 到 2 天工作量,但要复现论文数字需要自行设计评估集,结果很可能与文中报告存在明显出入。
论文图表
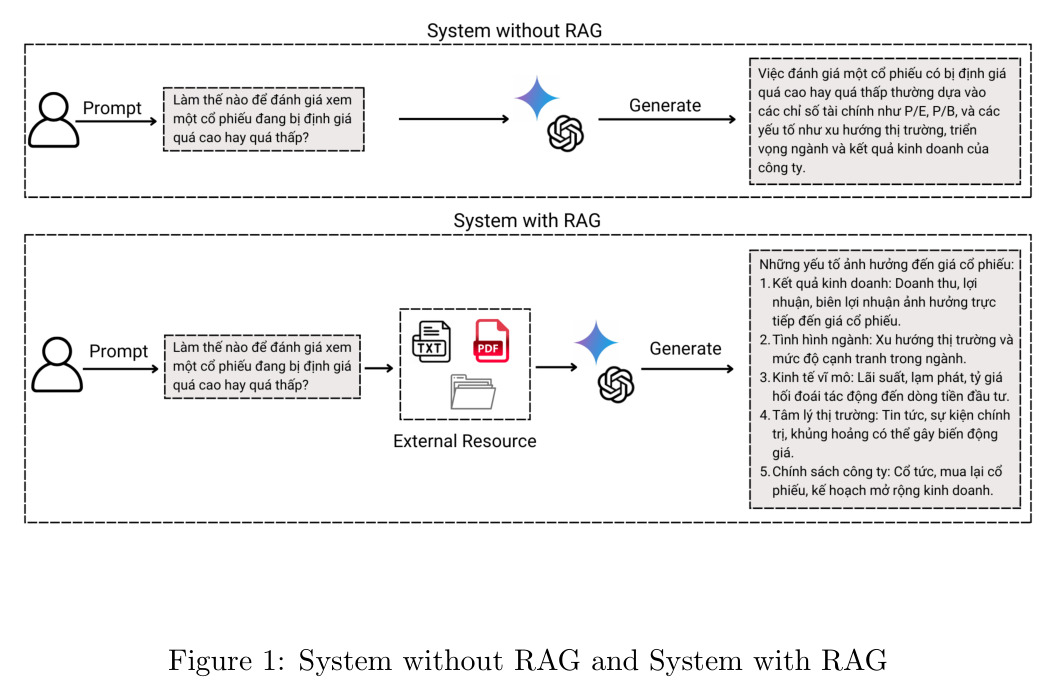
对比示意图:左侧是无 RAG 的系统,用户查询直接交给 LLM,模型仅凭参数内的记忆作答,容易产生幻觉且知识过时;右侧是带 RAG 的系统,查询先经过检索模块从外部知识库取回相关文档,再连同问题一起送入 LLM,生成有据可依的回答。
这张图直观呈现了论文的立论基础——RAG 相对纯 LLM 的机制差异,帮助读者在进入技术细节之前建立对整个系统动机的整体认知。
统计 30 篇 VnExpress 股市新闻的四个主题类别及篇数:市场趋势与指数表现 8 篇、个股与板块 9 篇、外资与流动性 7 篇、监管与公司行为 6 篇,合计 30 篇。
量化了知识库的规模与构成:30 篇这一极小的语料规模,是评判后续所有实验结论适用边界的关键事实,也是本文最大的局限来源。
报告 100 条查询生成答案的质量指标:ROUGE-1 精确率/召回率/F 值为 0.9616/0.9597/0.9555,ROUGE-2 为 0.9374/0.9356/0.9314,ROUGE-L 为 0.9496/0.9478/0.9436,三项 F 值均超过 0.93。
这是论文的核心实验结果表,作者关于系统生成质量高的所有结论都建立在这组数字之上,是评估其主张的第一手证据。
报告 100 条查询的端到端延迟统计:平均 1.1626 秒,最小 0.917 秒,最大 2.455 秒,刻画了系统响应时间的整体水平与波动范围。
延迟是本文除生成质量外的第二个评估维度,这组数字直接支撑其系统适用于实时金融应用的论断,与 Table 2 共同构成完整评估。