面向模式匹配的知识图谱检索增强生成 Knowledge Graph-based Retrieval-Augmented Generation for Schema Matching
检索外部知识图谱子图增强LLM提示,免训练提升模式匹配精度并抑制幻觉
前置知识
模式匹配(Schema Matching)
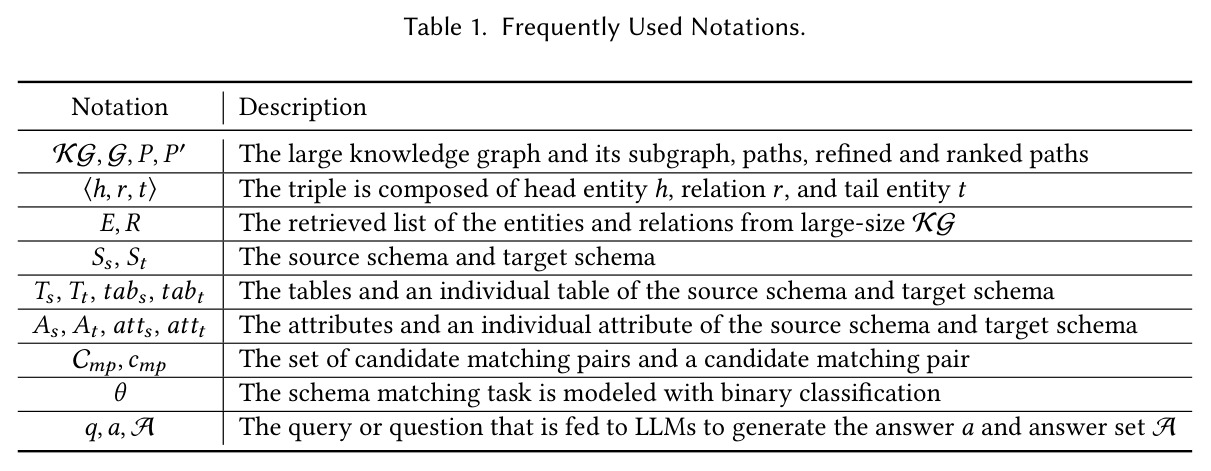
数据集成的基础任务:判断源属性-表对 $(att_s, tab_s)$ 与目标属性-表对 $(att_t, tab_t)$ 是否语义对应,本文建模为二分类 $\text{LLM}(\theta): C_{mp} \to \{Yes, No\}$,候选对 $C_{mp} = S_s \times S_t$ 由笛卡尔积生成。
全文的问题定义、方法流水线与评测指标 $P = \frac{TP}{TP+FP}$、$R = \frac{TP}{TP+FN}$、$F_1$ 都建立在该形式化之上,不理解它就无法读懂方法与实验。
知识图谱(Knowledge Graph, KG)
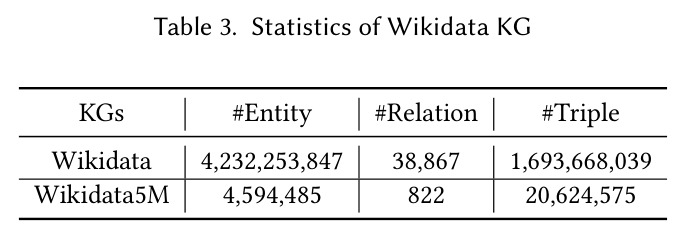
以 ⟨头实体 $h$, 关系 $r$, 尾实体 $t$⟩ 三元组结构化存储事实的知识库,如 Wikidata 中 patient(Q181600) 经 subclass of(P279) 连接 customer(Q852835)。Wikidata 含约 42.3 亿实体、16.9 亿三元组;UMLS 含 380 万医学概念。
KG 是外部事实证据的唯一来源,其三元组表示与巨大规模决定了'必须检索小子图而不能整体注入上下文'这一核心设计约束。
检索增强生成(RAG 与 KG-RAG)
先从外部知识源检索与问题相关的内容、再拼入提示以增强 LLM 生成的范式;Graph RAG / KG-RAG 检索的是子图或路径而非文本块,形式化为 $a^* = \arg\max_{a \in A} p(a \mid q, G)$,由子图检索器与 LLM 生成器组成。
KG-RAG4SM 本质上是专为模式匹配定制的 KG-RAG,理解该范式才能把握'检索—精炼—增强生成'的两阶段框架以及与 KGQA 类工作的异同。
向量相似度检索与 HNSW 索引
用 Sentence-BERT(RoBERTa-base,768 维)把问题与 KG 实体、关系、三元组编码成稠密向量存入 ChromaDB,在线用余弦相似度 $\text{sim}(A,B) = \frac{A \cdot B}{\|A\|\|B\|}$ 取 top-k;HNSW 索引构建多层近邻图实现近似对数级搜索。
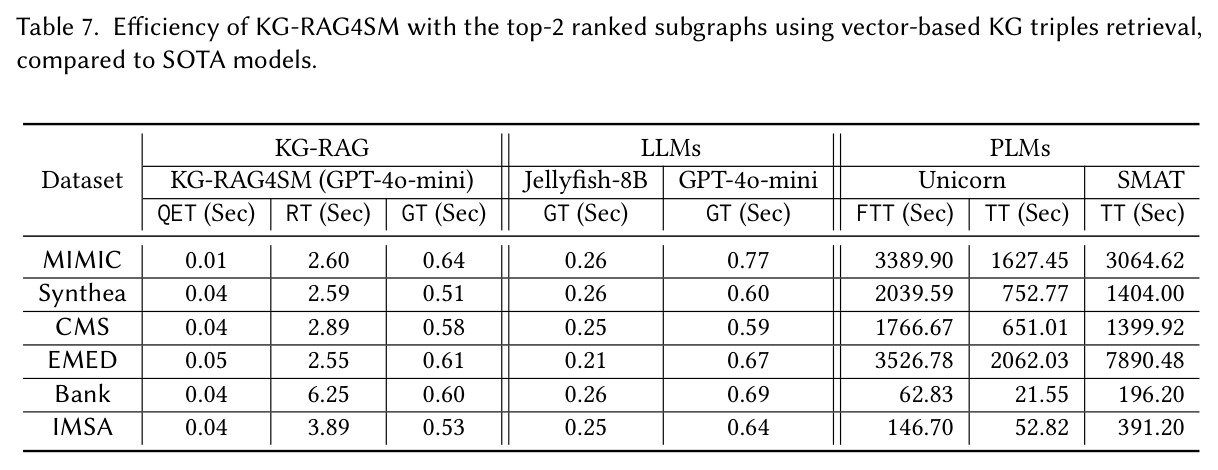
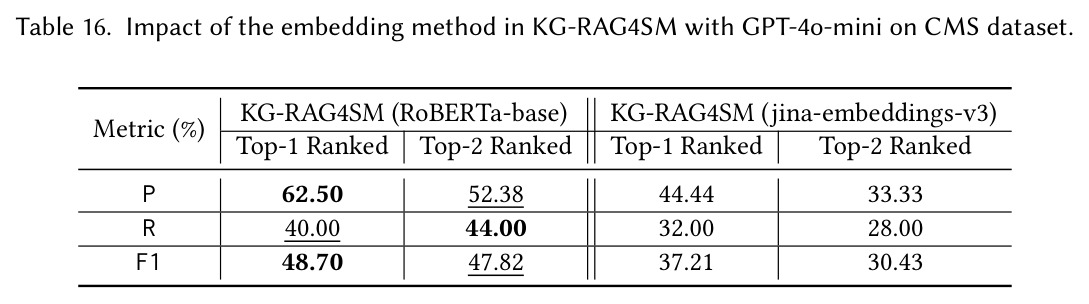
向量式三元组检索是实测最优的流水线之一,效率数据(每问检索 2.55-6.25 秒)与嵌入模型消融(RoBERTa vs jina-embeddings-v3)都围绕它展开。
广度优先搜索(BFS)图遍历
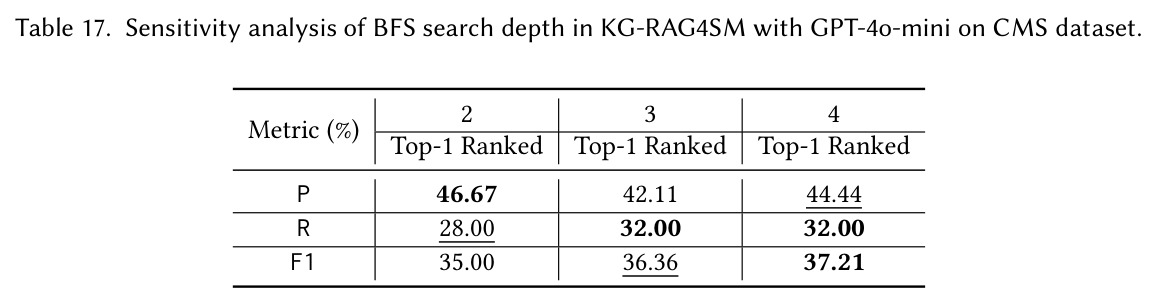
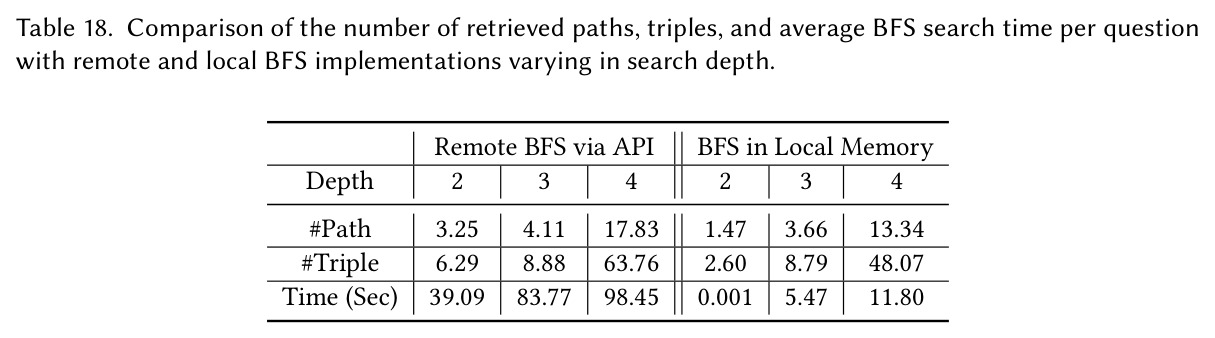
以向量检索得到的实体为种子在 KG 上扩展:单种子时扩展邻域至多 3 跳;多种子时对每对实体 $(e_s, e_e)$ 搜索连接它们的 ≤3 跳路径,可用本地内存 BFS 或 SPARQL 端点远程查询实现。深度 $D_{max}=3$ 是检索质量与延迟权衡的选择。
BFS 是图遍历式子图检索的核心,论文的复杂度分析 $O(\log n \cdot d + |V_S|^2 \cdot b^{D_{max}})$ 与搜索深度敏感性实验都以它为对象。
少样本提示与上下文污染(Context Poisoning)
在提示中附上带正确答案与解释的示例,让 LLM 模仿其推理方式完成新问题(in-context learning),全程不更新模型参数。但若注入的上下文包含不相关知识,会误导模型、诱发幻觉与假阳性答案,即上下文污染,这是 RAG 系统的已知痛点。
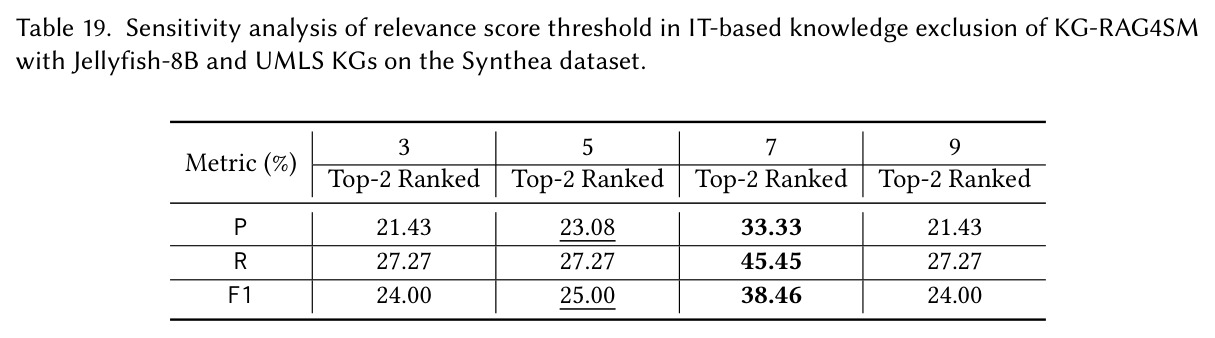
本文的排序精炼与规则式指令调优(相关性评分低于 7 时忽略 KG 上下文)都是针对上下文污染的对策,理解它才能领会这些设计的动机。
研究动机
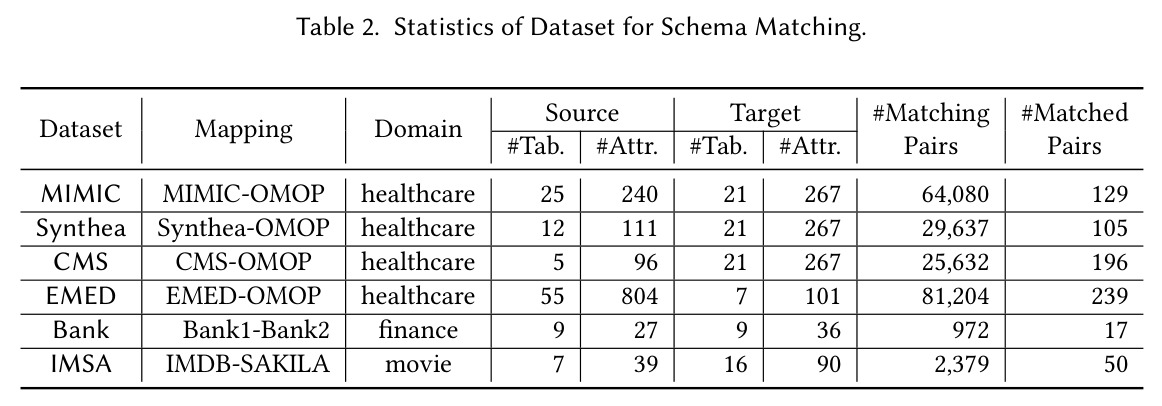
传统基于相似度的模式匹配对每对属性名计算相似度分数并按阈值接受,只依赖表面词汇相似,无法识别缩写、同义词与异构术语体系。作者以真实场景为例:匈牙利的 e-MedSolution 医院信息系统需要集成到标准医疗数据模型 OMOP CDM,源模式中 hun_case_i(o) 表的 ATTEND_DOCTOR 与 hun_case_diag 表的 DOCTOR 都应匹配到目标 CONDITION_OCCURRENCE 表的 provider_id,这类跨表、多对一的复杂映射难以靠名称相似度判定。近年来 LLM 与 PLM 被引入模式匹配(指令微调的 Jellyfish、注意力机制的 SMAT、多任务 Unicorn),但它们依赖属性名的文本描述做推理,而真实数据库往往缺乏这类背景知识;缺乏背景知识时 LLM 只能在句法层面利用文本信息,容易把语义相关的属性误判为匹配,产生幻觉。EHR 等系统集成规模巨大——例如 MIMIC 数据集有 64,080 个候选对、仅 129 个真实匹配——人工校验不现实,语义歧义与冲突因此成为自动化数据集成的核心瓶颈。
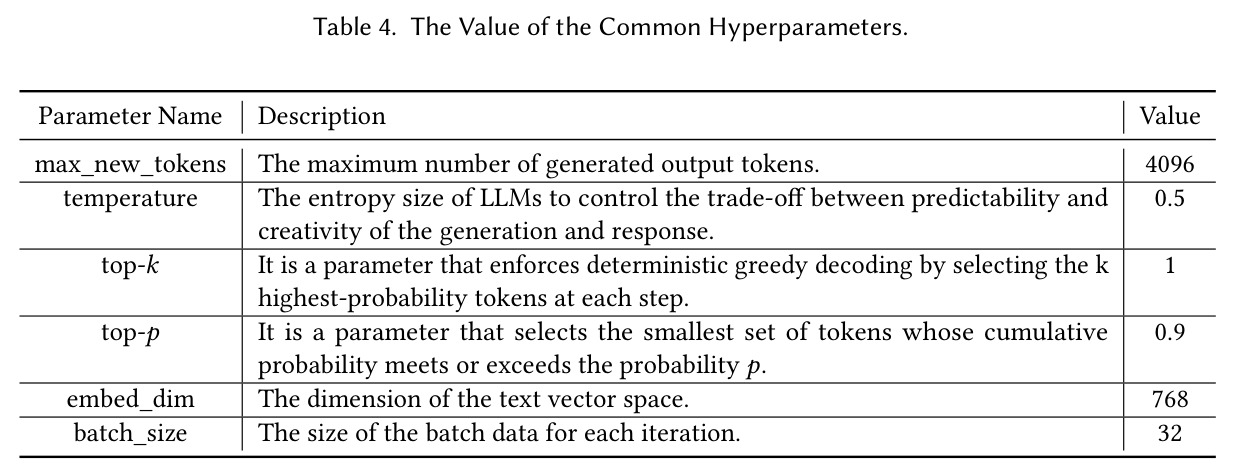
本文的目标是本文的目标是:在不重训任何 LLM 的前提下,通过从大规模外部知识图谱(常识类的 Wikidata 与领域专用的 UMLS)中检索与当前匹配问题相关的事实子图,为 LLM 提供常识性、事实性的背景知识,从而解决复杂映射中的语义歧义与冲突、抑制幻觉,并保证方法在效率上可部署。具体约束有三:(1) 外部 KG 规模巨大(Wikidata 含约 16.9 亿三元组),远超有限长度的模型上下文,必须高效检索出小的相关子图;(2) 注入过多不相关知识会引发上下文污染、反而降低性能,需要排序精炼与低相关子图排除机制;(3) 方法应跨领域可扩展(医疗、金融、电影),能从常识 KG 平滑迁移到领域 KG,并在 P/R/F1 上超过需要监督训练的 PLM 类 SOTA(SMAT、Unicorn)与 LLM 类 SOTA(Jellyfish),最终在真实场景案例中证明 LLM 幻觉被有效缓解。
与已有工作不同的是,本文的独特切入点在于'从大规模外部 KG 检索'这一范式选择。已有 Graph RAG 与 KG-RAG 工作(如 GraphRAG、ArchRAG)都是先从文本块自建局部小图,或使用 KGQA 数据集自带的内在图,再从中检索邻居或子图;而已有模式匹配的 RAG 尝试(ReMatch、Matchmaker、KcMF)只从模式自身的文本文档或自建知识集中检索,无法补充数据库里不存在的外部常识与领域事实。本文首次直接从 Wikidata 这类数十亿三元组的外部大图中检索子图来增强模式匹配。与主流图推理方法也不同:RoG、ToG、KG-CoT 通过 beam search 或思维链在图上多步生成推理路径,在大图与复杂查询上计算开销显著;KG-RAG4SM 改用'混合检索 + 排序精炼 + 知识排除'一次性提取紧凑的任务相关事实子图做 one-shot grounding,避免迭代式路径构建。作者还贡献了来自真实匈牙利医疗系统的新基准 EMED,推动领域专用模式匹配研究。
核心方法
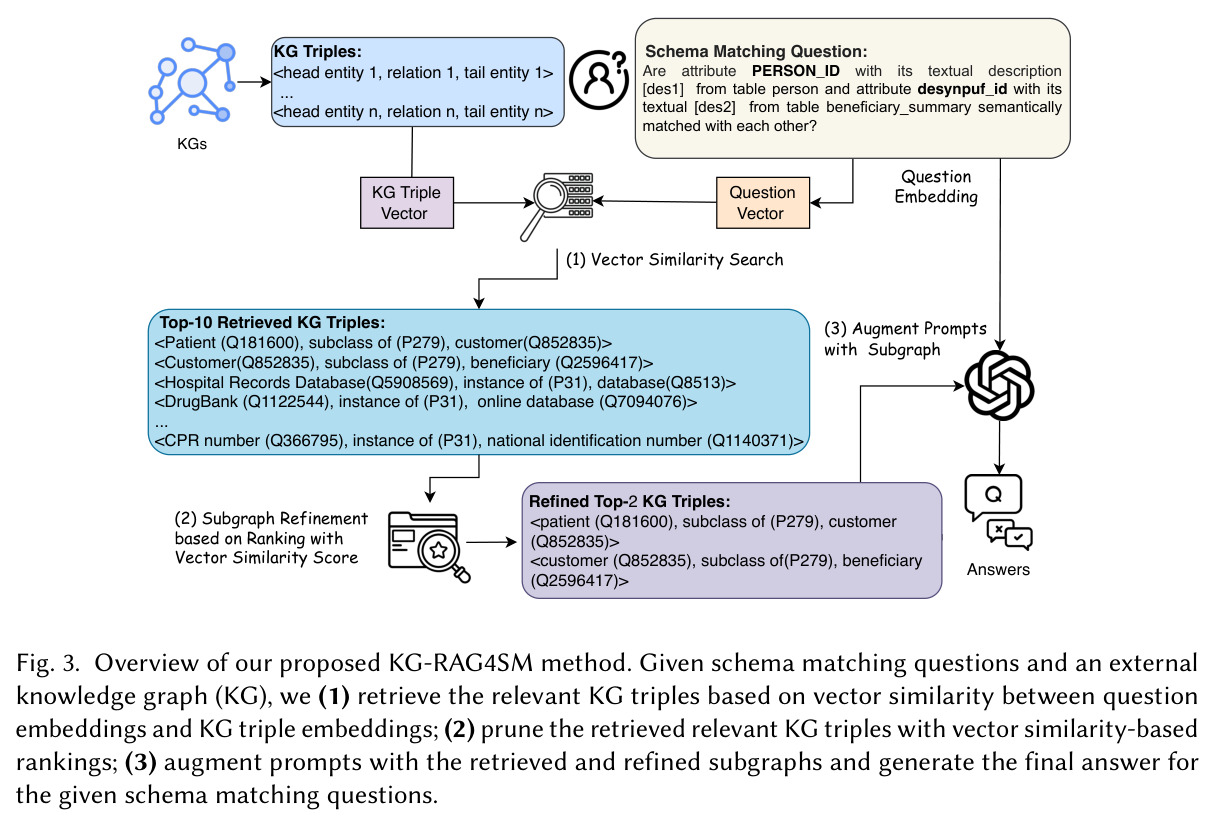
直觉上,让 LLM 判断两个属性是否语义匹配时,若能同时看到 Wikidata 里 'beneficiary subclass of customer subclass of patient' 这样的层级事实,就能明白两个外键指向不同实体、或两个标识符同属医疗流程,从而做出正确判断。技术路线分四步:(1) 把每个候选匹配对 $(att_s, tab_s)$ 与 $(att_t, tab_t)$ 生成一个二分类问题 $q$;(2) 用四种方式之一从外部 KG 获取相关子图——向量式三元组检索、向量式实体检索+BFS、LLM 式实体检索+BFS、LLM 式子图检索;(3) 用基于排序的检索精炼(频率加路径长度归一化,或直接用余弦相似度)把候选子图裁剪到 top-1/top-2;(4) 将精炼后的半结构化子图连同 few-shot 示例注入提示,让 LLM 输出最终判断。可选地,用规则式指令调优让 LLM 先给 KG 上下文打 0-10 相关性分,低于 7 分则忽略上下文、仅凭自身知识回答。实测表现最好的两条流水线是向量式三元组检索与向量式实体检索+BFS,其余作为消融对照。
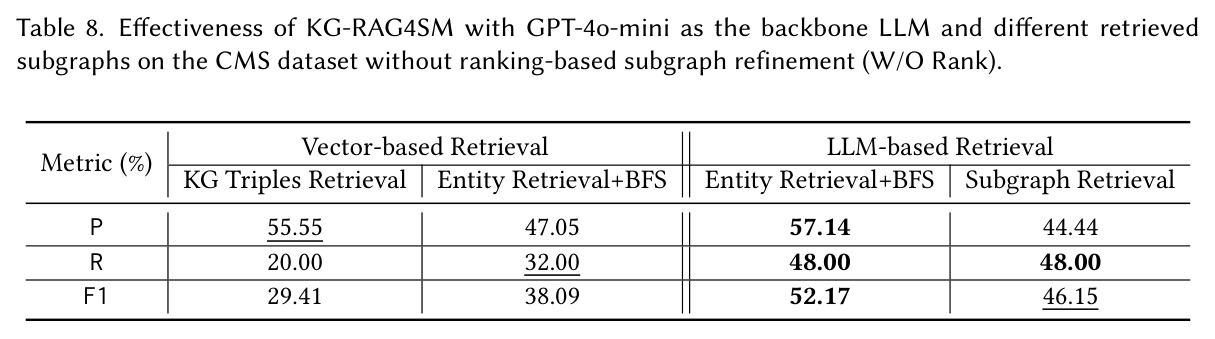
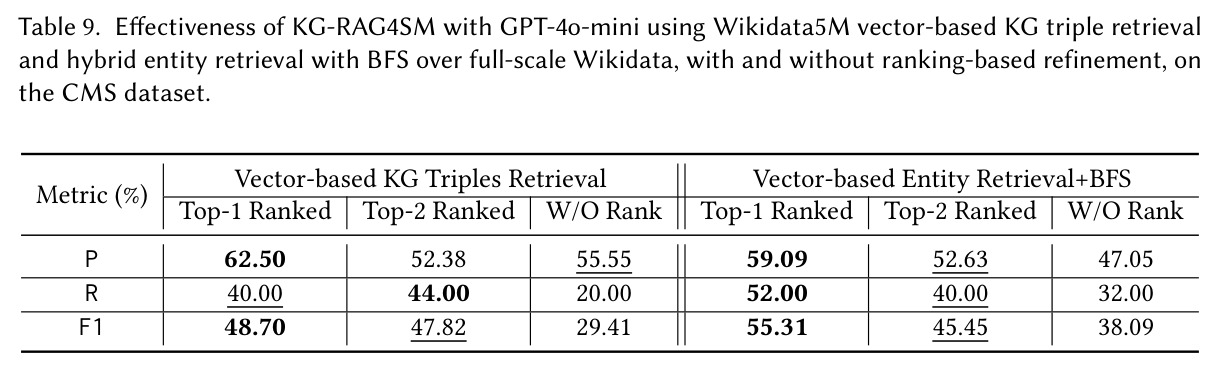
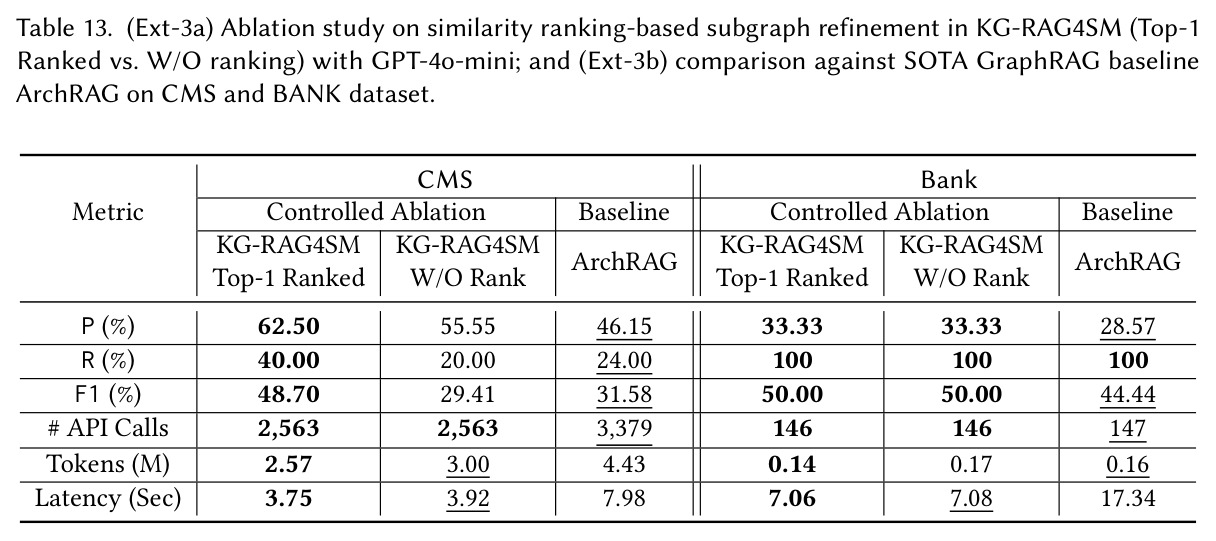
核心创新是把'外部大规模 KG'当作模式匹配的事实证据源,并解决'大图上如何检索'这一关键挑战。与 KGQA 场景的 Graph RAG 从自建小图取邻居不同,这里的相关知识只存在于外部大图(Wikidata 有约 42.3 亿实体),既不能整体注入上下文,也不能容忍不相关三元组造成的上下文污染。与已有方法的本质区别有三:其一,提出四种互补的子图检索机制(LLM-based、vector-based、graph traversal-based、hybrid),向量式检索用 RoBERTa 离线嵌入 Wikidata5M 存入 ChromaDB(HNSW 索引),在线按余弦相似度取 top-k,平均每问检索约 2.88 秒;其二,用频率加路径长度归一化的排序方案把检索结果裁剪到 top-1/top-2,在 CMS 上相比不排序(保留 top-10)把 F1 从 29.41% 提升到 47.82%;其三,规则式指令调优让 LLM 对 KG 上下文自评相关性、低于阈值 7 就回退到自身知识,保证即便检索质量欠佳也不产生假阳性。整个系统免训练、即插即用。
方法步骤详情
第一步,问题构造:对笛卡尔积 $C_{mp} = S_s \times S_t$ 中的每对候选属性-表组合,用属性名加文本描述生成二分类问题 $q$,送入 LLM(主骨干 GPT-4o-mini)。第二步,离线索引:经 Wikidata API 抓取标签与描述,用 RoBERTa-base 编码为 768 维归一化向量存入 ChromaDB(Wikidata5M 嵌入为一次性成本)。第三步,在线检索:(a) 向量式三元组检索按问题与三元组嵌入的余弦相似度取 top-k;(b) 向量式实体检索先取种子实体——单种子做 ≤3 跳局部 BFS,多种子则对实体对 $(e_s, e_e)$ 用 SPARQL 模板远程查 ≤3 跳路径,或做本地内存 BFS。第四步,排序精炼:按路径包含 top-k 相关关系的频次并做长度归一化排序(三元组直接按相似度),保留 top-1/top-2。第五步,提示增强:把子图以带箭头的半结构化文本直接放进提示(不做 verbalizer 转写以免丢结构信息),配合 few-shot 解释生成答案。第六步(可选),规则式指令调优:LLM 给上下文打 0-10 相关性分,≥7 才采信 KG 上下文,否则仅凭自身知识回答。
技术新颖性
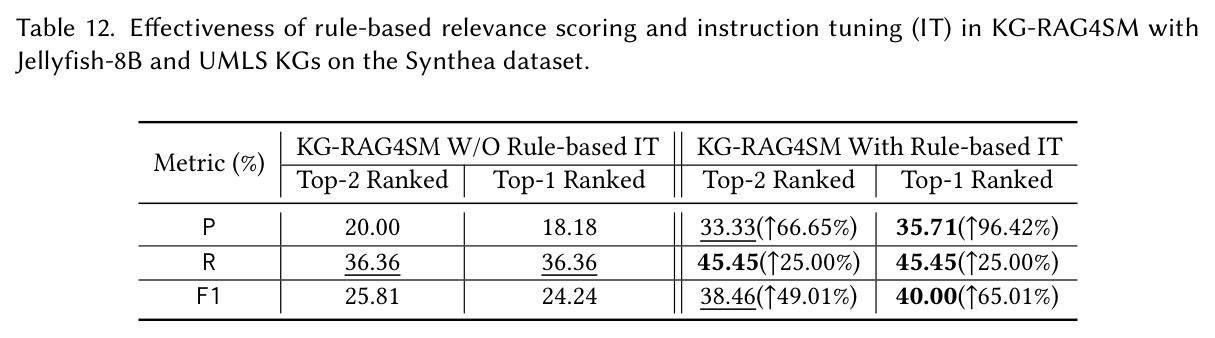
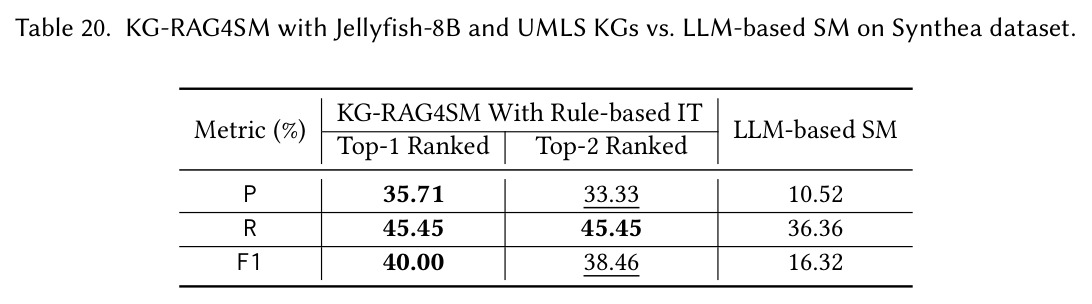
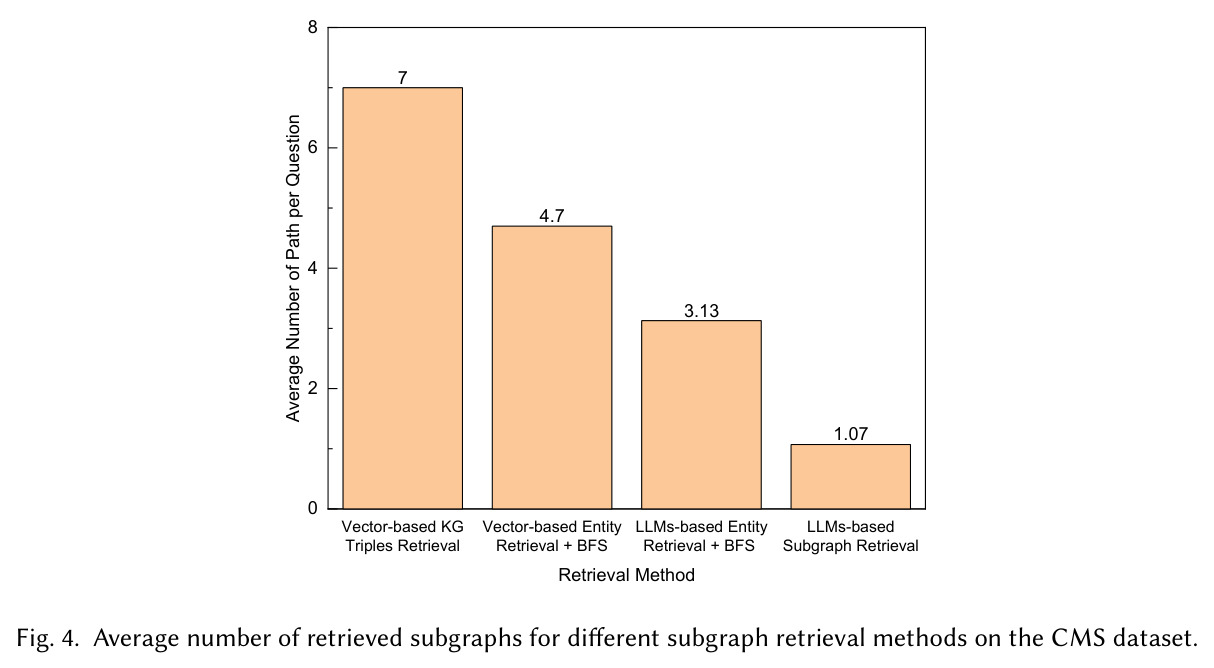
技术新颖性体现在四个层面。第一,问题层:首次把 KG-RAG 范式引入模式匹配,且检索对象是真实存在的外部大 KG 而非文本块自建图,填补了'数据库内部没有可借用 KG'的空白,与 ReMatch、KcMF 等只检索自身文档的方法有本质区别。第二,检索层:系统比较了 LLM-based、vector-based、graph traversal-based 与混合四类检索的权衡,发现向量式检索平均每问可取回 7 条子图而 LLM 式仅 1.07 条(LLM 记不准 Wikidata 标识符、对领域 KG 完全陌生),据此确立'向量检索为主、LLM 检索为辅'的工程结论。第三,精炼层:频率加长度归一化排序是轻量的上下文去噪方案,Ext-3a 消融证明仅保留 top-1 就能在 CMS 上把 F1 从 29.41% 提到 48.70%,同时把 token 消耗从 3.00M 降到 2.57M、延迟从 3.92 秒降到 3.75 秒。第四,鲁棒层:指令调优式知识排除把'相关性门控'内置进提示,使 UMLS 这类低质量检索场景的 F1 从 24.24% 恢复到 40.00%;不同于传统 RAG 的事后重排序,这是让模型自行决定是否采信外部证据的机制。
实验结果
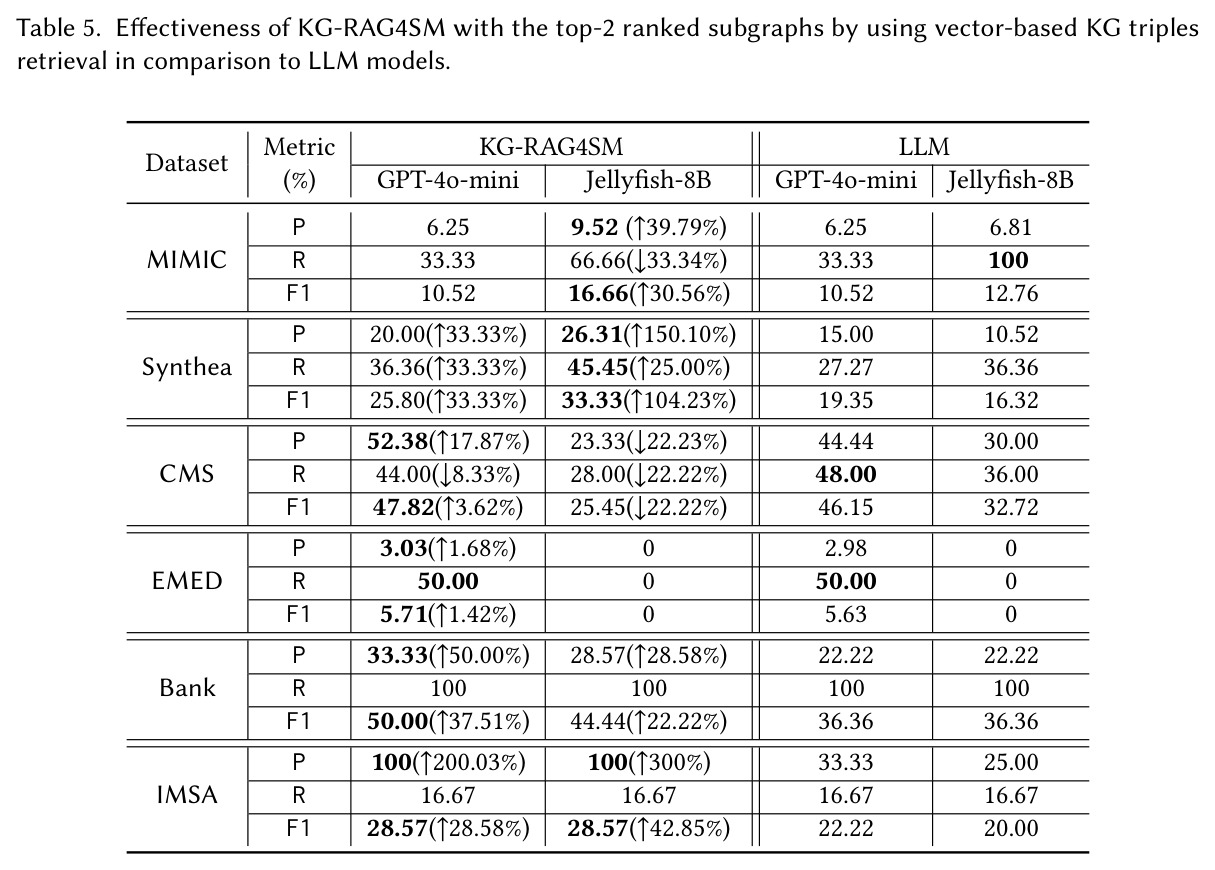
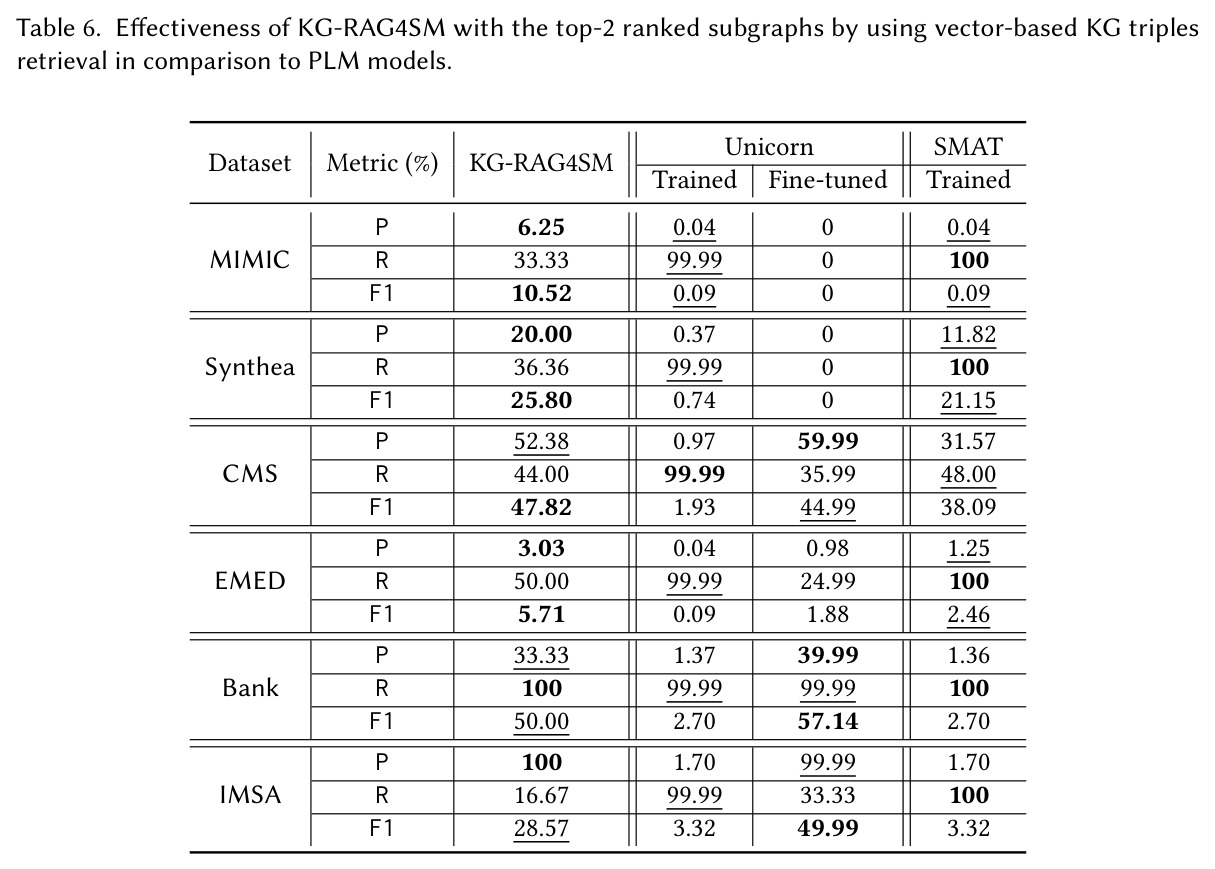
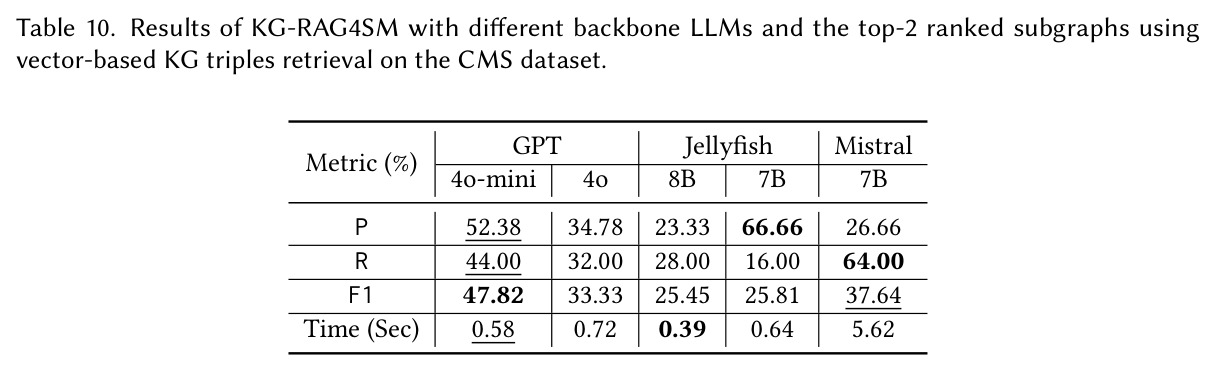
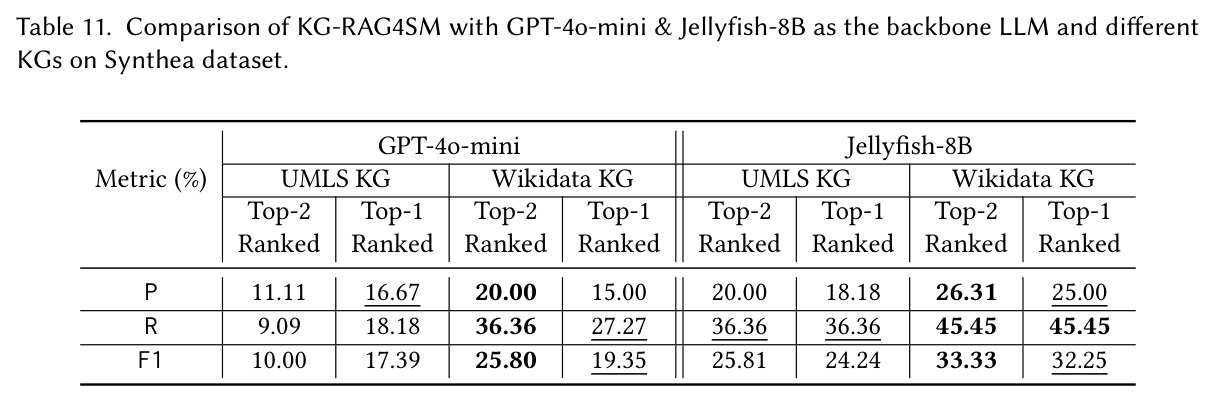
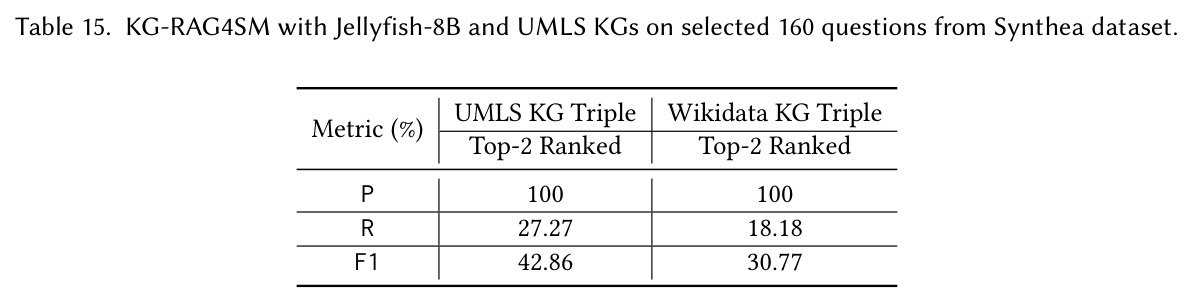
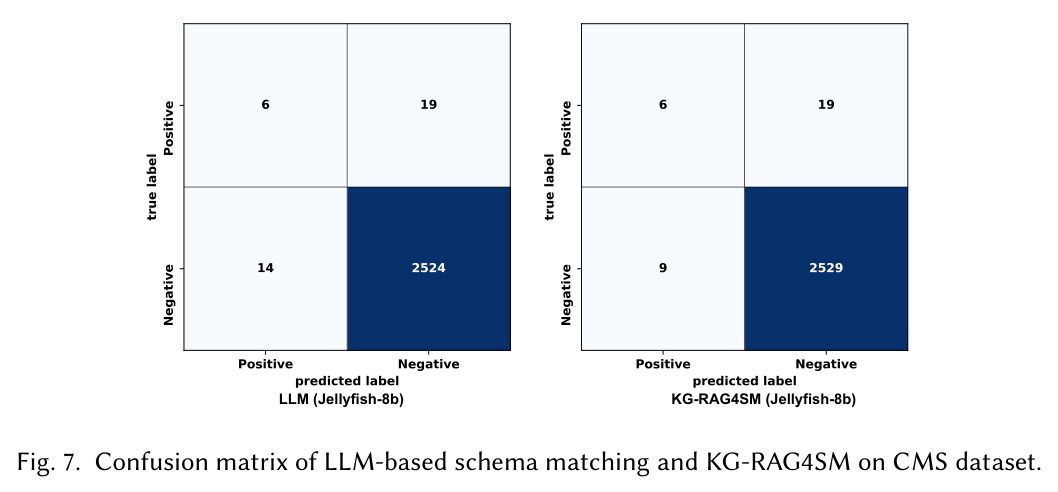
有效性(Exp-1):KG-RAG4SM 以 Jellyfish-8B 为骨干在 MIMIC 上取得 P 9.52%、F1 16.66%,较未增强基线(6.81%/12.76%)提升 39.79%/30.56%;Synthea 上 P +150.10%、F1 +104.23%。GPT-4o-mini 骨干在 Synthea 上比训练版 SMAT 高 69.20%(P)、21.99%(F1)。效率(Exp-2):每问嵌入+检索+生成合计 3-7 秒,而 Unicorn/SMAT 训练需数千至上万秒。消融:排序精炼贡献巨大——CMS 上 top-2 精炼使向量三元组检索 F1 从 29.41% 升至 47.82%,top-1 使向量实体检索+BFS 从 38.09% 升至 55.31%;且小骨干优于大骨干。KG 域:UMLS 全量 Synthea 上弱于 Wikidata(F1 25.81% vs 33.33%),但 160 道专业医学题上反超(42.86% vs 30.77%)。真实性:指令调优把 UMLS 配置 F1 提到 40.00%(+65.01%)。对比 ArchRAG:CMS 上 F1 48.70% vs 31.58%,token 与延迟约减半。案例:子图纠正两例幻觉(FP 14→9)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 模式匹配:MIMIC-OMOP(vs LLM) | Precision / F1 | 9.52% / 16.66%(Jellyfish-8B 骨干) | Jellyfish-8B(LLM SOTA,无增强)6.81% / 12.76% | +39.79% / +30.56% |
| 模式匹配:Synthea-OMOP(vs LLM) | Precision / F1 | 26.31% / 33.33%(Jellyfish-8B 骨干) | Jellyfish-8B 10.52% / 16.32% | +150.10% / +104.23% |
| 模式匹配:Synthea-OMOP(vs PLM) | Precision / F1 | 20.00% / 25.80%(GPT-4o-mini 骨干) | SMAT(监督训练)11.82% / 21.15% | +69.20% / +21.99% |
| 模式匹配:CMS-OMOP(vs GraphRAG) | F1 / token 消耗 / 端到端延迟 | 48.70% / 2.57M / 3.75 秒 | ArchRAG(SOTA GraphRAG)31.58% / 4.43M / 7.98 秒 | F1 +17.12 个百分点,token −42%,延迟 −53% |
| 模式匹配:IMSA(电影领域) | Precision / F1 | 100% / 28.57%(Jellyfish-8B 骨干) | Jellyfish-8B 25.00% / 20.00% | +300% / +42.85% |
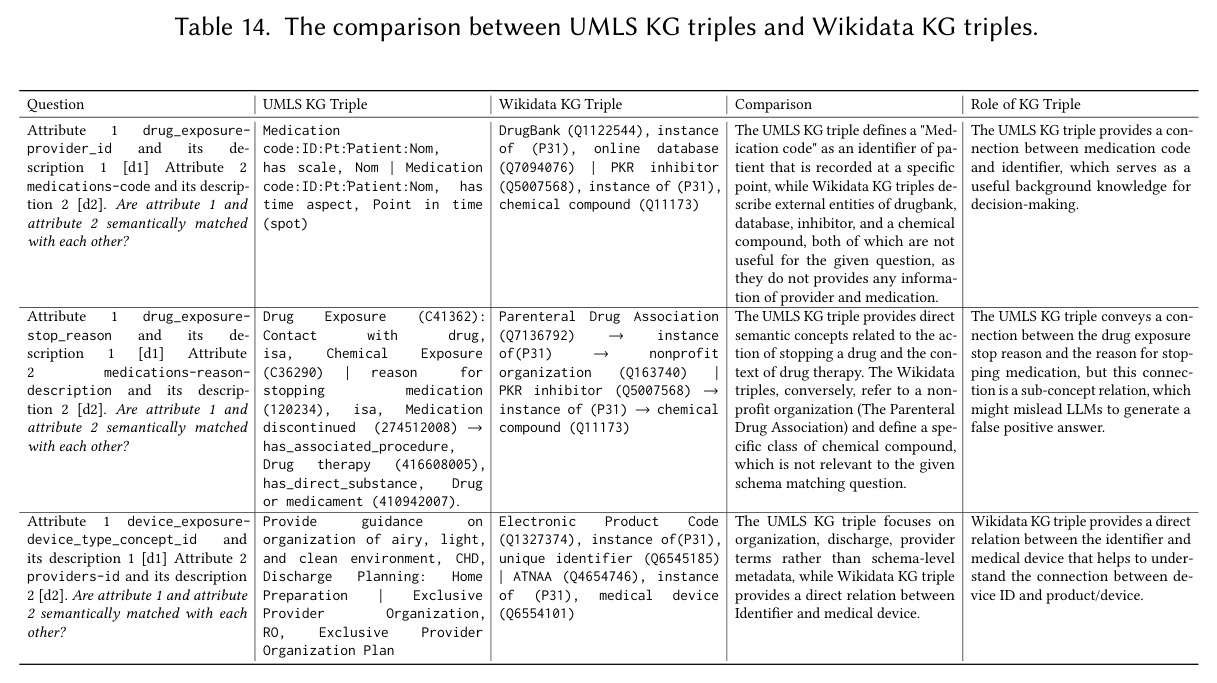
| 专业医学词汇子集(Synthea 160 题,UMLS KG) | F1 | 42.86% | Wikidata KG 30.77% | +39.29%(相对提升) |
局限与改进
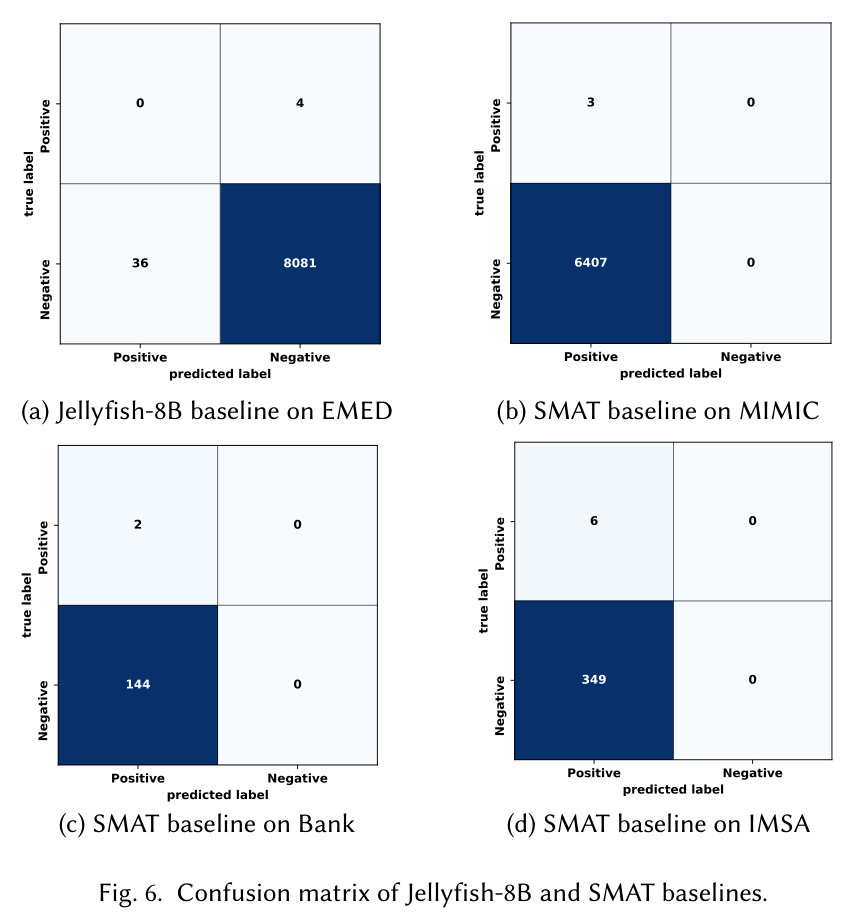
作者承认的局限:其一,微调型骨干(Jellyfish-8B)与检索知识冲突,在未见过的 CMS 上 P/F1 相对下降 22.23%/22.22%,印证'微调模型上做 RAG 可能负收益';其二,UMLS 等领域 KG 只维护一跳关系、多跳缺失,检索质量欠佳、假阳性增多,需指令调优补救;其三,LLM-based 检索依赖 LLM 对 KG 的记忆,对领域 KG 完全失效且常返回不存在的实体 ID;其四,召回率常低于 PLM 基线(作者辩称基线 100% 召回是过拟合、偏向答 Yes)。我自己的观察:(1) F1 绝对水平整体不高(MIMIC 16.66%、EMED 仅 5.71%),距实用尚远;(2) 候选对按笛卡尔积逐对调用 LLM,EMED 有 81,204 对,成本随模式规模乘积增长,缺乏 blocking 预筛;(3) 相关性阈值 7、BFS 深度 3、top-2 等关键超参靠经验网格搜索确定,迁移新领域需重调;(4) 仅做 schema 级匹配,未利用表内实例数据;(5) 各数据集正例极少(Bank 仅 17 个),指标方差大,结论稳健性存疑;(6) 本地 BFS 依赖 Wikidata5M 静态快照,KG 动态更新后需重做约 46 小时嵌入。
独立分析的弱点
独立分析的弱点与改进方向:(1) 候选对爆炸——EMED 的 804×101 个属性生成 81,204 个候选对,整体成本线性于笛卡尔积规模;可先用属性嵌入做近似最近邻预筛(blocking),只对 top-k 候选做昂贵的 KG 检索与 LLM 判断,预计砍掉 90% 以上调用量。(2) 逐对独立判断忽略全局一致性——无法利用'一个源属性通常只匹配一个目标属性'的基数约束;可引入全局优化(匈牙利算法)或把同表属性批量打包进一次提示。(3) 精确率绝对值偏低——MIMIC 上 P 仅 9.52%,通用常识子图对专业医疗属性区分力不足;可为高频领域预构建领域子图索引(如从 UMLS 展开多跳),或用对比学习微调嵌入模型替代通用 RoBERTa。(4) 知识冲突无仲裁——微调骨干与外部证据冲突时性能崩溃(CMS 上 Jellyfish-8B F1 相对下降 22.22%),可加证据来源加权或让模型显式输出冲突分析再决策。(5) 超参手工设定——阈值敏感性实验显示 3/5/9 都明显劣于 7,可改为自适应门控或在验证集上学阈值。(6) 检索质量未被单独评估——全文未报告实体/三元组检索的 recall@k,无法区分错误来自检索还是生成,应补充检索侧诊断指标。
未来方向
作者明确提出的方向:消解 LLM 内部参数化知识与检索 KG 之间的知识冲突;系统考察检索性能随 KG 规模与连通性变化的表现(目前仅有 Wikidata5M 与全量 Wikidata 两种配置);设计更先进的图遍历策略以进一步优化大图上的子图检索;把 KG-RAG 范式推广到其他 LLM 驱动的数据集成与数据融合任务。基于本文成果可自然延伸的研究:(1) 端到端 schema mapping——从二分类对应关系自动生成可执行的 ETL 映射表达式,打通'匹配到落地'最后一公里;(2) 实例感知匹配——把列值统计特征与 KG 事实联合证据化,弥补纯元数据匹配的判别力不足;(3) 增量式 KG 索引——支持 Wikidata 动态更新而无需 46 小时全量重嵌入;(4) 多 KG 联合检索——同时查 Wikidata 与 UMLS 并做证据融合(Table 14/15 显示二者高度互补);(5) 自适应检索——按问题难度动态选择 BFS 深度与 top-k,平衡成本与精度;(6) 把排序精炼替换为可学习的重排序器(如 cross-encoder),并在检索质量指标上形成闭环评估。
复现评估
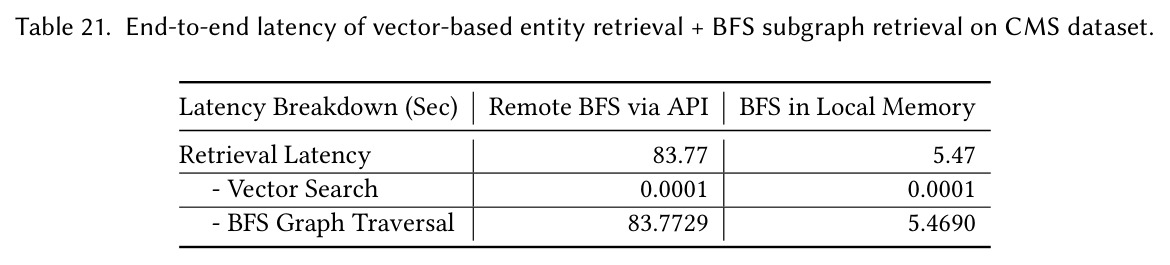
复现条件较好。代码与全部数据集已在 GitHub 开源(machuangtao/KG-RAG4SM);MIMIC、Synthea、CMS 公开可下载(来自 OMAP 基准),EMED 为作者新发布(源自匈牙利 e-MedSolution 设计文档,仅 schema 级信息,239 个正例);Bank、IMSA 来自 LLMATCH 与专家标注。硬件门槛低:主实验用 2× NVIDIA A10 GPU、100GB 内存服务器跑本地模型,GPT-4o-mini 走 OpenAI API;本地内存 BFS 在 32 vCPU、64GB 内存的纯 CPU 虚机即可运行(存储 1.23GB、常驻内存 8.29GB)。主要成本:Wikidata5M 离线嵌入约 20 小时(实体)加 26 小时(三元组);复现 ArchRAG 对比还需额外 token 开销。难点:(1) 全量 Wikidata 远程 BFS 延迟高(深度 3 时 83.77 秒/问)且受 SPARQL 端点限流;(2) UMLS 需申请 UTS 许可证;(3) few-shot 例子与措辞对结果影响大,好在附录 A 给出全部提示模板可照搬;(4) temperature=0.5 下输出有随机性,指标可能小幅波动。总体属中低难度复现。
论文图表
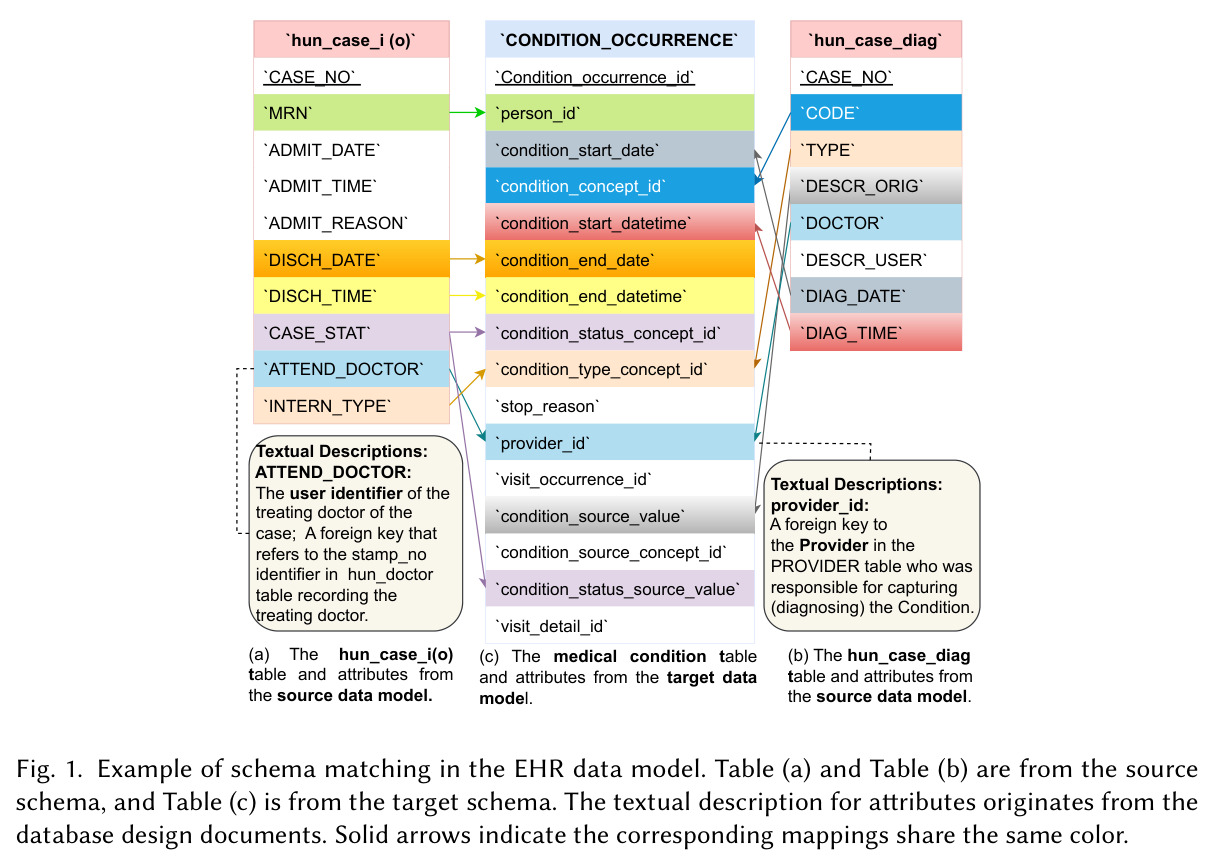
展示真实 EHR 集成场景:源模式的两张表 hun_case_i(o)(含 ATTEND_DOCTOR、ADMIT_REASON 等属性)与 hun_case_diag(含 DOCTOR、DESCR_ORIG 等),以及目标 OMOP CDM 的 CONDITION_OCCURRENCE 表,每个属性附数据库设计文档中的文本描述,实线箭头标出 ATTEND_DOCTOR 与 DOCTOR 都应映射到 provider_id 的对应关系。
这是贯穿全文的 motivating example,直观呈现传统相似度方法无法处理的跨表、多对一复杂映射,是一切方法设计的起点。
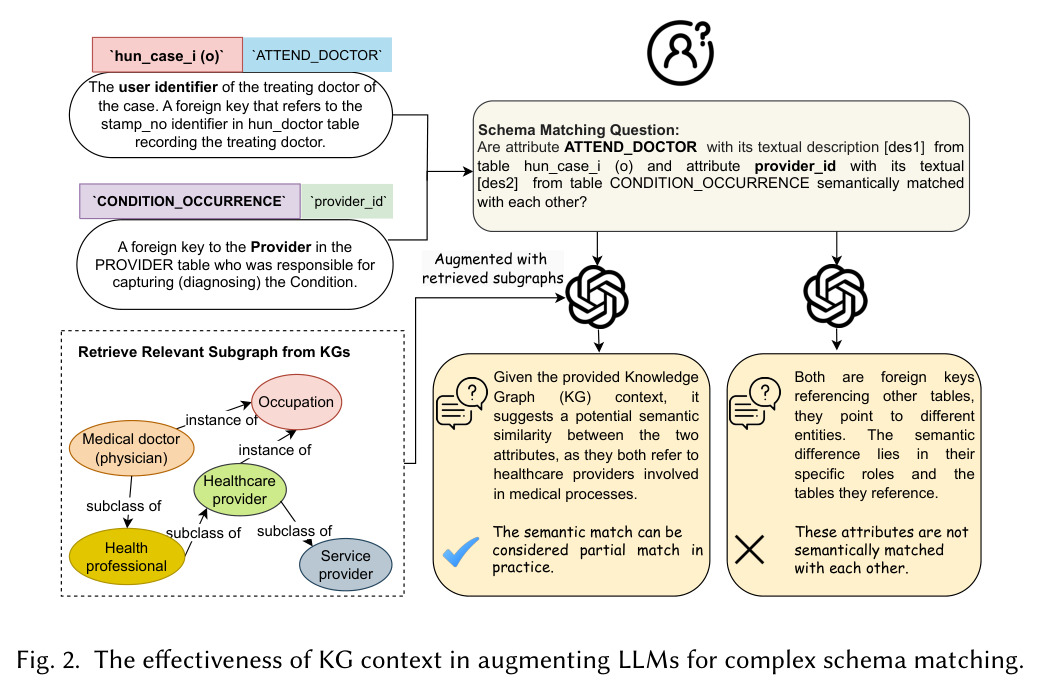
展示 KG 上下文如何改变 LLM 判断:针对 ATTEND_DOCTOR 与 provider_id 的匹配问题,从常识 KG 检索到的子图揭示 Medical doctor(instance of physician)与 Healthcare provider(subclass of Service provider)同属 Healthcare professional 下的不同分支,LLM 据此得出'两者都是引用其他表的外键但指向不同实体、语义不匹配'的正确结论。
一图说明外部 KG 事实如何帮助 LLM 区分表面相似但语义不同的属性,是方法价值的直觉展示。
CMS 数据集上 Jellyfish-8B 骨干的混淆矩阵对比:KG-RAG4SM 取得 2,529 TN、9 FP,裸 LLM 为 2,524 TN、14 FP,TP 与 FN 持平,说明子图增强的贡献主要是减少假阳性而不牺牲真阳性。
提供混淆矩阵级的定量证据,佐证外部 KG 结构化事实让判断更可靠,与案例研究相互印证。