LOLPlay:原版英雄联盟中的实时视觉智能体基准 LOLPlay: Benchmarking Real-Time Visual Agents in League of Legends
在不停盘的原版英雄联盟中评测实时视觉智能体,最强模型任务成功率仅25.0%。
前置知识
视觉智能体
指以图像(屏幕截图)为输入、以鼠标键盘等通用界面操作为输出的智能体,类似计算机使用代理:每个决策步接收当前截图 $o_k$ 与任务指令,输出 click(x,y)、press('q') 等动作。它没有游戏内部接口,只能像人类玩家一样看屏幕、动鼠标。
LOLPlay 评测的对象正是这类通用视觉智能体,理解其观察-决策-动作循环是读懂实验设置的前提。
MOBA 与英雄联盟
MOBA(多人在线战术竞技)是5v5推塔游戏类型,英雄需兼顾补兵发育、技能战斗、生存与地图目标。英雄联盟中右键移动/攻击、QWER 施放技能、商店购买装备,而小兵、野怪、防御塔和游戏时钟不依赖玩家输入持续推进。
本文所有36个任务都绑定具体英雄,任务的资源、战斗、生存、顺序要求全部来自 MOBA 玩法结构。
推理努力档位
大模型推理 API 的可调参数,控制模型在给出答案前内部思维链的深度:低档响应快、token 少,高档思考更久、延迟更高。本文测了 low/medium/high 三档对实时任务表现的影响。
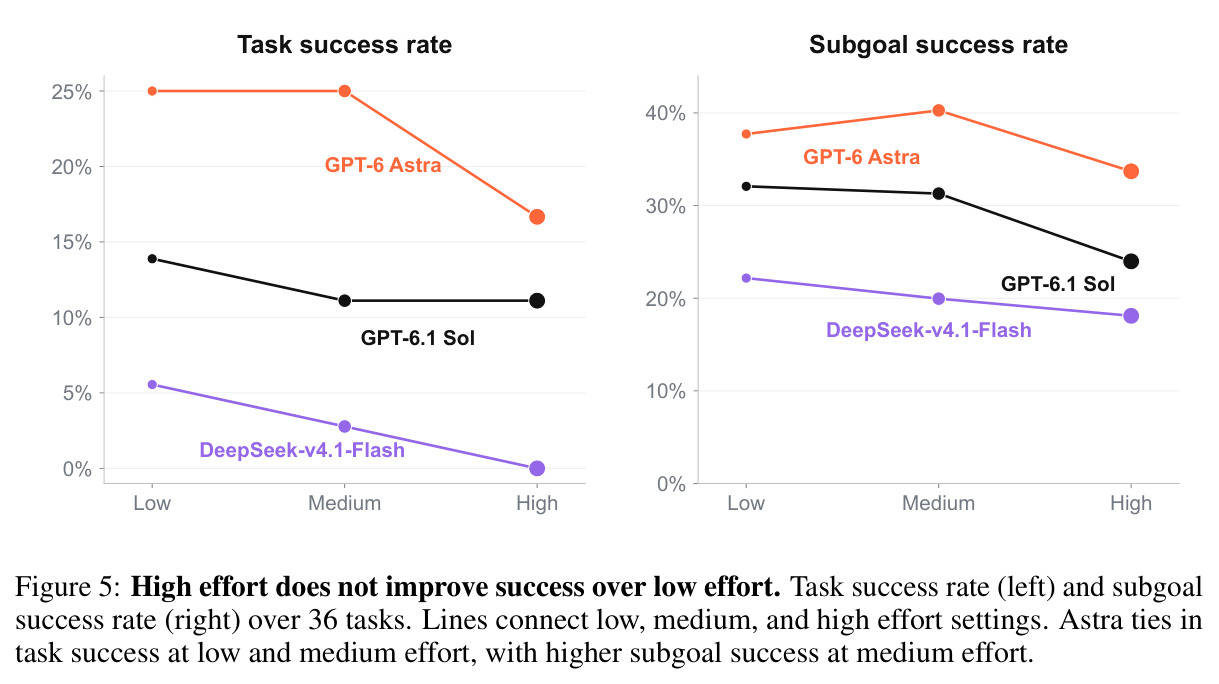
论文核心发现之一是更高推理档位在实时环境中无收益甚至有害,理解该参数才能读懂表6与图5。
LCU 与 Live Client Data API
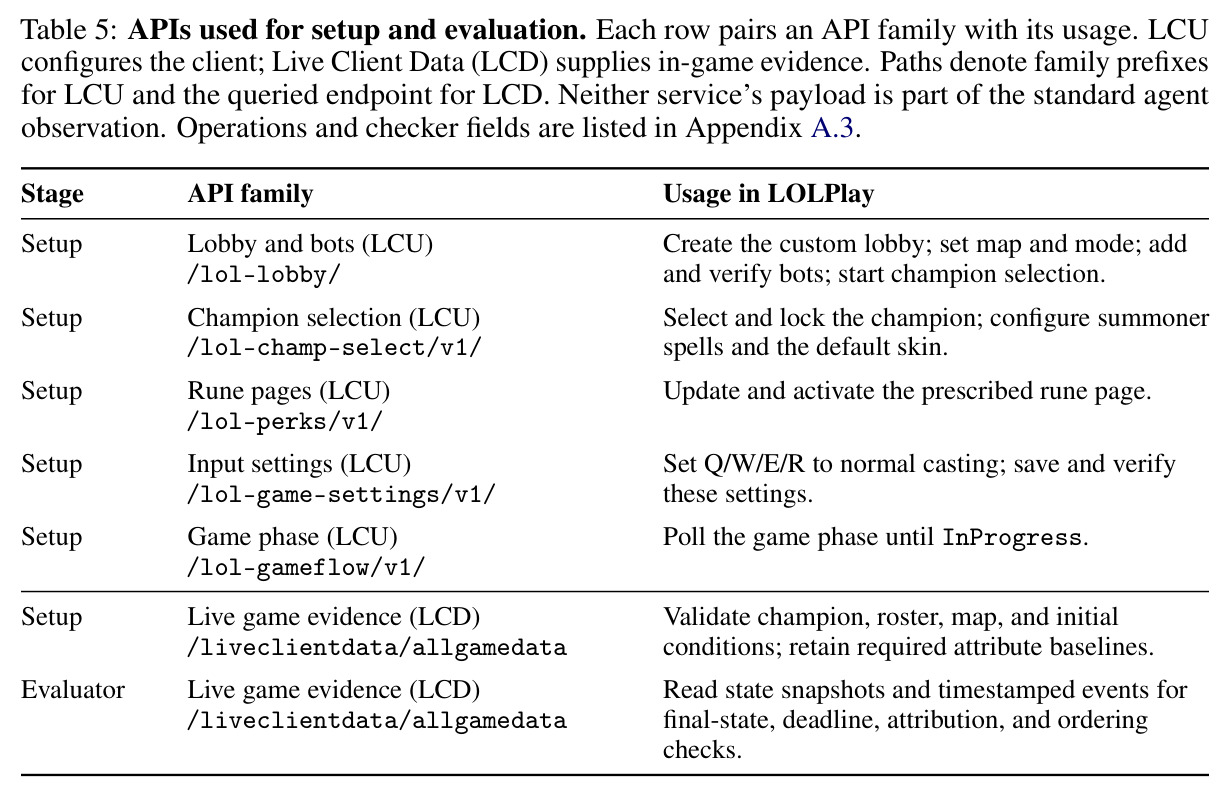
英雄联盟客户端提供的两个本地服务:LCU API 可自动创建自定义对局、添加机器人、选英雄、配符文,用于初始化任务环境;Live Client Data(LCD)API 在对局内提供玩家属性、游戏时间与带时间戳的事件流(击杀、推塔等),用于独立评估。两者都不进入智能体的观察。
LOLPlay 的自动初始化与可执行评估完全建立在这两个 API 上,且与智能体信息隔离,是方法可信度的关键。
观察-动作延迟
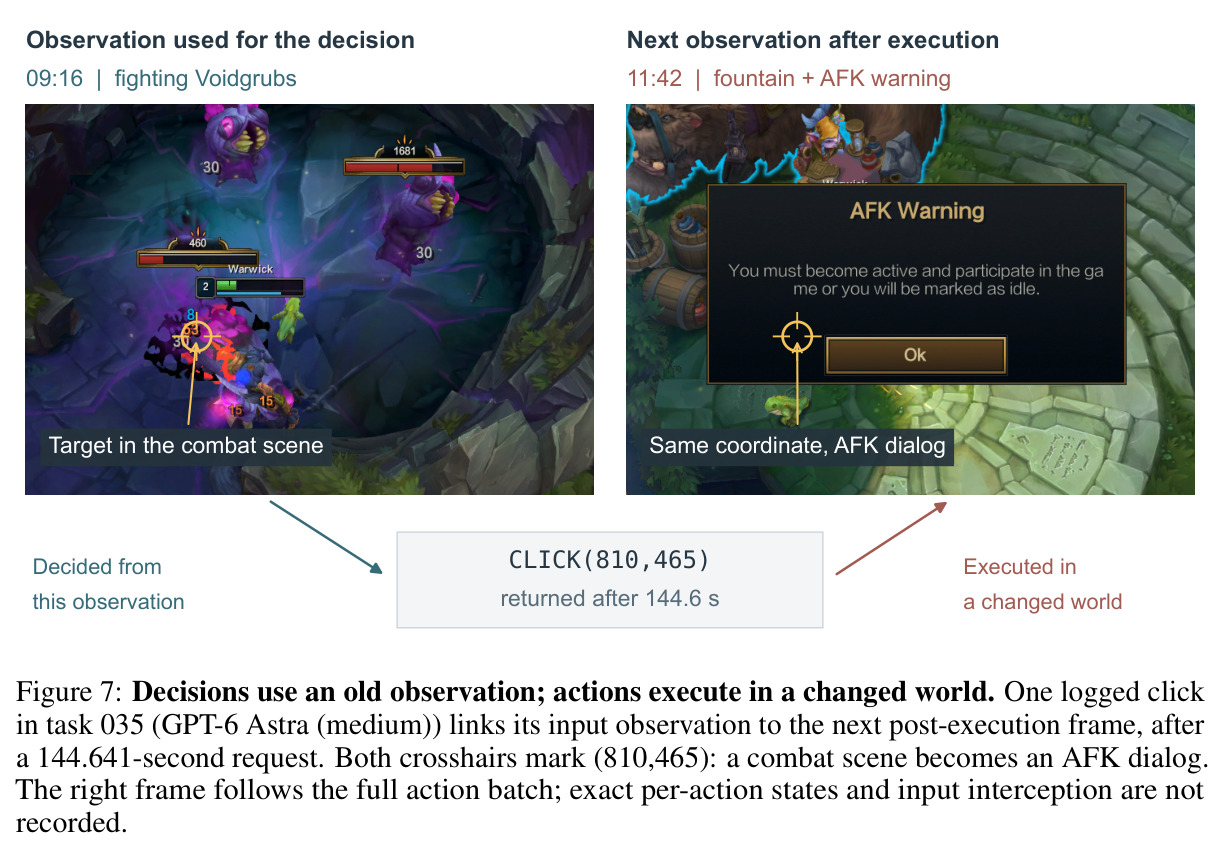
智能体基于时刻 $t_k$ 的截图决策,但游戏在模型推理与动作执行期间继续运行,动作落地时场景可能已改变:敌人位移、对话弹窗出现等。这是与暂停式环境(如 VideoGameBench Lite)的本质区别,也是实时智能体研究的核心难题。
论文的 Warwick 案例(144.6秒请求后点击落在 AFK 对话框)正是这一现象的实证,也是全文结论的出发点。
研究动机
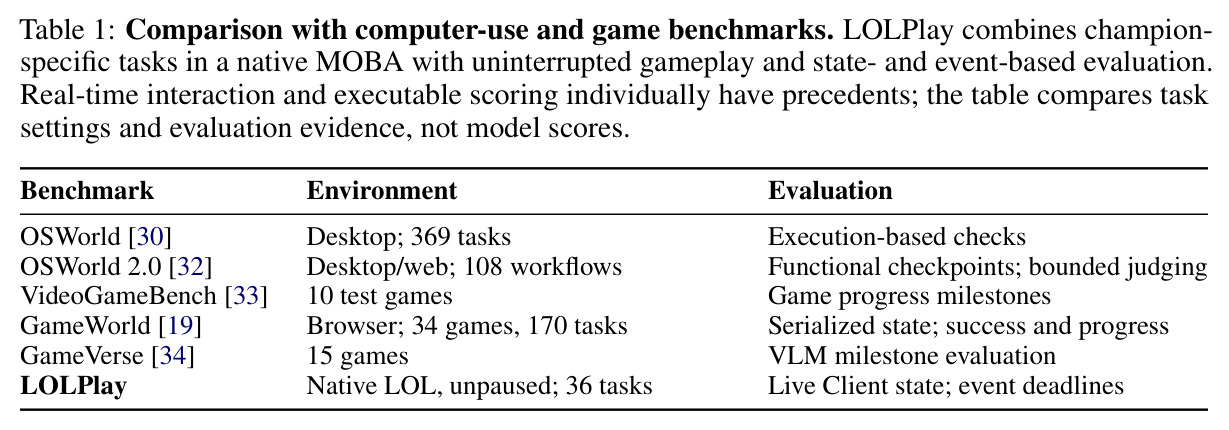
现有的计算机使用与游戏评测基准大多默认世界会等智能体。OSWorld 包含369个桌面任务、OSWorld 2.0 覆盖108个工作流,任务执行时应用状态基本静止;VideoGameBench 虽涉及游戏但提供可暂停的 Lite 版本,其论文已指出延迟是瓶颈;GameWorld 支持34款浏览器游戏170个任务,用序列化状态评估且可选用暂停协议。在这些设置下,智能体基于截图做长推理不会付出代价。真实世界却不等待:视觉智能体从截图判断要点击某个目标,等它推理完,目标可能已移动、机会已消失、安全局面已变危险。已有基准缺少专门测量场景理解能否转化为及时行动的设置,也没有在原生 MOBA 中以英雄级、多要求联合任务作为评估单元的工作,导致实时控制与深度推理之间的矛盾长期未被量化。
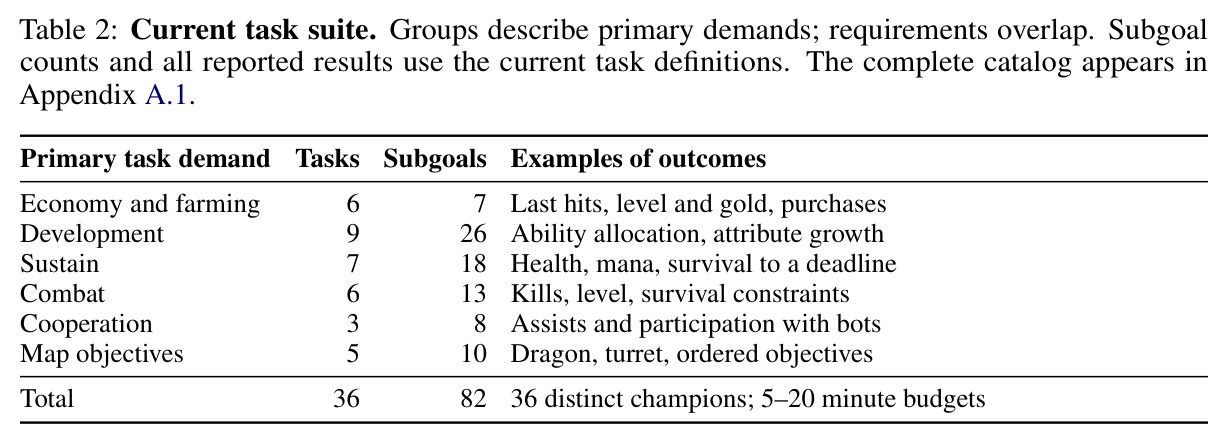
本文的目标是作者要构建一个环境全程不停的原生英雄联盟基准 LOLPlay,系统评测实时视觉智能体。具体包括三点:其一,设计36个英雄专属任务,覆盖经济发育、属性成长、生存续航、战斗、人机协作和地图目标六类需求,预算5到20分钟,配82个可执行子目标检查,使完全成功与部分进展都能被量化;其二,用 LCU API 自动初始化对局、用 Live Client Data API 的状态快照与带时间戳事件做独立验证,智能体自报的 DONE 不算数;其三,在3个模型(GPT-6 Astra、GPT-6.1 Sol、DeepSeek-v4.1-Flash)× 3档推理努力共9种配置上完成324次任务评测,把任务表现与推理配置、执行预算、观察-动作错位联系起来,回答今天的视觉智能体能否把场景理解转化为及时行动。
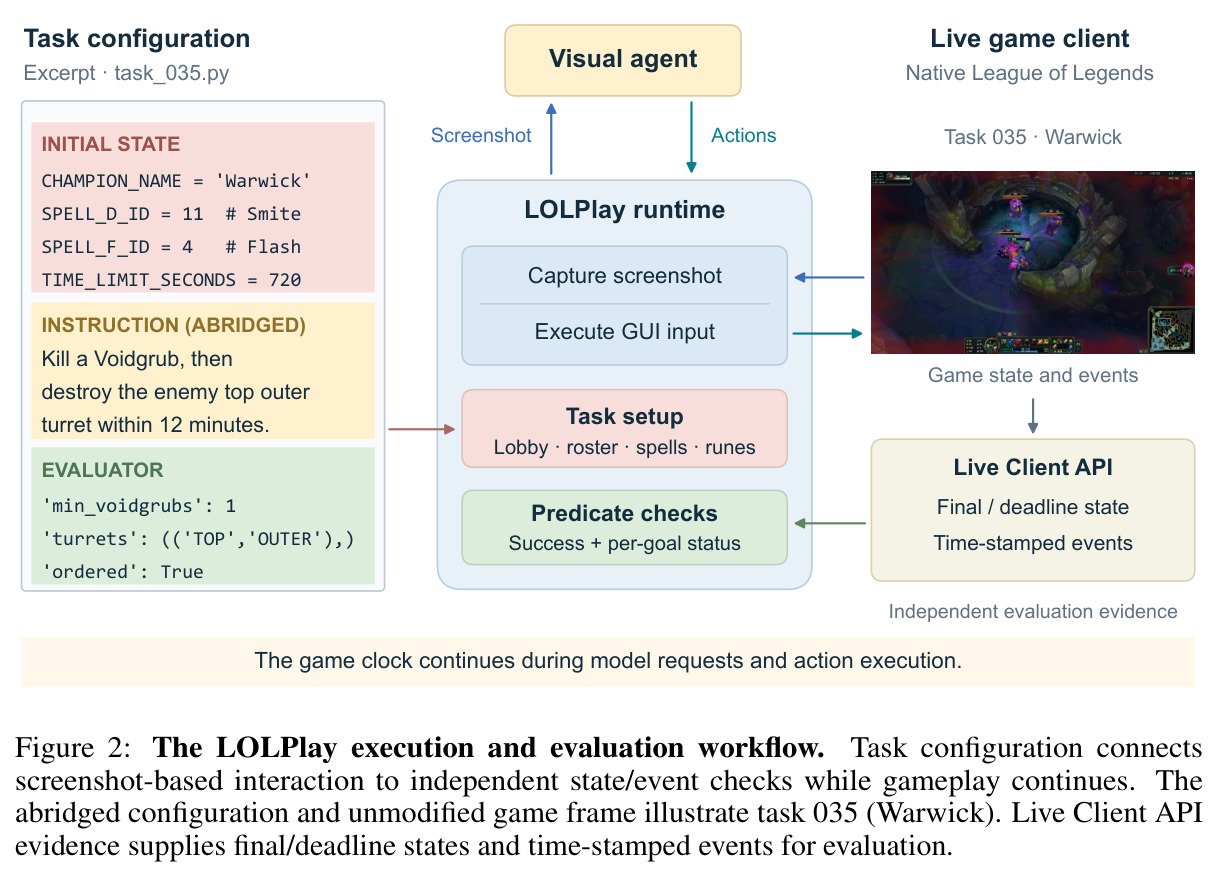
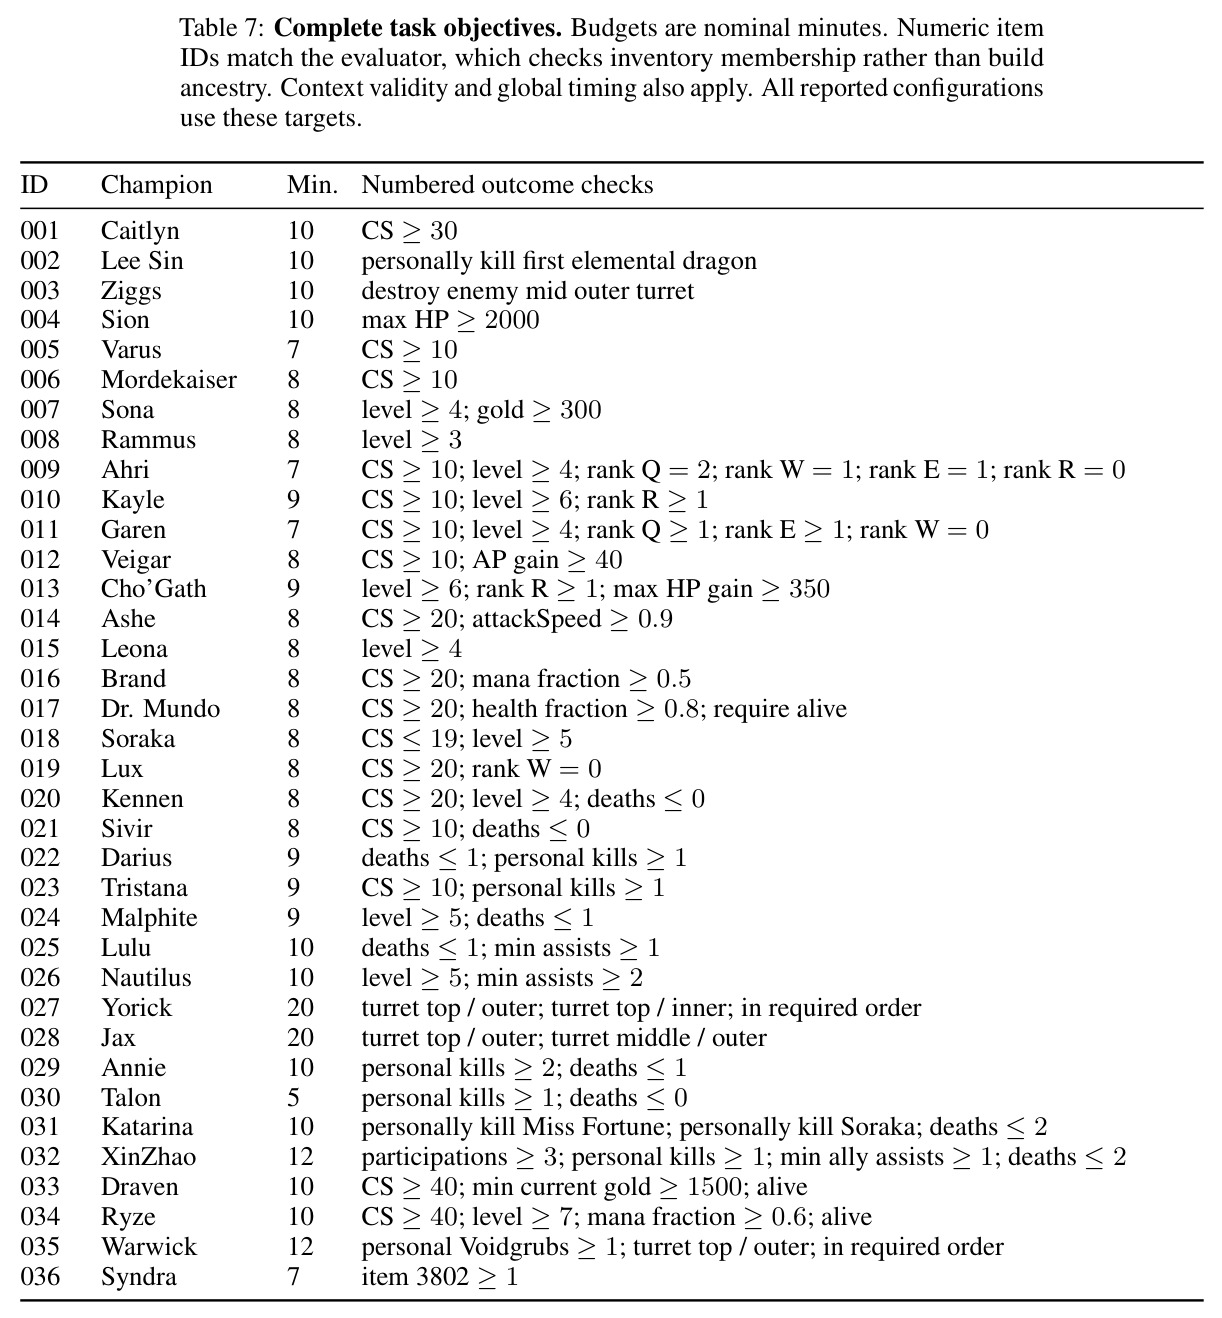
与已有工作不同的是,切入点在于评估单元的重新设计。此前实时游戏基准要么以整局游戏进度里程碑为检查点(VideoGameBench),要么以序列化状态判断成败(GameWorld),都无法回答智能体是否完成了用户指定的多要求目标。LOLPlay 独特地组合了三点:一是把任务定义在具体英雄上,如 Cho'Gath 九分钟内升6级、学大招并增加至少350点最大生命,让资源获取、战斗、生存和目标顺序约束同时生效;二是游戏全程不暂停,观察-动作延迟成为任务内生部分而非外部干扰;三是评估证据来自游戏官方 API 的状态与事件,包括击杀归属、事件时间与先后顺序(Warwick 任务要求先杀虚空幼虫再推塔),而非屏幕像素或模型自述。作者还明确划清界限:LOLPlay 评测通用截图+键鼠智能体,分数不代表与 AlphaStar 等专训智能体的竞技实力。
核心方法
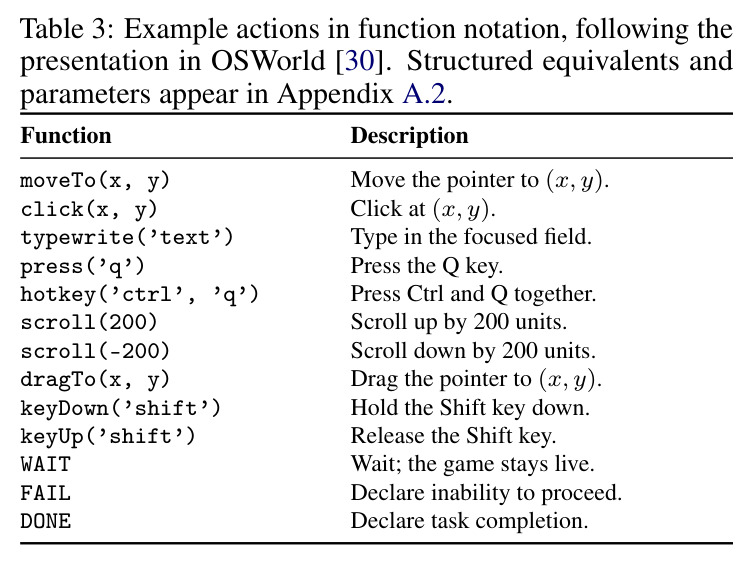
LOLPlay 把任务形式化为五元组 $\tau_i = (I_i, C_i, B_i, G_i, E_i)$:指令 $I_i$、初始配置 $C_i$、时间预算 $B_i$、子目标集 $G_i = \{g_{i1}, \dots, g_{im_i}\}$、评估器 $E_i$。套件共36个任务(每英雄一个)、82个子目标。直观理解:智能体像人类玩家一样打一局 LOL,但目标是结构化检查清单。技术路线分三段:初始化用 LCU API 自动完成建房、加机器人、选英雄、配符文与施法设置,验证初始条件后才计时;交互循环中智能体每个决策步接收截图 $o_k$、指令与历史 $h_k$,输出动作 $a_k \sim \pi(\cdot \mid I_i, h_k, o_k)$,可以是 moveTo/click/press/hotkey/DONE 等函数调用,期间游戏时钟不停,每个 episode 限时 $B_i$ 且最多100次模型响应;评估用 LCD API 读取最终状态、截止快照或事件流逐项核验,任务成功要求全部可执行要求(含时序与顺序检查)同时满足。3个模型×3档推理共324次运行、17221次响应构成实验主体。
核心创新是不停盘与可执行细粒度评估的组合。与 OSWorld 等计算机使用基准的本质区别在于:推理与执行期间环境持续演化,基于旧截图的动作可能落空,延迟本身成为被测能力。与已有实时游戏基准的本质区别在于评估证据:LOLPlay 不看游戏进度里程碑,而是用 LCD API 的状态快照和带时间戳事件构造82个可执行子目标检查,例如 Ahri 任务要求 $\text{CS} \ge 10$、等级 $\ge 4$ 且技能等级恰为 (2,1,1,0),Warwick 任务要求个人虚空幼虫击杀时间早于敌方外塔摧毁时间且都在720秒内。这使得部分进展可量化——284次失败运行中有108次(38.0%)满足了部分子目标。另外,任务可行性由两名各200+场经验的人类玩家用同一评估器验证,36/36全部完成(100%),保证低分是模型能力问题而非任务不可达。
方法步骤详情
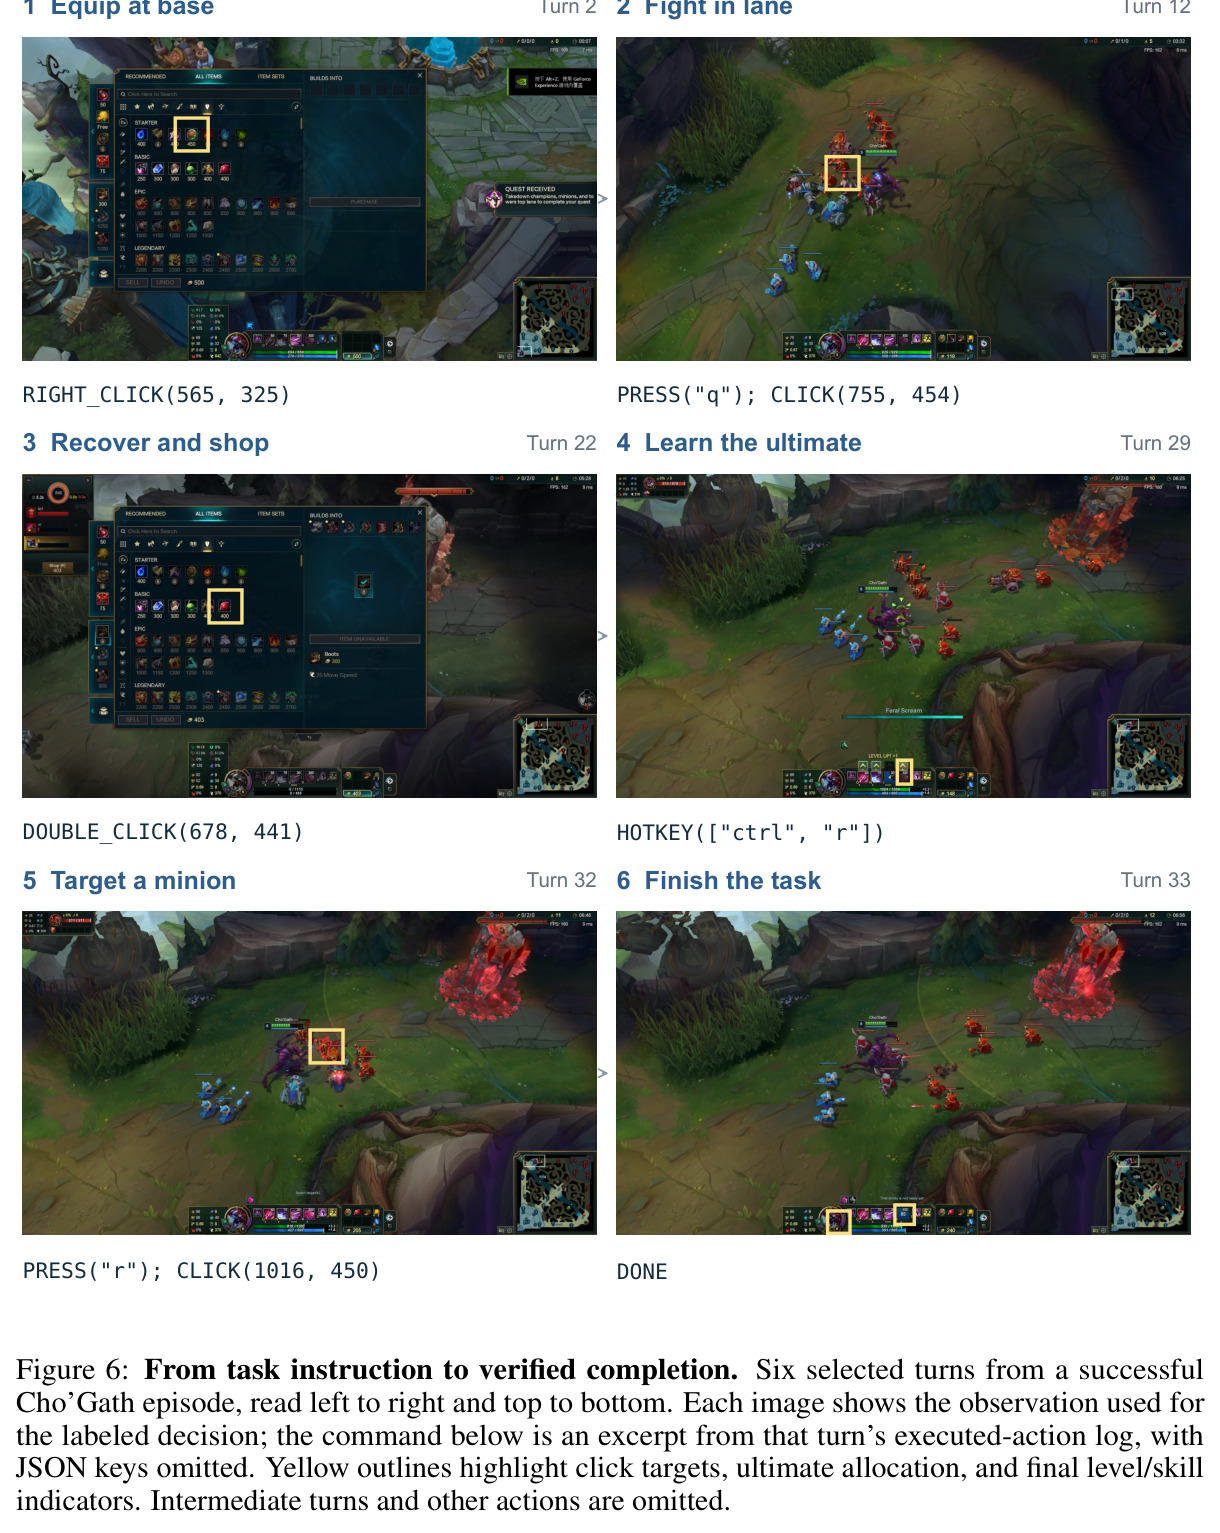
流程分四步。第一步自动初始化:LCU API 连接本地客户端,创建召唤师峡谷经典自定义对局(map 11),按配置插入敌我机器人(10个任务含敌方 bot、3个含友方 bot,新手难度),锁定英雄、配置召唤师技能与符文页、把 QWER 设为常规施法,轮询游戏阶段直至 InProgress,再经 LCD API 校验英雄、阵容、地图与初始条件(等级、库存、死亡数、未学技能)并保留属性基线,之后才记录任务开始,准备时间不计入预算。第二步交互循环:智能体收到截图与指令后返回一至多个动作(如 PRESS('q')、CLICK(755,454)、HOTKEY(['ctrl','r'])、DONE、FAIL),运行器在每次请求与每个动作前检查时间预算 $B_i$ 与100次响应上限,进行中的请求不被强断。第三步证据采集:对局内持续记录状态快照与时间戳事件。第四步评估:每任务有专属评估函数,如 Brand 用 deadline_state(480) 检查 CS≥20 且法力≥50%,Syndra 检查库存含物品3802,Darius 统计个人击杀并核验死亡≤1,全部通过才记任务成功,同时逐项输出子目标结果。
技术新颖性
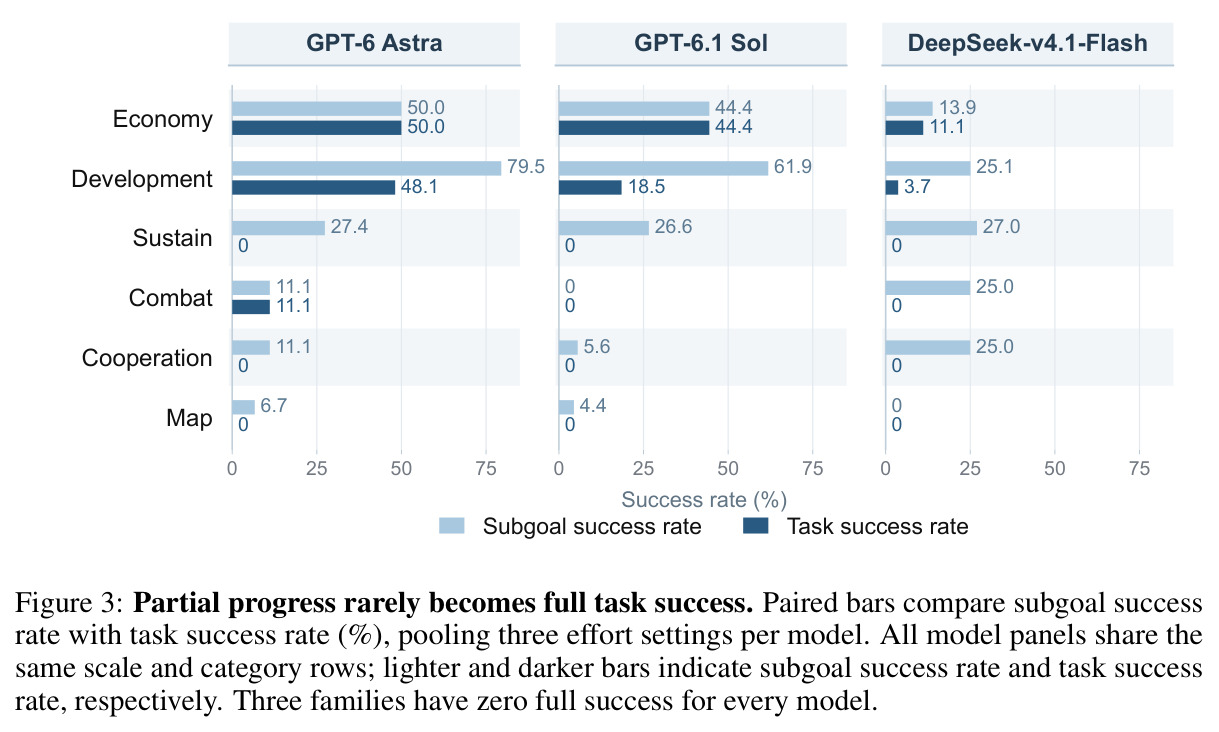
技术新颖性体现在四个层面。一是环境层面:原生 LOL 客户端不暂停、不加速、不简化,与 Cradle 等截图驱动控制商业游戏的工作相比提供了系统化任务目录与可执行评估;与 SC2LE 的迷你游戏相比,它是完整对局中的英雄级目标。二是评估层面:状态+参与者+事件顺序的联合检查此前没有先例,如 Lulu 任务要求玩家名字出现在友方击杀的助攻列表且死亡≤1,Warwick 任务校验事件先后顺序,这把到达某个状态与完成一段事件序列区分开。三是诊断层面:任务成功与82个子目标的双层指标能定位失败模式——本文据此发现所有模型能完成技能等级检查(25/36)和等级阈值(52/108),却0/45通过个人击杀、0/27通过友方助攻。四是研究层面:首次把推理努力档位、请求延迟、响应轮次与实时任务成功率放在同一框架下分析,揭示更长推理在实时控制中可能有害这一此前未被量化的现象。
实验结果
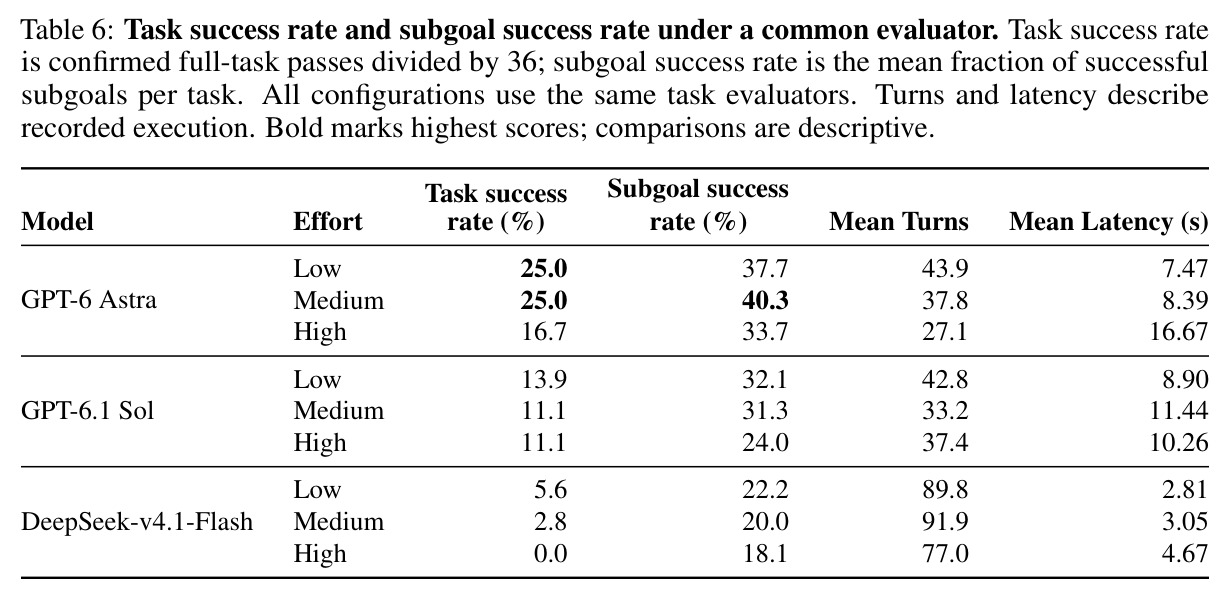
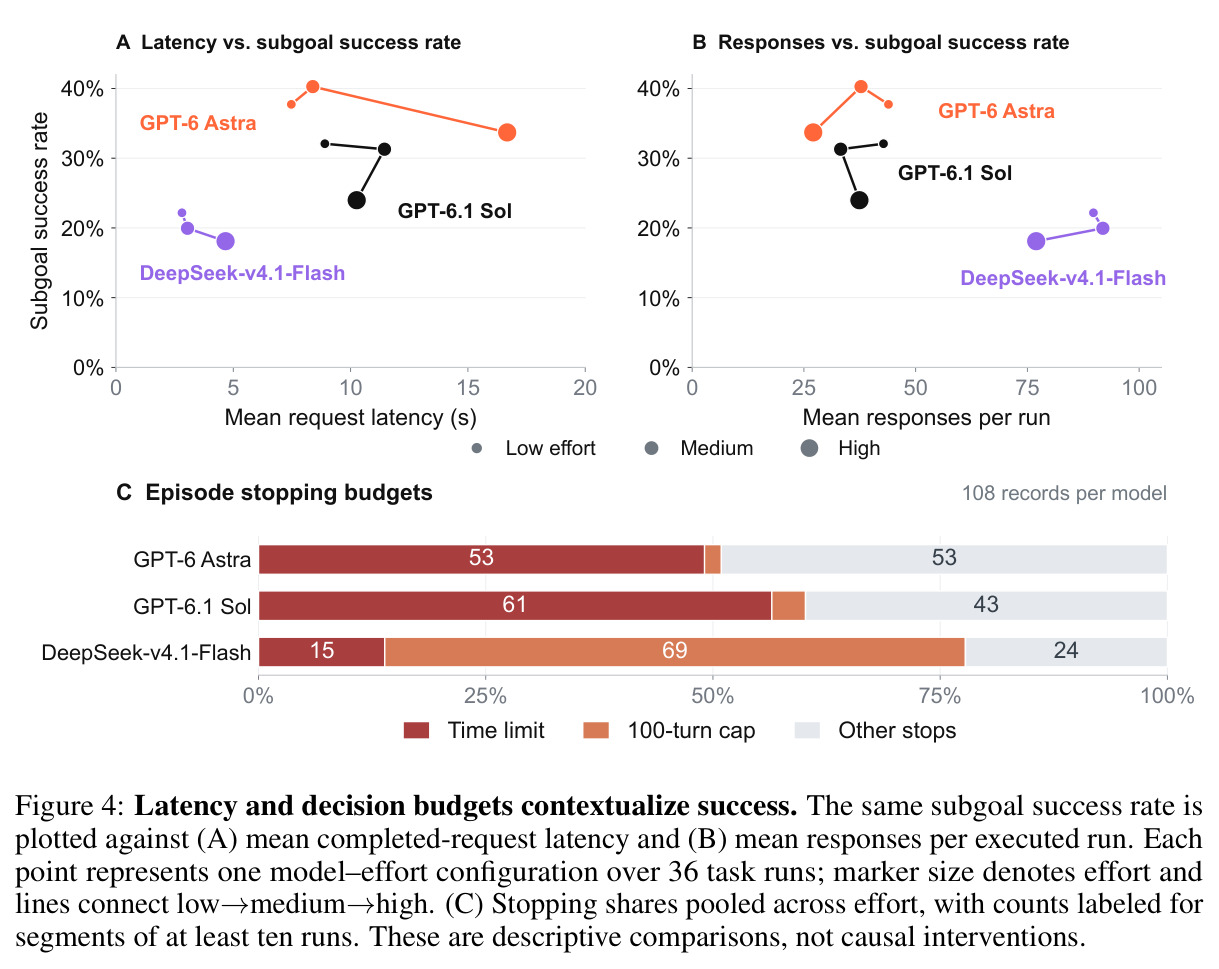
324次评测(3模型×3档推理×36任务,17221次响应)给出多层结果。整体上仅40/324次运行(12.3%)完全成功,覆盖12个不同任务;284次失败中108次(38.0%)达成部分子目标,说明部分进展并不必然转化为完成任务。分模型看,GPT-6 Astra 在低、中档并列最高任务成功率25.0%(各9/36),中档子目标成功率40.3%为全场最高;GPT-6.1 Sol 三档为13.9%/11.1%/11.1%;DeepSeek-v4.1-Flash 为5.6%/2.8%/0.0%。分任务族看,经济与发育各贡献19次通过,战斗仅2次(Malphite 升5级且死亡≤1),生存、协作、地图目标三族零通过。细粒度检查显示:技能等级检查25/36、等级阈值52/108通过,但 CS 检查仅10/144、必需物品4/9、个人击杀0/45、友方助攻0/27。推理努力方面,高档对任何模型都无收益:Astra 高档任务成功率跌至16.7%,延迟从7.47秒(低档)升至16.67秒,每局响应从43.9轮降至27.1轮。DeepSeek 低档延迟仅2.81秒、89.8轮响应却只有5.6%成功率,证明速度本身不决定表现。案例研究给出机制线索:Warwick 任务中一次请求耗时144.641秒,期间幼虫已于09:19.65被杀、英雄09:31.74死亡,点击(810,465)落地时已变成泉水 AFK 对话框;成功的 Cho'Gath 任务则用33次响应、2次死亡、420.8秒完成三项检查(生命+795.3)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 36英雄任务套件(9种模型×档位配置全量评测) | 任务成功率 (%) | GPT-6 Astra 低/中档 25.0%(9/36),高档 16.7% | GPT-6.1 Sol 最高 13.9%;DeepSeek-v4.1-Flash 最高 5.6% | 比最强基线高 11.1 个百分点;全部配置总体通过率仅 12.3%(40/324) |
| 82个子目标检查(任务平均通过率) | 子目标成功率 (%) | GPT-6 Astra 中档 40.3%(低档 37.7%、高档 33.7%) | GPT-6.1 Sol 低档 32.1%;DeepSeek-v4.1-Flash 低档 22.2% | 比最强基线高约 8 个百分点 |
| 36个任务的人类可行性验证 | 任务完成率 (%) | 最强模型 25.0% | 两名 200+ 场经验玩家 100%(36/36) | 人类远超模型,验证任务可达且模型差距巨大 |
| 战斗类硬检查(个人击杀/友方助攻) | 通过检查数 | 0/45 个人击杀、0/27 友方助攻(全部324次运行合计) | — | 无任何模型通过任何一次击杀/助攻检查,暴露实时战斗控制的整体缺失 |
局限与改进
作者承认的局限:36个任务每英雄仅一个目标,远不能覆盖 MOBA 玩法全貌;部分要求可被动满足(挂机也能保持不死),子目标成功率必须与任务成功率一起解读,Malphite 那次100次响应含101次右键、等级却停在1的案例说明频繁交互可能只是消耗预算;人类验证只证明任务可达,不代表人口级人类水平;设定是自定义对局+新手 bot,分数不代表与 AlphaStar、OpenAI Five 等专训竞技智能体的实力比较;桌面输入与不受限 Python 需要可信环境,存在被滥用于游戏自动化的风险。我自己的观察:其一,每配置仅36个任务,9/36与5/36这类差异没有置信区间或显著性检验,模型排序的统计功效有限;其二,观察频率与截屏时机由运行器固定,智能体不能主动请求新观察或中断自己的长推理,陈旧观察问题部分源于接口设计而非纯模型缺陷;其三,未跑暂停版消融,无法量化实时性本身造成多大损失;其四,评估依赖 LCD API 的可用性与事件语义,客户端更新可能影响评估稳定性。
独立分析的弱点
独立分析可见几个弱点。第一,接口不允许主动感知:智能体只能在固定节奏收到截图,Figure 7 的失败(144.6秒请求后点击落在 AFK 对话框)暴露的是决策所用的观察在执行时已失效,改进方向是允许模型推理中途请求刷新截图、或检测到高延迟后主动重新观察再行动。第二,响应批内动作不加校验:一次响应可含多个动作,批量执行期间游戏已前进约10秒,改进方向是逐动作前做低成本状态核对或限制批大小。第三,缺少延迟因果干预:作者自己也声明努力档位不是统一的延迟操纵(Sol 延迟非单调:8.90/11.44/10.26秒),因此长推理有害仍是相关性证据,改进方向是人为注入受控延迟做消融实验。第四,任务量与统计功效:36任务上2.8个百分点差异(如 Sol 中档 vs 高档)很难说稳定,改进方向是每任务多次重复运行并报告方差与置信区间。第五,子目标信号有噪声:避免型子目标(不死、不学技能)的通过不能证明会打,改进方向是区分进取型与保持型子目标并加权计分,Malphite 案例中生存检查通过而升级失败正是这种失真。
未来方向
作者指出的方向是开发推理在变化世界中保持有用的智能体,把视觉推理与及时行动协调起来。在此基础可延伸:一是架构层面做快慢分层——慢思考模块负责规划与商店决策,快反应模块(小型策略或规则)负责走位与战斗时机,类似 Overcooked 上分层语言智能体的思路;二是感知层面研究主动重观察与推理中断机制,把何时更新观察变成可学习的决策;三是评测层面补充暂停对照与受控延迟干预,量化实时性本身的代价,并把任务扩展到更多英雄目标、完整对局、更高难度 bot 与真实对局;四是训练层面,LOLPlay 的可执行评估器天然适合做 RL 奖励函数,可用于训练实时控制策略或对 VLM 做拒绝采样微调;五是模型层面测试更多计算机使用模型(如 Claude computer use、Gemini 系)并刻画速度-精度帕累托前沿,回答单位秒级延迟能买到多少子目标进展。
复现评估
复现条件中等偏上。开源情况:论文给出项目仓库 https://github.com/answers111/LOLPlay,任务配置以脚本形式提供(论文展示了 task_035.py 的 CHAMPION_NAME='Warwick'、SPELL_D_ID=11、TIME_LIMIT_SECONDS=720、INSTRUCTION、EVALUATOR 字段结构),附录 A.2/A.3/A.5 列出动作函数、LCU/LCD 操作清单与提示词、历史保留和生成参数,透明度较高。环境要求:Windows + 原版英雄联盟客户端(自定义对局、新手 bot)、本地 LCU 与 Live Client Data 服务、GUI 自动化输入与不受限 Python 的可信环境;游戏资产归 Riot Games,需遵守其条款。算力与成本:模型走 API 调用,完整实验为324次运行、17221次响应、单局5-20分钟预算,只复现部分配置(如一个模型低档36任务)成本可控。难度主要在游戏客户端自动化与环境稳定性(AFK 判定、客户端版本更新),对没有 LOL 自动化经验的团队有一定门槛,但评估器代码可直接复用。
论文图表
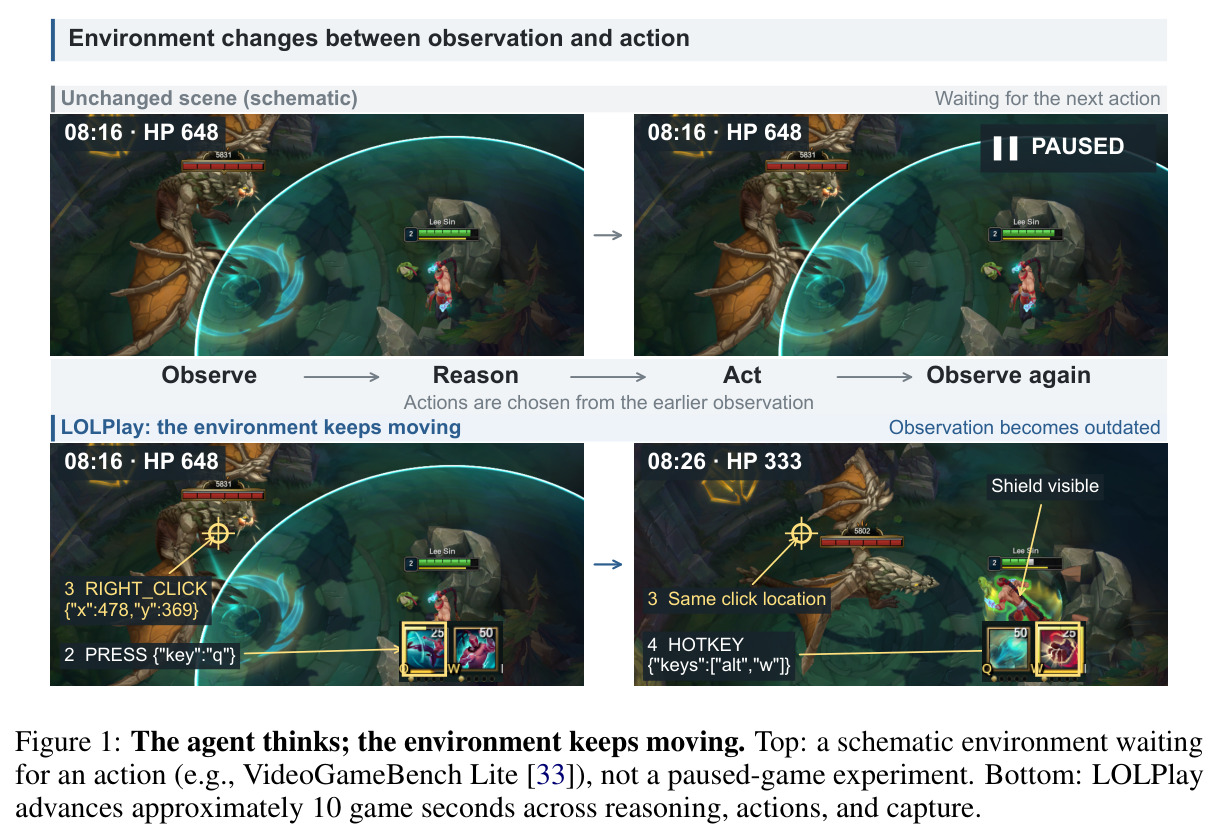
对比示意图:上半部分是等待动作的暂停式环境(如 VideoGameBench Lite)的时间线 Observe→Reason→Act→Observe again,场景保持 08:16·HP 648 不变;下半部分是 LOLPlay,推理、执行与截屏期间游戏推进约10秒,HP 从 648 掉到 333,同一点击坐标 (478,369) 执行时场景已变,还出现了护盾与按键提示。
一图点明论文核心命题:观察-动作延迟是实时任务的内生部分,是与暂停式基准的本质区别,是理解全文动机的钥匙。