TaoMate-FVSR:音频引导的人脸视频修复 TaoMate-FVSR:Audio-Guided Facial Video Restoration
用目标音频约束生成式人脸视频修复,同时支持原音频修复与换音频配音
前置知识
Flow Matching(流匹配)
一种生成模型训练范式:训练速度场网络直接回归从噪声分布到数据分布的直线路径上的速度 $v^\star = z_{source} - z_{target}$,推理时从起点出发用少量欧拉(Euler)步积分即可完成采样。相比扩散模型的多步去噪,轨迹更直、采样步数更少。本文用它训练 Wan 视频 DiT 做潜空间重建,推理仅需 10 步 Euler。
论文的重建公式、流损失 $\mathcal{L}_{MSE}$ 与「源-噪声混合」初始化全部建立在流匹配框架上,不懂它就无法理解 $z_\sigma$、$v^\star$ 与窗间「潜变量轨迹重放」的含义。
Source-Noise Mixing(源-噪声混合初始化)
把退化源视频的潜变量 $z_X = E(X)$ 与高斯噪声按强度 $\rho$ 线性混合 $z_s = (1-\rho)z_X + \rho\epsilon$ 作为采样起点。$\rho$ 越大,保留的源证据越少、生成自由度越大。本文训练取 $\rho \in [0.80, 0.95]$、推理固定 0.8:既保留身份、姿态、场景等可靠信息,又允许不可靠的嘴部结构被音频重新决定。
这是本文区别于「把退化图当复制目标」的修复方法与「从纯噪声出发」的配音方法(如 X-Dub)的关键机制,消融实验直接验证了它。
SyncNet 与唇音同步指标(Sync-C/Sync-D)
SyncNet 是源自 Wav2Lip 的双塔音视频网络,分别嵌入嘴部视频与音频谱来判断二者是否匹配。Sync-C 是同步置信度(越高越好),Sync-D 是同步距离(越低越好)。本文既用冻结 SyncNet 提供训练同步损失 $\mathcal{L}_{sync}$(权重 $\lambda_{sync} = 10^{-4}$),也用 SyncNet-v2 作为核心评测指标。
「恢复的嘴形必须跟音频走」是全文核心主张,理解 Sync-C/Sync-D 的语义才能正确解读表 1/2/3 中的同步列与消融结论。
HuBERT 语音特征
Meta 提出的自监督语音表征模型,能从原始波形中提取富含音素与发音动作信息的连续特征序列。本文冻结 HuBERT 提取目标音频特征,经一个可训练的音频投影层对齐到视频时间线后,作为视频 DiT 的音频条件注入。
音频如何进入视频 DiT 是本文方法的关键通路,答案就是「冻结 HuBERT + 可训练投影」,Stage 2 的唇形修正能力完全依赖这一条件。
因果视频 VAE(Causal Video VAE)
把视频压缩到潜空间的编码器-解码器,因果性保证每帧表征只依赖过去帧。本文冻结使用它编码源与目标视频;解码时让解码器在时间窗口之间保持内部状态(stateful decoding),从而在不做 RGB 交叉渐变或直方图匹配的情况下无缝拼接各窗口输出。
长视频按 72 帧载荷窗口重建后能无接缝拼回原始时长,靠的就是因果 VAE 的状态延续,这是理解第 3.3 节推理设计的前提。
研究动机
AIGC 视频生成模型能合成精细场景和协调的人物动作,但一张高分辨率帧不一定有一张高分辨率的脸:在中景和全身构图里,人脸只占画面很小比例,唇缘、单颗牙齿和口腔即使在被说服力很强的场景包围下仍然糊成一团,特写观看和重新构图时缺陷尤其突出。视觉超分(SeedVR2、FlashVSR、SparkVSR 等)可以锐化这些区域,但它们只以观测像素为依据做重建;而说话人的唇齿形态本质上由发音决定——唇闭合决定牙齿是否可见,张口度改变口腔边界和遮挡关系,模糊的小人脸区域里「嘴是闭着还是张开、露不露牙」在视觉上不可判定,锐化后完全可能得到牙列视觉合理却与所说语音矛盾的嘴。已有的音频辅助修复工作(极端尺度说话人脸放大、MDVD-Net、GAVN)都默认观测到的嘴部结构本身可信,只是分辨率低或压缩损伤;可当输入是 AIGC 生成的、口型可能与目标音频不一致的素材时,「忠实还原源嘴部」这一默认假设直接失效。
本文的目标是本文要构建一个目标音频直接参与重建过程的人脸视频修复框架,并用同一套重建接口统一支持两种模式:一是原音频修复,即恢复出的唇齿细节必须与视频自带语音的发音全程一致;二是换音频视觉配音(visual dubbing),替换音频后不再需要单独的嘴部编辑模型。量化目标是:在 150 段说话头基准(MEAD、HDTF、TalkVid 加内部数据,统一 4× 降质并回缩到 512×512)上,取得所有对比修复方法中最好的配对感知相似度(LPIPS/DISTS)与唇音同步分数(Sync-C/Sync-D);在 30 段换音频对比中全面超过「先超分再配音」的全部十条级联管线;同时把像素保真维持在可用水平(Ours 达 28.67 dB PSNR、0.8836 SSIM)。
与已有工作不同的是,本文抓住了三个被主流方法忽视的点。第一是重建初始化方式:图像修复范式把退化观测当必须复现的目标,配音范式(X-Dub)从纯高斯噪声出发、让退化源走稠密条件通道,本文改用源-噪声混合 $z_s = (1-\rho)z_X + \rho\epsilon$,让重建轨迹从部分保留的观测出发——源结构可用,但嘴部不必照抄。第二是参考帧的注入方式:参考帧自带特定姿态和口型,可能和当前动作冲突,直接当条件帧会让输出照抄参考嘴型,本文把独立编码的外观锚与序列编码的连续历史放进参考画布上互不重叠的时间槽。第三是训练监督:引入「降质配音源 + 目标音频」的跨发音样本——源和目标的口型不同,照抄输入嘴唇就必然失败——从而把「听音频改口型」的能力内化进修复模型本身,而不是留给下游第二个模型。
核心方法
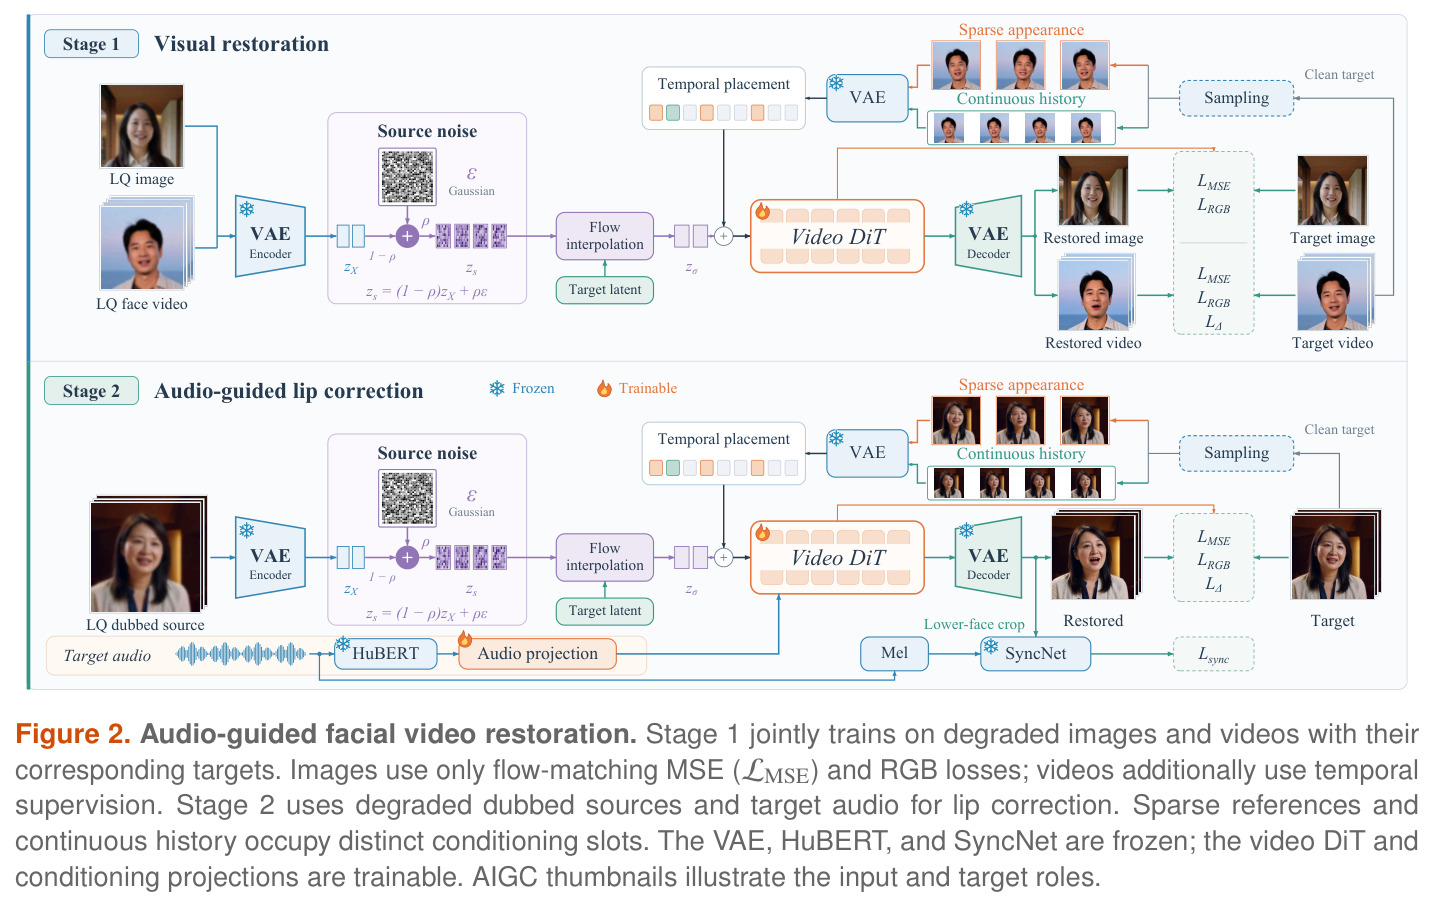
直觉上,修复一张说话的脸就像修复师拿着一张高清证件照、听着这个人说话,把模糊视频重画一遍:照片管长相质感,语音管嘴此刻怎么动,模糊像素只提供轮廓和场景约束。技术上,本文在基于 Wan 视频 DiT 的潜空间流匹配模型里重建:冻结因果 VAE $(E, D)$ 把图像/视频编进共享潜空间,重建从源-噪声混合点 $z_s = (1-\rho)z_X + \rho\epsilon$ 出发,流匹配训练 DiT 从 $z_\sigma = (1-\sigma)z_Y + \sigma z_s$ 预测 $v^\star = z_s - z_Y$。训练两阶段:Stage 1 用降质图像/视频与干净目标配对学视觉修复,$\mathcal{L}_{rec} = \mathcal{L}_{flow} + 0.1\mathcal{L}_{RGB} + 0.1\mathcal{L}_{\Delta} + 0.1\mathcal{L}_{LPIPS}$(嘴部流损失加倍);Stage 2 加入降质配音源与目标音频(HuBERT + 可训练投影),追加 $\lambda_{sync} = 10^{-4}$ 的 SyncNet 同步损失。推理按重叠时间窗重建,窗间靠「固定外观参考 + 最近四帧历史」与潜变量轨迹重放保持连续,最后由保状态的因果 VAE 解码拼回完整视频。
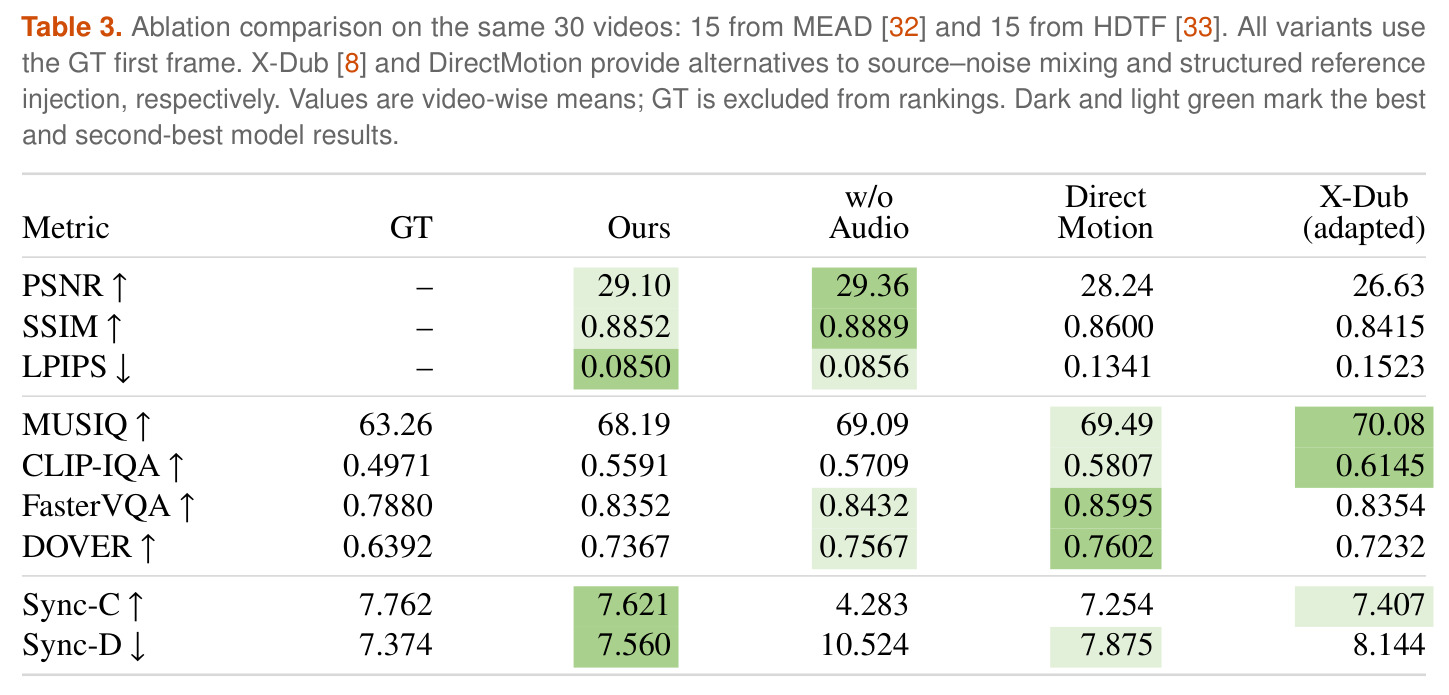
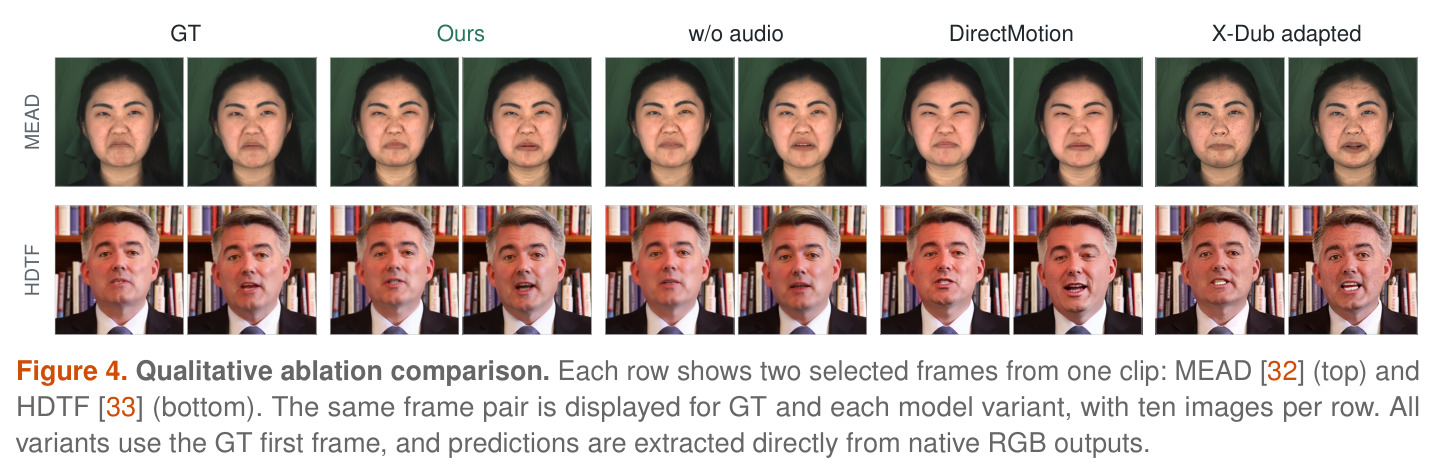
核心创新有三点,互为支撑。其一,源-噪声混合重建公式:不同于把退化图当复制目标的图像修复,也不同于从纯高斯噪声出发的 X-Dub 式配音,本文让轨迹从部分保留的观测出发——身份、姿态、场景这些可靠证据被保留,而嘴部这一不可靠或需改写的区域交给音频重新决定。消融给出直接证据:换成 X-Dub 适应版后 PSNR 从 29.10 掉到 26.63、LPIPS 从 0.0850 恶化到 0.1523,说明这条混合轨迹对「保外观的同时跟音频」至关重要。其二,结构化参考注入:独立编码的稀疏参考帧(外观锚)与序列编码的四帧历史(运动上下文)占据参考画布上互不重叠的时间槽,经共享投影叠加到 DiT 输入特征,参考全程可用但不会被当成必须复制的输出帧——DirectMotion 消融(后续窗口只继承生成历史)出现纹理过平滑和点状伪影,LPIPS 从 0.0850 涨到 0.1341。其三,跨发音监督:用口型与目标不同的配音源配目标音频训练,模型无法靠抄输入嘴唇得分,被迫学会跟随语音修正发音结构,这正是它能免掉独立配音模型的原因。
方法步骤详情
五步流程。(1) 编码:低质视频 $X$ 与目标 $Y$ 经冻结 VAE 编码为 $z_X$、$z_Y$,参考帧(GT 首帧)独立编码;77 帧训练窗对应 20 个时间潜变量。(2) 源-噪声混合:$z_s = (1-\rho)z_X + \rho\epsilon$(训练 $\rho \in [0.80, 0.95]$,推理 0.8),采样 $z_\sigma = (1-\sigma)z_Y + \sigma z_s$,监督 $v^\star = z_s - z_Y$。(3) 条件装配:稀疏参考帧独立编码入外观槽、四相邻帧序列编码入历史槽,未用位置置零,共享投影叠加到 DiT 输入;音频经冻结 HuBERT + 可训练投影对齐到时间线;dropout:外观 0.1、历史 0.4、音频 0.1。(4) 两阶段训练:Stage 1 图像仅 $\mathcal{L}_{flow} + 0.1\mathcal{L}_{RGB}$,视频加 $\mathcal{L}_{\Delta}$、$\mathcal{L}_{LPIPS}$,解码采四潜变量窗、前置预测 detach 作因果上下文;Stage 2 换配音源加目标音频,追加 SyncNet 损失($\lambda_{sync} = 10^{-4}$)。(5) 推理:每窗 5 条件帧 + 72 载荷帧、stride 56 留 16 帧重叠;后续窗条件 $P_k = (r, \hat{y}_{\tau-3}, \ldots, \hat{y}_{\tau})$,首窗用五份参考拷贝;重叠区按相同流时间重放前一窗潜变量轨迹,因果 VAE 解码器跨窗保持状态,丢弃条件前缀与重复重叠后拼回原时长,无 RGB 交叉渐变。
技术新颖性
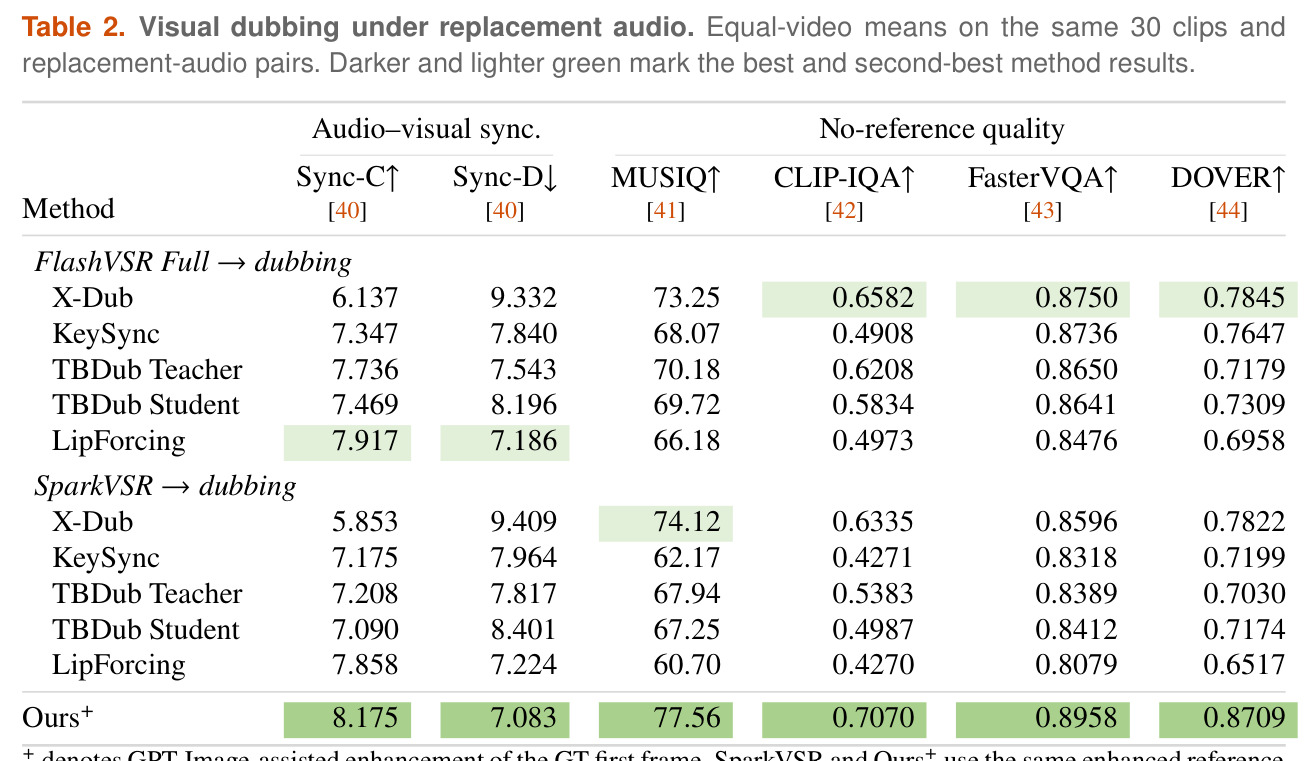
与已有工作的具体区别可按三条线梳理。相对 SeedVR2、FlashVSR、SparkVSR 等纯视觉视频超分:本文把目标语音作为一阶条件直接进入重建,并用跨发音样本监督口型修正,而不是仅靠参考帧做外观控制。相对 Wav2Lip、DINet、LatentSync、MuseTalk、X-Dub、KeySync、TBDub 等配音模型:它们假设输入人脸清晰可信、只做嘴部编辑,本文在低质 AIGC 输入上同时完成细节恢复与口型改写,把「超分 + 配音」两级级联合并为单次重建——表 2 中最强级联 FlashVSR Full→LipForcing 的 Sync-C 只有 7.917,仍低于 Ours+ 的 8.175。相对极端尺度说话人脸放大、MDVD-Net、GAVN 等音频辅助修复:它们依赖高分辨率身份图或编解码线索、默认源口型可信,本文明确针对「观测嘴部不可靠」的场景设计源-噪声混合与槽位化参考注入,并通过 w/o Audio(Sync-C 崩到 4.283)、DirectMotion、X-Dub adapted 三组消融定量验证每个组件的不可替代性。
实验结果
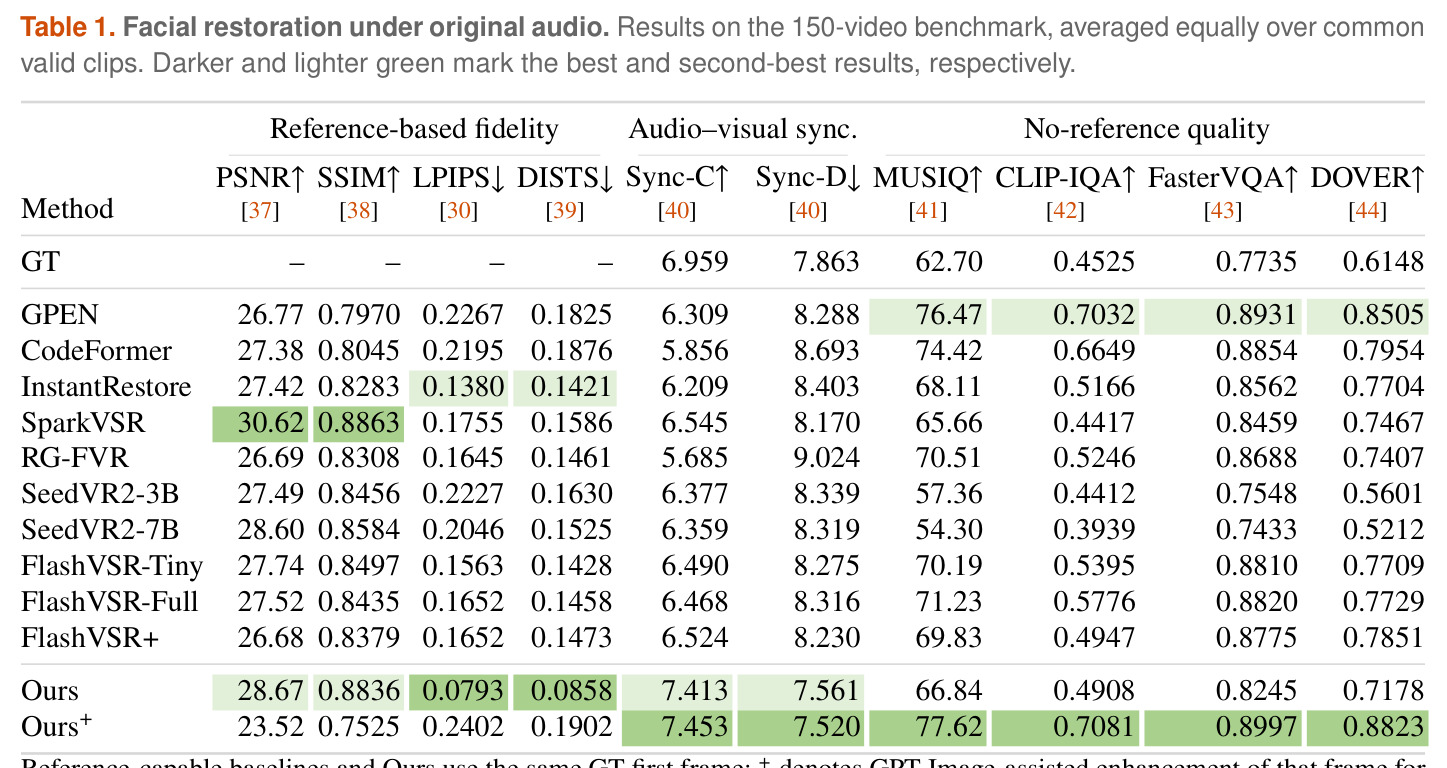
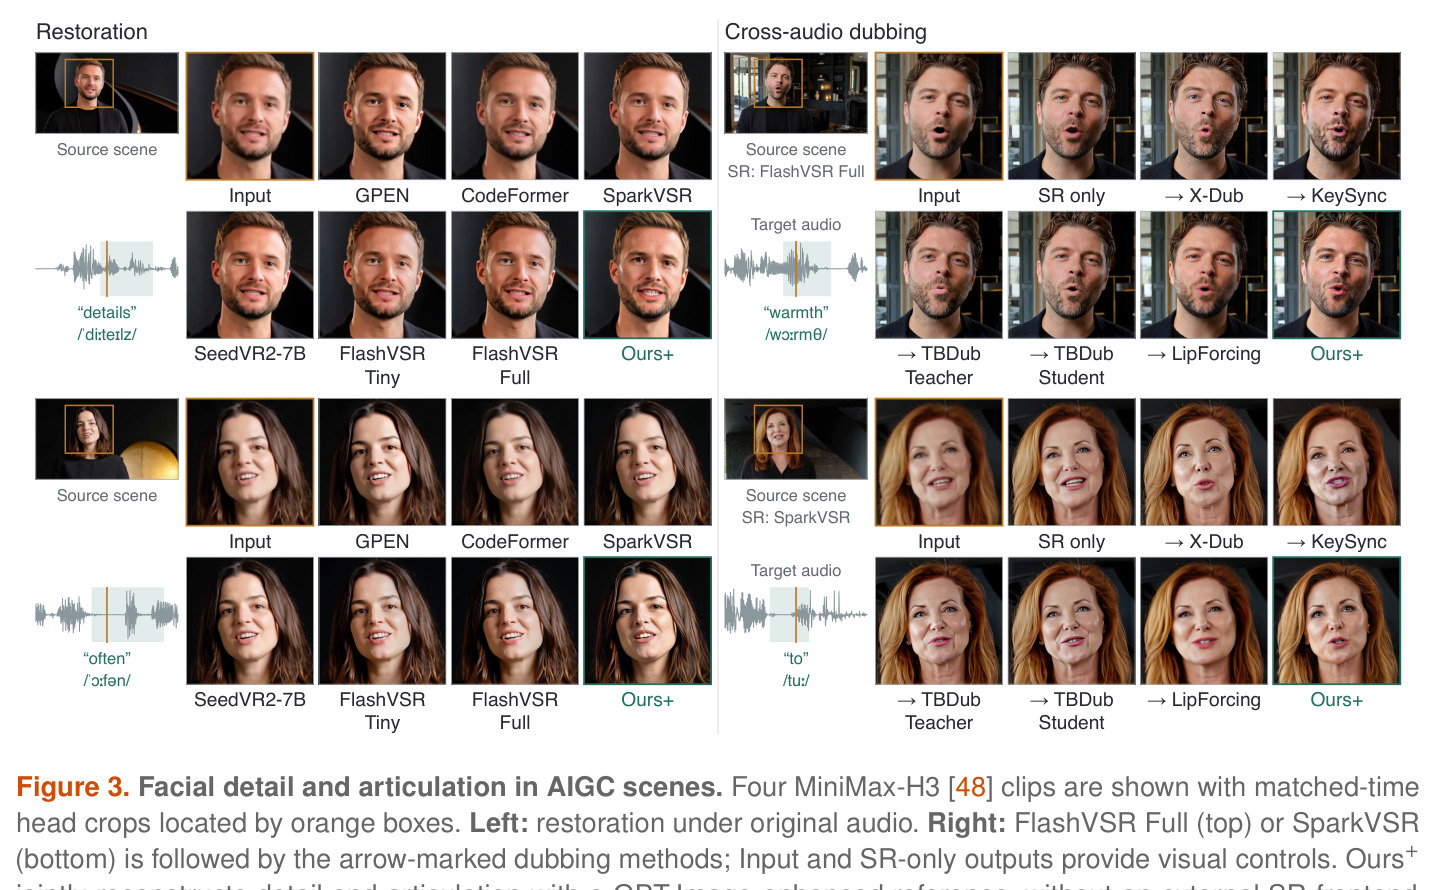
四组实验构成证据链。(1) 原音频修复(150 段,MEAD/HDTF/TalkVid/内部,4× 降质回缩 512×512,参考统一用 GT 首帧):Ours 取得修复方法中最低 LPIPS 0.0793 与 DISTS 0.0858(次优 InstantRestore 0.1380/0.1421),最好同步 Sync-C 7.413 / Sync-D 7.561(次优 SparkVSR 6.545/8.170);代价是 PSNR 28.67 比 SparkVSR 的 30.62 低 1.95 dB。Ours+(GPT-Image 增强参考)无参考质量四项第一:MUSIQ 77.62、CLIP-IQA 0.7081、FasterVQA 0.8997、DOVER 0.8823,但 PSNR 跌至 23.52、LPIPS 涨到 0.2402。(2) 换音频配音(30 段):Ours+ 六项指标全部领先十条级联——Sync-C 8.175 / Sync-D 7.083 超最强级联 FlashVSR Full→LipForcing(7.917/7.186)0.258/0.103,MUSIQ 77.56 超 SparkVSR→X-Dub 的 74.12 达 3.44,DOVER 0.8709 比 FlashVSR Full→X-Dub 的 0.7845 高 0.0864。(3) 原生 AIGC(四段 MiniMax-H3):Ours+ 能分清上排牙齿与唇-皮肤边界并恢复胡须纹理,级联 KeySync 会变形胡须与下巴。(4) 消融(30 段):去音频后 Sync-C 从 7.621 崩到 4.283、PSNR 反升 0.26 dB——音频约束口型而非像素;DirectMotion 使 LPIPS 0.0850→0.1341;X-Dub adapted 为 26.63 / 0.1523,均劣于 Ours 的 29.10 / 0.0850。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 原音频人脸视频修复(150 段) | LPIPS↓ | Ours 0.0793 | InstantRestore 0.1380(次优) | 降低约 43% |
| 原音频人脸视频修复(150 段) | Sync-C↑ / Sync-D↓ | Ours 7.413 / 7.561 | SparkVSR 6.545 / 8.170(修复方法次优) | Sync-C +0.868,Sync-D −0.609 |
| 原音频人脸视频修复(150 段) | PSNR↑ | Ours 28.67 | SparkVSR 30.62(最佳) | 低 1.95 dB(诚实披露的代价) |
| 无参考质量(150 段,Ours+ 增强参考) | MUSIQ↑ / DOVER↑ | Ours+ 77.62 / 0.8823 | GPEN 76.47 / 0.8505(四项均第二) | MUSIQ +1.15,DOVER +0.0318 |
| 换音频视觉配音(30 段 vs 十条级联) | Sync-C↑ / Sync-D↓ | Ours+ 8.175 / 7.083 | FlashVSR Full→LipForcing 7.917 / 7.186 | +0.258 / −0.103 |
| 换音频视觉配音(30 段) | MUSIQ↑ / DOVER↑ | Ours+ 77.56 / 0.8709 | SparkVSR→X-Dub 74.12 / FlashVSR Full→X-Dub 0.7845 | MUSIQ +3.44,DOVER +0.0864 |
| 消融:音频条件作用(30 段) | Sync-C↑ | Ours 7.621 | w/o Audio 4.283 | +3.338(而 PSNR 仅差 0.26 dB) |
| 消融:参考注入方式(30 段) | LPIPS↓ / PSNR↑ | Ours 0.0850 / 29.10 | DirectMotion 0.1341 / 28.24;X-Dub adapted 0.1523 / 26.63 | LPIPS 降低 37%~44% |
局限与改进
作者承认两点:重建出的面部细节是生成式估计而非真实外观的证据;音频驱动编辑可能助长冒充行为,应用须获得授权并明示内容已编辑。我的补充观察:(1) 基准偏小——修复 150 段、配音与消融各 30 段,且训练与评测都含内部数据集,跨分布泛化能力未知;(2) 原生 AIGC 场景只有定性结果,无 GT 时算不了配对指标,参考只能从输入首帧编辑而来,上限受首帧质量制约;(3) Ours+ 依赖 GPT-Image 这个外部黑盒来增强参考,整条管线的可控性与可复现性受第三方模型影响;(4) 增强参考的保真代价大(PSNR 从 28.67 跌到 23.52),何时该用增强参考缺乏自动判据;(5) 同步的训练监督与评测都基于 SyncNet 系模型,可能对 SyncNet 自身盲区(如某些闭嘴音素)系统性不敏感;(6) 论文未报告推理耗时与训练算力,底座是 Wan 视频 DiT 加 72 帧窗口重建,落地成本不透明。
独立分析的弱点
独立分析四个弱点。(1) 音频条件只约束与发音相关的下颌运动,眨眼、眉毛、情绪表情等非发音运动没有任何语义监督,长视频里只能靠历史槽软性延续,表情漂移风险随时长累积——改进方向:加入表情/头姿的轻量条件,或对 appearance 锚做周期性重锚定。(2) 参考槽只放稀疏静态帧,当视频出现参考帧未覆盖的大角度转头或新视角时外观锚会失效,论文未报告大姿态变化样本的表现——可扩展为多视角参考库,或从单参考帧做新视角外推后再注入。(3) 源-噪声混合强度 $\rho$ 是全局超参(推理固定 0.8),对所有退化程度一刀切:轻微退化时会不必要地破坏源信息,极重退化时又会保留过多伪影——可按退化程度估计自适应设定 $\rho$,或做逐帧置信度加权。(4) 训练把嘴部流损失权重加倍,但 RGB/LPIPS 全脸同权,若业务只关心口腔区,非嘴区的生成开销既浪费算力又引入不必要的纹理重绘——改进方向:区域可调损失加权,或 ROI 推理(只对口腔附近窗口跑 DiT、其余区域走轻量超分),同时大幅降低推理成本。
未来方向
作者方向:论文强调同一重建接口统一了修复与配音,暗示可延伸到更多 AIGC 后期任务(表情编辑、多语种配音);伦理上要求授权使用并明示编辑痕迹,暗示后续会配套内容溯源手段。基于成果可延伸的方向:(1) 把 GPT-Image 参考增强内化为模型自身的轻量编辑头或生成先验,形成端到端可训练管线,摆脱对外部黑盒的依赖;(2) 流式化——借鉴 FlashVSR 的流式思路,把 72 帧窗口与因果 VAE 状态机制改造成边生成边播的在线修复,服务直播与实时后期;(3) 从头部裁剪走向半身/全身场景,探索音频条件在人体与手部动作上的泛化边界;(4) 更细粒度的音频控制——音素级对齐或重音标注,实现对指定音素的牙列与口腔细节精确控制;(5) 评测层面,建立无 GT 的原生 AIGC 基准与感知-保真自动权衡曲线,弥补当前 30 段小样本消融的统计功效不足;(6) 把 $\rho$ 从固定超参变为可学习或输入自适应的变量,统一不同退化强度下的行为。
复现评估
复现难度较高。这是阿里巴巴的技术报告,未声明开源代码或权重(项目页 https://taoliveaigc.github.io/TaoMate-FVSR/ 仅展示样例);训练数据含内部说话头数据集,公开可得的只有 MEAD、HDTF、TalkVid;Stage 2 还需先用配音模型构造降质配音源。底座为 Wan 视频 DiT + 冻结因果 VAE + HuBERT + SyncNet,77 帧窗口训练对显存要求高,预计需多卡 A100/H100。利好是推理配置披露完整:seed 42、源噪声 0.8、10 步 Euler、shift 5、音频 guidance 4、参考 guidance 1.5、每窗 5+72 帧、stride 56、512×512 参考;但 $\rho$ 在 [0.80, 0.95] 内的采样策略、条件 dropout 实现细节与训练时长未说明。总体判断:核心思想(源-噪声混合 + 槽位化参考注入 + 跨发音监督)可在开源视频 DiT 上独立复刻并小规模验证,但要完全对齐论文指标需要大量算力与内部数据,短期内更现实的做法是复用其公式与消融结论。
论文图表
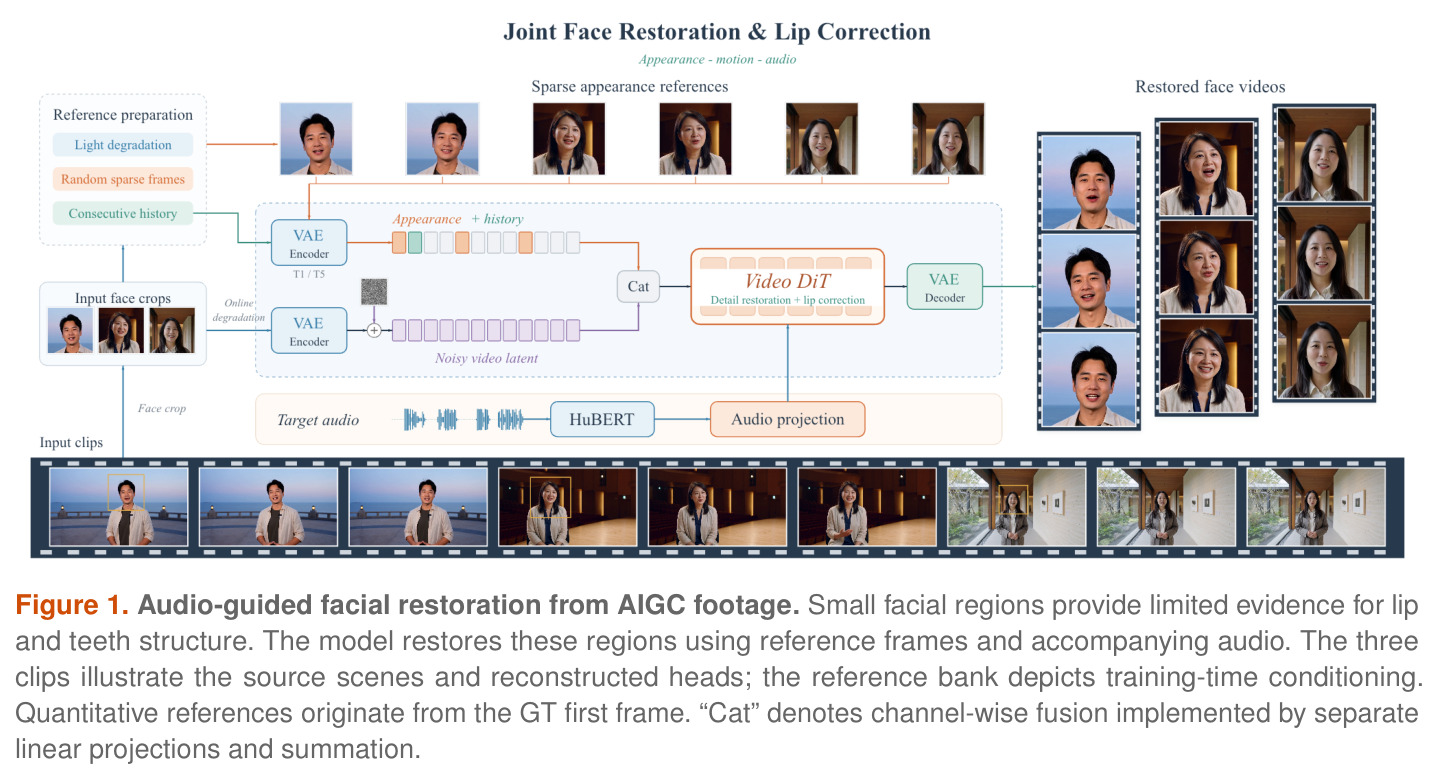
展示从 AIGC 场景级素材恢复小尺寸人脸的总体工作流:左侧是源场景(人脸只占画面很小比例),中间是恢复出的头部特写,右侧是训练时的参考库;口型由参考帧与伴随音频共同决定,「Cat」标注表示用独立线性投影与求和实现的通道级融合。三个剪辑对比源场景与重建头部。
一张图看懂任务定义:输入是什么、要恢复什么、音频和参考各自扮演什么角色,是读者进入方法细节前最重要的总览,也直观呈现了「小脸区域证据不足」这一核心困难。