从短片段到实时流:视频换脸的身份感知监督与上下文高效生成 From Short Clips to Real-Time Streams: Identity-Aware Supervision and Context-Efficient Generation for Video Face Swapping
首个参考引导流匹配实时流式视频换脸框架:单张4090上21 FPS稳定生成10分钟长视频
前置知识
Flow Matching(流匹配)
一种生成建模范式:学习一个速度场 $v_\theta$,把高斯噪声沿线性概率路径连续搬运到数据分布。潜变量按 $x_t=(1-\sigma_t)x_1+\sigma_t x_0$ 演化,$t=1$ 对应干净数据、$t=0$ 对应纯噪声,训练目标是 $\|v_\theta-v_t^\star\|^2$($v_t^\star=x_1-x_0$)。相比 DDPM 它路径更直、采样更少。
本文整个框架就是在 Wan 视频流匹配模型上微调的,而且论文的第一个核心发现就是流匹配重建损失对身份变化弱敏感,进而据此设计了噪声相关的 Rec-ID 损失,不懂流匹配就看不懂损失设计。
参考引导视频换脸与角色反转配对训练
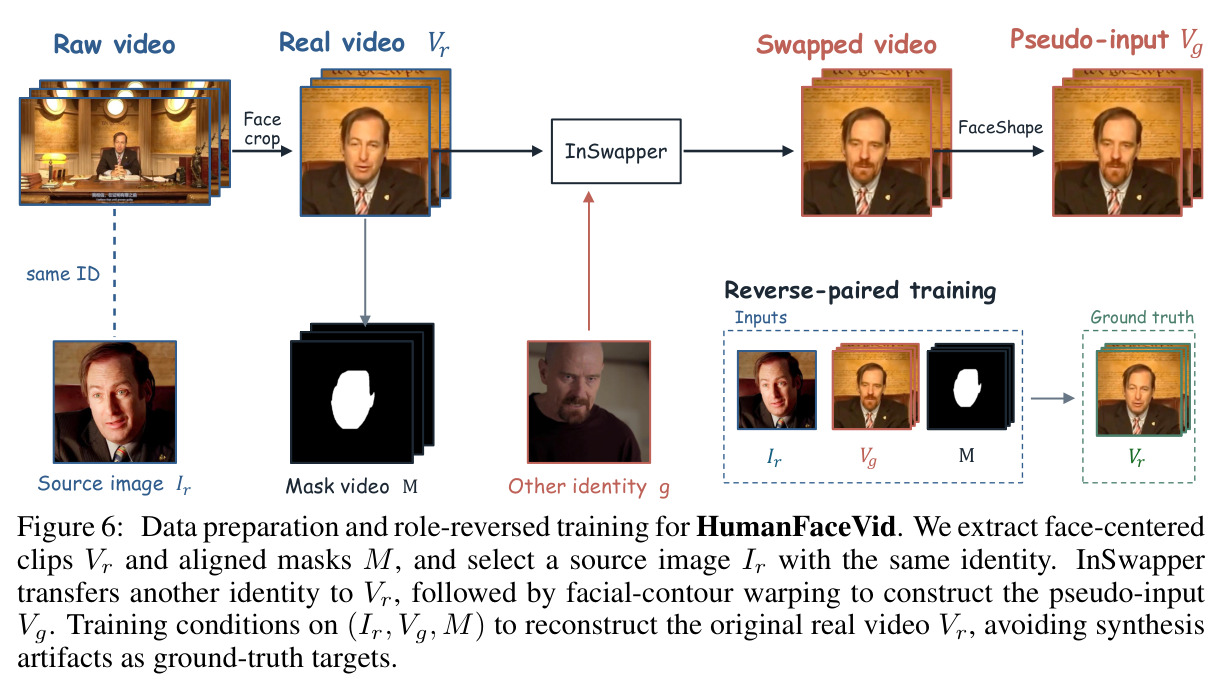
换脸要求把参考图身份迁移到目标视频,同时保留表情、姿态、光照、眼神和背景。由于真实成对的换脸视频无法获取,LivingSwap/DreamID-V 用预训练换脸管线(如 InSwapper)构造 $V_g=S(I_g,V_r)$,形成四元组 $(I_r,V_r,I_g,V_g)$:训练时以($I_r$, $V_g$, 掩码)为条件、以原始真实视频 $V_r$ 为真值,即角色反转,避免把合成伪影当监督目标。
StreamingSwap 的所有训练数据都来自这一构造,附录 B 的数据管线、HumanFaceVid 数据集以及伪配对带来的身份上限问题都源于此。
视频扩散 Transformer(Wan/DiT)与条件注入
把视频潜变量经 3D patch embedding 切成时空 token,交由 Transformer 做双向自注意力去噪。DreamID-V 基于 Wan Transformer:目标视频和掩码与噪声潜变量做通道拼接($H_{vid}=\mathrm{P_{3D}}(\mathrm{Concat}_h[x_t,x_v,x_m])$),源图像经 2D patch embedding 编成身份 token 与视频 token 做序列拼接。
Face-RoI Generation 正是在 token 层面做空间剪枝:理解 token 网格与拼接方式,才能明白为什么只保留人脸区域 token 就能省 78% 计算。
VAE 潜空间
冻结的视频 VAE 编码器 $E_\phi$ 把像素视频压缩到低维潜空间,扩散与去噪都在潜空间进行,最后用解码器还原。潜空间 MSE 与像素层面的语义差异并不同构:换脸这种语义大改、像素小变的编辑,在潜空间产生的误差可能非常小。
论文用潜空间 MSE 定量证明了流匹配对身份弱敏感;Face-RoI 的 token 选择、混合合成 $\|\tilde{x}_1=M_{blend}\odot \hat{x}_{1,roi}+(1-M_{blend})\odot x_g$ 都发生在潜空间。
自回归流式生成与 Self Forcing
双向注意力视频模型无法自然地流式生成,一种适配方式是自回归分块:每块以前面已生成的少量帧为历史条件,块内仍用双向注意力。但用真值历史训练、用自生成历史推理存在训练-推理错配,误差会跨块累积。Self Forcing 让模型训练时就消费自己的生成结果,并用随机梯度截断(随机选一个去噪步作为反传停止点)控制显存。
Phase II 的短上下文自展开训练就是 Self Forcing 思想换了个损失函数(不用分布匹配,改用身份+RoI 重建损失),这是实现 10 分钟稳定生成的关键。
ArcFace 与 FVD 评测指标
ArcFace 是加性角度间隔损失训练的人脸识别编码器,其嵌入余弦相似度(ID Sim)是换脸身份忠实度的标准度量;FVD(Fréchet Video Distance)在视频特征空间衡量生成分布与真实分布的距离,是视频质量的常用指标。此外姿态/表情/光照误差用 3D 重建系数距离度量,眼神用 3D 视线向量余弦相似度。
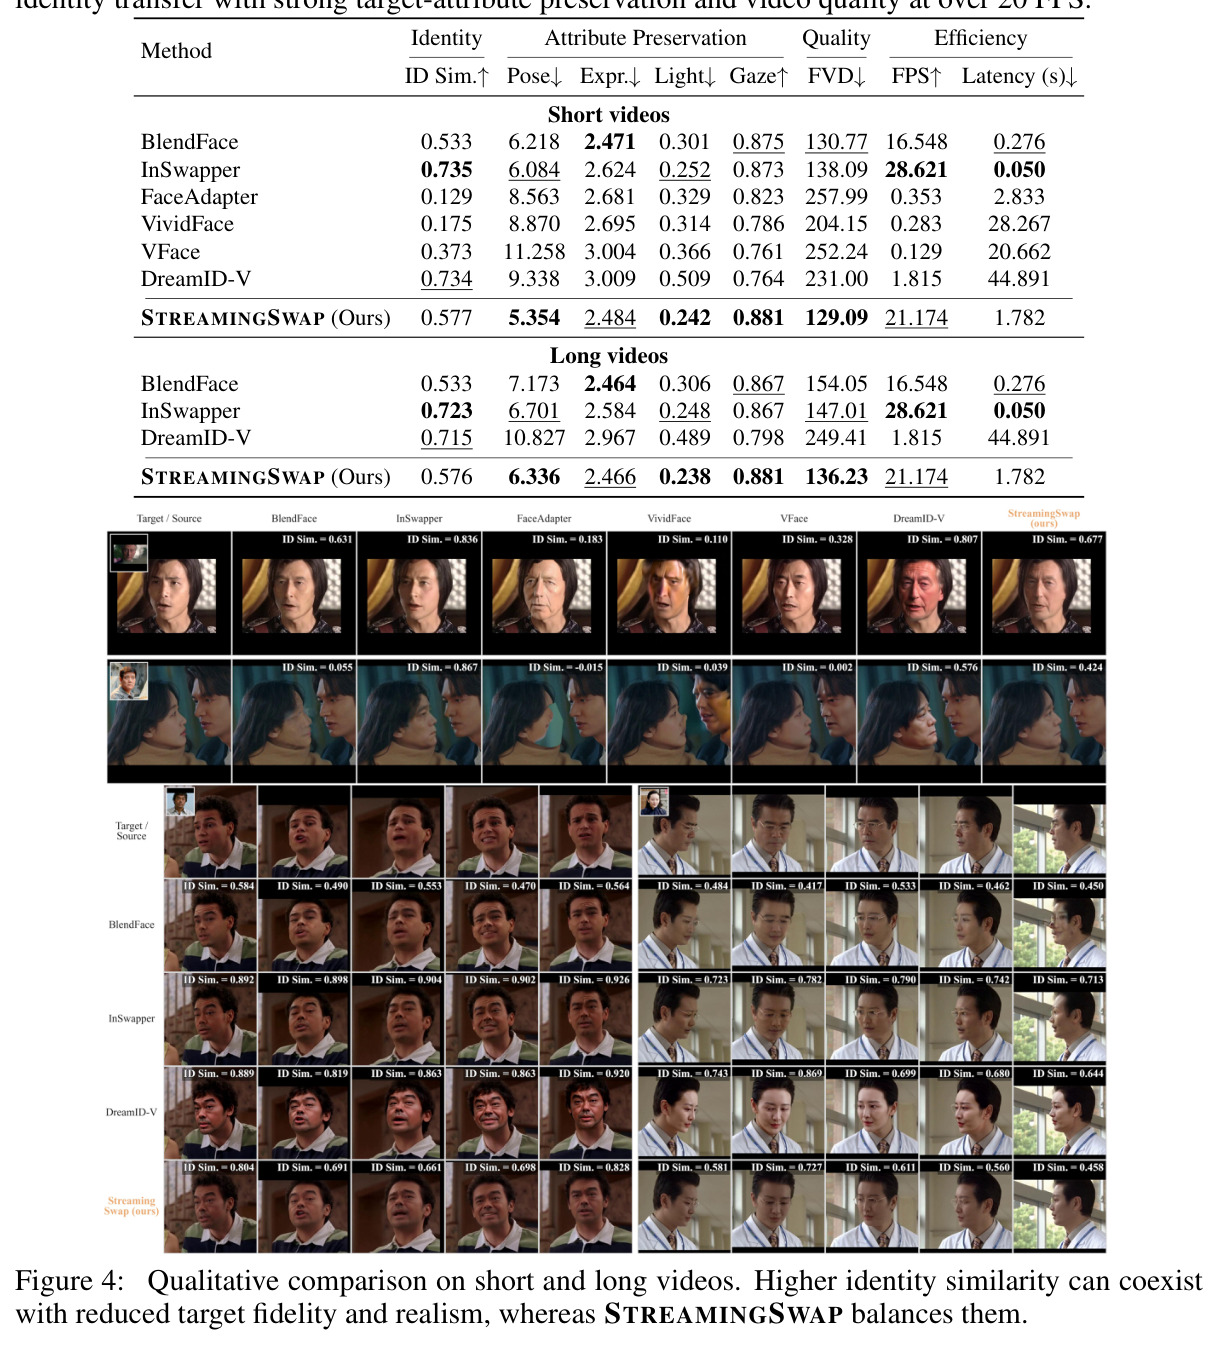
论文的 $\|\mathcal{L}_{id}$ 损失直接用 ArcFace 嵌入;Table 1 的全部对比(ID Sim 0.577 vs 0.735、FVD 129.09 vs 231.00)以及作者关于「嵌入相似度不等于感知身份」的论证都建立在这些指标上。
研究动机
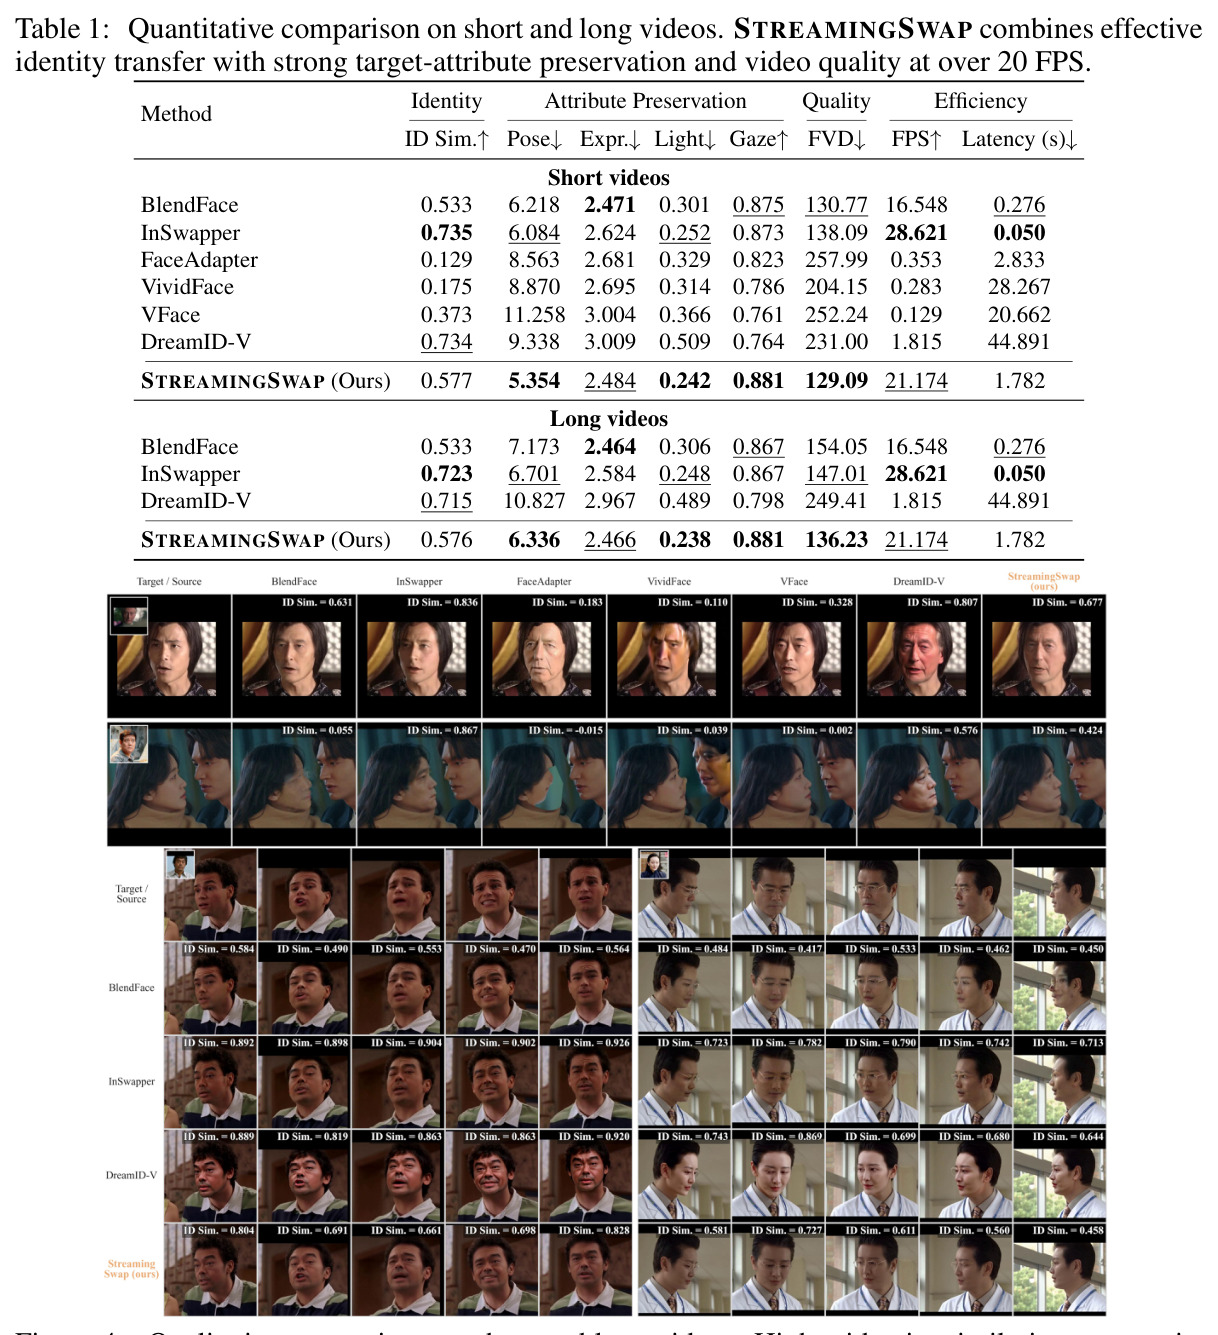
现有视频换脸方法分为三类,各有硬伤。GAN 类方法(SimSwap、BlendFace、InSwapper)逐帧独立处理,推理高效(InSwapper 在 4090 上可达 28.6 FPS、延迟 0.05s),但缺乏时序建模,容易产生视觉伪影和闪烁。扩散类修复方法(DynamicFace、VividFace、HiFiVFS)把目标脸遮住再从身份条件和辅助属性重建,虽能借用视频扩散先验,但遮罩切断了细粒度目标线索,表情、光照、妆容等非编辑属性难以忠实保留。最新的参考引导方法(LivingSwap、DreamID-V)把完整目标视频作为视觉条件,保真度最高,却有两个新问题:一是未遮罩的目标脸里既包含要保留的属性又包含要替换的身份,形成竞争性身份信号,源身份注入困难;二是它们从大规模视频扩散模型微调而来,需要对整帧、长时序上下文做迭代去噪,计算开销巨大——DreamID-V 在 RTX 4090 上只有 1.815 FPS、延迟 44.891 秒,处理一条短视频要近一分钟,完全无法实时,更谈不上长视频流式生成。
本文的目标是本文目标是让参考引导式视频换脸同时达到三个此前互相冲突的标准:忠实换上参考身份、高保真保留目标视频的表情/姿态/光照/眼神/背景等属性、以及在单张消费级 GPU(RTX 4090)上对长达数分钟的视频流做实时生成。论文给出了明确的量化验收线:端到端吞吐超过 20 FPS、延迟可控、生成 10 分钟长视频依然稳定不崩坏;身份与属性指标要能与 GAN 和扩散两条路线的强基线(InSwapper、BlendFace、DreamID-V 等)可比。为此作者还构建了 HumanFaceVid 数据集:基于 OpenHumanVid 整理出 1000 小时电影级训练数据,以及 200 条短视频与 200 条长视频两个评测集,覆盖身份忠实度、属性保留、画质与时序稳定性四个评测维度。
与已有工作不同的是,作者的独特切入点不是堆更大的模型,而是重新审视换脸任务区别于通用视频生成的两条结构性规律,并用对照实验定量验证。第一,换脸只改身份、保留绝大部分视觉内容,因此整帧潜空间流匹配损失对身份变化极不敏感:作者构造了身份相似度相差超过 0.75 的视频对,其人脸区域潜空间 MSE 变化不足 0.05,甚至轻度模糊产生的 MSE(约 0.15)都比可见身份变化更大——监督信号里身份只占极小份额。第二,目标视频本身已经提供了全部非编辑属性和时序动态,生成不需要重新发明这些信息:空间上把 token 保留比例从 100% 降到 39%、时间上只注意 6 个相邻潜帧,质量几乎不降,而计算量从 8900 TFLOPs 降到 2200 TFLOPs。基于这两条被量化证实的观察,作者提出首个参考引导流匹配的实时流式换脸框架 StreamingSwap:用显式身份监督补足弱信号,用人脸区域 token 与短上下文砍掉冗余计算。
核心方法
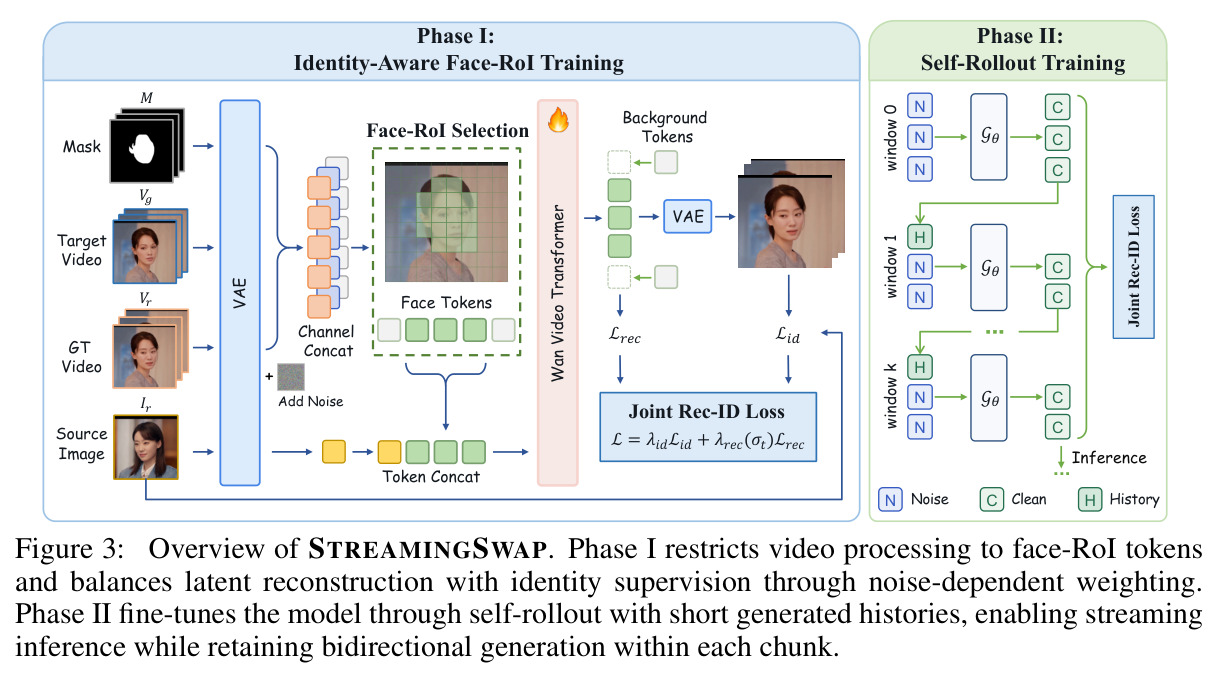
直觉上,作者把换脸从通用视频生成问题降维成两个被任务结构简化的子问题:监督信号往哪给(身份域小、重建损失钝感,需要显式身份监督并按噪声水平再平衡)、计算资源往哪花(目标视频即条件,背景与远期上下文可砍)。技术路线是三段式流水线:先按角色反转方式构造配对数据——用 InSwapper 把另一身份 g 换到真实视频 $V_r$ 上得到伪输入 $V_g$,训练时以(参考图 $I_r$、伪输入 $V_g$、掩码 $M$)为条件、以原真实视频 $V_r$ 为真值;然后 Phase I 在 DreamID-V 预训练权重基础上做身份感知的人脸区域训练,引入 Joint Rec-ID Loss 与 Face-RoI Generation;最后 Phase II 用短上下文自展开训练让双向模型适应流式推理。底层是流匹配框架:潜变量沿 $x_t=(1-\sigma_t)x_1+\sigma_t x_0$ 演化,模型预测速度 $v_\theta$,由其恢复干净潜变量估计 $\hat{x}_1=x_t+\sigma_t v_\theta$。每个阶段只训 1000 步(lr 1e-5、batch size 8、4 张 H100),推理端用 SageAttention、torch.compile 和 LightTAE 加速,在单张 4090 上达到 21.174 FPS。
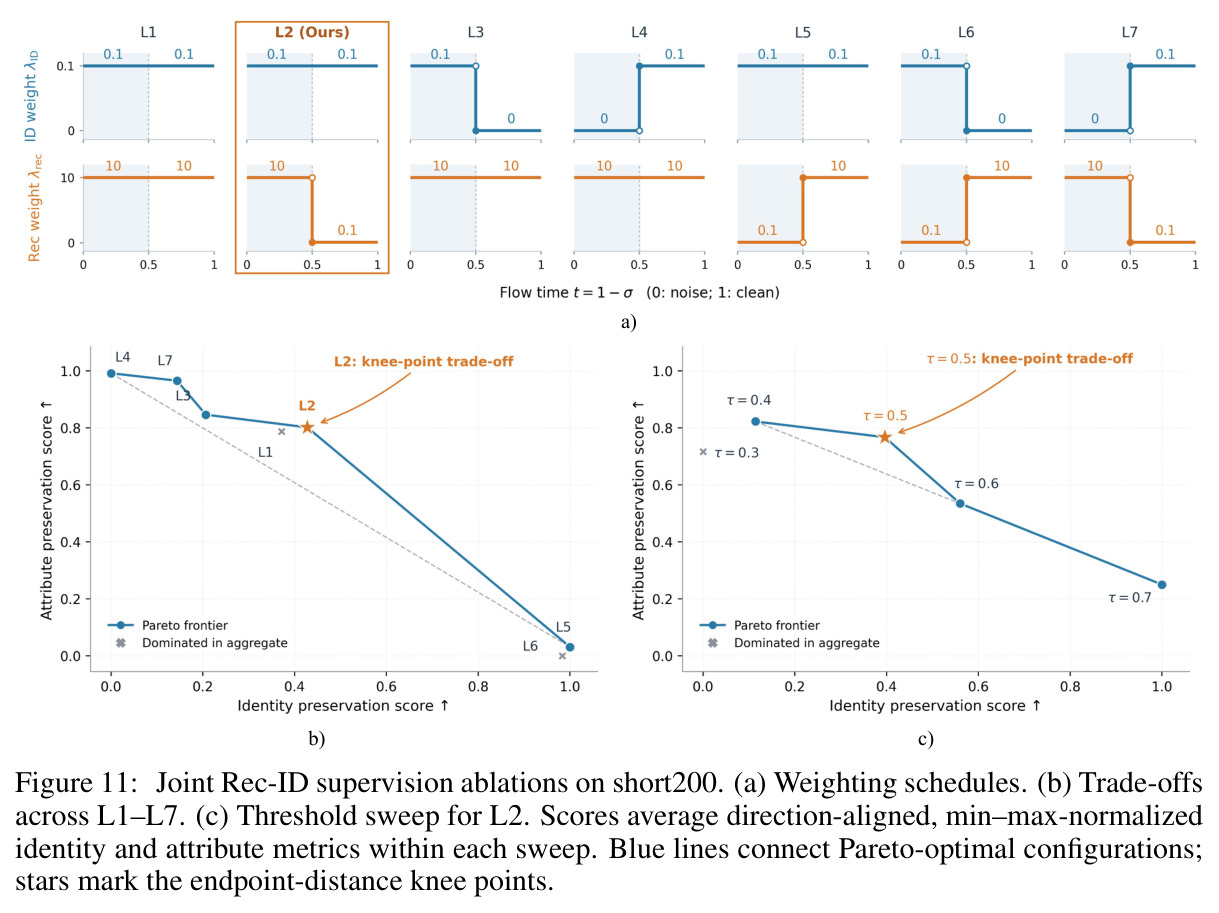
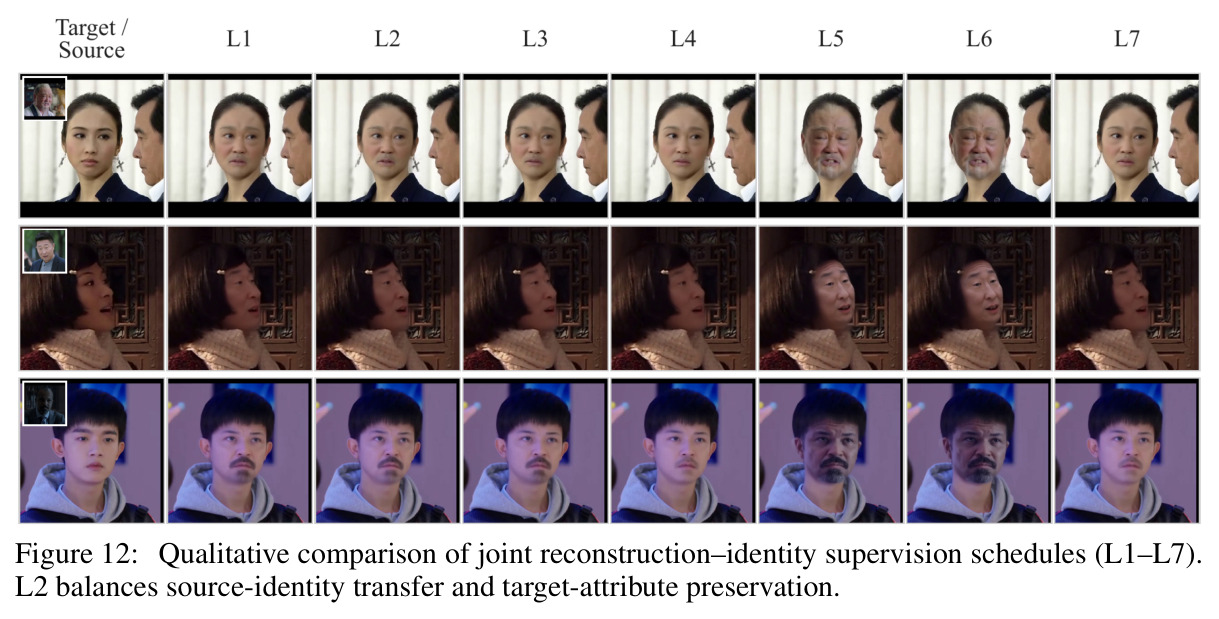
三个核心创新,每个都直接对应一条任务观察。第一,Joint Rec-ID Loss:既然流匹配对身份变化弱敏感,就显式加上 ArcFace 余弦身份损失 $\mathcal{L}_{id}$,并用噪声相关的权重调度平衡两种监督——$\mathcal{L}=\mathbb{E}[\lambda_{id}\mathcal{L}_{id}+\lambda_{rec}(\sigma_t)\mathcal{L}_{rec}]$,其中 $\lambda_{rec}(\sigma_t)$ 在高噪声段($\sigma_t>\tau$,$\tau=0.5$)取 $\lambda_{high}=10$ 引导干净潜变量整体恢复,低噪声段取 $\lambda_{low}=0.1$ 让身份监督主导细节精修,$\lambda_{id}=0.1$ 固定。这与以往把身份当静态辅助约束的做法本质不同:权重随噪声水平动态再平衡。第二,Face-RoI Generation:不再生成整帧,把 Transformer 输入限制在膨胀后人脸掩码覆盖的 token(约 39%),预测的 RoI 潜变量经羽化掩码 $M_{blend}$ 与目标视频潜变量混合回全图 $\tilde{x}_1=M_{blend}\odot\hat{x}_{1,roi}+(1-M_{blend})\odot x_g$。第三,短上下文自展开训练:受 Self Forcing 启发,训练时让模型用自己的 4 步去噪输出、以最新 $N_{ctx}=3$ 个潜帧为历史生成下一窗口,消除训练-推理错配,窗口内仍保留双向注意力。
方法步骤详情
步骤一,数据准备(附录 B):从 OpenHumanVid 检测追踪人脸、剔除不稳定轨迹,用 BiSeNet 人脸解析加 InsightFace 关键点凸包合成逐帧对齐的二值掩码 M;跨视频身份聚类选出同人图文对 $(I_r, V_r)$;用 InSwapper 把另一身份换入得到 $V_g=S(I_g,V_r)$,再做时序平滑的面部轮廓形变消除残余几何身份线索,得到角色反转四元组 $(I_r,V_r,I_g,V_g)$。步骤二,Phase I(身份感知 Face-RoI 训练):人脸掩码经 max pooling 下采样到潜网格并膨胀,选出与计算区域相交的 token 索引 $J_{roi}$,Transformer 输入为 $H_{roi}=\mathrm{Concat}_{seq}[H_{id},H_{vid}[J_{roi}]]$,token 保留原始时空位置编码;由预测速度恢复干净潜变量 $\hat{x}_{1,roi}$ 并散回全图,按羽化掩码 $M_{blend}$ 与目标视频潜变量混合;损失为 $\mathcal{L}=\mathbb{E}[\lambda_{id}\mathcal{L}_{id}+\lambda_{rec}(\sigma_t)\mathcal{L}_{rec}]$,其中 $\mathcal{L}_{id}=\frac{1}{|K|}\sum_{k\in K}(1-\cos[f_{id}(\hat{I}_k),f_{id}(I_r)])$ 只在解码的少量帧上计算以省显存,$\mathcal{L}_{rec}$ 为 RoI 潜变量 MSE。步骤三,Phase II(短上下文自展开):窗口 $n$ 取前步输出最新 $N_{ctx}=3$ 个潜帧为历史、生成 $N_{gen}=9$ 个新潜帧,历史全程固定于 $\sigma=0$;采用 4 步去噪调度与随机梯度截断(随机选一个去噪步作停止点,只回传该步干净潜变量预测的梯度),每次训练展开 5 个自回归窗口。步骤四,流式推理:逐窗口生成、羽化混合合成,配合 SageAttention、逐块 torch.compile 与 LightTAE 实现 21.174 FPS、延迟 1.782s。
技术新颖性
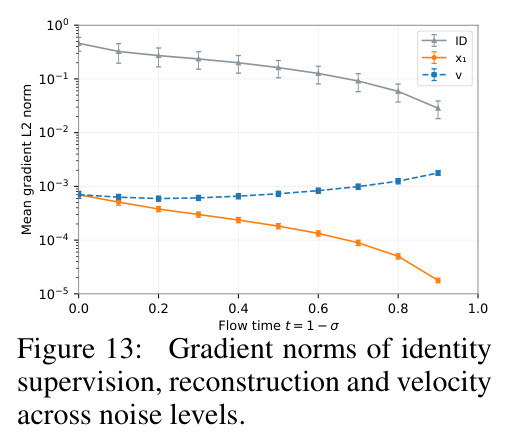
新颖性体现在四个层面。诊断层面:首次定量刻画流匹配监督对换脸身份变化的弱敏感性(身份相似度变化超 0.75 对应人脸区域潜 MSE 变化不足 0.05,Fig 2a),把「参考引导模型换不动身份」从经验感受变成可测量的事实,并据此设计噪声相关的双权重损失调度——经 L1-L7 消融与梯度范数分析(Fig 13)证明端点重建比速度重建与身份监督的梯度尺度更匹配。效率层面:Face-RoI 把「目标视频即条件」的冗余性转化为空间 token 剪枝,39% token 即可保住质量(Fig 2b),这在参考引导设定下是新的——修复式方法本来就遮脸但丢失线索,GAN 方法逐帧整图无先验。流式层面:不同于 LivingSwap 用关键帧编辑加时序拼接维持跨块身份,本文用固定短生成历史(3 潜帧)作为唯一跨窗口记忆,机制更简单;不同于 Self Forcing 的分布匹配目标,Phase II 直接复用 Phase I 的身份加 RoI 重建损失并保留噪声相关权重。整体上它是首个参考引导流匹配的实时流式换脸框架,21 FPS 与 10 分钟稳定性在扩散式换脸中前所未有。
实验结果
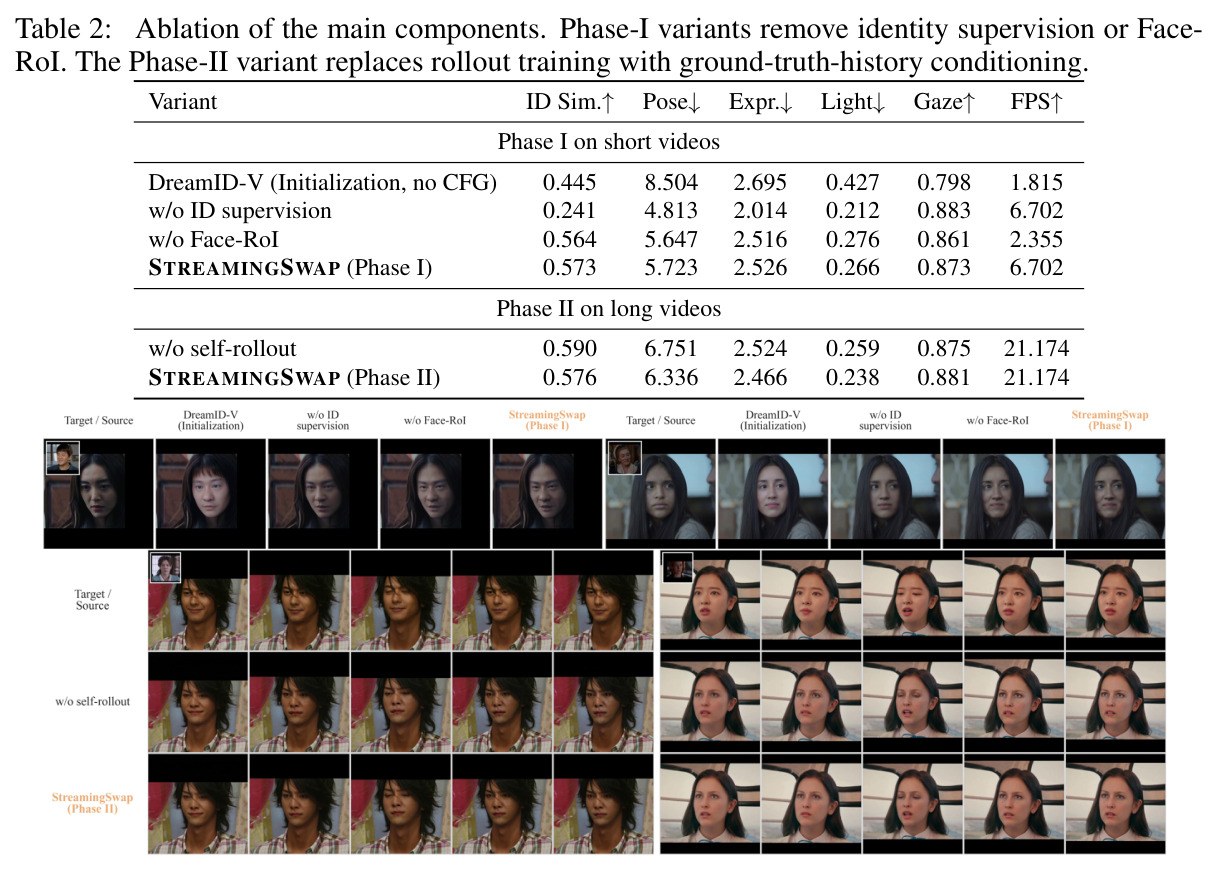
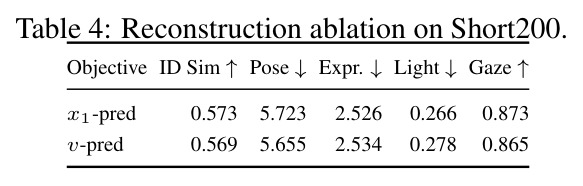
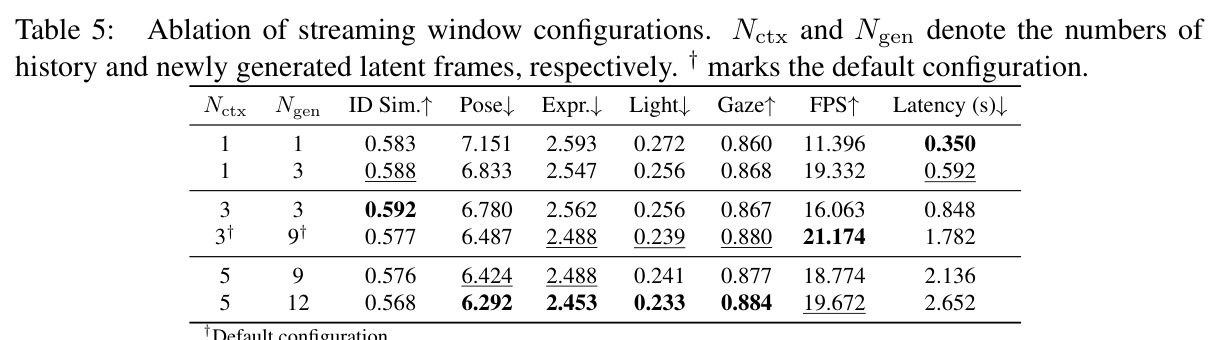
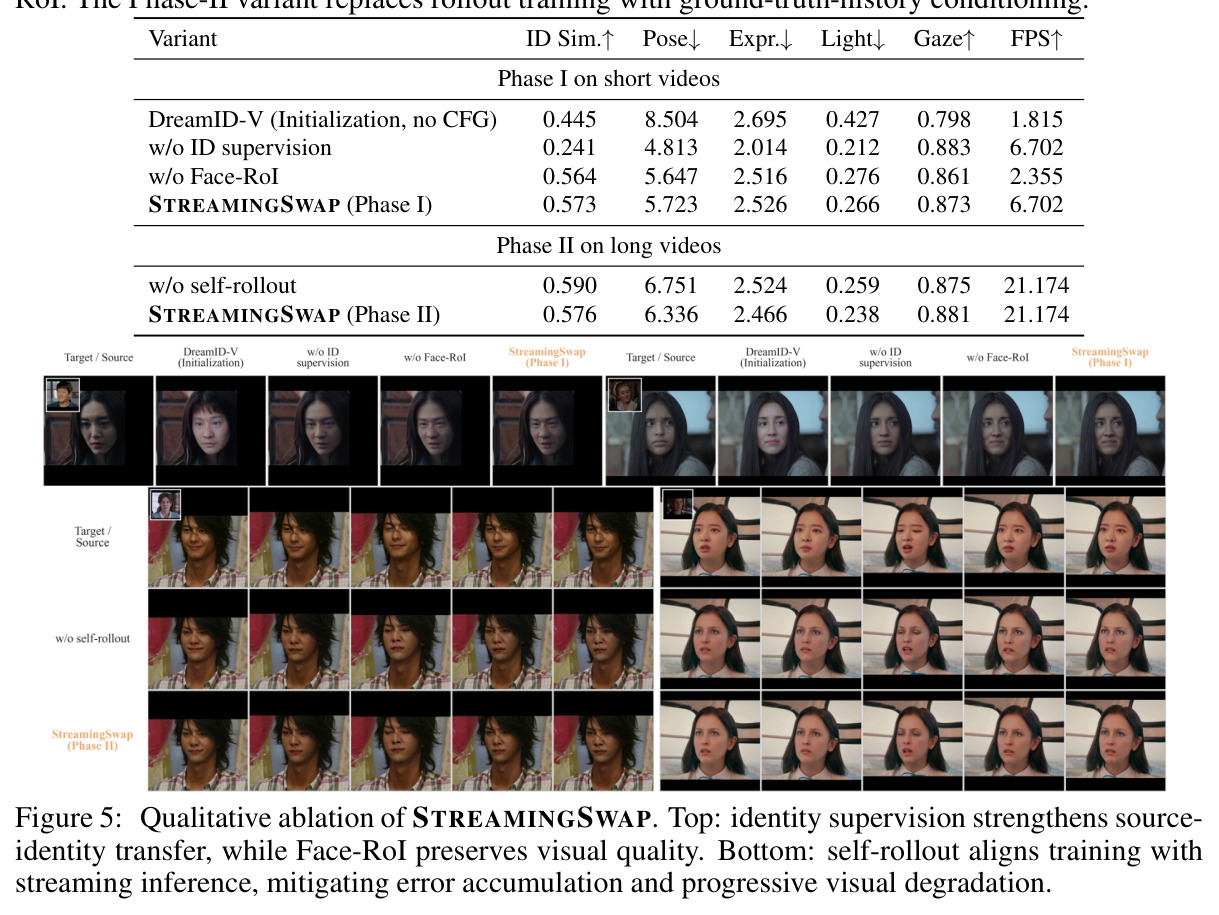
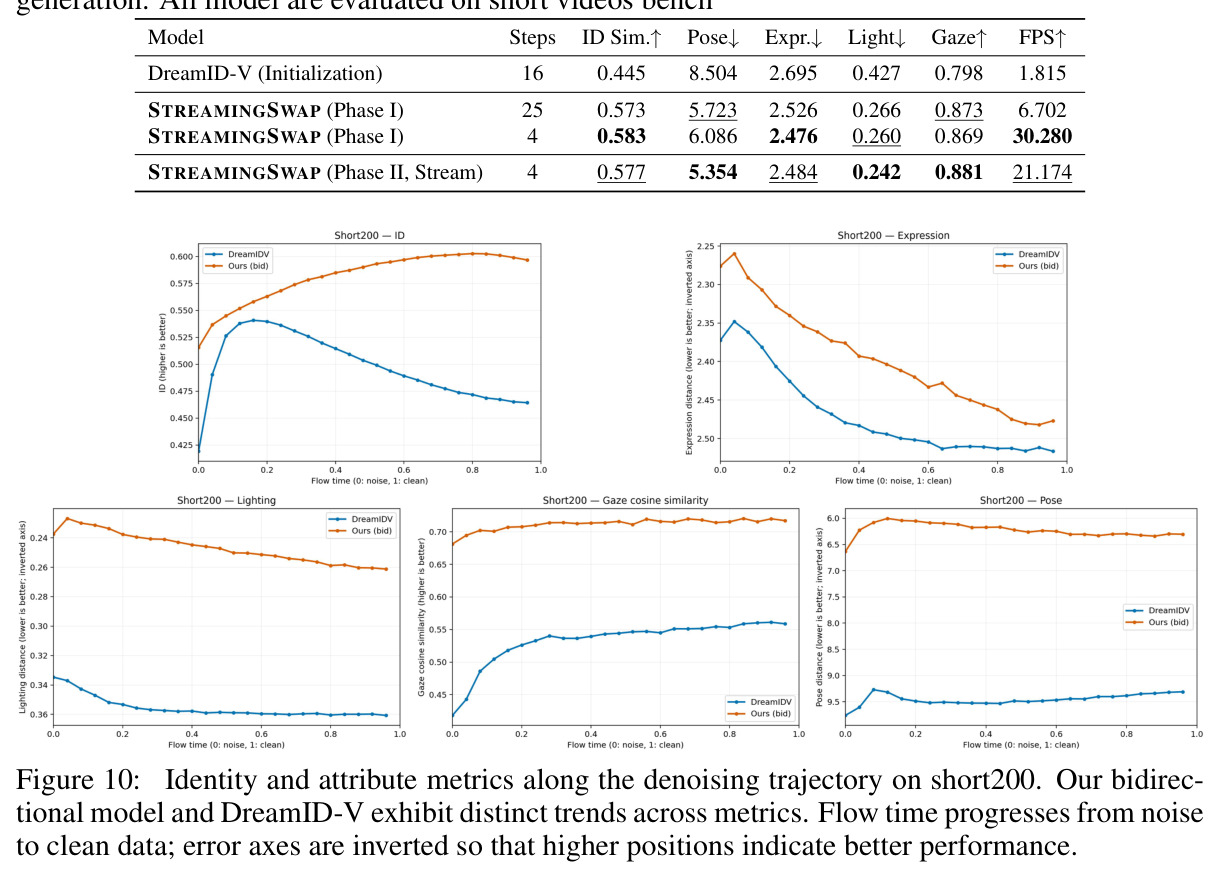
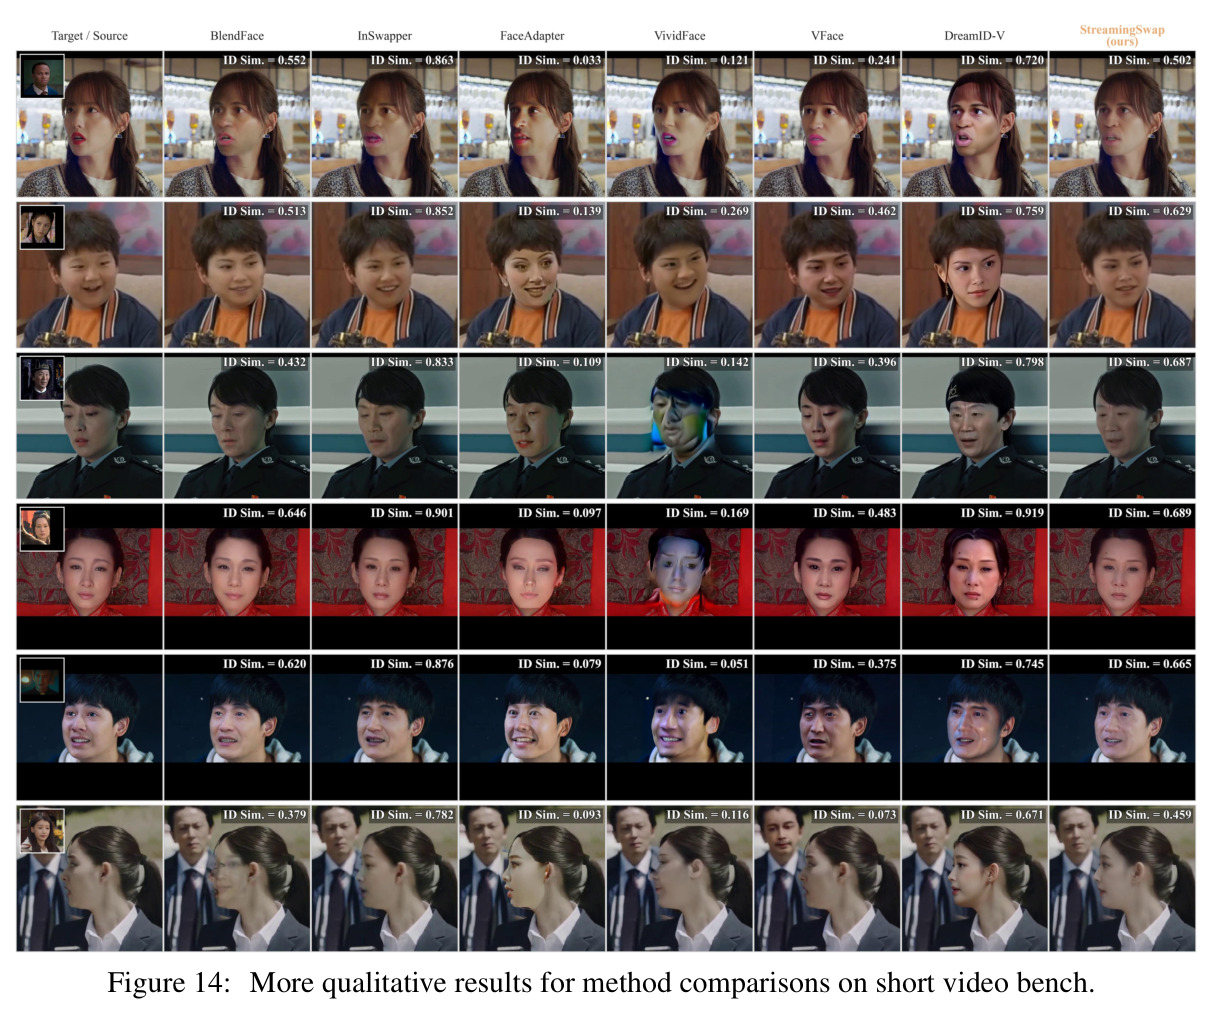
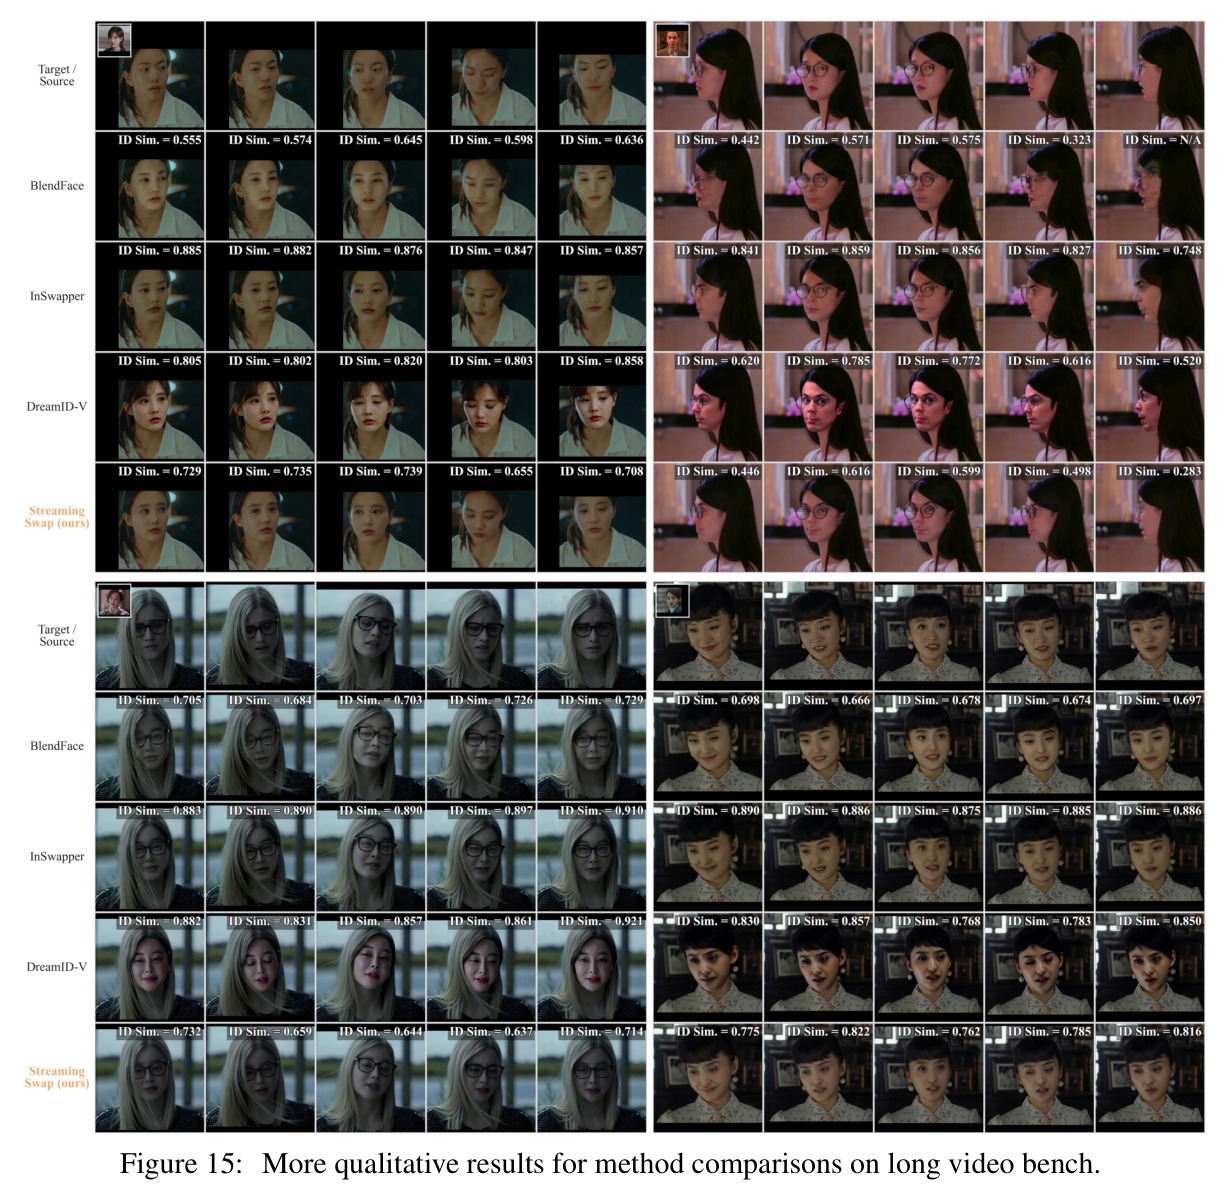
任务分析实验(Sec 3):64 个真实视频、每个配 5 个不同相似度身份,用 InSwapper 构造换脸对后发现身份相似度变化超过 0.75 而人脸区域潜 MSE 变化不足 0.05,轻度模糊对照 MSE 约 0.15(Fig 2a);空间上 token 比例从 100% 降到 39%,质量分基本不变,吞吐从约 1.3 升到 2.2 FPS、计算从 8900 降到 2200 TFLOPs(Fig 2b);时间上从全注意力缩到 6 个相邻潜帧仅轻度降质,K=2 时骤降(Fig 2c)。主实验(Table 1):短视频上 StreamingSwap ID Sim 0.577(低于 InSwapper 0.735、DreamID-V 0.734,但 Fig 4 显示高嵌入分数伴随光照姿态失真与真实感下降),姿态误差 5.354 全场最佳(InSwapper 6.084、DreamID-V 9.338),表情 2.484、光照 0.242、注视相似度 0.881 均为最优或接近最优,FVD 129.09 最低,FPS 21.174(约为 DreamID-V 的 11.7 倍),延迟 1.782s(DreamID-V 44.891s);长视频趋势一致:ID Sim 0.576、姿态 6.336、FVD 136.23(DreamID-V 249.41),10 分钟稳定生成。消融(Table 2):去掉身份监督 ID Sim 从 0.573 崩到 0.241;去掉 Face-RoI 后 FPS 从 6.702 掉到 2.355 而质量相近;Phase II 去掉自展开后姿态/表情变差(6.751/2.524 对比 6.336/2.466)。步数消融(Table 3):4 步去噪的 Phase I 达 ID Sim 0.583、30.28 FPS,较 25 步提速 4.52 倍;窗口消融(Table 5)选定 (3,9);重建目标消融(Table 4)端点重建优于速度重建(ID Sim 0.573 对 0.569)。轨迹分析(Fig 10)显示去噪后期身份相似度略降、表情/光照误差早触底后回升,解释了 4 步采样的优势。
局限与改进
作者承认的局限:其一,ID Sim(0.577)低于 InSwapper(0.735)与 DreamID-V(0.734),虽然作者论证高嵌入相似度可能伴随光照姿态失真和真实感下降(Fig 4),但这仍是身份传递强度上的明确折衷;其二,附录 E 明确说明 4 步采样可能牺牲部分精细视觉细节,其指标优势不能等同于感知质量全面更优;其三,流式窗口重复处理历史与每窗口固定开销使吞吐从 Phase I 的 30.28 FPS 降到 21.17 FPS。我的补充观察:端到端延迟 1.782 秒意味着所谓实时是吞吐意义上的实时,并不适合视频通话等需要亚秒级交互延迟的场景;整个训练信号建立在 InSwapper 伪配对之上,身份上限被教师模型封顶且继承其合成偏差;全部评测在自建 HumanFaceVid 上进行,缺乏第三方基准交叉验证;方法依赖人脸检测、追踪与掩码质量,对极端侧脸、大遮挡、多人同框、远景小脸等困难场景的鲁棒性论文未系统量化,Face-RoI 假设人脸可被稳定定位;此外实时流式换脸显著降低了伪造门槛,作者自己也承认效率提升会放大冒充与虚假信息的滥用风险。
独立分析的弱点
弱点一:身份传递强度不足。0.577 的 ID Sim 相比 InSwapper 有明显差距,在远景小脸、大姿态跨度等场景可能进一步走弱,而 Face-RoI 的膨胀掩码会把这些困难区域一并圈进来。改进方向:引入度量学习式身份监督(三元组损失或类中心约束)替代单一余弦损失;在低噪声段自适应提高 $\lambda_{id}$;或用更强的换脸教师构造配对数据。弱点二:伪配对监督的天花板。整个训练建立在 InSwapper 输出之上,模型学到的本质是「把 InSwapper 风格的换脸结果映射回真实视频质感」,难以在身份忠实度上超越教师。改进方向:加入对抗训练或真实身份一致性正则打破教师上限,或构建可微换脸管线端到端优化。弱点三:交互延迟高。1.782 秒的窗口延迟支撑直播换脸够用,但不支持实时对话式应用。改进方向:进一步蒸馏到 1-2 步去噪(一致性模型)、把窗口内双向注意力因果化以消除等待、减小 $N_{gen}$ 分摊延迟。弱点四:窗口配置固定为 (3,9),对场景切换、剧烈运动的适应性有限,Table 5 显示身份相似度在 (3,3) 反而峰值 0.592,说明固定配置并非处处最优。改进方向:学习式窗口调度或按运动幅度动态调整历史长度。弱点五:加速栈绑定 CUDA 生态(SageAttention、torch.compile),移动端与边缘设备部署门槛仍然很高。
未来方向
作者方向的自然延伸:把流式换脸与语音驱动口型结合,服务 AI 主播与虚拟人直播;把 Face-RoI 思想推广到其他局部编辑式视频生成任务(换装、换发型、局部风格化);用自适应上下文长度替代固定窗口配置;在身份损失中引入 3DMM 几何一致性约束以提升侧脸与遮挡下的身份稳定性。基于本文成果可延伸的研究方向:其一,身份监督与流匹配相互作用的理论分析——噪声相关权重调度是否可推广到一切「编辑域小、重建域大」的任务(视频补色、局部重打光);其二,把 4 步自展开进一步蒸馏到 1-2 步,逼近真正交互级延迟;其三,利用 HumanFaceVid 的 200 条长视频评测集推动换脸时序稳定性与误差累积的标准化评测协议;其四,多人同框、多身份同时流式换脸的扩展,现有 Face-RoI 是单脸假设;其五,配套的不可见水印与内容溯源机制,回应作者伦理声明中承认的滥用风险。
复现评估
复现难度中等偏上,方法透明度高但未明确承诺开源。有利条件:论文细节完备——附录 B 给出数据管线(OpenHumanVid + BiSeNet 解析 + InsightFace 凸包 + InSwapper + 轮廓形变),附录 D 给出全部训练评测设置(lr 1e-5、batch size 8、每阶段 1000 步、4×H100、SageAttention + torch.compile + LightTAE),附录 E-G 补齐消融超参($\tau=0.5$、$\lambda_{id}=0.1$、$\lambda_{high}=10$、$\lambda_{low}=0.1$、$(N_{ctx},N_{gen})=(3,9)$、4 步调度、5 窗口展开),项目页 aim-uofa.github.io/StreamingSwap 已建立,评测集构成(200 短 + 200 长)定义清晰。障碍:代码与权重未见明确开源声明;Phase I 必须从 DreamID-V 预训练权重初始化,该 checkpoint 的可得性是最大不确定项;数据构造涉及大规模人脸检测、聚类与 InSwapper 批量推理,工程量不小,1000 小时数据的整理成本高。推理侧复现门槛低(单张 4090 即可),若代码不开源,从零复现全流程估计需要数周工程投入;复现评测则需自建指标管线(ArcFace、3D 重建系数、FVD)。
论文图表
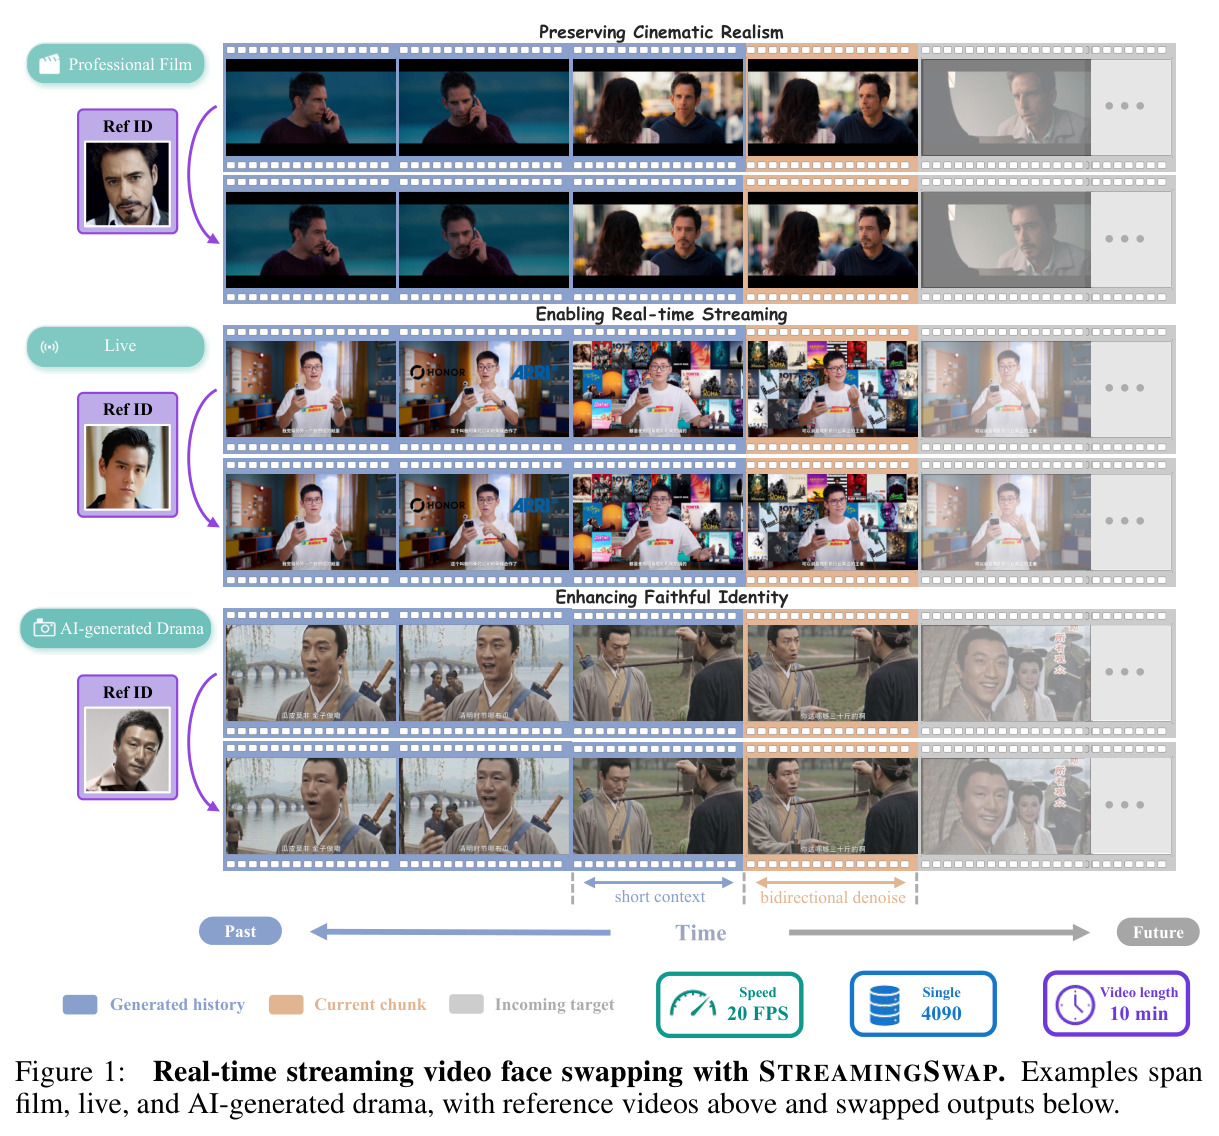
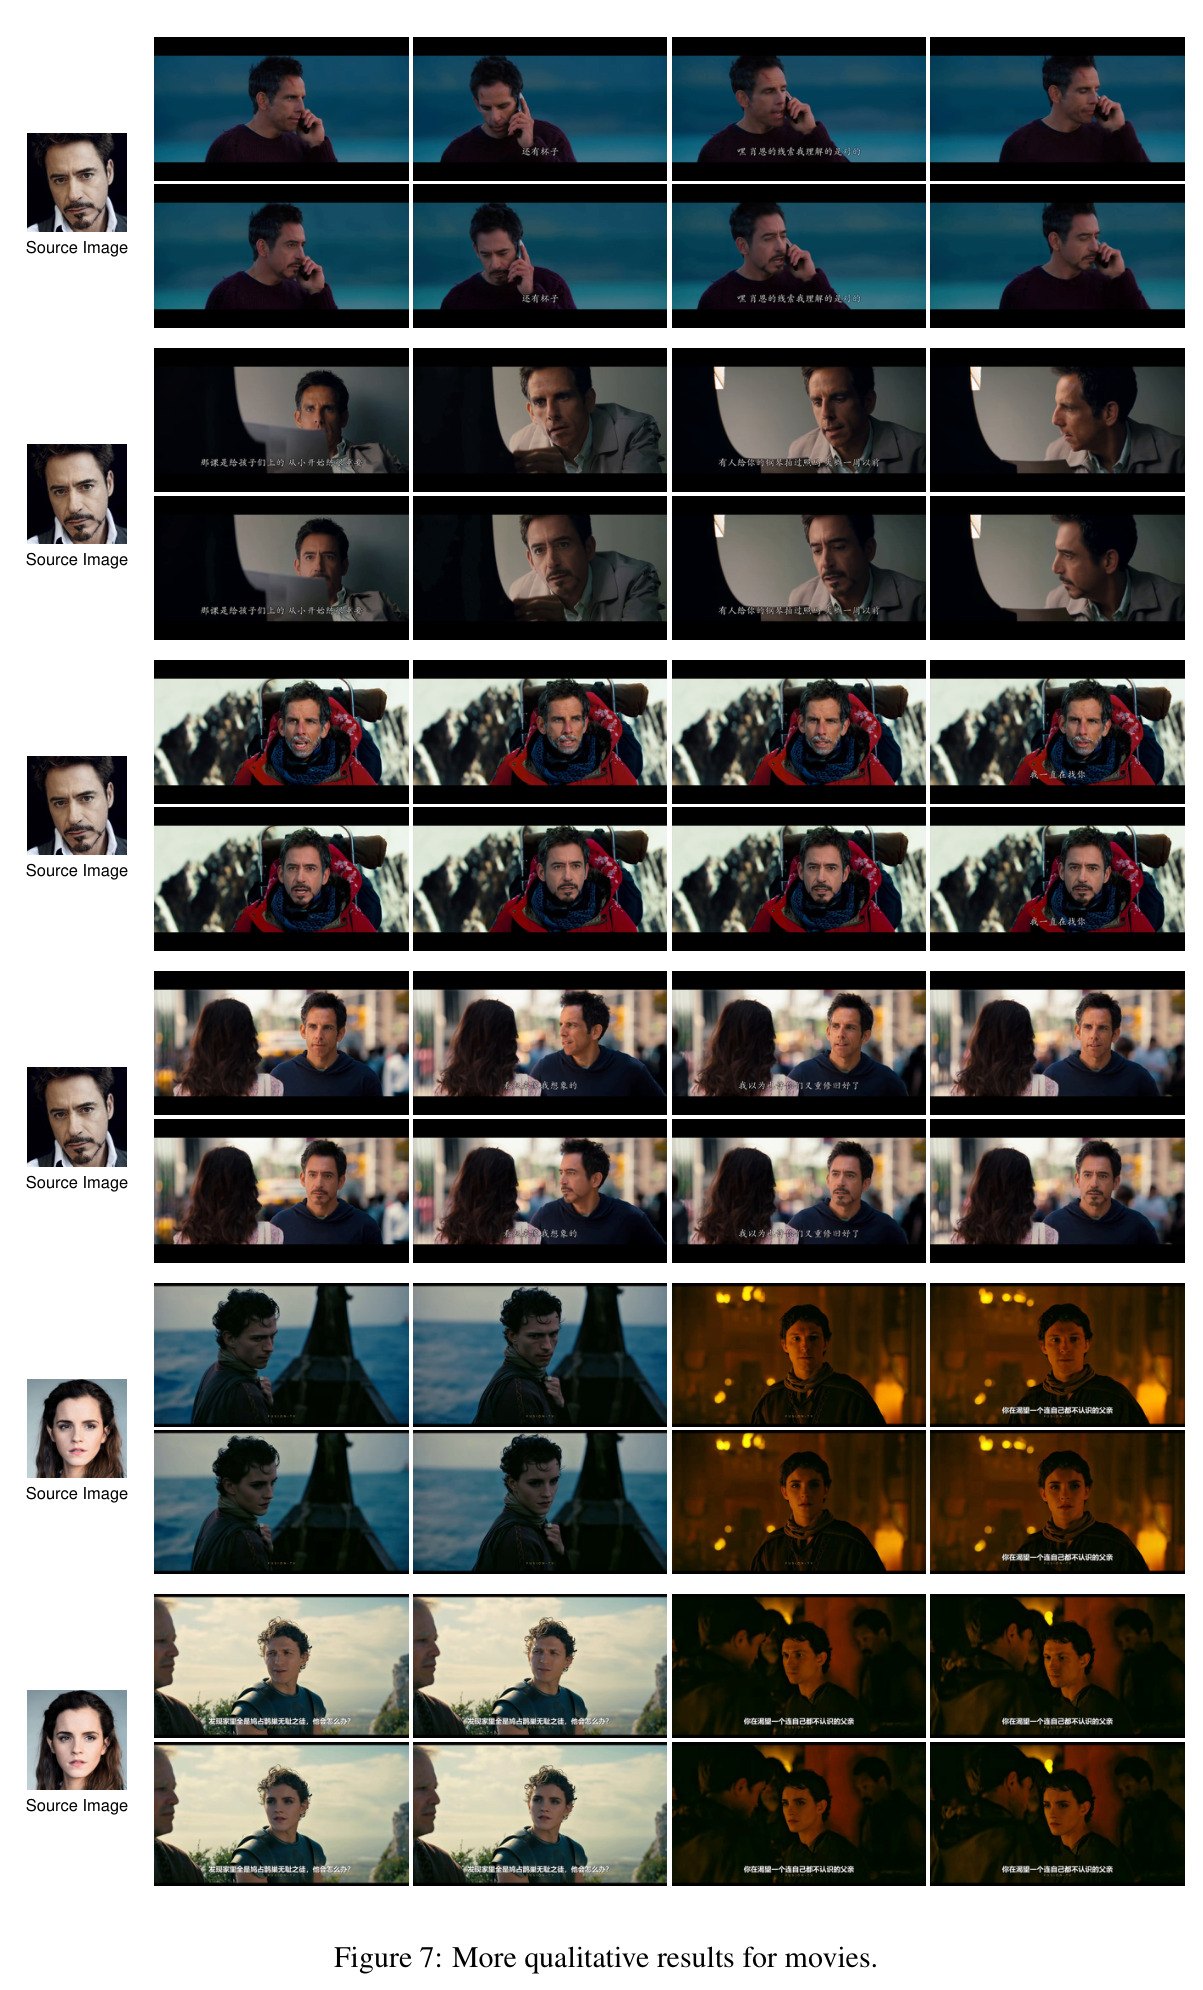
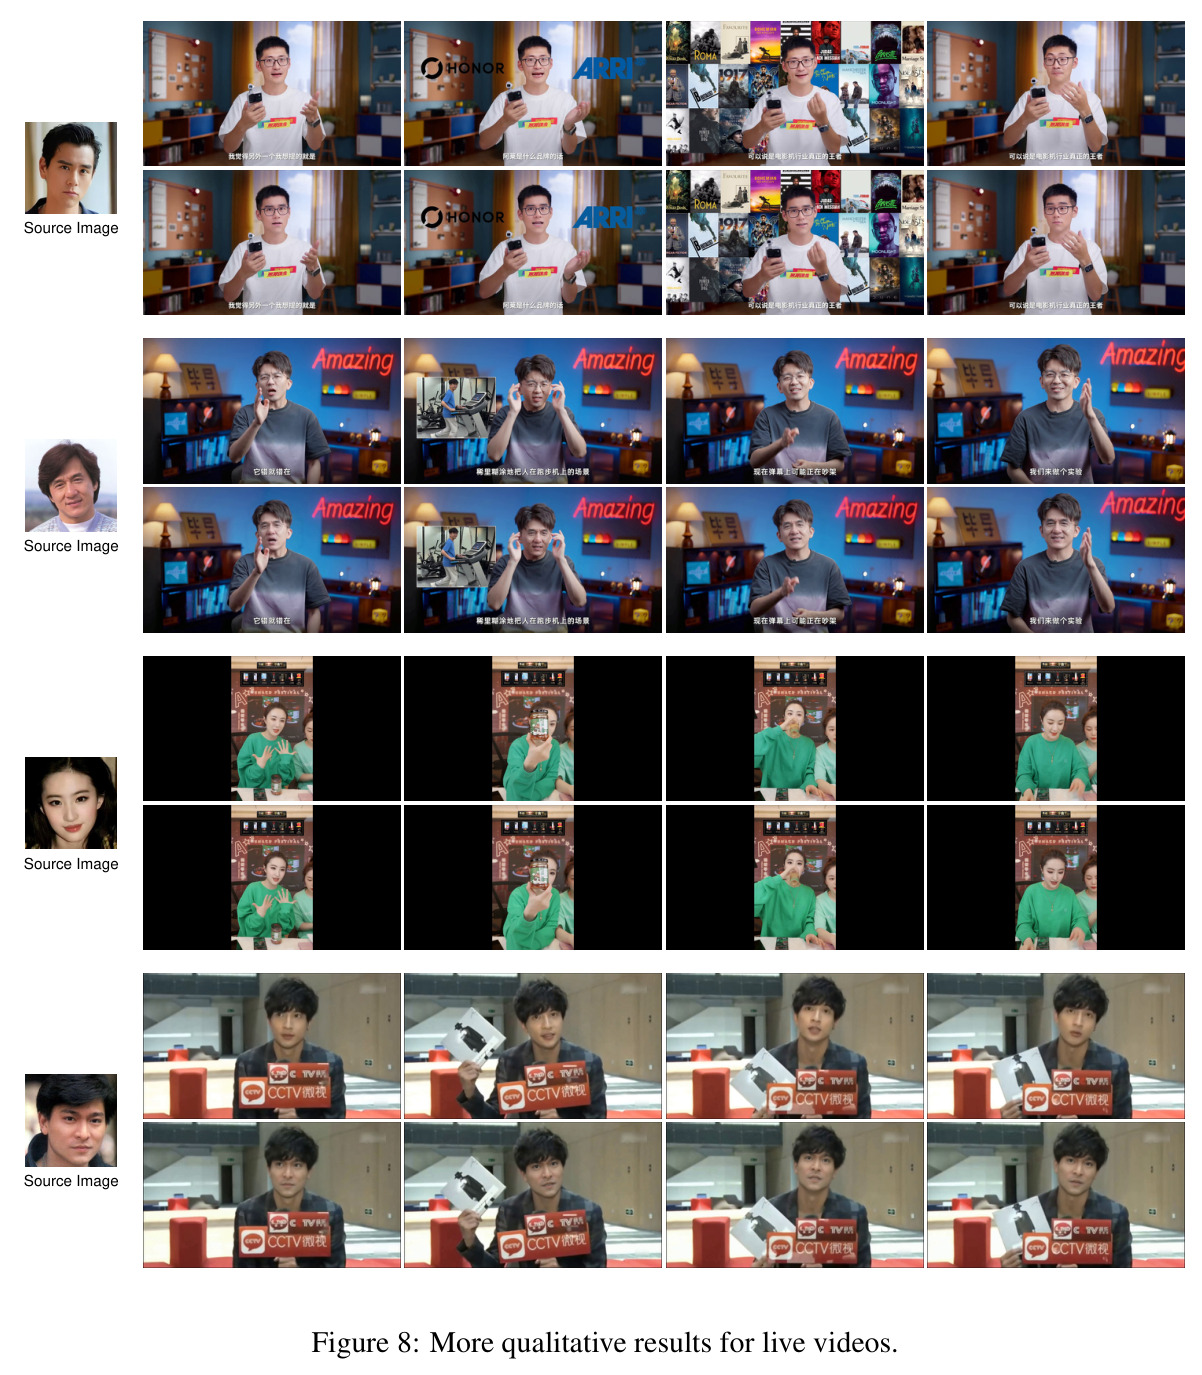
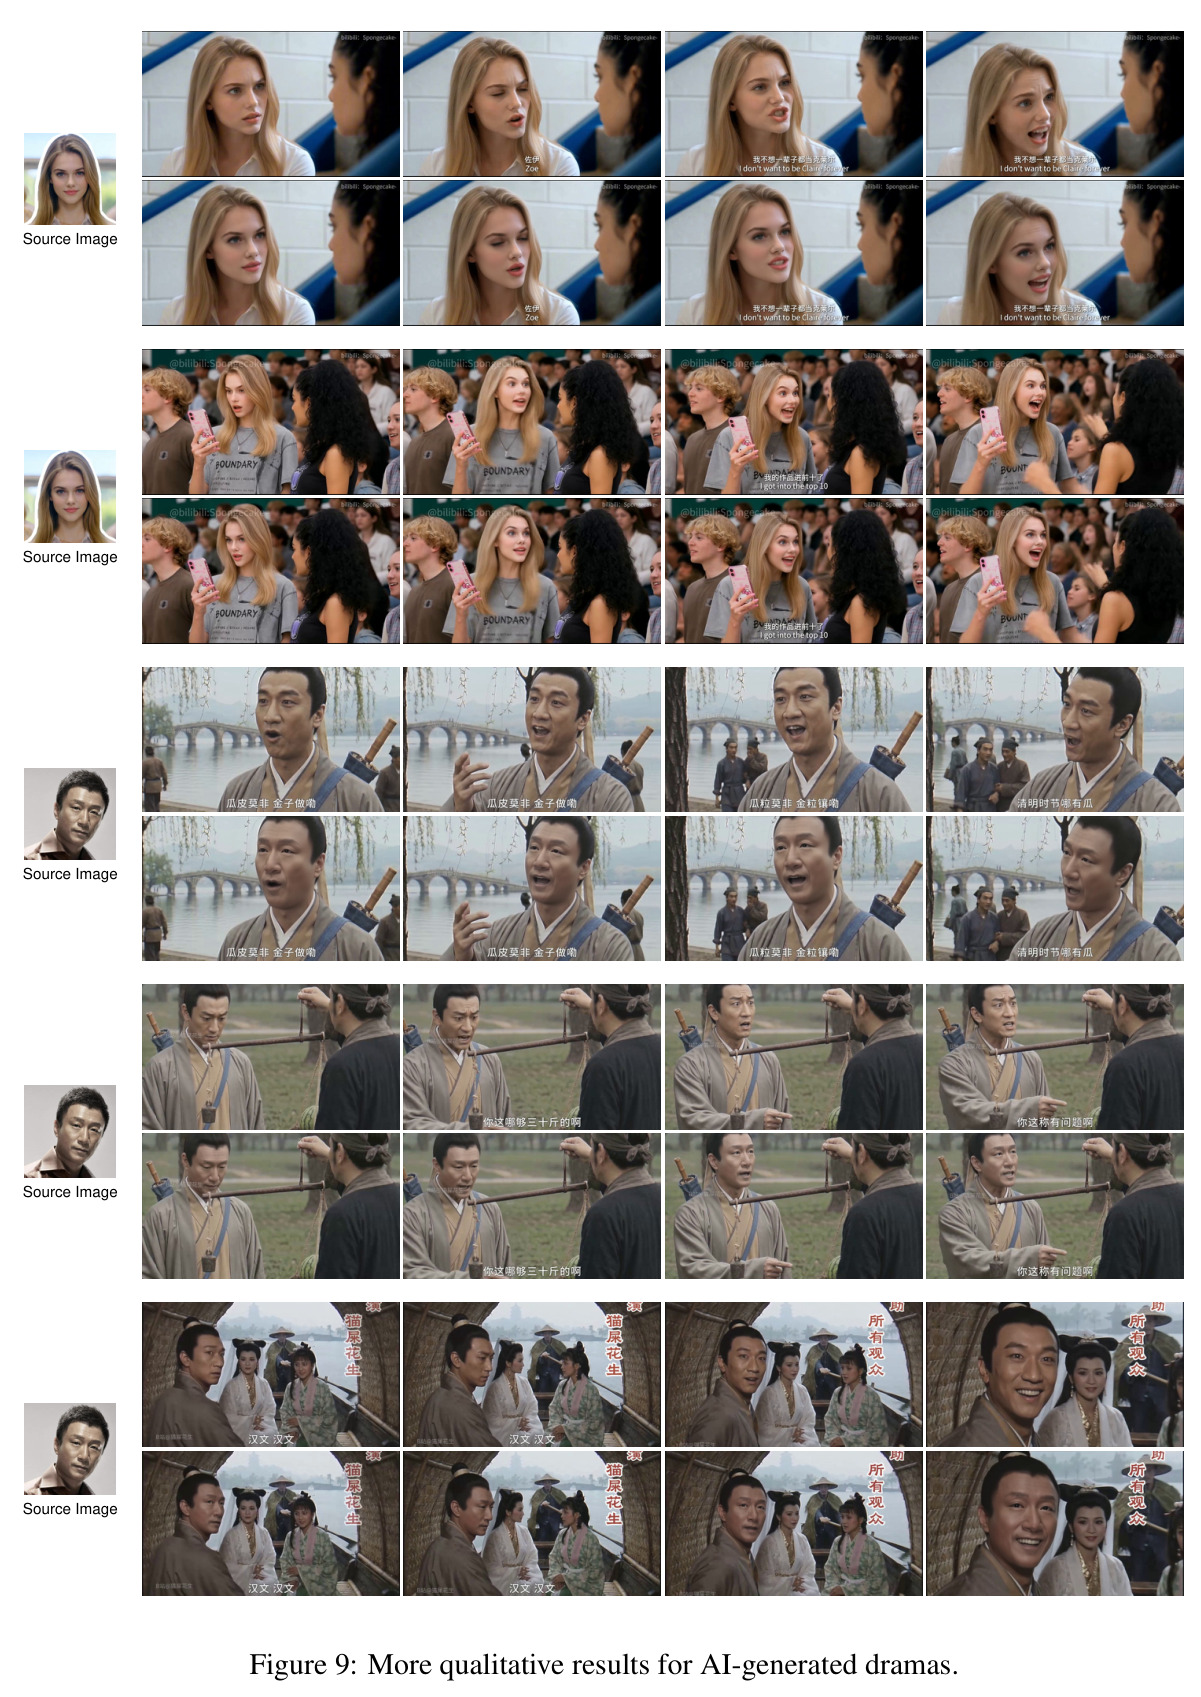
开篇总览图:三行分别对应专业电影、直播、AI 生成短剧三类应用场景,上排为参考身份视频(Ref ID),下排为换脸输出;右侧标注三项核心能力——保留电影级真实感、支持实时流式生成、增强身份忠实度,并给出关键指标:20 FPS 速度、单张 RTX 4090、支持 10 分钟视频长度。
一图定义了任务、展示了目标应用场景,并把论文最终达成的效率与稳定性指标直观呈现,是快速理解论文定位的入口。
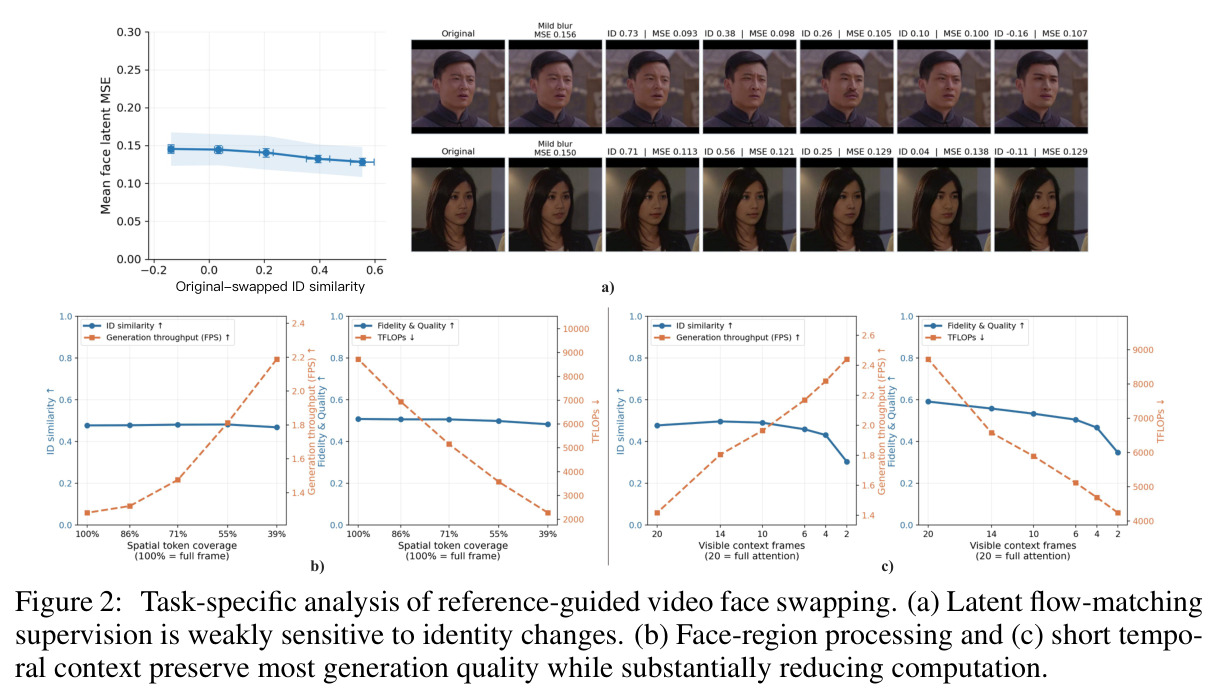
三个对照分析子图:(a) 换 5 个不同相似度的身份时,视频对身份相似度变化超过 0.75,但人脸区域潜空间 MSE 变化不足 0.05,且轻度模糊对照的 MSE 约 0.15,说明流匹配损失对身份几乎钝感;(b) 空间维度上 token 保留比例从 100% 降到 39%,身份相似度与保真质量分基本不变,吞吐从约 1.3 升到 2.2 FPS、计算从 8900 降到 2200 TFLOPs;(c) 时间维度上注意窗口从全注意力(K=20)缩到 6 个相邻潜帧仅轻度降质,K=2 时性能骤降。
整篇论文的方法设计(Joint Rec-ID Loss、Face-RoI、短上下文)全部建立在这三个实验证据之上,是论文从观察到方法的推理枢纽,堪称全文最重要的一张图。
阶段与去噪步数消融:DreamID-V 初始模型 16 步 ID Sim 0.445、1.815 FPS;Phase I 25 步 ID Sim 0.573、6.702 FPS;Phase I 4 步 ID Sim 0.583、30.280 FPS(较 25 步提速 4.52 倍且指标不降反升);Phase II 流式 4 步 ID Sim 0.577、21.174 FPS,Pose/Light/Gaze 进一步改善,吞吐因历史重复处理与窗口开销下降。
支撑 4 步采样这一激进效率决策,并解释流式化带来的 FPS 损耗来源,是理解 Phase I 到 Phase II 演进的关键。