每个像素都是一个选项:面向医学超声生物测量的系统一模型 Every Pixel Is an Option: A System One Model for Medical Ultrasound Biometry
Kev-Bio 把临床测量问题变成像素概率图,统一完成九视角超声生物测量
前置知识
System One 决策模型(Jev/Kev)
传统大语言模型以自回归方式逐 token 生成答案;System One 类模型(如 Jev 及其开源权重版本 Kev)把预测改为“对候选响应打分”:给定输入,模型对一组候选输出分布而非逐字生成。Kev 基于 Qwen3.5-0.8B 训练,其输入序列中 标记处的隐状态即“决策表示”。本文把这一打分思想从文本决策迁移到空间定位——把图像中每个像素位置视为对定位问题的一个候选答案。
Kev-Bio 的名字与核心机制直接继承 Kev:语言主干用预训练 Kev adapter 初始化, 处的决策状态是生成卡尺端点查询的源头,理解这一点才能看懂方法的核心链路。
视觉语言模型(VLM)
同时处理图像与文本的多模态模型:视觉编码器把图像切成 patch token,与文本 token 拼接后送入语言模型,使模型能根据文字指令理解图像内容,代表如 LLaVA、Qwen-VL 系列。本文用 Qwen3.5 的视觉编码器提取语言对齐的视觉特征,语言主干通过临床测量问题(文本)驱动关键点定位(视觉)任务。
Kev-Bio 的输入序列构造(视觉 token + 视图指令 + 逐测量问题)以及“换一句问题就换一个定位目标”的能力,全部建立在 VLM 的基本工作方式之上。
soft-argmax
一种可微的“从概率图取坐标”操作:对整张概率图 $P(i,j)$ 与每个网格单元中心坐标 $c_{i,j}$ 做加权求和 $\hat{p} = \sum_{i,j} P(i,j)\, c_{i,j}$,得到位置的期望值。由于 softmax 输出连续可导,梯度能从坐标损失一路回传到整个网络,是热图类关键点检测的标准技巧,避免了不可导的 argmax。
Kev-Bio 用 soft-argmax 把端点概率图转成可微坐标,进而计算测量值与几何损失 $\mathcal{L}_{geom}$,是实现端到端联合训练的关键一环。
LoRA 微调
低秩适配(Low-Rank Adaptation):冻结预训练权重 $W$,只训练低秩增量 $\Delta W = BA$(秩 $r$ 远小于维度),大幅减少可训练参数量与显存占用。本文语言主干、Qwen 视觉编码器、USFM 均用 r=16 的 LoRA,DINOv2 ViT-L/14 用 r=32,新增模块全参数训练。
论文总可训练参数只有 35.0M、单张 H100 即可训练,靠的正是 LoRA;理解它才能把握方法的实现规模与复现成本。
热图监督与关键点检测
关键点检测的经典范式:把真值点渲染成以该点为中心的二维高斯分布作为目标热图,让网络预测的逐像素分布与之对齐(常用交叉熵或 MSE)。相比直接回归坐标,热图保留了“真值附近高、远处低”的空间结构,天然携带定位置信度信息。nnLandmark、MedSapiens 等医学关键点检测器均属此类。
Kev-Bio 的热图损失 $\mathcal{L}_{hm}$ 用高斯热图交叉熵把点监督转化为连续概率场,而概率图的熵在实验中被用作不确定性分数,是结果分析部分的基石。
超声/通用视觉基础模型(USFM、DINOv2)
基础模型指在大规模数据上预训练、可迁移到多种下游任务的大 backbone。USFM 是超声领域预训练模型,提供超声特异特征;DINOv2 是自监督通用视觉模型(本文用 ViT-L/14),提供多层级空间细节特征。本文把 Qwen3.5(语言对齐)、USFM(超声专用)、DINOv2(空间细节)三路特征双线性对齐后拼接,经 Pixel Neck 融合成共享稠密特征图。
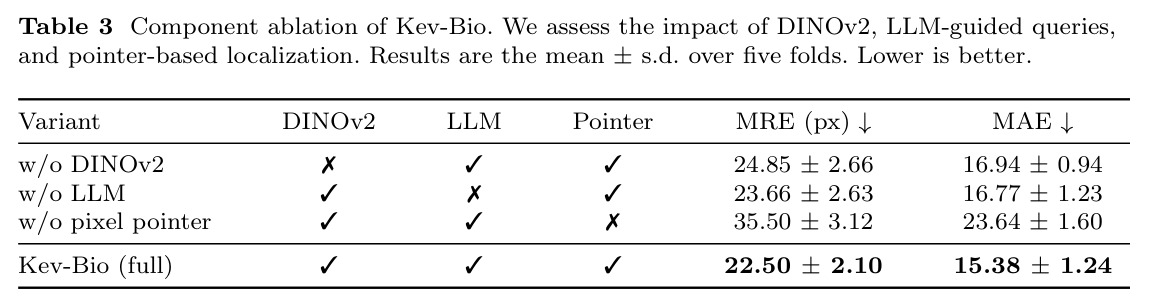
三路互补特征是定位精度的重要来源:消融实验显示去掉 DINOv2 会让 MRE 从 22.50 px 恶化到 24.85 px,理解特征融合设计才能读懂架构与消融。
研究动机
超声生物测量(biometry)要求医生在解剖标志点上手动放置卡尺,再计算距离、角度或周长,广泛用于产前检查(胎儿头围 HC、腹围 FA、股骨长 Femur、宫颈长 FUGC)和心脏检查(A4C、PLAX 等视图的内径测量)。即便经过标准化培训,不同操作者之间的测量结果仍存在明显差异。自动化定位面临多重困难:斑点噪声、声影和模糊的组织边界会掩盖解剖结构;探头方向变化会改变目标外观;单张图像可能支持多项临床测量,每项需要不同的关键点组合。现有专用模型(如 CAMS、IMPACT-L、FMUB)采用共享图像编码器加任务专属解码器/预测头的架构,每种测量绑定固定的输出头,难以扩展到新的解剖结构或测量任务;视觉语言模型虽可通过文本指令灵活指定任务,但直接预测坐标无法显式建模定位歧义的空间似然分布。
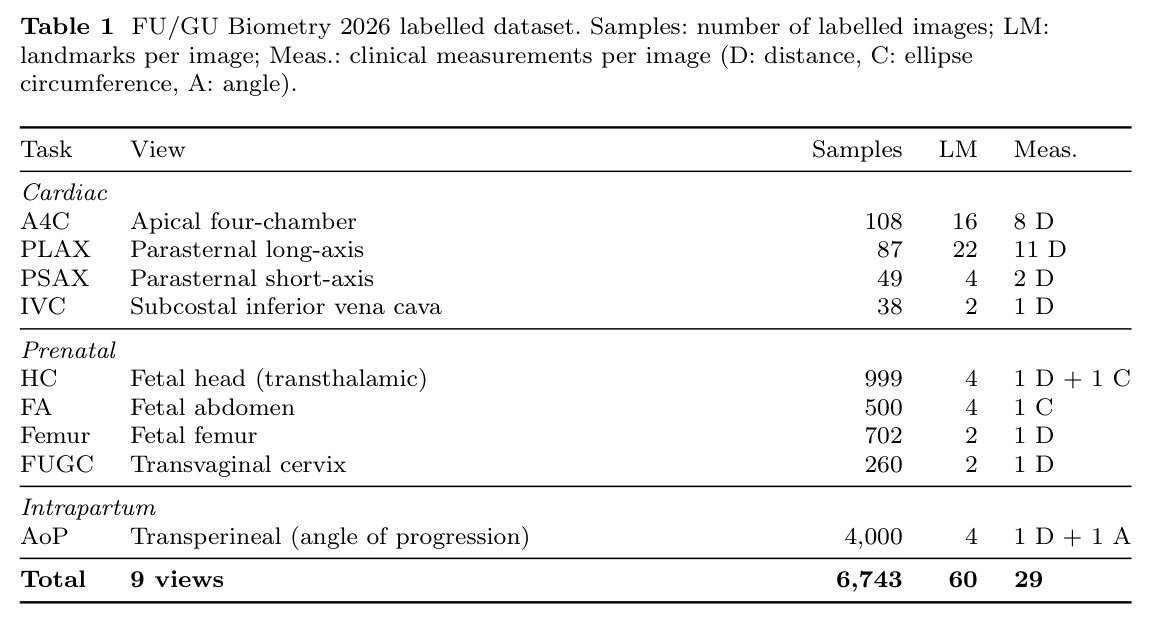
本文的目标是本文目标是构建一个统一框架 Kev-Bio:接收一张带解剖视图标签的超声图像和一组临床测量问题,在单一共享框架内同时完成全部卡尺端点的定位与测量值计算,并输出每个端点的空间概率分布。具体而言,模型要在 MICCAI 2026 FoundUS 挑战赛发布的 FU/GU Biometry 2026 基准上,覆盖心脏、产前、产时三个临床领域的 9 个超声视图、60 个视图专属关键点定义和 29 项临床测量(距离、椭圆周长、角度),在平均径向误差(MRE)和测量平均绝对误差(MAE)两项指标上超越 nnLandmark、MedSapiens、CAMS、IMPACT-L、FMUB、US-Foundation 等基线,且不使用挑战赛提供的 191,170 帧未标注数据,同时让模型自带的概率图能指示哪些预测值得人工复核。
与已有工作不同的是,本文的独特切入点是把关键点定位重新表述为“空间决策”问题。作者受近期 System One 决策模型(Jev 及其开源版 Kev)启发——这类模型不做自回归生成,而是对候选响应打分——将图像中的每个像素位置视为对一个临床定位问题的候选答案,标题“Every Pixel Is an Option”正是此意。与 LISA 等从语言模型状态预测分割掩码、或近期点定位工作预测单点热图不同,本文关注的是成组卡尺点(每个测量 2–4 个端点),其几何组合(距离/角度/周长)才构成临床测量。因此作者让语言模型在每个测量问题 标记处的决策表示生成端点专属查询,再与共享稠密特征图做点积匹配,使“理解问题”与“空间定位”在同一模型内显式耦合,而非各任务独立建模。
核心方法
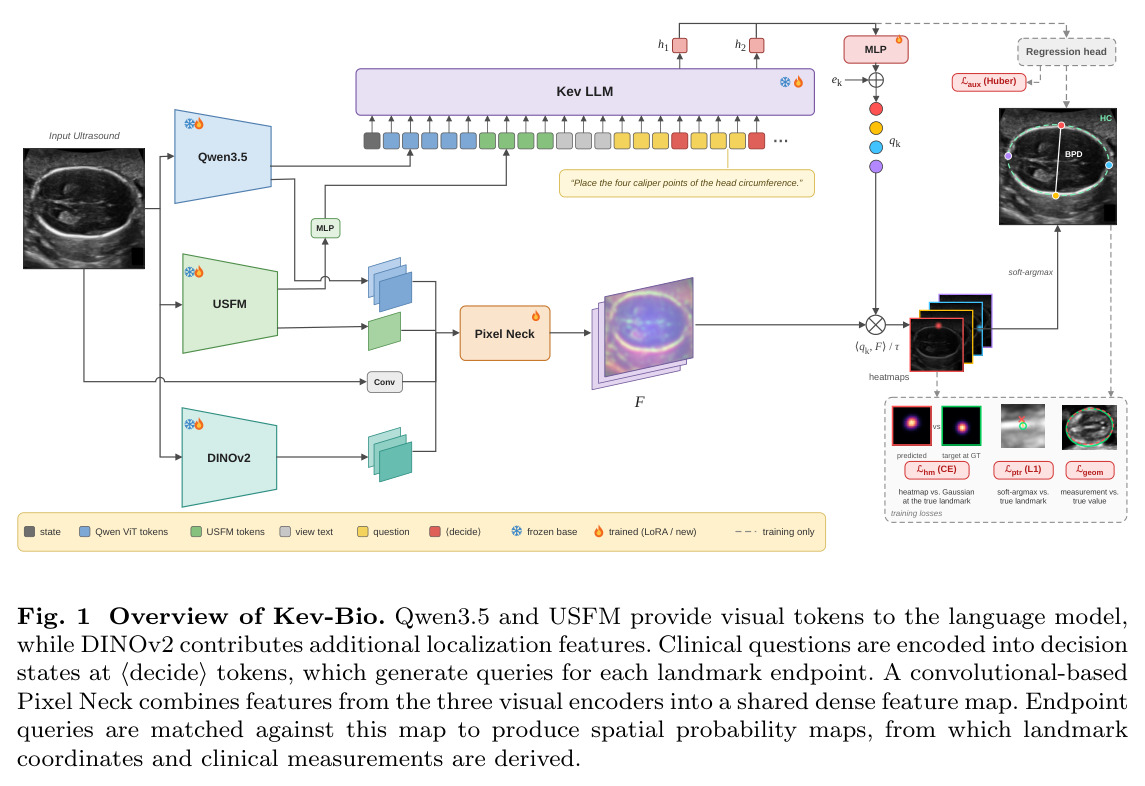
直觉上,Kev-Bio 把“放卡尺”变成“答题”:语言模型读完临床测量问题后,在特征图上为每个卡尺端点“指”一个位置。技术路线分四步。第一步,多模态编码:Qwen3.5 视觉编码器提取语言对齐的视觉 token $Z_Q(I)$,超声基础模型 USFM 提取 $Z_U(I)$,后者经投影网络 $P_U$ 映射到语言模型嵌入空间,与视图指令 $t_v$ 和各测量问题 $t_m$(以 开头、 结尾)拼成输入序列 $X$。第二步,查询生成:以 Kev 初始化的 Qwen3.5-0.8B 做一次前向,抽取每个 处的决策表示 $h_m$,经 MLP 加可学习端点嵌入得到归一化查询 $q_{m,k}$。第三步,空间匹配:Qwen3.5、USFM、DINOv2 三路特征经 Pixel Neck 融成共享稠密特征图 $F$,查询与 $F$ 逐位置做缩放点积再空间 softmax,得到概率图 $P_{m,k}$。第四步,soft-argmax 取得坐标,几何函数 $g_m$ 计算测量值,四项损失(坐标、热图、几何、辅助回归)端到端联合训练。
核心创新是“语言条件化的共享像素指针”。与 CAMS、IMPACT-L 等每个测量绑定专属预测头不同,Kev-Bio 中所有测量共享同一个稠密特征图和同一套匹配机制,测量的差异完全由语言模型决策状态生成的查询编码——换一个测量只需换一句文本问题,无需新增网络参数或重训输出头。第二个关键点是显式概率建模:不直接回归坐标,而是输出每个端点在整个图像上的空间概率分布 $P_{m,k}(i,j)$,点积相似度配合可学习温度 $\tau$,使定位歧义(如图像中存在两个相似解剖候选)自然体现在分布形状中,其熵可作为不确定性分数,这是直接坐标回归做不到的。第三,损失设计把点监督转化为连续概率场:高斯热图交叉熵 $\mathcal{L}_{hm}$ 鼓励真值附近高置信、周围保留空间不确定性,与坐标 L1 损失、测量几何损失和辅助回归损失互补,兼顾精度与不确定性表征。
方法步骤详情
完整流程:步骤一,输入构造——序列 $X = [\langle state\rangle, Z_Q(I), P_U(Z_U(I)), t_v, (\langle q\rangle, t_m, \langle dec\rangle)]$,各测量问题按预定义顺序拼接,一次前向完成。步骤二,以 Kev 初始化的 Qwen3.5-0.8B 抽取每个 处的隐状态 $h_m$。步骤三,$h_m$ 经 MLP 加可学习端点嵌入 $e_{m,k}$、L2 归一化,生成 $K_m$ 个查询 $q_{m,k}$。步骤四,三路编码器特征双线性插值对齐并拼接,Pixel Neck 上采样融合浅层卷积特征,得共享特征图 $F$。步骤五,$S_{m,k}(i,j)=q_{m,k}^\top F(i,j)/\tau$ 经空间 softmax 得概率图 $P_{m,k}$,soft-argmax 解码坐标 $\hat{p}_{m,k}$。步骤六,几何函数 $g_m$ 由端点坐标算距离、角度或椭圆周长 $\hat{y}_m$。步骤七,联合训练 $\mathcal{L}=\mathcal{L}_{ptr}+0.1\mathcal{L}_{hm}+0.2\mathcal{L}_{geom}+\mathcal{L}_{aux}$(坐标 L1、高斯热图交叉熵、中位数归一测量误差、辅助 Huber),AdamW 训 24 epochs、batch 8,单张 H100 完成。
技术新颖性
从技术谱系看:相对 nnLandmark、MedSapiens 等固定关键点检测器,Kev-Bio 用文本查询实现了跨 9 视图、60 个关键点定义、29 种测量的统一推理;相对 LISA 等语言-空间方法,它首次处理“成组端点的几何组合”而非单个掩码或单点,并把 System One 的“候选打分”范式从文本决策迁移到像素级空间决策;相对 CAMS、FMUB 等挑战赛方法,它在完全不用 191,170 帧未标注数据的前提下取得更优的平均误差。消融实验定量支持每个组件的必要性:去掉像素指针(改为从决策状态直接回归坐标)MRE 从 22.50 恶化到 35.50 px、MAE 从 15.38 到 23.64,是贡献最大的组件;去掉 DINOv2 升至 24.85/16.94;去掉语言模型(换成图像条件可学习查询)升至 23.66/16.77,说明即便测量定义固定,语言条件查询仍带来实质增益。
实验结果
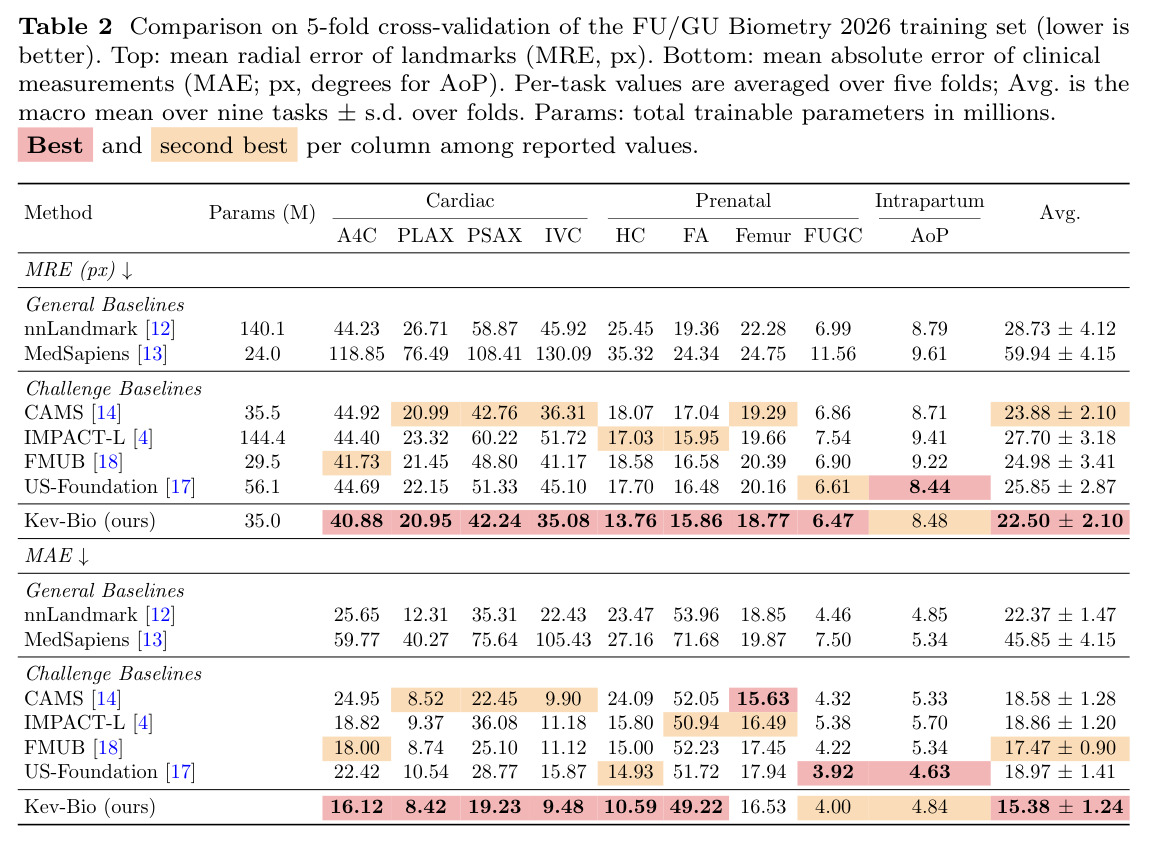
在 FU/GU Biometry 2026 标注集(6,743 张图像,从 IVC 38 张到 AoP 4,000 张高度不平衡)上做 5 折交叉验证。定位:平均 MRE 22.50±2.10 px,优于最强基线 CAMS 的 23.88±2.10,9 视图中 8 个最优;HC 从 IMPACT-L 的 17.03 px 降至 13.76 px(约 19%),A4C 从 44.92 降至 40.88。测量:平均 MAE 15.38±1.24,优于 FMUB 的 17.47±0.90,其中 HC 10.59(基线最好 14.93)、A4C 16.12(18.00);但 Femur(16.53 对 15.63)、FUGC(4.00 对 3.92)、AoP(4.84 对 4.63)单项上个别基线更低。参数量 35.0M,与 CAMS 相当、远小于 IMPACT-L 的 144.4M。不确定性:按概率图熵降序,前 10% 最不确定预测捕获 40% 错误(随机 10%),AUROC 心脏 0.70、产前 0.76、产时 0.86。消融显示像素指针贡献最大(移除后 MRE 35.50、MAE 23.64);定性结果中基线常把关键点放到相邻解剖结构,Kev-Bio 保持解剖对应。
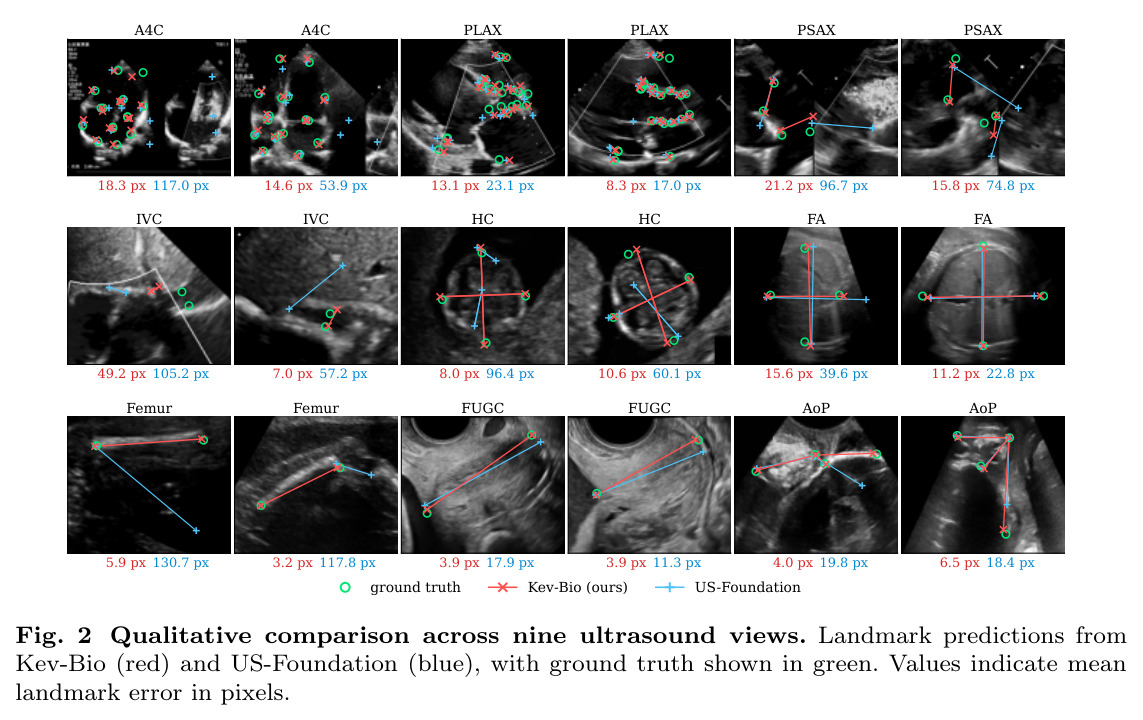
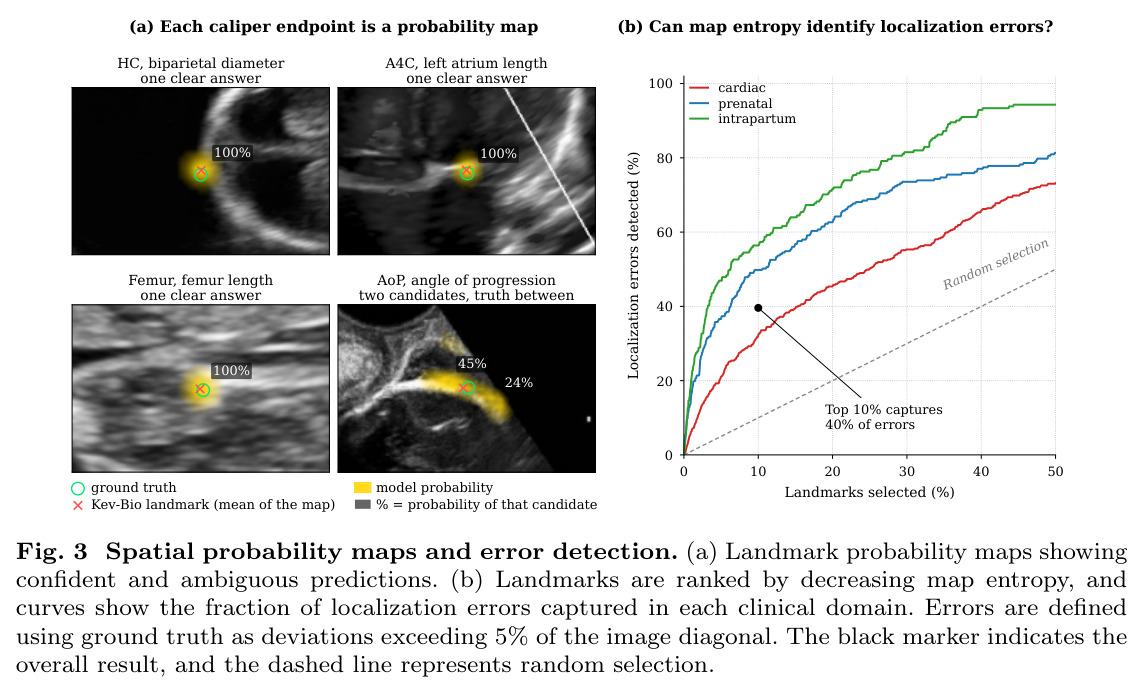
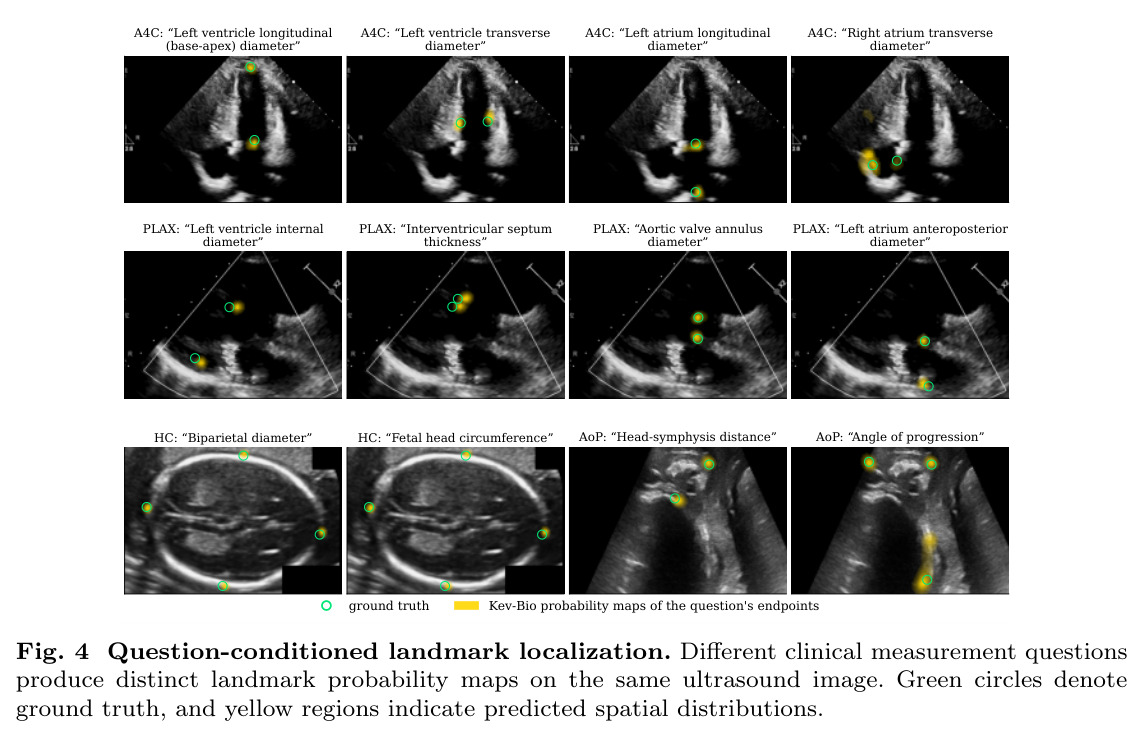
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 9 视图关键点定位(5 折交叉验证宏平均) | MRE 平均径向误差(px,越低越好) | 22.50 ± 2.10 | CAMS 23.88 ± 2.10 | 降低 1.38 px(约 5.8%),9 个视图中 8 个最优 |
| 9 视图临床测量(5 折交叉验证宏平均) | MAE 平均绝对误差(px,AoP 为度) | 15.38 ± 1.24 | FMUB 17.47 ± 0.90 | 降低 2.09(约 12%),6 个视图测量误差最低 |
| 胎儿头围 HC 视图定位 | MRE(px) | 13.76 | IMPACT-L 17.03 | 降低 3.27 px(约 19.2%),是论文强调的最大单项改进 |
| 基于概率图熵的定位错误检测 | 前 10% 最不确定预测的错误捕获率 / AUROC | 捕获 40% 错误;AUROC 心脏 0.70、产前 0.76、产时 0.86 | 随机选择捕获 10% 错误 | 错误捕获率为随机基线的 4 倍 |
| 组件消融:移除像素指针(改为直接坐标回归) | MRE / MAE | 完整模型 22.50 / 15.38 | 无指针变体 35.50 / 23.64 | 指针贡献 13.0 px / 8.26 的差距,是影响最大的组件 |
局限与改进
作者承认的局限:评估仅限单一基准上的预定义测量,虽横跨多个解剖区域,但对未见过的测量指令、解剖结构和成像条件的泛化尚未验证;不确定性校准与计算效率留待未来工作。我的补充观察:(1) 绝对误差仍不小——心脏视图 A4C 的 MRE 高达 40.88 px、MAE 16.12,距离临床直接可用仍有距离;(2) 数据高度不平衡,AoP 占 4,000 张(约 59%),IVC 仅 38 张,小数据视图的逐折方差更大;(3) 空间 softmax 是单峰归一化分布,论文图 3a 中“两个候选、真值居中”的案例里 soft-argmax 会取期望而落在两候选之间(45%/24% 的置信分配),多峰歧义处理不足;(4) 误差以像素计,未换算为毫米等物理单位,跨设备、跨深度的临床可比性存疑;(5) 点积匹配的表达能力有限,且测量问题文本与拼接顺序均为预定义模板,指令扰动的鲁棒性未测试。
独立分析的弱点
弱点一:单峰概率假设。空间 softmax 把全部概率质量归一到一张图上,当图像中存在两个相似解剖候选(如 A4C 中相邻心脏切面)时,soft-argmax 的期望输出可能落在两者之间的无效位置(图 3a 中 45%/24% 的案例即如此),改进方向是峰值感知解码、多假设预测或混合密度输出。弱点二:相似度度量表达力弱,端点查询与特征图只做一次缩放点积,无法建模复杂空间上下文与端点间相对几何,可引入轻量 cross-attention 或局部窗口内的关系建模。弱点三:对固定模板与视图标签的依赖——每个测量的临床问题文本预定义、拼接顺序固定,开放词汇测量与顺序敏感性均未测试,应做指令扰动实验。弱点四:几何函数 $g_m$ 的椭圆周长是近似计算,端点小误差会非线性放大为周长/角度误差(HC 的 MAE 仍有 10.59),可对几何量本身做不确定性传播或直接监督。弱点五:心脏视图误差仍高(A4C MRE 40.88 px),斑点噪声下的鲁棒性有待提升,可引入超声去斑预训练或时序多帧信息。
未来方向
作者提出的方向:泛化到未见测量指令、解剖结构与成像条件;不确定性校准(让熵不仅排序有用,还能对应真实错误概率);计算效率优化。基于本文成果可延伸的方向:(1) 利用挑战赛提供的 191,170 帧未标注数据做半监督或伪标签训练,与已使用这些数据的 CAMS/FMUB 做更公平的对比并进一步拉开差距;(2) 把端点概率分布从单峰扩展为多峰,配合交互式修正(医生点击候选峰)形成人机协同标注工作流;(3) 将框架推广到 3D 超声、更多胎心切面乃至 MRI 等其他模态;(4) 与 Echo-CoPilot 这类心脏解读系统集成,把卡尺定位作为可调用的下游测量工具;(5) 把 System One 的候选打分机制同样用于测量值层面——对多个几何假设排序而非单一输出,实现端到端的不确定性量化。
复现评估
复现条件较好。代码与模型已在 GitHub 开源(moeinheidari7829/Kev-Bio)。数据来自 MICCAI 2026 FoundUS 挑战赛的 FU/GU Biometry 2026:标注集 6,743 张公开可用,但官方测试集标注未公开,需按论文做法自行做 5 折划分(每折约 1,350 张);另有 191,170 帧未标注数据可选。预训练依赖均有公开版本:Qwen3.5-0.8B(含 Kev adapter)、USFM、DINOv2 ViT-L/14。算力方面,可训练参数仅 35.0M(LoRA r=16/32),但三路编码器 + 语言模型的前向显存需求不低,论文用单张 80GB H100 训练 24 epochs、有效 batch 8;普通实验室至少需要 A100/H100 级别 GPU,中端消费级显卡难以承载。超参($\lambda_{hm}=0.1$、$\lambda_{geom}=0.2$、$\lambda_{aux}=1$、分层学习率 1e-3/1e-4/5e-5、AdamW、weight decay 0.05)论文给出完整数值,复现难度总体中等。
论文图表