Axion 1.0:极简三阶段训练的全开源智能体基座模型 Axion 1.0: Open Agent Foundation Models, Simplified
仅用两阶段SFT加强化学习,训练出比肩前沿商业模型的全开源智能体基座模型
前置知识
SFT(监督微调)与 assistant-only 损失
用「问题—完整解题轨迹」数据对预训练模型做全参数微调,让模型模仿轨迹的每一步。本文的关键做法是 assistant-only supervision:系统提示、用户消息、工具返回值都进入上下文,但只在模型自己生成的 token(推理、工具调用、最终答案)上计算交叉熵损失,即对轨迹 $ au$ 的 assistant 位置索引 $I_{asst}( au)$ 求和。
本文两个能力阶段全靠 SFT 注入,损失函数(式3)直接定义在 $I_{asst}(\tau)$ 上,不理解这一点就看不懂训练设计与两阶段递进的含义。
GRPO(组相对策略优化)
DeepSeek-R1 提出的在线强化学习算法:对同一道题采样一组轨迹(本文 8 条),用组内平均奖励作为 baseline 计算每条轨迹的相对优势,从而省去独立的 value 网络。本文用 verl 框架的异步实现,并把被上下文压缩切开的 rollout 按会话(session)训练,同一条 rollout 的各 session 共享同一奖励与组归一化优势。
第 3.3 节的奖励设计、任务筛选规则(4 条采样至少 1 条正确且方差非零)全部围绕 GRPO 的组相对信号展开。
MoE 与专家路由一致性(R3)
混合专家模型(MoE)把 FFN 换成多个专家子网络,每个 token 只激活少数专家。训练时用专家并行(EP)把专家分布在不同 GPU 上。问题在于推理引擎(vLLM)与训练引擎(Megatron)可能为同一 token 选出不同专家,造成概率失配。Rollout Routing Replay(R3)在 rollout 时记录每个 token 每层的专家选择(uint8 张量,约 20MB/样本),训练前向时原样重放。
第 5.2 节与 4.4 节的 R3 消融(PPO KL 从 0.0413 降到 0.0396)是理解本文 RL 稳定性工程的关键。
TITO(Token-In-Token-Out)
智能体 RL 中 rollout 用推理引擎、训练用另一个后端,若把消息重新渲染再分词,BPE 对 token 边界敏感会导致两次分词结果不一致。TITO 让 agent loop 直接交换 token id,把模型生成与工具输出的 token 追加进共享缓冲区,训练器直接拿到这个缓冲区加 policy mask;上下文压缩后的新前缀只在 session 开始时分词一次,避免解码—重编码循环。
它与 R3 共同构成解决 rollout–trainer 失配的两大手段,是本文 RL 基础设施区别于普通 GRPO 实现的地方。
可验证奖励与中间验证目标链
RL 需要程序化判断对错。本文除最终答案正确性 $F(\tau;y)$ 外,还把数据构造阶段算出的中间实体/数值链 $z$ 保留下来,按依赖顺序逐项检查 $b_j(\tau;z)$,进度定义为 $P(\tau;z)=\frac{1}{m}\sum_{j=1}^{m}\prod_{\ell=1}^{j}b_\ell(\tau;z)$——后续步骤只有全部前置都通过才得分,防止跳步蒙混。
奖励函数(式4、式5)是全文 RL 设计的核心,而 $z$ 从哪来、为什么可信,必须先理解 Stage II 的确定性任务构造才能明白。
研究动机
当前领先智能体模型的训练管线日益臃肿:通常包含持续预训练或 mid-training、多个专项 SFT 阶段、DPO、on-policy 蒸馏(OPD)与强化学习等环节。例如 MiroThinker-1.7 组合了 agentic mid-training、SFT、偏好优化与 RL,Agents-A1 依赖长程监督和按领域路由的在线蒸馏。环节不断叠加带来三个实际困难:其一,难以判断哪些成分真正贡献了能力,消融与归因成本极高;其二,复现代价大,训练配方难以迁移到其他底座模型;其三,许多所谓「开源」模型只发布权重,数据构造、过滤、验证、提示词和训练代码全部缺席,社区拿得到成品却看不懂制造过程。这使开源智能体研究长期停留在「有权重、无配方」的状态,也让人无法回答一个根本问题:这些复杂环节里到底哪些是必要的。
本文的目标是作者提出一个朴素但尖锐的问题:造一个强而广的智能体基座模型,最少需要哪些训练环节?答案是只保留「两个轻量 SFT + 一段 RL」的三阶段配方,明确不使用 dedicated mid-training、DPO 和 OPD。具体目标包括:构造两条互补的 SFT 数据管线,分别培养自足推理(Stage I,约 10.8K 条轨迹)与工具依赖推理(Stage II,约 7.5K 条轨迹);在其上用 GRPO 强化长程工具交互;在 HLE、BioMysteryBench、SEAL-0、HiPhO、FrontierScience(Olympiad/Research)六个基准上与 GPT-5.6 Sol、Gemini 3.1 Pro、Claude Opus 5、Agents-A1 等开放与专有模型直接对比;并将数据构造、生成、过滤、验证、提示词与训练代码全部开源,使整个开发过程可复现、可检查、可扩展。
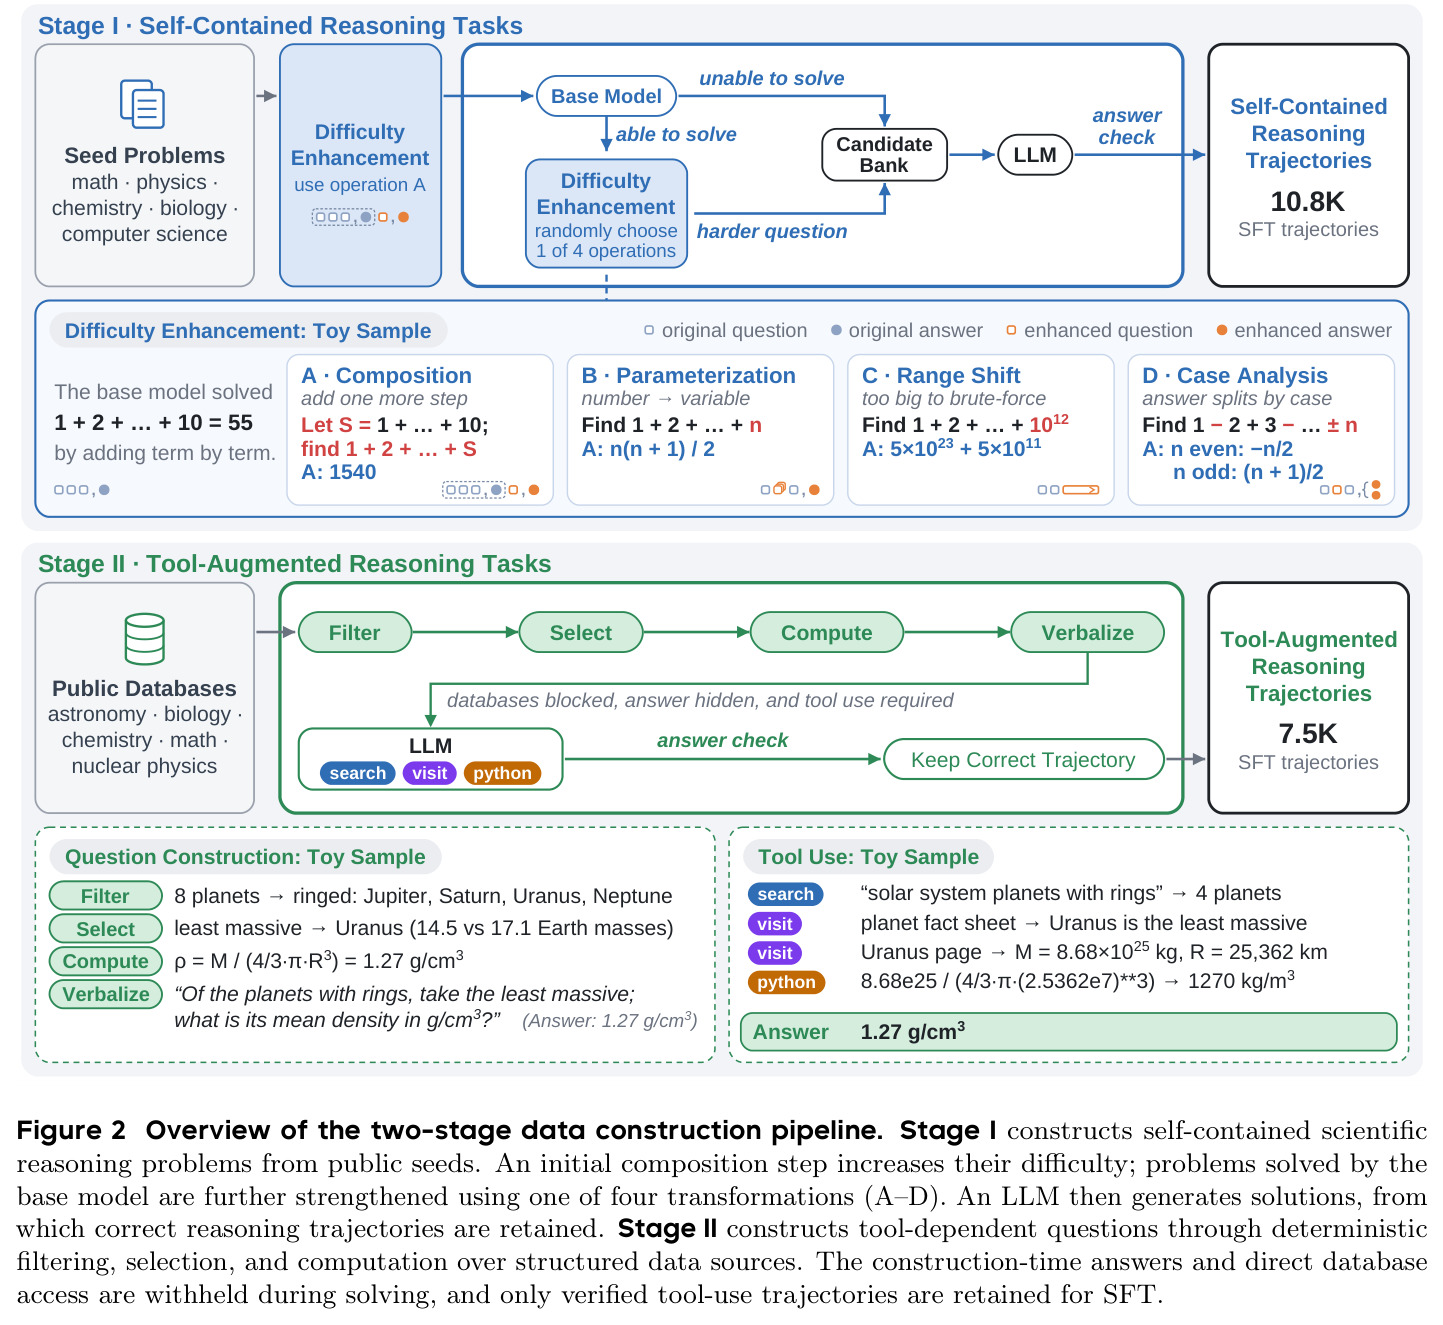
与已有工作不同的是,本文的独特立场是把复杂性从训练管线转移到数据构造上——「简化训练不等于简化学习问题」。与 Evol-Instruct 式盲目变难不同,Stage I 采用模型感知的难度增强:只有当基模型能解出某题时,才针对其成功解法随机施加持组合、参数化、范围平移、分类讨论四种操作之一继续加难,精准命中模型当前能力边界;参考答案须由 GPT-5.5 独立求解三次全部一致才被接受。与 QUEST、WebShaper 等先出题后验证的工作不同,Stage II 用 Filter-Select-Compute-Verbalize 的确定性程序在 LLM 见题之前就算出可验证答案,并屏蔽构造期数据库、剔除闭卷可解的题,强制任务真正依赖外部工具。这种「先有答案、后有题目」的路线,加上对训练侧 token/路由一致性的处理,构成了它区别于 MiroThinker、Agents-A1 等重管线方案的整体切入角度。
核心方法
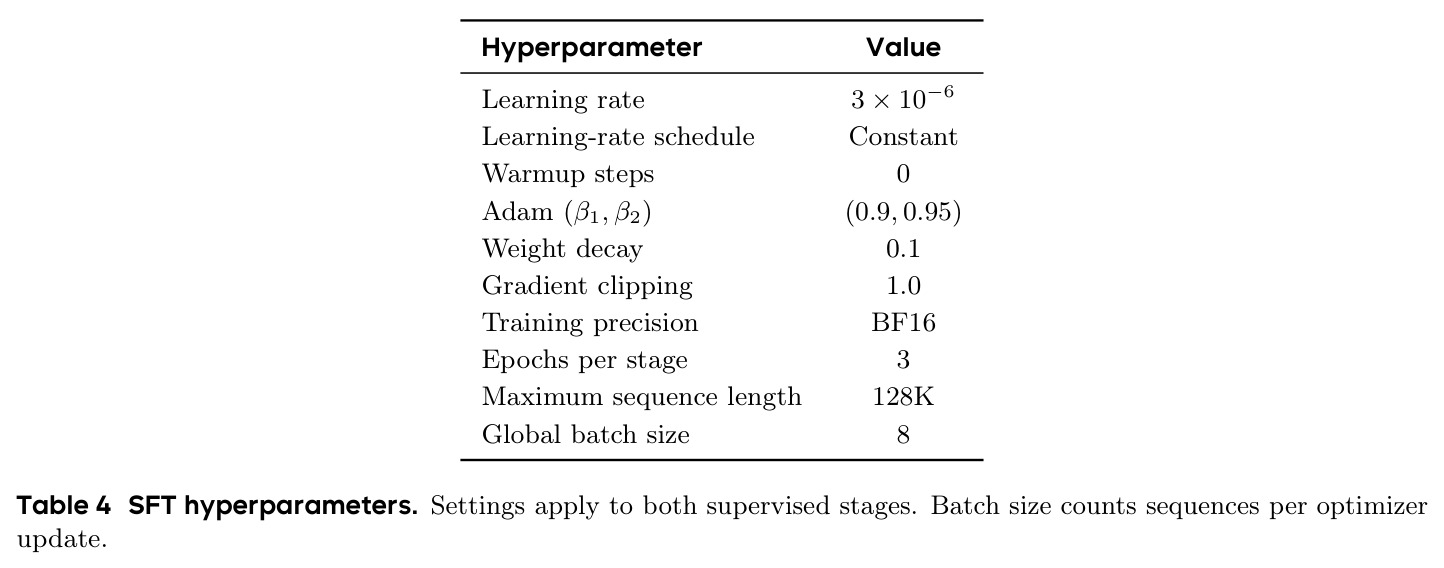
整体思路分三层。数据层:构造互补数据集 $D_{sc}$(自足推理,10.8K 条轨迹,可用 Python 禁搜索)与 $D_{ta}$(工具依赖推理,7.5K 条轨迹,需 search/visit/python),均先定题目与可验证答案、只保留解对的轨迹。训练层:Stage I 在 $D_{sc}$ 上全参数 SFT,损失只计 assistant token:$\mathcal{L}_{SFT}=-\sum_{j\in I_{asst}(\tau)}\log\pi_\theta(\tau_j|x,\tau_{<j})$;Stage II 自 Stage I 检查点继续在 $D_{ta}$ 上训练,学习率 $3\times10^{-6}$、各 3 epoch、序列最长 128K。强化层:从 Stage II 检查点用 verl 跑异步 GRPO,学习率 $2\times10^{-6}$、每题 8 条 rollout,奖励既看最终对错也按依赖链给中间进度分。直觉是把「教会推理」与「教会用工具」拆成两阶段循序渐进,再用 RL 巩固长程决策;全程无 mid-training、DPO、OPD。
核心创新有二。第一是模型感知的数据强化闭环:种子题先做一次组合增强,再用基模型测试(可用 Python、禁搜索),答错的直接进题库;答对的则把其成功解法喂给生成器,随机施加持组合 A、参数化 B、范围平移 C、分类讨论 D 四种操作之一继续加难——目标是增加推理量而非数字精度,且每次改写后答案都由 GPT-5.5 独立解三次全部一致才重新确立,病题直接丢弃。第二是「答案先于题目」的工具任务构造:Filter(条件筛选实体)→ Select(按极值准则唯一定位,要求与次优候选有足够边距防歧义)→ Compute(确定性公式算派生量,含单位换算)→ Verbalize(LLM 转自然语言但不得泄露实体与答案)。构造期数据库对求解模型封锁,闭卷能答对的题被剔除,配合奖励中的中间验证目标链 $z$,把监督信号精确压在「检索—取证—计算」上,而不是记忆答案。
方法步骤详情
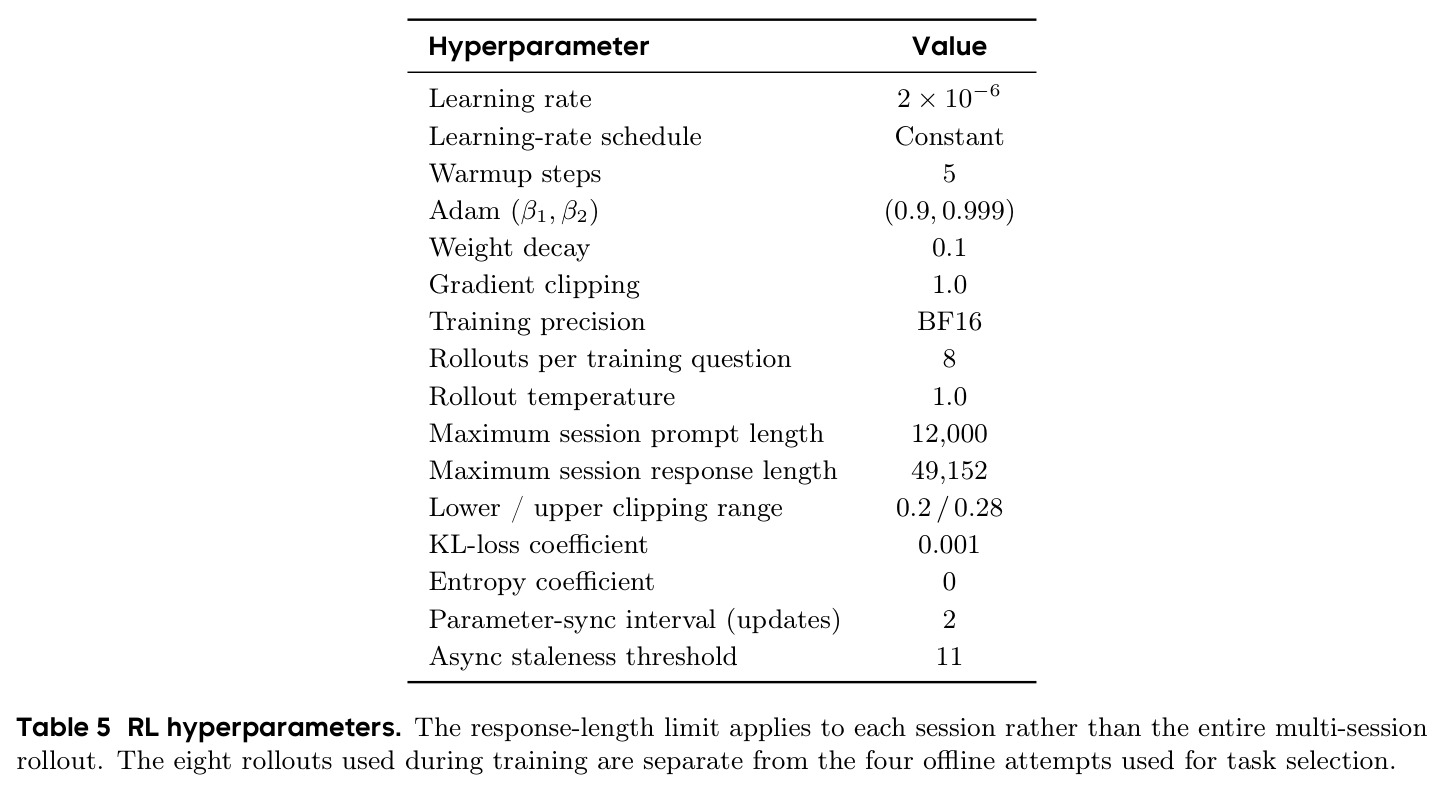
步骤一(Stage I):收集数理化生/计算机公开种子题,生成器 LLM 先用组合操作加难;基模型测试,答错的入池,答对的将其解法喂回生成器,再随机施加持 A、参数化 B、范围平移 C、分类讨论 D 之一;GPT-5.5 独立解三次全一致才确立答案;LLM 生成轨迹,只留正确者,得 10.8K 条 $D_{sc}$。步骤二(Stage II):对结构化数据库执行 Filter→Select→Compute 得到唯一答案,LLM verbalize 成题并检查约束丢失;封锁构造库、剔除闭卷可解题;LLM 带工具求解,按精确/容差校验后保留 7.5K 条 $D_{ta}$ 及中间目标 $z$。步骤三(SFT):全参数、样本打包、最长 128K,仅 assistant token 计损,各 3 epoch。步骤四(RL):异步 GRPO,答对 $R=1$,否则 $\max(0, 0.3P-0.1(1-A))$;筛题要求至少 1/4 条正确且方差非零。步骤五(基础设施):SFT 用 Megatron-FSDP(专家并行8、上下文并行4);RL 用 verl+vLLM,配 TITO 与 R3。
技术新颖性
技术新颖性有四点。其一,难度增强方向由基模型成败信号驱动:与 Absolute Zero、Agent0 的自博弈课程相比,本文专门针对「基模型能做对」的题、沿它自己的成功策略施加四种确定性变换,难度增长可控且答案仍可独立验证。其二,出题权交给确定性程序:参考答案在 LLM verbalize 之前就由程序算好,从根上避免合成数据答案不可信的问题,与 TaskCraft、WebShaper 先出题后验证的路线有本质区别。其三,RL 奖励把中间验证目标组织成依赖链,只有前置步骤全过后续才得分($\prod_{\ell\le j}b_\ell$),既给部分 credit 又防跳步,不提交答案另有 $-0.1$ 惩罚。其四,系统层面用 TITO 直接交换 token id 消除 BPE 重编码误差、用 R3 重放 MoE 专家路由,把 rollout–trainer 平均对数概率差从 0.044 降到 0.042、PPO KL 从 0.0413 降到 0.0396。这一切都在三阶段、无 mid-training/DPO/OPD 的约束下完成,本身就是对管线复杂度必要性的证伪。
实验结果
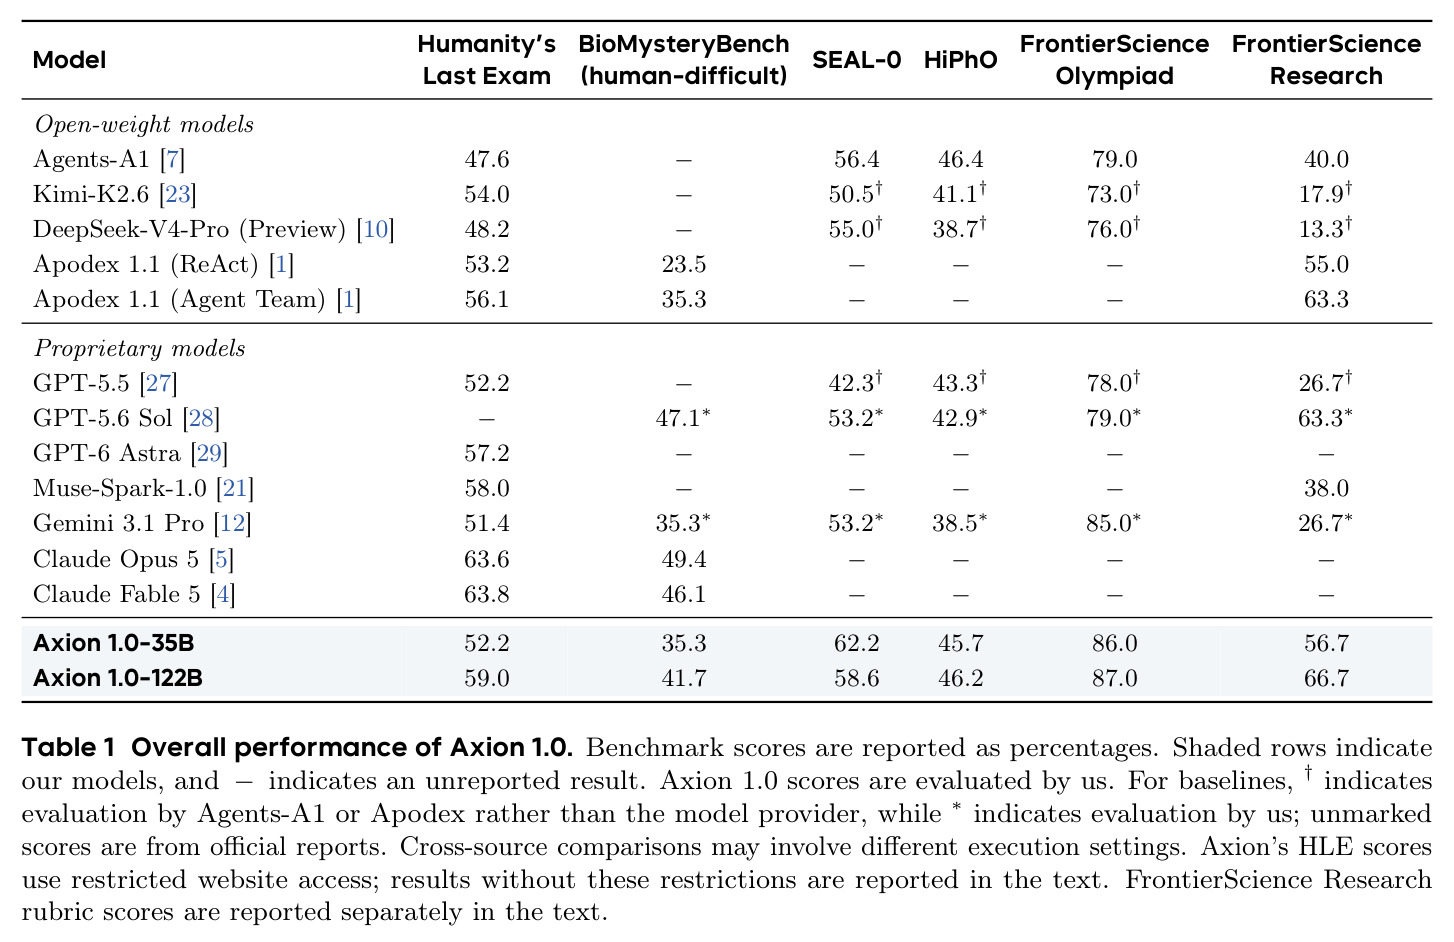
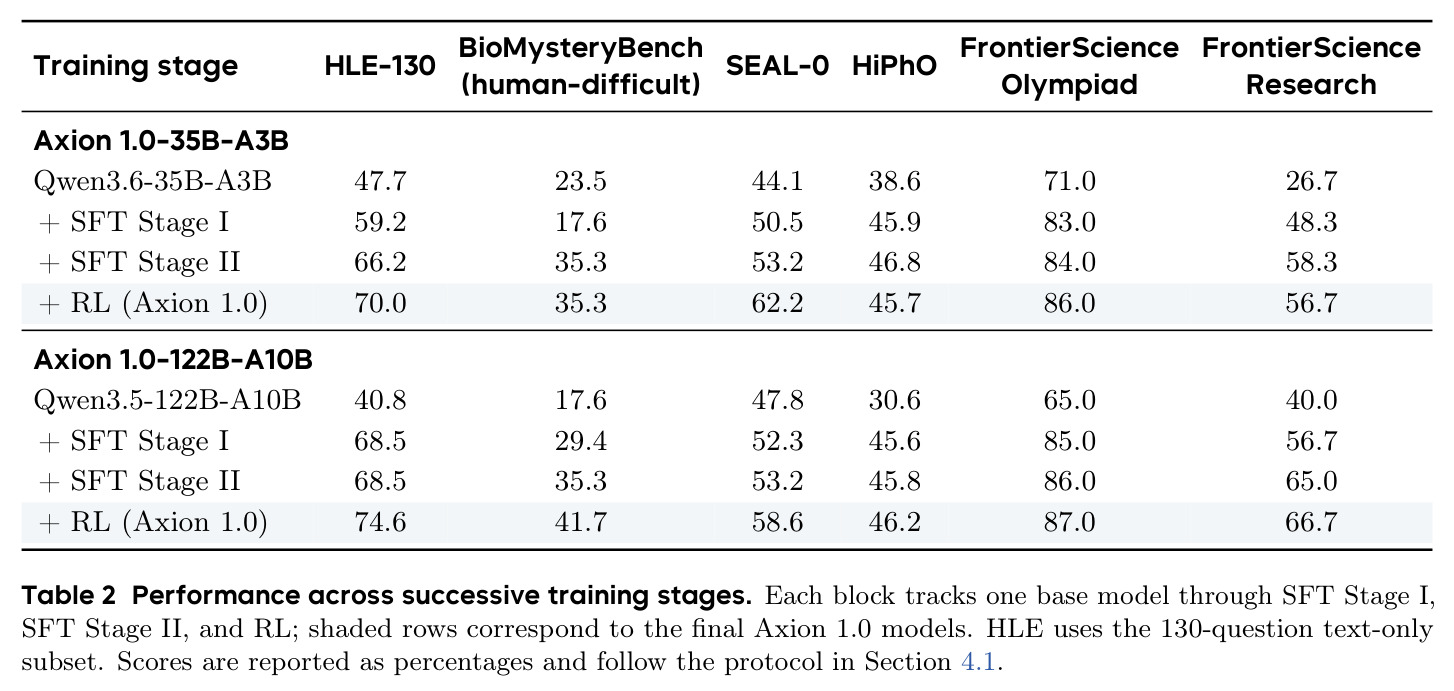
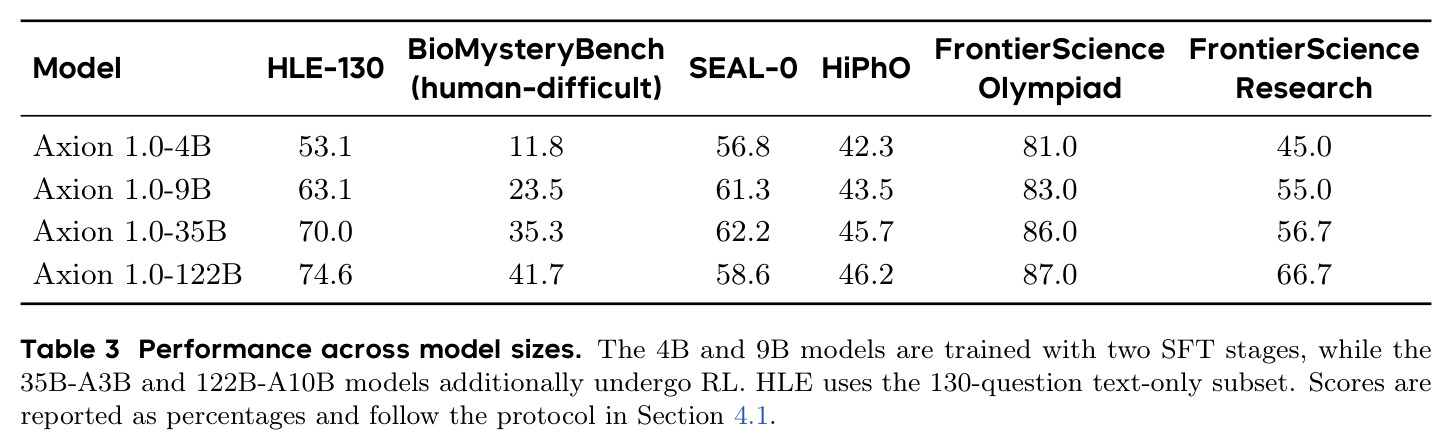
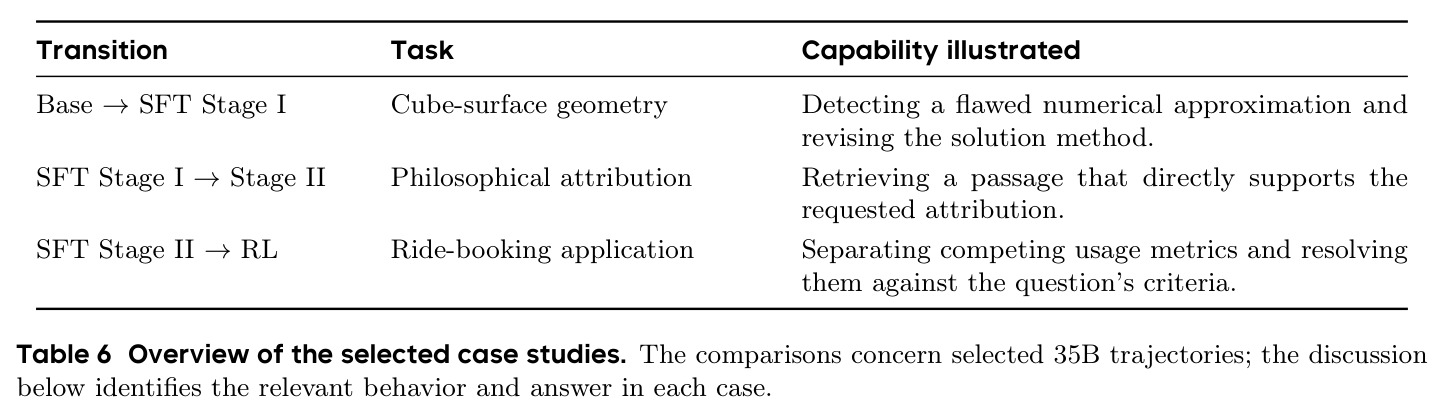
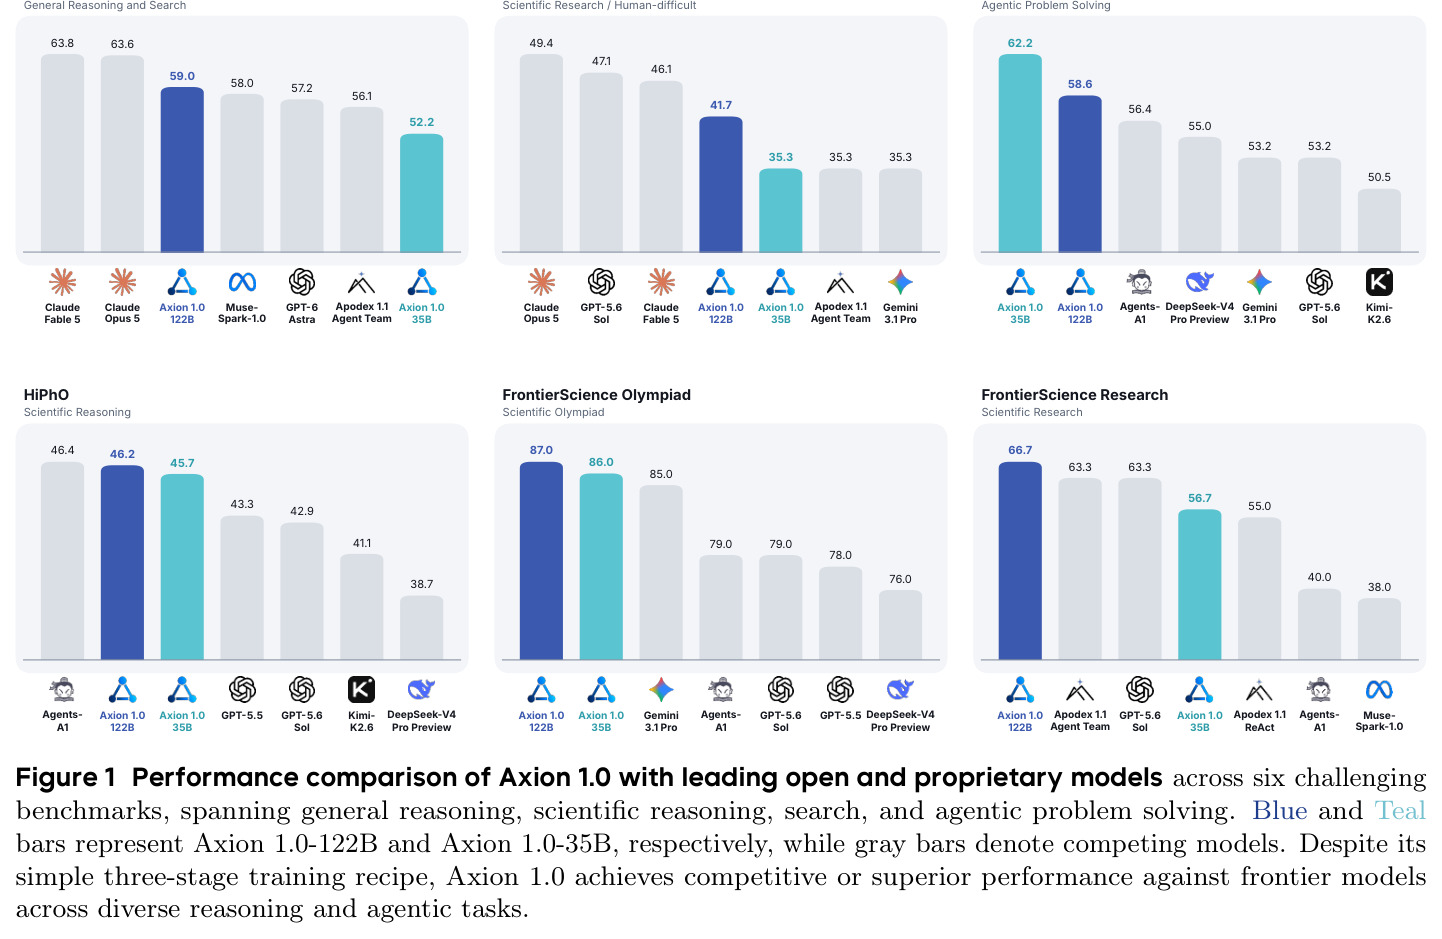
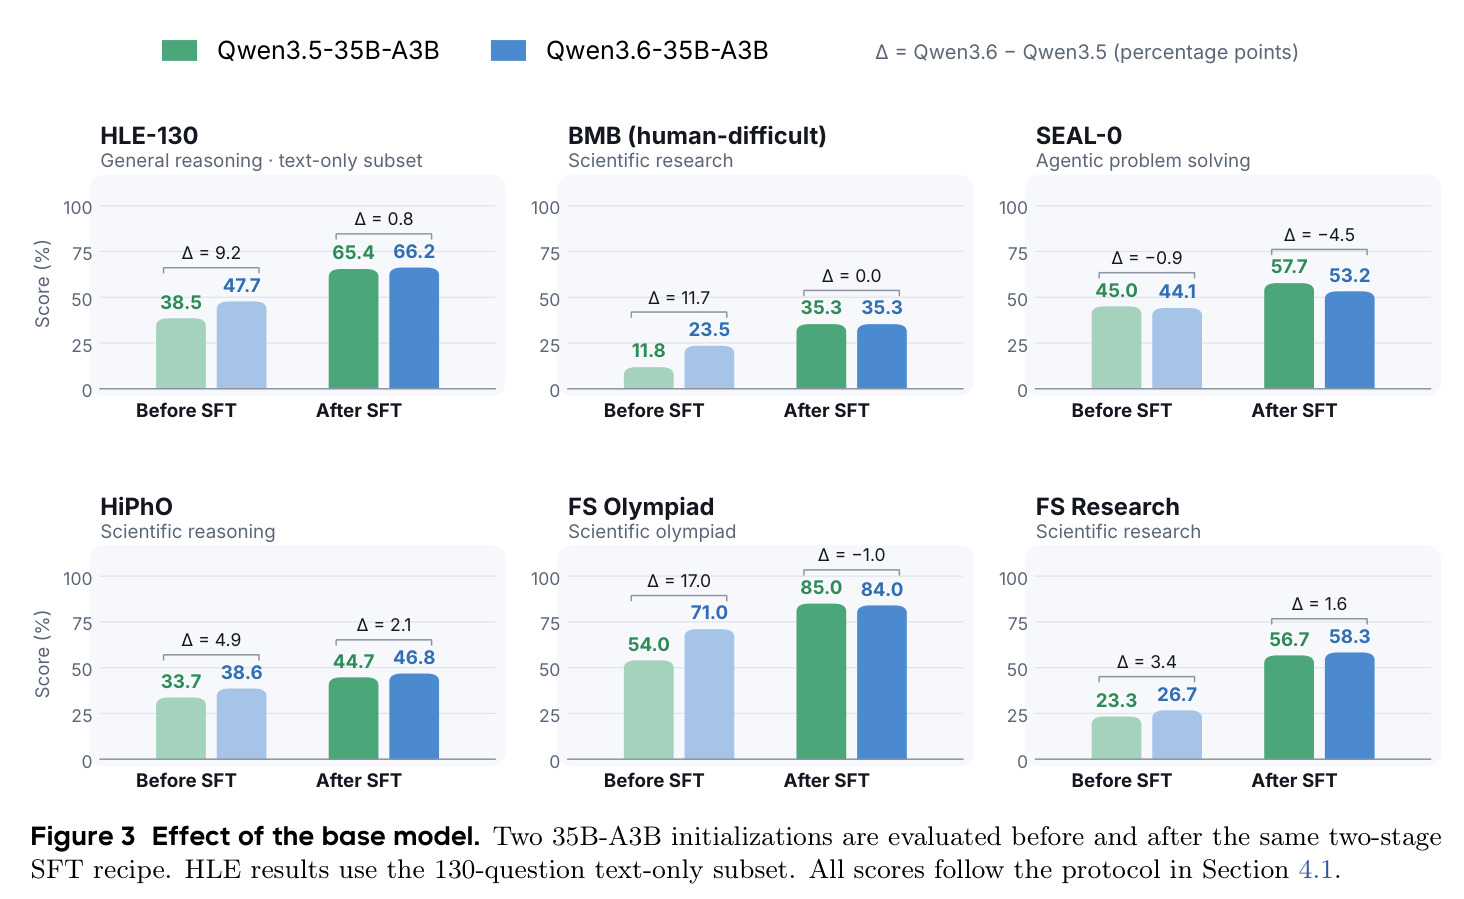
六个基准上,122B 取得 HLE 59.0%、BMB(human-difficult) 41.7%、SEAL-0 58.6%、HiPhO 46.2%、FS Olympiad 87.0%、FS Research 66.7%。对比同量级开源 Agents-A1,35B 在 HLE 52.2(+4.6)、SEAL-0 62.2(+5.8)、FS Olympiad 86.0(+7.0);FS Research 上 122B 的 66.7% 超 GPT-5.6 Sol 的 63.3% 与 GPT-5.5 的 26.7%。分阶段消融(HLE-130)显示增益主要来自 SFT:122B 从基座 40.8→Stage I 68.5→RL 74.6,35B 依次 47.7→59.2→66.2→70.0;35B 的 BMB 经历 23.5→17.6→35.3→35.3 的起伏,印证 Stage II 的作用。规模上,4B→9B→35B→122B 的 HLE-130 为 53.1→63.1→70.0→74.6。R3 消融:对数概率差 0.044→0.042,HLE-130 74.6 vs 72.3。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Humanity's Last Exam(专家级综合推理) | 准确率 %(屏蔽部分网站的受限设置) | Axion 1.0-122B 59.0 / 35B 52.2(无限制时 64.8 / 59.1) | Claude Fable 5 63.8、Claude Opus 5 63.6、Agents-A1 47.6 | 较同规模 Agents-A1 提升 4.6 个百分点,仍落后 Claude 旗舰 4.6–4.8 |
| SEAL-0(信息检索型智能体解题) | 准确率 % | 35B 62.2(全场最高)、122B 58.6 | Claude Opus 5 56.4、Agents-A1 56.4、GPT-5.6 Sol 53.2 | 较最强基线 +5.8 个百分点;注意 35B 反而高于 122B |
| FrontierScience Research(科研型开放评分) | 得分 %(另报 rubric 均分 6.67/7.09) | 122B 66.7、35B 56.7 | GPT-5.6 Sol 63.3、Apodex 1.1 (Agent Team) 63.3、Agents-A1 40.0、GPT-5.5 26.7 | 122B 超 GPT-5.6 Sol 3.4 个百分点,约为 Agents-A1 的 1.67 倍 |
| FrontierScience Olympiad(科学奥赛) | 准确率 % | 122B 87.0、35B 86.0 | Gemini 3.1 Pro 85.0、Agents-A1 79.0、GPT-5.5/5.6 Sol 78.0/79.0 | 较同规模 Agents-A1 +7.0,小幅领先 Gemini 3.1 Pro |
| BioMysteryBench human-difficult(真实生物数据分析) | 准确率 % | 122B 41.7、35B 35.3 | GPT-5.6 Sol 47.1、Claude Fable 5 46.1、Claude Opus 5 49.4 | 落后最强专有模型 5.4–7.7 个百分点,是六项中唯一明显劣势 |
| HiPhO(物理奥赛) | 准确率 % | 122B 46.2、35B 45.7 | Agents-A1 46.4、GPT-5.6 Sol 42.9、GPT-5.5 43.3 | 与 Agents-A1 基本持平(-0.2),超 GPT 系列 3 个百分点左右 |
局限与改进
作者坦承的局限:其一,BMB 上 122B 的 41.7% 仍落后 GPT-5.6 Sol 的 47.1% 和 Claude Fable 5 的 46.1%;SEAL-0 出现规模反常,35B(62.2%)反而高于 122B(58.6%);RL 对部分基准有回退,35B 的 HiPhO 从 46.8% 降到 45.7%、FS Research 从 58.3% 降到 56.7%。其二,评估协议取多次运行的单次最佳而非平均,且跨源基线的工具与执行设置不统一,作者自己声明对比只是 indicative;HLE-130 子集分数不可与全量 HLE 直接比较。我的补充:训练阶段对比是顺序检查点而非成分消融,无法严格回答「加回 DPO 会怎样」;附录 B 案例是挑选的轨迹,不代表所有 rollout;35B 与 122B 底座不同(Qwen3.6 vs Qwen3.5)且数据规模不同,规模效应与底座效应混杂,SEAL-0 倒挂的根因未被定位;R3 的增益也因异步过期与上下文压缩的 off-policy 效应而难以因果归因。
独立分析的弱点
独立来看有几处弱点。第一,数据管线深度依赖 GPT-5.5:既当难度增强的生成参考,又是答案三票验证的唯一裁判,还隐性决定「什么算病题」,开源配方的质量上限被闭源教师卡住;改进方向是引入多裁判交叉验证,或用可执行检查替代 LM 裁判。第二,任务域集中在科学问答式的检索—计算,缺少软件工程、长程规划类环境(论文未报 SWE-bench、Terminal-Bench 等),「广义智能体」的声明证据不足;可把 Filter-Select-Compute 管线推广到代码仓库、表格、仿真器等可执行环境。第三,奖励权重 0.3(中间进度)与 0.1(不提交惩罚)是手工常数,未做敏感性分析;可改为随训练动态调整或经小型搜索确定。第四,RL 筛题要求「4 条采样至少 1 条正确」,会把过难题全部筛掉,课程上可能浪费最难的数据;可用动态通过率阈值或课程式放行。第五,Stage I 使 35B 的 BMB 从 23.5% 跌到 17.6%,说明纯自足推理数据会挤压数据密集型能力,两阶段数据的配比与穿插方式值得系统研究。
未来方向
作者提出的方向:发布完整配方供社区复现与扩展,检验这一简单范式能否迁移到其他底座与领域。基于成果可延伸的研究包括:把模型感知难度增强与 RL 任务筛选闭合成随训练动态演进的自动课程;将确定性任务构造推广到数据库之外的环境(代码仓库、实验模拟器、机器人状态),使「答案先于题目」原则覆盖更多智能体形态;深入研究 TITO 与 R3 在更大规模、更长 rollout 下的稳定性边界——论文已指出 R3 虽降低平均梯度范数(1.998→1.922)但最大梯度尖峰反而从 21.1 升到 26.8、奖励标准差上升 15%,偶发不稳定尚未消除;探索 mid-training 与三阶段配方的互补性,检验「省略 mid-training」在不同底座上是否普遍成立;以及把中间验证目标链扩展为开放性任务的 rubric 化奖励,与 QUEST 的方向对接。
复现评估
复现条件相当友好但非零门槛。开源范围是真正的全量:数据构造与生成代码、过滤与验证逻辑、全部提示词、SFT/RL 训练代码均公开,底座用公开的 Qwen3.5-122B-A10B 与 Qwen3.6-35B-A3B。算力上,SFT 阶段 122B 在 32 卡上共 7 小时 30 分(约 240 GPU 时,峰值显存 113 GiB/卡),35B 约 90 GPU 时(101 GiB/卡),普通实验室可承受;RL 阶段需要 40 卡 rollout(10 个 TP4 vLLM 引擎)+ 16 卡 trainer + 服务节点(2 个 Qwen3.8-27B 裁判与 6 个 Qwen3.5-9B 网页摘要/上下文压缩实例),总计 60 卡以上并依赖 verl/vLLM/Megatron 栈。数据管线的 GPT-5.5 三票验证会带来 API 成本,数据库与种子题均为公开来源。综合难度中等:SFT 级复现难度低,RL 级需要多节点异步系统工程经验,但配方与超参(表4/表5)完整公开,属于开源智能体工作里复现性最好的梯队。
论文图表