AnchorComplete:从部分点云恢复完整场景网格 AnchorComplete: Recovering Complete Scene Meshes from Partial Point Clouds
以点云为条件锚定生成先验,用固定物理尺寸窗口粗到细补全任意尺度场景网格
前置知识
TRELLIS 与结构化潜变量(SLAT)两阶段生成
TRELLIS 是基础 3D 资产生成模型,把 3D 资产表示为结构化潜变量:先用结构 VAE 把稠密二值体素占用网格压缩为结构潜变量 $z_s$,由流 transformer 生成粗布局;再在活动体素支撑上用 SLAT VAE 生成局部几何与外观潜变量,解码为网格、高斯泼溅等多种表示。本文基于其升级版 TRELLIS.2,第二阶段改用 O-Voxel 形状潜变量。
本文的全部架构改动(点条件化、多级窗口生成)都搭建在 TRELLIS.2 的两阶段流水线上,不理解这套“先生成占用结构、再生成形状潜变量”的流程就无法看懂方法设计。
整流流(Rectified Flow)
一种生成式采样框架:训练时在数据 $z_0$ 与高斯噪声 $\epsilon$ 之间做线性插值 $z_t=(1-t)z_0+t\epsilon$,网络学习预测速度 $v_\theta(z_t,c_p,t)\approx(\epsilon-z_0)$;推理时从噪声出发沿速度场积分少量步数即可采样。本文两个去噪器均以整流流训练,推理每阶段仅需 12 步,并配合分类器无关引导(CFG)。
论文的训练损失(公式3)、warm start 初始化(公式1、2)和 CFG 引导尺度都定义在整流流框架下,需要理解 $z_t$ 插值和速度预测才能读懂这些公式。
前馈 3D 重建与部分点云
DUSt3R 及其后续(MASt3R、VGGT、DA3、CUT3R、PI-3 等)从无位姿图像集合一次前向回归稠密像素对齐点图,快速得到场景点云;DROID-SLAM、VGGT-SLAM 等在线 SLAM 系统在估计轨迹的同时输出稠密几何。这类方法只重建相机可见表面,未观测区域留下大片空洞,其输出就是“部分点云”。
本文的输入正是这些重建器的输出,论文的问题设定、评价指标(CDvis 只算可见区域)与主要对比基线(DA3 等)全部围绕这一生态展开。
交叉注意力条件注入与 Q-Former
Q-Former 用少量可学习查询向量 $F_q$ 对输入特征 $F_{(k,v)}$ 做交叉注意力(查询为 Q、输入特征为 K/V),把任意长度的输入压缩成固定数量的 token(本文 $m=768$ 个锚定 token $c_p$),供生成模型的 transformer 通过交叉注意力读取。这是把点云这类变长输入接入 DiT 的常用手段。
本文“全局路径”的锚定 token 编码器就是冻结 Utonia 点编码器加 4 层 Q-Former,是方法两大组件之一,消融实验专门验证了它的贡献。
固定物理尺寸窗口的粗到细生成
先用覆盖全场景的单个归一化立方体生成整体布局(Level 0),再在占用空间上摆放固定物理尺寸的窗口(Level 1、2,每级窗口宽度减半),每个窗口只细化自己那块区域。由于每级窗口的网格分辨率固定($512^3$),单元的物理尺寸不随场景大小变化,椅子腿、梯子横档等细结构在任何场景尺度都能被解析。
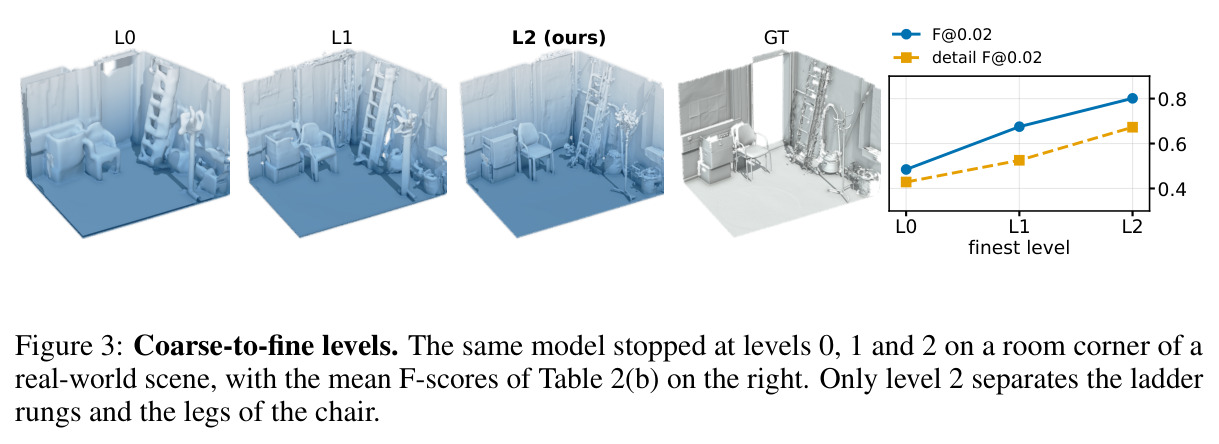
这是本文解决“场景越大细节越糊”这一归一化立方体固有问题(约束)的核心机制,Figure 3 与 Table 2(b) 直接量化了每一级带来的增益。
Chamfer Distance 与补全版 F-score
Chamfer Distance 衡量预测点集与真值点集间的平均最近邻距离,可拆成 accuracy(预测到真值)与 completeness(真值到预测)。本文的 $F_\tau$ 是非对称补全版:precision 只在输入视锥内的预测点上计算(视锥外生成区域天然多模态,不罚精度),recall 覆盖整个场景真值;$F_{0.05}$ 表示阈值 0.05 米。
论文所有主表都用 CDvis/CDall/F0.1/F0.05 报告结果,不理解这些指标的定义(尤其精度只算可见区域)就会误读数字的含义。
研究动机
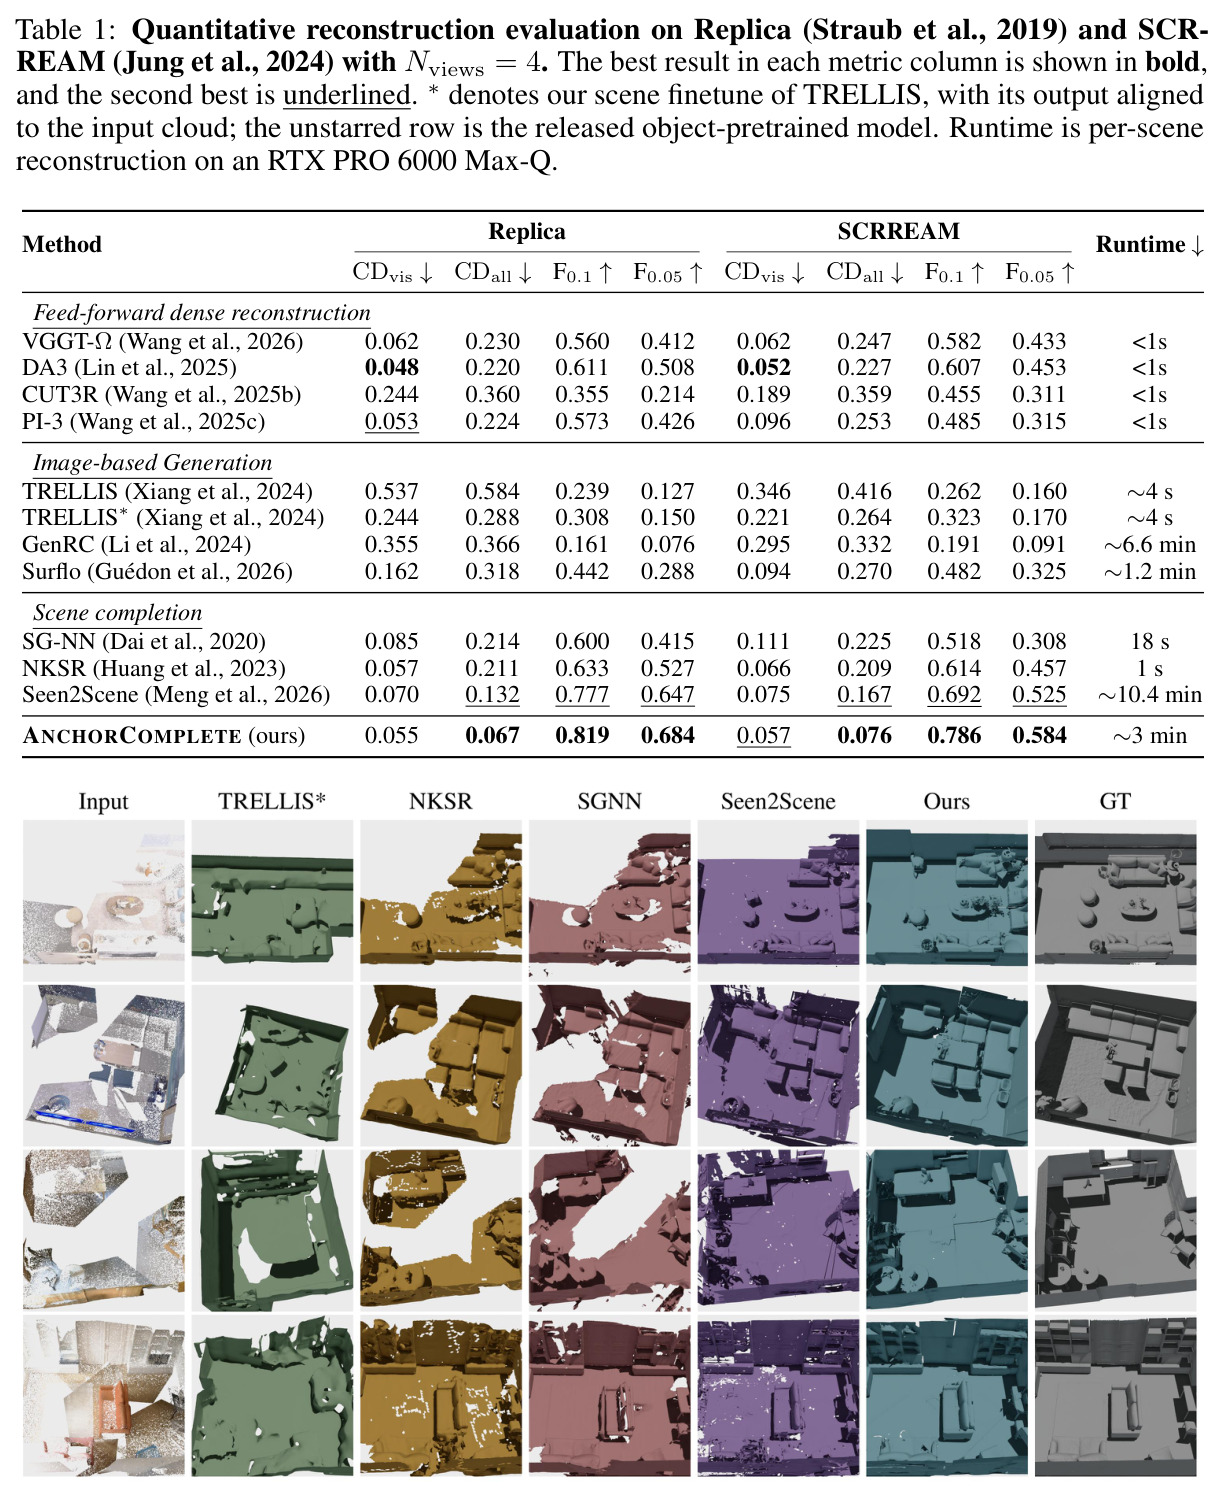
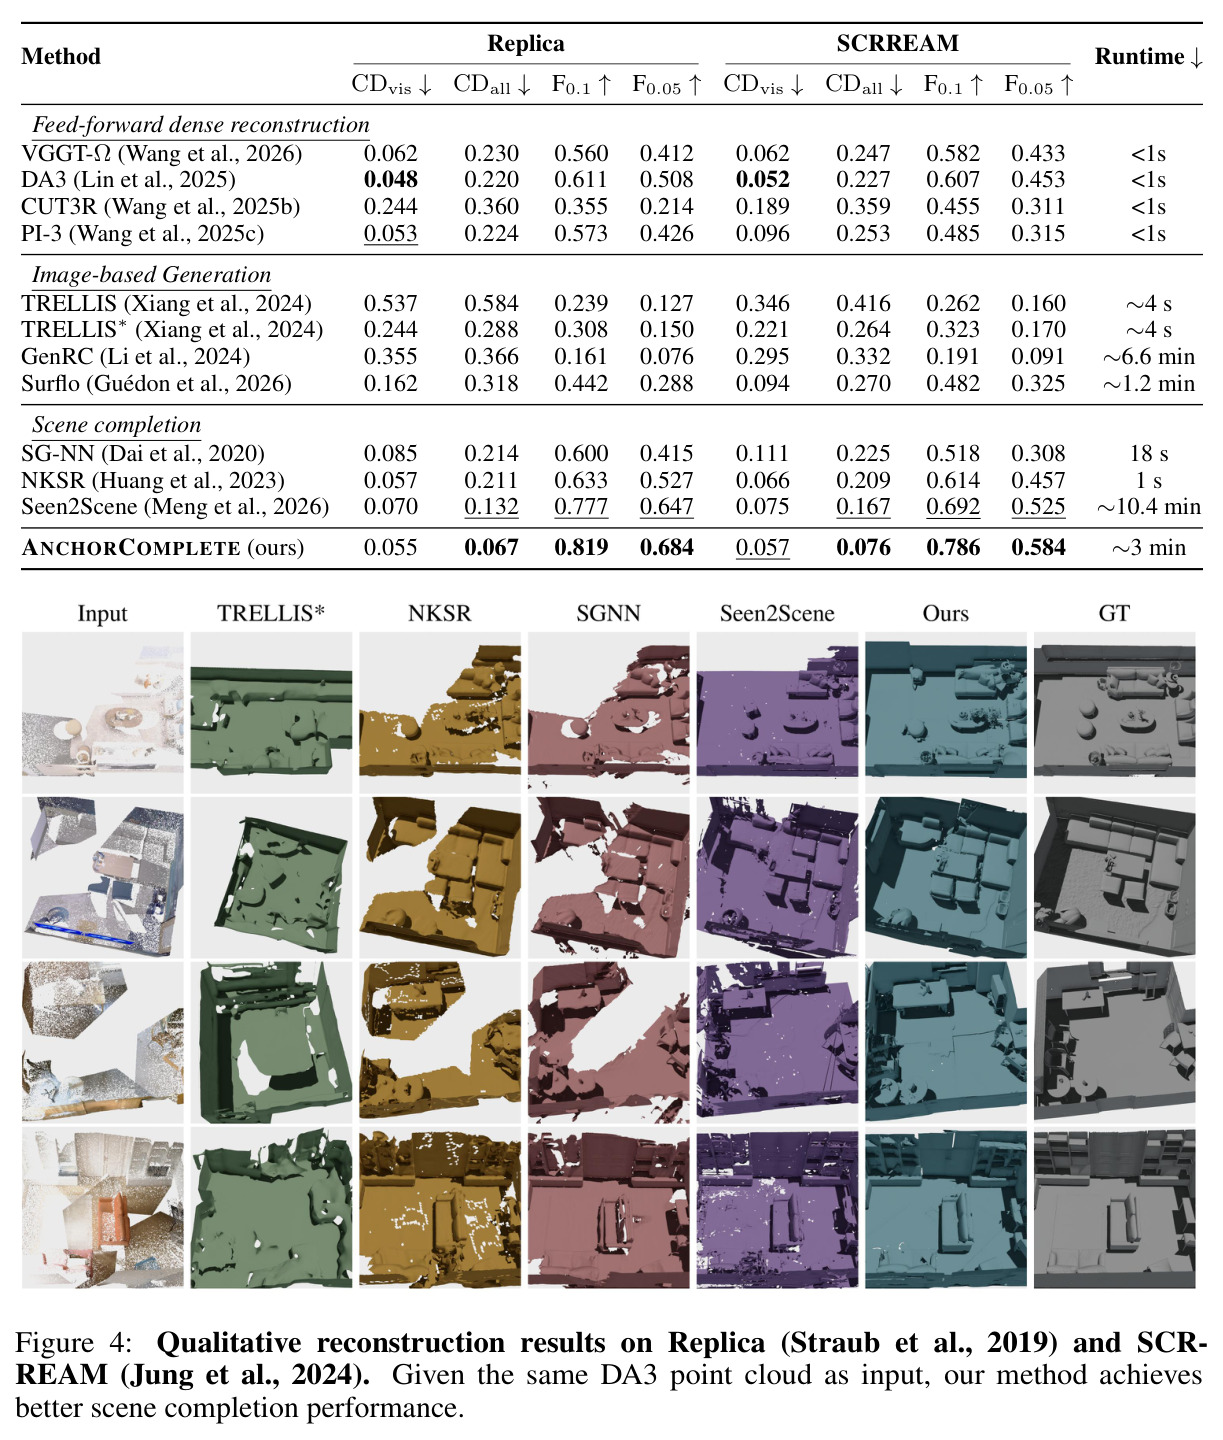
主流 3D 重建管线只会“看见什么重建什么”。DUSt3R 系列前馈重建器(VGGT-Ω、DA3、CUT3R、PI-3)和 DROID-SLAM、VGGT-SLAM 等 SLAM 系统虽能在一次前向中从稀疏图像回归稠密点云,但补全不在其公式化之内,未观测区域留下大片孔洞,限制了 AR/VR 新视角渲染、大规模物理仿真、机器人碰撞检测等下游应用。已有补全工作各有短板:早期方法(PCN、PointR、SeedFormer 等)针对归一化坐标空间中的单个物体,无法扩展到场景级输入;Amodal3R、SAM 3D、ShapeR、CoLa3D 等把基础 3D 生成器扩展到遮挡几何,但主要做归一化空间的单物体补全,不直接以部分点观测为条件,无法保证忠实于相机实际看到的几何;PaSCo、NOVA3R、Seen2Scene 等场景补全方法只在给定视场内补全,不考虑相机视野外的几何,且输出点云或体素网格而非可直接使用的完整网格。论文用 4 视角输入在 Replica 上实测:最好的前馈重建器 DA3 的 CDvis 为 0.048 但 CDall 高达 0.220,F0.05 仅 0.508——可见区域质量与全场景完整性之间的差距就是“补全缺口”。
本文的目标是目标是从部分点云 $P$(可来自前馈重建、SLAM 或 3D 扫描)直接生成完整场景网格 $M$,同时解决两个耦合挑战。其一是忠实性:生成必须锚定在观测几何上,不能像纯生成先验那样自由发挥——论文中未做点条件化的 TRELLIS* 在 Replica 上 CDvis 高达 0.244,会生成一个与输入无关的房间。其二是可扩展性:补全要能适配任意物理尺寸的场景,从 7.8×4.7 米的单房间到 24.2×25.6 米的两层住宅,网格单元的物理分辨率保持恒定,椅子腿、梯子横档等细结构不因场景变大而消失。此外整个过程不需要稠密采样的带位姿图像、不需要定向法线、不需要逐场景优化,输出直接落在原始场景坐标系中,可直接用于下游应用。
与已有工作不同的是,独特切入角度有二。其一是条件选择:不同于图像条件的 3D 生成器,本文直接以原始场景尺度的部分点云为条件,作者论证了四点优势——观测点划定了可见边界,提供“哪里需要补全”的直接几何证据;条件本身就在 3D 几何空间,天然保证对可见几何的忠实度;点云可均匀降采样到固定大小 $N$,条件成本不随输入图像数量增长;点输入可分块处理以支持可扩展的局部处理,输出可在同一场景坐标系直接合并。其二是尺度处理:与其把整个场景归一化进一个立方体(单元物理尺寸随场景增大而变粗),不如把“布局”与“细节”解耦——Level 0 看全局,Level 1/2 用固定物理尺寸的窗口逐块细化,模型本身永远不需要知道场景有多大。选择在 TRELLIS.2 这一强生成先验上做最小但关键的架构适配,而非从头训练场景补全网络,是该文区别于 SG-NN、Seen2Scene 等自监督补全路线的关键决策。
核心方法
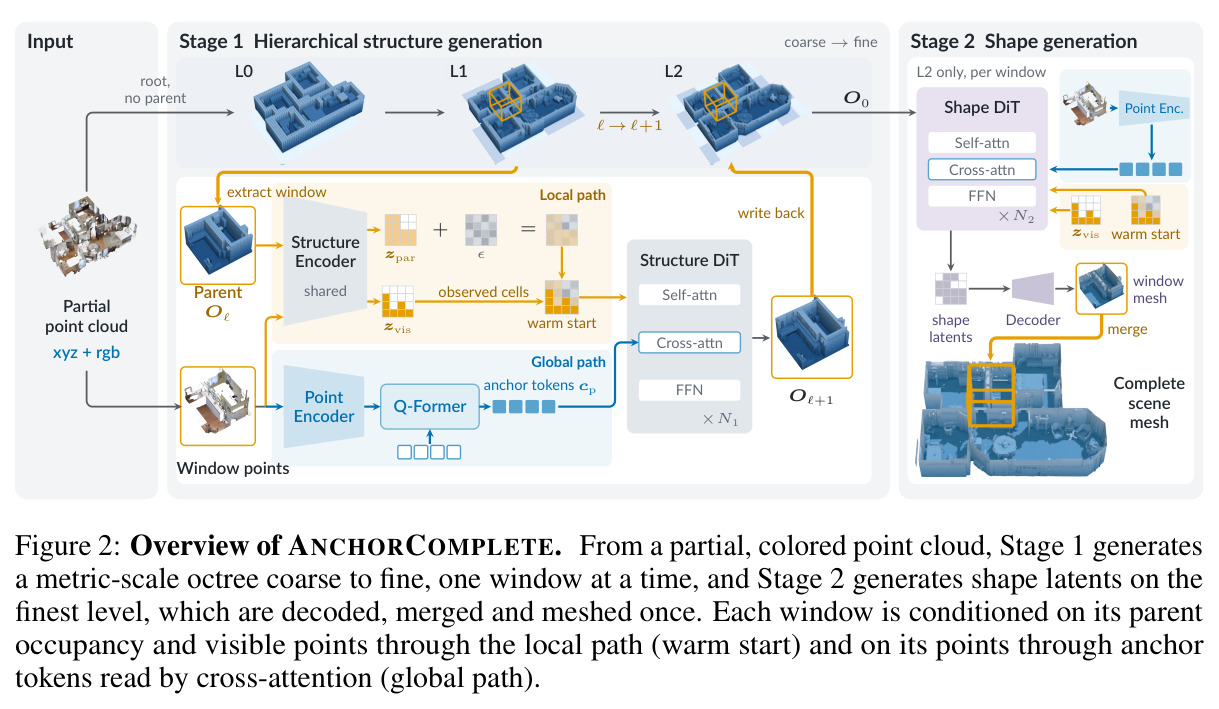
先说直觉:把一个“见过无数完整房间”的 3D 生成先验(TRELLIS.2)拉来补全真实场景,关键在两件事——告诉它“哪些地方是真的、不许乱动”(锚定),以及“场景再大细节也不能糊”(尺度)。技术上,AnchorComplete 保留 TRELLIS.2 的两阶段整流流流水线:Stage 1 在 $16^3\times8$ 的稀疏结构潜变量空间生成占用布局,解码为 $64^3$ 占用网格再最大池化到 $32^3$ 支撑;Stage 2 在该支撑上生成 32 通道 O-Voxel 形状潜变量,解码后在 $512^3$ 网格上提取网格。两个去噪器均为 30 块 DiT(1536 通道、12 头注意力、RoPE),条件从原来的图像/文本 token 换成 768 个点云锚定 token。锚定靠双路径:全局路径用冻结 Utonia 点编码器加 4 层 Q-Former 把观测点压成 $c_p\in\mathbb{R}^{768\times C_{xa}}$ 供交叉注意力读取;局部路径把观测点体素化为 $O_{vis}$,经冻结结构编码器得到 $z_{vis}$,既做采样起点又在每步拼接可见性 mask。尺度上采用度量尺度粗到细生成:Level 0 单立方体出全局布局,Level 1/2 用固定物理尺寸窗口细化,每个窗口继承父级 occupancy 做 warm start,最后在最细层把所有窗口解码合并、统一提取单一网格。
核心创新有两点,本质区别于已有方法。第一是部分点条件化的混合设计:全局锚定 token 提供场景级语义语境(这是什么房间、有什么家具),局部空间注入提供逐体素的观测证据。局部注入又分两招:warm start——采样起点不是纯高斯噪声,而是在可见体素处用 $z_{vis}$ 替换,即公式(1) $z_s^{(1)}=O_{vis,m}\odot z_{vis}+(1-O_{vis,m})\odot\epsilon$;以及每步去噪都把可见性 mask $O_{vis,m}$ 拼接到噪声潜变量上,让去噪器全程区分观测与未观测单元。消融显示去掉局部注入伤害最大(CDvis 从 0.055 涨到 0.072),去掉全局 token 伤害较小(0.060)。第二是度量尺度粗到细生成:窗口尺寸按物理大小(米)固定而非归一化比例,每级 $512^3$ 网格对应固定的厘米级单元尺寸;未观测区域的窗口从父级预测 warm start(公式2,$z_s^{(1)}=O_{vis,m}\odot z_{vis}+(1-O_{vis,m})\odot(\alpha z_{par}+\sqrt{1-\alpha^2}\,\epsilon)$,$\alpha=0.8$),主要是“锐化父级布局”而非重新发明房间;窗口重叠四分之一、只保留中心,相邻窗口因此对墙和家具的位置达成一致。这把网格分辨率与场景范围彻底解耦,是区别于 PaSCo/Seen2Scene 等“视场内补全”方法的根本点。
方法步骤详情
完整流程如下。输入:部分彩色点云(xyz+rgb),度量尺度模型还读取每点观测标志与预期深度噪声级。步骤一(条件编码):点云均匀降采样到 $N$ 个点,冻结的 Utonia backbone 逐点提取高维特征 $\{f_i\}$,4 层 Q-Former 用 $m=768$ 个可学习查询交叉注意力聚合成锚定 token $c_p$;同时把点体素化为二值网格 $O_{vis}$,用冻结结构编码器编出 $z_{vis}\in\mathbb{R}^{8\times16^3}$,下采样得到潜变量级 mask $O_{vis,m}$。步骤二(Stage 1 结构生成):以公式(1)(Level 0)或公式(2)(Level≥1,未观测处混合父级编码 $z_{par}$)做初始样本,12 步整流流采样(CFG scale 5,作用于 $t\in[0.6,1]$),每步拼接 $O_{vis,m}$;解码得 $64^3$ 占用,最大池化为 $32^3$ 活动坐标。步骤三(多级窗口):Level 1/2 在每个固定物理尺寸窗口内重复步骤一二,窗口内容取自输入点云的对应裁剪,父级 warm start 保证跨窗口布局一致,重叠四分之一只留中心。步骤四(Stage 2 形状生成):在最细层各窗口的活动支撑上生成 32 通道 O-Voxel 潜变量(12 步,CFG scale 3),观测体素处的初始样本取自可见点编码的形状潜变量,并带逐体素可见性标志。步骤五(解码合并):所有窗口解码到公共网格后合并,在 $512^3$ 网格上一次性提取完整场景网格,避免显式网格拼接。训练:在 InternScenes(约 1.6 万场景,水密 glTF 网格做完整监督)与 SAGE(约 7 千房间)上,用 BlenderProc 渲染 640×480、85° 水平视场的多视角 RGB-D,面积自适应布 1-9 个锚点加角落相机(每场景约 40-420 帧,平均 106 帧);每个样本裁一个窗口并取能看到它的 2-8 个视角的深度点,父级以 p=0.7 概率用模型预测、否则用损坏的真值,让模型学会纠正不完美父级。优化用 AdamW(学习率 $2\times10^{-5}$,权重衰减 0.01,每 GPU batch 1,10% 条件 dropout),两阶段各微调 4 万步(4 张 L40)。
技术新颖性
新颖性可从三个层面分析。问题层面:本文把“从部分点云补全完整场景网格”明确为一个新问题设定——不需要稠密位姿图像、定向法线或逐场景优化,并配套提出了基线与评价协议(精度只在视锥内计算,因为补全区域天然多模态、真值只是众多合法实现之一)。架构层面:把基础 3D 生成器适配为点条件场景补全器的两个组件都是新的——混合式部分点条件(全局 token + 局部 warm start + 全程可见性 mask 拼接)在 TRELLIS 这类两阶段生成器上是首次出现;固定物理尺寸窗口的八叉树粗到细生成把“单元物理分辨率恒定”作为硬约束,区别于 BlockFusion 等外推式方法或 chunk 式补全的窗口策略——尤其是父级 warm start(公式2)让细化窗口继承粗布局而非独立重采样,保证跨窗口结构一致。训练层面:父级混合策略(70% 模型预测 + 30% 损坏真值)显式训练模型“纠正不完美父级”,配合训练/推理一致的 warm start 与 mask 拼接,是系统能在真实不完美输入上工作的关键设计。与最近邻基线 Seen2Scene 相比,本文直接以原始点云为条件并输出原始坐标系中的完整网格,而 Seen2Scene 以 TSDF 体(1.1 cm 体素的 VDBFusion 融合)为输入、输出相对平坦缺乏家具起伏的结果。
实验结果
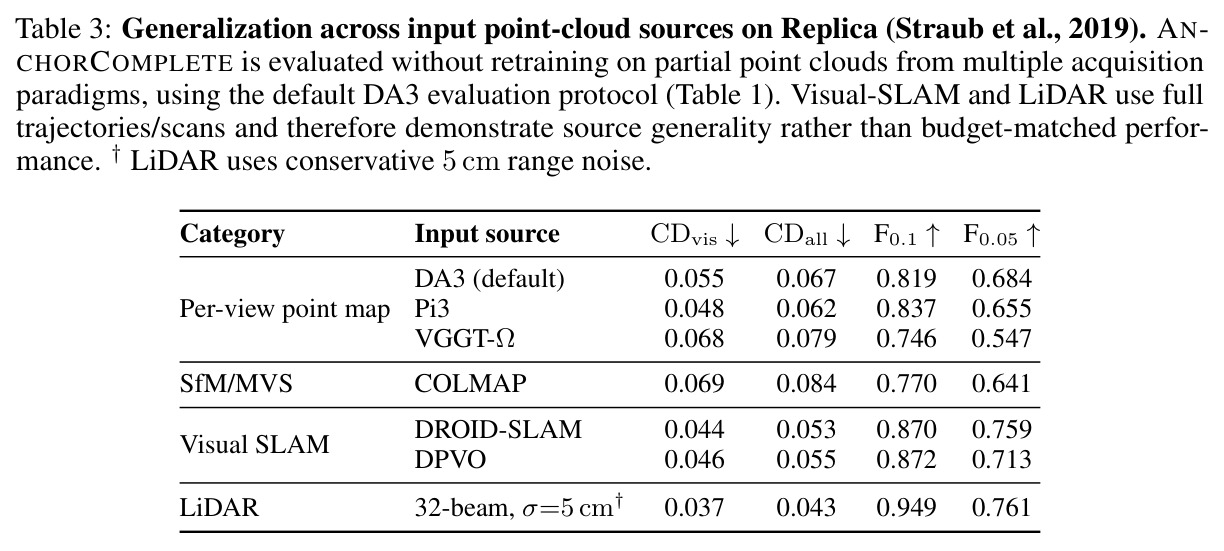
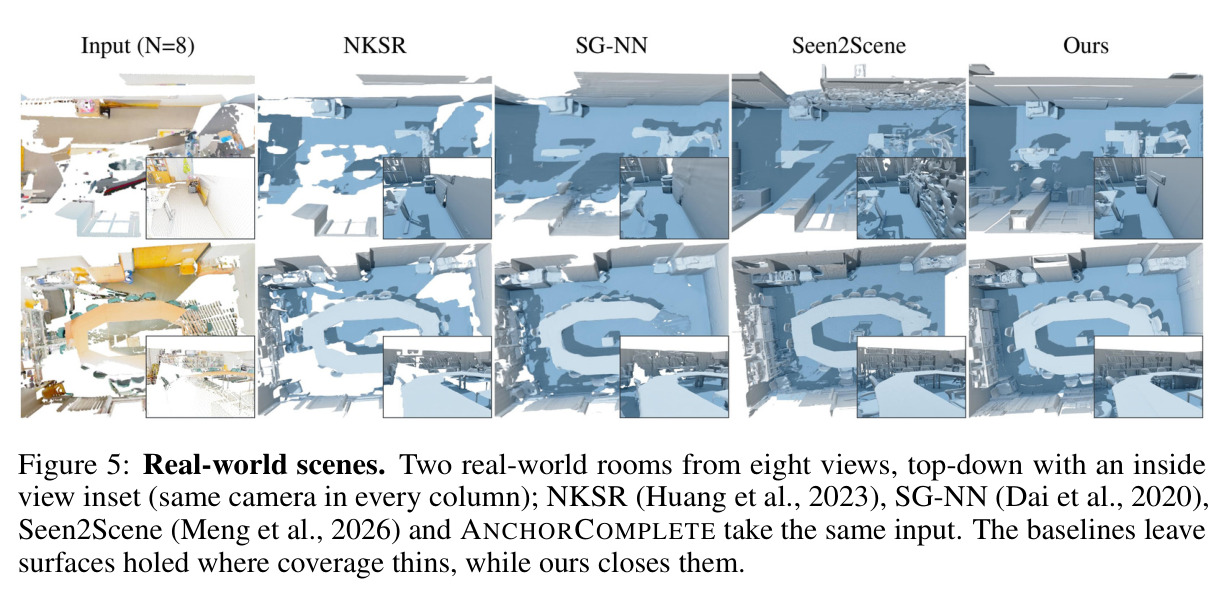
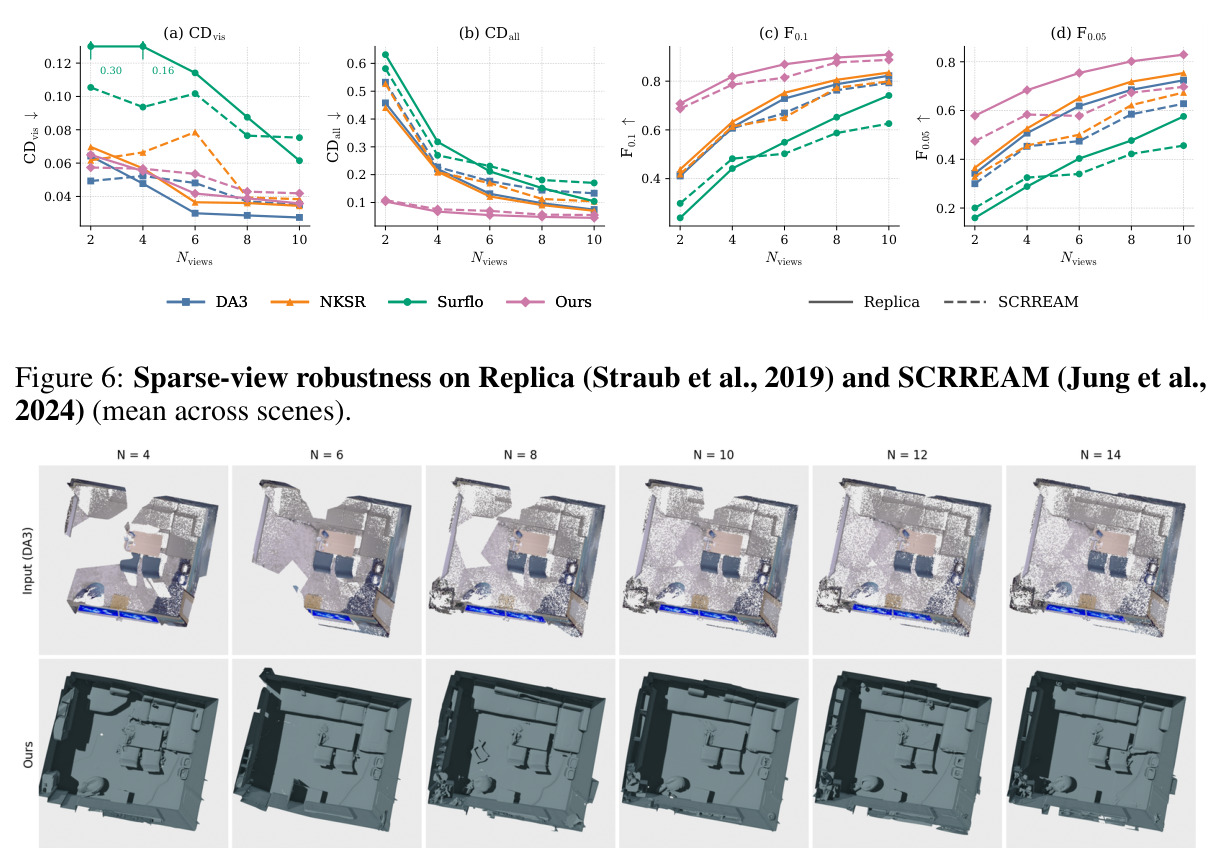
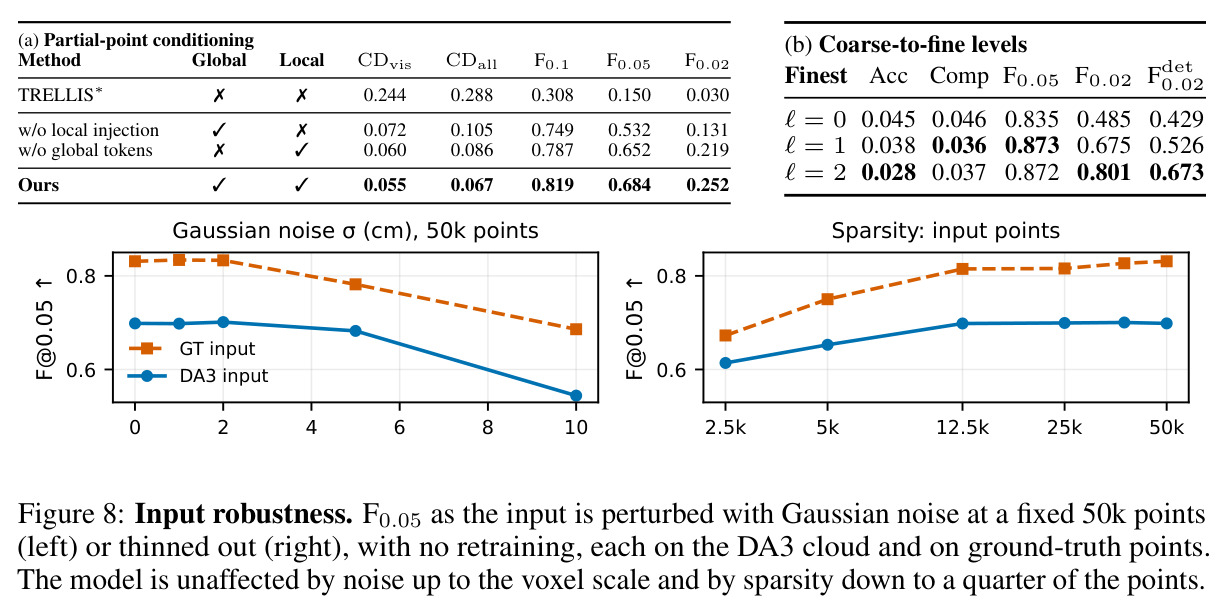
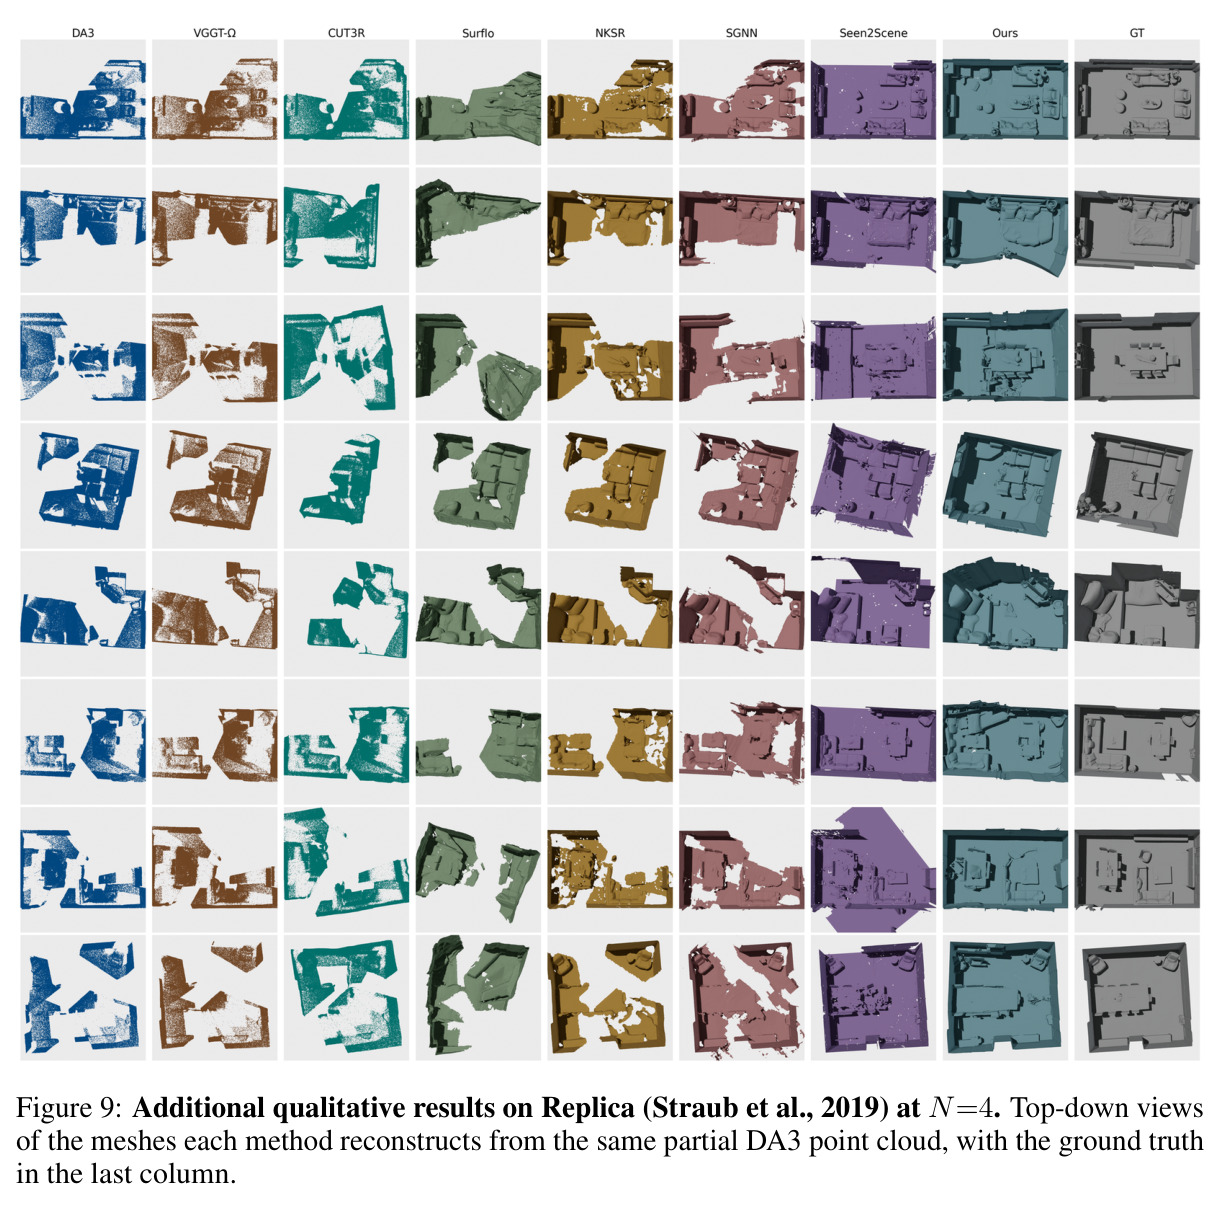
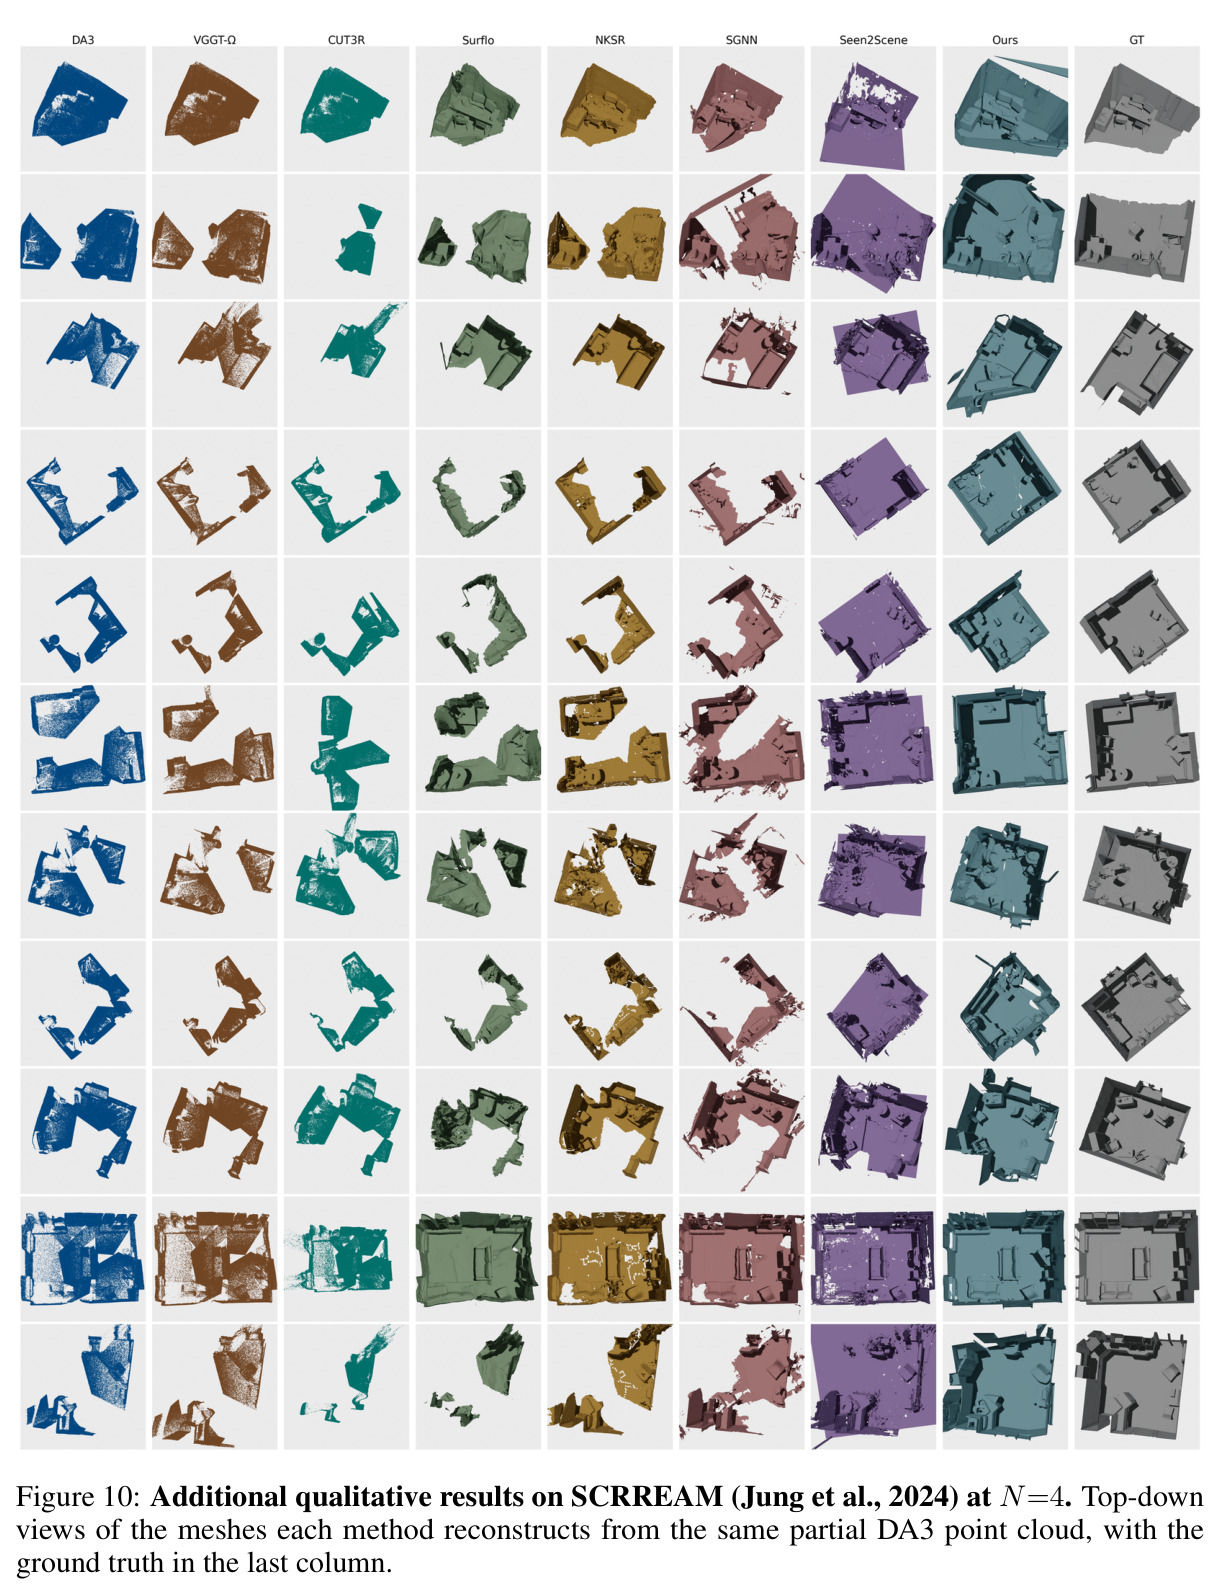
主实验(Table 1,Nviews=4):AnchorComplete 在 Replica 上 CDvis 0.055、CDall 0.067、F0.1 0.819、F0.05 0.684;SCRREAM 上 CDvis 0.057、CDall 0.076、F0.1 0.786、F0.05 0.584,全部完整场景指标领先。逐组分析:前馈重建组中 DA3 的 CDvis 最好(Replica 0.048 vs 本文 0.055),说明补全不以牺牲可见保真度为代价;CUT3R 在 4 视角下连可见区域都差(CDvis 0.244)。图像生成组中未做点条件化的 TRELLIS* CDvis 高达 0.244,证明本文增益来自条件化而非场景级微调本身;Surflo 虽能生成完整网格但 CDall 0.318 明显落后,因训练以物体为中心。场景补全组中 NKSR(CDall 0.211)说明平滑拟合无法恢复未见几何;最接近的 Seen2Scene 在 Replica CDall 0.132(本文 0.067,约减半)、F0.05 0.647 vs 0.684,且结果缺乏家具起伏。运行时间每场景约 3 分钟(RTX PRO 6000 Max-Q),介于 NKSR 的 1 秒与 Seen2Scene 的 10.4 分钟之间。稀疏视角鲁棒性(Figure 6,N=2 到 10):所有视角数下 CDall 与 F-score 均领先 DA3/NKSR/Surflo,N=10 时 Replica 上 F0.05 为 0.829 vs NKSR 0.754,N=2 时差距最大,退化更慢。消融(Table 2a):完整模型 F0.05 0.684,去局部注入降至 0.532,去全局 token 降至 0.652,两者都去掉(TRELLIS*)仅 0.150。粗到细(Table 2b,留出真实场景):L0→L1→L2 的 F0.05 为 0.485→0.675→0.801,细节 F@0.02 从 0.429 升至 0.673,只有 L2 能分开梯子横档和椅子腿。输入鲁棒性(Figure 8):不重训练,保留 1/4 输入点数、高斯噪声不超过体素尺度时 F0.05 稳定。跨输入源(Table 3):不重训练即可吃 DA3/Pi3/VGGT-Ω/COLMAP/DROID-SLAM/DPVO/32 束 LiDAR 七种来源,F0.05 在 0.547-0.761 之间,LiDAR 最好(CDall 0.043,F0.1 0.949),DROID-SLAM 次之(F0.05 0.759)。
局限与改进
作者承认三点局限。一是只预测几何不建模外观:沿用继承的网格解码器,无纹理输出,需要 RGB 监督和外观感知解码器才能生成带纹理网格。二是性能依赖上游几何质量:漂移、尺度误差或系统性深度偏差会传播到生成网格——附录 A.5 的失败案例很尖锐,低光或运动模糊让 DA3 丢掉大片房间,AnchorComplete 会“绕着缺口补全”而非恢复缺失观测,因为模型只用干净几何训练,把输入当作可靠锚点,系统性上游错误被保留而非修复。三是训练与评测聚焦室内场景,室外、无界或差异大的场景分布泛化性未知。我的补充观察:其一,生成区域的多模态性使“完整性”评价天然偏向本文设计的非对称协议(生成视锥外几何不罚精度),换用对称协议结论可能变化;其二,每场景约 3 分钟的推理时间对 SLAM 在线或交互式应用偏慢;其三,训练依赖 InternScenes/SAGE 这类带完整水密真值的大规模数据集,真实扫描(无完整真值)如何纳入训练未讨论;其四,$\alpha=0.8$ 的父级 warm start、窗口重叠四分之一、CFG 只在 $t\in[0.6,1]$ 施加等关键超参的敏感性没有消融。
独立分析的弱点
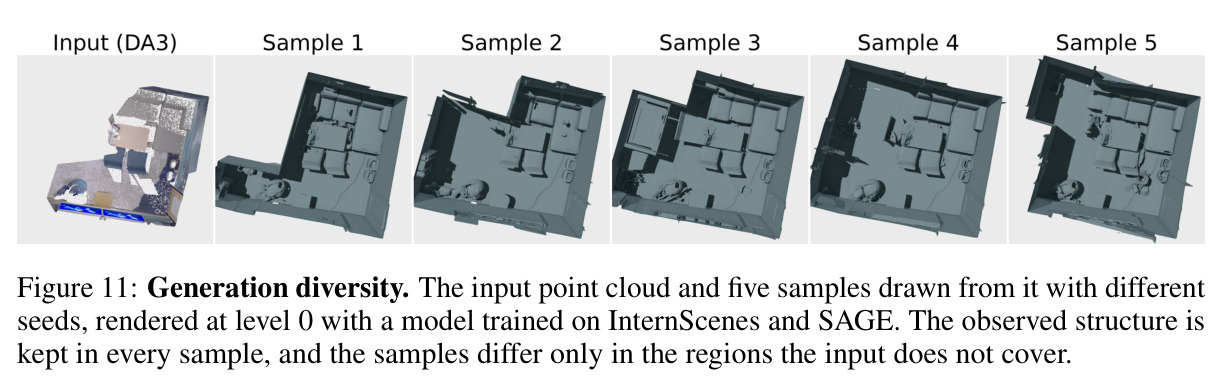
弱点一:上游错误继承。具体场景:传感器噪声或暗光下 DA3 丢失大片区域,模型在这些区域生成的是“绕开缺口的合理房间”而非真实几何,且用户无从分辨哪些是合理补全、哪些是错误继承。改进方向:训练时加入降质输入(模拟深度噪声、遮挡、位姿漂移),或让模型输出不确定性图标记低置信区域。弱点二:无外观。改进方向:在 O-Voxel 潜变量上加外观通道,用多视角图像做 RGB 监督——TRELLIS 本身支持外观解码,工程上可行性较高。弱点三:室内限定与数据依赖。改进方向:引入室外驾驶/街景完整先验数据,或把固定窗口机制扩展为无界场景的滑动扫描式增量处理。弱点四:推理成本。每场景约 3 分钟、两阶段各 12 步且逐窗口串行生成,级别越高窗口越多。改进方向:步数蒸馏、跨窗口共享与缓存锚定 token、无依赖窗口并行采样。弱点五:评测协议可能鼓励过度自信的全场景生成——视锥外不罚精度,模型生成错误几何在 CDall 上只体现为 completeness 惩罚。改进方向:报告生成区域的多样性与校准指标,论文 Figure 11 已展示多种子多样性,可量化为评价指标。弱点六:点条件需要成对的“部分观测+完整真值”训练数据,这类数据只有合成或水密化管线能提供,限制了向真实采集数据的扩展。
未来方向
作者明确提出的:加入 RGB 监督与外观感知解码器以生成带纹理网格;用降质输入训练,使模型能修复而非继承上游失败;扩展到室外、无界或差异更大的场景分布。基于本文成果可自然延伸的:把 Level 3/4 窗口堆到厘米级以下,做物体级精细补全甚至家具内部结构;与在线 SLAM 流式结合实现边扫描边补全——论文强调点输入可分块、输出可在同一坐标系合并,天然支持增量式处理;利用生成多样性(Figure 11 的多种子样本)做不确定性感知的主动探索,让机器人优先拍摄补全置信度低的区域;把锚定 token 思路反哺图像条件生成器,提高现有 image-to-3D 模型对部分观测的忠实度;在 Habitat 等仿真平台与 AR/VR 中量化完整网格对碰撞检测、物理仿真和新视角渲染的实际收益;探索把 LiDAR 输入(Table 3 中表现最好,F0.1 0.949)作为主场景的补全管线。
复现评估
作者承诺论文发表后开源代码与预训练 checkpoint。可复现性总体较好:模型初始化自公开的 TRELLIS.2 image-to-3D checkpoint;点编码器 backbone(Utonia)冻结且论文已挂 arXiv;训练数据 InternScenes 与 SAGE 均为公开数据集,渲染管线(BlenderProc,640×480,85° 水平视场)与相机采样器细节在附录 A.1 完整给出(1-9 个锚点、3 个俯仰环 -10°/-45°/+50°、每环 10 个偏航角);评测用公开的 Replica(8 场景,沿用 Ni et al. 2025 的子集)与 SCRREAM(12 场景),指标定义在附录 A.2 给全(含精度只算视锥内的说明,每网格采样 $10^5$ 点);基线 Seen2Scene 用作者公开代码与 checkpoint 复现,所有方法经同样的 Sim(3) 对齐后用同一套代码评测。算力门槛中等:4 张 NVIDIA L40 微调 40k 步(每 GPU batch 1,AdamW 学习率 $2\times10^{-5}$),推理约 3 分钟/场景(RTX PRO 6000 Max-Q),单张高端消费级 GPU 应可推理,复现训练需要 4 卡级工作站或云资源。主要难点:附录公式 1-3 的 LaTeX 在文本提取中损坏,需对照原文 PDF 确认 warm start 的精确形式;两阶段多级窗口的训练采样策略(Level 1/2 高频、父级 70% 用预测)工程细节较多;代码发布前只能凭文字描述重建。
论文图表
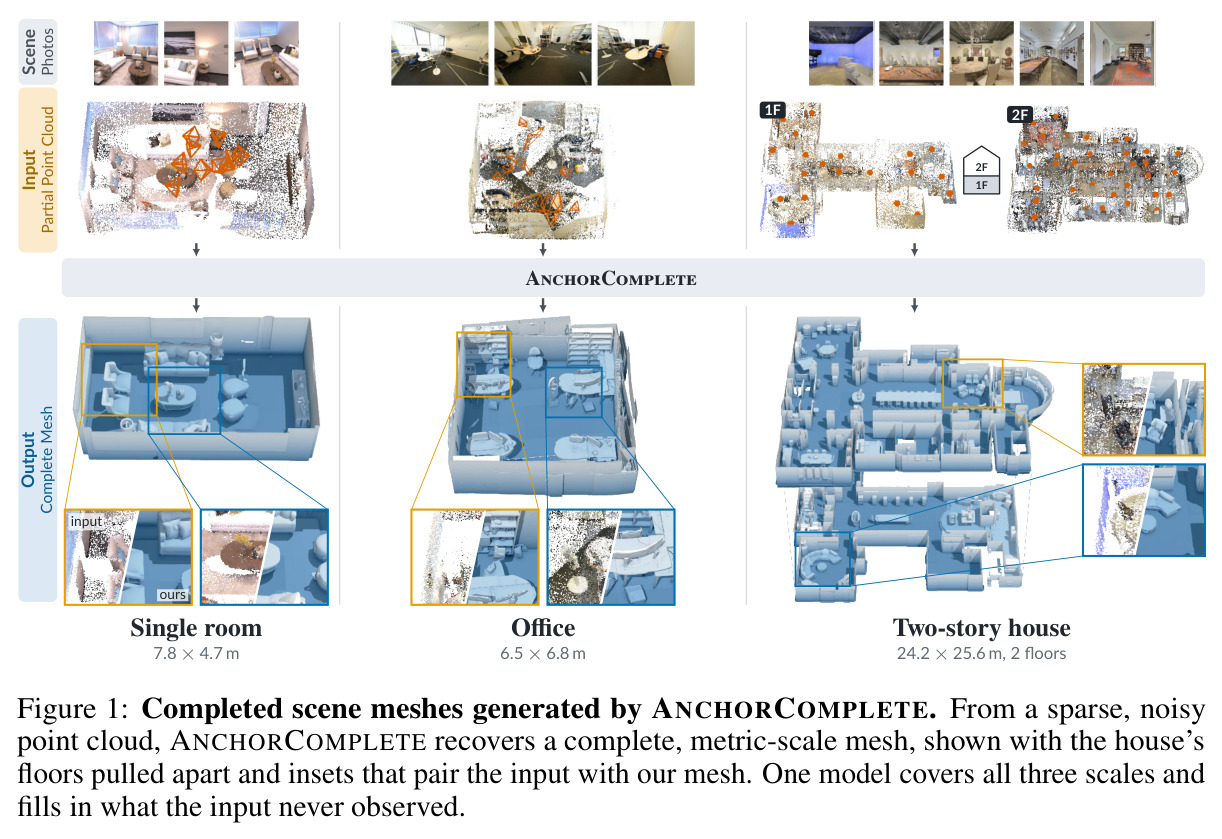
展示三个不同物理尺度的场景:输入为稀疏带噪声的部分点云,输出为完整网格,住宅的两层被拉开分别展示,并配有多组输入/输出对比插图,强调一个模型覆盖所有尺度且能填充输入从未观测到的区域。
一图概括论文核心卖点——单一模型覆盖从单房间到两层住宅的三个尺度、输出度量尺度完整网格,是读者建立直觉的起点。
上下两行分别展示输入点云与本文补全随视角数的变化:上排输入空洞越来越大,下排重建始终保持完整封闭。
与 Figure 6 的曲线互补,用可视化直观展示输入退化时输出仍保持完整,验证生成先验真正在“填洞”。
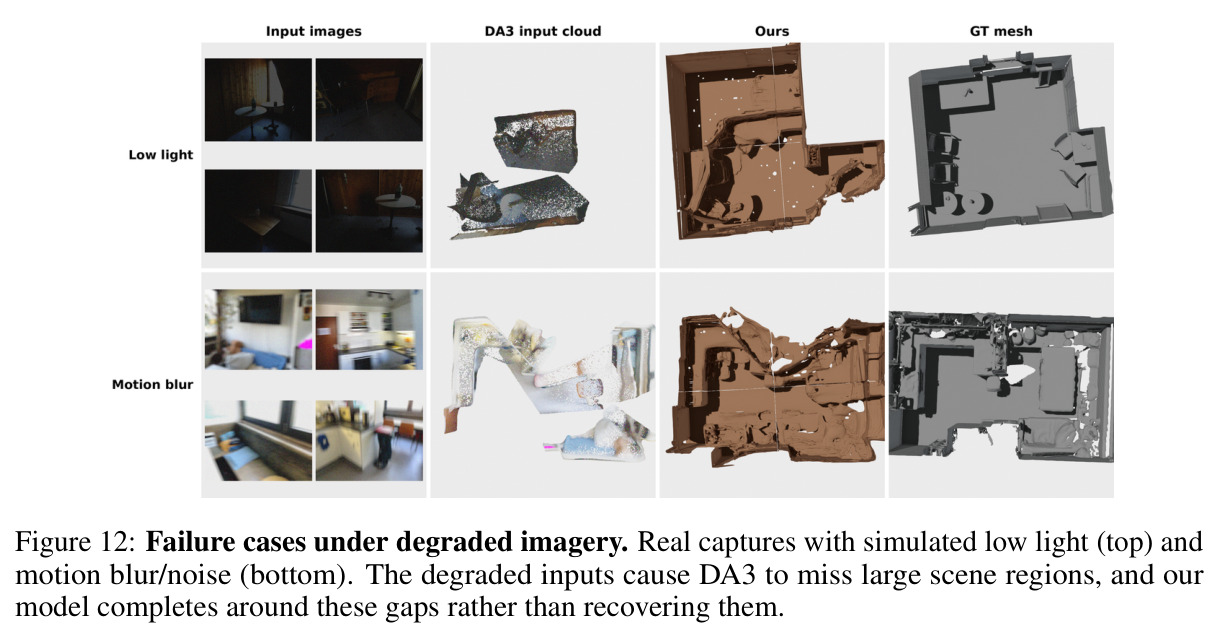
降质让 DA3 丢失大片场景区域,AnchorComplete 在这些区域绕着缺口补全而非恢复缺失观测,输出与上游错误一致的“合理房间”。
作者自曝的最尖锐局限:系统性上游错误被继承而非修复。理解这一边界对正确使用该系统、避免误信生成几何至关重要。
(a) 完整模型 CDvis 0.055/F0.05 0.684;去局部注入后 CDvis 涨至 0.072、F0.05 降至 0.532;去全局 token 后 0.060/0.652;两者皆无(TRELLIS*)0.244/0.150。(b) L0→L1→L2 的 accuracy 从 0.045 降到 0.028、F0.05 从 0.485 升到 0.801、细节 F@0.02 从 0.429 升到 0.673。
分别量化两大组件的贡献:局部注入负责定位观测几何(影响最大),全局 token 提供场景语境;多级窗口逐级提升细节。是理解“哪条设计在起作用”的关键证据。