WorldRecon:面向大规模三维世界的生成式多视角网格重建 WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
以粗点云为全局脚手架分块生成,从无位姿多视角图重建带PBR材质的完整场景网格
前置知识
无位姿前馈重建模型(VGGT-Ω 与点图回归)
这类模型(DUST3R/MASt3R/VGGT 系列)把多视角重建转化为逐像素 3D 点坐标(pointmap)的回归问题,单次前向即可同时输出每张图的深度、相机内外参与置信度,无需传统 SfM 的迭代匹配与标定。VGGT-Ω 是其中最新版本,本文所有的粗位姿与全局点云都由它产生。
WorldRecon 的全局点云脚手架、块级相机与点云条件全部来自 VGGT-Ω 的输出,理解它的输出形式、置信度含义与误差特性,才能明白后续对齐、过滤以及'容忍不完美条件'这一整套设计的动机。
原生 3D 生成先验(TRELLIS.2 与结构化稀疏体素隐变量)
TRELLIS.2 将 3D 资产表示为规则 $G^3$ 网格上的稀疏活跃体素,每个体素携带位置 $o_i$、几何特征 $f^{geo}$ 与材质特征 $f^{mat}$;生成时级联三个 DiT 流匹配阶段——稀疏结构预测活跃体素位置,几何与材质阶段填充对应隐变量,最后由解码器还原为带材质的网格。
本文方法主体就是把这一物体级先验微调成块级场景生成器并扩展出修复变体,三个生成阶段的划分与隐变量定义直接对应论文的公式和管线图,是读懂方法章节的前提。
流匹配与去噪轨迹
流匹配(flow matching)学习把高斯噪声 $\epsilon$ 沿确定性轨迹输运到干净数据 $x_0$ 的速度场,任意去噪时刻的状态可写作 $x_t=(1-t)x_0+t\epsilon$;采样时用 Heun 等高阶求解器迭代积分。本文的每个生成阶段都是一个流匹配 DiT。
论文的轨迹钳制公式直接操作这条轨迹:把已知重叠区域强制钳回 $(1-t)x_0^{known}+t\epsilon$。不懂流匹配就无法理解跨块一致性如何在采样过程中被逐步强制保证。
Plücker 射线与相机条件编码
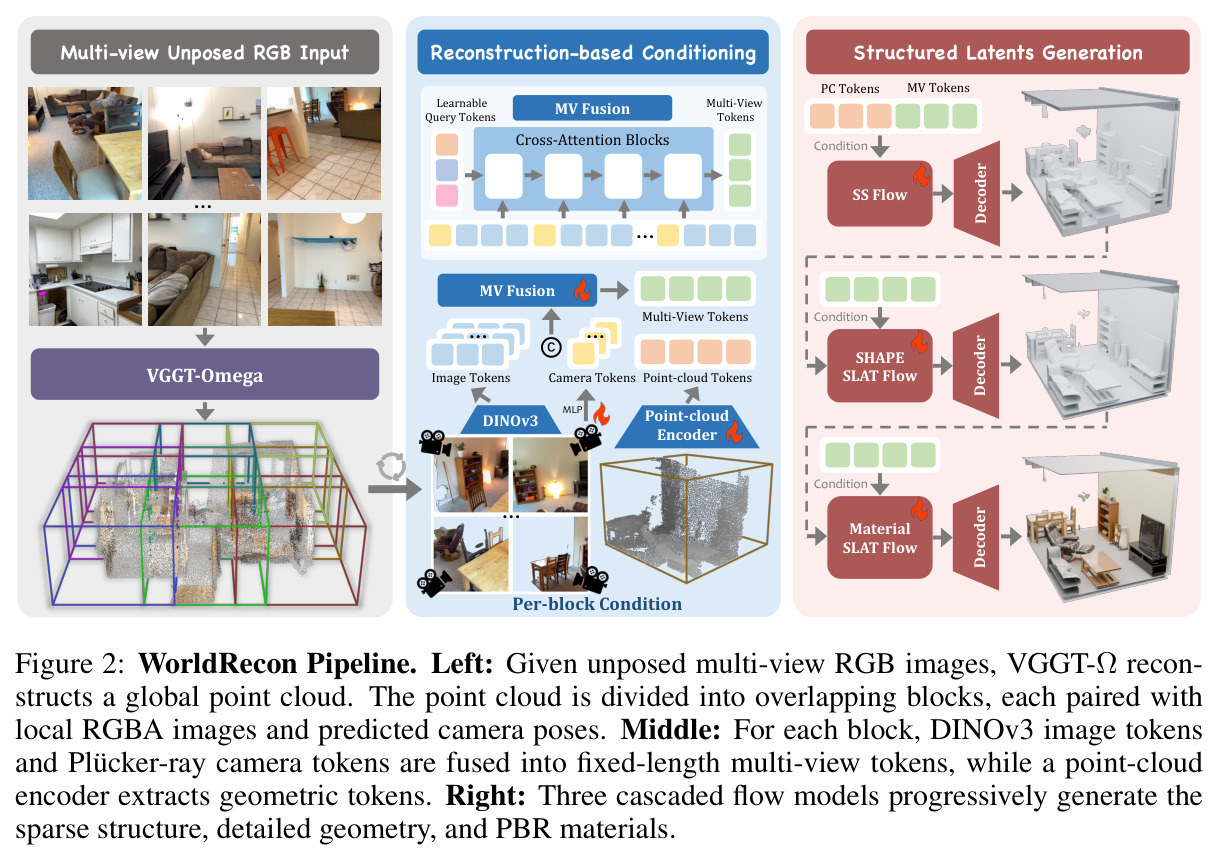
空间光线用六维 Plücker 坐标 $(\mathbf{d},\,\mathbf{o}\times\mathbf{d})$ 表示,含方向与相机中心叉积。图像中心与四角 5 条射线经 MLP 编码为 token,即可把相机内外参注入 Transformer。
WorldRecon 用这种方式给每个视角的 DINOv3 图像 token 配上相机 token,是'不投影特征体也能利用位姿'的关键;理解它才能比较本文与 SCube/GenRecon 条件机制的本质差异。
Classifier-Free Guidance(CFG)与条件丢弃
训练时以一定概率(本文为 0.1)随机丢弃全部条件,使同一模型同时学会条件生成与无条件生成;推理时用两者的外推组合放大条件引导。它还天然支持'条件完全缺失'的推理模式。
论文对点云 token 做整体丢弃训练,因此同一个稀疏结构模型既可在有点云时接地、也可在点云缺失时自由补全;推理时 7.5/7.5/3.0 的引导尺度设置也需要 CFG 概念来解读。
PBR 材质
基于物理的渲染(PBR)用 albedo、粗糙度、金属度等参数刻画表面与光照的物理交互,使物体能在任意新光照下被真实地重新渲染,区别于只记录颜色的烘焙贴图。TRELLIS.2 的材质阶段生成的正是这类材质隐变量。
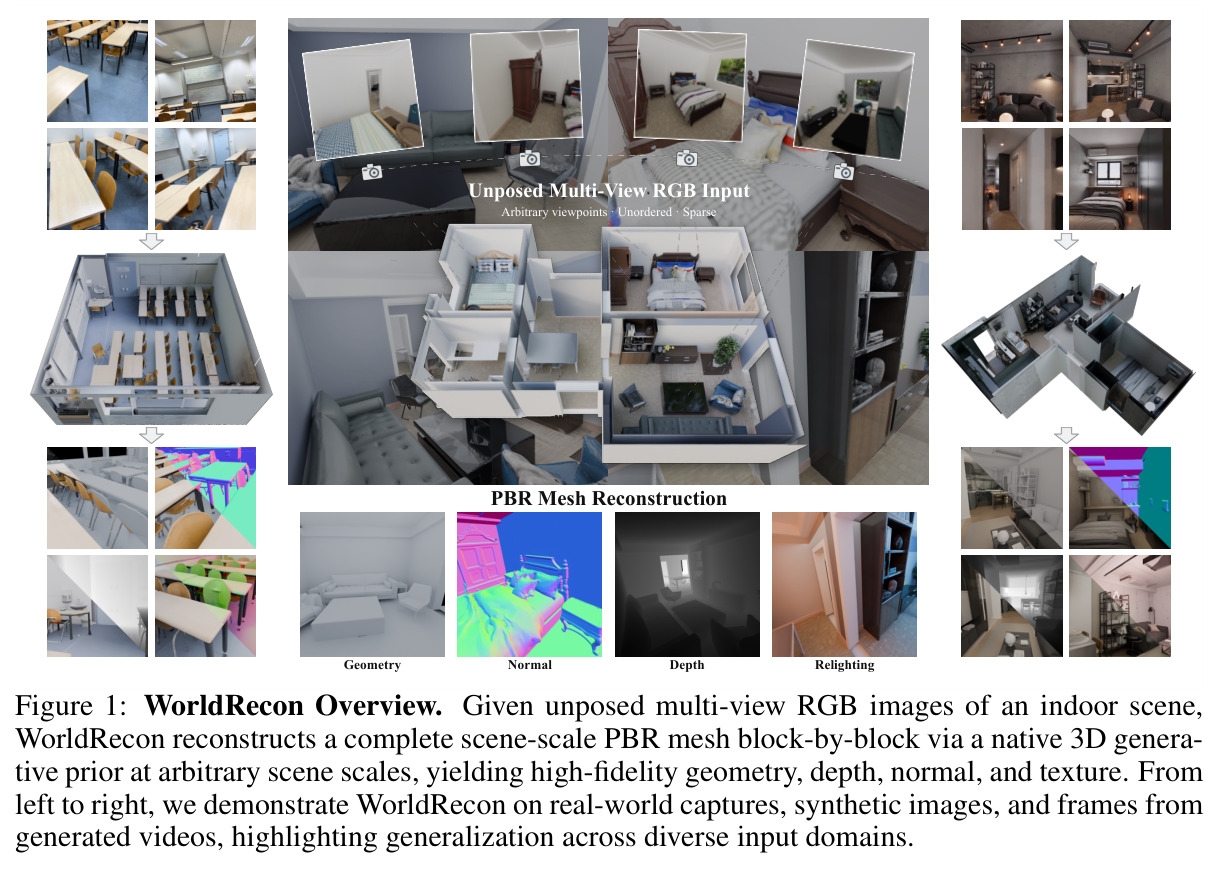
论文的核心卖点之一是输出可直接重光照、可导入仿真引擎的 PBR 场景网格(Figure 1 的 Relighting 列),理解 PBR 与普通纹理贴图的区别才能评估它的下游应用价值。
研究动机
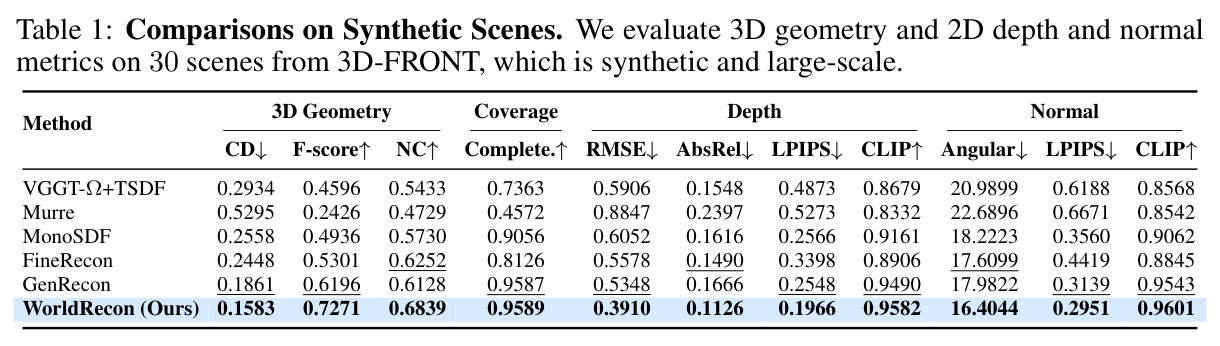
从无位姿多视角 RGB 图像重建大规模场景是计算机视觉的基础问题,但现有两条路线都有硬伤。重建式方法(TSDF 融合、NeRF、3DGS、MonoSDF 等神经隐式表面)只能恢复观测到的表面:遮挡区域直接缺失、几何噪声大、难以转成干净网格;即便用 VGGT-Ω 这类点图回归模型提供深度与位姿,误差也会在 TSDF 融合中传播,导致墙面扭曲与碎片伪影——Table 1 中 VGGT-Ω+TSDF 的 CD 高达 0.2934。生成式方法虽能补全缺失,但 ReconViaGen、UniRecGen 等多视角扩展仍停留在物体级;SCube、GenRecon 虽扩展到场景级,却必须依赖准确相机位姿把图像特征投影进 3D 特征体,位姿一错就引发跨视角冲突和全局布局畸变;而 BlockFusion、WorldGrow 等分块场景生成方法只以文本或布局为条件,完全没有视觉引导与 3D 空间接地。
本文的目标是本文的目标是:给定任意数量、无标定、视角稀疏且无序的室内场景 RGB 图像,直接输出一个完整的、场景尺度的高保真 PBR 网格。具体包含四层要求:其一,几何忠实——重建结果必须锚定在真实观测上,全局布局不能漂移;其二,表面完整——对未观测或仅稀疏观测的区域,能借助生成先验补全几何与材质而非留下空洞;其三,跨块一致——场景被切成多个 4 米块分别生成后,相邻块在几何与外观上要无缝衔接,不能出现错面和接缝;其四,强泛化——只用合成数据(3D-FRONT、SAGE-10k)训练就能在真实激光扫描数据 ScanNet++ 上工作,即 sim-to-real。最终产物需支持重光照,服务于 VR/AR、具身智能仿真与数字内容生产。
与已有工作不同的是,本文的独特切入是把'不完美的重建结果'当作可用的全局脚手架,而不是把生成模型的输入绑死在精确几何或位姿上。做法有三个反常规之处:第一,不再把图像特征按位姿投影进 3D 特征体(SCube/GenRecon 的做法),而是在条件空间里用交叉注意力融合多视角图像 token 与点云 token,让网络自己学会容忍位姿与点云噪声;第二,把物体级原生 3D 生成先验 TRELLIS.2 微调成'块级'生成器,每块只看局部点云裁剪和与该块相关的少数图像观测,天然规避了单一生成表示撑不起整个场景的容量瓶颈;第三,把跨块一致性从像素级拼接搬进隐变量空间——训练专门的邻居感知修复模型,配合轨迹钳制与羽化混合,在结构、几何、材质三个隐变量层面逐块传播上下文。
核心方法
直觉上,WorldRecon 一句话概括:'让粗点云钉住全局布局,让生成先验补全表面细节'。技术路线分五步。第一步,VGGT-Ω 对输入图像一次前向推理,输出每视角深度、置信度与相机位姿,反投影合并并做置信度过滤、统计离群点剔除与连通域滤波得到全局点云;再通过 PCA 轴加水平面法向投票估计重力方向与主墙面方向,完成对齐与尺度恢复(垂直范围缩放到 2.9 米)。第二步,沿 XY 平面把点云脚手架切成边长 $\ell=4$m、重叠 $\ell/4$ 的立方块,每块筛选最多 4 个块内像素覆盖最大的视角和 8192 点的局部点云裁剪。第三步,用微调后的 TRELLIS.2 级联三个 DiT 流匹配模型,按稀疏结构→几何→材质的顺序生成每个块。第四步,从体素占用率最高的种子块出发,按体素优先的因果顺序逐块扩展,新块通过邻居感知隐变量修复继承已生成邻居的重叠上下文。第五步,稀疏结构阶段做轨迹钳制、几何/材质阶段做羽化加权混合,最后解码各块网格并在世界坐标系合并。
核心创新是'重建式条件 + 隐变量空间修复 + 因果世界生成'三件套,本质区别在条件注入的位置与跨块传播的层面。重建式条件不构建 3D 特征体:每个视角用冻结的 DINOv3 编码成图像 token,相机用 5 条 Plücker 射线 $(\mathbf{d},\,\mathbf{o}\times\mathbf{d})$ 经 MLP 变成相机 token,再由可学习查询的交叉注意力压成定长多视角条件 $\mathbf{c}_{mv}$;点云经 Fourier 编码得到 $\mathbf{c}_{pc}$,只喂给稀疏结构阶段,训练时以 0.1 概率整体丢弃以支持 CFG。邻居感知修复把 inpainting 定义在隐变量空间:去噪器新增 $C+1$ 通道,输入 $\mathbf{h}^{in} = f^{in}[\mathbf{x}_t, \mathbf{m}, \mathbf{x}^0 \odot (1-\mathbf{m})]$,训练掩码模拟推理时的 1/2 邻居 L 形重叠布局;修复变体从基础生成器初始化、新增通道零初始化,起点等价于原模型,保证先验不丢失。
方法步骤详情
完整流程分数据、训练、推理三段。数据侧:对 3D-FRONT 与 SAGE-10k 场景渲染 RGBD 视角,按边长 4m 切块并归一化到 $[-0.5,0.5]^3$,共约 11.7 万个训练块;每块输出网格、点云、至多 16 张 RGBA 渲染与块局部相机,点云随机取加噪 GT 深度或 VGGT-Ω 重建两种噪声源,均为 8192 点。训练侧:微调 6 个模型——SS/几何生成器全量微调、对应修复器、材质生成/修复器用 rank-8 LoRA。推理侧:VGGT-Ω 全局重建→重力与主墙方向对齐缩放→3m 步长分块→每块选联合体素覆盖最大的至多 4 视角→体素优先排序→种子块直接生成、后续块修复;SS 阶段执行轨迹钳制 $\tilde{\mathbf{x}}^{ss}_t = \mathbf{m}_{ss}\odot\mathbf{x}^{ss}_t + (1-\mathbf{m}_{ss})\odot\mathbf{x}^{ss,known}_t$,几何/材质阶段按边界距离羽化权在线加权混合写入世界隐变量,最后逐块解码合并。
技术新颖性
从技术谱系看,新颖性有四点。其一,条件机制:与 SCube/GenRecon 的'位姿驱动特征体投影'不同,本文把几何接地信息放进条件 token 序列,让 DiT 通过交叉注意力自主加权,因而对 VGGT-Ω 的位姿漂移显著更鲁棒——Figure S3 的失败案例中 GenRecon 直接产生碎片化伪影,而 WorldRecon 在有观测覆盖的区域仍然正常。其二,尺度扩展方式:不同于物体级生成(ReconViaGen/UniRecGen)与层级体素隐变量(SCube),本文采用显式空间分块加隐变量级拼接,且修复训练掩码与推理时的邻居拓扑一一对应(至多 2 个已生成四连通邻居、L 形约束、已知边距 $3\ell/16$ 与 $\ell/16$ 可编辑过渡带),这种'训练-推理掩码分布对齐'是跨块无缝的关键细节。其三,推理期的轨迹钳制把已知重叠强制钳回前向流轨迹,保证已生成内容在后续去噪中零漂移。其四,把 TRELLIS.2 的三阶段级联结构原封不动改造成'结构→几何→材质'世界生成管线,只在输入通道层面加修复分支,最大化保留预训练先验。
实验结果
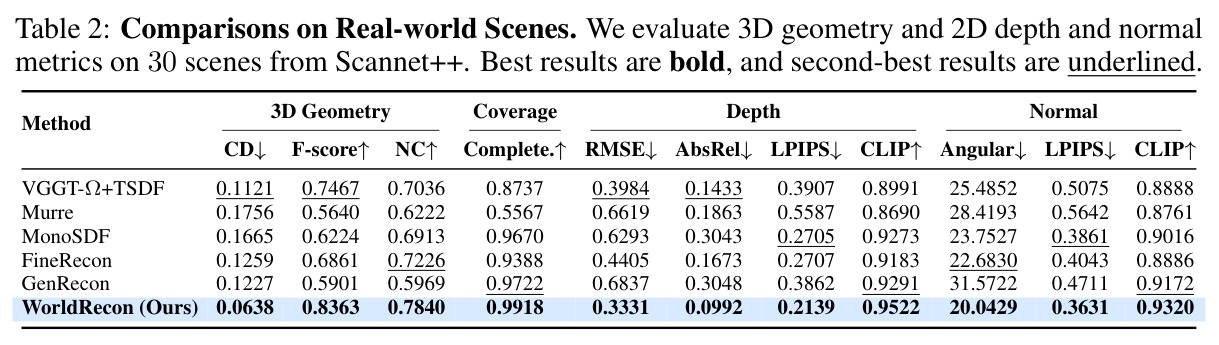
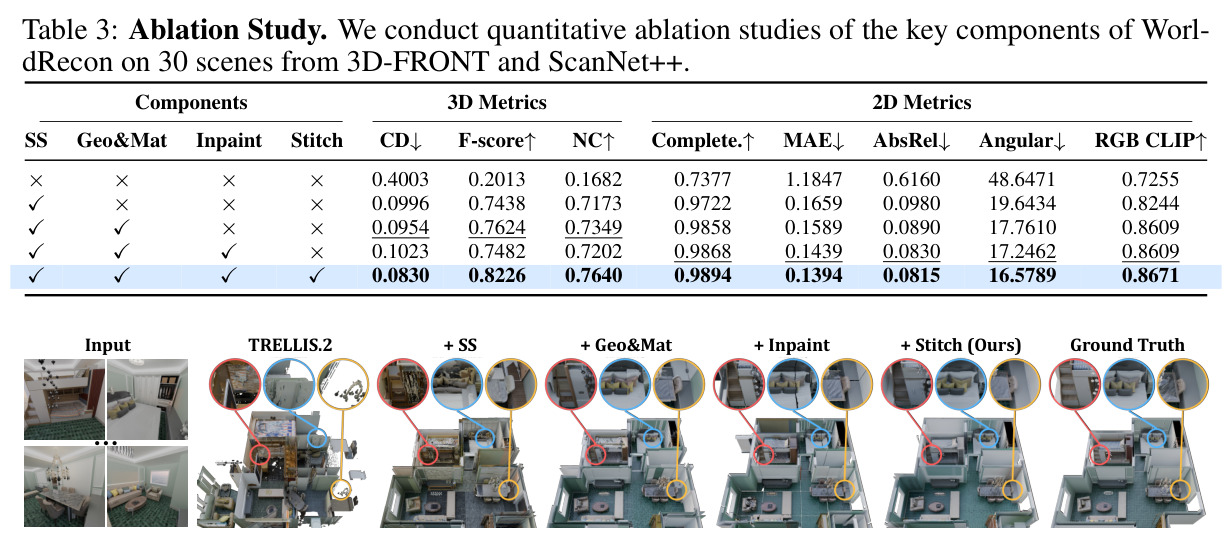
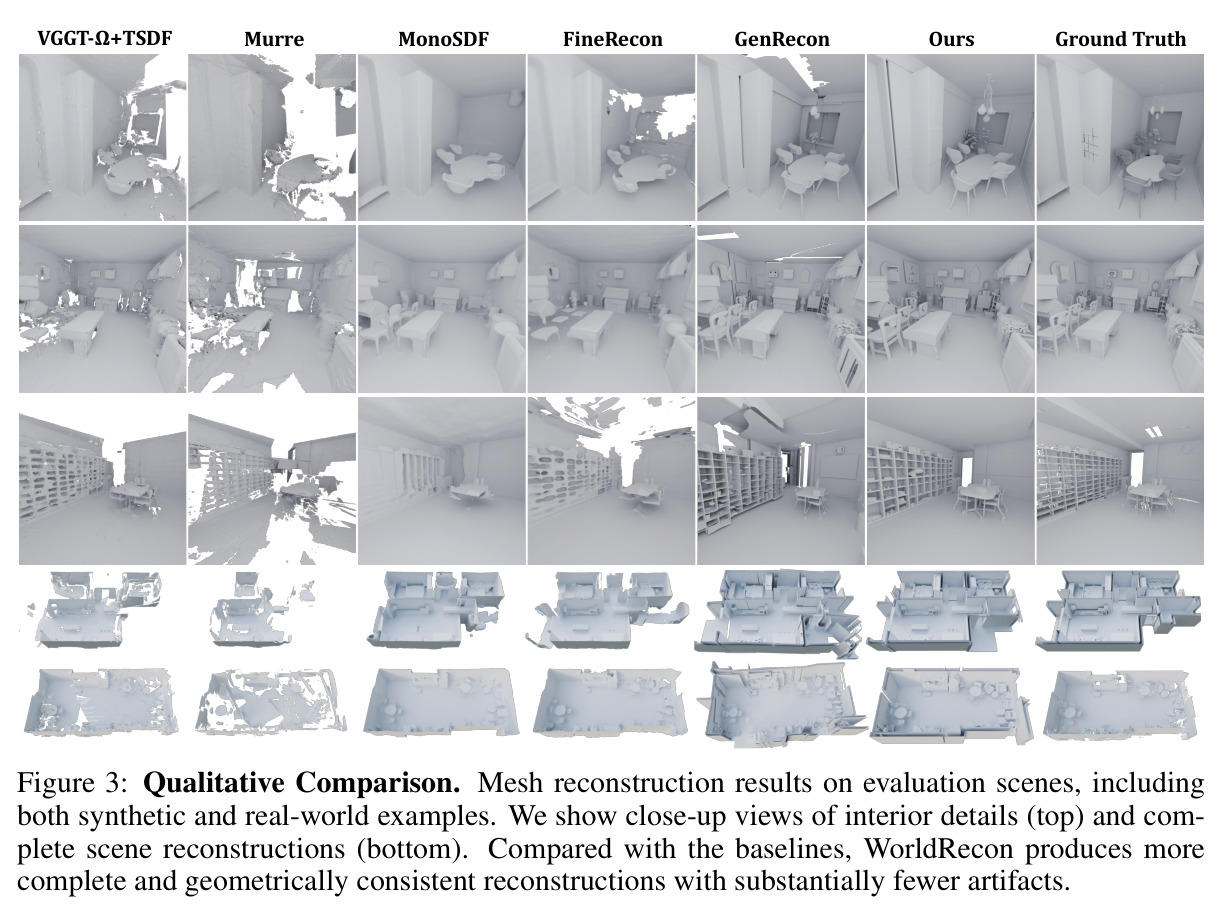
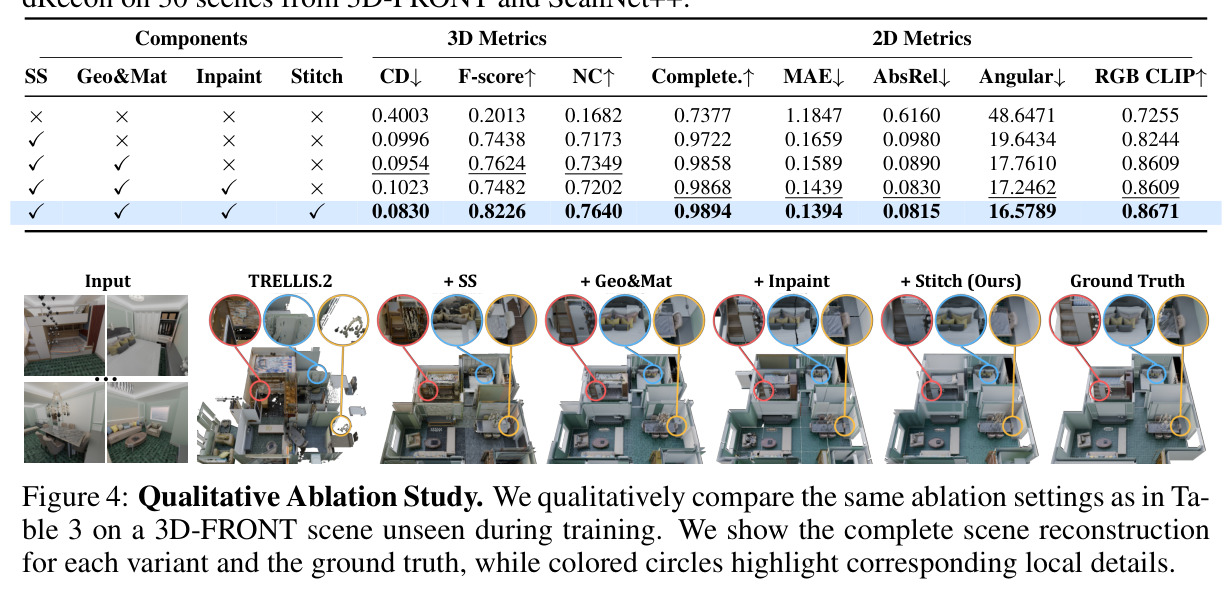
核心结果分四组。合成场景(3D-FRONT 30 场景,平均 7.1 房间、62.1 m²):CD 0.1583,较最强基线 GenRecon 0.1861降低 14.9%,F-score 0.7271 提升 17.3%,NC 0.6839、Completeness 0.9589 均第一,深度 RMSE 0.3910、法向角 16.40° 等全部 2D 指标领先。真实场景(ScanNet++ 30 场景,仅合成数据训练):CD 0.0638,较最强基线 VGGT-Ω+TSDF(0.1121)降低 43.1%,F-score 0.8363 提升 12.0%,验证强 sim-to-real 泛化。消融(15+15 场景):原始 TRELLIS.2 失效(CD 0.4003、F 0.2013),+SS 降至 0.0996/0.7438,+Geo&Mat 达 0.0954/0.7624,+Inpaint 改善 2D 但 3D 略退,+Stitch 全面最优(CD 0.0830、F 0.8226)。对比 GPT-6 智能体:其耗约 2M token/场景且布局扭曲,本文单 GPU 更忠实。
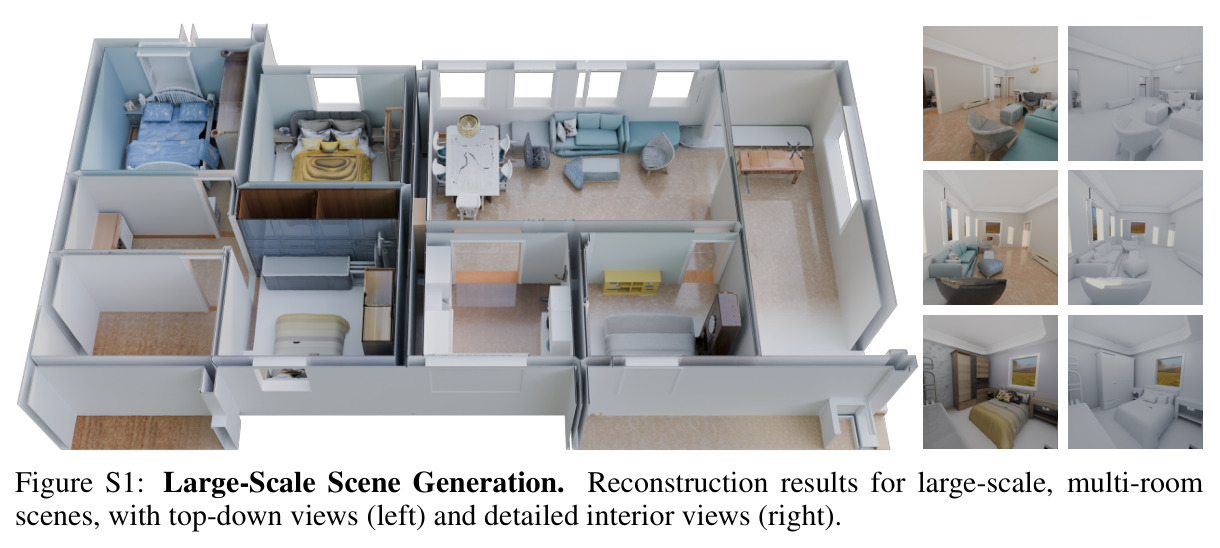
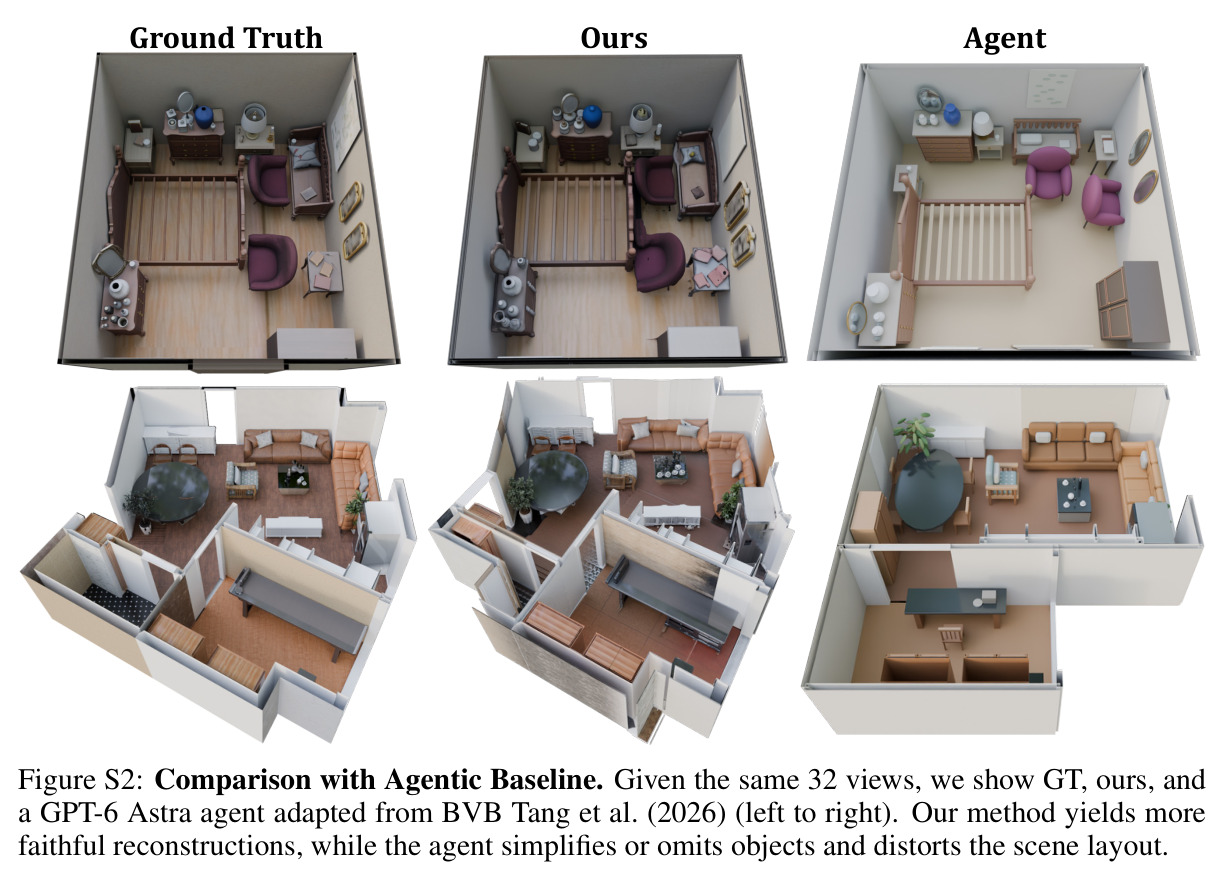
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 合成室内场景网格重建(3D-FRONT 30 场景) | Chamfer Distance (CD) ↓ | 0.1583 | 0.1861(GenRecon,最强基线) | 降低 14.9% |
| 合成室内场景网格重建(3D-FRONT 30 场景) | F-score@10cm ↑ | 0.7271 | 0.6196(GenRecon) | 提升 17.3% |
| 真实室内场景网格重建(ScanNet++ 30 场景,sim-to-real) | Chamfer Distance (CD) ↓ | 0.0638 | 0.1121(VGGT-Ω+TSDF,最强基线) | 降低 43.1% |
| 真实室内场景网格重建(ScanNet++ 30 场景,sim-to-real) | F-score@10cm ↑ | 0.8363 | 0.7467(VGGT-Ω+TSDF) | 提升 12.0% |
| 真实场景表面法向精度(ScanNet++) | 法向角误差 Angular (°) ↓ | 20.04 | 22.68(FineRecon,次优中最好) | 降低约 11.7% |
| 消融:完整管线 vs 原始 TRELLIS.2(15+15 场景) | F-score@10cm ↑ | 0.8226 | 0.2013(vanilla TRELLIS.2) | 约 4.1 倍 |
局限与改进
作者承认两点局限:训练数据全部是室内场景,对室外环境的泛化未知;场景表示是单层 4 米高的块,无法表达楼梯、复式等多层结构。结合失败案例(Figure S3)还能看到更深层的问题:整条管线以 VGGT-Ω 的点云脚手架为唯一全局锚,当部分视角位姿被错误估计或点云被置信度过滤掉时,未观测区域的几何只能靠幻觉补全甚至完全缺失——WorldRecon 只是相对 TSDF 与 GenRecon 更稳健,并未摆脱这一依赖。我自己的观察还包括:全局对齐依赖 PCA 轴与墙面法向投票的启发式,在非曼哈顿布局、弧形墙面或开放半户外场景可能失效;因果串行的块生成使大场景推理时间随块数线性增长,且早期块的错误会沿因果链累积传播;生成补全区域缺乏可验证的真实性保证,用于高精度测量类下游任务有风险;材质阶段仅用 rank-8 LoRA 微调,材质表达能力受原先验限制。
独立分析的弱点
独立分析五个弱点及改进方向。第一,对 VGGT-Ω 的单点依赖:脚手架质量决定性能上限,若初始重建大面积失败(Figure S3),系统只能幻觉或留洞;改进方向是引入多假设点云融合,或基于不确定性的主动式'最佳下一视角'采集建议来引导补拍。第二,垂直方向的单层限制:楼梯、挑空、多层建筑直接不可表达;改进方向是把分块从 XY 平面扩展到真三维网格并设计含 Z 轴的因果序。第三,串行因果生成的效率与误差传播:块数多时推理慢,早期块错误沿链条影响后期;改进方向是分组并行去噪加重叠区协商,或先粗后精的两级世界隐变量。第四,幻觉区域不可验证:补全的家具与墙面 plausible 但未必真实,下游无从区分观测与猜测;改进方向是输出逐区域置信度图,或在条件中加入观测覆盖掩码。第五,512 分辨率隐变量与 4 米块的细节上限:薄结构和高频纹理受限;改进方向是块级超分或局部自适应体素加密。
未来方向
作者明确提出:把训练分布扩展到更多样的室内、室外与多层环境,并支持沿垂直维度的块生成。基于本文成果还可自然延伸:其一,与视频生成模型(论文已用 Seedance 2.0 生成视频帧做演示)构成'世界模型闭环'——生成视频、重建可编辑 PBR 场景、再渲染回训练信号,直接服务具身智能仿真;其二,交互式编辑与补全,让用户涂抹或指定区域由修复器重新生成;其三,把因果世界生成推广到流式输入,实现边拍摄边重建的在线管线;其四,与 3DGS/NeRF 联合表示,同时获得照片级新视角合成与可编辑网格;其五,不确定性建模——让稀疏结构阶段输出占用概率而非硬判定,为下游规划提供风险感知;其六,户外大尺度场景需要引入天空/地形先验与 LiDAR-视觉融合条件,块尺寸也应随场景尺度自适应。
复现评估
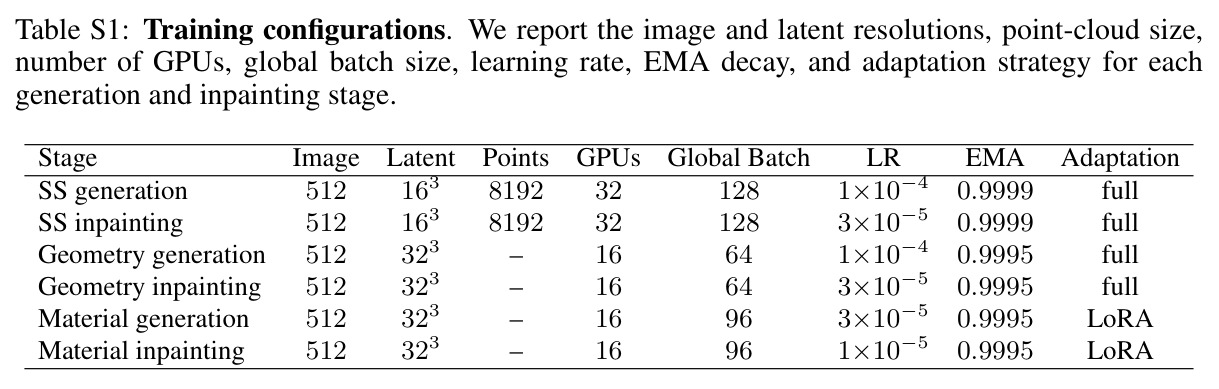
复现门槛中高。论文 v1 未声明开源代码(仅给出项目页),但训练与评估细节给得相当充分:Table S1 列出全部 6 个模型的分辨率、GPU 数、batch、学习率、EMA 与适配策略(SS/几何全量微调、材质 rank-8 LoRA),采样用 12 步 Heun、引导尺度 7.5/7.5/3.0;数据侧依赖公开的 3D-FRONT、SAGE-10k 与 ambientCG 材质库,渲染管线用 BlenderProc;评估协议(Horn Sim(3) 对齐、指标定义、GT 裁剪规则)在附录 C 完整给出。依赖的预训练模型 VGGT-Ω、DINOv3、TRELLIS.2 均有公开权重。算力上,SS 阶段用 32 卡、几何/材质各 16 卡训练,粗估需数百 A100-天量级;若无官方代码,自行复现数据切片、掩码对齐、轨迹钳制与羽化混合等大量工程细节,需要一个熟悉 3D 生成的小团队投入数周到数月。
论文图表
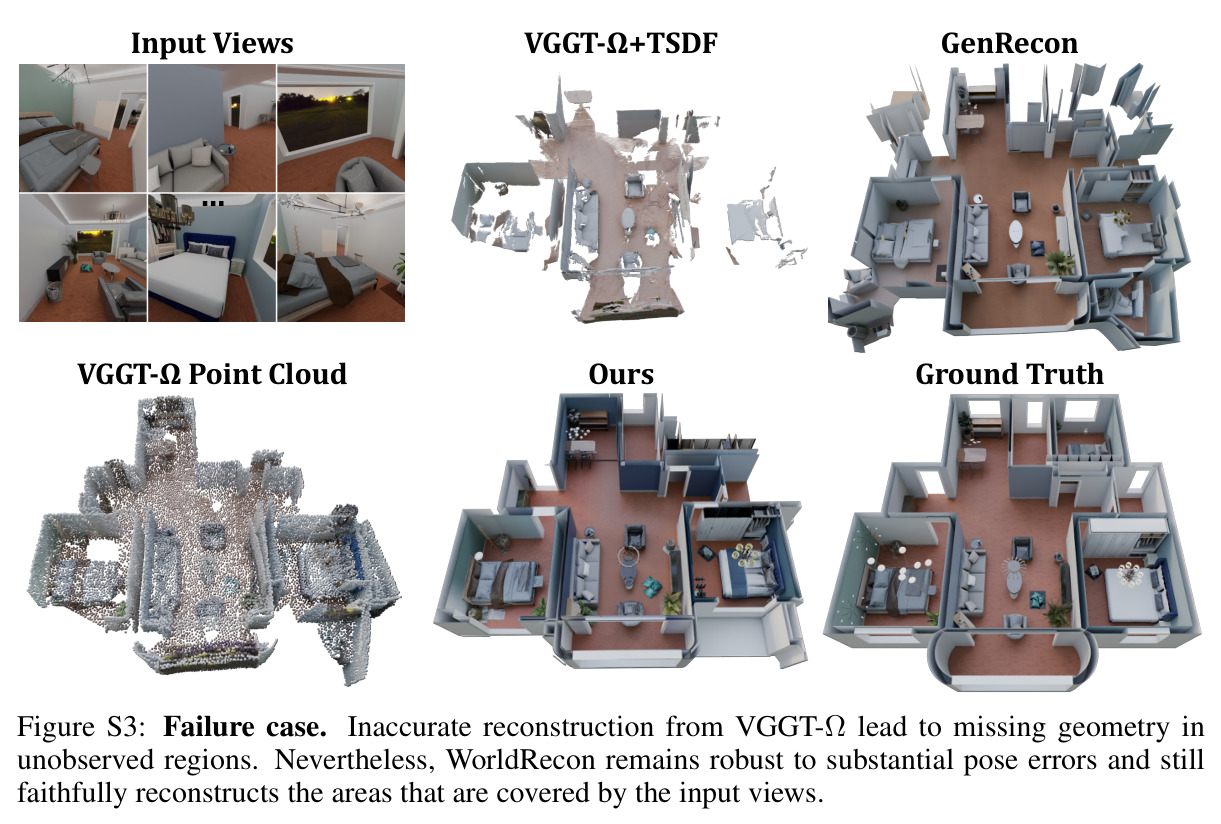
失败案例分析:一个多房间场景中部分区域被遮挡或仅有极少数视角覆盖,VGGT-Ω 点云脚手架出现位姿错估与置信度过滤导致的空洞;VGGT-Ω+TSDF 只能重建一小部分,GenRecon 因错误位姿投影产生大面积碎片伪影,WorldRecon 在有观测覆盖区域依然重建正确、对无点云区域给出合理幻觉补全,但未观测几何仍然缺失。
诚实展示方法边界:系统整体依赖脚手架质量,理解该失败模式对评估其在低覆盖输入下的可靠性至关重要,也直接关联局限性讨论。