解耦预测式决策:面向智能体的共享条件预测器 Decoupled Predictive Decision Making: A Shared Conditional Predictor for Agents
把智能体决策解耦为语义表示与条件预测,用共享冻结预测器从历史经验推断目标
前置知识
上下文学习与少样本提示
大语言模型无需更新参数、仅通过在提示词中放入若干输入-输出示例就能适应新任务的能力。少样本提示把历史样例连同标签塞进上下文窗口,由语言模型在生成时同时完成示例理解、关系归纳和答案产出。本文实验显示这种能力并不稳定:示例的标签频率和顺序都会系统性地左右预测结果。
少样本提示是本文的全部对照基线(zero-shot/few-shot prompting),DPDM 的所有增益都是相对它度量的;理解其失效模式才能看懂 DPDM 解耦的动机。
先验数据拟合网络(PFN)与上下文机制网络(CMN)
一类在合成预测问题上预训练的表格基础模型:训练时从先验分布采样海量随机数据集,训练 Transformer 只做前向推断——给定历史行、标签和查询行,直接在上下文中输出后验预测分布,完全不需要梯度更新。LimiX(CMN 前作)与 LimiX-2(本文用的 CMN)把这一思路扩展到分类、回归等通用结构化数据任务,用 32 条流水线聚合输出概率。
LimiX-2 是本文的共享条件预测器 $F_\theta$,整个方法成立的前提是存在一个免训练、可跨任务复用的条件推断引擎;不熟悉 PFN 就无法理解'冻结预测器也能从历史中学习'这一核心设定。
多数类标签偏差
上下文学习中,模型预测会偏向示例中出现频率最高的标签,且受标签排列顺序影响:当历史里绝大多数样例同属一类时,模型倾向于对新输入也复读该标签,即使当前案例需要不同判断。校准方法(如 contextual calibration)试图修正先验偏移,但效果有限。
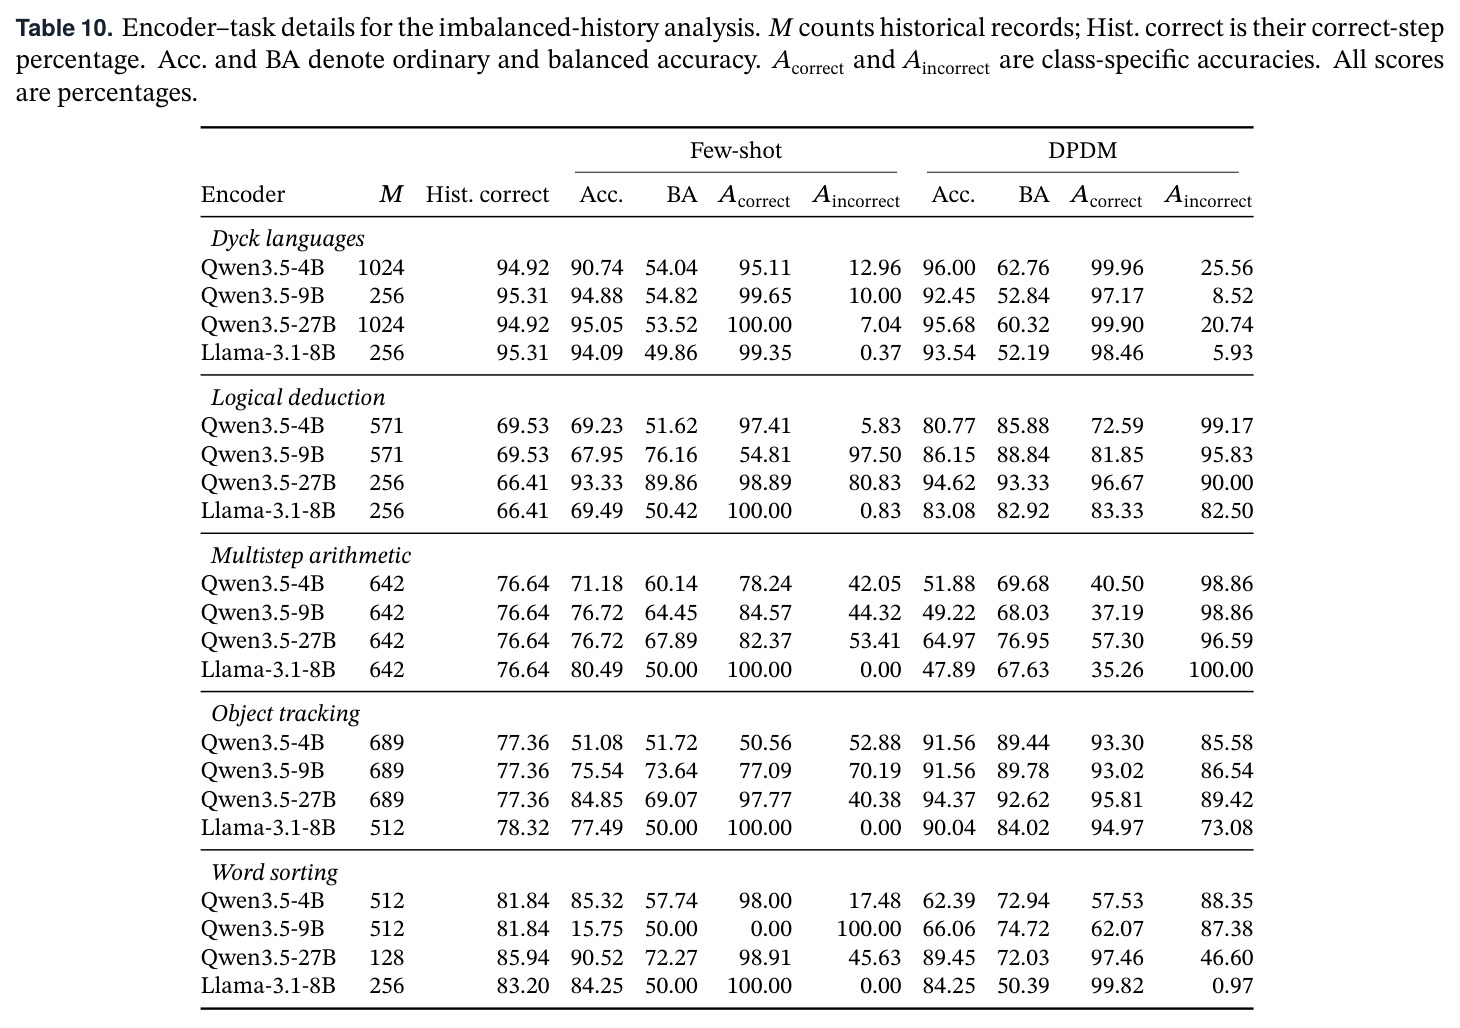
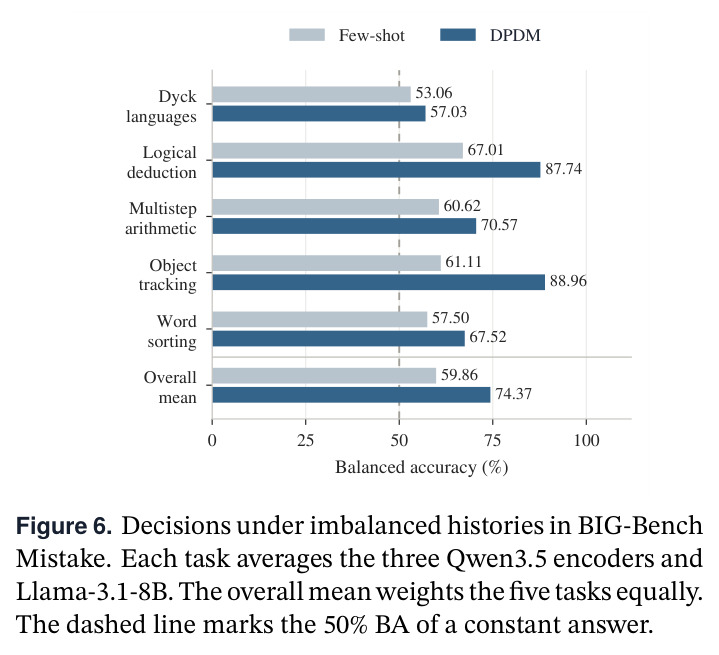
本文第 3.4 节的不平衡历史实验(BIG-Bench Mistake,正确步骤占 66.41%–95.31%)正是针对这一偏差设计的,平衡准确率指标和 DPDM +14.51% 的增益都围绕它展开。
平衡准确率(Balanced Accuracy)
二分类任务中两类各自准确率的算术平均:$\mathrm{BA} = \frac{1}{2}(\mathrm{Acc}_{\text{correct}} + \mathrm{Acc}_{\text{incorrect}})$,第一项是正确步骤被接受的比例,第二项是错误步骤被拒绝的比例。常数答案(全说对/全说错)在 BA 上只拿 50%,因此即使正负样本极不平衡,也能暴露模型是否真的会区分两类。
论文的推理步骤评估任务中正确步骤占绝对多数,普通准确率会严重高估性能;BA 是衡量'DPDM 真正学会拒绝错误步骤'的关键指标(如对象追踪任务 92.62% vs 69.07%)。
免参数更新的部署适应
模型参数在部署后保持冻结,适应只通过改变输入端信息实现:对 DPDM 来说是往历史集合 $S$ 中追加新观测 $\Delta S$,即 $S^+ = S \cup \Delta S,\ \phi^+ = \phi,\ \theta^+ = \theta$;特征变换 $\psi_{S^+}$ 在新历史上重拟合,两个神经模型都不动。这与微调、RLHF 等更新权重的路线形成对照。
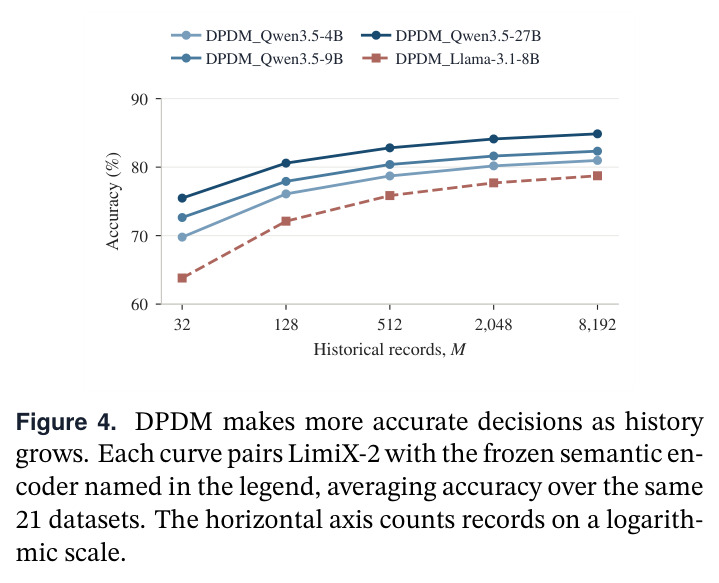
'两个模型全程冻结、只靠加历史就能持续变准'(Fig 4:历史从 32 涨到 8192 条时各编码器准确率单调上升)是论文的核心主张,也是'经验学习成为独立可改进能力'这一论断的基础。
研究动机
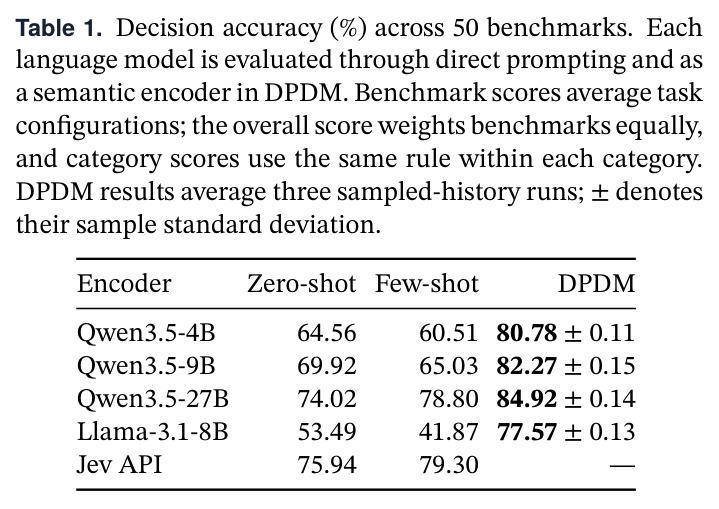
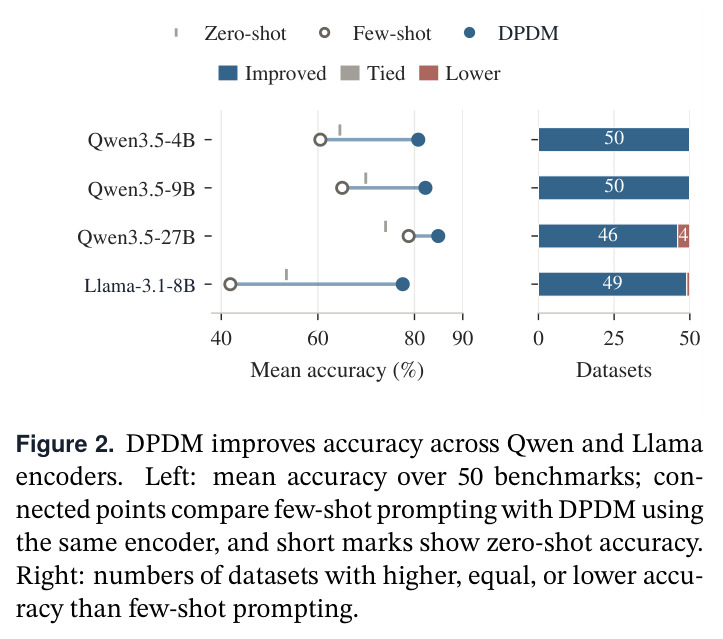
现有 LLM 智能体把'理解任务'与'从经验中学习'耦合在同一语言模型内部:少样本提示把历史样例和标签塞进 prompt,由 LLM 一站式完成语义解释、经验推理和答案生成。这种耦合带来两个实测问题。其一是经验利用效率低:在 50 个基准上,Qwen3.5-4B、9B 和 Llama-3.1-8B 的少样本提示准确率(60.51%、65.03%、41.87%)反而低于零样本(64.56%、69.92%、53.49%),说明 LLM 并不擅长在上下文中做条件推断;且受上下文窗口与显存预算限制,few-shot 能塞进的历史最多只有几千条。其二是多数类标签偏差:当历史中 66.41%–95.31% 的样本同标签时(如 BIG-Bench Mistake 里正确步骤占绝对多数),提示方法会复读多数标签,平均平衡准确率只有 59.86%,接近常数答案的 50%。更深层的问题在于架构:经验学习机制嵌在语言策略内部,不是可替换组件——语义能力的升级不会自动改善经验推断的质量,两条改进路线被焊死在一起。
本文的目标是本文要把智能体决策重新表述为通用条件推断问题,并让'从经验中学习'成为基础模型的一项独立、可单独改进的能力。形式化地:给定任务规范 $\mathcal{T}$、历史 $S=\{(r_i,y_i)\}_{i=1}^M$ 和当前查询记录 $r$,估计 $q_S(y \mid r, \mathcal{T})$ 并用决策规则映射为选择。具体目标有四条:(1) 语义编码器(冻结 LLM)只负责表示当前上下文与候选答案;(2) 一个跨任务共享的条件预测器(冻结的 LimiX-2)负责从表示化历史估计目标;(3) 两个模型的神经参数全程不更新,部署适应只通过追加历史记录 $\Delta S$ 实现;(4) 同一 LimiX-2 checkpoint 同时服务工具判断、候选偏好、推理步骤评估等异构决策角色,并可搭配不同语义编码器(Qwen3.5、Llama-3.1、StartLux)。
与已有工作不同的是,本文的独特切入是'解耦'。既有工作都在语言模型中心体系内组织经验学习:ExpeL 从经验中抽取洞见并检索示例,Rememberer 用 RL 反馈更新外部记忆,Algorithm Distillation 从 RL 交互历史学习,DPT 从交互上下文预测最优动作,PreDeToR 跨相关决策任务预训练奖励预测,SayCan 把语言规划与习得的技能价值结合。它们的经验推断机制都不是可独立替换的组件。本文则借用 Prior-Data Fitted Networks 与 Contextual Mechanism Networks 这条结构化数据预训练路线,把它通过'表示化记录 + 独立供给的历史标签'接口接到语义丰富的智能体决策上:LLM 只管语义表示,经验推断交给专门预训练的推断引擎。由此,'获取更多信息'(增长历史)与'更好地利用同样证据'(改进学习器)在架构上被显式分离,条件预测的任何进步都能通过统一接口惠及所有决策任务。
核心方法
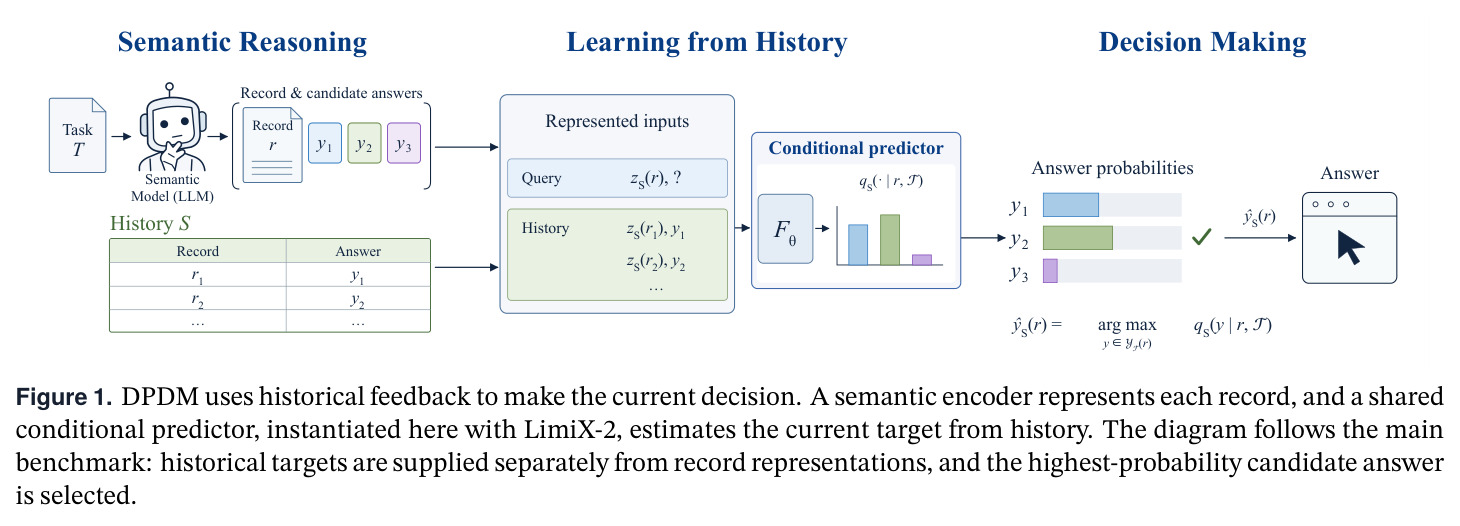
直觉上,每个任务定义的决策——选工具、评推理步骤、挑回答——都可以当成一张结构化表格上的分类问题:历史记录是带标签的训练行,当前案例是待预测的查询行,预测器在上下文中完成'训练+预测'。技术路线分三步。(1) 记录表示:冻结语义编码器 $J_\phi$ 在任务规范 $\mathcal{T}$ 上下文中独立编码每条记录,与原生字段 $b_\mathcal{T}(r)$、TF-IDF 词法特征一起经特征适配器映射为结构化行 $z_S(r) = A_{\psi_S}(J_\phi(r; \mathcal{T}),\, b_\mathcal{T}(r))$(式 1),其中 $\psi_S$ 是在历史输入上拟合的变换。(2) 条件预测:把表示化历史 $\tilde S = \{(z_S(r_i), y_i)\}_{i=1}^M$ 连同查询表示 $z_S(r)$ 送入预训练条件预测器 $F_\theta$,得到候选答案上的概率分布 $q_S(\cdot \mid r, \mathcal{T}) = F_\theta(\tilde S, z_S(r))$(式 2–3)。(3) 决策规则:剔除当前不可用候选后归一化,取概率最大者为答案。语义编码器参数 $\phi$ 与预测器参数 $\theta$ 全程冻结,历史标签不进入语义编码 prompt 而是单独作为监督信号供给。
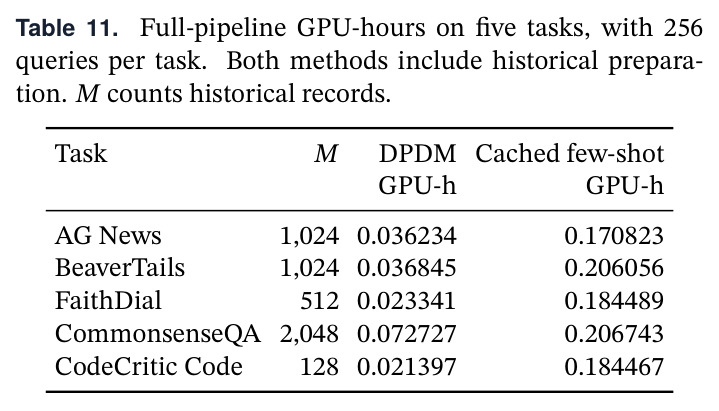
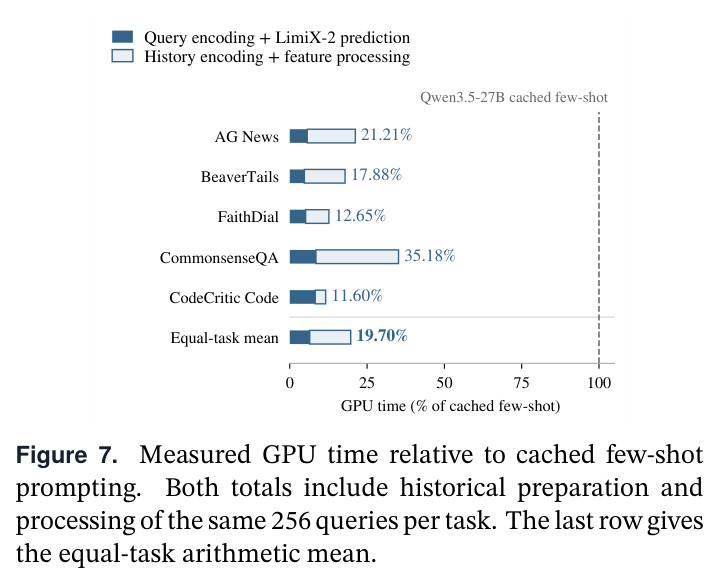
核心创新是把'学习机制'从'语言策略'中剥离,让智能体能力来自两条互补的预训练通道:语言预训练供给语义知识,结构化数据预训练供给经验推断能力。与少样本提示的本质区别在分工:few-shot 让 LLM 既解释历史又直接产出决策,而 DPDM 中 LLM 只独立编码每条输入及其候选描述,历史标签被排除在语义编码之外、单独交给共享预测器。这带来三个结构性好处:(1) 历史规模不再受 LLM 上下文窗口约束,可扩展到 8192 条记录(FaithDial 上用 8192 条历史达 83.53%);(2) 历史编码可跨查询缓存复用,全流水线 GPU 时间降至缓存 few-shot 基线的 19.7%;(3) 一个 LimiX-2 checkpoint 跨 4 个(附录中 8 个)编码器、5 类 50 个基准共享,条件预测器的任何改进都通过同一接口提升所有决策角色。任务定义 $\mathcal{T}$ 决定记录如何表示、输出如何映射到答案,预测器本身不含任何任务特定参数。
方法步骤详情
完整流程如下。(1) 任务规范 $\mathcal{T}$ 定义可见输入字段、预测目标含义和候选集 $\mathcal{Y}_\mathcal{T}(r)$,对历史与查询记录一致应用;例如 BFCL Callability 输入用户请求与函数 schema,目标标注是否有函数适用。(2) 语义编码:Qwen/Llama 用原生 chat 模板逐条独立编码(禁用思考模式),取最后一个非 padding token 的最终隐状态,多目标 prompt 的状态拼接、L2 归一化后经 PCA 压缩至至多 32 维。(3) 特征适配:拼接语义特征、TF-IDF 词法特征(历史上拟合的截断 SVD 降维)和原生数值/类别字段(类别映射与数值缩放在历史上拟合,查询未见类别视为缺失),得到 $z_S(r)$;所有变换只在历史输入上拟合,历史增长时重拟合。(4) 条件预测:历史行与标签 $\tilde S$ 加查询行送入冻结 LimiX-2(32-pipeline 聚合、禁用检索);超过 10 类时用确定性标签层级合并父类与叶节点概率;历史中未出现的类别初始概率为零;剔除不可用候选后归一化,若无剩余概率则均匀分布。(5) 决策:选概率最高候选,平局按候选顺序。(6) 部署适应:新观测 $\Delta S$ 到来时 $S^+ = S \cup \Delta S$、$\phi^+ = \phi$、$\theta^+ = \theta$(式 4),仅特征映射 $\psi_{S^+}$ 重拟合,编码在表示器不变时可复用。
技术新颖性
技术新颖性有四点。(1) 架构层面首次把结构化数据基础模型(LimiX-2,一个 Contextual Mechanism Network)作为智能体决策的共享推断核心:此前 PFN 系工作要么面向纯数值表格(TabPFN),要么面向 RL 控制与上下文赌博机(DPT、ICR-RL、BC-ICL),从未覆盖语义丰富的智能体判断;DPDM 用'LLM 表示 + 独立供给标签'的接口把它们接通。(2) 评估方法学上设计了两组关键对照:增长历史实验分离'更多证据'与'更好推断'两种收益来源;同历史同查询对照(82.33% vs 78.80%)证明优势并非来自额外记录。(3) 理论上给出风险分解 $R_m - R^*_{I_{or}} = \underbrace{R^*_I - R^*_{I_{or}}}_{\text{information gap}} + \underbrace{R_m - R^*_I}_{\text{inference gap}}$,把决策误差区分为信息缺口(历史没揭示的关系)与推断缺口(学习器没用好已有关系),并用附录 I 的受控环境数值化:64 条历史时推断缺口为每百次决策 2.624 次失败,信息缺口仅 0.00115。(4) 证明与决策后训练路线(StartLux)互补而非替代:已重度决策训练的 StartLux-27B 仍能从条件预测再获 2.72 个点的提升。
实验结果
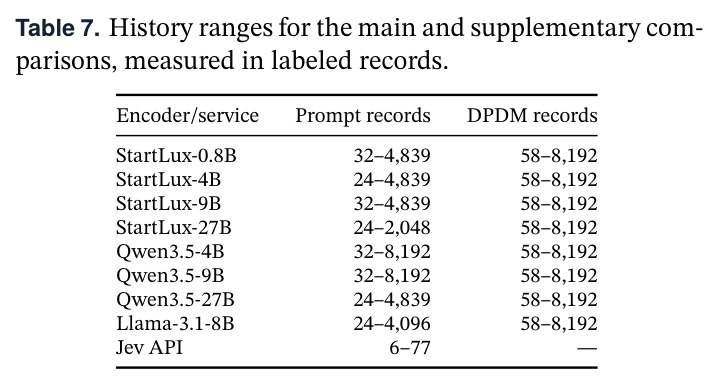
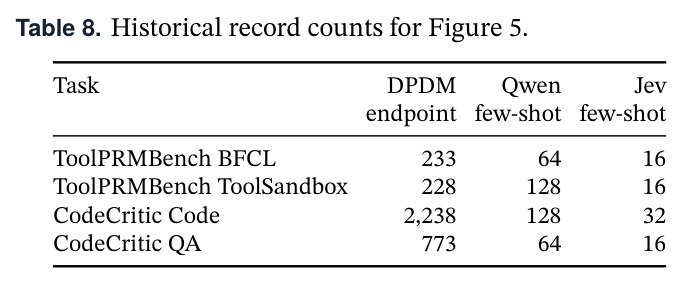
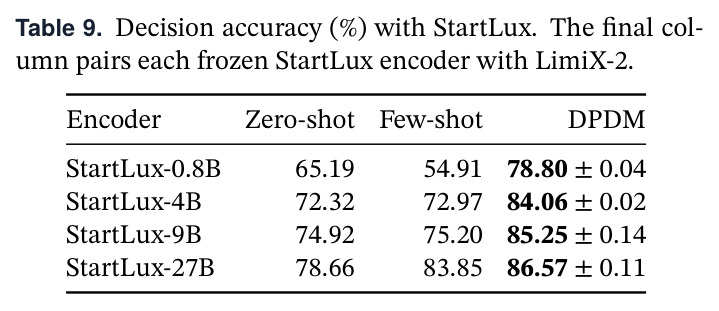
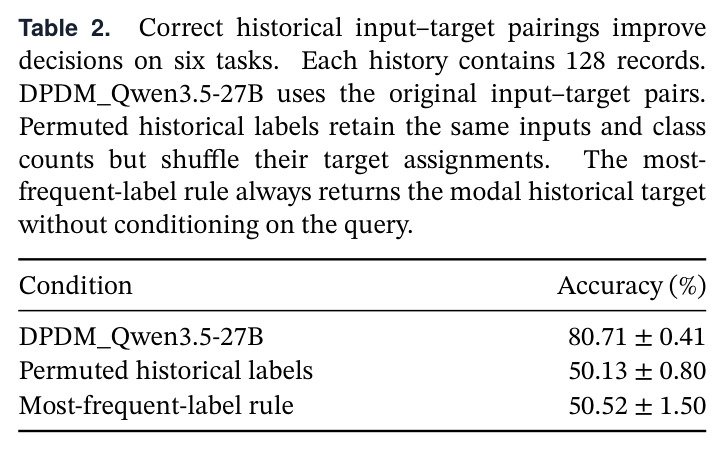
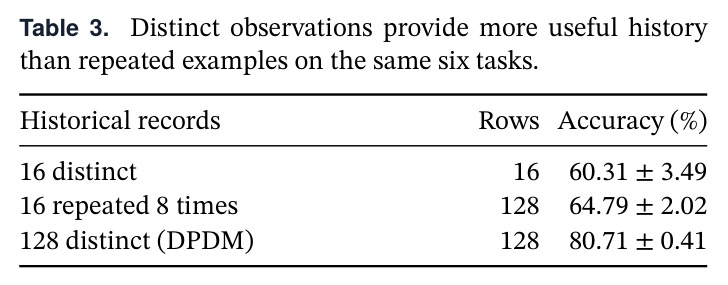
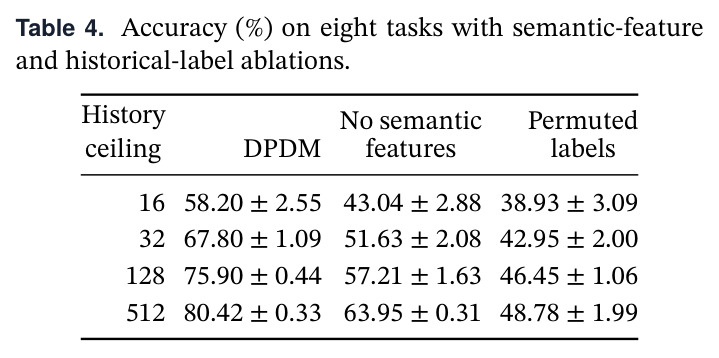
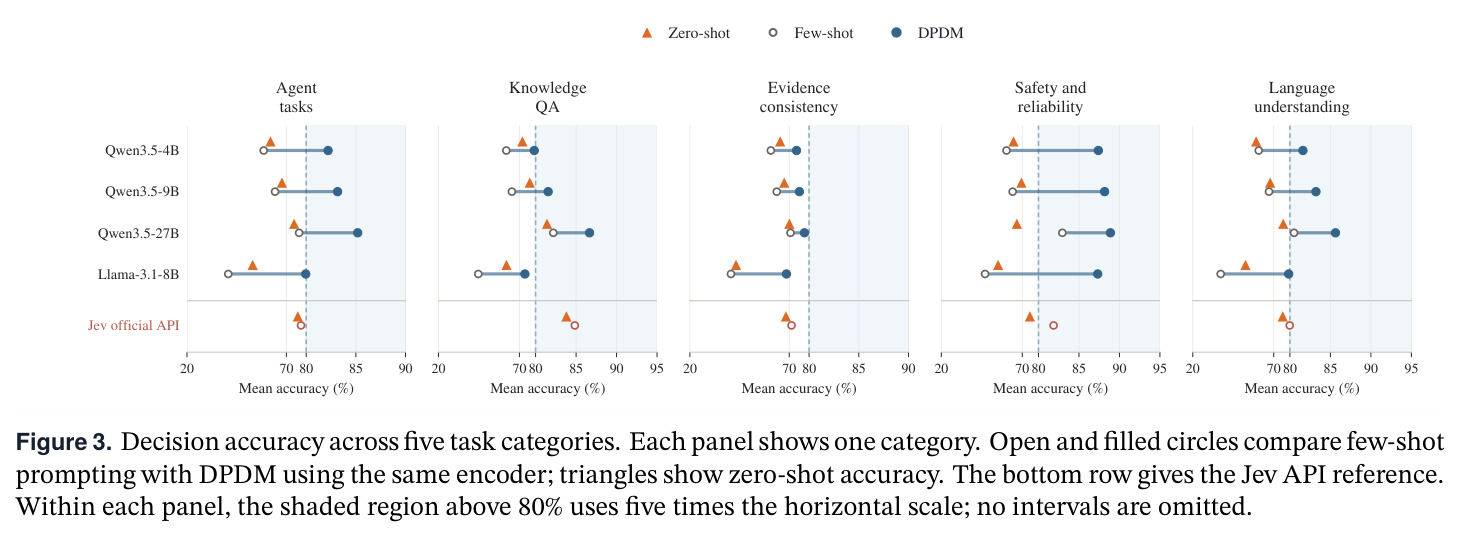
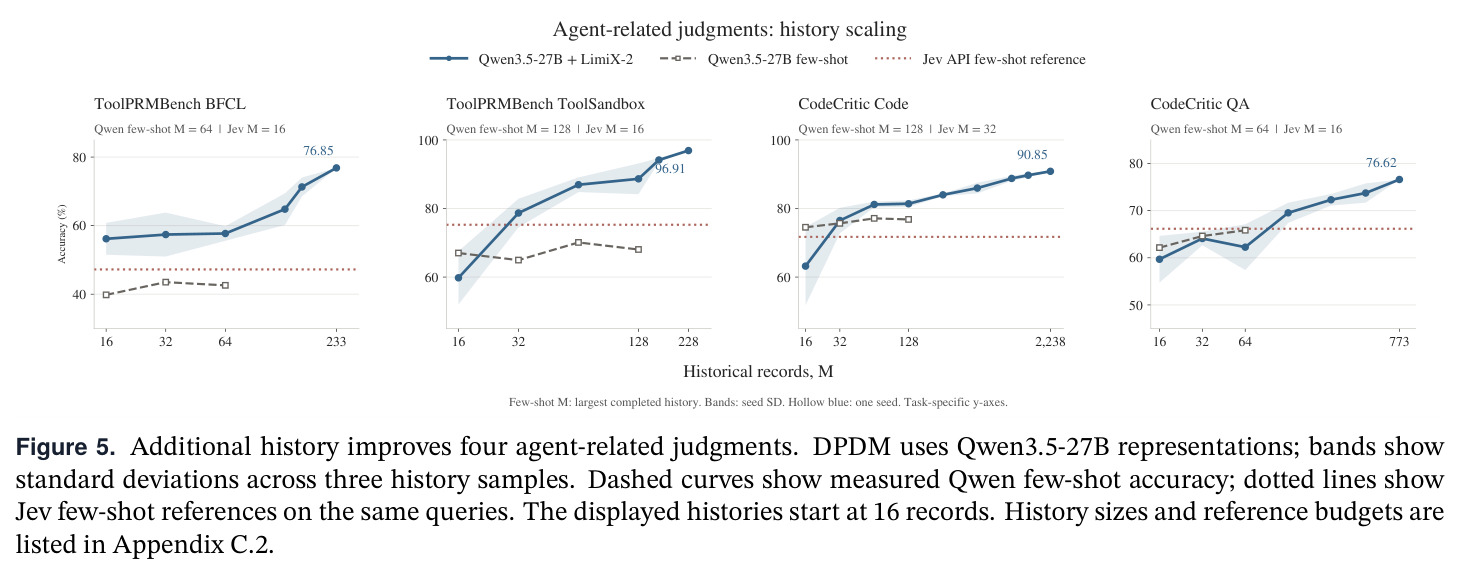
逐一分析核心实验。(1) 主对照(Table 1,50 基准 82 任务配置,各方法用各自最大完成历史):DPDM 以 Qwen3.5-27B 为编码器达 84.92±0.14%,vs 少样本 78.80%(零样本 74.02%);4B 为 80.78 vs 60.51;9B 为 82.27 vs 65.03;Llama-3.1-8B 为 77.57 vs 41.87。DPDM 在 46/50 个数据集上胜出(27B 编码器),两个较小 Qwen 编码器上 50/50 全胜,Llama 上 49/50。(2) 单项增益:ToolPRMBench BFCL 绝对提升 34.26 个点(76.85% vs 42.59%),ToolSandbox 提升 28.87 个点(96.91% vs 68.04%);CodeCritic Code 从 76.82% 升至 90.85%。类别层面(Fig 3)agent 任务中 Qwen3.5-9B 从 64.30% 升至 83.16%,Llama 从 40.77% 升至 79.73%,五个类别全部领先。(3) 同历史同查询对照:DPDM 82.33% vs few-shot 78.80%(27B),配对成绩 78.37/60.51(4B)、80.08/65.03(9B)、73.83/41.87(Llama),证明优势不靠更多记录。(4) 增长历史(Fig 4,21 基准,$M$ 从 32 到 8192):4B 从 69.78% 升至 80.98%,9B 从 72.65% 至 82.33%,27B 从 75.48% 至 84.87%,Llama 从 63.81% 至 78.74%,每个历史规模均有提升。(5) 不平衡历史(Fig 6,BIG-Bench Mistake 5 任务 7032 查询,正确步骤占 66.41–95.31%):平均平衡准确率从 59.86% 升至 74.37%(+14.51),20 个编码器-任务对中 18 个提升;对象追踪上 DPDM 92.62% BA vs 69.07%,正确拒绝 93/104 个错误步骤 vs few-shot 的 42 个。(6) 控制实验(Tables 2–4):置换历史标签后从 80.71% 崩至 50.13%(最频繁标签规则 50.52%);128 条不同记录 80.71% vs 16 条重复 8 次 64.79%(同 128 行差 15.92 个点);去掉语义特征后 512 条历史下从 80.42% 降至 63.95%,置换标签降至 48.78%。三项控制共同证明输入-目标关系、独特观测和语义表示三者都有独立贡献。(7) StartLux-27B(决策后训练模型)上 DPDM 仍从 83.85% 提至 86.57%。(8) 算力(Fig 7):DPDM 全流水线 GPU 时间为缓存 few-shot 的 19.7%,平均降低 80.3%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 50 基准总体(Qwen3.5-27B 编码器,各自最大历史) | 平均决策准确率 | 84.92% | 少样本提示 78.80% | +6.12pp |
| 50 基准总体(Llama-3.1-8B 编码器) | 平均决策准确率 | 77.57% | 少样本提示 41.87% | +35.70pp |
| 50 基准总体(同历史同查询对照) | 平均决策准确率 | 82.33% | 少样本提示 78.80% | +3.53pp |
| ToolPRMBench BFCL(工具使用步骤评估) | 准确率 | 76.85% | Qwen3.5-27B 少样本 42.59% | +34.26pp |
| ToolPRMBench ToolSandbox | 准确率 | 96.91% | Qwen3.5-27B 少样本 68.04% | +28.87pp |
| CodeCritic Code | 准确率 | 90.85% | Qwen3.5-27B 少样本 76.82% | +14.03pp |
| BIG-Bench Mistake(5 任务,不平衡历史) | 平均平衡准确率 | 74.37% | 少样本提示 59.86% | +14.51pp |
| BIG-Bench Mistake 对象追踪(689 条历史,77.36% 正确) | 平衡准确率 | 92.62% | Qwen3.5-27B 少样本 69.07% | +23.55pp |
| 标签置换控制(6 任务,128 条历史) | 准确率 | 80.71%(原始标签) | 置换标签 50.13% / 最频繁标签规则 50.52% | 约 +30pp |
| 独特 vs 重复记录控制(同 128 行) | 准确率 | 128 条不同记录 80.71% | 16 条重复 8 次 64.79% | +15.92pp |
| 语义特征消融(8 任务,512 条历史上限) | 准确率 | 80.42% | 去语义特征 63.95% / 置换标签 48.78% | +16.47pp / +31.64pp |
| StartLux-27B(决策后训练模型) | 平均决策准确率 | 86.57% | 少样本提示 83.85% | +2.72pp |
| 计算成本(5 任务,256 查询/任务) | 全流水线 GPU 时间 | 缓存少样本基线的 19.7% | Qwen3.5-27B 缓存少样本提示 | 降低 80.3% |
局限与改进
作者承认或可从文中推出的局限:(1) 评估集中于单步分类式判断(工具可用性、步骤正误、候选偏好、意图识别),决策规则只是 argmax,未覆盖开放式动作生成、长程交互规划等真正的多步智能体任务;(2) 系统依赖历史标签的质量与覆盖——标签置换实验显示错误配对会让准确率崩到 50.13%,意味着部署中必须有可靠的反馈通道,而现实部署的标签噪声未被评估;(3) 冷启动与新颖候选处理粗糙:历史中未出现的类别初始概率为零、单类历史直接输出概率 1,缺乏处理真正新选项的机制;(4) 主对照中各方法使用'各自评估的历史预算'(few-shot 受上下文限制、DPDM 可到 8192 条),虽然同历史对照部分弥补了这一点,但许多单项增益(如 BFCL 的 34.26 个点)仍混入了历史规模差异。我的补充观察:(5) 表示环节有损——LLM 隐状态被 PCA 压到 32 维、词法特征用 TF-IDF 忽略词序,长推理链的时序与因果结构可能丢失,多步算术任务上 DPDM 的普通准确率反而下降(4B/9B 为 51.88%/49.22% vs few-shot 71.18%/76.72%)就是证据;(6) 风险分解只在 4 上下文×2 动作×2 部署的玩具环境数值化,真实任务无理论保证;(7) 缺少与 ExpeL、Rememberer 等经验学习方法的直接数值对比,仅有 prompting 和 Jev API 参考。
独立分析的弱点
独立分析四个弱点并给出改进方向。(1) 有损且无交互的记录表示:每条记录被独立编码为 32 维 PCA 向量加 TF-IDF 特征,样本间的条件相似性完全压给 LimiX-2 从行向量中发现,长轨迹(PRM800K、CodeCritic 的推理链)中的步骤依赖关系基本丢失;改进方向是用池化多头编码或轻量序列编码器替代 PCA,甚至让条件预测器直接消费 token 级表示。(2) 单轮 argmax 决策缺乏不确定性利用:没有拒答、升级人工、代价敏感等下游机制;不平衡实验显示 DPDM 有时矫枉过正(多步算术任务普通准确率下降 19–30 个点、只优化了 BA),改进方向是引入期望代价决策规则与校准的弃权阈值。(3) 历史的选择本身是决策变量:附录 I 显示匹配部署的历史达 85.00% 期望成功率而错配历史只有 50.00%,但正文对分布漂移、历史污染、过期经验的检测与修剪没有任何机制;改进方向是加漂移检测、按时间加权的历史维护或主动遗忘。(4) 任务形态覆盖窄:全部 82 个配置都是分类目标,LimiX 系列支持的回归、时间序列未验证,序贯决策与 RL 场景(ICR-RL、Algorithm Distillation 所面向的)未打通;改进方向是把回报回归、动作排序纳入同一条件预测接口并做多步环境实验。
未来方向
作者提出或基于成果可延伸的方向:(1) 条件预测器预训练的专门化——为'语义表示记录'定制 CMN 预训练分布,让'从经验学习'像语义模型一样拥有独立的 scaling 曲线和评测基准,这是论文'经验学习成为基础模型能力'论断的自然延伸;(2) 主动经验收集与保留——既然历史决定实例化的决策函数,何时收集、保留哪些记录、何时重置历史就成为与学习器改进并列的研究目标;(3) 打通与 RL 路线的接口,把 DPT、ICR-RL、BC-ICL 的序贯决策场景纳入 DPDM 的表示-预测-决策框架;(4) 在真实多步交互环境(Web、代码执行、具身)中验证端到端智能体,而不仅单步判断;(5) 规模化研究决策后训练与条件预测的叠加效应——本文只测了 StartLux 一个家族,Codestral/对话类后训练模型是否同样互补值得系统实验;(6) 用信息缺口/推断缺口估计做部署监控:实时判断当前瓶颈是数据不足还是推断不足,指导收集数据还是升级学习器;(7) 跨任务共享——同一部署内多任务共享历史池或适配器状态 $\psi_S$,研究经验在任务间的迁移与干扰。
复现评估
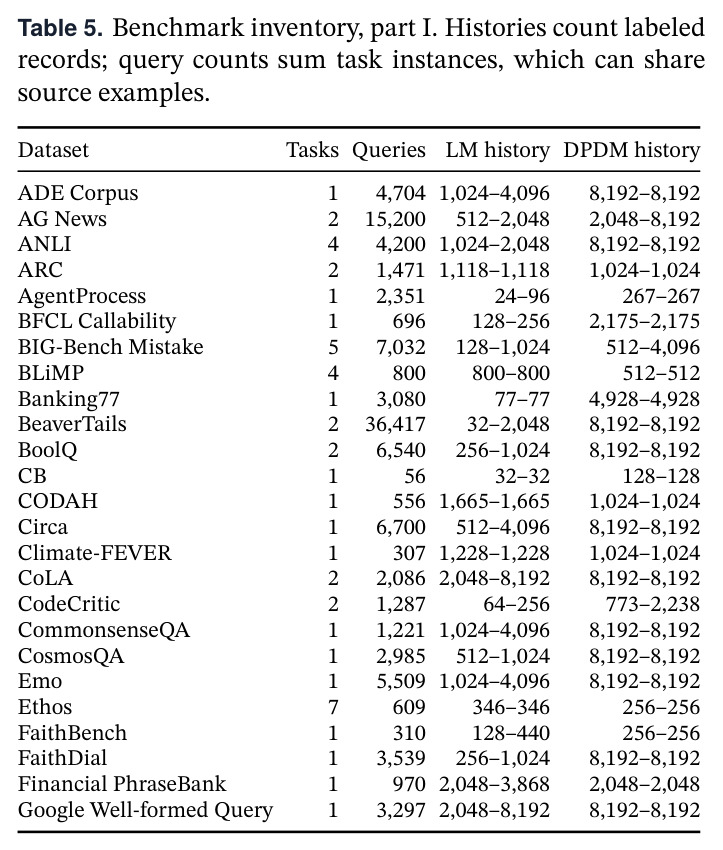
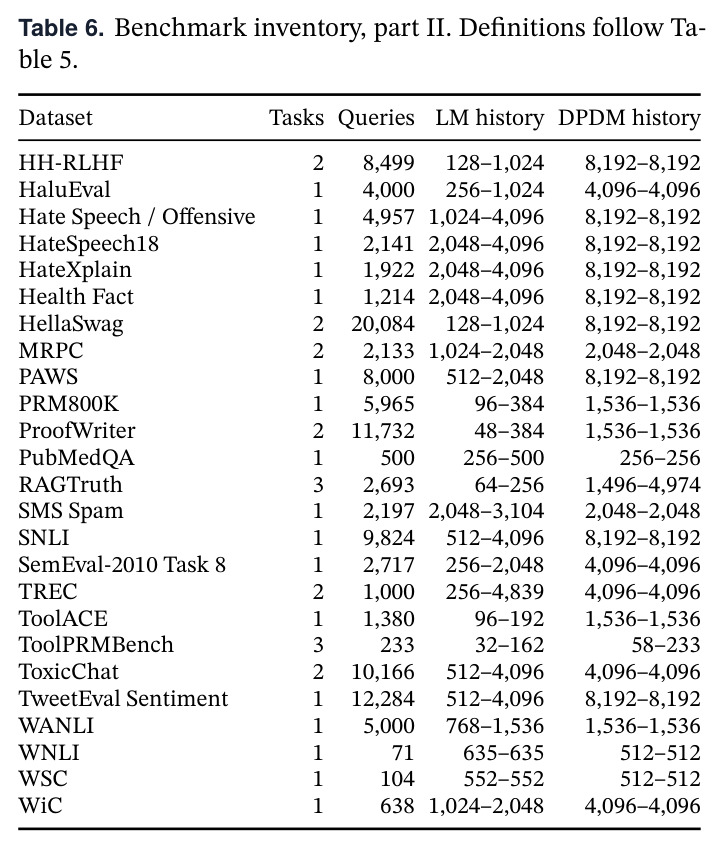
复现评估:所用模型与数据基本公开——Qwen3.5-4B/9B/27B、Llama-3.1-8B-Instruct 均为开源权重,StartLux-Decision-v1 有 GitHub 发布,LimiX-2 有 arXiv 报告(2609.17488,LimiX 系列一贯开源),Jev API 为商业服务(可选对照)。50 个基准全部公开(BFCL、ToolPRMBench、CodeCriticBench、BIG-Bench Mistake、AG News、BeaverTails、FaithDial 等)。附录 A/C 极其详尽:chat 模板与禁用思考、PCA 至 32 维、TF-IDF+截断 SVD、32-pipeline 聚合、标签层级解码、历史采样种子 11/23/47、预算范围(DPDM 58–8192 条、提示 24–8192 条)、数据集内任务平均再数据集等权的聚合规则,甚至计时协议(附录 G)都写明。算力需求低:DPDM 全程前向推断不训练,计时实验用单张 Pro6000 级 GPU 即可完成,8192 条历史的编码在 82 任务×4 编码器上有一定 GPU 时开销但可控。不确定性小:三历史采样的标准差仅 ±0.11–0.15,结果稳定。风险点:论文未明确声明代码开源,特征工程(PCA/SVD/类别映射)的细节虽已描述但复刻实现仍需细心;总体复现难度中等,主要工程量在搭建整条表示-预测流水线。
论文图表