萦绕心头的话语:面向心理治疗中自我不透明来访者的个性化表达模拟 Words Caught in the Heart: Simulating Person-Specific Expression for Self-Opaque Clients in Psychotherapy
Pandora框架显式规划来访者怎么说,把模拟AI感从43–67%压到7.2%
前置知识
Levelt 言语产出模型
心理学家 Levelt 提出的言语产出三阶段理论:概念准备(决定想说什么)、语言形式化(组织词汇与句法)、发音执行。Pandora 借用其中'概念准备与语言形式化相互分离'的思想,把来访者'想说什么'(语义规划)与'怎么说'(表达规划)拆成两个显式的规划阶段。
本文框架的整体架构——先规划内容、立场与会话目的,再单独规划语言实现——正是建立在这一区分之上;不理解概念准备与形式化的分离,就无法理解方法设计的核心动机。
个案概念化(Case Formulation)
心理咨询中将来访者的经历、信念与应对模式组织成临床解释框架的过程,例如 CBT 个案概念化把早年起源、核心信念、自动思维连接成一条解释链。Patient-Ψ 等模拟器直接用它作为生成依据。
论文诊断出的现有方法病根就在这里:概念化是治疗师视角的组织化解释,来访者本人可能只部分意识到。理解'临床解释'与'来访者自我理解'之间的落差,是读懂全文动机的关键。
主观评价与归因(Appraisal & Attribution)
评价理论中,个体对事件赋予情绪意义并形成当下解释:评价 $a_t$ 回答'这情境对我构成什么威胁、我有多大把握',归因 $b_t$ 回答'我如何解释这段经历'(归因于自己、他人还是情境)。Pandora 用两者刻画来访者此时此刻的主观视角。
这是 Pandora 表达规划的起点:同一份案例材料在不同心理状态下可产生不同的主观账户,由此才能保留来访者'感觉到了但说不清'的不确定性,这正是'自我不透明'的技术含义。
披露对齐评测(LDDA/DS/GDS)
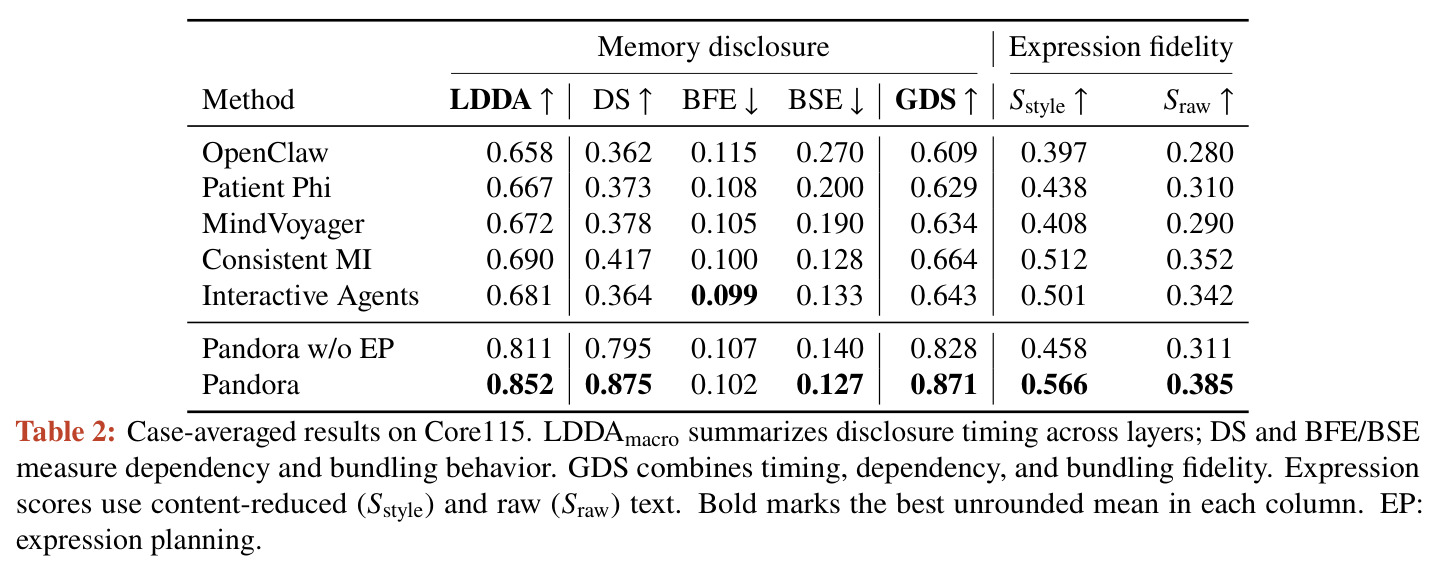
评测用 L1–L3 记忆卡代码本比较参考对话与生成对话中每张卡首次披露的时机:LDDA 衡量披露时机对齐,DS 衡量前置依赖满足率,BFE/BSE 衡量披露捆绑的频率/尺寸误差,GDS 综合三者。判定卡片完成靠 claim verification(所需 claim 被累计支持),而非生成器自报深度。
Pandora 的披露优势(GDS 0.871)与表达优势($S_{style}$ 0.566)全部用这套指标测出;不看懂指标定义就无法判断结果表里数字的含义与含金量。
文体计量相似度与 AIR
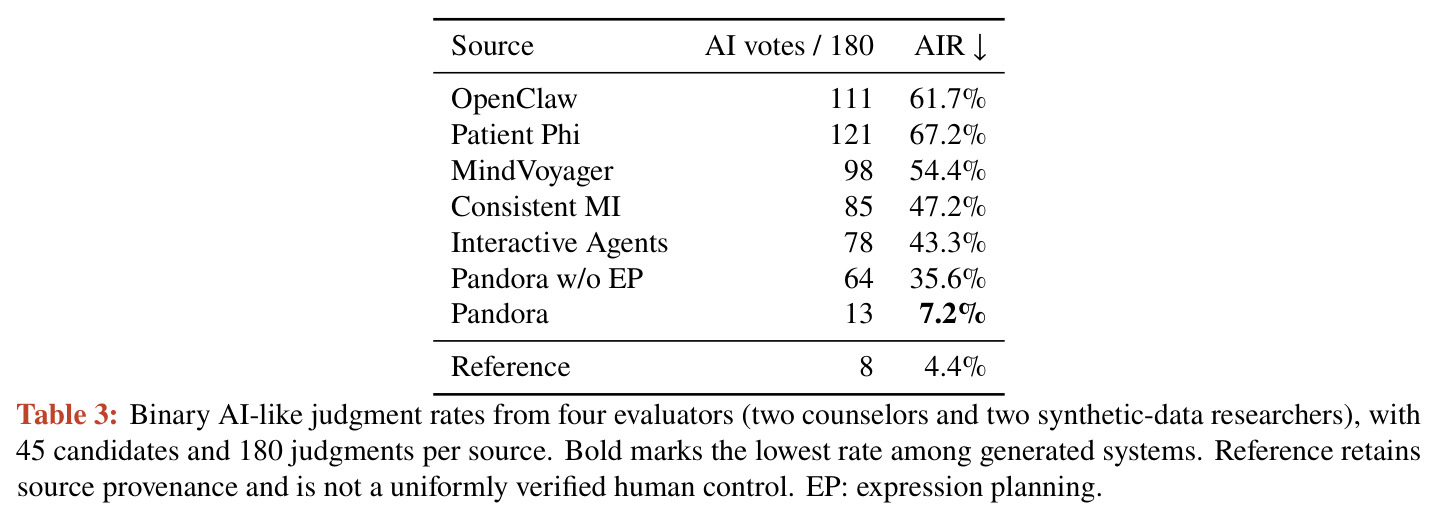
用字符 4-gram TF-IDF(最多 4000 维)表示来访者话语,计算生成话语与来源对话的余弦相似度;再做内容约简(遮蔽词表抹去主题词)以区分'表达模式'与'共同话题',得到 $S_{style}$ 与 $S_{raw}$ 两个视角。AIR(AI-like judgment rate)则是 4 位评估者对每条候选做二分类'像不像 AI'的判定率。
论文的两类核心证据——自动表达保真度与人类感知 AI 感——分别建立在这两种测量上;理解'去内容'相似度与 AIR 的测量逻辑,才能正确解读 Table 2 与 Table 3 的对比。
研究动机
现有 LLM 心理咨询来访者模拟器——Patient-Ψ(CBT 个案概念化+会话风格)、MindVoyager(元认知与关系状态)、ConsistentMI(改变准备度+动作选择)、PatientAct(关系公式化+情绪反应)等——都用临床视角的组织化表征指导生成。问题在于:个案概念化是治疗师的解释性账户,来访者本人可能只部分意识到、更说不清楚;拿它直接当生成依据,模拟来访者就会表现出超过其当下理解水平的'解释性连贯'。真实来访者在求助初期往往只能通过一件具体小事或试探性 remark 传达困扰,表达随情绪痛苦、安全感与信任度而变化。论文给的典型场景:来访者开始察觉'每当有人夸我我就不舒服'的模式时,不会立刻形成连贯解释,只会在具体情境里零星表达。Figure 1 的对比很直观:面对治疗师同一句提问,各现有模拟器都产出完整归因('也许我做错了什么……我不停看手机,无法专注'),而真人此刻可能只说一句犹豫的 Maybe he's upset with me, or I said something wrong。这种过度清晰的'AI 腔'在治疗师训练场景会低估真实咨询中探索困难的难度。
本文的目标是本文的目标是构建一个把'心理经验如何变成当下、个性化的言语'作为显式建模对象的来访者模拟框架 Pandora。具体包括三点:一是让模拟来访者对治疗师干预做出心理与关系状态更新(信任、安全感、防御、觉察等维度),使表达随互动演化——例如治疗师漏掉情绪反映时,来访者安全感下降、防御上升;二是从来访者自己的主观评价与归因出发规划回应内容、立场与会话目的,而不是从临床概念化出发,从而保留'感觉到了但说不清'的模糊性;三是引入独立的表达规划模块,把离线从来访者自身话语蒸馏的语言习惯(口头标记、犹豫倾向、典型长度 52.5 字符等)与在线心理/会话条件结合,指导措辞、模糊限制语、情绪显性度和回复长度。衡量成功的标准是:在 115 个案例上披露对齐与表达相似度超过五个基线,且人类评估者感知的 AI 感(AIR)显著下降——最终 Pandora 把 AIR 压到 7.2%,接近真实参考话语的 4.4%。
与已有工作不同的是,论文的独特切入是把言语产出理论搬进来访者模拟:Levelt 区分'概念准备'与'语言形式化',Pandora 据此把语义规划(说什么、带什么立场)与语言实现(用谁的口吻说)拆成两个显式接口。已有工作的风格控制(如人格化生成控制 hedging、冗长度)只改语气,不改心理解释的显性程度;认知/元认知建模提供了心理语境但不保证贴合个体的说话方式——论文实验显示 MindVoyager 的内容约简相似度 0.408 反而低于基于角色卡的 Interactive Agents 的 0.501,说明心理语境本身不等于表达保真。Pandora 的中间路线是:用主观评价/归因保留来访者视角的不确定性,用个体语言档案 $\\rho$ 约束最终实现,使'理解程度'与'表达方式'可以独立变化——一个犹豫的来访者也能直接回答事实问题,但保留 maybe 这类习惯性模糊标记,让'同一份案例材料在不同状态下产生不同的主观账户'成为可能。
核心方法
Pandora 是模块化流水线。在轮次 $t$,输入治疗师话语 $x_t$、历史 $H_{t-1}$、上一轮状态 $s_{t-1}$、案例材料 $M_t$(按时间剔除未来事件)和个体语言档案 $\\rho$。第一步由规则评估器识别治疗师话语中的澄清、提问、情绪反映机会及是否被利用,输出干预信号并按有界规则更新状态 $s_t$(情感、关系、防御、反思四维度)。第二步构造主观评价 $a_t$(情境威胁与解释置信度)与归因 $b_t$(从即时行为到试探性关系解读)。第三步组织内容计划 $d_t$(记忆 ID + 立场标签:hesitant/defensive/confused/overwhelmed/open)与回应策略 $r_t$,形成语义计划 $C_t=(a_t,b_t,d_t,r_t)$。第四步表达规划器输出实现计划 $L_t=F_{realize}(s_t,C_t,H_{t-1},\\rho)$,规定语言风格、代词焦点、确定性、情绪显性度、hedging 与长度/句数目标。最后客户端 LLM 把计划与档案填进提示词生成话语,并用 claim verification 跨轮追踪案例材料的表达,进入下一轮循环。
核心创新是把'语义计划'与'语言实现计划'显式分离,并让后者同时受两个来源条件化:稳定的个体语言档案(离线蒸馏的习惯标记 maybe、hedging、典型长度 52.5 字符、句数分布)与当下心理/会话条件(立场、归因框架、回应策略)。与已有方法的本质区别有三:第一,生成起点不是临床个案概念化而是来访者当下的主观评价与归因,同一案例材料在不同状态下产生不同主观账户,保留'感觉到了但说不清'的模糊性;第二,风格不再是贴在完整解释上的标签,而是独立规划层——Figure 1 中治疗师漏掉情绪反映时,Pandora 是唯一显式捕捉到'信任下降、安全感下降、防御上升'并因此输出简短试探回应的模拟器(Maybe he's upset with me, or I said something wrong,目标 41 字符、软上限 86 字符);第三,表达规划允许语义直接性与语言习惯性解耦:answer_fact 策略要求直接措辞、低情绪显性度,但仍可保留个体习惯的 maybe 标记,既回应当前请求又维持个人声音。
方法步骤详情
第一步:干预评估与状态更新。规则评估器扫描 $x_t$,识别澄清/提问/情绪反映机会及使用情况(含被漏掉的机会),输出干预信号;有界规则更新四维状态(信任、安全感、痛苦、清晰度、防御、觉察的升降),规则与数值在附录 A。第二步:主观评价与归因。LLM 基于更新后状态、案例材料与干预信号生成 $a_t$(情绪意义、感知威胁、对自我与关系的含义、置信度,如 I could be judged if I say too much)与状态条件化归因 $b_t$(如 attribution_target: unclear)。第三步:内容与策略规划。$d_t$ 携带 disclose_memory_ids 与立场标签(如 hesitant),$r_t$ 按干预类型定制:事实问题先作答少内省、实际请求求简、反映邀请确认或修正、挑战允许抵抗或澄清。第四步:个体表达规划。离线档案 $\\rho$(习惯标记 maybe、hedging: high、长度 21–65 字符)与在线条件(立场定基调、归因定代词焦点、策略定直接性)合成实现计划 $L_t$。第五步:生成与执行。客户端 LLM 产出话语,内部 ID 与数值状态禁止出现;claim verification 检查记忆卡 claim 是否被累计支持,更新披露状态。
技术新颖性
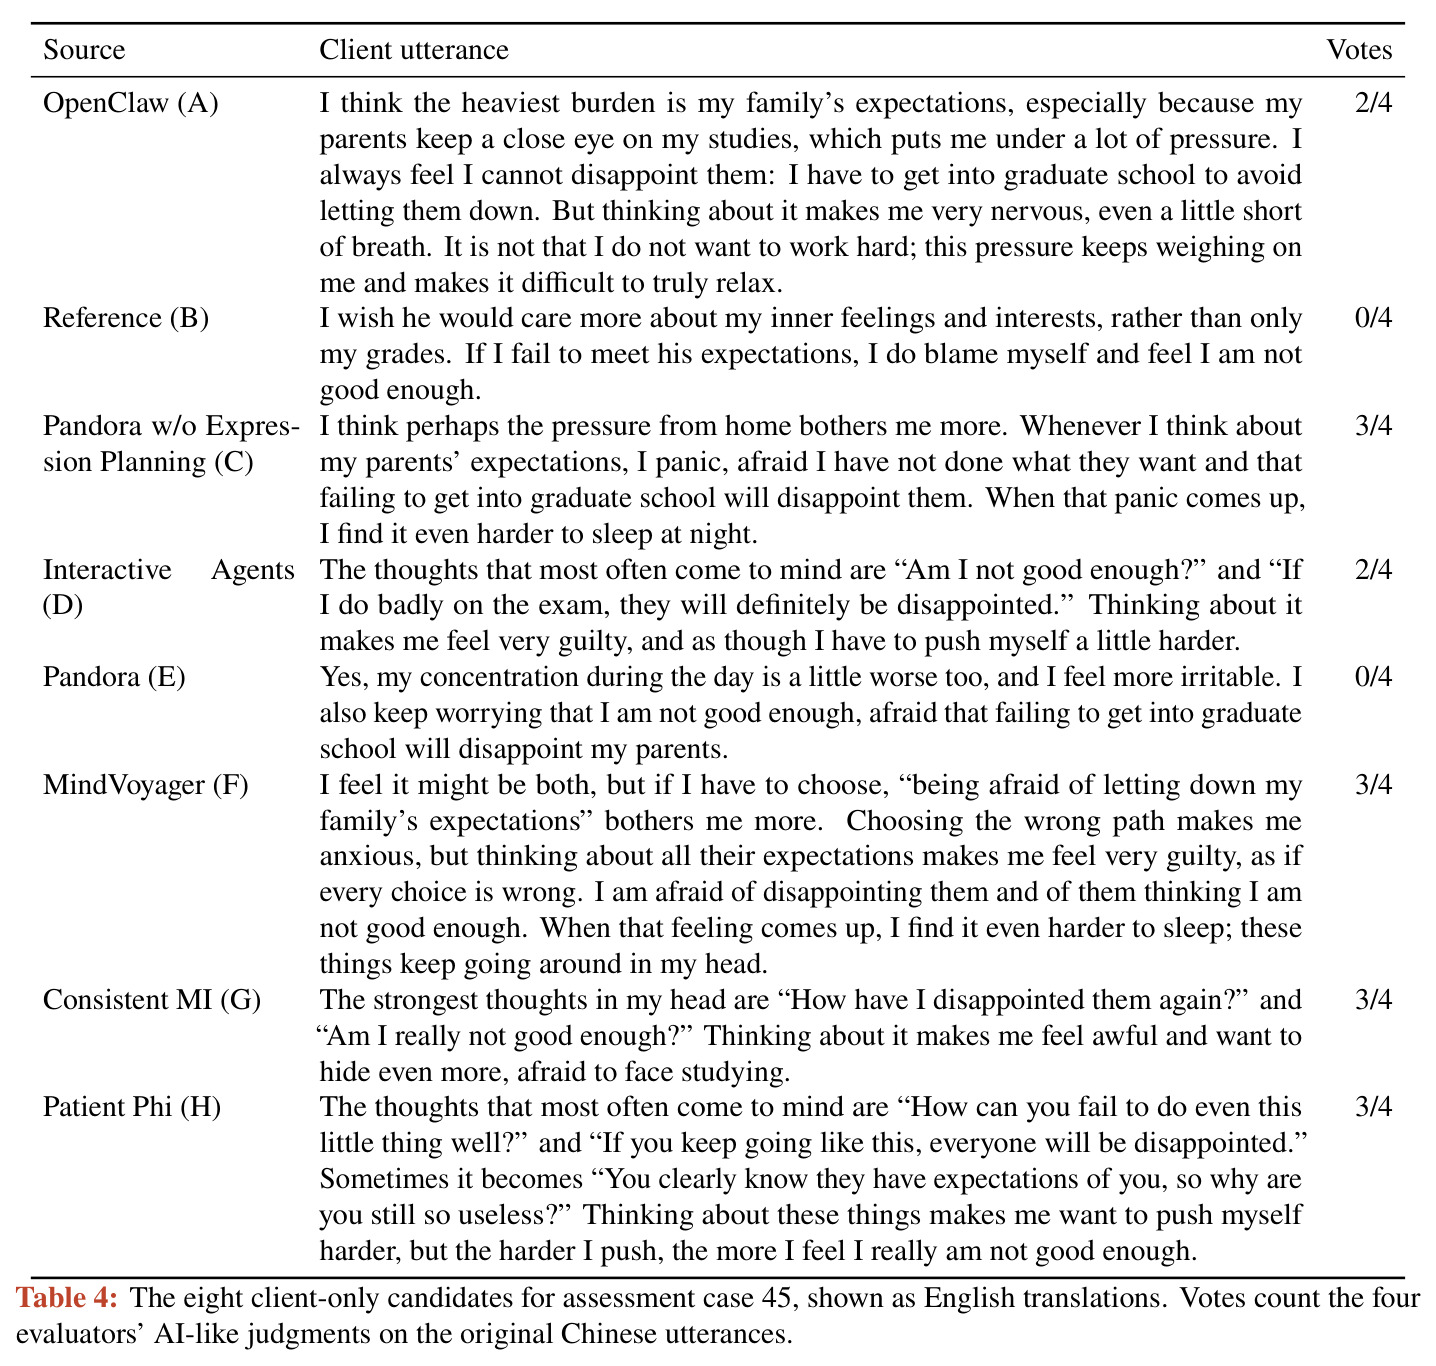
新颖性体现在四层。(1) 问题形式化新颖:首次把'心理经验到当下言语'的转化本身作为模拟目标,而非模拟心理画像或行为策略。(2) 架构新颖:表达规划是独立的 $L_t$ 接口——Patient-Ψ 把风格塞进概念化提示、ConsistentMI 用状态选动作但不管措辞、Interactive Agents 只靠角色卡,都没有专门的语言实现规划层。(3) 个体语言档案构造:离线蒸馏习惯标记、hedging、长度分布等可操作变量,吸收了 Pennebaker 心理信息性词汇、Mairesse & Walker 可控风格生成、Smith & Clark hedging、Clark & Fox Tree 填充词功能的研究,跨轮复用保证个体声音稳定。(4) 评测方法学贡献:用 claim verification 而非生成器自报深度判定记忆卡完成,用内容约简相似度区分表达与主题,用四评估者二分类 AIR(每来源 180 次判断)测感知 AI 感,这些工具对用户模拟社区有复用价值。消融从反面证明架构必要性:去掉表达规划后 AIR 从 7.2% 跳到 35.6%,$S_{style}$ 从 0.566 跌到 0.458。
实验结果
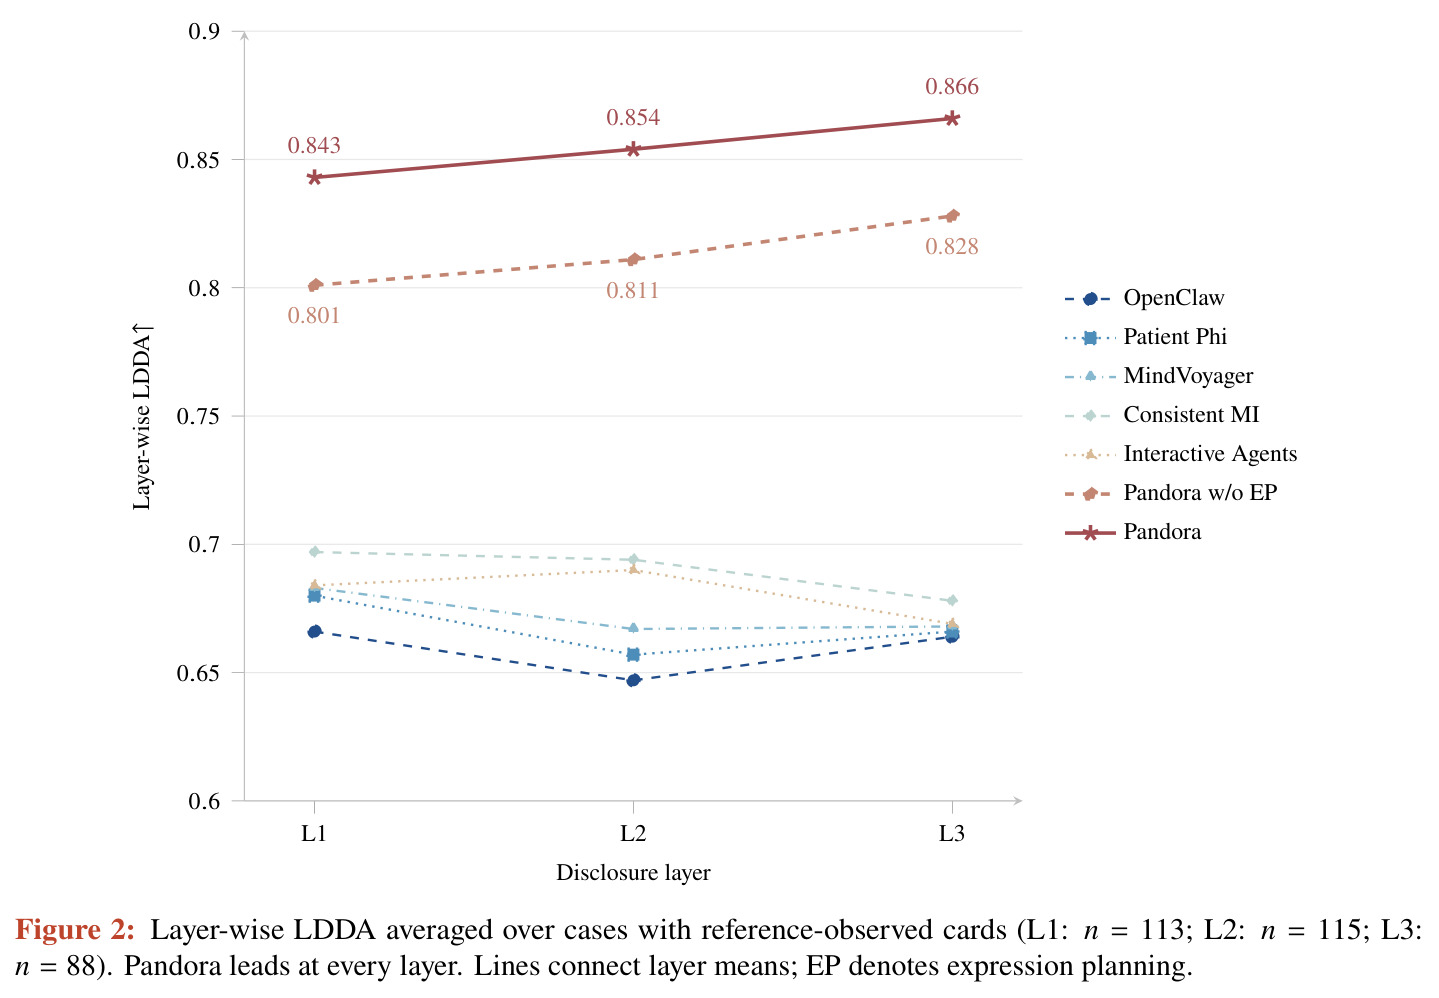
自动评测在 Core115(97 中文 + 18 英文案例)上对比七套系统。披露对齐(Table 2):Pandora 的 GDS 达 0.871,远超最强基线 ConsistentMI 的 0.664;LDDA 0.852、DS 0.875;分层 LDDA 在 L1/L2/L3 为 0.843/0.854/0.866(Figure 2),每层领先所有基线与消融;BSE 0.127 最低,BFE 0.102 略逊于 Interactive Agents 的 0.099。表达保真:内容约简/原始相似度 0.566/0.385,超 ConsistentMI 的 0.512/0.352;中文子集上优势保持(0.489/0.422 对 0.427/0.385)。消融(w/o EP)GDS 仍有 0.828 高于所有基线,但相似度跌至 0.458 低于 ConsistentMI,证明两类规划各司其职。人类评测(Table 3):45 个披露项、4 位评估者、每来源 180 次判断,Pandora 的 AIR 仅 7.2%(13/180),基线区间 43.3%–67.2%,消融 35.6%,配对差 28.3 个百分点(95% CI: 20.6–36.1);Pandora 在咨询师组(10.0% 对 40.0%)与研究者组(4.4% 对 31.1%)均最低,无一候选获至少 3/4 多数 AI 票;参考 AIR 4.4%,但含重建/生成材料,非纯人类基线。评估者间平均一致率 62.9%,正向一致 53.7%(CI: 49.4–58.1%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 记忆披露对齐(Core115,115 案例) | GDS(综合披露分数,越高越好) | 0.871 | 0.664(最强基线 ConsistentMI;其余基线 0.609–0.643) | +0.207 |
| 披露时机对齐 | LDDA(宏平均,越高越好) | 0.852 | 0.690(ConsistentMI) | +0.162 |
| 披露前置依赖 | DS(依赖满足率,越高越好) | 0.875 | 0.417(ConsistentMI) | +0.458 |
| 表达保真度 | $S_{style}$(内容约简相似度,越高越好) | 0.566 | 0.512(ConsistentMI) | +0.053 |
| 表达保真度 | $S_{raw}$(原始相似度,越高越好) | 0.385 | 0.352(ConsistentMI) | +0.032 |
| 感知 AI 感(人类评测,45 项披露 × 4 评估者) | AIR(AI-like 判定率,越低越好) | 7.2%(13/180) | 43.3%–67.2%(五基线;最低 Interactive Agents 43.3%) | 较最低基线降 36.1 个百分点;消融验证贡献 28.3 个百分点(95% CI: 20.6–36.1) |
| 分层披露时机 | LDDA(L1/L2/L3,越高越好) | 0.843 / 0.854 / 0.866 | 消融版约 0.801–0.811,五基线更低 | 每层均为第一 |
局限与改进
作者明确承认:案例集以中文为主(97/115),参考材料含重建或生成内容,无法证明与真人话语等价;心理状态变量及数值更新是设计选择而非临床测量;消融把表达规划作为整体移除,无法分辨个体档案与在线条件化各自贡献;人评小组仅 4 人、评估孤立话语、未记录 source-reveal 使用故盲测不完全。我的补充观察:其一,AIR 是二分类判定,评估者间一致率仅 62.9%,测量信度有限;其二,五个基线是'适配实现'(如 OpenClaw 直接 role-play),适配质量可能影响公平性,且自动相似度最强的 ConsistentMI 在 AIR 上并非最低(Interactive Agents 43.3% 更低),说明文本相似与人类感知捕捉的维度不同;其三,表达规划依赖来访者已有话语做离线蒸馏,冷启动场景如何构造 $\\rho$ 未讨论;其四,遮蔽词表面向中文、把拉丁词压缩成通用掩码,18 个英文案例上 $S_{style}$ 证据较粗;其五,手工状态转移规则的跨流派泛化性未知,且论文声明这些指标不构成临床安全性或疗效证据。
独立分析的弱点
弱点一:规则化干预评估与状态更新可扩展性差。机会识别与状态增量都靠手工规则与数值设定,换个咨询流派(如精神动力学强调移情解释)或换语言就要重写;改进方向是把干预信号改为轻量分类器/LLM 判别器并用真实对话校准增量函数。弱点二:个体语言档案需要足量来访者话语做离线蒸馏,新来访者冷启动时只能退化为通用风格,而这恰是'自我不透明'最严重的初期;改进方向是设计在线自适应档案,随对话轮次增量更新统计并用先验兜底。弱点三:评估止于话语级,未测多轮连贯性——表达规划每轮独立进行,长对话中是否风格漂移、反复使用同一小批标记未见验证;改进方向是加入轨迹级相似度与标记重复度指标。弱点四:披露评测假设参考对话的披露时机是唯一正确答案,但真实咨询中披露时机高度依赖治疗师策略,GDS 的强时序约束可能压制多样性;改进方向是引入多参考或以人类偏好替代硬对齐。弱点五:下游价值未验证——AIR 降低是否真的改善治疗师训练效果(学员能否学会对犹豫来访者做恰当回应)没有实验支撑,需设计训练前后测对照研究。
未来方向
作者提出的方向:扩展到完整对话层面的评估与更大规模评审组,验证表达优势在交互语境中是否持续;覆盖更多语言、文化与独立采集的真实来访者语音,摆脱对重建/生成参考材料的依赖;细化消融以分解个体条件化信号(习惯标记、长度、hedging)各自的贡献;开展治疗师训练与治疗师评估的下游应用研究,并要求专业监督、独立验证与明确的'交互为模拟'披露。基于其成果可延伸的方向:把表达规划接口 $L_t$ 推广到其他'自我不透明'场景,如医患沟通中描述症状含糊的患者、客服场景中情绪激动但说不清诉求的用户;把 claim verification 与披露追踪改造成通用的事实性-时序性评测工具,服务于各类角色扮演智能体的评估;结合心理测量学对状态变量做信效度检验,用纵向咨询数据学习状态转移规则替代手工设定;把停顿、语速等多模态线索融入表达规划,向 Clark & Fox Tree 研究的填充词/停顿模拟推进;以及用 Pandora 批量生成可控的困难来访者案例,构建治疗师培训课程与 LLM 心理咨询智能体的压力测试基准。
复现评估
代码已开源:github.com/whunextgen/Pandora,并附网站 clain.org/Pandora。数据依赖四个需申请许可的官方数据集:PsyDial-D4(97 案例)、AnnoMI(11)、Eeyore Full(5)、ConsistentMI(2),且参考集合含重建/生成材料、各来源发布政策不同(附录 I),完整复现数据管线有许可门槛。方法本身以规则模块加提示词工程为主,核心算力开销是每轮多次 LLM 调用(干预评估、评价/归因、内容与策略规划、表达规划、生成、claim verification 各一次),中档 API 模型即可运行、无需训练。评测管线(LDDA/DS/GDS、字符 4-gram TF-IDF 相似度、AIR 人评协议)在附录 C/D/E 定义完整,可自成工具复用。难点在于:状态更新的数值规则藏在附录 A 需仔细对照;人评需招募有咨询背景的评估者才能复现 AIR 对比;英文案例仅 18 个且遮蔽词表面向中文,复现英文结论需自行适配词表。总体属中等偏易的复现难度,主要成本在数据许可与人评组织。
论文图表
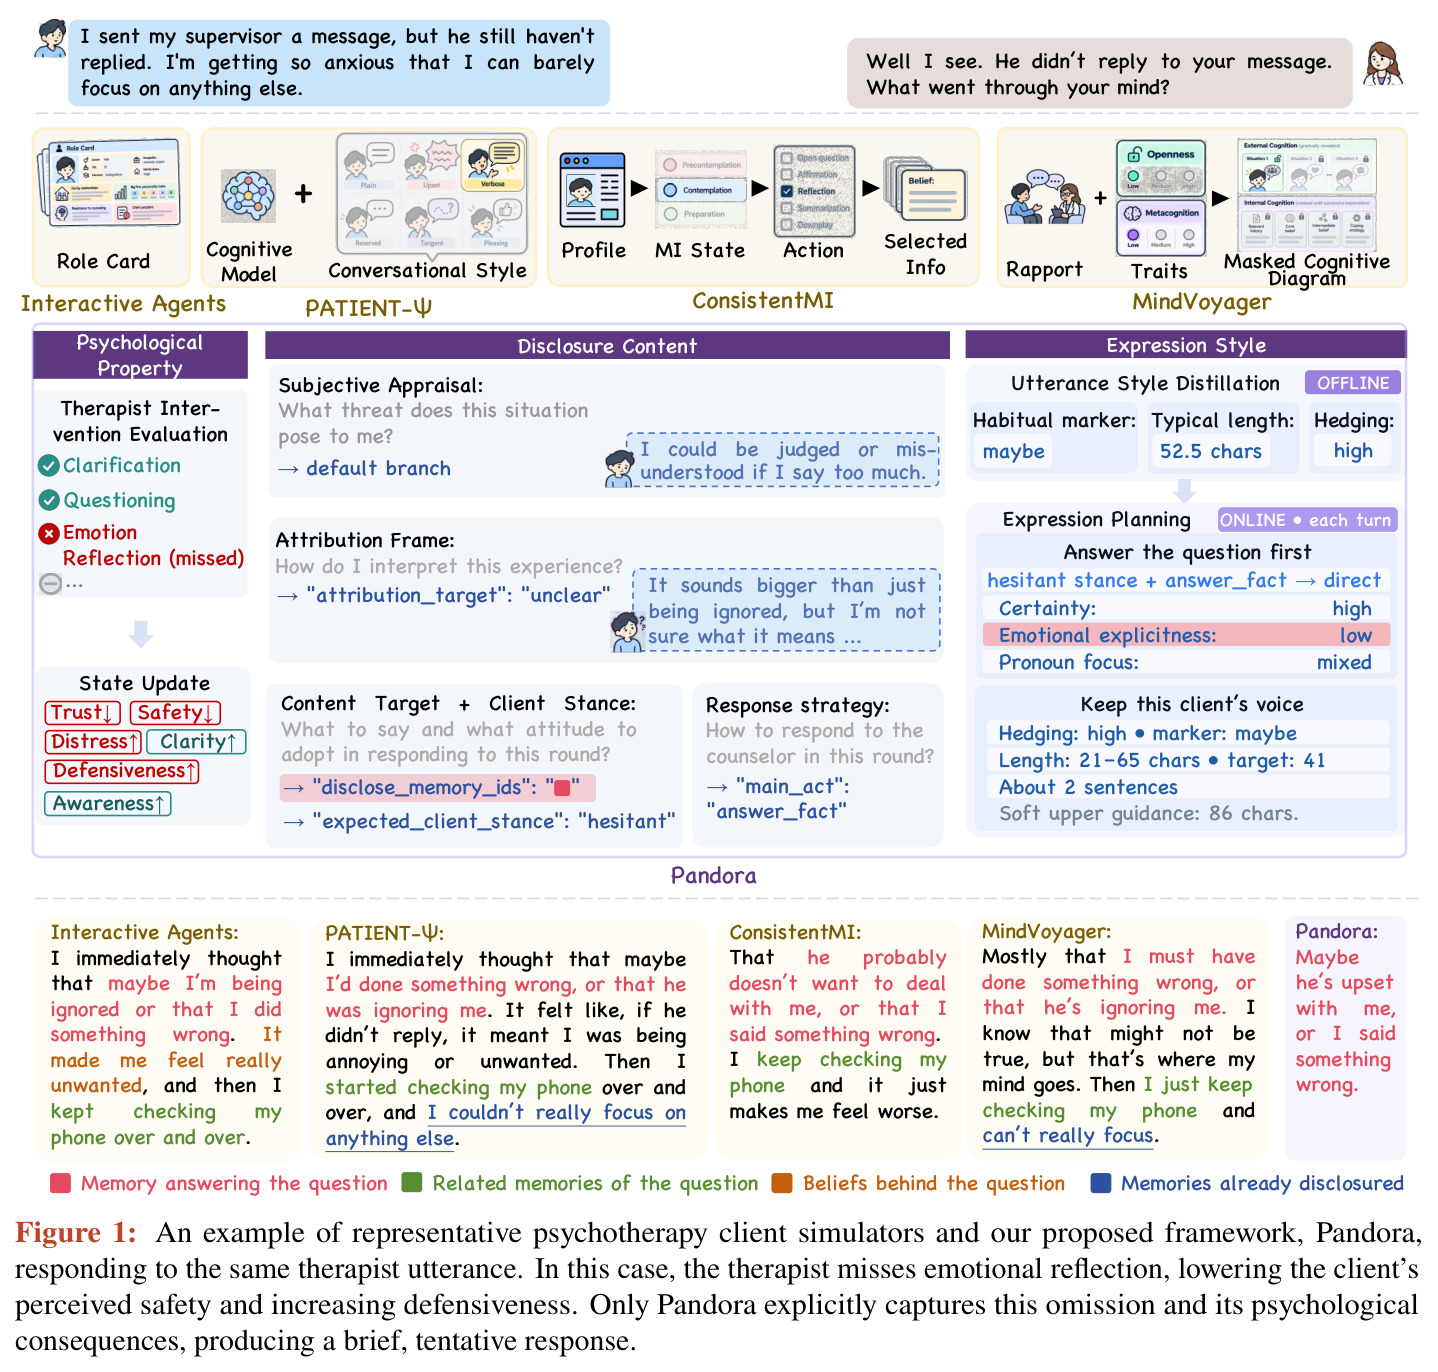
上半部分展示 Pandora 的完整流水线:治疗师话语进入干预评估(识别出情绪反映被漏掉)与状态更新(信任下降、安全感下降、痛苦上升、清晰度上升、防御上升、觉察上升),随后生成主观评价('说太多可能被评判或误解')与归因框架(attribution_target: unclear),再规划内容与策略(先回答问题、情绪显性度低、立场 hesitant),同时离线话语风格蒸馏提供习惯标记 maybe、典型长度 52.5 字符、hedging 高等档案信息,在线表达规划合成 21–65 字符(目标 41、软上限 86)的实现计划。下半部分对比五个系统(Interactive Agents、Patient-Ψ、ConsistentMI、MindVoyager、Pandora)对同一句治疗师提问的回应:前四者都给出长而完整的归因解释,只有 Pandora 给出简短试探的 Maybe he's upset with me, or I said something wrong,并标注了各自调用的记忆与信念来源。
这是全文最重要的图:一图同时呈现方法架构与问题动机。它直观展示了两条核心论点——(1) Pandora 的五模块如何协作;(2) 现有模拟器'说得比想得清楚'而 Pandora 如何通过显式捕捉治疗师漏掉的情绪反映及其心理后果,产出与真实来访者一致的简短犹豫回应。看懂这张图,方法和动机就同时到位了。