Mind2Dialogue:通过模拟用户心理状态训练人类感知型语言模型 Mind2Dialogue: Training Human-Aware Language Models by Simulating User Mental States
用共享演化心理状态的模拟器生成特权监督,蒸馏出理解用户心智的助手模型
前置知识
特权信息学习
Vapnik 提出的学习范式:训练时允许教师模型使用学生在部署时拿不到的额外信息(特权信息),学生只从可见输入与目标响应中学习;广义蒸馏将其推广为教师利用特权信息产出教学信号。本文中特权信息正是驱动用户行为、却在训练与推理时对学生扣留的模拟心理状态。
这是全文的骨架:Oracle 凭状态生成回应目标,学生在状态被隐藏的条件下做监督微调,理解这个不对称设计才能看懂数据构造与训练目标。
心智理论
推断他人信念、意图与情感并据此预测行为的能力。AI 领域常用 ToMi、BigToM 等叙事型基准评测,BigToM 要求同一场景的真信念与假信念两个变体都答对才计分(TB∧FB),以排除死记硬背。
本文与个性化并列的两大评测域之一,用来检验从模拟交互中学到的东西能否迁移到对他人心理状态的纯推理任务。
用户模拟器
用 LLM 扮演设定了人格与目标的用户,与助手多轮对话来合成训练数据。静态 persona 提示只固定背景描述;本文的模拟器还维护随对话演化的结构化状态,并用行为控制器在每一轮切换对话行为模式。
M2D-SIM 是整条数据生产流水线的引擎,其状态维护与行为控制直接决定语料的多样性和连贯性。
监督微调与 LoRA
SFT 用自回归交叉熵在目标回复的 token 上训练策略;LoRA 冻结原模型权重、只训练低秩增量矩阵,配合 4-bit 量化可在单张消费级显卡上微调 7-8B 模型,是参数高效微调的标准组合。
M2D-CHAT 三个底座统一采用 LoRA + 4-bit + response-only masking + AdamW 余弦调度,复现实验时需要按此配方设置。
个性化评测
检验模型是否把用户偏好与情境真正用于回应。PersonaMem 系列考察记忆与隐式偏好的多选题准确率,PrefEval 考察对显式或隐式表达的偏好的遵循,且选择题(识别合适回答)与生成(自行写出回答)分开计分。
本文的主指标 PrefEval-Gen、PersonaMem-v1/v2 MCQ 都出自这套体系,区分生成与选择两种口径是读懂实验表的前提。
研究动机
训练“懂人”的语言模型面临根本性的监督缺口:理想的示范是熟人之间那种基于共同经历的知情回应,但采集这类私人对话需要授权和大量标注,无法规模化;公开对话语料虽有规模,用户的信念、目标与情绪却不可直接观测,仅靠表面对话学不会推断未言明的心理状态。合成数据是可行的补救,但 persona 条件化生成只提供静态画像,用户状态的变化被隐没在生成的文本里;对 UserLM、LifeSim 的评测也记录了现成助手无法解读用户隐含意图的失败。更麻烦的是,若让教师从可见对话中推断那个未言明的状态再生成训练目标,推断误差会直接混入监督信号。作者点出被忽视的关键:生成回应目标时,“谁能看到驱动用户行为的那个状态”决定了监督的质量。
本文的目标是本文要构建一条可规模化的流水线,把“理解用户”变成可训练的监督信号:用心理学指导的用户模拟器 M2D-SIM 从共享演化状态同时生成用户行为与知情回应,汇成语料 M2D-CORPUS;再用特权蒸馏训练学生模型 M2D-CHAT,使其在看不到心理状态的前提下逼近 Oracle 式的知情回应。具体量化目标是在 Qwen2.5-7B、Llama-3.1-8B、OLMo-3-7B 三个开源底座上,用 1/8、1/4、1/2、全量四档语料训练后,在 PersonaMem-v1、PersonaMem-v2、PrefEval 的全部报告指标上超越各自基座,并检验能否迁移到 ToMi 与 BigToM 两个心智理论基准;同时以人工审计(抽检 1,240 条对话)确认监督质量达到可训练标准。
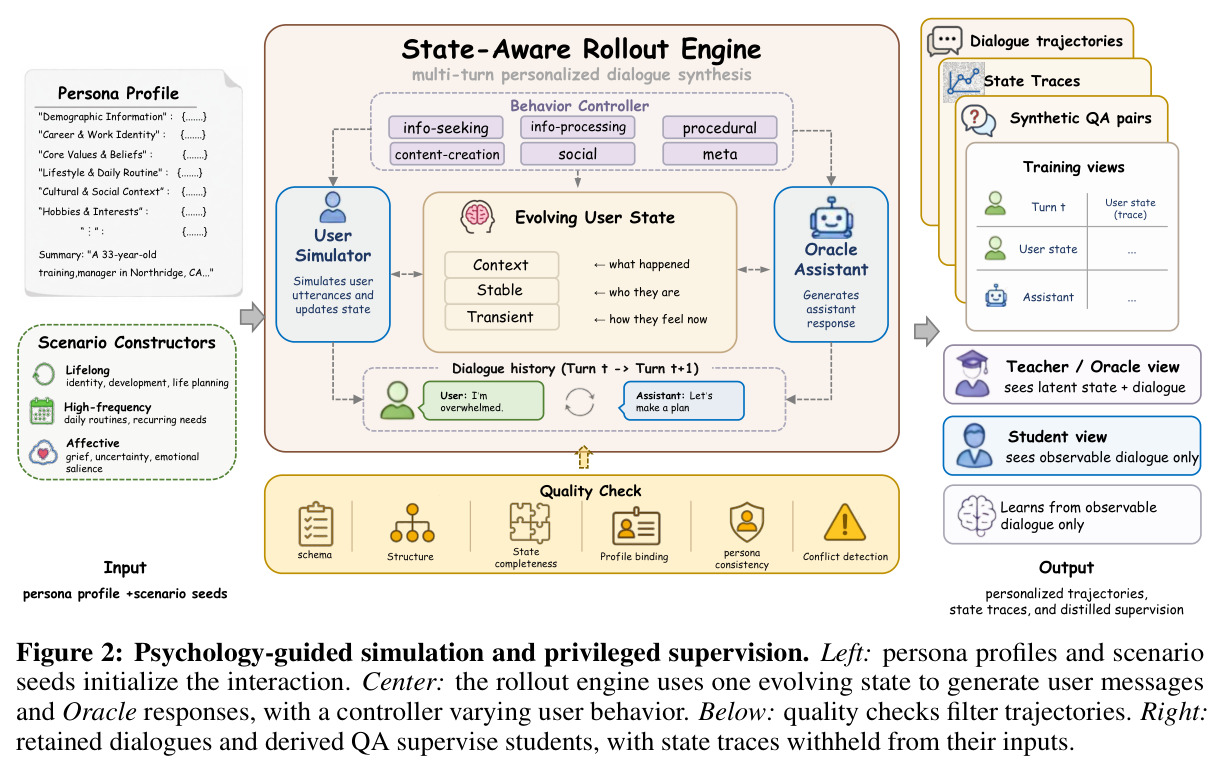
与已有工作不同的是,本文的独特切入是一个朴素的问题:生成助手回应目标时,谁看得到模拟器定义的用户状态?以往工作要么让教师从可见对话推断状态(推断误差进入目标),要么只训练更逼真的模拟器(HumanLM 训练的是模拟器而非助手),要么如 ToMATO 把逐轮想法隐藏、仅用于 QA 评测标注。Mind2Dialogue 的答案是共享状态模拟:同一个演化状态 $s_t$ 既驱动用户消息 $m_t$ 的生成,也直接交给 Oracle 助手 $\pi_{oracle}$ 用于生成回应目标。教师不必“猜”用户在想什么,示范天然知情;学生只在可见输入上训练,训练与部署的信息约束完全一致。特权信息不是外加标注,而是“生成交互的那个状态本身”。
核心方法
流水线分三步:模拟、构库、蒸馏。设 persona 为 $p$,第 $t$ 轮用户消息为 $m_t$,历史 $H_t=(H_{<t}, m_t)$,演化状态为 $s_t$,学生输入 $x_t$ 含 $H_t$ 但不含 $s_t$。每轮依次采样:状态更新 $s_t\sim\pi_{state}(\cdot\mid p, s_{t-1}, H_{<t})$、用户消息 $m_t\sim\pi_{user}(\cdot\mid p, s_t, H_{<t})$、Oracle 回应 $a_t\sim\pi_{oracle}(\cdot\mid p, s_t, H_t)$,三个策略可共享同一底座。保留的对话构成学生输入与 Oracle 回应的配对集,即 M2D-CORPUS 的对话视图,另有从同一交互派生的 QA 视图。训练用标准自回归交叉熵 $\mathcal{L}_{SFT}=-\mathbb{E}_{(x,y)}\sum_{j=1}^{|y|}\log\pi_\phi(y_j\mid x, y_{<j})$,只对目标回复计损失;文中证明其总体最优解为 $\pi^*(\cdot\mid x)=\bar q(\cdot\mid x)=\mathbb{E}_{s\sim q(\cdot\mid x)}[q(\cdot\mid x,s)]$,即等价于最小化 $\mathrm{D}_{KL}(\bar q(\cdot\mid x)\,\|\,\pi_\phi(\cdot\mid x))$:状态决定监督内容,可见上下文决定学生能学到的响应分布。
核心创新是共享状态用户模拟加特权蒸馏。状态是结构化记录 $s_t=\{c_t, z_t^{stable}, z_t^{transient}\}$:$c_t$ 记录轮次、未解决目标、信任历史与交互摘要;$z^{stable}$ 存放变化缓慢的价值观、背景约束与对助手的态度;$z^{transient}$ 存放短暂的心境、当前关切与本轮判断。这个状态只存在于生成侧:用户消息由它驱动,Oracle 回应由它引导,学生从训练到推理永远看不到它。与静态 persona 提示的本质区别在于状态随交互演化——助手上一轮的回应会改变用户下一步的信念与需求,后续轮次因此能反映助手的因果影响;与 ToMATO 的区别在于特权信息用于生成回应示范而非评测标注;与 HumanLM 的区别在于本文用模拟训练助手而非训练模拟器。一句话:特权即“生成交互的那个状态本身”。
方法步骤详情
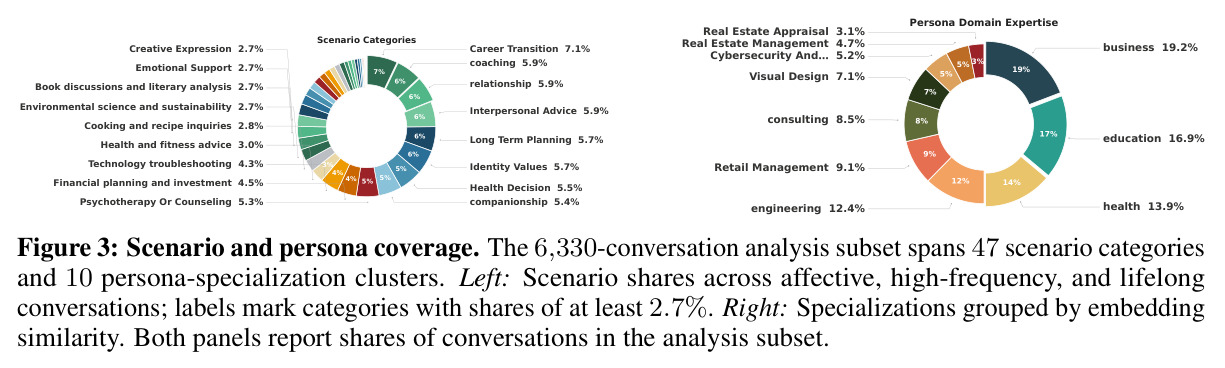
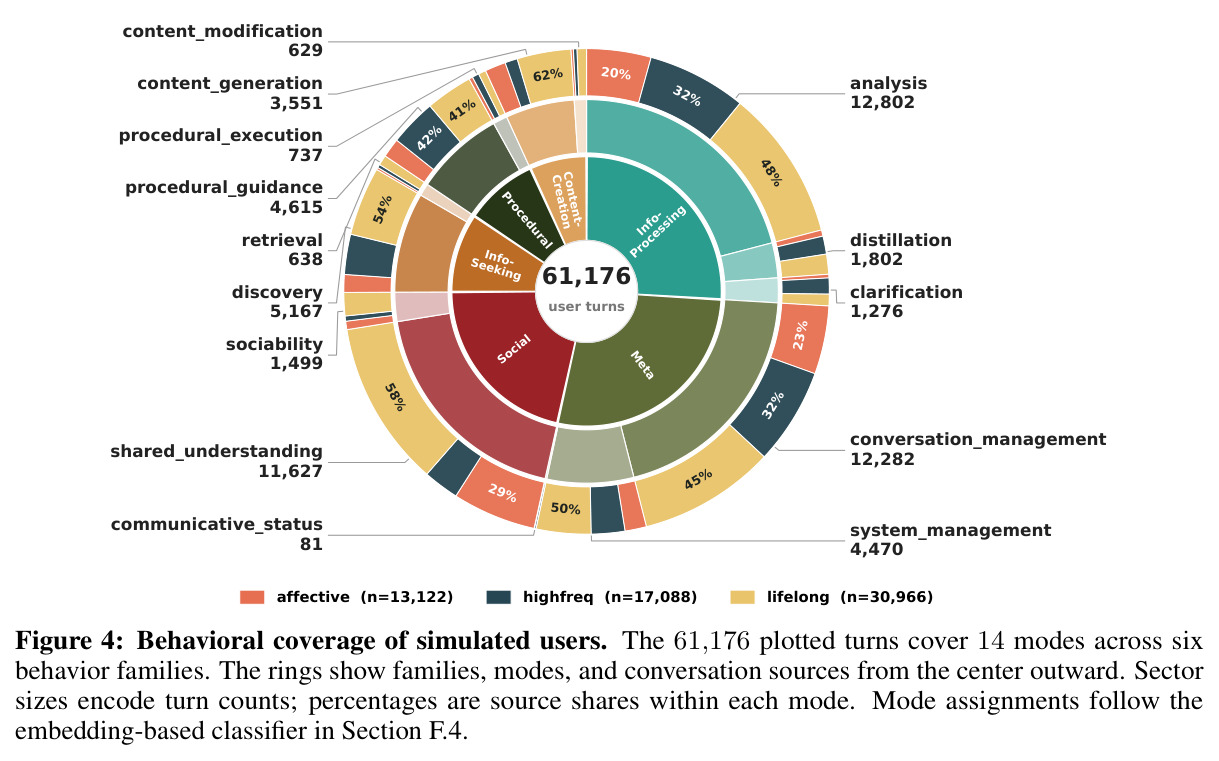
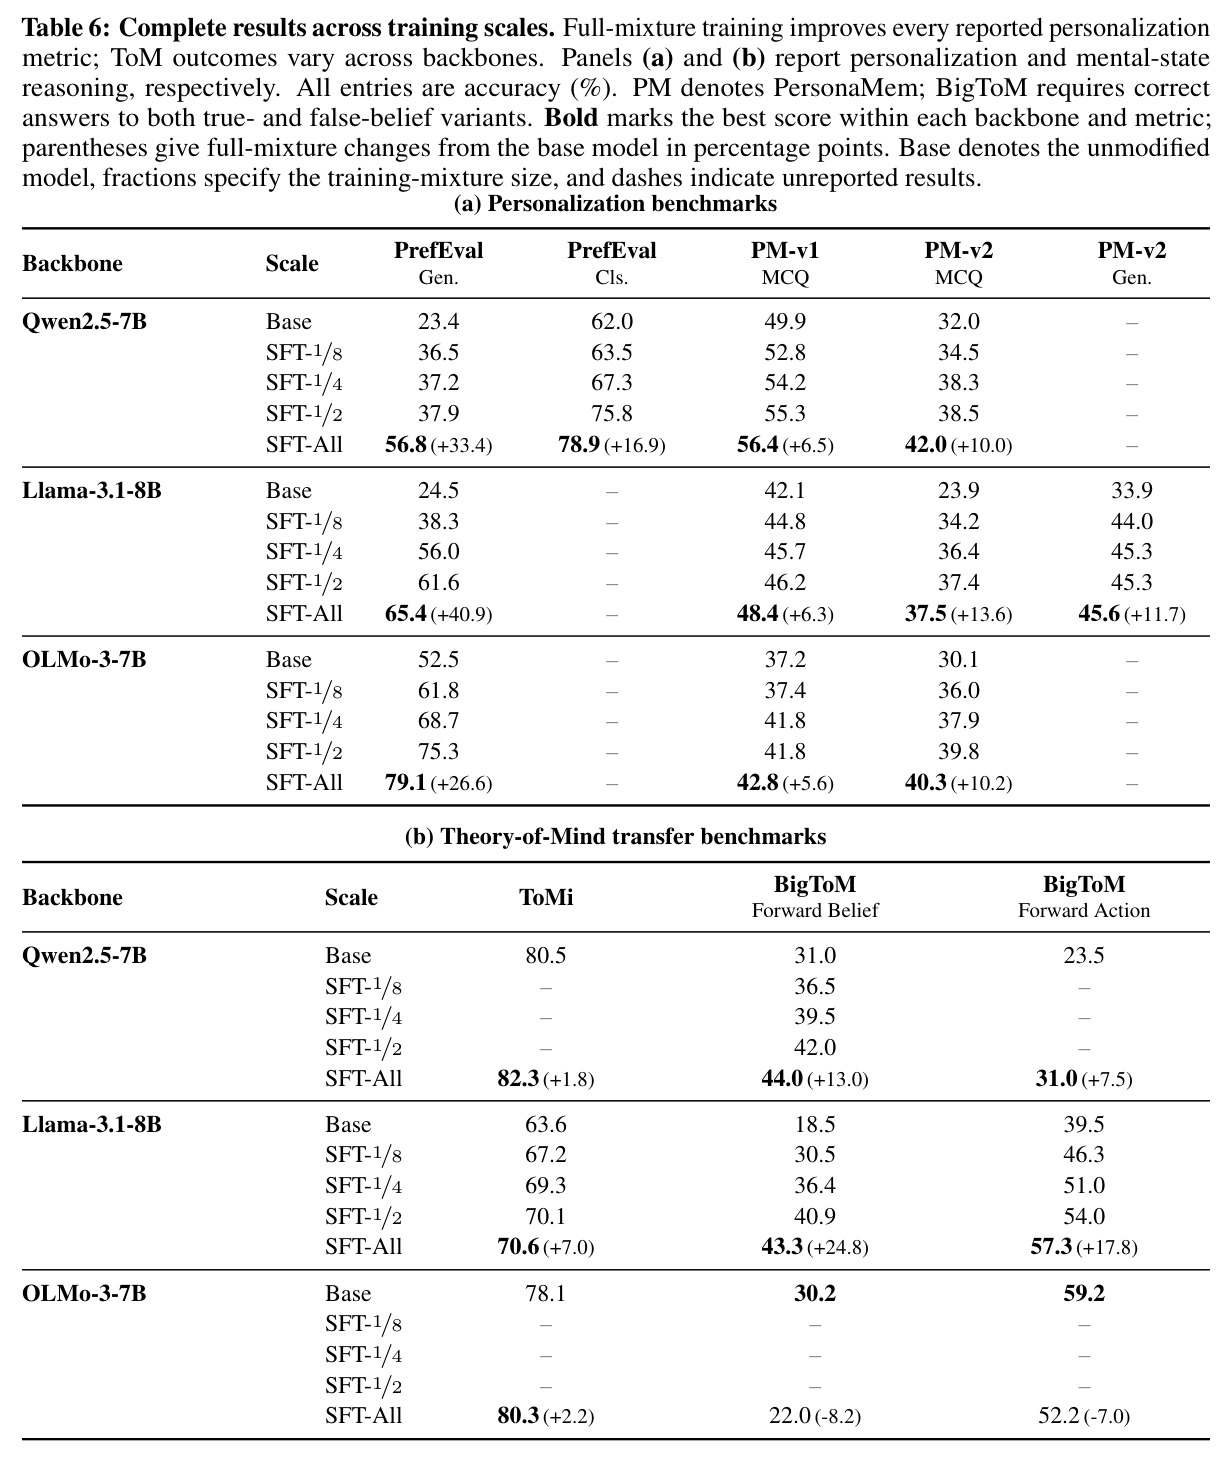
第一步,人格与场景:289 个 persona 各带自由文本专长(153 个取值聚成 10 类),场景分 LIFELONG、HIGH-FREQUENCY、AFFECTIVE 三族,候选经抽象层级、嵌入相似度(超过阈值 $\theta_{sim}$ 即拒收)、语义一致性三重过滤后缓存复用。第二步,状态感知推演:每轮先更新 $s_t$,再由基于 TUNA 分类法的行为控制器从 14 种模式加 2 种兜底模式中选择(覆盖信息获取、信息加工、程序指导、内容创作、社交、元对话六族),按轮次与用户委托程度注入强度不等的指令。第三步,质量过滤:四项程序检查(schema 合法性、结构健全性、状态轨迹完整性、persona 绑定)加两项 LLM 评审(persona 一致性与冲突检测,评审模型独立于模拟器与 Oracle);人工审计 1,240 条中 1,216 条通过(98.06%)。第四步,构库:分析子集含 6,330 条多轮对话、61,176 个用户轮次、47 类场景;SFT 混合集 8,244 条(3,312 对话 + 4,932 QA,含 MCQ 记忆题、偏好生成与偏好分类)。第五步,训练:LoRA + 4-bit 量化、仅回复计损、AdamW 余弦学习率,在 Qwen2.5-7B/Llama-3.1-8B/OLMo-3-7B 上以 1/8 至全量四档训练。
技术新颖性
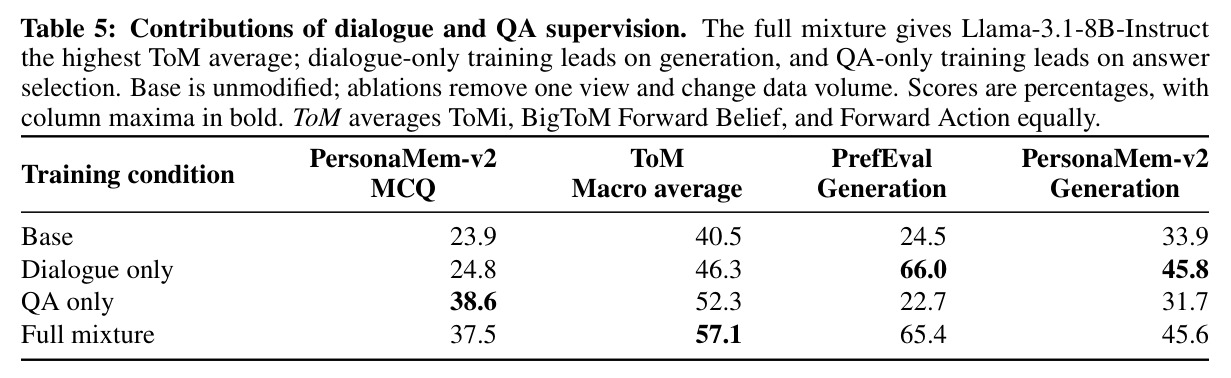
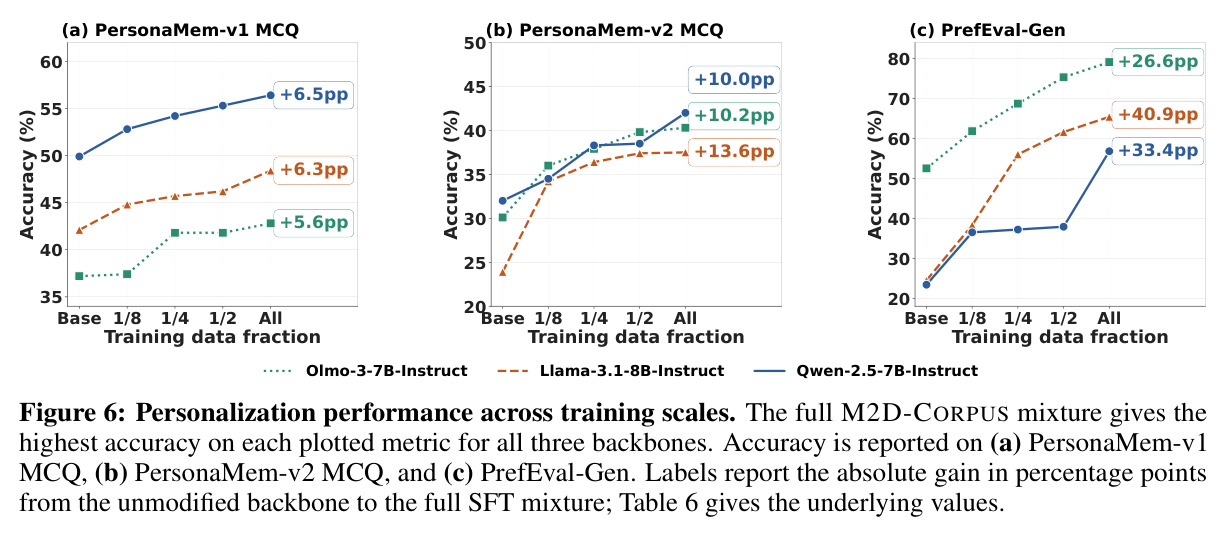
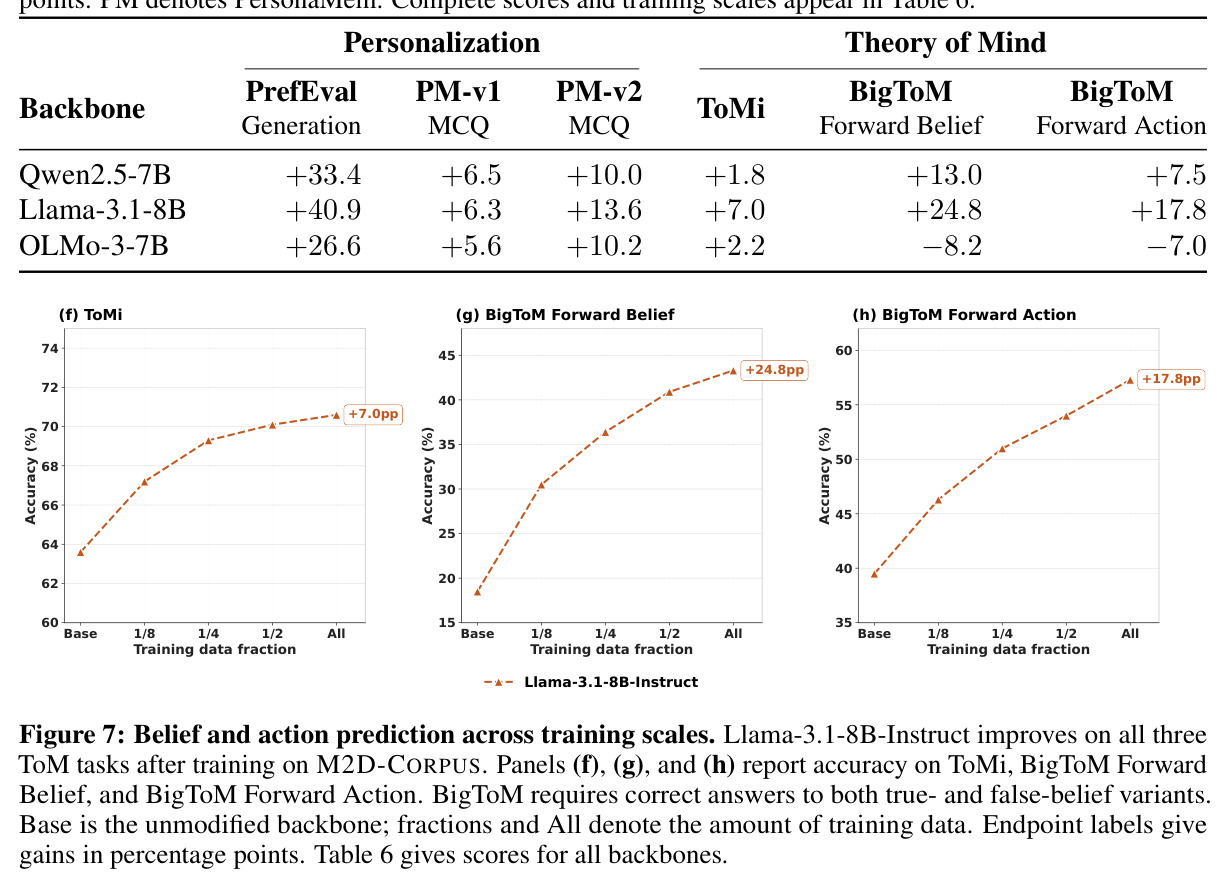
新颖性有四点。其一,特权信息的定义:不是额外人工标注或软标签,而是“生成交互的那个状态”,教师的知情性由构造保证而非由推断能力决定,从根上切断了推断误差进入监督的通路。其二,迁移方式刻意保守:用固定 Oracle 与标准 SFT,而非同期工作的 joint 或 on-policy 目标,Table 5 的消融证明这种最简单的方案已能同时带来个性化与 ToM 增益。其三,可扩展性:无需对每条生成对话做人工标注,289 个 persona、47 类场景、六族 14 种行为模式提供了受控的多样性,四档数据比例实验(Figure 6)验证了随数据扩展的增益曲线。其四,评测设计把个性化(是否按用户偏好行动)与心智理论(是否推断信念并预测行为)并列——SimpleToM 表明状态归因准确也可能伴随行动预测失误,单看任一域都会误判,OLMo“个性化涨、ToM 跌”的分化结果正是这一设计的直接回报。
实验结果
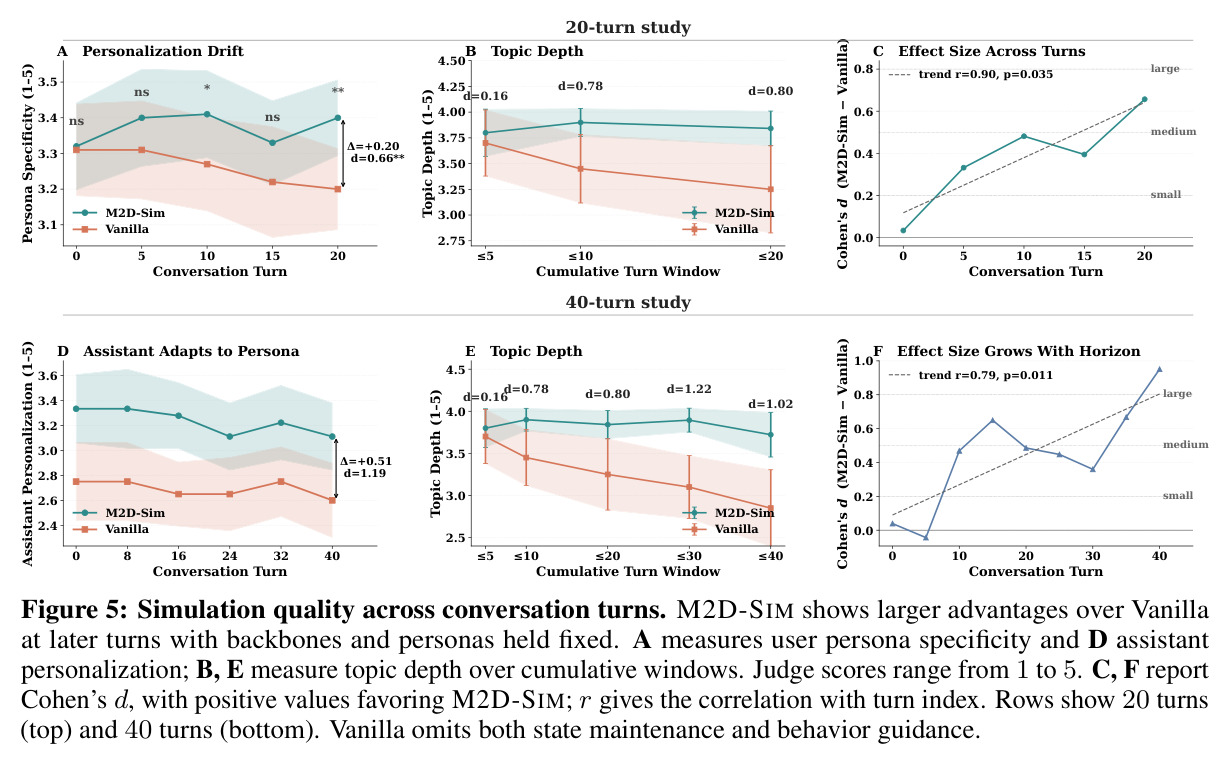
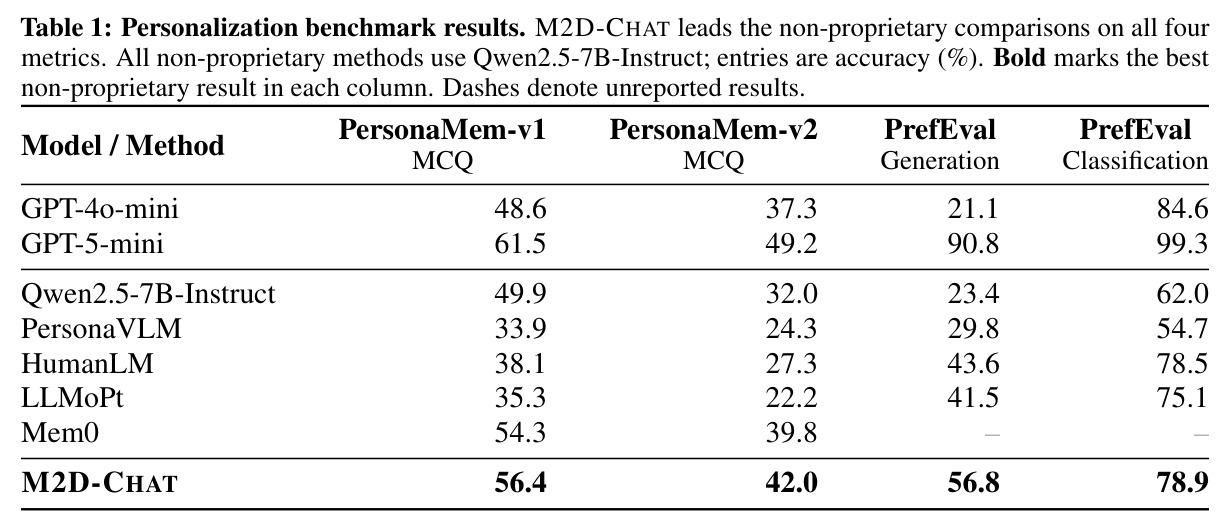
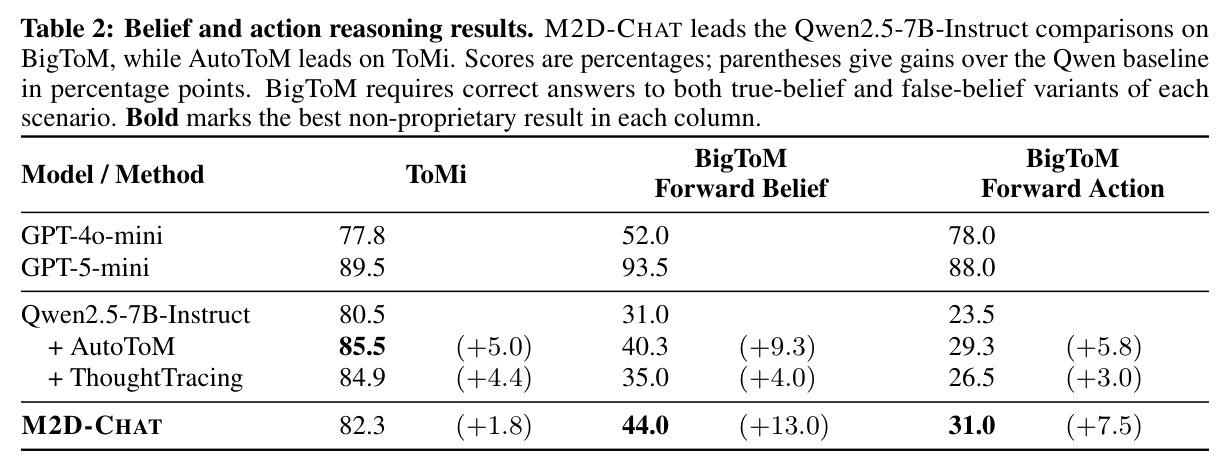
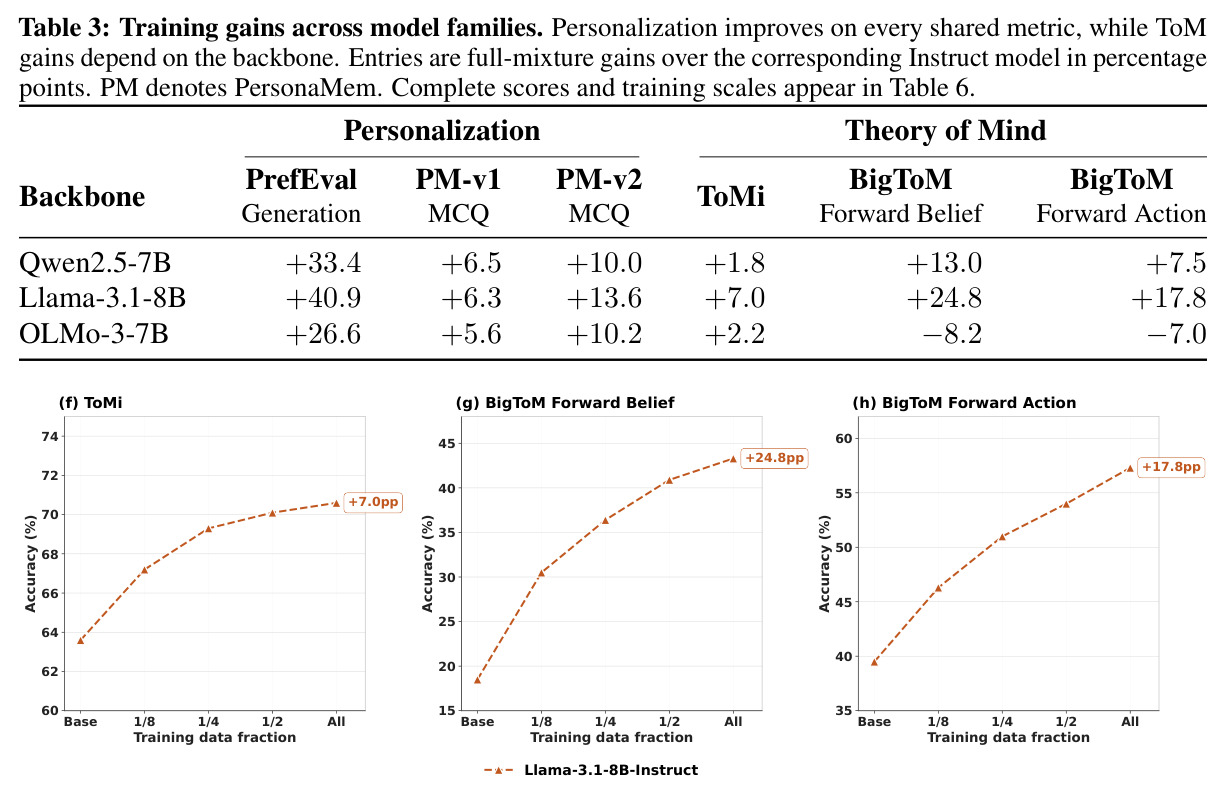
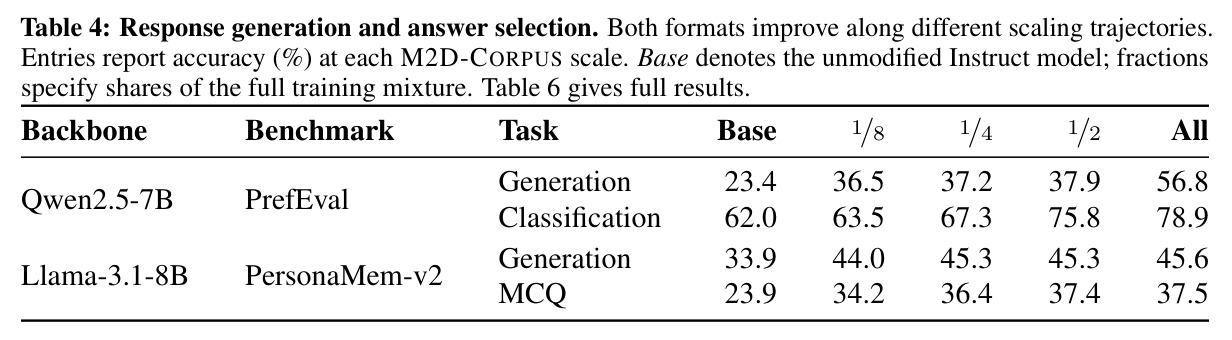
个性化全面改善(Figure 6、Table 1):全量语料下 Qwen2.5-7B 的 PrefEval 生成 23.4→56.8(+33.4pp)、PersonaMem-v1 MCQ 49.9→56.4(+6.5pp)、PersonaMem-v2 MCQ 32.0→42.0(+10.0pp)、PrefEval 分类 62.0→78.9;三底座所有报告的个性化指标均为全量最佳,PrefEval-Gen 增益 26.6 至 40.9pp。对比基线:PrefEval-Gen 56.8 比最强任务基线 HumanLM(43.6)高 13.2pp,远超 GPT-4o-mini(21.1);PersonaMem 两项比 Mem0(54.3/39.8)高 2.1/2.2pp;但四项均低于 GPT-5-mini(61.5/49.2/90.8/99.3)。ToM 迁移因底座而异(Table 2/3):Qwen 在 BigToM Forward Belief 31.0→44.0(+13.0pp)、Forward Action 23.5→31.0(+7.5pp),均超 AutoToM(+9.3/+5.8),ToMi 仅 +1.8pp 且不及 AutoToM 的 85.5;Llama 全面提升(FB +24.8、FA +17.8、ToMi +7.0);OLMo 个性化 +26.6pp 但 BigToM 两项退化 8.2/7.0pp。消融(Table 5):仅对话训练把 Llama 的 ToM 宏平均从 40.5 提至 46.3 且生成最高,仅 QA 训练拿到最高 PM-v2 MCQ 38.6 但生成低于基座,全混合宏平均最高 57.1。模拟质量试点(Figure 5):话题深度效应量从 ≤5 轮 d=0.16 增至 ≤30 轮 d=1.22,与轮次相关 r=0.90/0.79。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PrefEval 偏好遵循生成 | 生成准确率 (%) | 56.8(Qwen2.5-7B 全量语料) | 基座 23.4;HumanLM 43.6;LLMoPt 41.5;GPT-4o-mini 21.1 | +33.4pp(较基座),+13.2pp(较 HumanLM) |
| PersonaMem-v1 记忆适应 | MCQ 准确率 (%) | 56.4 | 基座 49.9;Mem0 54.3;GPT-5-mini 61.5 | +6.5pp(较基座),+2.1pp(较 Mem0) |
| PersonaMem-v2 隐式偏好 | MCQ 准确率 (%) | 42.0 | 基座 32.0;Mem0 39.8;GPT-5-mini 49.2 | +10.0pp(较基座),+2.2pp(较 Mem0) |
| PrefEval 偏好分类 | 分类准确率 (%) | 78.9 | 基座 62.0;HumanLM 78.5;GPT-5-mini 99.3 | +16.9pp(较基座);对 HumanLM 仅 +0.4pp |
| BigToM 前向信念 | TB∧FB 准确率 (%) | 44.0 | 基座 31.0;AutoToM 40.3;ThoughtTracing 35.0;GPT-5-mini 93.5 | +13.0pp(较基座),+3.7pp(较 AutoToM) |
| BigToM 前向行动 | TB∧FB 准确率 (%) | 31.0 | 基座 23.5;AutoToM 29.3;GPT-5-mini 88.0 | +7.5pp(较基座),+1.7pp(较 AutoToM) |
| ToMi 一二阶信念 | 准确率 (%) | 82.3 | 基座 80.5;AutoToM 85.5;GPT-5-mini 89.5 | +1.8pp(较基座),但落后 AutoToM 3.2pp |
| Llama-3.1-8B PrefEval 生成 | 生成准确率 (%) | 65.4(全量语料) | Llama-3.1-8B-Instruct 基座 24.5 | +40.9pp,三底座中最大增益 |
| OLMo-3-7B BigToM(负迁移) | TB∧FB 准确率变化 | Forward Belief −8.2pp,Forward Action −7.0pp | OLMo-3-7B-Instruct 基座 | 负面结果:个性化 +26.6pp 的同时 ToM 推理退化 |
局限与改进
作者承认的局限:PrefEval 分类上对 HumanLM 的领先仅 0.4pp(78.9 对 78.5),不足以支撑强分离结论;四项个性化指标全部低于 GPT-5-mini;ToM 收益依赖底座,OLMo 在 BigToM 两项上退化 8.2/7.0pp,说明个性化增益与心智推理增益可以脱钩;PersonaMem 式 QA 与评测共享四选项接口,虽经精确重叠审计确认内容独立,仍需谨慎解读格式熟悉效应。我的补充观察:$s_t$ 是模拟器定义的控制变量而非对真实用户心理的测量,模拟器质量成为新的单点依赖;试点研究把状态维护与行为控制捆绑对比(Vanilla 同时去掉两者),无法分离各组件贡献;固定 Oracle 加离线 SFT 意味着学生无法在推理时纠正教师的行为风格;语料仅 8,244 条 SFT 样本、289 个 persona,对更大规模底座的适用性未验证;全部评测为离线基准,缺少与真实用户长程交互的验证。
独立分析的弱点
第一,特权监督的上限由模拟器决定:若 $\pi_{state}$ 给出的状态与实际生成的对话脱节,Oracle 的“知情”会变成系统性幻觉,而 98.06% 的人工通过率只覆盖了被检出的维度。改进方向是把状态与对话的一致性做成更强的自动过滤器(如一致性打分的对抗筛选)。第二,组件归因缺失:试点中 Vanilla 条件同时去掉状态维护与行为引导,应补单组件消融以量化各自贡献。第三,数据规模偏小:8,244 条样本下,Qwen 的 PrefEval-Gen 直到最后一档才大涨(1/2 到全量 +18.9pp,分类仅 +3.1pp),说明增益尚未饱和,可用更多 persona 与场景自动扩产。第四,知识只从单一固定 Oracle 单向蒸馏,结合 on-policy RL(如 UserRL 式轮级奖励)可能进一步对齐学生在线行为。第五,QA 视图与 PersonaMem MCQ 格式同构可能抬高分数,建议增加不同格式的保留评测集。第六,评测缺主动澄清、隐私敏感等部署行为维度,可引入交互式评测补足。
未来方向
作者提出的方向:开发能主动探询真实用户意图的方法,从日常对话中识别可用的监督信号,同时保护隐私并让用户控制训练数据的使用;据此积累证据,构建更忠实地刻画信念、目标与情境如何演化的模拟器;把真实与模拟经验结合,训练能长期支持个人目标、理解言语背后信念与意图的 AI 协作者。基于本文成果可延伸:把共享状态模拟扩展到多用户、多会话的长程记忆场景(与 LongMemEval、HorizonBench 衔接);用特权蒸馏产出的教师构造状态感知的奖励模型再做强化学习;在学生侧加入显式的状态后验估计或逆推断模块,使“对用户心理的建模”从隐式学习变为可检查的中间表示;探索当模拟状态与真实用户反馈冲突时的在线纠偏机制;把评测扩展到主动澄清与伦理边界行为。
复现评估
复现难度中等偏低。底座全部开源(Qwen2.5-7B-Instruct、Llama-3.1-8B-Instruct、OLMo-3-7B-Instruct),训练配方固定且轻量(LoRA + 4-bit 量化 + response-only masking + AdamW 余弦调度),7-8B 模型单张 24GB 显卡即可微调,四档数据比例的扫描只需小时级算力。论文首页标注 Project/Code/Dataset 入口,语料构成(8,244 条混合集:3,312 对话 + 4,932 QA)、TUNA 分类全表、两套 LLM 评审 rubric、质量检查细节均在附录 F/G/H 中公开,程序化检查可直接复用。主要成本在数据生产侧:需要与 Oracle 相当能力的生成模型跑完 289 个 persona 的多轮推演,并复现 1,240 条对话的人工审计(约需标注预算);若直接使用其发布语料只复现训练与评测,单卡一天内可完成全部三底座实验。
论文图表
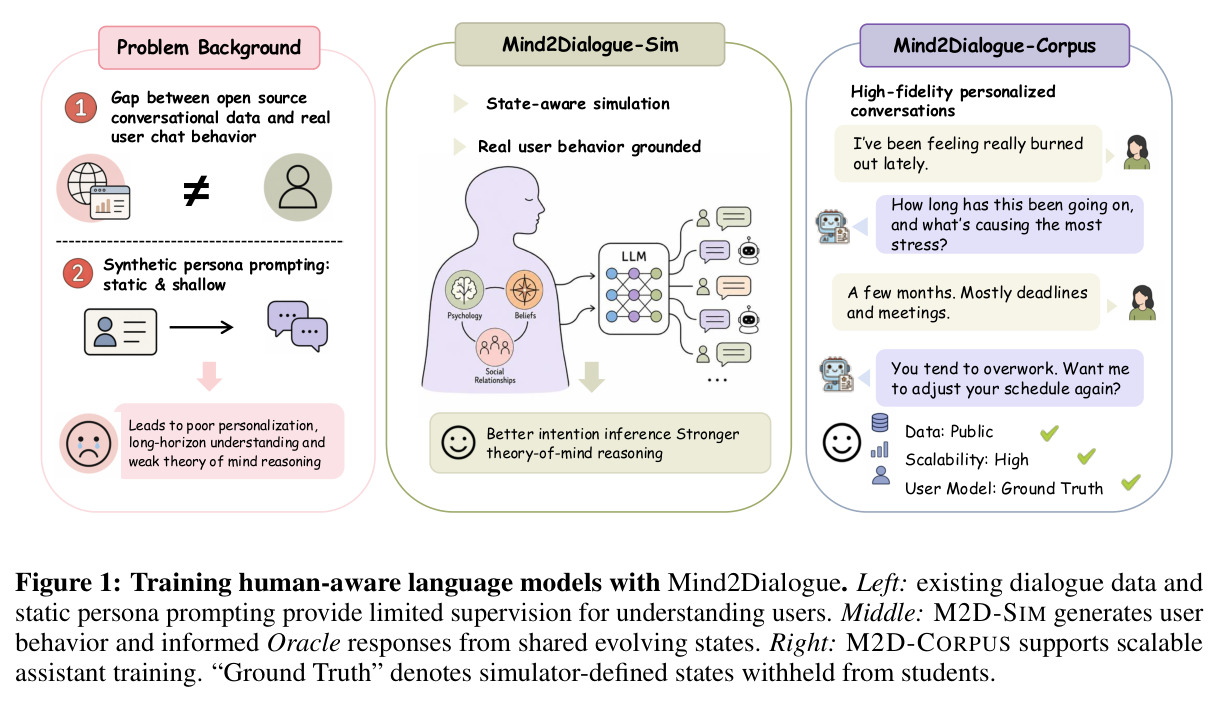
三栏总览图。左:问题背景——开源对话数据与真实用户行为之间存在鸿沟,静态 persona 提示生成肤浅对话,导致个性化差、长程理解弱、心智推理不足;中:M2D-SIM 从共享演化状态同时生成用户行为与知情 Oracle 回应,实现状态感知模拟;右:M2D-CORPUS 支撑可扩展的助手训练,模拟器定义的状态(Ground Truth)对学生扣留。
一图看懂全文动机与框架全景:监督缺口为何存在、共享状态模拟如何填补、语料如何用于训练,是读论文前必看的路线图。