从碎片化到融合:全模态嵌入的综述与路线图 From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
蚂蚁团队首篇全模态嵌入综述:提出3C透镜与转换、对齐、融合三路径路线图
前置知识
对比学习与 InfoNCE 损失
对比学习的核心是:给定锚点样本,拉近正样本对、推远负样本对,从而把「哪些变换不该改变语义」编码进向量空间的几何结构。最常用的实现是 InfoNCE 损失 $\mathcal{L}_{\text{InfoNCE}} = -\log \frac{\exp(\text{sim}(e, e^+)/\tau)}{\sum_{j=1}^{N} \exp(\text{sim}(e, e_j)/\tau)}$,它把正例当作 $N$ 个候选中唯一「正确的类」做交叉熵,温度 $\tau$ 控制分布锐度;在对数形式下 $\log N - \mathcal{L}_{\text{InfoNCE}}$ 是输入两个视图间互信息的下界。归一化变体 NT-Xent 先投影到单位超球面再打分,更早的三元组损失则直接强制正负距离之间的间隔。
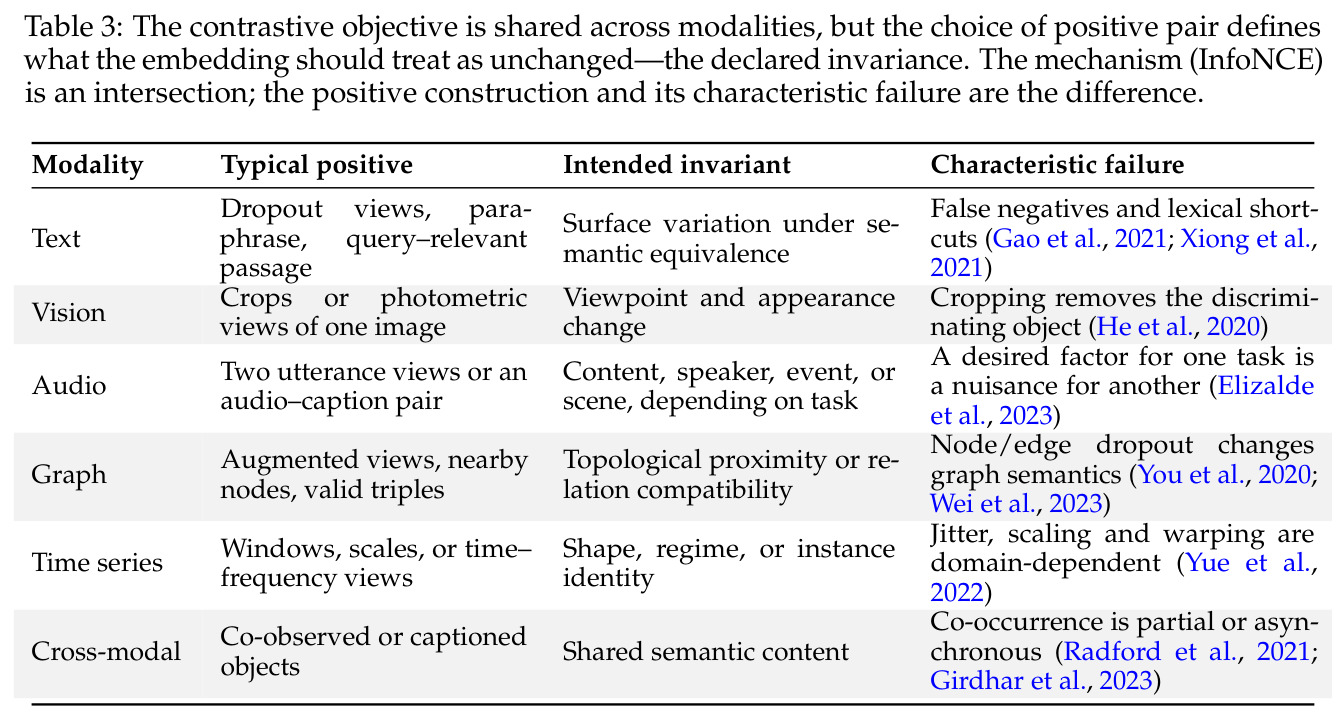
它是论文所说的第一条收敛轴:从文本 SimCSE、视觉 CLIP 到音频 CLAP,所有模态都用同一种损失。全文三条统一路径中的两条(对齐与融合)都以它为训练机制,理解它才能理解「正样本对如何构造」为何成为各模态真正的差异所在。
双塔架构与交叉编码器
双塔(dual-encoder)指每个模态各用一个独立编码器,输入分别编码成向量后只在共享度量空间中比较,因此候选可以离线预计算并建立索引,检索时只做最近邻查询。交叉编码器(cross-encoder)则把查询和候选拼接后一起送入同一个模型做深层交互,表达力更强但每个(查询, 候选)对都要跑一次前向,无法建立可复用的表示。两者构成检索系统的经典两级流水线:双塔召回、交叉编码器重排。
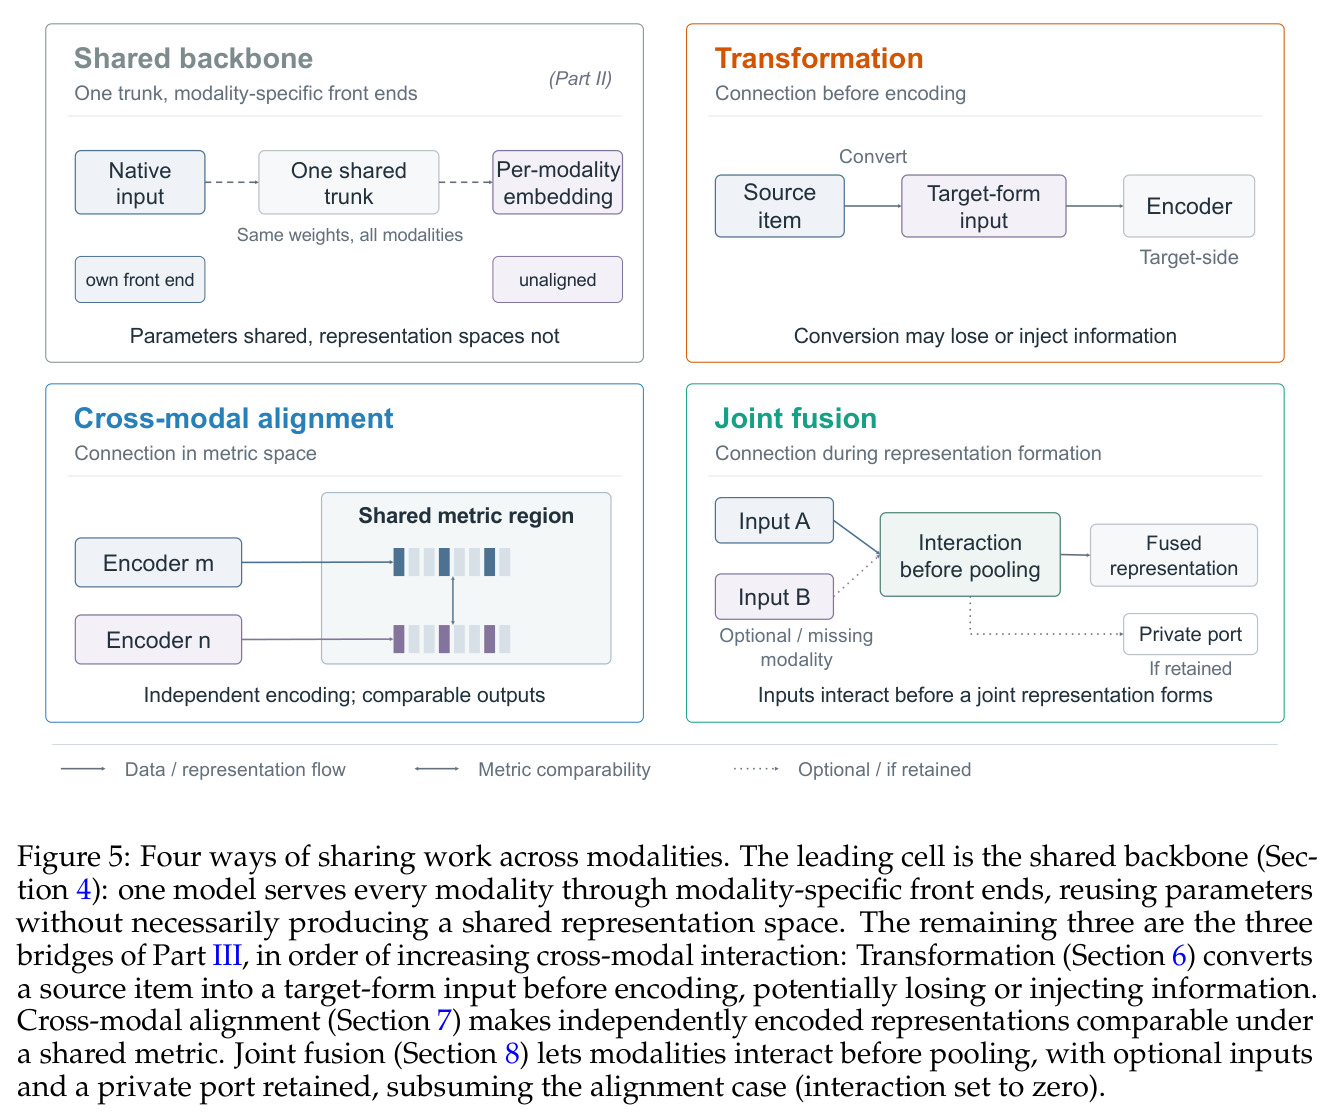
论文严格区分了两种「融合」:条目内融合(intra-item fusion,输出仍是可索引的嵌入向量)与查询-候选交叉编码(只输出配对分数)。CLIP 式对齐 = 双塔 + 对比损失;联合嵌入 = 条目内交互但保持可索引。不掌握这个区分就无法理解第 8 章的论证经济账。
模态鸿沟(modality gap)
指 CLIP 这类对齐后的双塔模型中,图像与文本嵌入在共享空间里并不混合,而是各自聚成两个分离的锥形区域。Liang 等人 2022 年给出三重成因:一是深度网络非线性激活的「锥效应」使任意两个嵌入的夹角变小;二是两个塔从不同随机初始化出发,从一开始就住在不同的锥里;三是低温度对比损失本身使默认 gap 距离成为局部最优——缩小 gap 反而会增大损失。该现象在随机权重模型中就存在,且仅由少数嵌入维度承载。
模态鸿沟是论文论证「对齐不能成为终点」的几何学核心证据:对齐只是让两个锥可以互相匹配,并未形成统一的语义区域。它直接造成混合模态检索的最近邻偏差与枢纽化(hubness)问题,也是第 7 章与第 8 章之间的逻辑枢纽。
柏拉图表示假说
Huh 等人 2024 年提出:不同模态、不同模型学到的表示可能正收敛向同一个关于现实的共享统计模型——一个「柏拉图」表示空间。其操作性证据包括:Jha 等人 2025 年证明不同文本嵌入空间之间存在通用潜在语义结构,无需配对数据即可无监督地把一个向量空间中的嵌入平移到另一个空间;以及相对表示(relative representations)等方法无需任何训练就能让不同数据集上训练的模型互相理解。
这是全文最重要的理论赌注:如果所有模态底下存在共享几何,那么模态鸿沟就只是表面坐标伪影,正确的架构应当直接暴露共享几何而非对齐两个锥。论文明确说自己的融合论点就是「被操作化的柏拉图假说」。
部分信息分解(PID)与协同信息
部分信息分解把多个输入 $x_1, \dots, x_k$ 共同携带的关于目标 $Y$ 的信息分解为三个部分:冗余(每个输入都单独携带)、独有(只由某一个输入携带)、协同(只在联合变量 $(x_1,\dots,x_k)$ 中才出现、任何单个输入或子集都不携带)。协同分量是「真正的融合」的信息论刻画——它无法通过任何分别编码再相加的方式还原。
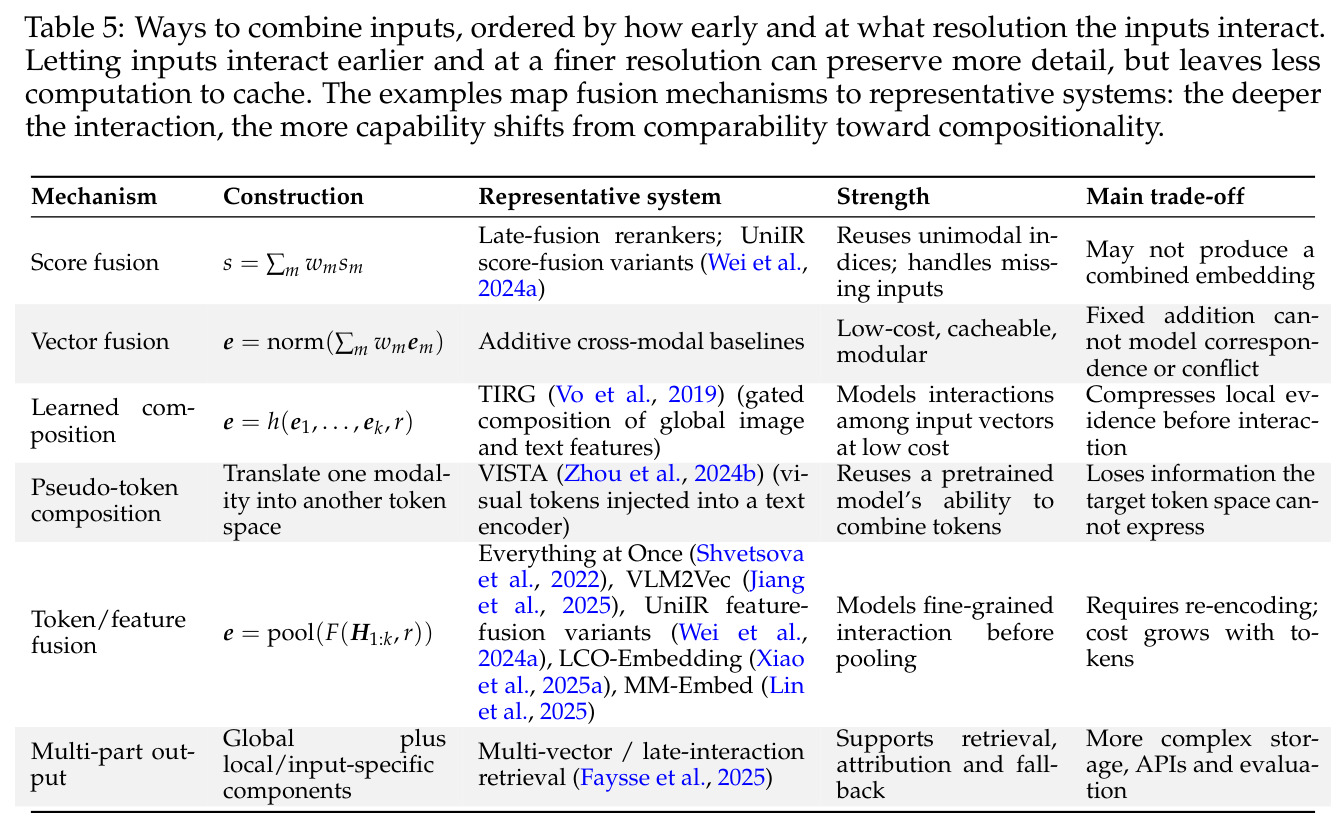
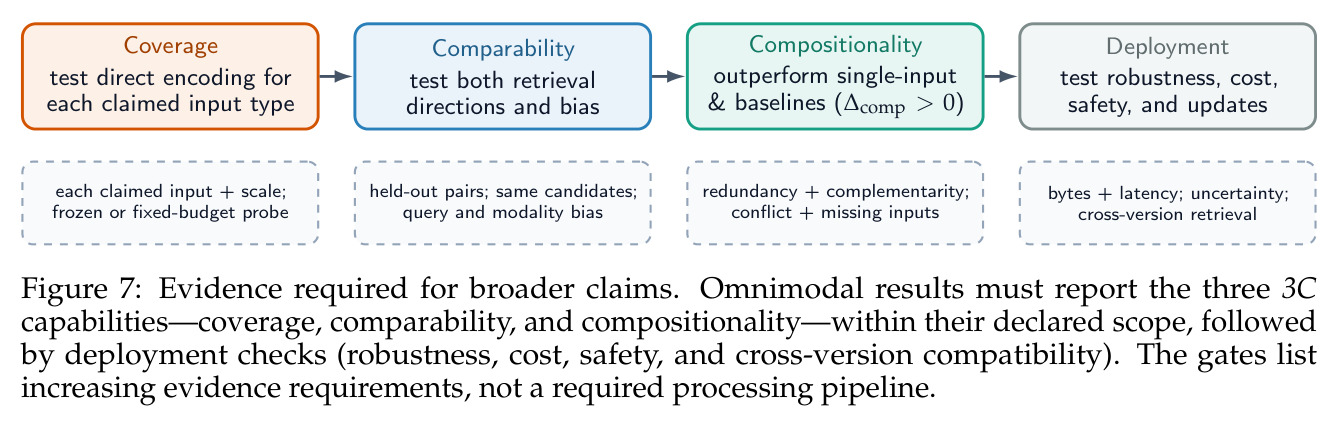
论文提出的组合增益指标 $\Delta_{\text{comp}}$(式 5)直接受 PID 协同项启发:一个联合嵌入只有在击败最强单模编码器、分数融合和向量加法基线时才配称「融合」。这是第三条能力(compositionality)从口号变成可测数字的理论基础。
研究动机
嵌入模型支撑着从搜索引擎到推荐系统的几乎所有现代 AI 系统,但对其研究却沿着模态边界深度割裂——文本嵌入研究(SimCSE、E5)与视觉自监督(MAE、DINO)、音频自监督(wav2vec 2.0、HuBERT)、图表示学习、时间序列和表格表示学习各自为政,各自办研讨会、发检查点、优化自己的基准,在一个社区里可以平移的方法在另一个社区被反复重新发明。这种割裂同时体现在三个层面:研究孤岛(图嵌入综述详细讨论视角增强却不提文本的 SimCSE 用 dropout 隐式构造正对;视觉综述盛赞掩码自编码却不指出音频在相隔一年内独立到达了同一原理);综述孤岛(现有综述全是单模态的,从不跨越模态边界系统比较方法论);评估孤岛(文本有 MTEB/MMTEB、代码有 CoIR、音频有 SUPERB 系、视觉有 MIEB,而表格和时间序列仍主要靠任务头和预测档案评分,没有任何标尺能衡量一个方法论跨模态泛化得如何)。割裂是可以测量的结构:对 1,352 篇 2023–2025 年正式发表的嵌入论文和 2015–2025 十年 arXiv 预印本(10,952 条有效记录)的联合分析显示,绝大多数嵌入研究是单模态的,显式跨越模态边界的工作在两个样本中都不到 5%。后果是整个 AI 栈的不对称:生成侧 GPT-4o 自 2024 年 5 月起已在单一模型内联合消费文本、音频、图像、视频,而表征侧有组合增益证据的联合融合至今仅限于图文对,全模态融合嵌入模型与基准 2025 年底才出现——比生成侧晚约两年。今天,能联合感知四种模态的模型,却被双模态、成对对齐或以文本为中心的检索系统(最典型的是 RAG 管线)来索引和记忆。
本文的目标是本文要提供第一个对所有主要模态家族(文本/代码、图像/视频、音频、图、表格、时间序列)的嵌入研究进行统一、横切处理的立场论文与路线图。具体目标有五:(1)建立模态无关的解剖学——把任何嵌入模型 $f_\theta: \mathcal{X} \to \mathbb{R}^d$ 分解为数据单元与分词、编码器架构、聚合与读出、训练目标、评估范式五个正交组件,并区分输入侧的数据单元与输出侧的表征对象;(2)论证四个收敛趋势(对比学习成为通用语、Transformer 成为通用编码器、预训练–微调配方标准化、表征粒度从部件上移到完整语义单元)不是巧合而是深层趋同的证据;(3)提出三条递进的统一路径——转换(transformation)、对齐(alignment)、联合嵌入(joint embedding),并以 3C 透镜(coverage、comparability、compositionality 三个递进能力)给每条路径定级;(4)盘点每个模态必须被尊重的特有属性,绘制方法跨模态迁移的机会图;(5)设计统一评估方案(含可操作的组合增益指标 $\Delta_{\text{comp}}$),并诚实指出:在统一全模态基准建成之前,「联合嵌入统一并超越对齐」这一中心论点仍是假设而非实测事实。
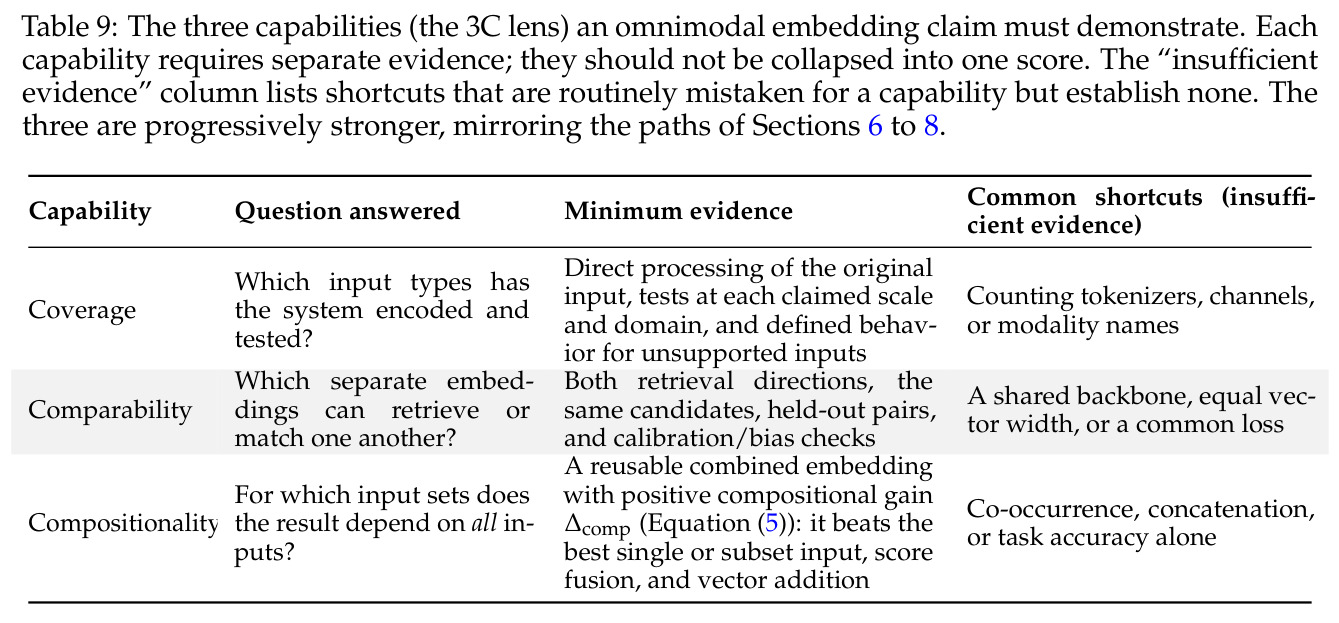
与已有工作不同的是,现有文献的空白在于:所有嵌入综述都是单模态的——文本嵌入综述、视觉自监督综述、语音表示综述、图嵌入综述、表格表示综述各自画自己的地图,没有一座桥。本文的独特切入有四点。第一,位置论文视角:不是 catalog 式罗列,而是论证一个命题——嵌入研究正沿共享原则收敛,这使得从转换、对齐走向真正融合成为可能,而实现全模态联合嵌入必须直面各模态的独特挑战并互相借鉴。第二,3C 透镜:把「全模态」这一含混口号拆成三个可分别检验的能力(系统实际编码并测试了哪些输入?分别编码的输入能否在共享空间匹配?输出是否真正依赖所有输入?),并揭示数分词器数量、共享主干、共现、任务准确率这些常被误当证据的捷径。第三,把「复用」(reuse)当作一等公民:绘制有向、有条件的跨模态迁移地图,标明哪些已被验证、哪些是提议实验。第四,给出可操作的组合增益定义 $\Delta_{\text{comp}}$,让「是否真融合」从哲学争论变成能上排行榜的数字。按作者所知,这是第一份从这一横切、立场驱动的视角统一处理嵌入研究的论文。
核心方法
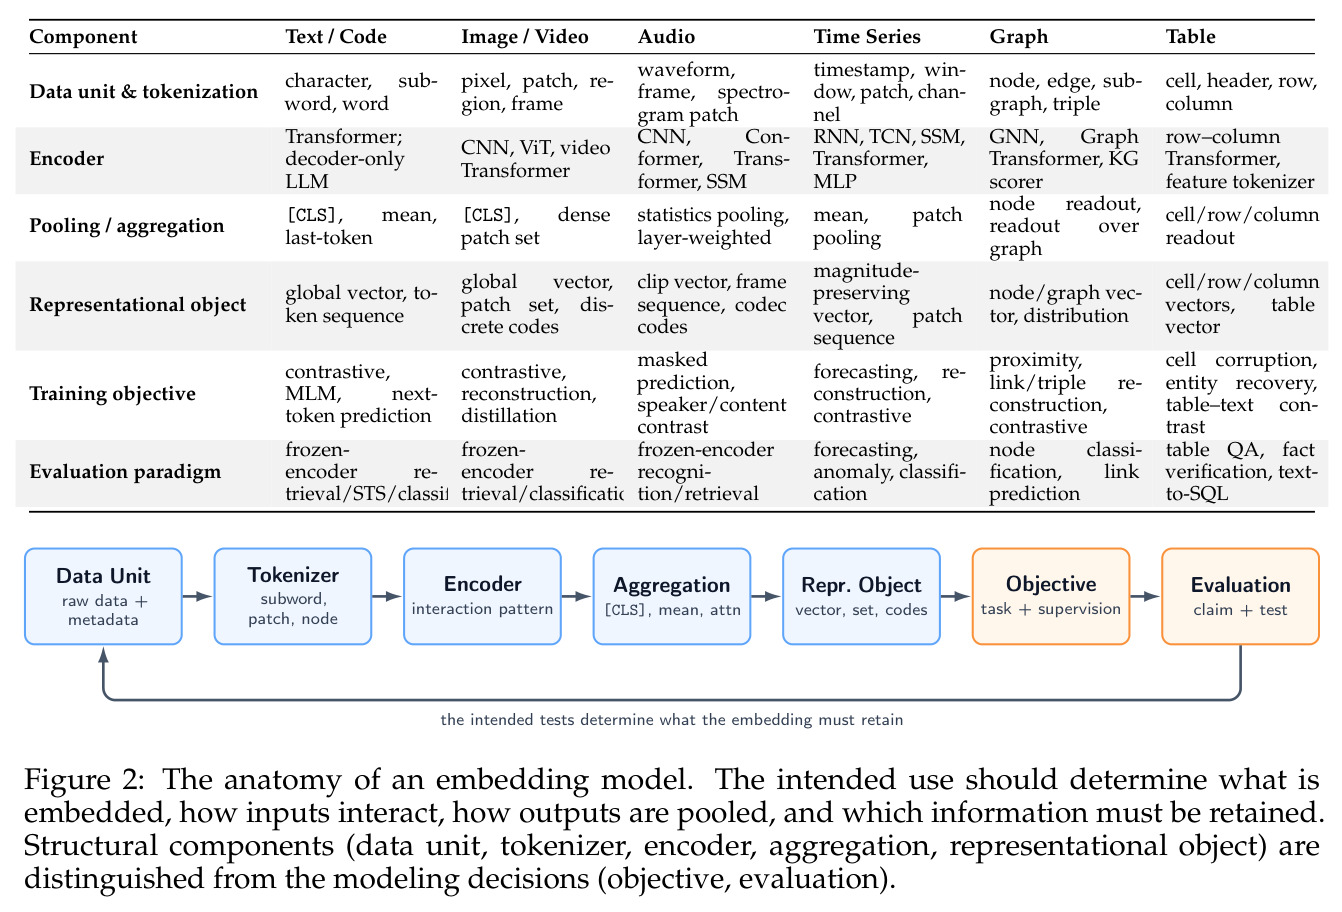
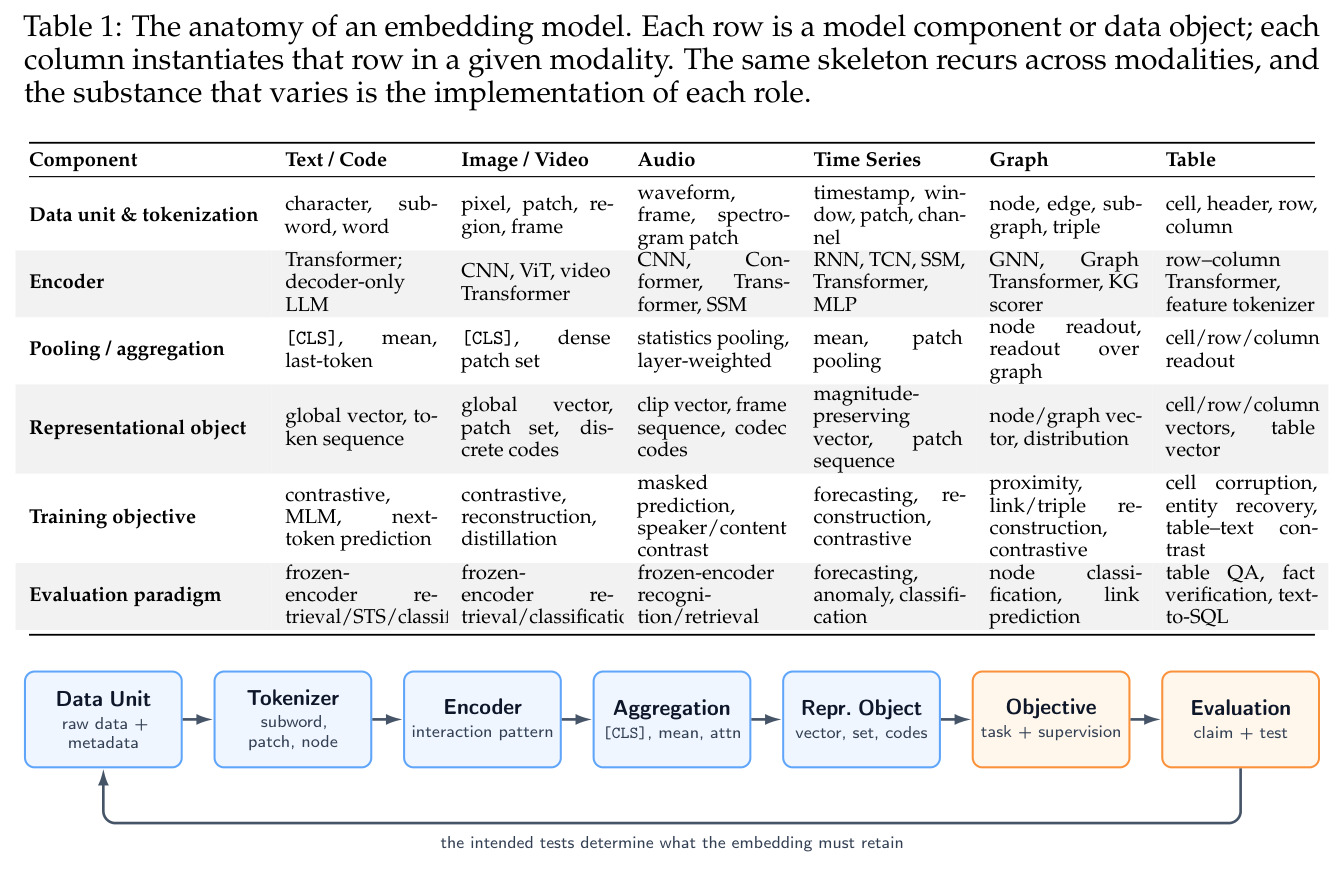
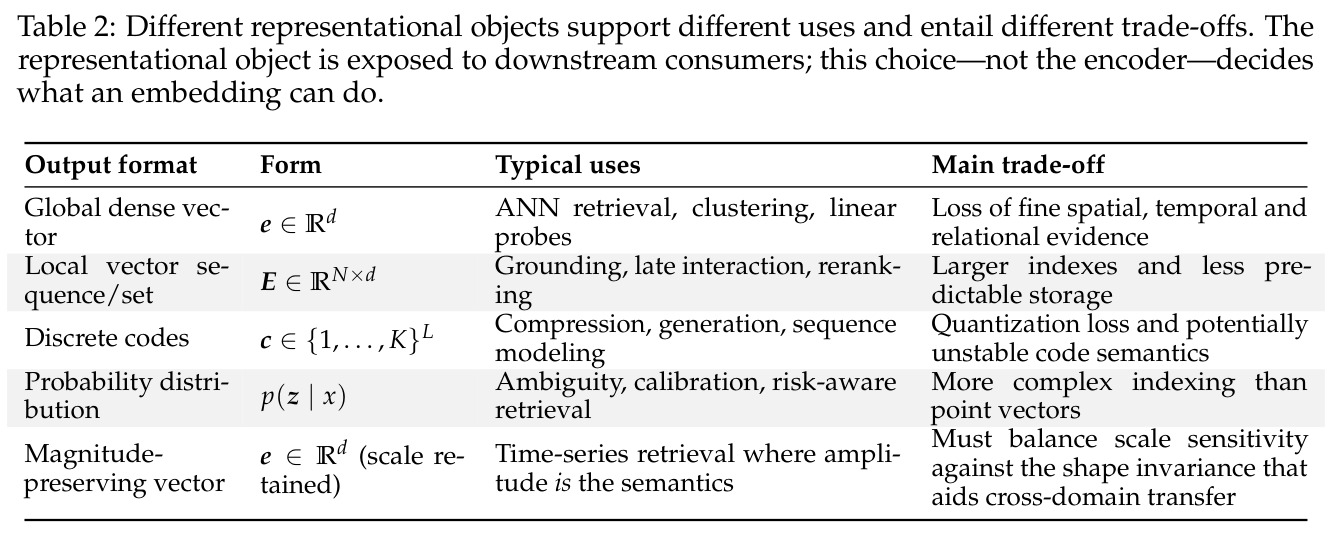
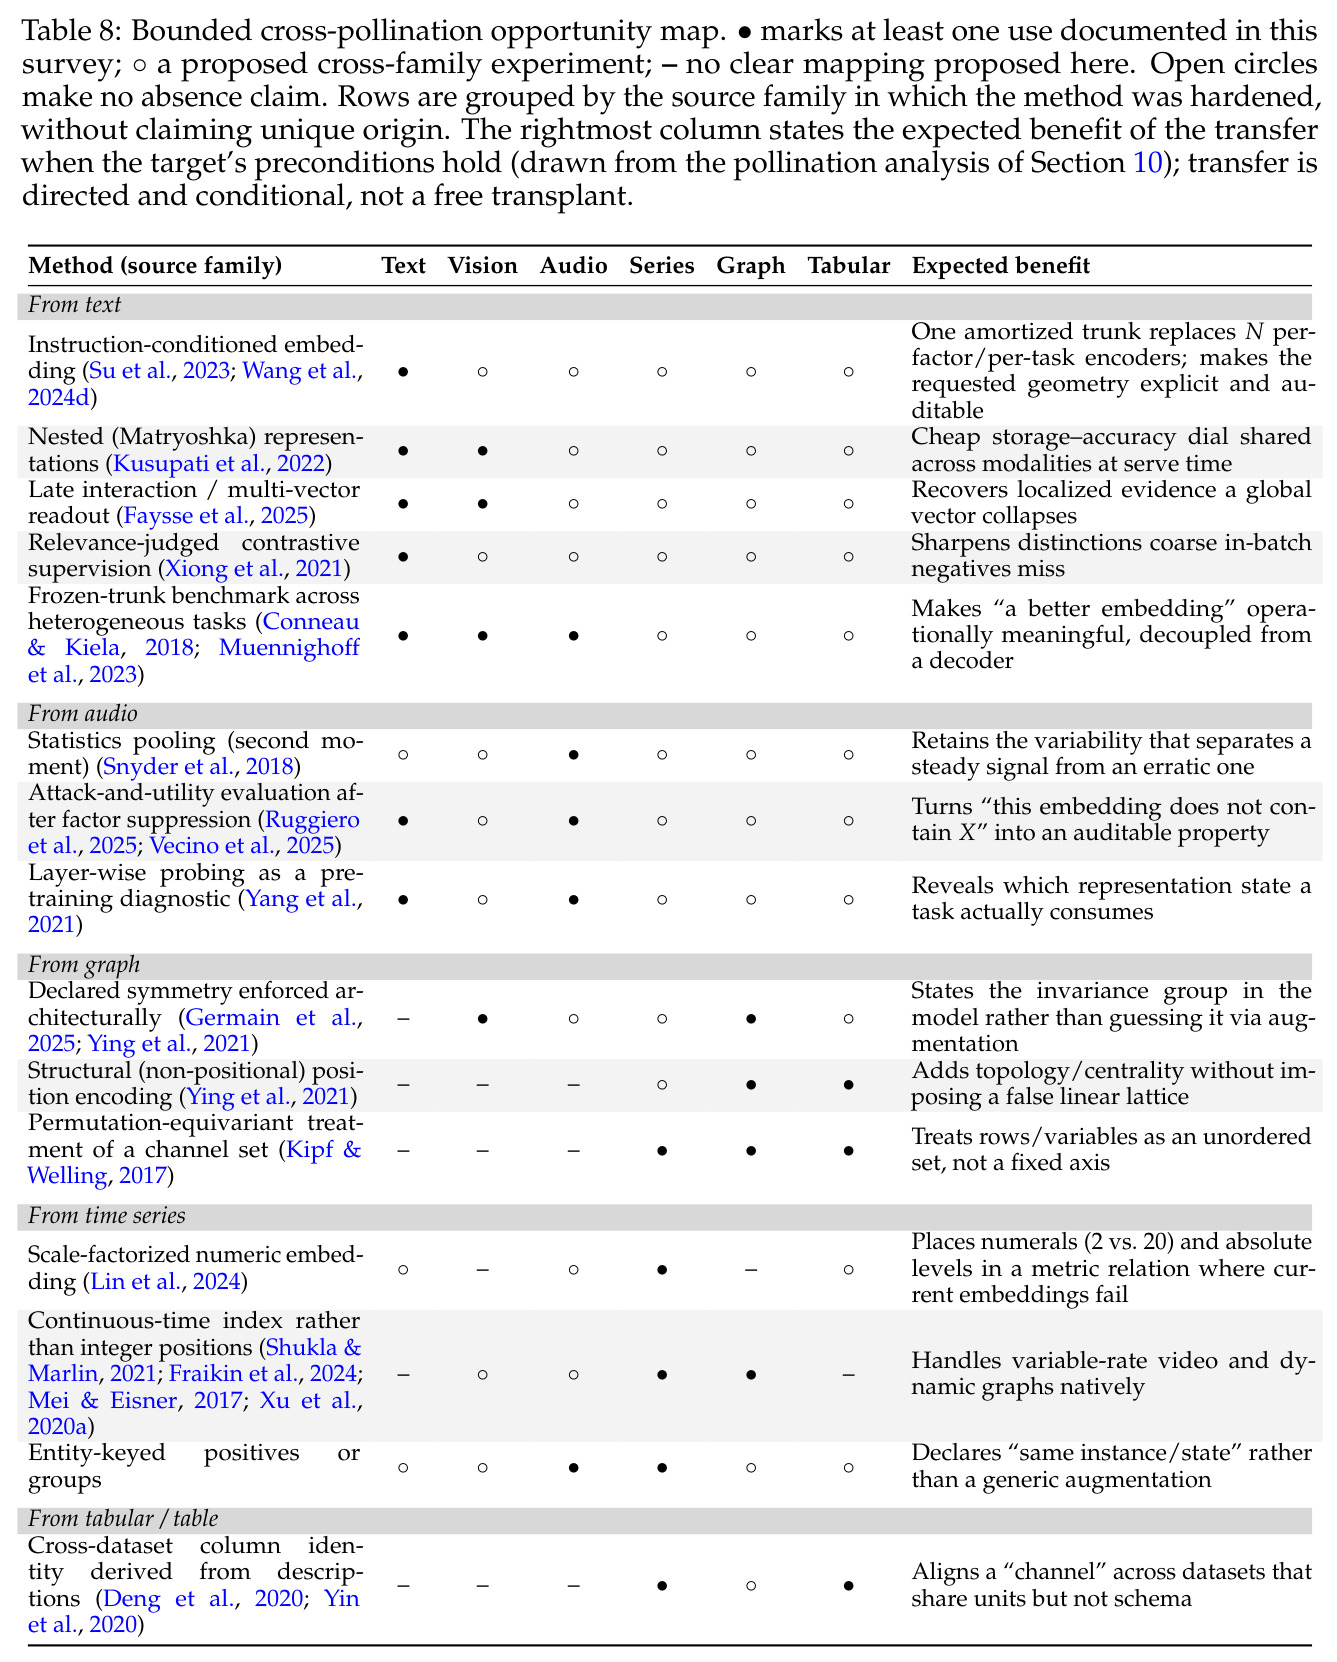
直觉上,各模态的嵌入研究像几块独立演化的大陆:它们各自发展出相似的文明(同样的对比损失、Transformer、两段式训练),却互不知晓。本文的工作分三层。第一层是造一门「通用语」——模态无关解剖学(第 2 章):任何嵌入模型都由五个按角色定义、可独立替换的组件构成——数据单元与分词(文本的子词、图像的 patch、音频的帧或 codec token、图的节点/三元组、表格的单元格、时序的窗口)、编码器(Transformer 正成为默认,CNN/GNN/RNN 最好理解为编码领域先验的归纳偏置)、聚合与读出($[\text{CLS}]$、平均池化、统计池化、多向量集合等)、训练目标(对比/重建/生成/混合四家族)、评估范式(冻结编码器 + 探针)。关键区分是输入侧「数据单元」与输出侧「表征对象」:同一编码器可暴露全局向量、局部向量集、离散码、概率分布、幅值保持向量五种读出(表 2),读出而非编码器决定嵌入能做什么。第二层是记录动态收敛(第 3–5 章):以 intersection/difference/reuse 三分透镜扫描文献,证明训练目标、架构、粒度三轴上各模态正在做相同选择。第三层是路线图(第 6–8 章):三条统一路径按交互深度递进——转换把其他模态渲染成图像或序列化成文本(PIXEL、TableRAG、Chronos),对齐用双塔加对比损失把独立编码的空间缝合起来(CLIP/SigLIP、ImageBind 枢纽绑定),联合嵌入让模态在模型内部交互(VLM2Vec、MM-Embed、e5-omni);3C 透镜依次给它们定级:转换提供覆盖(coverage),对齐提供可比性(comparability),融合瞄准组合性(compositionality)。最后第 9–11 章盘点模态特性、交叉授粉蓝图与统一评估设计。
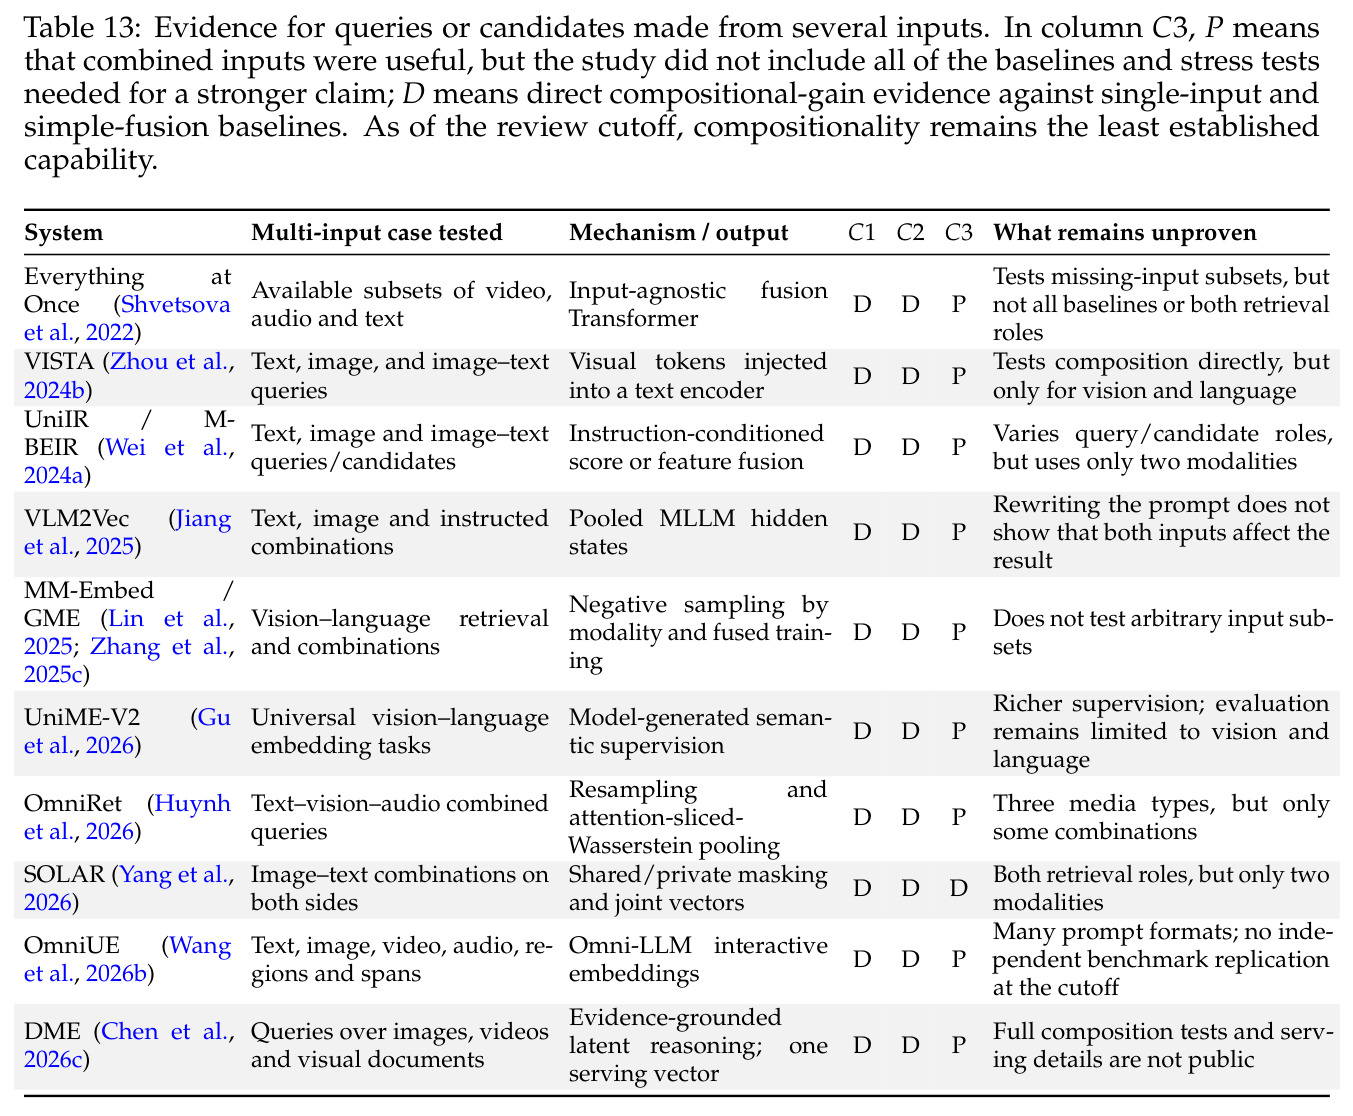
全文最核心的立场是:联合嵌入是对齐的严格泛化,因此是路线图的终点而非平行选项之一。论证分两步。第一步是架构论证:把交叉模态交互(交叉注意力)置零,融合模型就精确退化为对齐模型——双塔只是「一个什么都不融合的联合嵌入模型」;反之暴露交互只会增加对比对无法捕获的信息——跨模态 token 的相对排布。视觉-语言预训练时代提供了最干净的建筑学证词:ALBEF 和 BLIP 在同一主干上同时携带图像-文本对比(ITC,对齐头)与图像-文本匹配(ITM,交互头),而交互头恰好在「对应关系重要」的任务上获胜,说明交互是同一架构上的一个旋钮而非独立范式。第二步是运行模式论证:单一联合嵌入模型有两个模式——多模态输入时流交互、产生融合表示;单模态输入时退化为强单模态编码器(且因见过跨模态监督而受益)。在容量无约束的极限下融合弱支配对齐。配套的可测判据是组合增益 $\Delta_{\text{comp}}$:联合向量必须击败最强单模编码器、分数融合 $\sum_i w_i s_i$ 与向量加法 $\sum_i v_i e_i$ 两个加性基线,对应 PID 中只在联合变量出现的协同分量。论文同时诚实列出反例与代价:交互注意力对 token 数是二次方的;MM-Embed 联合训练使文本检索退化、需专门修复阶段恢复;Omni-Embed-Nemotron 发现音视频检索中非交错的分离编码反而优于同骨干的交错融合;模态竞争理论证明联合训练可能在每个成分模态上都劣于单独训练。因此「匹配专家」不是融合免费继承的性质,而是训练配方必须主动维护的约束。
方法步骤详情
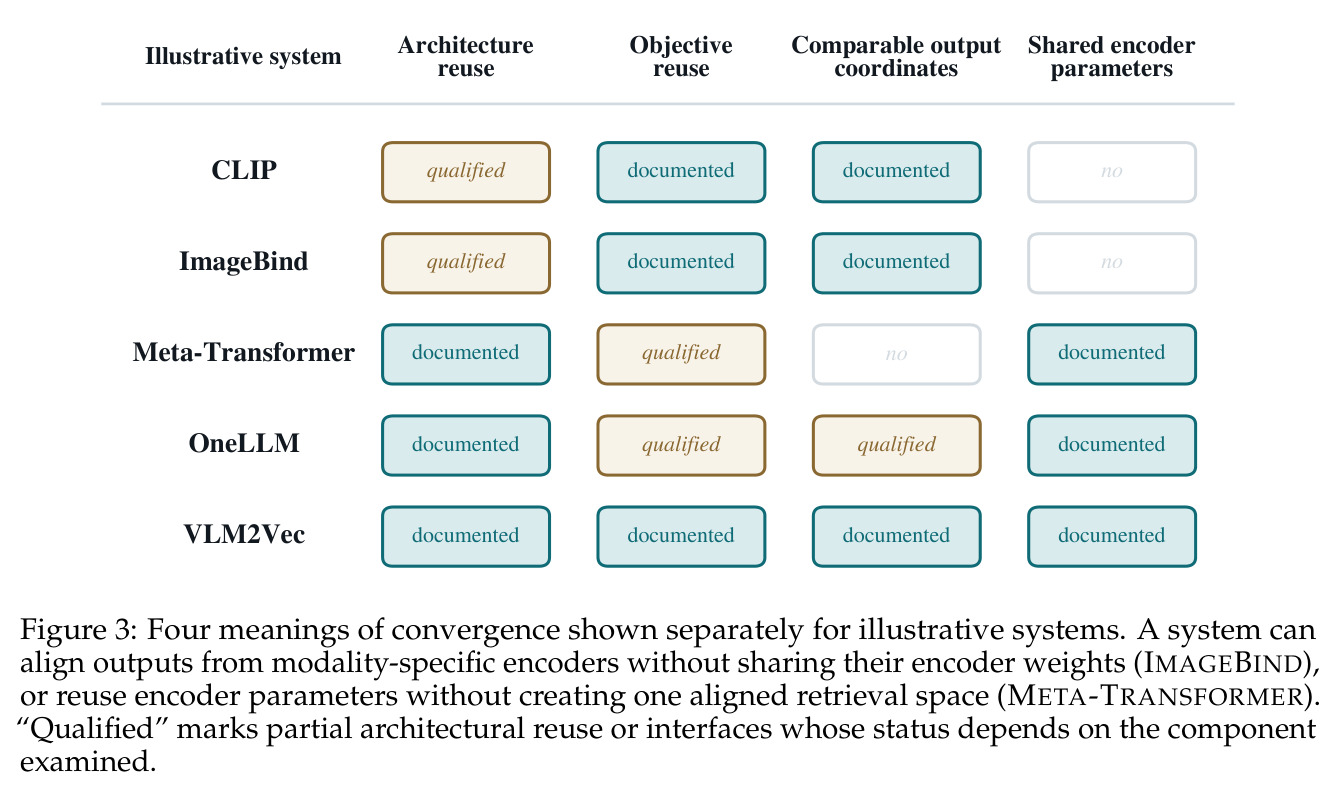
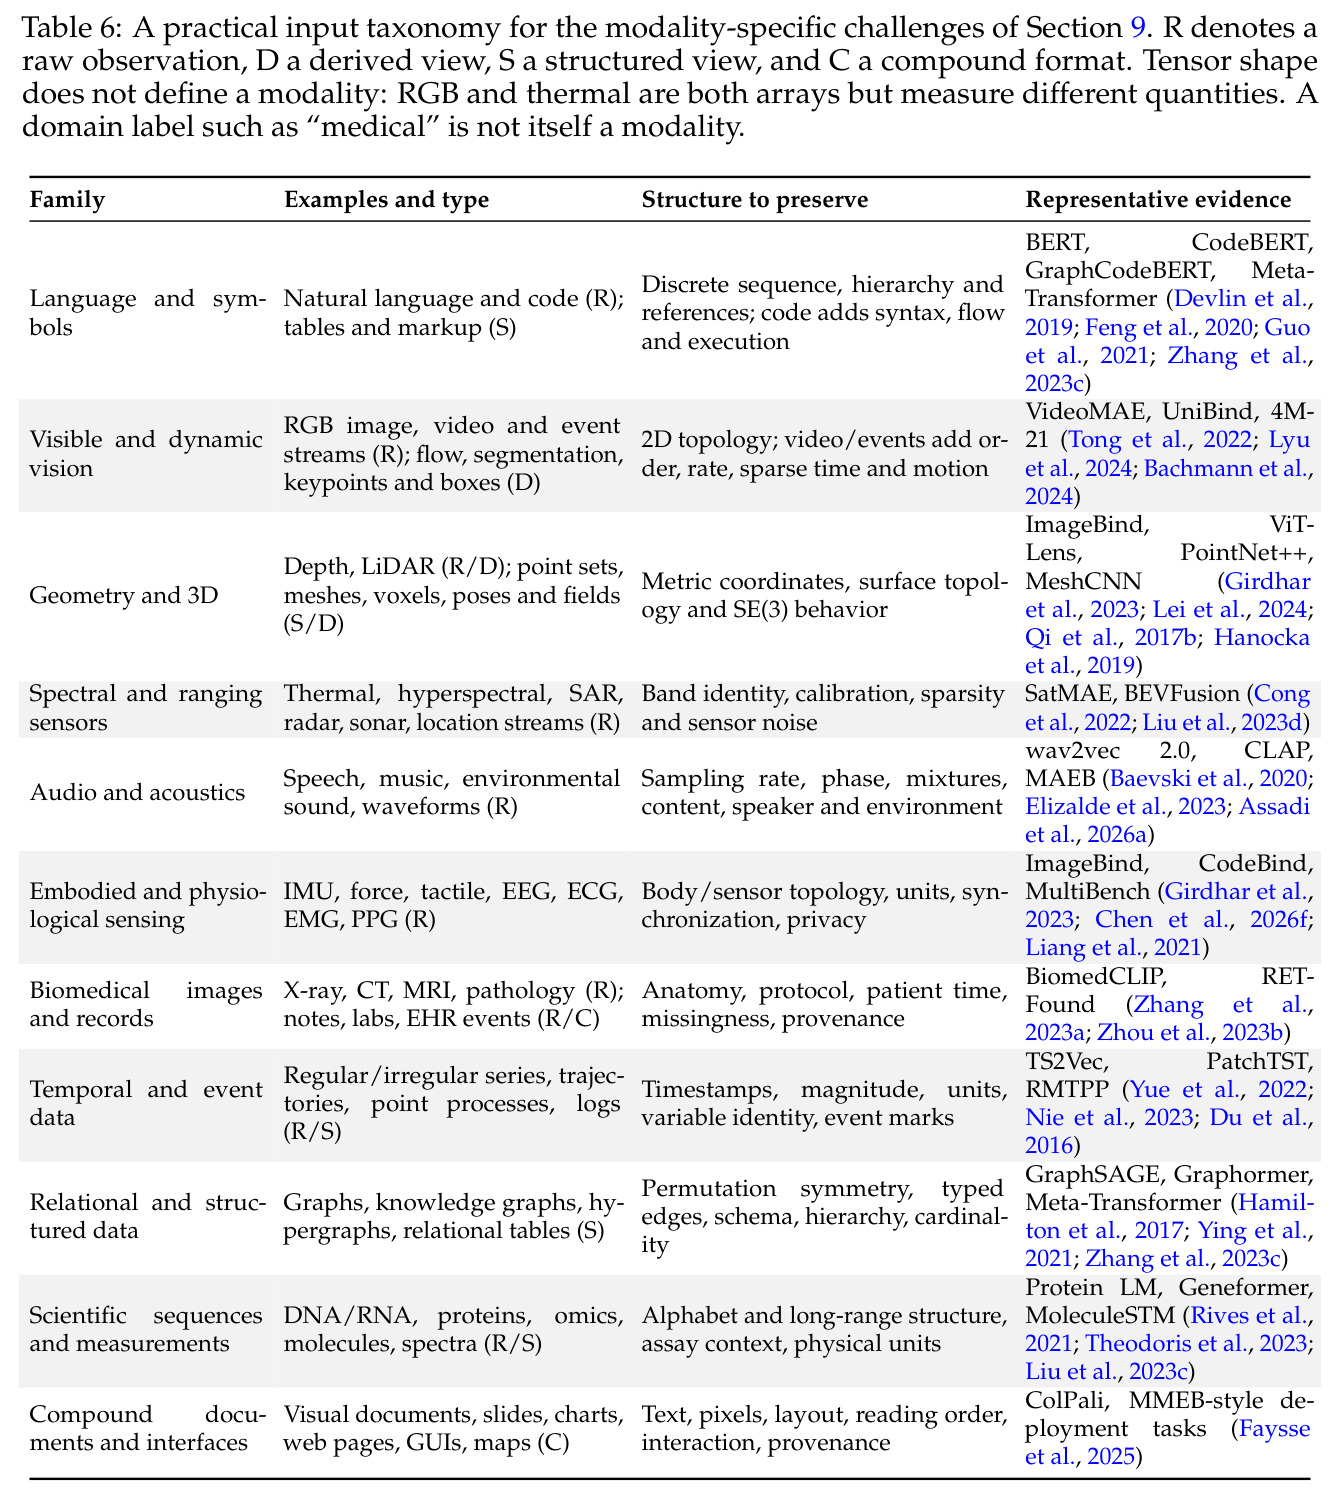
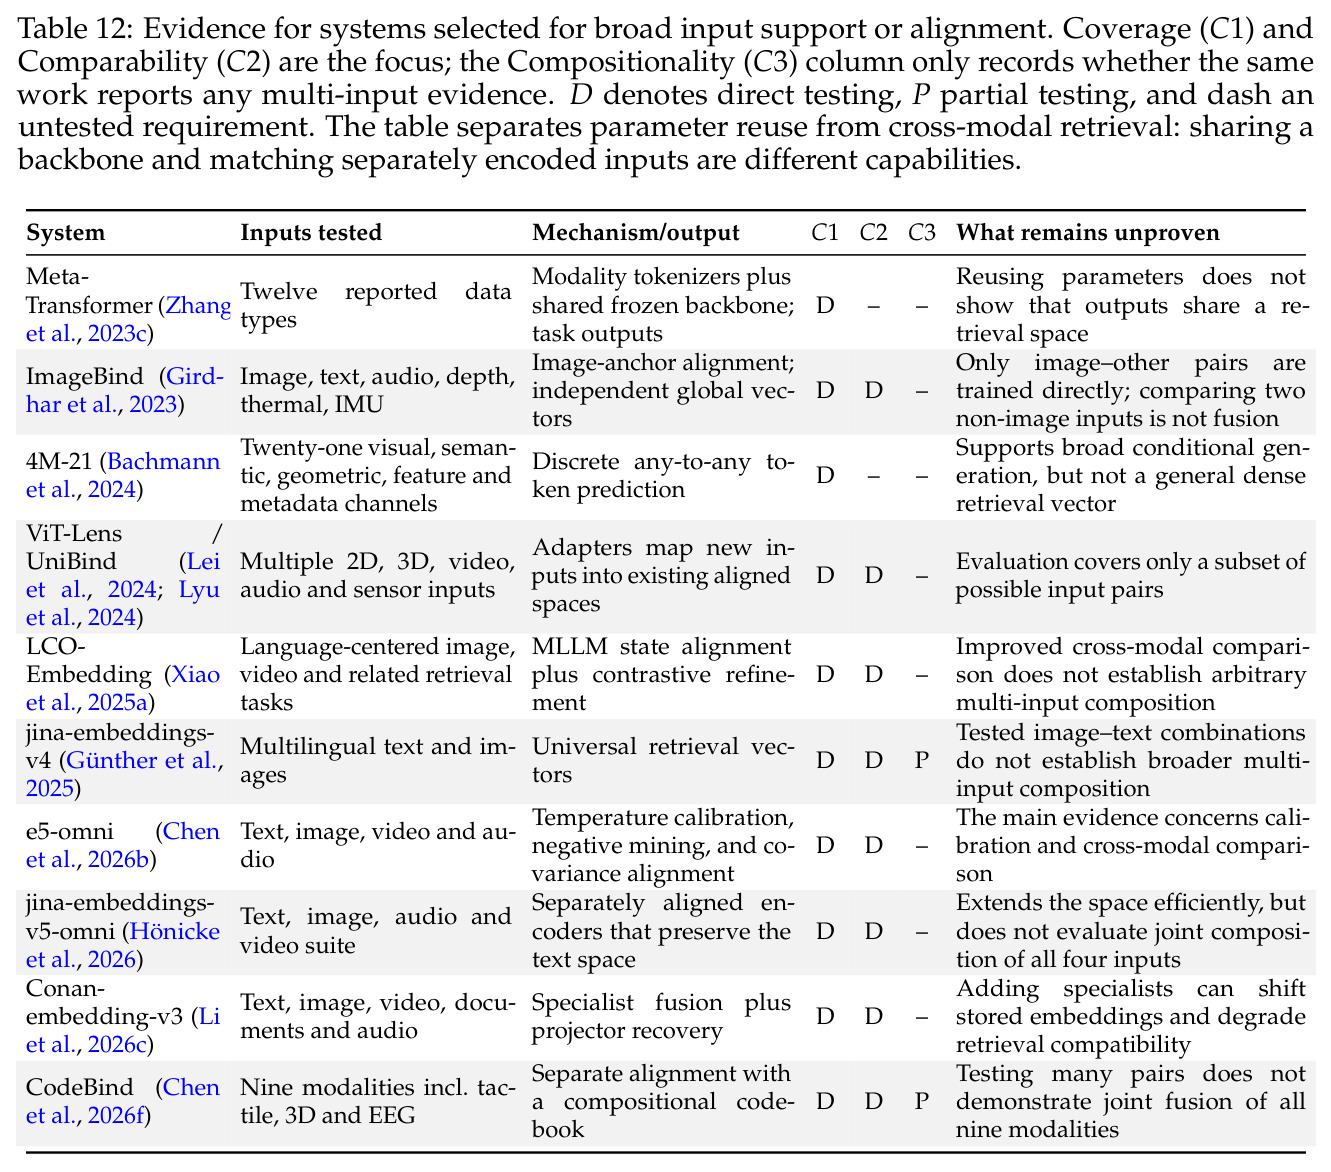
论文的分析框架按三步展开。第一步,建立解剖坐标系(第 2 章):定义五个组件并对文本/代码、图像/视频、音频、时序、图、表格六大家族逐一实例化(表 1),强调五轴正交——可以换编码器保持目标不变,或换读出保持编码器不变;随后区分数据单元与表征对象(表 2 给出五种读出的用途与代价:全局向量利于索引但丢位置/多重性,局部向量集保对应关系但存储昂贵,离散码桥接语言模型接口,分布表达歧义,幅值保持向量保留数值刻度);最后确立 intersection/difference/reuse 透镜并区分收敛的四种含义(架构复用、目标复用、可比较输出、参数共享——图 3 显示 Meta-Transformer 有参数共享但无对齐空间,ImageBind 反之)。第二步,证明收敛(第 3–5 章):训练目标上,InfoNCE 机制跨模态共享,差异只在正负对构造——文本用 dropout 隐式增强(SimCSE)或离散编辑,视觉用裁剪/光度视图( cropping 却可能裁掉判别物体),音频用话语视图或音频-标题对(一个任务想要的因子可能是另一个任务的噪声),图用增强视图或有效三元组,时序用窗口/尺度视图;重建目标共享 mask-and-predict 机制,掩码对象各异(BERT 预测词 ID、MAE 以 75% 比例掩码重建像素、HuBERT 预测离线聚类 ID、CodeBERT 做替换token检测、时序则掉进插值陷阱——平滑信号的重建回归出条件均值,恢复趋势与季节性是预期结果而非能力失败);生成-混合目标兴起(UniLM→T5→Unified-IO→GRIT 用对比+自回归联合训练单一 LLM);预训练–微调配方遍布所有模态(wav2vec 2.0 只需 10 分钟转写微调)。架构上 Transformer 成为通用主干,但分词器而非主干承载模态性(图 4):顺序、拓扑、采样率、变量身份必须通过位置编码、扫描顺序、注意力偏置重新注入;SSM/线性注意力是竞争者。表征对象上粒度上移(词→句→检索点、像素→图、帧→话语、样本→窗口/序列),但论文强调这是格而非单向阶梯——成熟编码器应按任务在格上上下移动。第三步,分级三条路径并给出判据(第 6–8、11 章):3C 透镜操作化为证据门(表 9/10 把机制与能力解耦),提出 $\Delta_{\text{comp}}$ 公式(式 5),并对 20 余个代表系统逐一体检(表 12/13)。
技术新颖性
技术新颖性有六点。其一,它是第一份跨全部六大模态家族的嵌入综述,此前的空白是结构性的:每个单模态综述都不跨界,导致「SimCSE 与图增强、MAE 与音频掩码」这类平行发现从未被并置。其二,五组件正交解剖加数据单元/表征对象二分是分析工具而非目录——它把「模态差异到底在哪里」从模糊直觉落到可指认的轴上(例如音频的统计池化故意保留二阶矩,是文本侧全局池化会抹掉的信息)。其三,3C 透镜首次把「全模态」声明拆成递进可检验的能力,并明确列出无效证据(数分词器、共享主干、共现、任务准确率),据此可以把 ImageBind 的「九模态」声明与真正的融合区分开。其四,融合吸收对齐的泛化论证与 $\Delta_{\text{comp}}$ 指标把一场哲学争论变成可计算量——这是综述论文里少见的「提出新度量」的贡献。其五,有向条件交叉授粉图(表 8)区分已验证迁移(实心点)与提议实验(空心圈),并为每个迁移写明前提条件(如离散化要求有复现单元清单),避免「自由移植」式的过度承诺。其六,附录 B 的定量文献普查(10,952 条 arXiv 记录的标题词分析 + 1,352 篇会议论文的九桶人工分类)让「割裂」诊断从印象变成可测结构。
实验结果
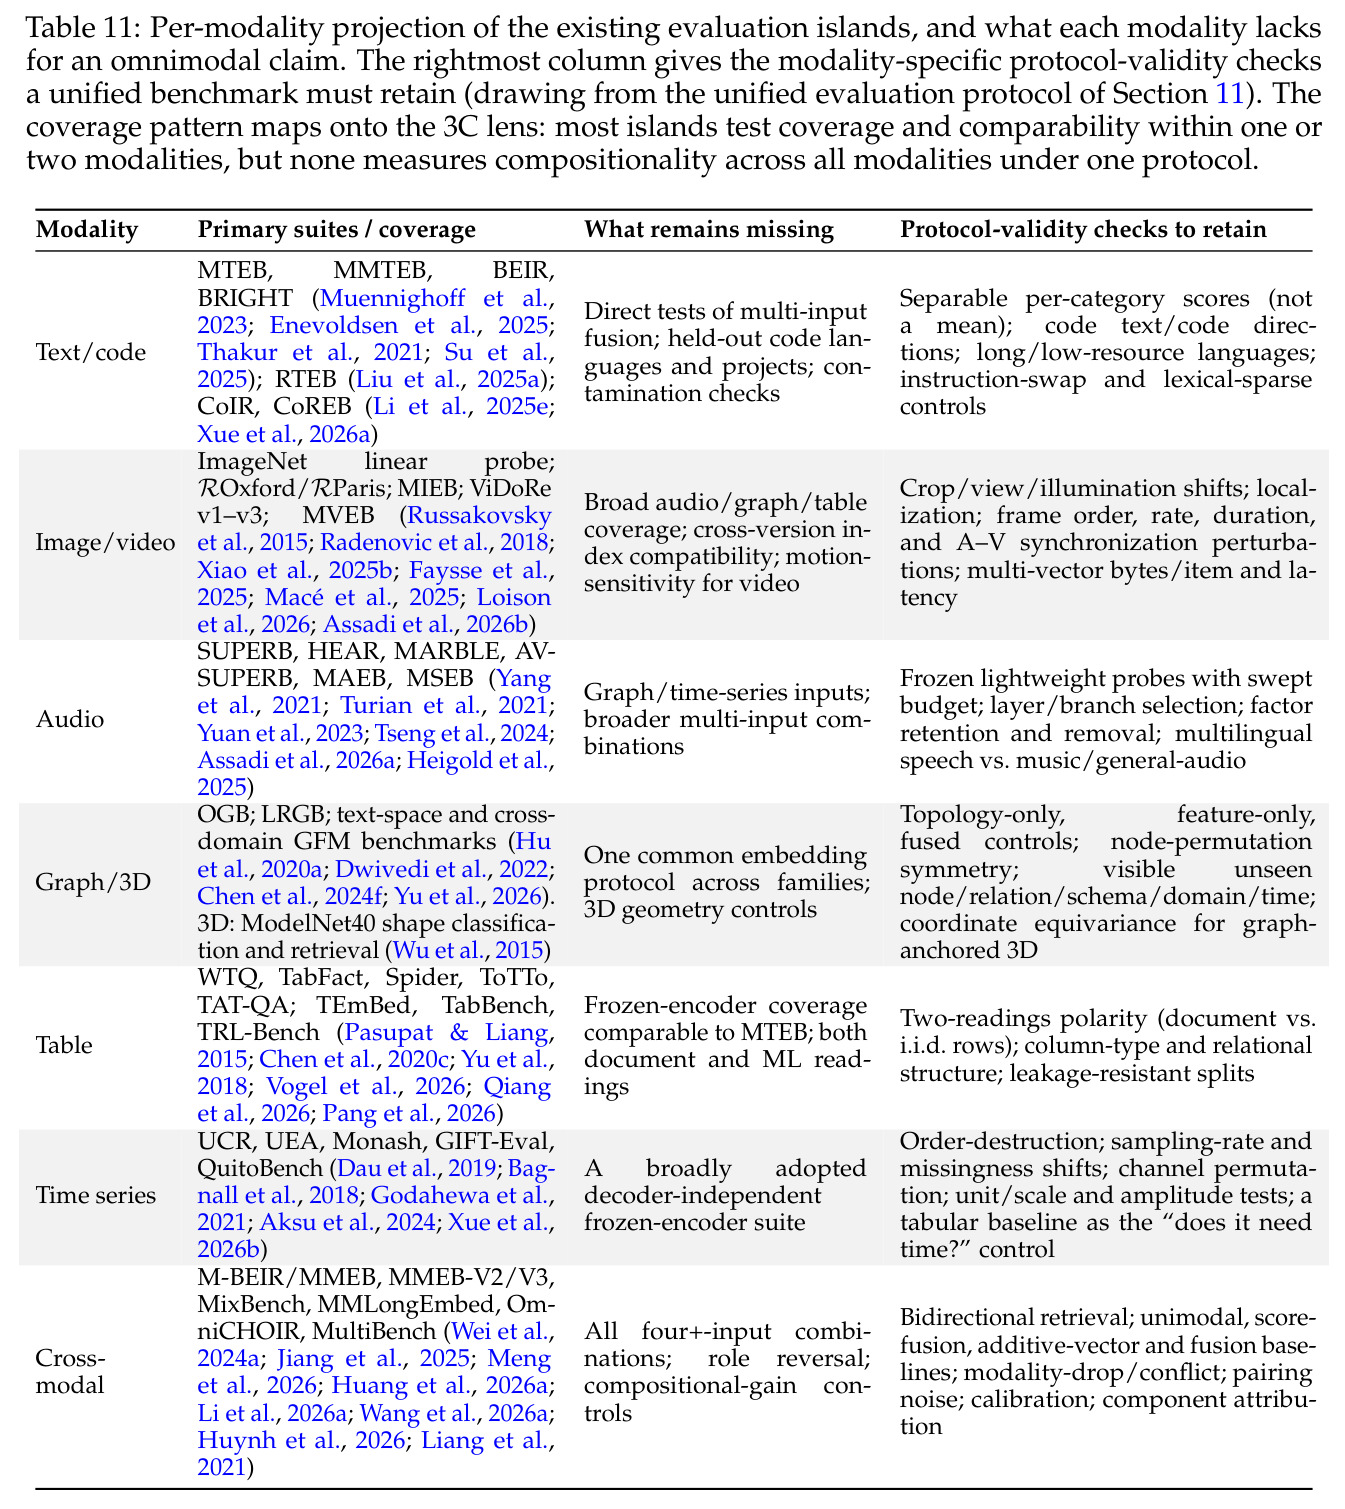
这篇综述的「结果」是文献证据的系统化与三个核心判断的落实。判断一:割裂是可测量的。十年 arXiv 标题词分析(10,952 条记录)显示「multimodal embedding」标题在 2023 年前每年不超过 10 篇,2023–2025 年升至 15、29、62 篇——单年增长 2.1×(同期总量仅增 13%),份额从约 1% 升至 3.5%;而「cross-modal embedding」整个十年窗口从不超过每年 8 篇,说明增长集中在「多模态融合」词汇而非成对「跨模态」措辞。1,352 篇会议论文普查显示:文本嵌入论文 237/308 发在 NLP 会议,音频 309/334 发在两个语音会议,跨模态对齐桶 48/66 集中在 CVPR 且是唯一连续翻倍的桶(7→22→37),语音是唯一衰退桶(136→120→78)。判断二:三条路径能力递进且证据严重失衡。对齐路线已高度成熟(SigLIP 用成对 sigmoid 损失摆脱巨型批;DataComp/MetaCLIP 证明数据策展收益超架构调优;EVA-CLIP 推到 18B 参数;hub 选择从 ImageBind 的图像枢纽经 LanguageBind 的语言枢纽演化到 OmniBind 绑定 14 个专家空间);模态鸿沟持续存在但功能负荷复杂——少数维度承载它,GR-CLIP 的免训练后处理中心化在混合模态检索上把 NDCG@10 提升最多 26 分,说明鸿沟在混合语料检索中是必须处理的排序病理。融合浪潮正在发生:E5-V 仅用文本对微调即迁移到图像与交错检索,LCO-Emb 论证潜在对齐是生成预训练的副产品、对比微调只是精炼。但 3C 体检结果刺眼:表 12 中所有广覆盖系统(Meta-Transformer、ImageBind、4M-21、ViT-Lens/UniBind、LCO-Emb、jina-embeddings-v4/v5-omni、e5-omni、覆盖 9 模态含触觉与 EEG 的 CodeBind)几乎全部是 C1=D、C2=D、C3=–;表 13 中多输入系统的 C3 几乎全为 P(部分证据),唯一 D 级是 SOLAR 且限图文两模态。判断三:评估是短板。MTEB 59.0 分的模型在推理密集检索基准 BRIGHT 上掉到 18.3;MAEB 跨 53 个编码器与 30 个任务无单一模型占优且出现干净的双分离(对比音频-文本模型在环境声上强但在多语言语音上近随机,反之亦然);表格与时序尚无被广泛采用的 MTEB 类比物。结论:compositionality 是今天最欠缺建立的能力,统一基准建成前「融合统一并超越对齐」是假设而非事实。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 嵌入研究的跨模态程度(文献计量) | 显式跨界论文占比 | 两个样本(10,952 条 arXiv 记录 + 1,352 篇会议论文)中均不足 5% | 单模态研究占绝对主导(各模态发表在母社区会场) | multimodal embedding 标题份额从约 1% 升至 2025 年的 3.5%,2024→2025 单年增长 2.1×,是增长最快的桶 |
| 混合模态语料检索(文本/图像/图文混合文档互检) | NDCG@10 | GR-CLIP:对每个模态的嵌入做免训练后处理中心化 | 原始 CLIP 嵌入 | 最高提升 26 分,证明模态鸿沟是混合模态检索中的可修复排序病理 |
| 推理密集检索(BRIGHT) | 检索分数 | 文献证据:MTEB 高分模型在 BRIGHT 上系统性崩溃 | 同一模型 MTEB 得分 59.0 | BRIGHT 上仅 18.3(下降 40.7 分),暴露单模态基准孤岛掩盖的真实能力缺口 |
| 通用音频嵌入(MAEB) | 跨 30 任务的总体表现 | 文献证据:53 个编码器中无单一模型占优 | 对比音频-文本模型(环境声强、多语言语音近随机)与语音模型(反之) | 干净的双分离——这种发现只有跨任务统一协议才能暴露,单模态孤岛做不到 |
| 组合性 C3(多输入联合嵌入) | 3C 证据等级(D/P/–) | 对 20+ 代表系统的审查:唯一 D 级是 SOLAR(图文两模态),其余多输入系统全为 P | 广覆盖系统(ImageBind、CodeBind 等 9 模态)C3 均未测试(–) | 结论性的负结果:compositionality 是全领域最欠缺建立的能力 |
| 时间序列分类(UEA 十数据集) | 超越基线数量 | LETS-C:序列化后用通用文本嵌入模型并与预处理数值序列逐元素相加融合 | 27 个专用时间序列架构基线 | 超越全部 27 个基线;但作者提醒任一单输入均落后于完整模型,控制实验不干净 |
| 视觉文档检索(ViDoRe) | 检索准确率 | 文献证据:ColPali 对文档图像做晚期交互检索 | OCR-转-文本管线 | 在视觉丰富文档上胜出——证明当语义本就是视觉布局时,渲染不是有损近似而是更忠实的表示 |
局限与改进
作者承认的局限有四。第一,中心论点悬置:由于没有统一全模态基准,「联合嵌入统一并超越对齐」严格说仍是假设——而没有任何标尺时,关于哪种收敛已发生、哪个模型更全模态的声明不可证伪。第二,评估工具本身脆弱:探针预算敏感性能翻转结论(「冻结编码器+训练头」谁更好取决于头的大小,没有套件令人信服地标准化这一点);公开测试集易被污染(MTEB 维护已记录流行嵌入模型在与基准同分布的数据上训练);多模态基准反复被证明可走单模态捷径(VQA 的语言先验平衡研究)。第三,融合数据贵且难释放:组合性任务标注成本最高且很多基准被事后发现噪声过大需重新标注;主要托管平台上超过 70% 的流行数据集许可未注明,临床、会议、车队等真正需要融合的场景被隐私与许可锁死——因此由「可发布的东西」拼成的基准会系统性欠代表性。第四,附录 B 定量分析的三个自认偏差:短语查询排除邻近术语(计数是下界)、标题级匹配漏掉不点名的使用、只测注意力分布不测任何具体构造是否有效。我的补充观察:融合的实证证据几乎全部限于视觉-语言两模态,本文关于「融合是终点」的宏大论证在音频、图、表格、时序上基本是外推;大量引用 2025–2026 年文献(e5-omni、Qwen3-VL-Embedding、MMEB-V3 等),结论的时效窗口很短;且 $\Delta_{\text{comp}}$ 测量的是单个冻结模型的端到端性能而非分布属性,与 PID 协同项并非等价,基线权重在验证集上拟合这一点既可能虚增也可能低估融合增益。
独立分析的弱点
弱点一:立场先行于证据。第 8 章的「融合弱支配对齐」是一个容量无约束极限下的论证,而论文自己引用的有限容量反例(MM-Embed 文本检索退化、Qwen3-VL-Embedding 不及匹配的专家、Omni-Embed-Nemotron 音视频非交错反而更好)说明该支配在实践中经常不成立,但路线图没有给出「何时融合不划算」的决策规则。改进方向:把容量、数据混合、模态失衡三个破坏因素形式化为成本-收益模型,给出类似「交互增益预计低于 $k$ 倍 token 数平方开销时退回双塔」的调度准则。弱点二:$\Delta_{\text{comp}}$ 对基线拟合敏感。分数融合与向量加法的权重 $w$、$v$ 在验证集上拟合,若拟合不充分会人为抬高 $\Delta_{\text{comp}}$;Perf 的任务依赖选择也缺少稳健性检验。改进:要求报告基线族、多次拟合的置信区间,并把「无融合增益」作为显式失败类别。弱点三:推理型嵌入游离在评估设计之外。Think-Then-Embed、UME-R1(用检索奖励做强化学习)、Retrv-R1(思考模式调度)被综述提及,但 3C 门只把 bytes/latency 放在部署门里,没有把「推理后嵌入」的延迟-质量权衡纳入主协议。改进:为生成式嵌入设计单独的帕累托前沿评估。弱点四:模态家族粒度的裁决有任意性。作者把 4M-21 的 21 个「模态」裁为视觉衍生视图是合理的,但这一裁决同时也把多视角联合建模(深度、分割、姿态互补)的价值排除在全模态叙事之外。改进:在 3C 框架内为「衍生视图的协同增益」保留一个二级审计位。弱点五:交叉授粉图几乎没有负迁移证据:除时序重建插值陷阱外,论文没有系统讨论迁移失败的成本如何度量与预警。改进:为每个迁移向量设计前提检验实验(作者已给出方向但未给出协议)。
未来方向
作者明确提出的方向有四。其一,建统一全模态基准:覆盖文本、代码、图像、视频、音频、图、表格、时间序列的输入与组合,横跨单模态任务、跨模态检索、多模态融合任务三类,采用冻结编码器+故意弱头的协议、标准化探针预算、内在诊断(对齐-均匀性、各向异性、反演攻击),并给每个多模态任务附上 $\Delta_{\text{comp}}$ 列——作者强调这是前提而非后果。其二,执行交叉授粉蓝图:文本的指令条件化迁移到音频(「为说话人身份嵌入、丢弃内容」一句话取代每因子一个编码器与整个解耦文献)与时序;音频的 codec 语义码本迁移到代码执行轨迹与时序(TOTEM 的通用码本已可零样本迁移到共享无采样率/传感器域);图的结构建模迁移到文本与代码;时序的连续时间索引迁移到变帧率视频与动态图(TGAT 已证明可行);音频的因子核算表迁移到视觉与文本。其三,融合病理治理:模态坍缩、梯度干涉、模态竞争的系统性缓解,以及 MoME 式参数专门化加晚期融合的配方(VLMo 分阶段预训练、音频语言线的生成先于对比、e5-omni 的对齐+融合耦合)。基于成果可延伸的方向:把 Jha 等人的无监督空间平移发展为免训练的融合审计工具;把指令条件化与音频因子表合流为「因子命名」的通用机制;把多部分读出、Matryoshka 嵌套维度与晚期交互统一为推理时可调预算(MetaEmbed 已把交互向量数变成测试时旋钮);以及面向 RAG 的全模态索引栈(可索引条目内融合嵌入 + 交叉编码器重排的 (A)+(B) 流水线)。
复现评估
作为综述/立场论文,可复现的对象是分析框架与评估协议而非模型权重。可复算部分:附录 B 的 arXiv API 查询协议完整公开(六个分类、关键词与去伪规则,11,806 条候选最终留下 10,952 条),会议普查的九桶分类法与 1,352 篇论文来源 venue 清单也已给出,重新执行只需 API 调用加人工分类(后者的领域判断有主观性,作者自认标题级偏差);3C 证据矩阵的评级标准(D=直接测试、P=部分测试、–=未测试)公开且可对照原文核查;$\Delta_{\text{comp}}$ 公式(式 5)可直接实现——对每个多模态任务计算冻结模型联合性能与三个基线(最优子集、分数融合、向量加法)之差。配套资源:论文附 GitHub 仓库 Awesome-Omnimodal-Embeddings 维护文献列表。算力需求:复现综述本身为零算力;若落地其提出的基准协议,主要成本是被评测模型的推理开销(全模态超集会成倍放大 MMTEB 已不得不降采样的评估账单)。总体难度:文献普查部分中等、协议实现部分中低;真正的门槛不在复现而在建设——按第 11 章的分析,统一基准受制于标注成本、许可清洗(超过 70% 流行数据集许可未注明)与污染检测的持续工程。
论文图表
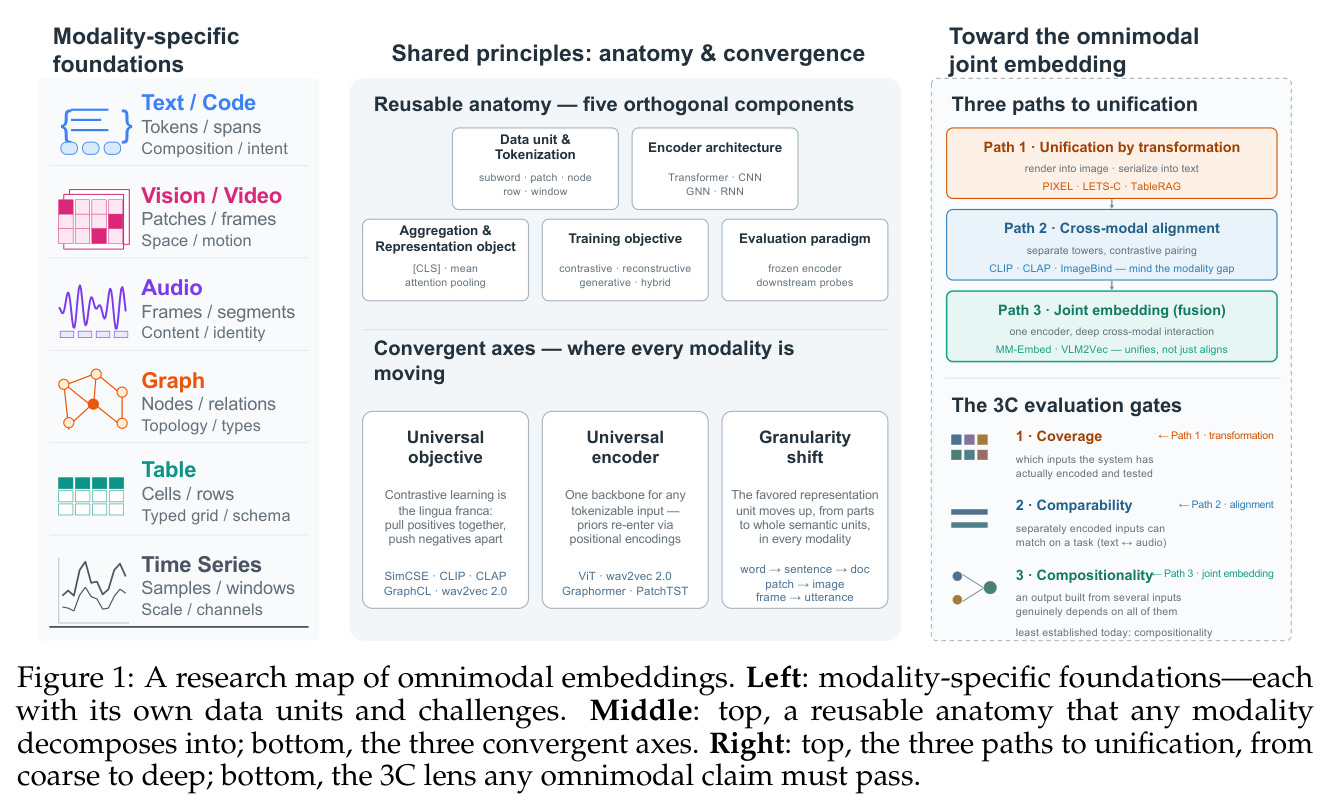
全文一页总览图。左侧是六大模态家族各自的专属基础(文本/代码的 token 与意图、视觉的 patch 与帧、音频的帧与段、图的节点与关系、表格的单元格与行、时序的尺度与通道);中部上方是任何模态都可分解进去的复用解剖(五组件),下方是三条收敛轴(通用目标、通用编码器、粒度迁移);右侧上方是三条由粗到深的统一路径(转换:渲染/序列化/离散 token;对齐:分离双塔+对比配对,CLIP/CLAP/ImageBind 但当心模态鸿沟;融合:单编码器深度交互,MM-Embed/VLM2Vec),右侧下方是任何全模态声明必须通过的 3C 门。
这是全文的导航地图:读者先看懂这张图,就掌握了论文的四部分结构(统一基础→收敛原则→统一路径→未来之路)与核心概念(解剖学、收敛轴、三路径、3C 透镜)之间的全部关系。
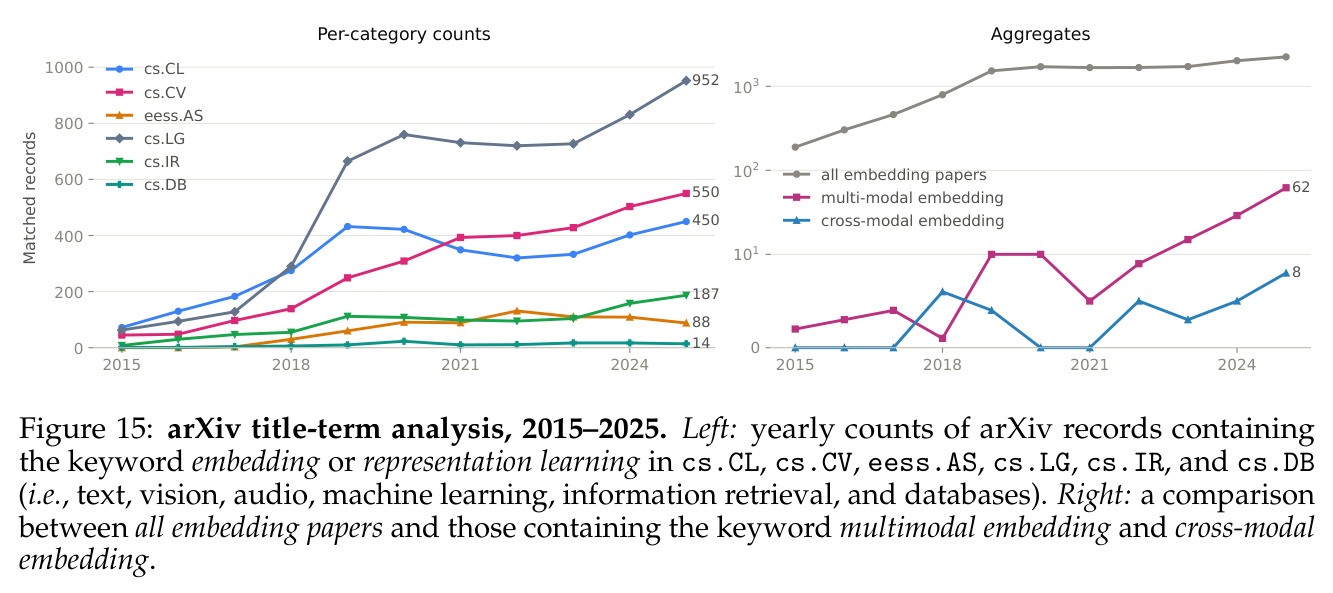
左图:cs.CL、cs.CV、eess.AS、cs.LG、cs.IR、cs.DB 六个分类中标题含 embedding 或 representation learning 的年度记录数(保留记录从 2015 年的 140 条增长到 2025 年的 1,784 条,cs.LG 自 2018 年起一直是最大类,2025 年达 952 条;cs.CV 2021 年超过 cs.CL 并在 2025 年达 550)。右图:全部嵌入论文与 multimodal embedding(2023–2025 年为 15/29/62 条)及 cross-modal embedding(全窗口每年不超过 8 条)两个词族的对比。
这是「碎片化」诊断的第一块定量证据:总体增长放缓(2024→2025 仅 13%)的同时 multimodal 词族单年增长 2.1×、份额从约 1% 升至 3.5%——「全模态嵌入」这个命名对象正在快速扩张,且扩张发生在 multimodal 一侧而非 pairwise cross-modal 一侧,直接呼应论文的融合论点。
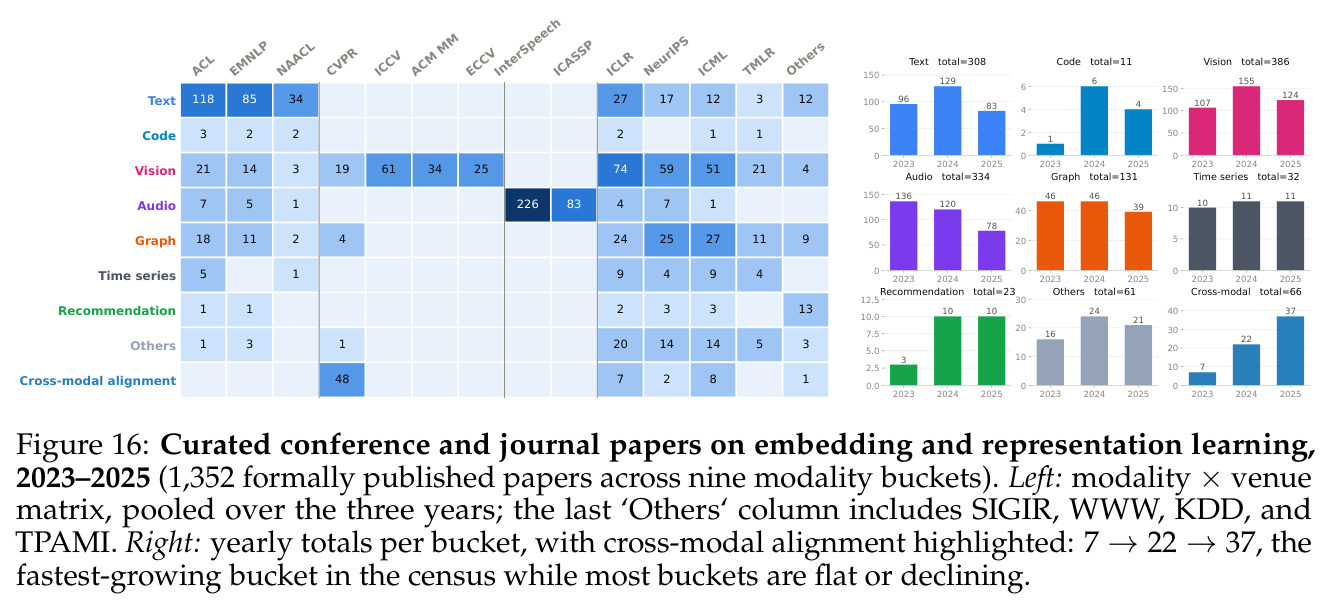
左图:模态×会场矩阵(三年合并):文本 237/308 在 NLP 会议,音频 309/334 在两个语音会议,推荐系统集中在 SIGIR,视觉/图/时序分散在 ML 会议(ICLR+NeurIPS+ICML 独占视觉桶 386 篇中的 205 篇);跨模态对齐桶 48/66 集中在 CVPR。右图:各桶年度总量——跨模态对齐是唯一连续翻倍的桶(7→22→37),语音是唯一明显衰退的桶(136→120→78)。
这是「碎片化」诊断的第二块定量证据:社区按会场精确隔离恰好在它们最大的地方,而增长最快的正是跨越模态边界的工作。它与图 15 共同把第 1 章的定性判断变成可测量结构。