EmbeddingGemma 2:统一且高效的多模态表示 EmbeddingGemma 2: Unified and Efficient Multimodal Representations
744M参数开源多模态嵌入模型,统一文本、图像、视频与音频表示空间
前置知识
对比学习与批内负样本
通过拉近匹配的查询-正样本对、推远不相关对来训练嵌入空间。噪声对比估计(NCE)损失把 batch 内其他样本当作负样本,配合困难负样本(检索中易混淆的样本)与同塔负样本(查询与查询、目标与目标之间),可防止不同类型的输入聚成互不相交的子空间。
本文微调阶段的唯一训练信号,作者用消融证明摆脱教师后对比学习才是质量继续上涨的关键。
嵌入匹配蒸馏
让小模型(学生)模仿大模型(教师)的输出。传统蒸馏只传递教师给出的查询-文档相关度分数,而嵌入匹配损失直接对齐学生与教师的嵌入向量本身:对查询、正样本和困难负样本都计算 $\mathcal{L}_D = \frac{1}{B}\sum_i \|u_i - \tilde{u}_i\|_2^2$,其中 $\tilde{u}_i$ 是截断并归一化后的教师嵌入。
本文前两个训练阶段的唯一主损失,直接从 Gemini Embedding 2 继承语义空间,是理解其训练配方的基础。
Matryoshka 表示学习(MRL)
训练时把每个损失拆分到嵌入向量的多个前缀子维度(如 768、512、256、128 维)上同时优化,使得截断后的短向量仍保持较高质量,一个模型即可按存储与延迟预算输出不同维度的嵌入。
本文支持四档维度,论文所有表格中 512/256/128 维的结果都来自 MRL,读表时必须知道这些不是重新训练的模型。
双向注意力与因果掩码
标准 decoder 用因果掩码让每个 token 只能看到左侧上下文;嵌入模型改为双向注意力,每个 token 可见全序列,再经 mean pooling 汇聚成全局表示。从生成模型改造时通常需要额外的适配阶段,但本文与前期工作证明该阶段可以省略。
骨干由 Gemma 4 decoder-only 模型改造而来,理解这一点才能明白文本预微调阶段承担了'隐式热身双向注意力'的角色。
量化感知训练(QAT)
训练时模拟整数权重(如 int4)的前向计算,使模型在低比特表示下仍保持精度。本文在模型合并之后增设独立的 tail-patch 阶段,从冻结的 float 检查点蒸馏并初始化 QAT 检查点,比直接在微调阶段做 QAT 更省资源且质量差距更小。
int4 量化后质量几乎无损、可在手机端运行是本文的核心卖点之一,涉及 Q4_0 与 Q4_C 两套逐块/逐通道方案。
Pareto 前沿
在质量-参数量(或质量-成本)平面上,若一组模型的每个点都无法被其他模型同时以更少参数取得更高质量,则称它们构成 Pareto 前沿。'树立新 Pareto 前沿'意味着在同等规模下质量最高,或在同等质量下参数最少、成本最低。
这是论文对全部评测结果的总结性主张,Figure 2 以图形方式直观呈现了这一核心 claim。
视觉 token 预算
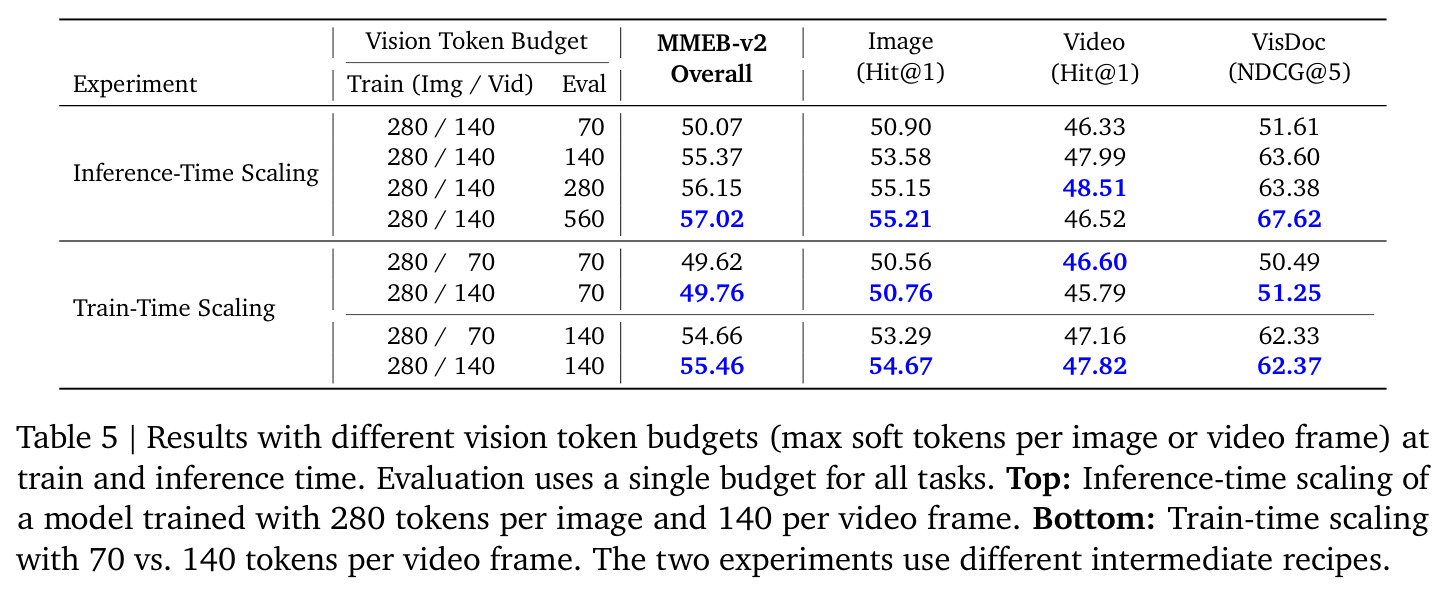
ViT 把图像切成 patch 编码后,经空间池化压缩到固定数量的 soft token(如每图 280 个),token 数决定了视觉信息的分辨率上限。推理时可调节预算(70 到 1120)在算力与质量间权衡,视觉文档类任务对细粒度细节敏感、需要更大预算才能发挥全部实力。
它是 3.4 节消融的核心变量,直接决定 VisDoc、图像、视频三类任务的表现与端侧推理成本。
研究动机
现有嵌入方案在多模态场景下存在两条都不令人满意的路径。其一是文本嵌入模型外挂工具:用 ASR 转写语音、用图像 captioner 描述图片后再走文本检索,这不仅叠加了额外计算成本,还会丢失细粒度视觉细节以及非语言、环境声等信号。其二是 CLIP、ALIGN、SigLIP 这类双塔多模态模型:它们为视觉单独建塔,跨模态检索很强,但无法原生处理图文交错、音视频混合的 mixed-modal 输入,也做不了视觉问答这类需要模态间深度交互的任务。近年出现了把多模态大语言模型(MLLM)改造成嵌入模型的工作,能支持交错输入与视觉定位等复杂任务,后续工作又扩展到视频和音频;但 MLLM 本身动辄数十亿参数,改造出的嵌入模型同样庞大,对延迟敏感、高吞吐或需要端侧部署(隐私、离线访问)的应用而言成本高不可攀。同时维护多个模态专家模型的存储与部署负担同样沉重。
本文的目标是论文的目标是构建一个小而全的通用多模态嵌入模型:用单一模型把文本、图像、视频、音频以及任意交错的混合输入映射到同一个语义对齐的向量空间,使单模态、跨模态、混合模态三类评测都达到高水准。规模上明确瞄准资源受限场景:总参数 744M,其中骨干(含嵌入器)仅 271M,可按需只加载文本(271M)、加视觉(439M)或加音频(577M)编码器;嵌入维度支持 768/512/256/128 四档截断;提供 int4 量化检查点,在 Pixel 11 Pro 上全模态推理峰值内存仅 567MB、纯文本仅 191MB。作者希望在覆盖文本、代码、图像、视频、视觉文档、语音、声音的七套综合基准上,相对专家模型和 2 到 12 倍大的通用模型树立新的 Pareto 前沿,并开源模型推动后续研究。
与已有工作不同的是,本文的独特切入角度有三点。第一,模块化的'小编码器 + 共享双向骨干'架构:视觉、音频编码器独立产出 soft token 注入同一个 271M transformer,模态参数可拆可合,而不是把所有能力塞进一个巨型 MLLM 再整体蒸馏。第二,训练目标与模态的双重课程设计:先文本预微调(兼作双向注意力的隐式热身),再纯蒸馏的多模态预微调,最后彻底换成对比目标的多模态微调——作者用消融证明蒸馏到后期会平台化(MMEB-v2 停在 52.27 附近),切换到对比学习才能涨到 55.46。第三,蒸馏信号的改造:不是传统的相关度分数蒸馏,而是直接对齐学生与教师的嵌入向量(连困难负样本一起对齐),并利用 Gemini Embedding 2 支持低维输出的特性直接截断教师嵌入,免去额外投影层。此外还简化了 PLE——去掉专用查找表、直接复用主嵌入表——既省参数又提升多模态质量,这是与 Gemma 3n/4 的关键差异。
核心方法
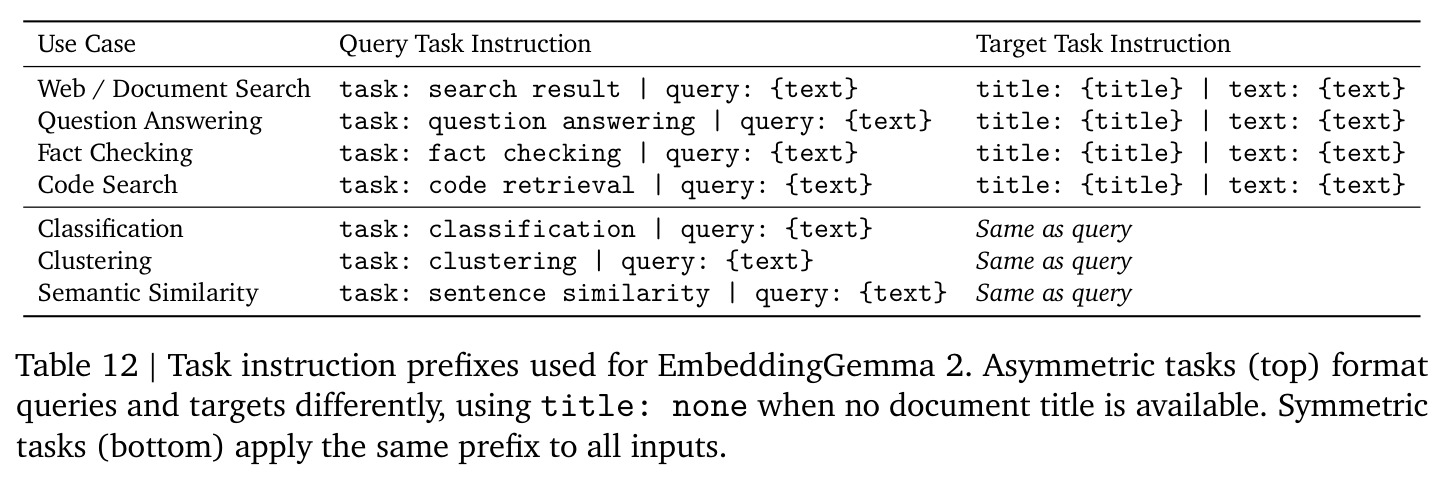
EmbeddingGemma 2 的整体思路可概括为'一个小骨干、多个可插拔编码器、三阶段课程、一次合并加量化'。骨干是 24 层、模型维度 $d_M=512$ 的双向 transformer(含嵌入器共 271M 参数):输入经 mean pooling 得到 $d_M$ 维向量,再经随机初始化的线性投影 $f$ 映射到 $d=768$ 并做 $\ell_2$ 归一化。视觉编码器是 patch size 16 的 ViT(167M),音频编码器是两层下采样卷积加 12 层 conformer(305M,USM 架构,训练中冻结),分别产出 768/1536 维 soft token,经线性投影映射到 $d_M$ 后与文本 token 交错拼成最长 8192 的序列。训练共约 2.9T token:文本预微调约 300B(几乎全用蒸馏),多模态预微调约 2T(纯蒸馏),多模态微调约 600B(对比 + spread-out 正则 + MRL)。最后将微调轨迹上早晚两个检查点做无权重平均,再经 QAT tail-patch 阶段产出 int4 检查点。
核心创新可归纳为三个反常规的设计。其一,简化逐层嵌入(PLE):Gemma 3n/4 为每层注入输入信息时维护专用 PLE 查找表,但它对非文本模态没有信号还占内存;本文改为对主嵌入表产出的 $T_{in}$ 逐层做 RMSNorm 加线性投影得 $P_l$,再用门控 $G_l = \sigma(g_l(H'_l))$ 调制后经 $u_l$ 投影加回本层输出 $H_l = H'_l + U_l$。消融显示去掉查找表既省参数又全面提升(Overall 55.46 对 55.07,Video +0.69)。其二,目标课程:预微调阶段用嵌入匹配蒸馏直接继承 Gemini Embedding 2 的语义空间,微调阶段完全抛弃蒸馏,改用对比学习叠加各向同性正则 $\mathcal{L}_S = \frac{1}{B(B-1)}\sum_{i \ne j}(q_i^\top q_j)^2 + \ldots$,让学生摆脱教师空间的次优性。其三,对比损失加入同塔负样本防止两塔聚成不相交子空间,并放弃上一代的难度加权机制——它会放大噪声正例的梯度并加剧模态间梯度失衡。
方法步骤详情
训练分六步。第一步初始化:从 Gemma 4 decoder-only 出发,把因果掩码换成双向注意力(省去显式适配),删除 PLE 查找表,尾部接 mean pooling、线性投影和 $\ell_2$ 归一化;视觉编码器取 Gemma 4 较小 ViT 且保持可训练,音频编码器与 Gemma 4 E2B/E4B 相同并冻结。第二步文本预微调:约 300B token,来自问答、句相似度、代码检索、网页搜索的查询-目标对,大 batch,几乎只用蒸馏。第三步多模态预微调:约 2T token,加入图像、音频、视频、文档的单模态/跨模态/混合模态任务,多带困难负样本,纯蒸馏,步数翻倍。第四步多模态微调:约 600B token,彻底改用对比损失(批内/困难/同塔负样本加 Plackett–Luce 列表损失),叠加 spread-out 正则与 MRL,学习率与 batch 调小,转向工具检索、视频排序、医学影像等高质量数据。第五步模型合并:轨迹末尾与较早检查点做无权重平均。第六步 QAT:增设 tail-patch 阶段,从冻结 float 检查点蒸馏并初始化 int4 检查点。
技术新颖性
与已有工作的本质区别体现在四个层面。蒸馏信号上,此前蒸馏嵌入模型只用教师给出的查询-文档相关度分数,本文直接匹配学生与教师的嵌入向量本身,并把困难负样本纳入对齐,经验证能迁移教师区分困难负例的能力;同时利用教师原生的低维输出直接截断,省去 Kim 等人方法中的投影层。架构上,从 MLLM 改造嵌入模型的路线往往继承数 B 参数,本文证明 271M 双向骨干加可拆的 167M 视觉与 305M 音频编码器即可达到与数倍大模型相当的质量,并支持按模态选择性加载与 191MB 级端侧内存。训练上,'先蒸馏后对比'的目标课程有明确消融支撑:继续蒸馏只到 52.27/52.28 就平台化,切到对比微调后涨至 55.46;模型合并也不跑多个微调任务,而是在单条轨迹上取早晚两个检查点平均,资源效率更高。表征工程上,简化 PLE 与 MRL 结合使一个检查点同时服务 768 到 128 维四档精度,128 维截断在多数基准上仍优于其他 sub-1B 模型的全维度结果。这些选择共同把统一多模态嵌入从大模型专属能力下放到端侧可负担的规模。
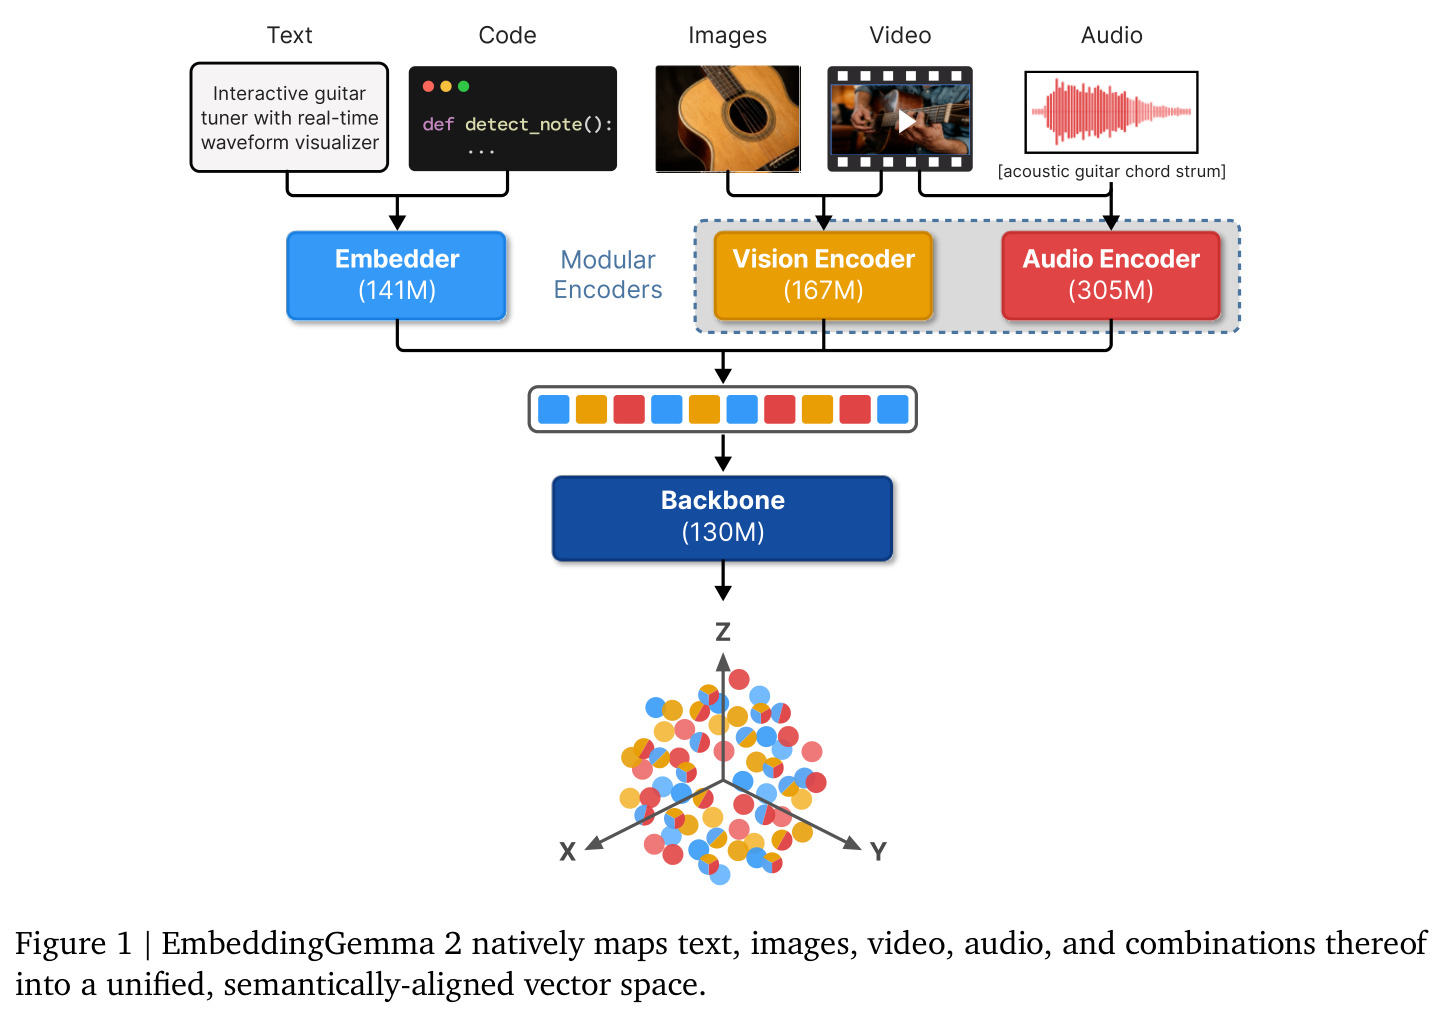
实验结果
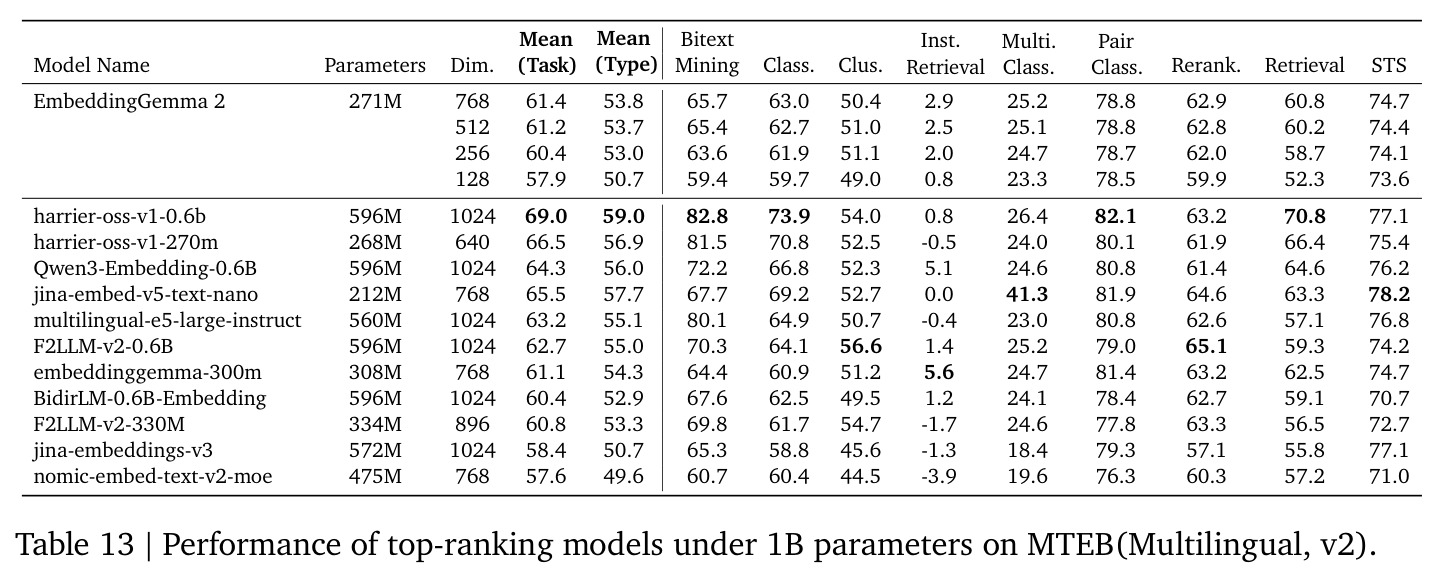
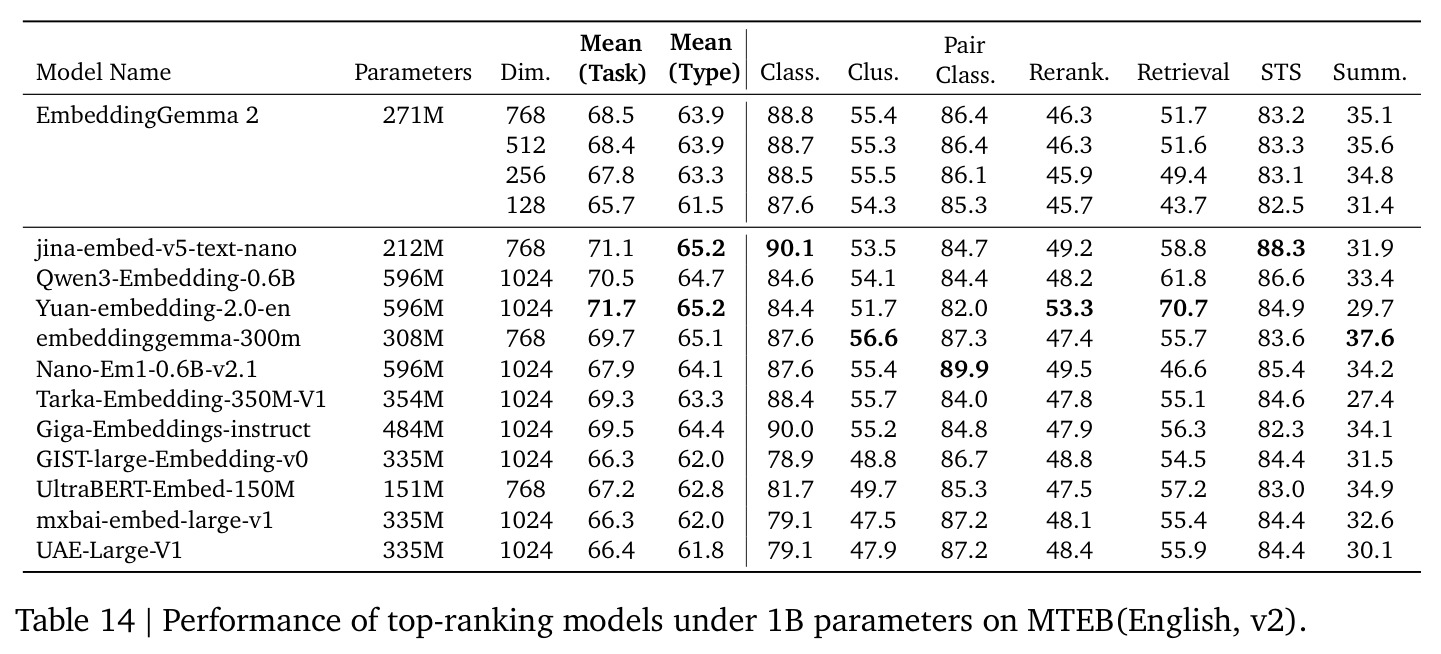
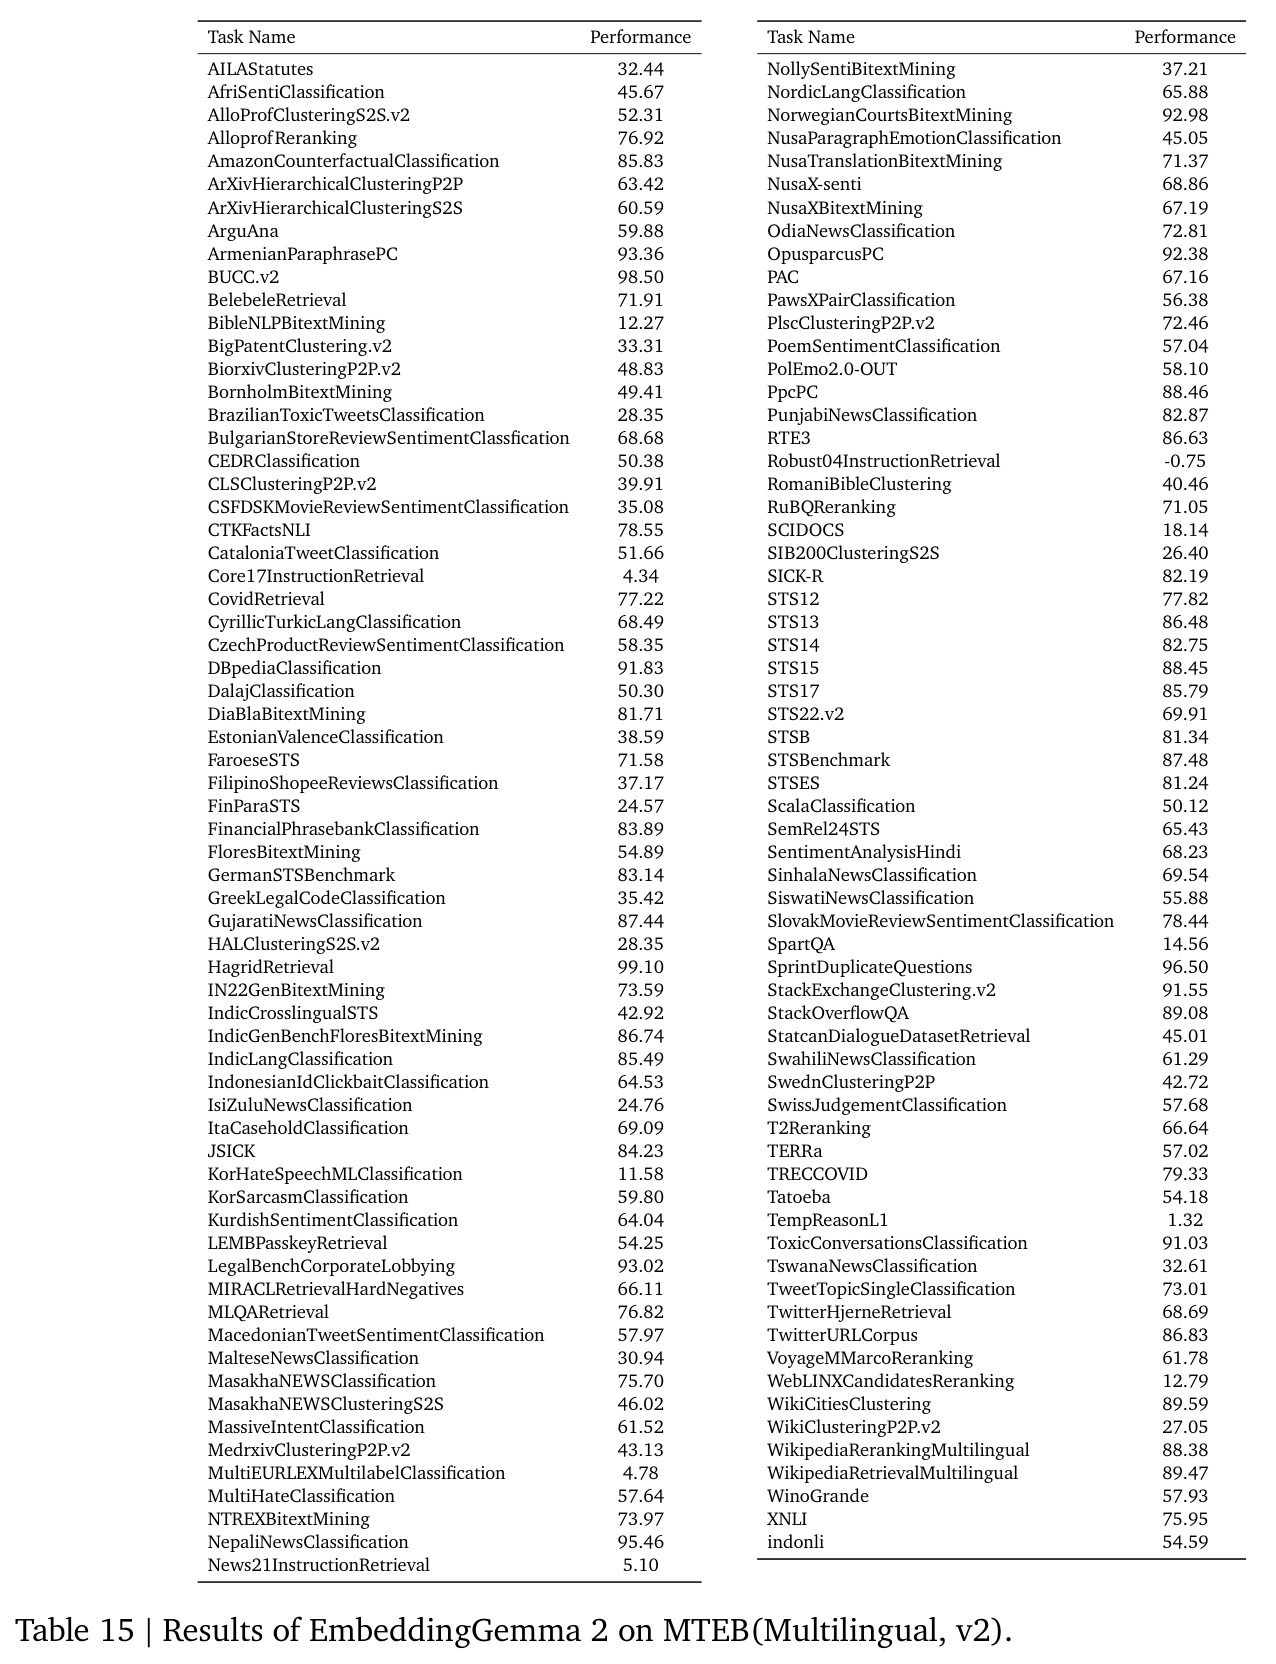
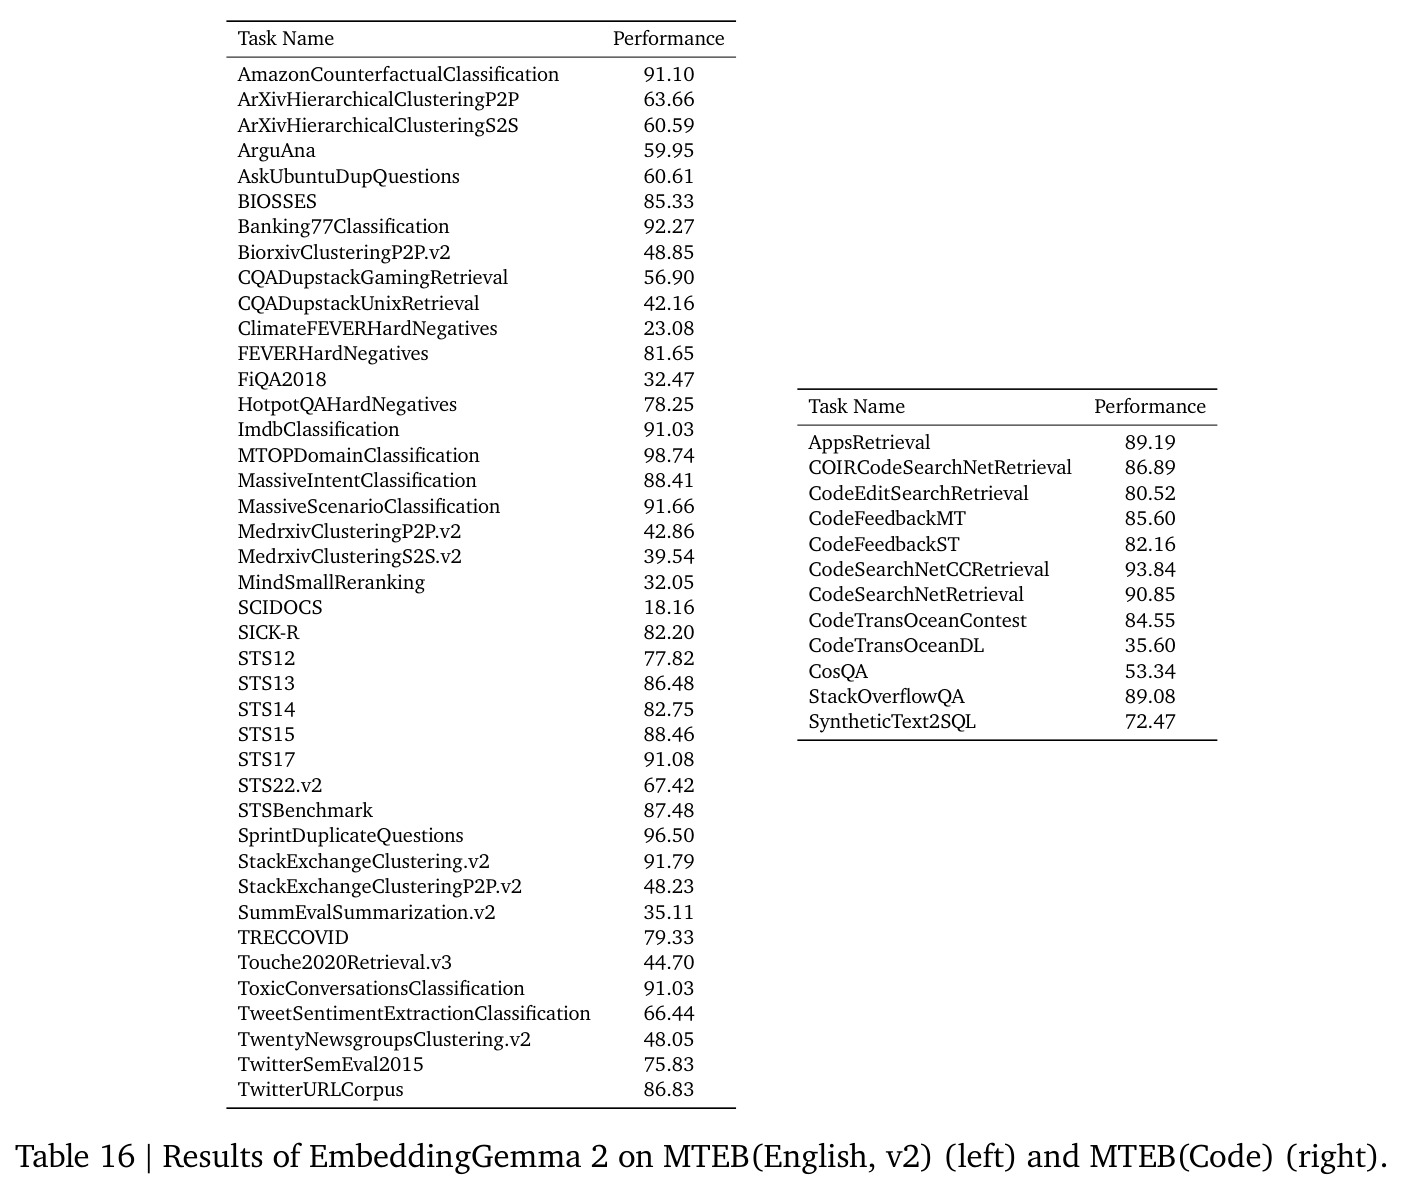
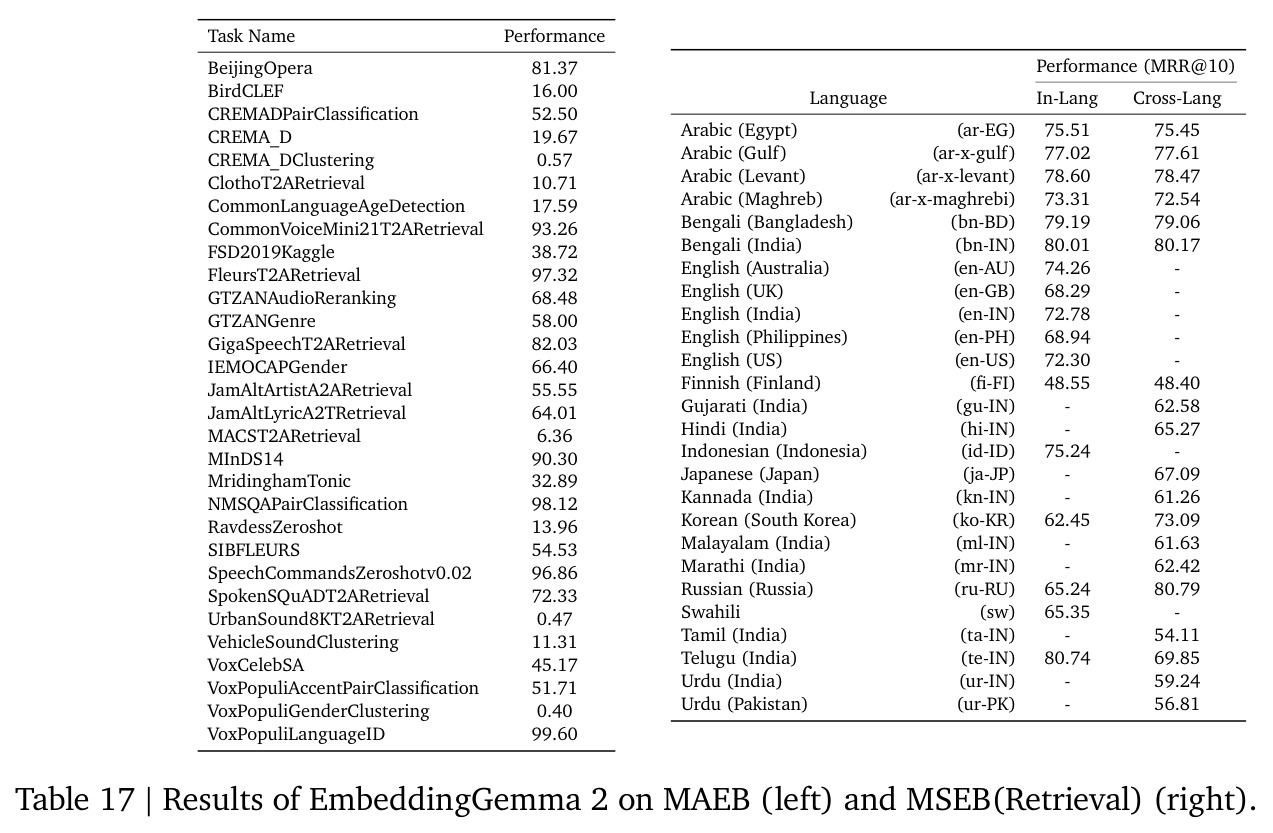
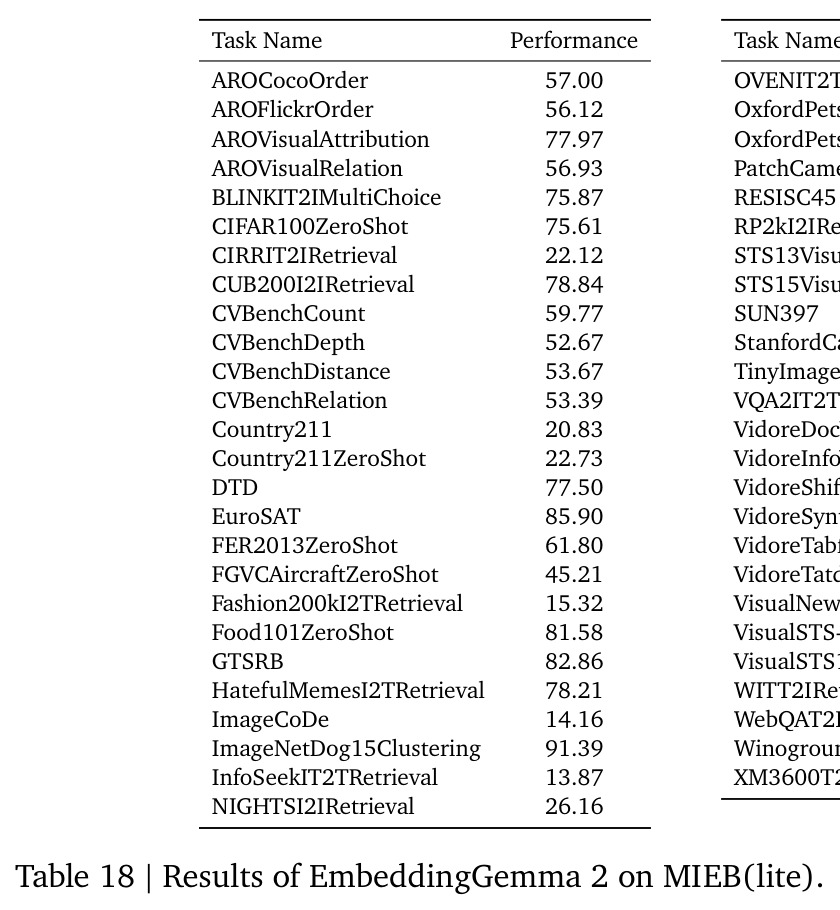
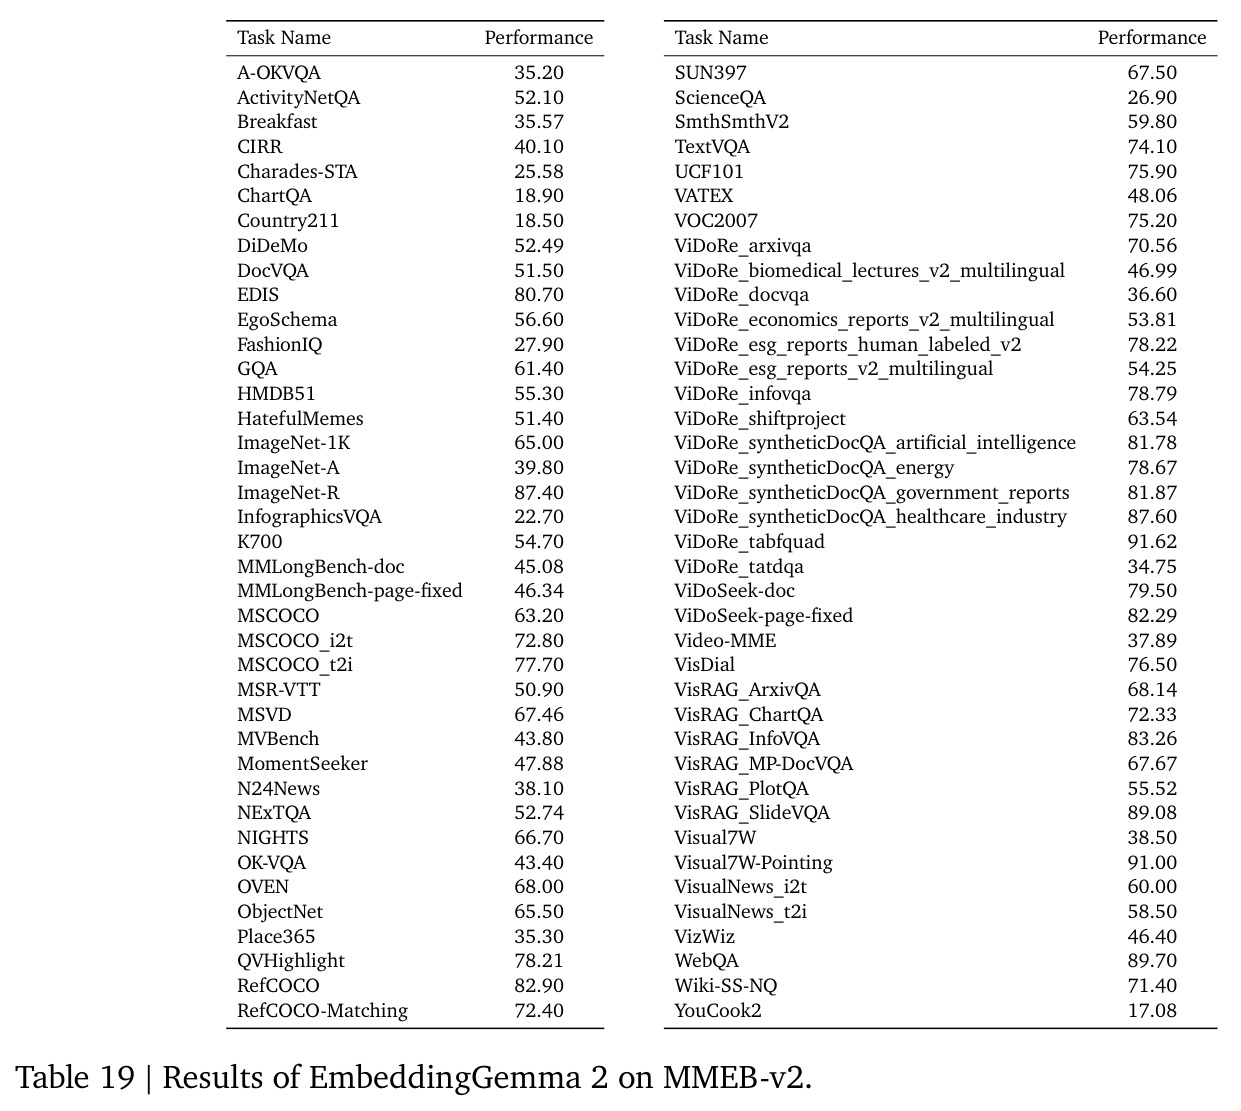
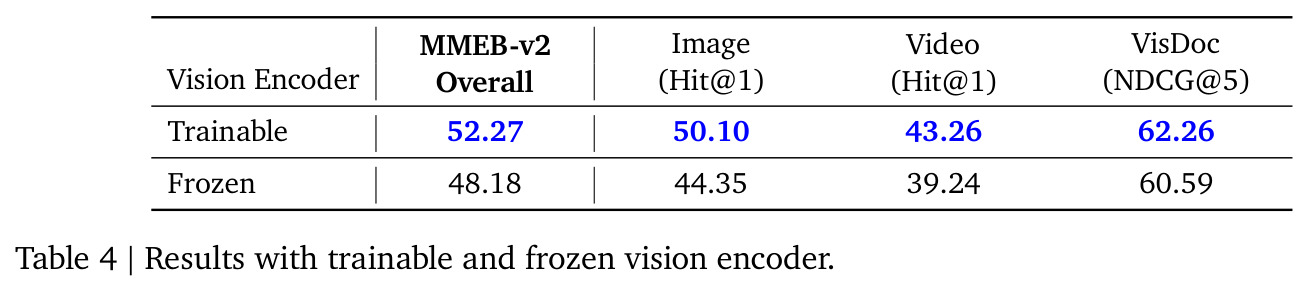
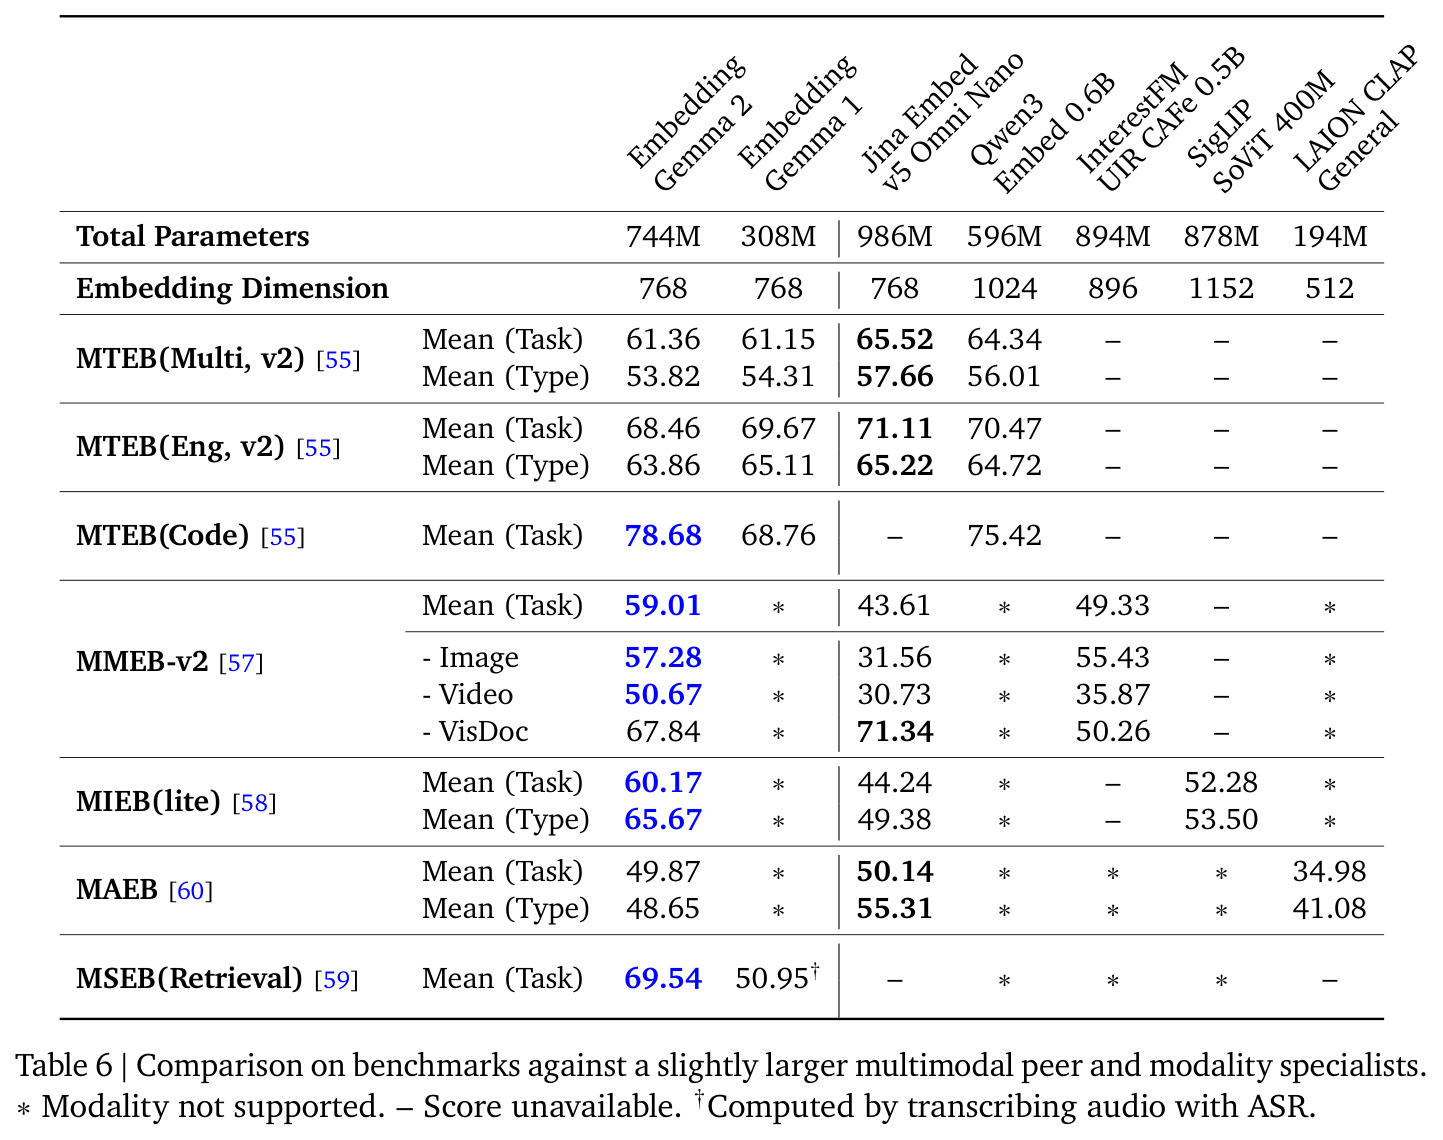
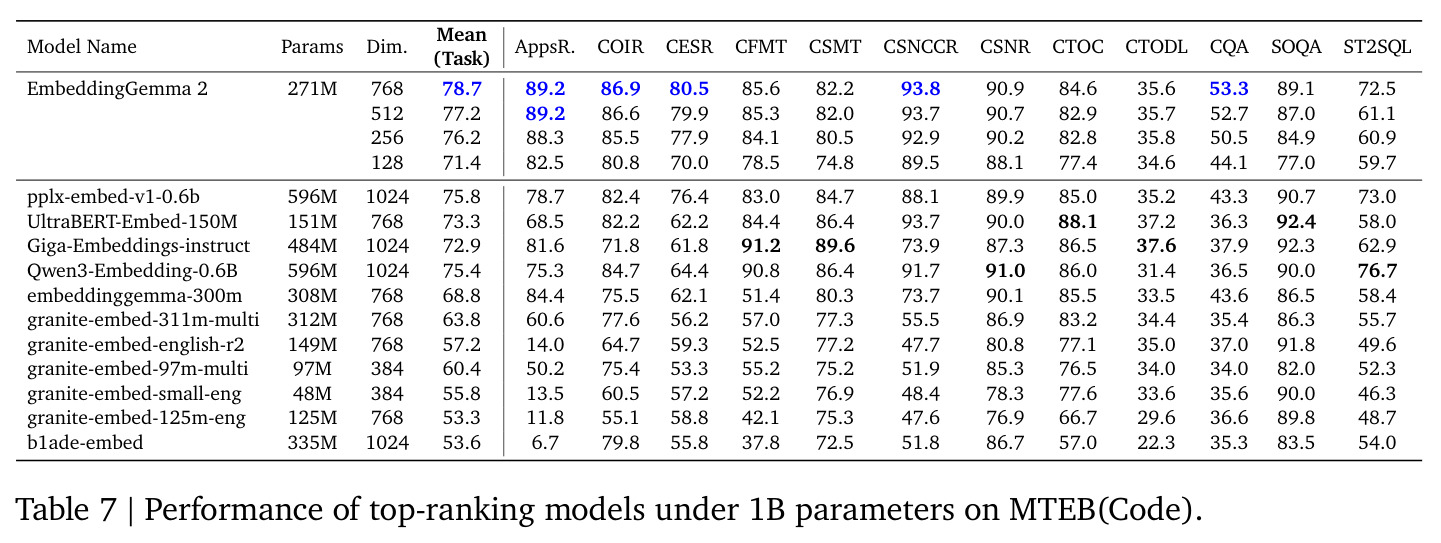
论文在七套基准上确立新 Pareto 前沿。文本:MTEB(多语言 v2) 61.36 略超 EG1 的 61.15;MTEB(英语 v2) 68.46 小幅回退(EG1 69.67);MTEB(Code) 78.68 远超 EG1 的 68.76,为 sub-4B 榜首。多模态:MMEB-v2 Overall 59.01(439M),远超 986M 的 jina(43.61),Image/Video/VisDoc 为 57.28/50.67/67.84;MIEB(lite) 60.17/65.67,较 sub-1B 次优领先 +7.9/+12.2,128 维仍胜其他 sub-1B 全维度。音频:MAEB 49.87 距 jina(50.14)仅 0.2 分,A2A 检索 53.6 与音频分类 52.9 为 sub-1B 最优;MSEB 原生音频 69.54 远超 EG1 用 ASR 的 50.95,比 ASR 路线高近 12 分。消融:可训练视觉编码器比冻结高 4.09 分;预算 280→560 使 VisDoc 涨至 67.62 但视频降至 46.52;Q4_C 量化几乎无损。
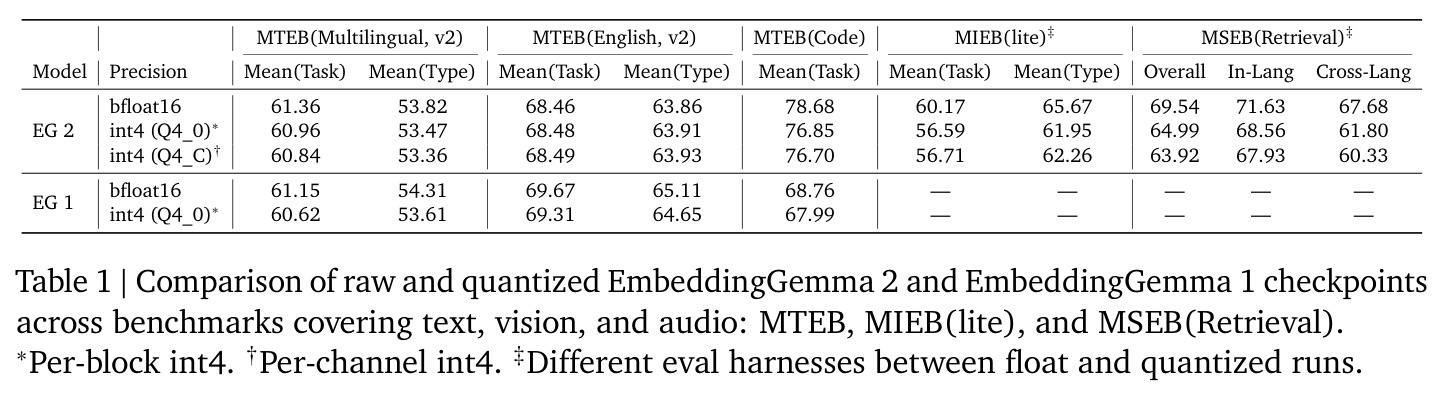
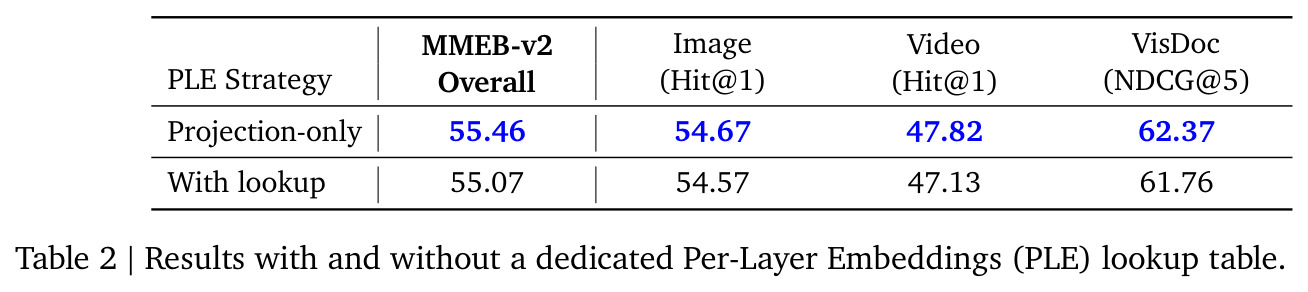
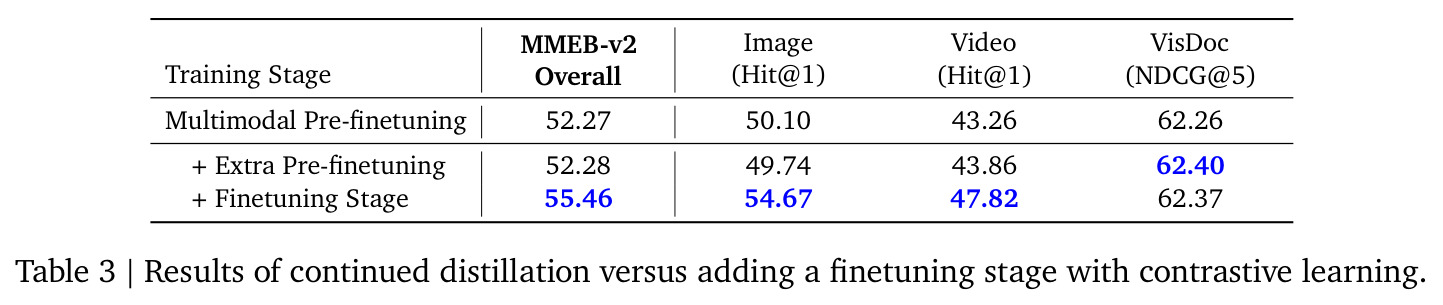
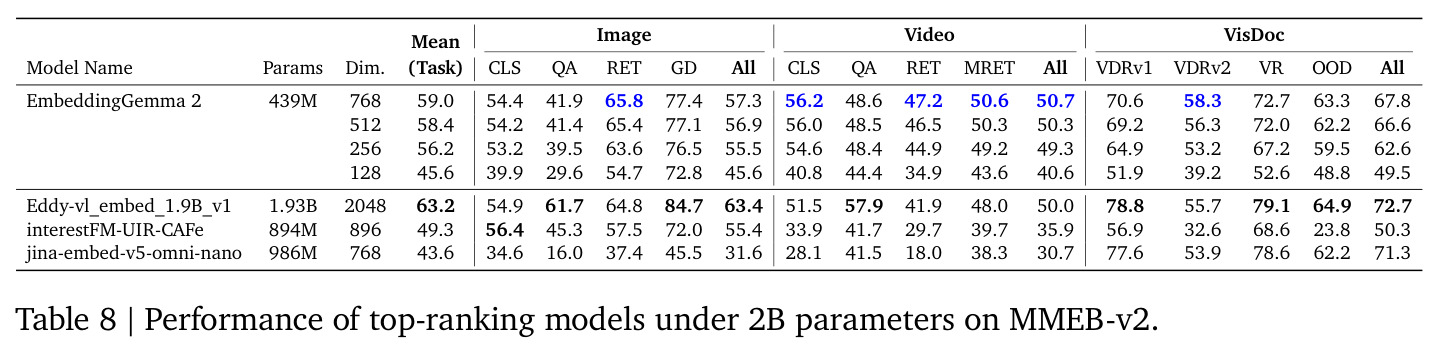
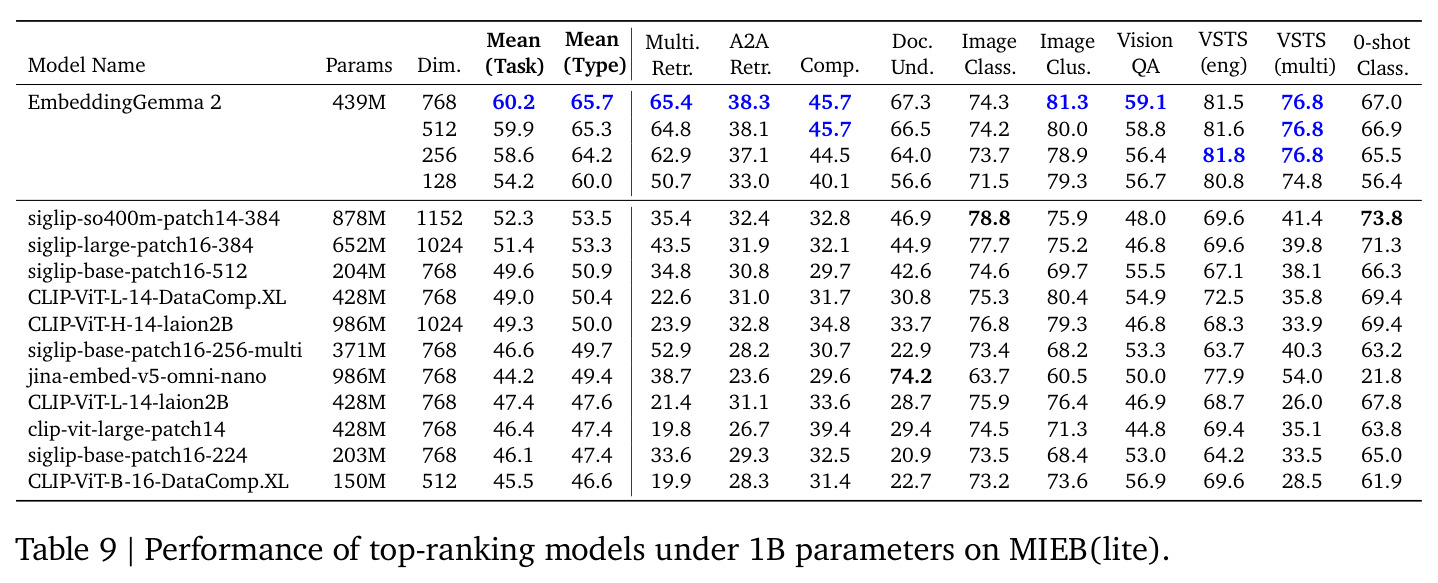
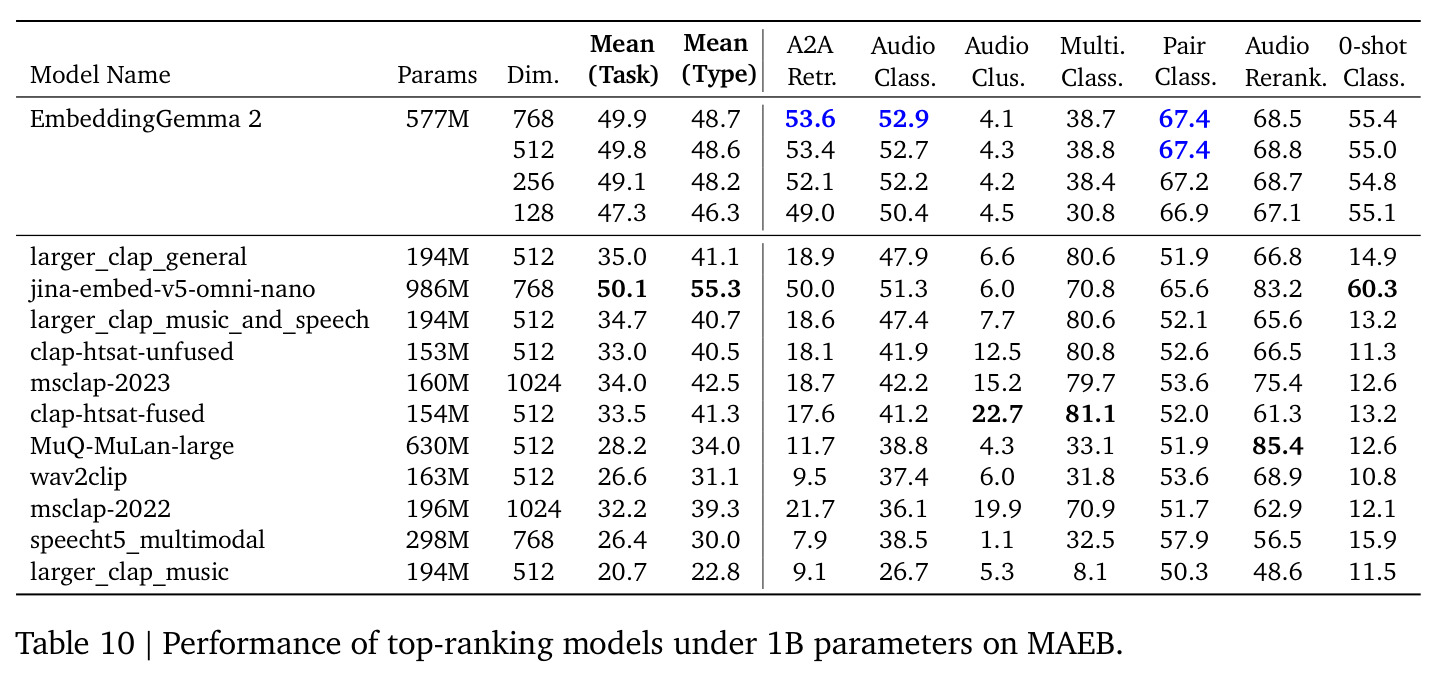
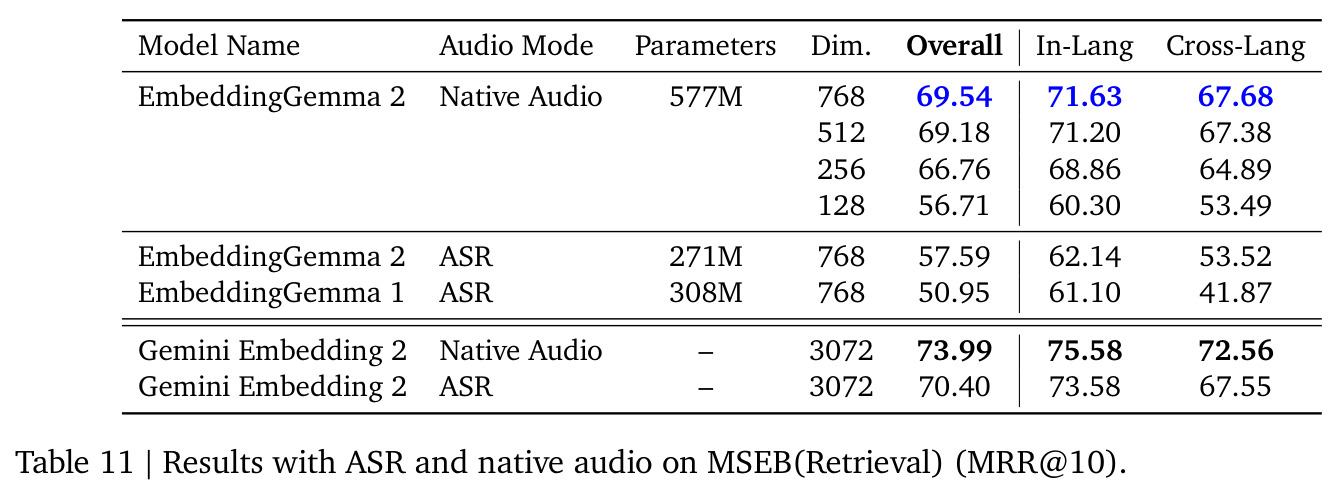
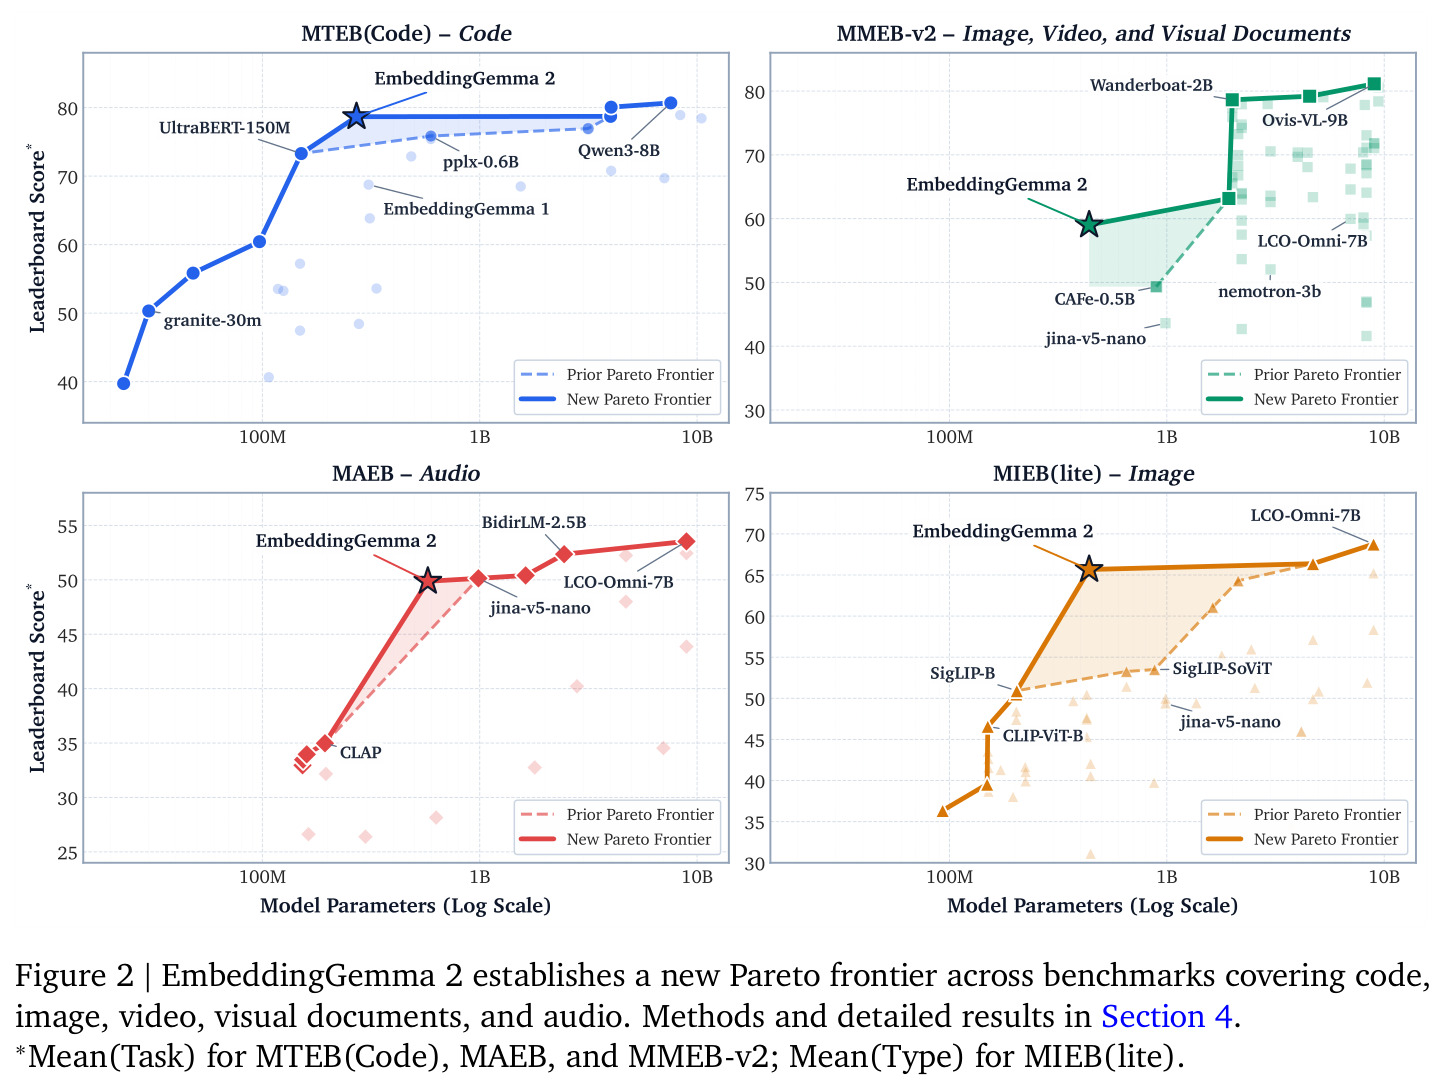
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MTEB(多语言 v2) 文本嵌入 | Mean(Task) | 61.36 | EmbeddingGemma 1: 61.15 | +0.21(文本参数更少且需兼容多模态) |
| MTEB(英语 v2) 文本嵌入 | Mean(Task) | 68.46 | EmbeddingGemma 1: 69.67 | -1.21(小幅回退) |
| MTEB(Code) 代码检索 | Mean(Task) | 78.68 (271M) | Qwen3-Embedding-0.6B: 75.4;EmbeddingGemma 1: 68.76 | +9.92 vs EG1,sub-4B 榜首 |
| MMEB-v2 多模态嵌入(图像/视频/视觉文档) | Overall (Hit@1/NDCG@5) | 59.01 (439M) | jina-embed-v5-omni-nano (986M): 43.61;interestFM-UIR-CAFe (894M): 49.33 | +15.40 vs jina,参数少约 55% |
| MIEB(lite) 图像嵌入 | Mean(Task) / Mean(Type) | 60.17 / 65.67 | sub-1B 次优: 52.28 / 53.50 | +7.9 / +12.2 |
| MAEB 音频嵌入 | Mean(Task) | 49.87 (577M) | jina-embed-v5-omni-nano (986M): 50.14;CLAP 类专家约 33-35 | 距最佳 sub-1B 仅 -0.27,远超 CLAP 专家 |
| MSEB(Retrieval) 多语言语音检索 | MRR@10 | 69.54(原生音频, 577M) | EmbeddingGemma 1 + ASR: 50.95;EmbeddingGemma 2 + ASR: 57.59 | +18.59 vs EG1;原生音频比 ASR +11.95 |
| PLE 消融(去查找表) | MMEB-v2 Overall | 55.46 | 带专用 PLE 查找表: 55.07 | +0.39 且省参数 |
| 视觉编码器可训练性消融 | MMEB-v2 Overall | 52.27(可训练) | 冻结视觉编码器: 48.18 | +4.09 |
| int4 量化检查点(Q4_C) | MTEB(英语 v2) Mean(Task) | 68.49 | bfloat16 原始检查点: 68.46 | 几乎无损,全模态端侧内存 567MB |
局限与改进
作者承认且数据可见的局限:英语文本回退(68.46 对 EG1 的 69.67,多语言 Mean(Type) 53.82 也低于 EG1 的 54.31),说明共享空间与更小文本骨干有代价;音频编码器全程冻结,作者自己推测继续训练很可能还有收益;视频在推理预算 560 时反而退化(48.51→46.52),时间覆盖受每视频 32 帧限制,长视频理解有缺口;零样本副语言任务挣扎,如 VoxPopuliGenderClustering 仅 0.40(线性探针 IEMOCAPGender 达 66.40),表示以语义为主导;对 CLAP 专家在 ClothoT2ARetrieval 等任务仍有差距;MAEB Audio Clustering 仅 4.1。我的观察:评测排除了在超 25% 评测数据上训练的模型,但教师 Gemini Embedding 2 可能间接带入的污染无法排除;部分量化与 float 评测用了不同 eval harness(表 1 脚注),可比性略有折扣;基准以检索/分类为主,真实混合模态应用的多样性仍待检验。
独立分析的弱点
独立分析几个弱点。第一,音频编码器冻结虽省算力,但视觉侧消融(可训练 52.27 对冻结 48.18)强烈暗示音频存在对称的未兑现收益,MAEB 落后 jina 0.27 分可能正源于此;改进方向是解冻音频编码器联合训练,代价是更大规模的音频-文本配对数据。第二,视频表示依赖'抽帧当图像加可选音轨交错',32 帧上限对长视频时间覆盖不足,且 560 token 下视频反降,说明 mean pooling 对长序列稀释敏感;改进方向是时间感知池化或内容感知帧选择。第三,副语言维度(说话人属性、韵律)零样本几乎失效,语义主导性是把双刃剑;可加入受控副语言任务或专用任务前缀。第四,MAEB Audio Clustering 仅 4.1,与 CLAP 专家差距明显,通用模型的模态内深度仍有空白。第五,低维截断损失不均匀:128 维在 VisDoc 与视频上退化陡峭,低维部署需按任务谨慎选档。
未来方向
作者明确提出的方向包括:扩展上下文长度(如借助 content-aware 方法)以直接索引全长媒体、支持长时程任务与新型 agent 记忆系统;探索 encoder-free 架构,同时提升质量并进一步压缩内存与延迟;引入端到端 RAG 训练范式,让嵌入模型为下游检索直接优化;随着交错式全模态搜索普及,建设覆盖新用例的评测框架。作者还指出该模型可作通用多模态编码器向下游辐射:改造或零样本充当通用决策模型、模型路由器、奖励模型、重排序器、语音转文本模型、late interaction 检索器等。基于本文成果可自然延伸的研究有:解冻音频编码器验证对称收益;把 tail-patch QAT 思路推广到 int2/int8 混合精度搜索;在单轨迹检查点合并基础上引入任务向量加权的多目标合并;将简化 PLE 回移植到 Gemma 4 生成模型检验其普适性;以及针对图文音交错的混合模态构建专门的检索与问答基准。
复现评估
模型本身开源(ai.google.dev/gemma/docs/embeddinggemma),提供 bfloat16 与 int4(Q4_0/Q4_C)多档检查点,支持 768/512/256/128 维截断与按模态选择性加载,复现推理成本很低:Pixel 11 Pro 上纯文本 191MB、图文 447MB、全模态 567MB 峰值内存,消费级 GPU 即可跑完整评测。但训练复现基本不可行:论文未开源训练数据混合、任务配比与完整超参数(只给了各阶段 token 量 300B/2T/600B 与约 2.9T 总量),教师模型 Gemini Embedding 2 是闭源 API,从头复现需要 Google 级算力。消融实验均基于中间配方,论文明确说明这些数字不代表最终模型,逐条复现同样需要完整预微调管线。评测侧部分基线分数取自公开榜单而非作者复跑,且 float 与量化运行使用了不同 eval harness,严格对齐需自行重跑。总体而言:作为使用者极易上手,下载即用、按需量化截断;作为研究者可复现关键消融的结论趋势;端到端复现训练则属于工业级工程,难度很高。
论文图表