Ovis-Embedding:迈向通用全模态嵌入前沿的原生统一嵌入模型家族 Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
以Qwen-Omni为原生骨干、经四阶段训练的全模态嵌入家族,登顶MMEB-v3等五大基准
前置知识
稠密嵌入与双塔检索
将任意输入编码为固定维向量,用余弦相似度衡量语义相关性。查询与候选由同一编码器独立编码,候选可离线建索引、在线只算内积,因此能支撑海量候选的低延迟检索。分类、问答等任务也被统一改写为"在候选集中检索正确项",与生成式模型形成鲜明对比。
本文的模型接口、训练目标与全部评测协议都建立在双塔余弦检索之上,不懂这一范式就无法理解为何去掉语言模型头、取末层隐状态就能做嵌入。
InfoNCE 与批内负样本
对比学习的标准损失:拉近查询与正样本、推远负样本,温度 $\tau$ 控制分布尖锐程度。批内其他实例的正/负候选会被汇聚成共享候选集 $C$(规模 $N(1+K)$),让每个查询免费获得大量负样本,是大规模嵌入训练的核心技巧。
论文 Stage-1/2 的损失、同源采样、focal 加权和蒸馏分布全部直接改造 InfoNCE,所有公式推导都以此为起点。
LoRA 低秩适配
冻结预训练权重,只训练注入的低秩增量矩阵,大幅减少可训练参数与显存。本文给出一个有趣发现:骨干刚被改造成嵌入模型时,新表征尚处混沌无约束状态,全参数更新会让梯度剧烈扰动、破坏预训练语义;低秩约束限制更新幅度,相当于稳定先验,保护基座知识直到嵌入空间自组织成形。
"LoRA 保护早期嵌入"是 Stage-1 采用低秩预训练的核心依据,也是本文区别于常见"直接全参微调"流程的关键经验结论。
KL 散度与知识蒸馏
KL 散度 $\mathrm{KL}(t\|q)=\sum_c t(c)\log\frac{t(c)}{q(c)}$ 衡量两个分布的差异。嵌入蒸馏中,教师对候选集输出完整相似度分布 $t_i(c)$,学生用 $q_i(c)$ 拟合。前向 KL 要求学生覆盖教师的全部概率质量,能保留正负样本间的相对排序结构,比 one-hot 标签的监督信号丰富得多。
Embedding Distillation 是本文两大核心损失之一,"为何选前向而非反向 KL"的论证直接决定蒸馏效果的理解。
Matryoshka 表示与 PCA 旋转
MRL 让嵌入向量的前缀(前 128/256/512 维)可独立用于检索,实现一个模型多种维度。PCA 通过二阶矩特征分解 $\Sigma=V\Lambda V^\top$ 得到正交旋转,使截断前 $d$ 维恰为最优低秩近似;正交性保证 $V^\top v$ 是等距变换,完全不改变全维向量的内积几何。
Stage-4 弹性嵌入 = 混合模态 PCA 基 + 零初始化残差适配器,不掌握这套数学就无法理解推理期压缩为何几乎无损。
MMEB 系列基准
MMEB 是多模态嵌入标准评测,含分类/问答/检索/视觉定位四类任务;v2 扩展到图像+视频+视觉文档共 78 个数据集,v3 进一步纳入音频与 agent(工具/GUI/记忆)场景达 190 个任务;MAEB、MVEB、RTEB 分别专注音频(30 任务)、视频(23 任务)与真实文本检索领域。
论文所有 SOTA 声明都基于这五个基准,理解各基准的任务构成与官方聚合指标,才能正确解读实验表格中的数字。
研究动机
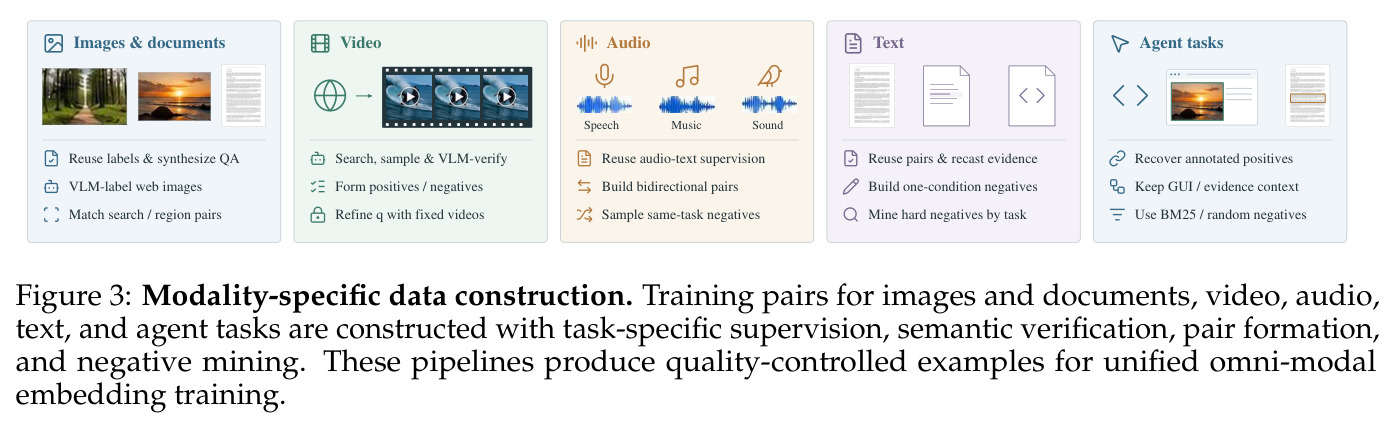
现代信息库日益混合文本、图像、视频、音频、视觉文档与界面状态,检索不再能归结为少数预定义模态对。论文给出典型场景:维护 agent 听到机器异常声音,需要用"音频片段+文字描述"组成的查询,在同一索引中直接检索相关的视频教程、PDF 手册图纸或历史服务工单——这就是 any-to-any 检索。它要求各模态表示不仅维度一致,还必须构成校准一致的语义空间:相关性分数跨模态可比,同时保留模态内细粒度区分。现有方案对此并不完整:视觉-语言专家模型(如 Qwen3-VL-Embedding、GME)完全不支持音频;而已有全模态系统(LCO-Embedding、e5-omni、Conan-embedding-v3、jina-embeddings-v5 等)通常是在预训练文本-视觉嵌入器上后挂音频分支,或把单独训练的音频编码器对齐到已固化的嵌入空间——声学输入被塞进一个没有它参与学习的几何结构中,跨模态细粒度对齐先天受限,实践中往往牺牲某一模态(通常是视觉)的性能。此外,训练侧混批采样会让批内负样本跨模态/跨任务,诱导模型走"模态不同即负样本"的捷径;部署侧把 MRL 塞进多目标训练又会损伤全维嵌入质量。
本文的目标是本文的目标是构建一个通用全模态嵌入家族:单个模型在共享表征空间中同时支持文本、图像、视频、音频及其交错组合的 any-to-any 检索,且在每个模态对上都不输给专门的模态专家模型。具体分解为四点:(1) 用原生多模态理解模型(而非文本模型外挂模态塔)作为嵌入骨干,不引入任何模态专属投影头;(2) 构建覆盖文本、图像、视频、音频、交错多模态与 agent 数据的大规模高质量语料(约 5000 万 query-target 对),并提升数据效率;(3) 设计嵌入专属的训练与推理优化——focal 损失聚焦难例、基于相似度的 Embedding Distillation 从互补专家迁移细粒度相似度结构、低秩特征分解支持 128~2048 的弹性嵌入维度;(4) 在 MMEB-v3、MMEB-v2、MVEB、MAEB、RTEB 五大基准全面达到 SOTA,并开源模型权重、训练与数据构建配方、推理代码和统一评测工具。
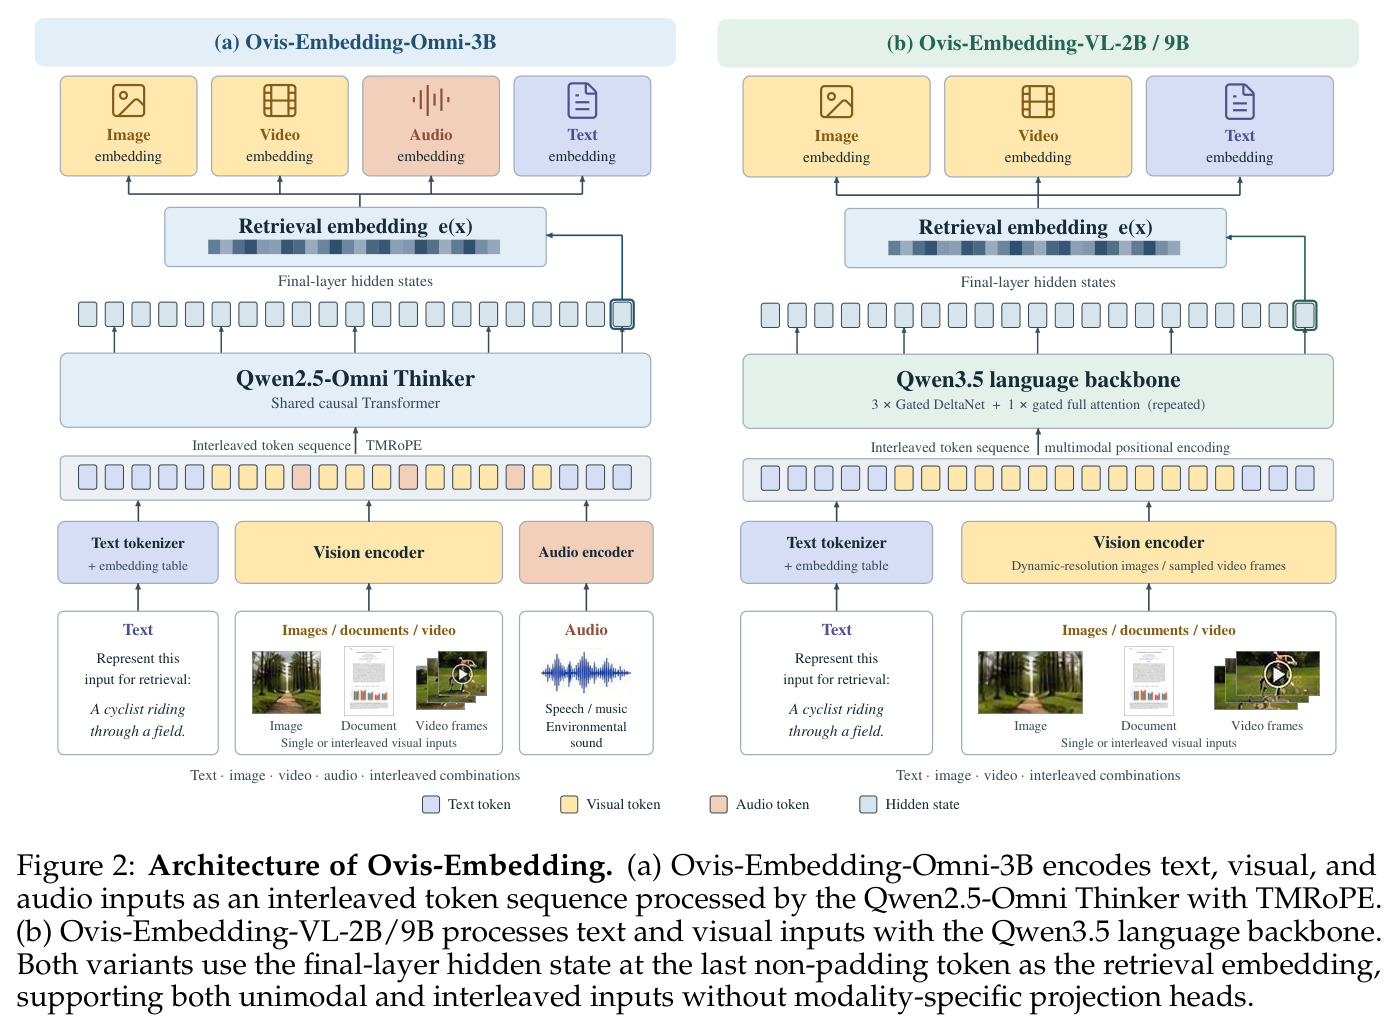
与已有工作不同的是,本文的独特切入点是"原生 omni-modal 初始化":不从文本嵌入模型出发外挂模态塔,而是直接把预训练的 Qwen2.5-Omni 理解模型改造成嵌入模型——移除语音生成的 Talker 通路,保留文本分词器、视觉编码器、音频编码器和共享的 Thinker Transformer,用最后一个非 padding token 的末层隐状态作为嵌入,不加任何投影头。由于骨干预训练时文本、图像、视频、音频本就通过共享 Transformer 与 TMRoPE 时序对齐位置编码融合,any-to-any 检索成为该架构的自然特例而非后期拼接。方法论上,论文把重心从"架构创新"转向"数据与训练动力学":同源采样消除批内负样本的模态捷径、LoRA 保护早期嵌入、按学生置信度退火的蒸馏权重、推理期混合模态 PCA 加残差适配器把多维度适配与编码器训练解耦。这套"数据-优化-部署"协同配方,以及"文本/图像/视频/音频/agent 全部喂进同一个嵌入模型"的数据哲学,是它与以往工作的本质差异。
核心方法
直觉上,检索嵌入需要的不是生成能力,而是一个所有模态已天然对齐、可用余弦相似度统一打分的语义空间;与其在文本模型上后接模态塔,不如让一个"天生看过所有模态"的骨干直接学检索。技术路线上,Ovis-Embedding 从 Qwen2.5-Omni-3B(Omni 版,原生含音频通路与 TMRoPE)和 Qwen3.5-2B/9B(VL 版,混合 Gated DeltaNet 线性注意力 + 全注意力的骨干,2B 为 24 层/2048 隐维,9B 为 32 层/4096 隐维)初始化,移除语言建模头,取末层最后非 padding token 的隐状态 $e(x)=h^{(L)}_{\ell(x)}\in\mathbb{R}^d$ 作嵌入(Omni-3B 与 VL-2B 输出 2048 维、VL-9B 输出 4096 维),输入用骨干原生 processor 与 chat 模板加任务指令格式化。训练分四阶段:Stage-1 在约 5000 万对全模态语料上做 LoRA 低秩对比预训练,批内混合所有模态与任务、跨数据并行 rank 汇聚候选,损失为 focal 加权 InfoNCE 与教师分布前向 KL 蒸馏的组合;Stage-2 解冻全参数,在更小更精的语料上用同源采样(每个微批全部来自同一数据集并哈希去重候选集)微调;Stage-3 退火嵌入蒸馏,保留教师做对的样本、上采样学生失败的样本,KL 权重随学生置信度自适应衰减;Stage-4 冻结编码器,外挂混合模态 PCA 旋转与零初始化残差线性适配器,从同一编码器产出 128/256/512/1024/2048 弹性维度。全程无模态专属组件,推理接口统一。
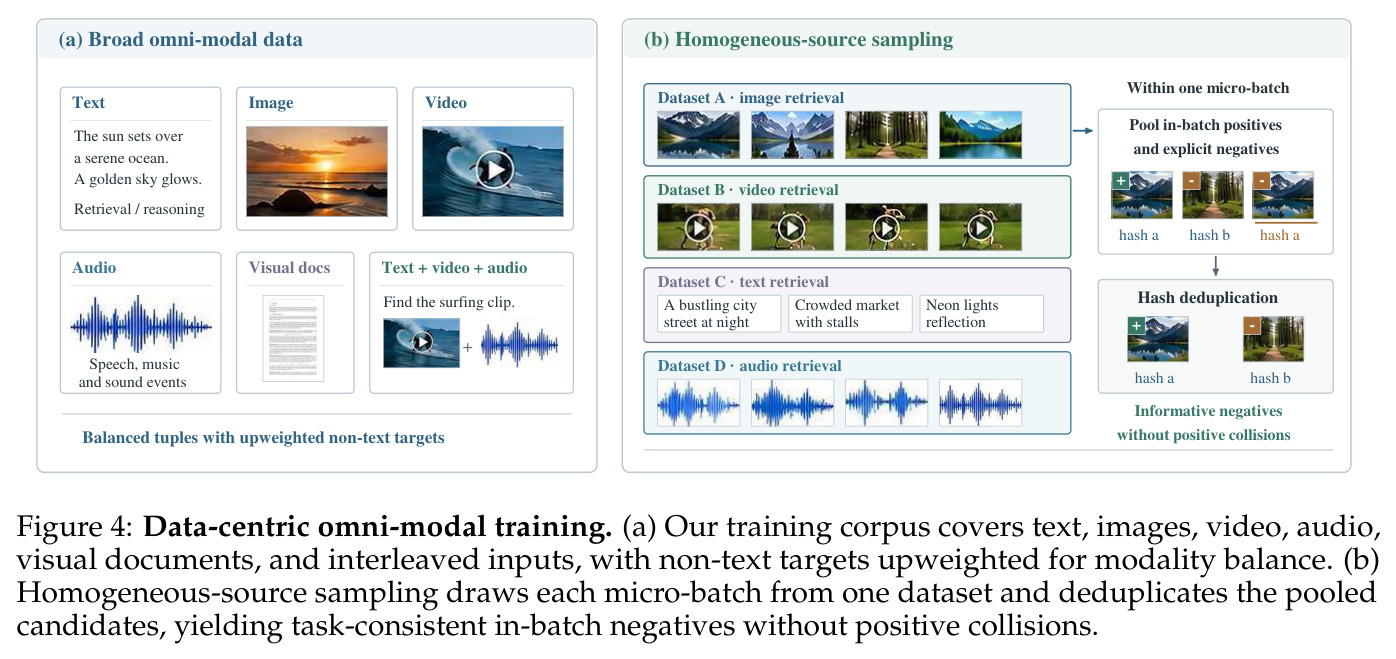
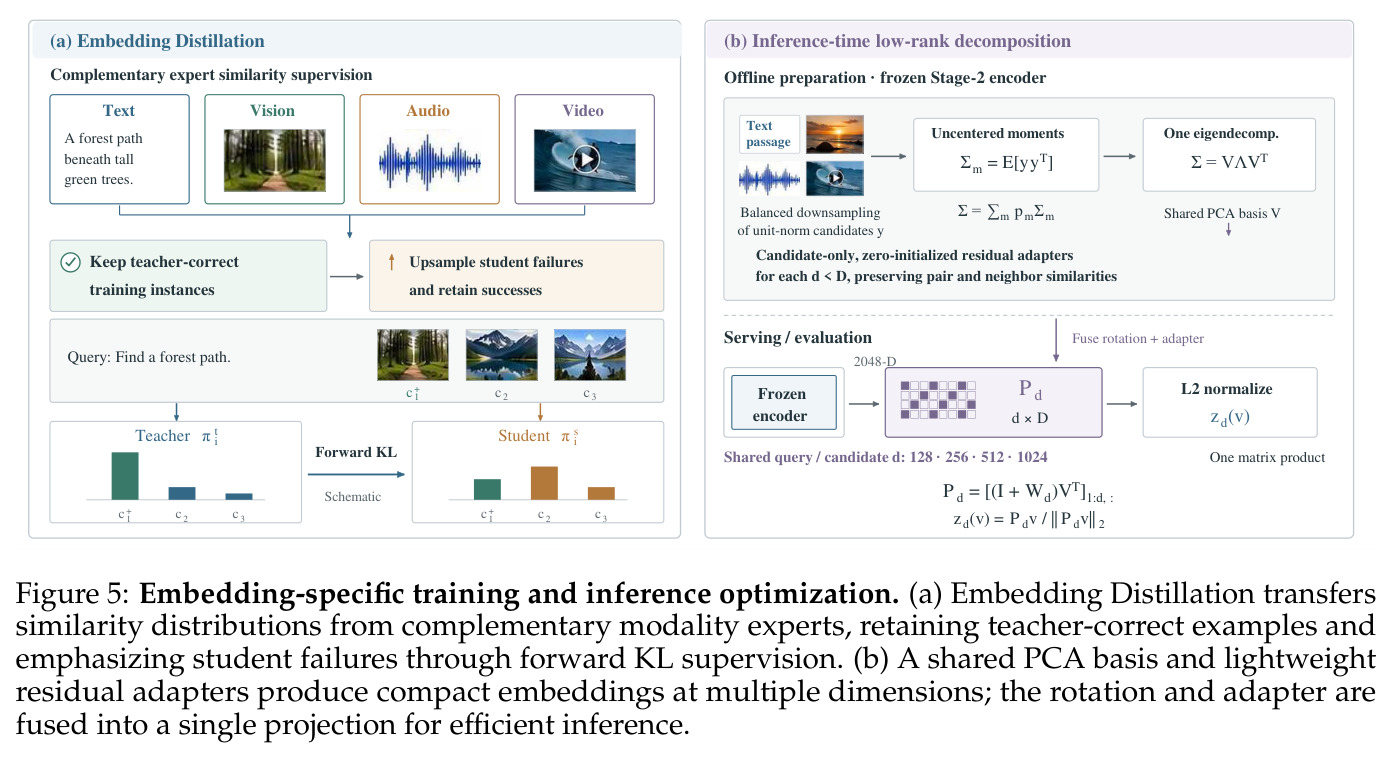
核心创新有三层。其一是原生 omni-modal 初始化:不同于给 text-vision 嵌入器加音频分支或对齐独立音频模型,直接复用 Qwen-Omni 中本就经共享 Transformer 与 TMRoPE 对齐的四模态前端,使 any-to-any 检索在同一空间自然成立,且改造零新增参数。其二是同源采样:微批内所有实例 $s_i=d$ 强制来自同一数据集,汇聚出的批内负样本任务一致、信息量大,迫使模型做细粒度语义区分而非利用模态、句长、语言风格等表面捷径;配合按哈希去重候选集,杜绝"批内负样本恰好等于正样本"的假阴性。其三是嵌入专属优化:focal 系数 $a_i=\mathrm{sg}[(1-\pi_i)^{\gamma_i}]$($\pi_i$ 为当前正样本概率)把优化预算从已分开的查询重新分配给难例,且经单位均值归一化后只重分配、不放大总损失;蒸馏用教师完整相似度分布(前向 KL)替代 one-hot 监督,权重 $\lambda_i=\lambda_{\min}+(\lambda_{\max}-\lambda_{\min})\,\mathrm{sg}[(1-\pi_i)^\gamma]$ 随学生掌握程度退火——学生已强的域少蒸馏、弱的域多蒸馏。推理端用混合二阶矩 $\Sigma=\sum_m p_m\Sigma_m$ 的单次特征分解作正交旋转,叠加零初始化残差适配器,把弹性维度与编码器训练彻底解耦。
方法步骤详情
完整流程如下。Stage-1(低秩预训练):输入约 50M 个 $(x_i, y_i^+, \{y_{i,k}^-\}_{k=1}^K)$ 元组,微批大小 $N$,所有模态/任务混合,候选跨数据并行 rank 汇聚成共享候选集 $C$(大小 $N(1+K)$);按 $\mathrm{sim}(x,y)=\frac{e(x)^\top e(y)}{\|e(x)\|_2\|e(y)\|_2}$ 计算相似度,正样本概率 $\pi_i$ 经温度 $\tau$ 的 softmax 得到;最终损失 $L_{\text{stage-1}}=\lambda_{\text{focal}}L_{\text{focal}}+\lambda_{\text{dist}}L_{\text{dist}}$(实验中两权重恒相等),教师候选级对数概率离线预计算随样本存储,训练时不跑教师;仅更新 LoRA 参数。Stage-2(全参同源微调):解冻全部参数,改用 InfoNCE 但采样约束为微批内 $s_i=d$ 同源,候选集 $\mathcal{C}(B^d)$ 哈希去重后共享;同源性只在微批内强制,一个优化步仍可平均多个数据集的梯度,减少更新振荡、缓解灾难性遗忘,同时规则微批占比大增带来 MS-SWIFT 框架下的显著加速。Stage-3(退火嵌入蒸馏):先用教师跑 Stage-2 同款语料并仅保留教师做对的实例,再用学生评估这些实例、按成败划分并上采样失败项构成 ED 训练集;损失 $L_{ED}=\frac{1}{N}\sum_i \ell_i+\frac{1}{N}\sum_i \lambda_i \ell^{KD}_i$,选前向 KL 因反向 KL 的 mode-seeking 特性与 InfoNCE 已有的正样本集中效应重复;批大小固定故 KL 权重按 $N$ 平均,教师总影响力随学生 mastered 程度自然下降。Stage-4(弹性嵌入推理):冻结编码器,对每模态候选池均衡降采样估计无中心二阶矩 $\Sigma_m=E[yy^\top]$,按权重 $p$ 混合成 $\Sigma$(消融显示均匀权重即稳健默认)后一次特征分解 $\Sigma=V\Lambda V^\top$;在旋转空间为每个 $d<D$ 训练零初始化残差 $f_d(\tilde v)=\tilde v+W_d\tilde v$($W_d^{init}=0$),用 Matryoshka-Adaptor 的 $L_d=L^{topk}_d+\alpha L^{pair}_d$ 无监督目标、仅在候选语料上训练、modality→category→dataset 三级均匀调度;线性结构使服务时可折叠为单矩阵 $P_d=[(I+W_d)V^\top]_{1:d,:}$,一个 $d\times D$ 矩阵乘即得 $d$ 维嵌入 $z_d(v)$,再 $L_2$ 归一化。
技术新颖性
与已有工作的本质区别体现在四个层面。架构层面:VLM2Vec、GME、Qwen3-VL-Embedding 等基于 text-vision 模型改造且无音频,LCO-Embedding 依赖学习式压缩 token,本文则直接把原生 omni 理解模型(含 TMRoPE 音视频时序对齐的 Thinker)零新增参数地转成嵌入器,检索两侧都可为任意模态组合。采样层面:以往工作普遍混批训练,本文证明同源微批+哈希去重能系统性消除模态捷径,且该策略超出稠密检索、在分类与聚类任务上同样有效;额外收益是微批形状规则化带来的工程加速。损失层面:focal 思想借自密集目标检测的 RetinaNet,但被重定义为按查询难度重加权的对比损失,并用 stop-gradient 与单位均值归一化保证"重分配而非放大预算";蒸馏坚持前向 KL 并给出明确论证,权重退火机制($\lambda_i$ 有界且随批次平均)在学生强弱域之间自动平衡。部署层面:不同于 MRL 把多维度目标塞进编码器训练(作者观察到会损伤全维性能),本文用训练后的混合 PCA+线性残差适配器解耦;PCA 基在二阶矩层面混合而非平均各模态基(后者会得到非正交算子、丧失等距不变性),适配器也从浅 MLP 简化为单线性映射并融合为一次矩阵乘,属典型的"简单即高效"工程创新。
实验结果
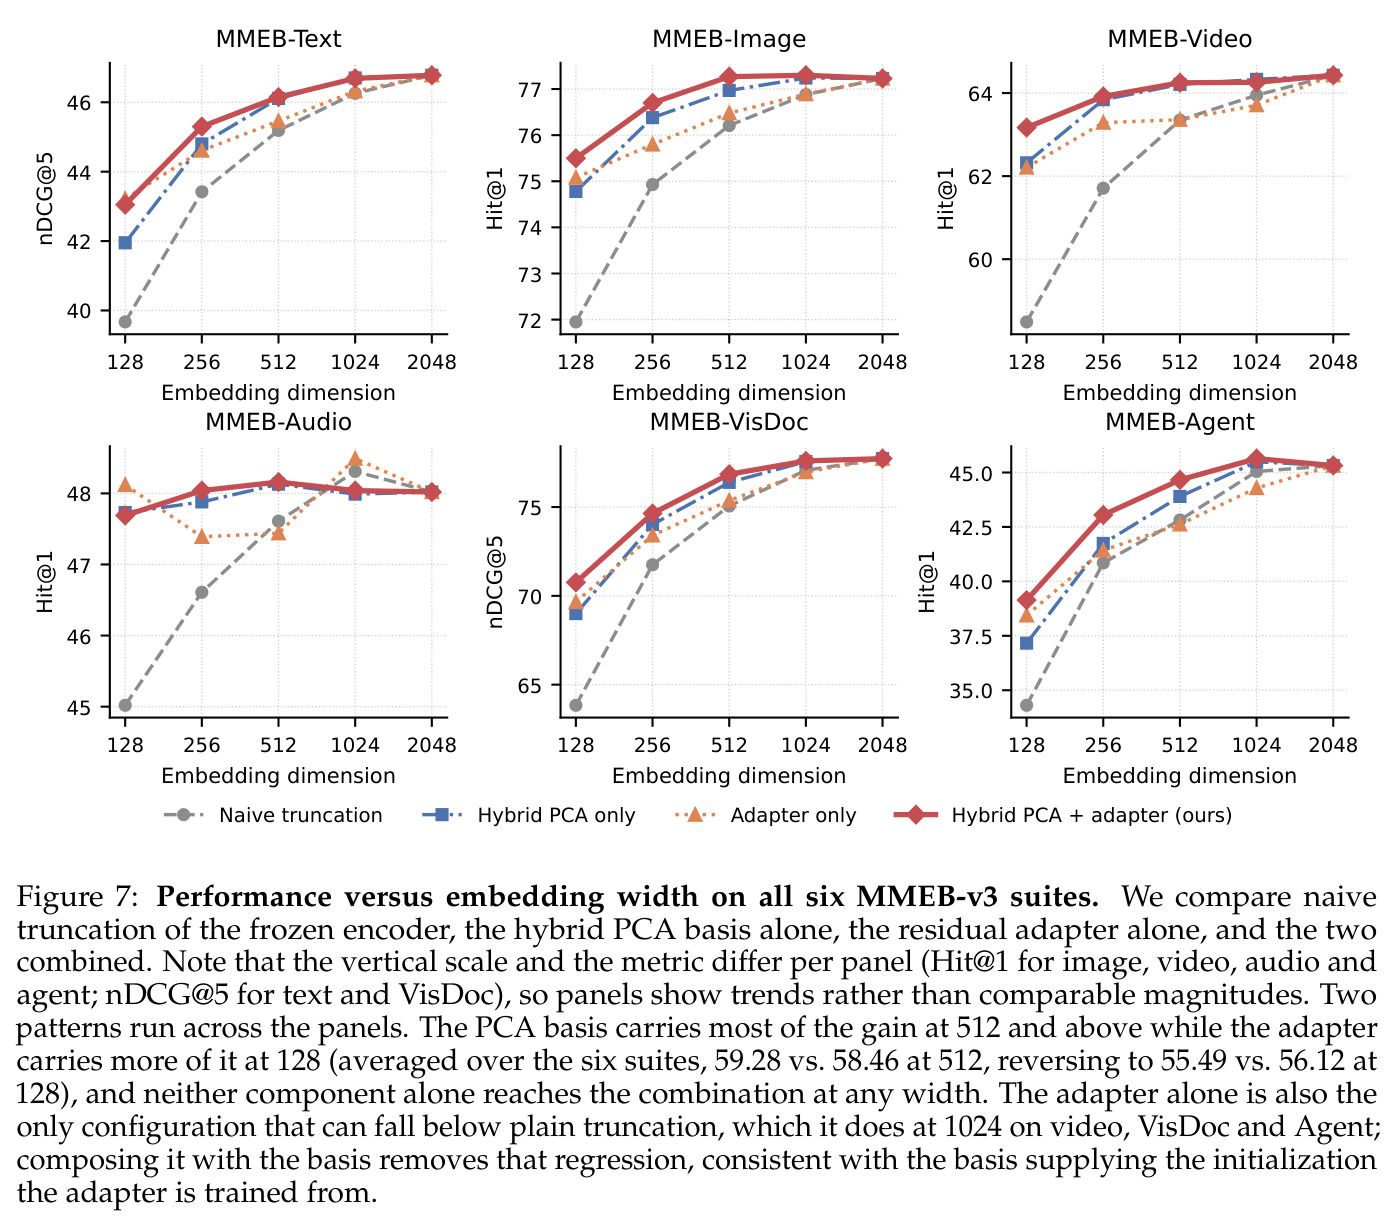
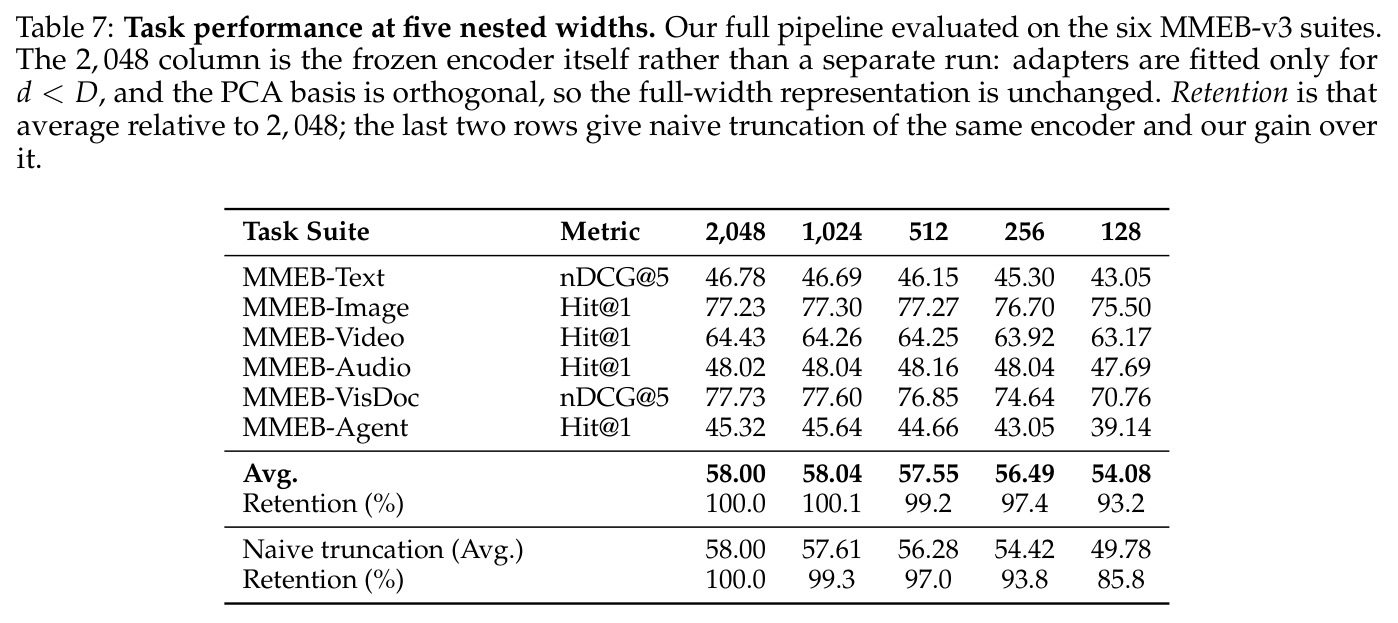
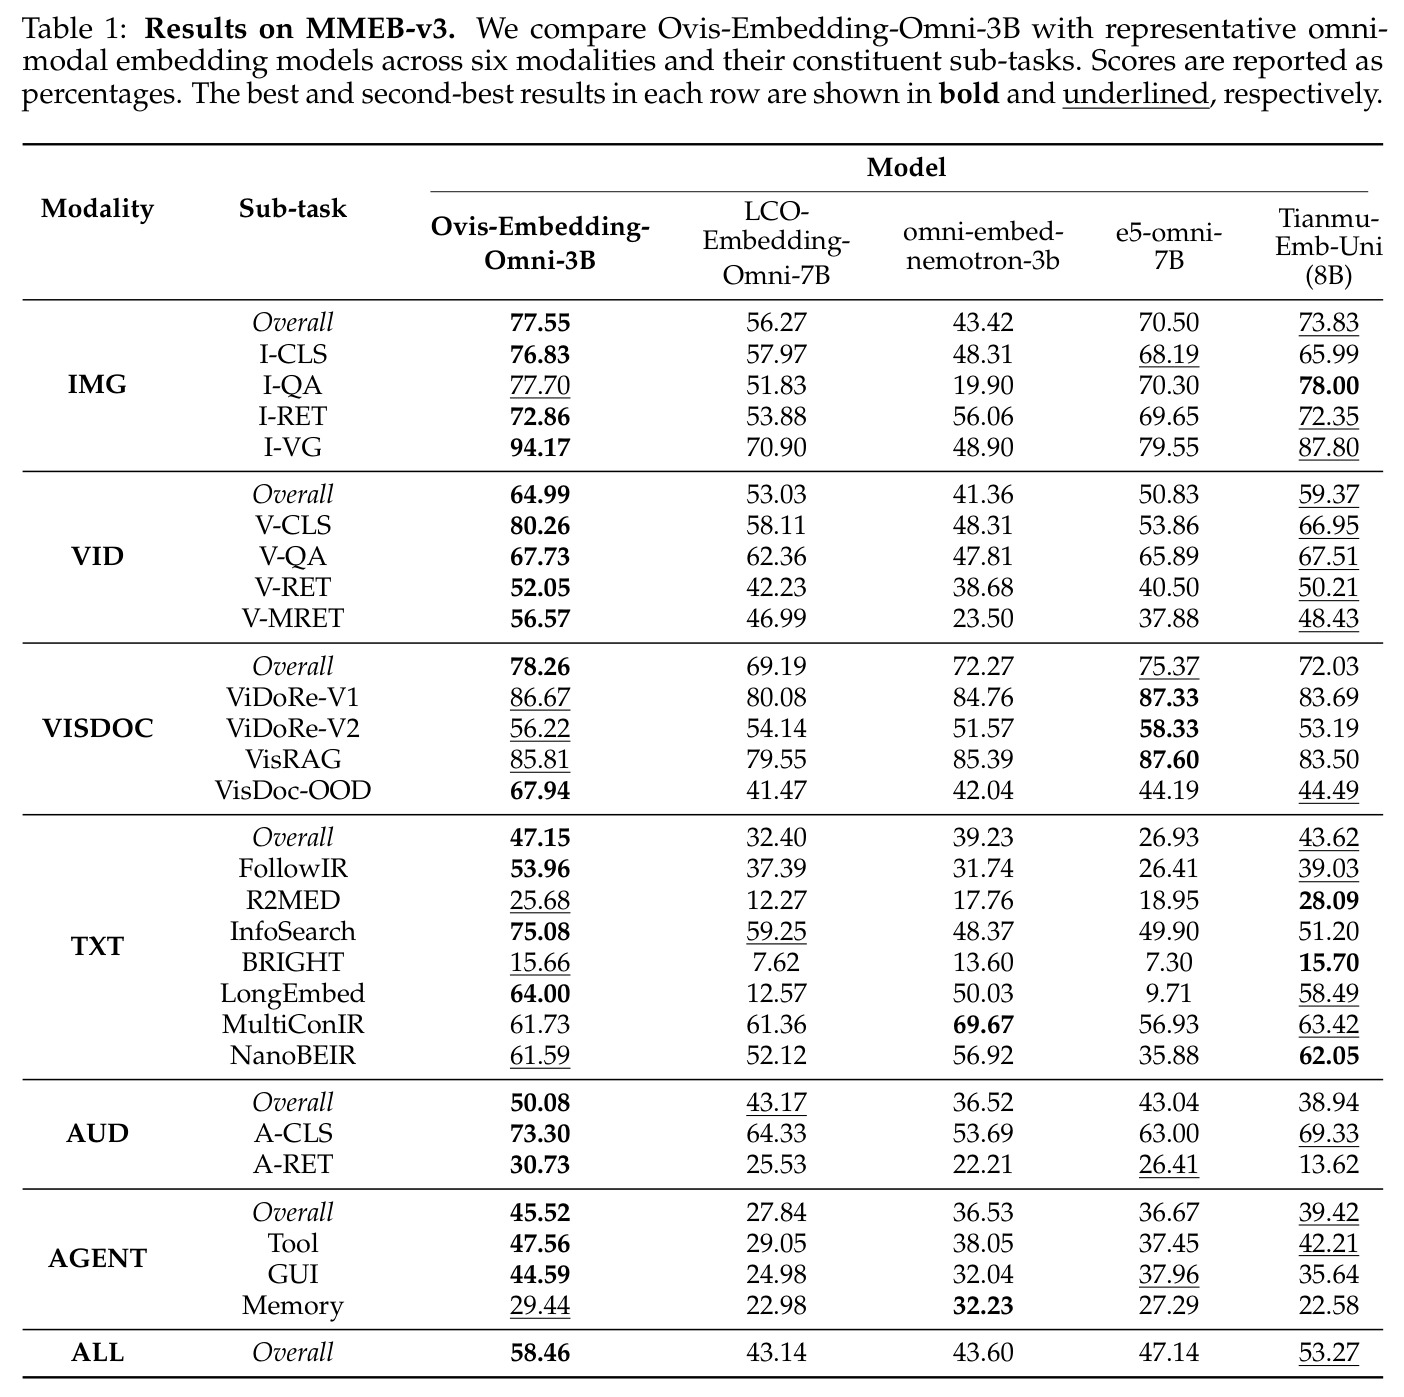
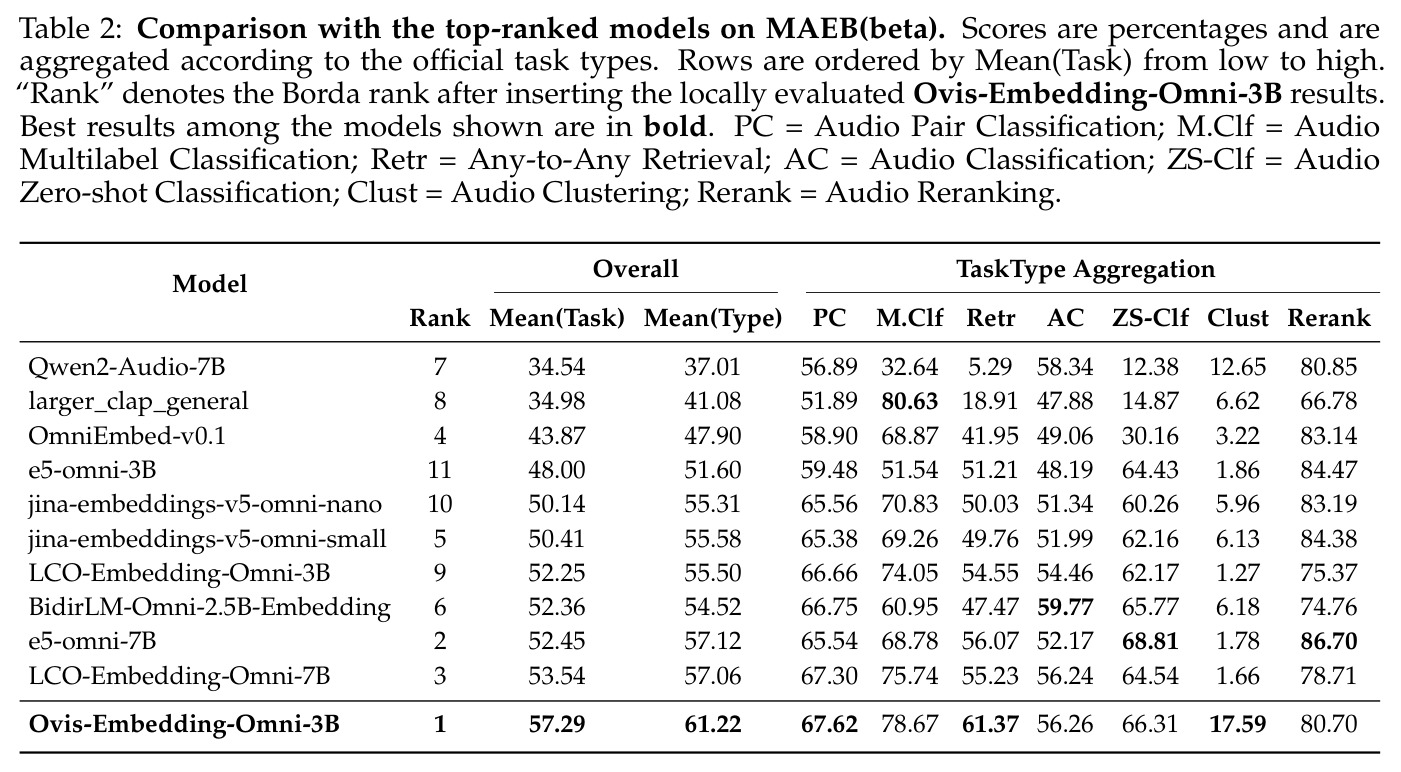
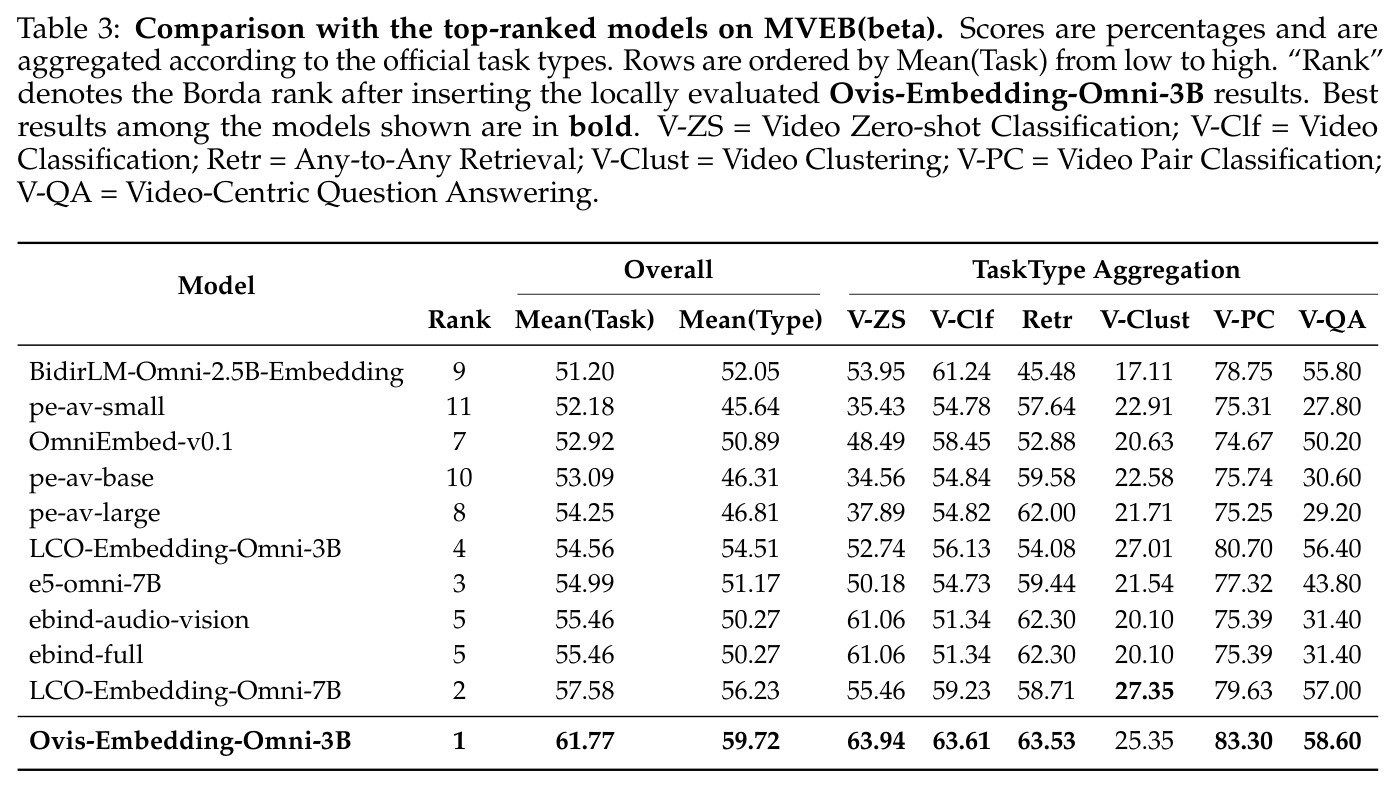
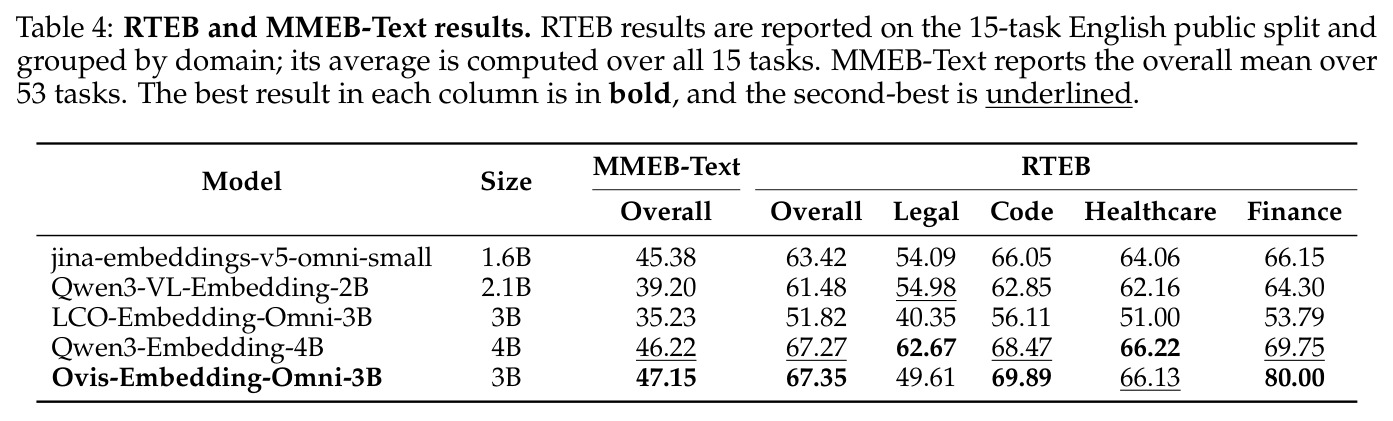
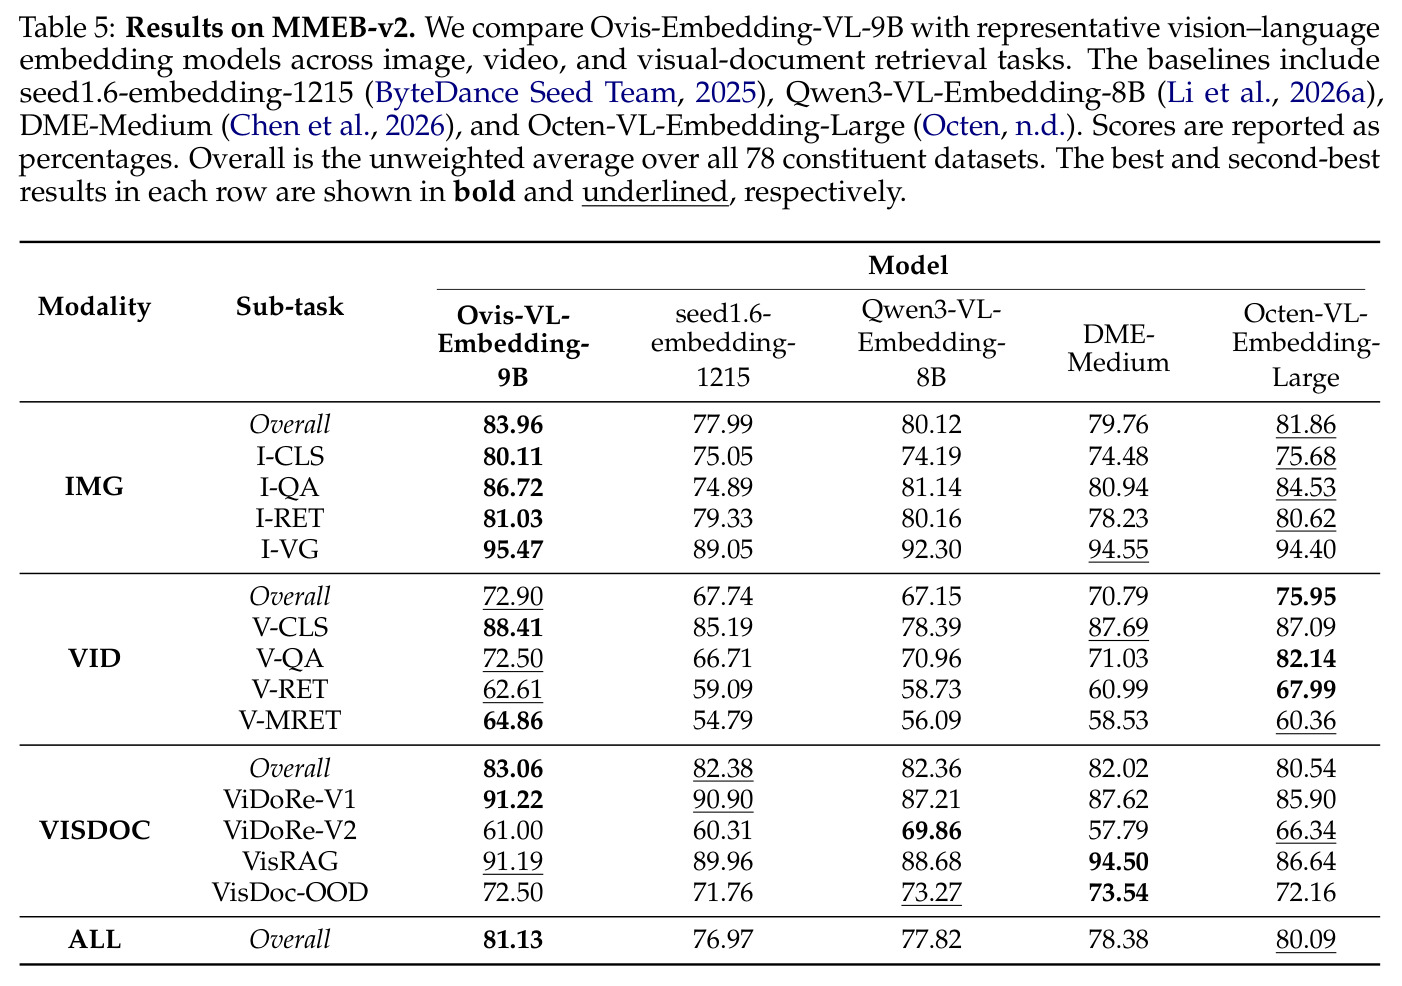
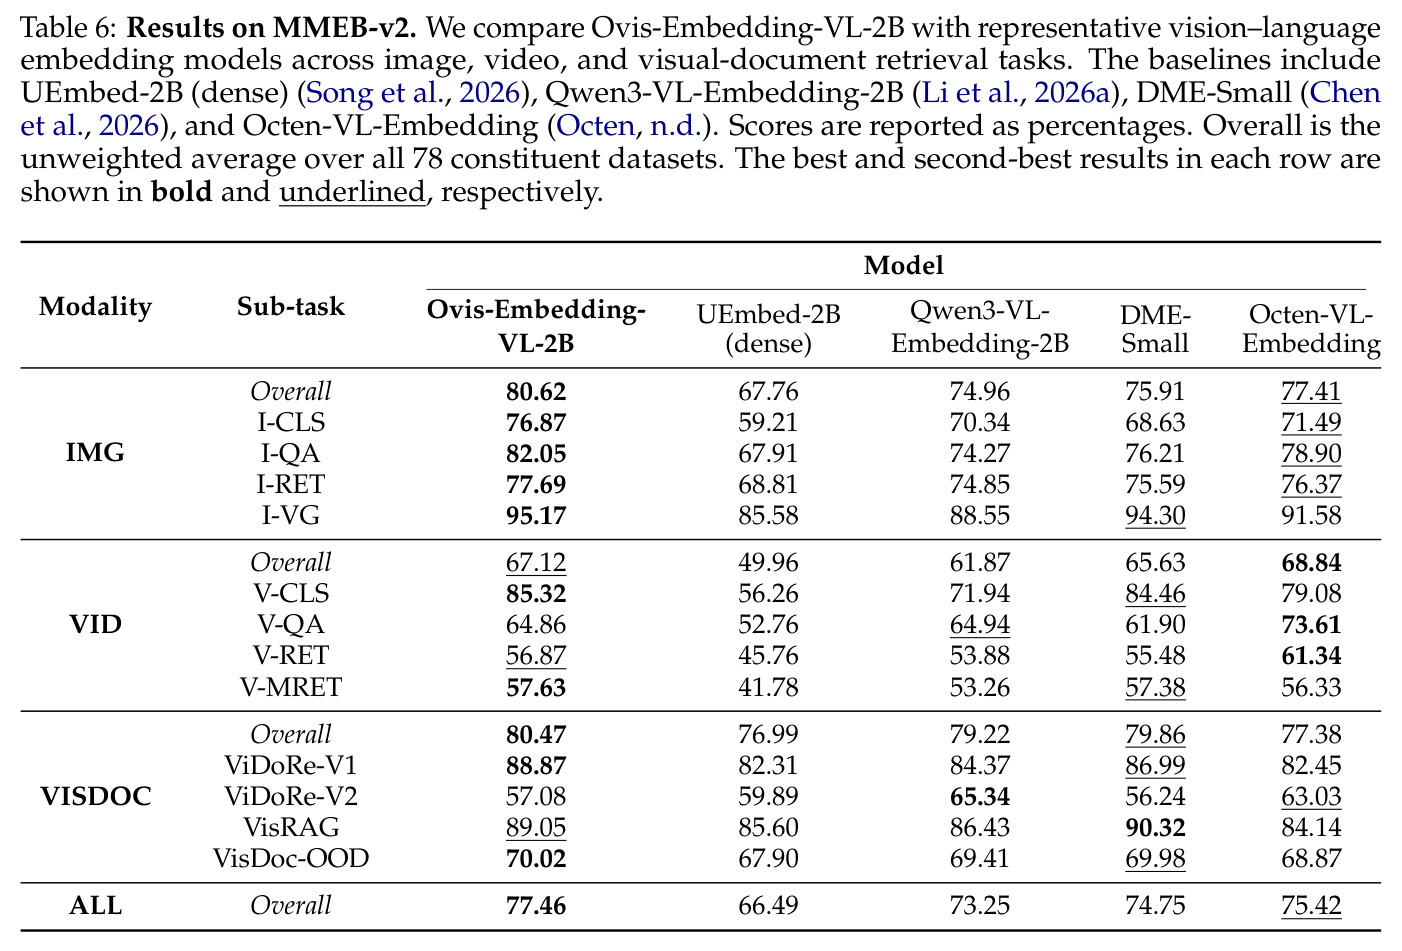
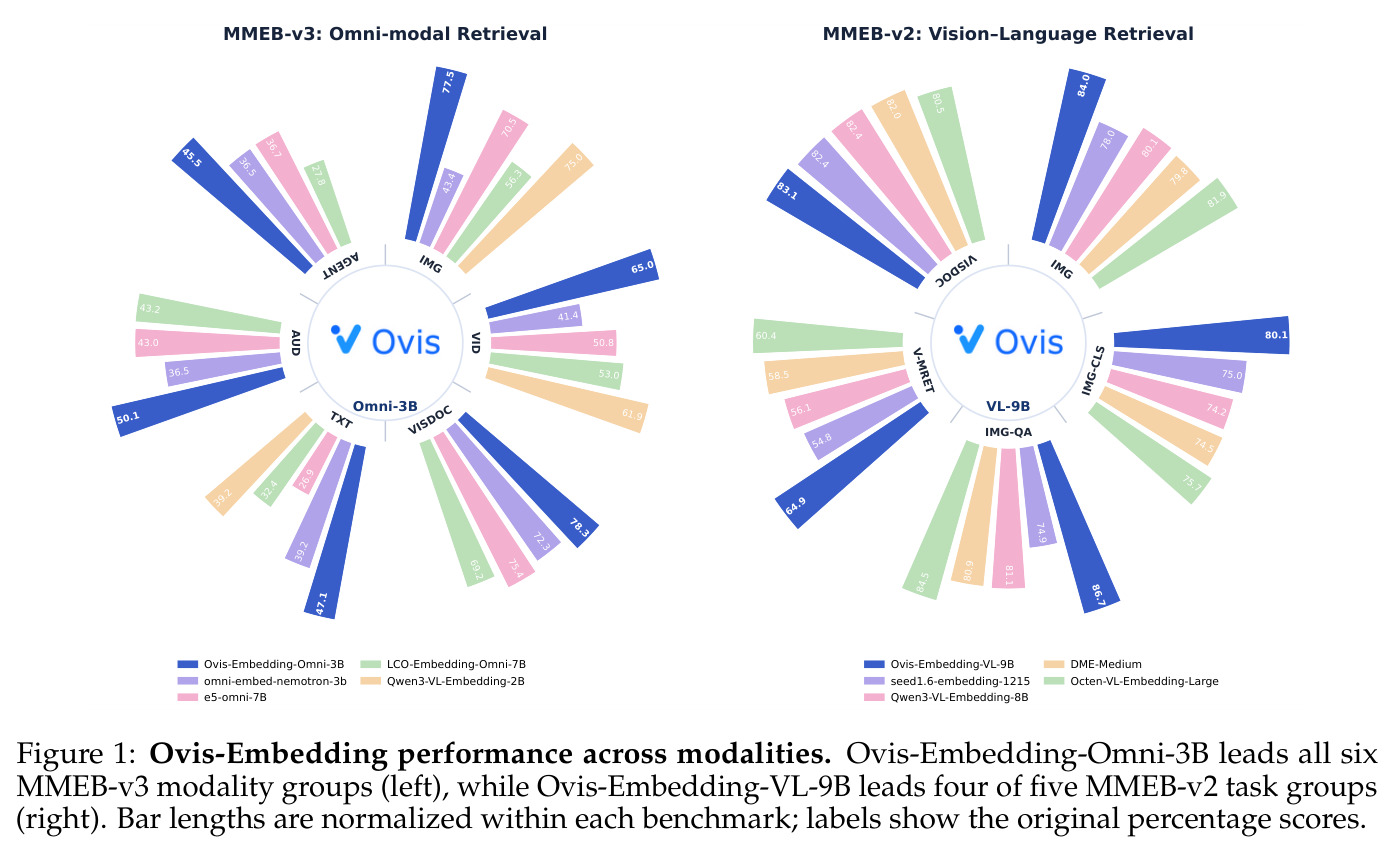
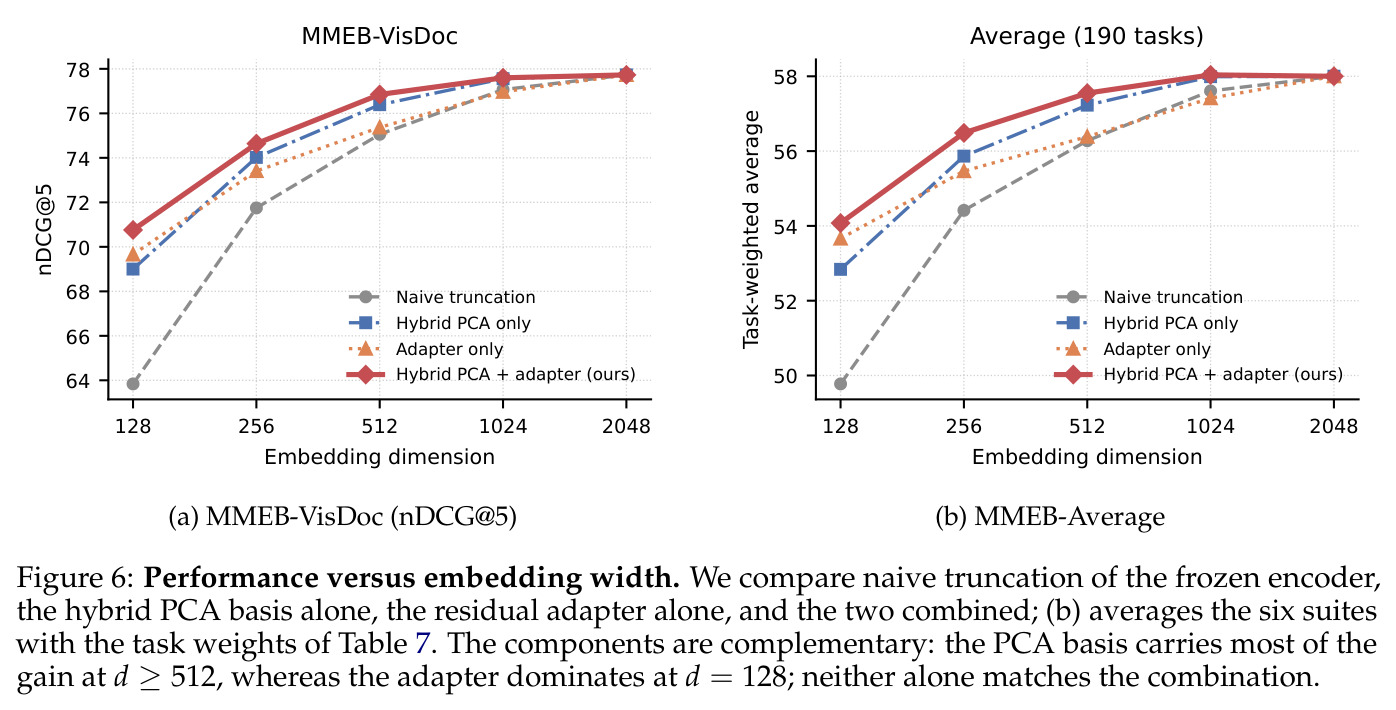
MMEB-v3(190 任务,六模态组):Ovis-Embedding-Omni-3B 总分 58.46,超最强基线 Tianmu-Emb-Uni(8B)的 53.27 达 5.19 分,比 e5-omni-7B(47.14)高 11.32 分、比 Omni-Embed-Nemotron-3B(43.60)高 14.86 分;六大模态组全部第一:图像 77.55(+3.72)、视频 64.99(+5.62)、视觉文档 78.26(+2.89)、文本 47.15(+3.53)、音频 50.08(+7.04,组间最大优势)、agent 45.52(+6.10)。子任务亮点:视觉定位 I-VG 94.17(+6.37)、视频分类 V-CLS 80.26(+13.31)、时刻检索 V-MRET 56.57(+8.14)、分布外文档检索 VisDoc-OOD 67.94(超第二名 23.45 分)、指令遵循检索 FollowIR 53.96(+14.93)、InfoSearch 75.08(+23.88);31 项聚合与子任务条目中 22 项第一、8 项第二,仅 MultiConIR(61.73,落后 7.94 分)跌出前二。MAEB(beta)(30 任务):Mean(Task) 57.29、Mean(Type) 61.22,插入官方排行榜后 Borda 排名第一,分别超最强对手 3.75/4.10 分,检索 61.37(+5.30)、聚类 17.59(+4.94)领先明显,但音频分类与重排低于最佳专业模型。MVEB(beta)(23 任务):61.77/59.72,以更少参数超 LCO-Embedding-Omni-7B 4.19/3.49 分,六类任务五类第一(零样本分类 63.94、配对分类 83.30 等),仅视频聚类 25.35 落后 2.00 分。RTEB(15 任务英文集):67.35,略超专用文本嵌入模型 Qwen3-Embedding-4B 的 67.27,MMEB-Text 47.15 也高于其 46.22,证明全模态覆盖不以文本质量为代价。MMEB-v2(78 数据集):VL-9B 总分 81.13(超 Octen-VL-Embedding-Large 1.04 分),VL-2B 77.46(超 2.04 分),两尺寸均居各自对比组第一,图像四子任务全第一(9B 视觉定位高达 95.47);9B 视觉文档 83.06、ViDoRe-V1 91.22。Scaling:2B→9B 总体 +3.67 分(IMG +3.34、VID +5.78、VISDOC +2.59),最大子任务增益在视频问答 +7.64、时刻检索 +7.23,说明额外容量主要强化时序理解。弹性维度(Fig. 6):在 128~2048 宽度上,混合 PCA 在 $d\ge512$ 时贡献主要增益,适配器在 $d=128$ 时占主导,两者结合在 MMEB-VisDoc(nDCG@5)与 190 任务平均上均全面优于朴素截断。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全模态嵌入 MMEB-v3(190 任务) | 总体平均分 | 58.46(Ovis-Embedding-Omni-3B,3B 参数) | Tianmu-Emb-Uni 53.27(最强基线,8B) | +5.19 |
| 音频嵌入 MAEB(beta,30 任务) | Mean(Task) | 57.29(Omni-3B) | LCO-Embedding-Omni-7B 53.54 | +3.75 |
| 视频嵌入 MVEB(beta,23 任务) | Mean(Task) | 61.77(Omni-3B) | LCO-Embedding-Omni-7B 57.58 | +4.19 |
| 文本检索 RTEB(15 任务英文公开集) | nDCG@10 均值 | 67.35(Omni-3B) | Qwen3-Embedding-4B 67.27(专用文本嵌入模型) | +0.08 |
| 视觉-语言嵌入 MMEB-v2(78 数据集,9B 组) | 总体平均分 | 81.13(Ovis-Embedding-VL-9B) | Octen-VL-Embedding-Large 80.09 | +1.04 |
| 视觉-语言嵌入 MMEB-v2(78 数据集,2B 组) | 总体平均分 | 77.46(Ovis-Embedding-VL-2B) | Octen-VL-Embedding 75.42 | +2.04 |
局限与改进
作者承认的局限:多条件文本检索 MultiConIR 得分 61.73,落后 Omni-Embed-Nemotron-3B 7.94 分,是全部 31 项条目中唯一跌出前二的,说明查询含多个并列约束时模型仍易顾此失彼;agent 记忆检索 29.44 仅居第二(落后 2.79 分),长时程记忆匹配能力与工具/GUI 理解不匹配;MAEB 上音频分类与重排低于最佳专业模型;MVEB 视频聚类 25.35 落后最佳 2.00 分,无监督类别结构有提升空间;文中约 50M 训练对等数字为基于当前数据冻结的占位估计,终稿才会更新;模型尚未提交官方排行榜,Borda 排名系将本地结果插入榜单快照后重算。我的补充观察:(1) 训练语料深度依赖专有资源——Quark 网页搜索日志、Qwen3.5-Plus 标注、私有配对数据,社区无法完整复刻数据配方;(2) 论文未披露 $\tau$、$\gamma$、$\lambda_{\min}/\lambda_{\max}$、负样本数 $K$、批大小、学习率等关键超参,也缺少 Stage-1 各损失组件的消融表,focal 与蒸馏的独立贡献只能间接推断;(3) 基线为选择性对比,未覆盖全部同期开源强模型;(4) Omni 版(Qwen2.5-Omni)与 VL 版(Qwen3.5)骨干代际不同,架构贡献与数据/训练贡献存在混淆,难以归因。
独立分析的弱点
弱点一:音频-音视频时序同步监督不足。音频数据以识别、双向音文检索为主,缺乏带时间戳对齐的音视频叙事数据,TMRoPE 的音视频同步建模能力未被训练充分利用(视频聚类偏弱或是表征),改进方向是构建时刻级对齐的音视频对并加入 moment-level 蒸馏。弱点二:多条件与记忆检索暴露单向量容量瓶颈。一个固定维向量需同时保持多个局部事实可独立寻址,MultiConIR 落后 7.94 分与 Memory 检索居次说明 3B/2048 维在约束组合场景吃紧,改进方向是查询条件分解展开、或多向量表示(ColBERT 式 late interaction)与稠密索引混合。弱点三:蒸馏依赖更强教师,若某模态/任务缺少强教师则难以突破,且教师分布离线预计算把语料锁定在 Stage-2 版本,数据更新需全部重算,改进方向是在线教师集成或自蒸馏。弱点四:评测集中于英文基准,多语言与跨语言 any-to-any 检索能力完全未验证,应纳入多语言 MTEB 类评测。弱点五:弹性适配器仅在候选语料上训练(查询不参与),线上查询分布漂移时短维(128/256)检索可能退化,可引入查询感知微调或分布鲁棒目标。弱点六:视觉文档上 e5-omni-7B 在 ViDoRe-V1/V2、VisRAG 三个子集仍更强,文档版面细粒度编码值得单独增强。
未来方向
作者提出的方向:开源模型权重、训练与数据构建配方、推理代码及统一评测工具,特别填补音频、音视频与 any-to-any 检索开源资源的空白;继续探索原生 omni-modal 模型作为通用检索基座的潜力(结论段明确将其列为动机)。基于本文成果可自然延伸:(1) 把同源采样、focal 加权与退火蒸馏迁移到生成式 RAG 的检索器-生成器联合训练,检验其对下游答案质量的增益;(2) 将分类、聚类、重排、STS 等异构任务统一到同一全模态接口(MAEB 已含重排与聚类),做成真正的"万能向量";(3) 弹性嵌入与向量量化(PQ、二值化)及 ANN 索引联合优化,做端到端存储-精度-延迟权衡;(4) 用该嵌入空间构建 agent 记忆的读写与检索机制,正面补足 Memory 短板;(5) 在更大骨干(Qwen3.5 系列更大尺寸)上验证 scaling 行为,论文已观察到容量主要增益时序理解,值得系统刻画;(6) 建设音视频时序同步检索的公开基准与数据集,填补作者自认的社区空白;(7) 探索蒸馏教师缺失模态时的自举方案,如跨模态教师互教。
复现评估
开源情况:论文承诺开源三个模型检查点(Omni-3B、VL-2B、VL-9B)、训练与数据构建配方、推理代码及统一评测工具,给出两个 GitHub 仓库地址(ATH-MaaS/Ovis-Omni-Embedding 与 Ovis-VL-Embedding),但截至报告版本尚未见正式发布,正文数据规模等数字也标注为占位估计。数据:约 50M 对语料混合公开数据(ImageNet、CUB-200、SUN397、TextVQA、DocVQA、InfoVQA、MS-COCO 及各 RTEB 领域集)与专有数据(Quark 搜索日志、Qwen3.5-Plus 标注、私有新闻/商品配对),完整复刻需调用闭源 VLM 做语义验证与查询改写,成本高但可用开源 VLM 部分替代。算力:NVIDIA H100 80GB 集群;Stage-1 仅训练 LoRA,3B 规模单节点可行;Stage-2 全参微调 3B~9B 需多卡多节点;Stage-3 需先运行多个模态专家教师做离线推理(一次性成本);Stage-4 训练极轻量、推理只是多一个矩阵乘。评测复现难度低:五个基准全部公开、官方聚合实现明确、双塔余弦协议简单。总体评估:复现难度中等偏高——方法文档化程度好、无未公开的私有模块,但专有数据配方与缺失的超参细节是主要障碍;直接使用开源权重做下游应用则门槛很低。
论文图表