REA:面向异步大脑-小脑控制的具身智能体路由运行时 REA: A Routed Embodied Agent Runtime for Asynchronous Brain-Cerebellum Control
路由器协调慢速大脑与快速策略,运行中的策略永不等待大脑
前置知识
System 1 / System 2 双系统架构
源自卡尼曼《思考,快与慢》的认知架构隐喻:System 1 快速、自动、低耗,System 2 缓慢、深思、高耗。机器人领域用它描述双层控制——慢速 VLM/LLM 负责规划推理,快速动作模型以不同频率闭环控制。本文保留层级命名但重定义语义:System 2 是离线生成策略、在线只做裁判和建议的大脑,System 1 是不发任何动作的路由器,System 0 是任意快速策略(冻结程序、VLA、全身控制器)。
REA 的三层契约、黄金法则『任何运行中的策略不等待大脑』以及与 GR00T N1、Helix 等既有双系统工作的区别,全部建立在这个框架之上,不理解它就无法理解本文要解决的核心矛盾。
VLA(视觉-语言-动作模型)
在机器人演示数据上端到端训练的多模态模型,输入相机图像、语言指令与机器人本体状态,直接输出动作块,以几到几十赫兹运行,代表工作有 RT-2、OpenVLA、Octo、$\pi_0$。它们在训练分布内成功率可达 90% 以上,但对物体、位置、语言扰动泛化差,且推理远快于基础模型智能体的慎思速度。
REA 在 RoboTwin 2.0 研究中把七个 VLA 和代码策略放进同一个候选池由学习型选择器路由,理解 VLA『快但脆』的特性是理解路由与混编池价值的前提。
Code-as-Policy(代码即策略)
由大模型编写可执行控制程序的操作范式:程序内部调用分割、抓取规划、逆运动学等感知与运动原语,可被冻结后反复执行,速度快且可解释。代表工作有 Code as Policies、Voyager、ASPIRE(把修复循环和进化搜索扩展到 LIBERO)。本文的冻结程序在沙箱里运行,封禁 getattr 等能触达仿真器内部状态的标识符。
LIBERO-Pro 主实验的 System 0 就是各流水线生成的冻结程序(Fix/Evo/SDK 程序),路径记忆正是对这些程序逐一实测成功率与步数后建表,离开启就无法理解调度机制。
静默失败(silent failure)
策略运行结束时不抛出任何异常、返回 $e=\perp$、截断标记 $\tau$ 也不置位,但任务实际没有完成的失败模式。论文统计:在 590 个 LIBERO-Pro 回合中,Fix 策略失败 166 次,而只由异常触发的路由器仅升级了 6 次——绝大多数失败完全绕过了异常检测。
静默失败是边界触发裁判门存在的直接理由:异常门在这些场景下形同虚设,换异常门会在匹配困难子集上损失 15.3 个百分点的成功率,这是论文最关键的消融结论。
LIBERO-Pro 基准
在 LIBERO 之上沿物体、位置交换、语言、任务、环境五个轴施加扰动的机器人操作基准,构成相对标准 LIBERO 的分布外(OOD)测试集。本文使用其六个 goal/object/spatial 套件在 task 与 swap 扰动下的全部 60 个任务,每任务测试种子 1–50 共 3,000 回合,步数上限 $H=4000$、墙钟预算 $W=900$ 秒,开发种子为 61–70。
论文的主表数字(95.9% 对 94.7%、步数 -25% 等)全部在这套对齐协议上测得,理解其 50 种子对齐设计才能正确解读统计检验(配对 McNemar 检验)的含义。
研究动机
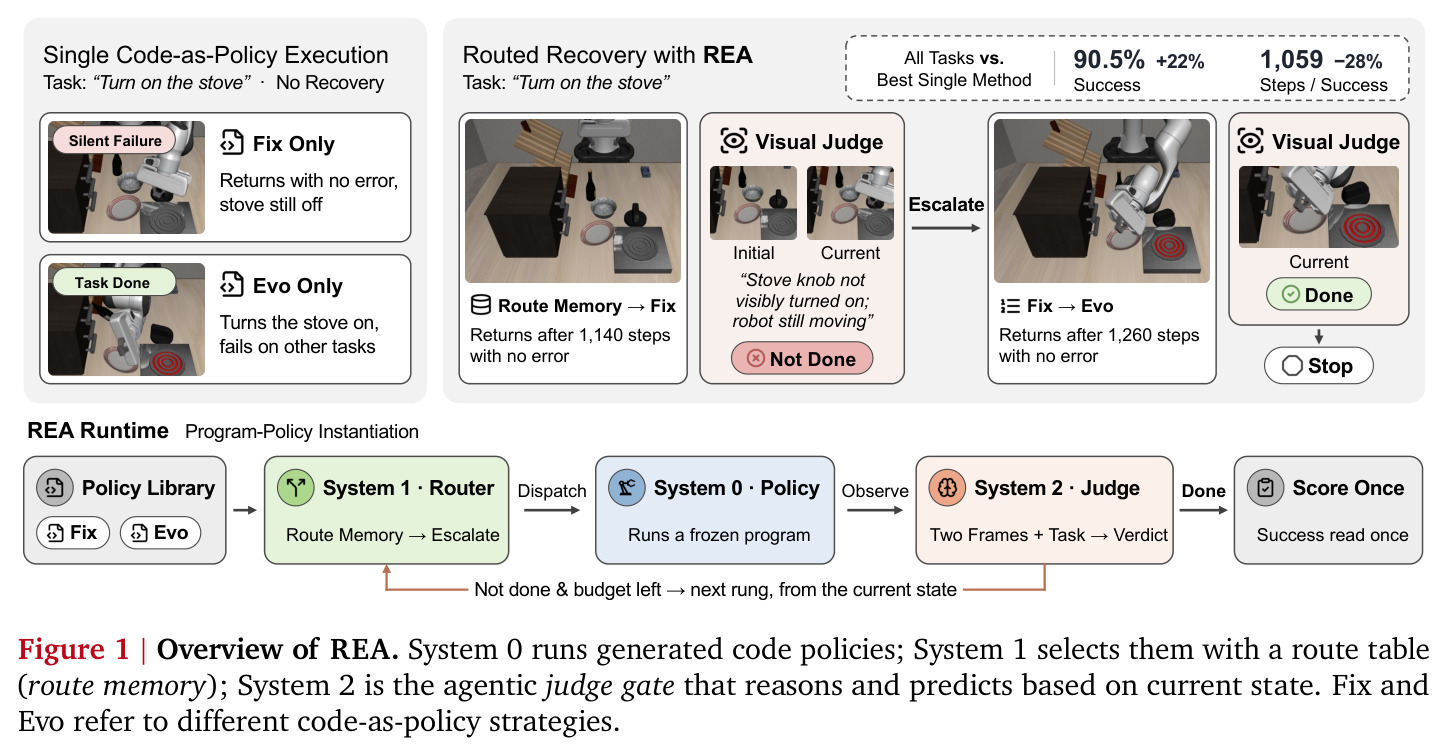
基础模型作为具身『大脑』已能写出调用分割、抓取规划与逆运动学的操作程序,但代价高昂:ASPIRE 修复循环在 LIBERO 上每任务中位耗时 43 分钟,Codex + GPT-6 流水线为 60 个 LIBERO-Pro 任务生成程序消耗 89M 输入 token;让大脑直接当控制器更不可行——单 token 动作模型在 1,987 个 LIBERO-Pro 回合里只解出 1 个,笛卡尔 IK 直控 600 个回合全军覆没。另一端,VLA 与全身控制器以几到几十赫兹运行,远快于智能体慎思,但在 LIBERO-Pro 扰动测试集上会从 LIBERO 上 90%+ 的成功率崩掉。两类系统还各自绑定不同仿真器、机器人、观测格式与成功判据,没有统一运行时可在相同回合上比较。异步协调同样困难:智能体驱动时机器人每回合为等待决策空转 2.6 秒、占控制时间 20%;快策略出错才叫大脑,则持久错误反复触发,而 590 个回合中 166 次失败里异常只触发 6 次升级——多数失败根本不报错,且任务已完成时盲目重跑还可能撤销成果。
本文的目标是REA 的目标是构建一个统一的具身智能体运行时,让慢速通用的 System 2(基础模型大脑)、System 1(具身路由器)和快速狭窄的 System 0(冻结程序、VLA、全身控制器)在同一个契约下协作,并恪守一条黄金法则:任何正在运行的策略都不等待大脑。大脑离线用各策略生成流水线准备候选程序,在线只在策略返回边界上提供判断(Judge)与建议(Advise)两个服务;所有控制流决策归路由器所有。同时 REA 提供对齐的评测协议——相同 (task, seed) 对、相同初始状态语义、相同地平线与墙钟预算、共享策略库时用同一份冻结代码、最后只评分一次——使智能体、VLA 与程序化策略能在 LIBERO-Pro、BEHAVIOR-1K、RoboTwin 2.0 三个仿真器和 Unitree G1、AlohaMini2 两台真机的相同回合上公平比较。
与已有工作不同的是,已有工作的独特盲区在于『大脑应该放在哪』这个位置问题从未被当作一等设计对象。既有双系统机器人模型(GR00T N1、Helix、Helix 02、Hi Robot、Gemini Robotics 1.5)的每一层都是某个固定技术栈里的学习模型,速率固定且无法互换;评测侧 Embodied Agent Interface 和 SIMPLER 各只评一族方法。REA 的切入是把耦合方式拆成三种对照:智能体调用快策略(每步承担大脑延迟)、快策略出错调用智能体(持久错误反复触发、静默失败漏掉)、以及 REA 的第三条路——路由器居中:调度靠预存的路径记忆查表完成,把大脑从调度路径上彻底摘掉;用边界触发的裁判门在每次策略返回时问一次『做完了吗』,专门捕捉不抛异常的静默失败;用共享预算的升级梯子保证恢复有界。『离线备策略、只在边界问大脑』的组织方式,加上跨三仿真器两真机的统一评测,是本文与所有既有工作的本质差异。
核心方法
REA 把回合形式化为任务 $t$ 与指令 $\ell_t$、初始种子 $s$、步数上限 $H$ 与墙钟预算 $W$。策略 $p$ 从当前状态启动,返回 $(\Delta, \delta, e, \tau) \leftarrow \mathrm{Run}(p; H-u, W-w)$,其中 $e$ 为异常或 $\perp$,$\tau$ 标记截断;策略可在段边界让出并被恢复,以原生速率闭环运行。三层分工:System 2 离线 $\mathrm{Generate}(t)$ 产出候选池 $P_t$,在线只提供 $\mathrm{Judge}(f_0, f_k, \ell_t) \in \{done, not\_done\}$ 与 $\mathrm{Advise}(o)$;System 1 路由器拥有全部控制流决策;System 0 只用剩余预算 $(H-u, W-w)$。实验变体三个:REA-M(路径记忆+异常门)、REA-A(智能体调度与恢复)、REA-V(路径记忆+视觉裁判门)。后端只需实现 Reset、Render、策略接口与回合末一次的 Score,即可接入 MuJoCo、Isaac Sim、SAPIEN 与真机。
核心是三个模块各对付一个协调难题。其一,路径记忆:评测前让每个候选 $p \in P_t$ 在开发回合(种子与测试不相交)上实测成功率 $\hat{r}_{t,p}$ 与平均步数 $\hat{c}_{t,p}$,测试时调度即查表——首选 $\arg\max_p \hat{r}_{t,p}$,平手取步数小者——把调度与 System 2 在线推理解耦。其二,边界触发的裁判门:多数失败是静默的($e=\perp$ 且任务未完成),异常门永不响;REA-V 改为每当策略返回时调用一次 $\mathrm{Judge}(f_0, f_k, \ell_t)$,判 done 则终结回合并保护已完成工作,not_done 则沿梯子推进;免费异常门只在异常或截断时升级。其三,共享预算升级梯子 $L_t = [\mathrm{first}(t), \mathrm{other}(t), \mathrm{first}(t)]$:每次升级从当前状态启动下一档,所有运行与大脑调用共用同一 $(H-u, W-w)$,回合永不超出单策略预算——由此兑现黄金法则:策略原生速率不间断运行,大脑建议只在下一个边界生效。
方法步骤详情
流程分四步。第一步离线备策略:System 2 用 ASPIRE、Codex + GPT-6、Agents SDK 等流水线为每任务生成候选程序(调用 SAM 3、ContactGraspNet、PyRoki 逆运动学,运行在封禁 getattr 的沙箱中),或纳入七个 VLA 与一个在线代码策略。第二步建路径记忆:每个候选在开发种子上实测 $\hat{r}_{t,p}$ 与 $\hat{c}_{t,p}$,共 1,790 回合、零模型 token,而生成流水线各需上千回合与 29–89M token。第三步在线执行:路由器查表调度首选策略,策略以原生速率闭环运行;返回时裁判门用首帧 $f_0$、当前帧 $f_k$ 与指令 $\ell_t$ 判 done/not_done(阈值与提示词在 216 个开发标签上冻结),not_done 则按梯子从当前状态启动下一档,每回合最多三次运行。第四步只评分一次:最后跑完后调用 Score 读出成败。VLA 研究还支持学习型调度器:编码器把初始观测映射为 $h_0$,对每个候选打分 $q_p = \sigma(w_p^\top h_0 + b_p)$,选最高分后整回合锁定。
技术新颖性
新颖性体现在三个『位置』规定而非新模型。路由方面:FrugalGPT 级联 LLM API、Lu 等奖励引导路由、混合专家逐 token 门控、Agent-as-a-Router 用验证结果路由编码任务,REA 把基于结果的路由首次带到具身策略上,且用最朴素的查表就与在线智能体调度同精度(95.9%,配对 26:26 平手)、零模型成本零等待。评测方面:Embodied Agent Interface 与 SIMPLER 各只评一族方法,REA 用同一运行时在相同 (task, seed) 回合上对齐大脑、路由器与不同家族策略,固定地平线、墙钟预算与静态 GPU 通道,使配对 McNemar 检验成为可能。裁判方面:VLM 成功检测器、LLM 裁判、REFLECT 各有其位,REA 不发明新检测器,只规定其位置——每策略返回一次、共享预算内门控升级、绝不当成功判据。实证显示最终判定准确率仅 0.72(对永远答 done 的 0.67)的噪声裁判仍净赚 +3.1%:done 判定精度高达 0.83–0.905,且重跑通常不破坏成果(转化 24% 的失败首跑、只撤销 5% 的成功回合)。
实验结果
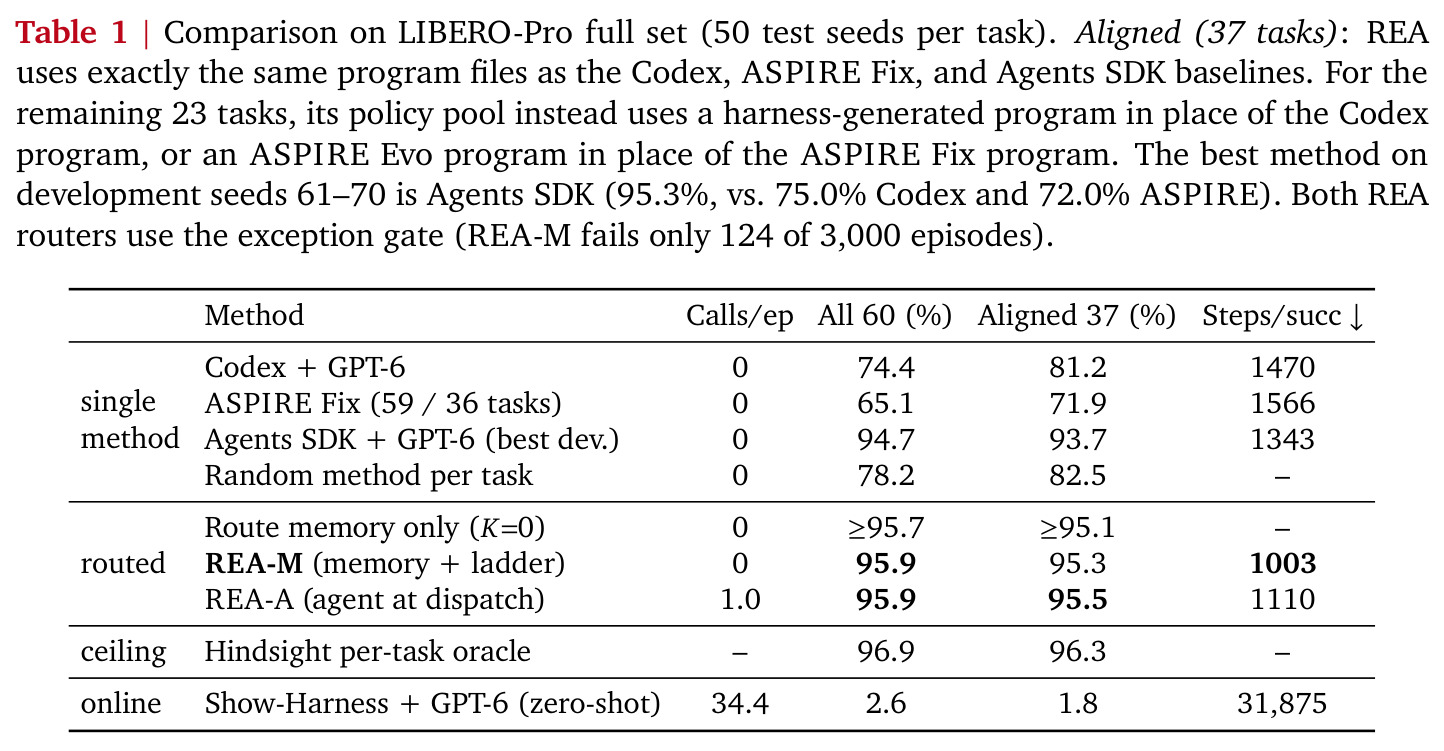
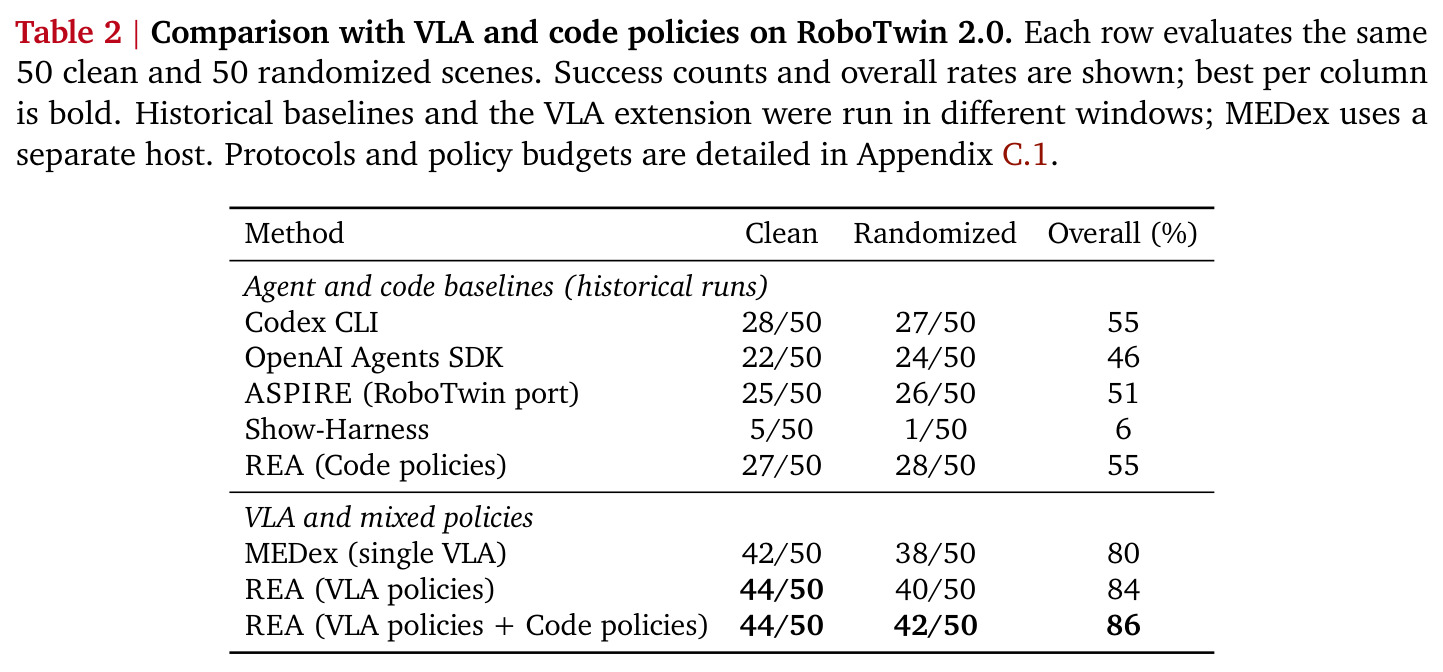
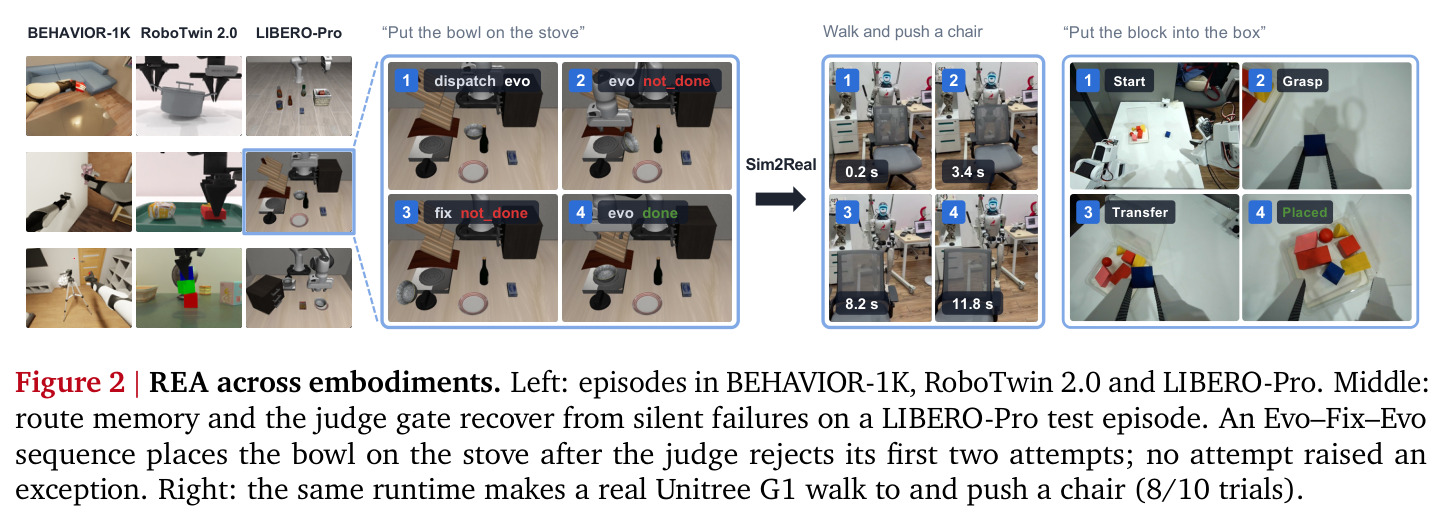
主结果六块。(1) LIBERO-Pro 全集 3,000 回合:REA-M 95.9%,超最强单方法 Agents SDK + GPT-6 的 94.7%($p=0.004$),距事后 oracle 96.9% 仅 1pp;每成功步数 1,003 对 1,343(-25%),控制时间 -17%。(2) 等待消除:阻塞 advisor 每回合空等 2.62 秒,REA-M 9.96 秒对 13.33 秒(-25%)。(3) 改进他源策略:ASPIRE Fix 池 66.3%→71.9%(+5.6%),裁判门再 +3.1% 至 74.9%;零样本 GPT-6 池 19.3%→26.3%。(4) 困难子集消融:完整 REA-V 48/72(66.7%)唯一显著超最佳单策略 Evo(51.4%),去路径记忆掉到 54.2%,换异常门损失 15.3%。(5) 大脑在环内当控制器失败:直控 0/600 且每回合耗 121.8–228.7 秒,Show-Harness 仅 2.6%。(6) 迁移:RoboTwin 2.0 REA(VLA+code) 86% 超 MEDex 80%;200 场景并排 97 对 Codex 75;BEHAVIOR-1K 27/50;真机 Unitree G1 8/10、AlohaMini2 10/10。
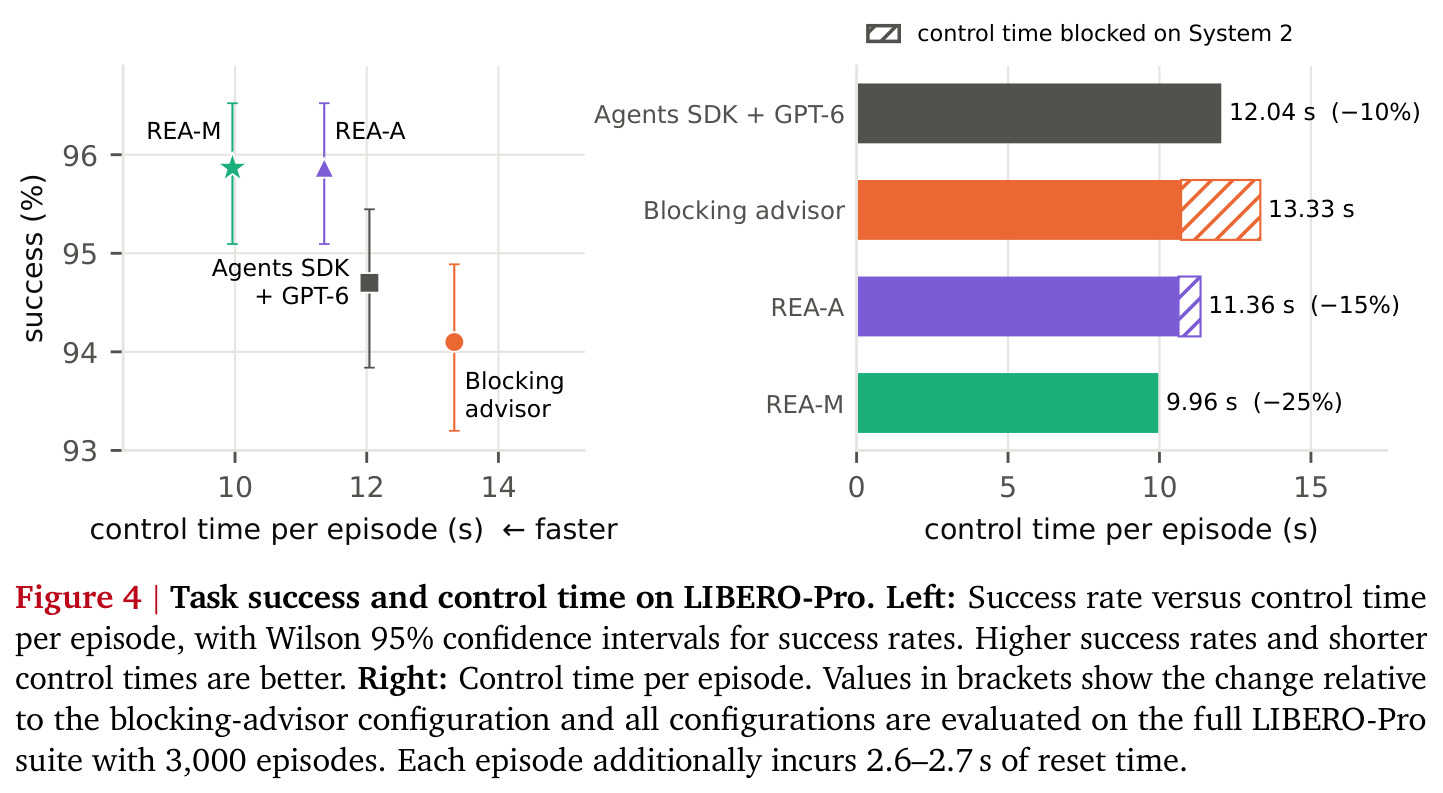
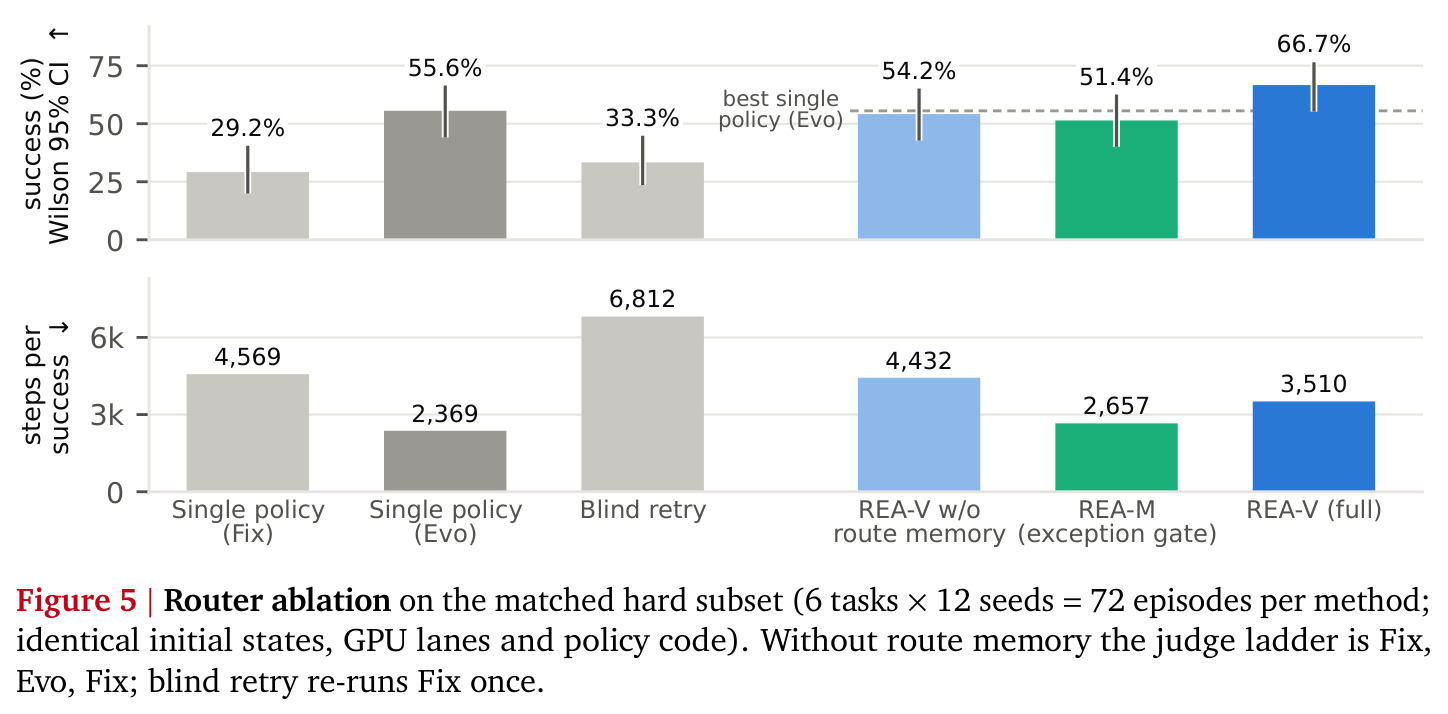
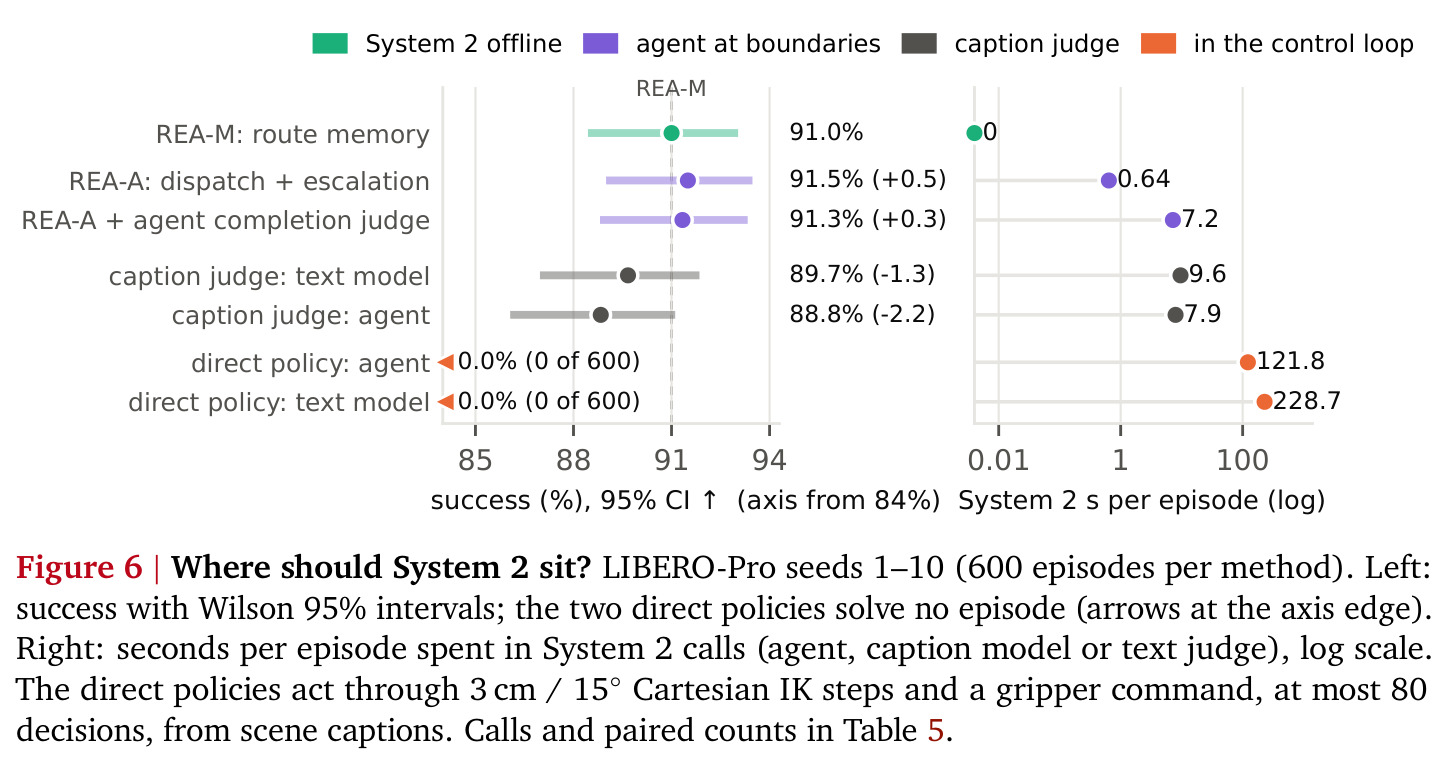
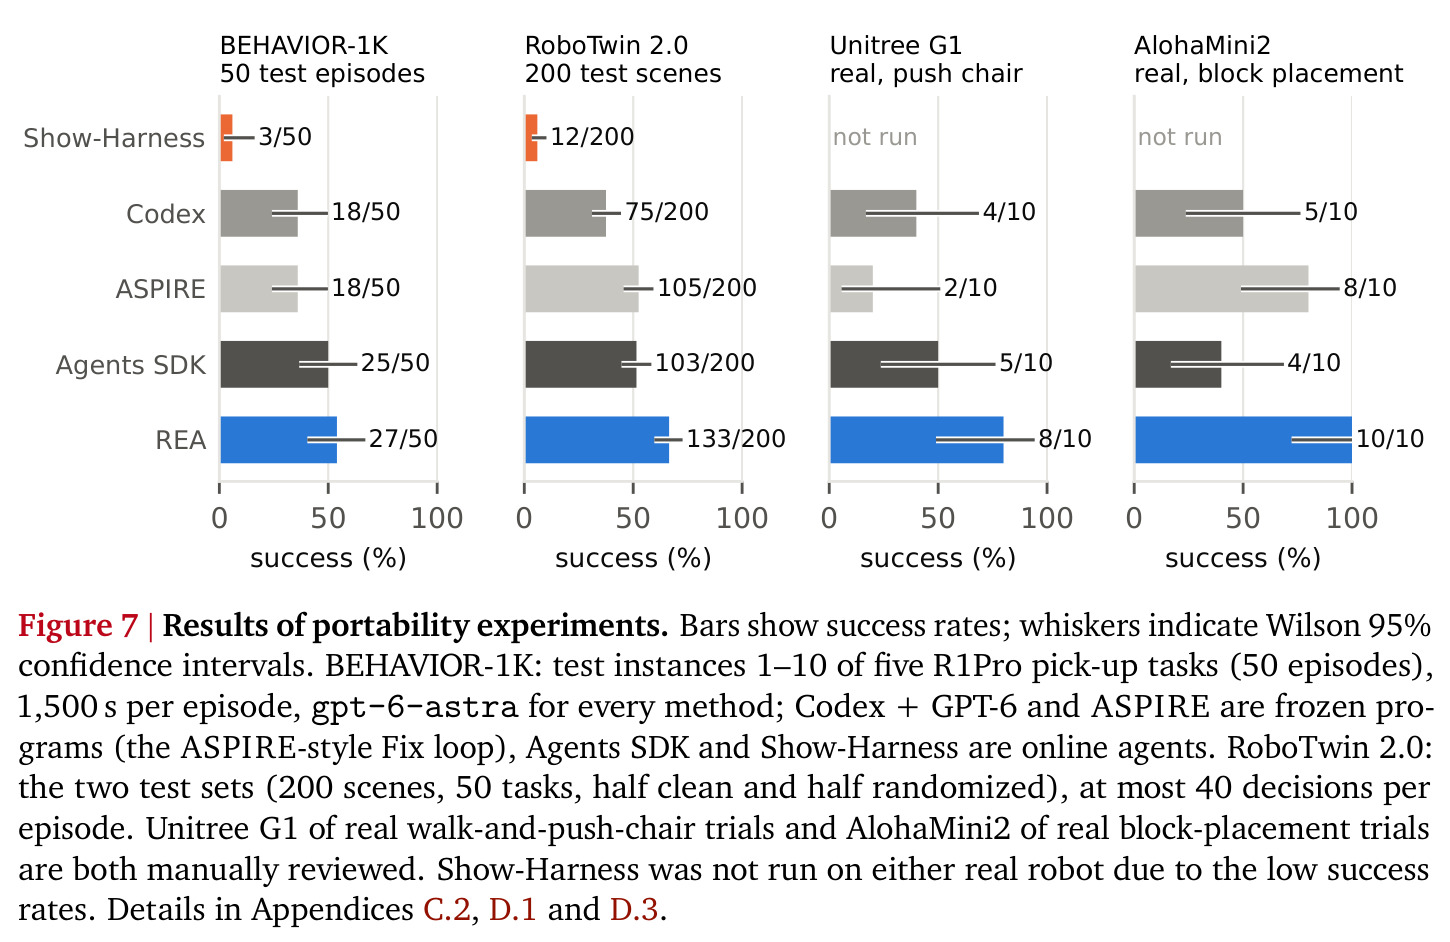
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-Pro 全集(60 任务 × 50 种子 = 3,000 回合) | 成功率 / 每成功步数 | REA-M 95.9%,1,003 步/成功 | 最强单方法 Agents SDK + GPT-6 94.7%,1,343 步/成功(事后 oracle 96.9%) | +1.2pp(86:51,p=0.004),步数 -25%,控制时间 -17% |
| LIBERO-Pro 控制效率对比 | 每回合控制时间 | REA-M 9.96 s | 阻塞式 advisor 13.33 s(每回合空等 2.62 s);Agents SDK 12.04 s | 对 advisor -25%(CI [-31,-20]%)且成功率 +1.8%(90:37,p<10^-5) |
| LIBERO-Pro ASPIRE Fix 策略池(种子 1–10,590 回合) | 成功率 | REA-M+裁判门 74.9% | 单用 ASPIRE Fix 策略 66.3% | +8.6pp;其中裁判门贡献 +3.1pp(37:19,p=0.022),代价是每成功时间 2.1 倍 |
| LIBERO-Pro 零样本 GPT-6 策略池 | 成功率 | REA-V 26.3% | 单用零样本策略 19.3% | +7.0pp(50:8,p<10^-4),三倍更弱的策略库上结论不变 |
| RoboTwin 2.0 VLA 研究(50 clean + 50 randomized = 100 回合) | 总体成功率 | REA(VLA+code) 86%(randomized 42/50) | 最强单 VLA 基线 MEDex 80%;REA(纯 VLA) 84% | +6pp;代码策略只增加成功不损失 VLA 成功 |
| RoboTwin 2.0 200 场景迁移研究 | 成功场景数 | REA 133/200 | ASPIRE 105/200、Agents SDK 103/200、Show-Harness 12/200 | 并排对比对 Codex CLI 97:75(42:20,p=0.007);各 p<0.001 |
| BEHAVIOR-1K(R1Pro,5 个拾取任务 50 回合) | 成功回合数 | REA 27/50 | Agents SDK 25/50(p=0.77 不显著);Codex 18/50;ASPIRE 18/50 | 对两个冻结程序基线分别 13:4(p=0.049)与 12:3(p=0.035) |
| 真机 Unitree G1 走向并推椅子(10 次试验) | 成功率 | REA 8/10 | Agents SDK 5/10、Codex 4/10、ASPIRE 2/10 | p=0.023,同模型同 System 0 策略、现场人工判分 |
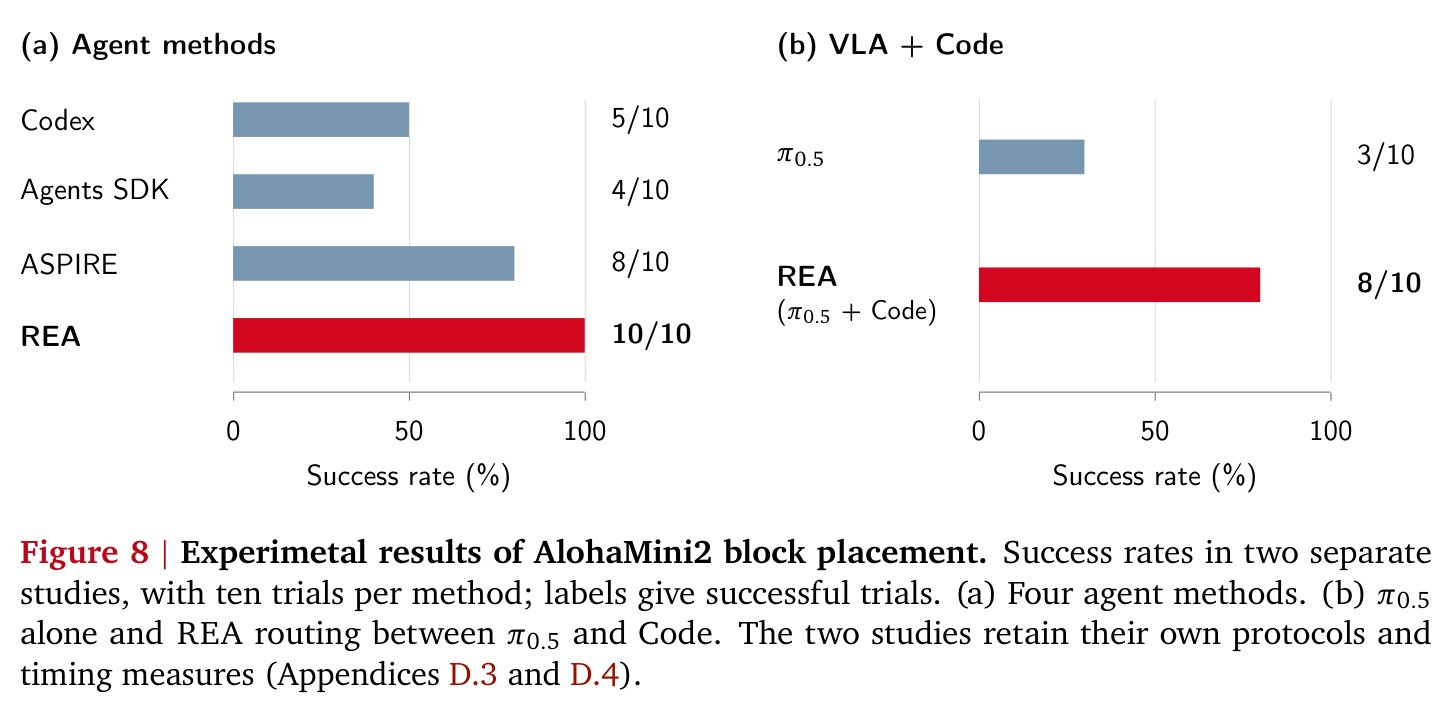
| 真机 AlohaMini2 积木放置(每法 10 次有效试验) | 成功率 | REA 10/10(平均用时 1,618.0 s) | ASPIRE 8/10、Codex 5/10、Agents SDK 4/10 | 控制器研究中 REA($\pi_0$.5+Code) 8/10 对 $\pi_0$.5 单独 3/10,放置失败 5→0 |
局限与改进
作者坦承:裁判门最终判定准确率(0.72 对永远答 done 的 0.67)几乎不比平凡基线好甚至更差,收益其实来自 done 判定的高精度与重跑通常无害,作者也说明这只是『一致的解释而非经检验的机制』;困难子集 +15.3% 里有 5/12 属于重放方差,无选择种子上的期望是 +3.1%;RoboTwin 200 场景同一配置两晚波动 36 个场景(97 vs 133),只有并排运行可比;BEHAVIOR-1K 对 Agents SDK 领先不显著($p=0.77$)且几乎全部来自 camera 一个任务;真机每法仅 10 次试验、统计功效低。我的补充观察:路径记忆需为每个候选跑 10 个开发回合,179 个程序耗 1,790 回合,池子扩大时成本线性增长且对任务分布漂移有冷启动问题;RoboTwin 的学习选择器每回合只在初始观测上选一次、中途不可换策略,运行内部的静默失败要等到返回边界才被发现;升级梯子只有三档,消融中 $K=1$ 封顶从未触界,更大池子的可扩展性未经检验。
独立分析的弱点
第一,路径记忆的建设成本与时效性:每任务每候选要花 10 个开发回合,候选池 179 个程序对应 1,790 个回合;任务分布一旦漂移(新物体、新环境扰动),表就会过时,需要周期性重测。改进方向:用少样本置信下界(如 UCB 准则替代 $\arg\max_p \hat{r}_{t,p}$ 的点估计)显式处理估计不确定性,或做在线 bandit 式更新。第二,裁判门的成本与误伤:每成功墙钟时间 2.1 倍,重跑会撤销约 5%(匹配集归因 9%)已成功的回合;对几乎不失败的强库异常门就足够,选哪扇门需在开发集上校准。可先用廉价启发式(状态差分、本体感知阈值)过滤明显 done 的回合再调视觉裁判。第三,回合级静态调度:RoboTwin 学习选择器 $q_p = \sigma(w_p^\top h_0 + b_p)$ 只在初始观测上打分一次并整回合锁定,无法响应回合内状态变化;段边界让出机制虽已实现但实验未用于中途换策略。第四,评测的窗口效应(两晚 36 场景漂移)与真机小样本削弱了部分迁移结论的统计强度,跨夜波动本身也值得单独研究。
未来方向
作者明确提出希望 REA 成为开发和比较具身大脑与快策略的共享平台,并把学习型选择器与查表式路径记忆统一到同一 Run 接口下。在此基础上可延伸:其一,把路径记忆升级为在线学习的路由器——用边界裁判的 done/not_done 标签做监督信号在线更新 $\hat{r}_{t,p}$,实现探索-利用平衡;其二,研究段边界(VLA 动作块、每 100 控制步暂停点)处的中途换策略,让异步建议真正在策略运行中生效,而非只在返回后;其三,校准或专门训练完成检测器,把裁判门 2.1 倍的每成功时间降下来,并研究噪声裁判的理论性质(何时高精度 done 判定足以补偿低召回);其四,与实时分块等推理-执行重叠技术结合,进一步压缩 VLA 的响应延迟;其五,把升级梯子推广到更多档位、按步数/时间的自适应预算分配,并在大规模策略池上验证路由表的可扩展性;其六,把对齐评测协议推广为社区标准,覆盖更多仿真器与真机。
复现评估
复现难度中等偏上。有利条件:项目页公开(mikeeeeeeeeeeeeee.github.io/REA/),附录极详尽——回合循环伪代码、裁判校准的 216 个开发标签、逐任务表与各基准协议都写明;基准(LIBERO-Pro、BEHAVIOR-1K、RoboTwin 2.0)与仿真器(MuJoCo/robosuite、Isaac Sim、SAPIEN)均公开;路径记忆很便宜——1,790 个仿真回合、零模型 token,复现核心消融只需仿真算力。不利条件:策略生成与裁判依赖 gpt-6-astra、Codex gpt-5.6-sol、jev-1.13.0、deepseek-flash 系列等内部或非公开命名的模型后端,第三方难以获得相同组合;真机需要 Unitree G1 与 AlohaMini2,多数实验室不具备;重建策略池需 29–89M 输入 token 与上千回合的 API 开销;RoboTwin 跨夜波动提示复现迁移数字必须并排对比。建议先在 LIBERO-Pro 上用公开 VLA 复现路由消融,再考虑全栈。
论文图表
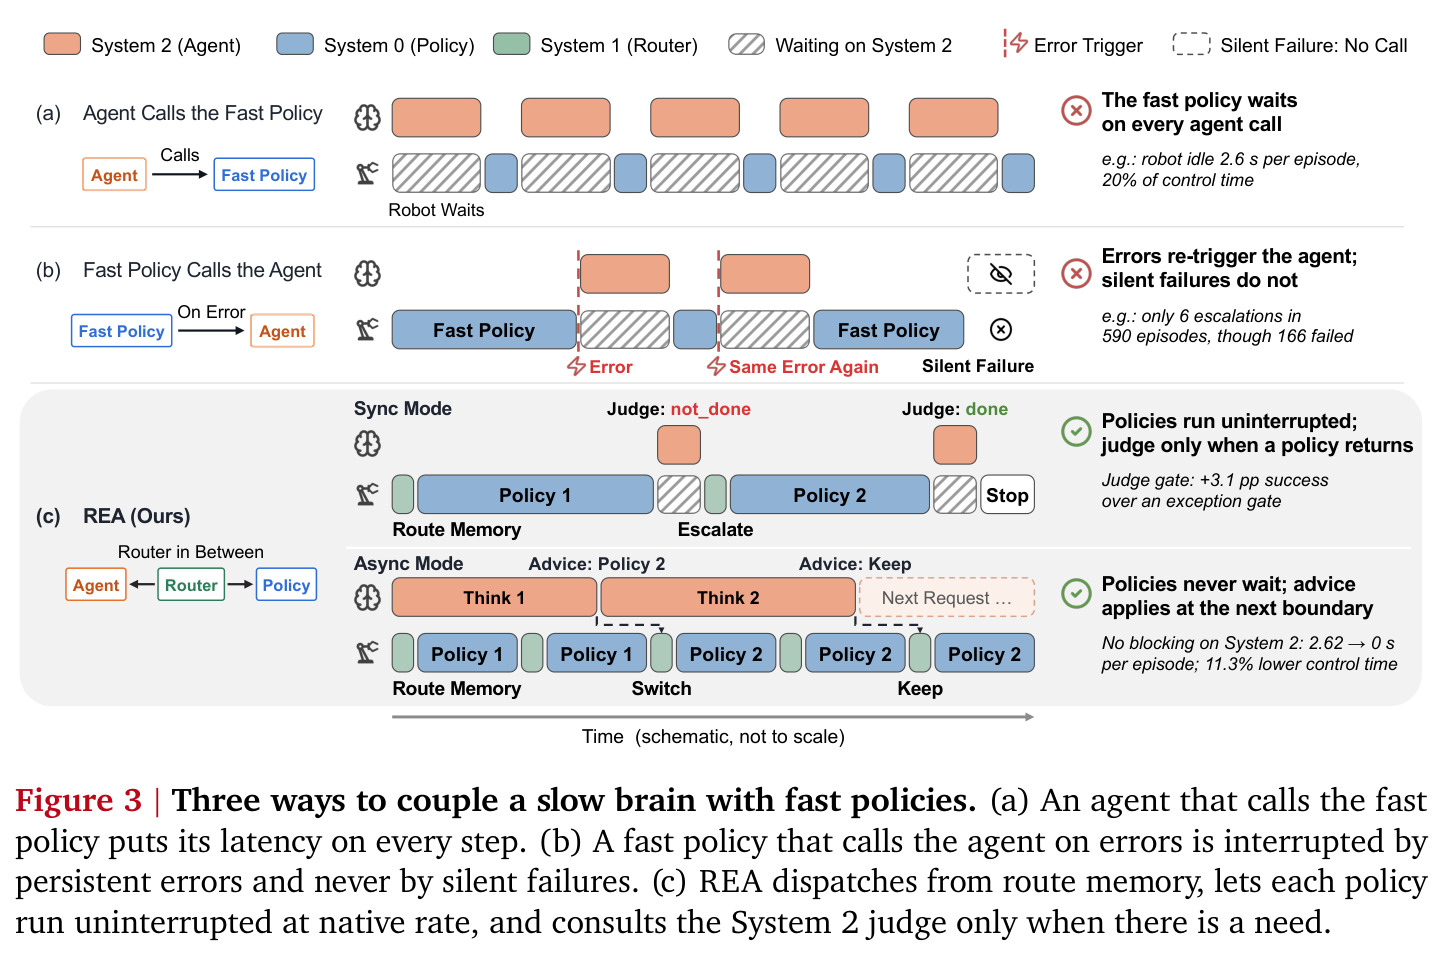
动机总览图,对比三种耦合方式:(a) 智能体调用快策略——快策略每个智能体决策都等待,机器人每回合空转 2.6 秒、占控制时间 20%;(b) 快策略出错才调用智能体——同一错误反复重触发大脑,静默失败从不触发(590 回合 166 次失败仅 6 次升级);(c) REA 路由器居中的异步模式——路径记忆调度、策略不间断原生运行、只在策略返回时问一次裁判门,done 停止并保护成果、not_done 升级;建议在下一个边界生效,System 2 等待从 2.62 秒降到 0,控制时间降低 11.3%。
论文动机的可视化精华:把两种既有耦合方式的量化缺陷(2.6 秒空等、6/166 的升级漏报)与 REA 解法并排呈现,是 Figure 4 实验的预告。