层级残差:残差宽度与计算宽度的极简解耦 Hierarchical Residuals: A Minimalist Decoupling of Residual Width from Compute Width
块级宽残差流解耦残差宽度与计算宽度,FLOPs效率提升1.30倍,仅需标准算子
前置知识
残差连接与 PreNorm/PostNorm
现代 Transformer 每个子层计算 $x_i = x_{i-1} + F_i(\mathrm{RMSNorm}(x_{i-1}))$,恒等路径把状态携带穿过深度。PreNorm 在分支内先归一化再相加,优化稳定但残差尺度随深度无界增长;PostNorm 在相加后归一化,能周期性控制激活尺度但可能衰减梯度。现代大模型几乎都用 PreNorm。
HiRes 的核心正是「块内 PreNorm + 块间 PostNorm」的两级组合,只有理解这两种归一化的经典权衡,才能明白它为何这样设计以及消融实验在验证什么。
神经缩放律(scaling law)
损失随训练计算量呈幂律下降,常用形式 $L(C)=L_\infty + A(C/C_0)^{-\alpha}$,其中 $L_\infty$ 是不可约损失、$\alpha$ 是指数。在多个模型规模上训练并拟合,可外推不同架构在等计算量下的损失差异,是架构比较的标准化工具。
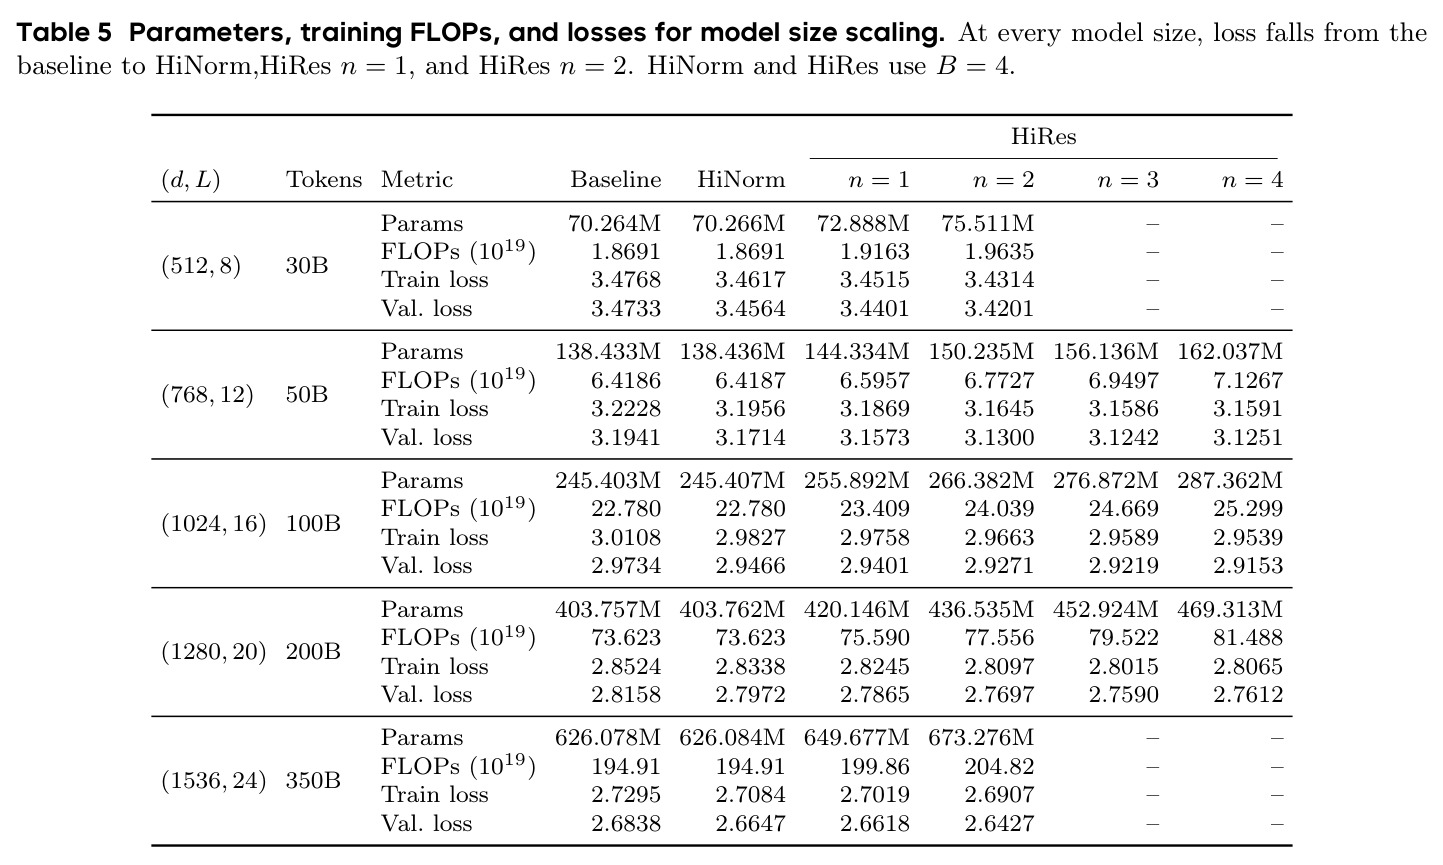
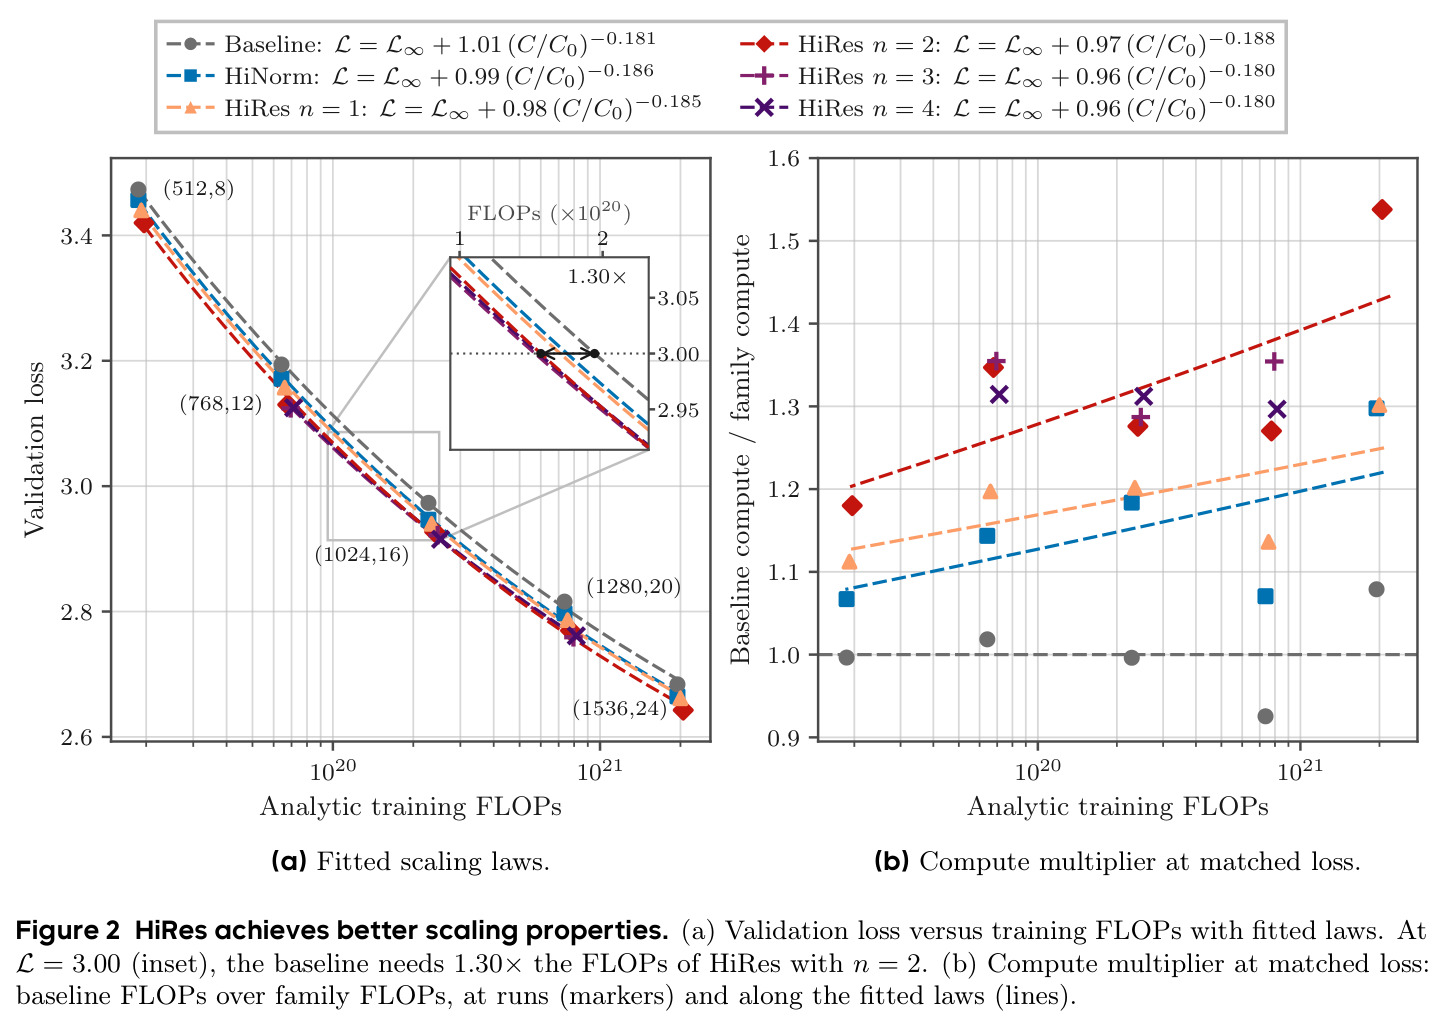
本文用损失-计算缩放律量化收益:HiRes n=2 的拟合指数从基线 0.181 提高到 0.188,达到验证损失 3.00 时基线需要 1.30 倍 FLOPs,这是论文最核心的结论。
残差扩展方法(HC/VWN/mHC/AttnRes)
一族把单条 $d$ 维残差流扩展为多条流或更宽状态的方法:Hyper-Connections(HC)用轻量投影学习逐层读写与混合权重;VWN 细分出更细粒度的分数流;mHC 把混合算子约束到双随机流形求稳;Attention Residuals 用跨深度注意力检索早层表示。它们的共同点是在每个子层都引入学习化混合算子。
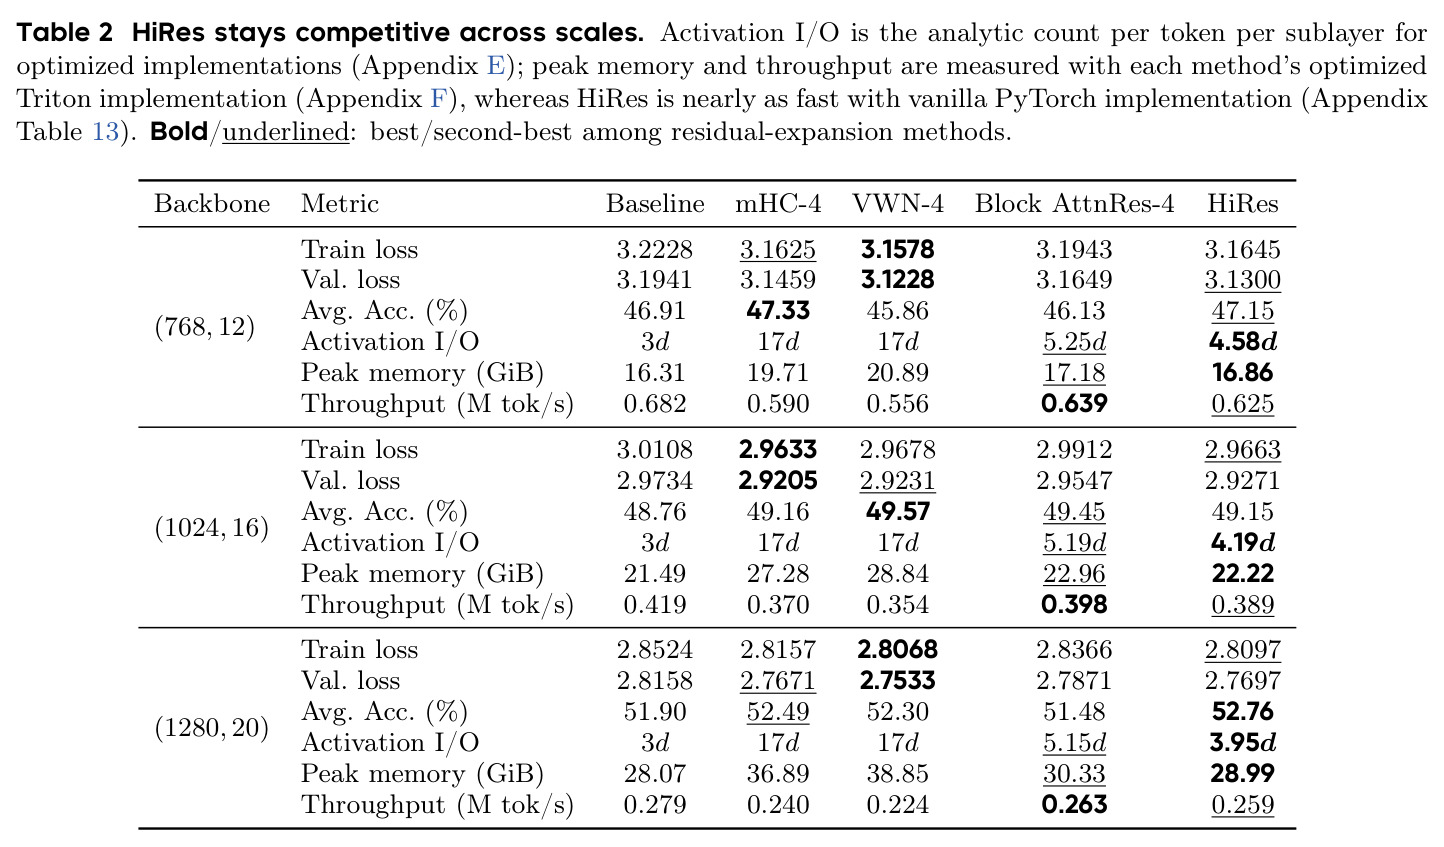
它们是 HiRes 的直接对照组。理解这些方法逐层混合带来的激活 I/O 与内存开销(如 mHC-4/VWN-4 每子层 17d),才能体会 HiRes「只在块边界用稠密投影」的差异化价值。
混合专家(MoE)
稀疏激活架构:每个 token 只路由到 top-k 个专家 FFN。OLMoE-1B-7B 有 64 个专家、top-8,总参数 6.9B 但每 token 仅激活 1.3B,可在固定计算预算下扩大参数容量。
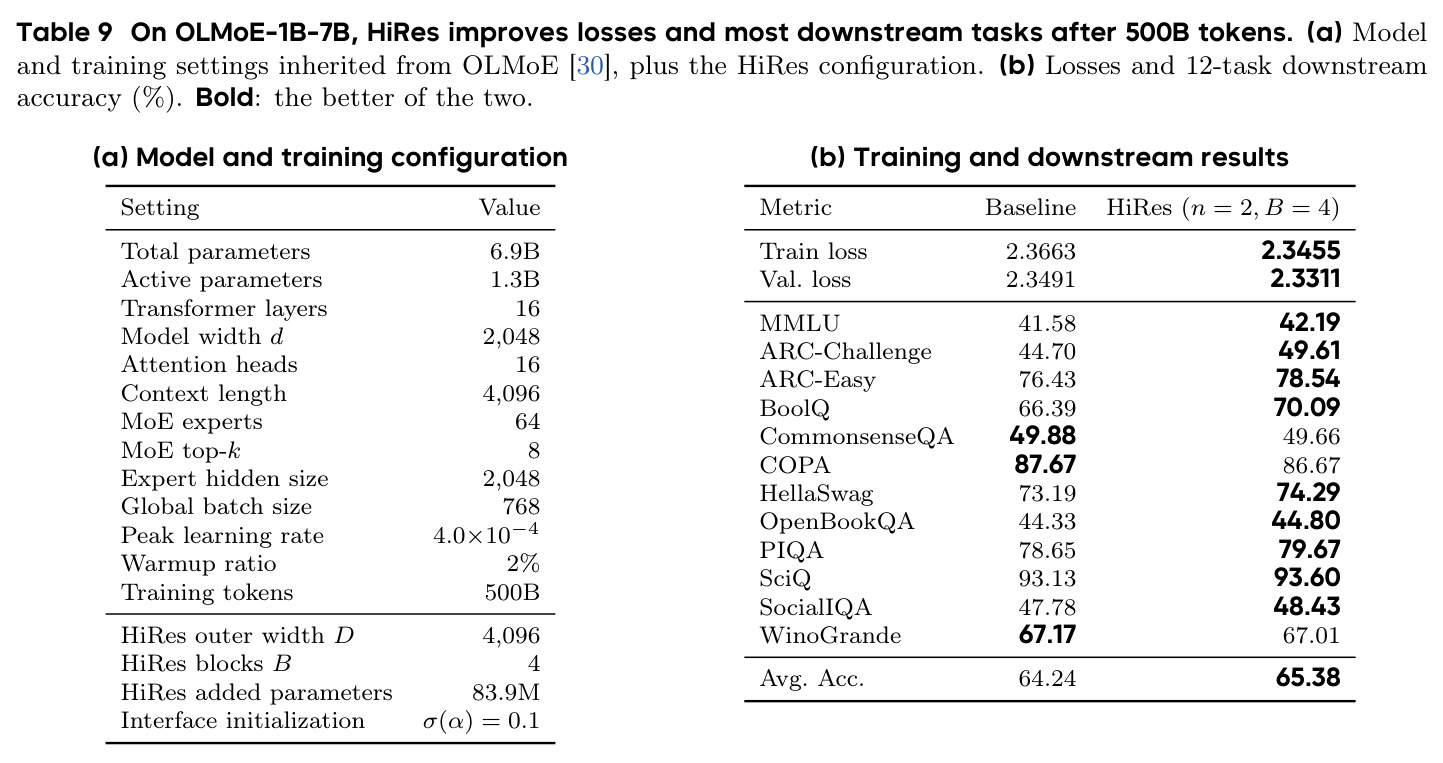
论文最有说服力的验证是在 OLMoE-1B-7B 上做 500B token 长程预训练;只有区分「总参数」与「激活参数」,才能读懂 HiRes 新增 83.9M 参数(占激活 6.5%、总参数 1.2%)的开销分析。
激活内存与 I/O
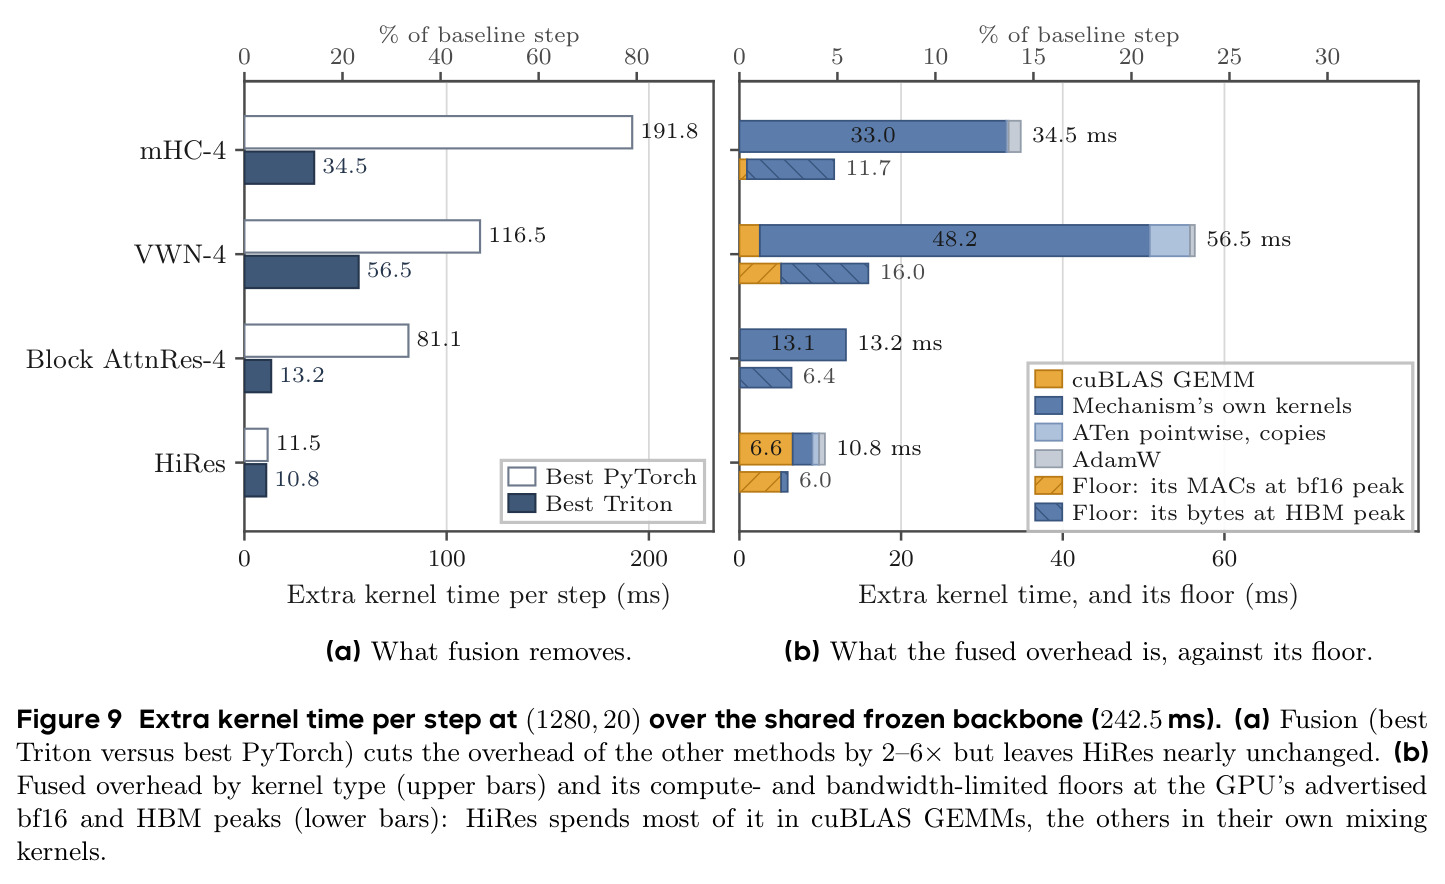
训练时反向传播需要保存和搬运的前向激活量。逐层混合残差的方法每个子层要多次读写扩展状态(基线每子层约 3d 个元素,mHC-4/VWN-4 达 17d),这类访存受限算子常成为吞吐瓶颈,需要算子融合、重计算或专用 Triton 内核来弥补。
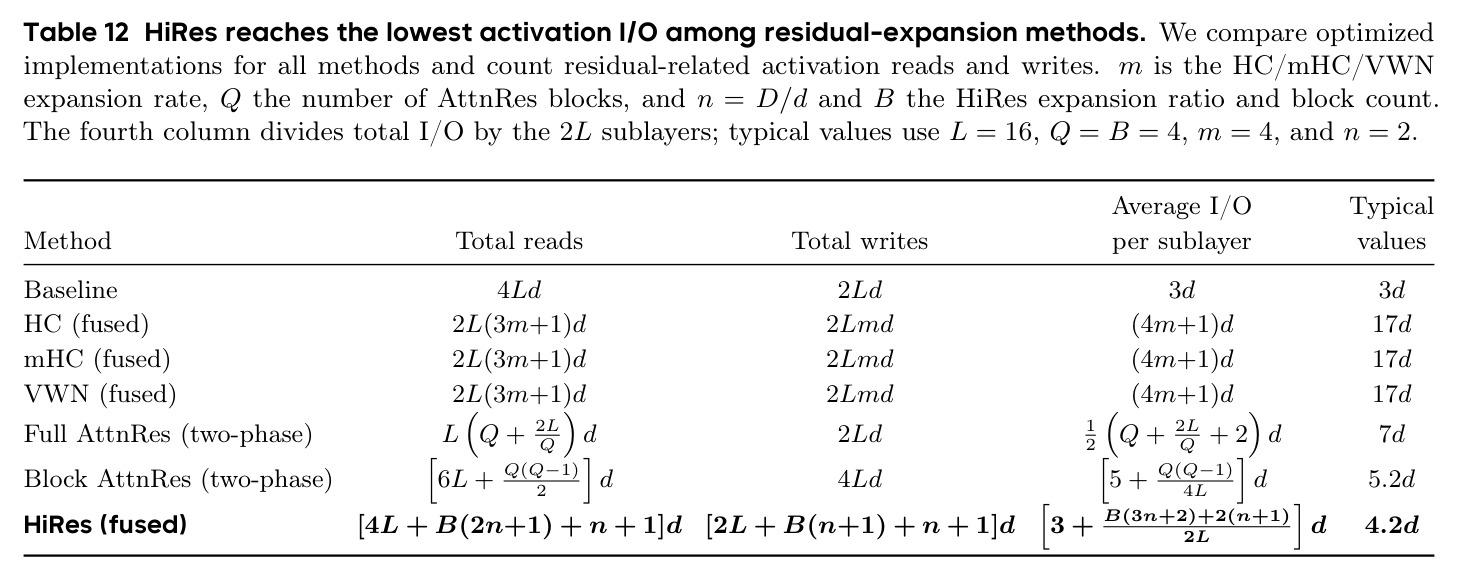
HiRes 的主要卖点之一是残差扩展方法中最低的激活 I/O(约 4.2–4.6d)且无需专用内核;附录 E/F 的大量效率分析都建立在这个概念上。
研究动机
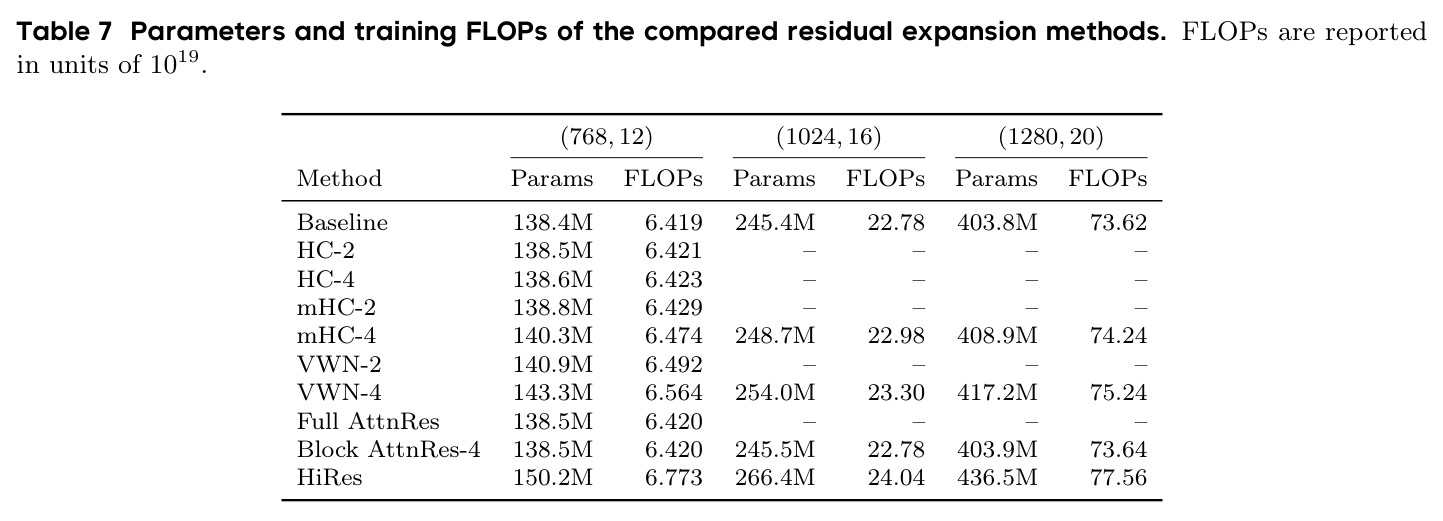
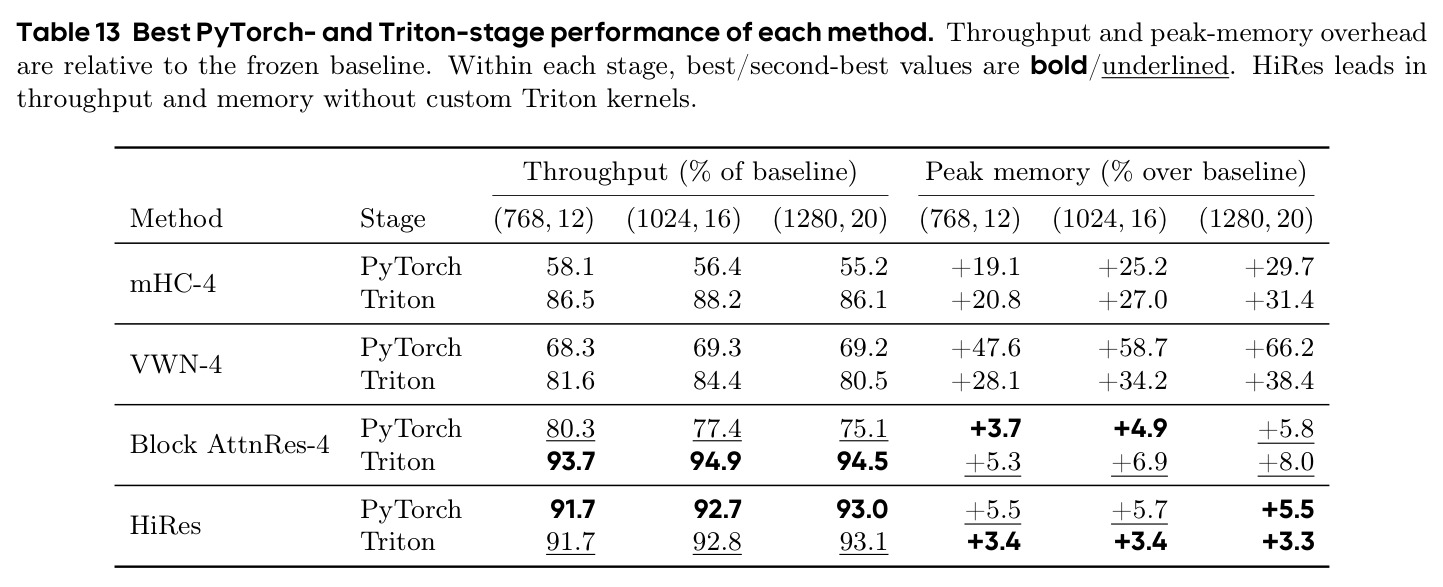
Transformer 的残差连接把「穿过深度携带的残差状态宽度」和「每层注意力/FFN 的工作宽度」绑定为同一个 $d$。近年一批残差扩展方法(AltUp、Hyper-Connections、VWN、mHC、Attention Residuals)证明:扩大有效残差状态并显式调节残差累积尺度,能持续降低损失——例如在 $(d,L)=(768,12)$、50B token 训练下,mHC-4 把验证损失从 3.1941 降到 3.1459,VWN-4 降到 3.1228。但它们的代价是把扩展和混合放到每一个子层:mHC-4/VWN-4 每子层的激活 I/O 高达 17d(基线仅 3d),属于访存受限算子,朴素 PyTorch 实现的吞吐只有基线的 58.1%(mHC-4)和 68.3%(VWN-4),必须依赖算子融合、重计算、专用 Triton 内核等基础设施级优化才能恢复速度。既然收益似乎来自「更宽的残差状态」本身而非特定混合算子,一个自然的问题是:能否用尽可能小的架构改动,直接获得更宽的残差状态?
本文的目标是本文的目标是把残差宽度 $D$ 从计算宽度 $d$ 中解耦出来:在不改动任何单个 Transformer 层内部计算的前提下,让模型携带一条更宽的残差状态穿过深度($D>d$),且每层计算宽度保持 $d$ 不变。工程上还有两个约束:只使用稠密线性投影、归一化、残差加法这类标准算子,不引入专用内核或系统级优化,使收益「开箱即用」;同时把收益的两个来源——残差尺度调节(regulation)与残差状态扩展(expansion)——干净地分离,给出各自贡献与合适超参(扩展比 $n=D/d$、块数 $B$)的量化答案。
与已有工作不同的是,已有方法的切入点是「改造每个子层的残差算子」:逐层学习读写与混合权重(HC/VWN/mHC)或跨深度注意力检索(AttnRes),接口多为共享权重或坐标分组的结构化矩阵,且每个子层都要访问扩展状态。HiRes 的独特角度是把解耦搬到「块」粒度:$L$ 层分成 $B$ 个块,块内是完全标准的 $d$ 维 PreNorm 层,块间才用 $D$ 维 PostNorm 外层残差连接;读写投影只在 $B$ 个块边界出现,把稠密接口的开销从 $\Theta(LDd)$ 摊销到 $\Theta(BDd)$。另一个差异是尺度调节方式:对手方法靠逐层学习到的混合隐式控尺度,HiRes 用块边界的 RMSNorm 显式复位外层尺度,从而让「调节」与「扩展」可以被独立消融。
核心方法
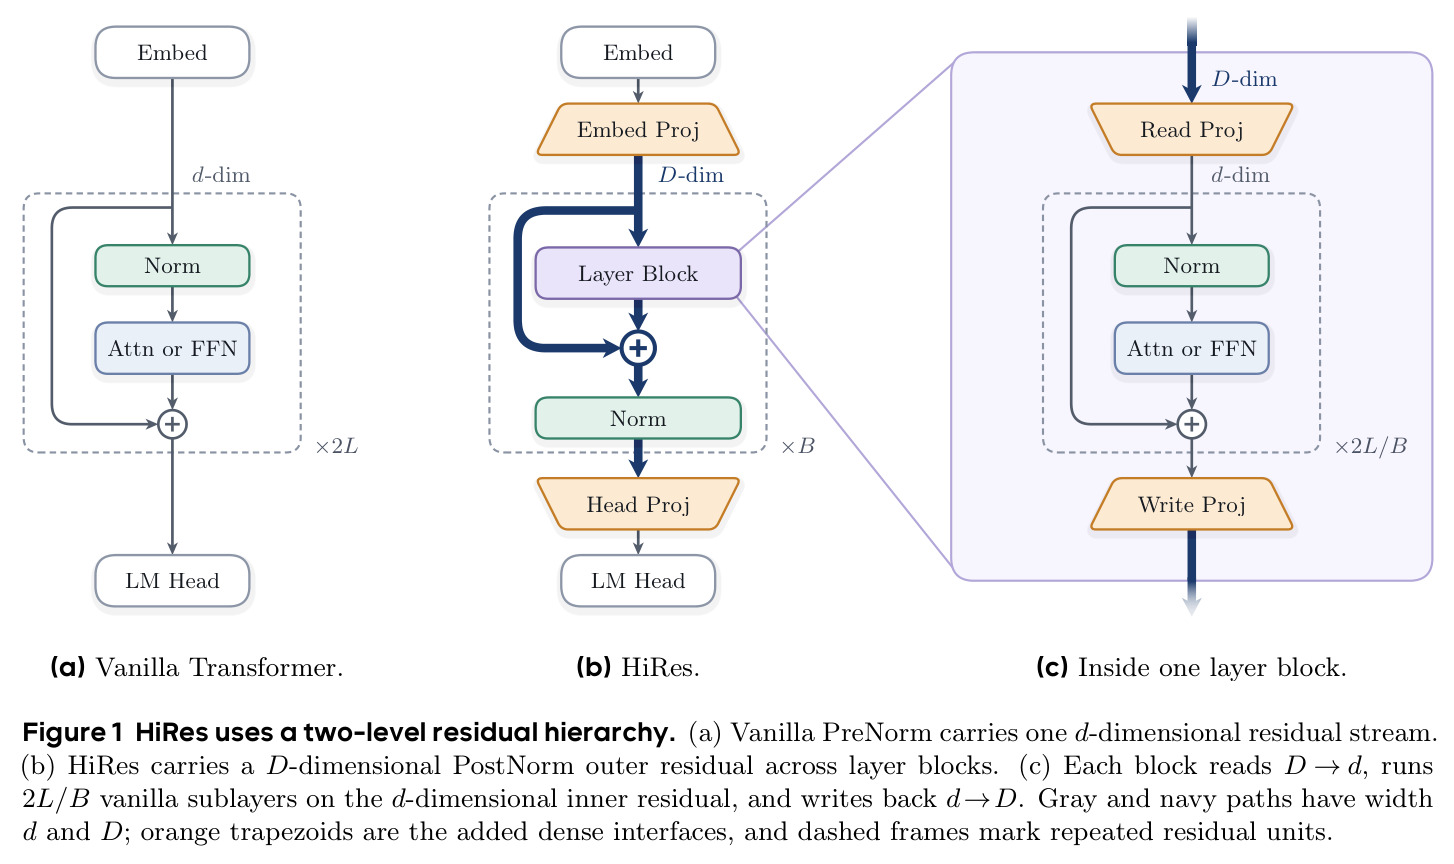
直觉上,HiRes 把 Transformer 变成「快慢变量」双层系统:块内每层在 $d$ 维窄空间里快速迭代计算(快变量),块间由一条 $D=nd$ 的宽状态(慢变量)携带累积信息跨块传递。每个块开头用读投影从宽状态拉出一个 $d$ 维子空间作为工作副本,块内跑若干普通 PreNorm 层,块尾用写投影把结果提交回宽状态并做 RMSNorm 复位尺度。技术路线:块内递推完全保持原版 $x_{b,i}=x_{b,i-1}+F_{b,i}(\mathrm{RMSNorm}_{b,i}(x_{b,i-1}))$;块间递推为 $x_{b,0}=R_b h_{b-1},\ \ h_b=\mathrm{RMSNorm}_b\big(h_{b-1}+W_b\Phi_b(x_{b,0})\big)$,其中 $\Phi_b$ 是块内残差递推的复合,$R_b\in\mathbb{R}^{d\times D}$、$W_b\in\mathbb{R}^{D\times d}$ 为稠密投影;嵌入经 $E\in\mathbb{R}^{D\times d}$ 升维进入外层状态,LM head 前经 $H\in\mathbb{R}^{d\times D}$ 读回。默认配置 $n=2$、$B=4$。
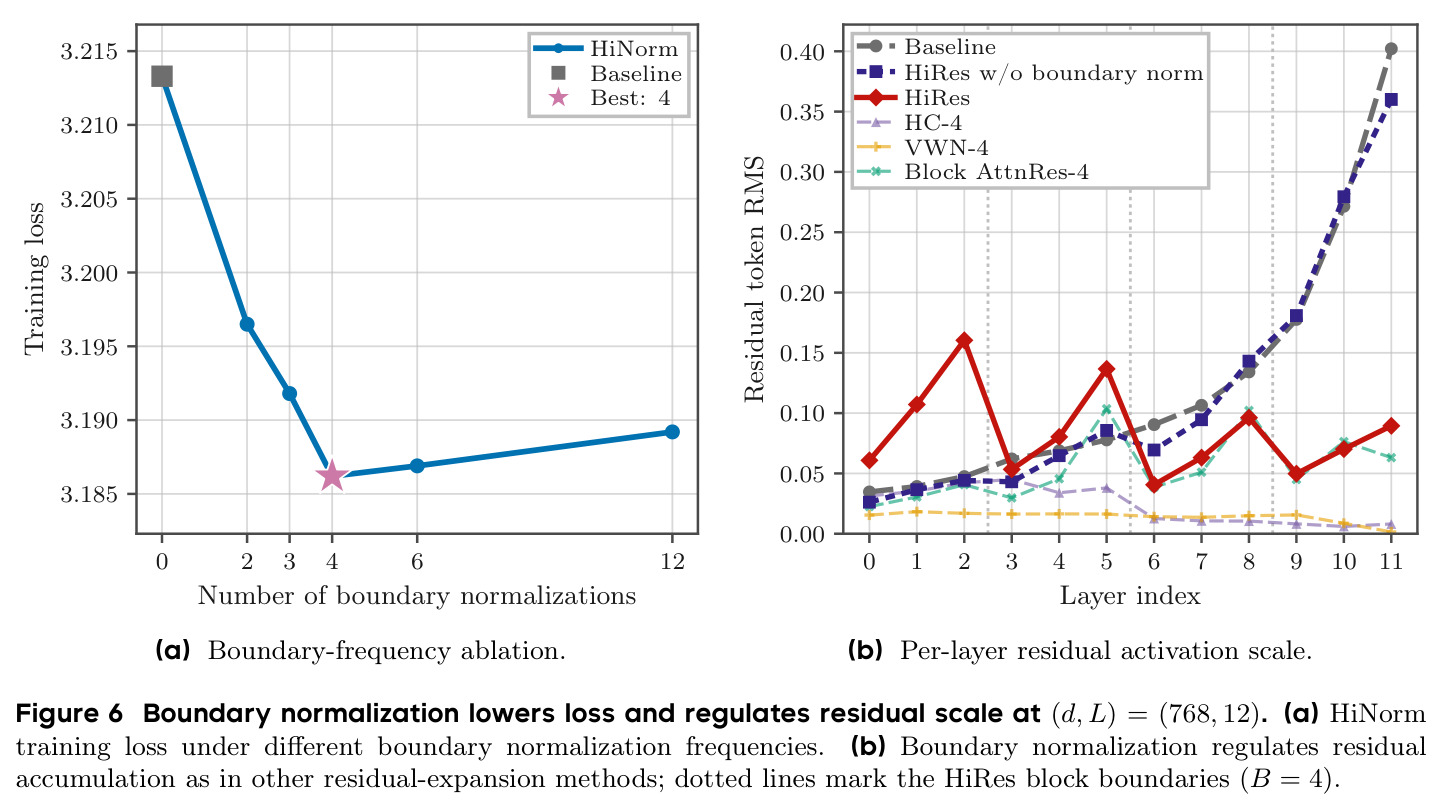
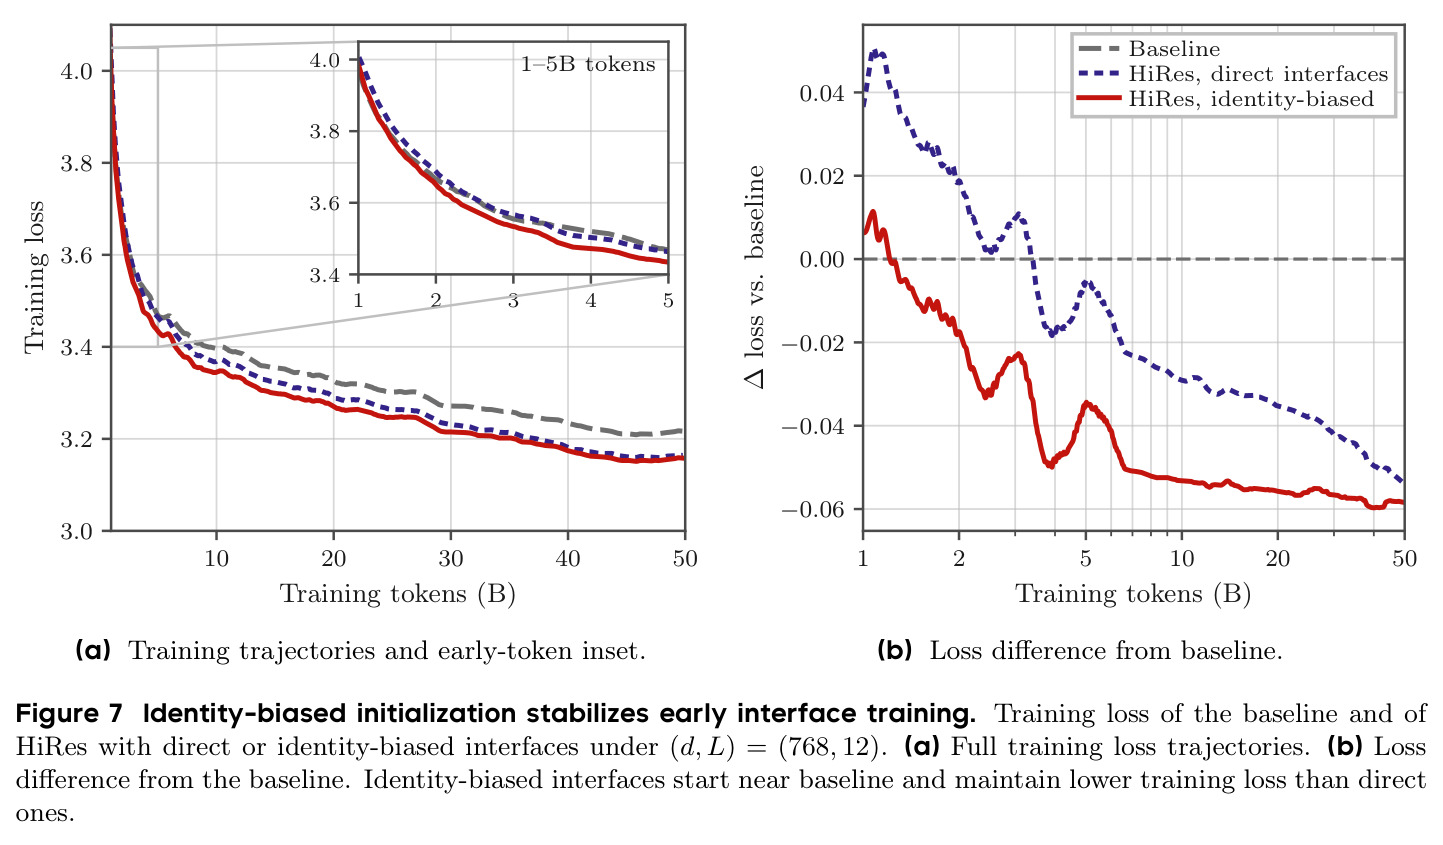
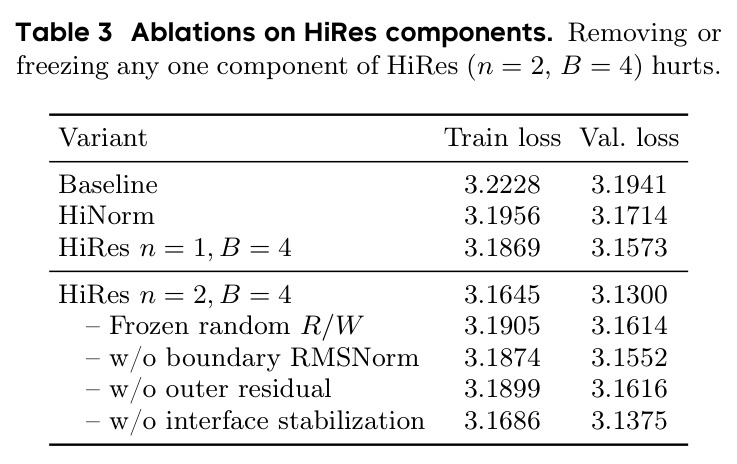
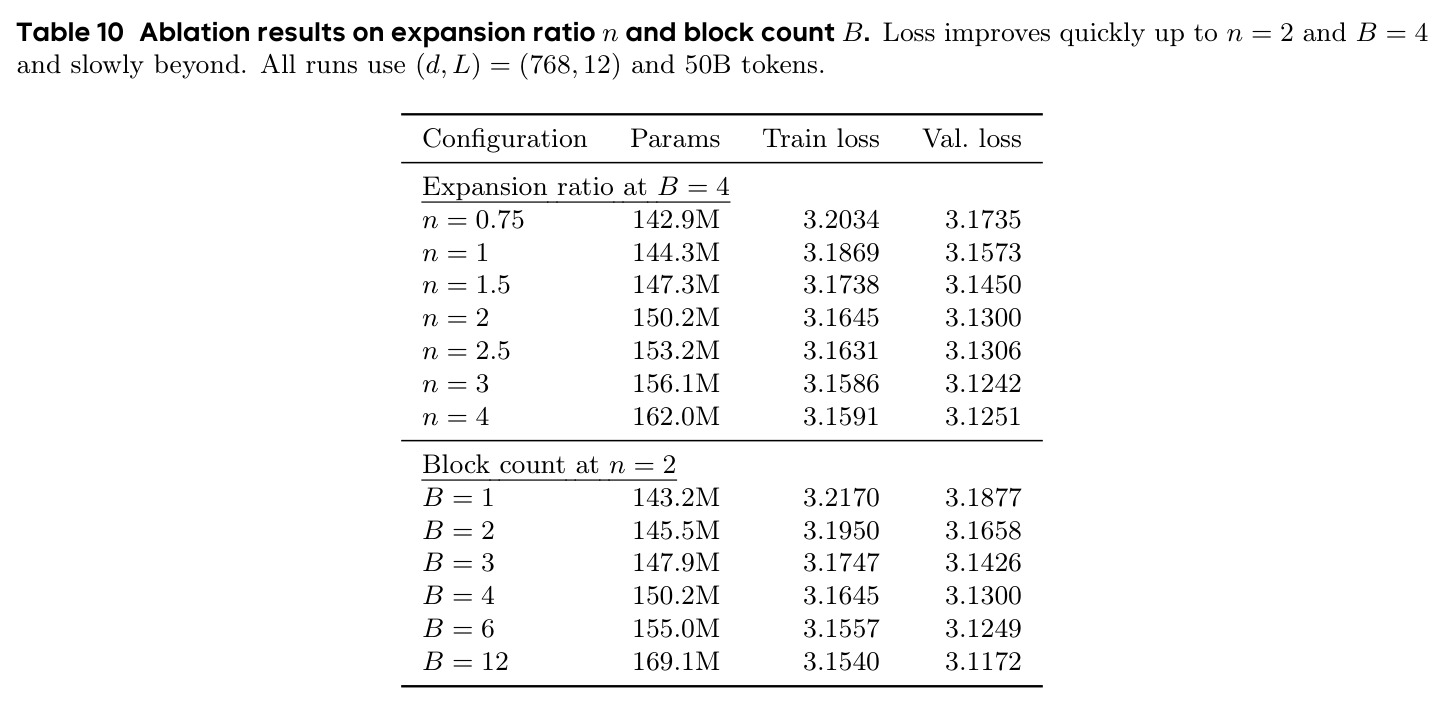
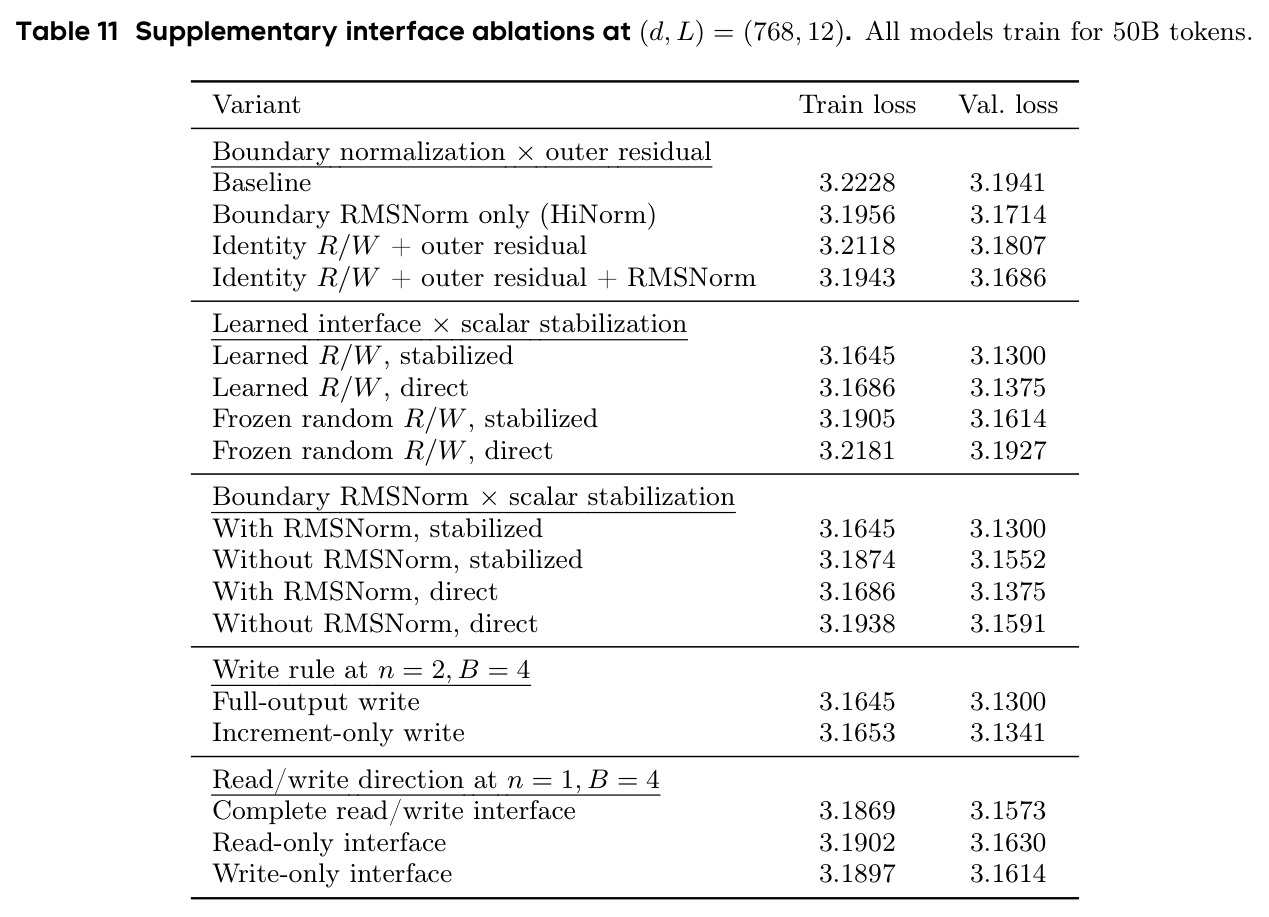
核心创新是把「残差宽度」从「计算宽度」中剥离,变成一个可独立调节的架构缩放变量。与 HC/VWN/mHC 每个子层都做学习化混合不同,HiRes 只在块边界放置两个最一般的稠密线性接口 $R_b$、$W_b$——刻意不施加权重共享等结构偏置,用最小的改动获得扩展状态与工作空间之间的全连接;配合块边界 PostNorm 显式控尺度,HiNorm 对照实验证明仅边界归一化一项就能把基线验证损失从 3.1941 降到 3.1714。当 $D=d$、$R_b=W_b=I$ 时严格退化为原版残差,说明这是原架构的最小扩展。接口还用可学习标量门做恒等偏置:$R_b=(1-\sigma(\alpha_{R_b}))\Pi+\sigma(\alpha_{R_b})\hat R_b$($\Pi$ 为截取前 $d$ 维的截断矩阵,$\sigma(\alpha)$ 初始化 0.1),让接口先近似恒等、再逐渐特化,避免早期「接口学习坐标系、内层坐标系又被接口搅动」的跷跷板效应。
方法步骤详情
完整前向流程(对应附录 Algorithm 1):(1) 词嵌入后经升维投影得初始外层状态 $h_0=E\,\mathrm{Embed}(t)\in\mathbb{R}^D$。(2) 对每个块 $b=1,\dots,B$:读投影 $x_{b,0}=R_b h_{b-1}$ 把宽状态映射到 $d$ 维工作空间。(3) 块内连续跑 $2\ell_b$ 个标准 PreNorm 子层(attention 与 FFN 各 $\ell_b$ 个),递推 $x_{b,i}=x_{b,i-1}+F_{b,i}(\mathrm{RMSNorm}_{b,i}(x_{b,i-1}))$,复合记为 $\Phi_b$。(4) 写回:$h_b=\mathrm{RMSNorm}_b(h_{b-1}+W_b\Phi_b(x_{b,0}))$——块输出经写投影升回 $D$ 维,加到外层残差上再做 PostNorm 式归一化。(5) 全部块结束后 $x_{\mathrm{final}}=H h_B$ 读回 $d$ 维,接最终归一化与 LM head。接口按公式 (7) 的恒等-学习插值参数化,标量 $\sigma(\alpha)$ 初值 0.1。开销:新增参数 $\Delta P=2BdD+2dD+BD+(2B+2)$,训练 FLOPs 增量约 $12N_{\mathrm{train}}(B+1)dD$,激活内存只多存 $B+1$ 个边界外层状态;OLMoE-1B-7B($d{=}2048,D{=}4096,B{=}4$)合计新增 83.9M 参数。模型 forward 改动不足十行代码。
技术新颖性
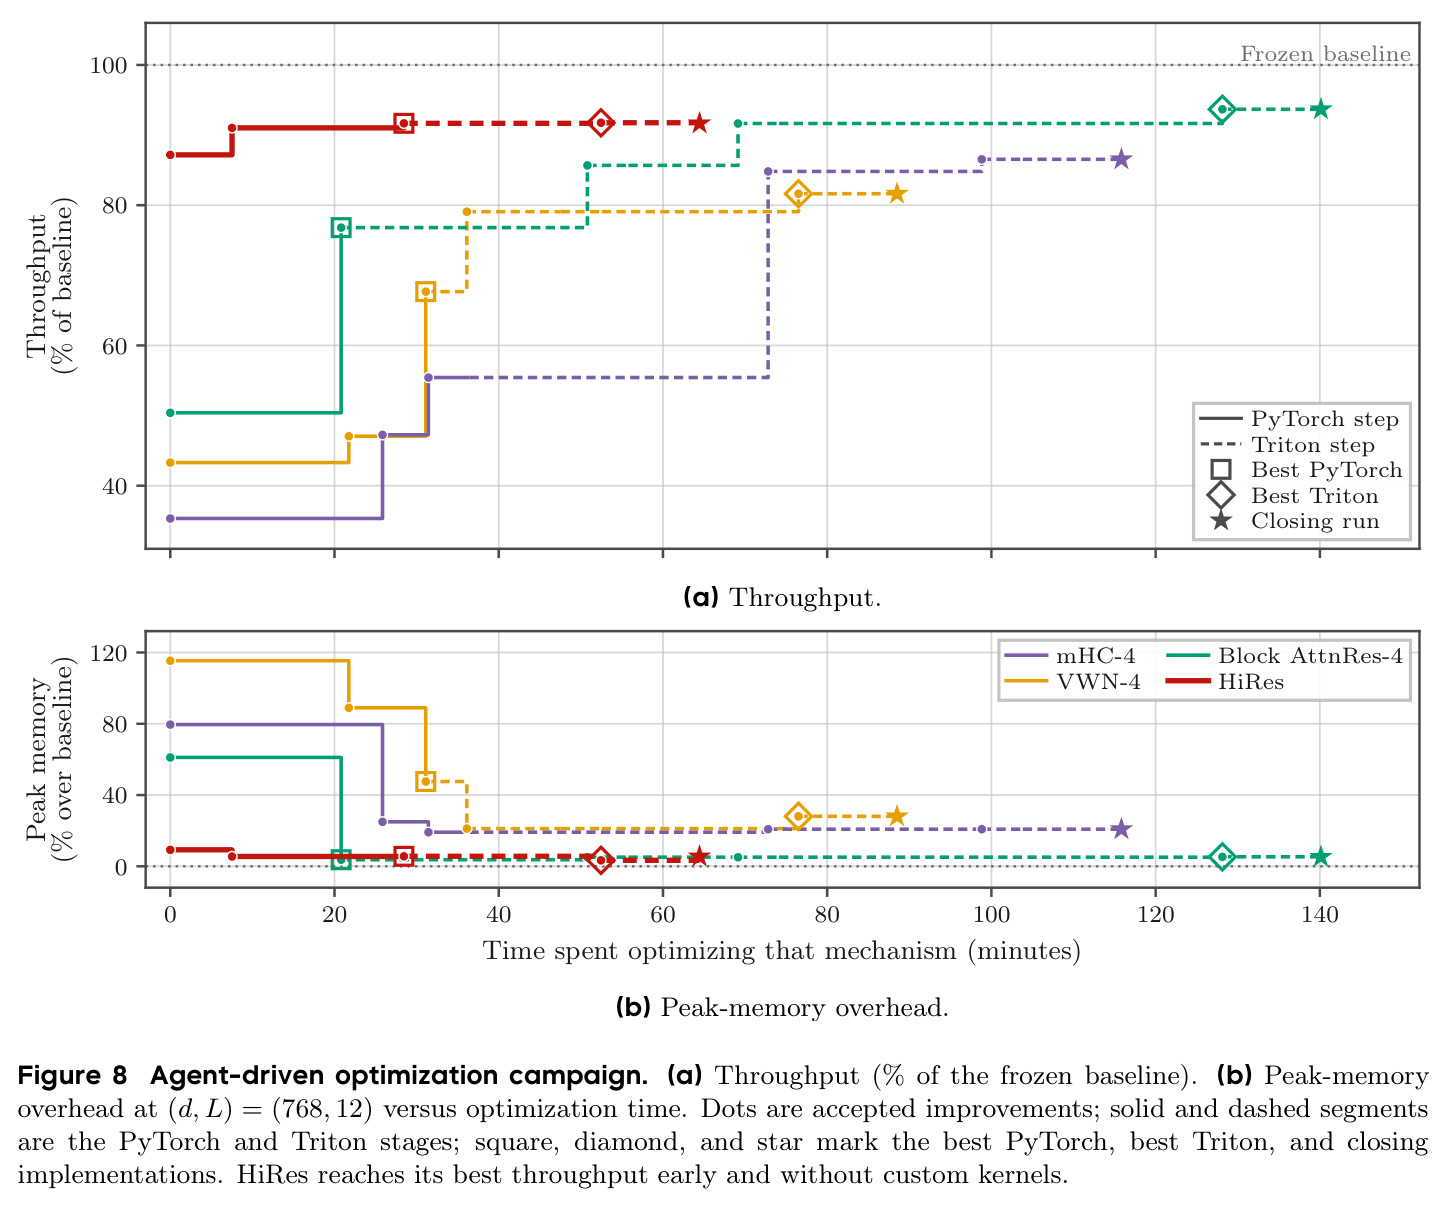
新颖性有三层。(1) 粒度新颖:残差扩展的既有工作(AltUp/HC/VWN/mHC/AttnRes)都在子层粒度引入学习算子,HiRes 首次把扩展状态与逐层计算完全分离到块粒度,用摊销思想让「最一般」的稠密接口变得可负担——稠密接口单看参数最多,但出现频率从 $2L$ 降到 $B$,总开销 $\Theta(BDd)$ 远小于 $\Theta(LDd)$。(2) 调节机制新颖:把 PostNorm 从每层移到每块边界,兼得 PreNorm 的反向传播稳定性与 PostNorm 的前向尺度控制;HiNorm 与等宽 HiRes(n=1)两个对照干净分离了「调节」与「扩展」的贡献(图 2、表 3)。(3) 工程新颖:它是唯一纯 PyTorch 实现即接近最终吞吐的残差扩展方法——agent 驱动优化实验(附录 F)显示 HiRes 的 PyTorch 版已达基线的 91.7–93.0%,而 mHC-4 需 Triton 才能从 58.1% 提到 86.5%。此外附录 G 给出对偶视角:残差扩展 $n$ 倍等价于相对 $D$ 维持久状态把计算宽度压缩 $n$ 倍,与 MLA、LatentMoE 的模块级潜空间设计形成呼应。
实验结果
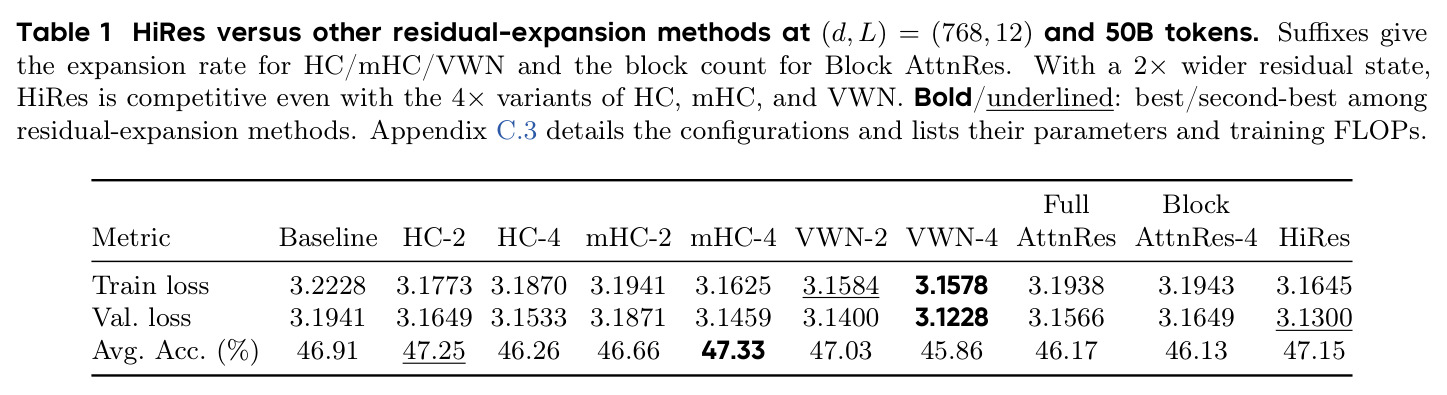
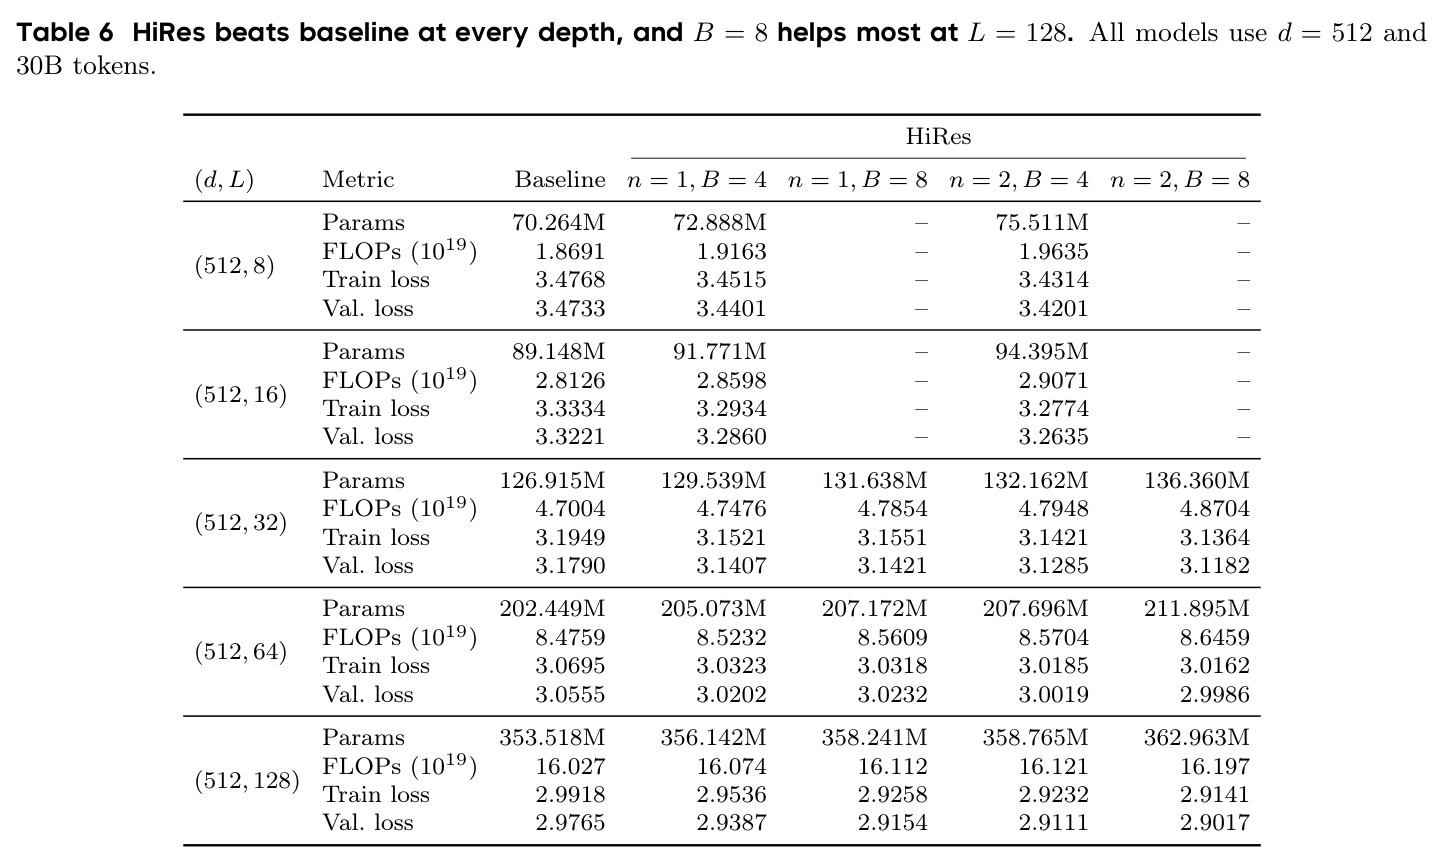
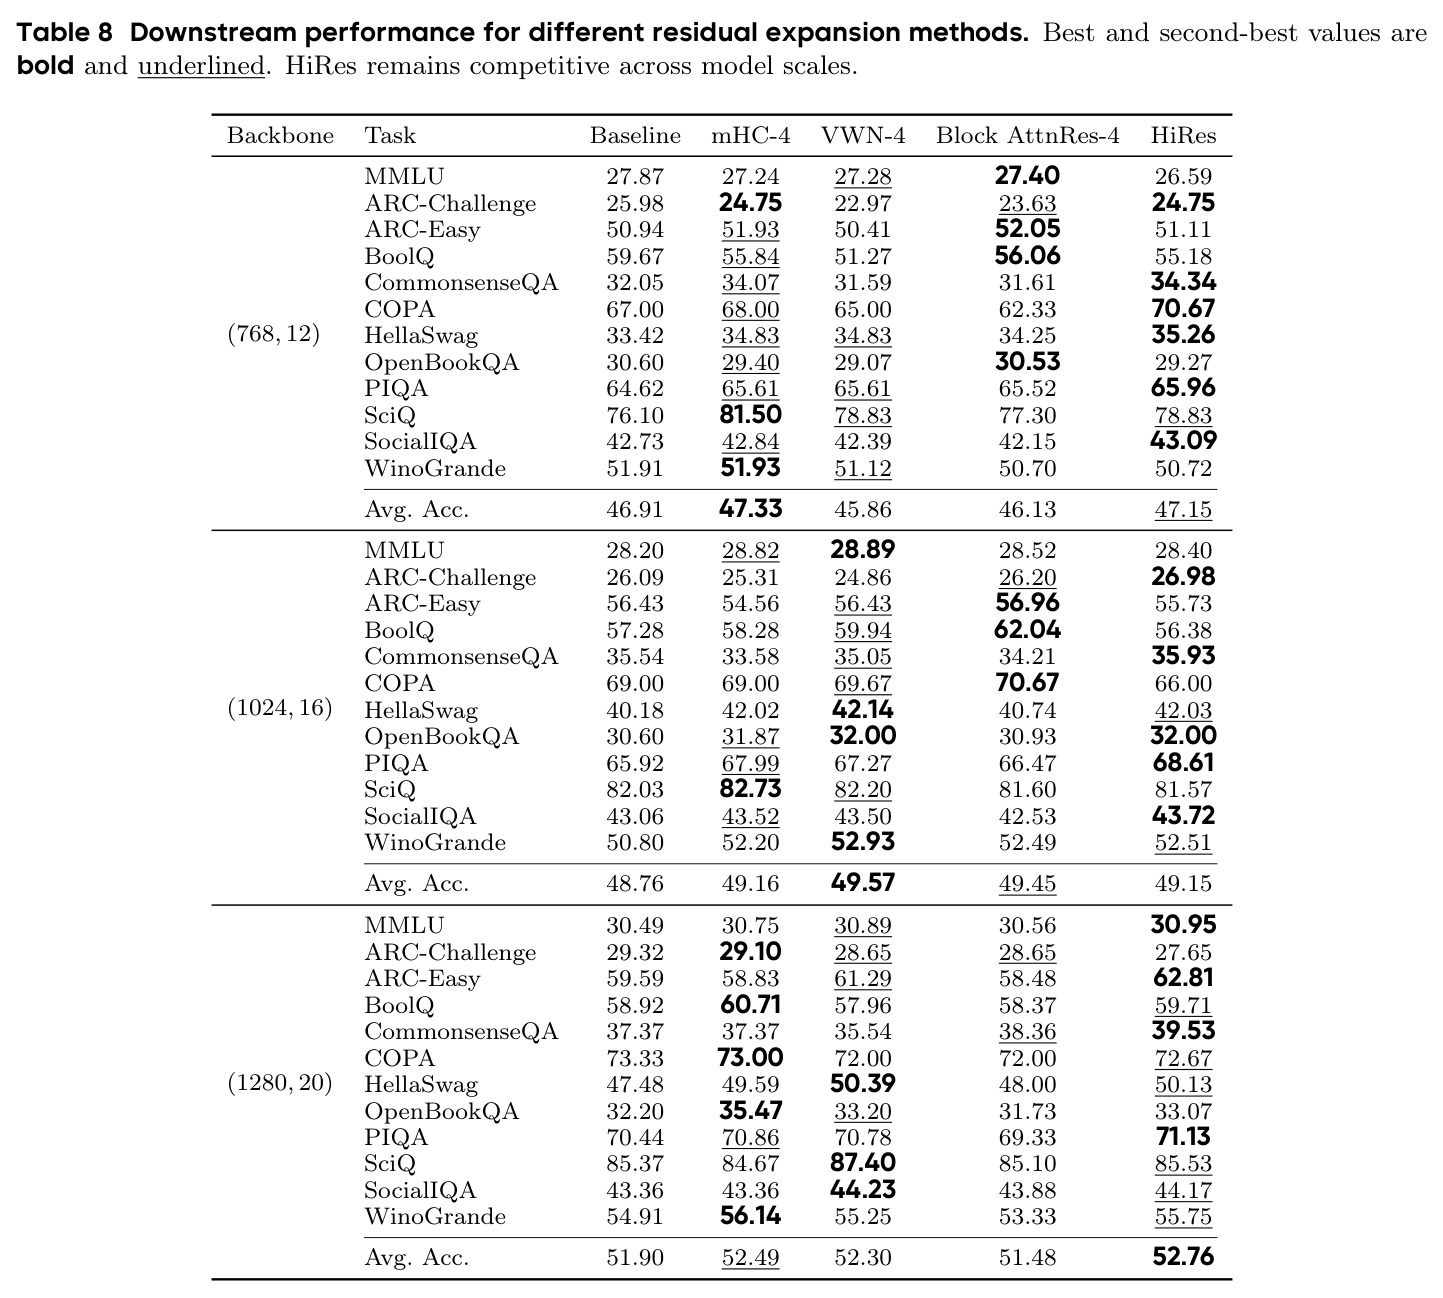
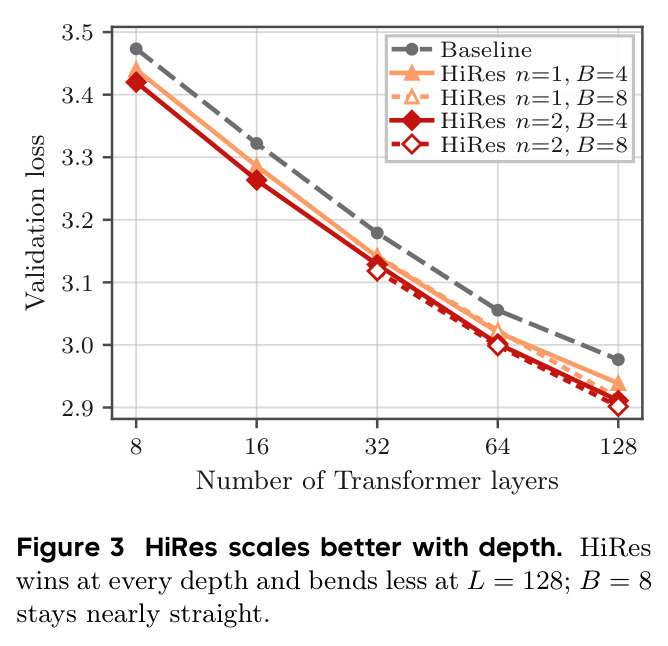
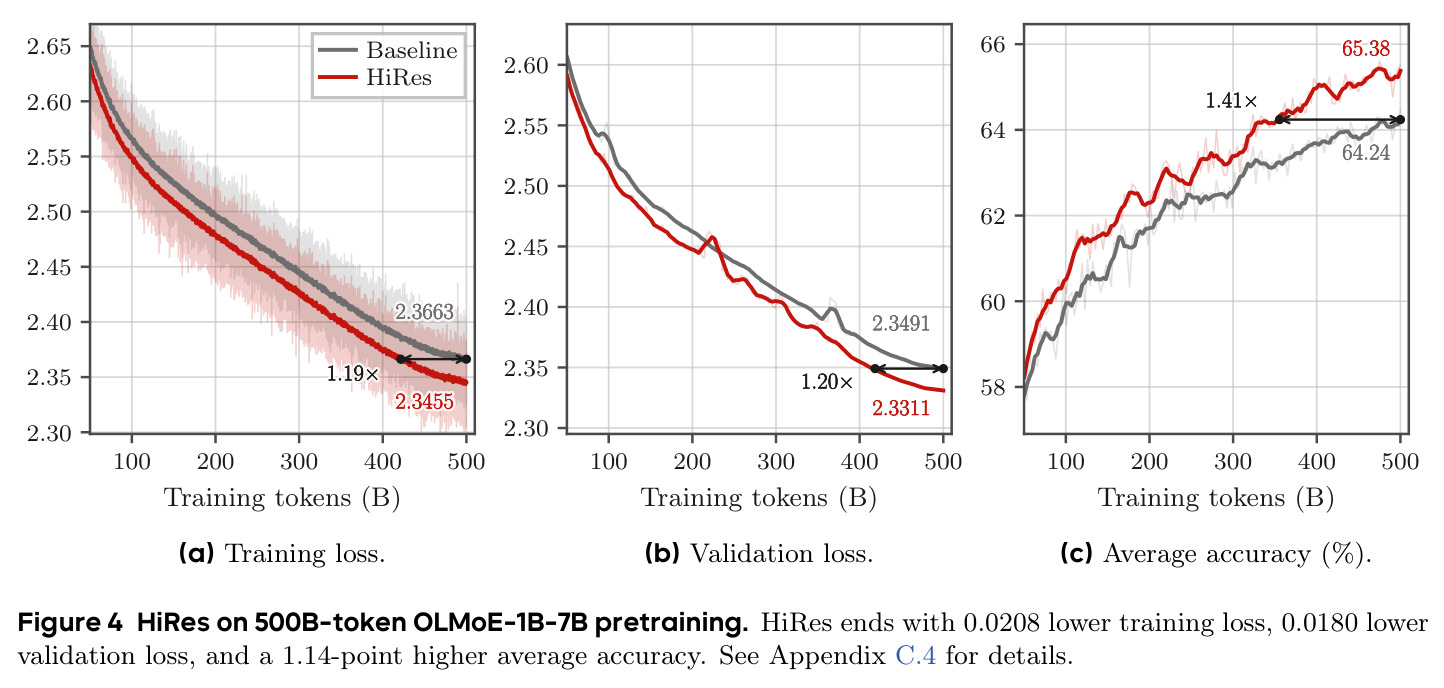
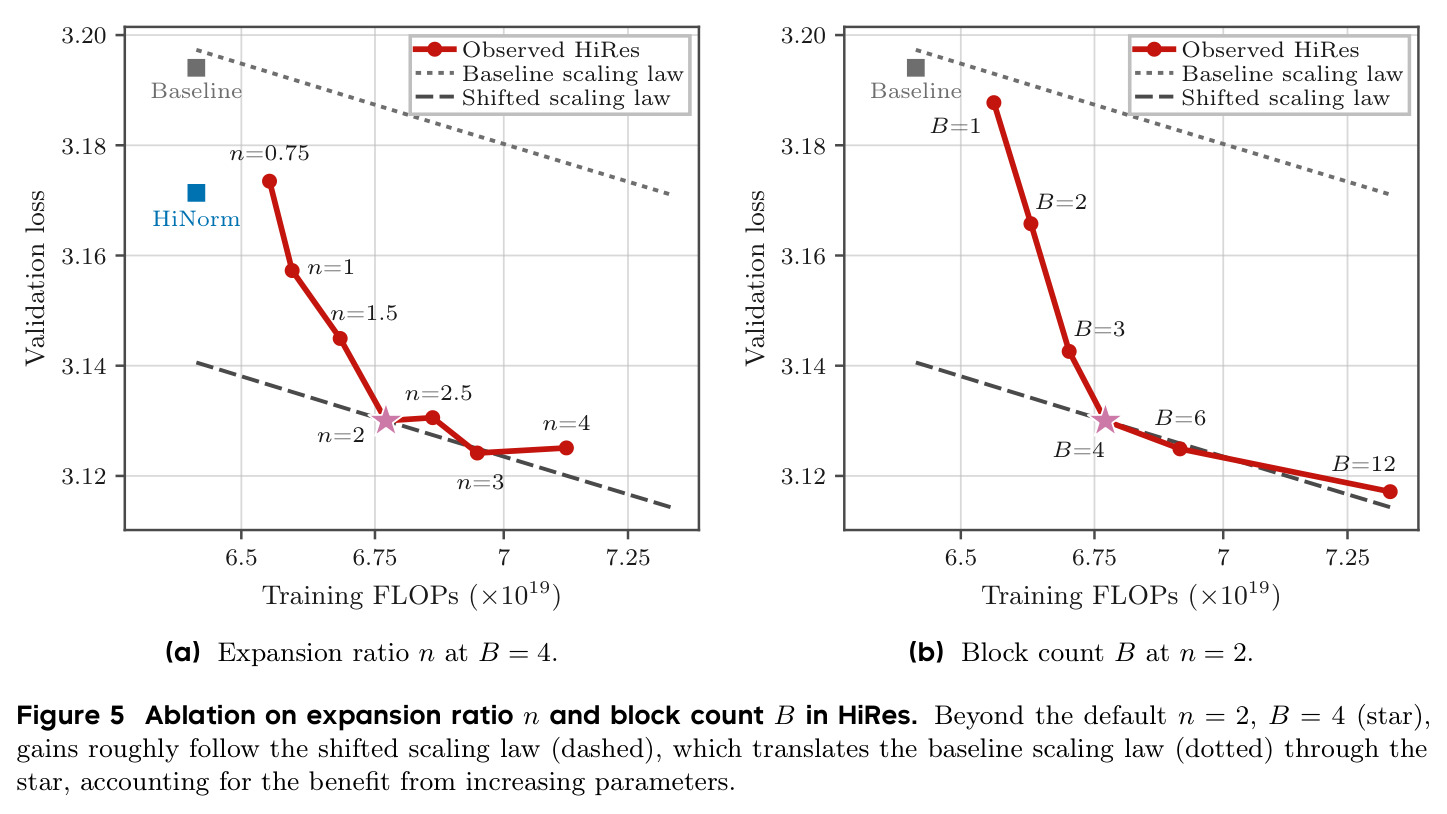
(1) 模型规模缩放:五个规模从 $(d,L)=(512,8)$ 到 $(1536,24)$(70M–626M 参数,30B–350B token),拟合 $L(C)=L_\infty+A(C/C_0)^{-\alpha}$($C_0{=}10^{20}$,$L_\infty{=}2.101$):基线指数 0.181,HiRes n=2 达 0.188;达到验证损失 3.00 时基线需 1.30× HiRes 的 FLOPs。增益可分解:HiNorm(仅边界归一化)整体下移曲线,n=2 再叠加增益,n=3/4 边际递减,n=1≈HiNorm。(2) 深度缩放($d{=}512$ 固定,30B token,$L$ 从 8 到 128):HiRes 每个深度都赢;基线在 L=128 出现收益衰减,HiRes B=8 时缩放曲线近乎直线(L=128 验证损失 2.9017 vs 基线 2.9765)。(3) 方法对比((768,12),50B token):HiRes 验证损失 3.1300,优于 HC-4(3.1533)、mHC-4(3.1459)、Full AttnRes(3.1566),仅次于 VWN-4(3.1228)但 I/O 约为后者四分之一;平均下游精度 47.15 仅次于 mHC-4(47.33);在最大规模 (1280,20) 上 HiRes 以 52.76% 平均精度居首。(4) 效率:HiRes 激活 I/O 为 3.95–4.58d/子层(基线 3d、mHC/VWN-4 17d、Block AttnRes-4 约 5.2d),扩展方法中最低;Triton 实现保留基线 91.7–93.1% 吞吐、显存仅 +3.3–3.4%;纯 PyTorch 已达 91.7–93.0%。(5) OLMoE-1B-7B、500B token:训练损失 2.3455 vs 2.3663(−0.0208),验证损失 2.3311 vs 2.3491(−0.0180),12 任务平均精度 65.38 vs 64.24(+1.14 点),其中 ARC-Challenge +4.91(49.61 vs 44.70)、BoolQ +3.70(70.09 vs 66.39)。(6) 消融:n=2 与 B=4 是质量-开销曲线的膝点;冻结随机读写 +0.031、去边界归一化 +0.025、去外层残差 +0.032、去接口稳定 +0.008(验证损失);n=0.75(外层比计算更窄)是唯一不敌 HiNorm 的设置,证明增益主要来自残差宽度本身。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 模型规模缩放(70M–626M,30B–350B token) | FLOPs 效率(达到验证损失 3.00) | HiRes n=2 所需 FLOPs 记为 1.0× | vanilla 残差基线需 1.30× HiRes 的 FLOPs | 1.30× FLOPs 效率提升 |
| OLMoE-1B-7B 预训练(500B token) | 训练损失 | 2.3455 | 2.3663 | −0.0208 |
| OLMoE-1B-7B 预训练(500B token) | 验证损失 | 2.3311 | 2.3491 | −0.0180 |
| OLMoE-1B-7B 下游 12 任务平均准确率 | Avg Acc (%) | 65.38 | 64.24 | +1.14 点 |
| (768,12)、50B token 与 HC/mHC/VWN/AttnRes 对比 | 验证损失 | 3.1300(n=2, B=4) | 3.1941(基线);mHC-4 3.1459;VWN-4 3.1228;HC-4 3.1533 | 较基线 −0.0641,与 4× 扩展的 mHC/VWN 相当 |
| (1280,20)、200B token 方法对比 | 下游平均准确率 (%) | 52.76 | 51.90(基线)/ 52.49(mHC-4)/ 52.30(VWN-4) | 对比方法中最高 |
| 深度缩放(d=512,L=128,30B token) | 验证损失 | 2.9017(n=2, B=8) | 2.9765 | −0.0748,且缩放曲线保持近直线 |
| 激活 I/O(每 token 每子层,优化实现) | 元素数(以 d 计) | 3.95–4.58d | 基线 3d;mHC-4/VWN-4 17d;Block AttnRes-4 约 5.2d | 残差扩展方法中最低 |
| 训练吞吐(Triton,(1280,20)) | 相对基线吞吐 / 峰值显存 | 93.1% / +3.3% | 100% / 基线;mHC-4 86.1% / +31.4%;VWN-4 80.5% / +38.4% | 扩展方法中显存开销最低、吞吐仅次于 Block AttnRes-4 |
| 纯 PyTorch 实现(无定制内核) | 相对基线吞吐 | 91.7–93.0% | mHC-4 55.2–58.1%;VWN-4 68.3–69.3%;Block AttnRes-4 75.1–80.3% | 无需 Triton 融合即接近最终性能 |
局限与改进
作者承认三点局限:其一,尚未在固定计算预算下联合优化 $d$、$D$、$L$ 的容量分配,「多少宽度用于携带表征、多少用于变换」仍无答案;其二,块大小均匀,未探索网络不同部位是否需要不同的宽状态访问频率;其三,更宽的残差状态为何有效仍是开放问题——跨块保存了什么信息、各子层如何变换与复用它,都缺乏理解。我的补充观察:(a) 结构超参(n=2、B=4)都是在 (768,12)、50B token 一个规模上找到的膝点,更大规模或不同数据分布下膝点可能漂移;(b) 对比方法的 I/O 数字是作者自构融合调度的分析值(附录 E 明说是 analytic constructions),吞吐也来自 agent 优化的实现,公平性依赖实现质量;(c) HiRes 有约 8.5% 参数与 5.5% FLOPs 开销((768,12) n=2:150.2M vs 138.4M),虽有缩放律对比,但缺少「等参数量下直接加宽基线 $d$」的对照实验;(d) 推理时外层状态宽 $2d$,解码阶段激活显存相应增加,论文只测了训练吞吐;(e) 验证仅限 decoder-only 语言模型,未触及视觉或编码器架构。
独立分析的弱点
(1) 均匀分块是粗糙假设:浅层也许需要更频繁的宽状态交换、深层或可放长块。改进方向:可学习或非均匀块边界,把读写频率做成每块超参。(2) 接口参数随 $dD$ 线性增长:$\Delta P=2BdD+2dD+BD+(2B+2)$,d=2048、B=4、n=2 时已新增 83.9M;按比例推到 d=8192 的 frontier 模型会显著挤占参数预算。改进方向:低秩、分块稀疏或组共享接口。(3) 缺乏机制解释:只知道「宽状态有用」(n=0.75 失败只证明宽度必要),不知道它存了什么、块边界交换了什么信息。改进方向:对 $h_b$ 做探针与因果干预分析,刻画不同深度块的功能分工。(4) 稳定化门是启发式设计:$\sigma(\alpha)=0.1$ 的初值靠经验,「跷跷板」假设没有理论支撑。改进方向:对接口与内层联合训练做动力学期分析,或按层深自适应初始化。(5) 只测 decoder-only LM:视觉 Transformer、扩散模型等层级架构同样存在残差宽度与计算宽度绑定问题,但未验证。改进方向:在 ViT/DiT 上复现。(6) 与逐层方法可能互补而非互斥:块级稠密接口与 HC/mHC 的逐层混合叠加效果未知。改进方向:构建「块级 HiRes + 层级轻量混合」的混合架构并检验收益是否可加。
未来方向
作者提出的方向:在固定计算预算下联合优化残差宽度 $D$、计算宽度 $d$ 与深度 $L$ 的容量分配;探索非等大小块、让网络不同深度以不同频率访问宽状态;理解宽残差状态改善学习的机制——跨块保留了什么信息、各子层如何贡献其变换与复用。基于本文成果可延伸的方向:(1) 把附录 G 的潜空间视角与 MLA、LatentMoE 级联,构建「状态宽、计算窄」的全栈架构,统一注意力 KV 压缩、专家压缩与残差压缩;(2) 用缩放律外推最优 $(n,B)$ 随规模的漂移规律,给出按规模配置的实用指南;(3) 与逐层混合方法正交组合,验证收益可加性;(4) 推理侧研究:外层状态 $D=2d$ 对自回归解码显存/带宽的影响及与 KV cache 的协同设计;(5) 理论分析块边界 PostNorm 对梯度传播与特征学习(如 $\mu$P 超参迁移)的影响;(6) 在多模态与扩散模型中检验残差宽度解耦的普适性;(7) 对 $h_b$ 做可解释性研究,把「宽状态存了什么」从开放问题变成可测量的对象。
复现评估
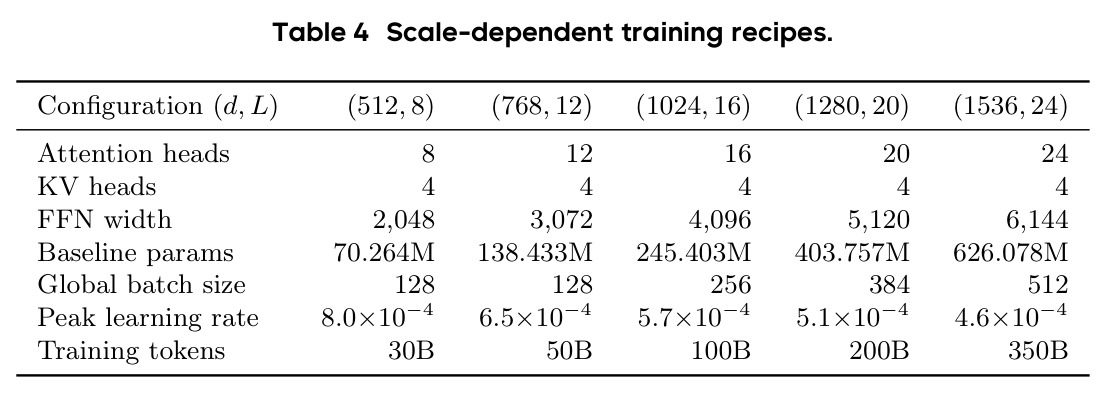
小规模复现门槛中等偏低,大规模复现门槛高。有利因素:实现基于公开的 OLMoE 代码库;方法改动不足十行代码(附录 A 给出完整 PyTorch 伪代码);只用标准算子(稠密投影、RMSNorm、残差加法),无需定制内核;附录 B 给出完整训练配方(AdamW β₁=0.9、β₂=0.95、wd 0.1、梯度裁剪 1.0、cosine 衰减到 0.1× 峰值、2% warmup、4096 上下文、init std 0.02)以及每个规模的 batch/LR/token 数(表 4);对比方法的配置与实现在附录 C.3、F 中有细节;数据是公开的 OLMo2 stage-1 混合物与 Dolma2 tokenizer(词表 100,352)。算力方面:最小规模 (512,8)、30B token(70M 参数)单机多卡即可复现;效率测试用 8 卡 FSDP + bf16;完整复现 (1536,24)、350B token 与 OLMoE 500B token 预训练需要大规模集群(论文未给出总卡时)。不确定性:正文未提及代码开源,需自行按伪代码实现;不过方法足够简单、超参披露完整,实现风险较低。
论文图表