多流注意力残差:面向大规模预训练的多头深度检索残差架构 Multi-Stream Attention Residuals
用多尺度因果卷积把残差源扩成多流做多头深度注意力,18B/28B全面领先,等损失加速1.58倍
前置知识
残差流与 PreNorm Transformer
现代 LLM 采用 PreNorm 结构,每个分支(注意力或 MLP)输出加回到一条贯穿全网的隐状态轨迹上:$h^{l+1}=h^l+f_l(h^l)$。这条轨迹被称为残差流,它保留了恒等通路,让信息和梯度可以绕过非线性层直接回传,是深层网络可训练的基础。
本文的出发点正是残差流的缺陷——单一加性轨迹会随深度稀释早期特征,读懂问题定义必须先理解标准残差在做什么。
Hyper-Connections(HC)与 mHC
HC 把单一残差流扩展为 $m$ 条持久并行流,用三个学习矩阵读写:$H_{pre}$ 聚合多流为层输入、$H_{post}$ 把分支输出写回各流、$H_{res}$ 做流间混合;流形约束变体 mHC 通过 Sinkhorn–Knopp 算法把 $H_{res}$ 投影到双随机矩阵(Birkhoff 多面体)上,保证信号传播稳定。
MSAR 的流融合直接借用 mHC 风格的 $H_{pre}$ 混合器,消融实验也以 mHC 为主要对比基线之一。
Attention Residuals(AttnRes)
AttnRes 保留每个历史源 $v_i$,用层特定的伪查询 $q_l$ 与 RMS 归一化指数核 $\phi(q,k)=\exp(q^\top\mathrm{RMSNorm}(k))$ 对所有源做 softmax 检索,用内容依赖的深度注意力取代固定加性累加,并通过块级源(Block 模式)、跨阶段缓存和两阶段计算控制存储与通信成本。
MSAR 是 AttnRes 的直接扩展:单流单头深度注意力升级为多流多头,Block MSAR 完全复用 AttnRes 的系统设计。
因果深度可分离卷积
深度可分离卷积对每个通道独立做一维卷积(权重 $c_{i,r,\delta}\in\mathbb{R}^d$ 逐通道相乘再求和),因果(causal)意味着只看当前及之前位置,序列开头零填充。参数量和 FLOPs 与通道数成线性关系,是轻量序列建模的常用组件。
MSAR 靠多个不同核大小的因果深度卷积({4,8,12})从序列轴构造互不相同的全维流,这是全部源多样性的来源。
等损失计算加速(iso-loss compute speedup)
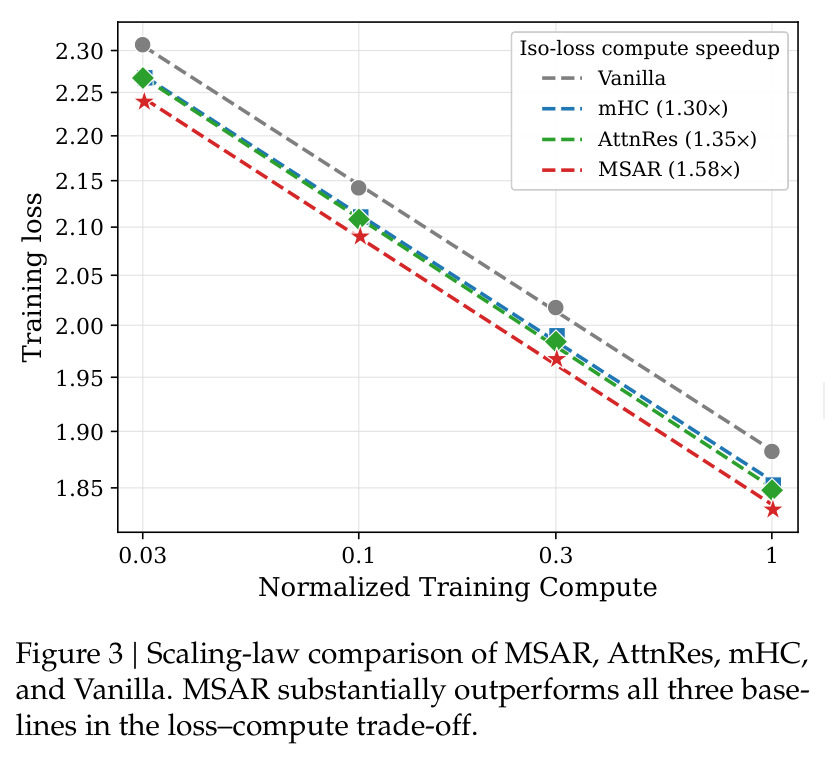
比较不同架构计算效率的 scaling-law 指标:对每种方法拟合幂律 $L(C)=AC^{-\beta}+E$($E$ 为不可约损失底线),然后回答“达到相同训练损失需要多少计算量”。本文以 Vanilla 的计算量为分母,MSAR 为 1.58× 意味着同样的损失只用约 1/1.58 的算力。
这是论文最重要的效率结论来源,理解它才能正确解读 Figure 3 中 1.58×/1.35×/1.30× 三个数字的含义。
研究动机
在现代 PreNorm Transformer 中,加深网络并不总是带来预期收益:残差流把所有先前计算压缩进一条固定加性更新的隐状态轨迹,随着层数增长,早期层形成的特征被逐步稀释,深层越来越难检索它们,导致深度扩展的实际效率远低于其表示容量。实证上这很直观:18B MoE 规模的标准残差基线(Vanilla)在 12 项下游基准上的平均分只有 37.5%,最终训练损失 1.799,说明大量参数与算力未被有效转化为能力。已有改进分两条路线:Hyper-Connections(HC)及流形约束变体 mHC 把单一残差流扩为多条持久流并学习流间混合,属于沿深度的多状态递归;Attention Residuals(AttnRes)则用沿深度轴的单头 softmax 注意力取代固定累加,显式保留跨层访问。两者都已在万亿参数级预训练(DeepSeek-V4-Pro、Kimi K3)中得到验证,但深度方向的检索表达能力仍受单头结构限制。
本文的目标是本文的目标是把 AttnRes 的单流深度注意力推广为真正的多头深度注意力,让不同的“头”通过不同的上下文视角检索历史表示,从而提升残差检索的表达能力和深度扩展效率,同时把额外开销压到接近零。具体约束有三条:(1)不破坏隐状态完整性——深度注意力的被检索值本质上是完整隐状态,不能像序列轴多头注意力那样做通道切分;(2)不引入持久的多流存储或流水线通信,保持与 AttnRes 相同的单流缓存与 $O(Nd)$ 通信成本;(3)在 18B 与 28B MoE 大规模预训练中,训练损失和 12 项下游基准全面超越 Vanilla、mHC、AttnRes 三个基线,并用 scaling-law 实验给出可比的计算效率指标——等损失计算加速,目标明显超过 AttnRes 的 1.35× 与 mHC 的 1.30×。
与已有工作不同的是,已有尝试表明多头深度注意力并不容易实现。AttnRes 曾尝试对隐状态做通道切分形成多头深度聚合,性能反而下降——因为被检索的值就是隐状态本身,切成低维片段破坏了整体性。另一条直观路线是借用 mHC 的 Hpost 式写回,从单层输出派生若干候选流再当深度注意力头:候选虽保持全维,但本质上只是同一向量的标量重加权,RMSNorm 会消除幅值差异,导致各头的 key 几乎相同、源表示缺乏多样性。MSAR 的独特切入是绕开“在深度轴内部制造多样性”的困局,转而向序列轴借多样性:用一组多尺度因果卷积把单层输出展开成 $m$ 条全维流,不同流聚合了不同大小局部窗口内的历史表示,接收野互不相同。这样既保证了流间差异(上下文视角不同),又保住了每条流的完整维数,以极低成本实现了真正的多头深度注意力。
核心方法
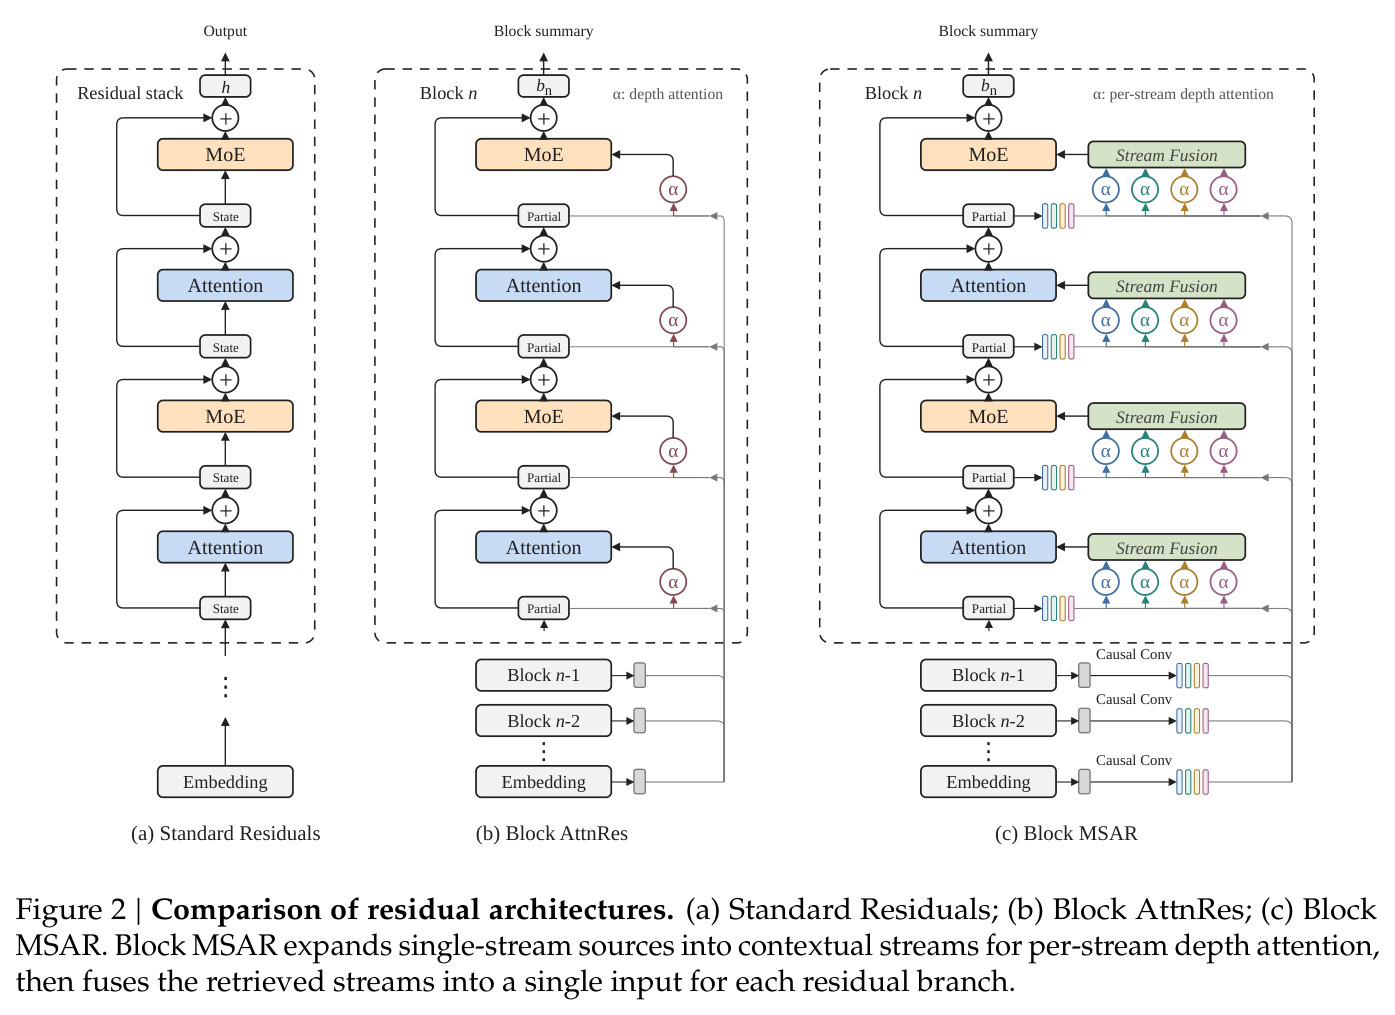
MSAR 的直觉是:既然深度注意力的被检索值(隐状态)必须保持完整,那就让多样性来自别处——同一层输出在序列不同位置的历史版本天然编码了不同范围的上下文,把它们按不同窗口聚合,就得到一组互补的“上下文视图”。技术路线分三段:首先,对每个残差源施加恒等映射加 $m-1$ 个层特定的因果深度可分离 1D 卷积(主设定核大小为 {4,8,12},共 $m=4$ 条全维流);其次,每个目标层拥有 $m$ 个独立学习的伪查询,在每条流内独立做深度 softmax 注意力,核为 $\phi(q,k)=\exp(q^\top\mathrm{RMSNorm}(k))$,得到 $m$ 个检索状态;最后用轻量的 mHC 风格 $H_{pre}$ 标量混合器($W_{pre}\in\mathbb{R}^{md\times m}$)把多流融合成单流层输入。系统层面,多流只是单流状态的确定性函数,仅在计算深度注意力时按需展开、即算即耗,可融合成单个 kernel;实测 28B MoE 下训练 FLOPs 仅增 0.5%,激活参数仅增 0.3%。
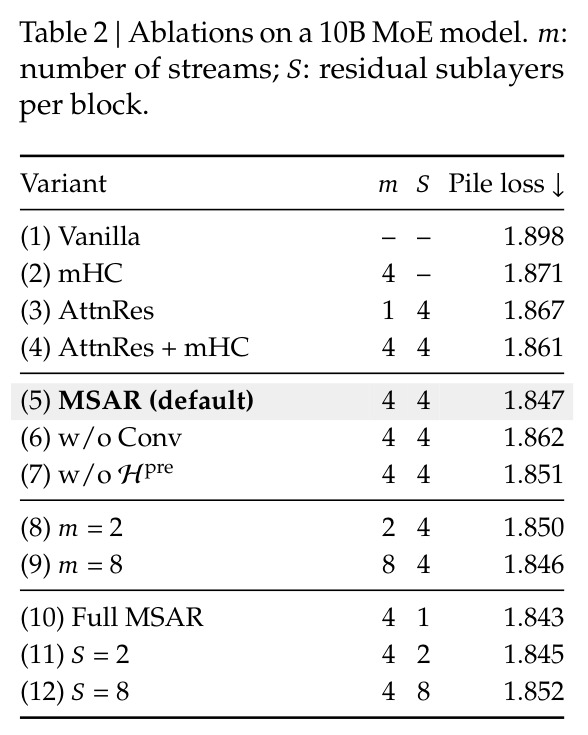
核心创新是把残差检索改造成多头深度注意力原语,与已有方法的本质区别在多样性的来源和存储策略。HC/mHC 在持久多流递归状态上做流混合,类似沿深度的线性注意力记忆;AttnRes 只保留单流源加单头深度 softmax 检索。MSAR 保留 AttnRes 的显式跨层访问结构,但用多尺度因果卷积从序列轴为每个源生成 $m$ 个全维上下文视图,使每个头拥有独立的 key 集合和深度注意力分布——这既非“多头共享同一组 key”的多查询变体,也非把多流递归与跨层访问简单相加:消融中去掉卷积(四流退化为同一源)损失从 1.847 升到 1.862,而 AttnRes+mHC 直接组合只降到 1.861,均明显差于 MSAR 的 1.847。效率上,“先累加后展开”的顺序保证多流是单流摘要的确定性函数,只存单流即可把流水线通信与前填充激活存储从 $O(mNd)$ 降到 $O(Nd)$,与 AttnRes 持平。
方法步骤详情
方法分五步。(1)定义源:嵌入为 $v_0$,各分支输出 $v_i=f_i(h^i)$。(2)多流展开:对每个源施加恒等映射加 $m-1$ 个层特定因果深度卷积 $v^{(r)}_t=\sum_{\delta<\kappa_r}c_{r,\delta}\odot v_{t-\delta}$,得 $m=4$ 条全维流(核 {4,8,12})。(3)逐流深度注意力:每层有 $m$ 个伪查询,key 为展开后的源,权重按 $\phi(q,k)=\exp(q^\top\mathrm{RMSNorm}(k))$ 在流内 softmax 归一化,得 $m$ 个检索状态 $z^{(r)}_l$。(4)流融合:$H^l_{pre}=\sigma(\mathrm{RMSNorm}(\mathrm{Flatten}(Z^l))W^l_{pre}+b^l_{pre})$,层输入 $h^l=H^l_{pre}Z^l$。(5)Block MSAR:$L$ 个分支分成 $N\approx8$ 块,块内单流累加出摘要 $b_n$,目标层从嵌入、已完成摘要与当前部分和检索,配合两阶段计算与跨阶段缓存。
技术新颖性
新颖性体现在四点。其一,首次在不切片、不标量重加权复制的前提下实现多头深度注意力:消融对比“多查询共享源”(w/o Conv,1.862)与“多查询多源”(MSAR,1.847),证明源多样性是不可替代的归纳偏置;直接组合 AttnRes+mHC 只降到 1.861,说明收益不是两种机制叠加可以替代的。其二,“先累加后展开”的计算顺序设计:层输出先累加成单流块摘要、消费时才卷积展开,若反过来先展开再累加会退化到 $O(mNd)$ 存储与通信,这一顺序约束是保持 AttnRes 级成本的关键。其三,系统巧思——卷积展开与逐流深度注意力融合为单个 kernel,消除中间流的内存写读;展开流在前向中只被深度注意力消费,无其他使用者,融合因此可行。其四,验证的严谨性:四规模 scaling-law 给出 1.58× 等损失加速(AttnRes 1.35×、mHC 1.30×),配合 10B 消融隔离各组件贡献,说明增益来自归纳偏置而非规模伪影。
实验结果
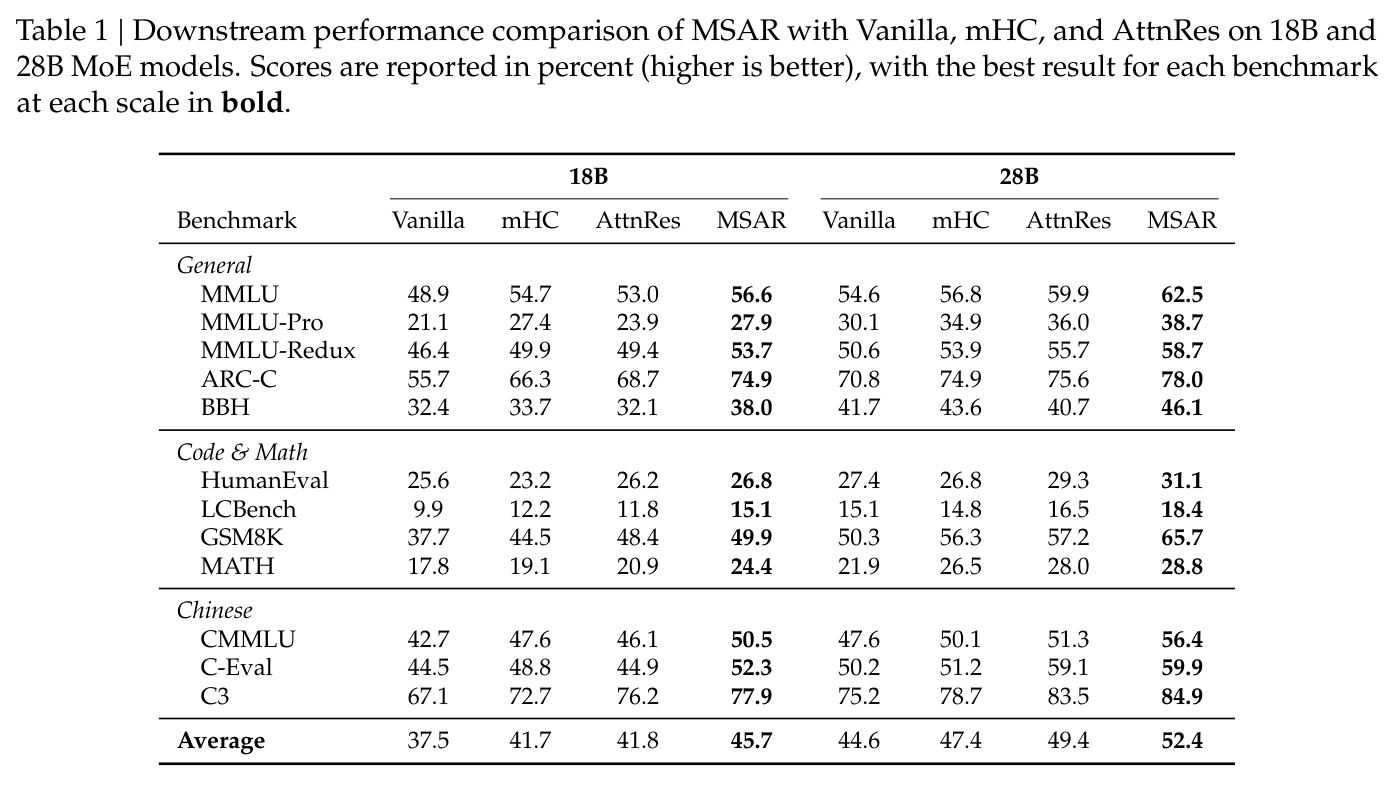
核心发现有三组。其一,主实验(Table 1):18B 上 MSAR 平均 45.7%,超 Vanilla 37.5%(+8.2)、mHC 41.7%(+4.0)、AttnRes 41.8%(+3.9),12 项基准全部第一(如 ARC-C +6.2);最终损失 1.750 低于 Vanilla 1.799、mHC 1.776、AttnRes 1.769。28B 平均 52.4 vs 44.6/47.4/49.4,GSM8K 65.7(Vanilla 50.3),开销仅 +0.3% 激活参数、+0.5% FLOPs。其二,scaling-law(Figure 3,$E=0.72$):最大规模损失较 Vanilla 降 2.7%(mHC 1.6%、AttnRes 1.8%),四规模平均等损失加速 1.58×。其三,10B 消融(Table 2):Vanilla 1.898→MSAR 1.847;w/o Conv 1.862 证源多样性必要;w/o Hpre 1.851;$m=2/8$ 为 1.850/1.846;Full MSAR 1.843,$N\approx8$ 块即 1.847。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 12 项基准平均分(18B MoE) | 平均准确率 % | 45.7 | Vanilla 37.5 / mHC 41.7 / AttnRes 41.8 | +8.2 / +4.0 / +3.9,且 12 项基准全部第一 |
| 12 项基准平均分(28B MoE) | 平均准确率 % | 52.4 | Vanilla 44.6 / mHC 47.4 / AttnRes 49.4 | +7.8 / +5.0 / +3.0 |
| ARC-C(18B) | 准确率 % | 74.9 | AttnRes 68.7 | +6.2 |
| BBH(18B) | 准确率 % | 38.0 | AttnRes 32.1 | +5.9 |
| GSM8K(28B) | 准确率 % | 65.7 | Vanilla 50.3 / AttnRes 57.2 | +15.4 / +8.5 |
| MMLU(28B) | 准确率 % | 62.5 | AttnRes 59.9 | +2.6 |
| 最终训练损失(18B) | 语言模型损失 | 1.750 | Vanilla 1.799 / mHC 1.776 / AttnRes 1.769 | -0.049 / -0.026 / -0.019 |
| 等损失计算加速(四规模平均) | 相对 Vanilla 的计算加速倍数 | 1.58× | AttnRes 1.35× / mHC 1.30× | +0.23× / +0.28× |
| Pile 损失(10B 消融) | 语言模型损失 | 1.847(Full MSAR 1.843) | Vanilla 1.898 / AttnRes 1.867 / AttnRes+mHC 1.861 | -0.051 / -0.020 / -0.014 |
局限与改进
作者承认的局限:相比 AttnRes,MSAR 的剩余开销主要来自把检索到的多流输出写回内存并聚合所需的额外访存(Appendix C 给出逐 token 逐层对比);流数 $m=8$ 相比 $m=4$ 只有边际改善(1.846 vs 1.847),块划分 $N\approx8$(1.847)与全深度访问 Full MSAR(1.843)之间仍有差距,说明块化牺牲了部分检索粒度。我自己的观察:其一,所有实验均基于 DeepSeekMoE 风格 MoE 加 SwiGLU,未报告稠密模型或其他架构上的迁移性,普适性存疑;其二,多尺度卷积引入了固定核({4,8,12})的局部性偏置,核大小如何随上下文长度与数据分布自适应未探讨,长上下文场景下序列轴视角是否仍有效缺少证据;其三,论文只分析训练 FLOPs 与存储,未量化推理端到端延迟和显存行为;其四,训练最长约 46k 迭代(18B),更长训练或多 epoch 下优势是否保持有待验证。
独立分析的弱点
独立分析四个弱点。(1)固定核大小的卷积是超参敏感点:论文只测了 {4,8,12} 一组配置,若预训练数据的上下文尺度差异大(长文档与短对话混合),固定核可能次优——改进方向是让核大小可学习或按输入动态选择。(2)Hpre 自适应融合的收益有限:均值聚合已能到 1.851(MSAR 为 1.847),而 $W_{pre}\in\mathbb{R}^{md\times m}$ 在 $d$ 很大时仍是不小的投影,可探索低秩分解或逐通道轻量门控来提高性价比。(3)检索输出的多流写回是唯一显著增量访存开销,论文只是量化而未消除——可尝试把 Hpre 聚合也吸收进融合 kernel,或让 $m$ 条流共享低秩结构。(4)块划分 $N\approx8$ 是启发式且块内检索粒度不均(块首层没有部分和源),可尝试重叠块或按层深自适应分块,逼近 Full MSAR 的 1.843。每个弱点都有明确的消融数字支撑,改进空间可量化。
未来方向
作者在结论中指出:多状态表示(HC 系)与跨层访问(AttnRes 系)的收益并不完全重叠,这直接启发更优雅地组合两者互补优势的残差设计。可延伸方向:(1)理论化——用状态空间或线性注意力视角分析卷积展开的深度记忆容量,解释为什么序列轴上下文视图能替代持久多流状态;(2)自适应化——让流数 $m$、核大小 $\{\kappa_r\}$、块数 $N$ 随训练进度或输入内容动态调整(类似 MoE 门控或早退机制);(3)推理系统——展开流按需生成、即算即耗的性质天然适合与投机解码、KV 缓存复用结合,值得端到端系统化验证;(4)架构泛化——迁移到稠密模型、多模态主干和其他归一化方案,检验 1.58× 加速的普适性;(5)与 $\mu P$、超参数转移等 scaling 工具结合,把 18B/28B 上的结论可靠外推到更大规模预训练。
复现评估
论文给出项目页 GitHub(github.com/jianke0604/MSAR),方法描述完整:卷积核大小、流数 $m=4$、块数 $N\approx8$、$H_{pre}$ 公式、两阶段计算与融合 kernel 策略均有交代,Appendix A/B/C 声称包含训练细节、模型配置、few-shot 评测协议和逐 token 逐层访存对比。但复现门槛极高:主结果需要 18B 与 28B MoE 级别的预训练算力(18B 训了约 46k 迭代),是千卡集群量级的投入,普通实验室只能复现 10B 消融的一部分;scaling-law 还需要四个模型规模的配平训练。此外需自建 MMLU-Pro、LCBench 等 12 项基准的评测管线。建议路径:先在 0.5B–1B 稠密模型上验证“卷积展开 + 逐流深度注意力”的相对收益是否复现,再按论文超参搭建 Block MSAR;若代码与权重未开源,方法本身逻辑自洽,工程复现主要难点在流水线并行的两阶段计算实现。
论文图表
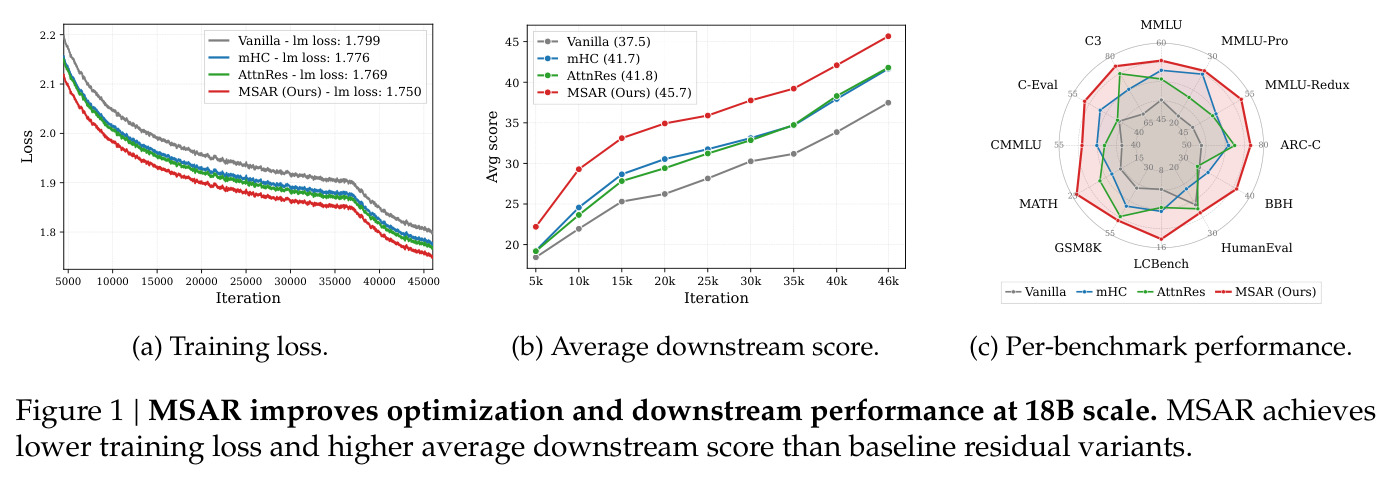
三个子图展示 18B MoE 训练全过程:(a) 训练损失曲线,约 46k 迭代后 MSAR 达到最低的 1.750,AttnRes 1.769、mHC 1.776、Vanilla 1.799;(b) 训练过程中平均下游分数曲线,MSAR(45.7)全程领先 mHC(41.7)和 Vanilla(37.5);(c) 各基准的柱状对比,MMLU、BBH、GSM8K、MATH 等逐项超越。
这是论文的招牌图,用最小的篇幅同时证明了训练优化和下游能力两个维度的收益,且损失优势随训练持续扩大而非昙花一现,是理解“为什么要做 MSAR”的第一入口。