DepthBench:度量残差连接如何使更深层的计算真正有效 DepthBench: Measuring How Residual Connections Enable More Computational Depth
固定参数量扫描宽深比,发现只有HC/AttnRes类残差设计能把更多层变成有效计算。
前置知识
Pre-LN Transformer 与残差流
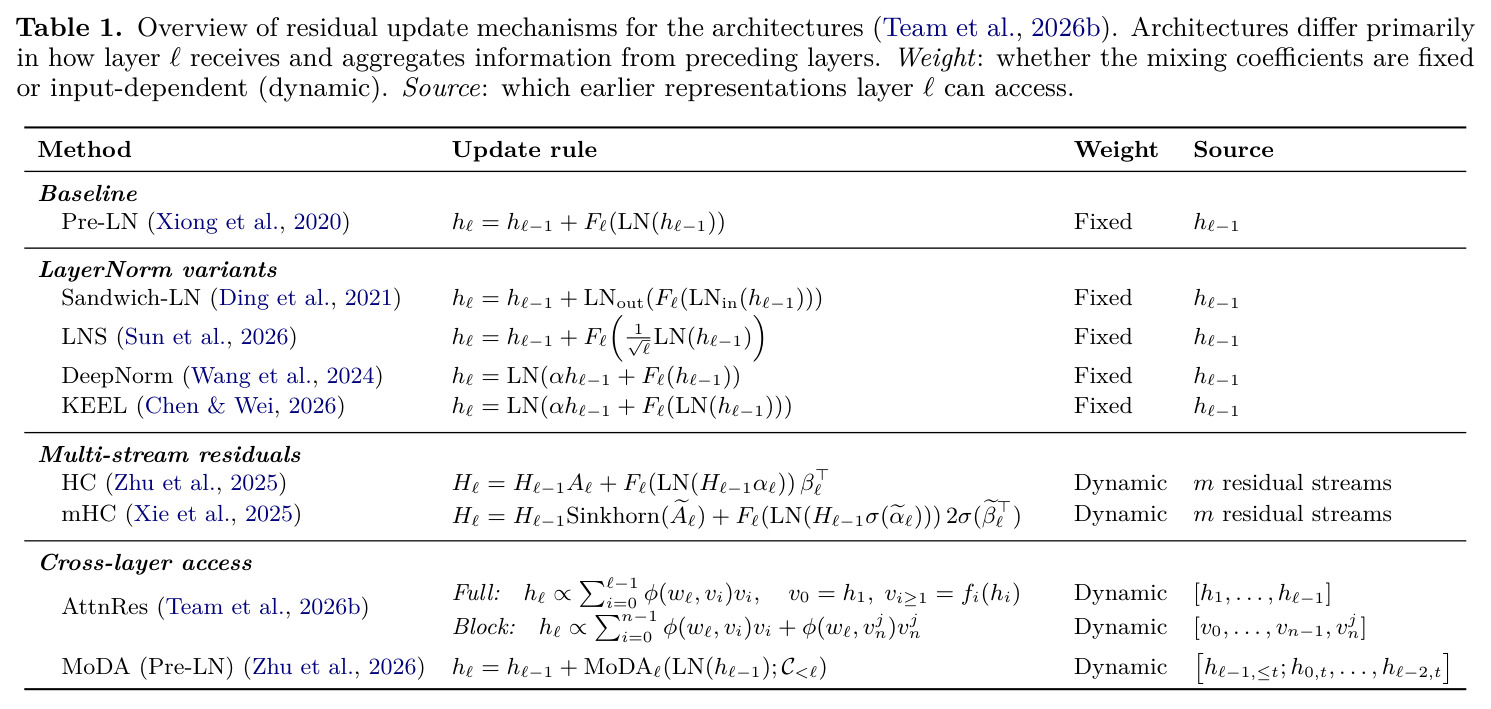
Pre-LN 把层归一化放在每个变换分支之前,子层按 $h^\ell = h^{\ell-1} + F_\ell(\mathrm{LN}(h^{\ell-1}))$ 更新隐状态。残差流是一条贯穿所有层的恒等通路,使梯度可以直达浅层,从而让上百层的网络也能稳定训练,是现代 LLM(LLaMA、Qwen 等)的标准配置。
本文所有 10 种被比较的架构都建立在 Pre-LN 基础之上,理解残差流如何传递信息与梯度,才能明白各种归一化和残差变体到底改了什么。
深度诅咒(Curse of Depth)
指 Pre-LN Transformer 中纯增加层数并不能带来成比例的能力增长:随着深度增加,残差流的方差不断累积,深层 LayerNorm 的输出趋近恒等映射,导致深层对残差流的更新越来越弱、越来越相似,很多后层只做微小的、可互相替代的精修。
深度诅咒是本文研究的核心问题背景——DepthBench 要回答的正是哪些架构设计能打破这个诅咒,让新增的层真正参与有效计算。
宽深比(Aspect Ratio)
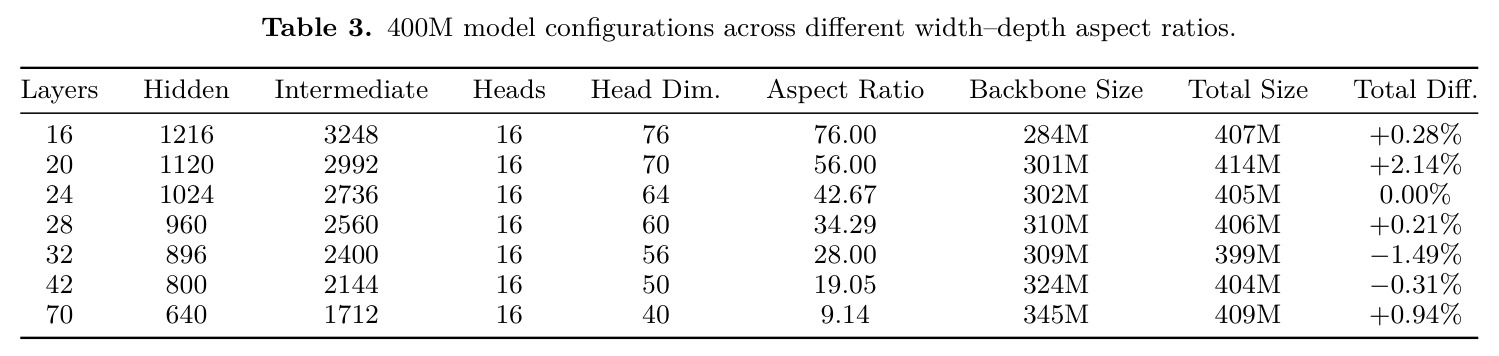
定义为 $d_{\text{model}}/n_{\text{layer}}$,即隐藏维度除以层数。由于总参数量近似为 $N \approx 12Ld^2 + 2Vd$,固定总参数时,宽深比决定了容量在宽度和深度之间如何分配:比值大是浅而宽,比值小是深而窄。
宽深比是 DepthBench 的核心实验变量。把深度当作容量分配的选择而非简单叠加,是本文区别于以往深度研究的根本实验设计。
Chinchilla 等参数比较与学习率扫描
等参数(iso-parameter)比较指在近似相同的总参数量和训练 token 预算(本文按 20 tokens/param 的 Chinchilla 比例)下比较不同架构。为排除超参混淆,需要对每个配置扫描多个学习率并报告各自最优值,否则差异可能来自次优学习率而非架构本身。
本文的主要结论都建立在等参数+等训练配方+学习率扫描这套严格控制协议上,理解这一点才能相信不同架构间的差距是干净可归因的。
HC 与 AttnRes 等新式残差设计
HC(Hyper-Connections)把单一残差流扩展为多条流,用可学习的读写和混合矩阵 $H^\ell = H^{\ell-1}A^\ell + F_\ell(\mathrm{LN}(H^{\ell-1}\alpha^\ell))\beta^{\ell\top}$ 传播信息;mHC 用 Sinkhorn 归一化约束其近似双随机以稳定训练。AttnRes 则让每层通过注意力机制对所有先前层输出做动态加权和,Full 版本可访问全部历史层输出,Block 版本只访问块级摘要。
这两种设计(及其衍生 mHC、Block AttnRes)是本文的主角:只有它们展现了随深度持续受益的缩放行为,理解其机制差异是读懂本文分析部分的前提。
研究动机
现代 LLM 几乎全部采用 Pre-LN Transformer,残差连接解决了深网络的训练稳定性问题,但并不保证每一层都贡献有用的计算。深度诅咒(Sun et al., 2026)表明:随着层数增加,Pre-LN 网络后层的更新越来越弱、冗余、彼此相似,额外增加的层只提升了名义深度(architectural depth),却没有带来成比例的有效计算深度(effective computational depth)。为此,一系列工作试图通过修改归一化(LNS、KEEL、Sandwich-LN、DeepNorm)或重新设计残差通路(AttnRes、HC、mHC、MoDA)来改善深度利用,其中部分设计已被 Kimi K3、DeepSeek V4 等前沿模型采纳。然而这些方法各自使用不同的架构、训练配方和系统配置进行评估,其报告的收益无法干净地归因:到底是优化变好了、跨层信息访问变好了、特征多样性保留了,还是仅仅来自未控制的参数量或计算量差异?此外,现有缩放定律研究大多固定传统架构只变总规模,很少回答一个更基本的问题——在固定参数预算下,把容量分配给深度而不是宽度,究竟什么时候是值得的。
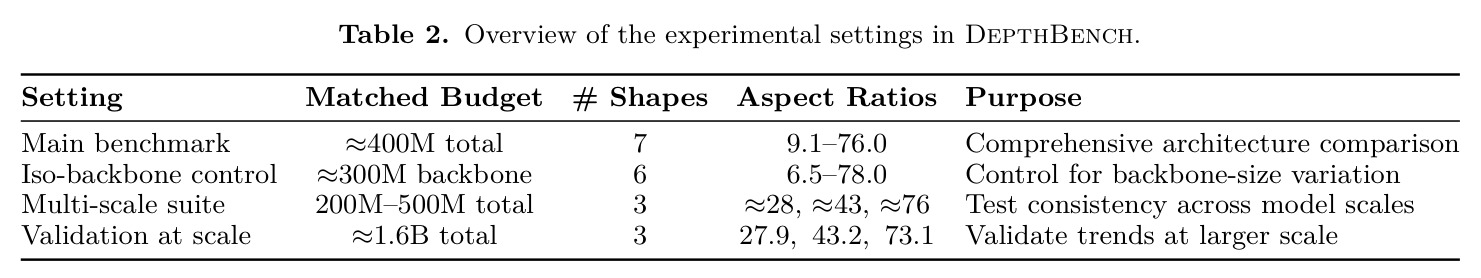
本文的目标是本文要构建一个受控基准 DepthBench,回答核心研究问题:哪些架构设计能让额外的架构深度转化为有效计算深度。具体目标是:(1)固定总参数量(约 400M)和完整训练配方,把宽深比 $d_{\text{model}}/n_{\text{layer}}$ 从 76.0(浅而宽,$d=1216, L=16$)系统性地扫到 9.1(深而窄,$d=640, L=70$),在同一光谱上横向比较 10 种代表性残差/归一化设计;(2)对每个配置扫描多个学习率并报告各自最优值,保证差异反映架构本身而非超参;(3)用 iso-backbone 控制、200M–500M 多尺度套件和 1.6B 规模验证排除混杂、检验趋势稳健性;(4)通过层级诊断(表示角距离、因果分数、置换分数、残差路径权重、层剪枝)揭示深度收益背后的机制,而不只报告损失曲线。
与已有工作不同的是,本文的独特切入角度有两层。实验设计上,它把深度重新概念化为一种容量分配选择(capacity allocation choice),用宽深比作为受控实验变量,而不是像以往工作那样简单地在固定宽度上加深层数(这会同时改变模型规模和计算量);同时它首次把 HC、mHC、AttnRes、Block AttnRes、MoDA、LNS、KEEL、DeepNorm、Sandwich-LN、Pre-LN 十种架构放在完全相同的等参数、等配方、扫过学习率的协议下横向对比——此前这些方法各自与自己的 baseline 比,结论互相不可比。问题层面上,它把社区的关注点从可训练性(能不能训得深)推进到有效深度(多出来的层到底有没有被用上):即使 Mix-LN、LNS 等工作已证明可训练性和深度利用是两回事,仍没有人系统检验过改善深度利用是否足以让深度成为一个有利的缩放轴。
核心方法
直觉非常简单:由于总参数量近似满足 $N \approx 12Ld^2 + 2Vd$,在固定 $N$ 时宽度和深度可以互相交换——同样的预算可以造一个浅而宽的网络,也可以造一个深而窄的网络。如果某个架构真的能让每层都做有效计算,那么用宽度换深度应该降低验证损失;反之如果深层大部分在摸鱼,把参数挪去深度就会让损失上升。因此宽深比扫描本身就是对有效计算深度的直接测量。技术路线上,所有变体共享一个 LLaMA-like 骨干:多头自注意力(16 头)、RoPE、RMSNorm($\epsilon=10^{-6}$)、SwiGLU 前馈层、GPT-NeoX 分词器(词表 50280)、输入输出嵌入不共享;1.6B 模型换用 Qwen3-1.7B 的 GQA 配置(16 个 query 头、8 个 KV 头)。唯一变化的是归一化/残差连接设计。训练使用 OLMo-core 在 FineWeb-Edu 上从头预训练,按 Chinchilla 的 20 tokens/param 配比(400M 模型 8B tokens,1.6B 模型 32B tokens),序列长度 2048,全局 batch 512(约 100 万 token/步)。整个基准由四个互补套件组成:400M 主基准(10 架构 × 7 种形状)、iso-backbone 控制(骨干固定 300M,排除嵌入/LM 头分配差异)、200M–500M 多尺度套件(3 种宽深比)和 1.6B 验证(3 种宽深比)。
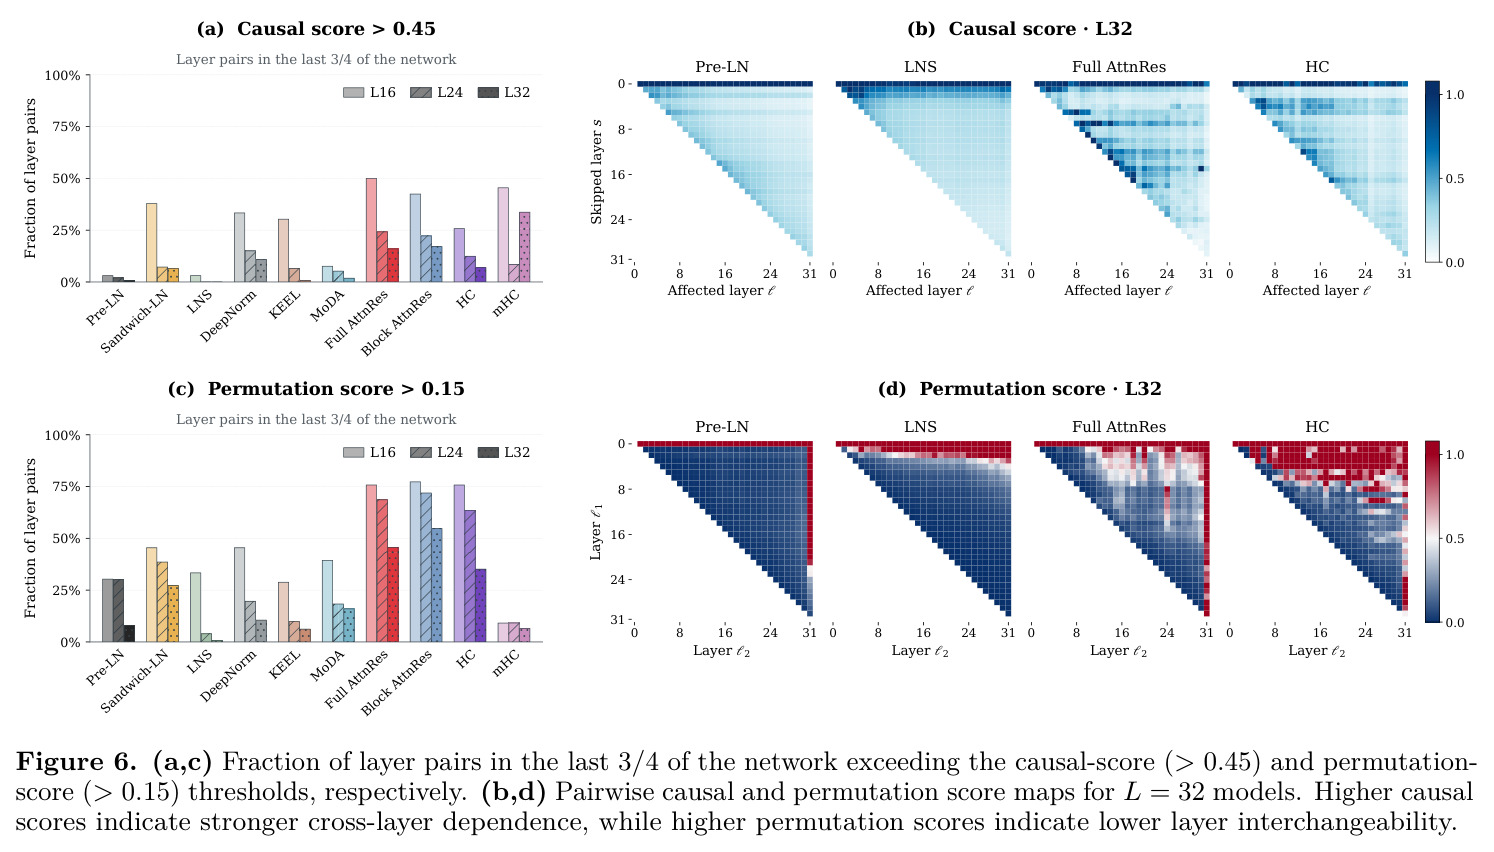
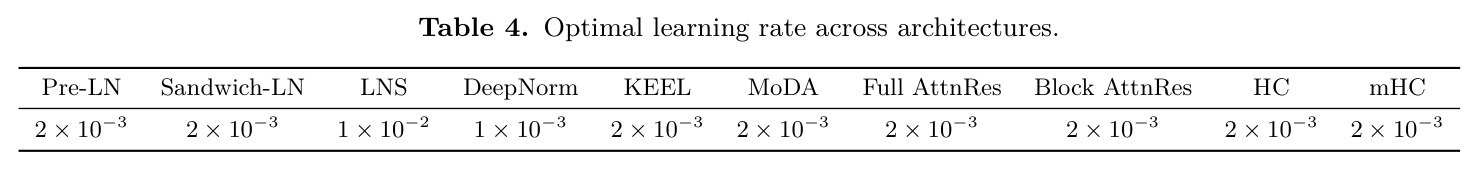
核心创新不是提出新架构,而是把架构的深度缩放能力变成一个可测量、可横向比较的量。实验设计上通过三重控制消除混杂:等参数量(总参数差控制在 ±2.14% 以内)、等训练配方(数据、token 数、优化器、调度完全一致)、逐架构学习率扫描(在 $\{5\times10^{-4}, 10^{-3}, 2\times10^{-3}, 5\times10^{-3}\}$ 内取最优,LNS 单独扫到 $2\times10^{-2}$),并有 iso-backbone 对照组消除一个隐蔽混杂——窄模型分配给嵌入和 LM 头的参数更少、骨干占比更高。机制分析上的关键设计是:不停留在损失曲线,而是定义一组直接测量深度利用的层级指标——相邻深度表示的角距离 $d(h^\ell, h^{\ell+n}) = \frac{1}{\pi}\arccos\frac{h^\ell \cdot h^{\ell+n}}{\|h^\ell\|_2 \|h^{\ell+n}\|_2}$、跳层因果分数 $C(s,\ell)$ 和交换两层后的置换分数 $P(\ell_1,\ell_2) = \frac{\mathcal{L}(M) - \mathcal{L}(M_{\text{swap}(\ell_1,\ell_2)})}{\mathcal{L}(M)}$——并且创新性地把统计范围限制在网络最后四分之三的层($s \ge \lceil L/4 \rceil$),因为最初几层在所有架构中都很重要,全局统计会掩盖后层利用上的差异。与已有方法的本质区别:以往研究问的是这个架构能不能训得深,DepthBench 问的是加深到底值不值、以及为什么值。
方法步骤详情
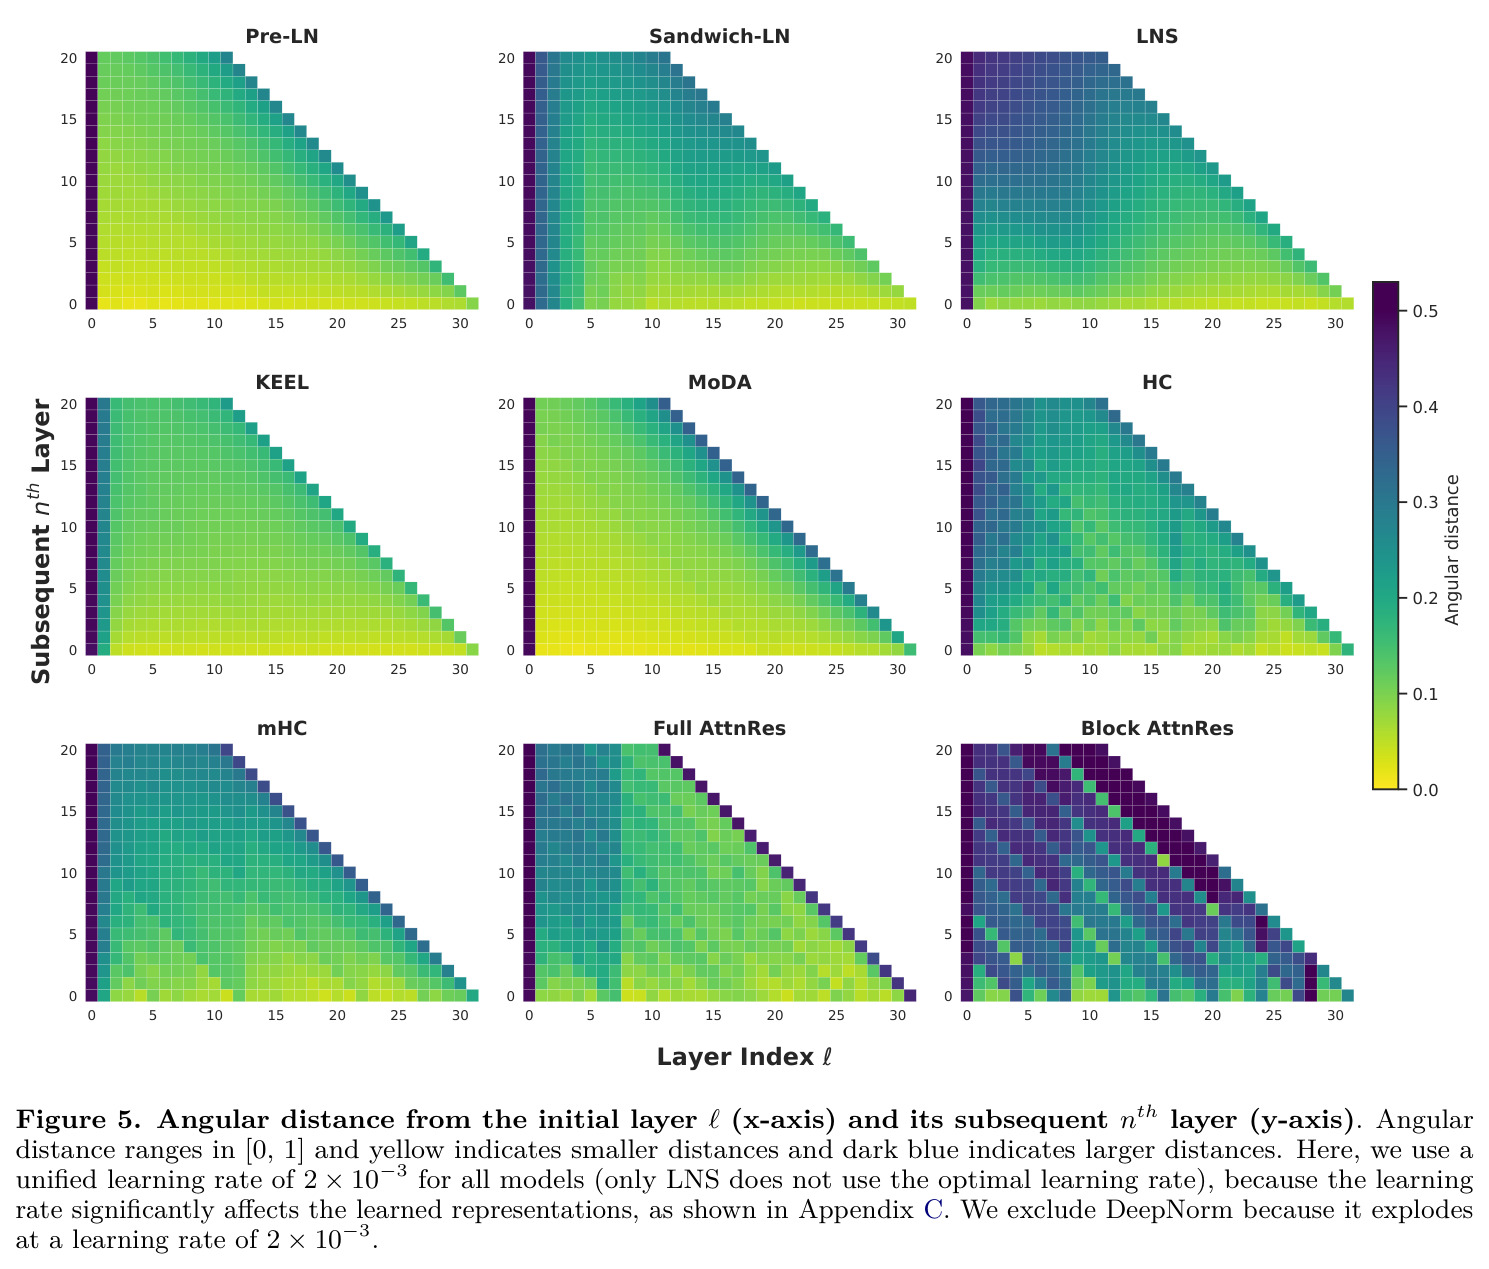
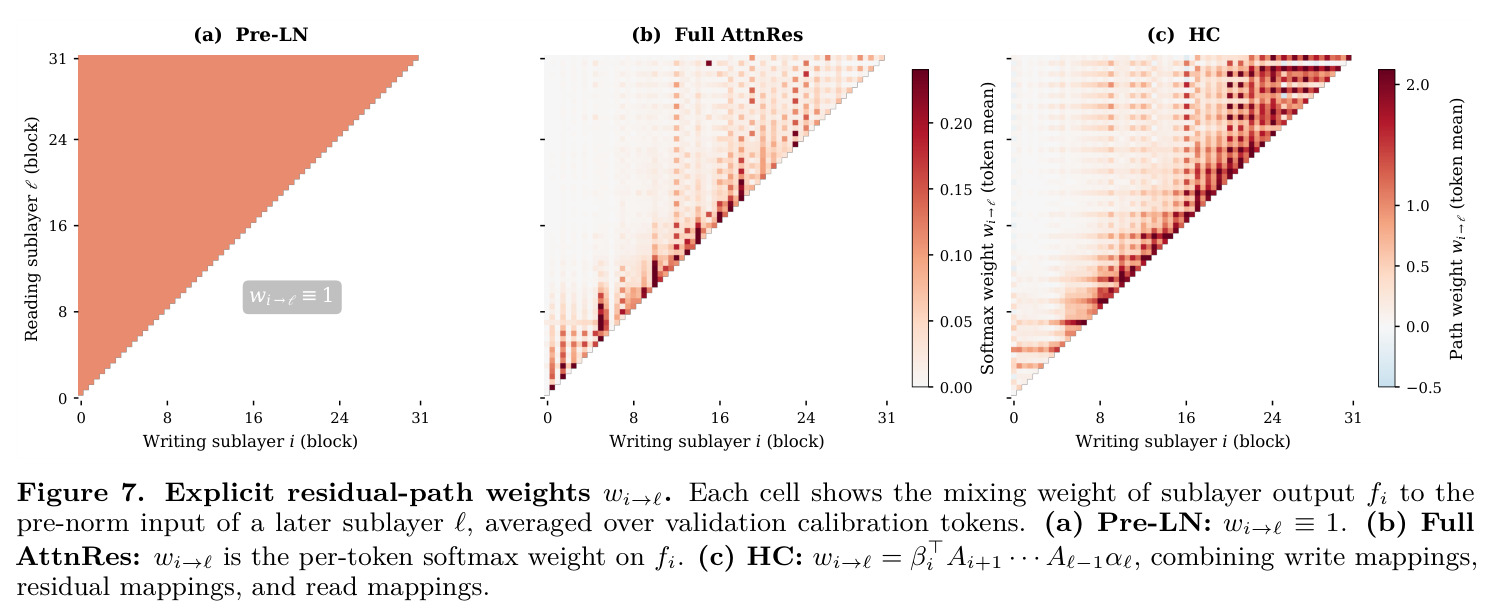
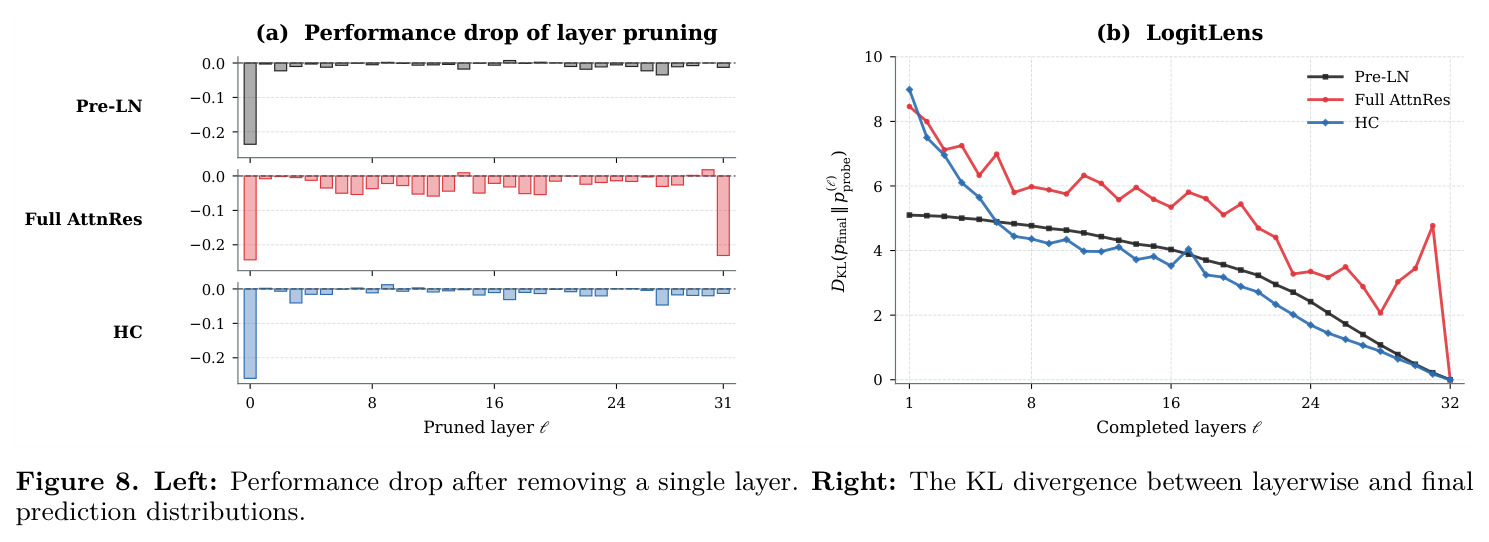
第一步,构造形状光谱:在 400M 总量下取 7 组 $(L, d)$ 配置,从 $(16, 1216)$ 宽深比 76.0 到 $(70, 640)$ 宽深比 9.14,中间层维度按 $d_{ff} = \text{ceil}_{16}(8d/3)$ 设置,总参数差控制在 ±2.14%(Table 3)。第二步,在同一骨干上实现 10 种架构:基线 Pre-LN 更新为 $h^\ell = h^{\ell-1} + F_\ell(\mathrm{LN}(h^{\ell-1}))$;Sandwich-LN 在分支前后各加归一化;LNS 对深层输出缩放 $1/\sqrt{\ell}$;DeepNorm 和 KEEL 改进 Post-LN 的梯度传播;HC 维护 4 条残差流,通过读写映射 $H^\ell = H^{\ell-1}A^\ell + F_\ell(\mathrm{LN}(H^{\ell-1}\alpha^\ell))\beta^{\ell\top}$ 传播;mHC 用 Sinkhorn–Knopp 归一化把残差映射约束为近似双随机;Full AttnRes 让每层对嵌入和所有先前子层输出做 softmax 加权混合 $h^\ell \propto \sum_{i=0}^{\ell-1}\phi(w^\ell, v^i)v^i$;Block AttnRes 只在每 $b/2$ 层的块边界保存块输出供后续层访问;MoDA 通过深度向 KV cache 提供跨层访问。第三步,统一配方预训练并按架构扫学习率取最优(最优学习率见 Table 4,多数为 $2\times10^{-3}$,LNS 为 $10^{-2}$,DeepNorm 为 $10^{-3}$)。第四步,主对比实验:验证损失(Figure 2、3)和下游 teacher-forced NLL——编码(MBPP+HumanEval)、STEM(SciQ+GPQA)、数学(GSM8K+MATH-500)(Figure 4)。第五步,机制诊断:计算表示角距离热图(Figure 5);统计最后四分之三层的因果分数超过 0.45 的比例 $R_{\text{causal}}$ 和置换分数超过 0.15 的比例 $R_{\text{perm}}$(Figure 6);可视化显式残差路径权重 $w_{i\to\ell}$(Figure 7);做单层剪枝和 LogitLens 分析(Figure 8);分析 Block AttnRes 的深度混合权重调度(Figure 9)和 mHC 残差传输的有效秩(Figure 10)。第六步,系统级测量:在 A100-SXM4-40GB、BF16、序列长 4096 下测量 prefill FLOPs、KV cache、峰值显存和 GPU 小时(Figure 11)。
技术新颖性
技术新颖性体现在四个方面。第一,这是第一个把等参数宽深比扫描与多架构横向对比结合的基准:此前 Gemstones 等形状研究固定在传统架构上,HC/mHC/AttnRes 等方法论文各自与不同 baseline 比较,从未有 10 架构 × 7 形状 × 4 套件的同协议对比。第二,层级诊断的聚合方式有方法学创新:相较于 Muhtar et al. (2026) 的全局层重要性统计,本文发现最初几层在几乎所有架构中都占主导,因此提出只统计最后四分之三的层内配对分数超过阈值的比例,这才让 Pre-LN 与 HC/AttnRes 在深层利用上的差异得以显现。第三,机制层面给出三个此前未知的具体解释:(a)HC 与 Full AttnRes 保持非平滑、层特异的表示变化,与 Pre-LN 深层逐渐同质化形成质变对比,关键不在变化幅度而在变化的结构;(b)Block AttnRes 缩放失败被归因于初始死区——L=16/24/32 时分别有 2/5/8 层的深度混合权重几乎为零、只能重读嵌入,最深配置下四分之一的网络无法从堆叠中受益,根因是固定 8 个块边界的调度;(c)mHC 的 Sinkhorn 双随机约束使残差传输趋向均匀混合矩阵 $U = \frac{1}{m}\mathbf{1}\mathbf{1}^\top$ 这一不动点,传播方向趋于共线(有效秩 1.44–1.65,HC 为 2.53–2.81),说明稳定化以牺牲长程路由多样性为代价。第四,明确量化了深度缩放的系统级隐性成本,指出这是架构-系统协同设计问题而非单纯的算力问题。
实验结果
核心发现可以逐条对应实验来看。(1)400M 主基准(Figure 2,每个配置取最优学习率):Pre-LN 验证损失随加深单调变差,从 L=16 的 2.759 升到 L=32 的 2.782;Sandwich-LN、LNS、DeepNorm、KEEL、MoDA 呈弱趋势或非单调,Pre-LN 家族的最优宽深比停留在 42.7–76.0,宽深比作为缩放轴基本失效。(2)相反,HC 从 2.729(L=16)单调改善到 2.699(L=32),Full AttnRes 从 2.751 到 2.718,且两者在极端深窄形状下仍持续改善——扩展到 70 层(宽深比 9.1)后趋势不变;在固定骨干 300M 的对照组中,即使深窄模型的总参数更小,改善依然存在,证明收益来自宽深分配本身而非骨干变大。(3)衍生变体不继承缩放能力:Block AttnRes 在 L=20 达到 2.715 后于 L=32 回升到 2.730;mHC 最优在 L=24,无随深度的单调增益。(4)多尺度(Figure 3):200M–500M 上 Full AttnRes 持续从更深形状受益,1.6B 上 Full AttnRes 依然改善(损失 3.006→2.950→2.937),Pre-LN 在宽深比 43.2 的 2.963 回升到 73.1 的 2.970,而 HC 的 500M 最大宽深比训练发散、1.6B 上改善不明显,说明 HC 对优化超参更敏感。(5)下游 NLL(Figure 4):HC 和 Full AttnRes 更深的模型在编码(MBPP/HumanEval)、STEM(SciQ/GPQA)、数学(GSM8K/MATH-500)上普遍 NLL 更低,STEM 和数学上趋势最清晰,而 Pre-LN 及多数变体呈弱趋势或非单调——深度收益不止于预训练损失。(6)深度利用机制(Figure 5、6):L=32 模型中,Pre-LN 后层因果分数只有约 1% 超过 0.45,Full AttnRes 约 16%、HC 约 7%;置换分数超过 0.15 的比例 Pre-LN 约 8%,Full AttnRes 约 46%、HC 约 35%,差距接近 6 倍。(7)代价(Figure 11):宽深比从 76.0 降到 9.1,prefill FLOPs 从约 3.0 涨到 4.4 TFLOPs/序列,KV cache 增加超过 2 倍,峰值显存和 GPU 小时向最深配置急剧上升,Full AttnRes 峰值显存最大、HC 实测 GPU 小时最高。
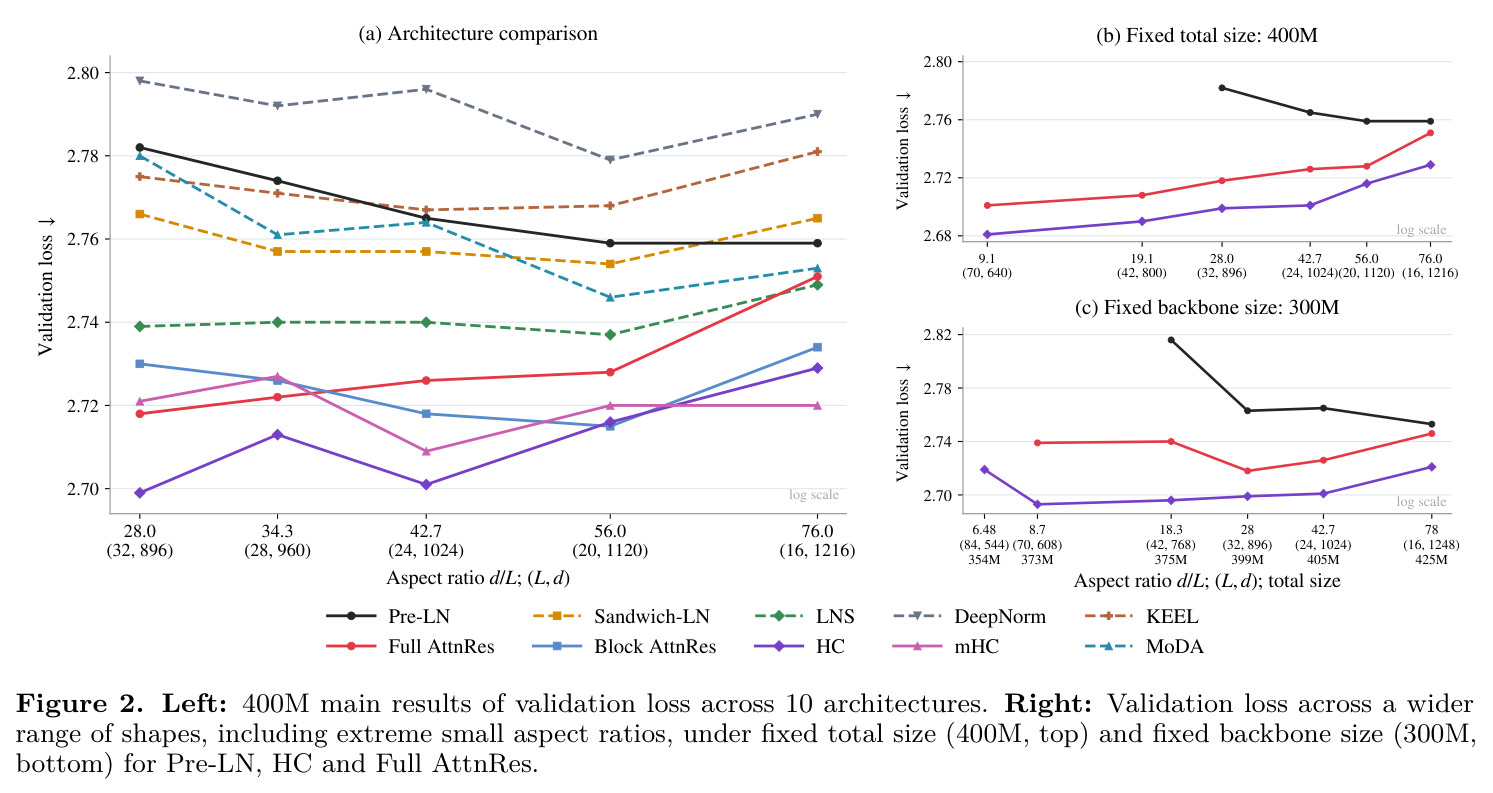
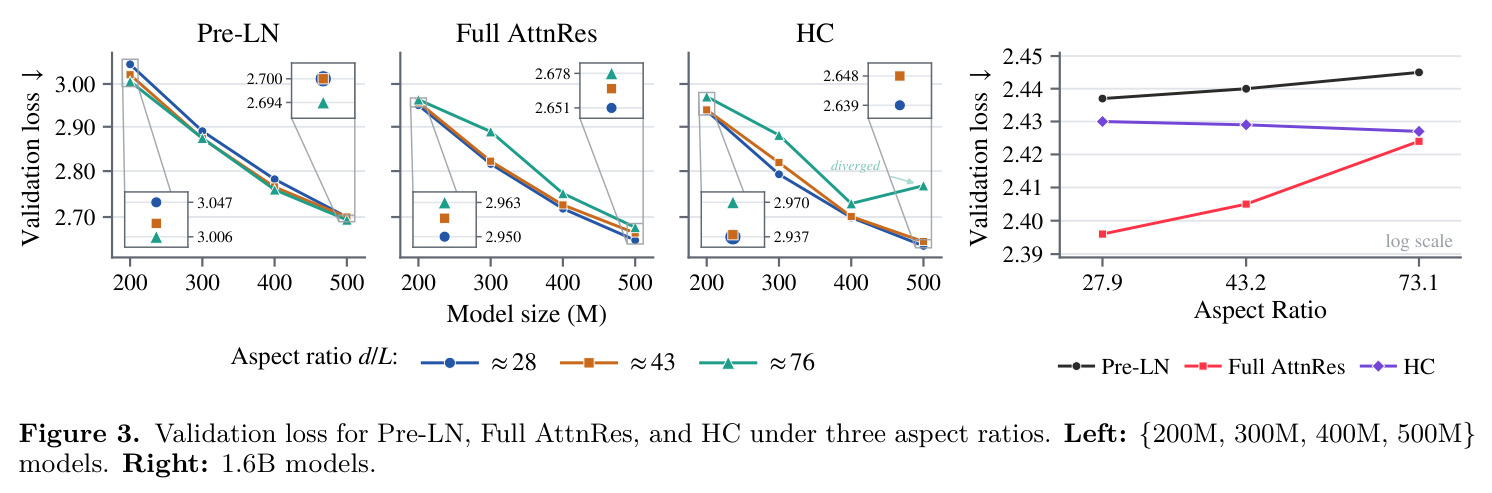
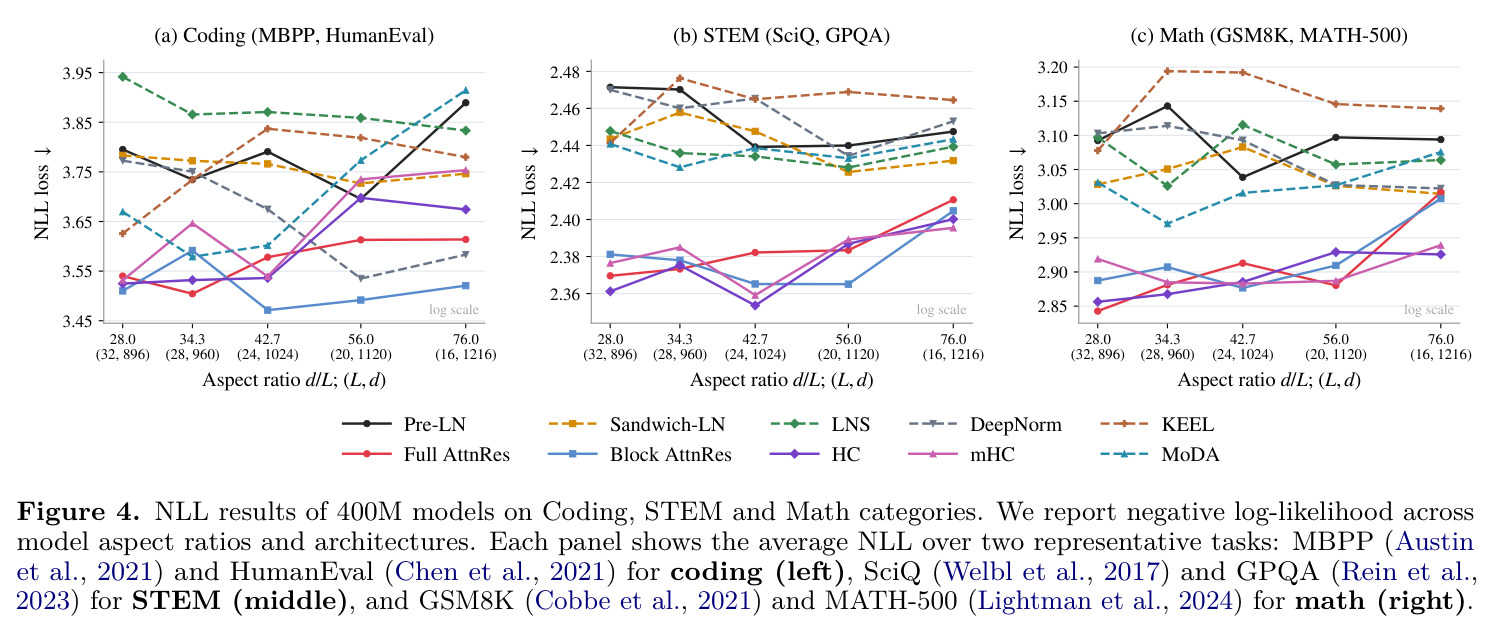
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 400M 等参数预训练(宽深比缩放,L=16→32) | 验证损失 | HC 2.729→2.699;Full AttnRes 2.751→2.718(随加深持续改善,至宽深比 9.1、70 层仍改善) | Pre-LN 2.759→2.782(随加深单调变差,最优在宽深比 42.7–76.0) | 同在最深形状(L=32)下 HC 比 Pre-LN 低 0.083、Full AttnRes 低 0.064,且缩放趋势完全相反 |
| 深层因果依赖性(L=32,跳层因果分数) | 因果分数 > 0.45 的层对比例(网络最后 3/4) | Full AttnRes ≈16%;HC ≈7% | Pre-LN ≈1% | Full AttnRes 约 16 倍、HC 约 7 倍,说明其深层具有更强的跨层因果影响 |
| 层顺序敏感性(L=32,交换两层后的损失变化) | 置换分数 > 0.15 的层对比例(网络最后 3/4) | Full AttnRes ≈46%;HC ≈35% | Pre-LN ≈8% | 约 5.8 倍 / 4.4 倍,说明其深层执行更专门化、不可互换的计算 |
| 1.6B 规模验证(宽深比 27.9→73.1) | 验证损失 | Full AttnRes 3.006→2.950→2.937(持续改善) | Pre-LN 3.047→2.963→2.970(最深处回升变差) | 最深形状(73.1)下 Full AttnRes 低 0.033,缩放趋势优于 Pre-LN |
| 下游领域 NLL(400M,宽深比扫描) | STEM(SciQ+GPQA)与数学(GSM8K+MATH-500)平均 teacher-forced NLL | HC 与 Full AttnRes 随加深一致改善(STEM 约 2.48→2.36 区间递减) | Pre-LN 及多数归一化变体呈弱趋势或非单调 | 定性优势:深度缩放收益迁移到领域预测能力,STEM/数学上最清晰 |
局限与改进
作者明确承认的局限有:(1)HC 的深度缩放在大规模下不稳定——500M 最大宽深比训练发散,1.6B 未复现清晰改善,原因是 HC 对优化超参敏感、可能需要更精细的跨尺度学习率调整(这也是 mHC 被提出的动机);(2)深模型有系统级效率代价:即使参数固定,与 $Ld$ 成正比的开销(注意力 prefill $O(T^2Ld)$、KV cache $O(TLd)$)随加深增长,且更深的模型硬件利用率更低、实际墙钟开销可能超过 FLOPs 所示,要在规模上兑现收益需要架构-系统协同设计和更好的 kernel。我自己的补充观察:(1)训练量偏小——400M 模型只训 8B tokens、1.6B 只训 32B tokens 且 1.6B 只有 3 个形状和单一学习率 $5\times10^{-4}$,1.6B 上 HC 的负结果可能只是学习率次优,结论向长训练、大数据机制的延伸性存疑;(2)下游评估全部是 teacher-forced NLL 而非生成式指标(pass@1、exact match),从更低 NLL 到更强实际能力的推理链不完整;(3)机制分析多为相关性证据(角距离、分数阈值),因果干预有限;(4)未评估长上下文和推理时扩展等深窄模型理论上可能更有优势的场景;(5) head dim、$d_{ff}$ 等随形状变化的细节可能引入次要混杂;(6)只在 FineWeb-Edu 单一数据分布上验证。
独立分析的弱点
独立分析本文弱点及改进方向:(1)规模与训练量天花板——最大只有 1.6B、32B tokens,且 1.6B 的 HC 只用了单一学习率 $5\times10^{-4}$ 就下结论改善不明显,这与作者自己指出的 HC 需要精细调参相矛盾;改进方向是在 1.6B 补学习率扫描或采用 schedule-free 优化器,并在 ≥7B 规模复验。(2)下游评估过弱——只用 teacher-forced NLL 无法回答深窄模型是否真正提升生成质量;改进方向是加入生成式 few-shot 评测(HumanEval pass@1、GSM8K 精确匹配)、长上下文任务和智能体任务,检验有效深度的真实红利。(3)系统成本测量太初步——只在单卡 BF16 prefill 下测了四个量,没有建模训练墙钟、没有多卡并行场景;改进方向是建立包含 kernel 效率、流水线并行的深度-效率 Pareto 前沿模型,并给出训练感知的宽深比选择准则。(4)Block AttnRes 的死区来自固定 8 个块边界的调度,深层时边界过稀导致初始多层只能重读嵌入;改进方向是让边界数量随深度增长或让模型可学习边界位置。(5)mHC 的分析揭示了稳定化与表达力的两难,但未给出折中方案;改进方向是放松为近似双随机并加谱正则,保住传播方向多样性的同时控制不稳定。(6)机制诊断依赖手工阈值(0.45/0.15)和相关性度量;改进方向是引入梯度流、CKA、电路级分析,进一步区分信息访问与优化友好性两种机制。
未来方向
作者提出的方向:(1)架构-系统协同设计——深窄模型虽在建模上占优,但需要专门的 kernel、流水线调度、通信重叠等基础设施层面的优化才能在实际效率上兑现收益,作者为此开源了覆盖宽宽深比范围的代码和 checkpoint 以便社区探索。(2)在更大规模和更充分训练下复验 HC 的稳定性(其 1.6B 表现可能是超参问题)。基于本文成果可延伸的方向:(1)把宽深比纳入缩放定律公式,拟合形状感知的 Chinchilla 定律,使给定算力下能直接预测最优 $(L,d)$ 与架构组合;(2)混合式残差设计——在浅层用廉价的标准残差、只在深层启用 AttnRes/HC 式跨层访问,以折中峰值显存与建模收益(Full AttnRes 显存占用最大是明确痛点);(3)与 MoE、长上下文结合——prefill 成本 $O(T^2Ld)$ 在 $T \gg d$ 时最突出,深窄形状对长上下文效率的影响值得专门研究;(4)可学习的深度混合调度以修复 Block AttnRes 的死区问题;(5)研究深窄形状对推理时扩展(长 CoT)和蒸馏的影响——MobileLLM 已证明深窄架构在子十亿规模的实用价值,其与测试时计算的结合是自然延伸;(6)从理论上刻画残差传输有效秩(HC 为 2.53–2.81、mHC 为 1.44–1.65)与有效深度之间的定量关系,把本文的经验观察升华为可预测的设计原则。
复现评估
复现条件相当好。开源情况:代码(DepthBench,基于 OLMo-core 构建)和覆盖宽宽深比范围的全套 checkpoint 均已发布(论文首页给出 Code 与 HuggingFace Checkpoints 链接),文本只用了公开的 FineWeb-Edu 数据集,无私有数据。训练配置完整给出:AdamW($\beta_1=0.9$、$\beta_2=0.95$、$\epsilon=10^{-8}$)、权重衰减 0.1、梯度裁剪 1.0、序列长 2048、全局 batch 512、cosine 衰减加 10% 线性 warmup、峰值学习率逐架构给出(Table 4)。算力估计:400M 模型训 8B tokens 约 8000 步,按论文测量的 GPU 小时(Figure 11,batch 8 下每 10 亿 prefill token 约 2–5 GPU 时量级)推算单个 400M 模型在百 A100-小时量级;主基准含 10 架构 × 7 形状 × 4 学习率约 280 次训练,加上多尺度和 1.6B 套件,总算力对一个装备良好的实验室可负担。难度评估为中等:主要风险点在个别架构的实现细节和稳定性——DeepNorm 在学习率 $2\times10^{-3}$ 下会爆炸(作者因此将其排除在该分析外)、HC 高宽深比可能发散、LNS 需要单独的学习率范围——但附录提供了架构实现细节(Appendix A)和完整学习率扫描结果(Appendix C),且 checkpoint 可直接用于验证层级诊断部分的分析。
论文图表
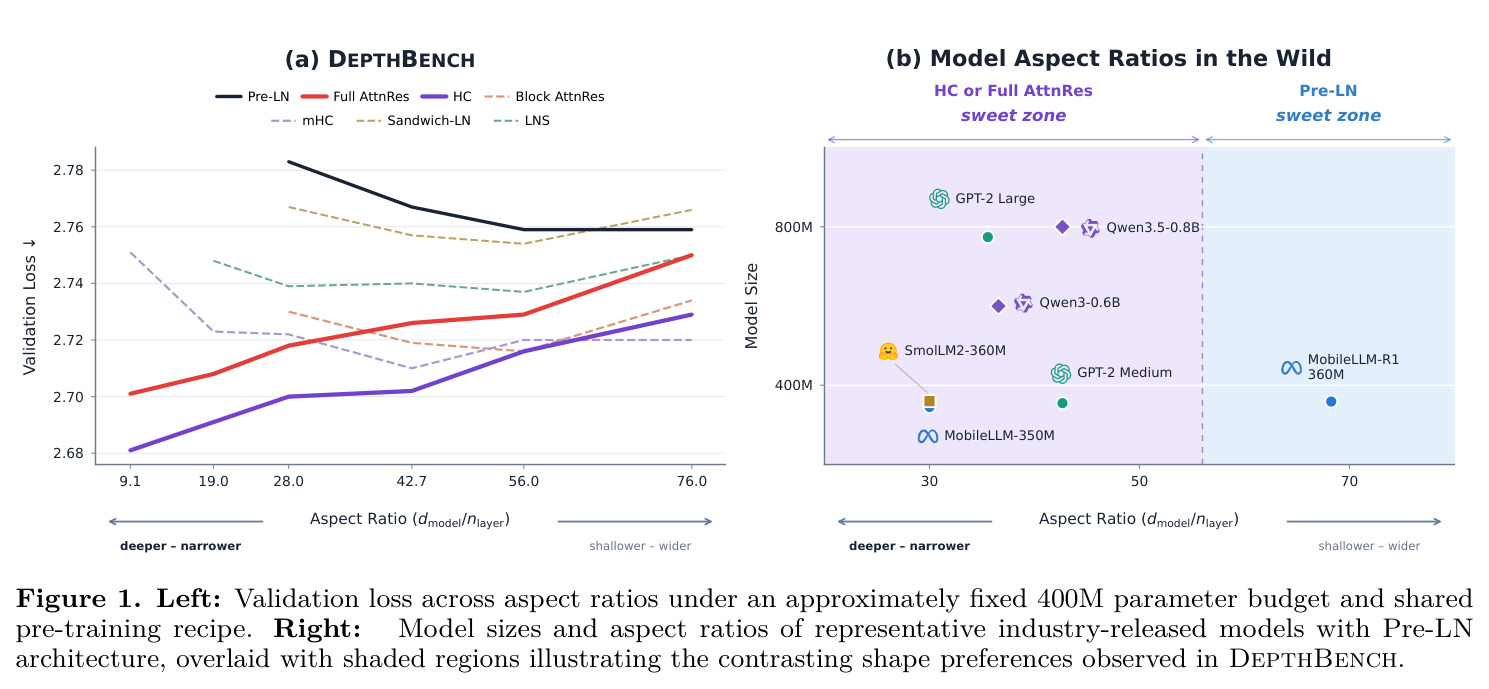
左图在约 400M 固定参数预算和共享训练配方下,画出 Pre-LN、Full AttnRes、HC、Block AttnRes、mHC、Sandwich-LN、LNS 七种架构的验证损失随宽深比(9.1 到 76.0)的变化曲线,可以看到 HC 和 Full AttnRes 的曲线随宽深比减小(更深更窄)持续下降并进入左下角 sweet zone,而 Pre-LN 等在右侧(浅宽)达到最优。右图把 GPT-2 Medium/Large、SmolLM2-360M、Qwen3-0.6B、MobileLLM-350M/360M、Qwen3.5-0.8B 等业界实际发布模型的规模与宽深比标注在同一坐标系上,叠加两种相反的形状偏好阴影区。
这是全文的电梯图:一图同时呈现核心发现(架构决定深度缩放能力)和现实意义(业界 Pre-LN 模型的形状选择与本文发现的偏好区域之间的错位),读者看懂这张图就抓住了论文的问题和答案。
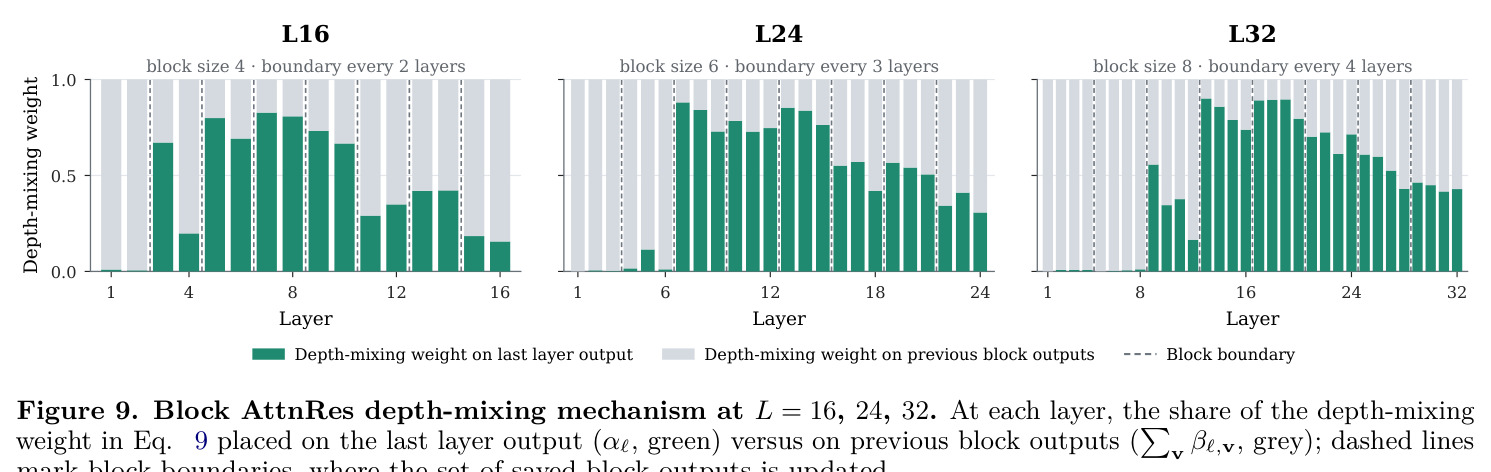
展示 Block AttnRes 在 L=16/24/32(块大小 4/6/8,每 2/3/4 层一个边界)下的深度混合机制:每层画出公式 $\tilde{h}^\ell \propto \alpha^\ell s^\ell + \sum_{v \in B^\ell} \beta_{\ell,v} v$ 中放在最近层输出 $s^\ell$ 上的权重 $\alpha^\ell$(绿色)与放在历史块输出上的权重之和(灰色),虚线标出块边界。在第一个块输出被保存之前,softmax 给运行和的权重几乎为零,网络只能反复重读嵌入;这个初始死区长度随深度增长(L=16/24/32 分别为 2/5/8 层)。
解释了 Block AttnRes 为何停止从深度获益——最深配置下四分之一的网络无法受益于层堆叠,这是论文对衍生变体失效机制最具体的一项归因。
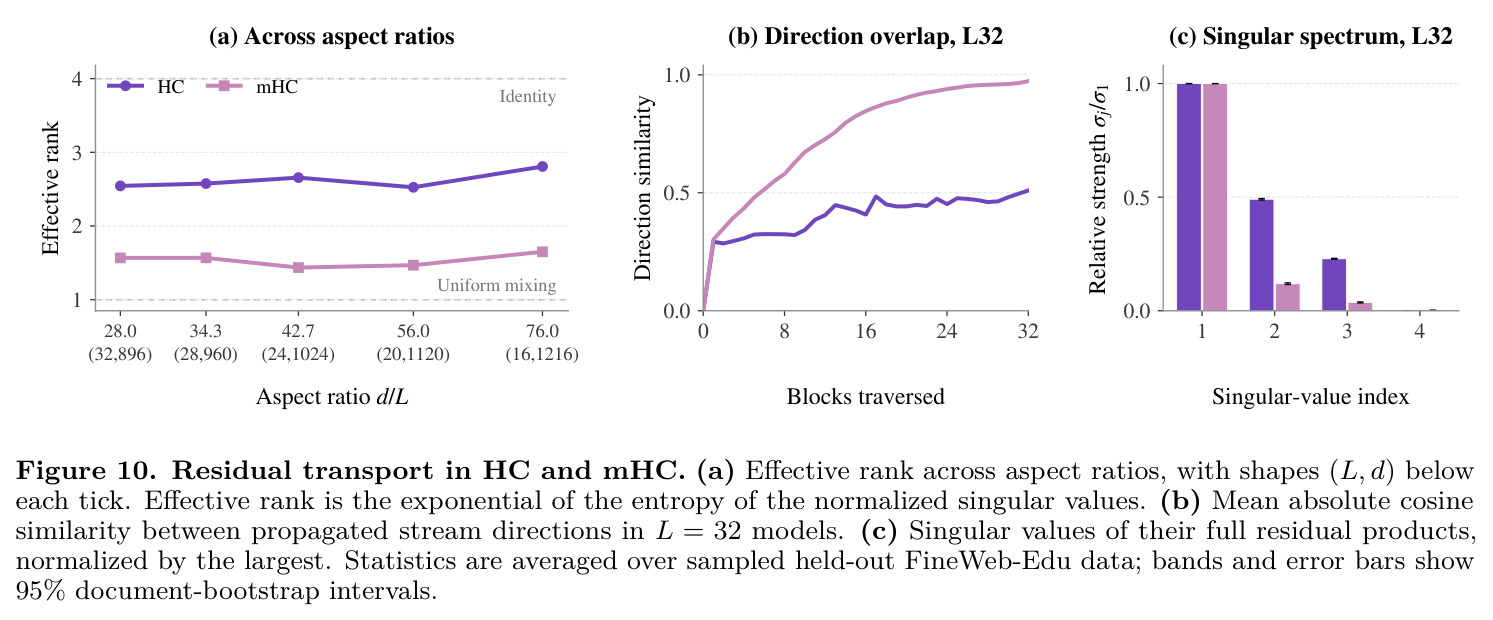
对比 HC 与 mHC 的残差传输特性:(a) 沿前向路径复合所有注意力/FFN 残差映射后的乘积的有效秩(归一化奇异值熵的指数),HC 为 2.53–2.81,mHC 仅 1.44–1.65,且在所有宽深比上 mHC 都更低;(b) L=32 时 mHC 的传播流方向平均余弦相似度接近恒等/均匀混合参照,方向近乎共线;(c) mHC 残差乘积的相对奇异值谱衰减远快于 HC。统计基于 FineWeb-Edu 留出数据,误差带为 95% 文档自助法区间。
为 mHC 的失效提供了谱视角的定量机制:Sinkhorn 双随机约束使残差传输趋向均匀混合矩阵这一不动点,稳定化的代价是长程路由多样性坍缩,是理解稳定与表达力两难的关键证据。
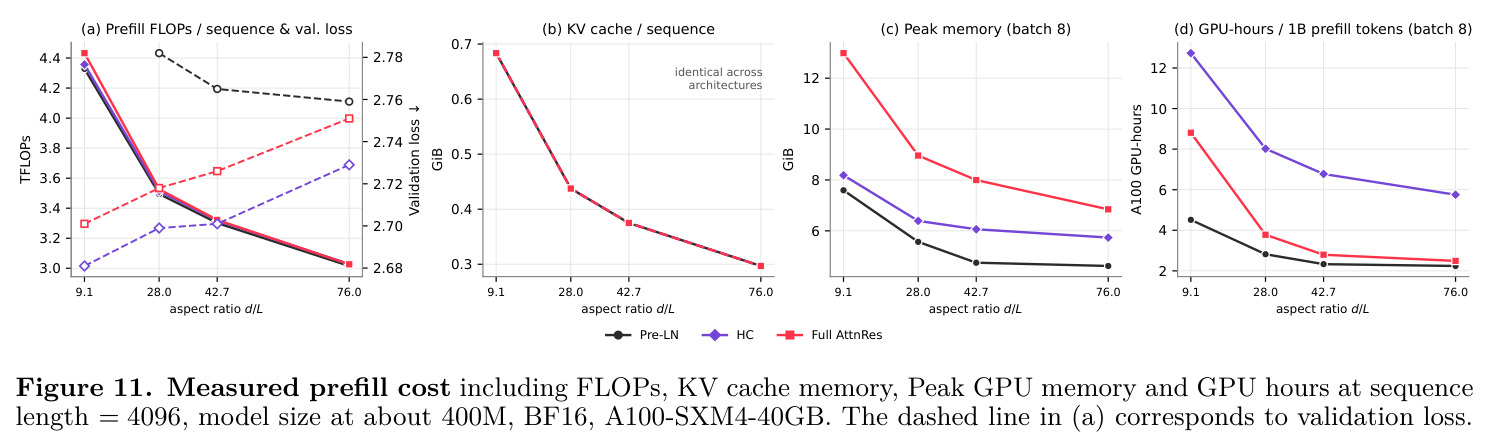
四个面板测量 400M 模型在 A100-SXM4-40GB、BF16、序列长 4096、batch 8 下的系统开销随宽深比(76.0→9.1)的变化:(a) 每序列 prefill FLOPs 从约 3.0 升到 4.4 TFLOPs(叠加验证损失参考线);(b) KV cache 每序列从约 8 GiB 升到 10 GiB(增幅超过 2 倍,且三种架构完全一致,说明这是宽深重分配的固有成本);(c) 峰值显存向最深配置急剧上升,Full AttnRes 最大;(d) 每 10 亿 prefill token 的 GPU 小时同样急剧上升,HC 实测最高。
量化了深度缩放的隐藏代价,给出 no free lunch 的完整图景:算法上的收益伴随着系统级效率损失,实际墙钟开销依赖硬件、kernel 和并行策略,这决定了论文结论的工程适用边界。