Muon-RT:复用教师轨迹的无动量 Muon 优化器用于大模型自蒸馏 MUON-RT Reusing the Teacher's Trajectory for Momentum-Free Muon for LLM Self-Distillation
自蒸馏中EMA教师的位移可替代Muon动量缓冲,省27–42%显存且精度更高
前置知识
EMA 教师(指数移动平均教师)
在自蒸馏/半监督训练中额外维护一份学生权重的指数滑动平均:$\theta_T \leftarrow \tau\theta_T + (1-\tau)\theta_S$,$\tau$ 接近 1(本文 SDFT 用 $\tau=0.99$)。教师与学生同步演化但带时间滞后,其预测是平滑后的版本,作为更稳定的学习目标(源自 Mean Teacher、BYOL、DINO 等自监督方法)。
Muon-RT 的全部额外信息都来自这个教师副本:论文的核心命题是“教师−学生位移”里已经编码了动量想捕捉的更新历史,因此理解 EMA 的递推结构是读懂 Lemma 1 的前提。
Muon 优化器与 Newton–Schulz 正交化
Muon 对每个隐层权重矩阵 $W\in\mathbb{R}^{A\times B}$ 维护动量 $M\leftarrow\mu M+G$,对 Nesterov 方向跑 $K$ 次五次 Newton–Schulz 迭代 $X_{r+1}=(\kappa_1 I+\kappa_2 X_rX_r^\top+\kappa_3(X_rX_r^\top)^2)X_r$,把更新近似正交化(各奇异值趋近相等),再按 $c_{A,B}=0.2\sqrt{\max(A,B)}$ 缩放以匹配 AdamW 的更新 RMS。Kimi K2、GLM-4.5 均采用。
本文是对 Muon 的直接改造:删掉动量缓冲、替换为教师位移分支。只有理解 NS 正交化的非线性放大效应,才能明白为什么教师方向必须在正交化之后混入(否则弱奇异方向会被抬升到单位奇异值,教师影响失控)。
自蒸馏微调(SDFT)与自蒸馏策略优化(SDPO)
学生用自己生成的补全 $y\sim\pi_S(\cdot|x)$,让教师基于特权上下文 $c$(SDFT 中是专家示范,SDPO 中是成功尝试的反馈)评估同样的 token,最小化 token 级散度 $\mathcal{L}=\mathbb{E}\sum_j \mathcal{D}(p_{S,j},\mathrm{sg}[p_{T,j}])$。相比普通 SFT 能显著减少灾难性遗忘。教师即学生的 EMA。
这是论文的实验载体和方法适用边界:Muon-RT 只在“已维护参数对齐 EMA 教师”的场景下成立,所有实验(Qwen2.5-7B 上 SDFT、Olmo-3-7B 上 SDPO)都在此框架内进行。
动量(momentum)及其代价
优化器维护梯度的一阶滑动平均 $M\leftarrow\mu M+G$,用来平滑随机噪声、加速一致方向。代价是每个隐层矩阵多一份与权重同尺寸的持久状态;AdamW 还要再存两个矩估计。动量平均的是“梯度”,而 EMA 教师平均的是“权重”——这是本文区分二者信息内容的关键视角。
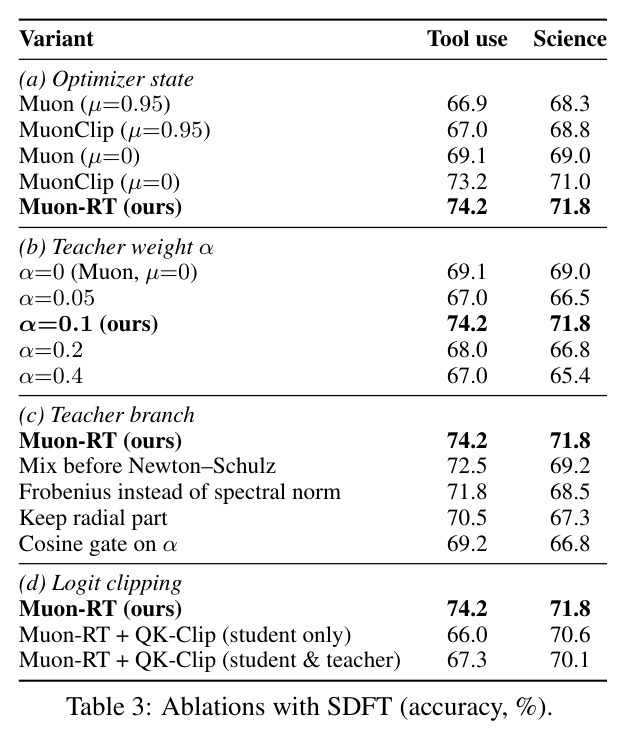
论文要回答的问题就是“这份动量缓冲能否被免费信息替代”;且消融显示在目标移动的自蒸馏中梯度动量反而有害(µ=0.95 比 µ=0 低 0.7–6.2 点),这构成了删除动量的双重动机。
PL 条件(Polyak–Łojasiewicz)
非凸优化常用的正则性假设:$\tfrac{1}{2}\|\nabla F\|_F^2 \ge \mu_{PL}(F-F^\star)$,即梯度范数平方控制次优间隙。配合 L-平滑性,可证明目标间隙的线性收敛 $\mathbb{E}[\Delta_{s+1}]\le q\,\mathbb{E}[\Delta_s]+\text{噪声项}$,$q=1-2\mu_{PL}\eta\gamma$。
定理 1 的收敛保证完全建立在这类标准假设上(平滑性 + PL + 有界教师漂移 + 下降对齐),读懂它才能理解“教师分支何时让收敛更快”(Corollary 1:提高有效下降系数 $\gamma$)。
研究动机
基于 EMA 教师的自蒸馏(SDFT/SDPO)是适配 LLM 的有效范式:学生从自己的生成中学习、教师基于特权上下文给出目标,能习得新技能的同时保留旧能力。但训练时的显存开销很高——必须同时持久保存学生参数、教师参数和优化器状态。AdamW 每个参数要存两个运行矩估计;即便换用 Muon(已比 AdamW 省一半优化器状态),每个隐层矩阵仍要维护一份动量缓冲。以 Qwen2.5-7B-Instruct 为例,论文统计两块 GPU 上的持久状态总量:动量版 Muon 需 103.2 GB,AdamW 需 129.0 GB,而理想情况(只有学生+教师)是 75.4 GB——多出来的部分全部是优化器状态。更糟的是,动量在自蒸馏里不仅费内存还可能有害:蒸馏目标随教师每步演化,历史梯度平均指向的是已经过时的目标,作者消融实验显示标准动量(µ=0.95)使 Muon 和 MuonClip 在两个任务上精度下降 0.7–6.2 个百分点。现有的省内存方案(GaLore 低秩投影、4-bit 状态量化、Adam-mini 共享统计等)都从优化器自身状态下手,没有人利用自蒸馏里“本来就要维护”的教师副本。
本文的目标是论文提出一个明确的研究问题:能否用自蒸馏中已存在的教师参数轨迹替代 Muon 的动量缓冲,在降低持久显存的同时提升任务精度?具体目标有三层:(1) 理论上刻画 EMA 教师−学生位移到底编码了什么信息,证明它是一种折扣加权的“已施加更新历史”并具有降噪性质;(2) 设计一个 drop-in 优化器 Muon-RT,删除隐层矩阵的动量缓冲,把归一化后的位移以有界权重混入更新方向,且不改变训练目标;(3) 在 SDFT(Qwen2.5-7B-Instruct,工具使用+科学问答)和 SDPO(Olmo-3-7B-Instruct,Biology+Materials 后训练)两个宿主上验证精度、收敛速度、旧能力保留和内存的全面表现。
与已有工作不同的是,本文的独特切入角度是“跨组件复用”:已有工作要么重新设计目标(SDFT/SDPO)但保留标准优化器,要么重新设计优化器状态(GaLore、量化、共享统计)但与训练框架无关。没有人注意到自蒸馏训练里天然存在两份模型副本,它们之间的位移本身就是优化器状态的信息来源。技术上的关键洞察是:动量平均的是梯度,而教师平均的是权重,动量式信息不在教师本身、而在教师−学生位移中——梯度下降下位移正比于梯度动量,Muon 下位移记录的是已被正交化的历史更新。这与梯度动量有本质区别:它捕捉的是“实际施加到学生上的更新”,而不是“指向过时目标的梯度”。另一个工程上的独到判断是混合位置:由于 NS 正交化会把弱奇异方向放大到单位值,位移必须在正交化之后以有界系数混入,才能严格控制历史信息的贡献。
核心方法
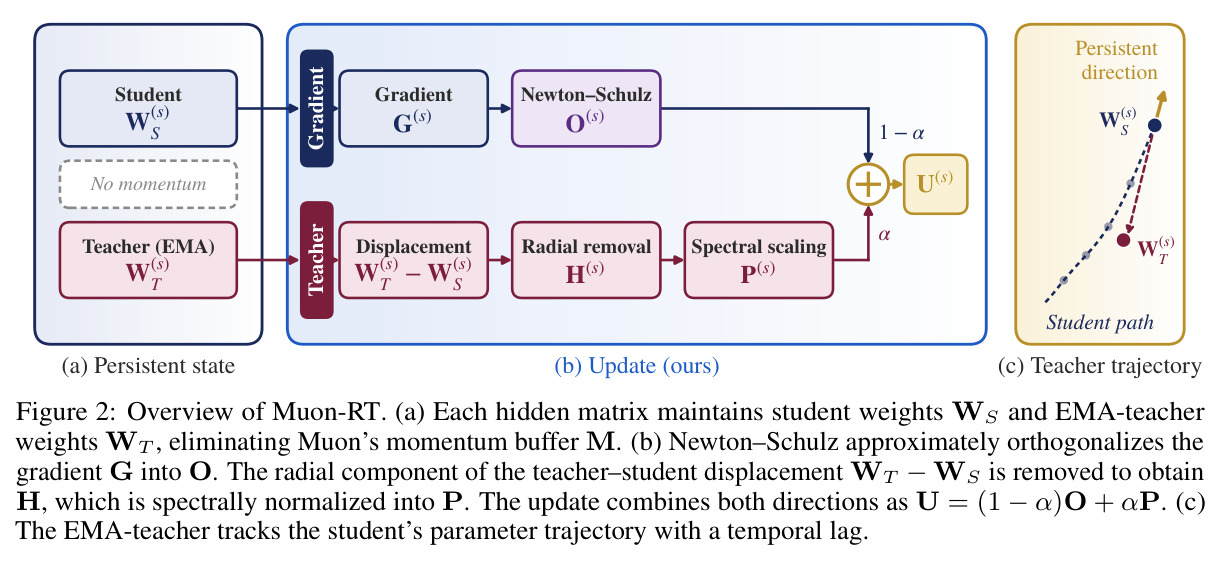
直觉上,EMA 教师每步只向学生靠拢一小步($\tau=0.99$ 即移动位移的 1%),因此始终“落后”于学生;这份落后量恰好是历史更新方向的指数加权平均——正是动量想要捕捉但需要额外缓冲才能存下的东西,现在可以免费读取。技术路线分三条支路再汇合:(1) 梯度支路:不带动量地正交化当前梯度 $O=NS_K(G)$(等价于 µ=0 的 Muon);(2) 教师支路:计算位移 $D=W_T-W_S$,先去掉与学生权重平行的径向分量(抑制权重缩放/权重衰减类变化),再用幂迭代估计最大奇异值做谱归一化,得到范数约为 1 的方向 $P$;(3) 混合:在正交化之后按 $U=(1-\alpha)O+\alpha P$($\alpha=0.1$)合并,随后按 Muon 常规方式更新 $W_S\leftarrow(1-\eta\lambda)W_S-\eta c_{A,B}U$。除一个用于幂迭代热启动的长度 $B$ 向量外,不保留任何模型级额外缓冲;$O,D,H,P,U$ 都是逐矩阵处理、用完即释放的临时张量。理论侧给出 Lemma 1(位移=折扣更新和)、Lemma 2(方差按 $(1-\tau)/(1+\tau)$ 缩减)和定理 1(PL 条件下的线性收敛到邻域)。
核心创新点是“把训练中已有的模型副本当作优化器状态来读”。区别于所有已有省内存优化器(改造优化器自身的状态表示),Muon-RT 从训练框架自带的 EMA 教师中提取历史信息,实现零新增缓冲的“动量替代”。信息论层面的关键论证由两个引理完成:Lemma 1 证明位移就是已施加更新的折扣和 $W_T^{(s)}-W_S^{(s)}=\tau\eta c_{A,B}\sum_{j=0}^{s-1}\tau^j U^{(s-1-j)}$;Lemma 2 证明在局部模型 $U^{(s)}=d+\xi^{(s)}$(固定方向+时间不相关噪声)下,它的期望收敛到 $d$、方差按因子 $(1-\tau)/(1+\tau)$ 缩减——即位移是一个降噪后的“持续运动方向”估计。Proposition 1 进一步证明单步瞬时对齐上教师方向不可能超过梯度的极化因子($\langle G,P\rangle_F\le\langle G,Q\rangle_F=\|G\|_*$),从而把收益来源干净地限定为时间信息与降噪。与已有方法的本质区别还在于对动量的重新审视:梯度动量平均的是针对不断移动目标的旧梯度(自蒸馏里这有害),而位移记录的是实际应用过的更新,且通过径向去除+谱归一化+正交化后有界混合三重处理,保证它只“引导”而不“接管”当前梯度。
方法步骤详情
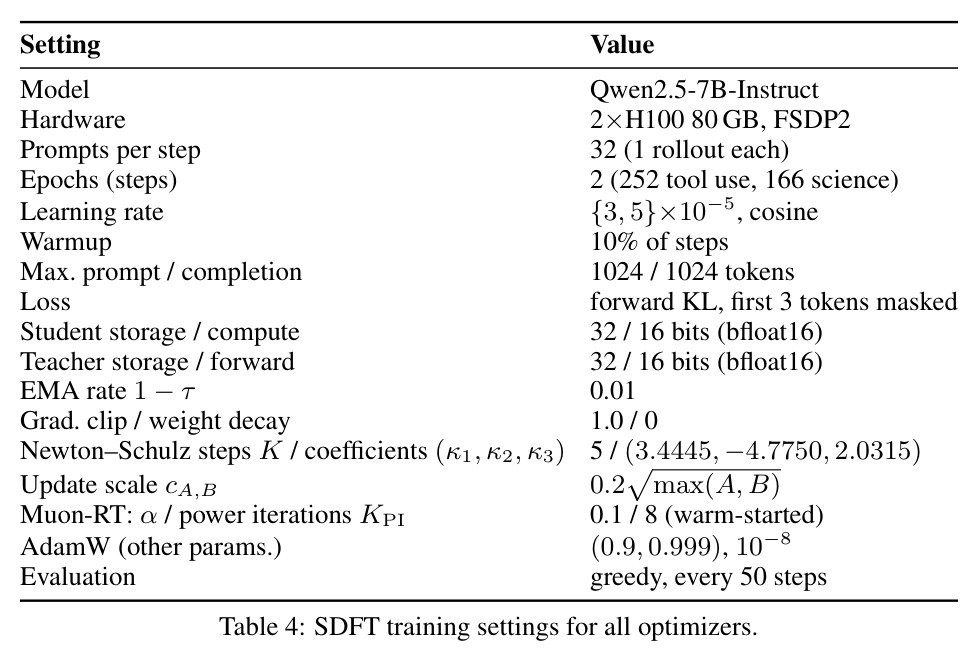
每个优化步的完整流程(Algorithm 1):输入学生 $\theta_S$、EMA 教师 $\theta_T$、损失 $\mathcal{L}$、混合权重 $\alpha$、EMA 系数 $\tau$、学习率 $\eta$、权重衰减 $\lambda$。第一步,对学生做前向/反向传播,得到每个隐层矩阵的梯度 $G_\ell=\nabla_{W_{S,\ell}}\mathcal{L}$。第二步,梯度支路:$O_\ell=NS_K(G_\ell)$,即 5 次五次 Newton–Schulz 迭代(系数 $\kappa=(3.4445,-4.7750,2.0315)$),输入先按 Frobenius 范数归一化。第三步,教师支路:计算位移 $D_\ell=W_{T,\ell}-W_{S,\ell}$;径向去除 $H_\ell=D_\ell-\frac{\langle D_\ell, W_{S,\ell}\rangle_F}{\|W_{S,\ell}\|_F^2+\epsilon}W_{S,\ell}$;用 8 次幂迭代(从上一步保存的右奇异向量热启动,初始随机向量会低估 $\sigma_{max}$ 约 8%,热启动 3 步内消除误差)估计 $\hat\sigma_{max}(H_\ell)$,得 $P_\ell=H_\ell/\max(\hat\sigma_{max},\epsilon)$。第四步,混合与更新:$U_\ell=(1-\alpha)O_\ell+\alpha P_\ell$($\alpha=0.1$),就地更新 $W_{S,\ell}\leftarrow(1-\eta\lambda)W_{S,\ell}-\eta c_{A,B}U_\ell$,随后释放该矩阵的临时缓冲再处理下一个矩阵。第五步,非隐层参数(嵌入、输出头、norm 权重、bias)照常用 AdamW。第六步,EMA 更新教师 $\theta_T\leftarrow\tau\theta_T+(1-\tau)\theta_S$(SDFT 用 $\tau=0.99$,SDPO 用 $\tau=0.95$)。分布式实现基于 FSDP2:学生与教师用相同分片布局,位移本地计算,式 (9) 的内积跨 rank all-reduce,$G$ 和 $H$ 临时 gather 成全矩阵做 NS 和幂迭代,各 rank 只更新自己的分片;已验证分片与非分片结果一致、$\alpha=0$ 时与 Muon µ=0 逐位相同。
技术新颖性
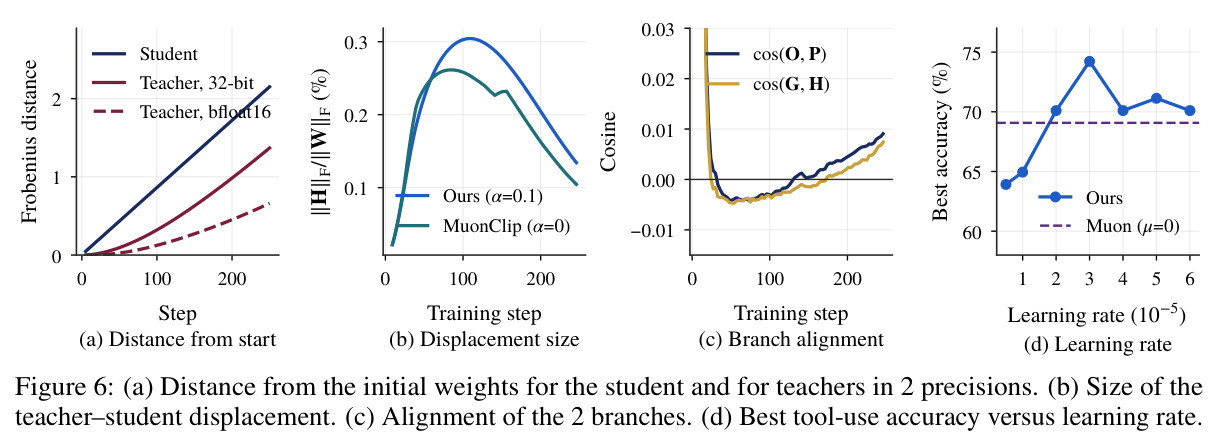
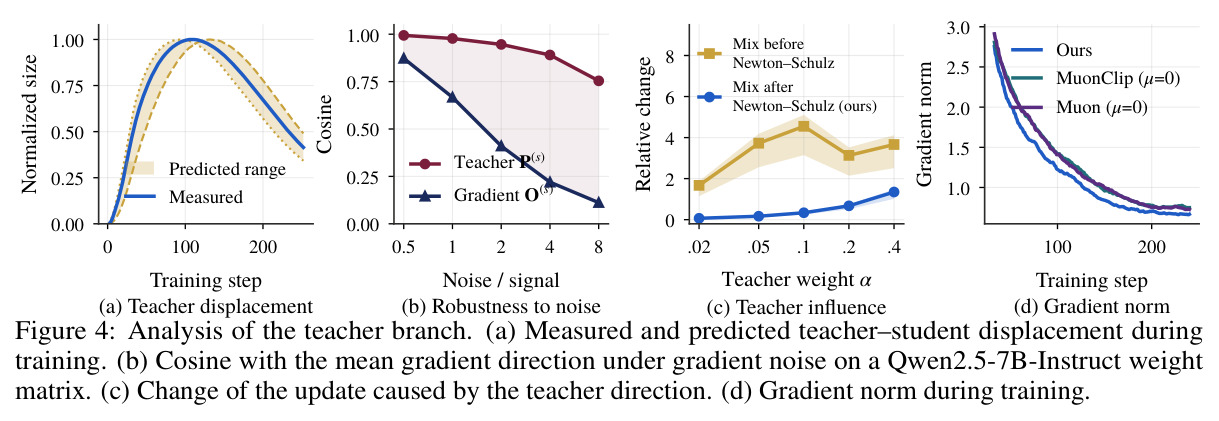
理论新颖性:这是首个系统刻画“EMA 教师位移信息内容”的工作——证明它是折扣更新历史(Lemma 1)、在温和条件下是降噪方向估计(Lemma 2),并用 Proposition 1 排除了一种过度解读(教师分支无法改进单步瞬时对齐),从而把增益机制严格归因于时间信息。这与 Defazio 等人“动量可写成迭代平均”的视角互补但不同:后者把平均当作专用缓冲,本文刻画的是两份活跃模型副本之间位移的语义。工程新颖性:三个具体设计都有实证支撑——(1) 混合必须在 NS 之后,文中测得 NS 前混合即使 $\alpha=0.02$ 造成的更新改变也超过其自身范数(NS 会把教师的弱奇异方向抬升到单位值),而 NS 后混合随 $\alpha$ 线性增长、影响可控;(2) 径向去除抑制权重缩放噪声,消融显示保留径向分量掉 1.3–4.5 点;(3) 谱归一化(而非 Frobenius)使 $\|\alpha P\|_2\le\alpha$ 有界,Frobenius 版本掉 0.9–3.3 点。实证闭环也很扎实:预测位移与实测相关 0.97、两分支余弦绝对值小于 0.015(教师几乎正交于当前梯度、补充梯度未覆盖的方向)、$\alpha=0$ 时实现与 Muon µ=0 逐位一致,理论声称都有对应的测量。
实验结果
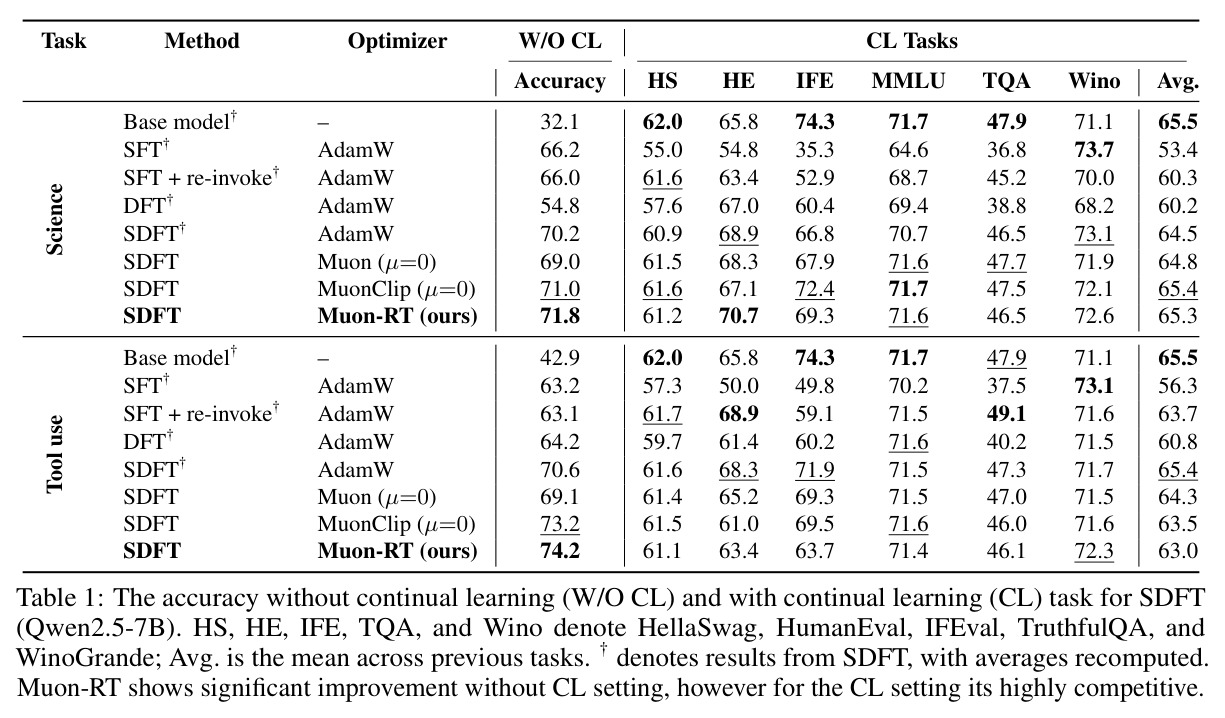
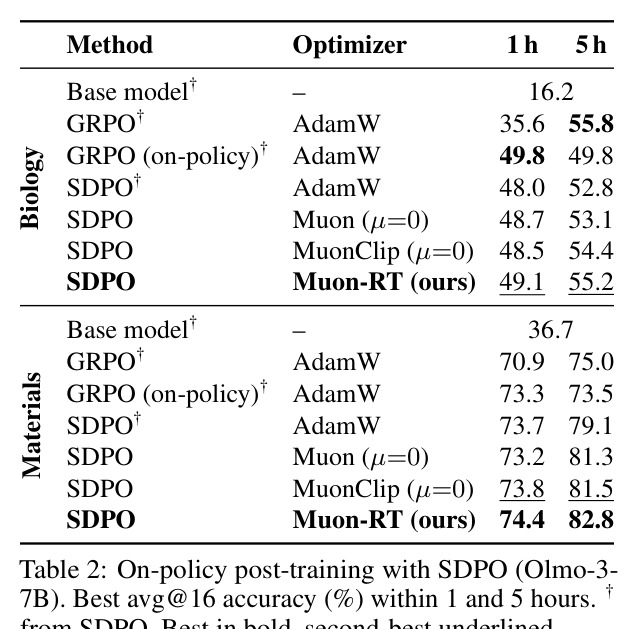
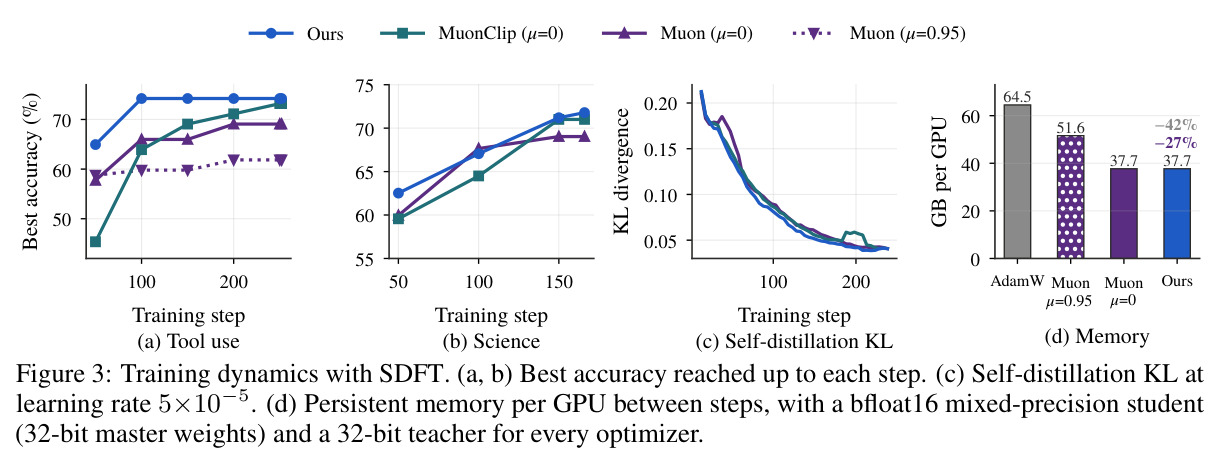
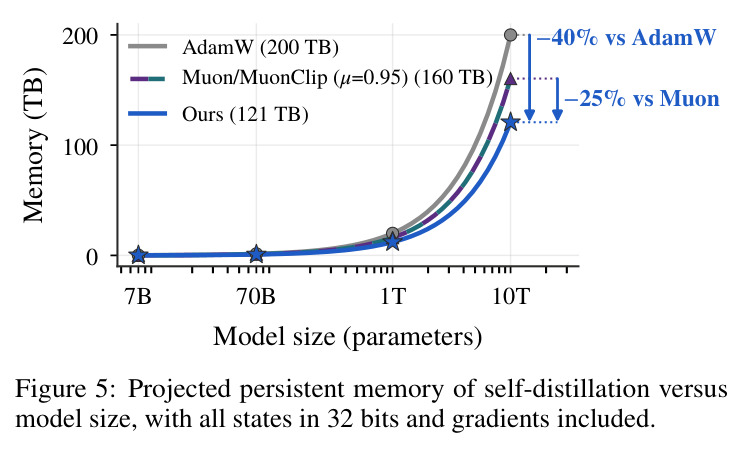
SDFT(Qwen2.5-7B-Instruct,表 1):Muon-RT 在两个新任务上取得所有优化器中的最高精度——工具使用 74.2%(SDFT+AdamW 为 70.6%,无动量 Muon 69.1%,MuonClip µ=0 73.2%),科学问答 71.8%(AdamW 70.2%);相对共享同一 32 位教师、只差教师分支的无动量 Muon,提升 5.1 和 2.8 点,可直接归因于教师复用。汇总看:平均精度比 AdamW 高 2.6 点且持久显存少 42%,比动量 Muon 高 5.4 点且显存少 27%(图 1)。收敛显著更快:工具使用任务 100/252 步即达 74.2%,MuonClip 需 250 步才到 73.2%(图 3a)。旧能力保留:由于只改优化器,保留主要由宿主损失决定,所有自蒸馏运行的旧能力平均相差在 2.4 点内;Muon-RT 比 SFT 高 11.9(工具使用)/6.7(科学)点,科学任务上拿到最佳 HumanEval 70.7;工具使用上所有 Muon 变体比 AdamW 平均低 1.1–2.4 点(主要在 IFEval),但 Muon-RT 仍保住 AdamW 平均的 96%(63.0 vs 65.4)。SDPO(Olmo-3-7B-Instruct,表 2):Biology 1h/5h 为 49.1/55.2,Materials 74.4/82.8(全场最佳),平均比 SDPO+AdamW 高 2.0 点;优势随训练时长扩大——1 小时领先 0.7–1.1 点,5 小时领先 2.4–3.7 点,与“收益来自轨迹累积信息”的解释一致。Muon-RT 在两个宿主共 6 个任务/预算设置中全部排 Muon 变体第一。消融(表 3):动量有害(µ=0.95 使 Muon 从 69.1/69.0 降至 66.9/68.3);$\alpha=0.1$ 在两任务同时最优且无需逐任务调参;教师分支的四种变体全部更差(NS 前混合 72.5/69.2、Frobenius 归一化 71.8/68.5、保留径向 70.5/67.3、cosine 门控 69.2/66.8);QK-Clip 对 Muon-RT 有害(71.8→66.0)。内存与开销:7B 每卡步间持久显存 37.7 GB,比动量 Muon(51.6 GB)少 13.9 GB(27%)、比 AdamW(64.5 GB)少 26.8 GB(42%);10T 参数投影下 121 TB,比 Muon 少 25%、比 AdamW 少 40%(图 5);额外开销仅为每矩阵一次幂迭代和一次 gather,优化器步 2.3 秒,约占训练步的 2%(生成主导)。理论实证(图 4、6):实测位移与式 (7) 预测相关 0.97;噪声增大时正交化梯度与均值方向的余弦从 0.87 跌到 0.11 而教师分支保持 0.99→0.75;同学习率下自第 40 步起梯度范数最低、自蒸馏 KL 大部分时间最低,符合 Corollary 1 的预测。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SDFT 工具使用(Qwen2.5-7B-Instruct) | 新任务准确率 % | 74.2 | SDFT+AdamW 70.6;MuonClip(µ=0) 73.2 | +3.6 vs AdamW |
| SDFT 科学问答(SciKnowEval) | 新任务准确率 % | 71.8 | SDFT+AdamW 70.2;MuonClip(µ=0) 71.0 | +1.6 vs AdamW |
| SDPO Biology(Olmo-3-7B,5 小时预算) | avg@16 准确率 % | 55.2 | SDPO+AdamW 52.8 | +2.4 |
| SDPO Materials(Olmo-3-7B,5 小时预算) | avg@16 准确率 % | 82.8 | SDPO+AdamW 79.1 | +3.7 |
| 7B 每卡持久显存(32 位教师,含梯度) | GB | 37.7 | 动量 Muon(µ=0.95) 51.6;AdamW 64.5 | −27% vs Muon;−42% vs AdamW |
| 10T 参数自蒸馏持久状态投影 | TB | 121 | Muon/MuonClip(µ=0.95) 160;AdamW 200 | −25% vs Muon;−40% vs AdamW |
| SDFT 工具使用收敛速度 | 达到 74.2% 所需步数 | 100 步(共 252 步) | MuonClip(µ=0) 250 步达 73.2%;Muon(µ=0) 最高 69.1% | 约 2.5 倍加速 |
局限与改进
作者承认的局限:(1) 实验只覆盖 2 个模型家族的 7B 模型和 4 个任务,更大模型与其他领域留待未来;(2) 收敛分析依赖平滑性、PL 条件和对齐假设(A1–A4),这些对非凸优化是标准假设但其常数并未在 LLM 上实际估计,定理只保证优化误差邻域收缩,不直接等同于下游精度提升;(3) 方法适用前提是已存在参数对齐的 EMA 教师(SDFT/SDPO/mean-teacher 类场景),如果只是为了替代动量而专门维护一个教师,内存反而不会节省。我自己的观察:(1) 在工具使用任务上,Muon-RT 的旧能力平均(63.0)仍比 AdamW(65.4)低 2.4 点,主要掉在 IFEval,说明优化器层面的加速与新任务学习同旧指令遵循保留之间存在张力,作者用“保留 AdamW 平均的 96%”的表述缓和了这一点;(2) 教师分支与 QK-Clip 存在结构性冲突——只裁剪学生的 query 权重会在位移中注入非学习偏移(一次 0.9 倍裁剪产生的间隙是学习位移的 6–19 倍,且径向去除无法滤掉),导致持续 200+ 步的错误收缩,这对在真正需要 logit 控制的预训练场景即插即用构成障碍;(3) 教师必须以 32 位存储(bfloat16 下 79% 的 EMA 条目不变),隐含每参数 2 字节的额外代价,这与“省内存”的叙事有内在张力;(4) $\alpha=0.1$ 是固定常数,虽在两任务两宿主上通用,但没有自适应机制来应对训练不同阶段位移大小的变化(位移范数在 warmup 期会涨到权重的 0.2–0.3% 再收缩)。
独立分析的弱点
(1) 32 位教师依赖:作者证明 bfloat16 教师会使 79% 的 EMA 条目永不更新(每步变化约为权重的 $10^{-5}$,而 bf16 只能表示 $4\times10^{-3}$ 以上的相对变化),因此位移信息会被舍入彻底破坏。这隐含每参数 2 字节的成本(7B 上每卡 7.6 GB),削弱了内存叙事;改进方向是研究随机舍入/误差补偿式低精度 EMA,让位移在 16 位下可读。(2) 与稳定化技术的冲突:QK-Clip 只作用于学生,会在 $W_T-W_S$ 中引入非学习偏移,实测首次裁剪使平均位移一步上升 12%;即便对教师同步裁剪(恢复到 67.3/70.1)仍低于无裁剪版本,因为裁剪还扰动了教师的注意力模式即蒸馏目标本身。改进方向是设计“位移感知”的稳定化:例如在径向去除后额外投影掉被裁剪头对应的子空间(文中显示 97% 的 $\|H\|_F^2$ 集中在被裁剪头上,说明这样的投影是可行的)。(3) 径向去除的副作用:它同时滤掉了权重衰减带来的合法缩放信号,实验中 SDFT 设 $\lambda=0$、SDPO 仅 0.01,强权重衰减的预训练场景未验证;改进方向是先把已知 $\eta\lambda$ 的缩放分量解析地扣除,再对残差做径向去除。(4) 幂迭代精度:8 次迭代低估 $\sigma_{max}$ 约 8%,依赖跨步热启动在 3 步内修正;训练早期或梯度突发突变时归一化可能暂时失准,$\|\alpha P\|_2\le\alpha$ 的界随之松动;改进方向是给 $P$ 加一个基于前几步 $\sigma_{max}$ 轨迹的保守上界。(5) 适用面:预训练从零开始时教师与学生都从同一点出发、位移从 0 缓慢生长,早期几乎没有历史信息可复用,方法的收益边界(微调/后训练 vs 预训练)需要在论文之外小心外推。
未来方向
作者提出的方向:扩展到更大模型(7B 之外)和更多领域/任务;在 LLM 上实际估计收敛理论的常数($\mu_{PL}$、$L$、对齐系数 $a_R,b_R$),把经验观察(梯度范数更低、KL 更低)与理论衔接得更紧。基于成果可延伸的方向:(1) 推广“复用模型副本作优化器状态”的思路到其他天然维护 EMA/权重平均的场合——mean-teacher 半监督、DINO/BYOL 自监督、AdEMAMix 的慢动量、Lookahead 外层权重、WARM 平均奖励模型,这些场景里副本间的位移同样可能承载动量信息;(2) 让教师分支与 logit 稳定化兼容(子空间投影或对教师-学生做对称裁剪的新方案),从而能进入 Muon 在大规模预训练中的主战场(Kimi K2 式训练);(3) $\alpha$ 的自适应调度:理论里教师漂移 $\delta_s$ 和位移范数都是可在线测量的,可以按 $\|H\|_F/\|W\|_F$ 或目标漂移自动调节混合权重,替代固定 0.1;(4) 部分替代 AdamW 的二阶矩:作者明确说位移不能恢复 AdamW 的二阶统计,但能否用它构造廉价的逐坐标尺度近似(例如利用位移各坐标的分布)值得探索,这可能把内存优势扩展到嵌入/输出头等仍用 AdamW 的参数上;(5) 在更多 on-policy 目标(GRPO、DPO、on-policy distillation)中验证,并研究位移信息在持续学习序列(多个任务依次蒸馏)中的积累与衰减规律。
复现评估
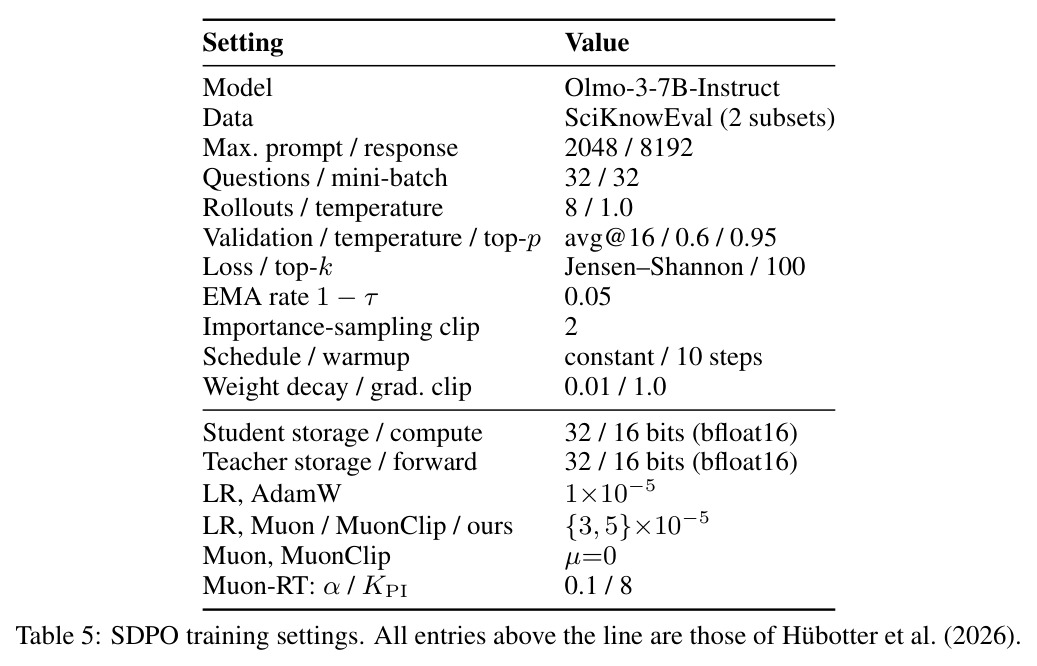
复现条件在论文中给出得相当完整。代码基础:官方 SDFT 发布代码(TRL + colocated vLLM 生成),只需替换优化器;分片与非分片、$\alpha=0$ 与 Muon µ=0 均已做逐位一致性验证。超参数:表 4(SDFT)与表 5(SDPO)完整列出——Qwen2.5-7B-Instruct / Olmo-3-7B-Instruct、2×H100 80GB + FSDP2、每步 32 prompt、SDFT 252/166 步、学习率 $\{3,5\}\times10^{-5}$ cosine、forward KL / Jensen–Shannon、教师 32 位存储 + bf16 前向、EMA $1-\tau=0.01/0.05$、NS 5 步及系数 $(3.4445,-4.7750,2.0315)$、$\alpha=0.1$、8 次热启动幂迭代、每配置 3 个随机种子。算力门槛:单次 SDFT 运行 1.1–1.8 小时(2×H100,生成主导),整套主表加消融估计需数百 GPU 小时,对学术实验室可负担;理论部分(图 4b/c、常数估计)只需在单个权重矩阵上做合成实验,普通单卡即可复现。数据全部公开(ToolAlpaca、SciKnowEval),AdamW 基线数字引自 SDFT/SDPO 原文并在作者的精度设置下复验过(复现差异在随机波动内)。未明确说明 Muon-RT 自身代码是否开源,这是复现的主要不确定性;不过方法只有约 30 行核心逻辑(Algorithm 1),配合论文的实现细节(A.4 节,含 FSDP2 的 gather/all-reduce 安排和 $5\times10^{-7}$ 的单矩阵数值验证)自行实现难度中等。
论文图表
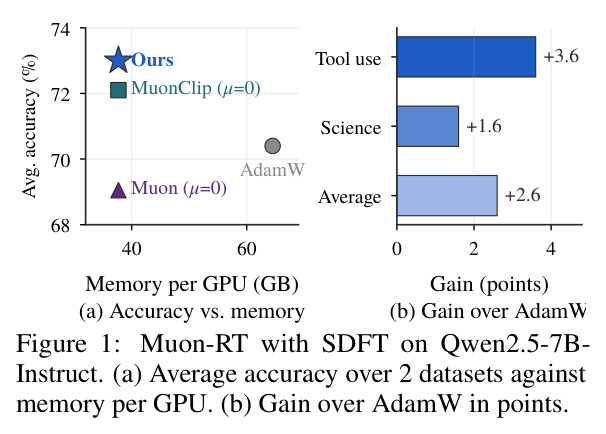
(a) 以每 GPU 持久显存(GB)为横轴、两个数据集的平均准确率(%)为纵轴的散点图:Muon-RT 位于左上角(约 37.7 GB、最高精度),AdamW 在右上(约 64.5 GB),Muon(µ=0) 与 MuonClip(µ=0) 显存相同但精度低 0.8–5.1 点;(b) 柱状图展示相对 AdamW 的精度增益:工具使用 +3.6 点、科学 +1.6 点、平均 +2.6 点。
一图浓缩全文卖点:同时做到更高精度与更低持久显存,打破了“省内存就要牺牲精度”的默认预期,是论文核心 trade-off 的最佳可视化。