Muon 让第一个混合专家层更难负载均衡 Muon Makes the First Mixture-of-Experts Layer Harder to Balance
Muon 训练骨干网络使首个 MoE 层的均衡偏置跨度翻倍,造成热身期专家严重过载。
前置知识
混合专家层(MoE)与路由器
MoE 层由多个前馈网络(专家)和一个路由器组成:路由器为每个 token 给每个专家打分,选出得分最高的 $k$ 个专家处理该 token,并按专家得分加权混合输出。若不加干预,路由器倾向于把多数 token 送给少数专家,这些专家因训练数据更多而进一步吸引 token,形成“强者愈强”的反馈循环。本文采用 DeepSeekMoE 式结构:$E=32$ 个路由专家、每 token 选 $k=4$、外加 1 个共享专家,路由器用 sigmoid 打分,块 0 为密集 FFN。
论文的所有测量对象(负载、偏置、跨度、输入余弦)都定义在这个结构上,不懂路由与专家选择机制就无法理解“均衡难度”问题和首个 MoE 层的特殊性。
无辅助损失负载均衡(bias)
DeepSeek-V3 提出的均衡器:每个专家有一个偏置 $b_i$,加在路由得分上参与专家选择、但不进入混合权重;每步之后按 $b_i \leftarrow b_i + u\,\mathrm{sign}(1/E - \ell_i)$ 更新,其中 $\ell_i$ 是该专家的负载(分到的 token 比例)、$u$ 是固定步长(本文取 0.001)。偏置不接收梯度,只靠这种符号更新把负载推向公平份额 $1/E$。偏置起点为 0,且两个偏置之差一旦达到 1(sigmoid 得分在 $(0,1)$ 内),排序就不再改变。
本文不直接测量负载(因为负载会被偏置强行推平),而是测量“偏置的工作量”即跨度,理解偏置的更新规则与上界($1+2u$)是理解核心指标的前提。
Muon 优化器
Muon 对每个权重矩阵的动量更新做正交化:$\mathbf{W}_t = \mathbf{W}_{t-1} - \eta_t\,(0.2\sqrt{\max(p,q)}\,\mathrm{Ortho}(\mu\mathbf{M}_t + \mathbf{G}_t) + \lambda\mathbf{W}_{t-1})$,其中 $\mathrm{Ortho}(\mathbf{A})=\mathbf{U}\mathbf{V}^\top$ 由几步 Newton–Schulz 迭代近似得到,它把更新矩阵的所有奇异值拉到约 1。效果是:不论某专家收到多少 token,其权重矩阵的更新谱范数基本相同;而 AdamW 下低负载专家的梯度噪声大、经自适应归一化后移动更少。
论文的核心现象(更新-负载相关性消失、路由器输入出现共享方向、首层跨度上升)都源于 Muon 的等谱范数更新,这也是作者预期会降低跨度却得到相反结果的原因。
AdamW 与“忙碌专家更忙碌”的反馈
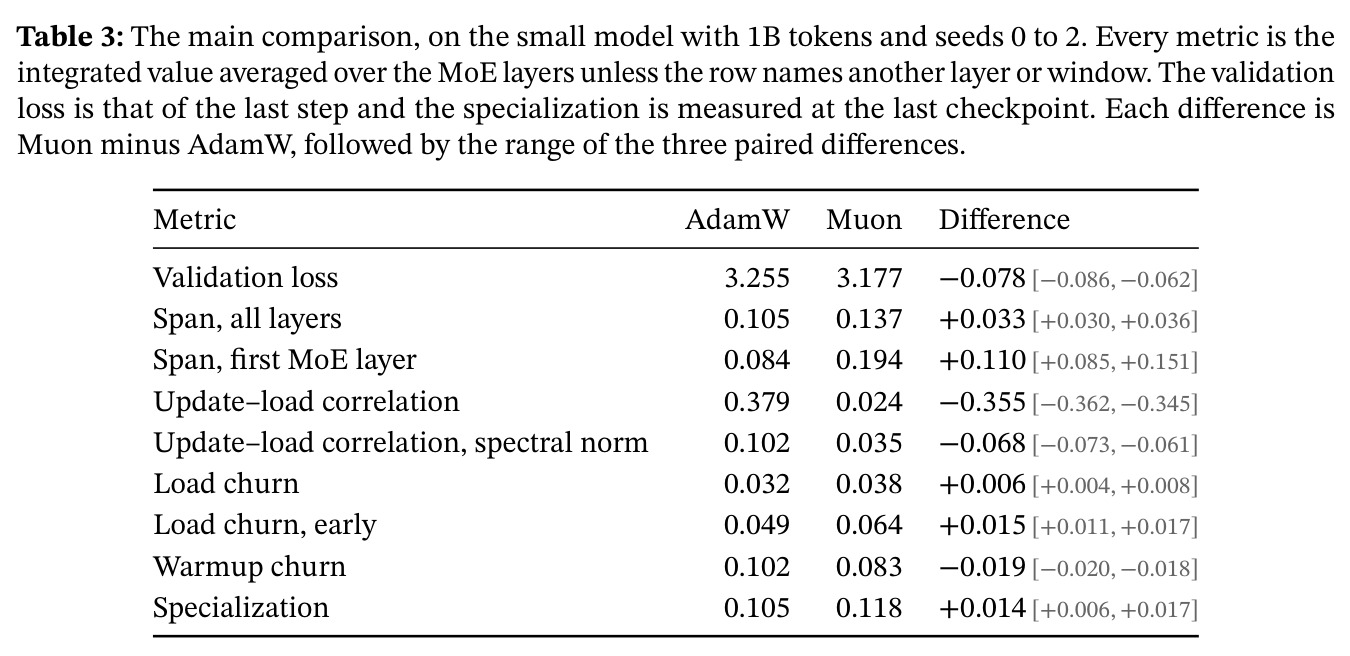
AdamW 将梯度的一阶矩按逐元素均方根归一化。低负载专家的梯度由更少 token 求和、波动更大,归一化后参数移动更少;高负载专家则移动更多,形成“忙碌专家更忙碌”的正反馈。论文用更新-负载相关性(专家每步收到的 token 数与其权重更新 Frobenius 范数的跨专家 Pearson 相关)来量化这一反馈:AdamW 下约为 0.38,Muon 下降到 0.02。
作者最初的假设(Muon 应降低不均衡)正建立在这个反馈会被等尺寸更新削弱上;理解它才能理解实验结果为何与预期相反,以及论文的修正解释。
研究动机
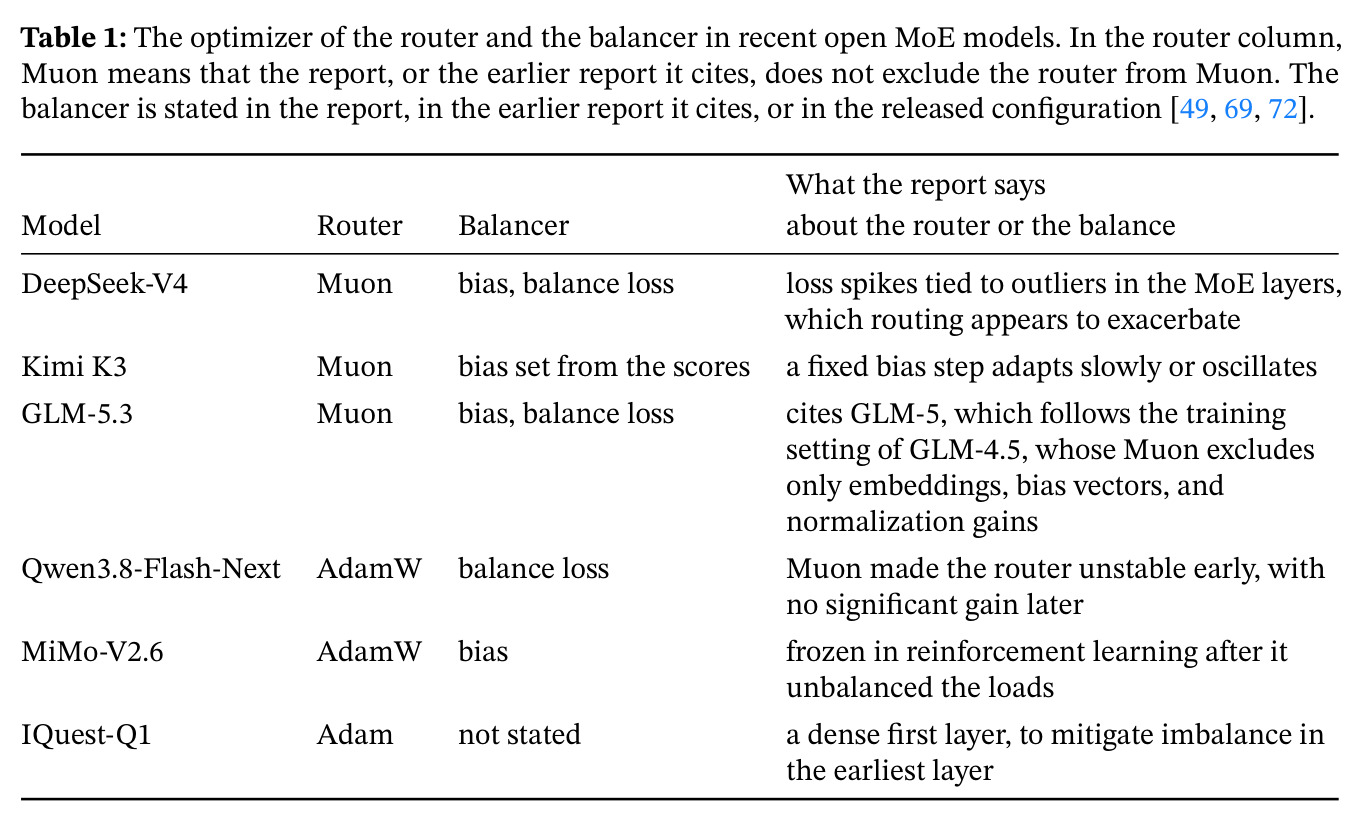
2026 年的旗舰开源语言模型几乎全是 MoE,且大多已把权重矩阵的训练从 AdamW 换成 Muon,但各家配方在“路由器该不该也用 Muon”上明显分歧:DeepSeek-V4、Kimi K3、GLM-5.3 不把路由器排除在 Muon 之外,而 Qwen3.8-Flash-Next、MiMo-V2.6、IQuest-Q1 把路由器留给 AdamW 或 Adam。只有 Qwen3.8-Flash-Next 给出理由——“Muon 让路由器训练早期不稳定、后期无显著收益”——但没有任何报告公开对比数据。已有的优化器对比研究要么不带偏置均衡器,要么根本不测量偏置本身;而在有偏置的情况下,负载会被强行推平,无法反映路由器的真实偏好。生产系统的事故也指向最早的 MoE 层:Nemotron 3 Ultra(AdamW)首个 MoE 层最忙专家早期达到公平份额的 4.8 倍、到 12T token 时约 12 倍;MiMo-V2.6 因最忙专家达到 16 倍而在强化学习阶段冻结了路由器;DeepSeekMoE 和 IQuest-Q1 干脆把第一层做成密集层来规避这个问题。
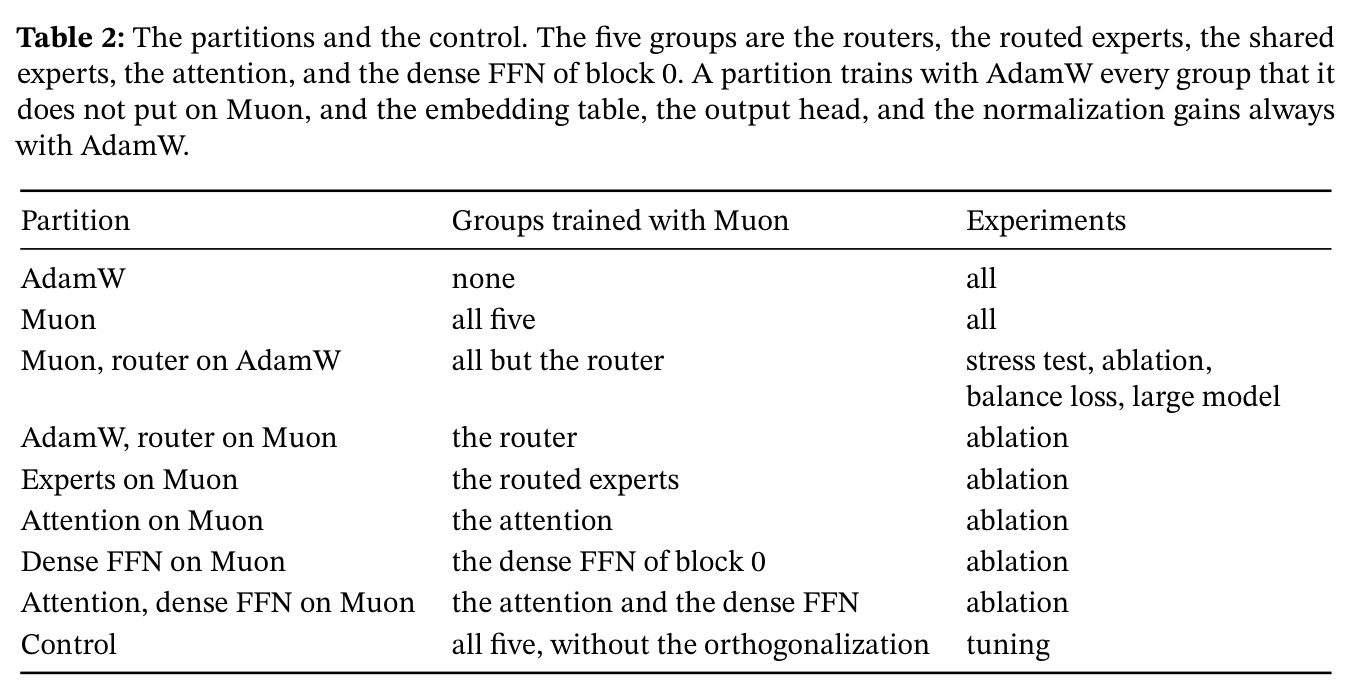
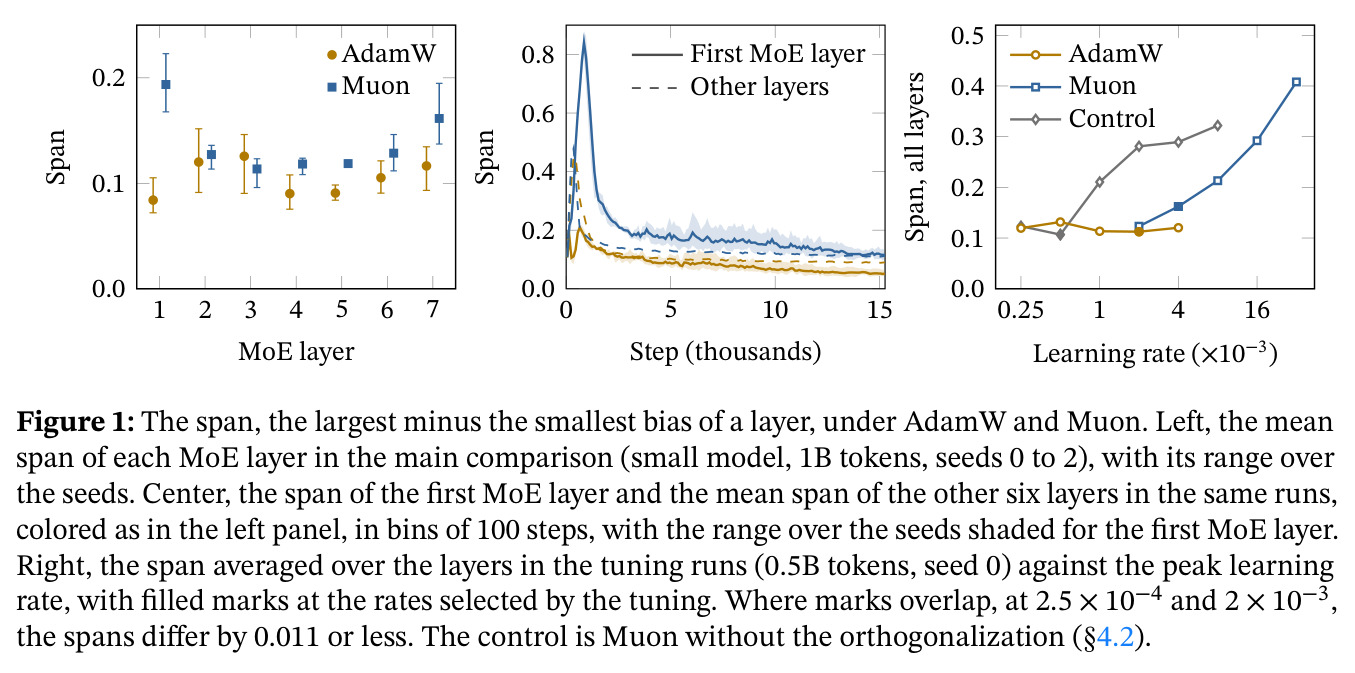
本文的目标是本文要在受控条件下回答两个紧密相关的问题:其一,优化器(AdamW 还是 Muon)如何改变辅助无损偏置均衡器的工作负担;其二,路由器究竟应该用哪个优化器训练。由于有偏置存在时负载已被推平、不能反映路由器偏好,作者提出用“跨度”(一层内最大偏置减最小偏置,$\max_i b_i - \min_i b_i$)作为核心指标:路由器自发的偏好越强、所有 token 越偏爱同一批专家,偏置就必须拉开越大的差距才能抵消这一偏好,因此跨度衡量“这一层有多难均衡”。具体做法是在 55M 与 108M 激活参数的两个 MoE 模型(FineWeb-Edu 数据)上,把参数切成六组并独立切换每组的优化器,同种子配对比较、三个种子重复,并事先登记计划比较及其预期符号。
与已有工作不同的是,本文的独特切入角度有三点。第一,度量上的转换:不测负载而测“偏置的辛苦程度”(跨度),绕开了“偏置会把负载推平从而掩盖路由器问题”这一混淆——这是与以往所有优化器对比研究的本质差别。第二,实验设计上的解耦:把参数分成路由器、路由专家、共享专家、注意力、密集 FFN、嵌入/输出头/归一化增益六组,分别指定优化器,从而能把“路由器优化器”与“骨干网络优化器”的效应分开,而已有工作(如 Wang et al.)都是整模型一次性切换优化器。第三,机制上的因果检验:设计控制组(保留 Muon 的动量与更新尺寸但去掉正交化)来区分“等尺寸更新”与“正交化”两个因素,并在 3000 步探针中从首个路由器的输入里减去批次均值(居中),直接干预“共享方向”这一疑似原因来验证因果链。
核心方法
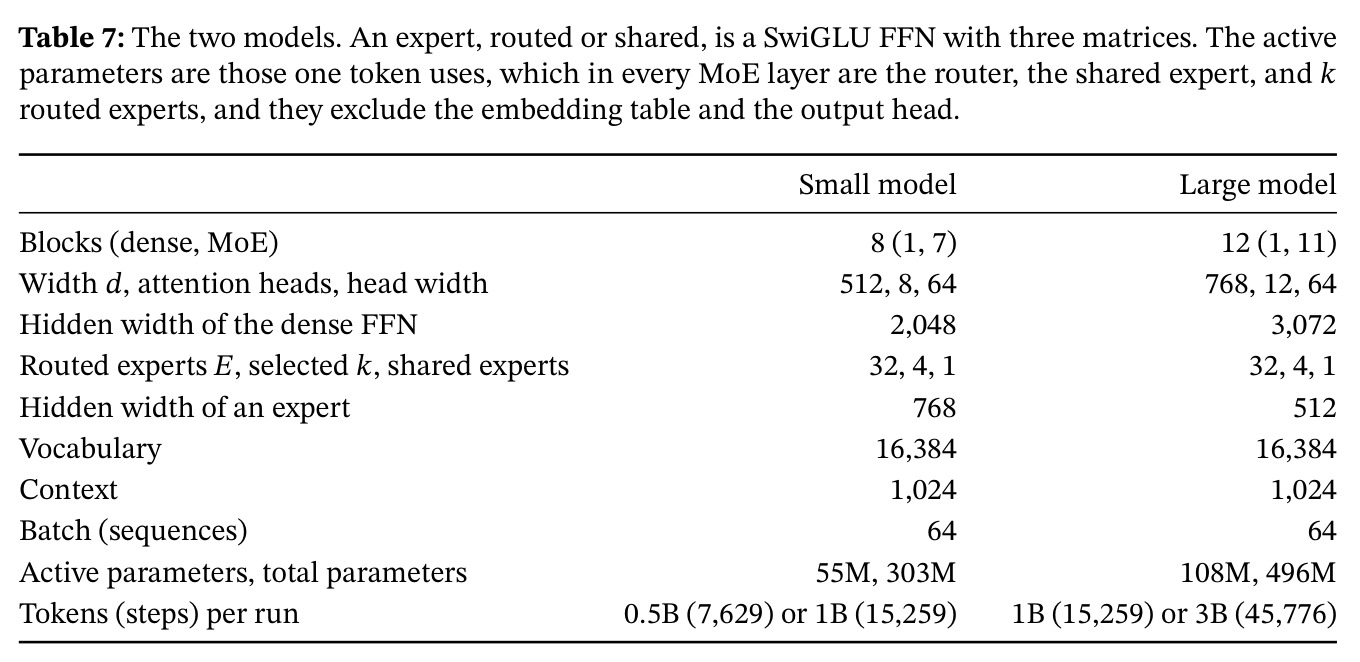
直觉上,无辅助损失均衡器像一个积分控制器:路由器若给某专家一个所有 token 共享的固有偏好,偏置就必须从一端到另一端拉开足够的差距去抵消它,偏好越强跨度越大、追赶时间越长。作者据此用跨度量化均衡难度,并在两个 decoder-only Transformer 上系统测量:小模型 8 块、宽 512、55M 激活/303M 总参,大模型 12 块、宽 768、108M/496M,每块含 $E=32$ 选 $k=4$ 加 1 个共享专家的 MoE 层(块 0 密集)。技术上:六个参数组分别指定 AdamW 或 Muon,每个优化器独立调学习率(小模型 0.5B token 调参选出 AdamW $2\times10^{-3}$、Muon $4\times10^{-3}$);随后依次做主比较(1B token、种子 0–2)、消融(路由器×骨干 2×2 组合、Muon 半学习率、四个部分骨干分区、无偏置臂,种子 3–5)、偏置速度实验($u$ 对 $4u$,种子 6–8)、平衡损失实验($\alpha=10^{-4}$)与大模型实验(3B token、种子 0–2),另有 1–16 倍学习率的压力测试。每个 MoE 层每 10 步记录输入余弦、得分偏移、过载、负载变动率、共同份额等指标。
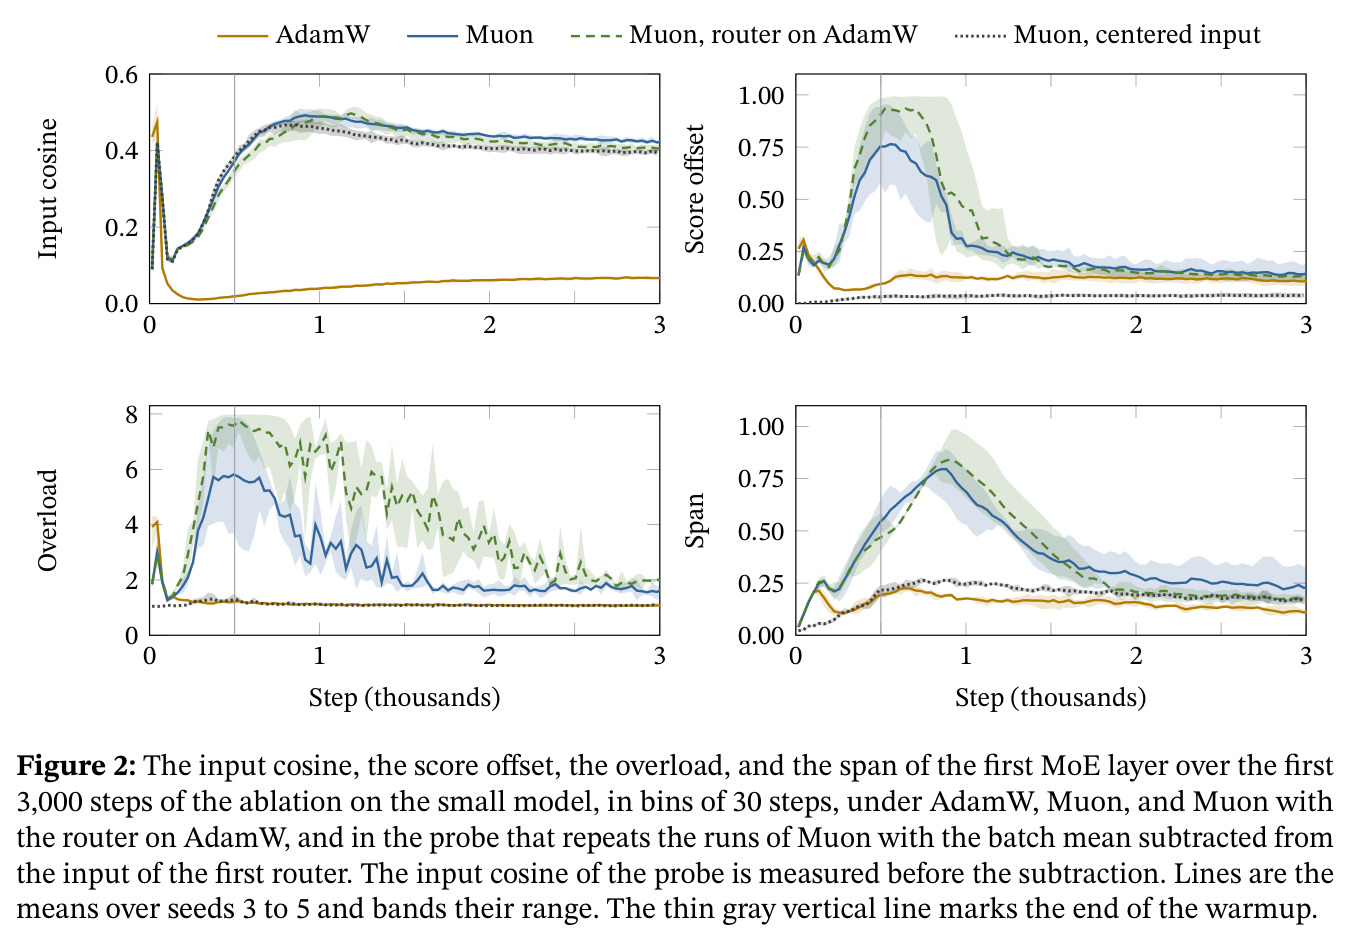
核心创新是把“均衡难度”操作化为跨度,并把它与一个 Logit 分解框架结合:$\mathbf{w}_i^\top\mathbf{x}_n = \mathbf{w}_i^\top\mathbf{c} + \mathbf{w}_i^\top(\mathbf{x}_n - \mathbf{c})$,其中 $\mathbf{c}$ 是批次内路由器输入的均值。当输入共享一个方向(输入余弦 $\rho$ 高)时,均值项 $\mathbf{w}_i^\top\mathbf{c}$ 对每个 token 都相同,形成所有 token 共享的专家偏好;而偏置每步至多移动 $2u=0.002$,要建立 0.8 的跨度至少需要 400 步,于是偏好出现后的数百步里被偏好的专家持续过载。这条“共享方向 → 共享偏好 → 偏置追赶延迟 → 暂时过载”的因果链是论文的解释框架。与已有工作的本质区别:Wang et al. 只证明 Muon 的全秩更新让路由器每行移动相同距离,并在不带均衡器的 500M 模型上测负载;本文在带偏置的现实设置中测量均衡器的工作量,用输入居中做干预证明因果,还发现只有整个骨干都上 Muon 才会出现约 0.4 的输入余弦——尽管两个只把部分骨干放上 Muon 的分区反而拉出了更大的跨度。
方法步骤详情
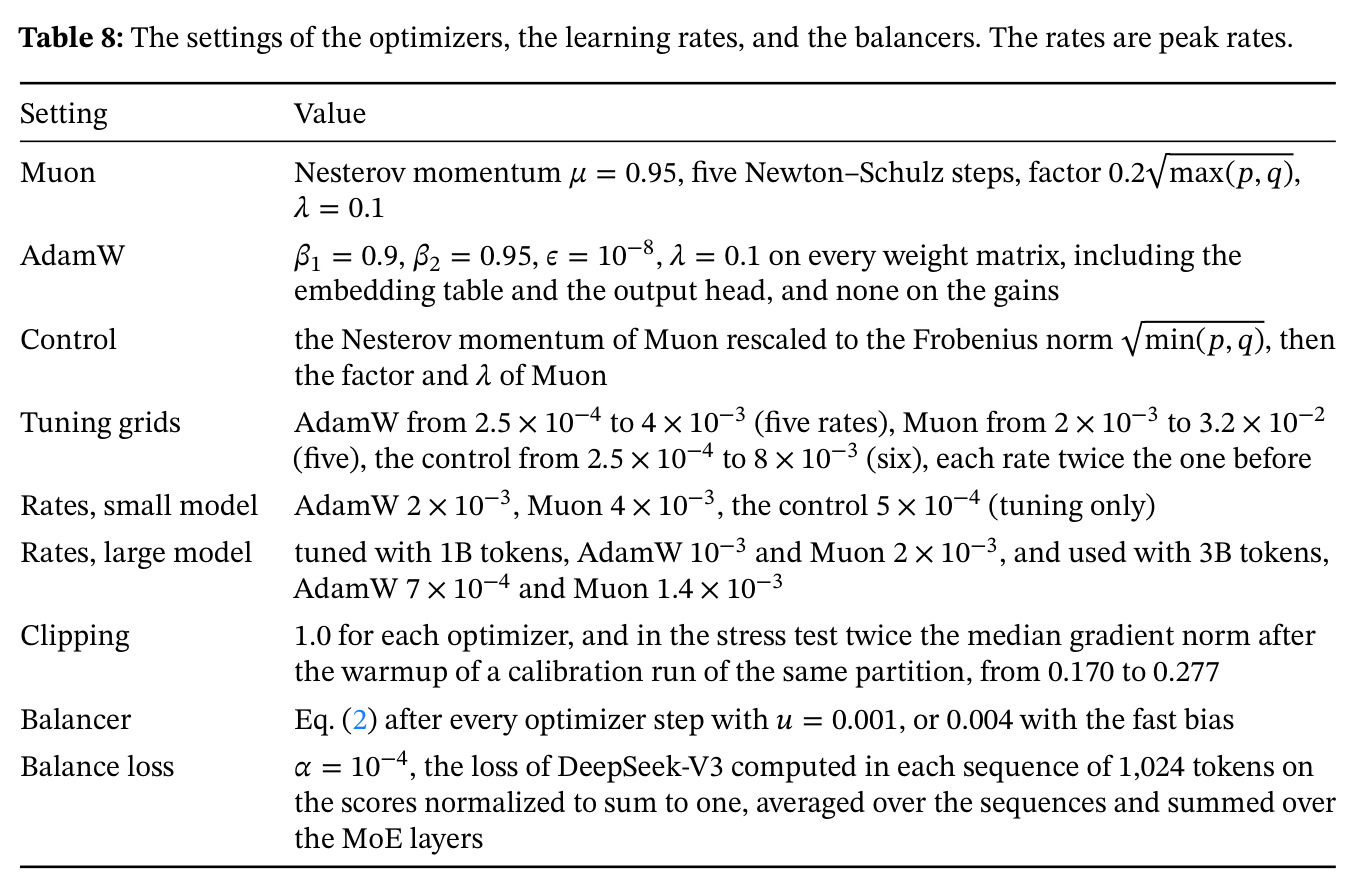
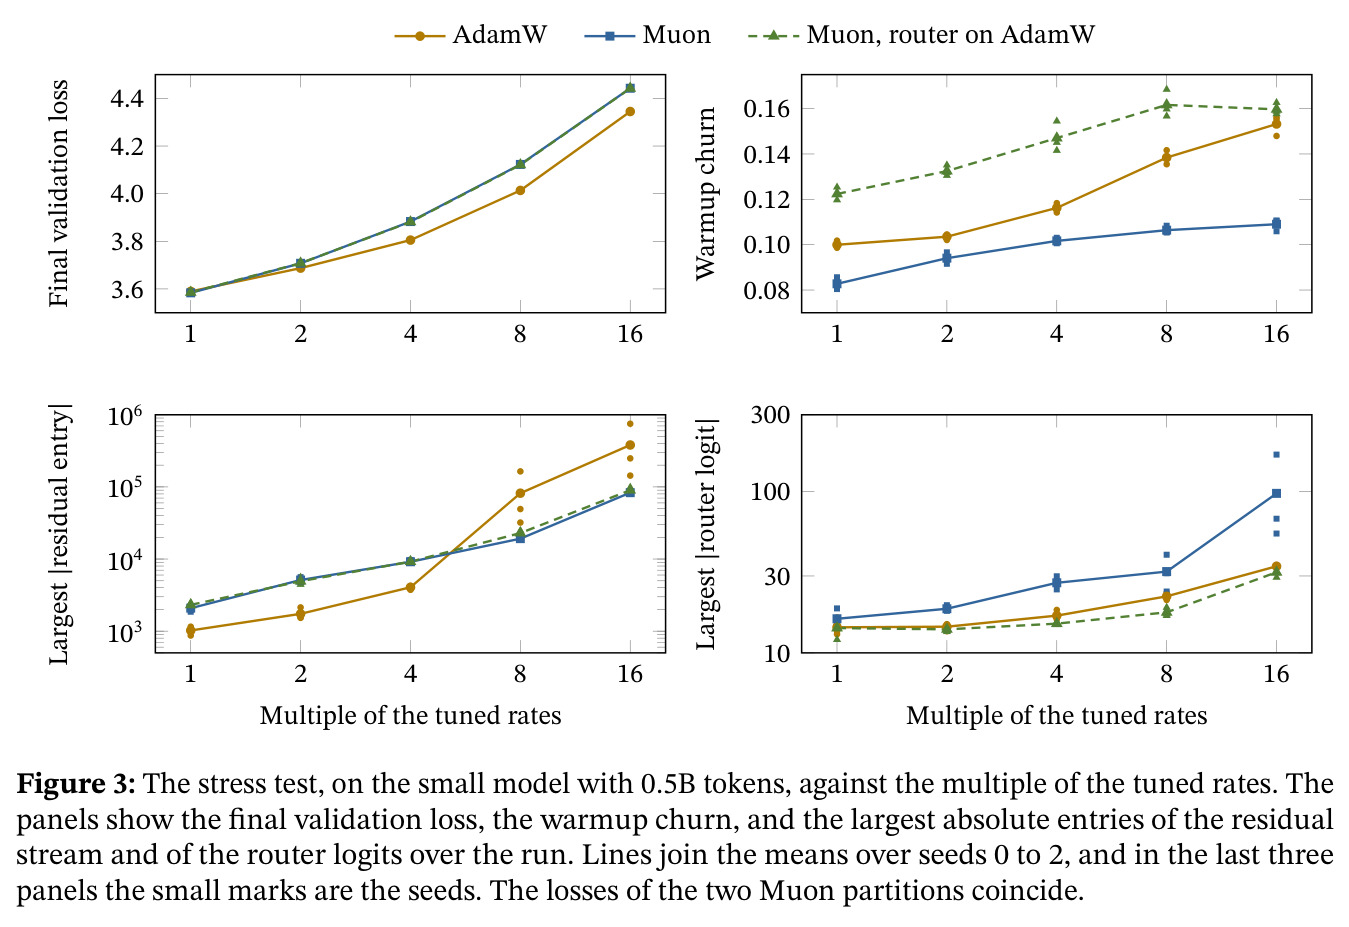
完整流程如下。(1) 架构与数据:两个模型(55M 激活/303M 总参、8 块宽 512;108M/496M、12 块宽 768),数据为 FineWeb-Edu sample-10BT,BPE 词表 16384,序列长 1024、批 64 序列(65,536 token/步),500 步线性预热后余弦衰减到 0.1 倍峰值,梯度裁剪 1.0。(2) 调参:小模型用 0.5B token、种子 0、倍增网格,选出 AdamW $2\times10^{-3}$、Muon $4\times10^{-3}$、控制组 $5\times10^{-4}$;大模型重调为 $10^{-3}$ 与 $2\times10^{-3}$,3B token 时按缩放律乘 0.7。(3) 主比较:AdamW 对 Muon,1B token,种子 0–2。(4) 消融:路由器与骨干的 2×2 组合、Muon 半学习率、四个部分骨干分区(仅路由专家、仅注意力、仅密集 FFN、注意力+密集 FFN 上 Muon)、无偏置臂,种子 3–5。(5) 均衡器变体:快偏置 $4u$ 实验(种子 6–8)与平衡损失实验(DeepSeek-V3 序列级损失、$\alpha=10^{-4}$、种子 3–5)。(6) 大模型实验:三个配方分区、3B token、种子 0–2。(7) 压力测试:三个配方分区在 1/2/4/8/16 倍调参学习率下各跑 0.5B token。(8) 探针:逐位复现若干运行的前 3000 步,再做单变量改动(首个路由器输入居中、快偏置、路由器换 AdamW 等)。(9) 统计:所有比较按种子配对,报告均值与三种子区间,事先登记计划比较及其预期符号。
技术新颖性
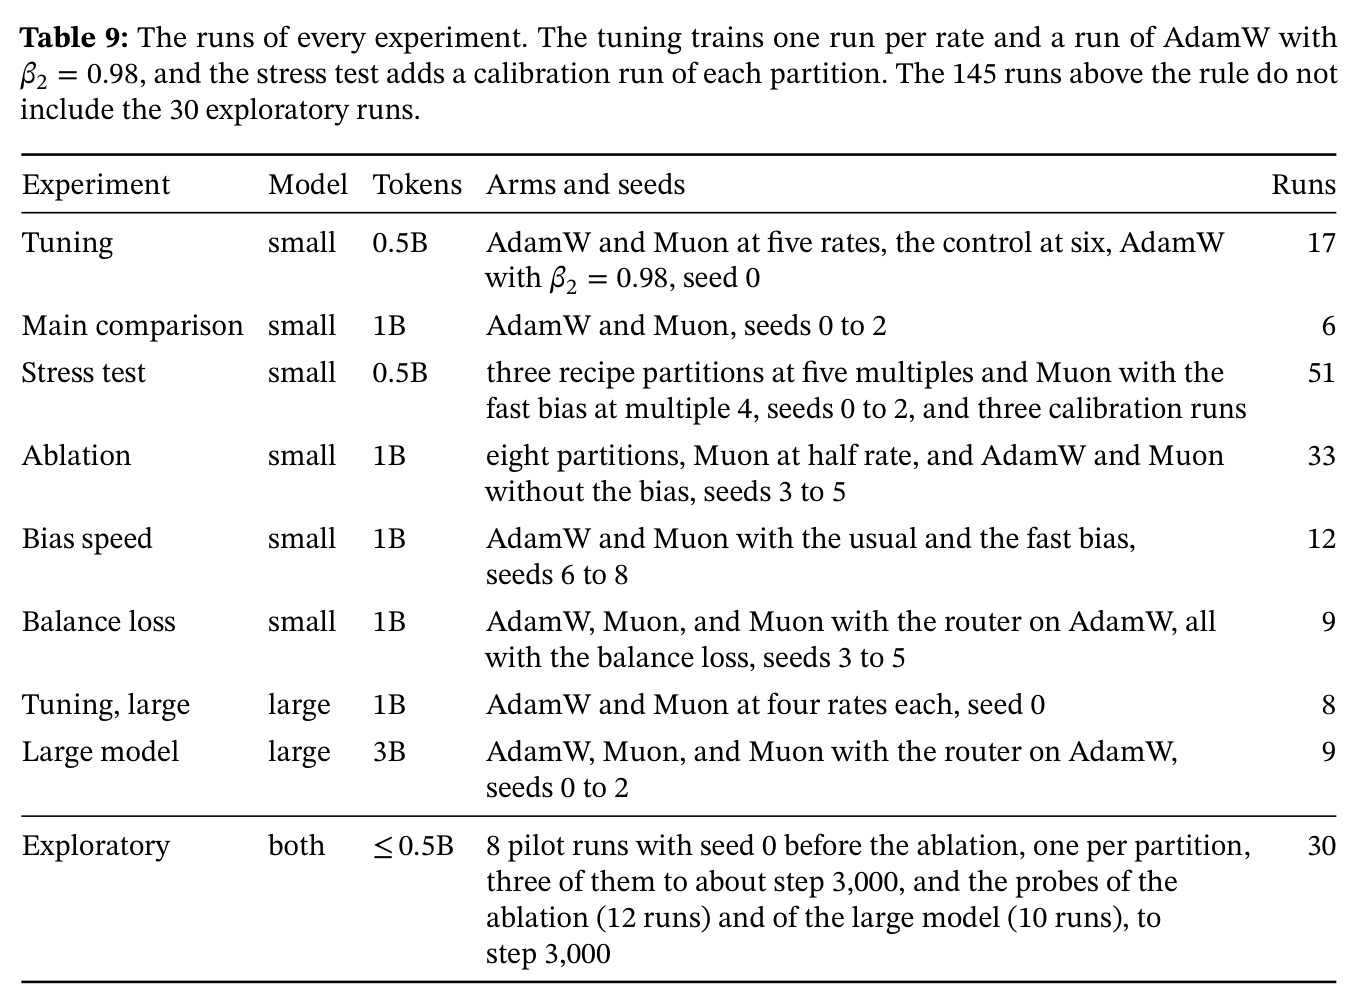
技术新颖性体现在五个方面。(1) 度量创新:跨度作为指标是新的,且作者利用 sigmoid 得分有界推出其上限 $1+2u$——当 $b_i - b_j \ge 1$ 时专家 $i$ 对所有 token 排序都高于 $j$、差距不再扩大,因此跨度天然有界、可跨运行比较,并有明确物理含义(偏置必须抵消的共享偏好大小)。(2) 实验设计创新:参数分组切换优化器的因子设计把路由器与骨干的效应干净分离,结果发现跨度跟随骨干而非路由器——这直接推翻了“路由器优化器是关键”的行业直觉。(3) 控制组设计:保留 Muon 动量与更新尺寸但去掉正交化,发现控制组在高于调参速率时跨度也超过 AdamW,说明“等尺寸更新”本身(而非正交化)已足以推高跨度。(4) 因果干预:输入居中把早期过载从 3.30–4.66 压到 1.11–1.16 而损失几乎不变,把相关性升级为因果证据。(5) 实证规范:145 次正式运行、预登记计划比较与预期符号、确定性训练保证逐位复现、明确区分计划与探索性分析,这份严谨在优化器对比文献中少见。
实验结果
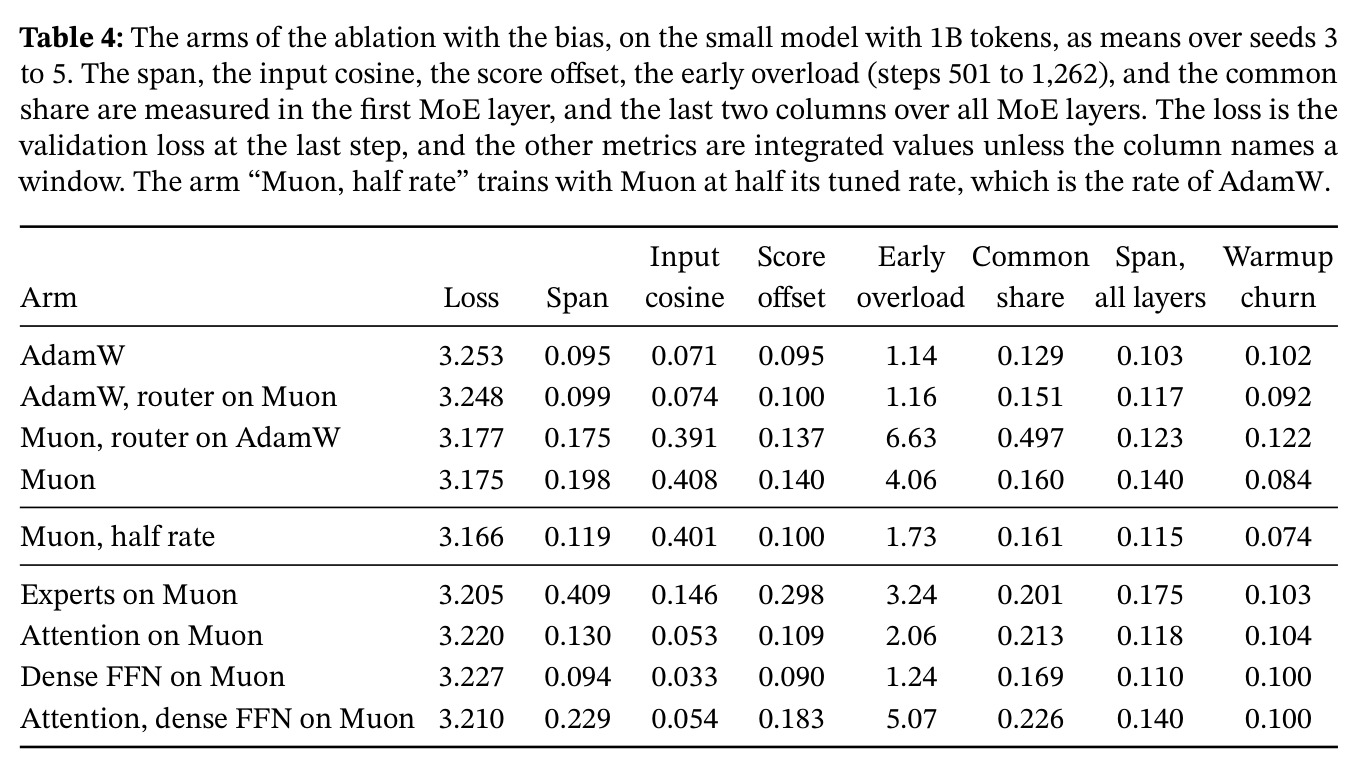
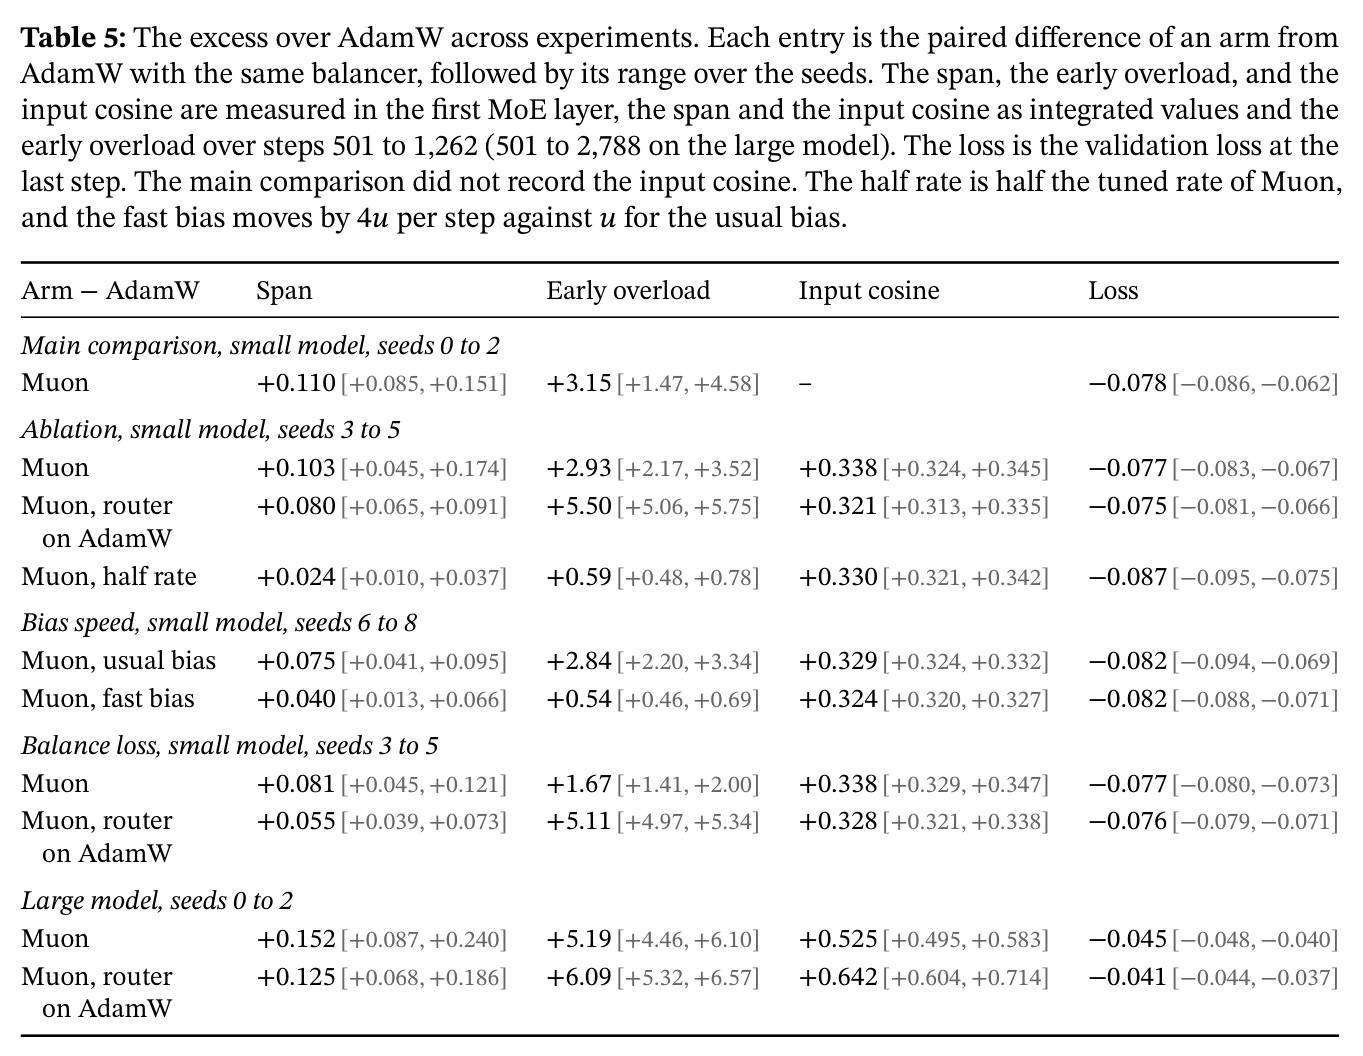
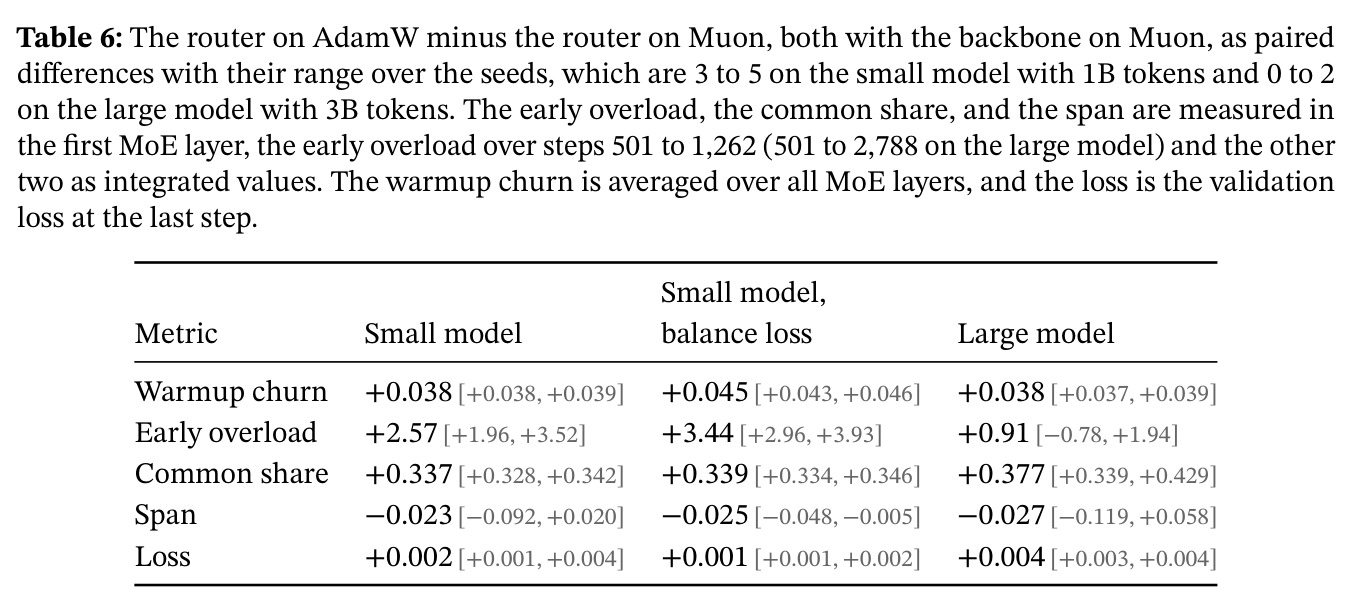
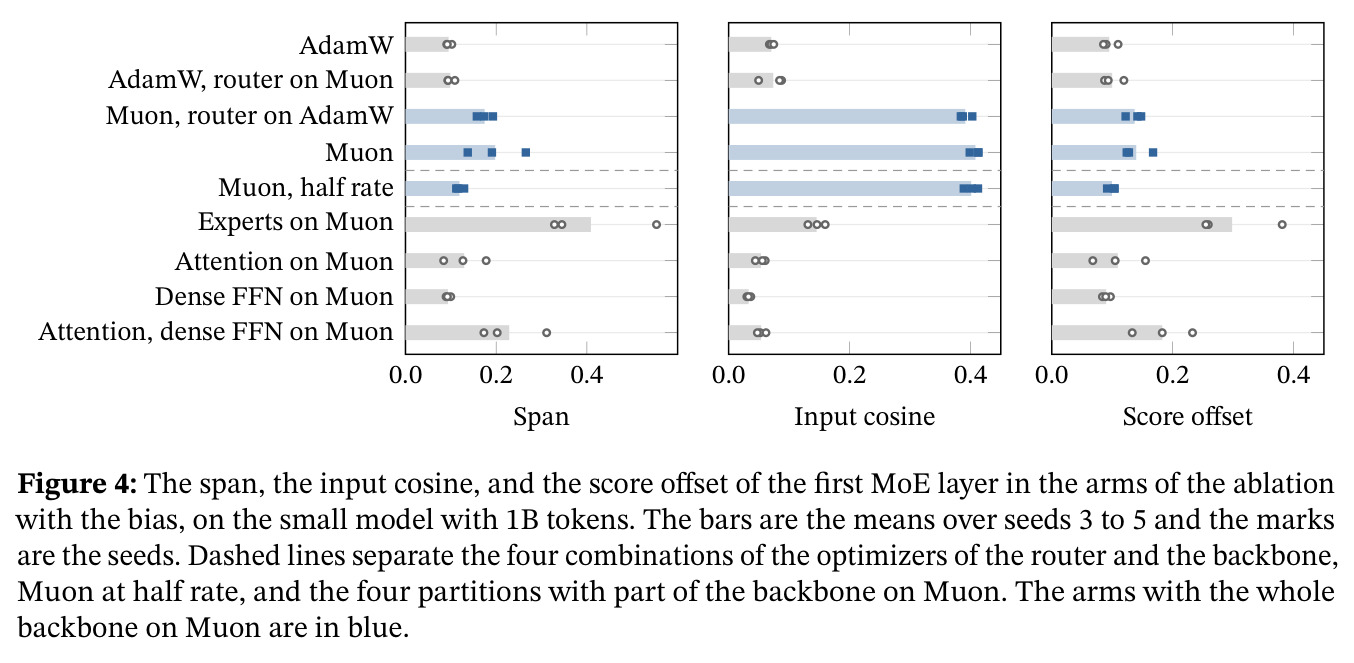
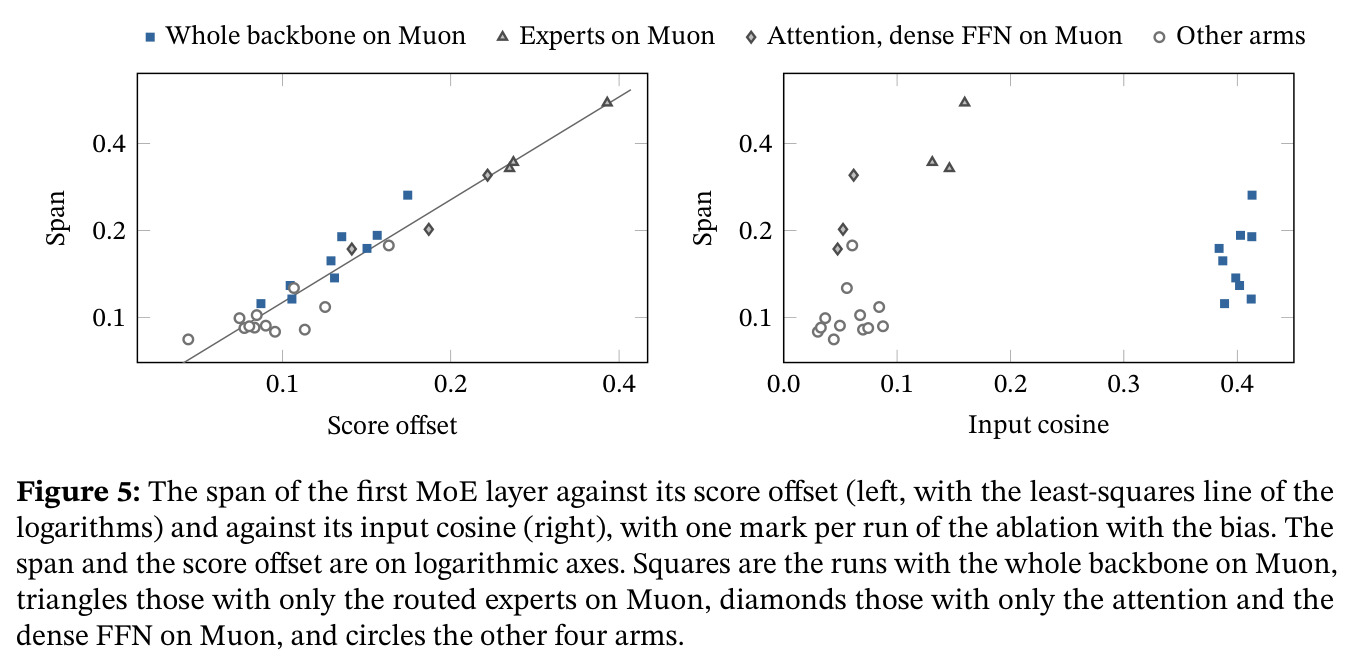
逐条来看。(1) 主比较(55M、1B token):Muon 把首个 MoE 层的跨度从 0.084 提高到 0.194(每个种子都上升,约翻倍),其余六层平均只差 0.02;全层平均跨度 0.105→0.137;Muon 验证损失更低(3.255→3.177,差 $-0.078$);更新-负载相关从 0.379 降到 0.024——与作者预期相反。(2) 消融(种子 3–5):跨度跟随骨干——骨干上 Muon 时首层跨度 0.198(路由器 Muon)/0.175(路由器 AdamW),骨干上 AdamW 时仅 0.099/0.095;输入余弦同样跟随骨干(约 0.4 对 0.07)。(3) 机制时间线:预热结束后输入余弦在步 310–340 升破 0.2 并达 0.43–0.48,得分偏移在步 490–720 达峰 0.64–0.99,跨度晚 200–290 步达峰 0.74–0.99;早期过载(步 501–1262)Muon 4.06、路由器 AdamW 6.63,对比 AdamW 1.14(上限 $E/k=8$)。(4) 因果确认:居中输入后早期过载降到 1.11–1.16,3000 步处损失变化不超过 0.003。(5) 缓解:Muon 半学习率把跨度超出量从 +0.103 降到 +0.024、早期过载降到 1.73,且 1B token 下损失反而更低 0.008–0.012;快偏置把 rise 减半(0.075→0.040)、过载超出从 2.84 到 0.54;平衡损失降低得分偏移与过载,但每个种子下 Muon 跨度仍高 +0.081。(6) 大模型(108M、3B token):首层跨度超出 +0.152(每个种子上升),输入余弦 0.61/0.73,早期过载 6.3/7.2 接近上限 8,训练结束时最忙专家仍达公平份额 2.2–2.8 倍(AdamW 1.07)。(7) 路由器优化器:骨干 Muon 时路由器换 AdamW 使热身负载变动率在每个设置下 +0.038、损失升 0.001–0.004、共同份额 0.497 对 0.160;大模型上损失尖峰只出现在路由器 AdamW 的运行(2/6/2 次),且 9/10 次尖峰时首层跨度几乎贴着上限 1.0。(8) 压力测试:1–16 倍学习率下热身变动率始终是路由器 AdamW 最高;Muon 学习率敏感度 0.24 对 AdamW 0.18,与 Qwen3.8-Flash-Next 报告的说法相反。总体结论:在这个规模上路由器应留在 Muon,且首个 MoE 层是对优化器最敏感的层。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 首个 MoE 层均衡难度(主比较,55M 模型、1B token、种子 0–2) | 积分偏置跨度($\max_i b_i - \min_i b_i$,越大越难均衡) | Muon 0.194 | AdamW 0.084 | +0.110,每个种子都上升,约 2.3 倍 |
| 全部 MoE 层平均均衡难度(主比较) | 积分偏置跨度(全层平均) | Muon 0.137 | AdamW 0.105 | +0.033(其余六层平均只差 0.02,效应集中在首层) |
| 语言建模质量(55M、1B token) | 最终验证交叉熵 | Muon 3.177 | AdamW 3.255 | -0.078(Muon 更优) |
| 热身后早期过载(55M 消融,步 501–1262) | 过载 $E\max_i \ell_i$(最忙专家为公平份额的倍数,上限 8) | Muon 4.06(路由器 AdamW 时 6.63) | AdamW 1.14 | 超出 +2.93 / +5.50(每个种子成立) |
| 因果干预:首个路由器输入居中(3000 步探针,两个模型) | 早期过载 | 居中后 1.11–1.16,损失变化 <0.003 | 不居中 3.30–4.66(小模型)/ 大模型 5.59–7.2 | 过载基本消除,验证共享方向是过载原因 |
| 降低 Muon 学习率(55M,半速率 $2\times10^{-3}$,1B token) | 首层跨度超出量 / 验证损失 | 超出 +0.024,损失比全速率低 0.008–0.012 | 调参速率($4\times10^{-3}$)超出 +0.103 | rise 减少约 77% 且训练更好 |
| 加快偏置(快偏置 $4u$,55M、种子 6–8) | 首层跨度超出量 / 早期过载超出量 | +0.040 / +0.54 | 常规偏置 $u$ 时 +0.075 / +2.84 | rise 减半、过载大幅缓解,损失几乎不变 |
| 规模验证(大模型 108M、3B token、种子 0–2) | 首层跨度超出量 / 输入余弦 / 早期过载 | +0.152 / 0.61(路由器 AdamW 0.73)/ 6.3–7.2(近上限 8) | AdamW(余弦 0.39,过载 1.1 量级) | 效应在大模型上每个种子成立且更强 |
| 路由器优化器选择(骨干 Muon,两模型+平衡损失) | 热身负载变动率 / 最终验证损失 | 路由器留在 Muon 更好 | 路由器换 AdamW:变动率 +0.038、损失 +0.001~+0.004(每个种子) | 且大模型损失尖峰只出现在路由器 AdamW 的运行 |
局限与改进
作者承认的局限:(1) 规模差距——模型只有 55M/108M 激活参数,比激励问题的生产模型少约 50–2000 倍,训练最多 3B token、少约四个数量级,效应随规模是增长还是消退无法回答;(2) 单一架构、单一数据集(FineWeb-Edu)、单一均衡器(偏置,两个速率)、单一批大小与预热长度,且 sigmoid 得分有界而 DeepSeek-V4 的得分无界,跨度上限论证不能直接移植;(3) 学习率只用单种子、0.5B token 调参,而 1B token 时 Muon 半速率反而更好,说明调参协议可能选出了偏大的速率;(4) 每个比较只有三个种子、未做多重比较校正,多数探针分析是看到数据后才选的且只用一个种子;(5) 评估只用验证损失,小模型少 token 时它可能区分不了路由方法。我自己的观察:(6) 最关键的机制仍是黑箱——为什么只有完整骨干(似乎必须路由专家或共享专家在 Muon 上)才产生约 0.4 的输入余弦,论文自己列为最重要开放问题;(7) 居中干预只测了 3000 步、只测了第一层,且批次均值使路由依赖批次,实用的滑动均值版本未验证;(8) 无容量限制的设置会低估过载成本——现实中专家分布在不同设备、有容量上限,4–7 倍过载意味着 token 丢弃或设备瓶颈,论文承认“无可测成本”的结论只在其简化设置下成立;(9) 损失尖峰与跨度贴上限只是 10 个样本的相关性证据,且作者无法判断 Qwen3.8-Flash-Next 所说的早期不稳定是否就是这里测的热身变动率。
独立分析的弱点
(1) 机制不明:为什么只有全骨干上 Muon 才让首个路由器输入出现约 0.4 的共享方向?论文承认不知道路由器行为何沿共享方向散开,“负载不均导致行散开”的猜想也未检验——改进方向:做梯度流分析或在受控合成设置中单独操纵负载与更新尺寸,定位输入余弦上升的来源。(2) 简化设置掩盖成本:无容量限制、无多设备约束的小模型上过载“无可测成本”,但生产系统有 expert capacity、all-to-all 通信与设备瓶颈——改进方向:加入容量因子和模拟分桶/多设备调度的评测,量化过载对吞吐和被丢弃 token 的影响。(3) 调参协议薄弱:单种子、0.5B token 的调参在 1B token 下已被证明次优(半速率更好),大模型速率可能同样偏大——改进方向:多种子调参并按 token 数拟合速率缩放律,重跑大模型实验。(4) 居中干预离部署很远:批次均值让路由决策依赖批次成分,只测了一层、3000 步——改进方向:实现滑动均值或 LayerNorm 式归一化,测全程训练与所有 MoE 层,并检查其与偏置控制器交互是否引入振荡。(5) 只测 sigmoid 路由:softmax/无界得分路由下跨度的“上限 1+2u”论证失效,得分沉入 sigmoid 平坦区(大模型上 84% 得分低于 0.01)这一病态在别的打分函数下可能表现不同——改进方向:在 softmax+router z-loss 设置下重复关键实验。(6) 部分骨干分区的反直觉结果(仅路由专家上 Muon 跨度最大 0.409 却无共享方向)说明大跨度有多个来源,论文的因果故事只覆盖其一,跨度作为单一诊断指标会混淆不同机制——改进方向:把得分偏移分解(均值输入长度 × 行散开度)作为常规记录指标区分两种病因。
未来方向
作者明确提出的方向:(1) 这些效应在生产规模(数千倍参数、四个数量级更多的 token)下会增长还是消退,特别是大模型上首层过载是否会像 Nemotron 3 Ultra 那样演化为不稳定;(2) 能否用滑动均值替代批次均值做输入居中,使其可部署且不引入批次依赖;(3) 是什么把路由器的行沿共享方向推开——负载不均是否真是原因;(4) 仅路由专家上 Muon 就能产生最大跨度但无共享方向的机制,以及等尺寸更新(控制组)在其中的作用;(5) 为什么共享方向似乎需要路由专家或共享专家在 Muon 上。基于本文成果可延伸的方向:(6) 把跨度与得分偏移做成生产训练的常规监控指标——Kimi K3 的分位数偏置、Trinity Large 的阻尼更新、$\phi$-balancing 等均衡器都可以用“偏置工作量”来横向诊断;(7) 设计偏置的预热调度或自适应更新率(与 Han and Zhong 的比例更新、积分控制器视角结合),在路由得分未稳定的早期加快追赶而不放大噪声;(8) 架构级修复:对首个路由器输入做轻量归一化/居中,并检验其长期效应与损失尖峰(大模型上 10 次尖峰都与跨度贴上限相关)是否消失,这可能是大规模训练不稳定的早期预警信号;(9) 验证“Muon 半速率在更长训练下更好”是否普遍成立,与学习率缩放律文献衔接;(10) 在带容量限制和多设备模拟下重估过载成本,把“均衡难度”从统计现象变成工程指标。
复现评估
复现条件极佳,对个人研究者非常友好。代码(Python 包 tfg,含 213 个测试)公开在 github.com/marcoshernanz/muon-moe-routing,code/RUNBOOK.md 给出训练和分析每个运行的命令;分词后的训练数据公开在 HuggingFace(marcoshernanz/llm-lab-fineweb-edu-sample10bt-bpe-16384-full);全部 145 次正式运行加 30 次探索性运行的日志与分析目录公开在 marcoshernanz/tfg-runs,其中 claims.csv 列出所有预登记计划比较及其结果。算力需求低:单张 NVIDIA RTX 5090 可跑单个运行,全部主运行在租用的 4×RTX 5090 主机上共 252.6 GPU 小时、73 小时墙钟完成;训练用 bfloat16 混合精度(主权重与路由器单精度)、确定性算法,同 GPU 型号上同种子逐位复现,指标计算只增加约 12–14% 时间。复现的难点不在算力而在实验纪律:预登记计划比较、按种子配对、探针运行需逐位一致校验后再做单变量改动,这些工程要求需要仔细照搬 RUNBOOK;此外三种子配对区间的统计解释(区间较窄但不代表置信区间)需要按论文 §4.4 的说明理解。总体难度:中等偏低,任何有一张消费级 GPU 和几周时间的人都能复现核心结果。
论文图表