MAServeBench:面向多智能体LLM服务系统的层级协作负载基准 MAServeBench: Benchmarking Multi-Agent LLM Serving Systems with Hierarchical Collaboration Workloads
把多智能体协作规则抽象为可配置服务负载,用语义轨迹实现固定工作量受控回放与SLO归因
前置知识
Continuous Batching 与 Prefill/Decode 两阶段
LLM 推理把每个请求分为 prefill(对整段提示并行计算一遍)和 decode(逐 token 自回归生成)两阶段;KV cache 缓存历史 token 的中间状态避免重复计算;continuous batching 则在不间断解码的同时动态插入新请求、移除完成请求,以填满 GPU 批处理窗口、提高吞吐。批大小 M(张量行数)是决定算子效率的关键几何量。
本文的核心观察是 MAS 协作改变了请求就绪时间、批组成与 KV 驻留时长,全部通过 prefill/decode、batching、KV 这些服务机制起作用,不懂这些机制无法理解论文的测量与归因。
多智能体系统(MAS)协作模式
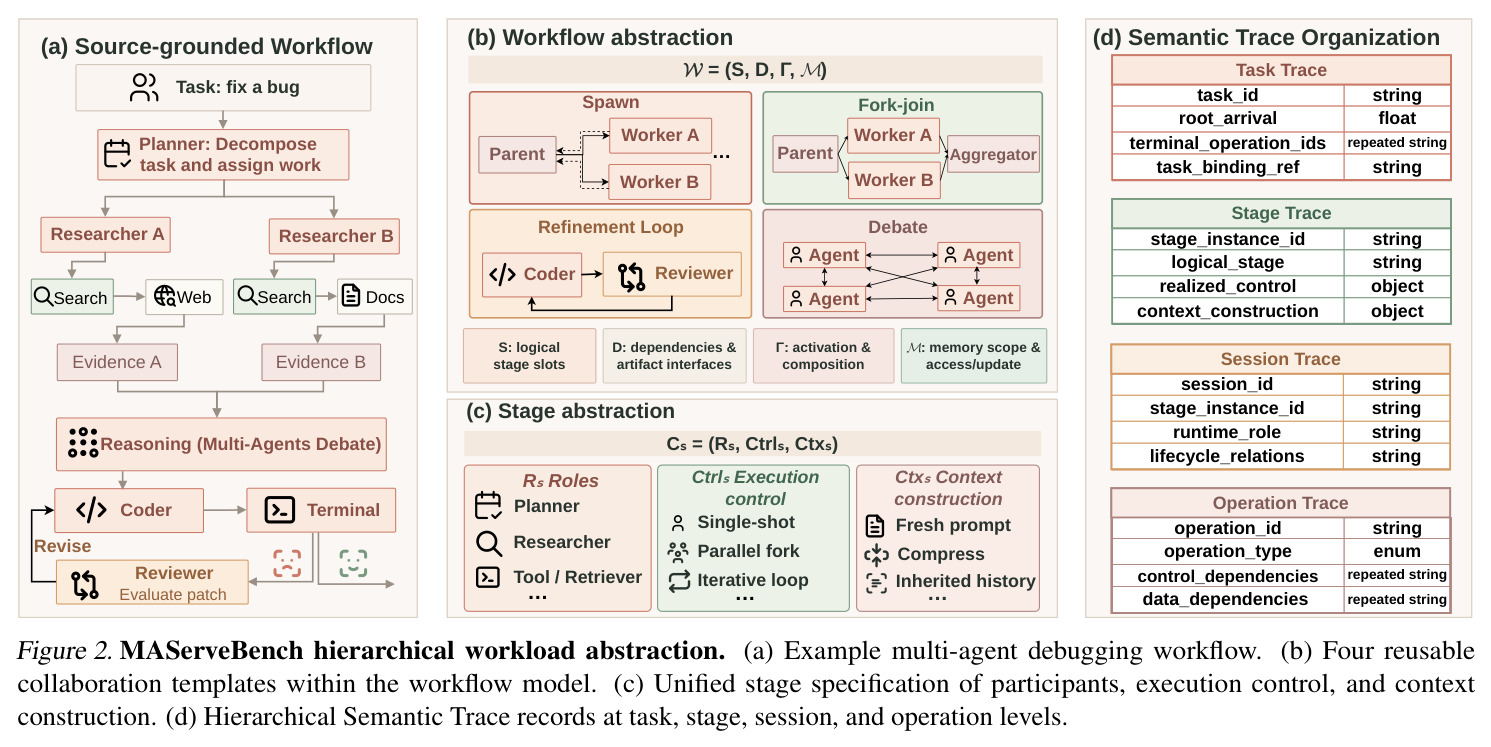
MAS 由多个承担不同角色(规划者、研究员、写作者、评审者等)的 LLM 智能体协作完成同一任务,典型协调模式包括:Spawn(父智能体派生子智能体)、Fork–Join(并行分支汇聚聚合)、Refinement Loop(评审-修订循环)、Debate(辩论)等。AutoGen、MetaGPT、ChatDev、Magentic-One 是代表性框架。
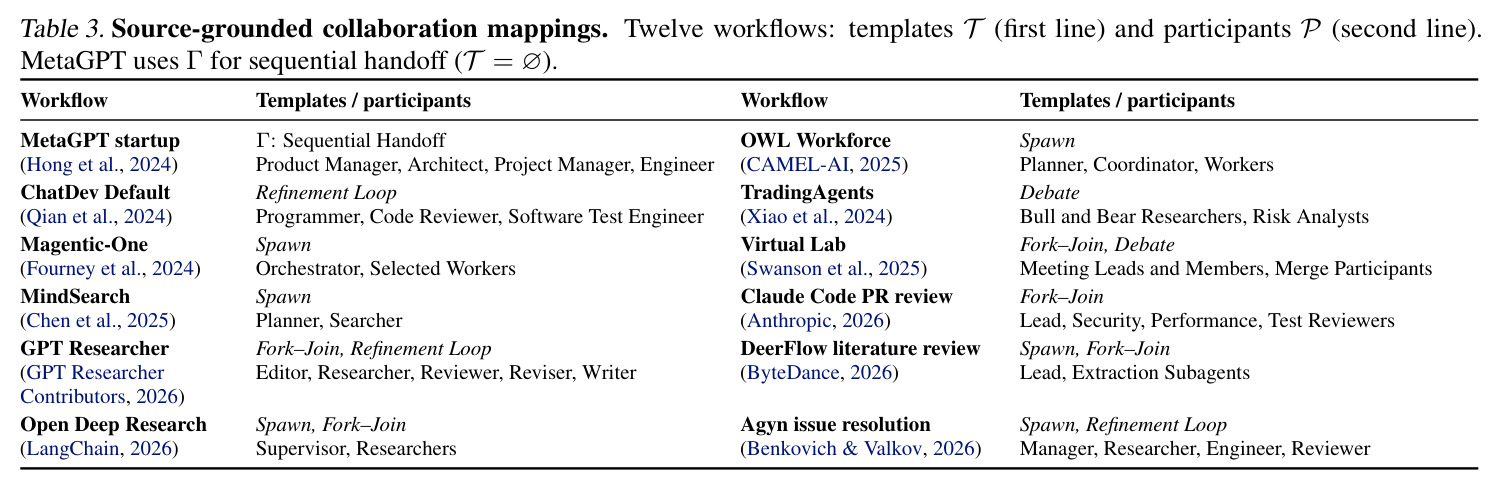
论文把这些模式抽象为四个可复用模板,并用 12 个真实开源工作流做源验证;理解这些协作模式是理解负载模型 W=(S, D, Γ, M) 设计的前提。
算术强度(Arithmetic Intensity, FLOP/byte)
计算量(FLOP)与访存量(byte)之比,是 Roofline 模型判断负载处于 compute-bound 还是 memory-bound 的核心量。LLM decode 阶段每步访存整份权重、计算量小,算术强度低;prefill 与大批 decode 强度高。聚合强度用 $\sum F / \sum D$ 按调度步加权。
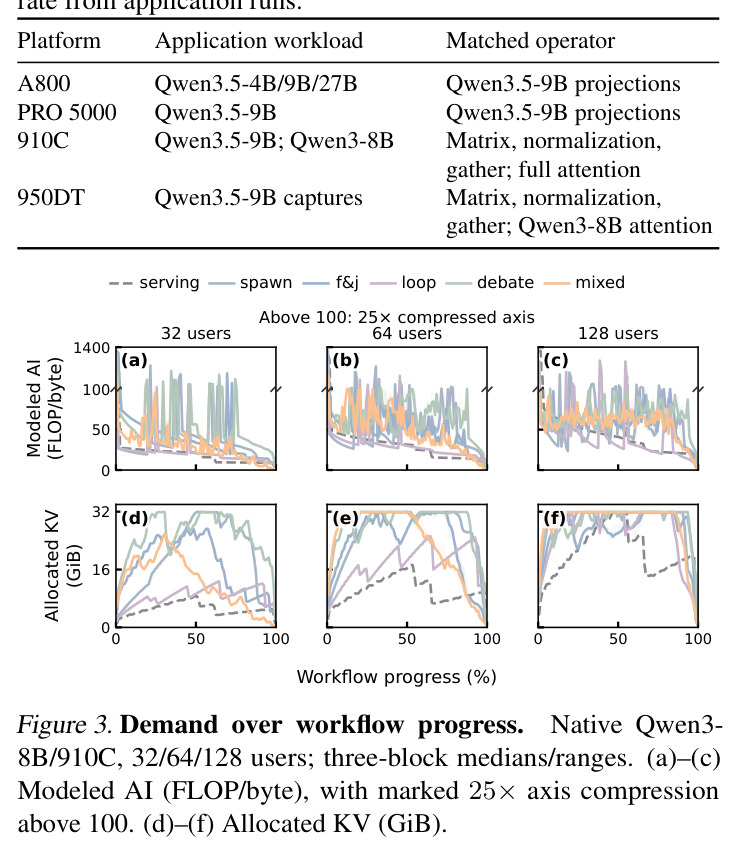
论文用 modeled FLOP/byte 和 KV 内存-时间积分 $\int K(t)\,dt$ 刻画不同协作结构的需求差异(如 Spawn 在 64 用户下聚合强度是普通服务的 1.70 倍),这是连接协作语义与硬件瓶颈的桥梁。
DAG 依赖、释放(release)与调度
MAS 的操作之间有控制依赖、数据依赖和状态依赖三类有向边,构成有向无环图;一个操作在其所有前驱完成并经过外部延迟后才变为就绪(release)。调度器只对就绪请求做准入、批组合与放置,协作依赖与后端调度必须解耦。
论文区分「工作生成」与「工作暴露」:合法释放(legal release)对比在冻结操作图上只改释放约束(如加 barrier),是全部固定工作量受控实验的方法论基础。
SLO、Deadline Attainment 与 Task Goodput
SLO 是服务级质量目标,这里表现为任务完成时限(deadline),取独立低负载参考 P95 的若干倍。时限达标率(attainment)= 达时限完成的根任务数 / 窗口内到达的全部根任务;任务 goodput = 单位时间内达时限完成的任务数,把吞吐量与任务级时效绑定。
论文最重要的结论是硬件效率提升不必然转化为任务按时完成(DAG 100% vs Barrier 4% 达标率),这一结论完全建立在 complete-task SLO 指标上,而非常规的 TPS/P99。
Trace 回放(length-locked / token-locked)
记录真实执行的请求负载(解析后的输入、输出长度、工具结果、依赖边)后离线重放,以在相同工作量下对比不同系统。length-locked replay 固定输入输出长度、让模型自己生成 token;token-locked replay 把每个采样 token 替换为记录的 token ID,逐位置精确复现。
语义轨迹加双模式回放是 MAServeBench 可控性的技术保障:论文验证了 16,077 个输出 ID 逐位置一致、204 对根任务回放/原生延迟差在 −1.85%~+2.88% 内。
研究动机
传统 LLM 服务评测把请求视为相互独立的到达(如 ShareGPT 式泊松负载),单智能体工作流则近似一条持续演进的交互链。而 AutoGen、MetaGPT、ChatDev、Magentic-One 等多智能体系统把一个用户任务拆成相互依赖的模型与工具操作:并行研究分支可能同时释放多个调用,join/barrier 会推迟下游调用,修订与辩论引发反复交换,智能体还会继承历史、共享中间产物或重建上下文。因此即使两个任务的请求数和 token 长度相近,其请求就绪时间、批处理机会与内存需求也可能截然不同。现有请求级 trace 只记录执行时观察到的「已实现工作」,不记录生成这些工作的协作规则;框架特定的协作模式又让负载难以复用构造。这导致系统与体系结构研究者无法回答一个根本问题:如果合法地改变协作规则(如给独立分支加 barrier、改换产物投递粒度),服务并发、计算与内存需求会如何变化,瓶颈会移到哪里?
本文的目标是论文要构建一个把多智能体协作当作可配置负载维度的基准 MAServeBench,包含三层目标。其一,负载构造:在任务输入和工具完全不变的前提下,通过改变协作规则(参与者数量、修订轮数、产物投递方式等)原生地生成不同的服务负载,使协作与任务绑定正交、可复用。其二,受控执行:用层级语义轨迹(Hierarchical Semantic Trace)保存每次实现的操作、解析后的输入与类型化依赖,既支持可复现的固定工作回放,也能作为架构模拟器的输入;并严格区分「改变生成的工作」(需要新的原生实现)与「只改变合法释放约束」(可在冻结轨迹上回放对比)。其三,任务关联测量:把工作生成、工作暴露与服务批次、算子开销、GPU/NPU 硬件行为贯通到完整任务时延与时限达标率,回答为什么硬件效率提升不必然转化为任务按时完成。
与已有工作不同的是,已有工作分三类,各有盲区:多智能体基准(如 MASBench)只评协作效果,不看服务与硬件;workflow 感知的服务系统(TokenCake/TokenDance 的轮次 KV 共享、Maestro/Topas 的依赖感知调度)针对单一机制做优化,不是可复用的负载源;XPerf 剖析观测到的 agentic trace 并通过改到达模式合成回放,AgentSysBench 刻画完整应用,AgentPerfBench 剖析推理与硬件开销,但都从「观测到的请求」出发,无法系统性地让协作规则本身成为实验变量。本文的独特切入是:把 12 个文档化真实工作流映射为 4 个可组合模板(Spawn、Fork–Join、Refinement Loop、Debate),使协作成为与任务绑定正交的负载生成维度;再配以「合法释放」概念——只允许在不引入依赖环、不破坏数据/状态前提的前提下改变释放顺序,从而在完全相同的工作量上隔离「暴露」效应,这是与以往所有 trace 合成方法的本质区别。
核心方法
直觉上,多智能体协作从两个正交维度塑造服务负载:工作生成(哪些调用、什么输入、多长的输出涌现)与工作暴露(依赖约束下操作何时就绪可执行)。技术路线分四层:第一层逻辑工作负载 $W = (\mathcal{S}, \mathcal{D}, \Gamma, \mathcal{M})$,$\mathcal{S}$ 为协作阶段槽、$\mathcal{D}$ 为阶段间依赖与产物接口、$\Gamma$ 用序列/选择/并行/有界重复/移交组合阶段、$\mathcal{M}$ 定义私有历史、共享版本状态与外部记忆的逻辑内存;第二层阶段语义 $C_s = (R_s, \mathrm{Ctrl}_s, \mathrm{Ctx}_s)$ 分别描述参与者、阶段内执行控制(spawn/fork/join/repeat/finish)与上下文构造(继承历史、压缩、投递产物);第三层把每次运行实现为具体操作图 $G^{(r)}$(含 control/data/state 三类边)并记录为分层语义轨迹;第四层把轨迹绑定到场景(到达率、释放规则、SLO)与系统配置(后端、硬件、调度/批处理/缓存/放置策略),在 vLLM 与 vLLM-Ascend 上于 GPU/NPU 平台原生执行或回放测量。
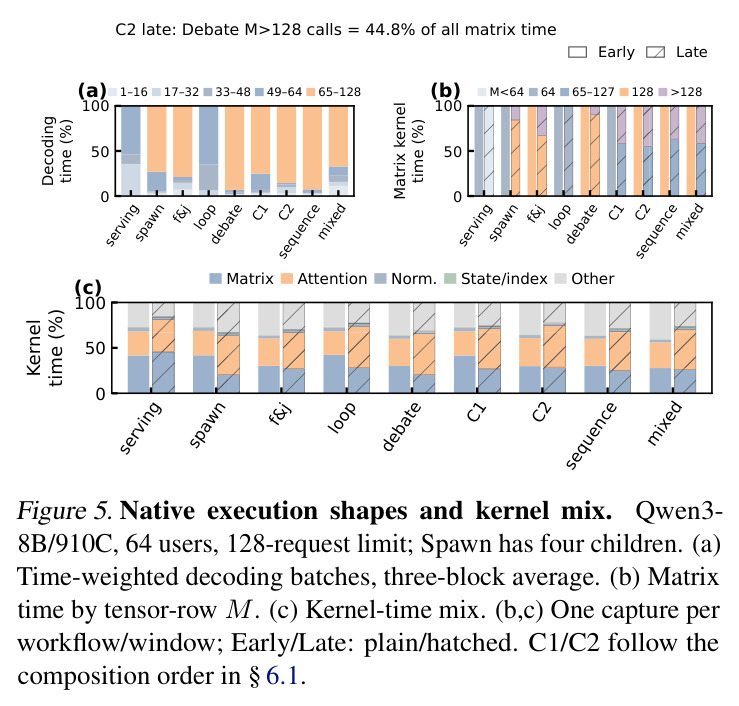
核心创新是把协作从「被动观测的结果」变成「可配置的负载生成器」,并配一套严格的对等实验语法。首先,12 个文档化工作流(MetaGPT、ChatDev、GPT Researcher、TradingAgents、Claude Code PR review、Agyn 等)经源码审计映射到 Spawn、Fork–Join、Refinement Loop、Debate 四个模板及其组合,同一任务绑定可派生不同负载——例如四调用控制中「只投递分析师 JSON 的 answer 字段」会经一次记录的 CPU 变换改变综合调用的解析输入,必须生成新的原生实现;而「给两个独立分析师加 barrier 边」保留全部数据/状态前提且不引入环,属合法释放改变,可在冻结轨迹上回放。其次,每个操作带分层身份 $h(o) = (\mathrm{task}, \mathrm{stage\ instance}, \mathrm{session})$,把调度批次与算子开销回溯到协作阶段——C2 捕获窗口中全部 1,008 个 $M>128$ 的矩阵调用被归属到 Debate 阶段,占该窗口矩阵核时间 44.8%。这种语义—物理双向贯通是区别于 XPerf 等 trace 合成方法的关键。
方法步骤详情
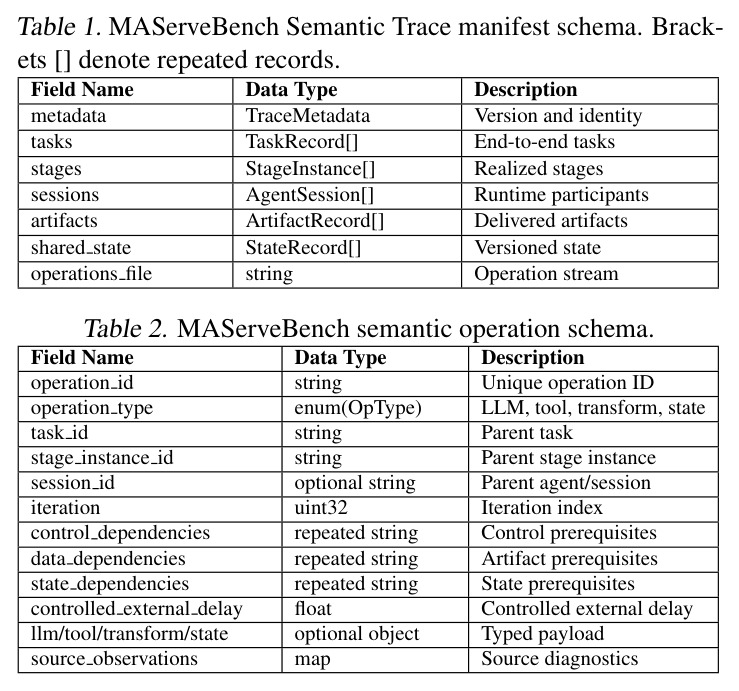
流程五步。(1)任务绑定:提供与协作无关的输入、角色指令、工具与评测标准,保证改协作规则时任务语义不变。(2)组装与原生执行:用模板组合工作流(如 GPT Researcher = Fork–Join + Refinement Loop),执行协作逻辑与工具,生成具体操作、输入与三类依赖边。(3)记录语义轨迹:task/stage/session/operation 四层清单(Table 1/2),含解析输入输出、生成设置、可选原生 token ID、工具结果与实测耗时、受控外部延迟;工件存于内容寻址存储,状态带版本与读写溯源,回放从可复现初始状态开始。(4)回放与校验:length-locked 固定输入输出长度让模型自行生成,token-locked 逐位置替换记录 token ID(在 CUDA vLLM Model Runner V2 上验证);工具按记录时长返回记录结果;审计要求 1,032 个请求 token 计数全吻合、186 条前置边 1 ms 内释放、204 对根任务无早释放。(5)测量与指标:执行键把 task/stage/operation ID 穿透到调度步、共享批次与算子窗口;指标含根任务时延、阶段时间、完成路径分解(就绪-提交-等待-调度驻留)、时限达标率与任务 goodput $G_{\mathrm{task}} = N_{\mathrm{SLO}}/T$。
技术新颖性
技术新颖性有五点。其一,逻辑/物理解耦:$\mathcal{M}$ 定义命名空间、共享范围、生命周期与版本读写语义,与物理 KV 分配和驱逐严格分离,使状态依赖成为可测的一等公民。其二,模板与任务绑定正交:七个结构(含 Spawn–Fork–Join–Refinement、Fork–Join–Debate–Refinement 两种组合)× 30 个共享绑定 = 210 个原生实现,负载多样性来自协作而非任务。其三,合法释放的形式化:barrier 只能串行化满足前提且无环的独立操作,为「固定工作、只改暴露」的因果推断提供语法——Barrier 使调度宽度 24→12、根延迟 +26%,GPT Researcher 上宽度 9→3、延迟 +40~54%。其四,分层归因:首个把协作阶段映射到执行几何的证据链(Debate → $M>128$ 矩阵行 → 44.8% 矩阵核时间)。其五,功能保真验证:7 组配对比较覆盖 6 框架、4 个真实任务集(SWE-bench Verified 500、GAIA 165、WebArena 812、DeepResearch Bench 100 实例),质量差仅 1.2–3.8 个百分点、输入中位数差 ≤2.3%,证明抽象未破坏任务语义。
实验结果
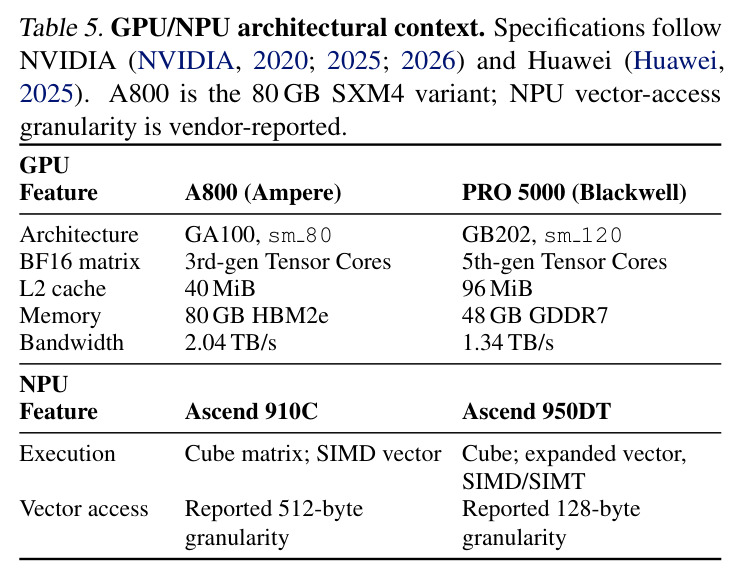
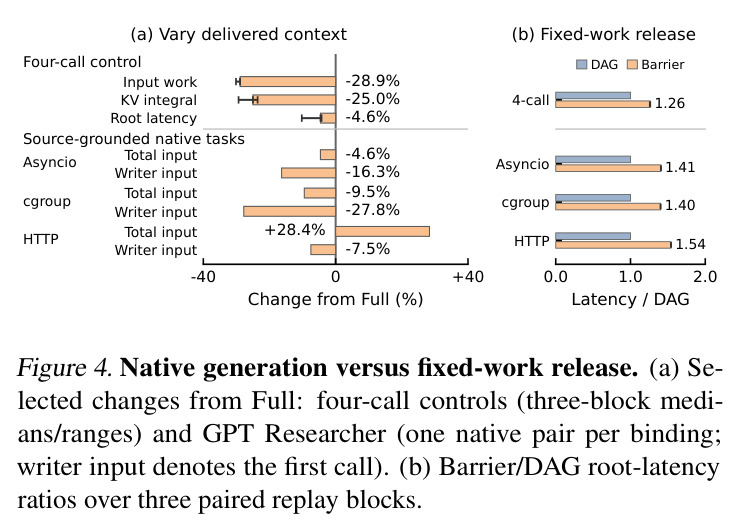
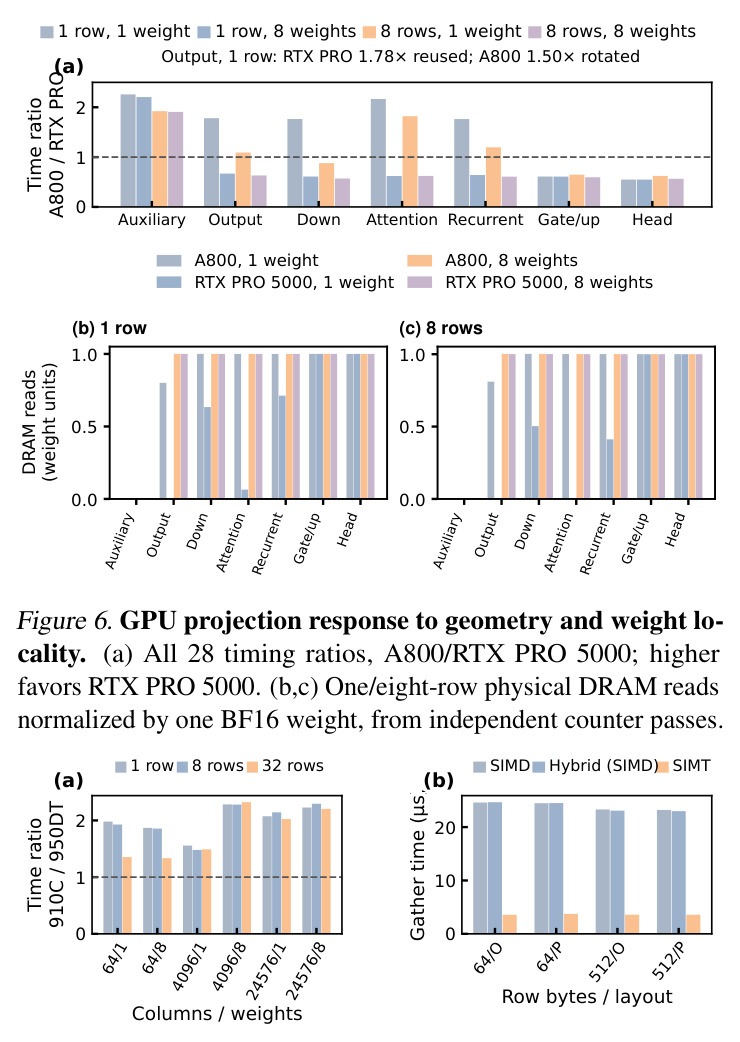
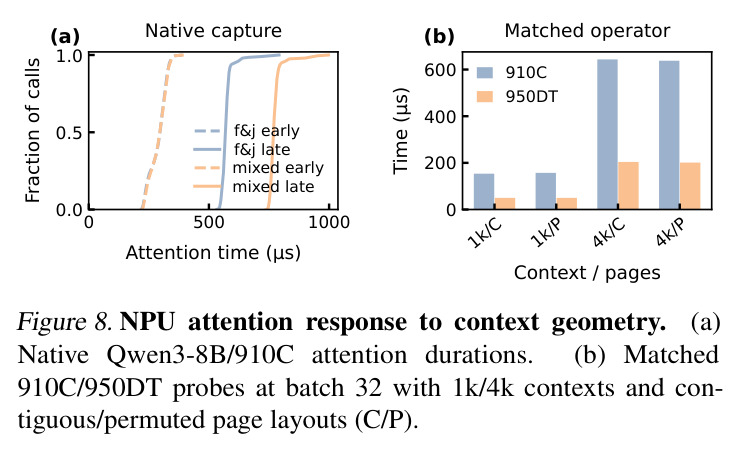
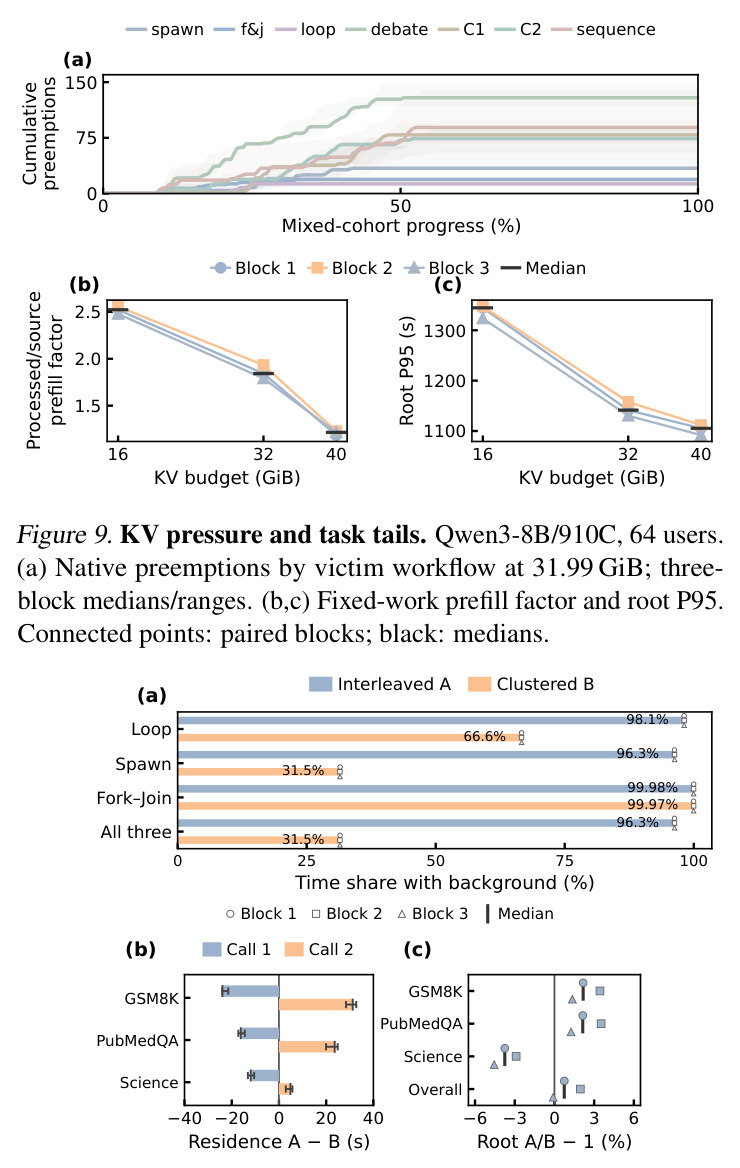
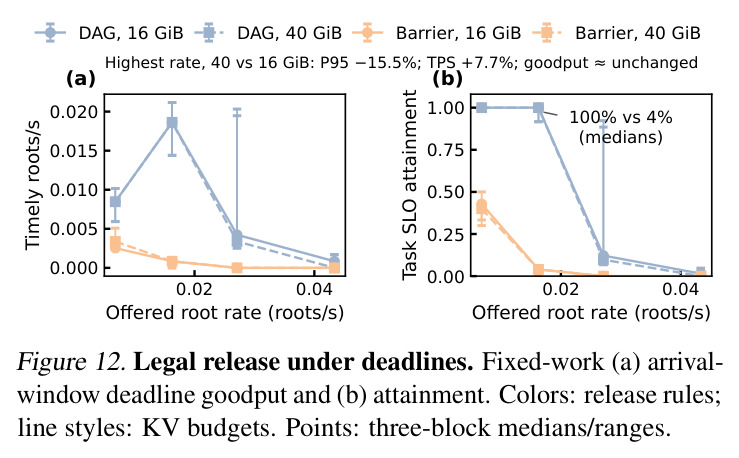
验证层面:1,032 个已完成请求 token 计数全部匹配、186 条前置边 1 ms 内释放;204 对回放根任务延迟差 −1.85%~+2.88%;token-locked 回放 16,077 个输出 ID 逐位置一致。洞察一(协作控制生成与暴露):64 用户下 Spawn 聚合算术强度为普通服务 1.70 倍,但执行 580 s 对 109 s,KV 内存-时间积分达 13.85 倍;四调用控制中 Selected 上下文使输入工作 −29%、KV 积分 −25%、根延迟仅 −5%,而 GPT Researcher 的 HTTP 绑定中 Selected 反使总输入 +28.4%、LLM 调用 25→30、图深度 15→20;固定工作下加 Barrier 使根延迟 +26%~+54%。洞察二(计算需要局部性与灵活执行):Spawn 的矩阵行数 $M$ 由早期 64 移到晚期 128(Loop 恒 64),混合队列注意力核时间占比 28.3%→44.6%;单行 4096×4096 输出投影在重用权重时 PRO 5000 比 A800 快 1.78×,8 权重轮换时 A800 反快 1.50×(L2 40 vs 96 MiB;计数器显示 A800 重用 32 MiB 权重仍外读 25.6 MiB,PRO 5000 为 0);950DT 上二进制验证的 SIMT Gather 比 SIMD 快 6.47–6.90×。洞察三(保留重叠 KV):混合队列 1,372 次抢占使处理 prefill 达源输入 1.76–1.84 倍且全落在 KV 分配 ≥95% 的时间仓;KV 从 16 扩至 40 GiB 使 prefill 因子 −52%、根 P95 −17.5%。洞察四(硬件收益必须兑现为 SLO):时间混合使共批重叠率 31.5%→96.3%,第二调用驻留惩罚致 GSM8K +2.17%、PubMedQA +2.14% 而 Science −3.75%;第二速率 DAG 达标率 100% 对 Barrier 4%;最高速率 40 GiB 使 DAG P95 −15.5%、TPS +7.7% 但时限 goodput 几乎不变;请求上限 64→128 使 TPS +14.6% 但及时任务率 −22.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 功能等价性(配对原生比较,6 框架 × 4 任务集,Qwen3.5-9B) | 任务质量(resolved rate / accuracy / success / RACE) | MAServeBench 实现:Agyn 62.4%、OWL 67.9%、Open Deep Research 0.4608 | 原始框架:Agyn 60.4%、OWL 64.8%、Open Deep Research 0.4509 | 全部 7 对质量差仅 1.2–3.8 个百分点(RACE ≤0.019),请求输入中位数差 ≤2.3%,确认抽象保真 |
| 固定工作回放保真度(Qwen3-8B/910C) | 回放/原生根任务延迟差 | 204 对根任务全部通过工作校验,延迟差 −1.85%~+2.88% | 原生执行 | 时序保真进入 ±3% 以内,支撑受控对比的因果有效性 |
| Token-locked 精确回放(Qwen3-4B/RTX PRO 5000 门控) | 输出 token ID 逐位置匹配数 | 16,077/16,077 全部逐位置一致,EOS 终止验证通过 | 原生记录的输出 ID 序列 | 100% 精确复现,消除采样随机性对服务测量的干扰 |
| 聚合服务需求(64 用户,Spawn 对比普通独立请求服务) | 聚合算术强度 $∑F/∑D$ 与 KV 内存-时间积分 | Spawn:1.70× 强度、580 s 时长、13.85× KV 积分 | 普通服务:109 s 时长、基线强度与 KV 积分 | 需求形态彻底改变:并发高但强度增 70%,KV 驻留积分增约 13 倍 |
| KV 容量干预(16→40 GiB,固定工作回放,64 根 × 3 块) | 处理/源 prefill 因子与根任务 P95 | prefill 因子 −51.97%,根 P95 −17.49%(各块单调下降) | 16 GiB 预算(因子约 2.5,P95 约 1340 s) | 证明并行分支的重叠 KV 驻留是抢占与重复 prefill 的根因 |
| 合法释放 × 时限(DAG/Barrier × 16/40 GiB,泊松到达) | 时限达标率(361.7 s = 1.5× 参考 P95) | 第二速率 DAG 达 100%(中位) | 同速率 Barrier 仅 4%(任意 KV 预算) | 仅加 3 条顺序边、不改任何工作,达标率差 96 个百分点 |
| GPU 投影权重局部性(1 行 4096×4096 输出投影) | CUDA 事件时间(A800/RTX PRO 5000 比) | 重用权重时 PRO 5000 快 1.78×;8 权重轮换时 A800 快 1.50× | 两代 GPU 互为对照(L2 40 vs 96 MiB) | 排名反转:MAS 变化的批几何使「更大 L2」与「更高带宽」的优劣互换 |
| NPU 辅助算子执行路径(950DT Gather,12 种实现) | Memory pass 耗时(二进制路径验证) | SIMT 实现比 SIMD 快 6.47–6.90× | SIMD 路径(Hybrid 模板编译出同一 SIMD 二进制) | 状态/索引操作需要可编程 SIMT 与访问感知路径选择 |
局限与改进
作者承认的局限:配对功能比较存在 1.2–3.8 个百分点的质量差(Magentic-One 在 WebArena 上 44.7%→40.9%),实现与源工作流的调用数、工具数不完全一致;token-locked 回放只在 CUDA vLLM Model Runner V2 上验证,HTTP 与昇腾适配器仅支持 length-locked;强制 KV 抢占与活跃取消未经回放验证;SLO 实验只覆盖 1.25–2.0× 参考 P95 的四个时限倍数;混合队列 Separate/Mixed 比较同时改变共执行与每类负载,需靠固定总体时间混合实验补证。我自己的观察:模型限于 4B–9B、BF16、TP1、单实例,结论对 70B+ 密集模型、MoE、多副本与 Prefill–Decode 分离部署是否成立未知;12 个工作流到模板的映射依赖人工源码审计,缺乏自动化保障;8192 token 上限截断长上下文场景;与 XPerf 的对照只做了 GPT Researcher 一例,外部效度有限;时限取参考 P95 倍数,依赖低负载参考窗口的稳定性;多数实验关闭前缀缓存,削弱对复用友好系统的评估。
独立分析的弱点
弱点一:模板体系只有 4 个本地模板,未覆盖人机协同、异步事件驱动、部分可观测等协作形态(作者引用的 MASBench 正研究部分可观测),对真实产品中的动态拓扑(如 agent 根据中间结果决定是否扩分支)无法表达——改进方向是引入策略化的 $\mathrm{Ctrl}_s$(控制规则本身可作为被测变量或由 LLM 策略生成)。弱点二:结构固定后仍需人工映射源工作流,1.2–3.8 pp 的质量差未做归因分析,可能引入系统性偏差——可增加配对数量并做映射步骤的消融。弱点三:硬件探针围绕 Qwen3 形状族(7 个投影族、K=4096)构建,矩阵族仅覆盖 54.9% 的采样矩阵时间,对其他模型族的代表性有限——可自动化形状提取与探针生成流水线。弱点四:单实例、TP1、BF16 的设置回避了张量并行、多副本路由与 PD 分离等真实生产变量,前缀缓存多数实验关闭也削弱了对复用友好系统的评估——需扩展到多卡多实例并开启缓存做敏感性。弱点五:时限实验中 Barrier 的劣势集中在中等负载区(0.016 roots/s),负载网格较稀(4 个速率),最优切换点刻画不足。
未来方向
作者在讨论中提出:重用感知计算(SRAM/L2 保留可重用权重、HBM 流式读取轮换权重、cache 旁路)、可编程 SIMT 与访问感知的 Gather 路径选择、页管理 HBM 池在迁移成本低于节省 prefill 时异步扩展 KV 到 DRAM、用 HBF 容纳冷读权重、3D 近存注意力服务长上下文、以及阶段感知放置与状态迁移(需把 phase 放置与 KV/状态传输关联到每个操作以评估 offset 成本与跨池排队);多副本方向提议 API-facing 回放适配器以研究路由、负载均衡与 prefix affinity 对完整任务时延的影响。基于其成果可自然延伸:把语义轨迹作为架构模拟器的标准负载格式做设计空间探索;以时限 goodput 为目标的协作感知调度器与 KV 缓存策略竞赛;研究 MAS 中 prefix 共享、投机解码、上下文压缩的收益量化;扩展异步/人机协同模板与多模型(多权重集交错)服务场景;以及把 210 个原生实现开放为社区负载库。
复现评估
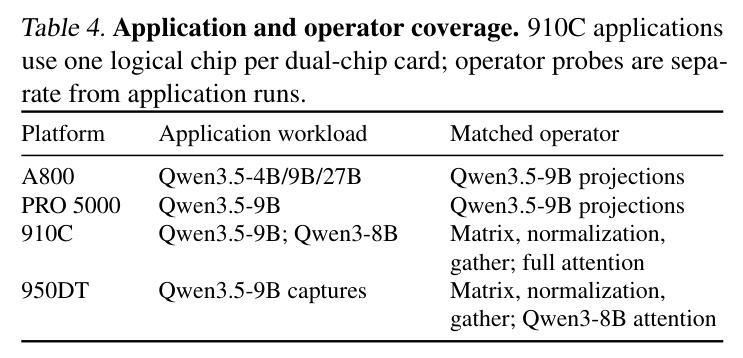
复现条件较好。代码开源于 GitHub(ShengxuanQiu/MAServeBench);12 个工作流全部给出源码版本号或审计版本(如 GPT Researcher rev 6f99857、TradingAgents rev 35543d0、DeerFlow rev 59aa91d),角色 prompt 与工具边界可追溯;模型为公开的 Qwen3-8B 与 Qwen3.5 系列(4B/9B/27B),任务集为公开的 SWE-bench Verified、GAIA、WebArena、DeepResearch Bench、GSM8K、PubMedQA。硬件上 A800 与 RTX PRO 5000(48 GB 工作站卡)较易获得,昇腾 910C/950DT 难获取、是主要门槛;大部分核心实验单卡、TP1、BF16 即可运行,软件栈 vLLM 0.30.0 与 vLLM-Ascend 均开源。附录 A–G 极其详尽:统计定义(P95 零基索引插值)、测量契约、逐块账本(Table F.4、G.1–G.9)、到达种子与观测窗 T=1181.13 s 齐备。总体难度中低:GPU 单实例路径易于复现;token-locked 回放需调用官方 trace 回放接口(不修改服务包);全套硬件覆盖与 NPU 路径验证成本较高。
论文图表
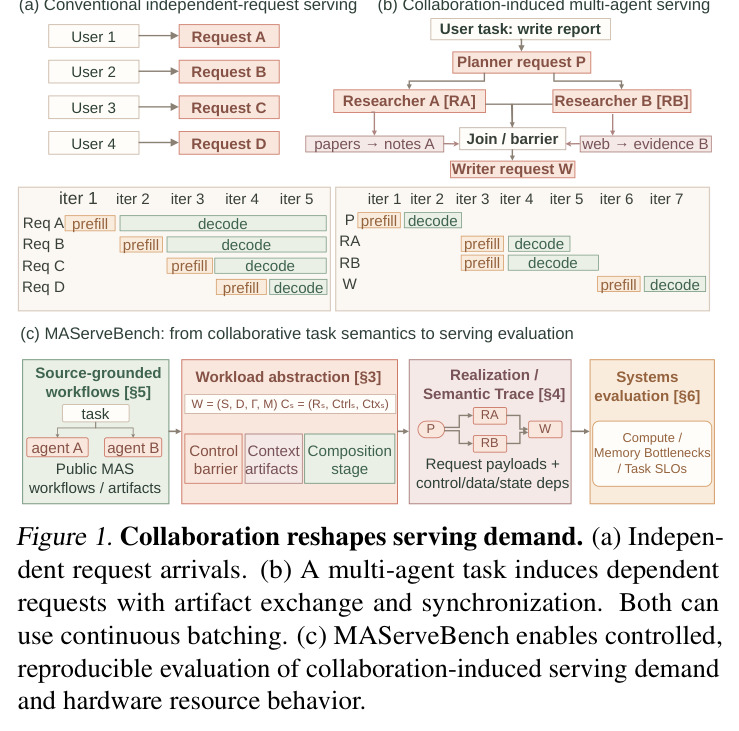
三栏对比:(a) 传统服务中四个用户请求相互独立到达;(b) 一个多智能体写作任务把用户请求变成规划者 P、研究员 RA/RB、写作者 W 的依赖调用链,含产物交换与 join/barrier 同步,两类负载都可用 continuous batching 执行;(c) MAServeBench 的全景流水线:从源工作流经负载抽象 W=(S,D,Γ,M)、实现/语义轨迹到系统评测,贯通任务、阶段、请求与硬件瓶颈。
一图讲清论文的根本论点:协作而非调度决策改变了请求就绪时间、批处理机会与内存需求,并给出整套基准的方法论地图,是全文的纲领图。
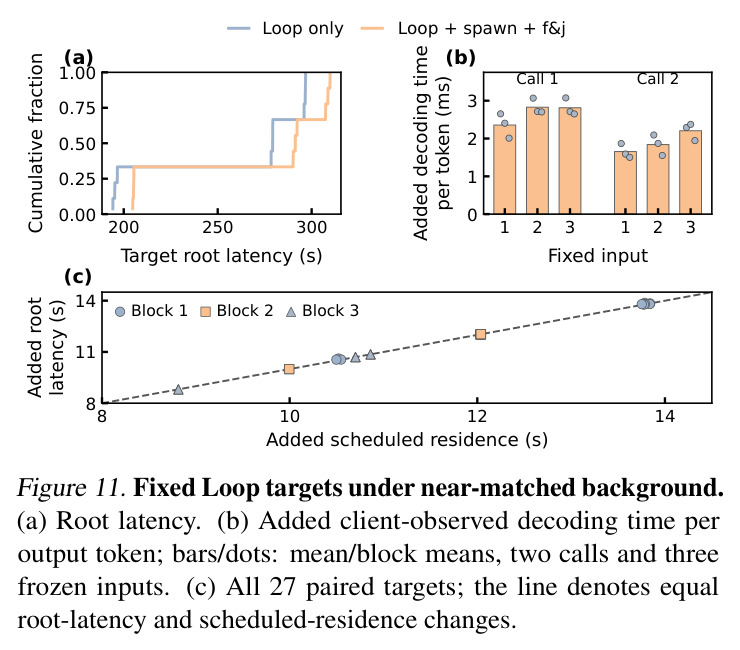
九个固定 Loop 目标在近似匹配的后台(把 55 个 Loop 后台中的 2 个换成 Spawn+Fork–Join,仅增加 6 个调用、4.5%/4.8% token)下:目标平均延迟升 3.9–5.0%,主要落在调度驻留(三块分别 +12.7/+11.4/+10.1 s),两调用客户端观测的每 token 有效解码时间均变长。
展示微量背景成分变化即可经由调度驻留传导为约 4–5% 的目标延迟变化,说明 MAS 任务对共批环境高度敏感。
DAG/Barrier × 16/40 GiB 的 2×2 固定工作对比,共享 361.7 s 时限、四个泊松速率:(a) 到达窗时限 goodput;(b) 达标率。第二速率 DAG 达 100% 对 Barrier 4%;最高速率下 40 GiB 消除抢占、DAG P95 −15.5%、TPS +7.7%,但 goodput 几乎不变。
全文压轴结论的可视化:硬件效率提升(更大 KV、更高 TPS)不必然转化为任务按时完成,调度与容量必须用 complete-task SLO 评判。
七组配对功能验证全表(Qwen3.5-9B):SWE-bench Verified 500 实例上 Agyn 60.4%→62.4%、SWE-Debate 55.6%→53.4%;GAIA 165 上 Magentic-One 62.4%→61.2%、OWL 64.8%→67.9%;WebArena 812 上 Magentic-One 44.7%→40.9%;DeepResearch Bench 100 上 GPT Researcher 0.498→0.479、Open Deep Research 0.4509→0.4608;并给出每组平均 LLM 调用、工具调用与输入/输出千 token 数。
功能保真是整个基准可信度的基石:该表证明抽象映射没有破坏任务语义,同时显示同等质量下执行需求可大不相同,论证服务测量的必要性。
GPT Researcher 原版编排与 MAServeBench 实现的负载几何对照:两臂反链宽度 3、深度 12–20、峰值 client in-flight 3,三个请求在根生命周期 23.0% 的时间重叠,输入中位数随进度增大,按派发时在飞请求数加权的 token 分布几乎重合。
最深一层的等价性验证:不仅任务质量等价,服务负载几何(并发、深度、上下文时序)也逐项对齐,排除「实现本身改变负载」的混淆。
并发与前缀缓存下的回放校准:Fork–Join 与 Fork–Join+Refinement 在 1/16 根、缓存开/关共 8 个层(204 对根),中位误差 −0.80%~+0.20%,单根范围 [−1.85, +2.88]%,全部通过 token/依赖校验。
证明语义轨迹回放在并发与缓存两种现实设置下的时序保真度,是所有固定工作干预实验有效性的量化前提。
16 个配置单元(4 速率 × DAG/Barrier × 16/40 GiB)的 goodput 与达标率三块中位/最小/最大值:第二速率 DAG 1.000 对 Barrier 0.040;第三速率 DAG 0.122/0.098 对 Barrier 0;最高速率几乎全部归零,40 GiB 在最高速率仅个别块救回 0.000847 roots/s。
Figure 12 结论的完整数值底账,展示释放规则效应的块间稳定性与高负载下容量干预的边界。
四调用控制中串行/并行比:Full 上下文三块根时间比 1.257–1.266、KV 积分比 0.953–0.957;Selected 上下文 1.280–1.283、0.951–0.958,说明加 barrier 的延迟代价约 +26% 且与上下文投递方式弱交互。
逐块给出「固定工作下暴露干预」的原始比例,支撑 Figure 4(b) 的中位数并显示效应的块间一致性。
KV 预算干预逐块账本:16 GiB 时抢占 887–900 次、因子 2.478–2.557、P95 1323.5–1347.2 s;32 GiB 时 425–511 次、1.791–1.933、1130.4–1157.7 s;40 GiB 时 96–134 次、1.187–1.228、1092.0–1111.9 s,全部 576 个根任务完成。
为「扩 KV 使 prefill 因子 −52%、P95 −17.5%」提供逐块单调证据,并披露实际分配(15.996/31.992/39.990 GiB)与执行顺序轮换,体现可复现性。