AgentWorld:面向多智能体 LLM 长程协作的基准测试 AgentWorld: Benchmarking Long-Horizon Collaboration of Multi-agent LLMs
基于MMORPG沙盒的长程多智能体协作基准,用因果图指标CCE度量协作质量
前置知识
LLM 智能体(Agent)
以大语言模型为决策核心的系统:每轮接收文本观察,输出一次工具调用或消息,形成“观察→决策→行动”循环。本文中每个智能体每轮还会收到任务专属文档(配方、怪物属性、资源位置)作为外部知识。
论文的被评测对象就是这类智能体,理解其回合制观察-行动循环是看懂实验协议与打分方式的前提。
多智能体协作(MAC)
多个角色、能力各异的智能体在共享环境中通过自然语言沟通、联合规划与资源共享,共同完成任何单个智能体都无法独立完成的任务,核心难点是信息不对称下的分工与同步。
这是本文的研究对象:任务被刻意设计成“没有单个智能体能独自成功”,协作质量直接决定分数。
黑盒交互设置
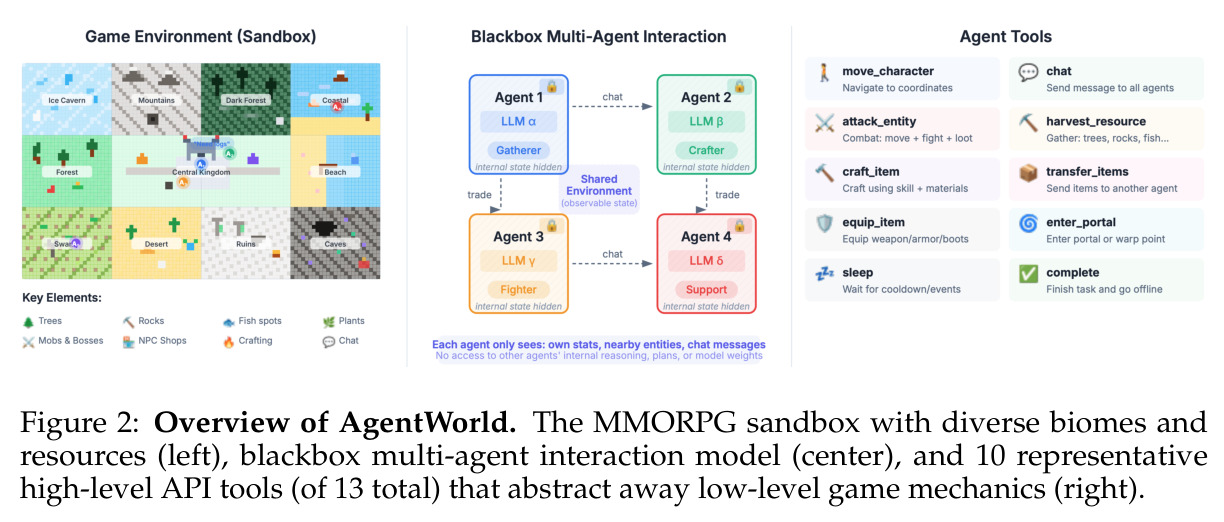
每个智能体无法读取其他智能体的内部状态、观察或动作历史,只能通过环境路由的显式聊天消息交换信息;与之相对的白盒设定允许智能体间共享完整上下文。
这是 AgentWorld 全部实验采用的设定,也是“协作能力”能被隔离出来的关键:信息差只能靠沟通弥合。
因果动作图与反向追溯
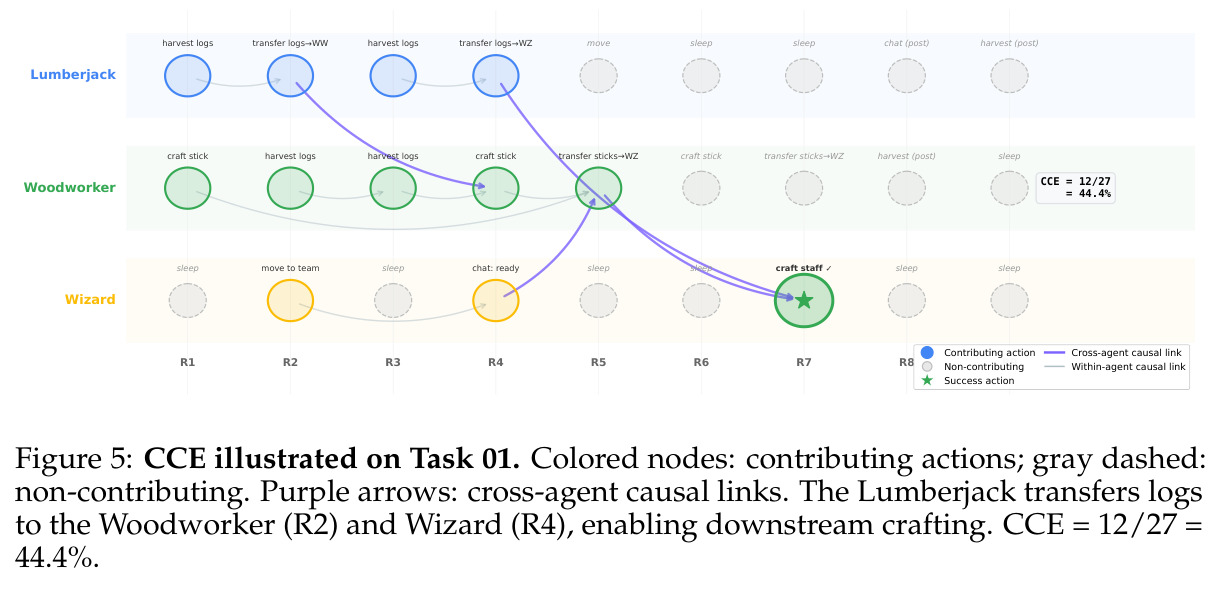
把轨迹中每个动作作为节点、动作间跨轮的因果关系作为有向边构成图;从直接达成目标的“成功动作”出发,逐轮向时间反方向追溯哪些动作因果地促成了已确认的动作,过程类似广度优先搜索(BFS)。
CCE 指标的数学基础:贡献动作集合 $\mathcal{C}$ 由此图累积而来,最终计算 $\text{CCE}=|\mathcal{C}|/|\mathcal{T}|$。
Cohen's Kappa($\kappa$)
扣除随机一致后的一致性系数,$\kappa=(p_o-p_e)/(1-p_e)$,其中 $p_o$ 为实际一致率、$p_e$ 为随机期望一致率;按 Landis–Koch 标准 0.6–0.8 属“显著一致”。
论文用它验证 CCE 裁判判断的可靠性:人类标注者与 GPT-4.1 裁判 $\kappa=0.64$,两个裁判模型之间 $\kappa=0.66$。
MMORPG 与 Kaetram
MMORPG 是大型多人在线角色扮演游戏,含战斗、采集、制造、交易等多种技能系统与开放世界;Kaetram 是开源 2D MMORPG 引擎,本文在其上构建了 9 种生物群系、380+ 物品、144 种怪物的沙盒世界。
它是基准的世界载体,8 大任务类别与 13 个高层 API 工具的设计都源于该游戏的技能与资源体系。
研究动机
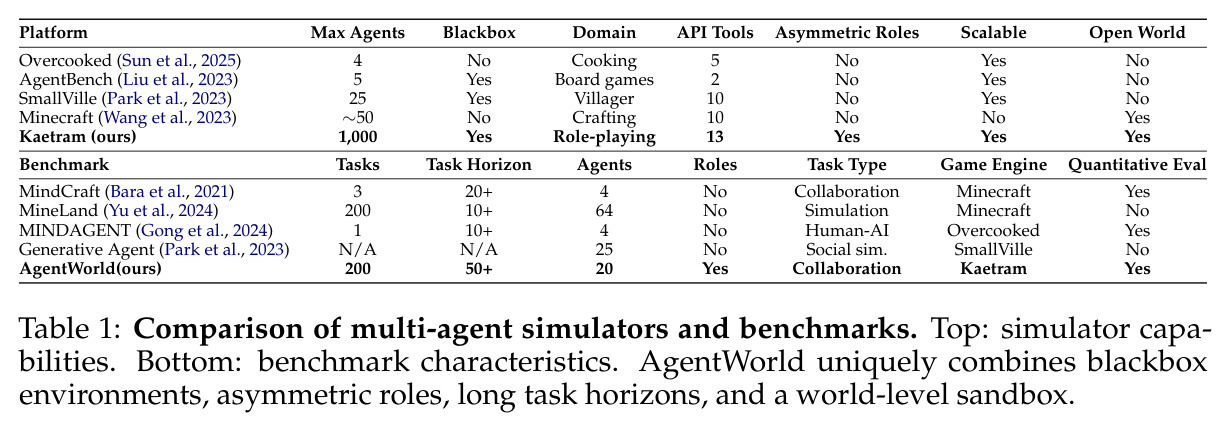
现有多智能体基准存在三类系统性缺陷。第一,任务时程过短:主流基准的交互轮数多在 20 步以内(如 MindCraft 仅 3 个任务、MINDAGENT 仅 1 个任务、Overcooked 最多 4 个智能体、MineLand 时程约 10 轮),不足以考察需要持续协调的复杂任务。第二,把底层动作控制与协作能力混为一谈:以 Minecraft 系环境为例,智能体要花费大量决策预算在精确 3D 导航、方块放置等细粒度操作上,导致协作质量对分数的影响被稀释。第三,Project Sid、Agent Society 等千级智能体的大规模仿真关注涌现社会行为,缺少可程序化验证的具体任务。此外多数基准既无非对称角色也无黑盒约束,无法区分真正的团队协作与各自为战。
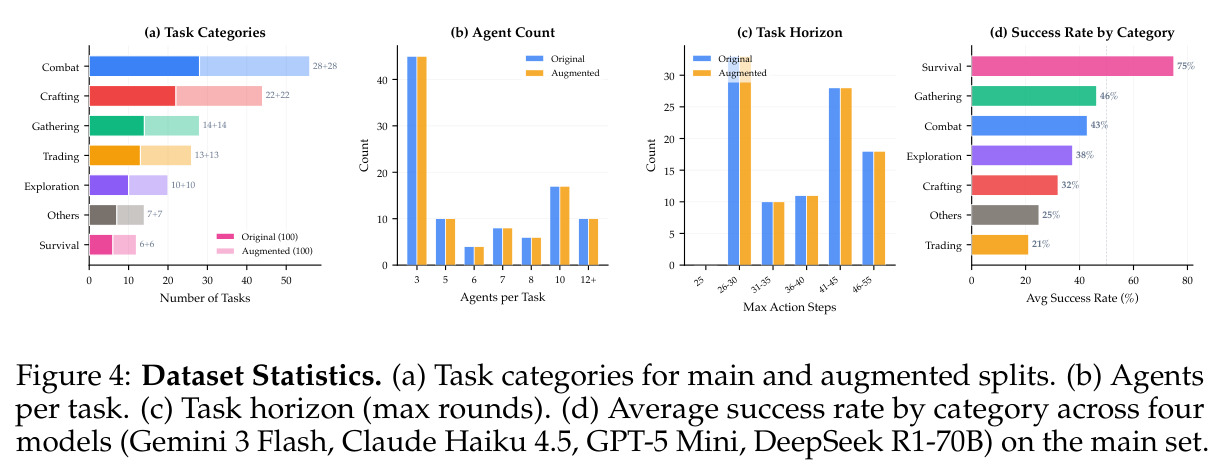
本文的目标是本文目标是构建一个能把“协作能力”从其他能力中隔离出来的评测基准:任务需要 3–20 个技能、装备、出生点互不相同的非对称智能体,在 25–55 轮(平均 38 轮)的长时程内,于黑盒设置下(互不可见内部状态,只能通过环境路由的聊天沟通)完成战斗、制造、采集、交易、探索、生存、建造、协调 8 大类任务;基准包含 100 个人工标注任务与 100 个 LLM 增强变体,每个任务配有 Python 验证器。同时提出超越二元成功率的量化指标,度量团队行动中有多大比例因果地贡献于最终结果。
与已有工作不同的是,独特切入是“中间地带”的环境设计哲学与可复现的指标设计。环境上,比 Werewolf/Overcooked 简单环境复杂得多——基于开源 MMORPG 引擎 Kaetram,1056×768 格地图、9 种生物群系、380+ 物品、144 种怪物、70+ NPC、1,531 个资源节点、8 种技能,又用 13 个高层 API 工具把寻路、战斗结算等底层机制封装成单次函数调用,使分数只反映协作决策而非操作熟练度。指标上,拒绝“给协作打 1–5 分”的主观 LLM-as-judge,只让 LLM 回答客观的二元因果问题(某动作是否促成了后续动作),把协作质量转化为因果图上的比例,并实证验证了其跨裁判稳定性。
核心方法
AgentWorld 由三部分组成:MMORPG 沙盒、长程协作基准、CCE 评估指标。沙盒在 Kaetram 之上构建抽象层,暴露 move、attack_entity、harvest_resource、craft、transfer、chat 等 13 个工具,把多步游戏机制(寻路→攻击→拾取)封装为一次调用;实时引擎被改造成回合制:每轮每个智能体依次收到结构化观察(附近地块、实体、自身状态)和任务专属文档,选择一个工具调用并等待结算,轮转次序确定,保证可复现;所有实验采用黑盒设置,协调只能靠聊天消息。基准含 100 个人工任务(8 类)与 100 个 Claude Opus 4.5 生成的增强变体。CCE 在轨迹上构建因果动作图,反向追溯贡献动作集合 $\mathcal{C}$,以 $\text{CCE} = |\mathcal{C}|/|\mathcal{T}|$ 度量团队努力中真正推进任务的比例。
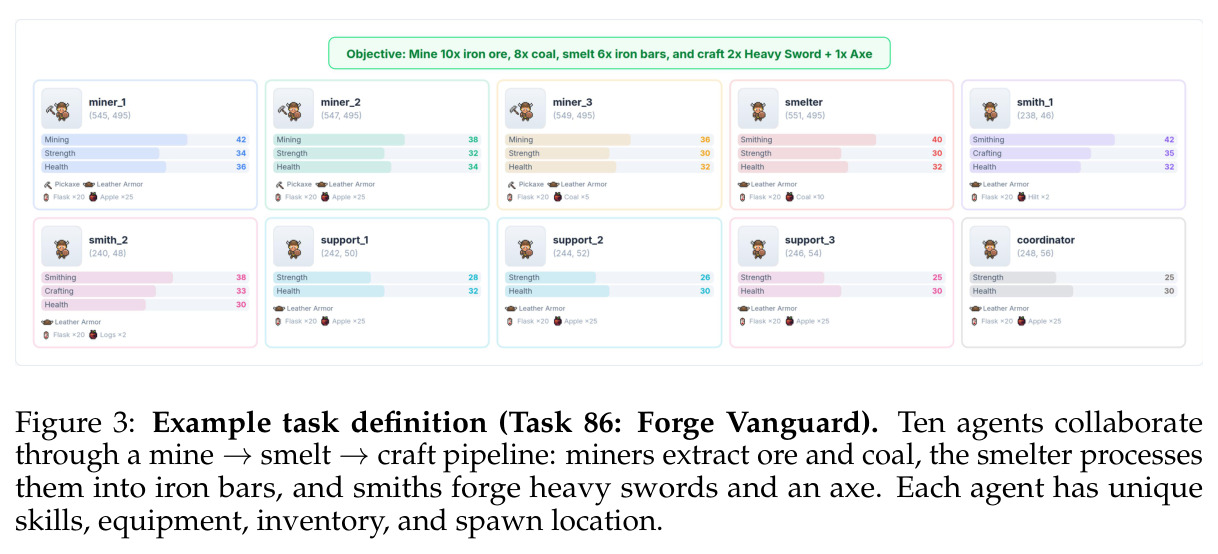
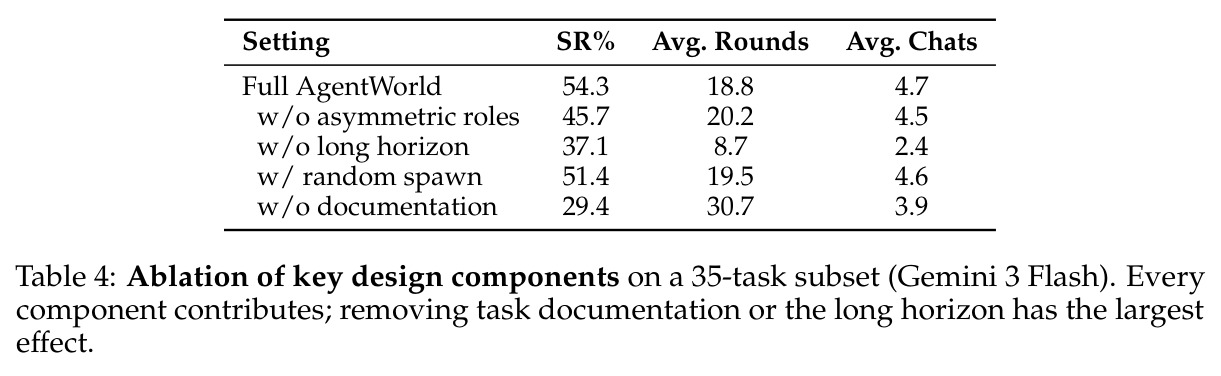
两项核心创新。第一,“黑盒 + 非对称角色 + 高层 API”的基准设计使协作成为唯一瓶颈:每个任务都保证任何单个智能体不具备全部所需技能或资源(例如 Task 67 需要 8 个智能体跨三个生物群系协调伐木、采矿与锻造),且智能体互相看不到内部状态,信息共享只能通过显式聊天——“会不会协作”直接决定分数,而消融实验(去任务文档 54.3%→29.4%、50 轮砍到 10 轮→37.1%)证明分数瓶颈确实在协作而非信息收集或时间压力。第二,CCE 的因果图构造:先锁定直接达成目标的成功动作,再逐轮向后扫描,让裁判 LLM 只回答二元问题“该动作是否因果地促成了任一已确认贡献动作”,以类似 BFS 的方式累积贡献集。与 MultiAgentBench 等整体打分的 LLM-as-judge 的本质区别在于:LLM 只做可复现的二元因果判断,不做主观质量评分。
方法步骤详情
方法分四步。(1) 环境构建:基于 Kaetram 定制抽象层,将寻路+攻击+拾取等封装为 13 个高层工具,每轮为每个智能体生成结构化观察与任务文档。(2) 任务标注:5 名标注者按预设类别分布设计任务,为每个任务定义非对称智能体配置(角色、技能、出生点、初始物品)、主目标与中间检查点、Python 成功验证器、逐智能体文档;任务须经两种 LLM 试点,失败归因为系统/任务/智能体错误并修订至只剩智能体错误;轮数预算(25–55)按试点成功所需轮数校准。(3) 任务增强:Claude Opus 4.5 变换目标、出生点与初始物品生成 100 个变体并人工质检。(4) 评测打分:验证器程序化检查最终游戏状态给出 SR,并按检查点给出部分成功率 PSR;CCE 由裁判模型(GPT-4.1)定位成功动作后逐轮反向做二元因果判断累积 $\mathcal{C}$,失败任务 CCE 记 0,最终报告 $|\mathcal{C}|/|\mathcal{T}|$。
技术新颖性
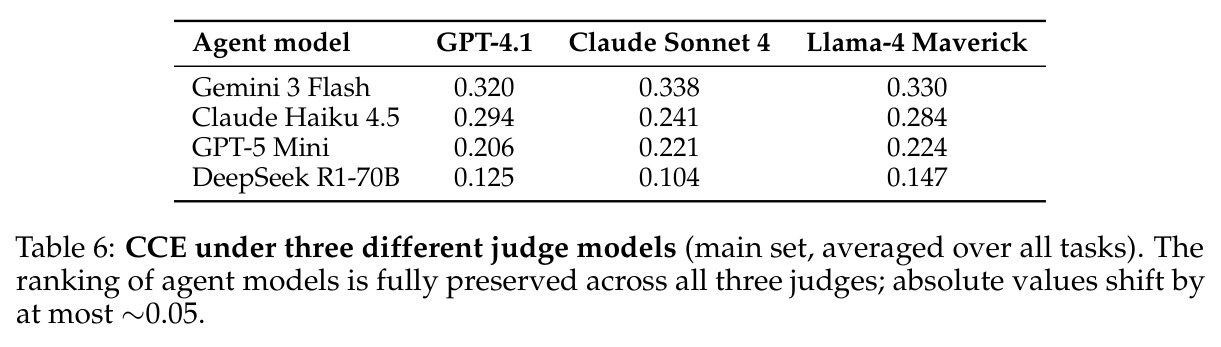
新颖性有三。其一,环境抽象的取舍有实证支撑:消融显示去掉任务文档 SR 从 54.3% 跌至 29.4%、把 50 轮缩到 10 轮跌至 37.1%、去掉非对称角色信息跌至 45.7%,而随机化出生点仅降至 51.4%,证明设计确实把难度压在协作上而非运气或信息获取。其二,CCE 的可复现性经过严格验证:人类标注者与 GPT-4.1 裁判在 84 个动作判断上一致率 82%(Cohen's $\kappa=0.64$),与两个不同裁判模型之间的一致度($\kappa=0.66$,基于 7,298 次判断)相当;换用 Claude Sonnet 4、Llama-4 Maverick 裁判后四个模型排序完全不变,绝对值漂移不超过约 0.05。其三,把协作质量从整体印象分变成轨迹上的比例量,支持条件分析——只看成功任务时 Claude 效率 0.653 反超 Gemini 的 0.609,揭示出 SR 看不到的差异。
实验结果
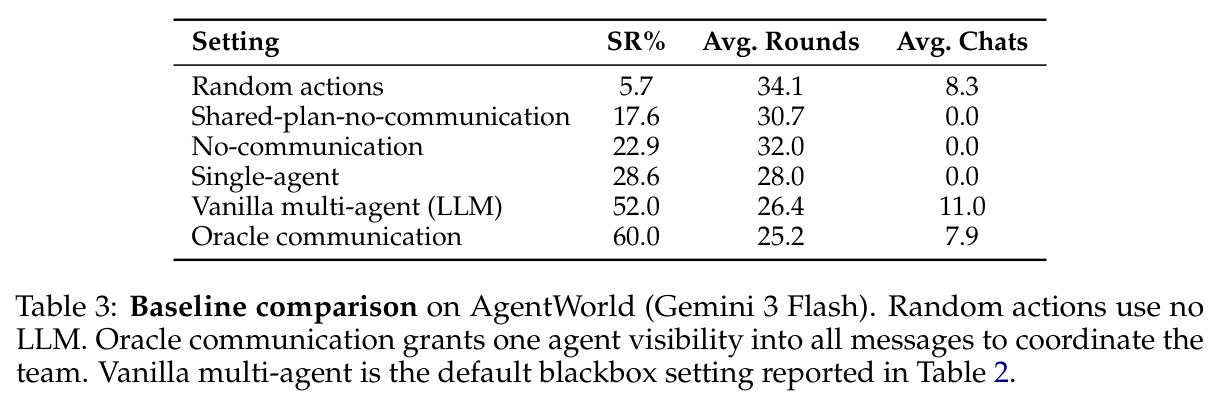
主集 SR:Gemini 3 Flash 52.0% > Claude Haiku 4.5 45.0% > GPT-5 Mini 36.0% > DeepSeek R1-70B 20.0%;PSR 均高于 SR(Gemini 71.5% vs 52.0%),显示晚段协调失败;27% 任务无模型解出。CCE 依次为 0.320/0.294/0.206/0.125,最佳模型也仅约 1/3 动作在因果路径上。增强集全部大跌:Gemini 52→24%、Claude 45→26%、GPT-5 36→21%、DeepSeek 20→10%。类别上生存最易(75%),协调(12%)与建造(20%)最难。沟通量与成功率不相关:GPT-5 Mini 发 44.1 条/任务却仅排第三(失败任务 26% 动作在聊天),DeepSeek 仅 7.5 条且首条拖到第 5 轮垫底,Gemini 适度(11.0 条)最优。基线中单智能体 28.6%、Oracle 通信 60.0%,信息完美也仍有 40% 失败。消融显示去任务文档暴跌至 29.4%、去长时程至 37.1%。通信错误“过期与冗余”占 37.7%。
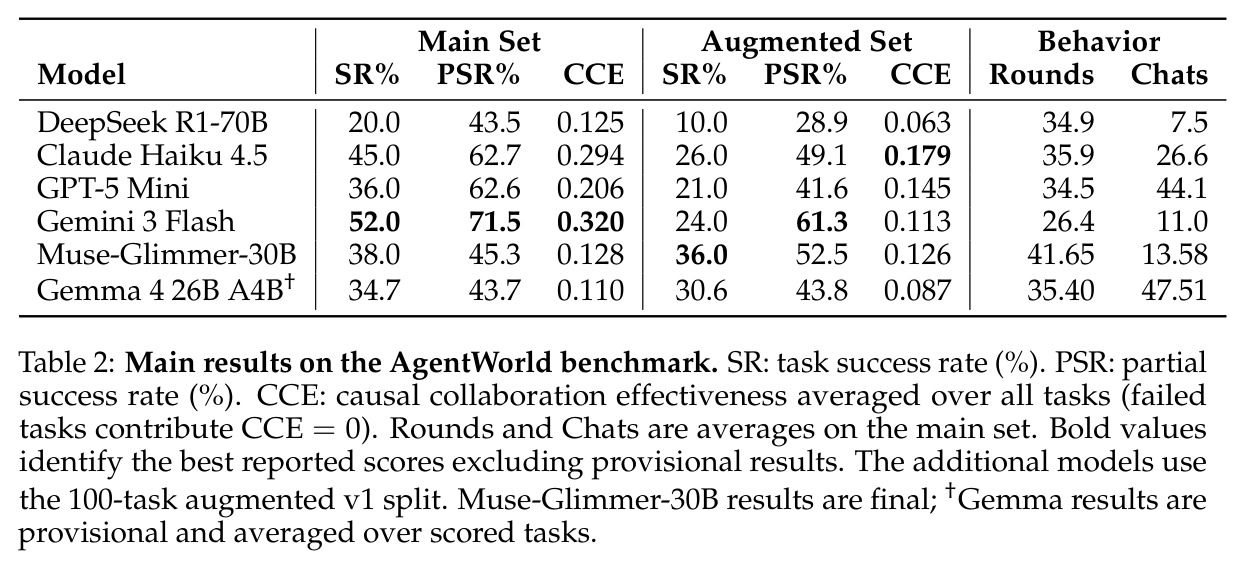
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AgentWorld 主集(100 个人工标注任务) | 任务成功率 SR | Gemini 3 Flash 52.0% | 单智能体 28.6%;无通信 22.9%;随机动作 5.7% | 比最强单智能体基线高 23.4 个百分点,确认任务确实需要多智能体协作 |
| AgentWorld 主集 | 因果协作有效性 CCE | Gemini 3 Flash 0.320 | DeepSeek R1-70B 0.125 | 即使最佳模型也仅约 1/3 动作在因果路径上,揭示大规模协作低效 |
| 通信上限分析(Gemini 3 Flash) | SR | Oracle 通信 60.0% | 黑盒 vanilla 多智能体 52.0% | +8 个百分点,但剩余 40% 失败说明规划与资源分配本身是主要瓶颈 |
| 增强集(100 个 LLM 增强变体) | SR | Claude Haiku 4.5 26.0%(主集为 45.0%) | DeepSeek R1-70B 10.0% | 四模型主集→增强集全部大幅下降(如 Gemini 52→24%),验证增强任务真实更难 |
| 设计消融(35 任务子集,Gemini 3 Flash) | SR | 完整设定 54.3% | 去任务文档 29.4%;去长时程 37.1% | 任务文档贡献 -24.9 个百分点、长时程贡献 -17.2 个百分点,是承重设计 |
局限与改进
作者承认的局限:CCE 采用宽松标注策略(边缘有帮助的动作也计为贡献),应读作真正有用动作比例的上界;失败任务 CCE 一律为 0;运行方差分析仅基于单模型三次运行(种子 42/819/314),不能证明模型间差异的统计显著性;Gemma 4 26B A4B 结果为临时值且按已打分任务平均。我的补充观察:CCE=0 使所有失败任务得分相同,“差一步成功”与“全程乱跑”无法区分,只能靠 PSR 部分补偿;裁判逐轮反向扫描成本高(仅两个模型 100 条轨迹就产生 7,298 次判断);单一 2D RPG 域的结论向代码协作、科研工作流等真实场景的迁移性未知;验证器只检查最终状态(可选检查轨迹),无法刻画协作过程质量本身。
独立分析的弱点
独立分析的主要弱点及改进方向:(1) 失败任务 CCE 恒为 0,丢弃大量诊断信息——改进:以检查点为锚定义部分因果链得分,或对失败任务报告“距最近检查点的因果覆盖度”。(2) 回合制 round-robin 串行执行与真实并发协作不符,轮转次序固定也可能系统性偏袒先行动的智能体——改进:引入异步或并行回合协议做对照实验。(3) 100 个增强变体由 Claude Opus 4.5 生成,可能携带单一生成器的目标与难度分布偏差,且增强集 SR 普遍腰斩(Gemini 52→24%),提示难度校准偏紧——改进:混合多个生成器并按人类难度标注重新校准轮数预算。(4) 13 个工具的抽象层次是单一选择点,高层接口隐藏了低层协调失误——改进:提供不同抽象层级的接口变体做消融。(5) 通信错误六分类(“过期与冗余”占 37.7%)只停留在观察层面——改进:设计状态同步协议等干预措施并验证因果效应。
未来方向
作者方向:开源完整沙盒、任务与标注平台,供社区评测 LLM 智能体团队的协作能力。可延伸的研究:(1) 把 CCE 用作强化学习的奖励信号,直接优化因果贡献率而非仅任务成功;(2) 针对 37.7% 的“过期与冗余”通信错误,设计显式状态同步、共享工作记忆或结构化消息协议并验证其因果效应;(3) Oracle 通信(60.0% 对 52.0%)暗示层次化协调有收益,可训练专门的协调者智能体或研究动态领导权分配;(4) 把任务生成器扩展到代码仓库、实验室工作流等域,检验 CCE 的跨域稳定性;(5) 利用沙盒支持 1,000 并发智能体的能力,研究大规模分工结构与涌现组织形态;(6) 把 CCE 改造为在线指标,在执行中途估计当前计划偏离度并触发重规划。
复现评估
复现条件良好:论文宣称完全开源——沙盒(基于开源引擎 Kaetram)、100 个人工任务与 100 个增强变体的定义及 Python 验证器、评测脚本、数据标注平台,另有项目网站 agentworld.io 与 GitHub 仓库。复现需要:四个被测模型的 API(Gemini 3 Flash、Claude Haiku 4.5、GPT-5 Mini、DeepSeek R1-70B),并按论文的回合制协议复用或自建编排器。算力集中在推理端:主表为 200 任务 × 多模型 × 每任务最多 55 轮 × 最多 20 智能体;CCE 打分还需大量裁判调用(仅两个模型的轨迹就产生 7,298 次二元判断)。总体难度中等:环境与数据齐备、协议确定性(轮转次序固定),但完整复现主结果需要可观的 API 预算;35 任务的消融与方差实验成本较低,适合先小规模验证。
论文图表
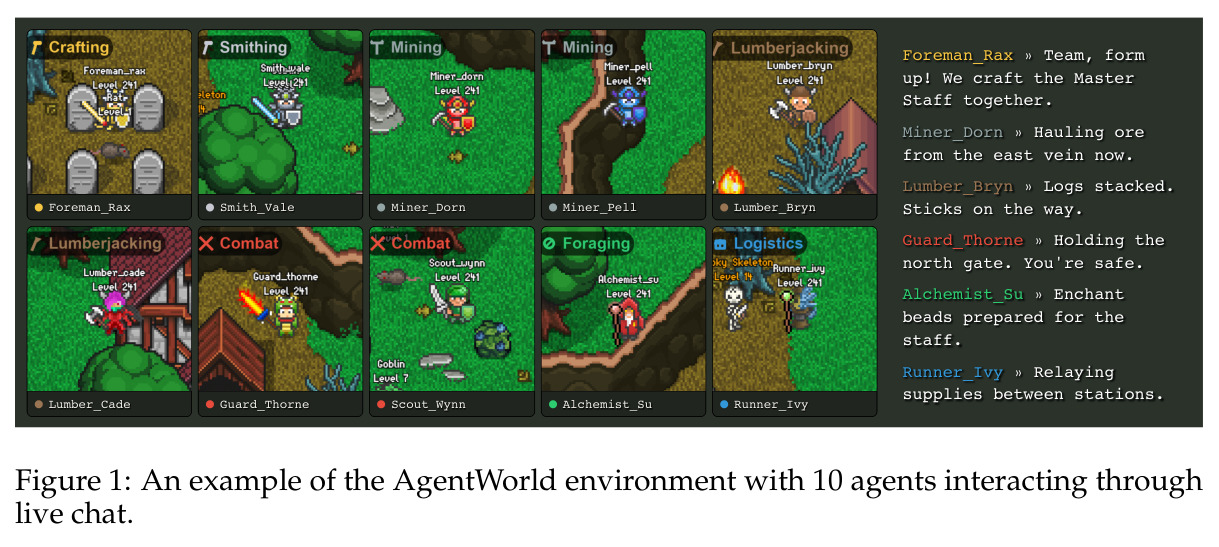
展示 10 个智能体(工头 Rax、铁匠 Vale、矿工 Dorn/Pell、伐木工 Bryn/Cade、守卫 Thorne、侦察兵 Wynn、炼金术士 Su、信使 Ivy)通过实时聊天协作打造 Master Staff 的画面:工头喊话分工,矿工汇报采矿、守卫报告守门、信使传递补给。
直观呈现“非对称角色 + 聊天协调”的基准形态,是理解黑盒多智能体交互如何运作的最快入口。
对 Gemini 3 Flash 在 100 条任务轨迹中的消息按类型聚类,通信错误分为六类,其中“过期与冗余”类占比最高,达 37.7%,根源可能是对其他智能体状态的错误理解或预测。
给出智能体通信失败的定量画像,是未来改进多智能体通信协议的直接依据。