随时随地:以世界状态为中心的智能体视频生成框架 Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation
以场景与事件双记忆构建可查询的世界状态,实现长视频任意时空一致生成
前置知识
智能体视频生成
指用大语言模型作为智能体来协调长视频创作全流程的范式:智能体负责剧本解析、镜头规划、参考素材选择,调用文本/图生视频模型逐个渲染短镜头,并对产出进行审查,最后拼接成完整影片。与端到端一次性生成长视频不同,它把长故事拆成一连串短镜头,由“计划-生成-审查”循环驱动,每个镜头只有几秒钟时长。
ATAS 就是这样一个智能体框架,理解这一范式才能明白它改造的是“镜头之间如何传递信息”这一具体环节。
显式三维场景记忆(点云/3DGS)
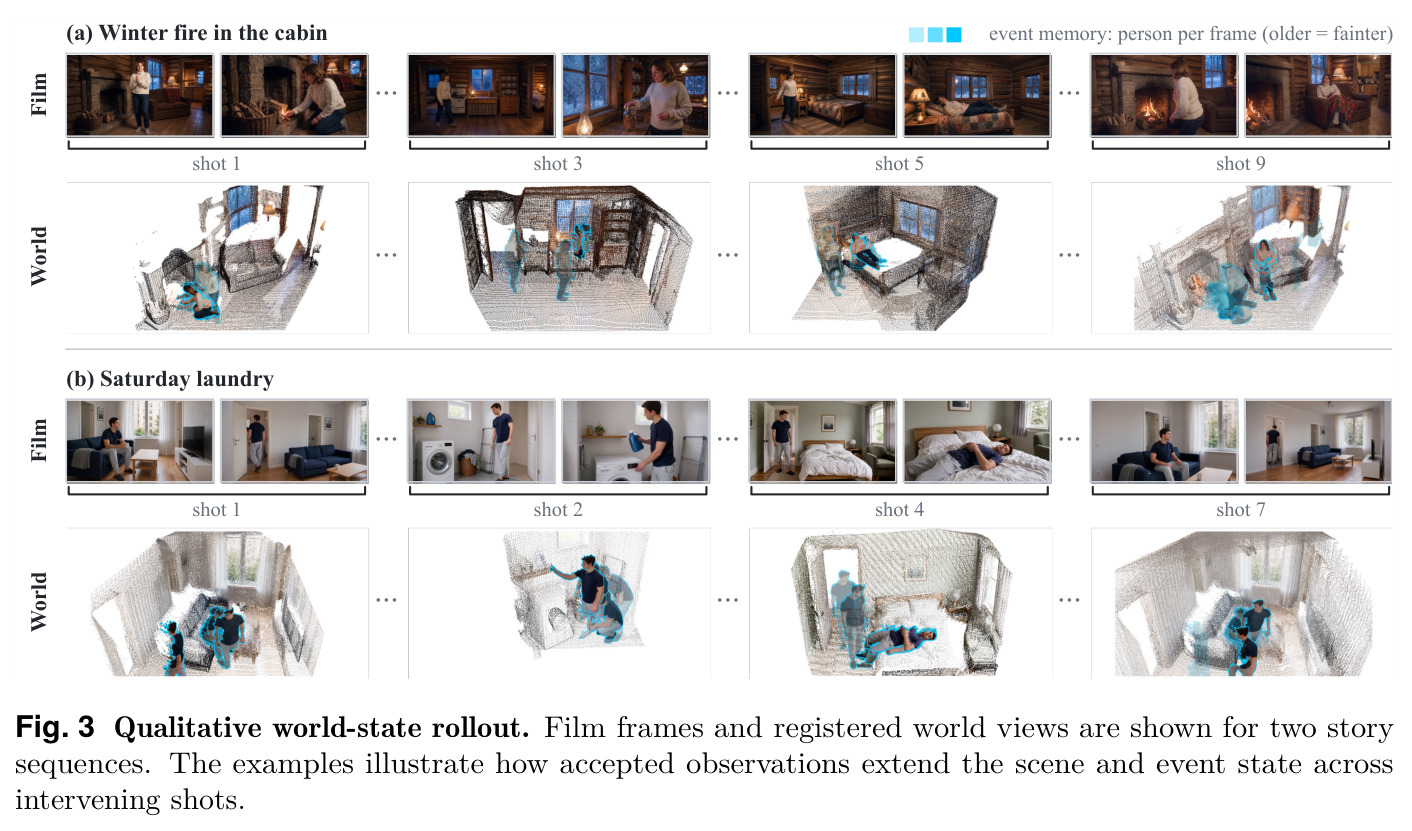
把场景表示为显式的三维几何数据,如点云或 3D Gaussian Splatting,而非隐式的神经网络权重。显式表示的优点是可以按任意相机位姿重新渲染出新视角图像,也能做增删改和空间查询。本文用配准到共享坐标系、剔除动态区域后的静态点云保存场景布局,用帧级动态点云保存事件证据。
ATAS 的场景记忆本质是一个可查询、可渲染的显式几何库,“空间重访”能力完全建立在它之上。
RGB-D 重建与坐标配准
从视频或图像序列估计每帧深度得到 RGB-D 数据,再通过相机位姿估计把多帧几何对齐拼合成统一的三维表示;坐标配准指求解刚体变换,把新观测的坐标系对齐到已有场景坐标系,使新旧点云落在同一坐标框架内。生成的视频片段必须先重建再配准,才能作为可靠的空间证据使用。
本文的配准检查 $r_t$ 决定一段生成视频能否进入世界状态,是整个方法闭环能否成立的关键。
VBench / ST-Bench / ViStory 评测体系
VBench 评估单视频的美学、主体与背景一致性、时间闪烁、运动平滑度等;ST-Bench 评估长视频的美学、全局与单镜头提示跟随,并用 C-All 与 C-Top10 度量跨镜头一致性;ViStory-Self/Cross 分别评估故事内部和跨镜头的身份、外观与场景一致性。多数指标在 0 到 1 之间,分数越高越好。
论文主表的所有数字都来自这套基准,读懂各指标的含义才能判断 ATAS 的提升究竟落在哪些维度上。
研究动机
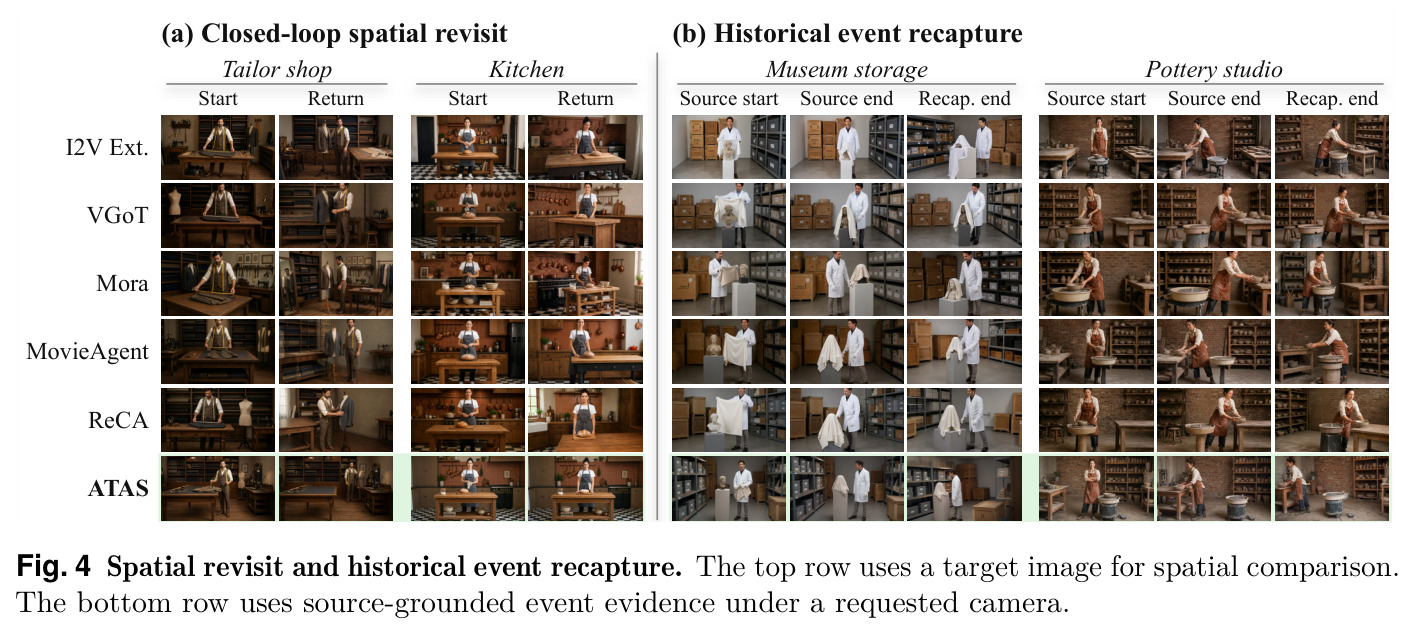
现有智能体视频系统(如 VGoT、Mora、MovieAgent、ReCA)在镜头之间传递的信息通常是最近生成的帧、文本摘要或检索到的参考图像。这类“编辑式上下文”只对时间相邻的镜头有效,对两类非局部请求会失效:一是空间重访——故事先在某个房间发生事件,切到其他地点,之后又回到这个房间,此时系统没有保存房间布局的共享坐标框架,回访镜头里家具位置、门窗朝向都可能变样;二是历史事件重演——要从新视角重演早前发生的事件,系统没有按“场景+事件+时间”索引的证据存储,无法找回当时的动作序列。更糟的是,即使有记忆,现有系统通常不加甄别地吸收自己生成的内容,一旦某个片段出现视觉、几何或时间错误,误差会顺着上下文传播到后续所有镜头。论文实验中,最朴素的 I2V Extension 在四个视频生成器上的平均分只有 0.531 到 0.605,正是逐镜头独立、无状态传递的极端情况。
本文的目标是本文的目标是给长视频智能体一个“持久世界状态”:让剧本中出现的每个场景和事件在任意时刻都可寻址。具体要同时满足三点:其一,空间上,后面对旧场景的回访镜头要能恢复先前确立的场景布局,论文用与目标图像的对比来度量,要求在 PSNRC、SSIMC、LPIPSC 三个指标上超过现有多镜头智能体方法和 3D 引导方法;其二,时间上,从新相机重演早前事件时,要保留事件身份、动作与状态、时间顺序,事件重拾总分要从无记忆时的 0.452 提升到接近 0.74;其三,可靠性上,世界状态只能吸收通过审查的观测,成片交付与记忆准入解耦,避免生成误差污染后续镜头。并且在四个视频生成器(MiniMax-H3、Wan 2.7、HappyHorse 1.0、Wan 3.0)上都要取得各 backbone 块内最高的聚合基准分。
与已有工作不同的是,点云与显式记忆方向的研究(3D Gaussian Splatting、空间记忆方法、动态视角合成)已能提供几何记忆和相机控制的重演能力,但作者指出的空白是:这些方法没有暴露“镜头级观测层、事件-时间寻址和状态更新决策接口”——即没有一套规则来决定“一段生成视频够不够格作为未来镜头的证据”。而智能体视频方向有镜头规划和审查,却没有共享坐标框架与事件时间索引。ATAS 的独特切入是把两条线合并:用空间配准的场景记忆和按三元组索引的事件记忆构成世界状态 $W_t = (S_t, E_t)$,并提出“成片交付与记忆准入分离”的三重门控机制。这个分离是被此前工作忽视的关键点:一段视频可以进成片但不能进记忆(配准失败时),也可以触发重试——现有系统大多把“这段视频好不好”当成唯一决策,而 ATAS 把它拆成三个独立的可靠性问题。
核心方法
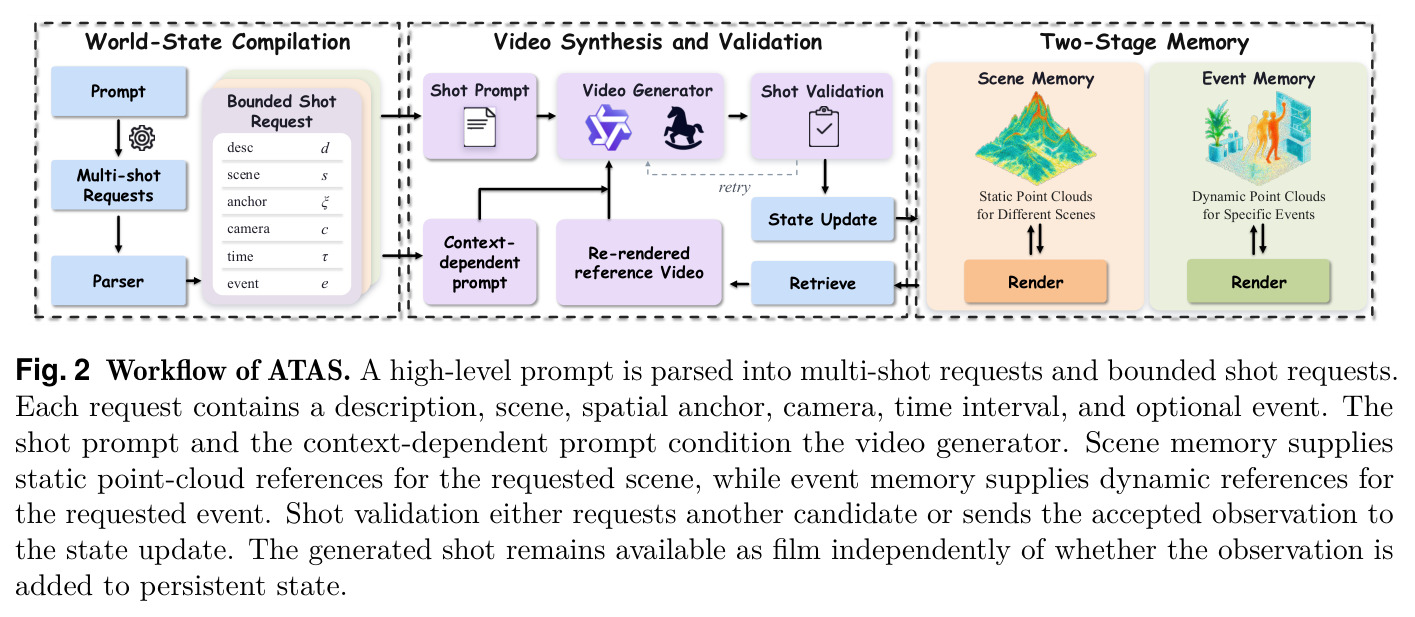
直觉上,ATAS 像一个配备了“场景图纸柜+事件档案室”的剧组:每拍一个镜头前,先根据剧本确定要去哪个场景、什么机位、什么时间、拍什么事件,然后从图纸柜调出该场景的三维布局渲染成参考图,从档案室调出相关事件的逐帧动态证据,一起交给视频生成器作为条件;拍完后片段要过三道审查——成片审查、坐标配准、状态准入——只有全部通过才把重建出的观测合并进世界状态。技术路线是一个循环:$(u, W_t) \xrightarrow{\text{Compile}} q_t \xrightarrow{\text{Query}} C_t \xrightarrow{G} V_t \xrightarrow{\text{Reconstruct/Register/Validate}} (V_t, W_{t+1})$,其中 $u$ 是高层剧本而非逐镜头提示词,$W_t = (S_t, E_t)$ 是世界状态,$q_t$ 是镜头请求,$C_t$ 是检索到的条件上下文,$V_t$ 是生成的短片。生成器 $G$ 保持为即插即用的短镜头模型,接口固定不变,因此在四个 backbone 上都能直接套用同一套编排逻辑。
核心创新有三点。第一,双记忆结构:场景记忆 $S_t$ 只存注册到共享坐标系、剔除动态区域后的静态点云,负责“任何空间”的重访;事件记忆 $\mathcal{E}_t = \{\epsilon_i\}_{i=1}^{N_t}$,每条记录 $\epsilon_i = (s_i, e_i, b_i, \tau_i, D_i)$ 按场景、事件、时间三元索引,存放帧级 RGB-D、掩码与动态点云,负责“任何时间”的事件重演。动静分离使静态布局不会被运动污染,事件证据也不会被误并进几何。第二,也是最本质的区别:状态更新由三个独立布尔决策控制——成片审查 $f_t$、配准检查 $r_t$、准入检查 $a_t$(校验候选的来源、场景范围与父状态版本),仅当 $f_t = r_t = a_t = 1$ 时才执行 $W_{t+1} = \mathrm{Update}(W_t, O_t)$,否则 $W_{t+1} = W_t$。也就是说一段片段完全可以“进成片但不进记忆”。第三,重建与注册只在生成之后发生,推理时的静态证据来自重新渲染的点云而非原始帧,使参考视角与请求视角彻底解耦。
方法步骤详情
第一步,世界状态编译:编译器按场景、时空关系、事件引用和相机需求递归切分剧本 $u$,直到每个请求都在短视频时长预算内,产出请求序列 $Q_t = \{q_{t,1},\dots,q_{t,K_t}\}$,每个请求 $q_{t,k} = (d_{t,k}, s_{t,k}, \xi_{t,k}, c_{t,k}, \tau_{t,k}, e_{t,k})$,即局部描述、场景、空间锚点、相机、时间区间与可选事件标识。第二步,记忆查询:静态部分用 $C^{\mathrm{scene}}_t = \mathrm{Render}(S_t, c_t)$ 渲染目标机位的场景参考;事件部分若 $e_t \neq \emptyset$ 则按 $(s_t, e_t, \tau_t)$ 从 $\mathcal{E}_t$ 检索记录,否则为空。第三步,镜头生成:$V_t = G(q_t, C_t)$,$q_t$ 构成镜头提示词,$C_t = (C^{\mathrm{scene}}_t, C^{\mathrm{event}}_t)$ 构成上下文相关提示词。第四步,验证与更新:$\tilde{O}_t = \mathrm{Reconstruct}(V_t)$ 重建观测,$O_t = \mathrm{Register}(\tilde{O}_t, S_t)$ 配准到场景坐标框架(首个源观测的配准即建立该框架),依次过成片审查、配准检查、准入检查,全过才 $W_{t+1} = \mathrm{Update}(W_t, O_t)$,否则 $W_{t+1} = W_t$;被拒片段仍留在成片,只是不能作为后续证据。空间重访与事件重拾两种查询复用这一流程。
技术新颖性
与 VGoT、Mora、MovieAgent、ReCA 等智能体方法相比,它们的镜头间状态是提示词、参考图或生成历史的“编辑上下文”,既无共享坐标框架,也无事件-时间索引,更没有准入规则;ATAS 把请求编译、记忆检索、镜头生成、状态更新拆成四个显式接口,嵌入语言智能体的“计划-行动-观察”循环。与 FlexWorld、ViewCrafter 等 3D 引导方法相比,它们有几何引导但不做事件时间寻址,也没有“观测够不够格进状态”的决策层。与动态视角合成研究相比,ATAS 刻意保留帧局部的动态证据而不假设身份级运动模型,因此不依赖同步目标视频。消融显示这套组合各组件贡献互补:仅镜头渲染时 ViStory 平均只有 0.478,加入场景/事件解析升至 0.612,递归编译把事件分从 0.508 拉到 0.711,验证与准入检查再补到最后 0.670 和 0.739,说明创新不在单一模块,而在结构性的分离与门控设计。
实验结果
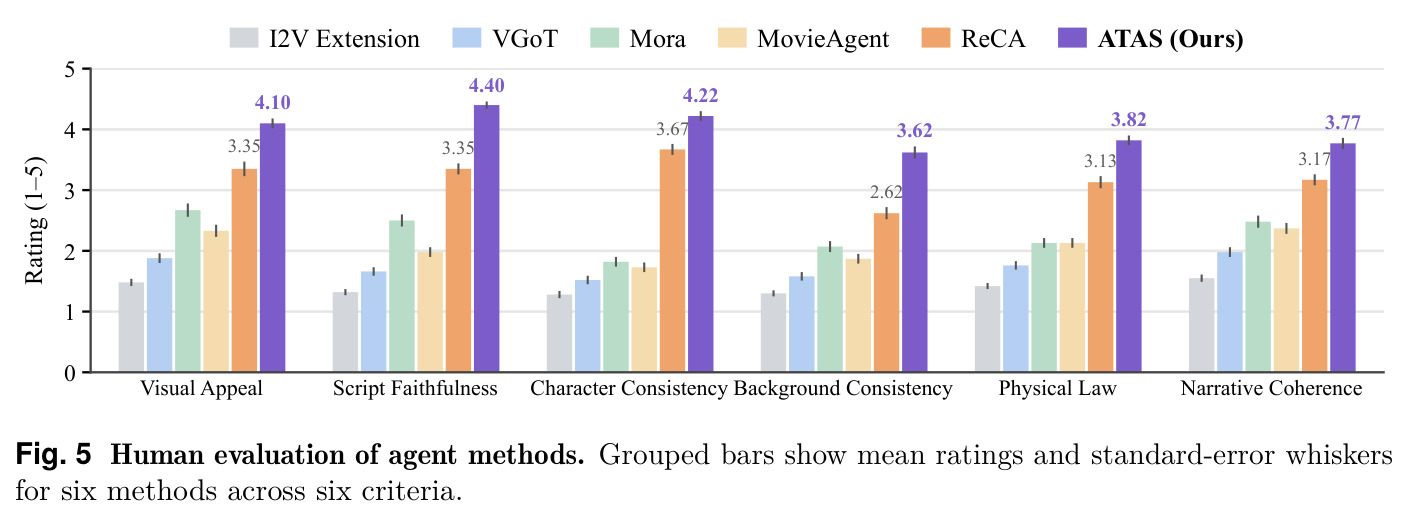
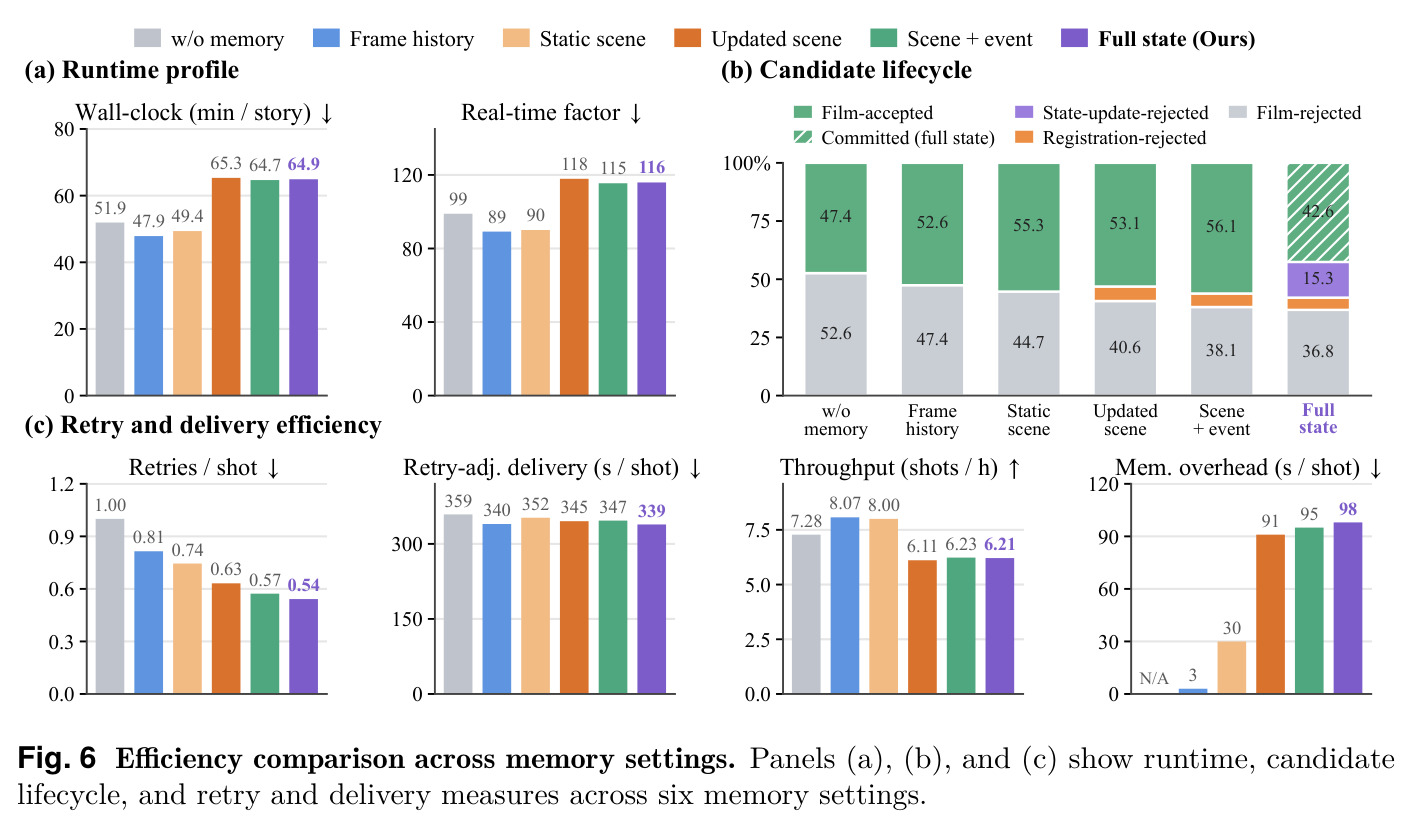
主表(Table 1)在四个 backbone 上对比五个基线:Wan 3.0 上 ATAS 聚合分 0.734,比最强基线 ReCA 的 0.648 高 0.086,ST-Bench 0.719、ViStory-Self 0.756、ViStory-Cross 0.584 均为块内最高;MiniMax-H3 上 0.702 对 0.659,HappyHorse 1.0 上 0.694 对 0.656;唯一例外是 Wan 2.7 的 VBench 上 0.846 略低于 ReCA 的 0.854,但聚合分仍以 0.656 对 0.612 领先,说明收益来自持久状态而非渲染器。空间重访(Table 2):ATAS 取得 PSNRC 15.968、SSIMC 0.385、LPIPSC 0.284,超过 3D 引导的 ViewCrafter(15.255/0.375/0.293)和 FlexWorld(14.740/0.343/0.315)。事件重拾(Table 3):事件身份 0.750、时间顺序 0.688、视角实现 0.650 三项领先,角色/物体一致性 0.917 与 ReCA 并列,仅动作状态 0.688 略低于 0.700。人评(Fig. 5)六项全部第一:剧本忠实度 4.40、角色一致性 4.22、视觉吸引力 4.10、物理规律 3.82、叙事连贯 3.77、背景一致性 3.62。记忆消融(Table 5):C-Top10 从 0.536 升到 0.719,事件分从 0.452 升到 0.739,LPIPSC 从 0.341 降到 0.284。效率(Fig. 6):重试从每镜头 1.00 降到 0.54,重试校正交付时间 359 降到 339 秒,成片拒绝率从 52.6% 降到 36.8%,但墙钟时间从 51.9 升到 64.9 分钟/故事,吞吐从 7.28 降到 6.21 镜头/小时,记忆开销约 98 秒/镜头。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 长视频跨镜头一致性(Wan 3.0) | 四基准聚合平均分 | ATAS 0.734 | ReCA 0.648(最强基线) | +0.086 |
| 长视频跨镜头一致性(MiniMax-H3) | 四基准聚合平均分 | ATAS 0.702 | ReCA 0.659 | +0.043 |
| 空间重访(目标图对比) | PSNRC / SSIMC / LPIPSC | 15.968 / 0.385 / 0.284 | ViewCrafter 15.255 / 0.375 / 0.293 | 三项全面领先 |
| 历史事件重拾 | 事件身份 / 时间顺序 / 视角实现 | 0.750 / 0.688 / 0.650 | ReCA 0.733 / 0.617 / 0.500 | 三项均领先 |
| 人评(六准则) | 5 分制平均分 | 全六项第一(剧本忠实度 4.40、角色一致性 4.22) | ReCA 等五种方法 | 六项全部最高 |
| 记忆消融(Wan 3.0) | C-Top10 / LPIPSC / 事件重拾 | 全状态 0.719 / 0.284 / 0.739 | 无记忆 0.536 / 0.341 / 0.452 | C-Top10 +0.183,事件分 +0.287 |
局限与改进
作者承认的局限:动作与状态的精确复现仍是最难一环,事件重拾中该项 0.688 低于 ReCA 的 0.700,说明系统能检索到正确的“发生过什么”,却无法精确重放动作本身;人评中背景一致性 3.62 和叙事连贯 3.77 明显低于剧本忠实度的 4.40,说明环境级一致性和整篇故事的连贯性尚未解决;效率上持久记忆降低了重试却没有降低总算力,吞吐反而下降约 15%。我的补充观察:其一,世界状态的坐标系由首个源观测建立,初始重建若有系统性偏差会波及全场景且难以自愈;其二,事件记忆按帧存 RGB-D 与动态点云,随故事变长存储与检索成本线性增长,论文未报告几十镜头以上的长篇压力测试;其三,事件重拾评测依赖 VLM 判分(源锚定协议),判分器自身偏差可能放大或掩盖方法差异;其四,Wan 2.7 上 VBench 落后 ReCA 提示强记忆约束可能挤压单镜头美学质量;其五,配准失败但已交付的镜头意味着成片与记忆会渐渐不一致,后续编译如何处理“这段没有记忆”并未说明。
独立分析的弱点
独立分析四个弱点。(1)计算开销:每故事多花约 13 分钟、吞吐降 15%,在大规模内容生产中代价可观。改进方向:对点云做增量更新与多分辨率压缩,缓存场景渲染结果按相机复用,把重建与配准异步化并与下一镜头生成重叠执行。(2)动作-状态复现弱:事件记忆只存帧级动态点云,没有可执行的运动模型,重演时动作时序靠生成器自由发挥。改进方向:为事件记录附加关键帧轨迹或光流约束,用轨迹/姿态条件信号引导重演,或在准入检查中加入动作一致性校验。(3)单源脆弱性:场景框架由首个源观测建立,若首镜头重建质量差,后续所有配准都会系统性偏移。改进方向:引入多视角一致性校验、在线束调整,或允许场景框架随高质量观测缓慢重锚定。(4)状态与成片漂移:配准失败但已交付的镜头造成“观众看到的世界”与“系统记忆的世界”分叉,长片中可能产生连贯性错觉破灭。改进方向:为无记忆片段生成显式的“不可回访”标记,并在编译时禁止产生指向它们的事件引用。
未来方向
作者在结论中提出 ATAS 可作为交互式电影制作、剧集内容创作和影视预可视化的基础,这是最直接的应用延伸。基于本文成果还可以延伸出多个方向:把世界状态从“生成时记忆”扩展为可编辑资产,让用户直接修改点云或事件记录后重新生成,形成人机协作的叙事编辑器;支持状态分支与回滚,从同一世界状态派生多个平行剧情版本,服务互动叙事与游戏;将事件记忆从帧级证据升级为持久的 4D 动态记忆,直接弥补动作-状态复现的短板;跨故事复用场景与角色资产,构建可积累的“世界库”;结合具身智能与游戏引擎,把 ATAS 的记忆接口作为世界模型的一部分用于可控环境仿真;以及在记忆侧引入不确定性度量,让准入检查 $a_t$ 从二值判断升级为置信度加权的软合并。
复现评估
代码在 GitHub(ziplab/ATAS)开源并有项目页演示,复现门槛中等。有利条件:方法与生成器解耦,接口只是“短镜头提示词+参考图”,用开源的 Wan 系模型即可跑通主体流程;评测所用 VBench、ST-Bench、ViStory 均为公开基准;消融实验把每个组件的增益拆得很清楚,便于逐模块验证。不利条件:主表中 MiniMax-H3 和 HappyHorse 1.0 属专有模型,Wan 2.7/3.0 的具体版本与提示词包需要完全对齐才能复现表中数字;方法依赖生成片段的深度估计、多帧重建与点云配准,论文引用了相关工作但未详述所用具体模型,重建质量直接决定配准通过率与最终效果;五个智能体基线(VGoT、Mora、MovieAgent、ReCA 等)需各自搭建;人评协议沿用 ReCA(Liu et al.)的六准则匿名流程,VLM 判分提示词若未完全公开会带来复现偏差。建议先用 Wan 加单场景两镜头的空间重访最小闭环验证,再逐步加入事件记忆与三重门控。
论文图表
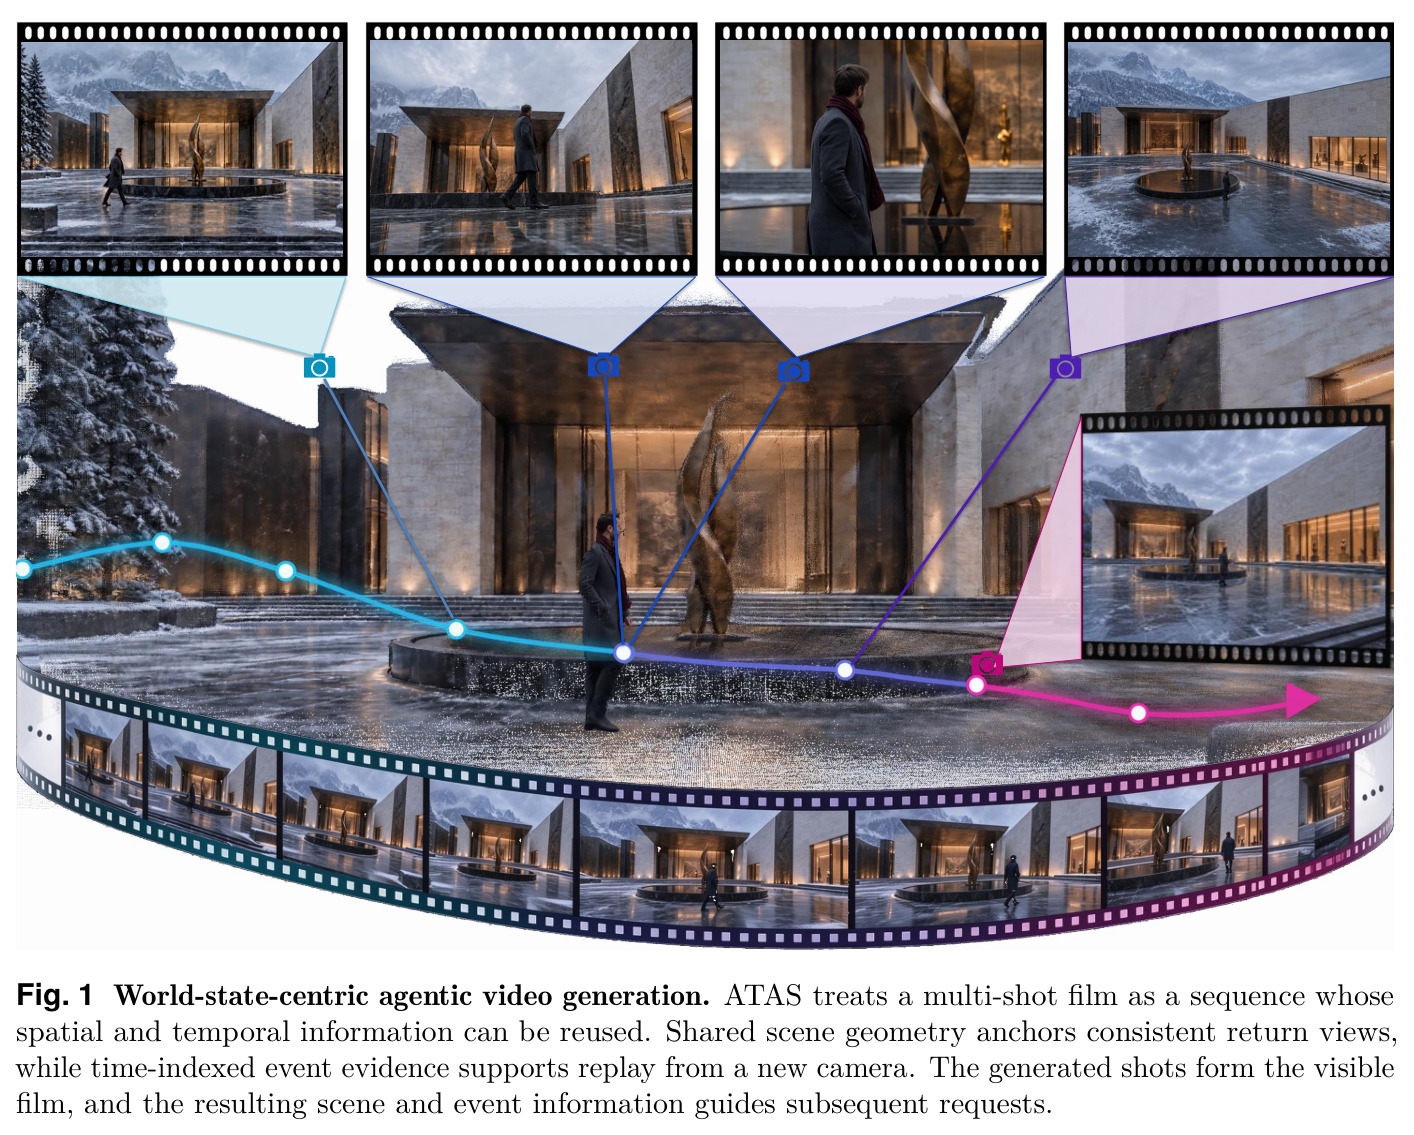
对比展示 ATAS 的核心思想:把多镜头影片视为空间与时间信息可复用的序列,共享场景几何锚定一致的回访视角,按时间索引的事件证据支持从新相机重演事件;生成的镜头构成可见成片,而产生的场景与事件信息反过来指导后续请求。
一图看懂“世界状态为中心”与“成片/记忆双轨”的总体思想,是理解全文定位的入口。
按 backbone 分块(MiniMax-H3、Wan 2.7、HappyHorse 1.0、Wan 3.0),对比六种方法在 VBench、ST-Bench、ViStory-Self/Cross 及聚合平均分上的表现,ATAS 在每个块内聚合分最高,Wan 3.0 达 0.734。
主实验表,支撑“增益来自持久状态而非渲染器”这一核心论断。
智能体方法与 3D 引导方法在共同可见掩码下与目标图比较的 PSNRC、SSIMC、LPIPSC,ATAS 以 15.968、0.385、0.284 全面领先,ViewCrafter 次之。
量化证明场景记忆让智能体框架在空间重访上超过专用 3D 引导方法。
五个准则(事件身份、动作状态、时间顺序、角色物体一致性、视角实现)下的源锚定事件重拾得分:ATAS 三项领先、一项并列、动作状态一项略低于 ReCA。
细分指标既展示事件记忆的强项,也明确暴露动作-状态复现这一短板。
固定 Wan 3.0 与相同请求、相机、候选预算和重试策略,从镜头渲染开始逐级叠加组件:ViStory 平均从 0.478 升到 0.670,C-Top10 从 0.528 到 0.719,事件分从 0.441 到 0.739,其中递归编译带来最大跳变。
拆解各组件贡献,显示事件分的跃升主要来自递归编译而非记忆本身。
六种记忆配置(无记忆、帧历史、静态场景、更新场景、场景+事件、全状态)下的 C-Top10、LPIPSC 与事件重拾分:从 0.536/0.341/0.452 逐级提升到 0.719/0.284/0.739。
回答“哪类记忆贡献什么”:静态场景主要压低 LPIPSC,事件记忆主要抬高事件分,验证与准入保住已有能力。