Video-RSI:通过执行框架演化递归自我改进的视频理解智能体 Video-RSI: Recursive Self-Improvement of Video Understanding Agents via Harness Evolution
冻结模型兼任求解器与编辑器,回看视频诊断失败、演化执行框架,准确率与帧数成本双优
前置知识
智能体执行框架(Harness)
包裹在 LLM 外的可执行程序层,包括提示词构建、工具实现(抽帧、OCR、转写检索)、观测处理、记忆管理与执行控制流。它决定智能体看什么证据、如何组织证据、何时继续调查或作答。模型权重不变时,仅修改 harness 代码就能显著改变智能体行为。
本文的改进对象不是模型权重而是 harness,所有演化操作都作用在这一层代码上,不理解这个概念就无法理解递归自我改进到底改的是什么。
递归自我改进(RSI)
系统利用自身运行产生的经验修改自己的程序并保留有效修改,形成迭代循环。代表工作有 STOP(自我修改的改进程序)、Darwin Gödel Machine(档案式探索)、Self-Harness(冻结模型回归测试式自改)。关键在三要素:谁来提出修改、用什么证据、按什么标准保留。
Video-RSI 是递归自我改进在视频理解上的实例:同一个冻结 LLM 既当求解器又当编辑器,读懂这三个要素才能理解其循环设计。
执行轨迹(Execution Trace)
智能体一次完整执行中记录的工具调用、观测内容与中间决策序列。它是事后诊断失败的原始材料,但只包含当前框架选择采集的证据,存在天然盲区——没被观测到的事件根本不会出现在轨迹里。
论文动机正是轨迹证据不足以区分失败原因,主动视频调查是对这一局限的直接回应,消融实验也证明仅用轨迹会显著削弱改进效果。
视觉成本(帧数指标)
以每次完整问答执行中所有成功视觉模型调用处理的帧数总和、再对问题取平均来度量观测开销。帧数直接对应视频 token 数量,是长视频场景下显存、延迟与 API 费用的主要来源,论文用它作为效率指标。
成本感知门控公式完全由帧数定义,主结果表与消融表的 Frames 列都是这个指标,不懂它就看不懂实验在衡量什么。
长视频问答基准
MLVU、Video-MME(long 切分)、LongVideoBench(long val)、EgoSchema 等多选题评测集,视频从数分钟到一小时不等,考察时序检索、细节感知与推理;本文另用 LVBench 的 216 题做演化训练、72 题做门控开发集。
全部主表与消融数字都建立在这些基准上,了解其多选题形式和长视频特点,才能准确解读准确率与帧数变化的含义。
研究动机
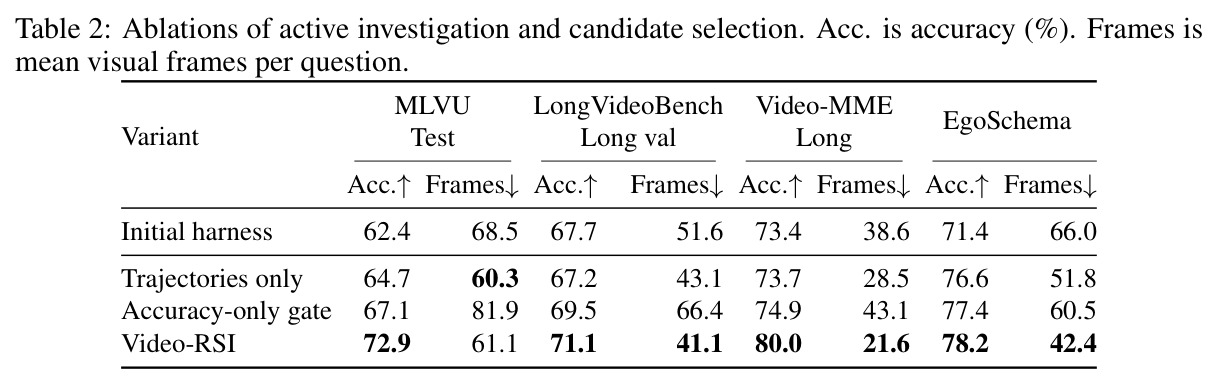
视频理解智能体(如 VideoAgent、VideoTree、VCA)靠可执行框架在长视频中决定看哪里、看多少、何时作答,但当答案出错时,唯一可用的诊断材料是当前框架产生的执行轨迹——而轨迹里只有框架选择去观测的内容。一次漏看的事件可能源于采样太稀疏(事件落在采样帧之间)、感知出错(看到了但看错)、或证据使用失败(看到了却没用上),三种解释对应完全不同的修改方向,仅凭轨迹无法区分。同时,加密采样这类修改虽然能提升单个问题的答案,却会在所有问题上抬高视觉成本。作者给出的具体数据:初始框架 $H_0$ 在 MLVU 上准确率仅 62.4%、每题平均处理 68.5 帧;若编辑器只看轨迹做修改(trajectory-only 变体),MLVU 准确率也只到 64.7%,20 轮里只接受 3 次修改,说明诊断证据不足严重限制了自我改进的空间。
本文的目标是本文的目标是让一个权重完全冻结的语言模型,把执行经验转化为可复用的代码改进:同时提升答案准确率、降低每题平均帧数(视觉成本)。这需要同时解决两个此前未被同时满足的问题:一是修改的证据——编辑器必须超越现有轨迹,主动回看原始训练视频,用新观测检验互相竞争的失败解释,形成有依据的诊断;二是保留的标准——演化需要明确的准入门槛,防止局部有用但整体变贵的修改被留下来。最终产物是一个在离线演化中打磨、随后冻结用于新问题的可执行框架 $H_T$,在 MLVU、LongVideoBench、Video-MME、EgoSchema 四个基准上实现准确率与帧数的同时改善。
与已有工作不同的是,已有工作分三类:视频智能体只在单个问题内自适应取证据,不跨问题积累改进;自动化智能体设计(ADAS、AFlow、Meta-Harness)把框架代码当作搜索空间,但不关注编辑器拿什么证据做决策;自我改进方法(STOP、Darwin Gödel Machine、Self-Harness)和最接近的 VideoHarness-RSI 虽然演化代码,但编辑器只能看到执行轨迹。本文的独特切入有两点:一是让编辑器在改代码之前回到案发现场——主动回看训练视频发起诊断式查询,通过变化时间区域、采样密度、模态(转写、屏幕文字)和感知问题,把漏看、看错、没用三种失败区分开,且感知请求不给标准答案以避免泄漏;二是在保留标准中同时约束准确率与视觉成本,允许有界成本换准确或有界精度换省帧,而非只看准确率。
核心方法
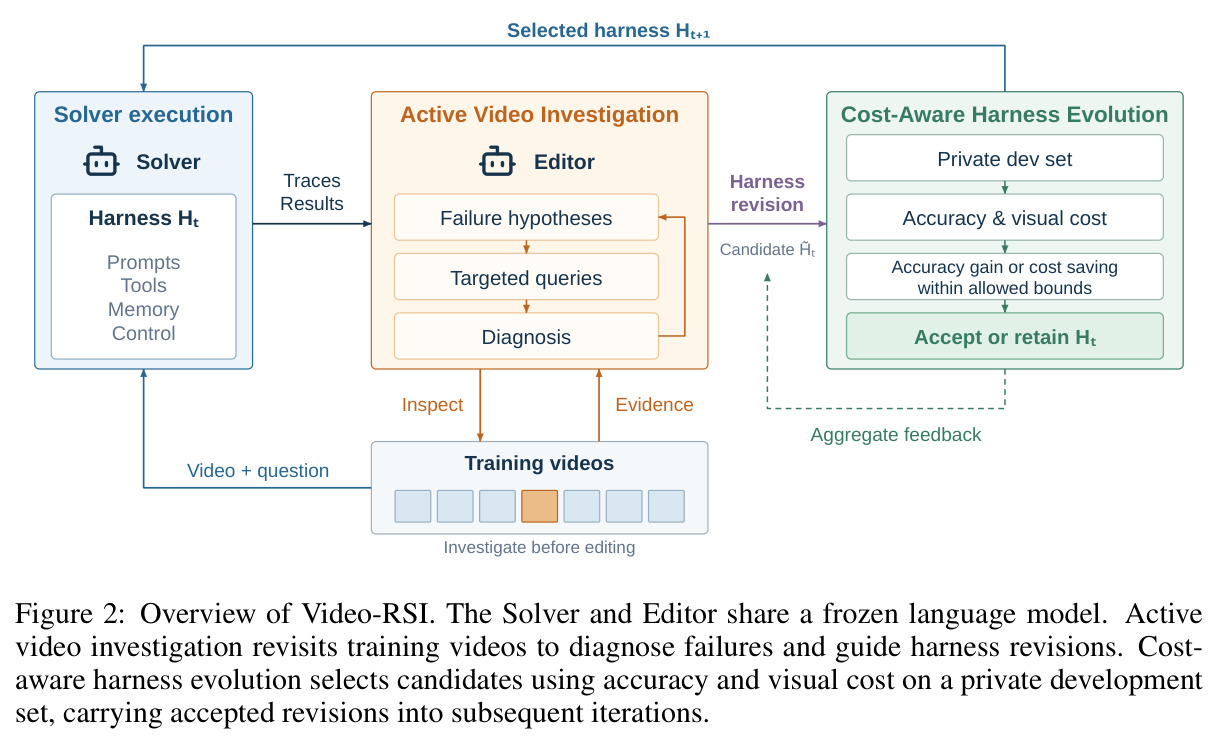
直觉上,Video-RSI 让答题的模型和改进答题程序的模型是同一个冻结 LLM,就像工程师调试自己的代码:复现失败、回看原始视频取证、形成诊断、修改代码,最后用一套兼顾准确率与成本的验收标准决定改动去留。技术上,框架 $H$ 决定求解器如何取用证据:$(\hat{y}, \tau, c) = \mathrm{Run}(H, V, q; M)$,输出答案、执行轨迹和资源记录。演化共 20 轮:求解器在 216 条 LVBench 训练问题上执行现任框架 $H_t$;编辑器检查轨迹并对训练视频发起诊断查询 $u_k = \mathrm{QueryEditor}(I_k)$、积累证据 $o_k = \mathrm{Investigate}(u_k; H_t, D_{tr}, M)$,形成修改假设后将 $H_t$ 编辑成候选 $\tilde{H}_t$;再在与训练视频不相交的 72 条私有开发集上对比候选与现任框架的准确率 $A_t$ 和平均帧数 $C_t$,按门控规则 $g_t$ 决定接受候选为 $H_{t+1}$ 还是保留 $H_t$。求解器与编辑器共用 DeepSeek-V4-Pro,视觉观测用 Qwen3.6-Plus,全程不动模型权重。
核心创新有两个。第一是主动视频调查(Active Video Investigation):执行轨迹只记录当前框架看到的证据,无法回答失败是因为没看到、还是看到了没用好。编辑器通过结构化诊断查询回到原始训练视频——加密采样检验事件是否落在采样帧之间、查语音转写或屏幕文字检验证据是否在别的模态、重跑未修改的现任框架做对照——每个查询都指定训练样例和要检验的解释,感知请求不提供金标准答案,避免信息泄漏,调查结束要么得到被证据支持的修改假设,要么标记为无法解决。第二是成本感知门控:设 $\Delta A_t = \tilde{A}_t - A_t$,候选必须在两个方向之一胜出——准确率提升且帧数不超过 $(1+\alpha)C_t$,或准确率下降不超过 $\epsilon$ 且帧数降到 $(1-\beta)C_t$ 以下。这与只看准确率的保留标准有本质区别:消融中 accuracy-only 门控在 MLVU 上把帧数推高到 81.9,而 Video-RSI 以 61.1 帧把准确率从 67.1 提到 72.9。
方法步骤详情
完整流程对应 Algorithm 1:第 1 步,初始框架 $H_0$(支持全局与局部视频检查、语音转写、OCR、观测记忆)在训练问题上执行,产出答案 $\hat{y}$、轨迹 $\tau$ 与资源记录 $c$。第 2 步,编辑器初始化调查上下文 $I_0$(当前代码、训练轨迹、可用标签、历史反馈),循环执行选择查询、获取证据、更新 $I_{k+1}$,并同步修订被支持的失败解释和遗留疑问,直到形成可复用的修改假设或无更有信息量的查询。第 3 步,把诊断映射为代码改动,覆盖提示构建、工具实现、观测处理、记忆与执行控制,一个可复用改动可能需要同时改工具输出和消费它的下游代码;先在训练侧行试跑调试候选。第 4 步,候选 $\tilde{H}_t$ 与 $H_t$ 在同一批 72 条开发题上、相同条件下重跑,评测器只向编辑器反馈聚合的准确率与帧数,单题门控轨迹保密。第 5 步,按 $g_t$($\alpha=0.1$、$\beta=0.2$、$\epsilon=1/|D_g|$,成本换准确分支最多容忍少答对 1 题)接受或保留,20 轮后返回最终框架 $H_T$ 冻结评测。
技术新颖性
技术新颖性分三层。对象层面:改进的可执行框架同时覆盖观测获取与证据使用(提示、工具、记忆、控制流),而多数视频智能体只调采样策略,多数自动化设计只搜工作流。证据层面:与 VideoHarness-RSI 只用历史轨迹和评分不同,本文证明改代码前回看视频是关键——消融显示主动调查把 MLVU 准确率从 64.7 提升到 72.9(+8.2 个百分点)而推理帧数相近(61.1 vs 60.3),接受的修改数从 3/20 提到 5/20;这一离线调查与部署时解耦,新问题仍只用自身输入。选择层面:把视觉成本写进准入判据,形成准确率-成本双目标门控,Video-MME 上帧数 21.6 约为 accuracy-only 变体 43.1 的一半且准确率更高。与需要训练的 FrameThinker、EVA-GRPO、EvoGround、Video-Zero 相比,全程不动权重,改进累积在可读代码里,演化产物可直接审计(如 HS2 结构化感知、HS4 关系图复用、HS5 事件计数工具)。
实验结果
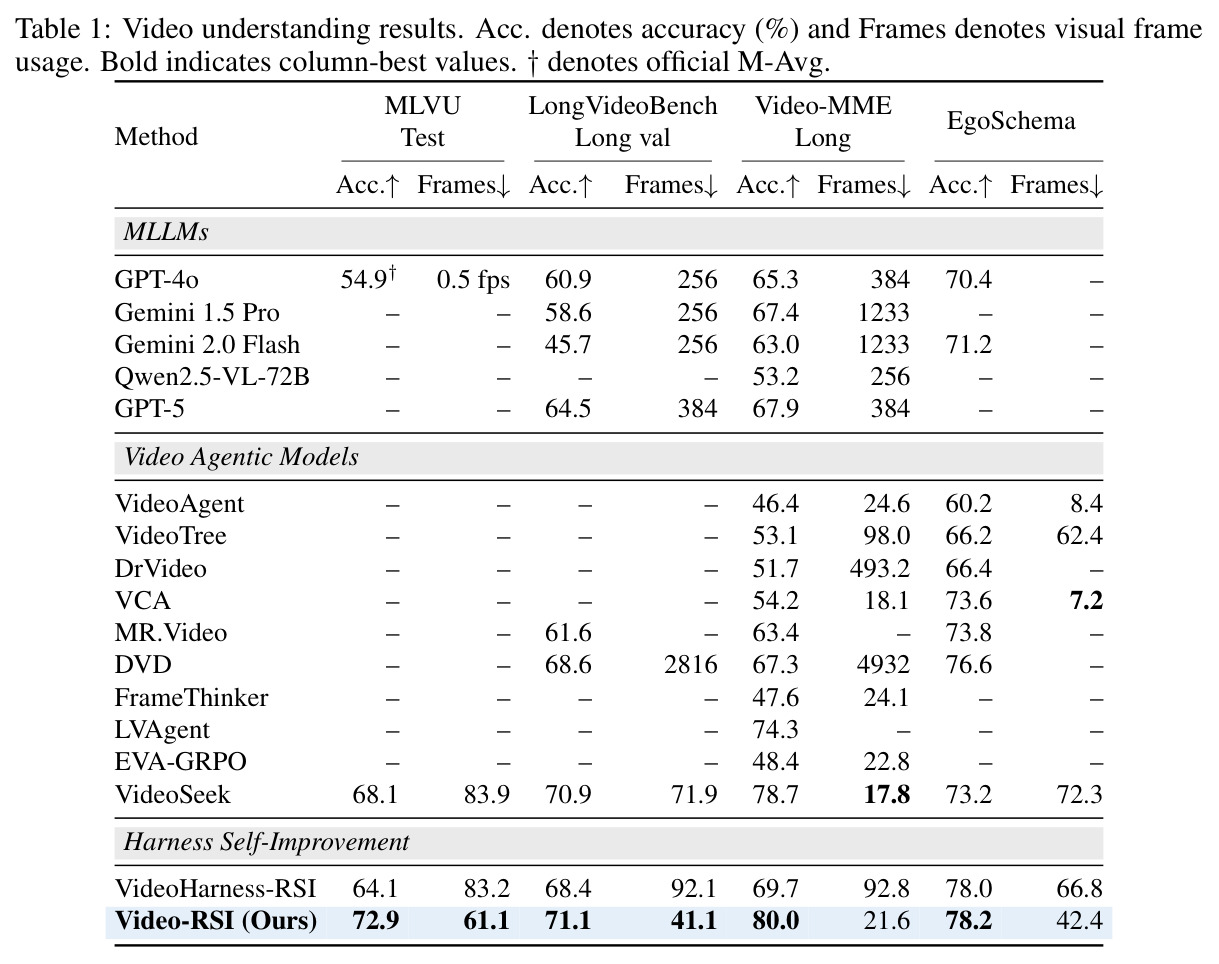
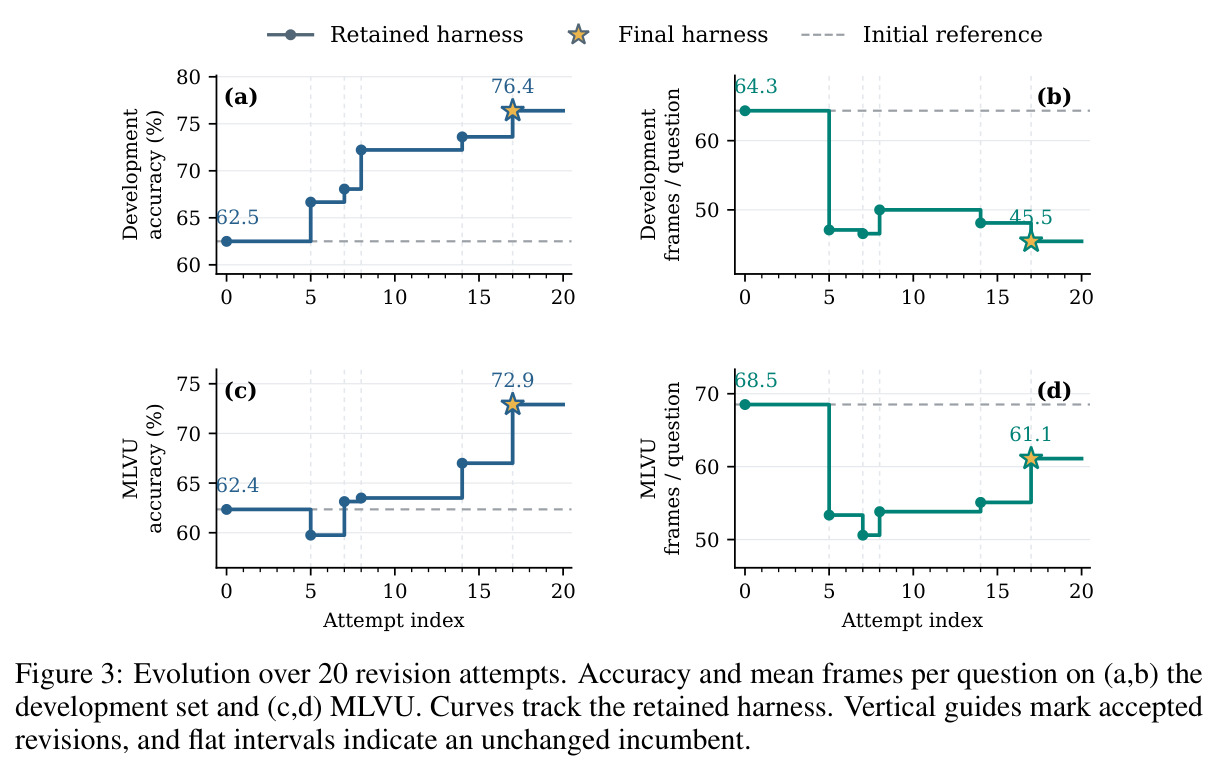
主结果(Table 1,DeepSeek-V4-Pro + Qwen3.6-Plus,LVBench 216 题演化、72 题门控、20 轮):对同模型复现的 VideoHarness-RSI 四个基准全面占优——MLVU 72.9% vs 64.1%(帧 61.1 vs 83.2)、LongVideoBench 71.1% vs 68.4%(41.1 vs 92.1)、Video-MME 80.0% vs 69.7%(21.6 vs 92.8)、EgoSchema 78.2% vs 78.0%(42.4 vs 66.8),准确率更高且帧数更少。对 VideoSeek:MLVU 准确率 +4.8 个百分点且省 27.2% 帧;EgoSchema 双优(78.2 vs 73.2、42.4 vs 72.3);Video-MME 准确率 80.0 vs 78.7 但帧数 21.6 vs 17.8 略增,说明优势是准确率-成本的平衡而非一律省帧。消融(Table 2):仅轨迹修订 MLVU 只有 64.7,accuracy-only 门控 67.1/81.9 帧,完整方法 72.9/61.1——主动调查贡献 +8.2 个百分点,成本门控负责省帧,Video-MME 帧数约为其一半(21.6 vs 43.1)。Figure 3 显示第一次接受的修订贡献了大部分省帧,MLVU 上首次接受曾短暂降低准确率、随后恢复并由最后两次接受贡献主要涨幅。最终框架较初始 $H_0$(MLVU 62.4/68.5、LVB 67.7/51.6、VME 73.4/38.6、Ego 71.4/66.0)帧数下降 10.8%–44.1%、准确率提升 3.4–10.5 个百分点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MLVU test 长视频多选问答 | 准确率 (%) | 72.9 | VideoHarness-RSI 64.1 / VideoSeek 68.1 | +8.8 / +4.8 个百分点,且帧数 61.1 比 VideoSeek 的 83.9 少 27.2% |
| Video-MME (long) 多选问答 | 准确率 (%) | 80.0 | VideoHarness-RSI 69.7 / VideoSeek 78.7 | +10.3 / +1.3 个百分点(帧数 21.6 vs 92.8,仅对 VideoSeek 略增至 17.8) |
| LongVideoBench (long val) 多选问答 | 准确率 (%) | 71.1 | VideoHarness-RSI 68.4 / VideoSeek 70.9 | +2.7 / +0.2 个百分点,帧数 41.1 接近两个基线(92.1 / 71.9)的一半 |
| EgoSchema 官方公开子集 | 准确率 (%) | 78.2 | VideoHarness-RSI 78.0 / VideoSeek 73.2 | +0.2 / +5.0 个百分点,帧数 42.4 同时低于 66.8 和 72.3 |
| MLVU test 长视频多选问答 | 平均视觉帧数/题 | 61.1 | 初始框架 H0 68.5 | -10.8%,同时准确率 +10.5 个百分点 |
| Video-MME (long) 多选问答 | 平均视觉帧数/题 | 21.6 | accuracy-only 门控变体 43.1 | 约减半,且准确率更高(80.0 vs 74.9) |
局限与改进
作者承认并可观察到的局限:演化只有 20 次尝试、门控集仅 72 题,$\epsilon=1/|D_g|$ 意味着成本换准确分支最多容忍少答对 1 题,小样本噪声可能让接受或拒绝带偶然性;Figure 3 显示第一次接受的修改虽改善开发集两项指标,却短暂降低 MLVU 准确率,说明门控集上的提升并不保证逐步迁移。评测局限于多选题基准,未覆盖开放式生成与时间定位任务;视觉成本只统计成功视觉调用处理的帧数,不计入 LLM token、调用次数与离线调查本身的计算开销,作者明确说明报告的节省只衡量视觉帧而非总计算量。调查阶段允许使用训练集标注定位信息区间,演化带有监督信号。结果依赖特定商用模型(DeepSeek-V4-Pro、Qwen3.6-Plus),跨模型、跨域泛化未验证;基线中多数数字引自原论文,采样配置不同(如 GPT-4o 为 0.5fps),横向可比性有限,只有两个基线是同模型复现。
独立分析的弱点
第一,门控集太小:72 题上 $\epsilon$ 只容忍 1 题的准确率波动,统计功效低,容易把噪声当信号,一次侥幸的帧数下降就可能挤掉一次真实的准确率改进——改进方向是扩大开发集、用 bootstrap 置信区间或序贯显著性检验替代固定阈值。第二,演化依赖监督信息:调查上下文含训练集标签,标注还用于定位信息区间,迁移到无标注新域时诊断质量会打折——改进方向是用多次采样一致性、自洽性投票等自监督信号替代金标准。第三,计算开销不透明:每轮要在训练集跑现任框架、回看视频调查、再在开发集跑候选,20 轮的 API 成本可观,论文未报告总 token 或费用——改进方向是按代表性筛选失败案例、建立跨轮共享的证据缓存库。第四,成本维度单一:Global-64 这类修改可能增加延迟而不增加帧数,分辨率变化也不反映在帧数里——改进方向是把延迟、token 数、分辨率纳入多维成本向量,沿帕累托前沿做选择。第五,框架演化是单点贪心,每轮只保留一个现任,可能陷入局部最优——可引入档案式种群避免早期接受锁死搜索方向。
未来方向
作者方向:将框架演化扩展到更多任务形态(时间定位、开放式问答)、分析不同类型调查查询的贡献分布、检验演化产物跨域冻结迁移的能力。基于成果可延伸的方向:其一,把演化出的可读机制(HS2 结构化感知、HS4 关系图证据复用、HS5 事件计数工具)蒸馏进模型权重,形成代码演化与训练混合的改进路径;其二,引入 Darwin Gödel Machine 式档案与种群,维护多个候选框架并行演化,缓解单点贪心的局部最优;其三,把同一套调查-诊断-修订机制搬到推理时在线进行,让部署后的智能体对失败案例做轻量即时修正;其四,把成本门控推广为多维目标(延迟、token、分辨率、API 费用)的帕累托选择;其五,研究编辑器诊断的可靠性度量,检测因调查证据不足而产生的错误归因;其六,与 EVA、FrameThinker 等通过强化学习训练观测策略的方法结合,让权重训练与代码演化互为补充。
复现评估
代码已在 GitHub 开源(github.com/bingjunluo/Video-RSI)。数据全部公开:评测用 Video-MME long、LongVideoBench long val、EgoSchema 官方公开子集、MLVU test;演化用 LVBench 的 216+72 题。但求解器与编辑器依赖 DeepSeek-V4-Pro、视觉观测依赖 Qwen3.6-Plus 这类商用大模型 API,复现需要相应预算:20 轮演化每轮包含训练集执行、视频回看调查、开发集候选评测,视觉帧处理与长上下文调用是主要开销,总成本估计中等偏上,论文未给出具体费用。有利因素是主表、消融、超参($\alpha=0.1$、$\beta=0.2$、$\epsilon=1/72$)与门控公式都完整给出,代码层演化产物(HS2–HS5)有文字描述,工程复现难度中等;不利因素是 API 模型版本迭代可能导致行为漂移、开发集单题门控轨迹保密导致部分中间证据无法核对。
论文图表
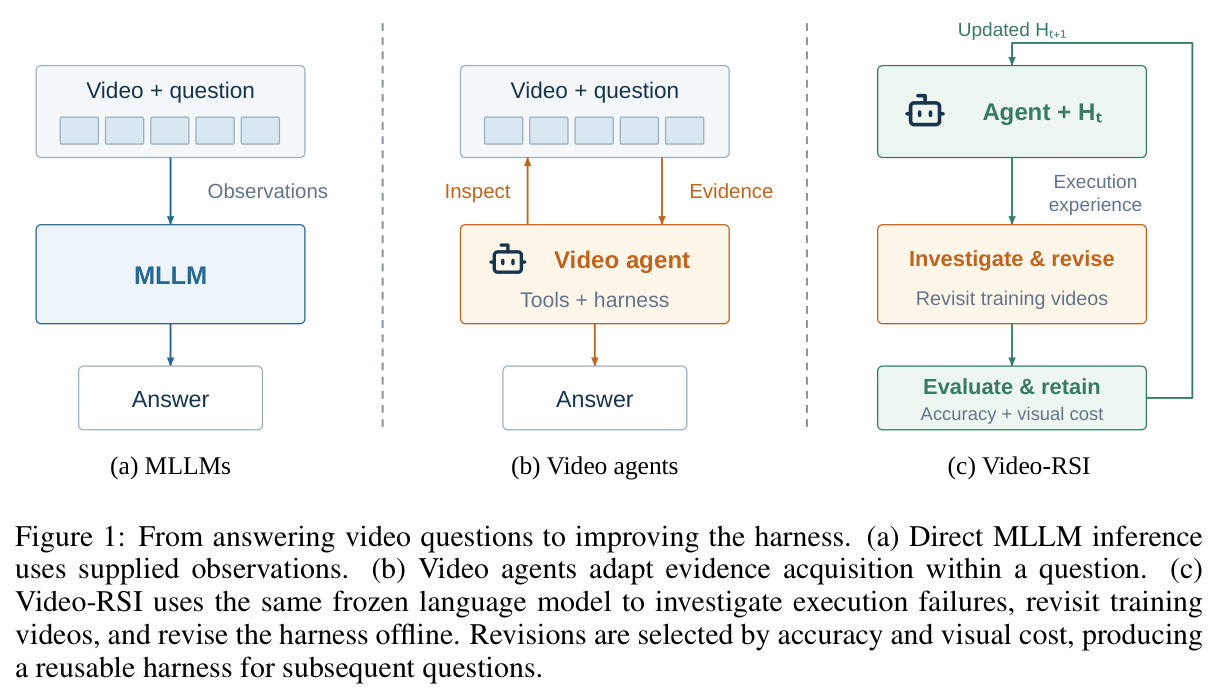
三栏对比图:(a) MLLM 直接推理只使用给定观测作答;(b) 视频智能体在单个问题内自适应地采集证据(观察-检查-证据循环);(c) Video-RSI 用同一个冻结语言模型调查执行失败、回看训练视频、离线修订 harness,修订由准确率与视觉成本共同筛选,产出可复用的 harness 用于后续问题。
这张图一图定位了论文的问题层级:MLLM 答题、智能体题内取证、Video-RSI 跨题改程序,三层递进直观说明了 harness 自我改进与题内自适应取证据的本质区别,是理解全文动机的入口。
伪代码描述完整演化流程:对每轮 $t$,执行 $H_t$ 并检查轨迹;初始化调查上下文 $I_0$ 后循环选择区分失败解释的查询、用式 (2) 获取证据更新 $I_{k+1}$;综合诊断并规划可复用行为修改;编辑 $H_t$ 为候选 $\tilde{H}_t$ 并做训练侧检查;在 $D_g$ 上验证对比,按式 (3) 接受或保留;返回最终框架 $H_T$。
伪代码是复现的直接蓝本,把 3.3 节的调查循环与 3.4 节的选择门控串成可执行的迭代骨架,明确了每步的输入输出与终止条件。