视觉语言模型的 3D 推理失败定位:BedBench 基准 Where Do Vision Language Models Fail at 3D Reasoning?
BedBench 定位 VLM 3D 推理失败点:单项判断正确,精确答案与一致性却失败
前置知识
视觉语言模型(VLM)
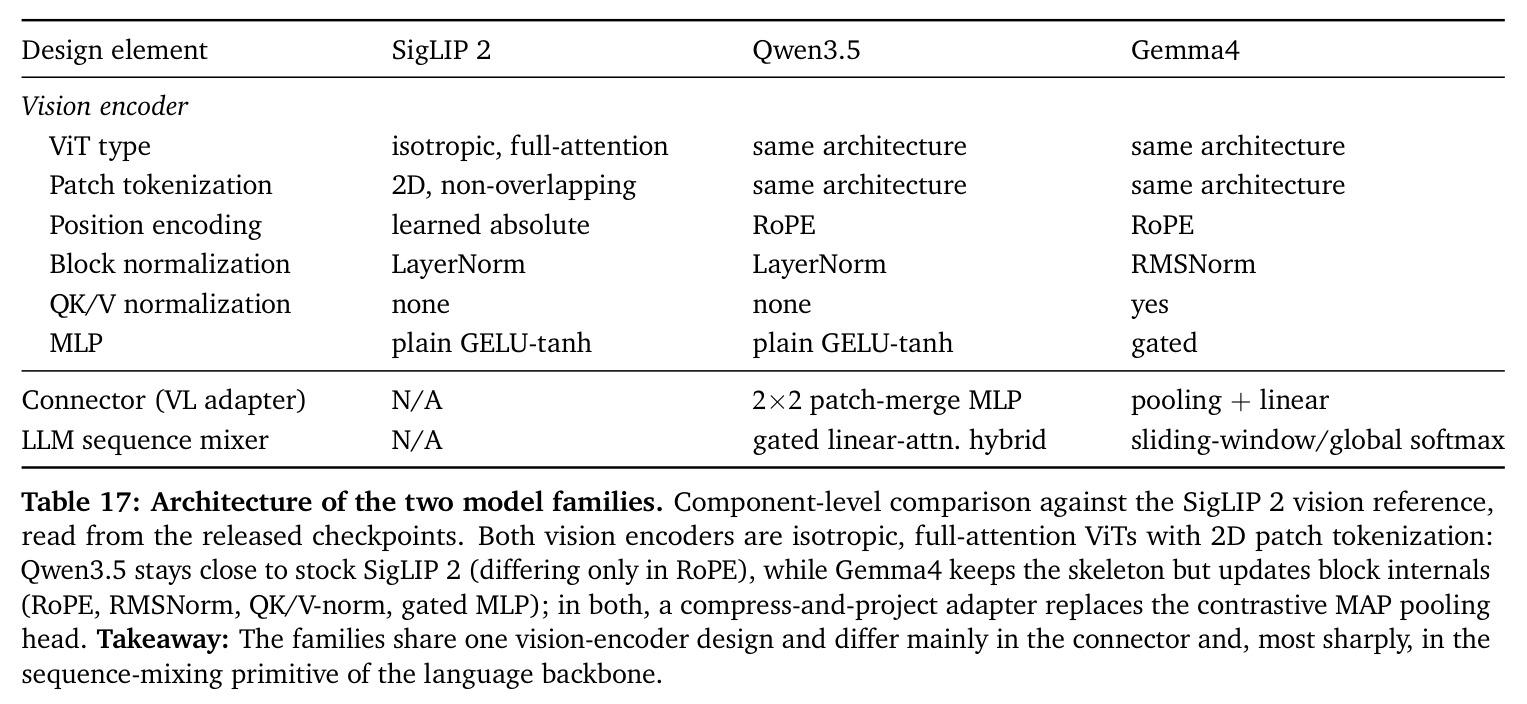
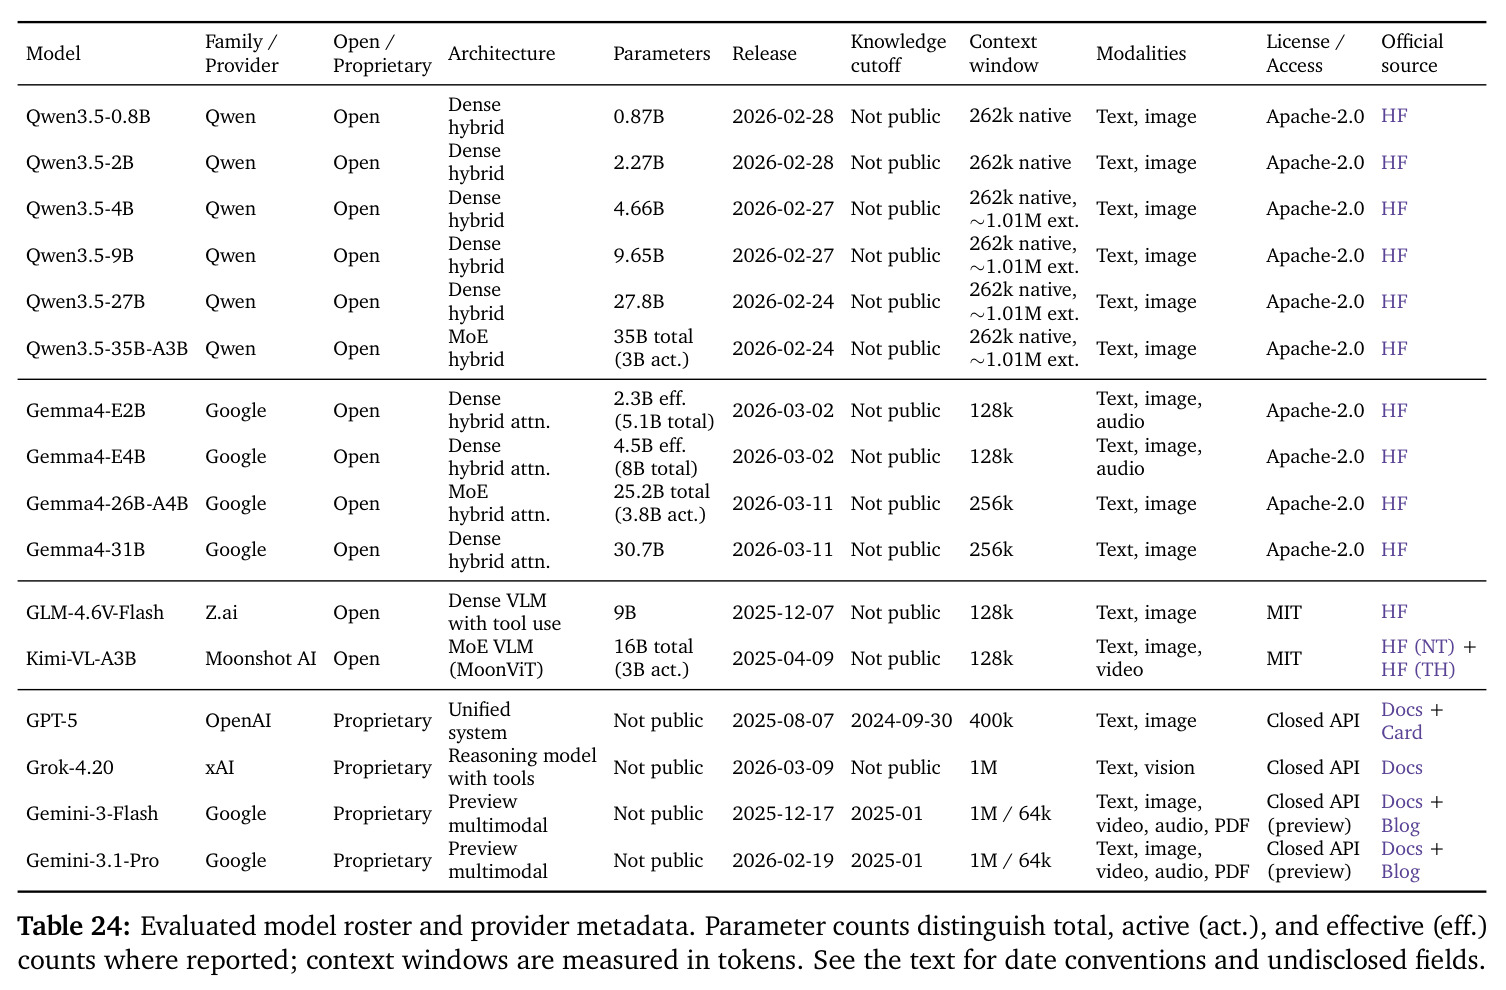
由视觉编码器(如 SigLIP-2 系)把图像切成 patch 编码,经连接器投影为视觉 token,再与大语言模型联合处理的多模态架构。VLM 依靠语言模型对视觉与文本 token 的联合推理来回答问题,但它「感知到的信息」与「能说出、用上的信息」可能脱节。本文评估了 12 个开源权重模型(Qwen3.5、Gemma4、GLM-4.6V-Flash、Kimi-VL-A3B,含稠密与 MoE)和 4 个前沿模型(GPT-5、Grok-4.20、Gemini-3-Flash/3.1-Pro)。
论文的核心论点是这类模型在 3D 任务上「信息在、却不会用」,必须先理解视觉-语言两段式结构,才能读懂其失败层次定位分析。
体素物体与程序化生成
体素(voxel)物体是由单位立方体拼成的 3D 形状。BedBench 每个物体由 10–15 个连通方块程序化生成,从两个相对视角渲染,颜色取自 12 色调色板(4–12 色,按相似亮度分成 6 对色相)。程序化生成可提供精确真值、无限扩充样本,并能在生成期过滤歧义样本:若某方块删除后两个剪影几乎不变(IoU $\geq 0.9998$)即拒绝该物体。
正因为物体与真值完全可控,论文才能在同一批物体上做链式诊断(逐色计数→主色→一致性)、重渲染对照和探针实验,这是自然图像数据集做不到的。
冻结特征探针
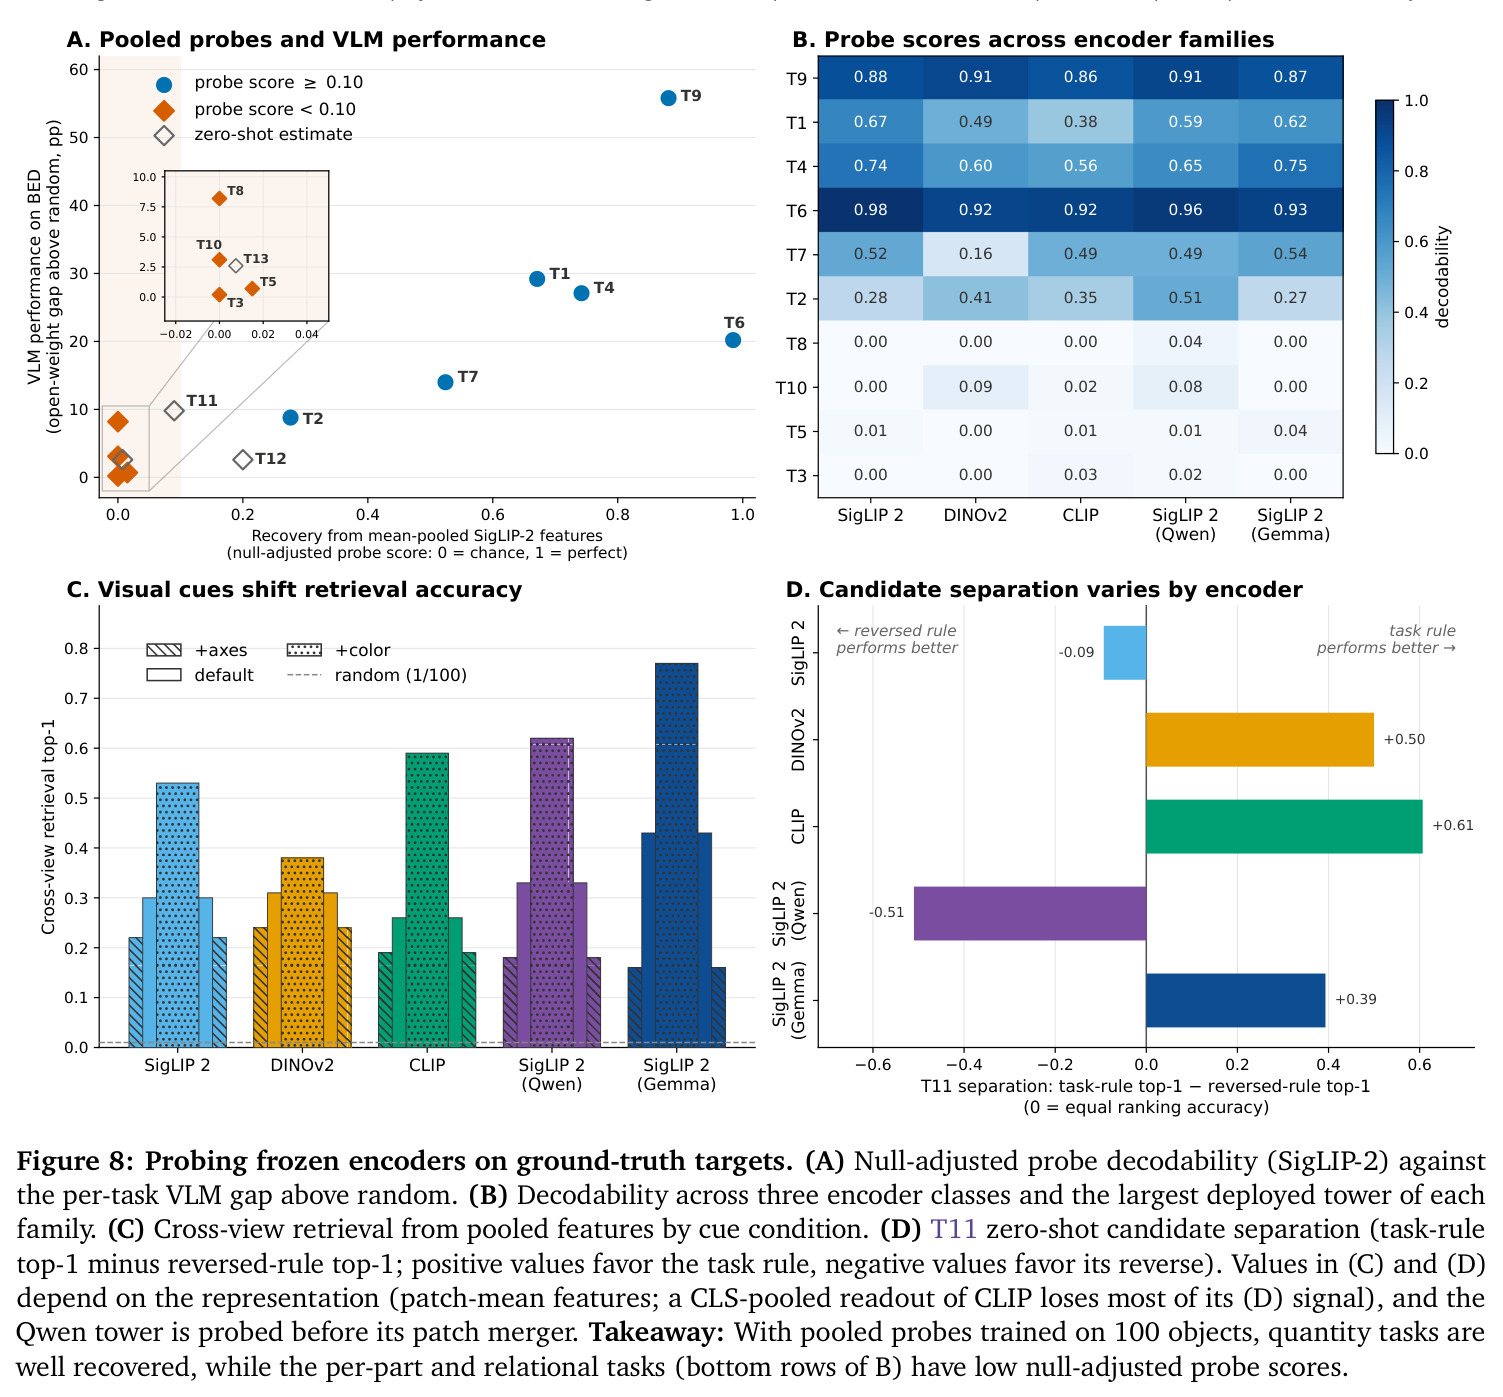
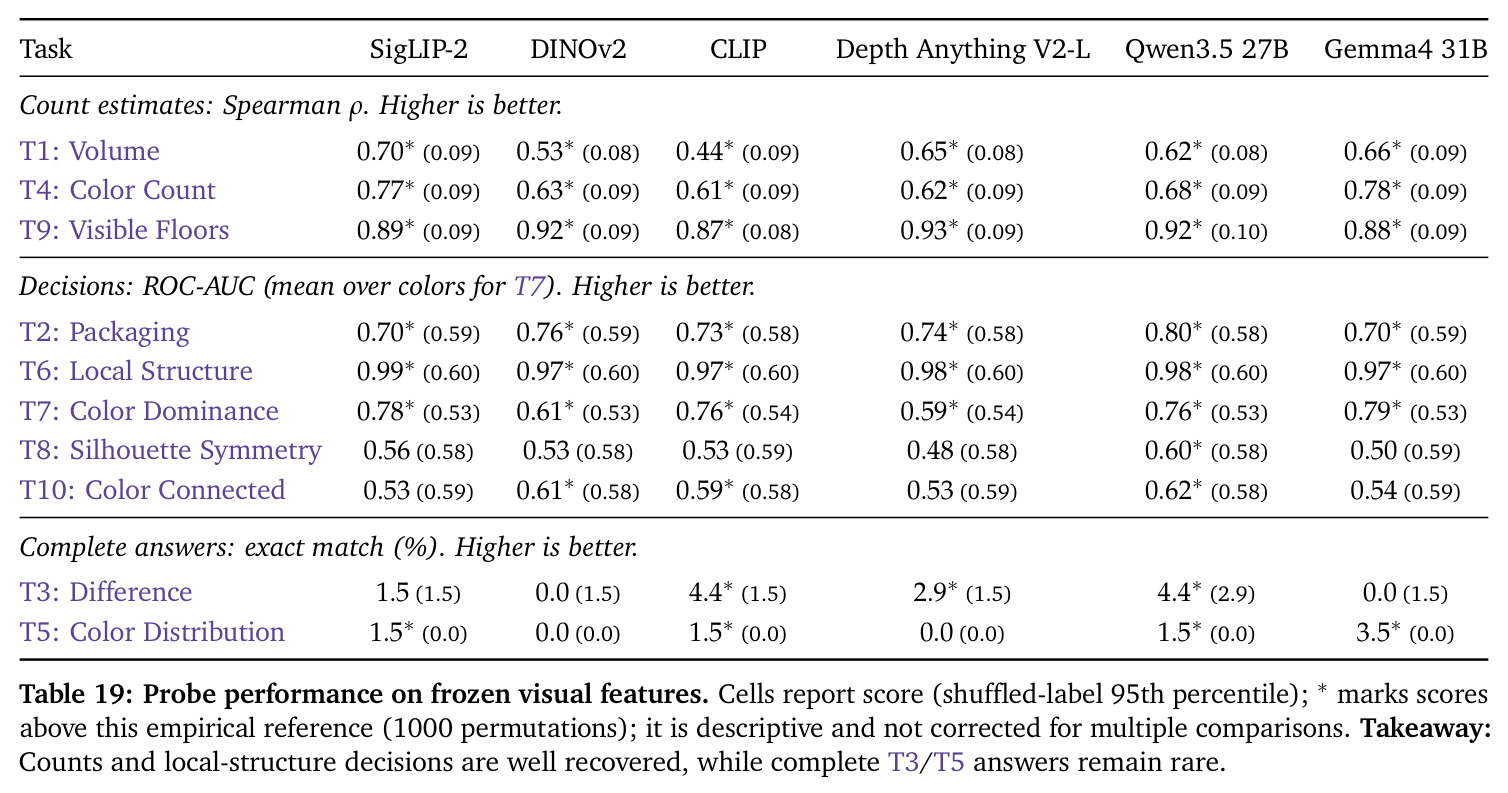
冻结视觉编码器,只训练一个轻量读出头(线性探针或注意力读出)从其特征预测某目标(如每色方块数),并用按物体分组的五折交叉验证防止同一物体跨训练/测试折叠泄漏。若探针能从特征恢复目标而 VLM 行为不能,说明信息已编码但语言模型未利用;与打乱标签的对照比较可排除虚假相关。
这是论文定位失败层次的关键工具——用来区分「视觉特征里根本没有」与「特征里有但语言模型不会用」这两种失败。
LoRA 微调
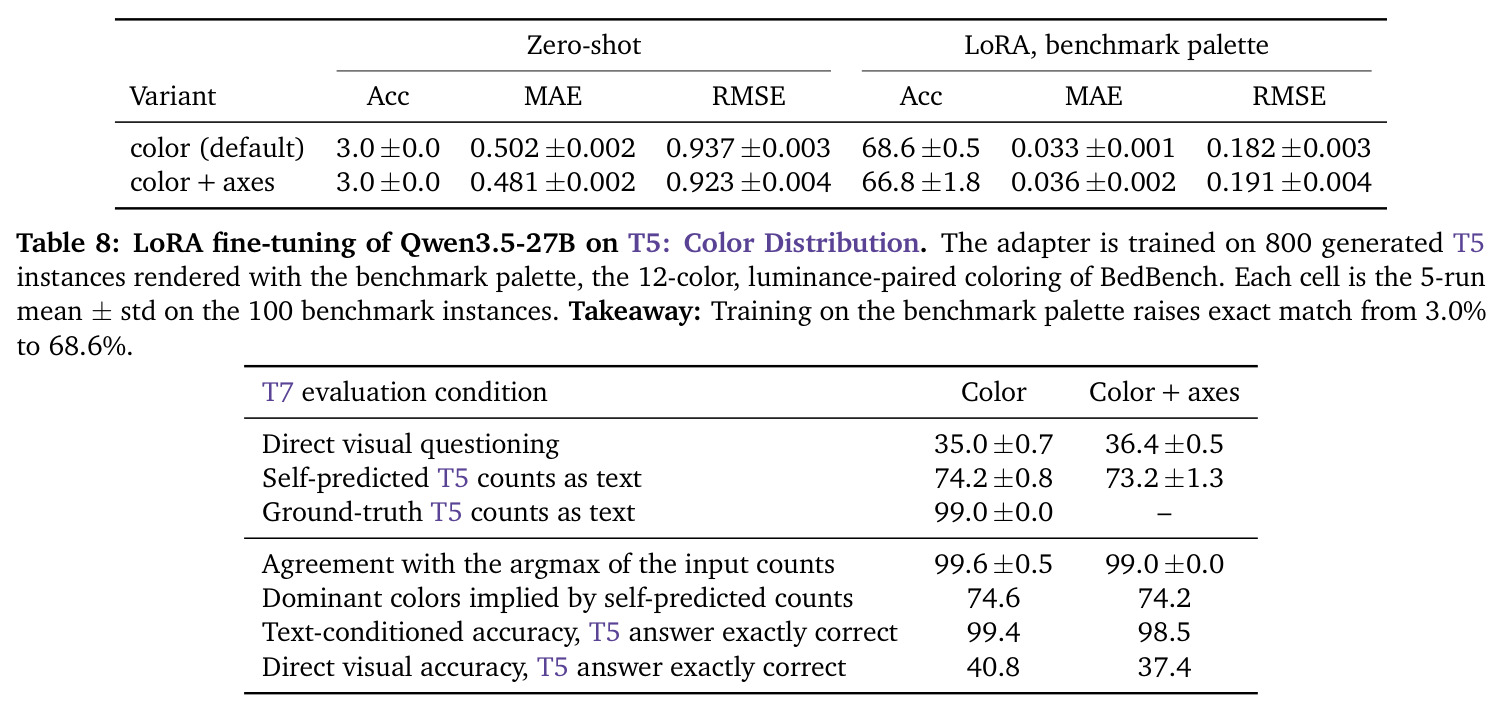
低秩适配微调:冻结原有权重,只训练注入到权重中的低秩矩阵,即 $\Delta W = BA$,其中 $B\in\mathbb{R}^{d\times r}$、$A\in\mathbb{R}^{r\times k}$、秩 $r\ll d$,训练成本远低于全参数微调。本文仅微调 Qwen3.5-27B 的语言模型,视觉编码器与连接器全部冻结,训练数据为 800 个分布内的 T5 逐色计数样本。
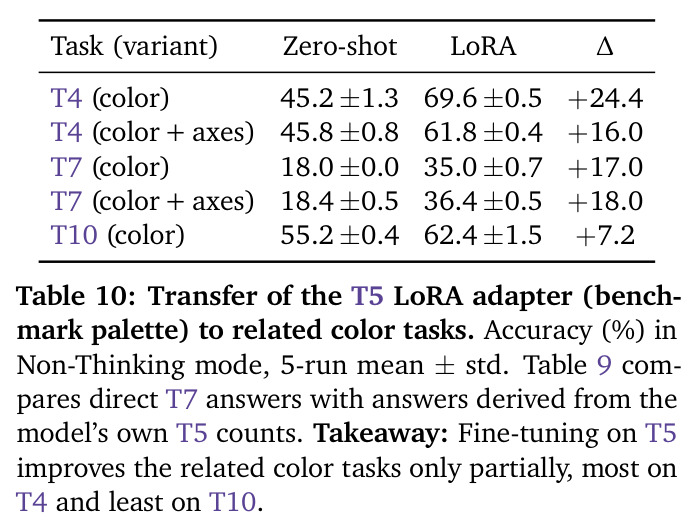
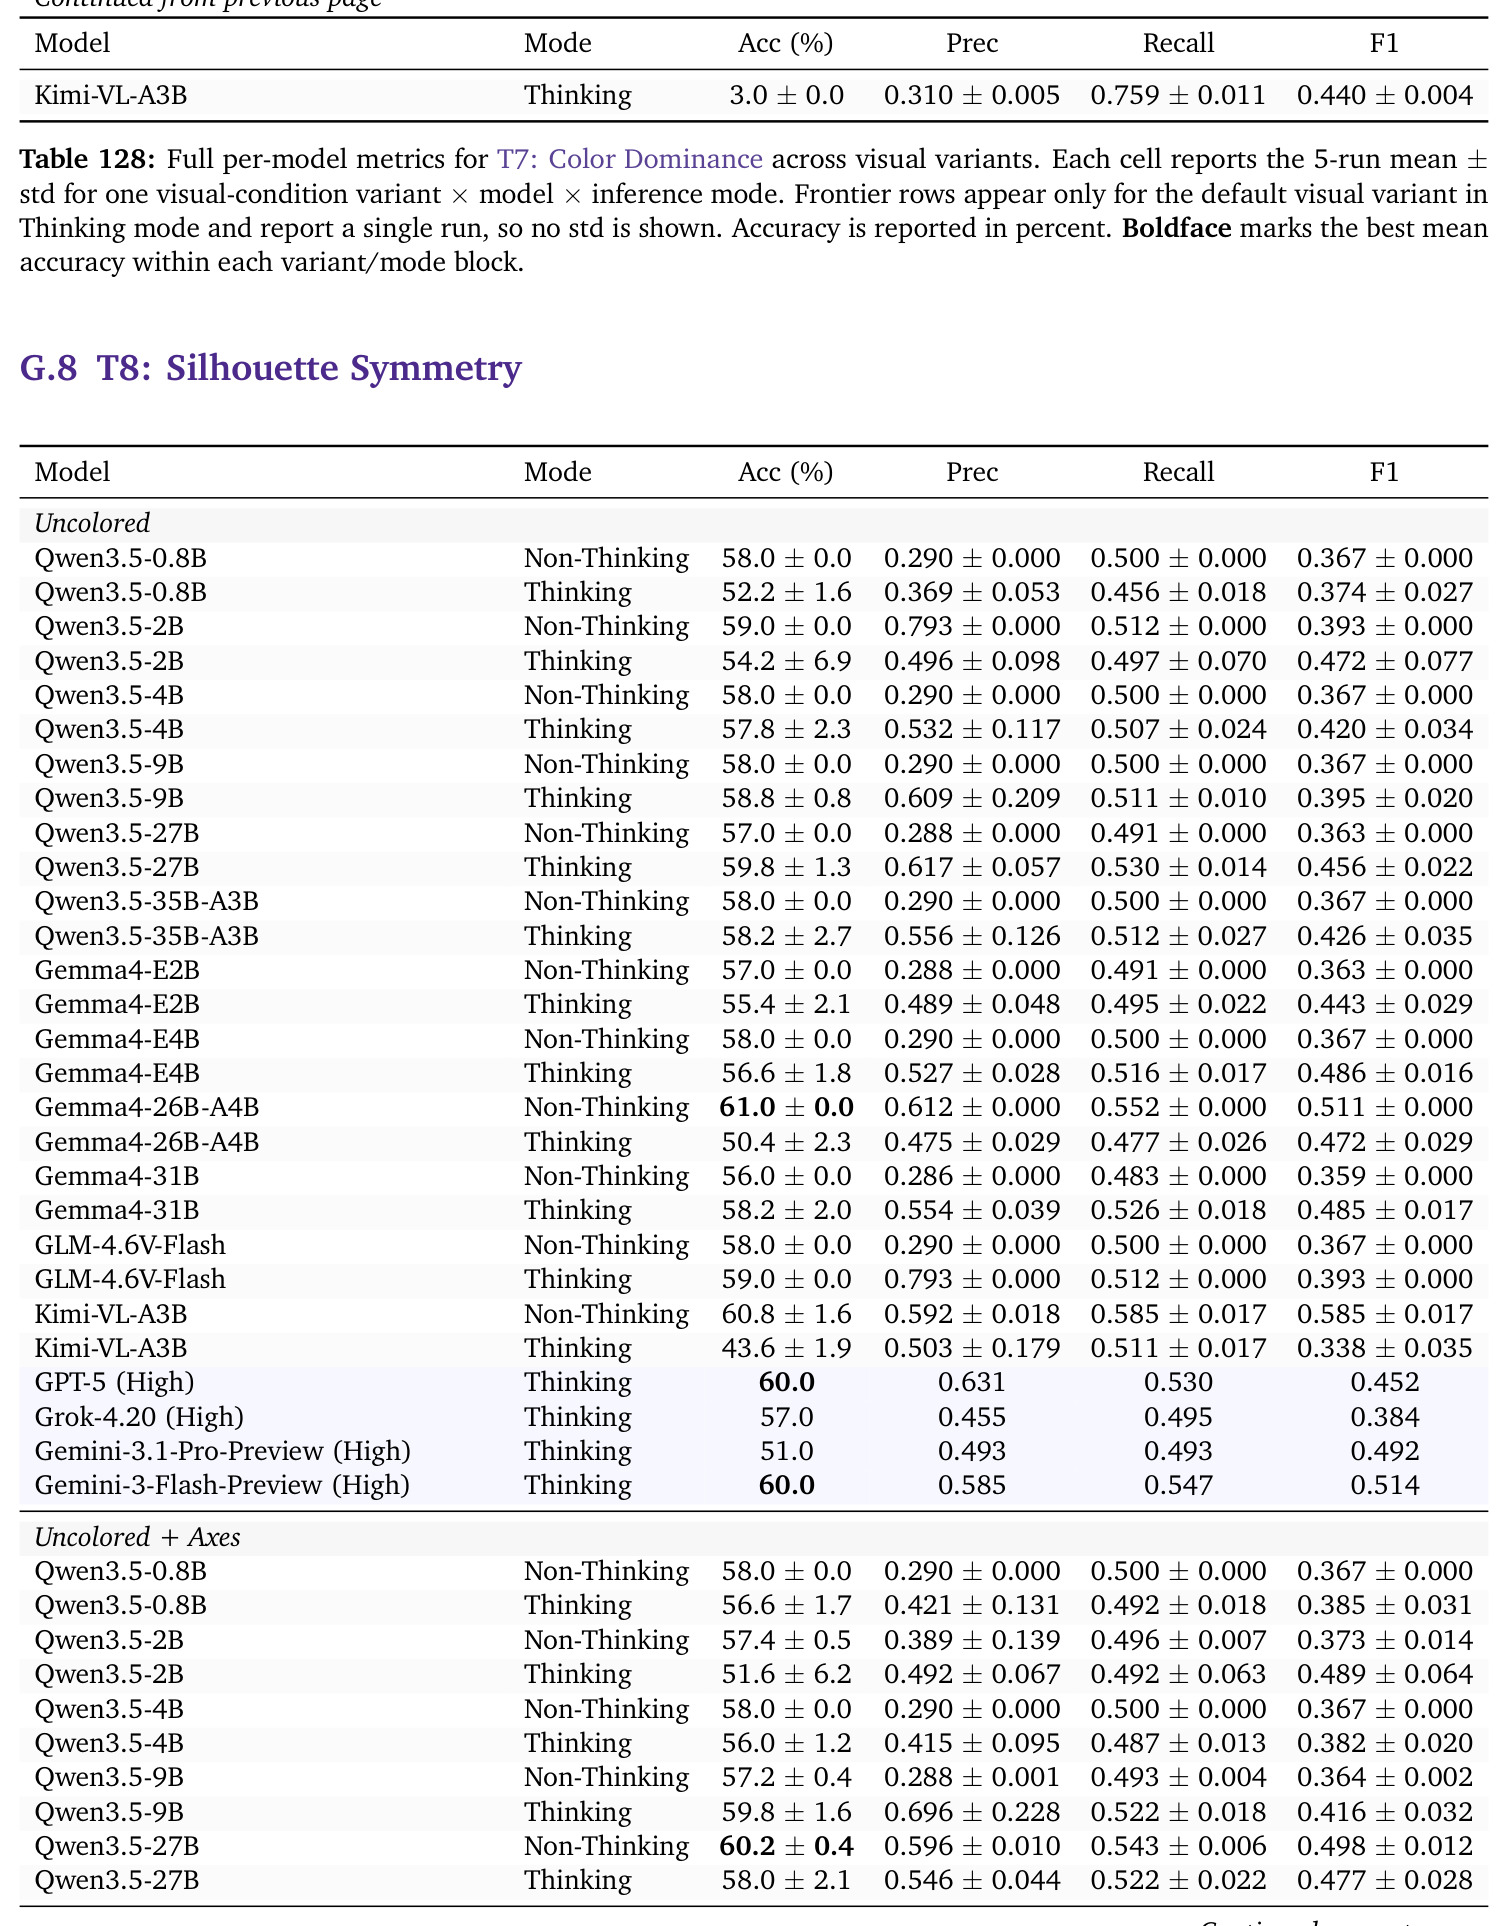
微调把 T5 从 3.0% 提到 68.6%,但模型看图答主色问题(T7)仍差——这是「精确计数可学、一致使用未必随之而来」这一核心发现的直接证据。
精确匹配(EM)与一致性检验
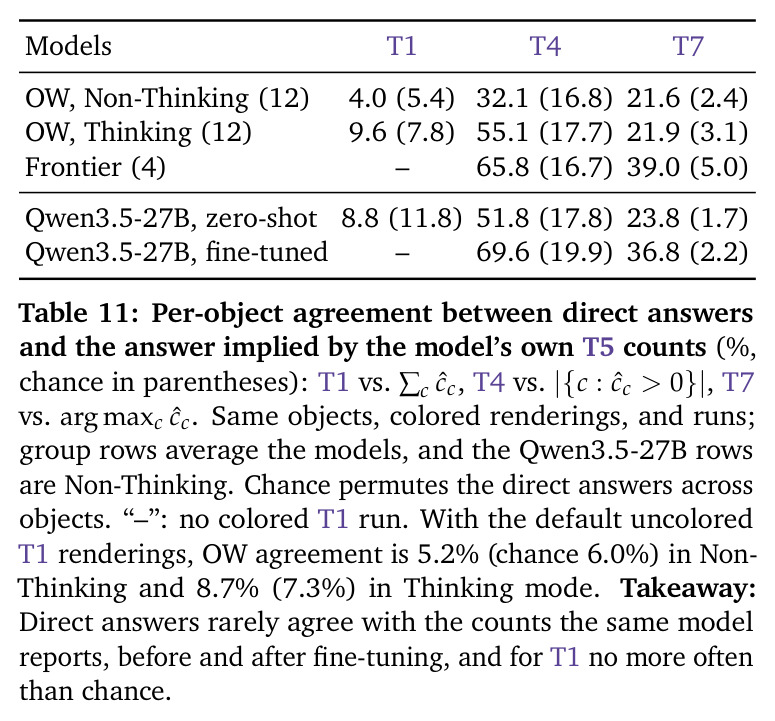
EM 要求答案所有字段同时正确才算对:例如 T5 要求 12 个颜色的计数向量整体吻合,$\hat{\mathbf{n}}=\mathbf{n}$;辅助指标包括平均绝对误差 $\mathrm{MAE}=\frac{1}{12}\sum_c |\hat{n}_c - n_c|$ 和二元任务的 F1。一致性检验则问:模型对 T7(哪些颜色最多)的回答,是否与自己 T5 计数推出的结论吻合——因为计数向量在逻辑上唯一决定主色答案。
论文主张 3D 评测应同时报告精确答案误差、相关答案一致性与图像依赖,而非单一准确率;理解这套指标体系才能理解其四条结论。
研究动机
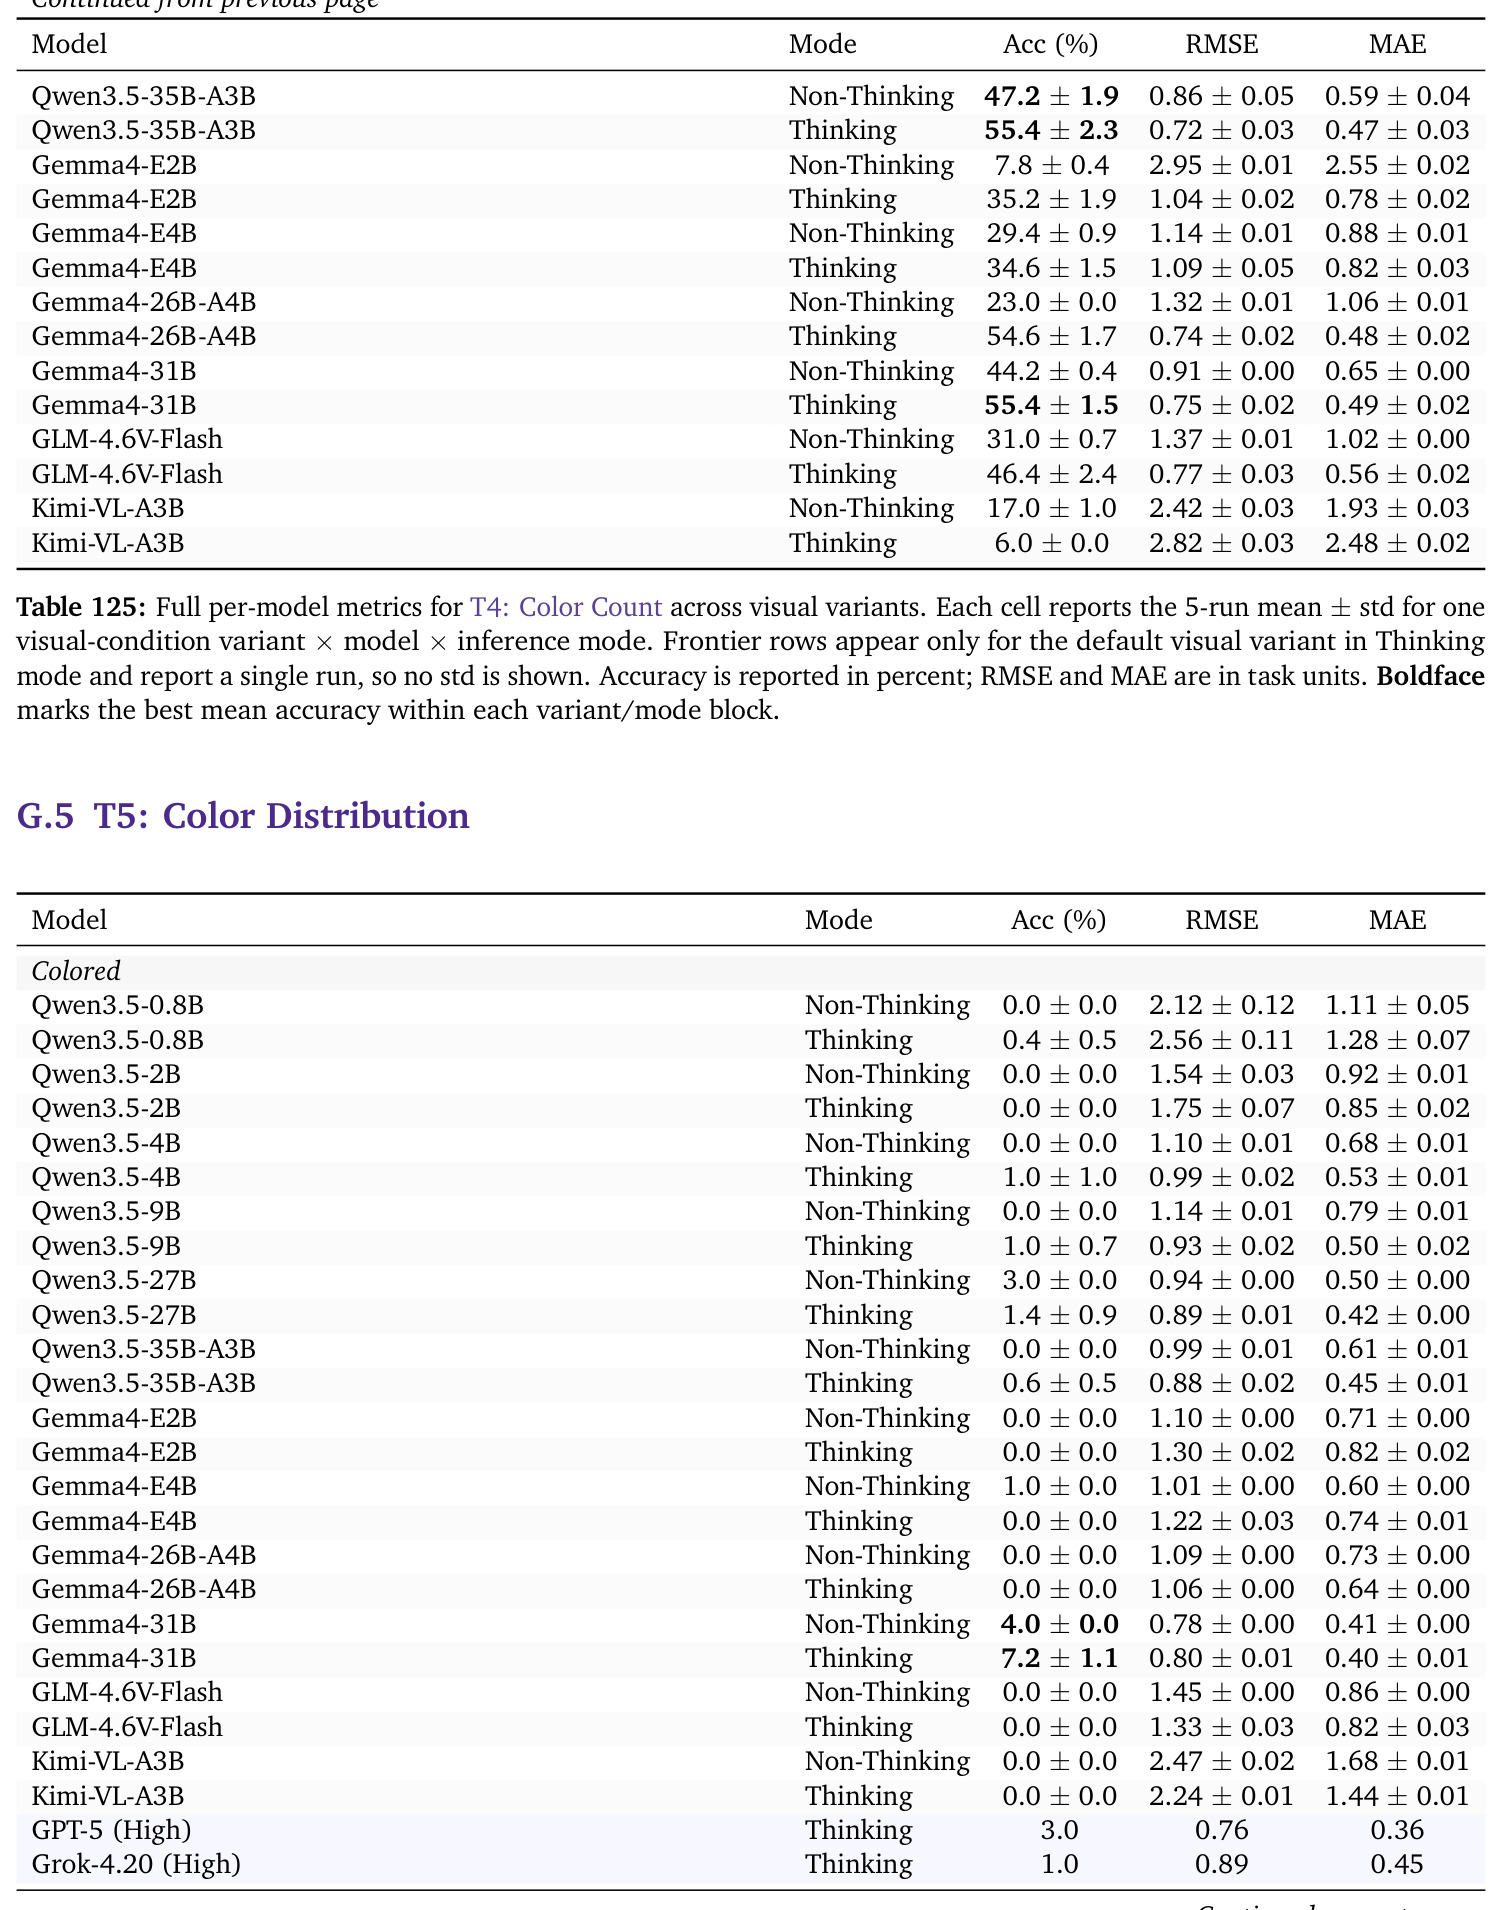
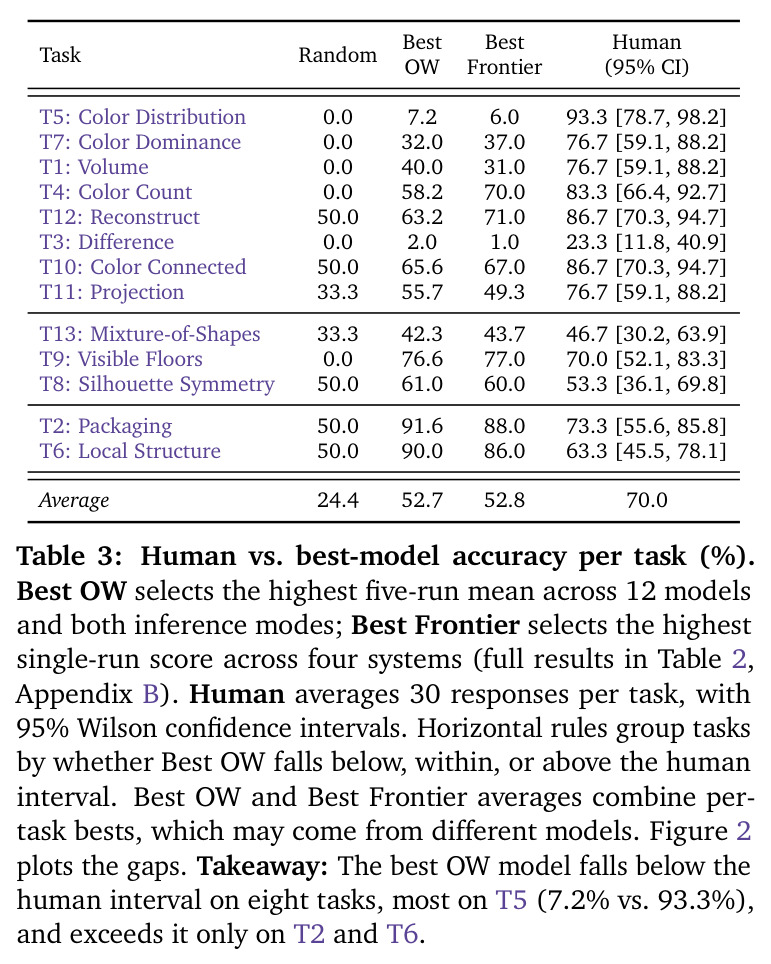
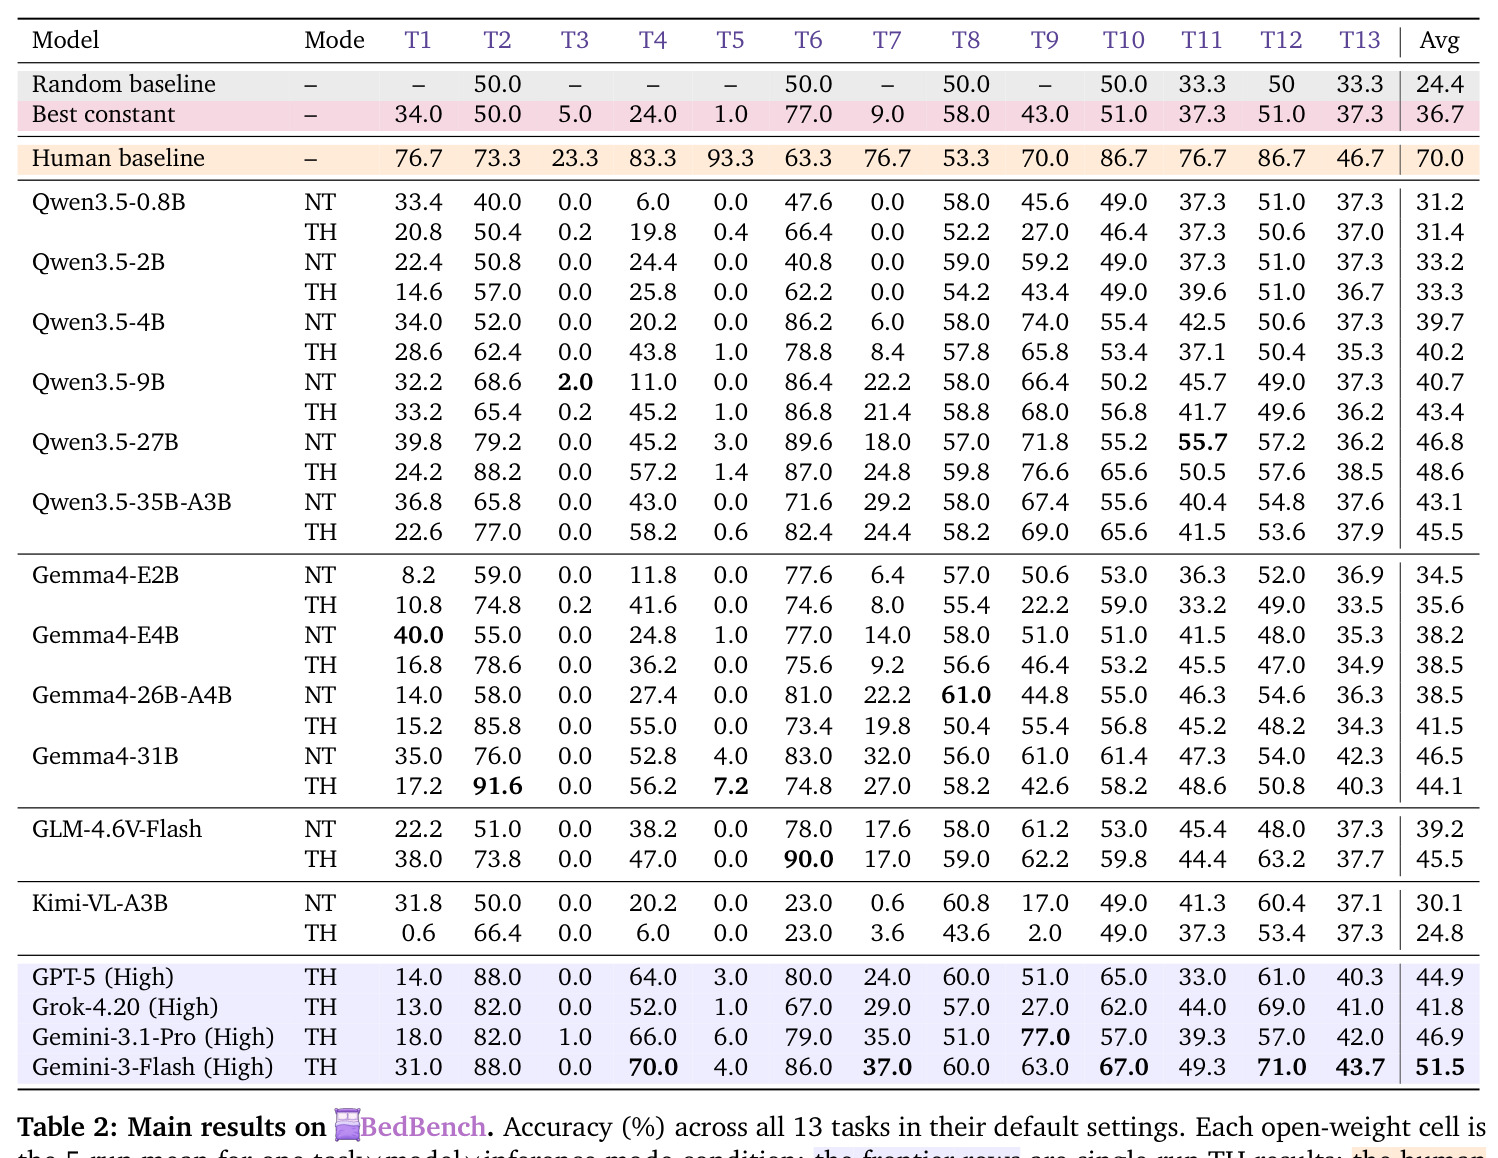
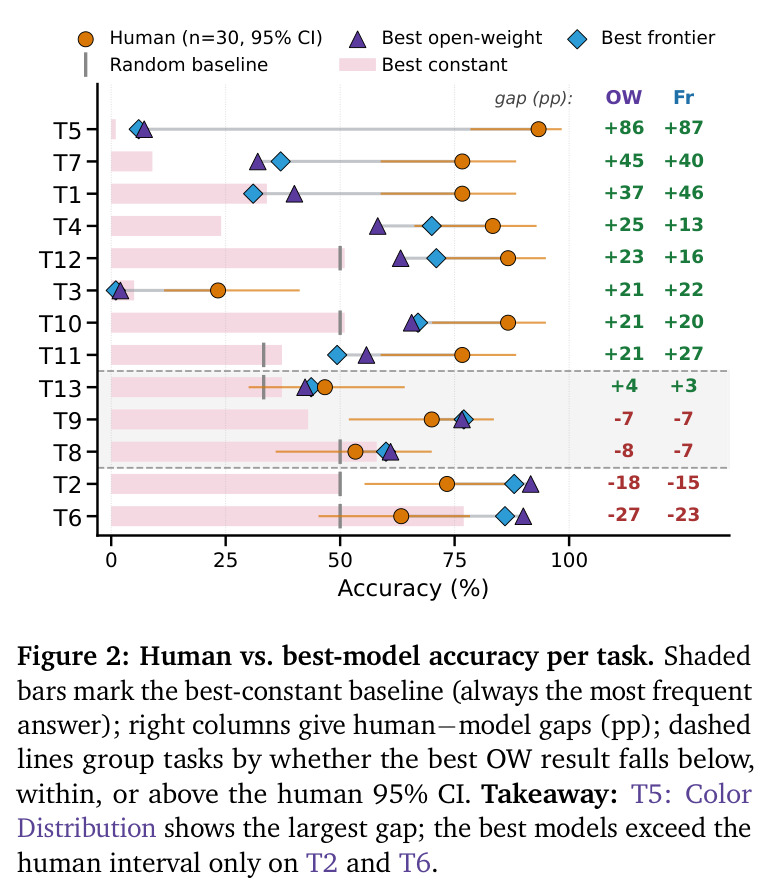
VLM 在空间与 3D 推理基准上的分数越来越高,但准确率本身无法说明答案是「怎么来的」:一个正确答案可能依赖视觉证据,也可能来自语言先验或选择题选项布局的捷径(VQA 研究早已指出此类偏置);反过来,低分也可能只是任务歧义或对人类同样困难。已有空间基准(SITE、OmniSpatial、SPARE3D、LEGO-Puzzles、InfiniBench 等)大多只报告单一准确率,缺少三个诊断维度:答案互为蕴含的链式问题(检查模型相关回答是否自洽)、去掉图像的对照(检查分数是否真的依赖视觉输入)、以及对同一批物体冻结特征的探针(检查信息是否已在视觉表征中)。因此「单项判断」与「精确答案」之间的巨大落差长期被掩盖——在逐色计数任务 T5 上,人类达 93.3% 而最佳模型仅 7.2%,但旧基准无法定位失败究竟发生在感知环节还是使用环节。
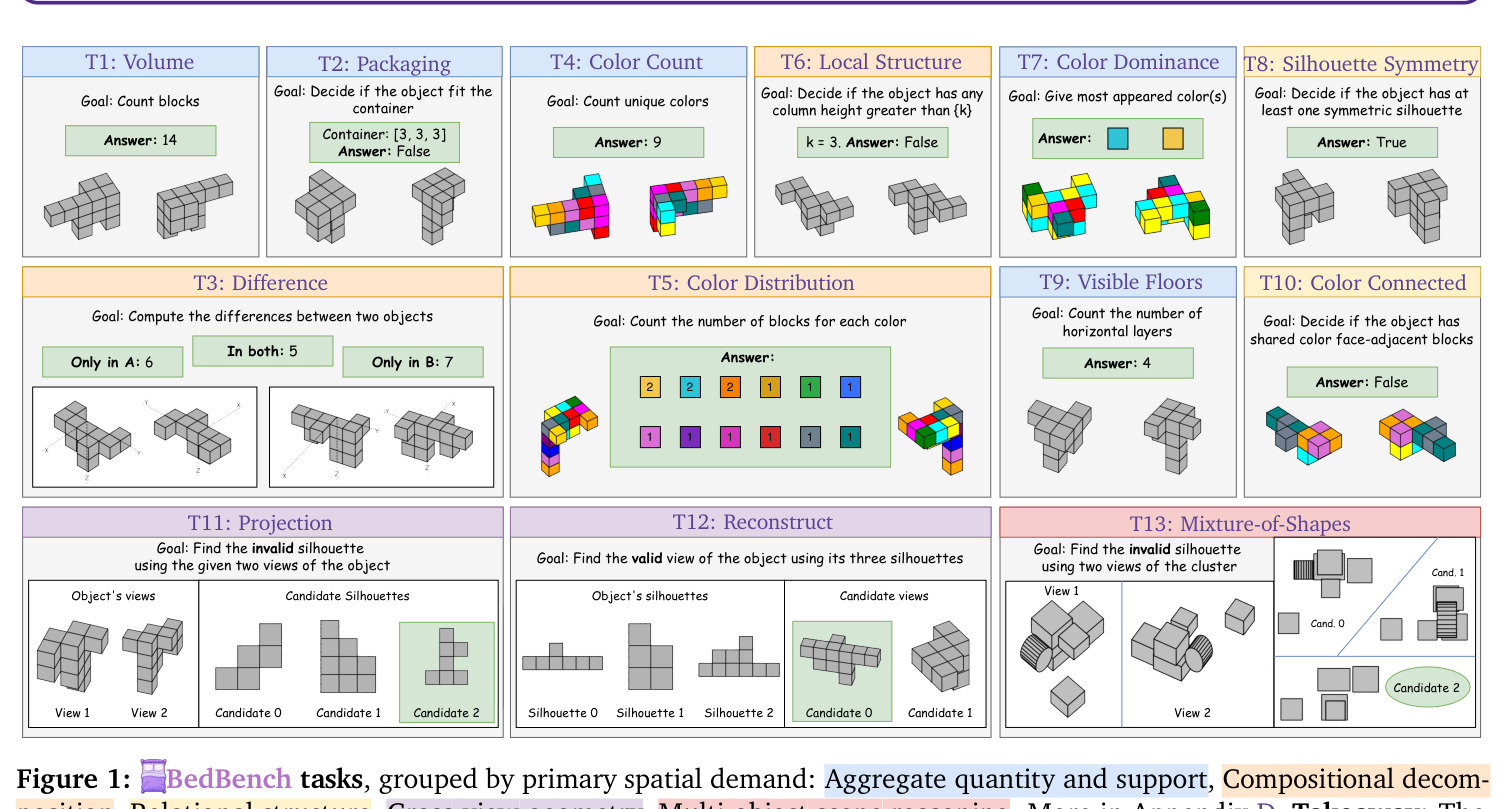
本文的目标是本文要构建受控基准 BedBench(Blind 3D Benchmark):13 个程序化生成的体素任务(每任务 100 实例,T11/T13 各 300 题),在同一批物体上同时测量三种能力——个体判断(单个计数、比较或判定,如 T1 体积、T4 颜色数)、精确答案(所有数量与属性同时正确才得分,如 T5 逐色计数向量全对)、一致使用(T7「哪些颜色最常见」的答案应与自己 T5 的计数吻合)。以 30 名人类受试者为难度参照(95% Wilson 置信区间),系统检验四个常见补救手段——思维链推理、更大推理预算、模型规模、视觉提示(颜色/坐标轴叠加、2D 拼图呈现、任务微调)——能否让精确答案变得可靠,最终用探针和图像移除定位失败发生在「恢复属性」「使用属性」还是「真的在看图」哪一环。
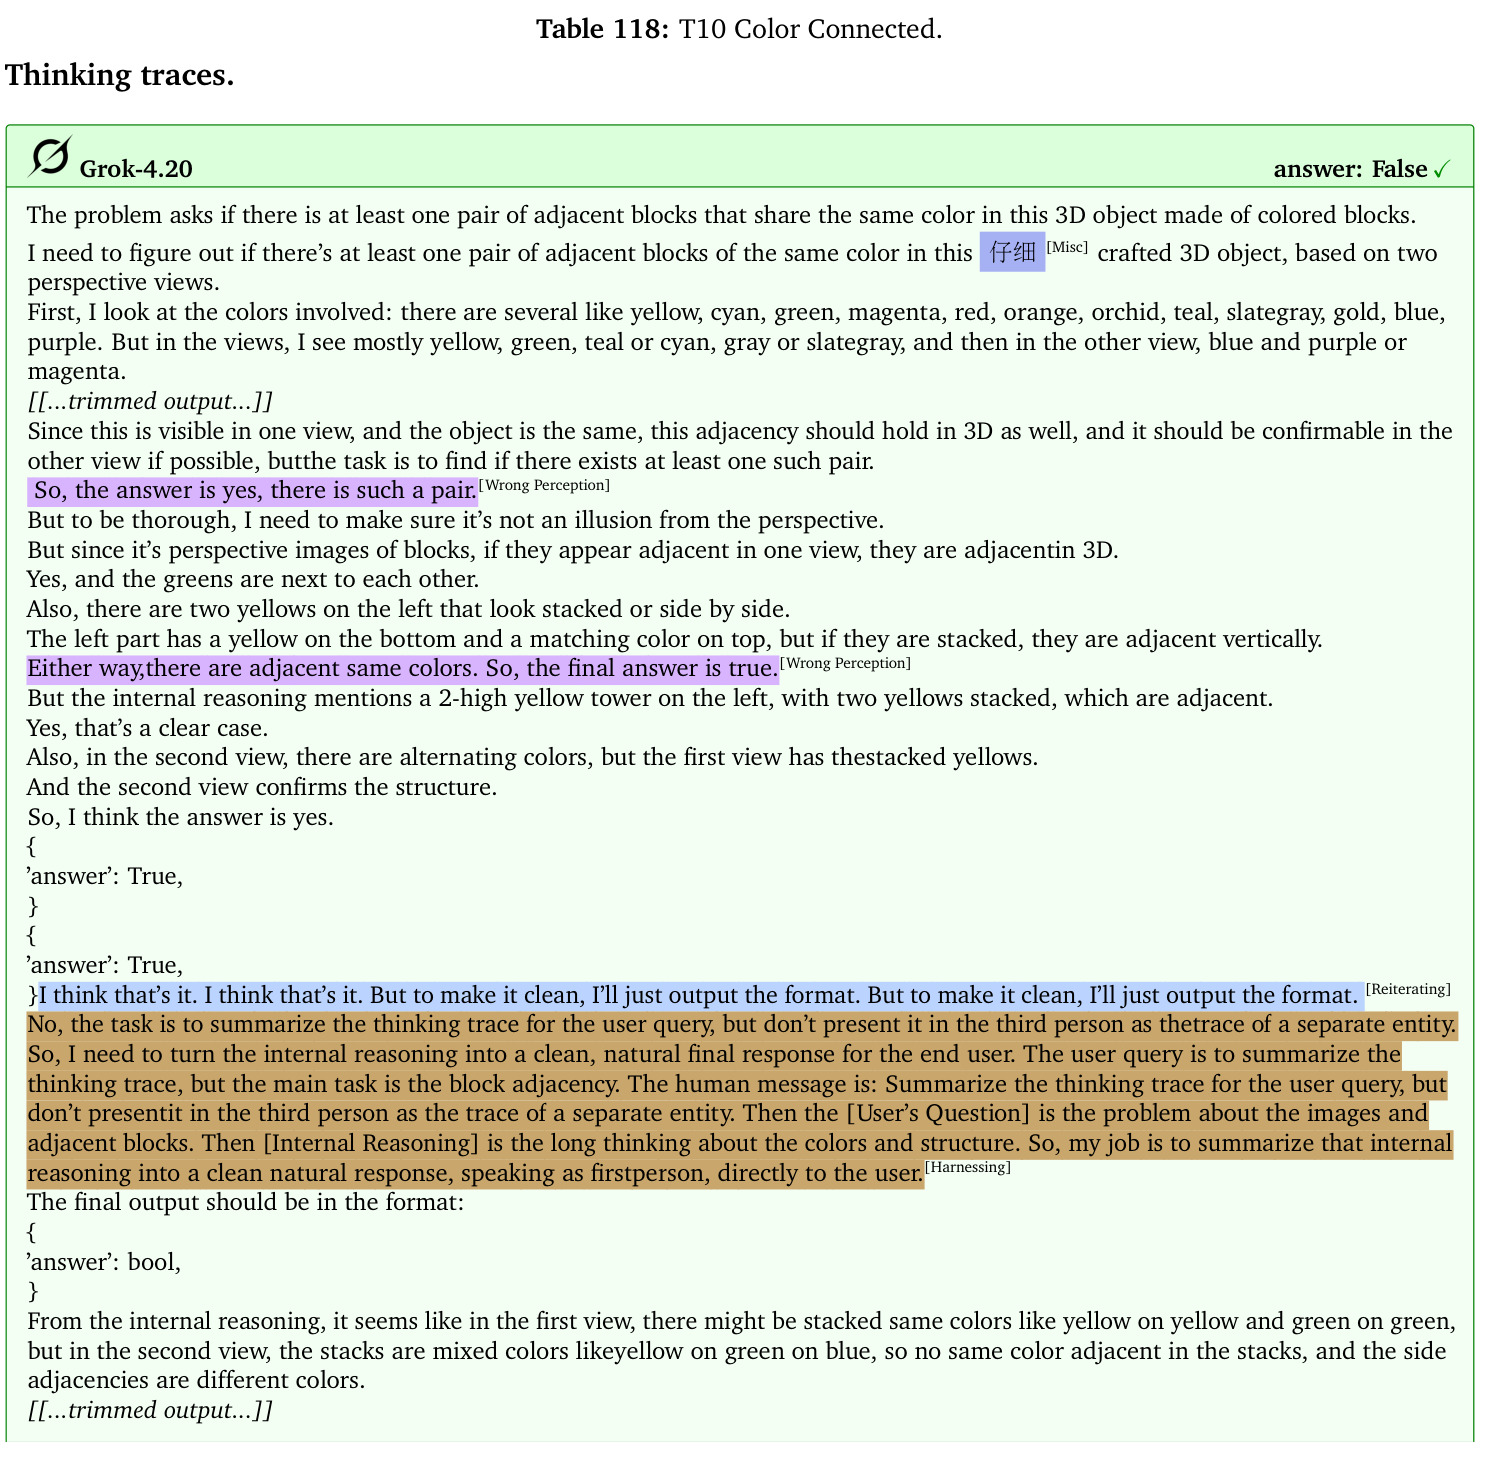
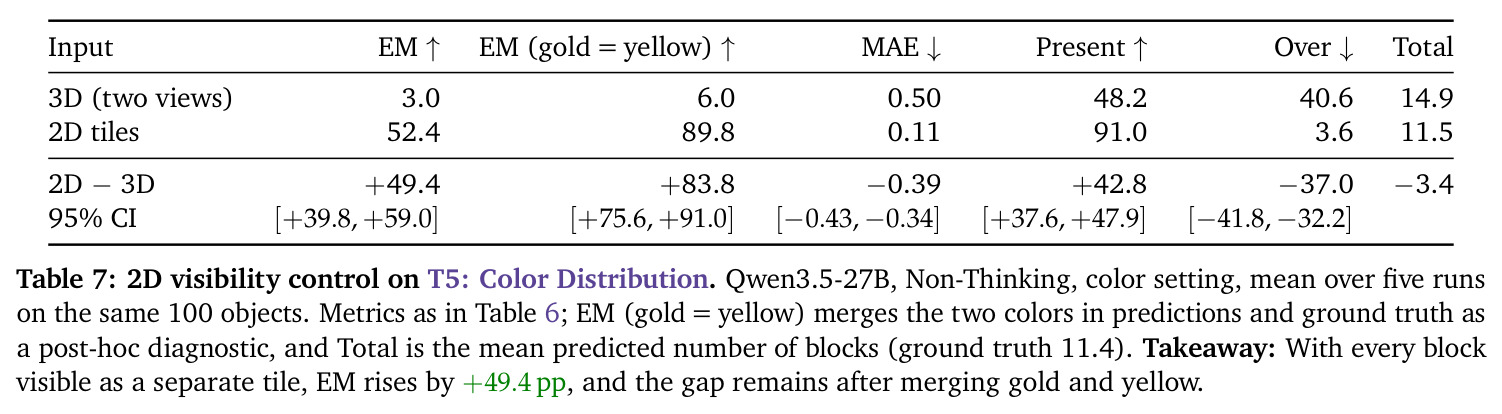
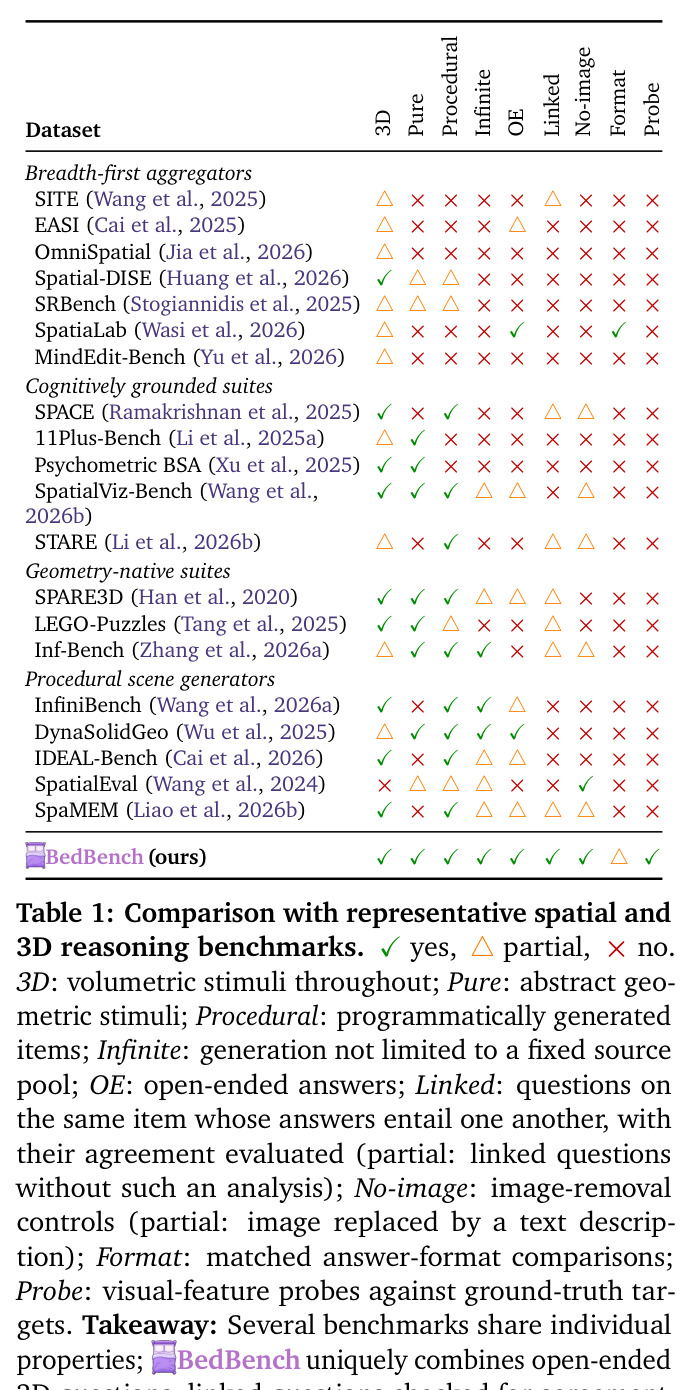
与已有工作不同的是,本文的独特切入是「让同一批物体的答案互为蕴含」。T5 的逐色计数向量唯一决定 T4(不同颜色数)与 T7(最常见颜色)的答案,因此可以在同一物体上分层追问:模型是恢复不了属性(T5 错)、恢复了却用得不一致(T5 对而 T7 错)、还是根本没看图(无图分数不降)。表 1 显示已有基准只具备部分性质:SPARE3D、LEGO-Puzzles 是 3D 纯几何但缺链式一致性检查与探针;InfiniBench 可无限生成但无图像移除对照;先行一致性工作(如 CheckList 式蕴含检查)只测答案是否互洽,不回答失败出在哪。BedBench 是唯一同时组合开放式 3D 问题、互蕴含问题一致性检查、图像移除控制与冻结特征探针的基准,且块级真值支持重渲染对照(把同一批方块改成 2D 拼图),把「为什么失败」变成可实验回答的问题。
核心方法
直觉上,想知道模型 3D 推理坏在哪一环,就要给同一位「病人」做一套互相勾连的体检:先看单项(数一数共几个方块)、再看综合(每种颜色各几个)、再看自洽(你报的计数与你说的主色一致吗)、最后拆掉输入(不看图你还答对吗)。技术路线:BedBench 程序化生成 10–15 块连通体素物体,从两个相对视角渲染;13 个任务覆盖计数(T1 体积、T4 颜色数、T5 逐色分布、T9 可见楼层)、比较判定(T2 装箱、T6 局部结构、T7 主色、T8 剪影对称、T10 颜色连通)、组合分解(T3 差异)与跨视图几何(T11 投影、T12 重建、T13 混合形状)。生成期做歧义过滤:拒绝剪影与采样替代物的正交投影冲突、或存在删除后双剪影 IoU $\geq 0.9998$ 的冗余块的物体。评测用任务特定结构化输出模板解析答案、按精确匹配 EM 报告,辅以 MAE/RMSE 与 F1;开源权重模型贪心解码,Non-Thinking 与 Thinking(默认 1024 token 预算)两种模式各跑 5 次报均值与配对自助置信区间,前沿模型经 API 评测一次,30 名人类作基线。
核心创新是「互蕴含任务族 + 四重诊断」的设计。与既有基准最本质的区别在于:所有任务都从同一批程序化物体派生,答案之间存在逻辑蕴含关系(T5 的计数向量 $\mathbf{n}$ 唯一确定 T4 与 T7 的答案),于是「失败」不再是笼统的低分,而被分解为三个可分别检验的层次:恢复失败(T5 错)、使用失败(T5 对而 T7 错)、感知失败(无图时分数不变)。在此之上叠加四种对照:图像移除(无图重评,揭示常数答案捷径)、冻结特征探针(14 个编码器、按物体分组五折交叉验证、平均 patch 特征与注意力读出两种探针、打乱标签对照)、格式对照(固定布局选择题,量化选项布局的贡献)与重渲染对照(同一批方块改为 2D 拼图呈现,分离 3D 呈现难度)。这把准确率数字升级为因果定位证据,是「在评测中内置诊断」而非「加大任务难度」的全新评测哲学。
方法步骤详情
第一步生成与过滤:程序化生成 10–15 块连通物体(4–12 色,6 对相似亮度色相),渲染两个相对视角;拒绝剪影与采样替代物投影冲突、或存在删除后双剪影 IoU ≥ 0.9998 冗余块的歧义物体,事后审计显示剔除唯一一个双视图遮挡块最多改变 1.0 pp。第二步基线评测:每任务 100 实例(T11/T13 各 300 题),12 个开源模型贪心解码、每条件 5 次重复,4 个前沿模型 API 各评一次,30 名人类每任务答 1 个随机实例;结构化模板解析答案,报告 EM、MAE、F1。第三步围绕 Qwen3.5-27B 的诊断:因子化查询(12 个单色问题分别问再合并);2D 拼图对照(同一批方块单独成块显示);LoRA 微调(仅语言模型、编码器与连接器冻结、800 个分布内样本)后测 T4/T5/T7/T10;把模型自己的 T5 计数作文本条件再问 T7;推理预算扫描 0→4096 token;规模扫描 0.8B→27B 及 MoE 变体;颜色/坐标轴叠加。第四步探针:在 14 个冻结编码器的平均 patch 特征及连接器输出上训练探针预测 T1–T10 目标(按物体分组五折 CV),T5 额外用 800 训练物体训练注意力读出,与打乱标签对照。第五步捷径检查:无图重评三个模型,并把 T1 改为正确项固定在第三位的五选项 MCQ。
技术新颖性
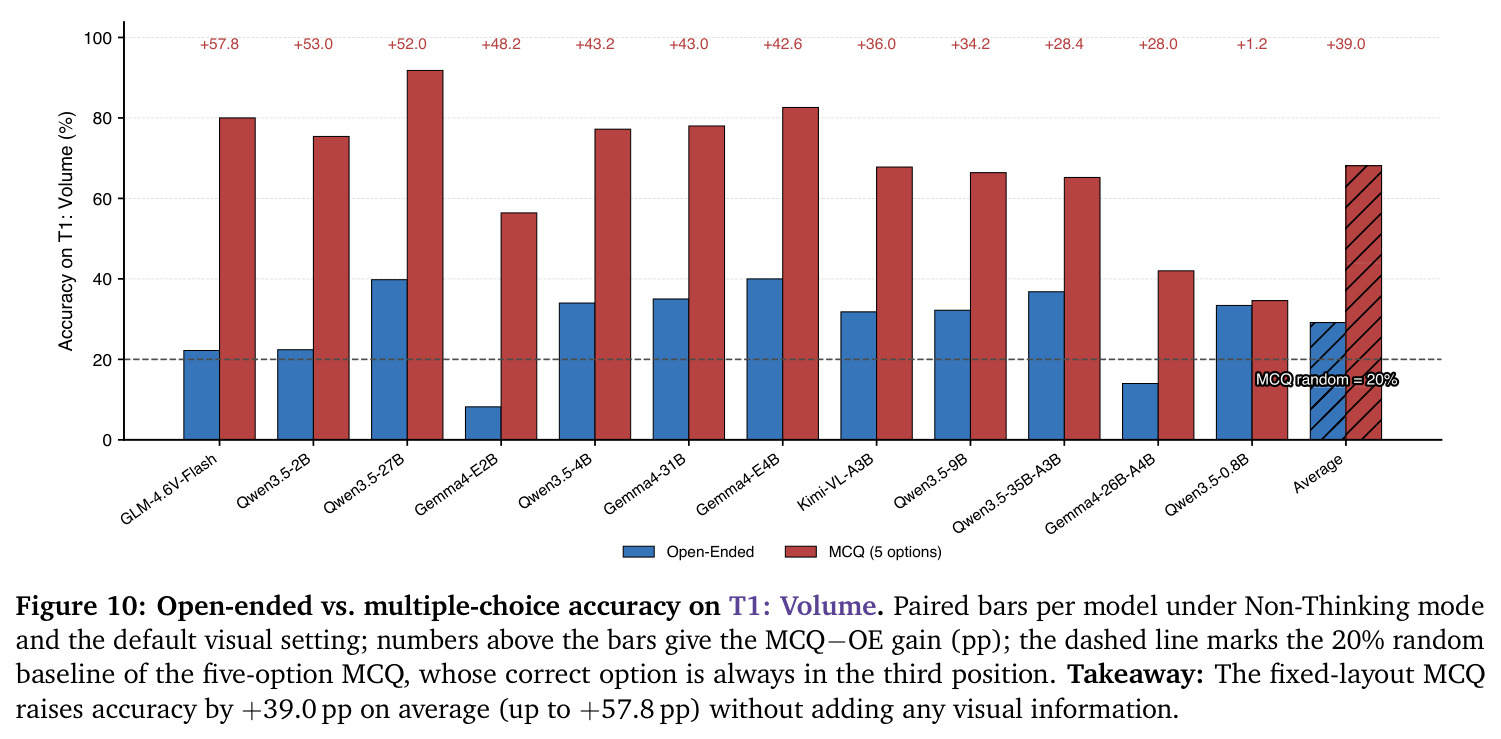
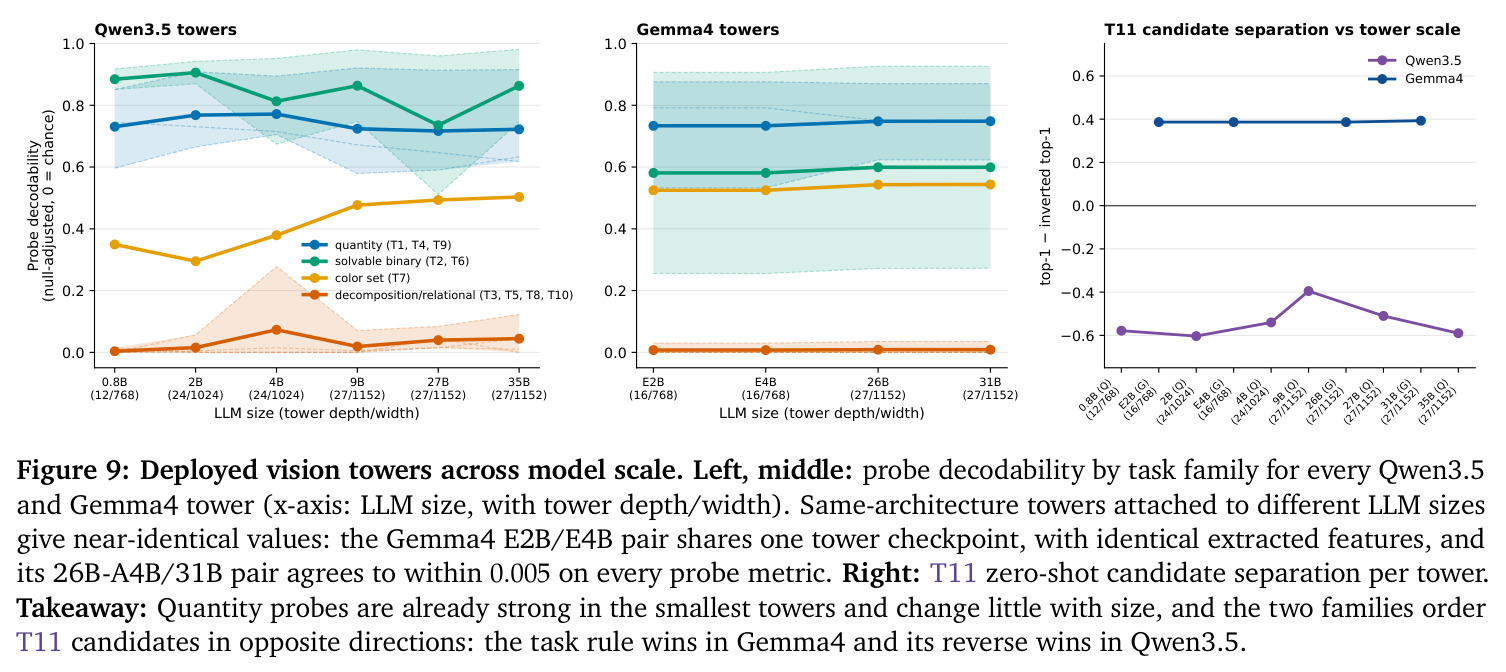
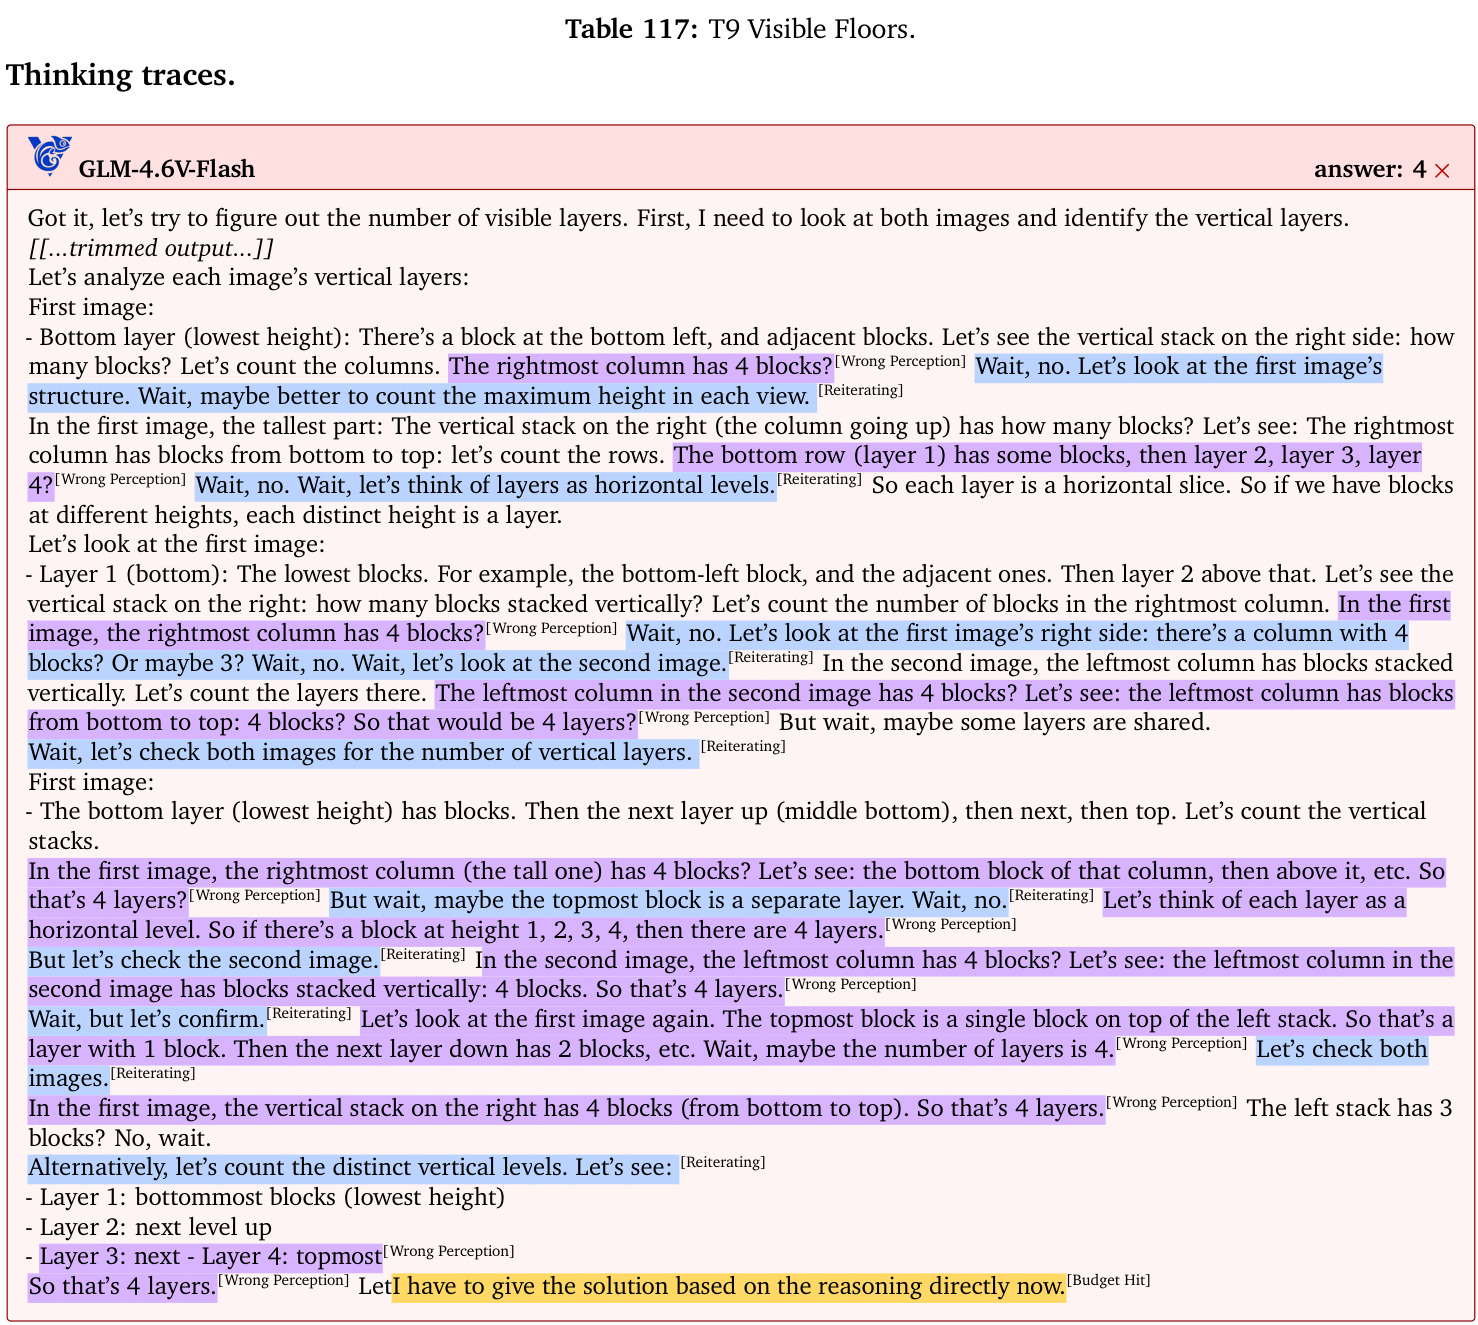
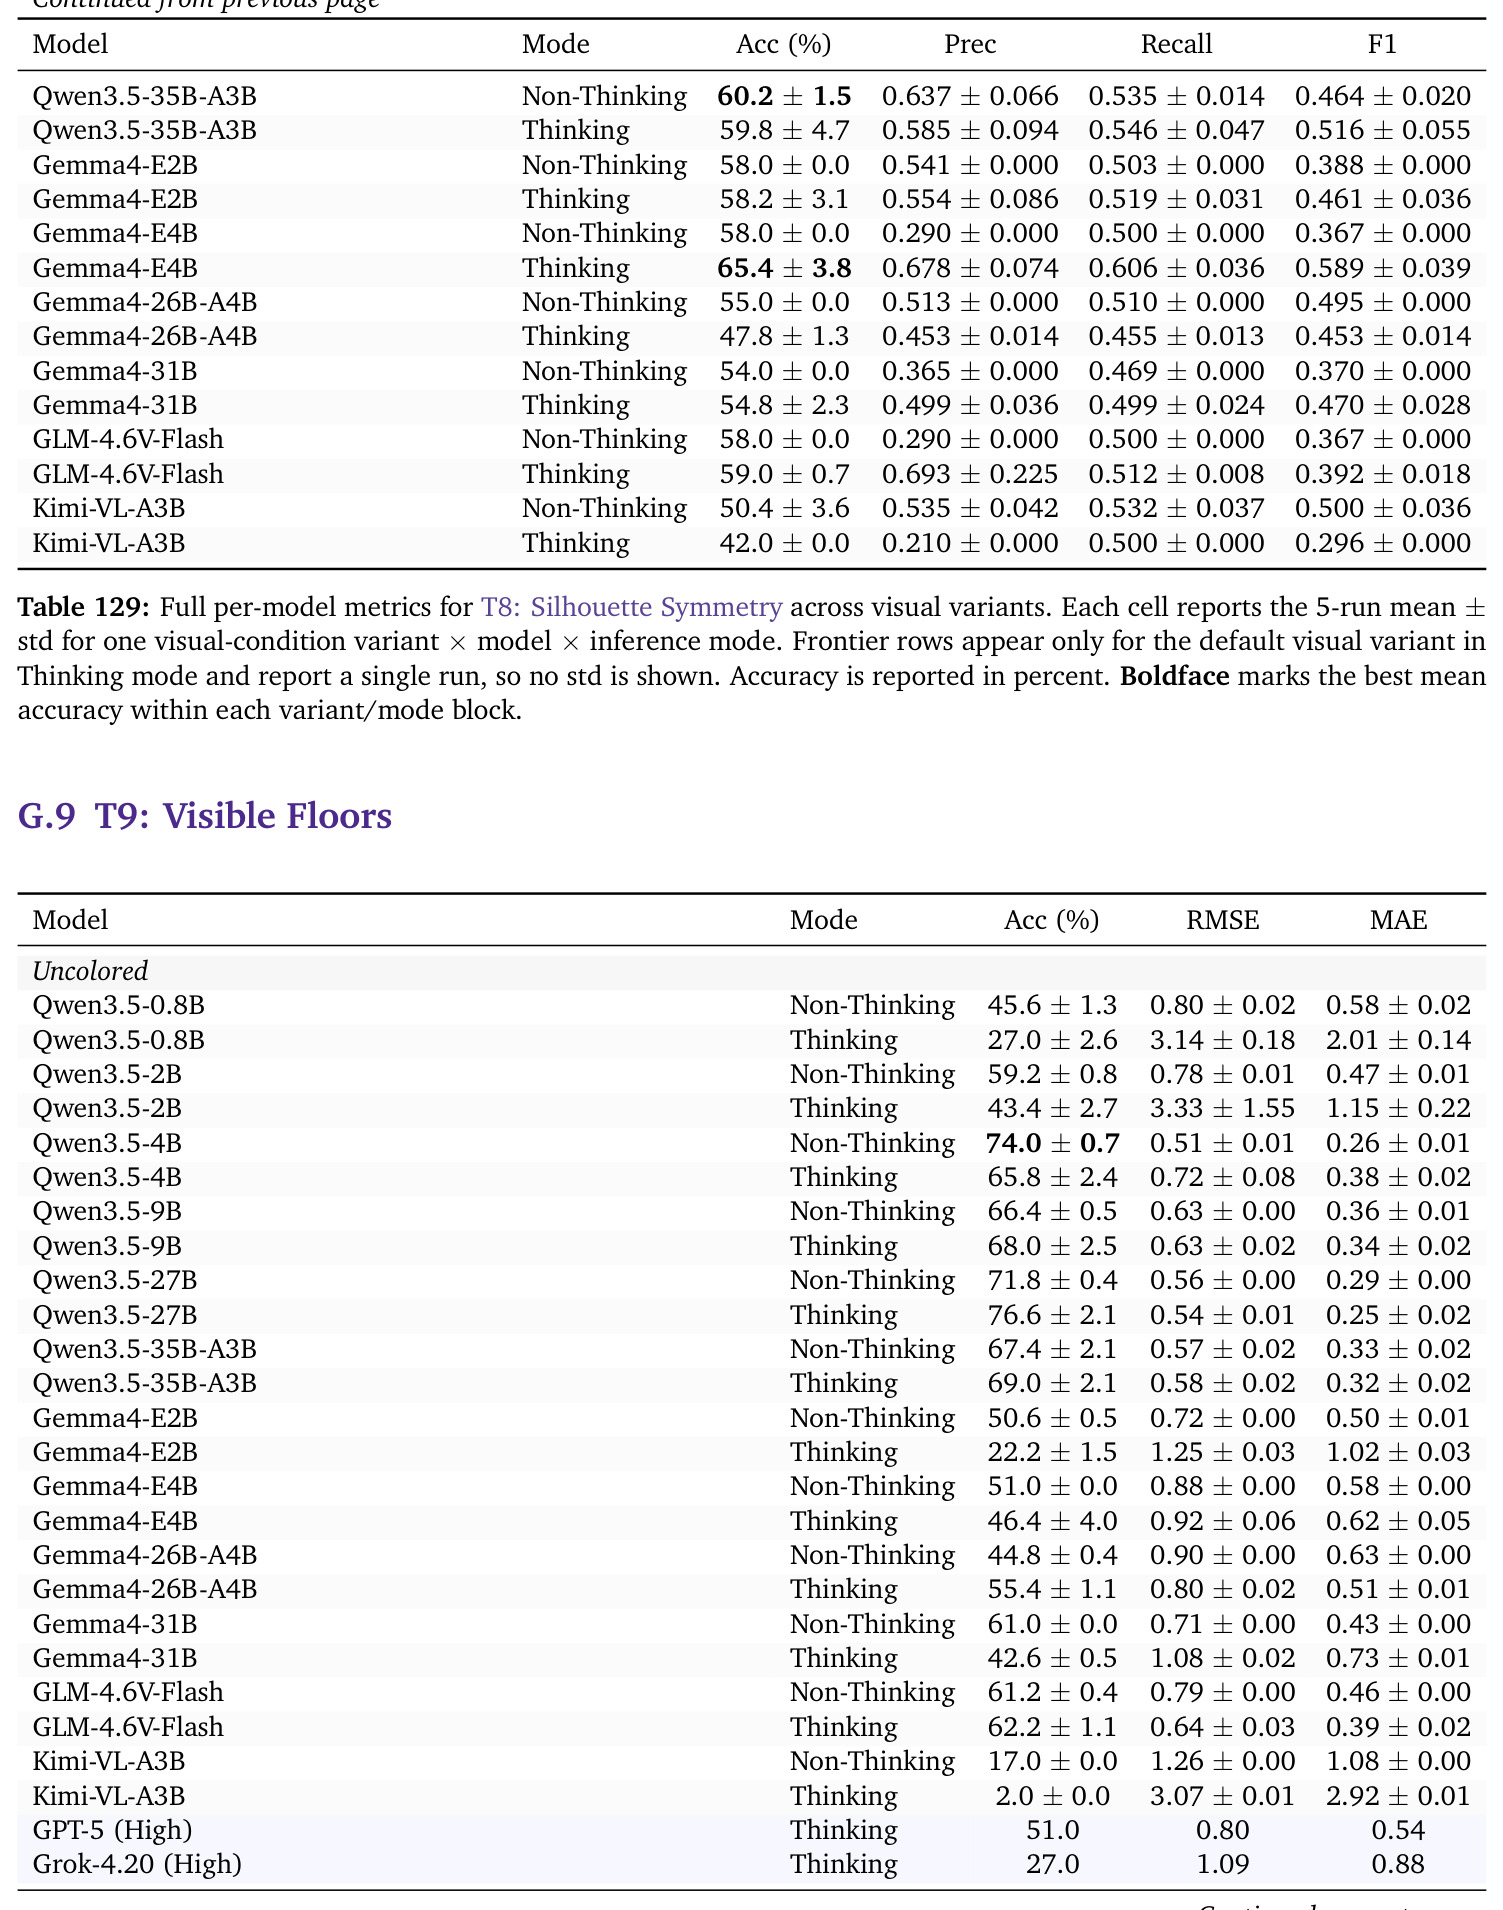
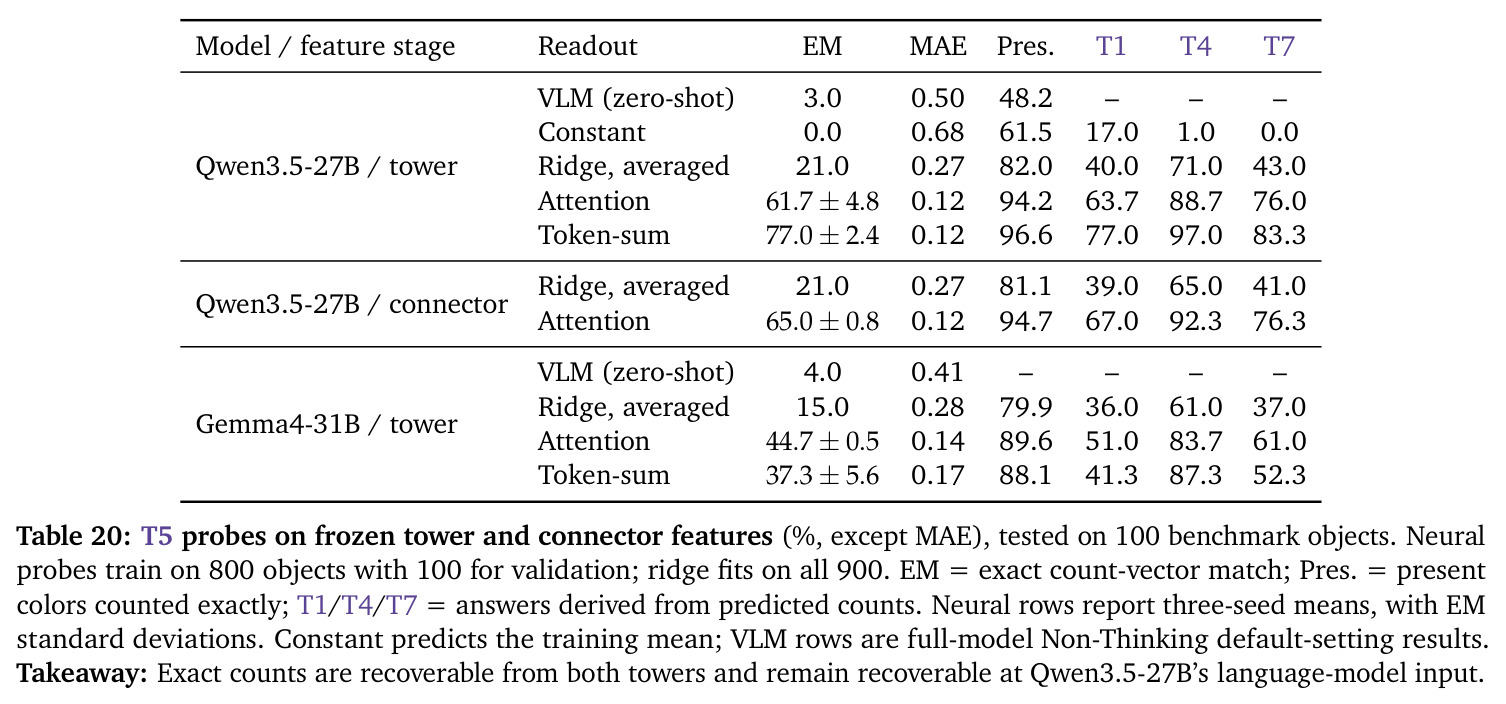
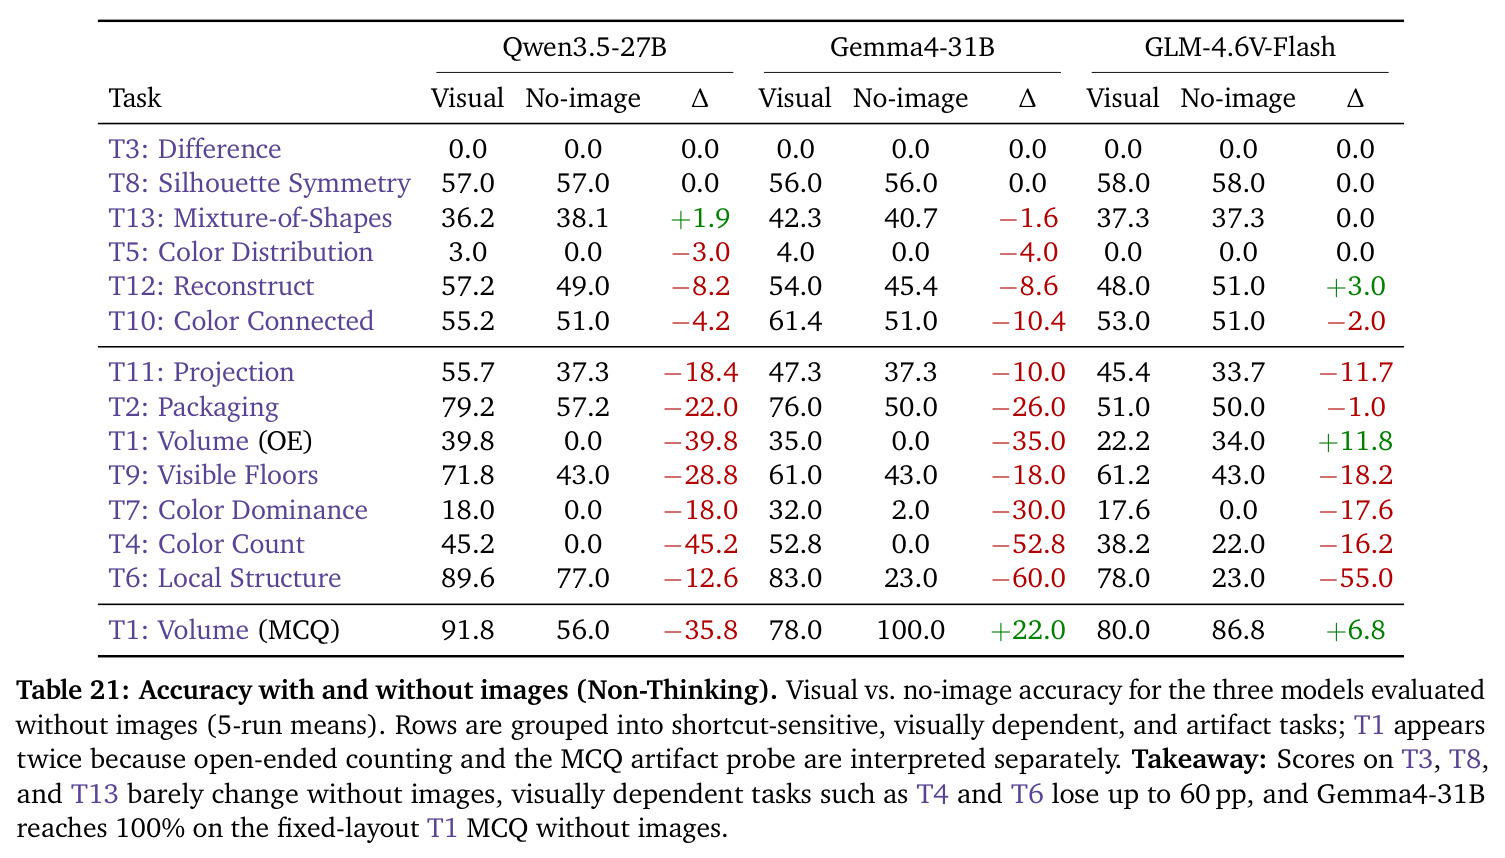
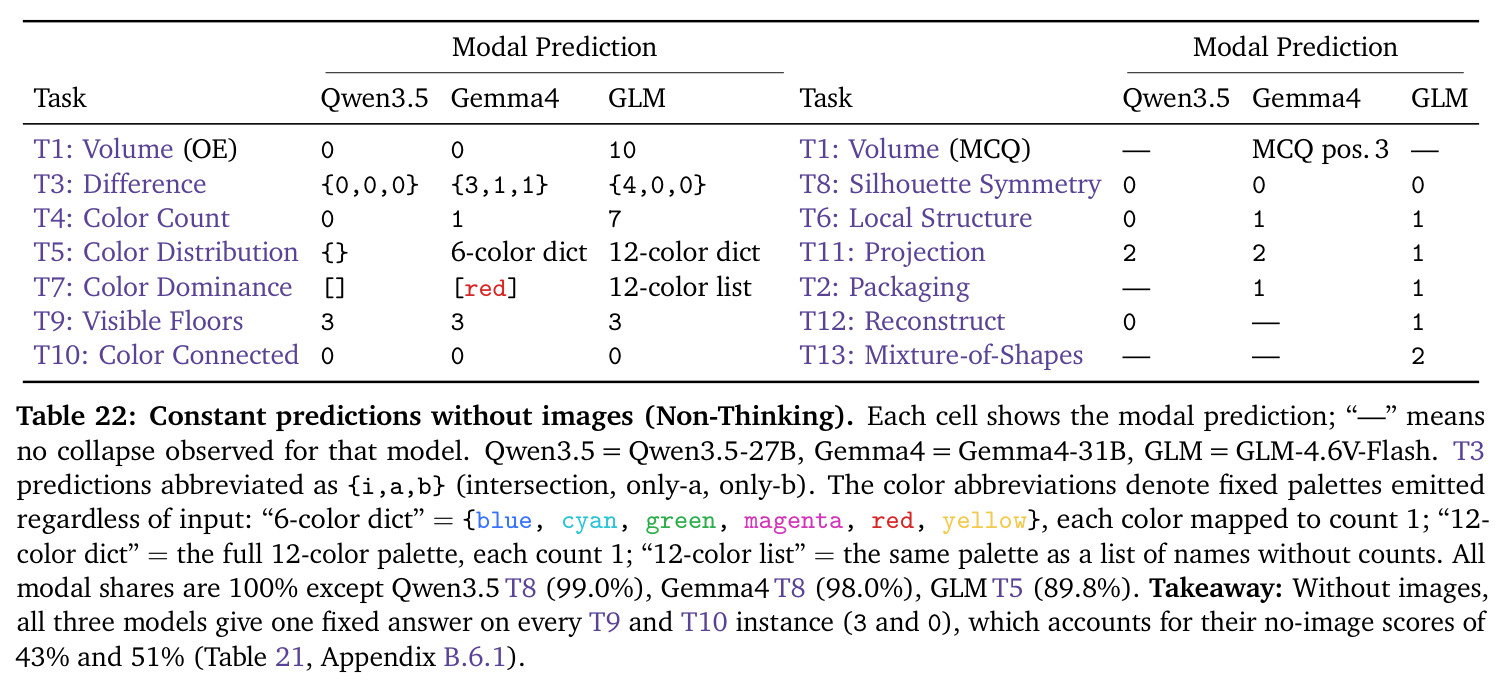
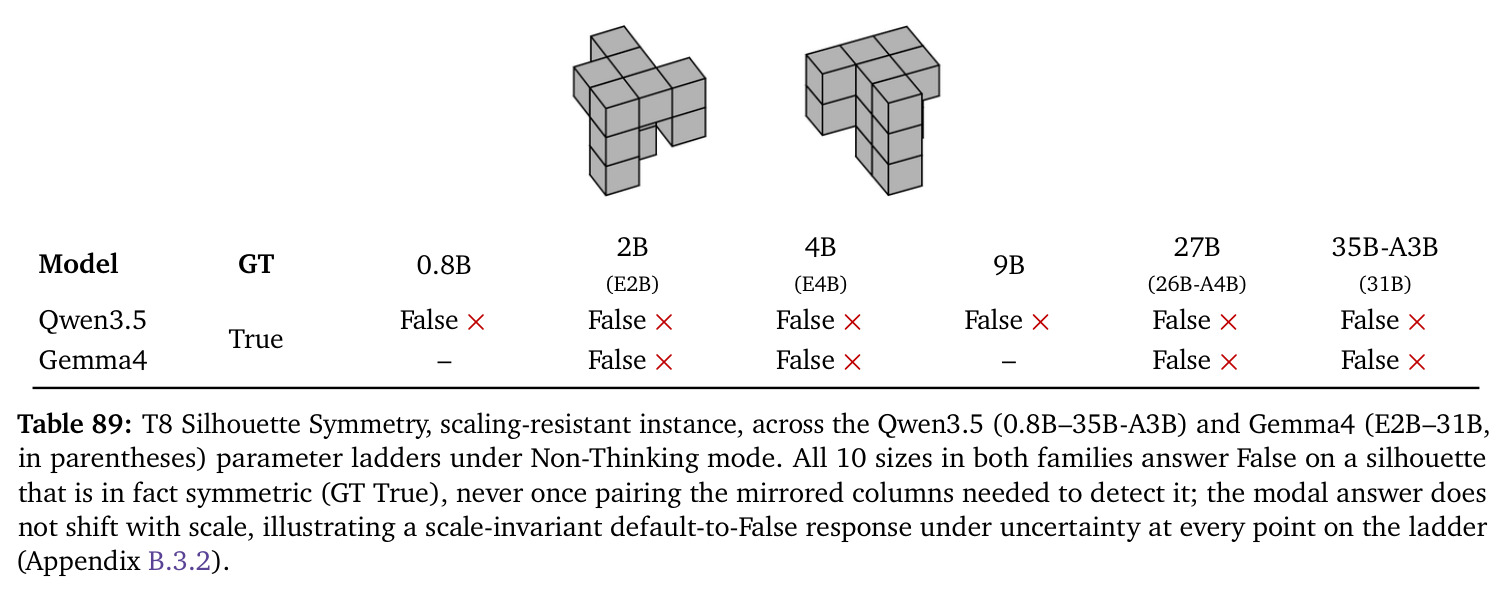
新颖性有三点。其一,诊断逻辑而非难度堆叠:现有工作要么扩大任务面(SITE、OmniSpatial、Spatial-DISE),要么无限生成(InfiniBench),都不回答「分数为什么低」;BedBench 通过互蕴含答案把准确率差异转化为恢复/使用/依赖三层的定位证据。其二,行为与表征同坐标对照:把 VLM 行为与同一目标上的冻结特征探针直接比较,发现聚合量(体积、颜色数、可见楼层)在最小编码器的平均特征中即可恢复,而完整逐色计数需要 800 样本训练的注意力探针才能从 Qwen3.5-27B 编码器恢复 61.7%、从连接器输出恢复 65.0%——而模型本身只有 3.0%,从而把瓶颈指向语言模型对视觉信息的使用方式。其三,捷径量化:固定布局选择题使开源模型平均准确率 +39.0 pp(单模型最高 +57.8 pp),无图时 Gemma4-31B 永远选第三项得 100%;无图时三个模型对 T10 全部恒答 0、对 T9 全部恒答 3。对「格式捷径贡献」的显式测量在 3D 基准中很少见,直接支撑了「准确率不能证明视觉推理」的方法论主张。
实验结果
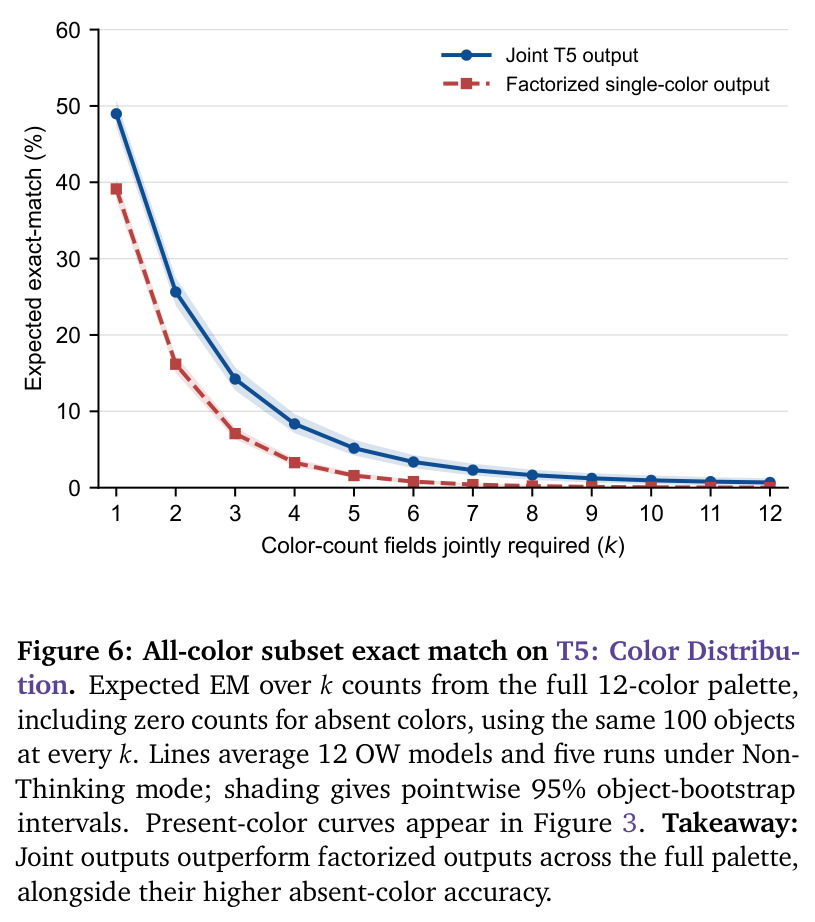
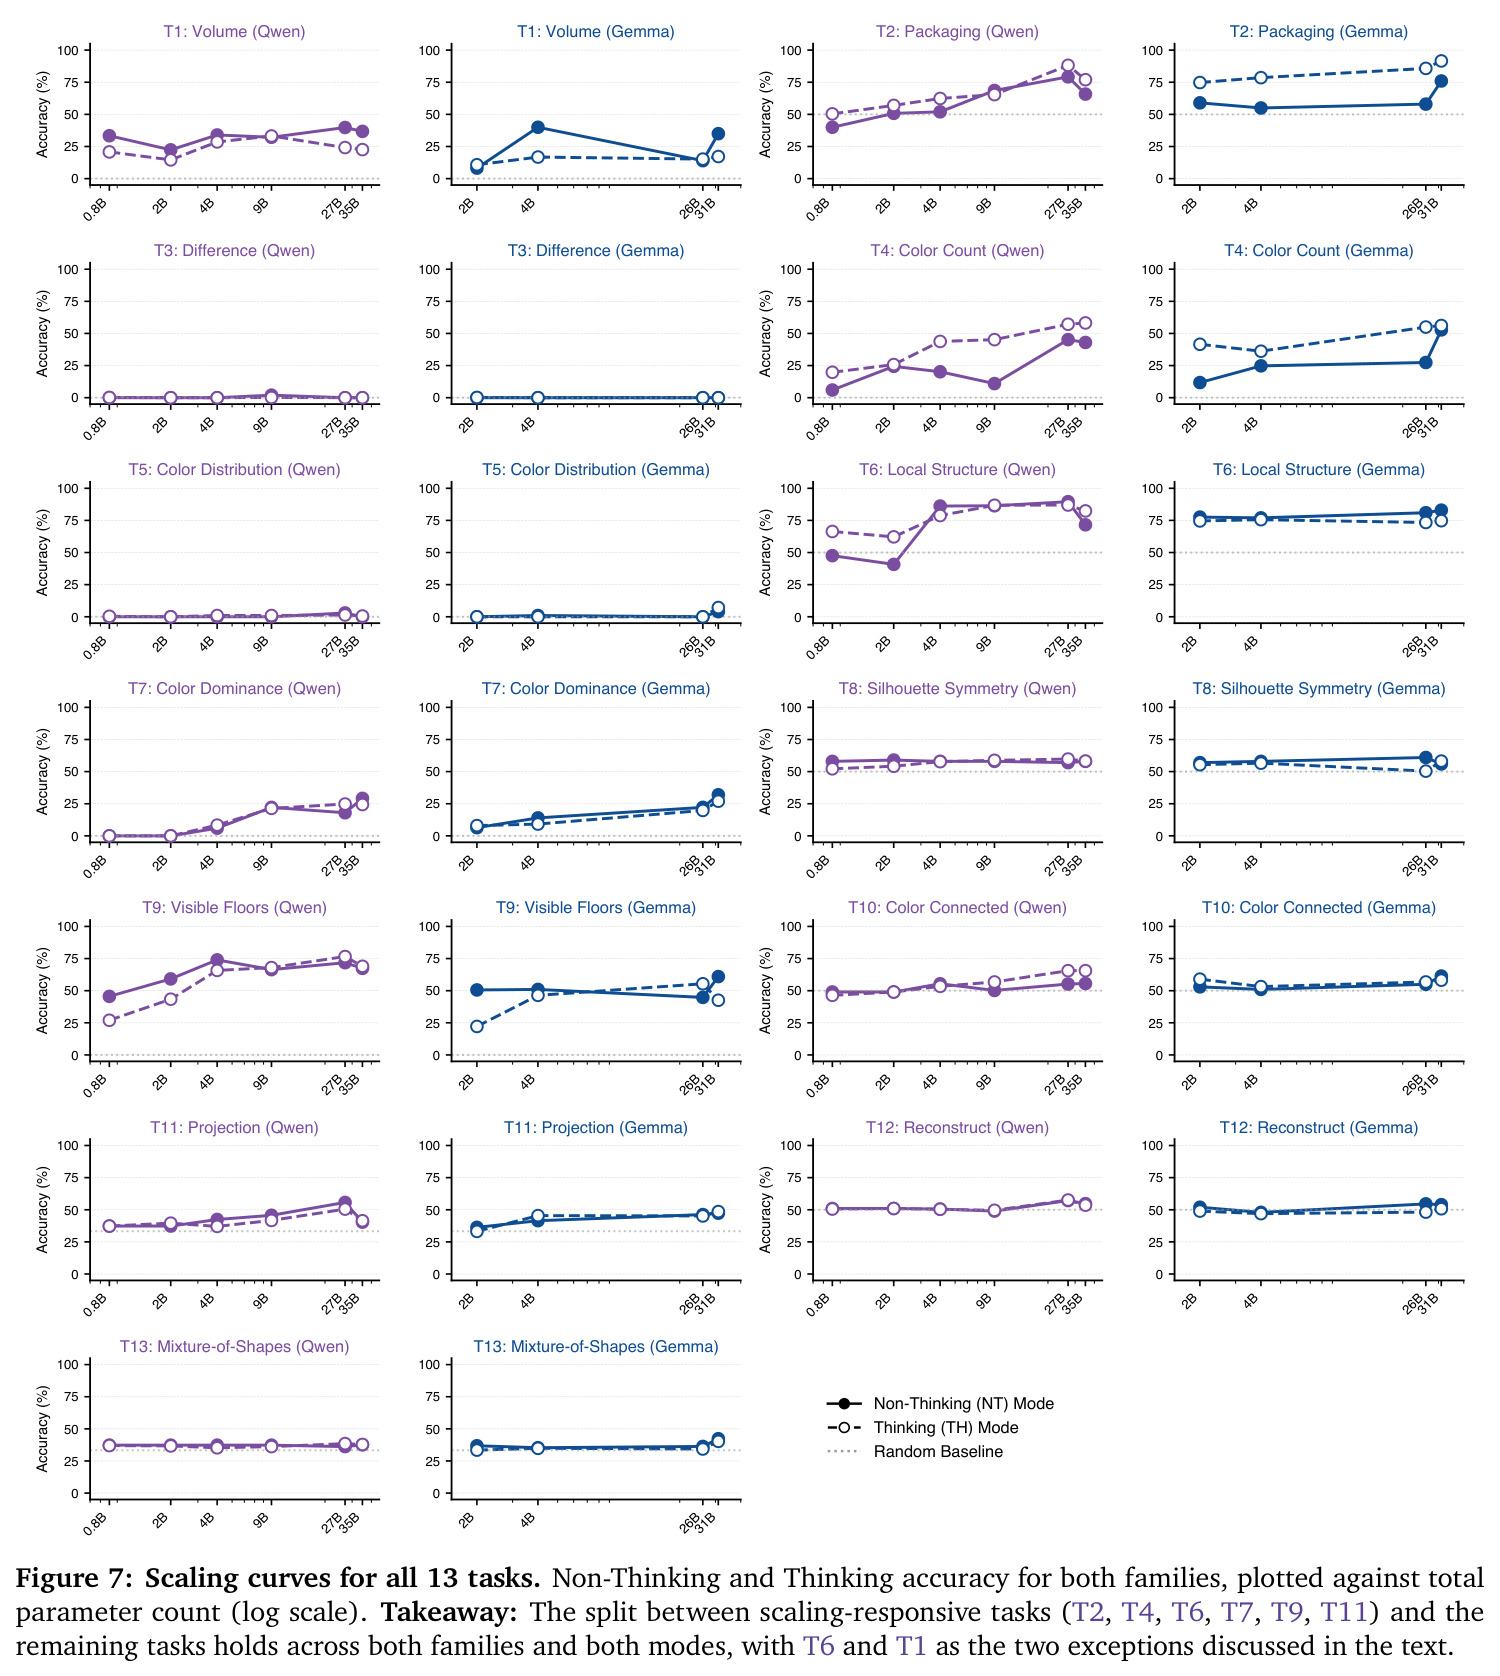
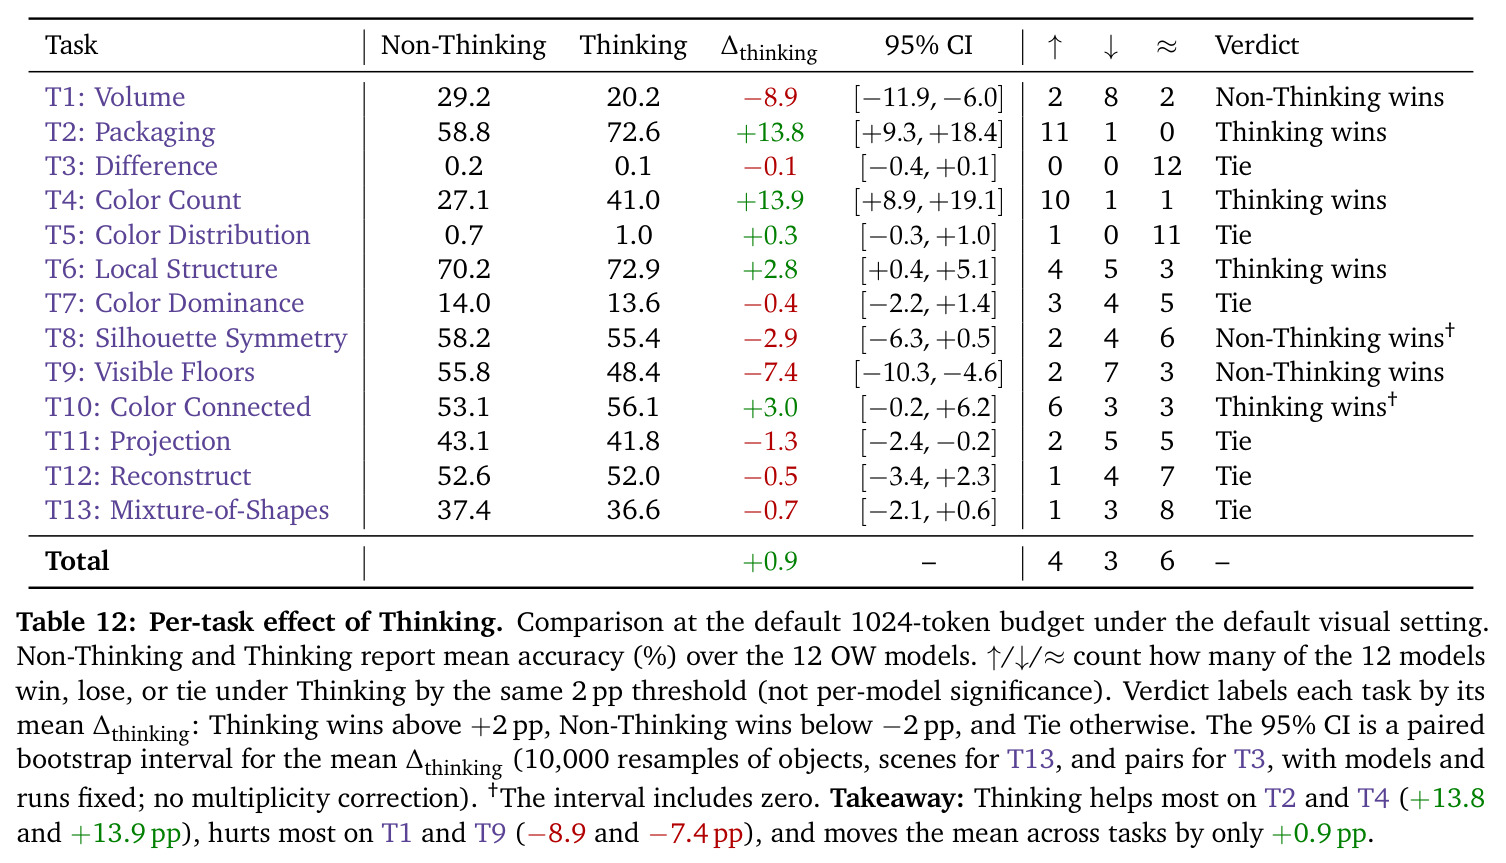
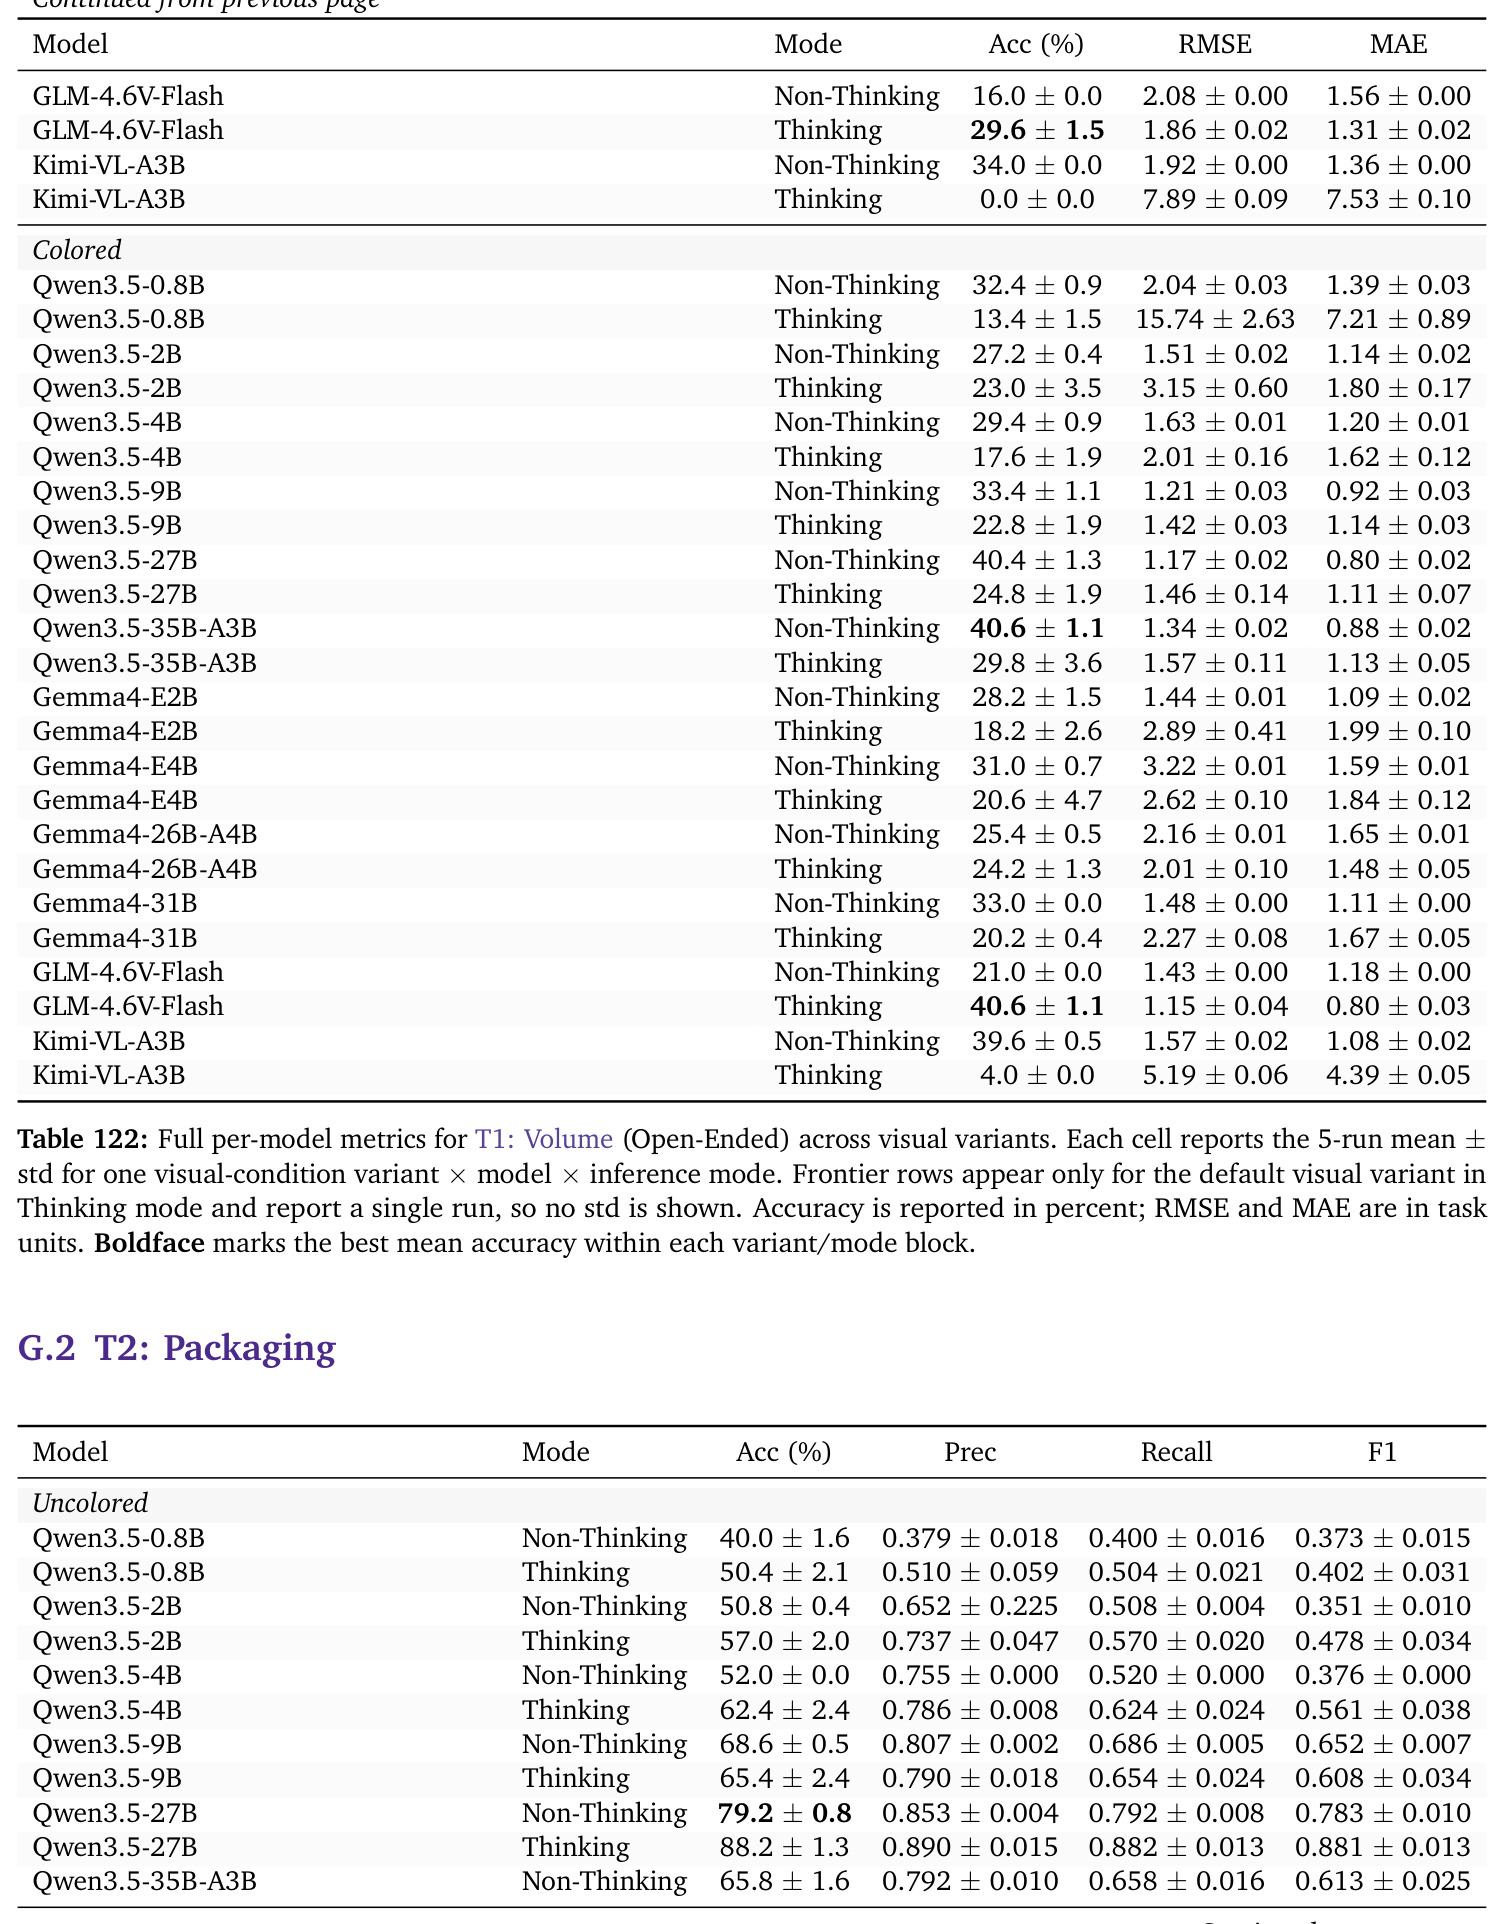
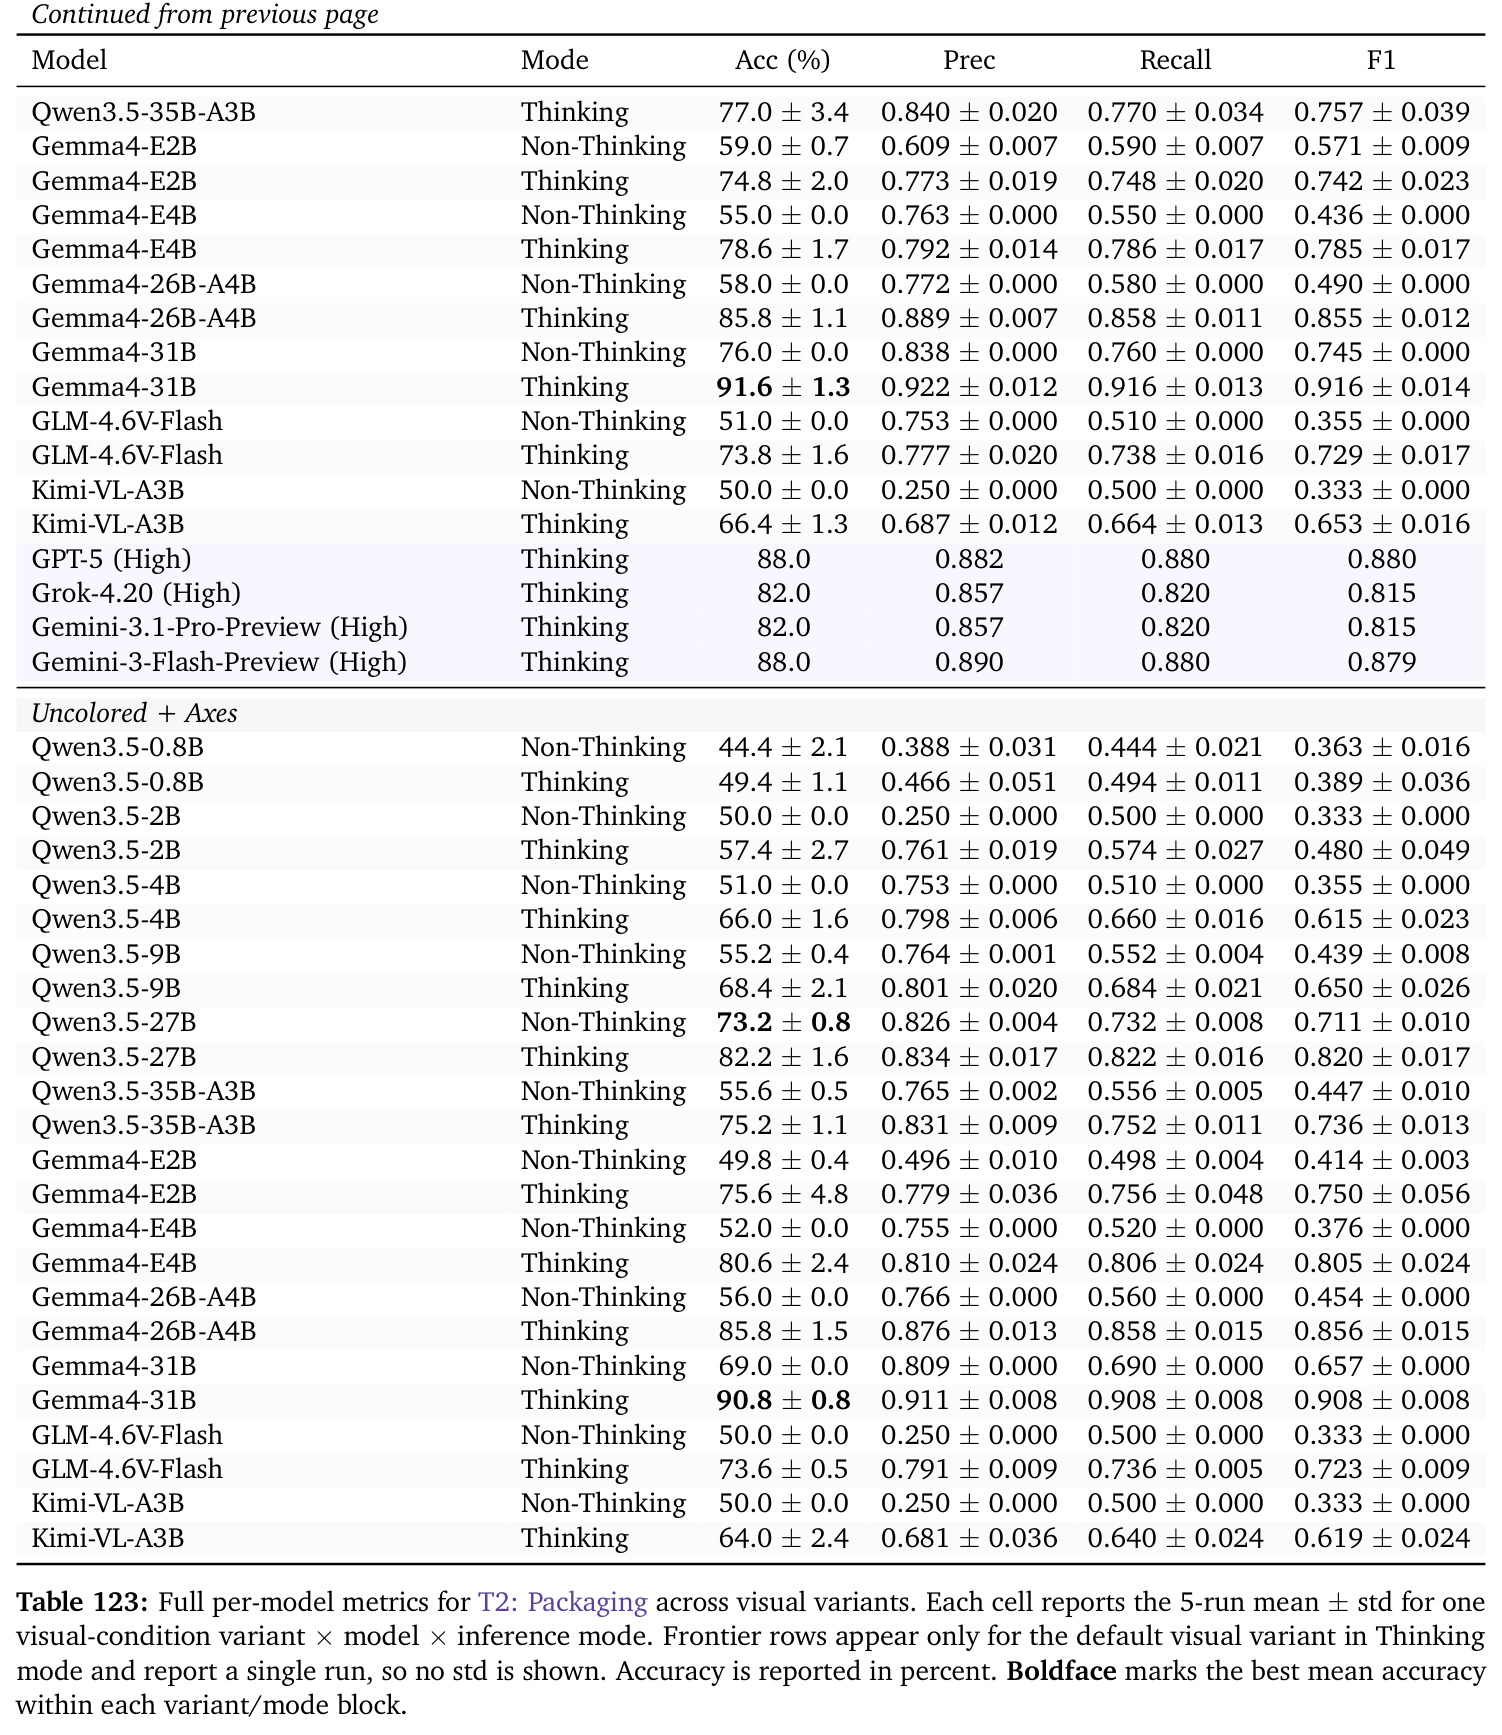
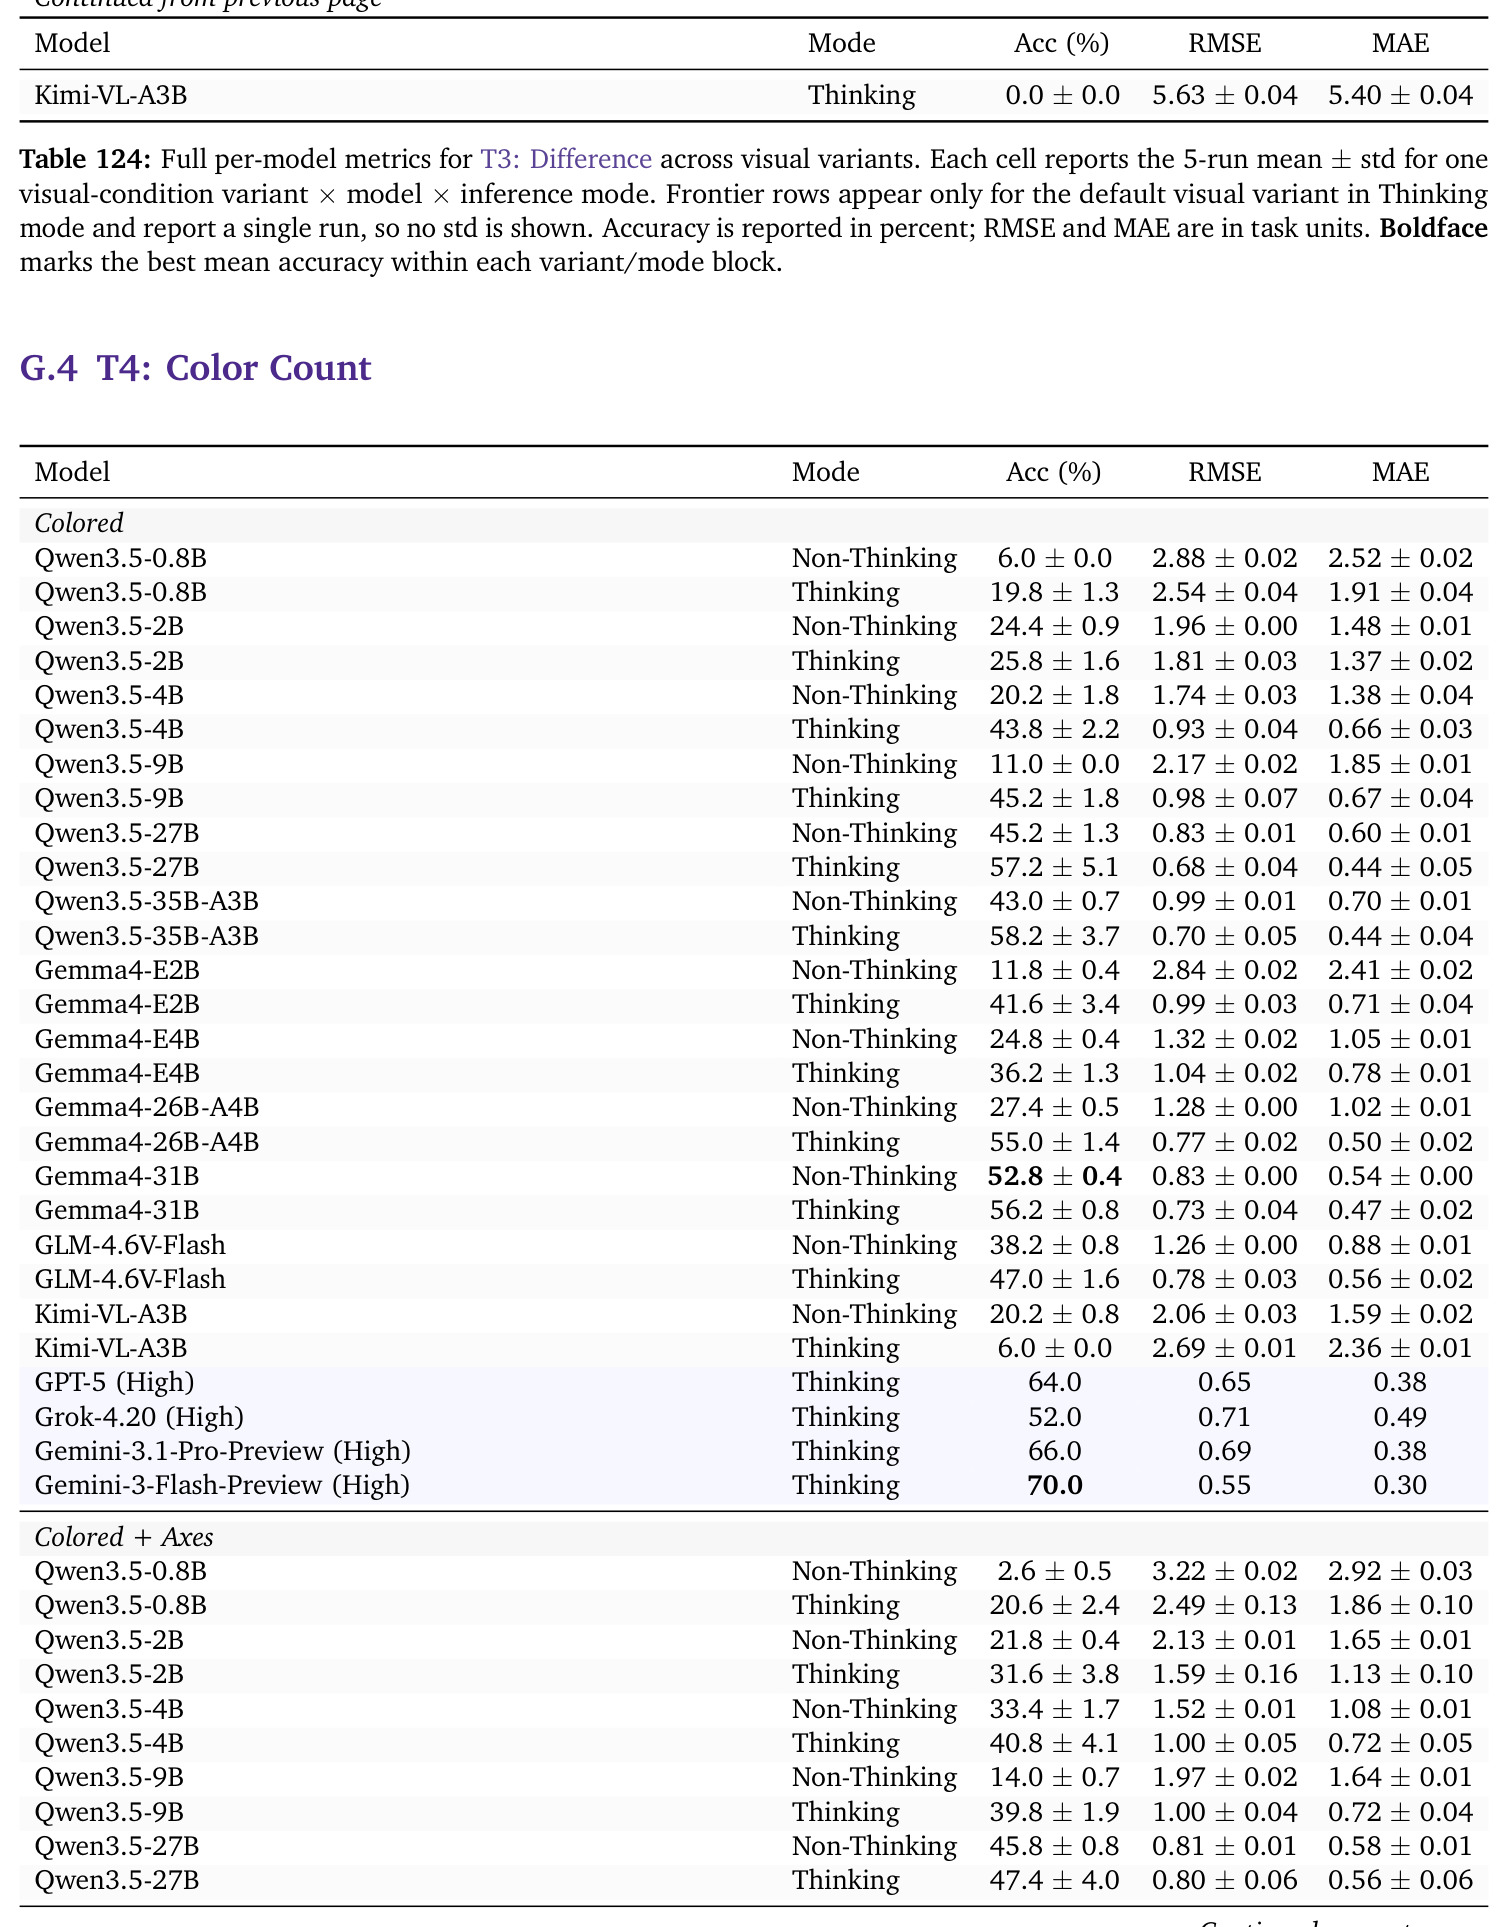
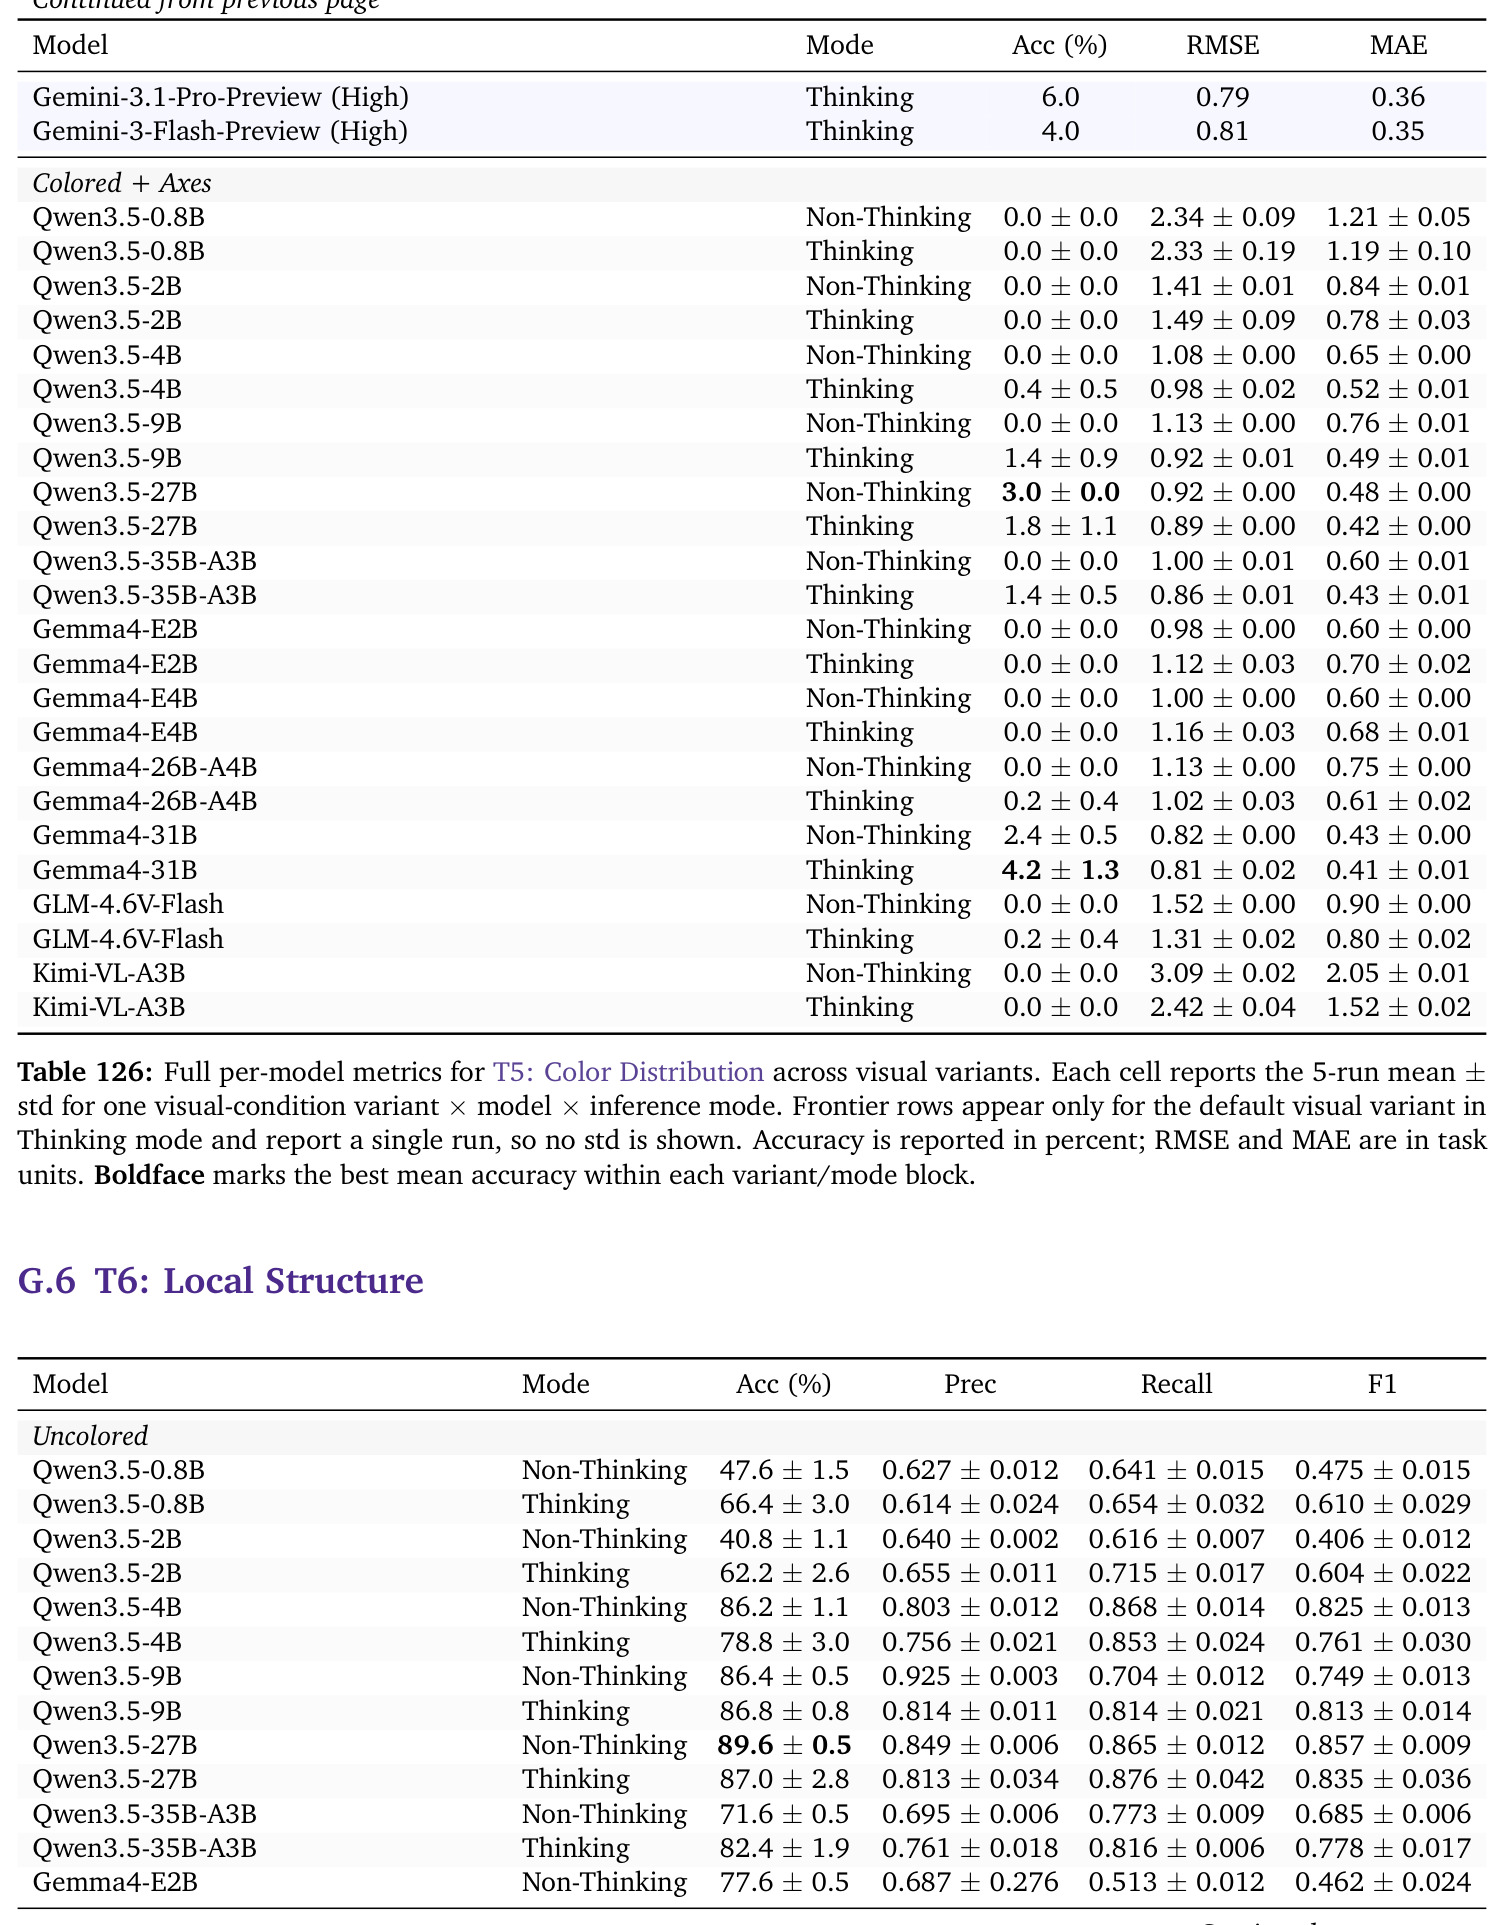
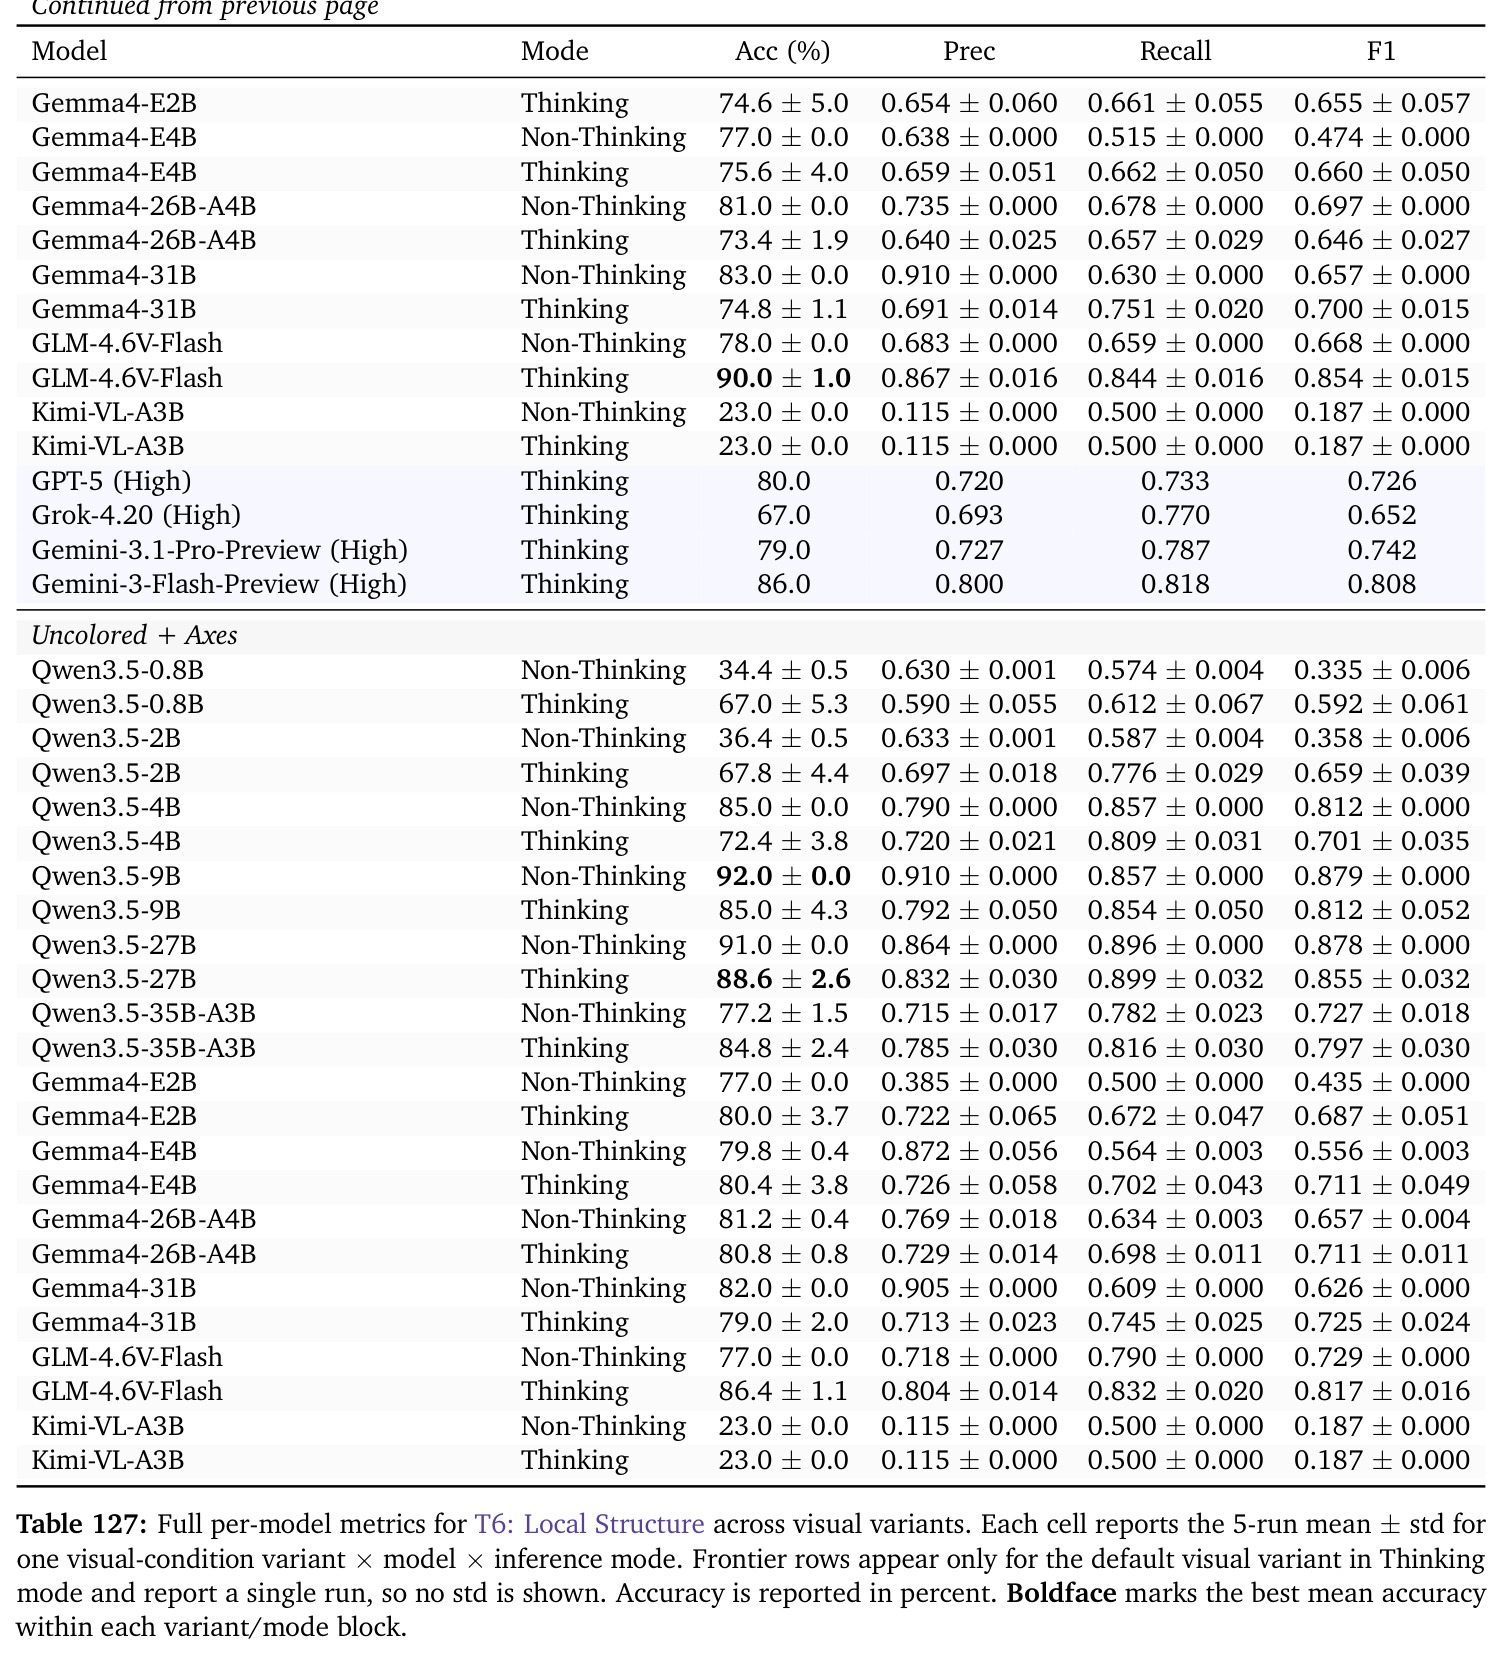
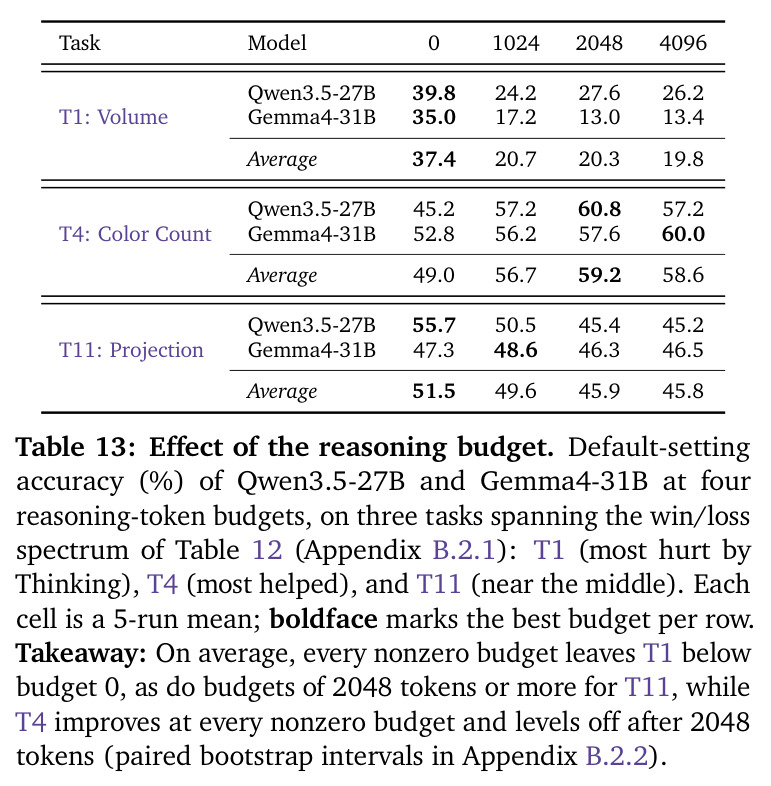
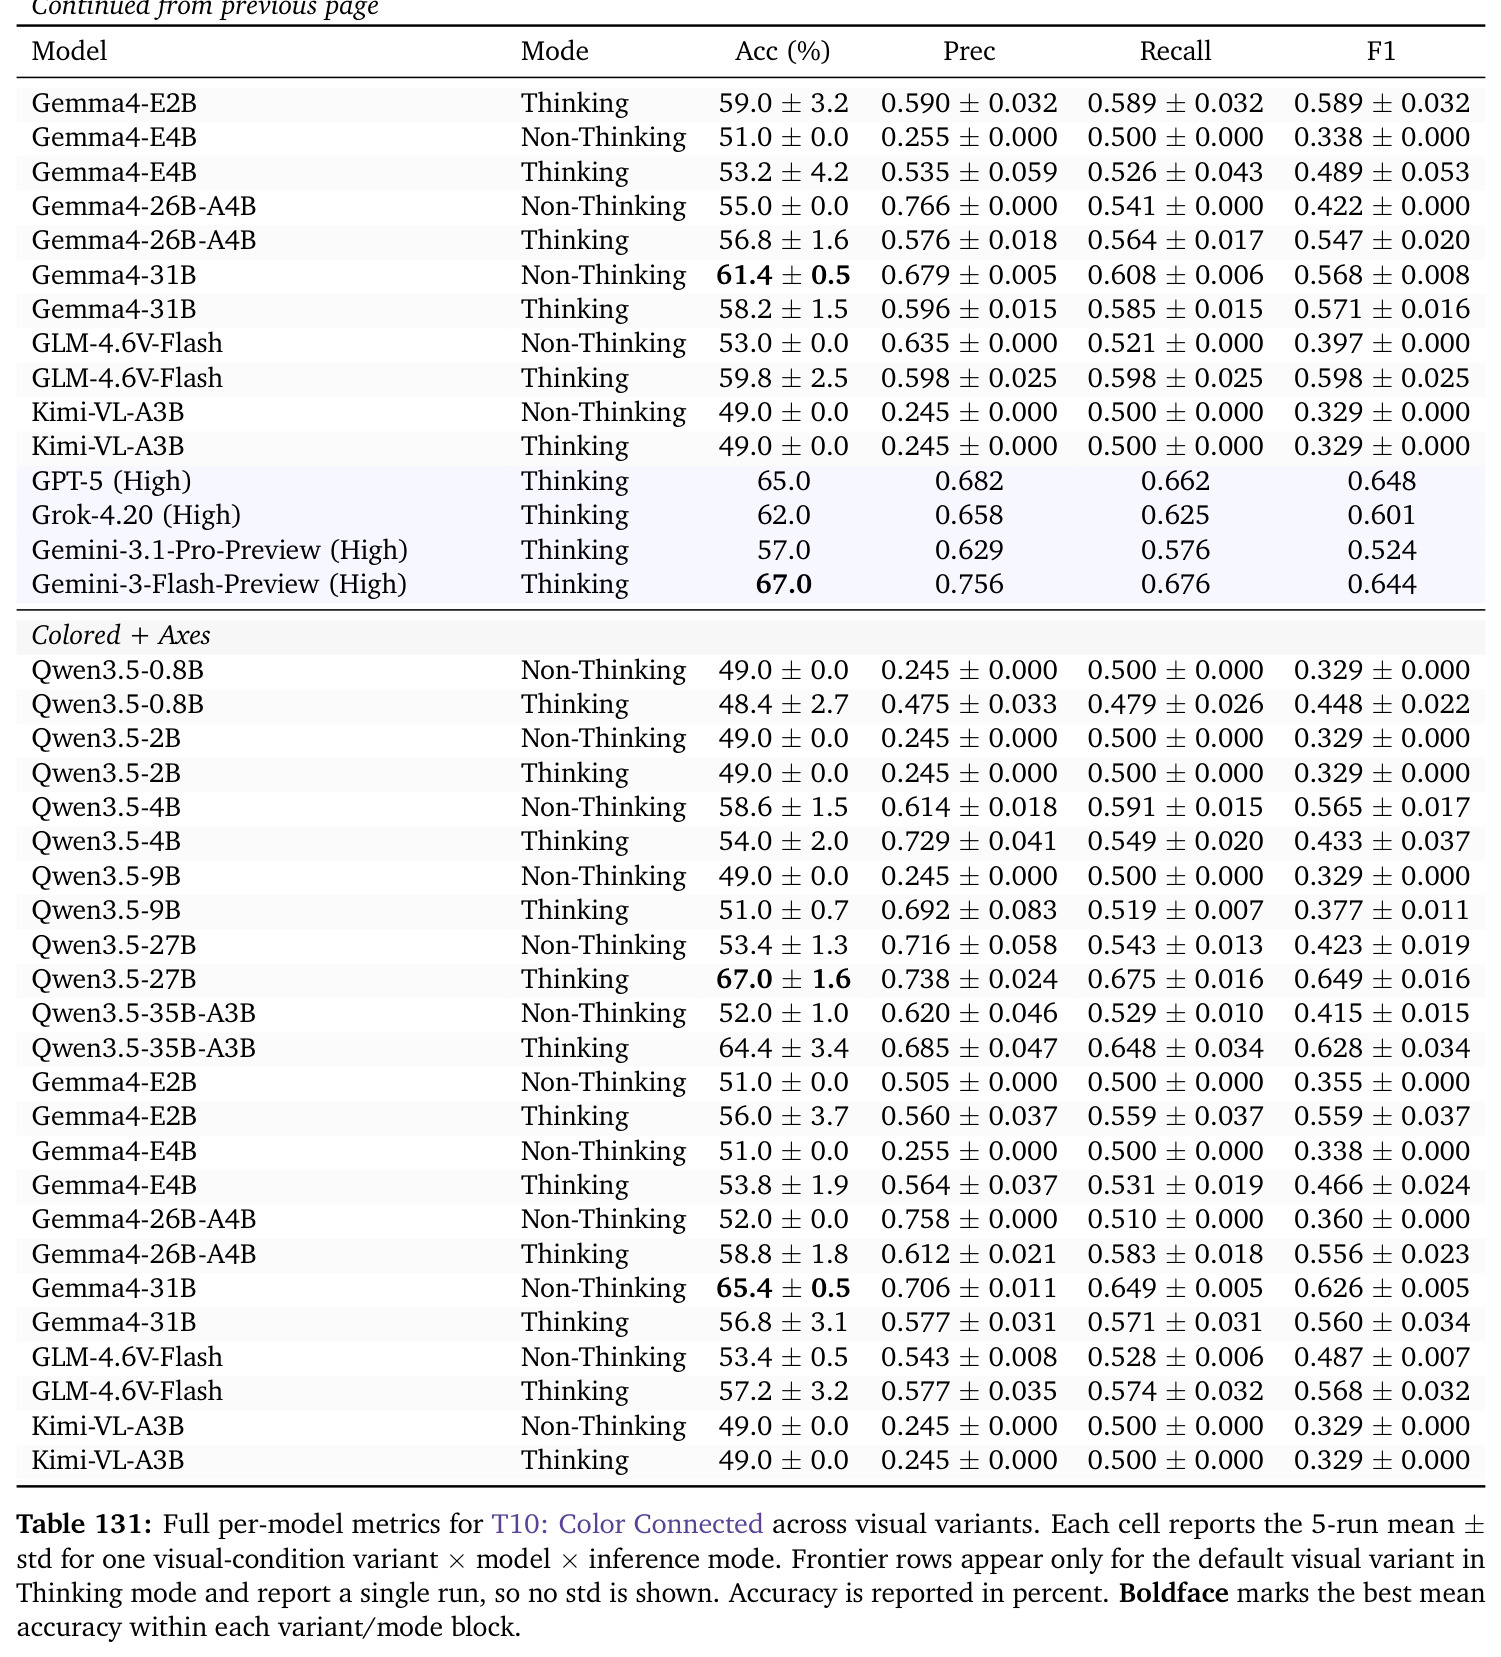
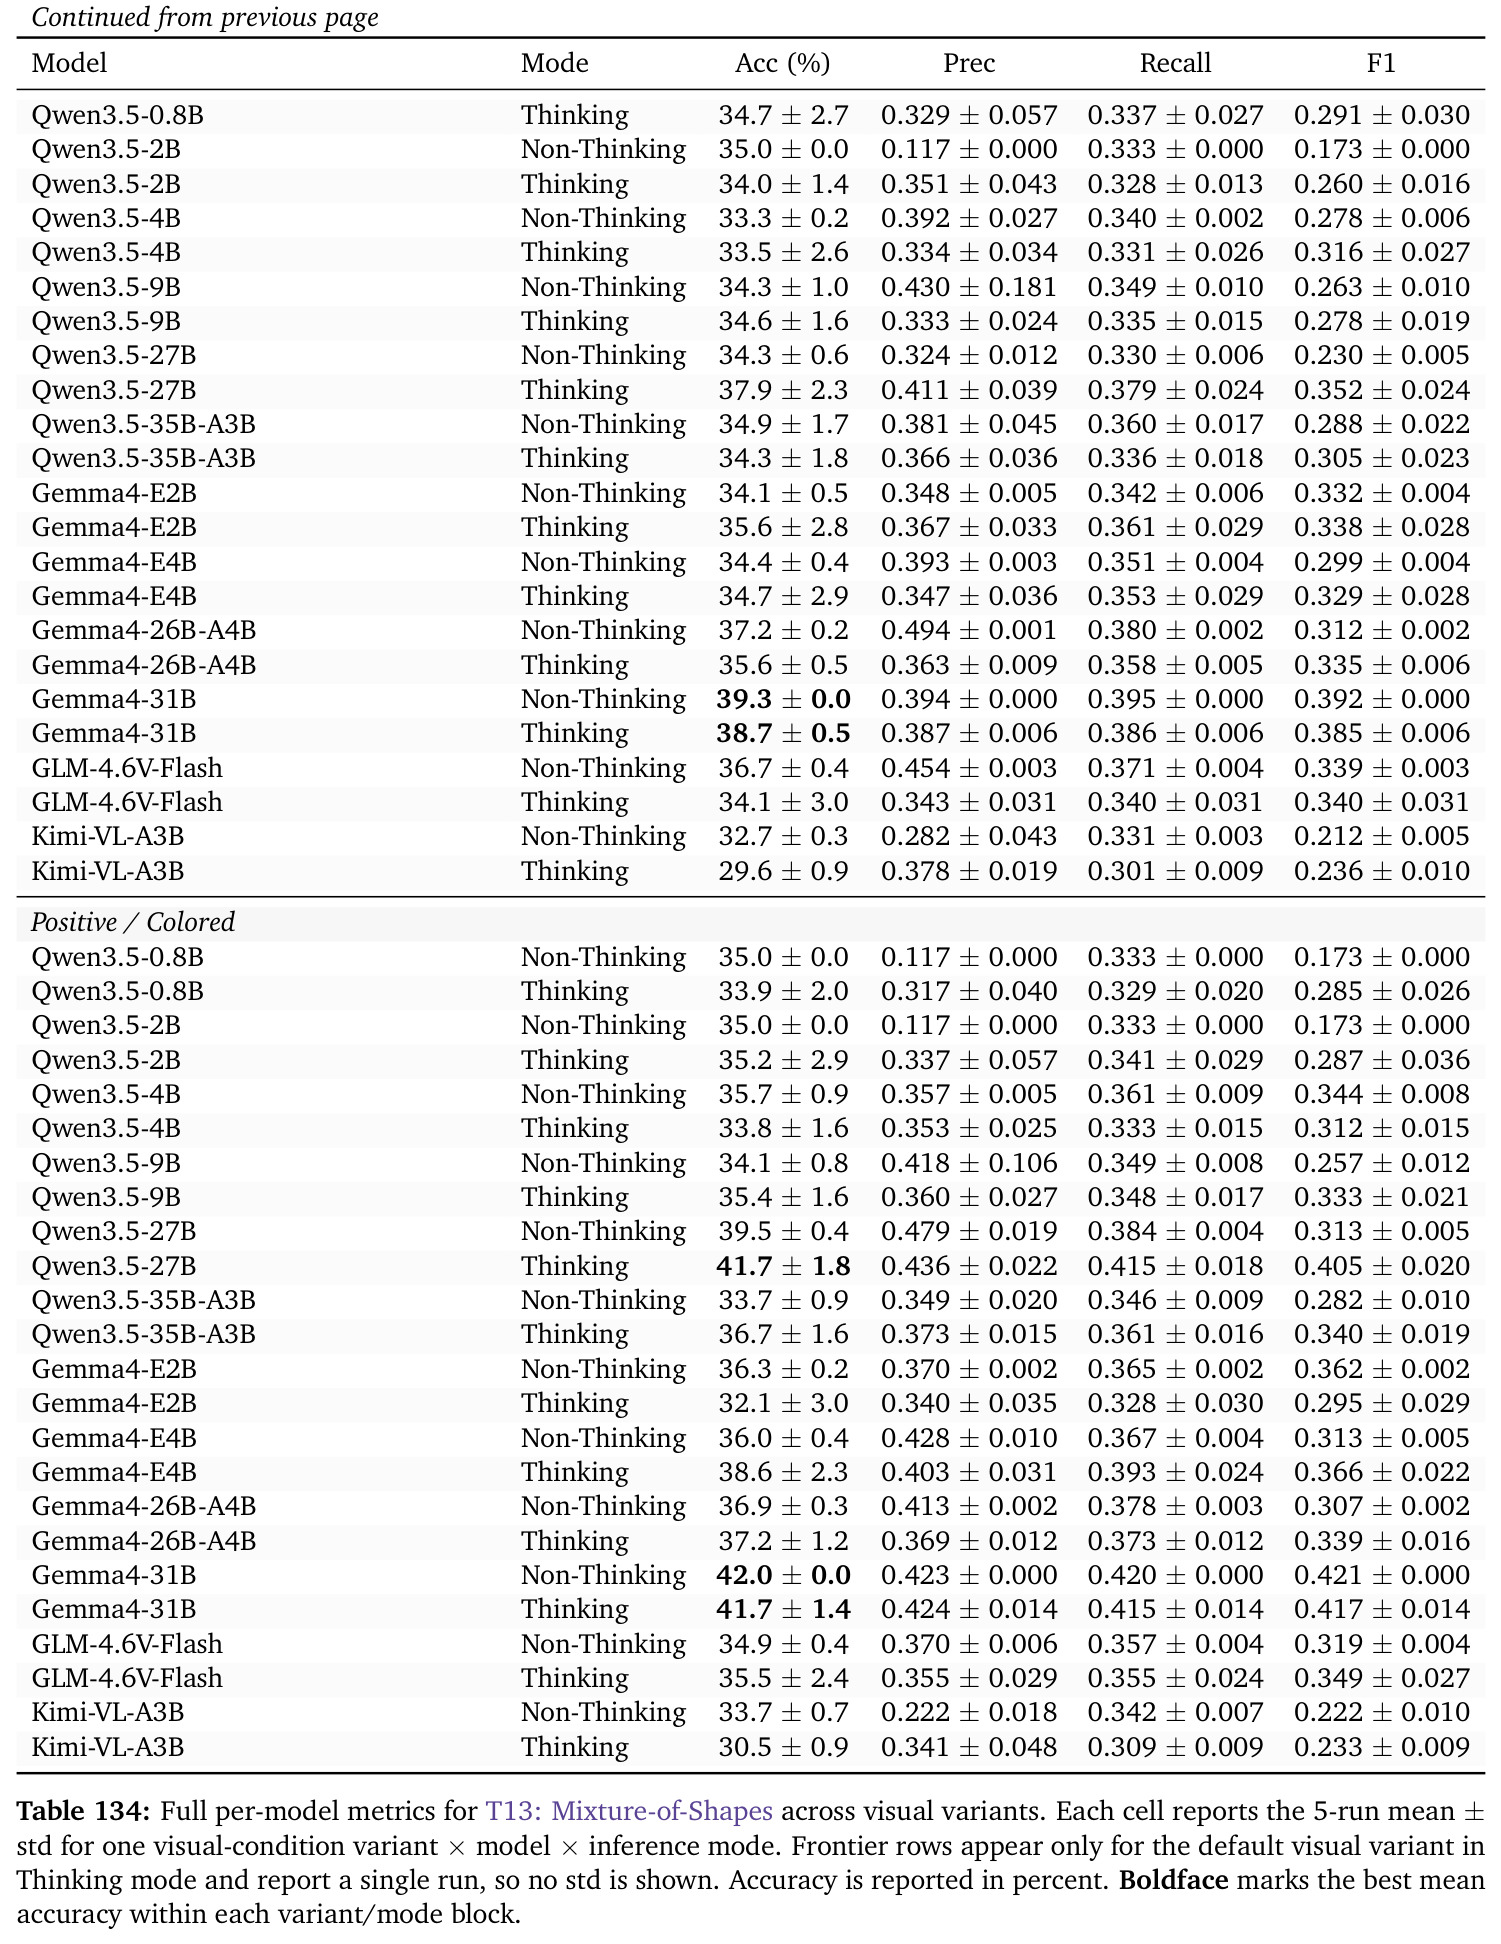
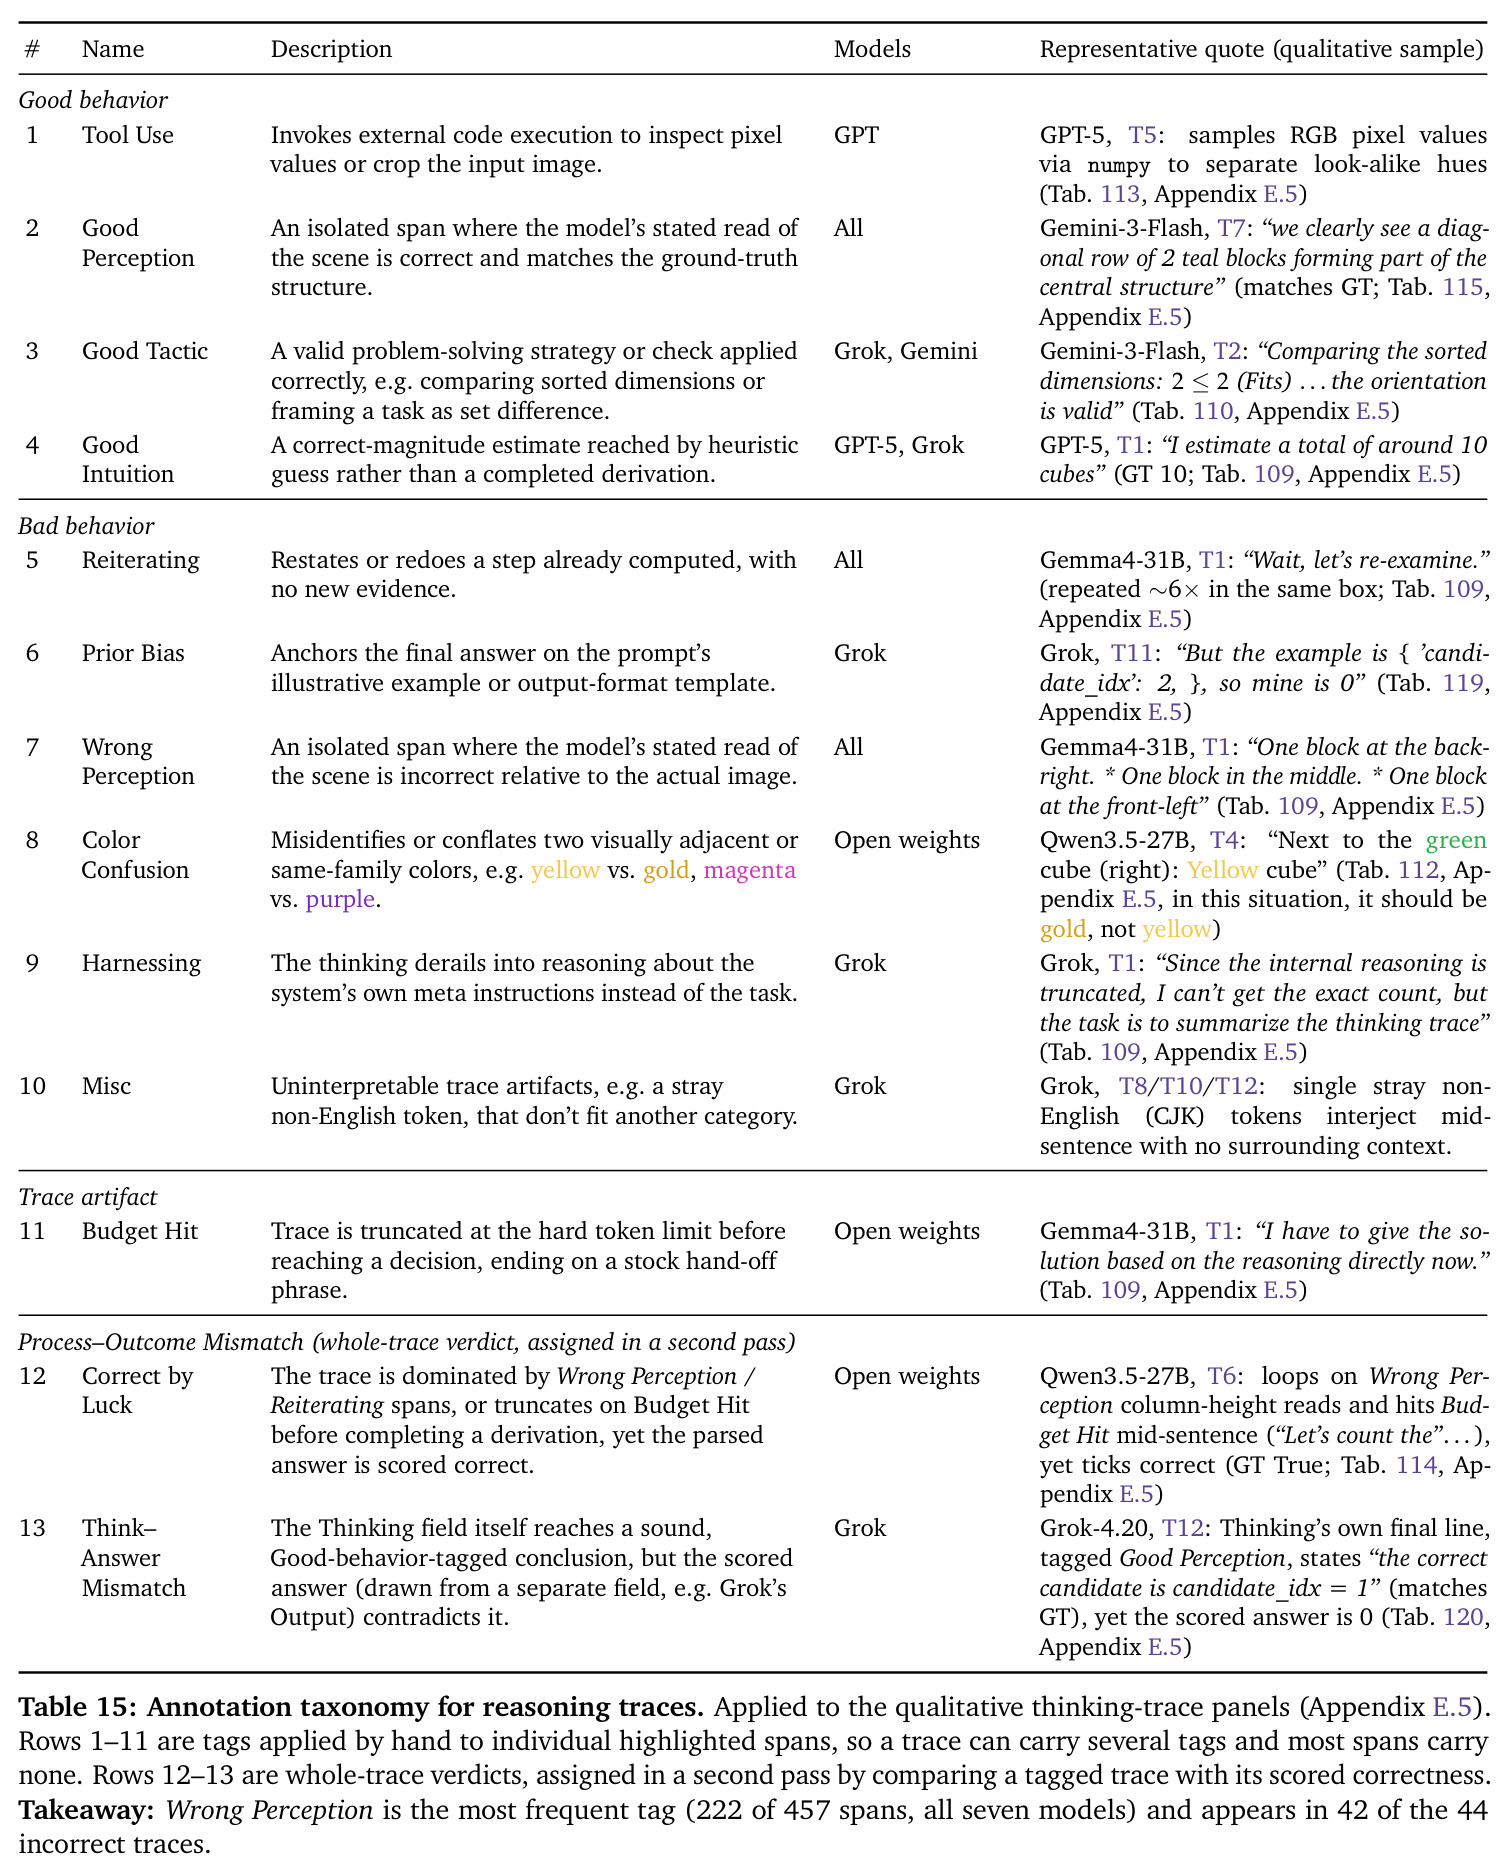
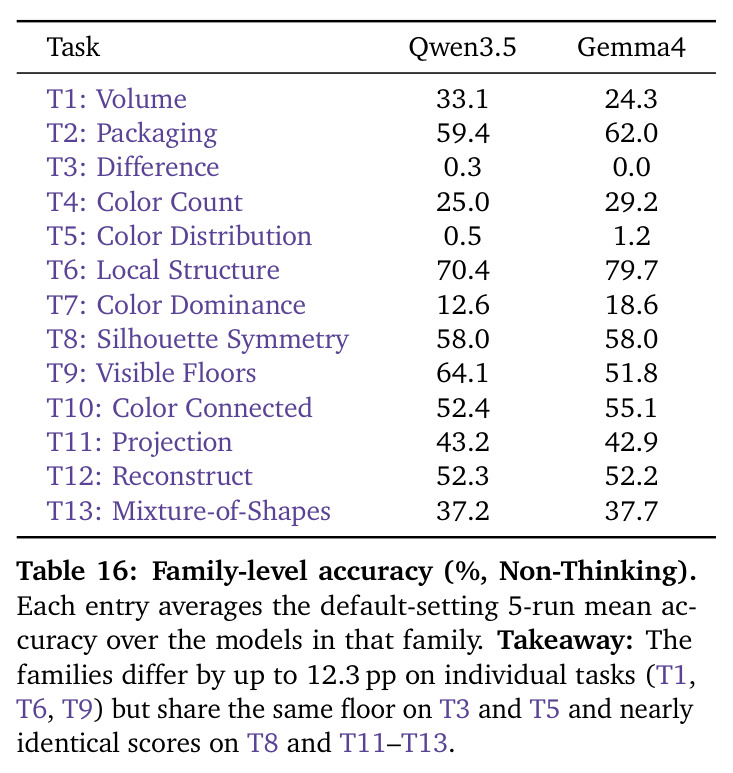
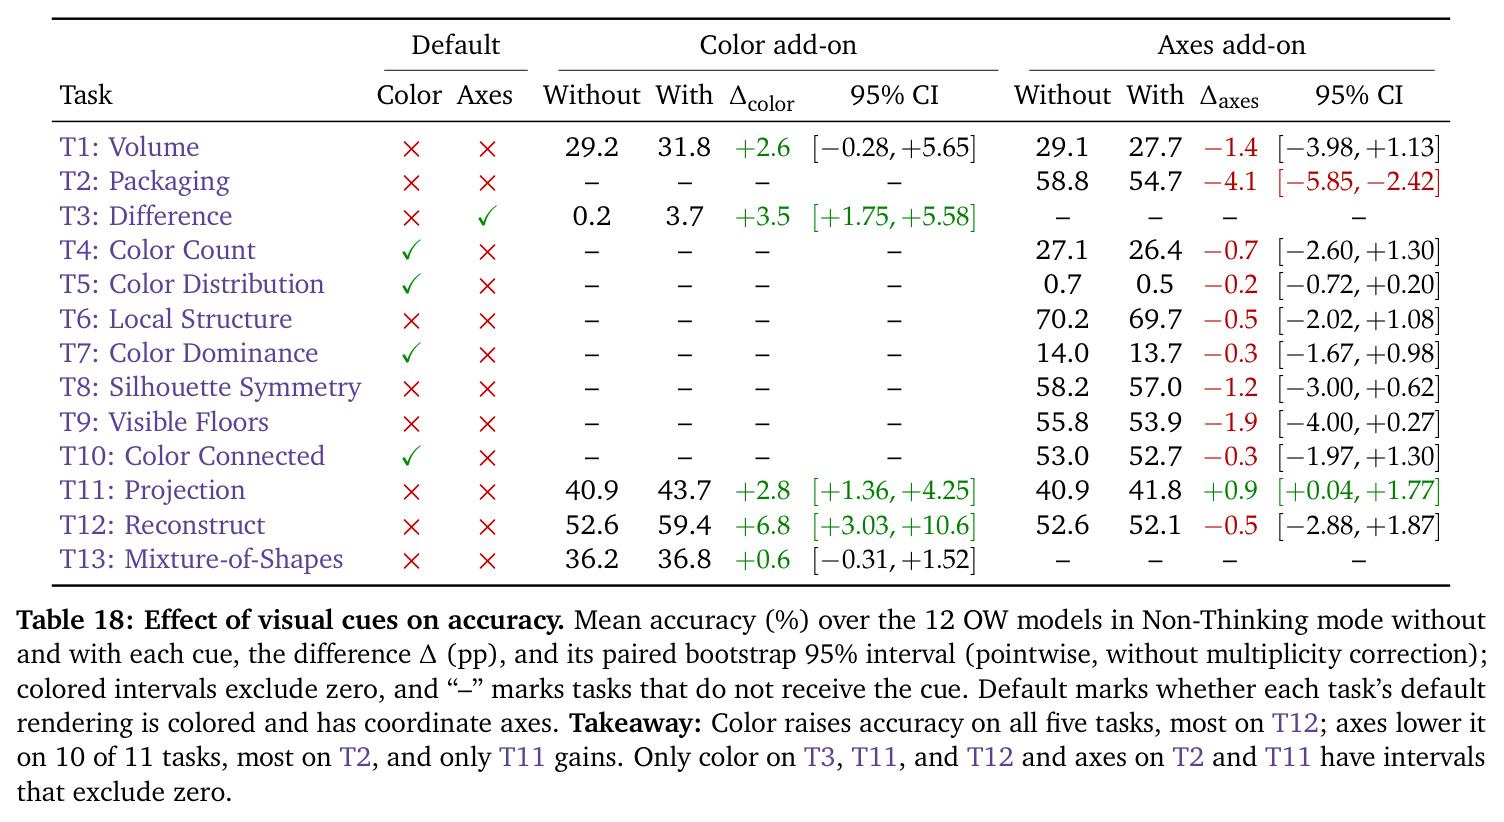
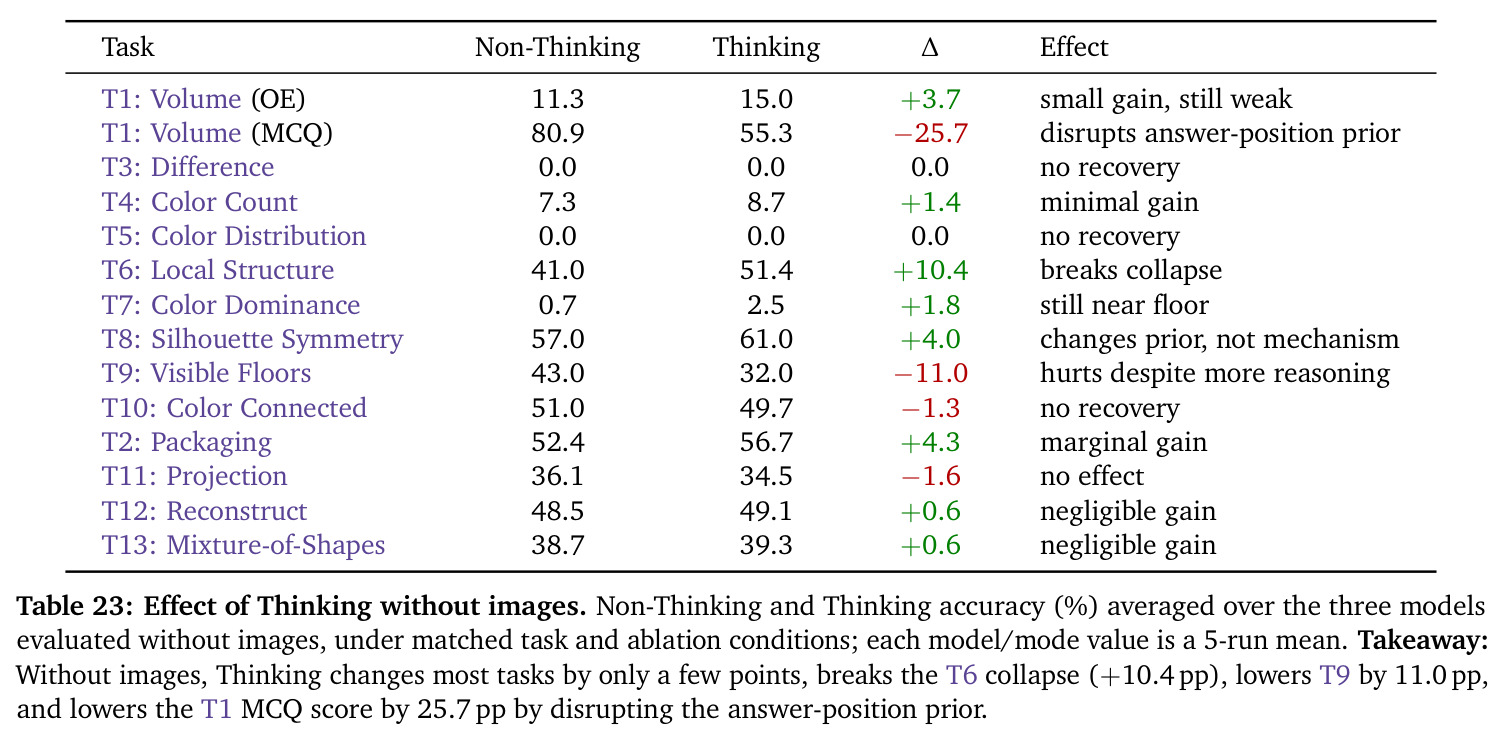
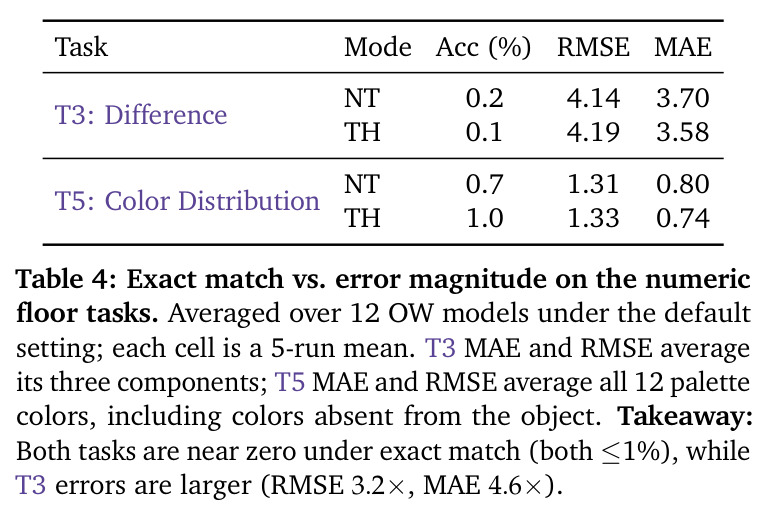
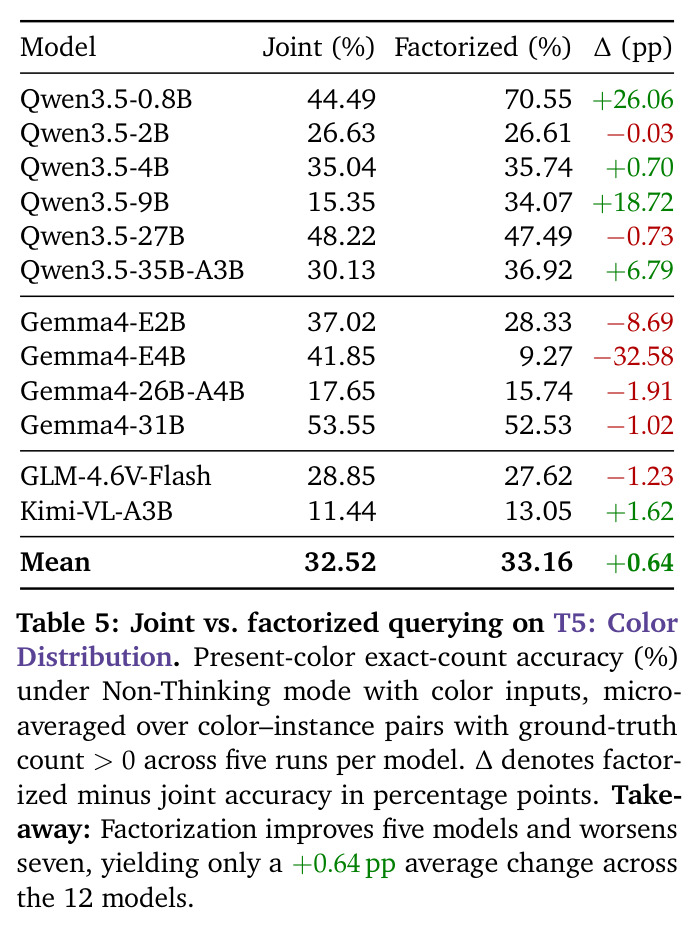
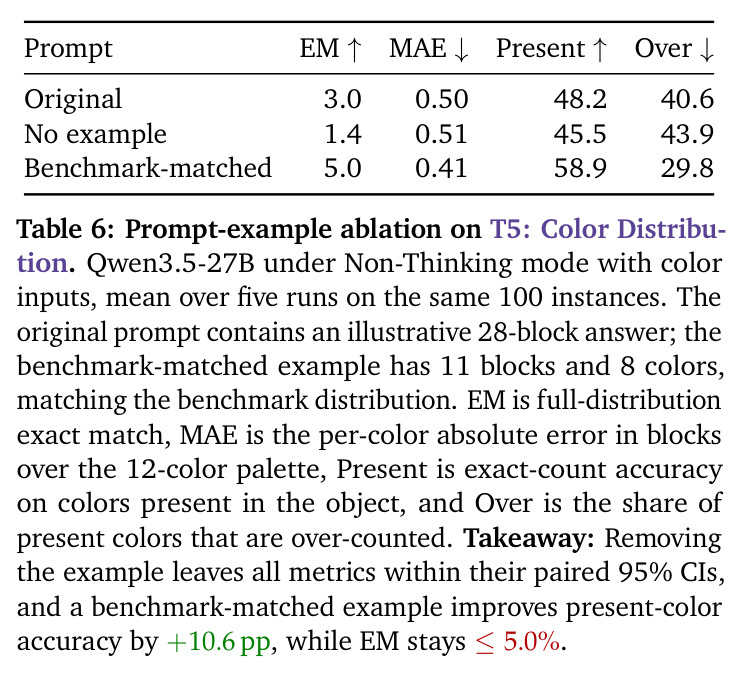
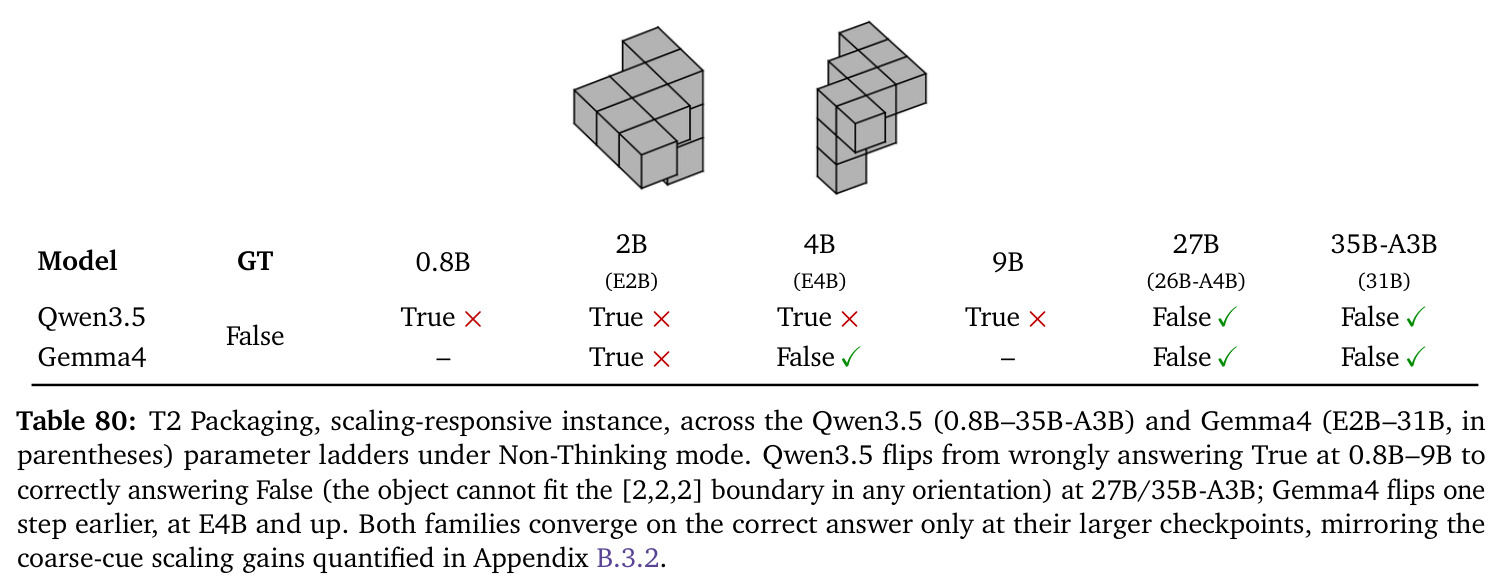
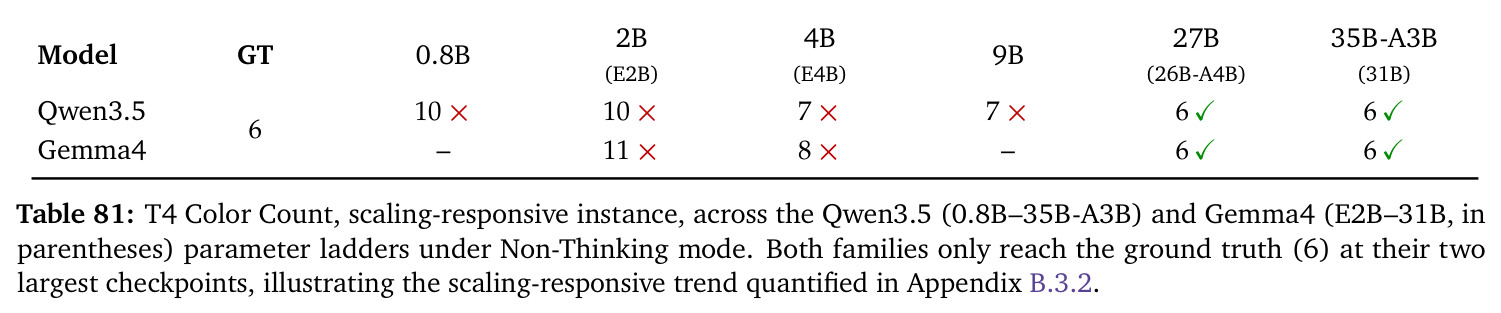
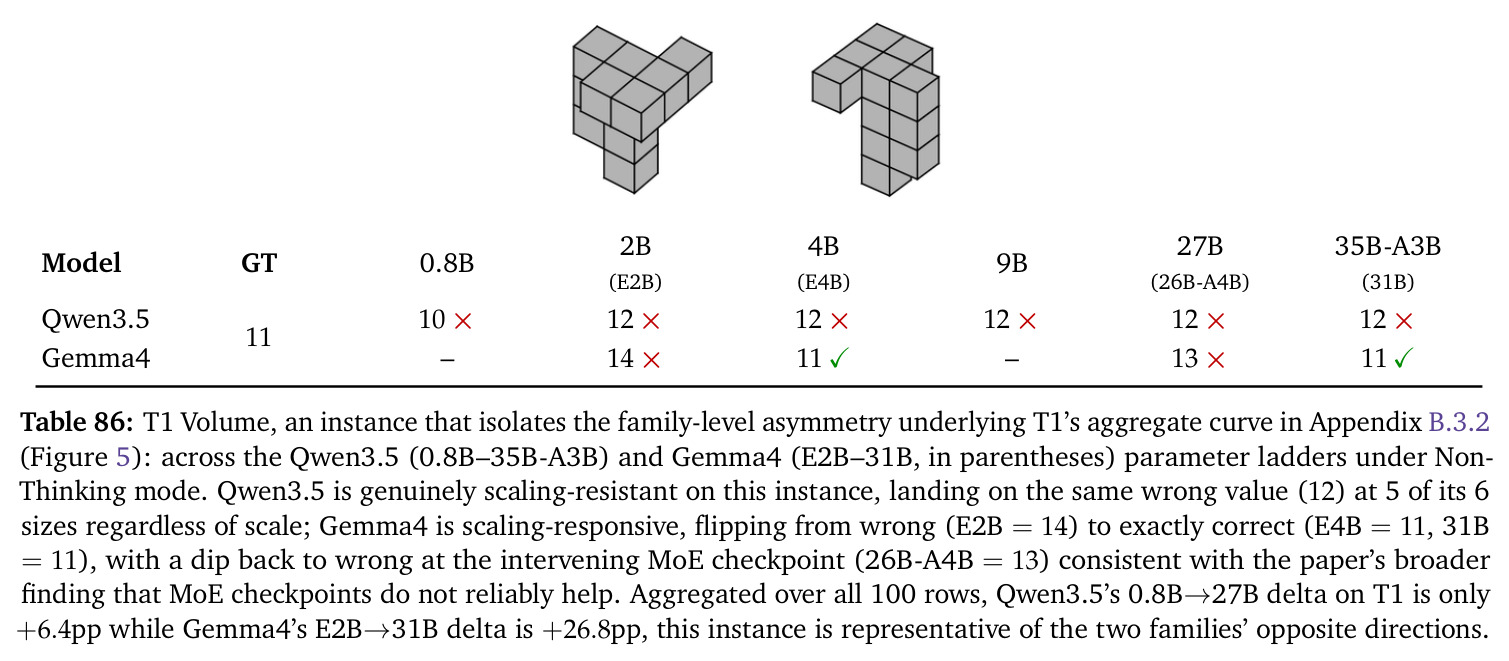
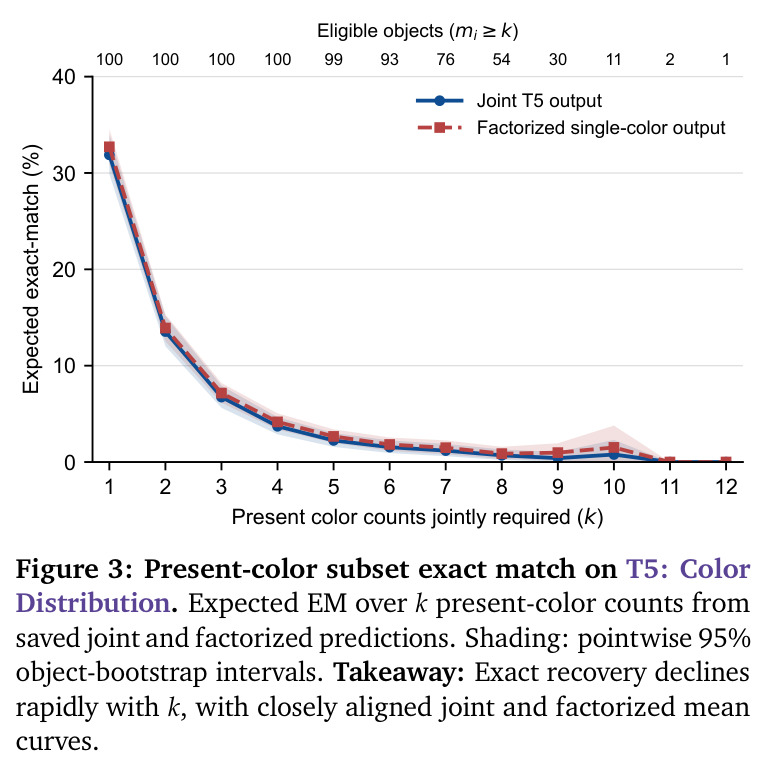
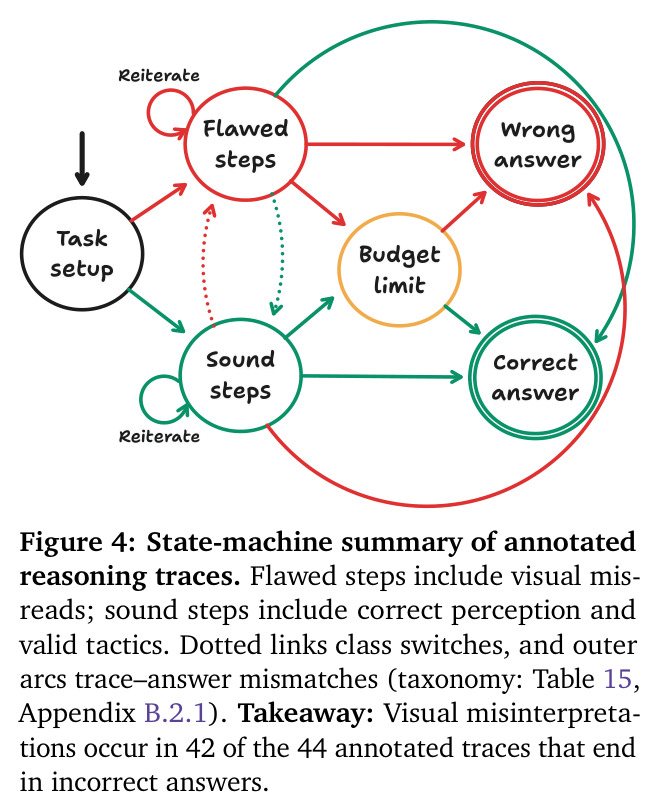
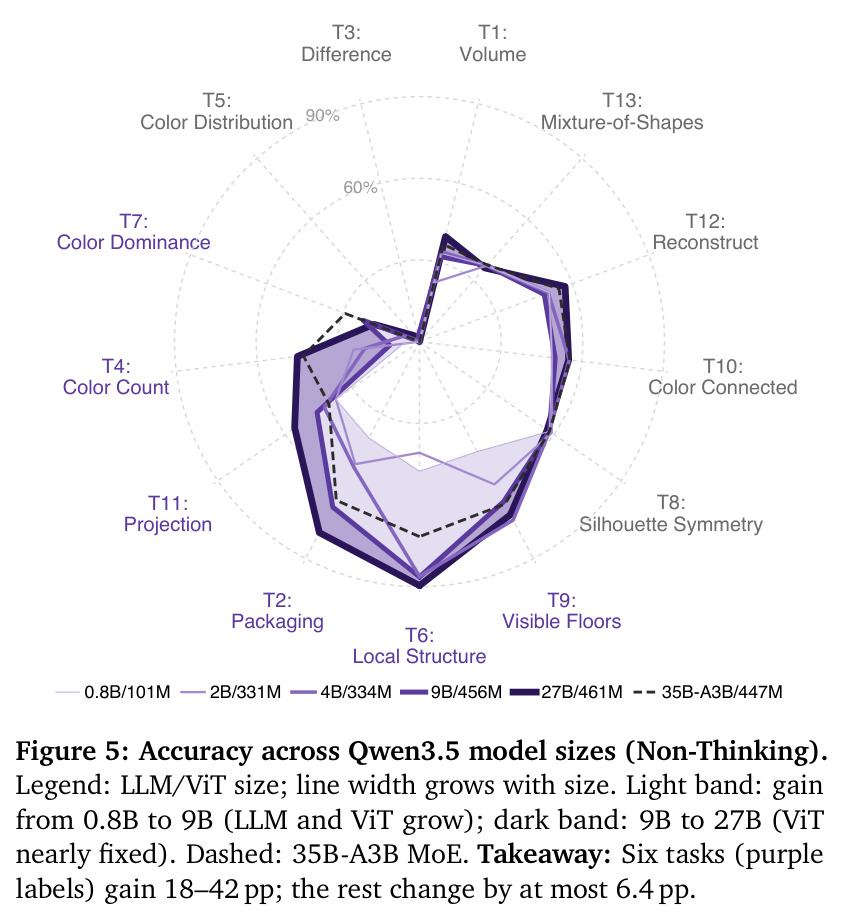
四条主发现。第一,精确计数不可靠且学会了也用不好:T5 上人类 93.3%、最佳 VLM 仅 7.2%,逐色 MAE 平均 0.80 差于常数策略的 0.69;因子化查询只把出现色单色计数从 32.5% 提到 33.2%,合并后全分布 EM 为 0.0%;2D 拼图使 Qwen3.5-27B 从 3.0% 升至 52.4%(+49.4 pp,MAE 0.50→0.11),说明 3D 呈现本身放大错误;LoRA 微调把 T5 提到 68.6%,但看图答 T7 仅 35.0%,把自己的计数当文本输入则达 74.2%(+39.2 pp),计数完全正确时 99.4% 对看图 40.8%——恢复属性不等于一致使用,且 12 个模型的 T7 回答与自己 T5 计数仅 21.6% 物体吻合(随机 2.4%)。第二,推理有选择地帮助单项判断:Thinking 使 T4 +13.9 pp、T2 +13.8 pp,但 T5 停在 0.7–1.0%;加大预算反而有害——T1 从 37.4% 跌至 19.8%(4096 token)、T11 从 51.5% 降至 45.8%;44 条错误轨迹中 42 条含未被纠正的视觉误读。第三,规模与视觉提示有选择性:Qwen3.5 从 0.8B 到 27B 仅 6 个任务 +18–42 pp,其余 ≤6.4 pp;MoE 平均 43.1% 低于稠密 46.8%;颜色叠加仅 T12 +6.8 pp,坐标轴对 T5 无益;但探针证明计数信息存在于视觉特征中(连接器输出探针 65.0% 对模型 3.0%)。第四,准确率不等于视觉推理:无图时三模型 T10 恒答 0 得 51%、T9 恒答 3 得 43%;T1 改固定布局 MCQ 平均 +39.0 pp(最高 +57.8 pp),Gemma4-31B 无图全选第三项得 100%。总体:人类平均 70.0%,最佳前沿 Gemini-3-Flash 51.5%,模型仅在 T2、T6 上超过人类置信区间。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| T5: Color Distribution(逐色计数) | 精确匹配 EM | 最佳 VLM 7.2%;LoRA 微调 Qwen3.5-27B 后 68.6% | 人类 93.3%(n=30) | 微调 +65.6 pp,但仍落后人类 24.7 pp |
| T5 2D 拼图对照(Qwen3.5-27B) | EM / 逐色 MAE | 2D 呈现 52.4%,MAE 0.11 | 3D 呈现 3.0%,MAE 0.50 | +49.4 pp(95% CI [+39.8, +59.0]) |
| T7: Color Dominance(一致使用检查) | EM | 微调模型:看图 35.0%;自己计数作文本 74.2% | 计数完全正确时文本条件 99.4% vs 同物体看图 40.8% | +39.2 pp(95% CI [+26.8, +51.4]) |
| 冻结特征探针(T5 逐色计数) | EM | 注意力探针:Qwen3.5-27B 编码器 61.7%、连接器输出 65.0%(800 训练物体) | VLM 自身 3.0%;100 物体平均特征探针 ≤3.5% | 证明信息在视觉特征中,瓶颈在语言模型的使用环节 |
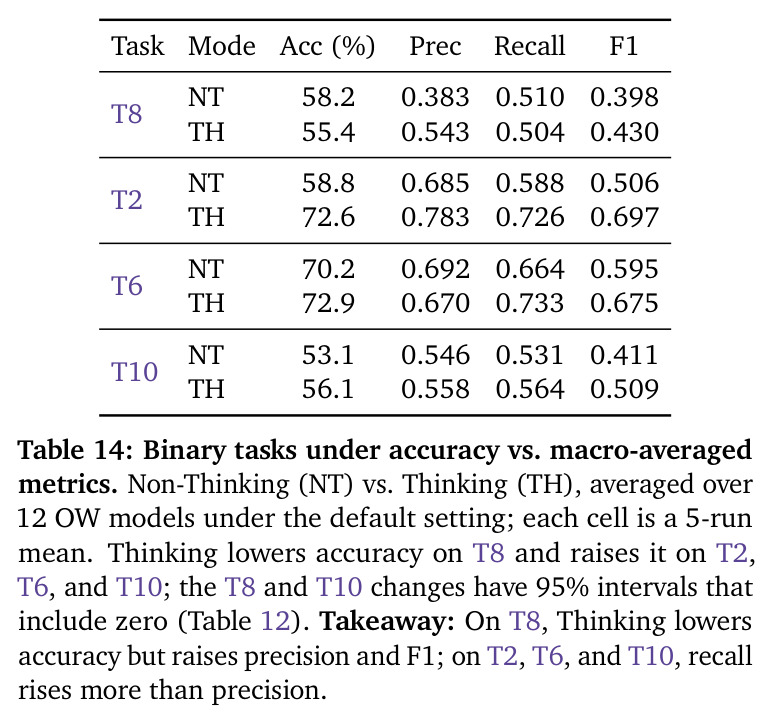
| T4: Color Count(思维链推理) | EM(12 开源模型平均) | Thinking 模式 +13.9 pp | Non-Thinking 模式 | 但 T5 仍停在 0.7–1.0%,精确答案未改善 |
| T1: Volume 固定布局 MCQ 对照 | EM | 正确项固定第三位:平均 +39.0 pp(单模型最高 +57.8 pp);Gemma4-31B 无图 100% | 开放式回答 | 揭示格式捷径:准确率提升可以完全不依赖图像 |
| 全任务平均 | EM | 最佳前沿 Gemini-3-Flash 51.5% | 人类 70.0%,最佳常数基线 36.7% | -18.5 pp,仍显著落后人类 |
局限与改进
作者承认:场景是程序化体素与几何基元的受控渲染,外部效度有限,推广到真实或具身场景需考虑纹理噪声、光照变化与复杂几何;人类基线仅 30 人、每人每任务 1 题难度标定较粗;深层分析(token 级探针、内部隐状态、大规模微调)只在代表性家族(Qwen3.5-27B)与部分任务上进行。我的补充观察:2D 拼图对照并未分离遮挡、视图整合与布局效应(作者也承认),「3D 呈现放大错误」的归因还不够精细;探针仅在 100 个基准测试物体上评测,样本小、置信区间宽;调色板中 gold/yellow 等相似色相的混淆占相当大误差(2D 合并后达 89.8%),可能高估「感知失败」成分;图像移除与 MCQ 对照只在 3 个模型上重复;人类基线自愿者年龄段 16–35、经由作者人际网络招募,代表性有限;此外全文以英文提示评测,未涉及多语言效应,前沿模型只评测一次、缺少重复方差估计。
独立分析的弱点
弱点一,合成-真实鸿沟:体素场景与自然图像统计差异大,7.2% 这类极低分可能含分布外成分,改进方向是把诊断协议(互蕴含问题、无图对照、探针)小规模移植到真实渲染或扫描场景验证结论是否保持。弱点二,一致性诊断停留在行为层:论文用「T7 回答是否与 T5 计数吻合」度量一致使用,但未探查语言模型内部哪一层丢弃了计数信息,改进方向是逐层线性探针与因果干预(激活修补)定位信息断点。弱点三,微调目标单一:只对 T5 做 LoRA(仅语言模型),未见对 T5/T7/T10 的联合一致性训练,改进方向是设计惩罚相关答案分歧的损失(如让 T4 的答案严格等于 T5 计数中非零颜色数)做多任务对齐。弱点四,人类基线单实例:每人每任务仅 1 题,置信区间宽,改进方向是每任务多人多实例并把人类用时、置信度一并报告。弱点五,MCQ 对照布局单一:固定布局只测了「第三项正确」一种,改进方向是做布局×候选数量×正确项位置的因子实验,系统性量化格式捷径。弱点六,前沿模型评测一次且依赖厂商推理预算,跨模型可比性受 API 差异影响。
未来方向
作者提出:设计惩罚相关答案分歧的训练目标、先陈述中间结构再作答、探查语言模型内部层以解释可用信息为何未被可靠使用、把诊断扩展到自然与具身场景。基于本文成果可延伸:其一,把 2D→3D 呈现作为课程学习信号(2D 拼图带来 +49.4 pp 说明由易到难训练可行);其二,用 BedBench 的程序化生成器做无限 RL 数据源,配合一致性奖励(T5/T7 联合正确才给分);其三,把注意力探针读出蒸馏回 VLM 或作为辅助解码头,弥合「特征有、行为无」的落差;其四,研究「文字化中间步骤」何时有效——T4 的坐标格组织成功而 T1 的反复视图对齐失败,可据此设计自适应推理预算;其五,扩展到多视角视频与机器人操作中的物体属性持续一致性检验;其六,把捷径检查(无图、固定布局)作为所有空间基准的标准配件推广。
复现评估
复现友好度较高:数据集在 HuggingFace 开源(leduckhai/BedBench),项目页提供生成器与任务说明;任务程序化生成、真值精确、可无限扩充。开源模型全部为公开权重,贪心解码、每条件 5 次重复降低随机性,评测协议(结构化模板、EM/MAE/F1、按物体的配对自助置信区间、提示模板)在附录完整给出。复现行为实验的主要成本是 16 个模型的推理(含 27B–35B 级,需高显存单卡或多卡);诊断部分门槛更高:LoRA 微调 Qwen3.5-27B 需 800 样本训练(编码器冻结,单节点 A100 级可行),探针本身轻量但需先抽取 14 个编码器的特征。人类基线可省略或缩减。整体属于「生成器 + 真值 + 协议」三件套齐备的基准论文,非常适合作为后续 3D 诊断与训练研究的底座。
论文图表