SpaceCast-Bench:评估视觉语言模型预测性空间推理的诊断基准 SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
首个预测性空间推理诊断基准:最强模型58.0%远低于人类87.2%,空间专用模型接近随机
前置知识
视觉语言模型(VLM)
以大语言模型为骨干、接入视觉编码器的多模态模型,输入为图像(或图像序列)加文本,输出文本。典型代表包括 GPT-5.6、Gemini 3.5、Qwen3-VL、Claude Sonnet 等。它们通过海量图文对训练获得视觉感知与语言推理的联合能力,但通常缺少显式的 3D 几何表征——看到的更多是 2D 像素模式而非可操作的场景结构。
本文评估对象全部是 VLM,理解其'感知强、几何弱'的先天倾向,才能理解为何模型在静态感知上得分不低、一旦要求在脑中'移动桌子'就大面积失败。
参考框架:自我中心 vs 环境中心
描述空间关系时的坐标系选择。自我中心(camera-centric)以相机视角定义前后左右;环境中心(world-centric)以房间固定方位(东南西北)定义;对象中心(object-centric)以某个物体的'面朝方向'为基准(如'想象你是杯子并面向法压壶')。人类可以在这几套坐标系间自如换算,这称为视角采择(perspective taking)能力。
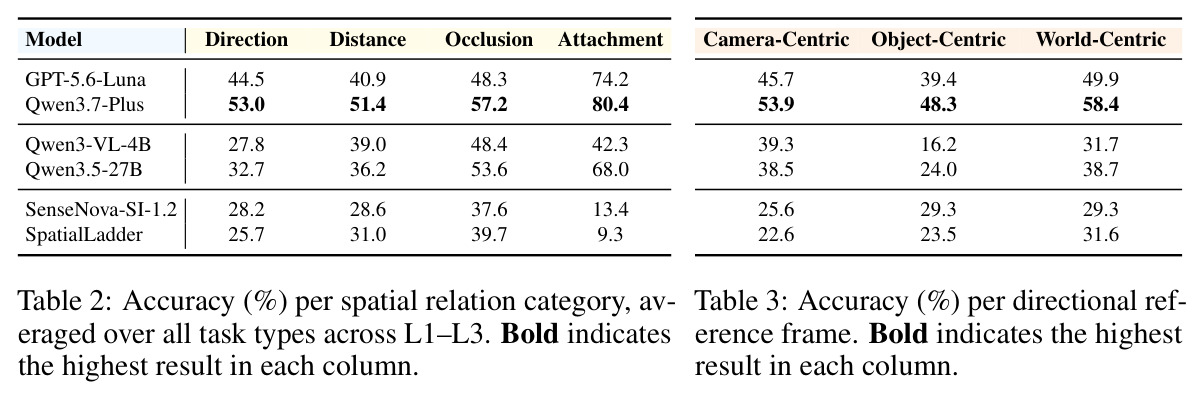
本文 16 个任务中有 9 个方向任务显式区分这三种参考框架,实验发现对象中心是模型最弱项(最低仅 16.2%),这一维度是论文诊断结论的核心之一。
空间世界模型与心智模拟
世界模型指把环境表示成一种内部状态,使得即使动作后果从未被展示,也能预测干预后的环境变化(如 Ha & Schmidhuber 的世界模型、Hafner 的 Dreamer 系列)。对应到空间认知,就是从观察构建'心智场景',在想象中执行变换(移动、旋转),再查询新状态下的关系——即 observe-transform-infer 流程。
本文的评测对象正是这种能力:结果状态从不出现 在输入中,模型必须靠内部场景表示来'脑补'答案,这是论文与感知类基准的本质区别。
RGB-D 扫描与相机位姿
ScanNet/ScanNet++ 等室内扫描数据集提供:带标定相机位姿(位置+朝向)的 RGB 图像序列、逐像素深度图、重建出的场景级 3D 网格(mesh),以及实例级语义标注(每个物体属于哪一类、其 3D 轮廓在哪)。有了位姿和深度,就能把任何 3D 点投影到任意视角的图像上,也能做遮挡射线检测。
本文所有标签(方向、距离、遮挡、附着)都不是人工标注,而是从这些 3D 几何中程序化计算的;view chain 的深度校验、变换后的标签重算也全部依赖这套几何基础设施。
支持与附着关系(support/attachment)
物理场景中的依赖结构:如果一个物体(如桌上的鼠标)由另一物体(桌子)支撑或连接,那么移动支撑物时被支撑物会随之移动。本文用有向附着图形式化——父到子的边表示移动父物体连带移动子物体,边由表面接触、水平支撑重叠与语义相容性提议生成,每个子物体至多一个父物体,传递闭包决定共动集合。
附着图是 L2 预测题的关键设计:'把桌子移走后鼠标在哪'要求模型理解传递性共动。实验显示这是专用空间模型最弱的关系类型(低至 9.3%)。
后训练:SFT 与 GRPO
SFT(监督微调)直接在问答对上训练模型模仿标准答案;GRPO 是类强化学习的在线策略训练,对同一问题采样一组回答、按答案正确性计算相对优势来更新策略,常配合 KL 惩罚防止偏离过远。两者通常都以 LoRA 低秩适配器的形式实施,只训练少量参数、冻结视觉编码器。
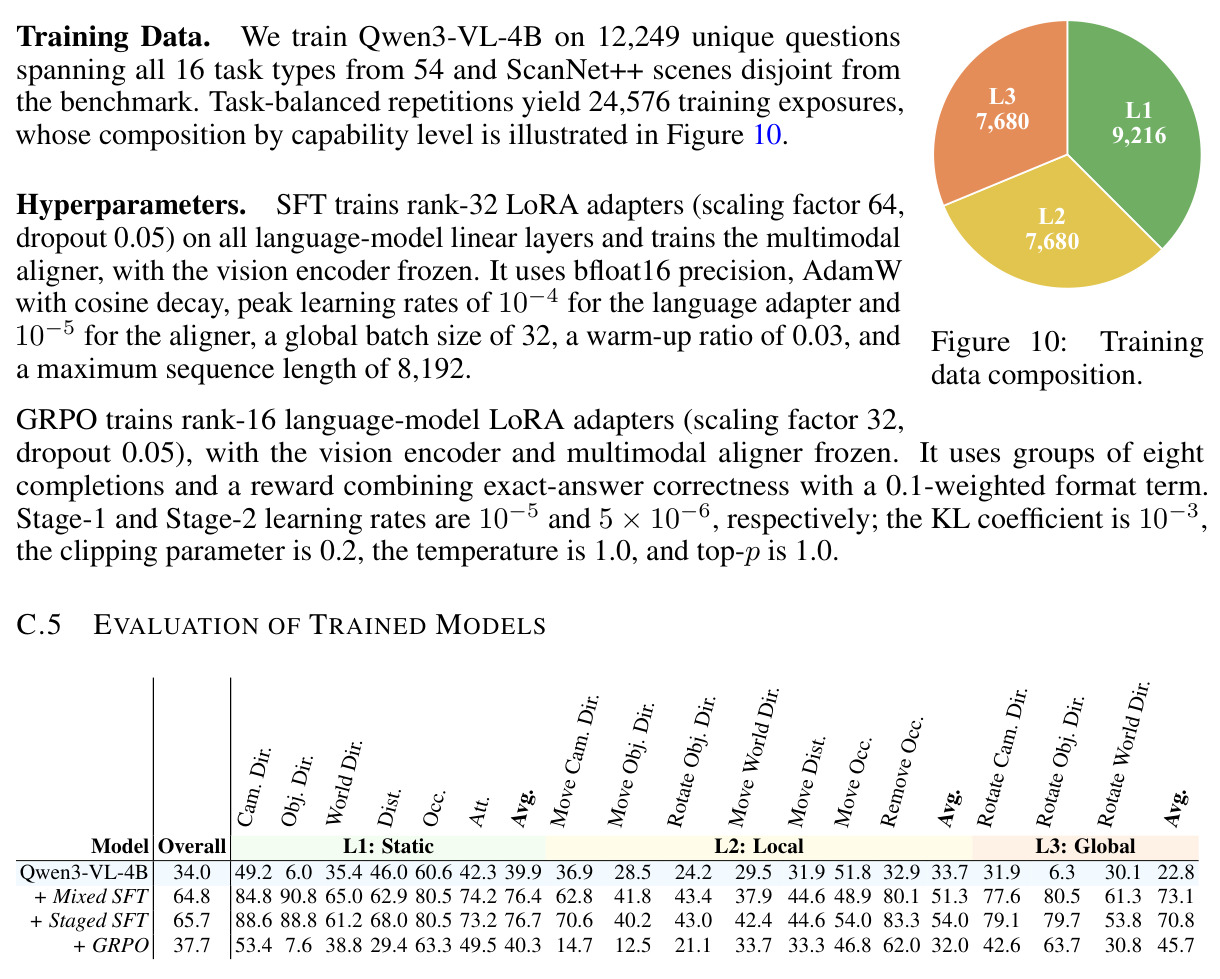
论文第 4.4 节用这两种范式在程序化生成的训练集上训练 Qwen3-VL-4B:SFT 提升巨大(+31.7pp)而 GRPO 几乎无效(+3.7pp),这一对比是关于'如何教模型空间预测'的重要实证发现。
研究动机
现有空间推理基准——单图类的 What'sUp、EmbSpatial-Bench、SpatialRGPT-Bench、3DSRBench,多图/视频类的 SPAR-Bench、ViewSpatial-Bench、MMSI-Bench、VSI-Bench——存在一个共同的根本局限:它们评估的是'空间感知',即把输入帧中已经可见的空间关系读出来。然而真实世界的空间智能需要'预测性空间推理':构建场景的心智模型、预判干预如何改变场景、并对从未被观察到的结果做关系推断。论文开篇给出典型场景:机器人要取回压在书下的信封,而书上放着一个杯子——为安全操作,它必须先预测'滑动书会带动杯子',于是决定先移开杯子。这要求构建场景心智模型、模拟动作后果、并据此修正计划,是安全操作与多步规划的前提,也正是空间世界模型(Ha & Schmidhuber 2018;Hafner et al. 2019/2025)必须学会的核心:以支持'预测未见后果'的形式表示环境。尽管这种能力对具身智能至关重要,此前没有任何基准以受控、可诊断分解的方式评估它。
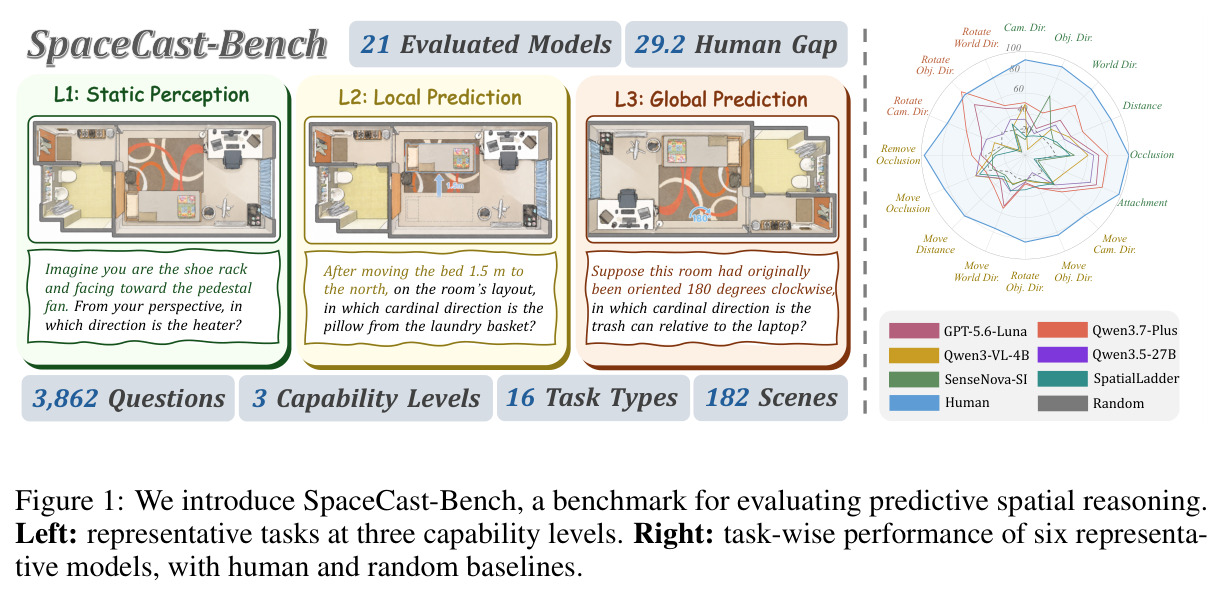
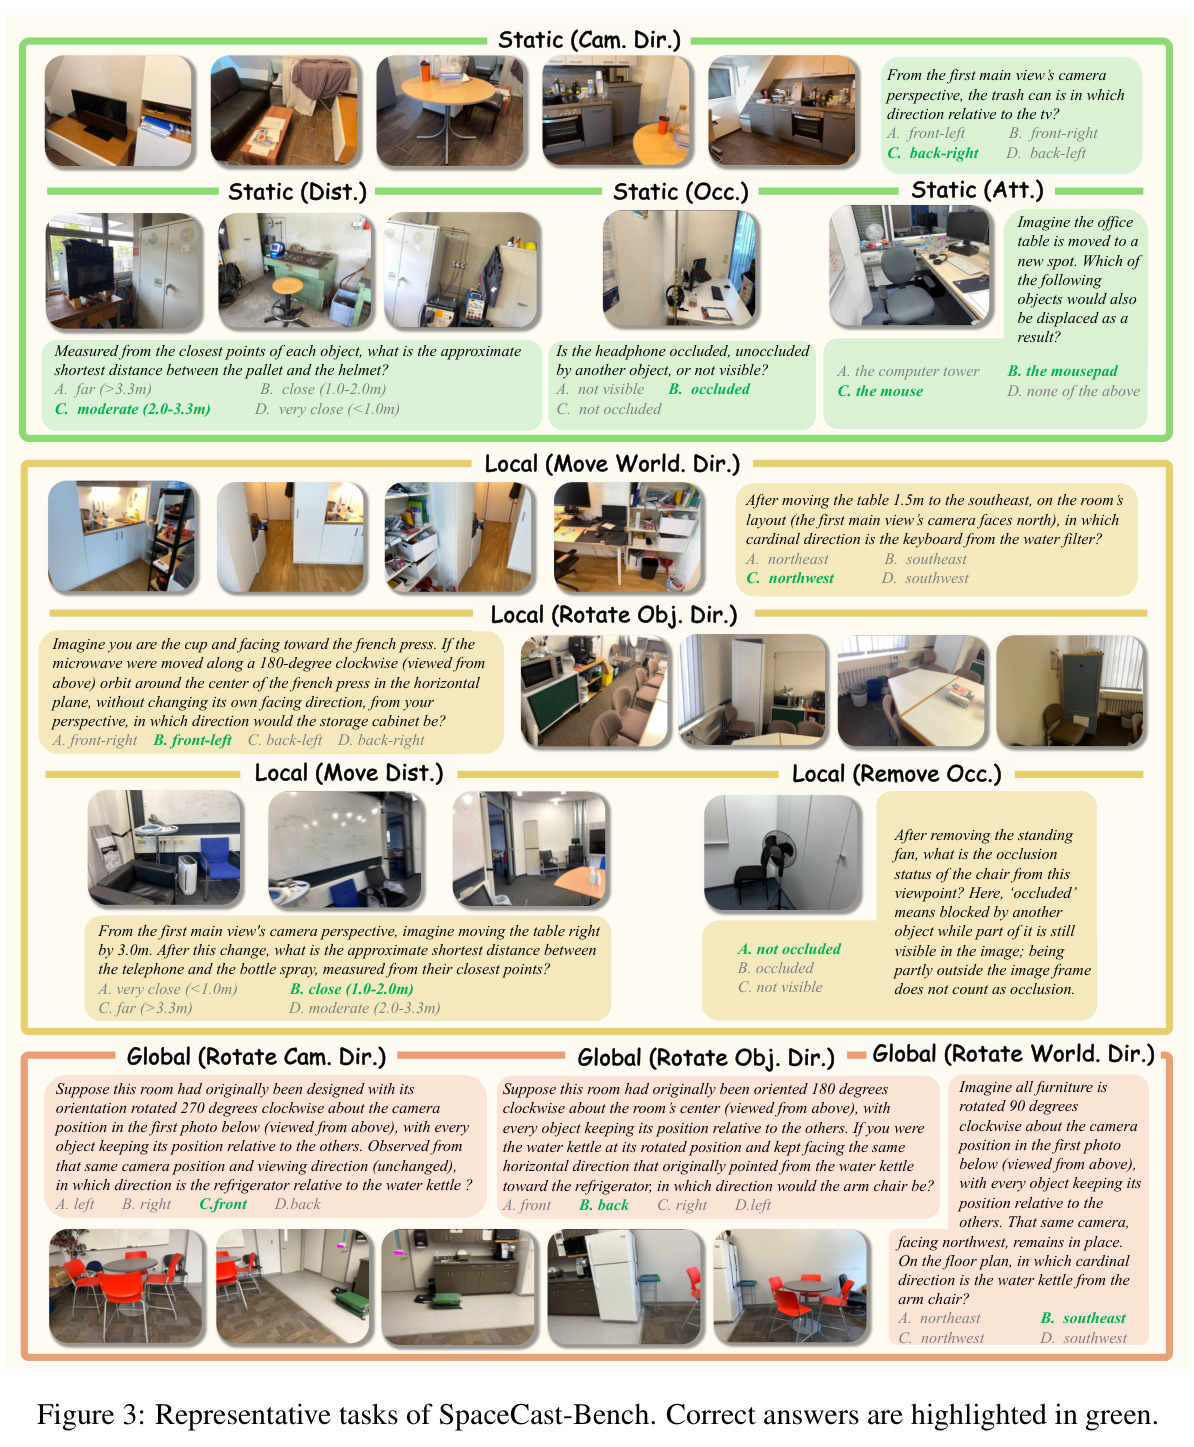
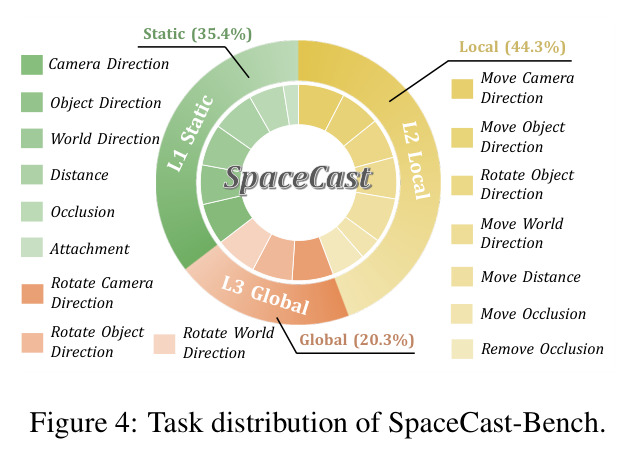
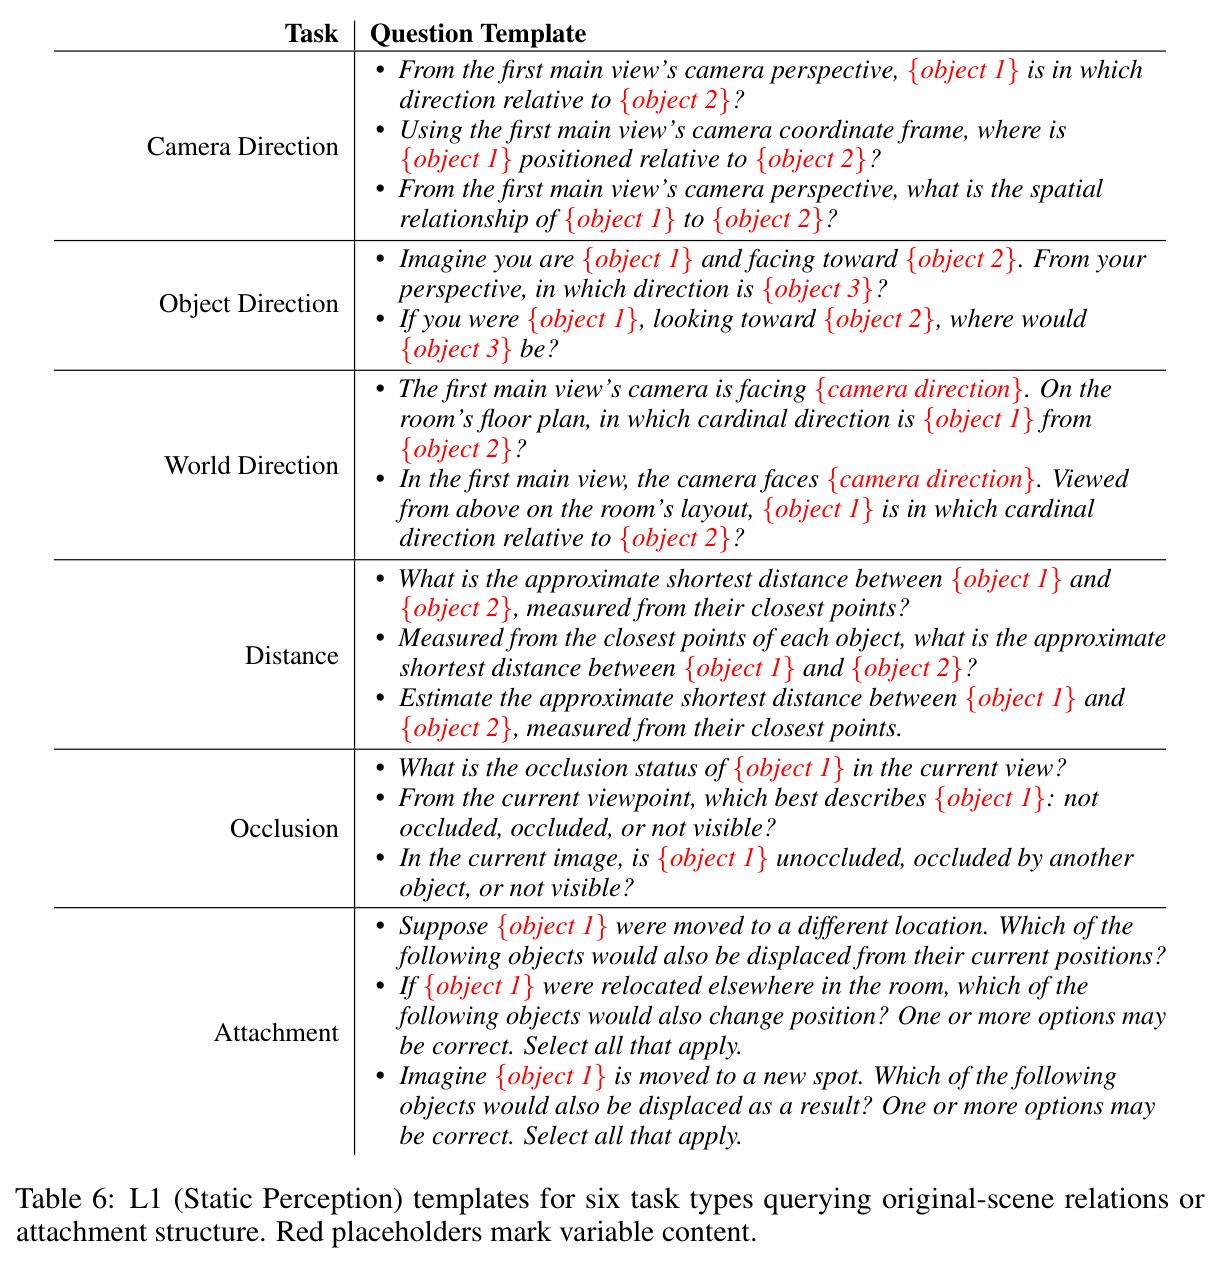
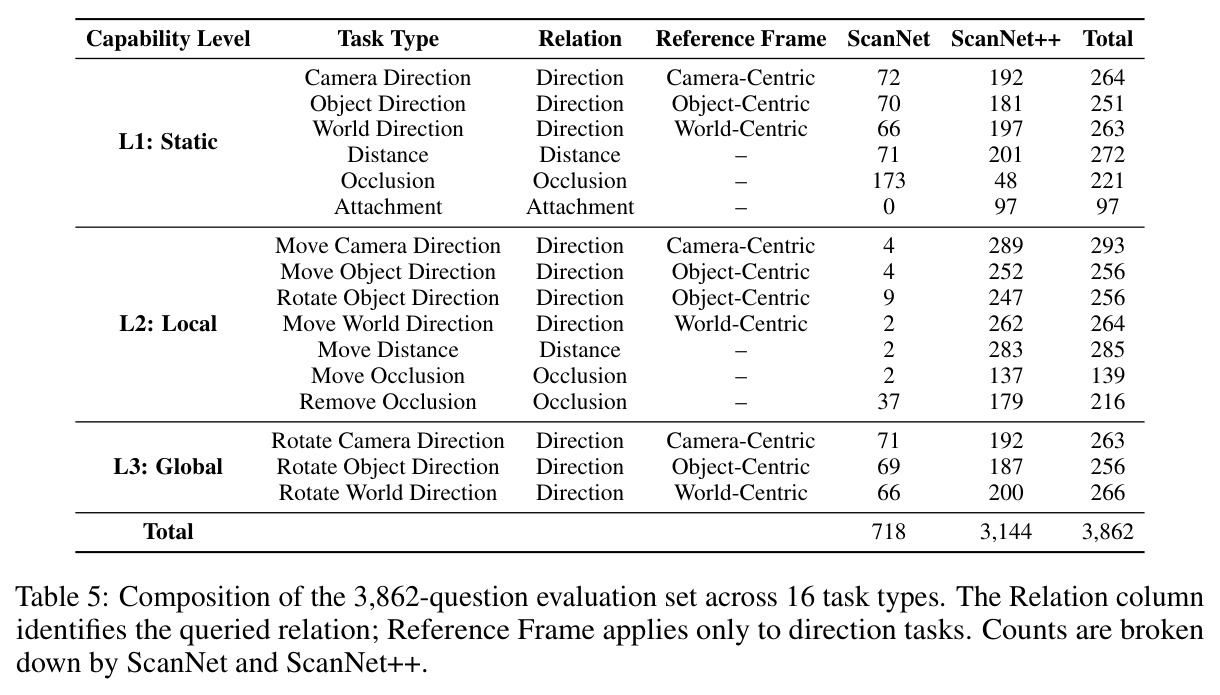
本文的目标是本文的目标是构建第一个直接、诊断性评估预测性空间推理的基准 SpaceCast-Bench:包含 3,862 道多选题,来自 182 个真实室内场景,横跨 16 种任务类型。任务形式化为:模型只观察到变换前的有序 RGB 视图序列 $O = (I_1, \ldots, I_m)$、收到自然语言变换指令 $T$ 和空间查询 $q$,必须在从未展示的结果状态 $S_1 = F(S_0, T)$ 中求值 $q$。任务按三个能力层级递进:L1 静态感知($T$ 为恒等变换,建立感知基线)、L2 局部预测(对单个物体及其附着依赖者做平移/环绕/移除)、L3 全局预测(整个布局绕固定相机做刚性旋转)。查询关系覆盖方向、距离、可见性/遮挡与附着结构,方向题又分相机中心、对象中心、世界中心三种参考框架,从而把'模型在哪一步、哪个维度上崩溃'分解成可定位的诊断信号。作者还额外验证:同一流水线生成的数据能否用于训练并迁移到其他基准。
与已有工作不同的是,本文的独特切入角度是 observe–transform–infer 框架加全流程程序化。最接近的先行工作各有不足:CLEVRER 在合成碰撞视频上评估物理事件与反事实、SAT 把观察到的运动与假设自我动作结合——二者都锚定在观察到的证据上;MindCube 研究有限视角下的 what-if 物体运动、SpaMEM 测试物体操作后的信念修正、SpatialWorld 评估闭环交互智能体——它们只触及预测推理的侧面。SpaceCast-Bench 则是首个在受控场景变换下直接评估预测性空间推理的基准,其独特性体现在三处:(1) 所有输入视图只采样自变换前场景,结果状态对模型完全不可见,杜绝了'从像素里找答案';(2) 能力层级 × 关系类型 × 参考框架的因子化设计,使失败模式可精细归因;(3) 几何接地的自动生成流水线既能规模化出基准(3,862 题),又能产出与评测场景完全不相交的训练集(12,249 题、54 个场景),把'诊断基准'和'训练数据引擎'合二为一。
核心方法
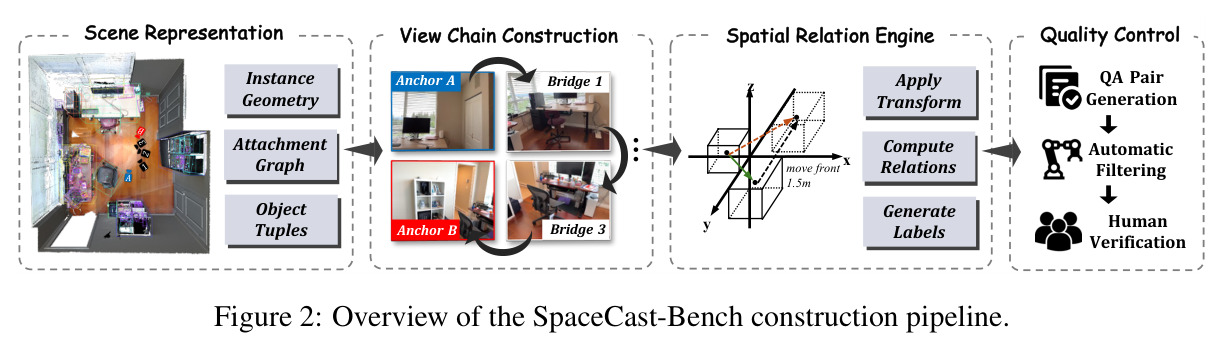
先说直觉:这就像给一个人看几张房间照片,然后问'如果桌子向南移 1.5 米,在户型图上键盘位于净水器的哪个方位?'——他必须先从照片恢复房间布局,再在脑中把桌子(连同桌上的鼠标)移过去,最后在新布局里回答方位。论文的技术路线是一个四阶段自动化流水线(Figure 2):第一阶段场景表示,从 ScanNet/ScanNet++ 的 RGB-D 扫描中提取每个物体的表面几何、3D 中心与轴对齐包围盒,并构建有向附着图记录'动谁带谁';第二阶段视图链构建,为查询物体挑选相互遮挡的锚点视图,并用深度校验的桥视图走廊把它们连成有序观测序列,保证观测是分布式且互补的;第三阶段空间关系引擎,直接从 3D 几何程序化计算方向/距离/遮挡/附着标签,预测题则先在几何上施加变换、再在变换后的状态上重跑引擎得到标签;第四阶段质量控制,自动过滤加多人独立人工审核。整条流水线无需人工标注答案,既保证了标签的几何正确性,也使基准和训练数据可以规模化复制。
与已有工作的本质区别有三点。第一,结果状态不可见:所有输入视图只展示变换前场景('keeping the resulting state unobserved'),标签由几何引擎在变换后的 3D 状态上重新推导,模型只能依靠内部场景表示做状态更新——这使'静态感知强'无法自动兑换成'预测强',实验证实 L2 比 L1 掉分高达 21.8pp。第二,视图链是被精确操纵的实验变量:锚点 A 只暴露物体组 A、锚点 B 只暴露组 B(语义互斥),中间的桥视图必须逐段覆盖连接两组质心的归一化走廊 $p(t) = c_A + t(c_B - c_A)$(相邻视图覆盖重叠至少 $\tau = 0.10$ 且向对侧推进),这迫使模型把分布式观测整合成全局场景表示——去掉桥视图后世界系方向准确率下降 5.3pp,证明该变量确实抓住了真实瓶颈。第三,附着图的传递闭包引入物理常识依赖:移动桌子会自动带走桌上的鼠标,2,494 道 L2+L3 题中有 2,217 道变换后查询关系改变、277 道保持不变,同时测试状态更新与不变性判断。三个能力层级与三种参考框架进一步把错误定位到'观察、变换、推断'的具体环节。
方法步骤详情
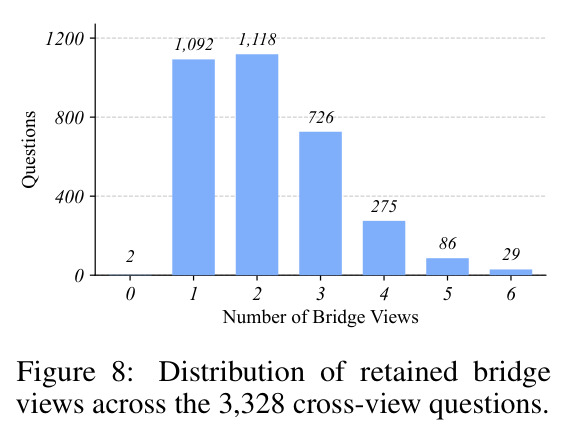
第一步,场景表示:取 134 个 ScanNet 加 48 个 ScanNet++ 验证集场景,从每个实例的 mesh 导出表面几何、3D 中心与轴对齐包围盒;构建有向附着图——边由表面接触、水平支撑重叠与语义相容性提议,每个子物体至多一个父物体、拒绝成环,传递闭包决定根物体移动时的共动组件。第二步,视图链构建:跨视图题需要两个'语义互斥'的锚点视图(锚点 A 只暴露组 A、锚点 B 只暴露组 B),候选按相机有效性、图像质量、投影面积、几何可见性过滤;桥视图沿走廊 $p(t) = c_A + t(c_B - c_A),\ t \in [0,1]$ 以约 0.09 米间距采样并投影进候选帧,要求观测深度一致,相邻视图须覆盖走廊至少 10%($\tau = 0.10$)且朝对侧锚点推进,任何桥视图不得同时暴露两组物体,链长 $k \le 6$;3,328 道跨视图题中仅 2 道无需桥视图。第三步,空间关系引擎:方向把物体中心相对向量投影到地板平面、量化为 8 个 45° 扇区另加上/下,按相机/对象/世界三坐标系表达;距离用采样 mesh 点近似最短表面间距,映射为 <1.0m / 1.0–2.0m / 2.0–3.3m / >3.3m 四档(距边界 0.1m 内剔除);遮挡由 mesh 射线投射聚合出未遮挡/被遮挡/不可见三态;附着题要求精确集合识别传递闭包中的共动物体。预测题先施加变换——L2 为平移、45–180° 水平环绕或移除(连带附着组件),L3 为整个布局绕固定相机旋转 90/180/270°——再在结果状态上重跑引擎取标签,越界或引入新碰撞的变换被拒绝。第四步,质量控制:自动过滤歧义与近重复、平衡答案位置;10 名标注者对每题至少两轮独立盲评,3,801 道单选题两两一致率 98.9%,97 道附着链题精确集合一致率 91.8%,69 道分歧题交第三位仲裁;最终 157 处标签修正、143 处改写、36 道删除。
技术新颖性
技术新颖性不在单一算法,而在'测量对象与测量仪器'的协同设计。其一,把'预测'变成良定义的计算问题:$S_1 = F(S_0, T)$ 从不出现在输入中,标签由关系引擎在变换后几何上重算,消除了人工标注的主观性与歧义,也让几何歧义、边界情形可以被系统性排除而非默默混入。其二,桥视图机制把'多视图整合能力'从混淆变量变成可控实验变量(Figure 8 显示 3,328 道跨视图题的桥视图数分布为 0–6,主体是 1–3 个),支持有/无桥视图的对照实验——这是感知类基准做不到的。其三,附着图把支持/共动这类物理常识首次引入纯几何基准的任务族,并直接解释了案例研究中模型'移桌丢鼠标'的系统性失败。其四,生成与评测共用一条流水线:训练池 12,249 题(54 个与评测完全不相交的场景、24,576 次任务平衡曝光)证明该范式可以无限量制造带精确标签的监督数据,形成'诊断→训练→迁移验证'的闭环。相比之下,感知基准(VSI-Bench、MMSI-Bench)无法控制变换变量,合成基准(CLEVRER)缺乏真实场景复杂度,交互式基准(SpatialWorld)难以程序化归因。
实验结果
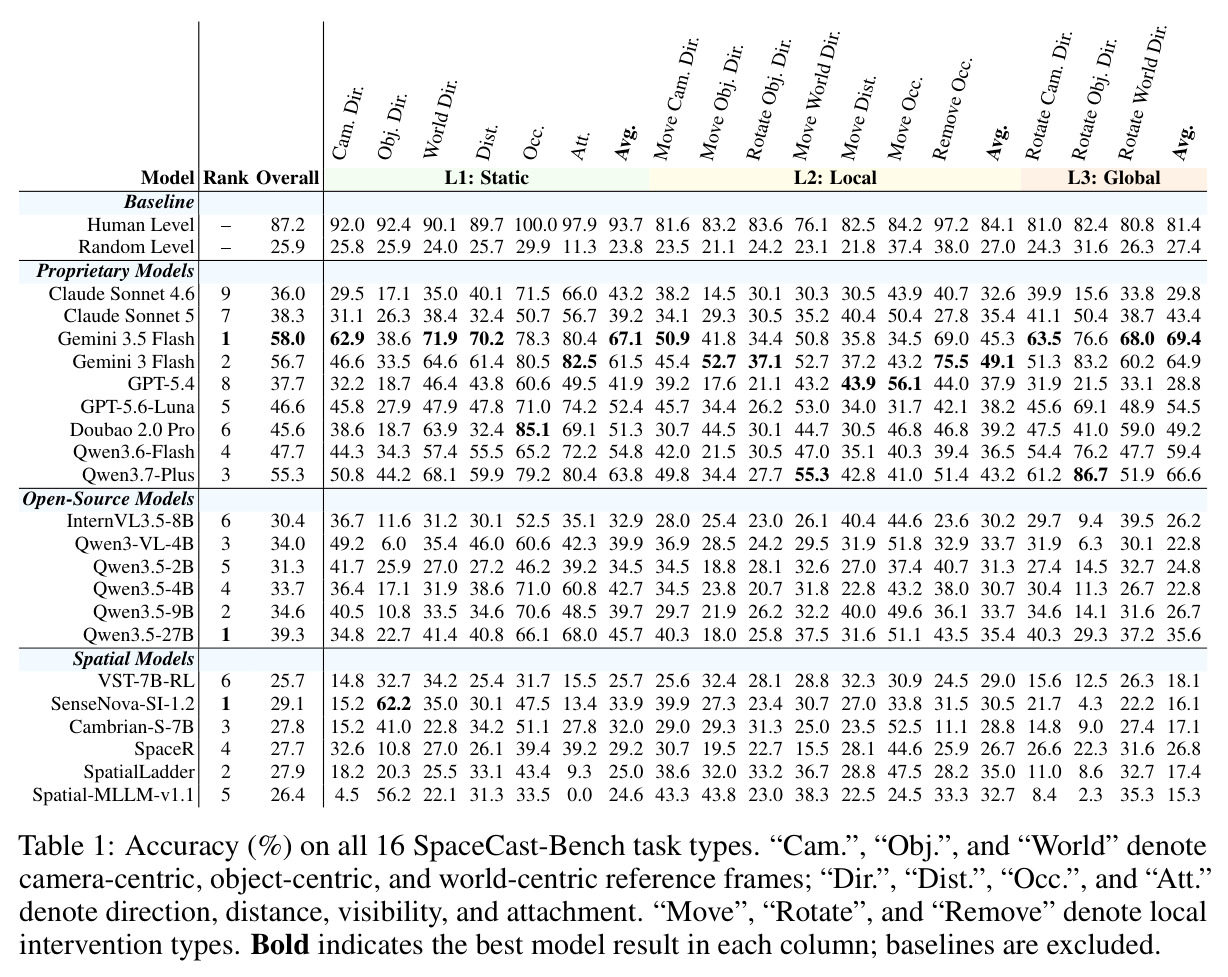
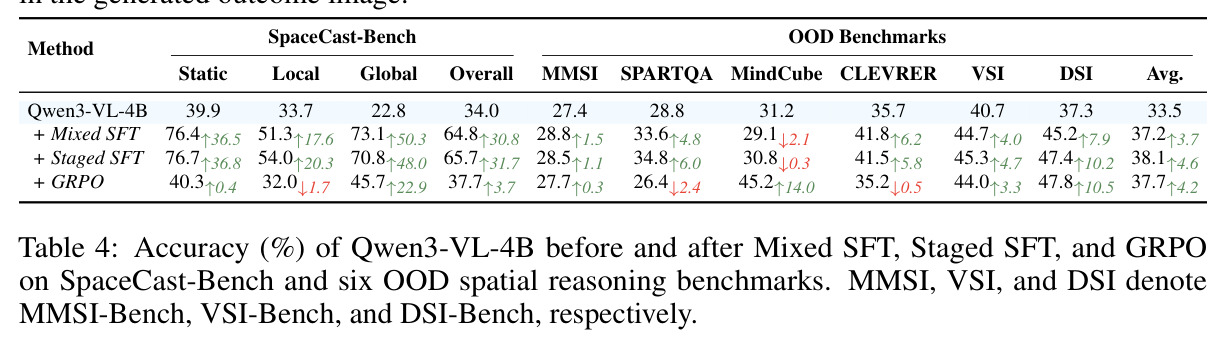
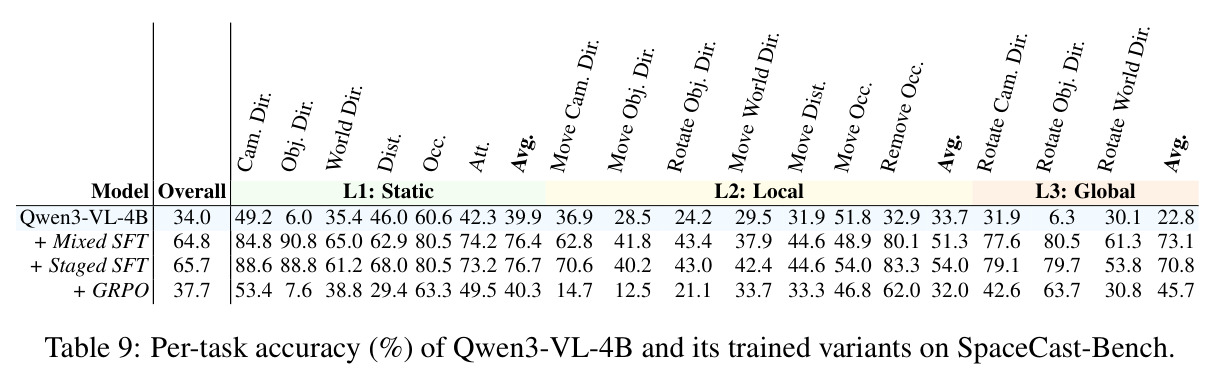
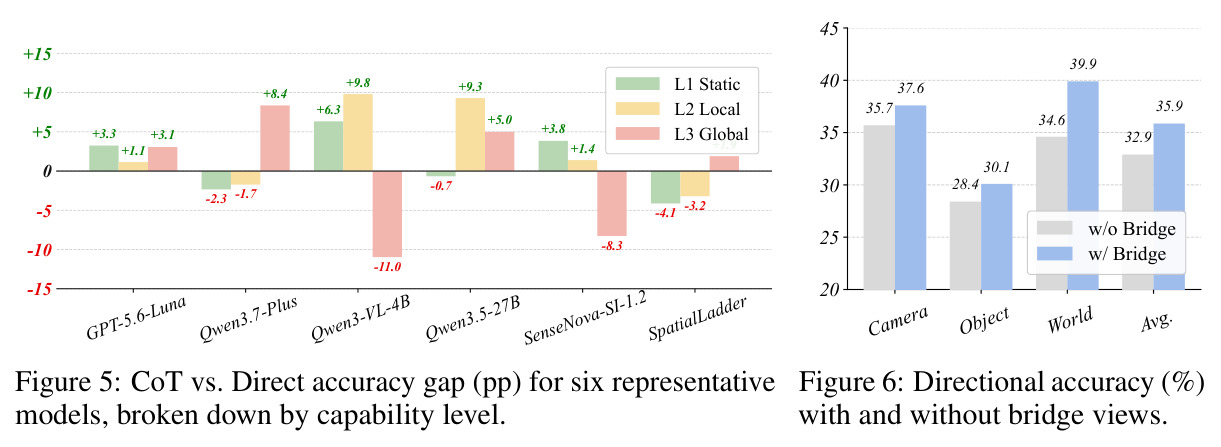
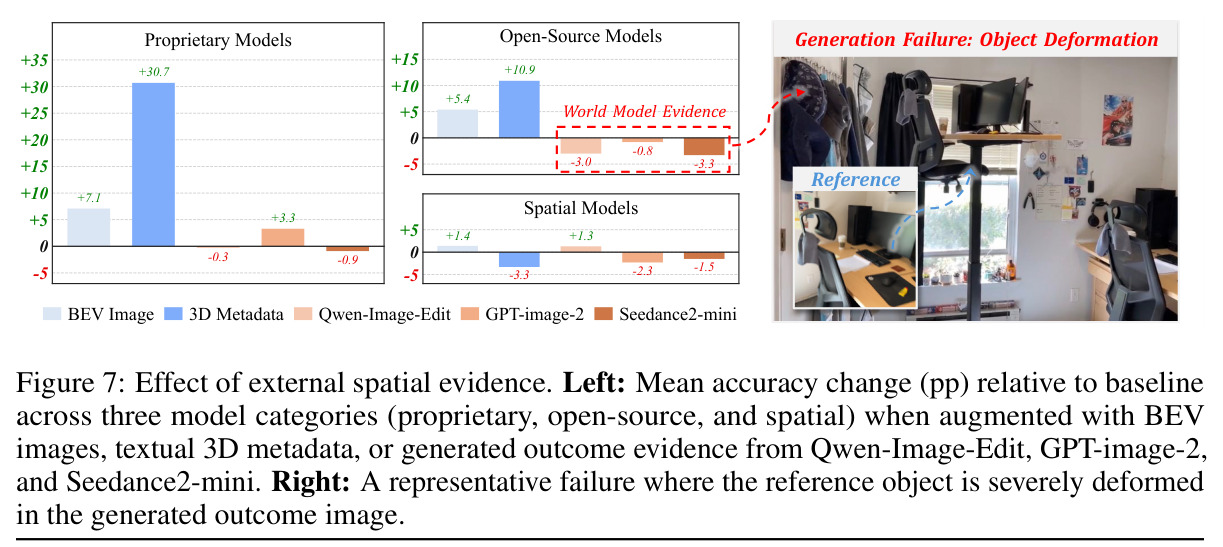
21 个模型(9 专有 + 6 开源 + 6 空间专用)对比人类 87.2%(12 名志愿者,3,340/3,862 正确)与随机 25.9%。实验一(Table 1):最强专有模型 Gemini 3.5 Flash 58.0%,仍落后人类 29.2pp;Gemini 3 Flash 56.7%、Qwen3.7-Plus 55.3%,Claude Sonnet 4.6 仅 36.0%;最强开源 Qwen3.5-27B 39.3%;六个空间专用模型全部落在 25.7–29.1%,接近随机,说明现有空间微调未建立真正的状态更新能力。实验二(能力层级):预测比静态难——L2 相对 L1,Gemini 3.5 Flash 掉 21.8pp、Qwen3.7-Plus 掉 20.6pp;但顶级专有模型在 L3 回升(Gemini 3.5 Flash 从 L2 的 45.3% 回到 69.4%),整体旋转可依赖布局整体把握;空间专用模型却在 L3 崩塌(SenseNova-SI-1.2 从 30.5% 跌至 16.1%),说明其微调只强化了局部感知。实验三(Table 2):附着最易(Qwen3.7-Plus 80.4%),遮挡次之,方向与距离最难;空间专用模型附着仅 9.3–13.4%。实验四(Table 3):对象中心一致最弱——Qwen3-VL-4B 相机系 39.3% 对对象系仅 16.2%;世界系最强(Qwen3.7-Plus 58.4%)。实验五(Figure 5):CoT 无一致收益,效应随模型家族与层级翻转。实验六(Figure 6):移除桥视图使世界系方向从 39.9% 跌至 34.6%(-5.3pp),相机系 -1.9pp、对象系 -1.7pp,六模型一致下降。实验七(Figure 7):显式 3D 证据最有效——文本 3D 元数据给专有/开源模型 +30.7pp/+10.9pp,BEV 普遍有效,空间专用模型加 3D 元数据反而 -3.3pp;世界模型式生成证据改善小——审计 600 道局部干预题发现错误回答中 80.3%(Qwen-Image-Edit)与 38.3%(GPT-image-2)伴随生成失败。实验八(Table 4):Qwen3-VL-4B 从 34.0% 经 Staged SFT 至 65.7%(Mixed SFT 64.8%),GRPO 仅 37.7%;OOD 上 Staged SFT 把 6 基准宏平均从 33.5% 提至 38.1%——DSI +10.2pp、SPARTQA +6.0pp、CLEVRER +5.8pp、VSI +4.7pp、MindCube -0.3pp;GRPO 迁移剖面不同(MindCube +14.0pp、SPARTQA -2.4pp)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SpaceCast-Bench 总分(16 任务类型宏平均) | 准确率 (%) | Gemini 3.5 Flash 58.0(所有模型最高) | 人类 87.2 / 随机 25.9 | 距人类 -29.2pp(全场最大缺口);高于随机 +32.1pp |
| 空间专用模型组(6 模型区间) | 准确率 (%) | 25.7–29.1 | 随机 25.9 | ≈0:专用空间训练未带来有效状态更新能力 |
| Qwen3-VL-4B 域内(SpaceCast-Bench) | 准确率 (%) | 65.7(Staged SFT);Mixed SFT 64.8;GRPO 37.7 | 34.0(基座模型) | Staged SFT +31.7pp;GRPO 仅 +3.7pp |
| DSI-Bench(域外迁移,动态空间智能) | 准确率 (%) | 47.4(Staged SFT) | 37.3(基座模型) | +10.2pp(六个 OOD 基准中最大单项增益) |
| 六个 OOD 基准宏平均(MMSI/SPARTQA/MindCube/CLEVRER/VSI/DSI) | 准确率 (%) | 38.1(Staged SFT);GRPO 37.7 | 33.5(基座模型) | +4.6pp(Staged SFT),验证训练数据可迁移 |
局限与改进
作者承认的局限(附录 A):其一,全部 182 个场景均为室内环境且来自 ScanNet/ScanNet++(仅 ScanNet++ 就贡献 3,144/3,862 ≈ 81% 的题目),不覆盖户外场景及这两个数据源之外的物体排布与尺度;其二,标签依赖重建 mesh、深度图、相机位姿与实例标注,几何误差会传导到射线投射的可见性判断和表面接触的附着判断——尽管排除歧义案例并做双人盲审,仍无法完全消除低重建置信度物体上的不确定性;其三,三种干预均为程序化几何更新,不模拟物理动力学,因此不考核形变、摩擦或碰撞驱动的运动效应。我的补充观察:第四,选择题格式使强模型可借助语言先验与排除法得分,天花板效应可能掩盖更细粒度的错误;第五,题目由模板生成、措辞同质,Staged SFT 域内升至 65.7%(部分子任务超 88%)而 OOD 宏平均仅 38.1%,提示训练收益含可观的'适应题型'成分;第六,L3 仅有三种整体旋转型方向任务,变换类型偏窄,人基线 12 人样本也偏小;基准是单轮静态问答,未覆盖'主动决定看哪里'的取证能力。
独立分析的弱点
弱点一:'预测'被限定在刚性欧氏变换内——L2/L3 只覆盖平移、环绕、移除与整体旋转,推倒、滑动、形变、多物体连锁等真实操作的物理后果全部缺席,基准高分模型仍可能在'书压信封、上有杯子'的例子中打翻杯子。改进:接入物理引擎生成带动力学终态的变换算子。弱点二:附着图由'接触 + 支撑重叠 + 语义相容'启发式构建、每子物体至多一父,无法表达嵌套容纳、多重支撑、可动性差异,标注错误会直接污染训练信号。改进:引入可供性属性或对高分歧边做人工复核。弱点三:评测是单轮多选题,模型不能主动转视角再确认,而真实瓶颈可能在'观察什么'而非'如何推断'。改进:做主动版基准——模型在视图预算内请求新视角。弱点四:世界模型证据实验偏薄:只审计 600 道局部干预题,且生成模型月级迭代,'80.3% 错答源于生成失败'的结论时效性短,也未报告'生成成功条件下'的准确率分解。改进:随生成模型滚动更新评测协议,分离生成质量与证据利用两个因子。弱点五:Staged SFT 域内/域外落差(65.7% 对 38.1%)加 MindCube 微降 0.3pp,暗示部分收益来自模板适应而非可迁移推理。改进:训练时多样化措辞与选项结构,加模板鲁棒性评测。
未来方向
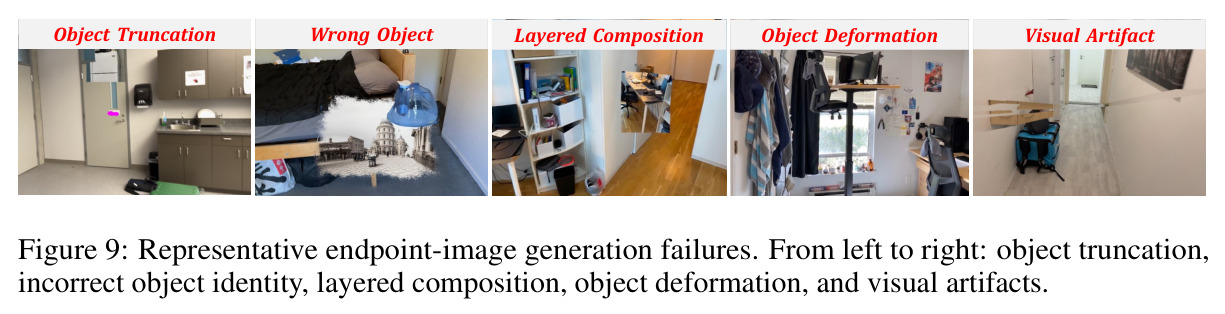
作者明确指出的方向:一是闭合世界模型证据的双重缺口——生成保真度(形变、截断、物体缺失,见 Figure 9 的五类失败)与跨视图证据对齐都要突破,即证据必须'既可得又可用';二是把显式 3D 表示(BEV 图、文本 3D 元数据,对专有模型带来 +30.7pp)以轻量方式内化进模型,而非推理时依赖外部工具。基于成果可延伸的方向:其一,RL 奖励设计——GRPO 总体仅 37.7%,作者归因于任务太难导致奖励信号稀疏,但它在 MindCube 上 +14.0pp 的独特迁移剖面提示课程化 RL 或过程奖励(对中间状态更新的塑形信号)可能释放潜力;其二,扩展不变性测试线——现有 277 道'关系不变'题只是开端,可扩建成专门的恒常性/反事实套件,以区分'真状态更新'与'表面模式匹配';其三,把附着/支持关系与具身仿真打通,做物理接地的预测基准;其四,视图链设计天然支持主动观察设定——让模型自己决定查看哪些桥视图;其五,下游应用上,可把该基准作为机器人部署前的安全预检:筛出哪些 VLM 具备规划所需的最小空间预测能力;其六,沿着 Staged SFT 优于 Mixed 的发现,继续研究课程顺序、数据配比与规模定律对空间推理训练的影响。
复现评估
复现评估:条件较好、难度中低。数据基于公开的 ScanNet/ScanNet++ 验证集(原始扫描需签署许可协议获取),生成流水线在附录 B 逐步文档化——走廊公式 $p(t) = c_A + t(c_B - c_A)$、0.09m 采样间距、10% 覆盖阈值、距离四分箱及 0.1m 边界剔除、变换参数范围与拒绝条件,质量控制数字(98.9% 一致率、157 处修正等)可用于校验复现质量;论文首页标注 GitHub 与 HuggingFace 入口,基准数据大概率随论文公开(以仓库实际放出为准)。训练仅在 Qwen3-VL-4B 上做 LoRA 微调(SFT rank-32、学习率 $10^{-4}$/$10^{-5}$、batch 32、序列长 8192;GRPO rank-16、KL 系数 $10^{-3}$、clip 0.2),训练集 12,249 题、24,576 次曝光,算力需求适中,单台多卡节点可承担。评测为标准化 CoT 提示 + 确定性解码,完整 prompt 在附录 C,OOD 子集以 seed 42 固定。不确定处:未报告 GPU 型号与时长、生成代码开放程度、专有模型 API 费用。总体若数据如期开源,一名研究者可在数周内完成评测复现与 LoRA 训练。
论文图表
6 个代表性模型在三种参考框架下有/无桥视图的方向题平均准确率对比:移除桥视图后世界系方向从 39.9% 降至 34.6%(-5.3pp),相机系 -1.9pp、对象系 -1.7pp,所有模型一致下降。
对基准的关键设计变量做了受控消融,证明桥视图对'把分布式观测整合成全局空间表示'确实不可或缺,且世界系推理对它依赖最大。
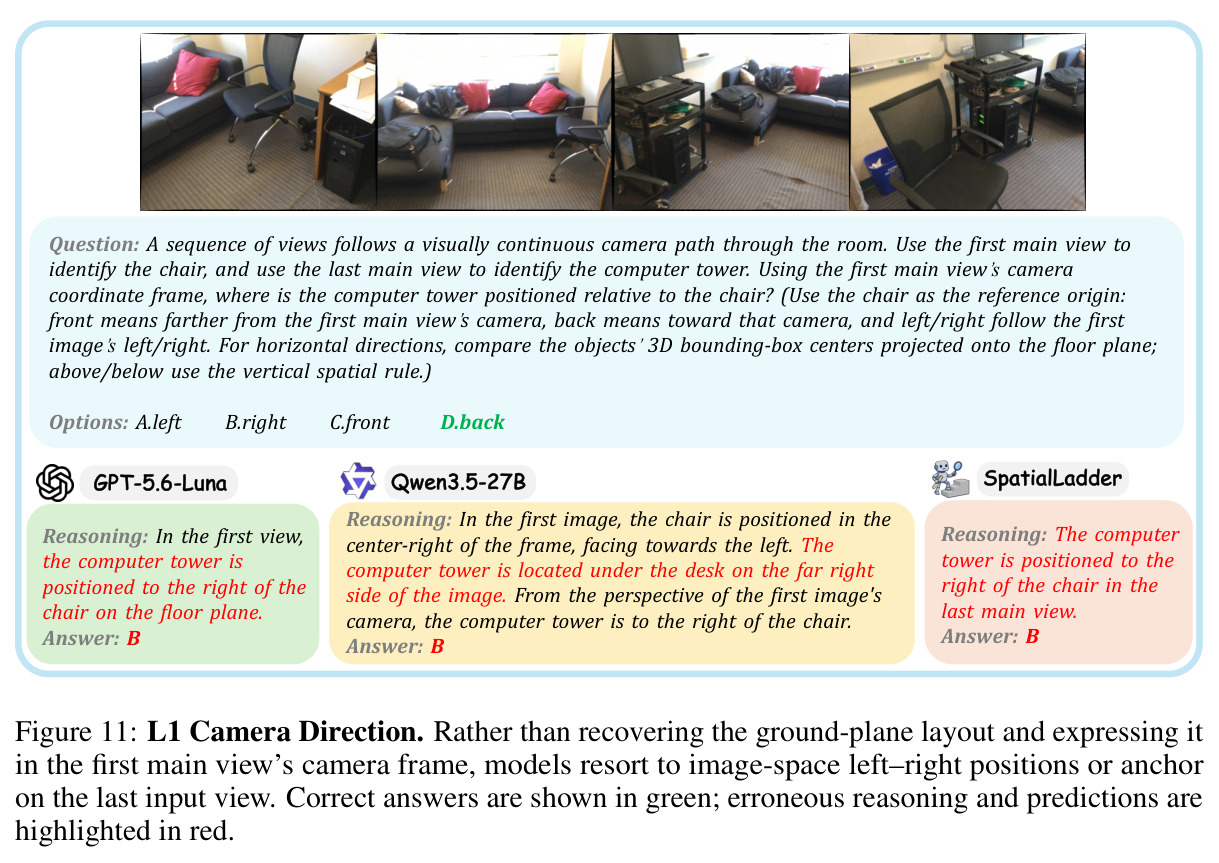
同一道 L1 相机方向题下 GPT-5.6-Luna、Qwen3.5-27B、SpatialLadder 三个模型的完整推理链与错误答案:它们都使用图像内的 2D 左右位置启发式、或错误锚定在最后一个输入视图上,而非恢复地面布局并用第一主视图相机系表达。
失败模式案例一:说明即便在静态感知上,模型的跨视图方向判断也依赖浅层 2D 启发式而非 3D 布局,解释了方向类任务的系统性低分。
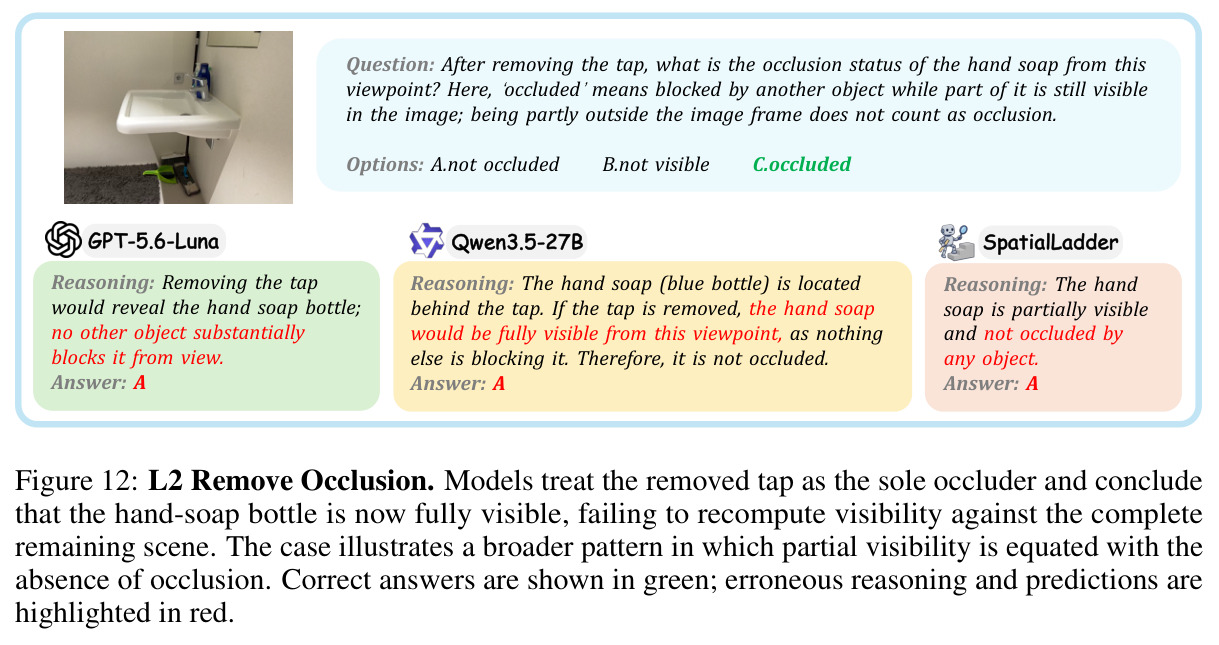
移除水龙头后洗手液瓶遮挡状态的题目:GPT-5.6-Luna、Qwen3.5-27B、SpatialLadder 三个模型全部答'未被遮挡'(正确答案为仍被遮挡),因为它们只移除了唯一想到的遮挡物,未对场景中其余所有物体重新计算可见性。
失败模式案例二:揭示模型可见性更新逻辑的系统性缺陷——'部分可见即无遮挡',是缺乏持久可操作 3D 场景状态表示的直接表现。
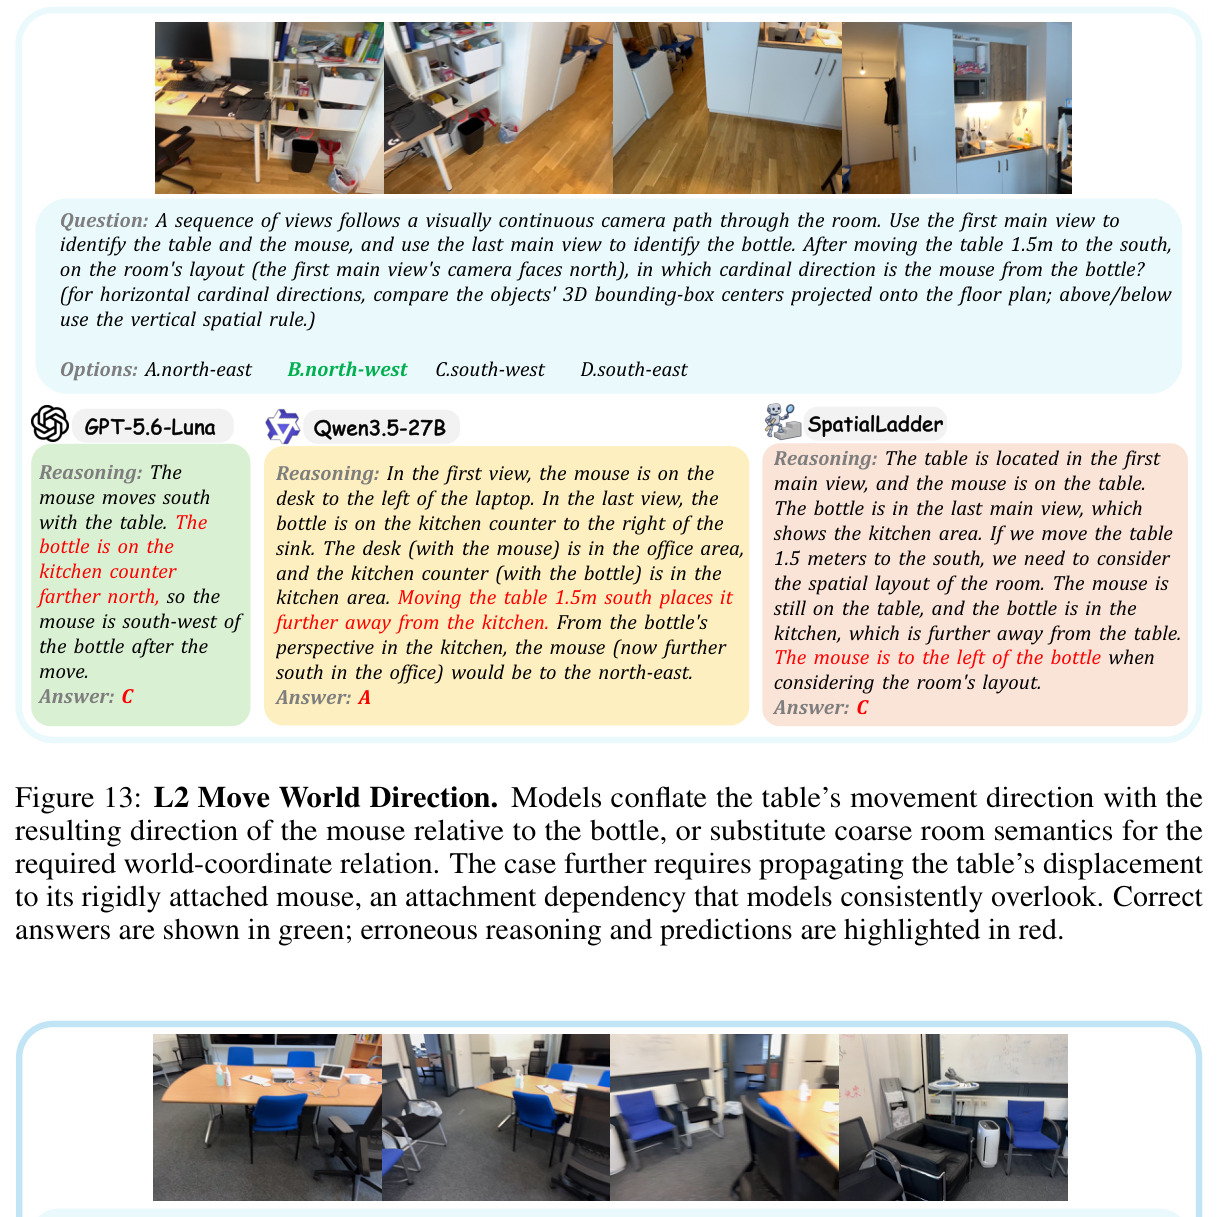
桌子南移 1.5 米后鼠标相对水瓶世界方位的题目:三个模型全部答错——有的把桌子移动方向与鼠标相对水瓶的方向混为一谈,有的用'办公区/厨房区'这类粗粒度房间语义替代世界坐标关系,且都忽略了'鼠标随桌子共同移动'的附着依赖。
失败模式案例三:展示了'附着传播 + 世界参考框架'的复合挑战,与 Table 2、Table 3 中附着任务和世界系参考框架的数据模式直接呼应。
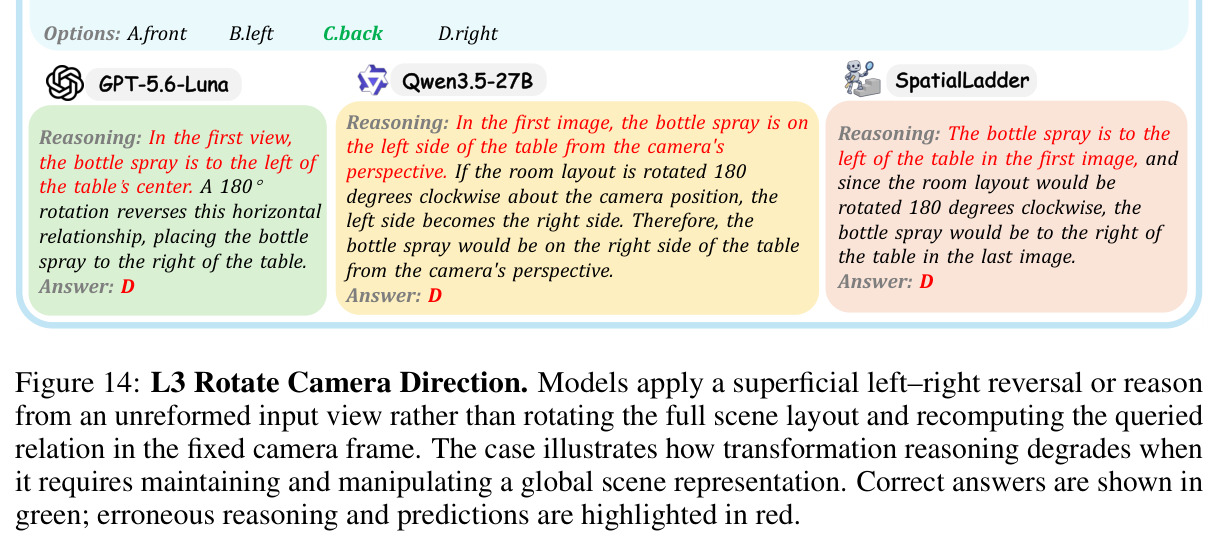
房间整体绕相机顺时针旋转 180° 后喷瓶相对桌子方向的题目:三个模型都答'右'(正确为'后'),只做了表面的 2D 左右翻转,而非在固定相机系中旋转整个场景布局后重新计算关系。
失败模式案例四:说明即使在相对'容易'的整体旋转任务上,模型仍用浅层 2D 启发式作答,支撑了'模型缺少可查询、可更新的持久场景表示'这一核心判断。