RoTA-Bench:用交互式投影对齐评测3D空间推理 RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
转动3D物体对齐目标剪影:人类全对,最强VLM仅17%成功率
前置知识
投影 IoU(Intersection over Union)
两个二值轮廓掩码的交并比,即 $\mathrm{IoU}(I_t, I^\star) = |I_t \cap I^\star| / |I_t \cup I^\star|$,衡量当前投影剪影与目标剪影的重叠程度,取值 1 表示完全重合。本文把 IoU ≥ 0.90 设为唯一成功判据,既保证高对齐保真度,又给离散动作空间留出容差。
它是任务的目标函数,也是成功率、最终 IoU、IoU 轨迹等所有核心指标的基础;不理解 IoU 就无法解读任何实验数字。
SO(3) 与 pitch/yaw/roll
SO(3) 是所有 3D 旋转矩阵构成的群(3×3 正交、行列式为 1),姿态更新即矩阵左乘 $R_{t+1} = Q(a_t) R_t$,且每个旋转都可逆。pitch/yaw/roll 是绕相机固定坐标系三个轴的旋转,本文用 3 轴 × 2 方向 × 4 角度($1°, 5°, 10°, 30°$)构成 24 个离散动作。
论文把每个动作解耦为『方向(轴+符号)』和『角度(步长)』分别诊断,方向选择和角度控制的公式与指标都建立在 SO(3) 的表示与距离度量上。
正交投影与剪影(silhouette)
正交投影沿视线方向把 3D 点 $(x,y,z)$ 映射为 $(x,y)$,无透视缩放,渲染出物体的二值剪影。面外旋转会引起剪影的非线性形变、长宽比变化和自遮挡,这是任务『必须靠视觉推理』的根源;深度着色辅助视图 $V_t$ 在同一视角按深度调节灰度,补充单眼深度线索。
理解剪影匹配的难度来源(自遮挡、几何对称导致多解)才能明白为什么同一剪影可对应多个等价 3D 姿态,以及位姿误差为何只作诊断不作目标。
心理旋转(mental rotation)
认知科学经典概念(Shepard & Metzler, 1971):人在头脑中旋转物体的心理表征,以判断不同视角下的形状是否相同,是空间认知的基础能力;Richards 等(1987)进一步说明 3D 形状可从 2D 轮廓与剪影推断。本文任务正是这一能力的可操作化、可计分版本。
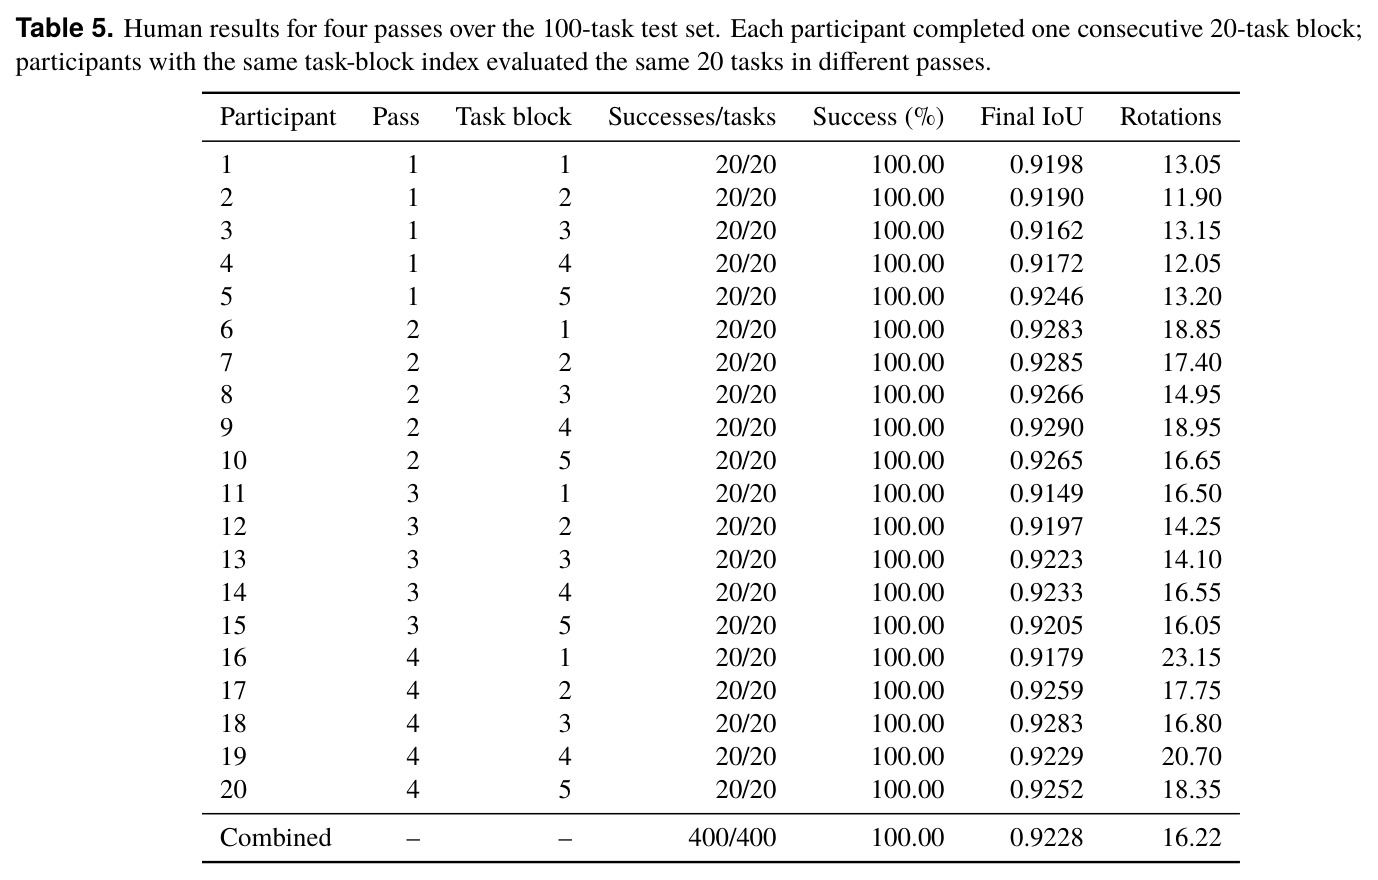
它解释了为什么人类被试能 400/400 全部成功——这是任务的效度检验,也是『人机差距』论证的理论锚点。
闭环交互评测与 ReAct
闭环评测指 agent 每步输出动作、环境返回新观测、往复直至终止条件触发,与单轮静态问答相对。ReAct 是让模型交替输出推理链与行动的经典 agent 框架;本文还测试了含 manager-solver 编排的 Magentic 框架,均基于同一 GPT-5.6-Sol 底座。
RoTA-Bench 的评测协议(48 步决策预算、交互历史、停滞终止)都建立在闭环设定上;两个 agent 配置用来检验『框架编排能否弥补基础模型的能力缺陷』。
研究动机
现有视觉空间评测存在一条无人覆盖的能力链:『从 2D 观察推出 3D 理解、再转化为精确动作』。静态基准(CLEVR、GQA、MathVista 一类)在固定图像上做被动问答,完全没有动作执行与闭环反馈;交互式基准则集中在软件界面操作、视觉迷宫、滑块拼图上,其对象是轴对齐的网格实体、没有旋转姿态变化,任务成败主要取决于编码、推理与高层规划能力,空间推理退化为组合寻路;而具身导航类基准又强调宏观移动与语义规划,测不到细粒度朝向控制。与此同时,VLM 正被大量用于具身探索、几何感知导航等交互场景,但已知模型在三维位置、朝向与空间关系推理上持续碰壁,还在相机位姿估计、正交投影、形状识别上表现不佳。换言之,没有现成基准能回答:模型能否像人一样,看着旋转物体的剪影,一步步把它转到目标姿态?
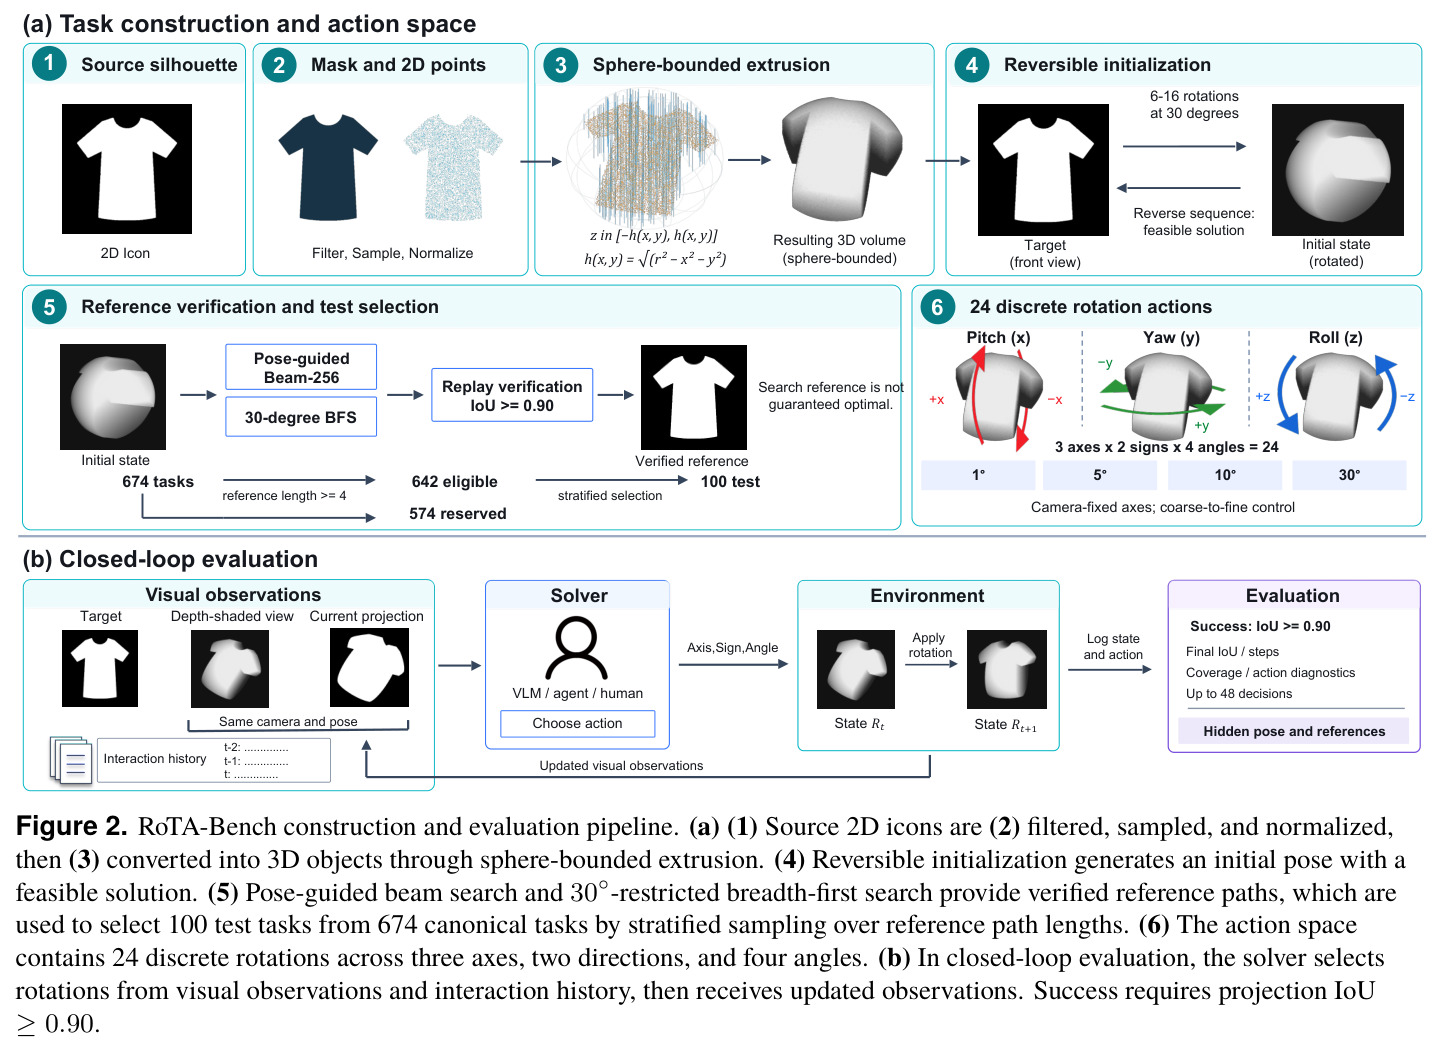
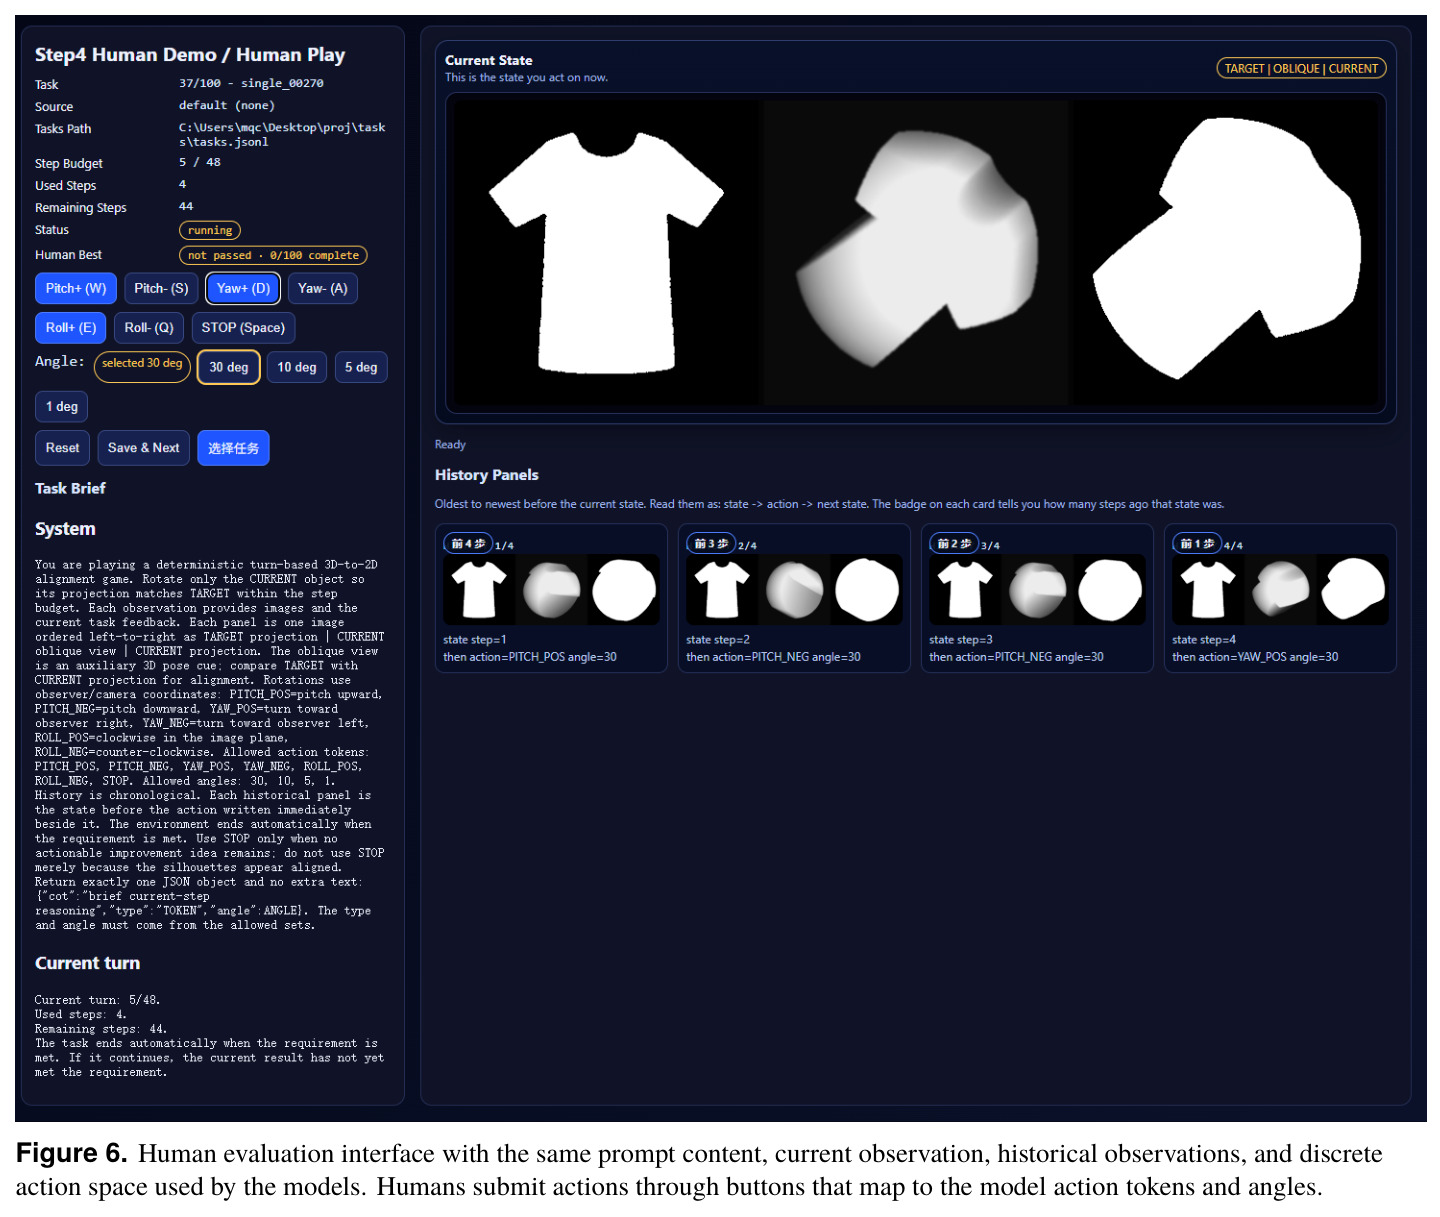
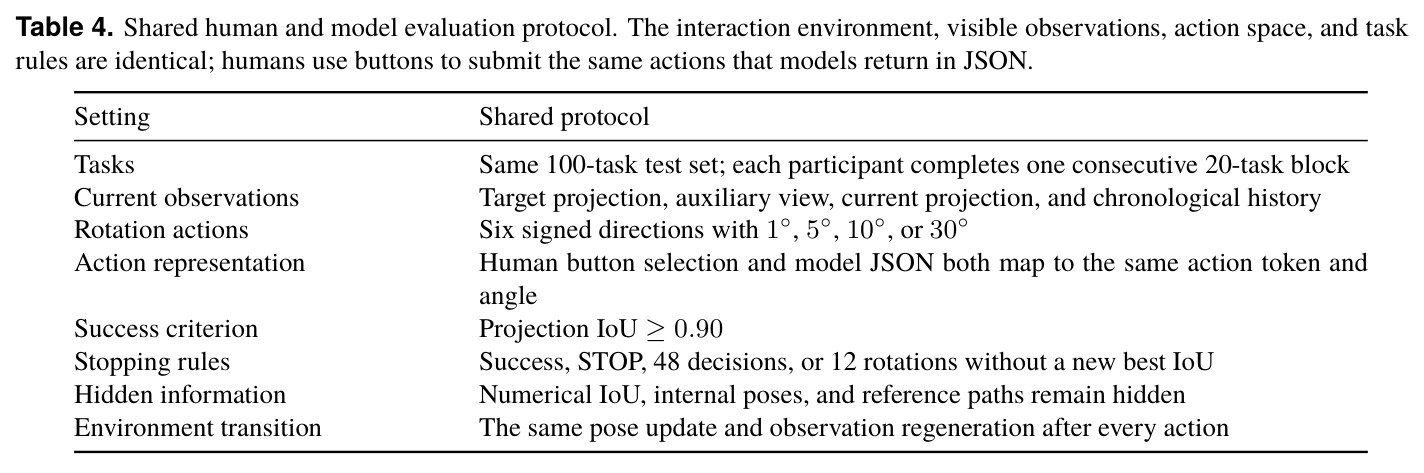
本文的目标是本文目标是构建一个自动化、可验证、难度可量化的交互式基准 RoTA-Bench:给定目标剪影 $I^\star$,模型观察被旋转的 3D 物体(当前投影剪影 $I_t$ 加深度着色辅助视图 $V_t$),在最多 48 步决策预算内从 24 个离散旋转动作(3 轴 × 2 方向 × $\{1°, 5°, 10°, 30°\}$)加 STOP 中连续选择,直到投影 IoU ≥ 0.90。具体包括:(1) 从 2D 图标自动构建保轮廓的 3D 物体,用可逆初始化从构造上保证 100% 可解,产出 674 个任务;(2) 用位姿引导束搜索与 30° 受限 BFS 得到经验证的参考路径,按其长度分层抽样冻结 100 任务测试集;(3) 在统一协议下评测 9 个 VLM、2 个 agent 框架与 20 名人类被试,并定位失败发生在方向选择、角度控制还是视觉探索环节。
与已有工作不同的是,独特切入角度有三点。其一,把 3D 朝向对齐形式化为『投影匹配』并只保留纯旋转:面外旋转带来剪影的非线性形变与自遮挡,天然抵抗文本化表示;同时干净剥离平移漂移、抓取可供性、接触摩擦等无关物理动力学,使失败可以归因到空间推理本身。其二,物体不从常见 3D CAD 库取材(避免预训练先验走语义捷径),而是把 2D 矢量图标在球体内挤成抽象而新颖的几何,又数学上保证正视图重现原图标细节。其三,初始姿态由可逆离散旋转序列生成,使每个任务从构造上可解,再配合双搜索得到验证过的参考路径,让『这道题最少几步』成为可分层的难度标尺——这套『构造保证可解 + 搜索量化难度』的基准工程方法本身也是贡献。
核心方法
直觉上,任务像『转动一把钥匙直到齿形对准锁孔』:你看得到目标剪影、当前剪影和一张带明暗深度提示的辅助视图,但不知道物体的真实朝向,只能凭视觉证据一步步判断该绕哪个轴、往哪边、转多少度。技术路线:每个任务由刚体 $G \subset \mathbb{R}^3$、初始姿态 $R_0 \in SO(3)$ 与目标姿态 $R^\star = I_3$ 定义;第 $t$ 步环境给出观测三元组 $O_t = (I^\star, V_t, I_t)$;模型从 24 个相机固定旋转动作加 STOP 中选 $a_t$,姿态按 $R_{t+1} = Q(a_t) R_t$ 更新并重新渲染观测。成功判据为 $\mathrm{IoU}(I_t, I^\star) \ge \tau = 0.90$。因几何对称性,目标姿态天然多解,目标集定义为 $R_{goal}(G, I^\star) = \{R \in SO(3) \mid \mathrm{IoU}(\Pi(G,R), I^\star) \ge \tau\}$。回合在成功、STOP、48 步上限、或连续 12 步无最佳 IoU 改进(停滞)时终止。
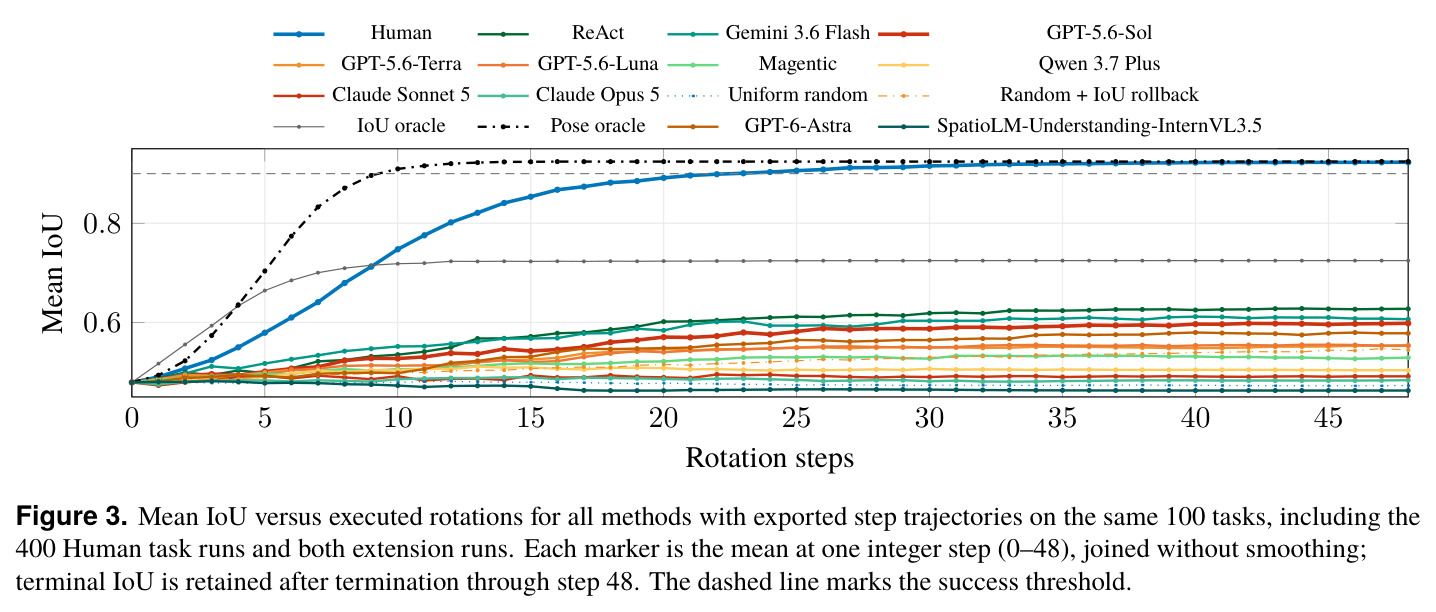
核心创新是『自动构造 + 构造级可解 + 难度可分层』三件套,把抽象认知能力变成可规模化的闭环任务。(1) 球域内挤出:把图标点集按深度半厚 $h(x,y) = \sqrt{\max(r^2 - x^2 - y^2, 0)}$ 对称挤出,因 3D 旋转保持欧氏范数,物体任意旋转后都在半径 $r$ 的球内,杜绝视口裁剪并全局固定相机尺度,正视图又严格重现原图标。(2) 可逆初始化:初始姿态 $R_0 = Q(b_L) \cdots Q(b_1) R^\star$ 由 $L \sim \mathrm{Uniform}\{6,\ldots,16\}$ 个 30° 旋转合成(禁止相邻互逆),因 $SO(3)$ 中每个旋转可逆,反向执行必回目标,100% 可解性由构造保证。(3) 参考搜索:位姿引导 Beam-256 与 30° 受限 BFS 各自重放验证后取更短者——86.8% 的任务上比反向生成路径更短(均值 6.54 步 vs 11.04 步)。与静态 VQA 的本质区别在于评估感知-行动闭环:动作改变观测,观测再驱动下一个动作。
方法步骤详情
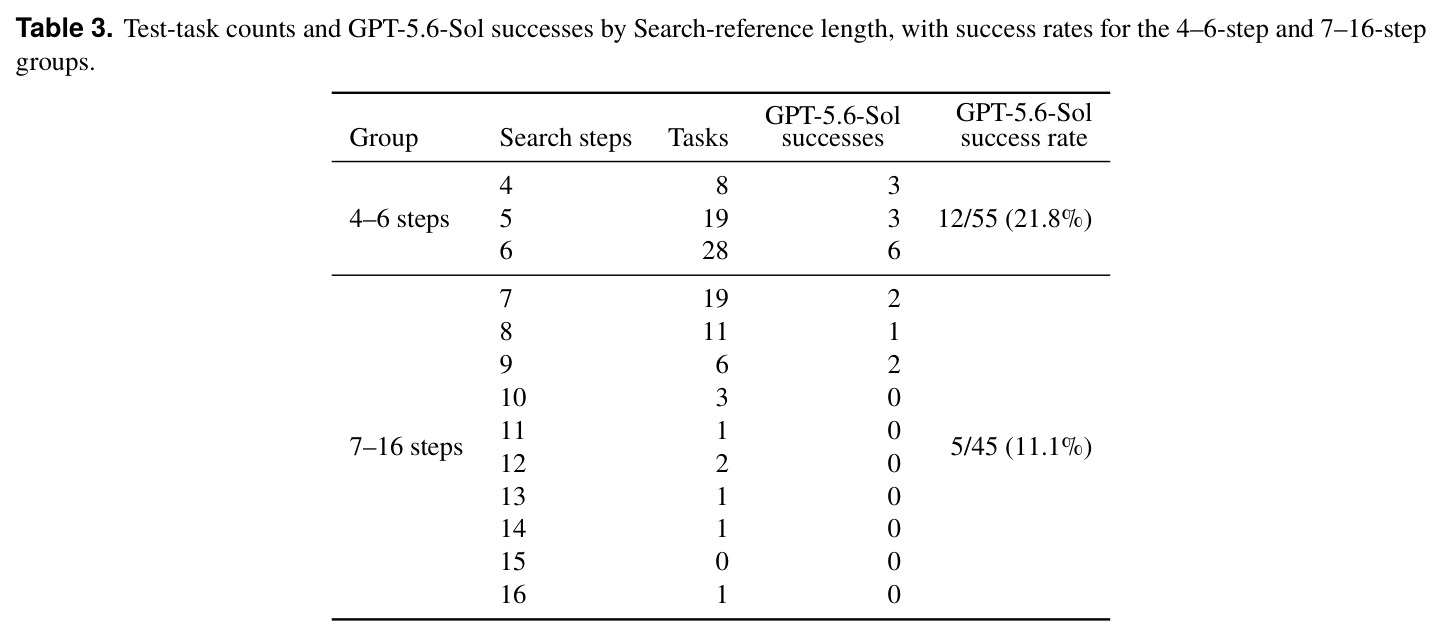
流水线五步。(1) 图标处理:从 Game-icons 库栅格化 SVG 为 512×512,按 $F(u,v) = \mathbb{1}[\alpha(u,v) > 8 \wedge \|C(u,v) - c_{bg}\|_1 > 30]$ 提取前景,再经连通域占比 ≥0.985、圆占积 ≥0.28、长宽比 ≤2.2、前景点数 ≥2000 等过滤,输出最多 90,000 个 2D 点。(2) 3D 构建与渲染:点集缩放进半径 $r=28$ 的圆内,按 $h(x,y)$ 挤出,每点取 31 个深度采样(两端加 29 个种子确定性内点),得到可复现的稠密点云;正交投影点溅射渲染剪影,辅助视图按深度着色补充单眼深度线索。(3) 可逆初始化:随机合成 6–16 个 30° 旋转得 $R_0$,丢弃初始已对齐($s_0 \ge \tau$)者,产出 674 个任务。(4) 参考搜索:Beam-256 每条路径按位姿残差生成 6 个候选并保留 256 个;BFS 在 30° 动作集上逐层展开;两者重放验证 IoU ≥ 0.90 后取更短者,参考长度 ≥4 的 642 个任务合格。(5) 测试集:Hamilton 最大余数法按参考长度比例分层、SHA-256 确定性排序选出 100 个测试任务,其余 574 个保留用于训练研究。
技术新颖性
与已有工作的具体区别:(1) 相对静态空间基准(CLEVR、GQA、MathVista),首次把动作执行与视觉反馈闭环引入 3D 朝向推理,成功判据由渲染器自动验证,零人工标注;(2) 相对具身基准(ALFRED、Habitat 类导航与长程任务),剥离宏观移动与高层语义规划,专测『从剪影推朝向并转化为动作』这一最小能力单元;(3) 相对交互式迷宫、滑块拼图、文字坐标搜索类基准(对象是轴对齐网格实体、无旋转姿态变化),本文引入面外旋转的非线性剪影形变、长宽比变化与自遮挡,任务无法靠 token 空间里的串行搜索解决;(4) 相对符号规则类可验证基准(A2RBench),验证对象是几何投影而非抽象规则。方法论层面,『可逆初始化保证可解 + 双搜索量化难度 + 分层冻结测试集』是可被其他自动基准生成器直接复用的工程模式。
实验结果
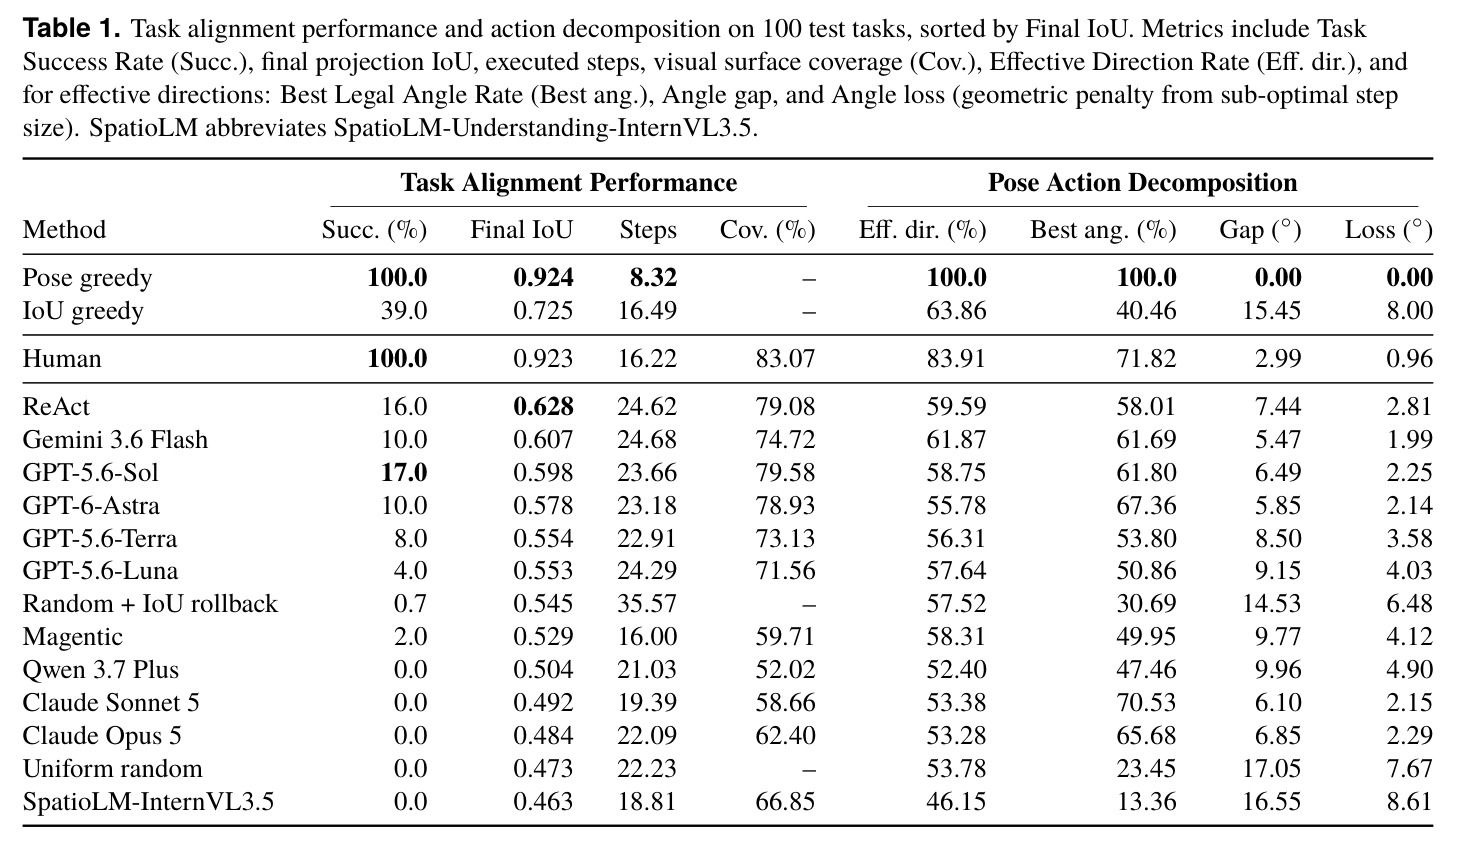
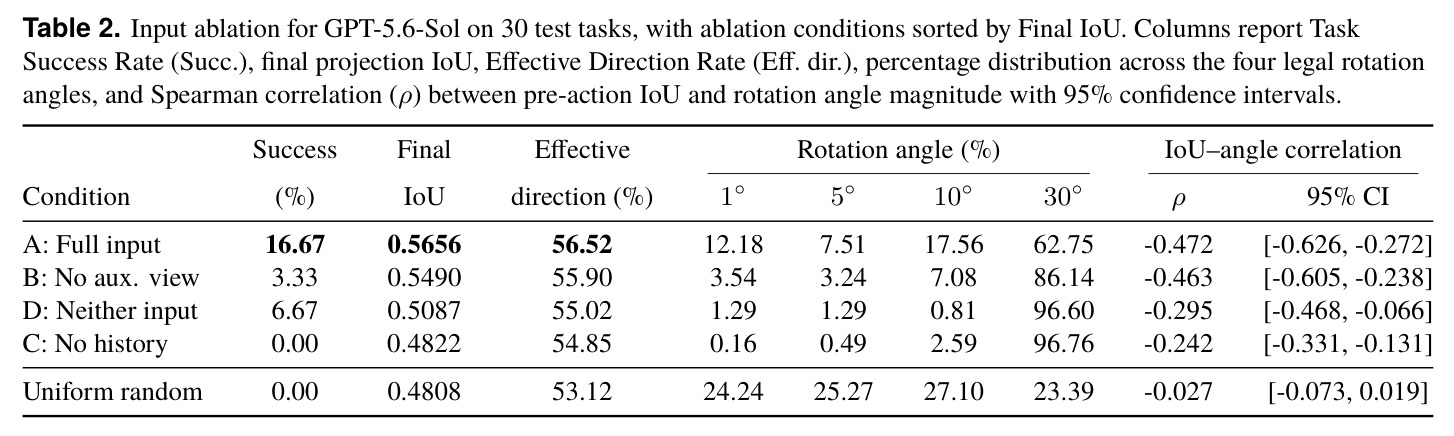
人机差距显著:最强模型 GPT-5.6-Sol 成功率仅 17.0%(最终 IoU 0.598),Gemini 3.6 Flash 10.0%,ReAct 以 16.0% 成功率拿到最高 IoU 0.628;Claude Sonnet 5、Claude Opus 5、Qwen 3.7 Plus 全部 0.0%(IoU 0.484–0.504,仅略高于均匀随机 0.473);SpatioLM 策略坍缩——91.12% 动作退化为 YAW_POS $10°$,IoU 0.463 低于随机。人类 20 名本科生 ×4 轮共 400 次任务运行全部成功,平均最终 IoU 0.923、16.22 步、覆盖率 83.07%(Sol 79.58%,探索量相当)。两个 oracle 锐化归因:IoU 贪心只成功 39.0%(IoU 0.725),位姿贪心 100% 成功(8.32 步、IoU 0.924)——瓶颈正是 2D→3D 位姿估计。动作分解:人类有效方向率 83.91% vs Sol 58.75%(随机 53.78%),角度差距 $2.99°$ vs $6.49°$,每步角度损失 $0.96°$ vs $2.25°$。消融(Sol,30 任务):全输入 16.67%/0.5656;去辅助视图 3.33%;去历史 0.00%——$30°$ 占比飙到 96.76%、$1°$ 从 12.18% 跌到 0.16%,IoU–角度相关从 $\rho=-0.472$ 减弱到 $-0.242$,说明历史主要支撑『转多细』而非『往哪转』。相关性分析:Sol 选角与 IoU 的相关($\rho=-0.536$)强于与位姿误差($\rho=0.368$),人类两者都强($-0.696$/$0.751$)。211 个匹配状态对比:Sol 的 UF 动作(IoU 升、位姿误差升)19.43% vs 人类 10.90%,UC 34.60% vs 50.24%,每步 $\Delta$IoU 0.0071 vs 0.0207、位姿缩减 $2.87°$ vs $10.04°$——两个空间的进展确实背离。Oracle 分解(2,366 个状态):修正方向可再降 $15.61°$,修正角度仅 $5.70°$,方向是更大短板。跨几何对照:Sol 在 30 个 Poly Haven 真实网格任务上 20.0%/0.7179,高于图标任务的 16.7%/0.5656,提示形状熟悉度有影响。
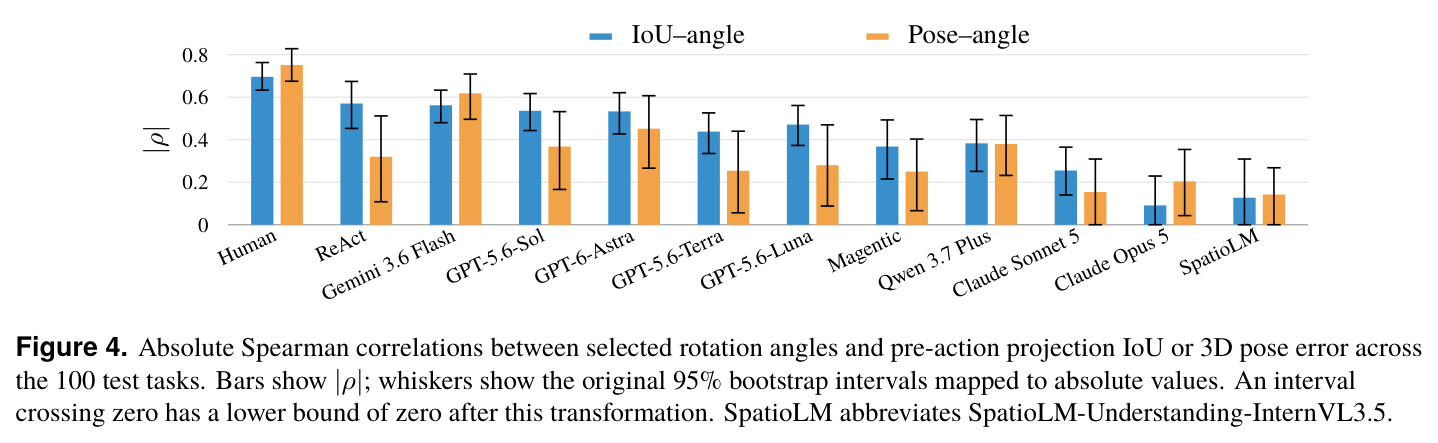
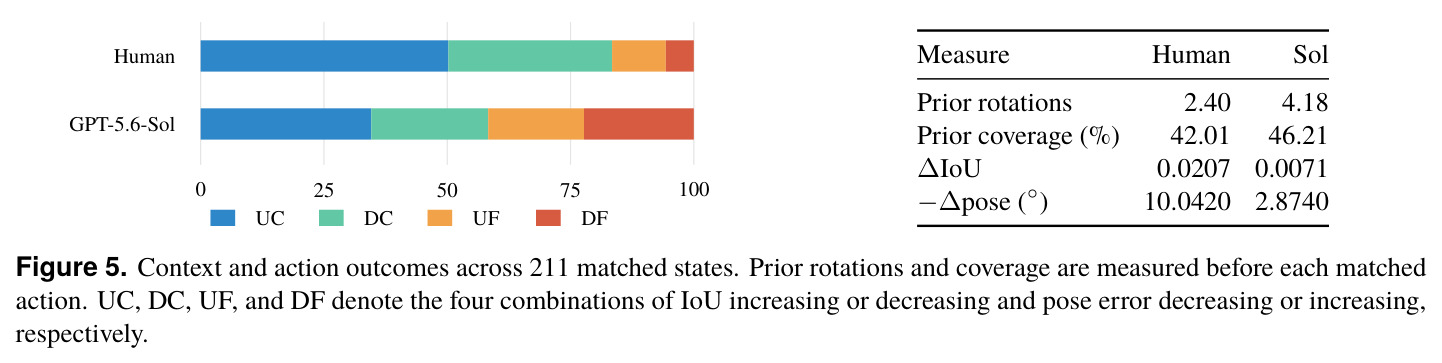
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 交互式 3D 投影对齐(100 任务测试集) | 任务成功率 | GPT-5.6-Sol 17.0%(模型最高);ReAct 16.0% | 人类 100.0%(400/400 次运行);均匀随机 0.0% | 最强模型距人类仍差 83 个百分点 |
| 交互式 3D 投影对齐(100 任务测试集) | 平均最终投影 IoU | ReAct 0.628(最高);GPT-5.6-Sol 0.598 | 人类 0.923;位姿贪心 oracle 0.924 | 模型落后人类约 0.30 IoU |
| 旋转方向选择质量 | 有效方向率(Effective Direction Rate) | GPT-5.6-Sol 58.75% | 人类 83.91%;均匀随机 53.78% | 模型仅比随机高约 5 个百分点,落后人类 25.16 个百分点(配对 95% CI 不含 0) |
| IoU 贪心 vs 位姿贪心 oracle | 任务成功率 | IoU 贪心 39.0%(最终 IoU 0.725,16.49 步) | 位姿贪心 100.0%(最终 IoU 0.924,8.32 步) | 差距 61 个百分点,定位瓶颈在 3D 位姿估计而非 2D 匹配 |
| 输入消融(GPT-5.6-Sol,30 任务) | 任务成功率 | 全输入 16.67%(最终 IoU 0.5656) | 去交互历史 0.00%;去辅助视图 3.33%;两者皆去 6.67% | 历史贡献 +16.67 个百分点,去历史后 30° 动作占比 96.76% |
| 跨几何对照(各 30 任务,参考长度分布完全匹配) | 成功率 / 平均最终 IoU | Poly Haven 真实网格 20.0% / 0.7179 | 图标挤出几何 16.7% / 0.5656 | 熟悉几何 +3.3 个百分点 / IoU +0.15,提示预训练形状先验仍起作用 |
局限与改进
作者承认:(1) 3D 物体由有限的 2D 图标挤出,形状多样性受限,无法完全代表复杂 3D 几何;(2) 每个任务只有单一目标物体和离散旋转动作,交互动力学比连续物理环境简化。我的补充观察:(1) 成功判据只看投影 IoU,对称物体存在多个等价姿态,任务实际测的是『剪影匹配』而非严格位姿恢复——位姿误差仅作诊断,『成功不等于位姿正确』使结论解释要小心;(2) 100 任务测试集置信区间很宽(如 Sol 17.0% 的 95% Wilson CI 为 [10.89, 25.55]),模型间 17% vs 16% vs 10% 的排序在统计上未必可靠,作者自己也承认单看排序不能确立方法差异;(3) 人类被试仅 20 名本科生、每任务无练习,样本代表性有限;(4) 闭源模型为 temperature 0 单次运行,无多种子方差;(5) 图标抽象形状可能系统性偏向人类视觉系统擅长的轮廓组织,模型劣势存在被放大的可能。
独立分析的弱点
(1) 离散动作空间可能低估模型能力:$30°$ 粗调占主导,若模型内部有连续旋转的隐式估计,离散化会引入量化误差——可增加 $0.5°$ 级微调档或允许连续角度输出来检验。(2) 数值反馈完全隐藏:模型看不到 IoU,只能从图像对比推断;可加『文本化 IoU 反馈』消融,区分『感知差』与『利用反馈差』两种失败。(3) 单物体、单目标、无遮挡:真实具身场景常有多物体遮挡与装配,结论向具身导航外推有限——可引入遮挡源或多物体组装任务。(4) 重复行为缺乏显式建模:SpatioLM 91.12% 动作坍缩、失败案例中 Sol 连打 12 次同向 $30°$(重复率 53.35%、78% 停滞结局),说明部分模型缺乏策略更新机制——可显式刻画重复行为或测试反重复提示约束。(5) 对称性估计的数值容差:位姿误差依赖附录 D 的估计流程(99 百分位距离阈值 $3h + 10^{-6}$、2° 步长镜像搜索),高对称物体的诊断指标可能有系统噪声——建议对高对称子集做敏感性分析。
未来方向
作者提出:(1) 用生成模型合成更丰富的 2D 图标或直接构建更表达力的 3D 网格,扩大任务与形状多样性;(2) 引入连续旋转控制、外部遮挡、多物体对齐/装配任务以提高挑战性;(3) 自动生成的任务可作为强化学习微调的可扩展环境,研究交互训练能否改善模型对视觉反馈的利用。基于成果可延伸:(1) 把『位姿贪心 vs IoU 贪心』的差距转化为训练信号——用位姿误差作过程奖励,检验能否教会模型『接受 2D 短暂变差换 3D 变好』的策略,这是 211 匹配状态分析最直接的落地;(2) 研究交互历史的压缩与记忆机制:消融显示历史主要影响细粒度控制($30°$ 占比 96.76% vs 62.75%),可测试显式位姿假设跟踪模块能否恢复 $1°$ 级微调能力;(3) 用保留的 574 个任务做 SFT/RL 训练,报告训练前后成功率、有效方向率与行为指标的变化;(4) 把同一流水线推广到平移+旋转的 6D 对齐、透视投影和动态场景,检验结论的普适性。
复现评估
复现条件较好。论文承诺发布任务构建代码、评测流水线和完整 674 任务数据集;任务生成完全确定性(种子随任务存储,深度采样与渲染参数全部公开);图标来自 Game-icons 开源库(CC BY 3.0 / CC0,固定快照 commit b659ba7),许可清晰并保留署名。评测细节完备:附录 L/M 给出完整提示词、超参(temperature 0、推理努力 medium、最大 8192 输出 token、1500 秒超时)、agent 配置(ReAct/Magentic 的工具与轮次限制、Python 工具的 300 秒/4GiB 限额)与人类界面说明;API 总成本 $1,482.07 附逐模型 token 账目(Table 20,单模型约 $6–$359);本地模型 SpatioLM 用 8×A100-40GB bf16 贪心解码。复现难度:评测侧低(照跑代码,闭源 API 每模型约百美元量级);人类基线侧中等(需招募 20 名被试 ×4 轮,每任务约 4.6 分钟);扩展构造(新图标源、连续动作)需理解球域挤出与双搜索流水线,工程量中等。总体属于可复现性优秀的基准论文。
论文图表
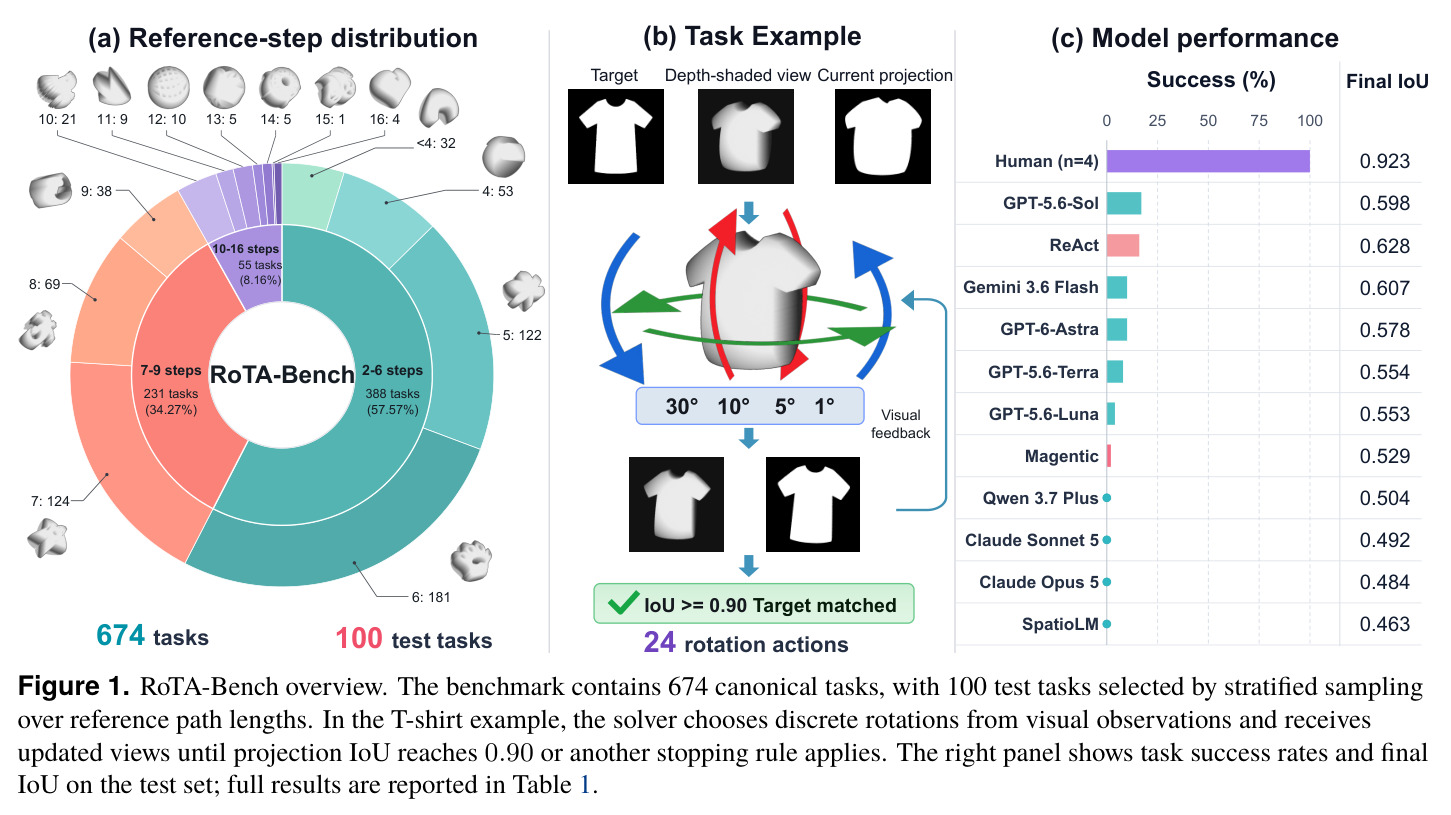
总览图:左侧显示 674 个任务按参考路径长度的分布(2–6 步 388 个、7–9 步 231 个、10–16 步 55 个);中间是 T 恤任务示例,展示目标剪影、深度着色视图、当前投影以及 $30° \rightarrow 10° \rightarrow 5° \rightarrow 1°$ 的粗到细控制;右侧是各方法在 100 任务测试集上的成功率与最终 IoU 条形图(人类 0.923 一路到 SpatioLM 0.463)。
一图看全基准规模、任务形态与核心结果——人类与模型的断层一目了然,是论文的『门面图』。
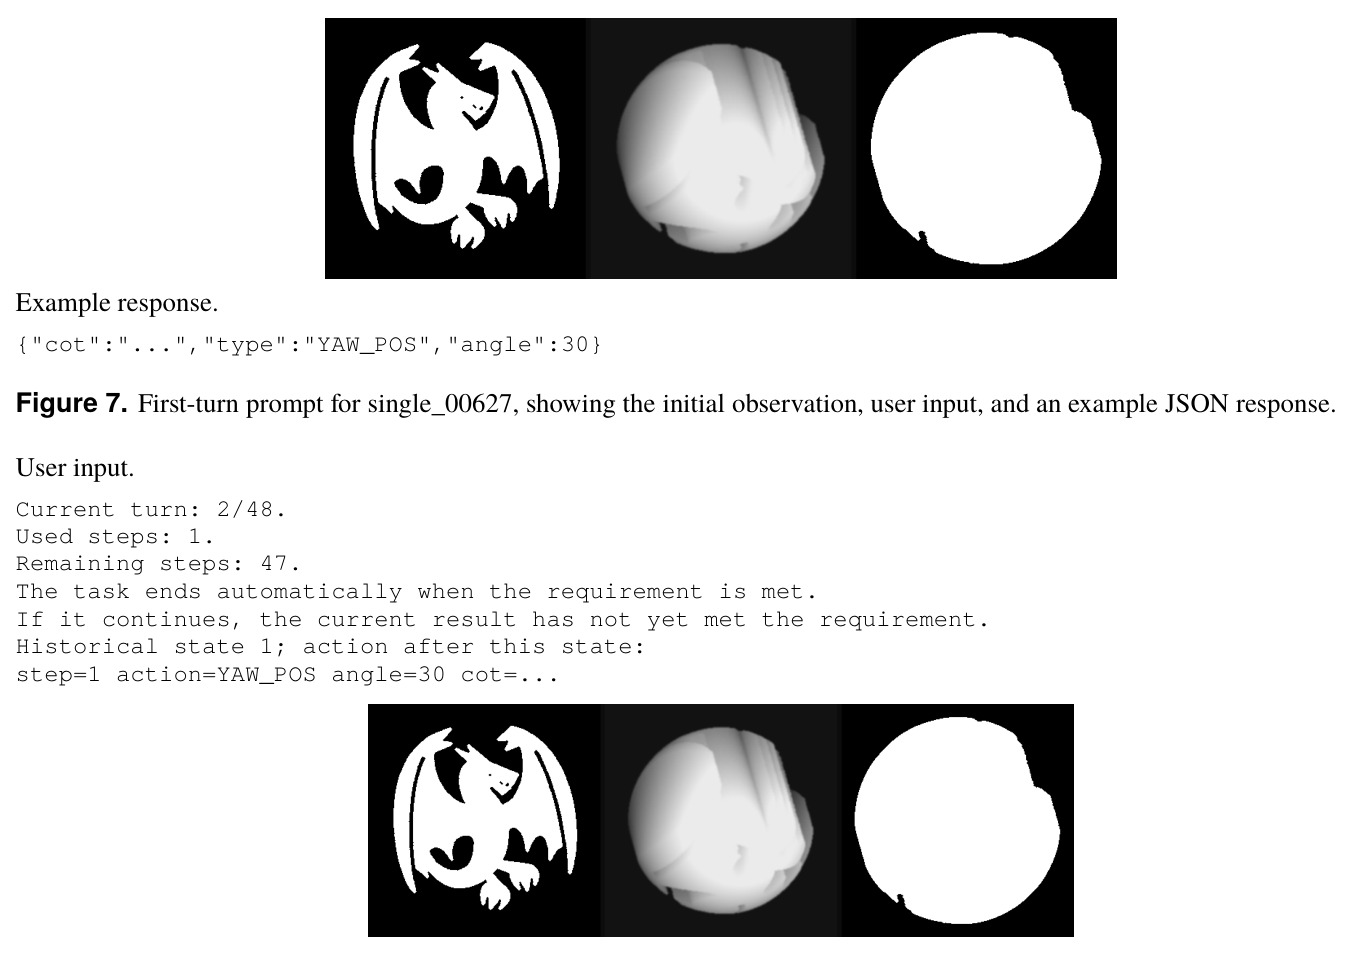
失败案例的完整 12 步轨迹:模型连续 12 次选择同方向 $30°$ yaw,绕整圈回到初始姿态(IoU 0.450),思维链反复声称要『暴露隐藏的面』却从不改变策略,最终因停滞规则终止。
典型失败模式(重复动作、无策略更新、停滞终止)的最好例证,解释 Table 12 中 Sol 53.35% 的重复率与 78% 的停滞结局。