多词预测的正确做法 Multi-Token Prediction Done Right
拆解 MTP 梯度滤除低信噪比残差,一行代码零开销恢复 KL 自蒸馏信号
前置知识
下一词预测(NTP)
大语言模型的标准训练目标:给定前缀 $x_{1:t}$,模型最后一层隐状态经线性输出头 $W_\theta$ 与 softmax 得到分布 $p_t^{(0)}$,用交叉熵 $-\log p_t^{(0)}(x_{t+1})$ 监督。理论上任何 token 序列分布都能自回归分解,因此 NTP 长期被视为充分的训练配方,Radford 等人以来一直是 LLM 的通用做法。
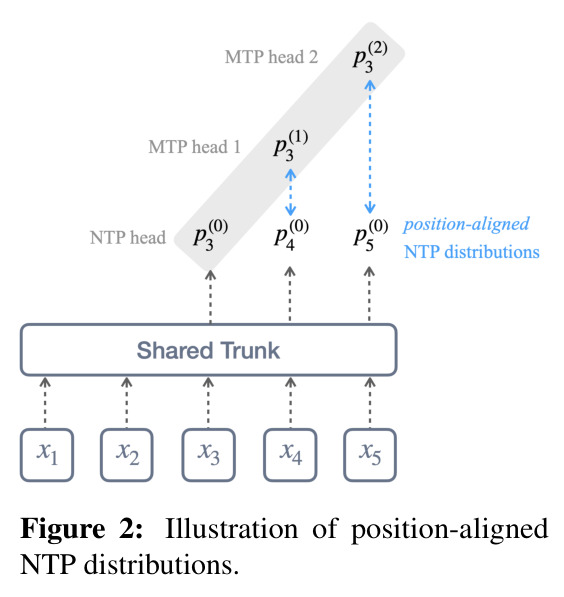
本文中位置对齐的 NTP 分布 $q_t^{(k)}:=p_{t+k}^{(0)}$ 既是 MTP 头自蒸馏的老师,也是投机解码的验证器,读懂 NTP 才能理解整个梯度分解。
多词预测(MTP)
在 NTP 之外增加 $K$ 个预测头,第 $k$ 个头负责预测未来第 $k+1$ 个 token。有 Meta 式并行头和 DeepSeek-V3 式顺序模块两种架构,实践中通常与主模型共享线性输出头 $W_\theta$,总损失为 $\mathcal{L}_{MTP}=\mathcal{L}_{NTP}+\lambda_{MTP}\sum_k\mathcal{L}^{(k)}_{MTP}$。MTP 能缓解下一词监督的短视性、提升数学与代码等长程任务,并让 MTP 头充当投机解码草稿器,已被 DeepSeek-V3/V4、Nemotron 3、GLM-5、Kimi K3 等广泛采用。
本文的全部理论都围绕标准 MTP 交叉熵梯度展开,必须先理解其损失结构和共享输出头这一关键设定。
KL 散度与自蒸馏
KL 散度 $D_{KL}(q\|p)$ 度量两个分布的差异。自蒸馏指让学生分布去拟合模型自身的另一路输出:这里学生是 MTP 头的 $p_t^{(k)}$,老师是对齐位置的 NTP 分布 $q_t^{(k)}$(对老师做 stop-gradient)。此时 KL 对学生隐状态的梯度恰为 $W_\theta^\top(p_t^{(k)}-q_t^{(k)})$,只依赖两个预测分布之差。
论文的核心发现是这个 KL 梯度本来就藏在标准 MTP 的交叉熵梯度里,Soft-MTP 要做的就是把这份信号干净地分离出来。
投机解码
一种无损推理加速技术:草稿模型快速连续提议多个 token,目标模型一次前向并行验证,与自身预测一致的 token 被接受、不一致处回退重来。预训练中的 MTP 头可以顺手充当草稿器。草稿的接受率由草稿分布与目标模型 NTP 分布的距离决定(严格说是 TV 距离,KL 通过 Pinsker 不等式给出间接上界)。
把 MTP 头向自身 NTP 分布对齐正是为了提高接受率,这解释了为什么论文愿意接受『偏向 NTP 分布』这一偏差。
直通梯度路由
源自 Bengio 等人的 straight-through estimator 思想:前向计算数值保持不变,反向时让梯度沿人为解析设计的路径流动。本文的具体用法是把 MTP 隐状态以 $\mathrm{sg}(h^{(k)})-h^{(k)}$ 的差值叠加进 NTP 隐状态,得到 $\tilde h_t=h_t^{(0)}+\sum_k[\mathrm{sg}(h_{t-k}^{(k)})-h_{t-k}^{(k)}]$:前向数值完全等于 $h_t^{(0)}$,但梯度会额外流进 MTP 隐状态。
Soft-MTP 的一行代码改动全靠这个技巧实现:不改前向、只改反向,从而在数值无损的前提下精确消去残差梯度。
偏差-方差分解与梯度信噪比
随机小批量上的梯度可分解为期望方向(信号 $S_c=\|\mathbb{E}_\xi[g_\theta^c]\|^2$)与围绕该方向的方差(噪声 $N_c=\mathrm{tr}(\Sigma_c)$),信噪比 $\mathrm{SNR}=S_c/N_c$ 与 McCandlish 等人的梯度噪声尺度互为倒数。one-hot 标签是对真实下一 token 分布的采样,天然引入零均值、无法随规模或训练消除的采样噪声。
论文用 SNR 论证残差 $g_{res}$ 为何有害且随规模变本加厉:其信号(NTP 误差)随模型变大而缩小,噪声却不可约减。
研究动机
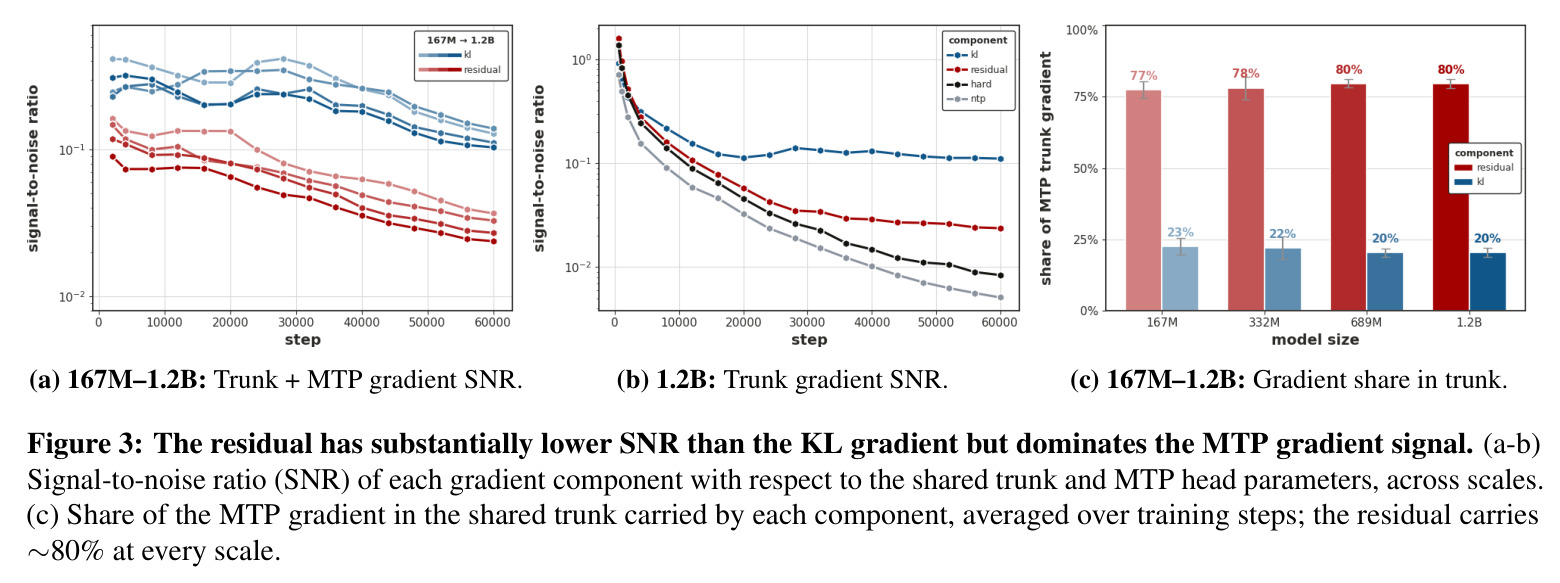
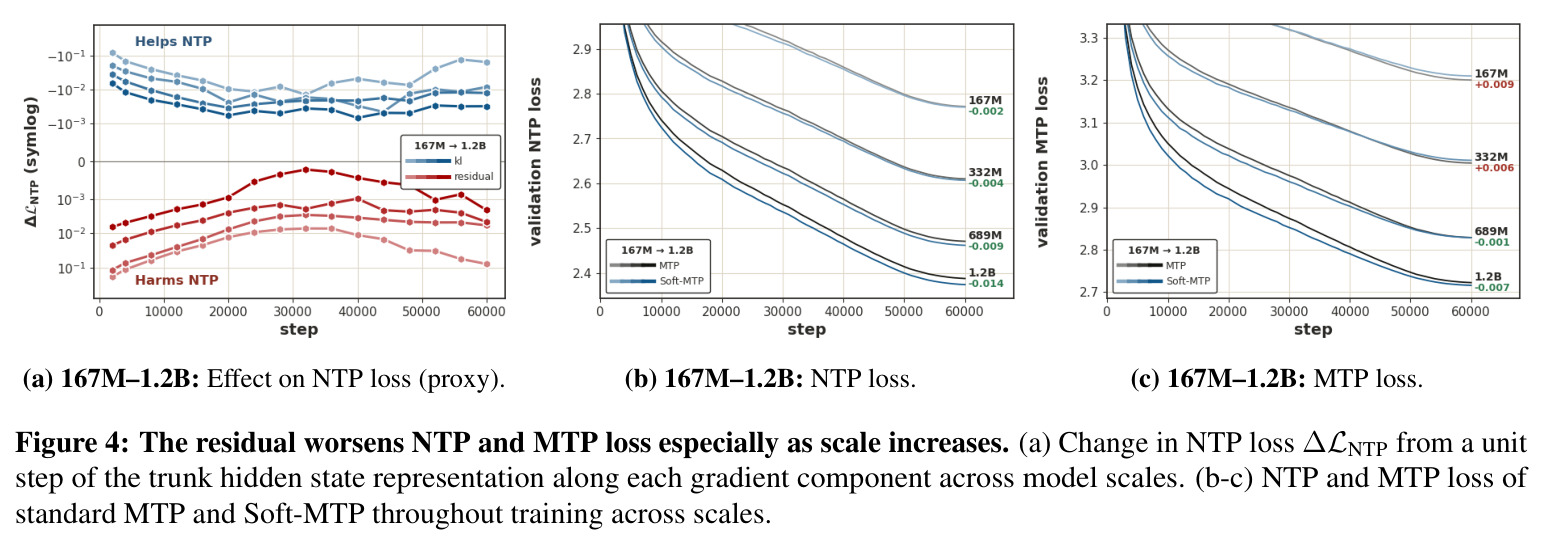
多词预测(MTP)已成为大模型预训练的标配组件,DeepSeek-V3/V4、Nemotron 3、GLM-5、Kimi K3 等都用它提升下游性能并为投机解码提供草稿器。但在投机解码中,MTP 草稿只有与目标模型自身的 NTP 分布一致才会被接受,最直接的做法是让 MTP 头通过 KL 自蒸馏去模仿自身 NTP 分布;然而显式计算 KL 需要物化词表大小的教师与学生 logits 矩阵,内存昂贵且与现代预训练标配的 fused cross-entropy 内核不兼容,因此前沿模型仍然用对数据的普通交叉熵训练 MTP 头。本文进一步揭示标准 MTP 有更深层的问题:其交叉熵梯度可精确分解为自蒸馏项 $g_{KL}$ 与残差 $g_{res}$ 两项,实测残差的信噪比只有 KL 项的约四分之一(167M 时差 4.1 倍,1.2B 时扩大到 4.6 倍),却占据共享主干中约 80% 的 MTP 梯度范数;沿残差方向对主干隐状态走单位步会持续升高 NTP 损失。也就是说,这个占大头的成分既噪声大、又与下一词学习相冲突,而且随规模增大愈发严重。
本文的目标是本文的目标是把标准 MTP 改造成只传播 KL 自蒸馏信号的训练目标,且不付出任何额外代价。具体而言:(1)精确去掉 MTP 梯度中低信噪比的残差项 $g_{res}$,只保留把 MTP 头拉向自身 NTP 分布的 $g_{KL}$,从而同时改善 NTP 与 MTP 两方面的学习并提升投机解码接受率;(2)全程不显式计算 KL、不物化任何词表大小的矩阵,保持与 fused cross-entropy 内核以及数据并行、流水线并行、专家并行等前沿训练配置的兼容;(3)不新增参数,无可测量的吞吐与显存开销;(4)在 167M 到 1.2B 的每个规模上都要验证:NTP 困惑度更低、零样本准确率更高、自投机解码更快,微调后数学与代码推理更强。最终作者希望把它做成一个『一行代码的免费午餐』。
与已有工作不同的是,已有的 MTP 自蒸馏路线各有代价:NextLat(Teoh et al., 2025)显式计算 KL,需要物化师生两个全词表分布;Zhao et al.(2026a)用 top-k logits 近似、Kirchenbauer et al.(2026)用 argmax 近似,都有精度损失;Chang & gpt-5.5-xhigh(2026)缓存教师对 KL 梯度的贡献,但仍需物化教师分布且要求冻结输出头。本文的独特切入是换一个问法:不去想『如何便宜地计算 KL』,而是问『标准 MTP 的交叉熵梯度里是否已经藏着这份 KL 信号』。借助 MTP 头与 NTP 头共享线性输出头 $W_\theta$、且监督的是仅错开 $k$ 个位置的同源数据这一结构,作者把 MTP 梯度精确分解为 $g_{KL}+g_{res}$,把问题转化为『如何在反向传播中消去残差』,用直通梯度路由即可零成本解决;同时还意外发现保留输出头上的 CE 监督能避免读出几何坍缩,使 Soft-MTP 在多数指标上匹配甚至超过昂贵的显式 KL 蒸馏。
核心方法
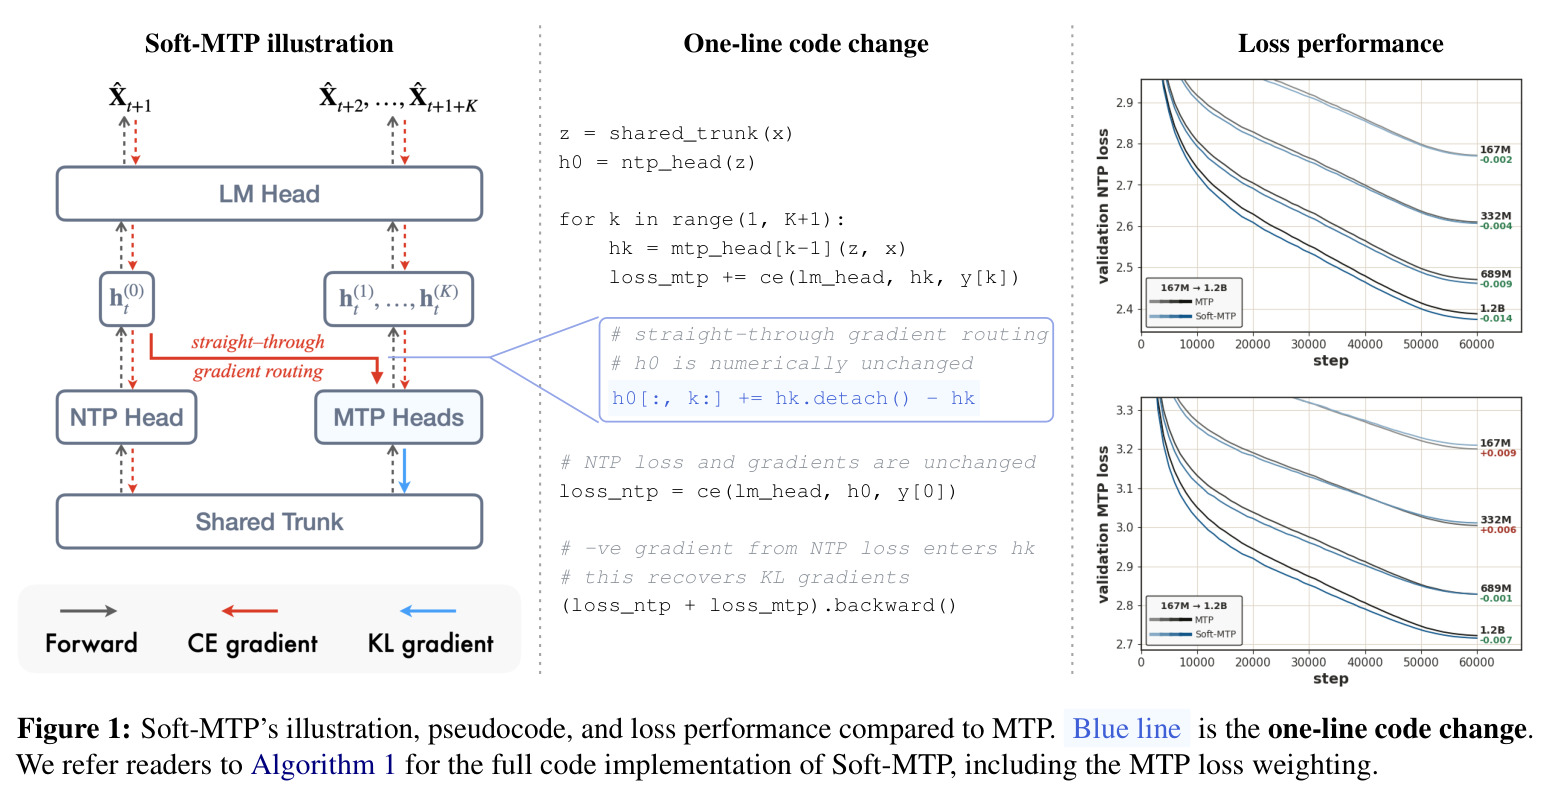
先看直觉:第 $k$ 个 MTP 头预测 $x_{t+k+1}$,而位置对齐的 NTP 分布 $q_t^{(k)}:=p_{t+k}^{(0)}$ 预测的是同一个 token。于是 MTP 交叉熵梯度 $g_{hard}=W_\theta^\top(p_t^{(k)}-x_{t+k+1})$ 可通过插项精确改写为 $g_{KL}=W_\theta^\top(p_t^{(k)}-q_t^{(k)})$ 加上残差 $g_{res}=W_\theta^\top(q_t^{(k)}-x_{t+k+1})$:前者正是以 $q_t^{(k)}$ 为 stop-gradient 老师的 KL 自蒸馏梯度,后者是把对齐位置 NTP 隐状态的 CE 梯度搬到了 MTP 头上。既然 $g_{res}$ 恰等于 NTP 损失对 $h_{t+k}^{(0)}$ 的梯度,只需让 NTP 损失『额外』向 MTP 隐状态流入一份 $-g_{res}$,两者相加就只剩 $g_{KL}$。实现上引入增广隐状态 $\tilde h_t=h_t^{(0)}+\sum_k[\mathrm{sg}(h_{t-k}^{(k)})-h_{t-k}^{(k)}]$:前向数值不变,反向自动注入 $-g_{res}$,一行代码完成,且对 DeepSeek 式顺序与 Meta 式并行 MTP 都适用。
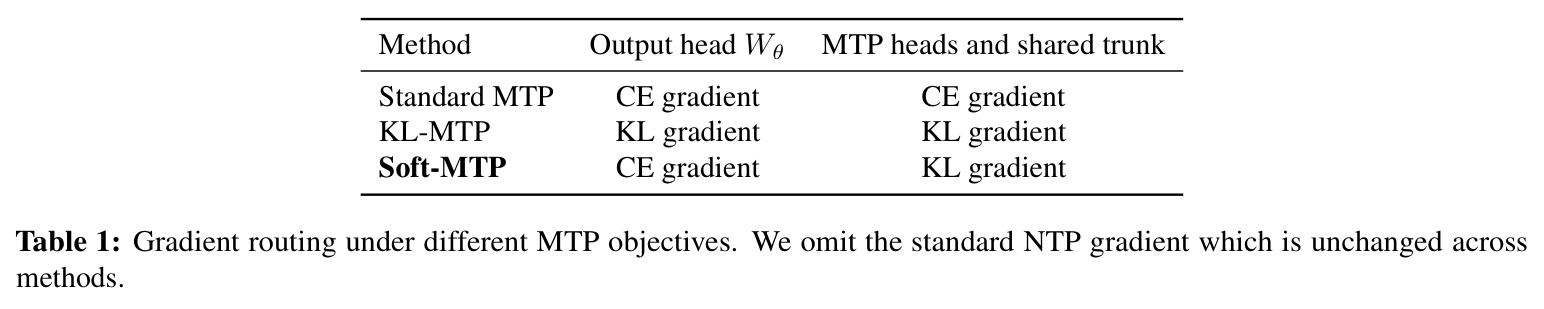
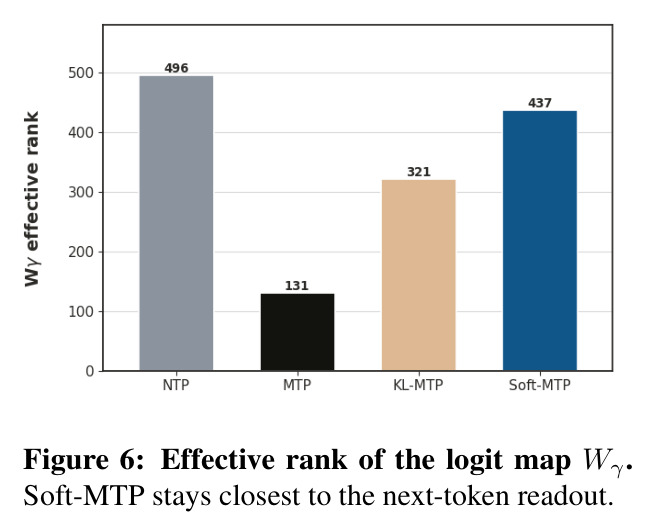
核心创新是 KL 梯度恢复技巧:当两个分布共享线性输出头时,其前向 KL 的梯度 $W_\theta^\top(p-q)$ 可由两个交叉熵梯度相减精确恢复,完全无需显式构造或存储任何分布。实现载体是直通式梯度路由:把第 $k$ 个 MTP 隐状态以 $hk.\mathrm{detach}()-hk$ 的差值加进对齐位置的 NTP 隐状态,前向数值完全不变,softmax 后仍得到 $q_t^{(k)}$,NTP 自身的优化路径分毫未动;反向时 NTP 损失却向 $h^{(k)}$ 注入恰为 $-g_{res}$ 的梯度(论文式 6)。与显式 KL-MTP 的本质区别有二:其一,KL 信号通过隐状态而非 logits 传播,与 fused CE 内核天然兼容;其二,共享输出头 $W_\theta$ 仍由 CE 拟合数据而非模型自身预测——在 KL-MTP 中 KL 可以靠『降低读出层对师生隐状态差异方向的敏感度』这条捷径作弊,导致 logit 映射有效秩从 NTP 的 496 坍缩到 321,而 Soft-MTP 保持 437,最接近 NTP。
方法步骤详情
以 DeepSeek 式顺序 MTP、$K=3$ 为例:第一步,trunk 前向得到 NTP 隐状态 $h^{(0)}$;第二步,3 个 MTP 模块依次产生 $h^{(1)},h^{(2)},h^{(3)}$,经共享头 $W_\theta$ 得 $p^{(k)}$,对各自主目标 token 算交叉熵得 $\mathcal{L}^{(k)}_{MTP}$,按 $\lambda_{MTP}/K$ 加权并对各头目标数差异重缩放(见附录 Algorithm 1);第三步,做一行改动:把第 $k$ 个 MTP 隐状态以 $hk.\mathrm{detach}()-hk$ 的差值加到 $t+k$ 处的 NTP 隐状态上,得到增广的 $\tilde h$;第四步,用 $\tilde h$ 计算常规 NTP 交叉熵 $\mathcal{L}_{NTP}$,前向数值与原损失完全一致,NTP 优化不受影响;第五步,对 $\mathcal{L}_{NTP}+\mathcal{L}_{MTP}$ 一起反向:$\mathcal{L}_{NTP}$ 向每个 $h^{(k)}$ 注入 $-g_{res}$,与 MTP 的 $g_{hard}$ 合成 $g_{KL}$ 后流入 MTP 头与共享主干,而 $W_\theta$ 上仍接收 CE 梯度。全程零新参数、零额外前向,与 fused CE 内核兼容。
技术新颖性
技术新颖性体现在三个层面。理论层面:首次把 MTP 交叉熵梯度精确分解为 $g_{KL}$ 与 $g_{res}$,并给出偏差-方差解读——$g_{res}$ 由 NTP 误差(偏差,随规模与训练时长缩小)与 one-hot 采样噪声(方差,零均值且不可消除)组成,故删除残差换取的偏差随规模越来越划算,这与实测 SNR 差距从 167M 的 4.1 倍扩大到 1.2B 的 4.6 倍相互印证。实现层面:KL 梯度恢复把『计算 KL』重构为『消残差』,用 stop-gradient 差值复用训练中已有的两次 CE 计算,不需要任何自定义内核,实测吞吐与标准 MTP 仅差 0.07%,fused CE 下峰值显存完全相同(107.0 GB)。目标设计层面:Soft-MTP 并不照搬 KL-MTP 的梯度路由,而是在输出头保留 CE、只对 MTP 头与主干传播 KL(Table 1 的解剖),既避免了 KL 优化在读出层走捷径导致的表征坍缩,又让模型在大多数指标上匹配或超过昂贵的显式 KL 蒸馏。这三点组合使 Soft-MTP 成为对标准 MTP 的严格改进,而非又一种带损的近似蒸馏方案。
实验结果
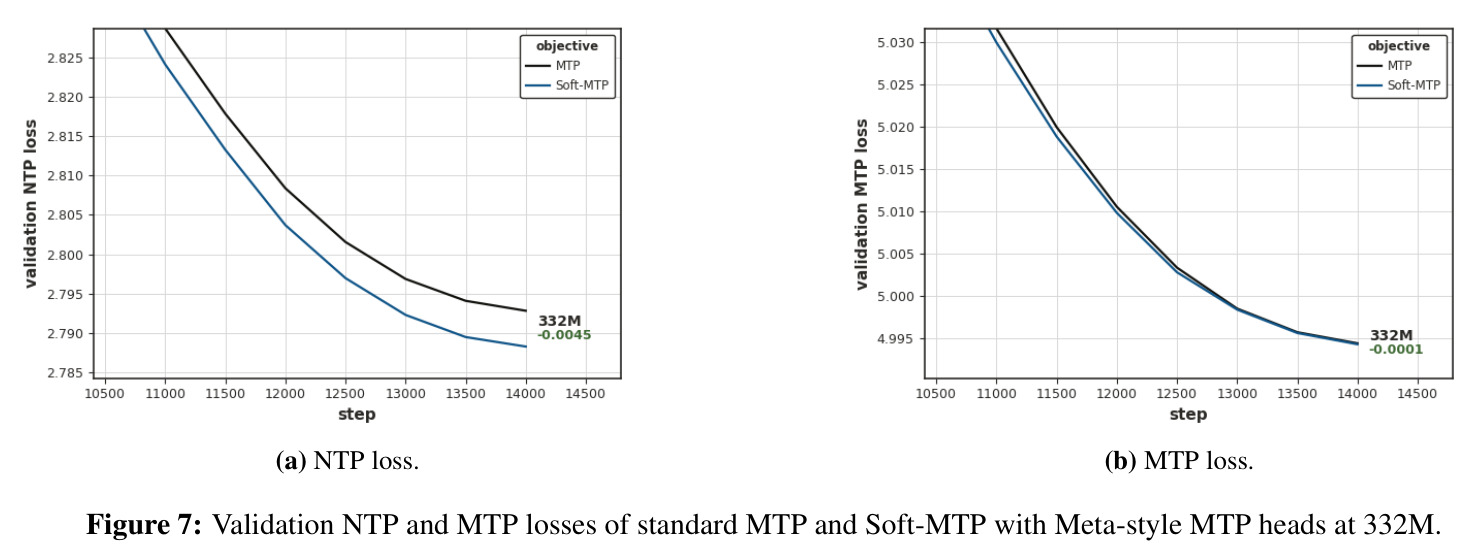
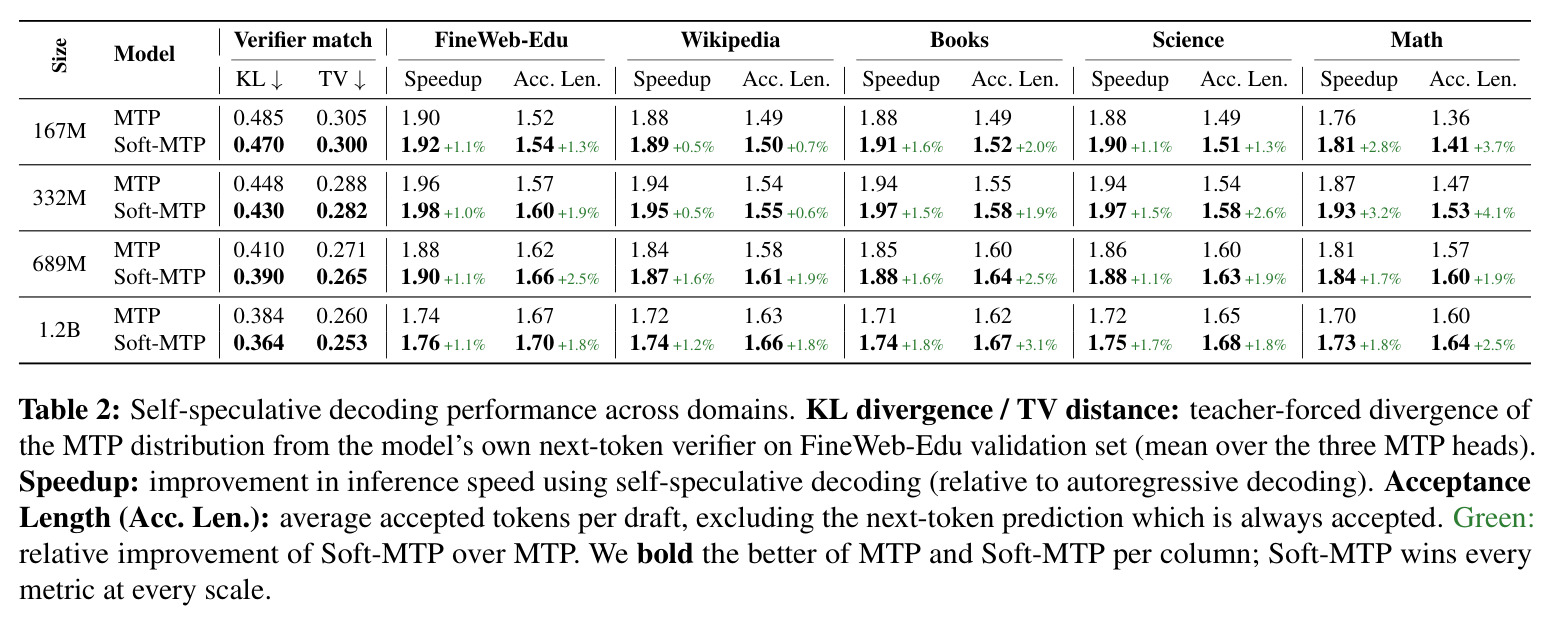
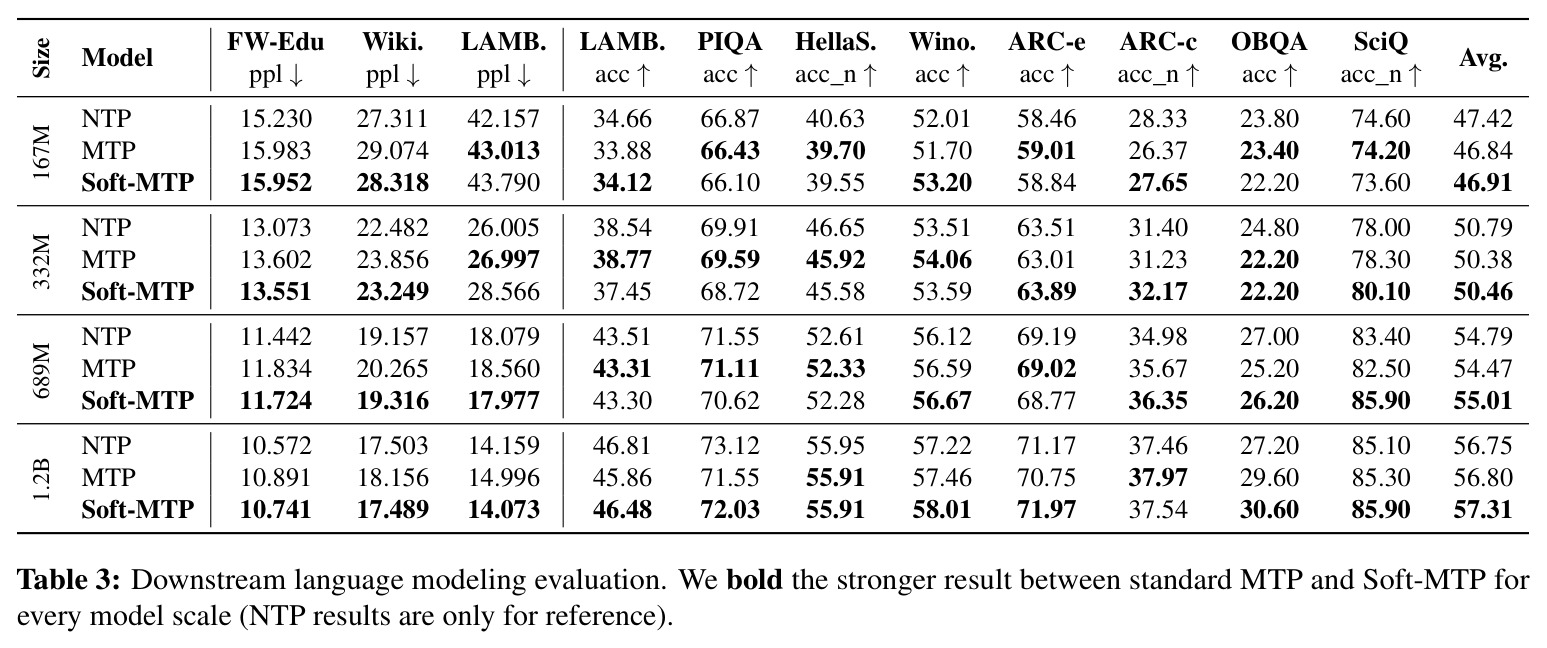
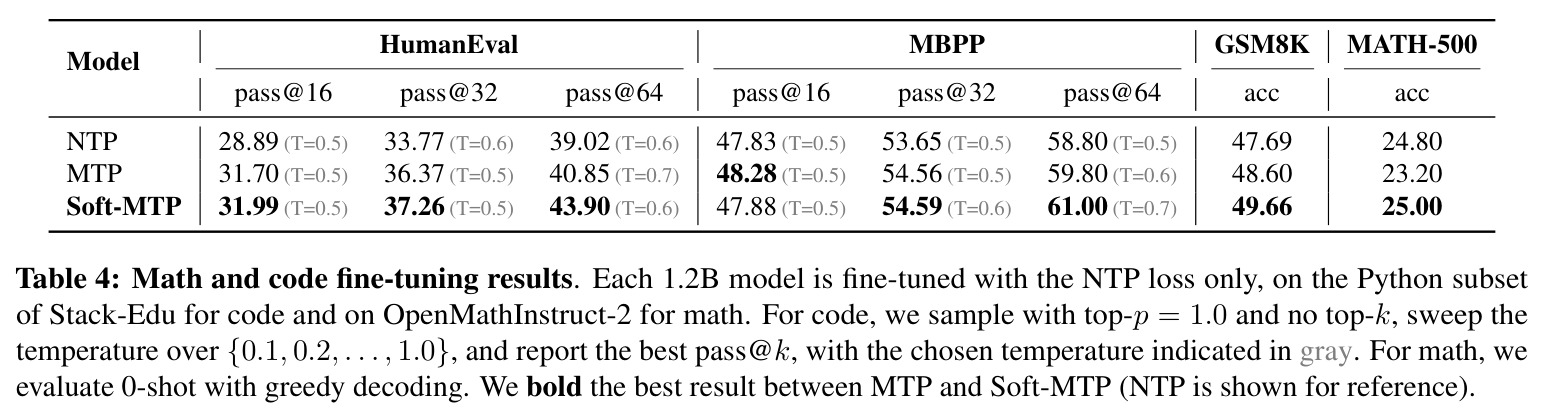
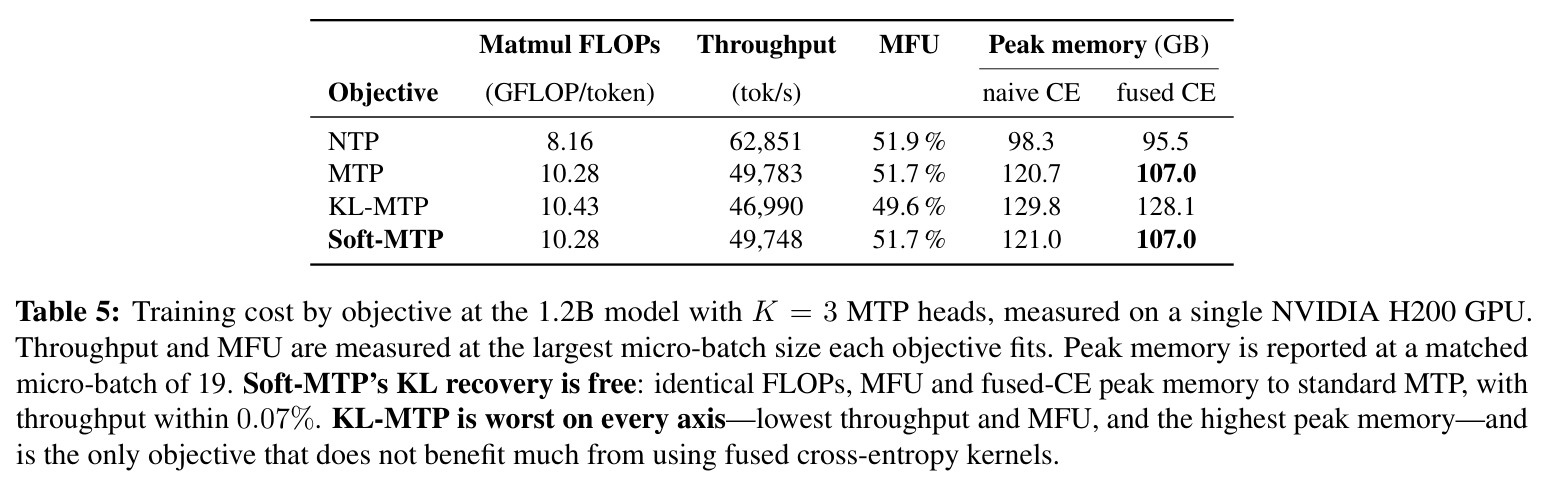
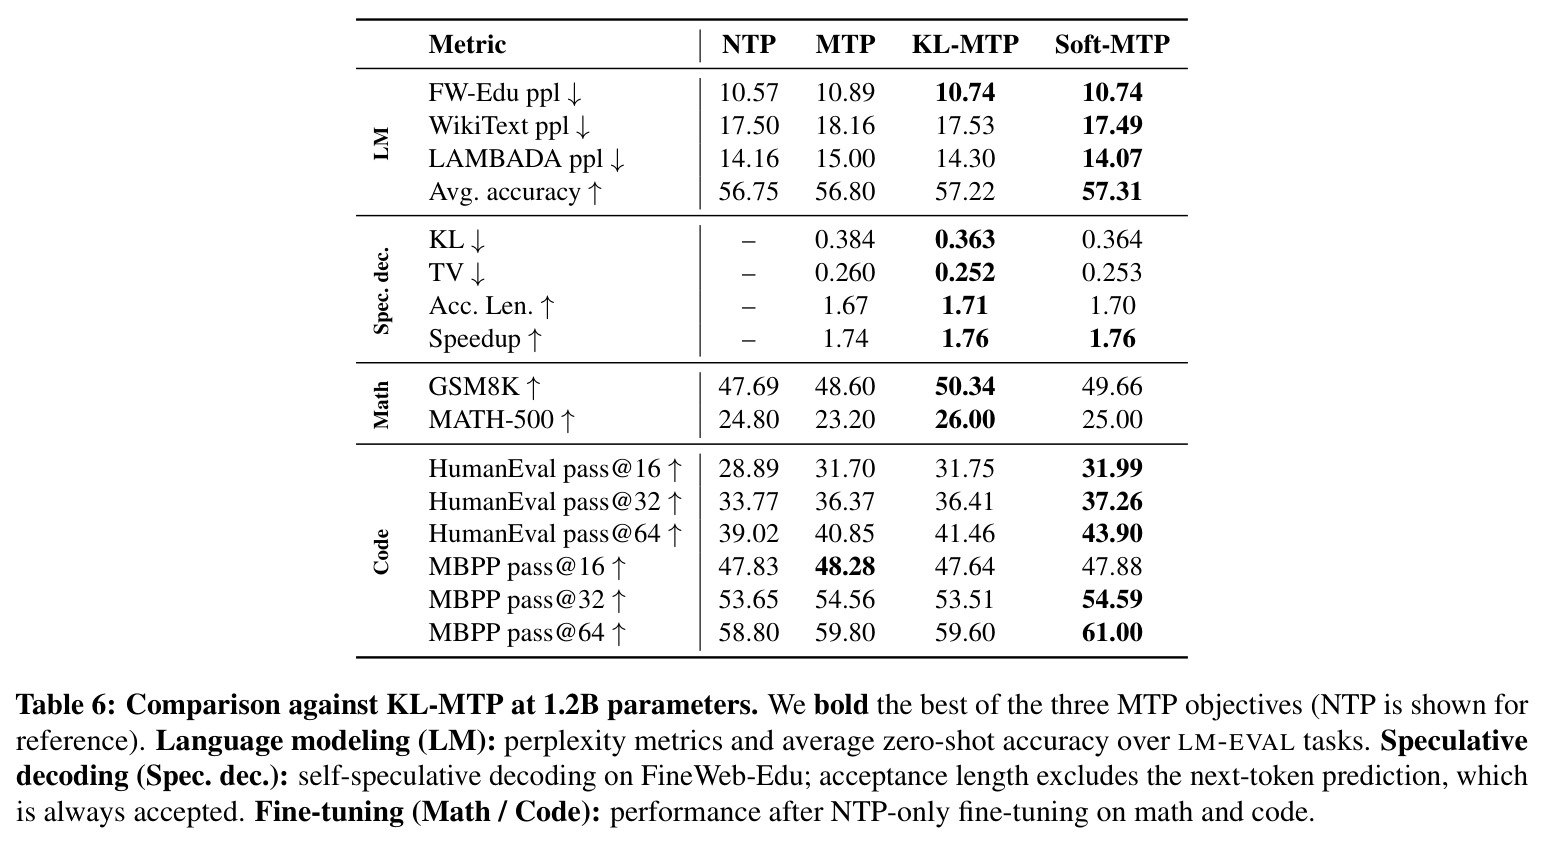
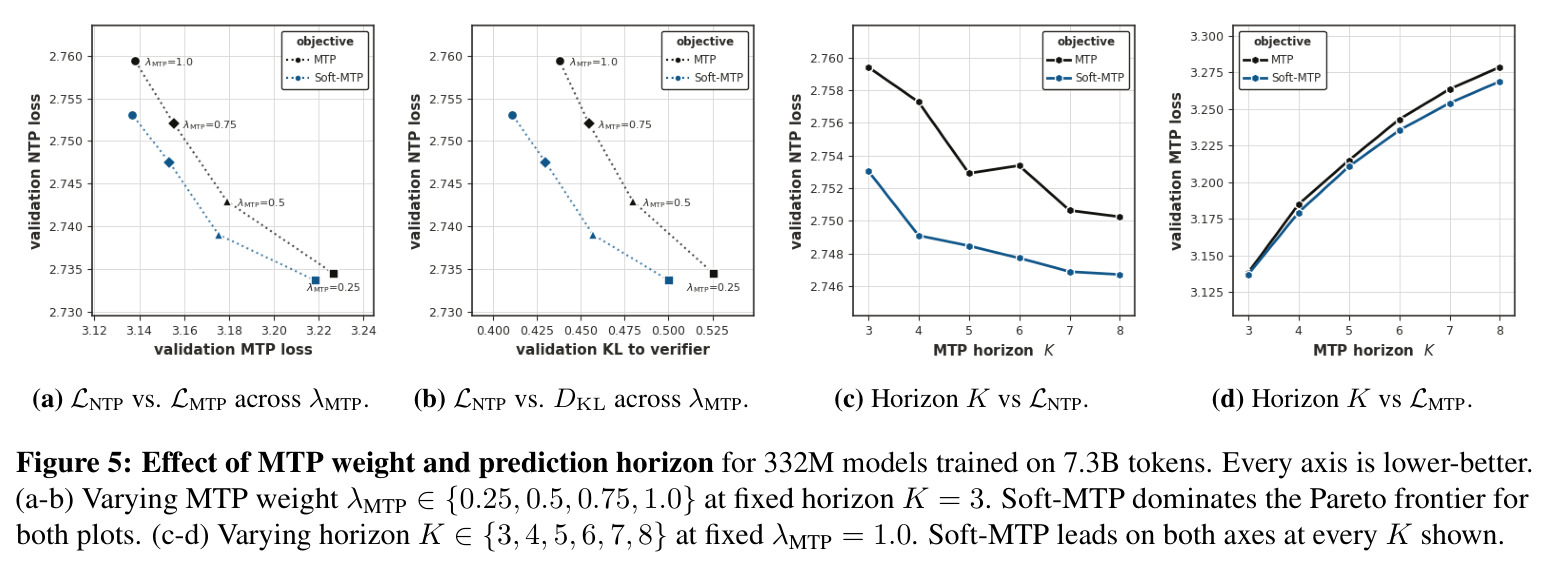
设置:LLaMA 架构 167M/332M/689M/1.2B,FineWeb-Edu 上 60000 步、批 0.5M token、序列长 2048,共 31.5B token(约 1.2B 的 1.3 倍 Chinchilla),Muon 优化器。残差分析(Figure 3/4):残差 SNR 比 KL 项低约 4 倍(4.1×→4.6× 随规模扩大)却占主干 MTP 梯度约 80%;沿 KL 走一步降低 NTP 损失、沿残差走一步升高;Soft-MTP 的 NTP 损失每规模都更低,689M 起 MTP 损失也更低。投机解码(Table 2):五域全胜,1.2B FW-Edu 加速 1.74→1.76(+1.1%)、接受长度 1.67→1.70,KL 0.384→0.364、TV 0.260→0.253;各规模平均接受长度 +1.8–2.2%、加速 +1.4–1.5%。零样本(Table 3):1.2B 平均准确率 57.31(MTP 56.80、NTP 56.75),WikiText ppl 17.49 vs 18.16,LAMBADA 14.07 vs 15.00,689M/1.2B 反超 NTP。微调(Table 4):1.2B 上 GSM8K 49.66 vs 48.60、MATH-500 25.00 vs 23.20、HumanEval pass@64 43.90 vs 40.85、MBPP pass@64 61.00 vs 59.80,八格赢七格且是从不低于 NTP 基线的唯一目标。对比 KL-MTP(Table 6):困惑度打平或更好、平均准确率 57.31 vs 57.22、六个代码指标全胜,数学微调略逊(GSM8K 50.34 vs 49.66),解码相差 ≤0.01。成本(Table 5,H200):与 MTP 同为 10.28 GFLOP/token、MFU 51.7%、fused CE 显存 107.0 GB、吞吐 49748 vs 49783 tok/s(差 0.07%);KL-MTP 吞吐降 5.6%、显存多 21 GB。扫参(Figure 5):$\lambda\in\{0.25,...,1.0\}$、$K\in\{3,...,8\}$ 下均帕累托支配。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 自投机解码(1.2B,FineWeb-Edu) | 推理加速比(相对自回归解码) | 1.76× | 标准 MTP 1.74× | +1.1% |
| 自投机解码(五域平均,各规模) | 平均接受长度 | 各规模 +1.8–2.2%(如 1.2B FW-Edu 1.70) | 标准 MTP(1.2B FW-Edu 1.67) | +1.8–2.2% |
| 与自身 NTP 验证器的距离(1.2B) | KL 散度 ↓ | 0.364 | 标准 MTP 0.384;KL-MTP 0.363 | -0.020 vs MTP |
| 零样本平均准确率(1.2B,9 项 LM-EVAL 基准) | 平均 acc/acc_n ↑ | 57.31 | 标准 MTP 56.80,NTP 56.75 | +0.51 vs MTP,+0.56 vs NTP |
| WikiText 困惑度(1.2B) | ppl ↓ | 17.49 | 标准 MTP 18.16,KL-MTP 17.53 | -0.67 vs MTP |
| GSM8K 数学微调(1.2B) | 准确率 ↑ | 49.66 | 标准 MTP 48.60,NTP 47.69 | +1.06 vs MTP |
| MATH-500 数学微调(1.2B) | 准确率 ↑ | 25.00 | 标准 MTP 23.20,NTP 24.80 | +1.80 vs MTP |
| HumanEval 代码微调(1.2B) | pass@64 ↑ | 43.90 | 标准 MTP 40.85,NTP 39.02 | +3.05 vs MTP |
| MBPP 代码微调(1.2B) | pass@64 ↑ | 61.00 | 标准 MTP 59.80,NTP 58.80 | +1.20 vs MTP |
| 训练吞吐(1.2B,K=3,单卡 H200) | tok/s | 49,748(与 MTP 的 MFU 51.7%、fused CE 显存 107.0 GB 完全相同) | 标准 MTP 49,783;KL-MTP 46,990(显存 128.1 GB) | 与 MTP 仅差 0.07%,比 KL-MTP 快约 5.9% |
局限与改进
作者承认与本文观察到的局限:其一,实验规模最大仅 1.2B、31.5B token,『残差随规模愈发有害』的论证虽与 SNR 趋势一致,但在更大的前沿规模上仍是外推;其二,Soft-MTP 有意让 MTP 头偏向自身 NTP 分布而非数据分布,这个偏差对投机解码是好事,但若把 MTP 头直接用于生成、或在训练早期模型分布与数据分布差距很大时,丢掉 $g_{res}$ 中的 NTP 误差修正项可能有害;其三,数学微调上 KL-MTP 仍更好(GSM8K 50.34 vs 49.66、MATH-500 26.00 vs 25.00),说明输出头上保留 CE 并非处处最优;其四,技巧依赖师生共享线性输出头这一结构假设,且在序列并行/上下文并行下需跨分片交换最多 K 个隐状态梯度;其五,改进幅度不大(零样本约 +0.5 点、解码加速 +1.4–1.5%),论文未报告多种子方差,预训练也只用 FineWeb-Edu 单一语料。此外作者指出 MTP 本身的前景不确定:DeepSeek-V4.1-Flash 已弃用 MTP 转向后训练草稿器 DSpark。
独立分析的弱点
独立分析可见几处弱点。第一,评估语料偏窄:预训练只用 FineWeb-Edu,代码/数学语料上的预训练效果未直接测、仅靠微调间接验证,而 Gloeckle et al. 指出 MTP 对代码增益最明显,Soft-MTP 在这类语料上是否放大优势未知,可补充多语料对比。第二,指标精度:解码加速 +1.4–1.5% 接近工程测量噪声量级,论文未报告方差或显著性检验,应多种子重复并给置信区间。第三,『残差信号随规模缩小』隐含 NTP 误差单调下降的假设,但老师 $q_t^{(k)}$ 来自 k 步之前的隐状态,距离越远误差越大,残差相对价值可能与 $k$ 强相关,论文只给端到端扫描、未按头分别报告 $g_{KL}/g_{res}$ 占比。第四,DeepSeek 顺序 MTP 中后续头以先前头为输入,梯度消融对级联结构的细粒度影响只有整体分析。第五,训练时长为 1.3 倍 Chinchilla,欠训练/过训练区间下结论是否成立未测;零样本 +0.1~0.5 点的实用性也依赖任务对小幅提升的敏感度。
未来方向
作者提出的方向:把 KL 梯度恢复技巧推广到一切『师生共享线性输出头』的 KL 场景,包括 Nemotron 3 Ultra 的 MTP Boosting 后训练对齐、在线自蒸馏 OPSD、off-policy RL 的 score centering,以及 NextLat 这类本就冻结输出头的方法,可省去显式 KL 或 top-k 近似的开销;讨论 MTP 的长期前景,提出『从未做过 MTP 的基座上后训练草稿器(Medusa、EAGLE、DFlash、DSpark)能否弥补预测性表征的缺失』这一开放问题。基于本文成果可延伸的工作:在百亿参数与数万亿 token 规模上验证 SNR 偏差-方差论断,观察增益是否随规模继续扩大;对 TV 距离设计类似的梯度恢复以直接优化接受率;把残差项系数做成可学习或随训练进度退火,兼取无偏与低噪;在代码、数学语料占比高的预训练中检验 Soft-MTP;对不同 MTP 头深度使用不同残差权重;以及把该技巧用于奖励模型蒸馏、RLHF 中的 KL 正则等非 MTP 场景,凡涉及大词表 KL 计算的地方都可能受益。
复现评估
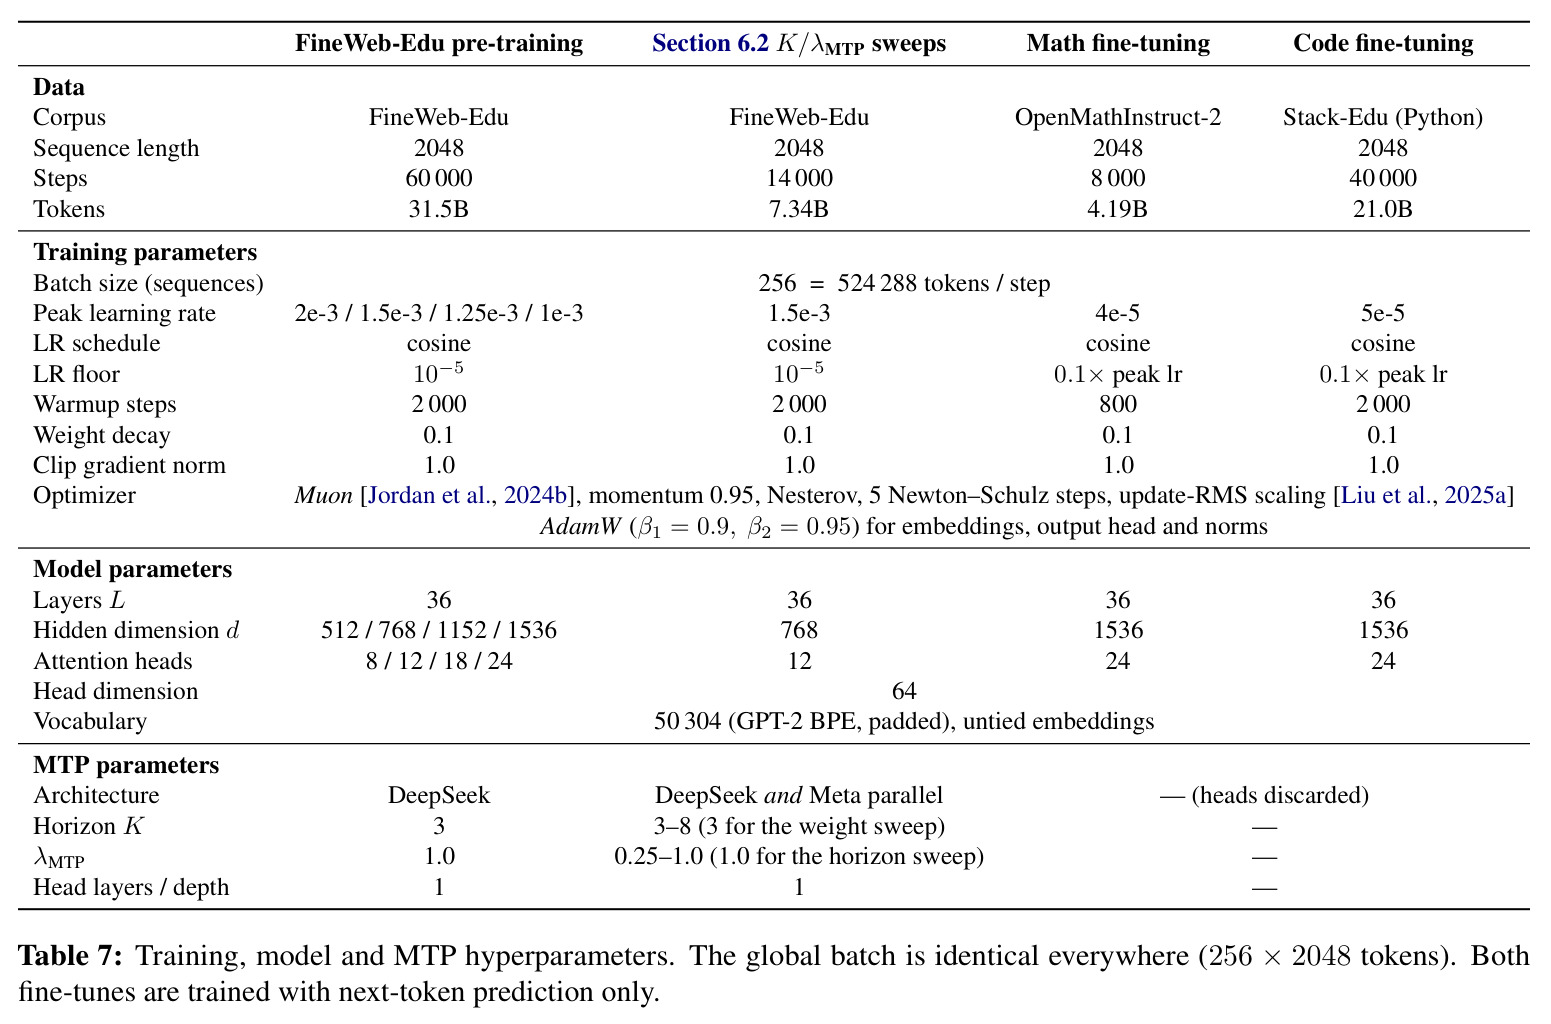
复现条件较好。代码开源于 github.com/JaydenTeoh/Soft-MTP,附录 A 提供完整 PyTorch 风格 DeepSeek 式实现(含 $\lambda_{MTP}/K$ 加权与目标数重缩放),正文 Figure 1 直接给出核心一行改动 $h0[:, k:]\ {+}{=}\ hk.\mathrm{detach}()-hk$,移植到现有 MTP 管线的工程量极小。数据全公开:FineWeb-Edu 预训练、OpenMathInstruct-2(4.2B token)数学微调、Stack-Edu Python 子集(21.0B token)代码微调,评测用 LM Evaluation Harness 与 BigCode Harness。算力上作者用租自 Vast.ai 的 8×RTX PRO 6000 完成主要实验,1.2B×31.5B token 属工作站级预算,167M/332M 单机即可低成本复现。附录 D 给出全部超参(Muon 加 update-RMS 重缩放、序列长 2048、$\lambda_{MTP}=1.0$、每个 MTP 头为 trunk 非嵌入参数的 3.2%)。总体难度中等:核心结论在 332M 以下规模数天内可验证,全套含五域投机解码与微调约需一到两周;需注意复刻附录 B.5 的重缩放细节,否则损失加权与论文不一致。
论文图表