ECHO:超越辅助式多词预测的高效因果自递归 ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
复用主干最后一层预测未来token,监督直接落到生成参数,训练省一半还能深度外推。
前置知识
多词预测(Multi-Token Prediction, MTP)
在标准下一词预测(NTP)之外,让模型同时预测未来第 2、3、…、K 个位置的 token。早期并行式 MTP 从同一隐状态独立预测多个未来位置(Gloeckle 等、Medusa);因果式 MTP(如 DeepSeek-V3)让未来预测步骤之间保持自回归依赖,每步输入上一隐藏状态与已预测 token 的 embedding。MTP 既提供更密集的训练信号,又能在推理时充当投机解码的起草器(drafter)。
ECHO 的全部动机是批判并取代这种『辅助模块式』MTP:理解它的训练结构以及两条局限(监督间接、加深昂贵),是读懂本文问题定义的前提。
投机解码(Speculative Decoding)
一种无损推理加速技术:小模型(drafter)一次起草 K 个 token,大模型(target)并行验证;从左到右接受,遇到第一个被拒绝的 token 即截断,并附赠一个修正 token。设第 $i$ 位接受率为 $a_i$,期望接受长度为 $E[\tau] = 1 + \sum_{d=1}^{K} \prod_{i=1}^{d-1} a_i$——浅层位置的接受率主导整体收益。
ECHO 在推理端的卖点是『模型自己当 drafter』,接受长度(accepted length)是论文的核心推理指标,第 4 节关于 DDS 的理论界(式 5)完全围绕它展开。
循环/共享层 Transformer(Looped Transformer)
让同一块解码器层在不同迭代中反复使用,用参数共享换取计算深度,代表工作包括 Universal Transformer、looped LM 等。它们在相同参数量下沿『同一 token 位置反复精炼表示』的方向递归,通常带来推理能力提升,但在困惑度和闭卷问答上略有牺牲。
ECHO 借用了『共享层递归』的参数效率思想,但递归方向不同——沿时间视野(horizon)轴而非位置轴。辨析这一区别是理解第 2.3 节相关工作对比和本文定位的关键。
稀疏混合专家(Sparse MoE)
把 FFN 换成多个『专家』网络,由路由器为每个 token 只激活少数专家,从而在计算量近似不变的情况下扩大总参数量。本文所有配置共用一个 10B 总参 / 1B 激活(10B-A1B)的隐式注意力 MoE 主干:24 层、多头隐注意力(MLA)、256 个路由专家、每 token 激活 8 个。
论文所有对比都在这一主干上做,固定主干与训练配方才能把性能差异干净地归因到 MTP 设计本身;MoE 也是当前工业界预训练的主流形态。
随机深度(Stochastic Depth)
训练时以一定概率随机跳过某些深层(等价于少训练它们),测试时使用完整网络。深层的训练频率随深度衰减,既省算力又像正则化一样保护网络免受深层噪声干扰,是 ResNet 时代提出的经典技巧。
DDS 的思想与之同构:深层监督噪声更大、对接受长度贡献更小,于是按衰减概率少训深层。论文明确用随机深度类比解释了 DDS 为何有效。
研究动机
现行多词预测(MTP)都是『辅助式』设计:未来词的预测由挂在主干外的专用模块完成,因果式 MTP(DeepSeek-V3)每加一个预测深度就要多一个模块、多一次前向。这带来两个结构性问题。其一,监督落点错位:多视野损失主要训练这些辅助模块,主干只间接获得信号,因此 MiMo 发现给 DeepSeek 式 MTP 加更多 MTP 层不再带来收益,DeepSeek-V3 实际也只训练一个深度为 1 的模块。其二,长视野监督昂贵:每个 horizon 的参数与计算成本线性增长,限制了大规模因果 MTP 预训练的深度,实践中通常只敢开一个草稿深度。推理端同样有麻烦:事后训练的 drafter(EAGLE-3、DFlash、DSpark 等)只在远小于预训练语料的数据上对齐冻结的 target,分布一偏接受率就掉,EAGLE-3 的 warm-start 仍追不上联合预训练的对齐度;而把 drafter 训练扩展到预训练语料又算力巨大,且对主干下游性能没有帮助甚至可能损害训练。
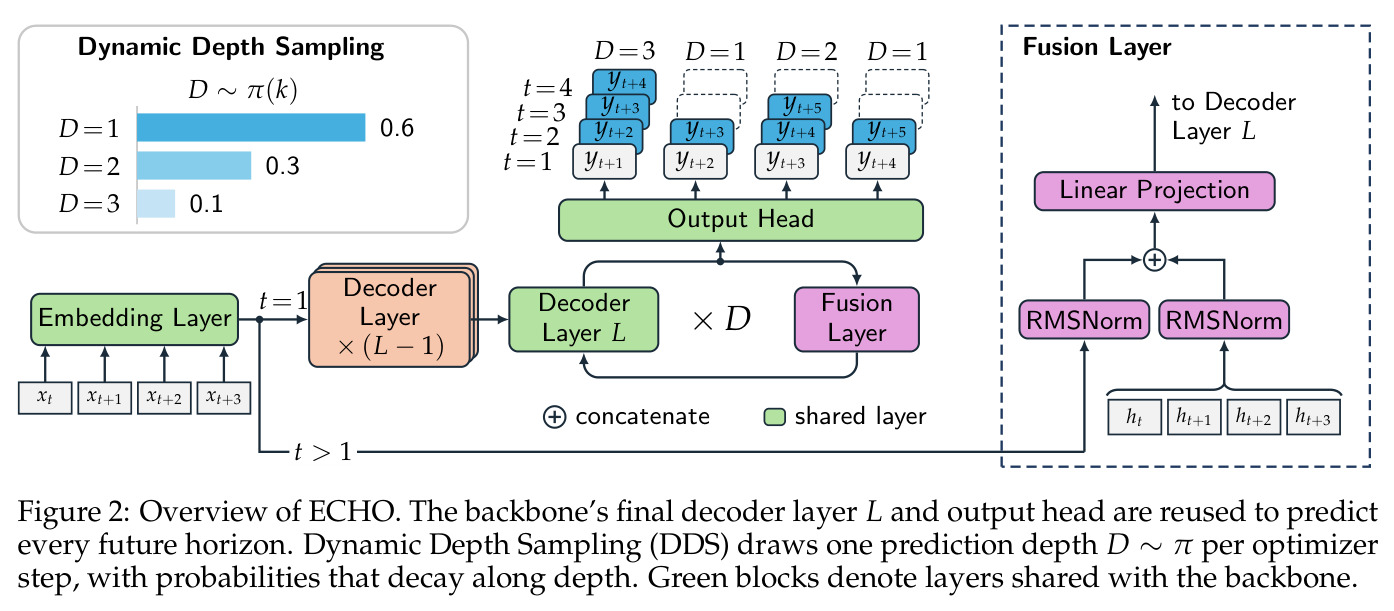
本文的目标是本文要把多词预测从『挂在主干上的辅助任务』变成自回归目标本身的一部分:让主干自己的最后一层直接预测每一个未来视野,使所有深度的监督都落在生成下一个 token 的那批参数上;同时让加深监督的代价可控——用动态深度采样(DDS)按衰减概率抽取每个优化器步的训练深度,把 MTP 额外开销压到 1.5 个『深度-1 展开步』,却有深度 3 的监督效果(E[D]=1.5 对应 K=3)。推理端的目标是彻底取消事后 drafter 微调:预训练好的模型用自己的共享层递归起草,且能外推到超过训练深度的 K(训练到 3、服务到 7),在开放域高熵生成上保持比事后 drafter 更长的接受长度。最终要在 14 项基准、推理与代码类任务、SFT 之后、双倍数据预算和重复实验下验证这套设计的稳健性。
与已有工作不同的是,独特之处在于『递归的方向』。循环 Transformer 沿位置轴递归——同一 token 反复过共享层来精炼表示,代价是困惑度和闭卷问答受损;ECHO 沿视野轴递归——每一步以前一隐藏状态 $h_{t-1}^L$ 和下一个 token 的 embedding 为条件向前多预测一个位置,相当于把『未来的展开』内嵌进自回归目标,因此既有推理收益又不付知识容量的代价(QA 与多选基本不掉分)。第二个切入点是成本核算方式:现有 drafter(DFlash、DSpark)用损失重加权来编码『浅层更重要』,但每步仍训练所有深度;DDS 把这个衰减编码进训练频率 $f_k = P(D \ge k)$,让计算量直接跟随衰减走,从训练调度而非目标函数上对齐投机解码的接受动力学。两件事合起来:预训练目标和推理加速第一次在同一次训练、同一组参数里同时受益。
核心方法
直觉:既然真正生成 token 的是主干的最后一层加输出头,那让这同一组参数去预测未来第 2、3 个 token,多视野监督就会直接改造『真正干活』的权重,而不是耗散在辅助模块里;又因为同一层被反复复用,推理时可以递归迭代任意多次,天然支持超出训练深度的起草。技术路线分三步。一是因果自递归:沿用 DeepSeek-V3 的自回归设计保持视野间因果依赖,用轻量融合层 $F$ 把上一步的最终层隐状态 $h_{t-1}^L$ 与已预测 token 的 embedding $e(x_t)$ 组合后送入共享的最后一层 $T^L$ 和输出头,递归定义 $h_t^L = T^L(F(h_{t-1}^L, e(x_t)))$。二是动态深度采样(DDS):每个优化器步从 $\{1,\dots,K\}$ 按衰减分布 $\pi$ 抽一个深度 $D$,只展开深度 1 到 $D$,期望开销 $E[D]=\sum_k k\pi(k)$,取 $\pi=(0.6,0.3,0.1)$ 得 $E[D]=1.5$。三是推理复用:同一个共享层反复应用即可在 $K>3$ 处继续起草。整个框架唯一新增参数是融合层 $F$。
核心创新是『最终层共享』这一参数结构选择,与 DeepSeek-V3 的对比最能说明本质:辅助式 MTP 的每个 horizon 由专属模块承担,新加深度的损失绝大部分用来训练新模块,主干隐层依旧只为下一个 token 特化——所以 MTP 从深度 1 到 3 十四项基准平均只涨 0.16 分;而 ECHO 把每个 horizon 的损失都直接打在主干最后一层上,加深监督等于加深主干的学习信号——同样从深度 1 到 3 平均涨 0.63 分。第二个关键是 DDS 与接受动力学的对齐:投机解码中第 $d$ 位被到达的概率是 $\prod_{i=1}^{d-1} a_i$,一次深度 $k$ 的拒绝会截断其后 $c_k = K-k+1$ 个草稿,因此浅层主导接受长度。论文证明(式 5):$E[\tau] \ge 1 + K - \tfrac{1}{\sqrt{2}}\sqrt{\mathcal{L}_{\text{MTP}}(f)}$,且衰减的 $f_k$($\pi=(0.6,0.3,0.1)$ 给出 $f=(1,0.4,0.1)$)比均匀训练所有深度更紧。换言之,DDS 让『训练频率的衰减』替代『损失重加权』,把算力集中到决定接受率的浅层,同时像随机深度一样保护主干免受深层监督噪声影响。
方法步骤详情
训练流程如下。第一步:输入序列 $x_t$ 正常过主干(10B-A1B MoE,Muon 优化器,bf16,序列长 4096,全局 batch 1920),得到最终层隐状态与下一词预测损失。第二步(视野 $t=1$):直接取 $h_1^L$ 过输出头做深度 1 的未来预测,无额外模块。第三步(视野 $t>1$):融合层 $F$ 把 $h_{t-1}^L$ 与已预测 token 的 embedding $e(x_t)$ 拼接,送入共享的最后一层 $T^L$(含 RMSNorm、线性投影与输出头)得到 $h_t^L$,再过输出头预测更远的 token,如此递归展开。第四步(DDS):每个优化器步先抽 $D \sim \pi(k)$,$\pi=(0.6,0.3,0.1)$ 对应 $K=3$、$E[D]=1.5$(ECHO-2(7) 则在 $\{1,\dots,7\}$ 上按 $(0.520,\dots,0.016)$ 抽样,$E[D]=2$);只计算深度 1 到 $D$ 的 MTP 损失并反传,梯度直接更新主干最后层与融合层。第五步(SFT):所有配置用同一配方在 32768 上下文、5000 步内过一遍内部 chat 语料,保留各自预训练 MTP 深度。第六步(推理):起草时反复应用 $T^L \circ F$ 递归产出草稿,target 并行验证;训练只到深度 3 也能递归到深度 7——外推靠共享层的重复使用而非新增参数。
技术新颖性
新颖性有四点。其一,结构上『零参数加深』:除轻量融合层 $F$ 外,未来预测用的全部参数就是生成下一 token 的参数,这与 EAGLE/DeepSeek 式『每深一模块』和 Medusa 式『并行多头』都不同,也与 GLM-5 的跨深度共享不同——GLM-5 共享的是辅助模块参数,ECHO 共享的是主干本体。其二,把 MTP 从辅助目标升格为自回归目标的一部分,训练信号落点从『模块』变为『主干』,这直接解释了它随深度持续增益而辅助式 MTP 饱和的现象。其三,DDS 是首个把『训练频率』而非『损失权重』作为衰减载体的多视野训练方案:DFlash/DSpark 在每步训练所有深度时重加权损失,DDS 则让每步只训一个抽到的深度,与 stochastic depth 共享『少训深层』的直觉但作用在视野轴上。其四,理论侧给出接受长度下界(式 5),把 DDS 调度与 $\mathcal{L}_{\text{MTP}}$ 的收紧程度定量挂钩,说明衰减调度为何比均匀监督更利于 $E[\tau]$。这四点合起来,让『预训练目标』与『推理加速』首次在同一次训练里同时受益。
实验结果
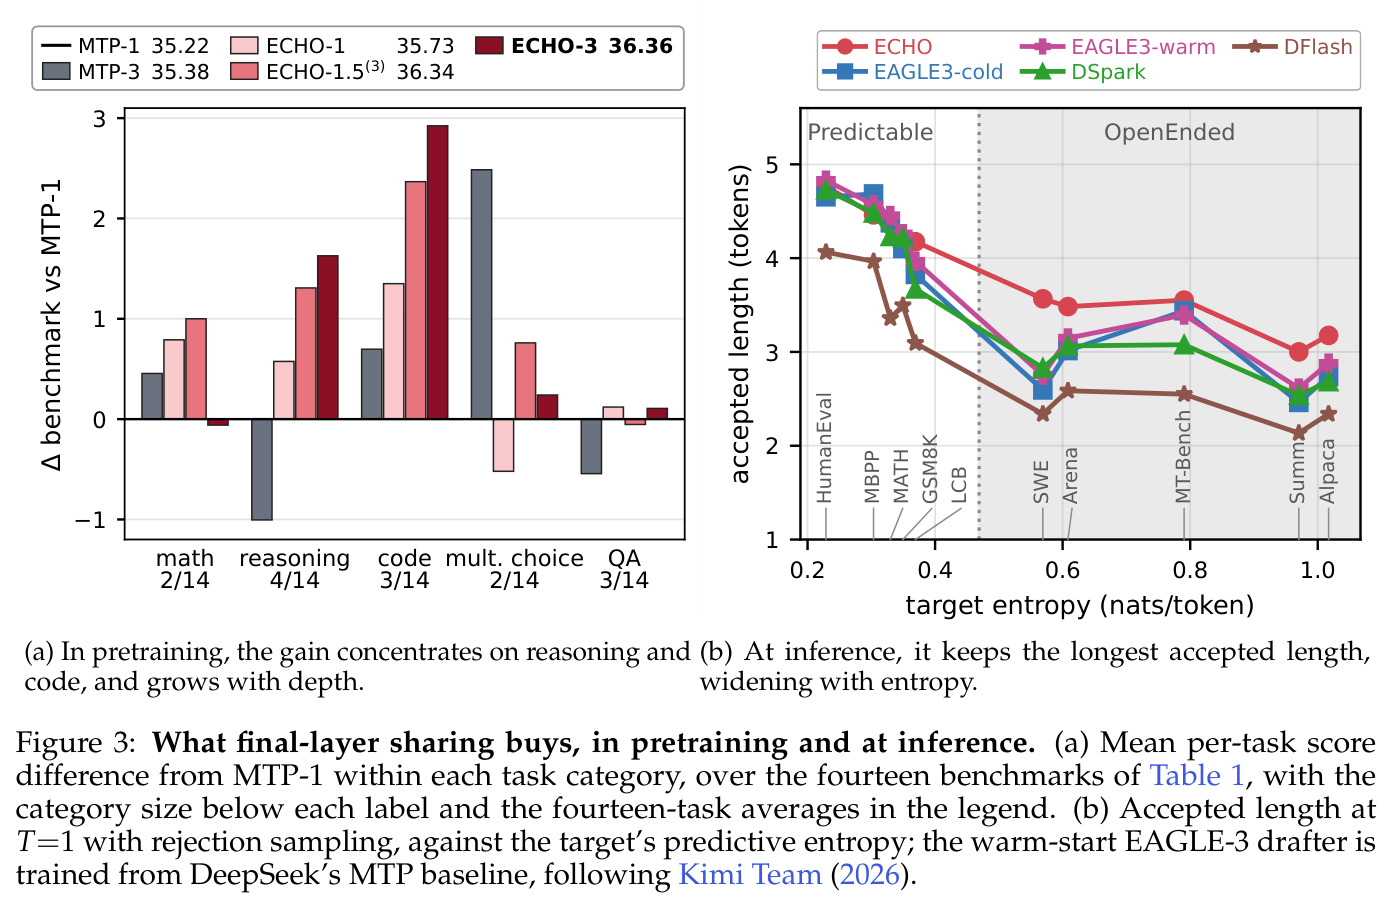
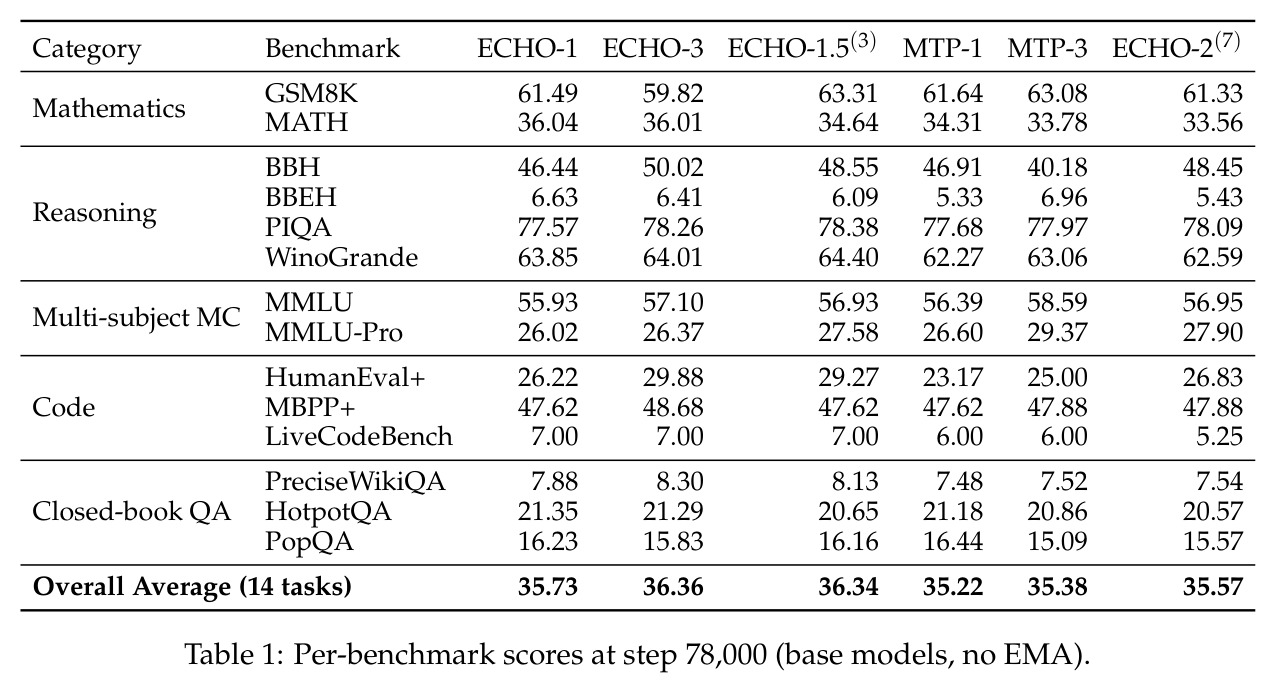
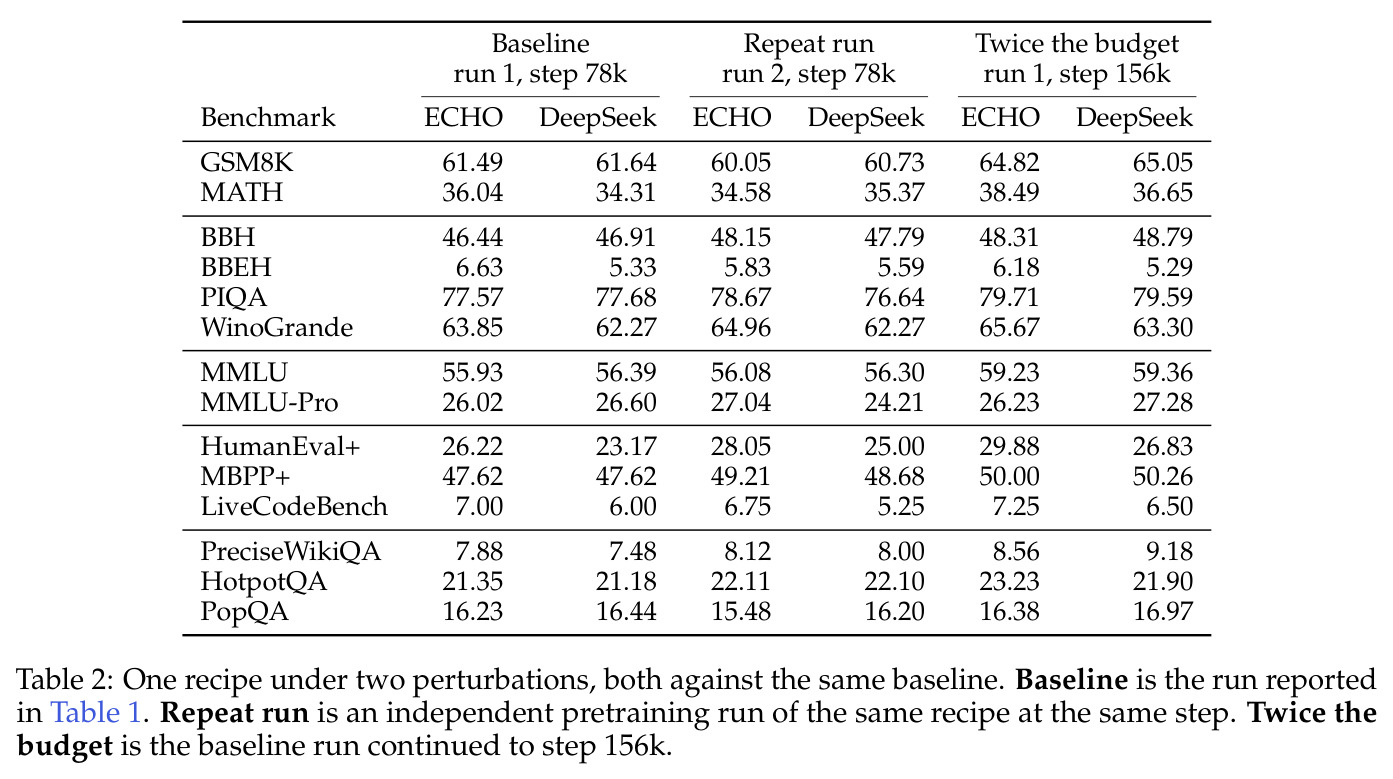
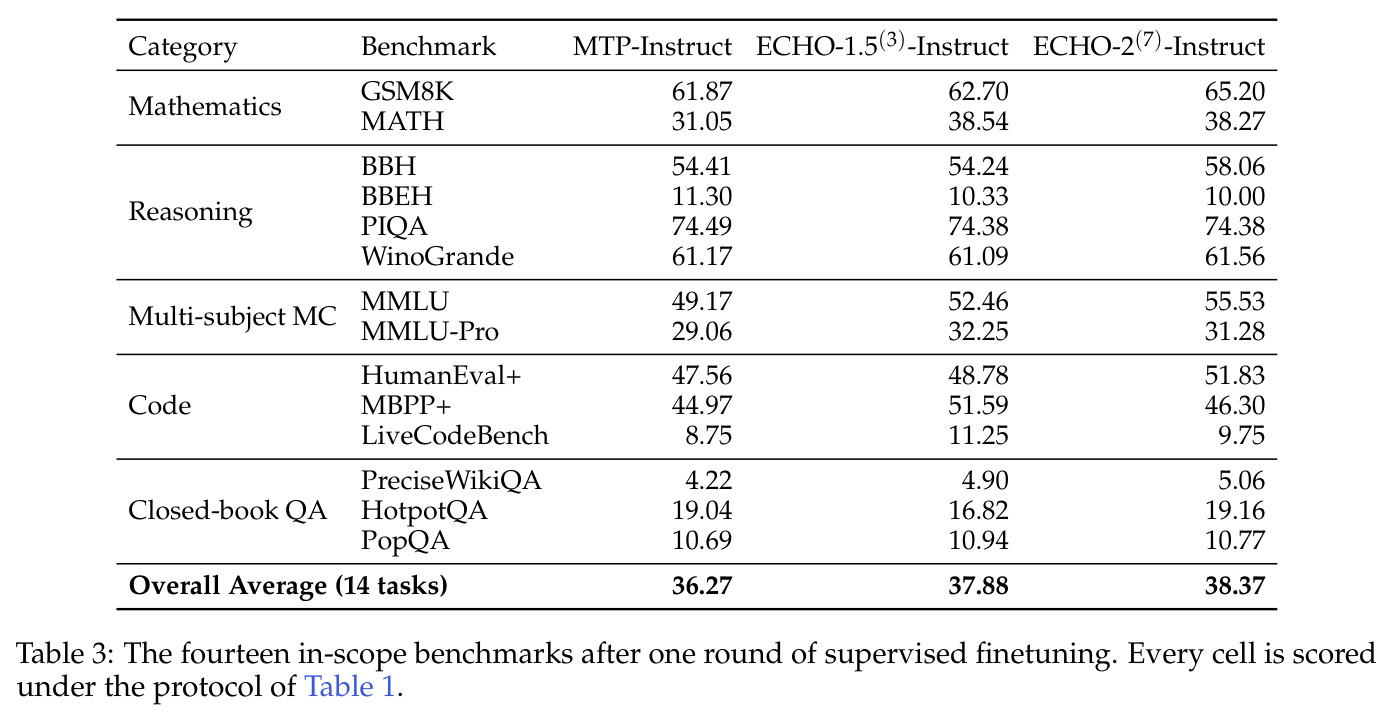
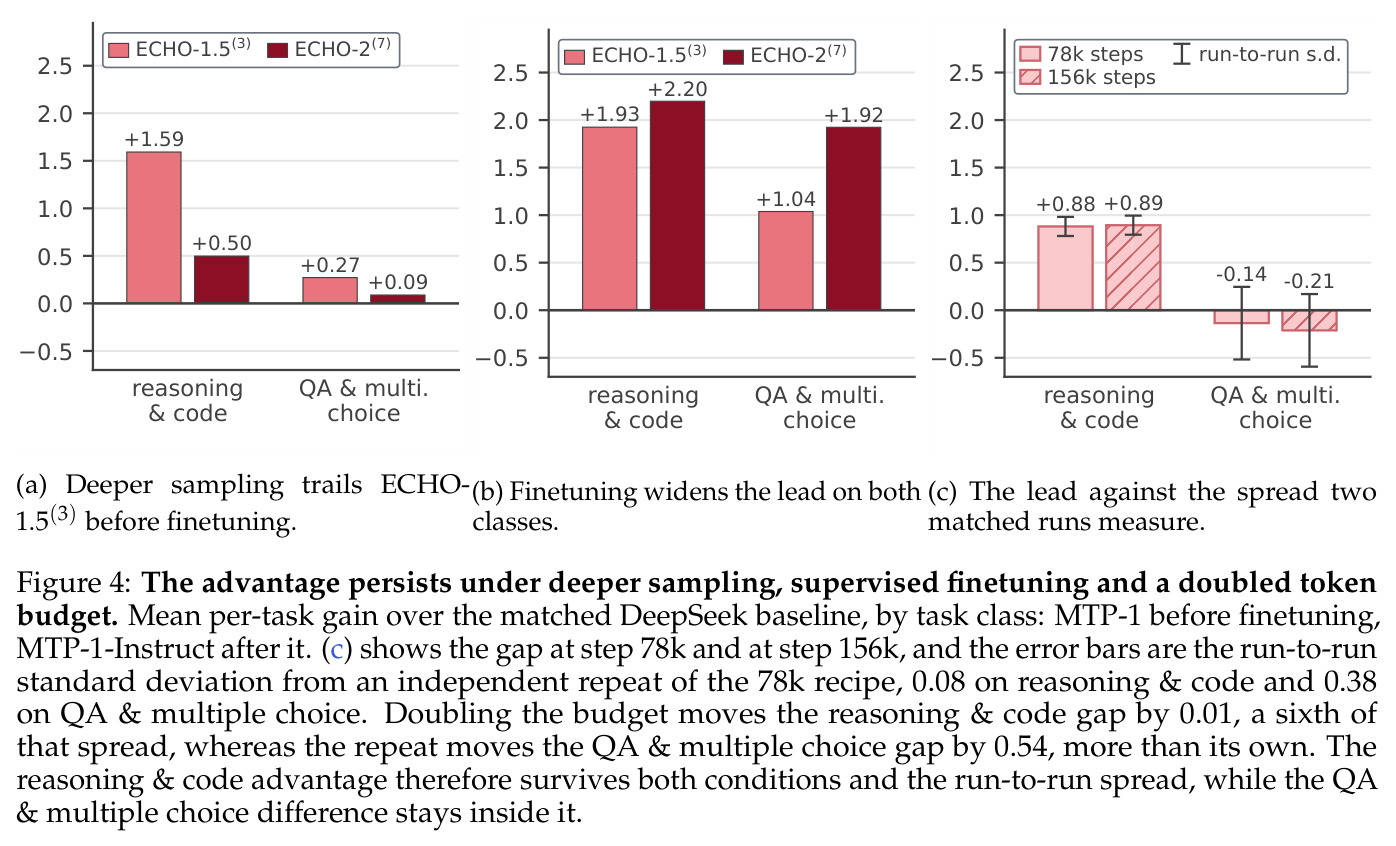
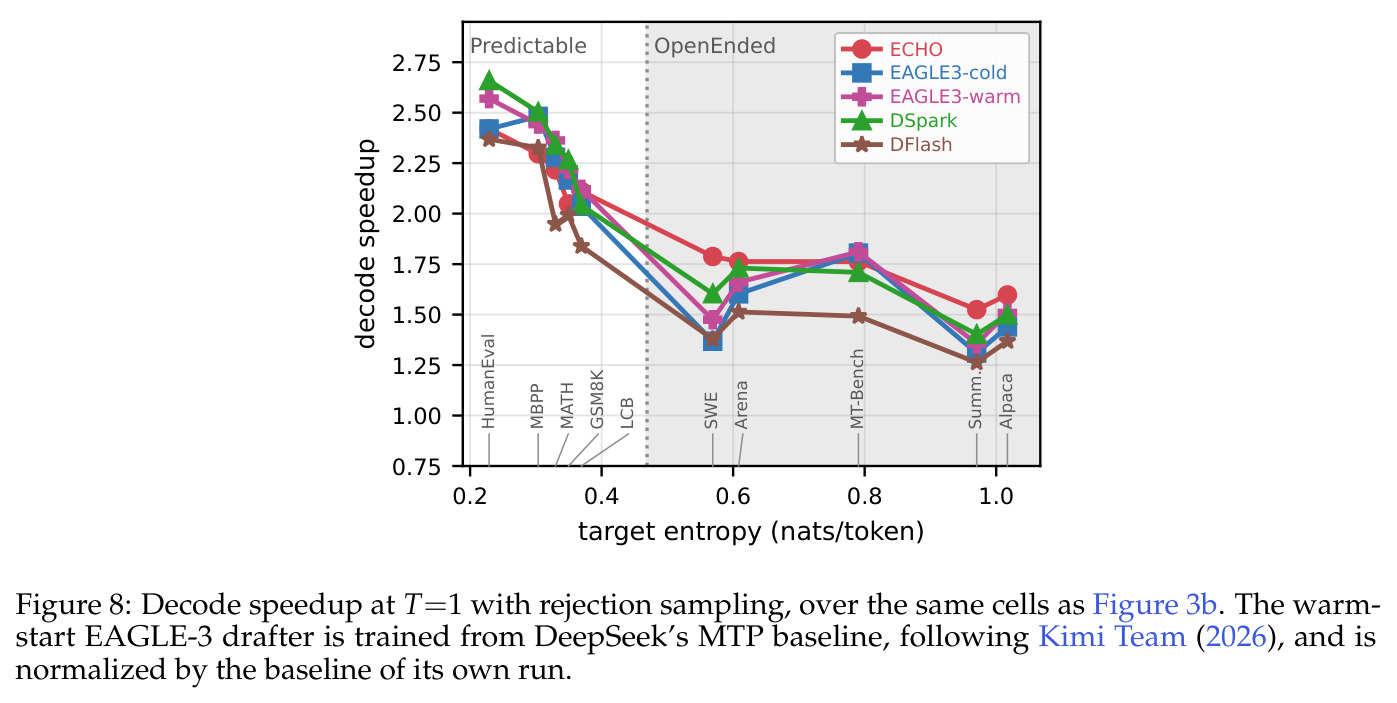
预训练主结果(Table 1,14 项基准平均):MTP-1 35.22,ECHO-1 35.73;MTP-3 35.38,ECHO-3 36.36;ECHO-1.5(3) 以一半 MTP 开销达 36.34,几乎追平 ECHO-3。同深度对比中共享层收益明显:深度 1 时数学/推理/代码为 +0.79/+0.57/+1.35,深度 3 时推理 +2.63、代码 +2.23;深度 1→3 ECHO 平均 +0.63 而 MTP 仅 +0.16,证实辅助模块吞掉了加深监督。ECHO-1.5(3) 对 MTP-1 领先 +1.00/+1.31/+2.37(数学/推理/代码),对两倍预算的 MTP-3 仍领先 +0.55/+2.31/+1.67。SFT 后(Table 3)优势扩大:ECHO-1.5(3) 达 37.88、领先 MTP-Instruct +1.93;ECHO-2(7) 预训练落后 0.49,SFT 后反超并取得全配置最大领先 +2.10。推理端(Figure 3b,budget 匹配 7+1、T=1):ECHO 在高熵开放域保持最长接受长度,SWE-bench 差距最大,超过 warm-start EAGLE-3;并行 drafter(DFlash/DSpark)只在 HumanEval/MBPP/GSM8K 等低熵任务占优。深度外推(Figure 1b):K>3 后 ECHO 仍近恒定增长而 MTP-3 饱和。稳健性(Figure 4c/Table 2):预算翻倍(78k→156k 步)后整体领先 +0.52→+0.50、推理与代码 +0.88→+0.89(变化约为噪声 0.08 的 1/6);重复运行两次领先 +0.52/+0.78,推理与代码差值仅移动 0.11;QA/多选差值 -0.14/-0.21 在自身噪声 0.38 内。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 14 项基准平均(预训练后,600B token) | 平均分(贪心解码) | ECHO-1.5(3) 36.34 / ECHO-3 36.36 | MTP-1 35.22 / MTP-3 35.38 | ECHO-1.5(3) 对 MTP-1 +1.12,ECHO-3 对 MTP-3 +0.98;1.5(3) 以一半 MTP 开销追平 ECHO-3 |
| 推理与代码类(9/14 个基准,深度 3 vs 深度 1 基线) | 类内每任务平均分差 | ECHO-3:推理 +2.63、代码 +2.23 | MTP-1(DeepSeek 式因果 MTP) | 深度 1 时即为 +0.57/+1.35,随深度扩大而 MTP 自身仅 +0.16(深度 1→3 全类平均) |
| 14 项基准平均(SFT 后) | 平均分 | ECHO-1.5(3) 37.88(+1.93);ECHO-2(7) 对 MTP-Instruct +2.10(全配置最大) | MTP-1-Instruct / MTP-Instruct | SFT 把领先从 +0.88(预训练类均)放大到 +1.93,ECHO-2(7) 较 ECHO-1.5(3) 再 +0.49 |
| 投机解码接受长度(深度外推 K>3) | 平均接受 token 数(budget 匹配 7+1,T=1) | ECHO-1.5(3) 超出训练深度后仍近恒定速率增长 | MTP-3(辅助模块,无外推能力) | K=3 之后 MTP-3 增益逐步饱和,ECHO 持续拉开 |
| 高熵开放域生成(SWE-bench、MT-Bench、Summ.、Alpaca) | 接受长度(按目标预测熵分组) | ECHO 全部领先,SWE-bench 差距最大,优势随熵增大 | warm-start EAGLE-3(最强事后 drafter)与 DFlash/DSpark | 在熵最高的分组超越包括 warm-start EAGLE-3 在内的所有事后 drafter |
| 数据缩放与运行稳定性(78k vs 156k 步;独立重复运行) | 对 MTP-1 的平均分领先 / run-to-run 标准差 | +0.52 → +0.50(翻倍预算);两次运行 +0.52 / +0.78 | 同配方 DeepSeek MTP-1 | 推理与代码类领先变化 0.01-0.11,远小于噪声(0.08-0.38),优势可复现 |
局限与改进
作者承认三点:预训练只重复了一次、SFT 只用单 seed,噪声估计有限;加深监督与深度外推的收益边界、DDS 在更深(如 K 远大于 3)时的行为尚未探索;『为什么更深采样预训练时落后、SFT 后才反超』只有推测性解释(深层监督噪声在预训练中稀释浅层学习、SFT 更好利用了主干学到的长程知识)。我的补充观察:其一,规模单一——所有结论都来自 10B-A1B、600B token 的单一配方,缺少缩放曲线,$\\pi$ 也是手工设定而非自适应;其二,QA 与多选类在预训练阶段略有回撤(-0.14/-0.21),作者论证其在 run-to-run 噪声(0.38)内,但共享层监督偏向推理型任务的再平衡效应值得警惕;其三,正文只报告接受长度,端到端 decode 加速比放在附录(Figure 8),且推理实验限于单节点 8×H800、budget 匹配 7+1 的设置,未覆盖大 batch 生产场景——投机解码的加速在批间竞争下会缩水;其四,理论界(式 5)只给出方向性保证且较为宽松,没有对融合层 $F$ 做消融。
独立分析的弱点
第一,融合层 $F$ 是唯一新增参数,论文没有消融它的容量、初始化方式对深层递归质量和接受率的影响,若 $F$ 过弱可能成为外推深度的瓶颈——改进方向是显式消融 $F$,或尝试门控/低秩变体。第二,$\pi$ 是固定衰减分布,与数据难度无关——可引入自适应调度,按 batch 内困惑度或梯度噪声动态调整 $\pi$,让深层监督集中在长程依赖密集的数据子集上。第三,ECHO-2(7) 预训练阶段落后 ECHO-1.5(3)、SFT 后才反超 0.49 分,说明深层监督噪声未根治——可以对深层损失做置信度加权,或设计课程式深度调度(先浅后深)。第四,接受长度的界不紧且未被直接优化,可借鉴 $L_K$ 类损失,在 DDS 频率框架下按截断权重 $c_k$ 直接优化接受目标,而非只收紧 $\mathcal{L}_{\text{MTP}}$。第五,QA/多选的轻微回撤提示共享层监督可能系统性偏向推理任务——可在 SFT 阶段对知识型数据提高深度采样频率做补偿。第六,推理收益在小 batch 服务场景最有利,大 batch 连续批处理下的吞吐收益论文未评估。
未来方向
作者列出的方向:把加深监督与深度外推推到什么程度、DDS 在更深 $K$ 下的行为、以及解释『更深采样只在 SFT 后兑现收益』的机理。可以延伸的方向:其一,与 RL 对齐结合——论文指出 T=1 起草能在目标熵上升时保持接受稳定、对 RL 训练关键(引用 Bebop 与 GLM-5.2),ECHO 的自起草结构天然适合在 RL 阶段同时优化策略质量与接受率;其二,把视野轴递归与潜空间思维链(latent CoT)结合,论文已在讨论中指出三者分别对应『重复过同一位置』『标注推理链』『额外位置』三种潜计算定价方式,探索『预测未来 k 步』是否等价于一种可验证的显式规划表示很有价值;其三,缩放到更大 MoE(数十亿激活参数)验证共享最终层是否仍随深度持续增益;其四,用自适应 DDS 与课程学习化解深层监督噪声,使 ECHO-2(7) 类配置在预训练阶段就兑现收益;其五,在生产级 serving(大 batch、连续批处理、多租户)下重估接受长度收益与显存节省;其六,把 DDS 的『训练频率衰减』思想迁移到其他辅助目标(如世界模型、检索规划)上。
复现评估
论文挂出了代码链接(github.com/ernie-research/ECHO),架构与实验细节集中在附录 A:10B-A1B 隐式注意力 MoE(24 层、MLA、256 专家激活 8 个)、Muon 优化器、bf16、序列长 4096、全局 batch 1920、600B token,DDS 的具体 $\\pi$ 值全部给出。算力门槛很高:一次预训练约 192 块 H800 跑 3 天,SFT 5 小时;基线 drafter 训练也要 24 块 H800 跑 19-55 小时(EAGLE-3 约 22h、DFlash 19h、DSpark 55h)。训练数据为自建 600B token 语料与内部 chat SFT 集,不公开,这是端到端复现的最大障碍;预训练只重复一次也意味着统计功效有限。若作者按承诺开源 checkpoint,推理端复现门槛会低很多:用 SGLang 在单节点 8×H800 上即可验证深度外推起草与 Figure 3b 的接受长度-熵曲线。总体评估:读懂与局部复现(方法机制、DDS 消融的思路)容易,训练端完整复现属于大厂级工程,推理端中等难度。
论文图表
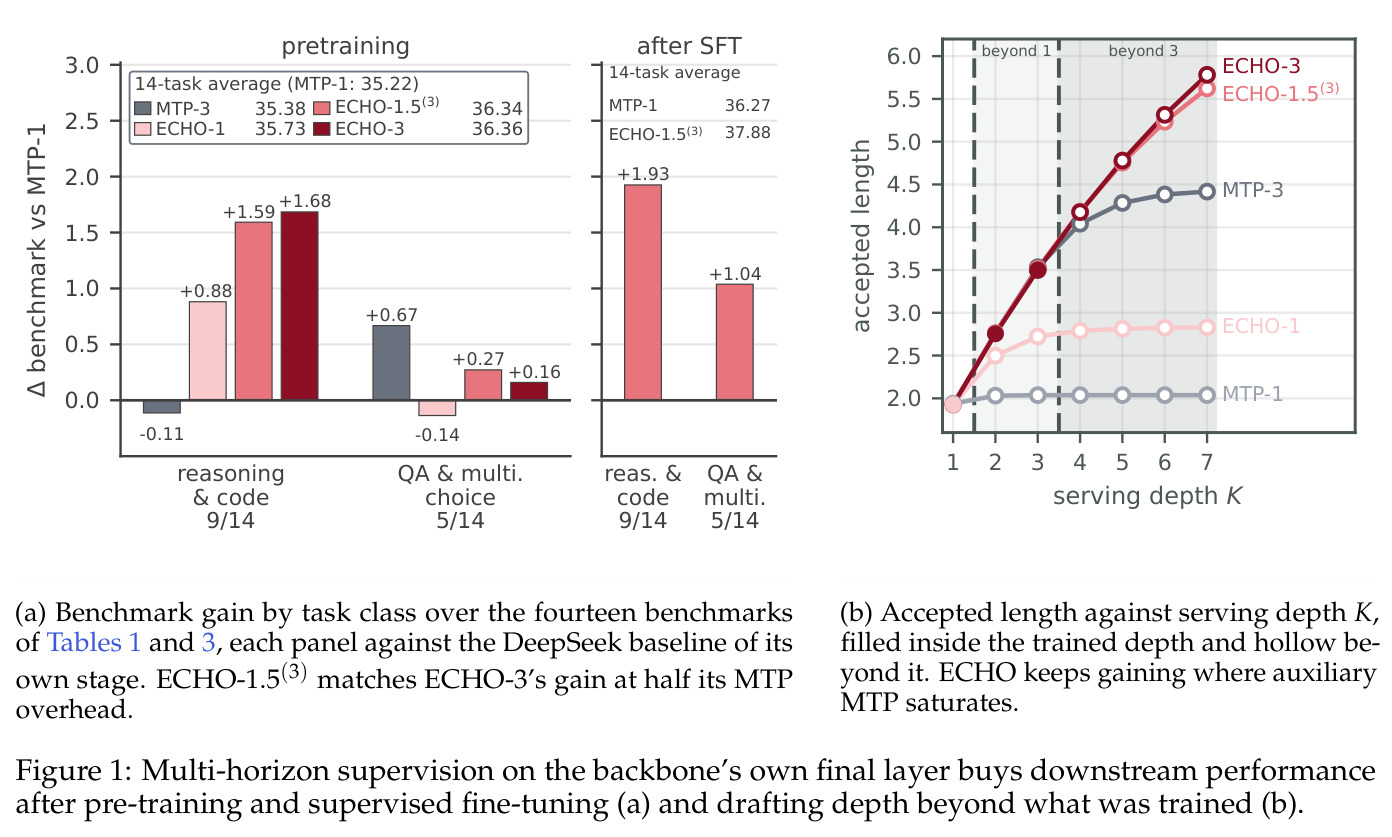
(a) 展示 14 项基准按任务类别的平均增益:预训练阶段 ECHO-1 比 MTP-1 高 +0.51,ECHO-3 比 MTP-3 高 +0.98,ECHO-1.5(3) 以一半 MTP 开销达到 36.34、几乎追平 ECHO-3 的 36.36,且增益集中在推理与代码类(9/14 个基准);SFT 后 ECHO-1.5(3) 达 37.88、领先 MTP-1-Instruct 扩大到 +1.93。(b) 展示接受长度随服务深度 K(1 到 7)的变化:实心点为训练深度内、空心点为外推区——ECHO 在 K>3 后仍以近恒定速率增长,而辅助式 MTP-3 的增益逐步饱和。
这是全文的『一图流』:一张图同时交代训练端(直接监督随深度持续增益、SFT 后扩大)和推理端(深度外推、辅助 MTP 饱和)两大卖点,以及 ECHO-1.5(3) 的开销-收益平衡点,适合作为理解全文结论的入口。