一键视频之后:服务型内容涌入、推荐池机制失灵与伯乐系统 After One-Click Video: The Inflow of Service-Type Content, the Failure of the Recommendation Pool Mechanism, and the BoLe System
AI让服务型内容百倍量产,而用户注意力固定,推荐流量池必然失灵,出路是伯乐系统。
前置知识
推荐流量池机制(推荐池)
免费内容平台分发新内容的分层筛选机制:新内容先推给小批疑似感兴趣的用户(约100人)试看,若完成率等指标高于同类均值则进入更大的池(约500、2500人)逐层放大,任一层不达标即止。平台采用它是因为用户反馈是最准确也最便宜的判断方式,无需雇佣大量编辑。文中层级数字为行业示意值,机制描述来自作者从业经验。
论文的核心论证对象就是该机制:它隐含依赖试看消耗用户注意力这一前提,本文证明该前提在内容量产下必然崩塌。
冷启动与探索-利用权衡
推荐系统中新内容没有历史行为数据,平台必须拿一部分曝光做探索(试探质量)、其余做利用(推已知好内容),对应多臂老虎机问题中的探索-利用权衡,冷启动分配已有大量研究(Li et al. 2010; Wu et al. 2016)。探索试验次数有限时如何更聪明地分配,是经典的算法优化问题。
本文把这一被当作算法问题研究的现象重新定义为经济学约束:探索预算由用户注意力支付且总量固定,无法靠算法创造。
互信息 $I(Q;M)$
信息论中度量两个随机变量相互包含信息量的量:若度量 $M$ 与真实质量 $Q$ 独立则为零,$M$ 越能预测 $Q$ 互信息越大。当生产者专门针对试看指标(封面、前三秒完播率)优化内容时,指标好不再代表质量好,$I(Q;M)$ 下降,测再多指标也换不回质量信息,即“巧克力味的便便”通过筛选而“便便味的巧克力”被埋没。
论文用它解释“瞄准算法的内容”为何让试看机制失效——该问题与试看预算无关,是信号本身失真。
基础率与贝叶斯筛选
条件概率公式 $P(A|B)=\frac{P(B|A)P(A)}{P(B)}$:即便筛选器准确率固定,晋级池中好内容的后验占比仍随好内容的基础率(先验占比)下降而崩塌。论文设试看准确率高达90%(好内容90%晋级、平庸内容仅10%晋级):基础率5%时晋级池约30%是好内容,基础率稀释到0.05%时不足0.5%。
这是“好内容被稀释后,再准的试看也救不回来”这一关键结论的计算依据,直接支撑机制必然失灵的论证。
Beta-Bernoulli 信任更新
贝叶斯统计中共轭先验的标准用法:对伯乐“推荐真的好”的概率 $\theta$ 设初始信念 $\mathrm{Beta}(\alpha,\beta)$,读者每看完 $m$ 条推荐、满意其中 $h$ 条后,信念更新为 $\mathrm{Beta}(\alpha+h,\beta+m-h)$。每次单条推荐对信念的改动很小,信任只能逐条累积、无法跳变。
论文借此论证伯乐的信任无法用钱一次买断,先建成伯乐系统的平台将获得条件性累积优势。
信息商品(experience good)
Nelson (1970) 提出的经济学概念:使用前无法判断质量、只有消费后才知道好坏的商品。内容是典型的信息商品,因此历史上演化出替代筛选机制——Michelin 指南、报刊书评版等可信第三方替消费者先试用,且都出现在同类商品大量涌现之后。
它说明“商品泛滥后信任转向第三方”是历史规律,为伯乐系统的合理性与“信任只能慢慢积累”提供类比支撑。
注意力稀缺
Simon (1971) 的论断:信息的丰富造成注意力的贫乏。用户每天可支配的观看时间是常数,信息供给增长时注意力成为瓶颈资源。论文设一次试看平均带回 $c$ 比特质量信息、平台每天可用试看量为 $\varepsilon X$、新内容量为 $N$,则每条内容分到的判断信息至多 $I_{\text{per item}} \le \frac{c\varepsilon X}{N}$。
这是全文的第一性假设:分子由用户时间决定、不随内容增长,$N$ 增百倍则每条信息少百倍,推荐池失灵的根源就在于此。
研究动机
2026年9月22日 Opus 5.5 发布后,一种新的视频生产方式迅速流行:让大模型写一个程序,由程序逐帧绘制并合成动画解说视频,不经过视频生成模型;一周内行业通讯 Latent Space 即评价这类代码生成视频“占领了时间线”,随后各平台涌现一键视频技能包与教程。作者团队做了十多年专业短视频:过去一条五分钟科普视频需先用 After Effects 逐帧做特效、再用 Final Cut Pro 剪辑合成,耗时五天;现在经第一作者逐条把关一天能做三到五条,若放弃质量把关只求“好看”,一天可达二十条,产能提升约一百倍。这类“一键视频”本质是服务型内容:观众为满足需求而看,不为欣赏作品本身。问题在于,免费平台的分发依赖推荐流量池机制——新内容先推给约100人试看,达标则逐层放大到500、2500人——而试看消耗用户注意力,注意力总量固定(Simon 1971)。历史上已有预演:内容农场把“按广告价选题、模板化廉价写作”做成上市公司生意(Roth 2009),Demand Media 算法选题、日产超四千篇稿件,2011年 Google Panda 更新一举影响美国11.8%的搜索查询。
本文的目标是本文的目标是回答一个结构性问题:当个体创作效率在数周内提升一到两个数量级时,免费内容平台的生态会发生什么?作者要做的不是提出新算法,而是给出一个可论证的判断框架。具体包括三点:第一,提出服务型内容与作品型内容的二分法,并说明AI为何让两者供给以不同速度增长——服务型内容人人可做、上限极高,作品型内容受限于“有话要说的人”的数量,AI尚不能替作者决定要表达什么;第二,用简化的数学模型论证推荐流量池机制在内容量增长超过某个倍数后必然失灵,并给出失灵临界倍数的量级与参数敏感性;第三,在承认机制失灵的前提下提出一种可能的出路——伯乐系统:机器与准入规则判断服务型内容是否过线,可信的人判断作品型内容的好坏,再由机器放大分发。最终还给内容生产者一个不依赖未来走向的可操作结论:先分清自己做的属于哪一类,并把两类内容的生产在组织结构上分开。
与已有工作不同的是,本文的独特之处在于提问方式。推荐系统文献早已研究“候选多于可试次数”的问题(Wang et al. 2008),冷启动的探索-利用分配也有大量工作(Li et al. 2010; Wu et al. 2016),但它们都把它当作算法问题,问的是如何更聪明地分配试验;本文问的是谁在支付试验成本——答案是用户注意力,而注意力总量固定,因此这是一个经济学刚性约束而非算法优化问题。在内容分类学上,Bourdieu (1992) 区分“有限生产场”与“大规模生产场”,讨论的是场域层面标准由同行还是市场制定;本文的区分落在单条内容层面,回答的是“观众从这条内容里得到什么”。另一个有趣的反差是方向性:1990年代网页爆炸时,Yahoo 目录等人工分类被算法搜索取代,是“人退机器进”;这次算法试看付不起账单,人被请回来,但方式是“人选机器放大”,与 Michelin 指南、报刊书评版等信任第三方的历史演化一脉相承。
核心方法
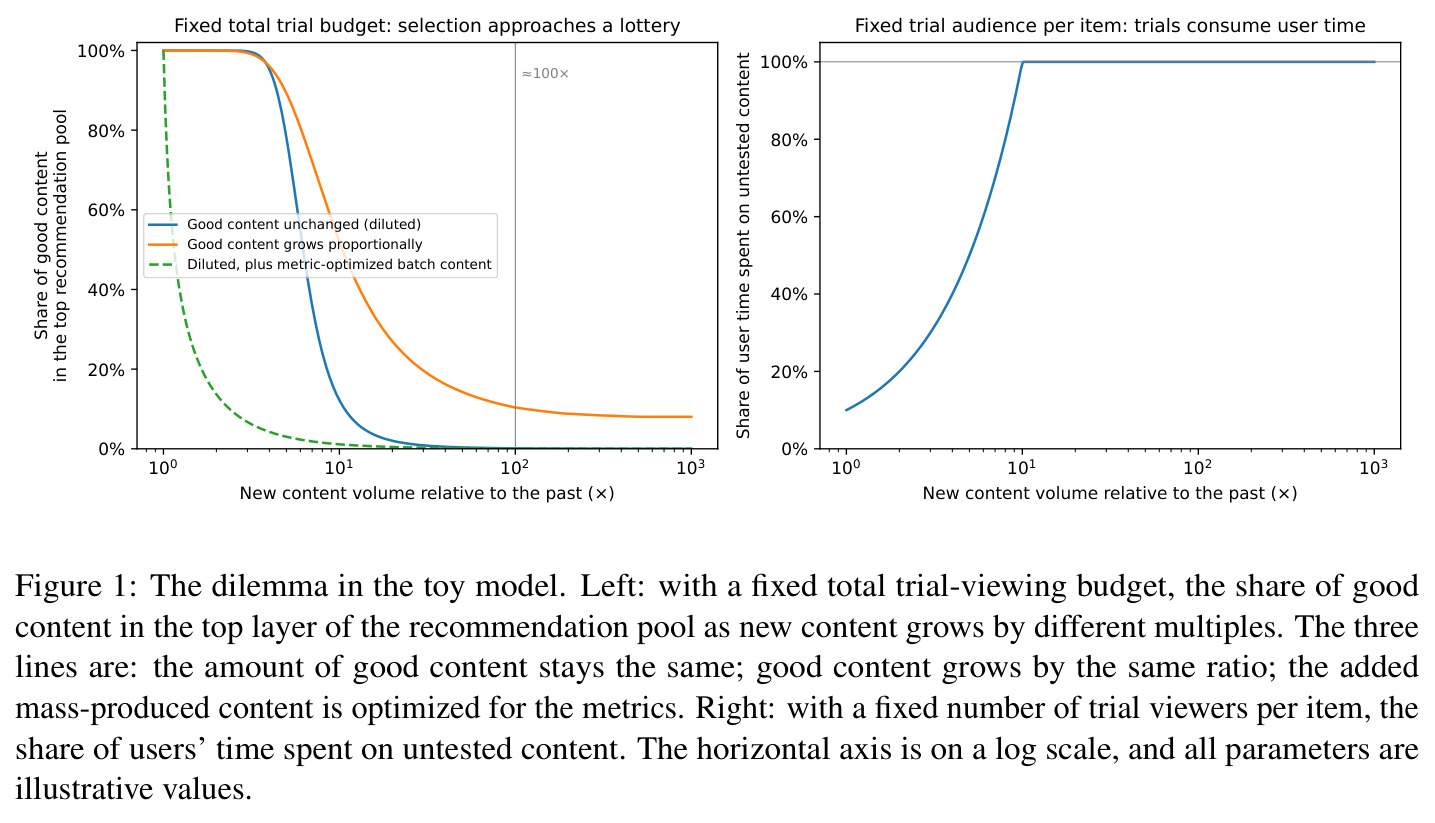
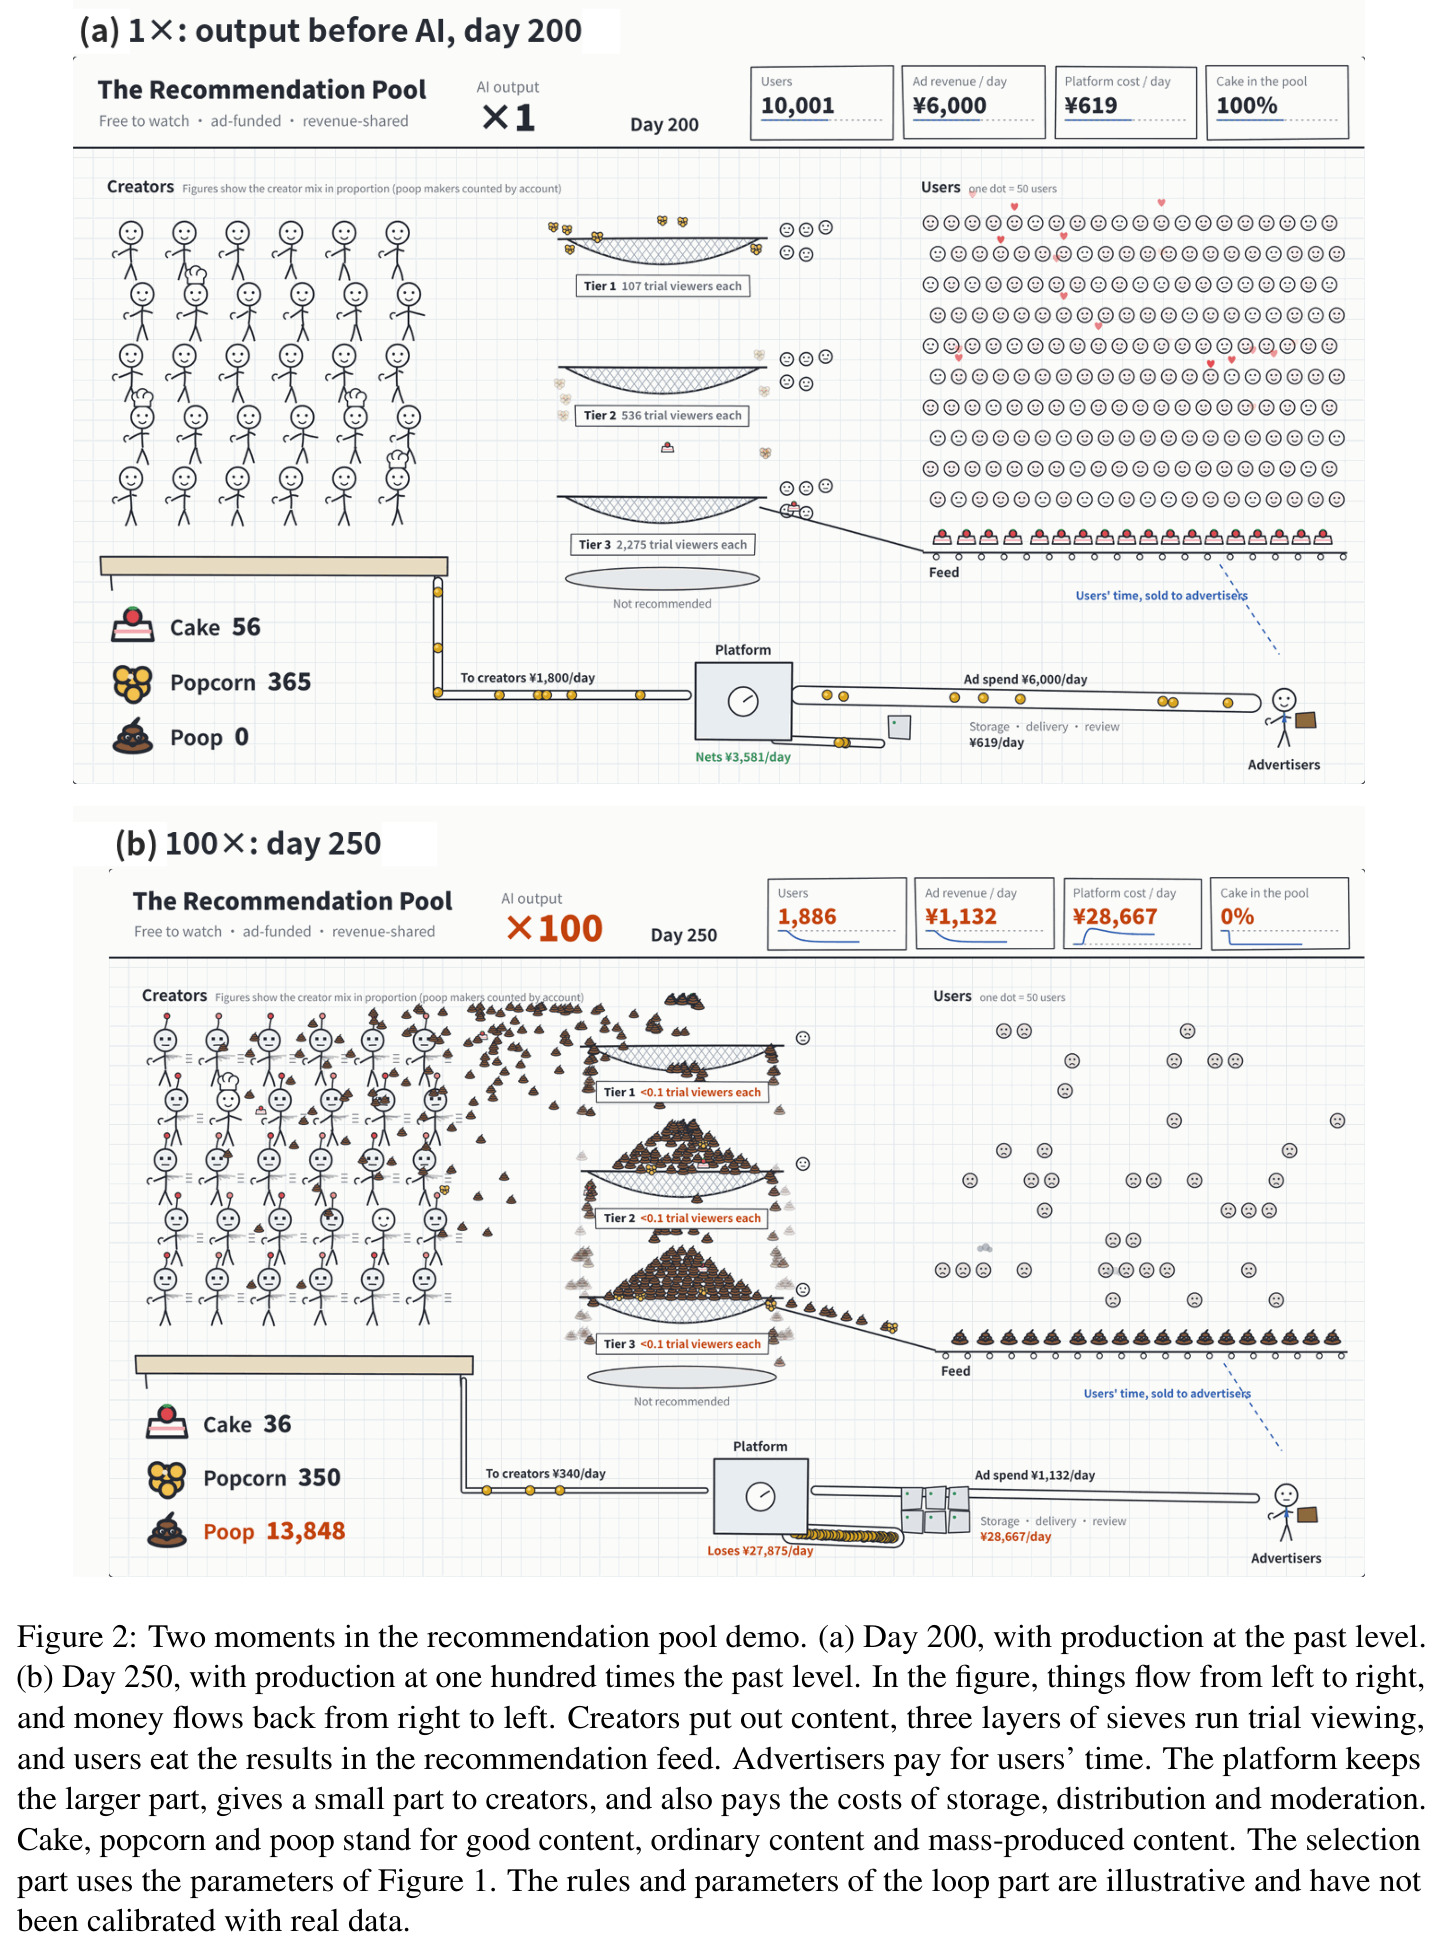
这是一篇立场性论文加简化数学模型,而非新技术系统。整体思路分三步。第一步是概念工具:把内容分为服务型(为满足需求而看,如多数AI短剧)与作品型(为内容本身而看,如头部YouTuber长视频、Netflix剧集),二者的区别不在成本与时长,而在观众获得的效用——同长同价的两条视频在同一个信息流里,观众得到的仍是两种东西。第二步是约束建模:设一次试看平均带回 $c$ 比特质量信息,平台每天可用试看量为 $\varepsilon X$,新内容量为 $N$,则每条内容分到 $I_{\text{per item}} \le \frac{c\varepsilon X}{N}$——分子由用户时间决定、不随内容增长,$N$ 增百倍则每条信息少百倍,低于判断所需信息量时筛选接近抽签。平台只剩两条路:固定总试看预算则每条试看人数降为 $1/k$;固定每条试看人数则未测内容占用户时间份额升为 $k$ 倍。第三步是用三层试看池的玩具模拟量化失灵过程,做参数敏感性分析,再叠加用户、广告、创作者流失的循环规则做一年期交互演示。
核心洞察有三层。第一,生产门槛曾是平台的免费第一轮筛选:在代码生成视频之前,做内容又难又少,门槛替平台挡住了绝大多数人;平台的七项需求(发现好内容、留住能吸引广告的创作者、控制存储分发审核成本、清除流量作弊、留住用户、满足广告主、合规审核)都悄悄依赖这道门槛,门槛消失后所有需求同时失衡且互相冲突。第二,两类内容需要的信息量本质不同:判断服务型内容“过不过线”是一比特问题,机器与准入规则即可完成;把作品型内容分成 $K$ 档需要约 $\log_2 K$ 比特,普通观众一次滑动的信息量少且混入大量无关噪声(手指滑了、心情不好),而领域专家一次认真审看能带回相当于成百上千次滑动的低噪声信息,恰好补上作品型内容需要的比特,且不消耗公众注意力。第三,信任只能随时间累积:读者对伯乐的信任 $\theta$ 从 $\mathrm{Beta}(\alpha,\beta)$ 出发,看完 $m$ 条推荐、满意 $h$ 条后更新为 $\mathrm{Beta}(\alpha+h,\beta+m-h)$,金钱无法一次买断,这构成先建伯乐系统平台的条件性累积优势。
方法步骤详情
论文的论证按以下步骤展开。第一步,界定范畴:只讨论免费观看、广告分成、信息流分发的平台,排除订阅制与按件付费。第二步,分析供给弹性:AI让两类内容都提速,但服务型内容人人可入,作品型内容受限于有表达欲的人;用摄影史(1888年Kodak相机到1902年Photo-Secession为艺术摄影自立名分)说明“普及后作品型自立名分”的规律。第三步,建模信息预算 $I_{\text{per item}} \le c\varepsilon X/N$,推出固定预算与固定试看人数两条失败路径。第四步,用贝叶斯公式计算好内容稀释:90%准确率下基础率从5%降到0.05%,晋级池中好内容占比从约30%跌到不足0.5%。第五步,跑三层玩具模拟:各层试看人数100/500/2500、每层总预算固定、基线好内容占比5%,扫描内容量1到1000倍。第六步,敏感性分析:单参数变动时临界倍数约3到40倍;同时翻倍三个参数也只推迟到50到近200倍。第七步,分析指标优化型量产内容对互信息 $I(Q;M)$ 的破坏,并指出按量补贴在成本趋零时利润趋近全额补贴。第八步,论证机器预审至多覆盖七项需求中的部分,最后给出伯乐系统设计与信任积累模型。
技术新颖性
本文的新颖性不在算法而在论证框架:把注意力经济学、信息论与产业史整合成可证伪的结构判断。与机器学习文献把探索预算当超参数调优不同,本文指出预算的支付方是用户,因而是刚性约束——参数只改变失灵临界倍数(约3到40倍,最乐观50到200倍)而不改变失灵本身,这把“平台该怎么办”从算法问题改写为制度问题。与平台治理依赖举报与合规审核不同,本文证明机器预审至多覆盖七项需求中的部分(需求1、3、4),无法满足“留住能吸引广告的创作者”这一需求2,且内容涨百倍时合规审核工作量同步涨百倍。伯乐系统亦非凭空构想:它对接 Medium 2023年 Boost 机制(社区提名、人工确认、算法放大的三段式)、Apple Music 2015年专家编辑歌单,以及第一作者2026年10月受邀参与的微信公众号“精选”(Original Picks)内测,是已有实践的抽象化。借助 Lizzeri (1999) 的认证经济学还能推出伯乐系统会有垄断与竞争两种形态——垄断认证者只说“过/不过”,竞争认证者才提供细粒度质量信息,这为后续机制设计留下接口。
实验结果
玩具模拟给出了非常具体的数字。基线(好内容占新内容5%、三层试看人数100/500/2500、每层总预算固定)下,内容量增长3倍以内机制仍有余裕,顶层池几乎全是好内容;10倍时顶层池好内容仅约12%;100倍时仅约0.1%。即使好内容同步等比增长(最乐观情形),100倍时也只有约10%,仅为输入端5%的两倍,筛选几乎不起作用。若新增量产内容专门优化试看指标(降低 $I(Q;M)$),则仅3倍时顶层池好内容就只剩约7%。敏感性分析:单参数变动时,好内容占比跌破一半的临界倍数在约3到40倍之间;同时翻倍三个参数(对平台最有利)也只推到50到近200倍,且要求用户花20%时间看未测内容。贝叶斯计算:试看准确率90%时,基础率从5%稀释到0.05%,晋级内容中好内容占比从约30%跌到不足0.5%。一年期交互演示:生产为过去水平时平台全年稳定,倍数超过3到5倍时用户与广告收入开始下滑。历史数据佐证分成稀释:TikTok 创作者基金从每千次播放约5美分降到2.5美分后于2023年12月关停;YouTube 头部3%频道占超85%播放,约96.5%想变现的创作者收入低于美国贫困线(Bärtl 2018)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 固定总试看预算下的三层池筛选模拟 | 顶层池好内容占比 | 内容量100×时约0.1%;10×时约12% | 内容量1×(好内容占新内容5%)时顶层池几乎全为好内容 | 无提升——该结果用于论证机制随倍数增长而失效 |
| 好内容等比增长(最乐观情形) | 顶层池好内容占比 @100× | 约10% | 输入端基础率5% | 仅约2倍富集,筛选几乎不起作用 |
| 指标优化型量产内容注入 | 顶层池好内容占比 @3× | 约7% | 无指标优化时3×以内机制仍有余裕(顶层池几乎全为好内容) | 互信息 $I(Q;M)$ 下降导致机制提前失灵 |
| 参数敏感性(对平台最有利组合) | 好内容占比跌破一半的临界倍数 | 同时翻倍三参数后为50~近200倍(需用户花20%时间看未测内容) | 单参数减半/翻倍时约3~40倍 | 临界倍数只能被推迟、无法被消除 |
局限与改进
作者在第六节坦承多项限制:玩具模型是简化数学模型,所有参数均为示意值,结论依赖结构而非具体数字;对平台试看机制的描述来自作者从业经验而非平台公开材料;一键视频在2026年秋爆发的规模判断来自行业报道与作者观察,平台未公布数据;团队从五天一条到一天三至五条的案例只有一个样本且是事后描述;图2演示中的用户流失、广告收入、创作者流失规则是示意性的、未经真实数据校准,作者明言“展望可能是错的”。我的补充观察:其一,服务型/作品型的边界在真实内容上模糊,一条科普视频可能既满足需求又有作者表达,论文未给可操作判据;其二,“注意力总量固定”在数月尺度成立,但屏幕时间仍在缓慢增长,长期尺度上该假设需修正;其三,伯乐系统未讨论代理人被收买、互刷好评等对抗行为,Beta 信任更新隐含推荐质量独立同分布的假设,过于乐观;其四,范畴排除了订阅制平台,而这恰是作品型内容的主要栖身地,结论对整个内容产业的适用范围因此受限。
独立分析的弱点
第一,分类学缺乏操作化判据。“为满足需求而看”与“为内容本身而看”在个体层面是连续谱,同一视频对不同观众类别不同,改进方向是设计可测量的代理指标,例如复看率、收藏后二次消费率、需求满足后的取关意愿。第二,伯乐机制设计薄弱。谁支付伯乐报酬、如何防止被公关收买、如何处理伯乐自身偏见与口味窄化,论文只用一句“信任需长期积累”带过;改进方向是引入竞争性认证(Lizzeri 1999 的结论是竞争认证者才提供细粒度信息)、公开校准记录与盲评机制。第三,“机器只能判一比特”的前提可能很快失效:模型评分能力在快速提升,若AI也能输出多比特的质量排序,伯乐的信息优势会收窄,论文未检验这一前提的时效性。第四,模拟未校准:全部参数为示意值且临界倍数跨一个数量级(3到40倍),实践者无法据此判断“什么时候该动手”,改进方向是用平台公开数据或行业合作估计真实基础率与完成率差距。第五,条件性累积优势依赖“有表达欲的创作者会被埋没并迁移”这一行为假设,未建模迁移摩擦(粉丝资产、合同约束),结论强度受限。
未来方向
作者在第七节留下一个开放问题:读者跟随一位伯乐,是因为他选得好,还是因为这个人本身?若是前者,伯乐提供的是满足需求的服务;若是后者,伯乐的判断本身就带作品型属性——这直接决定伯乐系统能否规模化复制。基于本文成果可延伸的方向包括:其一,伯乐系统的机制设计——竞争性认证与垄断认证的信息量差异(Lizzeri 1999 已给出理论线索)、伯乐声誉市场的定价与防合谋;其二,实证检验:与平台合作获取冷启动试看数据,估计真实的基础率与完成率差距,把临界倍数从“3到40倍的区间”收敛到可操作的预警指标;其三,检验AI多比特评分能否部分替代人工伯乐,寻找人机混合管道(机器粗排+人工精判+算法放大,即 Medium Boost 结构)的最优分层;其四,创作者迁移的动力学建模,结合 Bourdieu 场域理论检验“有表达欲者流向伯乐平台”的预测;其五,政策维度:当准入规则成为筛选主力时,谁有资格定义“过线”、规则本身的治理与透明度将成为新问题。
复现评估
复现难度很低。论文声明图1玩具模型的代码是公开的,模型本身只是三层伯努利筛选加固定预算分配,用 Python 几十行即可重实现,无需GPU或真实数据集;关键参数(好内容基础率5%、各层试看人数100/500/2500、好差完成率差距等)都在正文给出,敏感性分析在笔记本上几分钟即可跑完。图2演示的筛选部分复用图1算法与参数,但用户流失、广告收入、创作者流失等循环规则为示意性、未随代码提供校准数据,复现时只能自行设定。真正的复现障碍不在代码而在证据:平台试看机制的层级数字、2026年秋内容爆发的规模、微信公众号“精选”内测经历均为作者私有经验或未公开信息,第三方无法独立验证;引用的历史数据(TikTok基金5美分降到2.5美分、YouTube 96.5%低于贫困线、Demand Media 日产四千篇)均有公开出处可查。论文附有AI使用声明:讨论与思考主要用 Opus 5.5(也是论文研究对象之一),文献与史料检索用 GPT 6.1 sol 与 Gemini 3.8 flash,作者对核心判断与最终文本负责。
论文图表