Timestral:解耦视野预测的时间序列基础模型家族 Timestral
Mistral 发布四个时序基础模型,凭 DHF 解耦预测与上下文,包揽三大基准全部指标前二
前置知识
Patch 化时序表示
把时间序列切成每段 P 个时间步的互不重叠 patch,每个 patch 经一个小 MLP 映射成一个 token,序列长度压缩 P 倍(本文 $P=32$)。自 PatchTST 以来这几乎是所有时序基础模型的标准输入表示,预测头再把 token 级表征映射回时间步分辨率,输出每步的预测值或分位数。
Timestral 的上下文 token、预测 token、缺失指示位全部定义在 patch 粒度上,不掌握这个表示就读不懂它的注意力掩码结构和架构图。
因果 vs 双向时间注意力
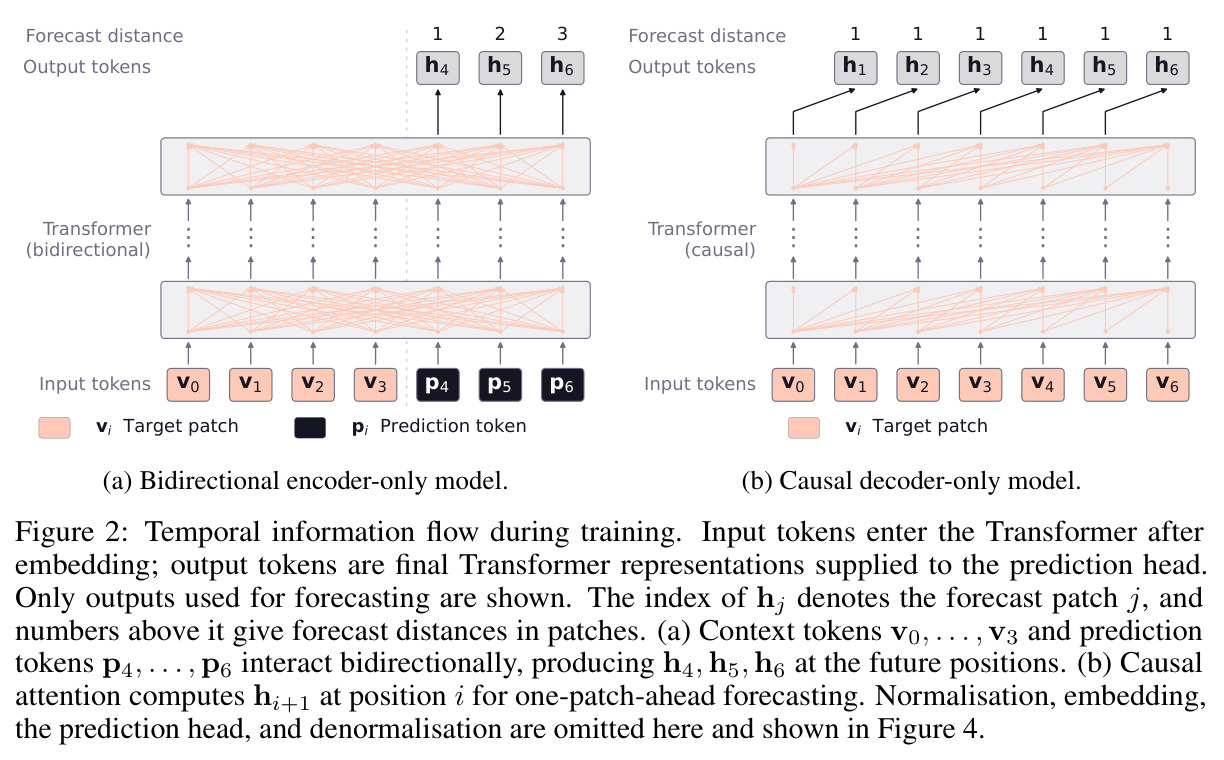
因果注意力只允许每个位置看当前及之前的 token,是解码器式模型的标准;双向注意力允许全序列任意互通,是编码器式模型的标准。时序预测中双向模型(如 Chronos-2)把预测位置的专用 token 与上下文一起双向编码,因果模型(如 TimesFM、Toto)则从每个位置的表征直接外推下一个 patch。
Timestral 的关键定位是「因果编码的上下文 + 专用预测 token」,即两种范式的杂交,Figure 2 和 Figure 5 讲的全部是这个区别。
连续 Patch 掩码(CPM)
TiRex 提出、Toto-2.0 和 TimesFM-3 沿用的训练技巧:训练时把连续 r 个输入 patch 掩掉(观测值隐藏但 token 保留在序列中),使模型从更早的上下文一次预测 r+1 个 patch,从而在一次前向里覆盖多个视野、无需自回归回喂预测值。代价是被掩的观测值同时也从同一序列中后续所有预测的上下文里消失。
DHF 正是为替代 CPM 而生,只有理解 CPM 中「视野分布与上下文完整性被耦合」的缺陷,才能体会本文核心贡献的价值。
Pinball 损失与分位数预测
概率预测的一种参数化:对每个分位水平 $\tau$,损失为 $\rho_\tau(e)=\max(\tau e,(\tau-1)e)$,其中 $e=y-\hat q_\tau$。最小化它使 $\hat q_\tau$ 收敛到条件 $\tau$ 分位数。本文预测头输出 21 个分位水平 $T=\{0.01,0.05,\ldots,0.95,0.99\}$,中位数直接预测,其余分位数由 softplus 正增量累加构造,结构上杜绝分位数交叉。
这是本文唯一的训练目标(论文明确说明不使用辅助损失),也是 CRPS、SQL 等评测指标的直接基础。
先验数据拟合网络(PFN)
一种训练范式:从已知先验 $p(f)$ 中采样生成过程 $f$,由 $f$ 生成训练数据,网络学习从上下文直接近似后验预测分布 $p(y_{t+1:t+H}\mid y_{1:t})=\int p(y_{t+1:t+H}\mid y_{1:t},f)\,p(f\mid y_{1:t})\,df$,即把贝叶斯推断摊销进单次前向。合成数据的生成过程就定义了先验,先验里不可预测的变异太大会让区间过宽,太小则模型过度自信。
本文预训练 100% 依靠合成数据,生成器设计即先验设计,PFN 是理解其训练哲学与数据策略的理论框架。
研究动机
时序基础模型(TSFM)分两大阵营,各有软肋。双向编码器模型(如 Chronos-2、Falcon-2.0)训练时为每个样本单独采样上下文长度和预测视野,一次前向只能覆盖一种组合,训练效率低。因果解码器模型(如 TimesFM、Toto)虽能从序列每个位置同时预测、一次前向覆盖多个上下文长度,但要训练「一次前向直接预测多个 patch」就必须用连续 Patch 掩码(CPM):为制造距离 $d$ 的预测监督,需掩掉目标前的 $d-1$ 个 patch,而这些被掩的观测值同时也从同一序列中后续所有预测的上下文里消失了——等于「练更长视野就要拿走更多上下文」,视野分布与上下文完整性被硬性耦合。已知未来协变量(节假日标记、促销计划等)是第二道难题:它们的未来值必须对预测可见,而目标变量的未来值必须隐藏,Chronos-2 的组注意力和 Toto-2.0 的变量注意力都没有从架构层面简洁地解决这一矛盾。
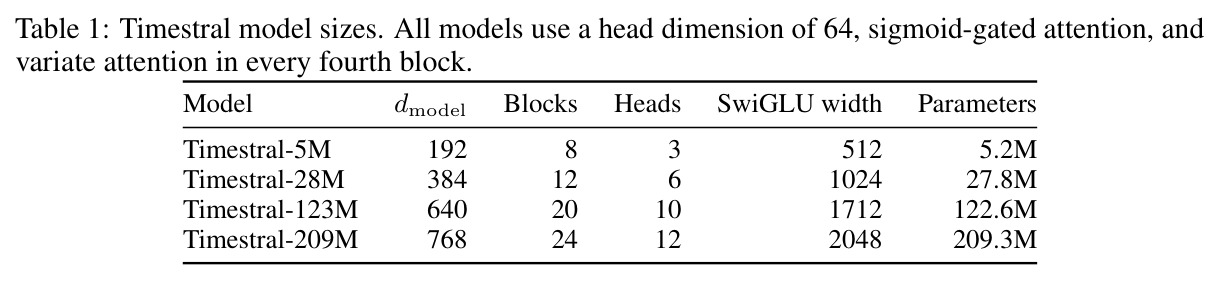
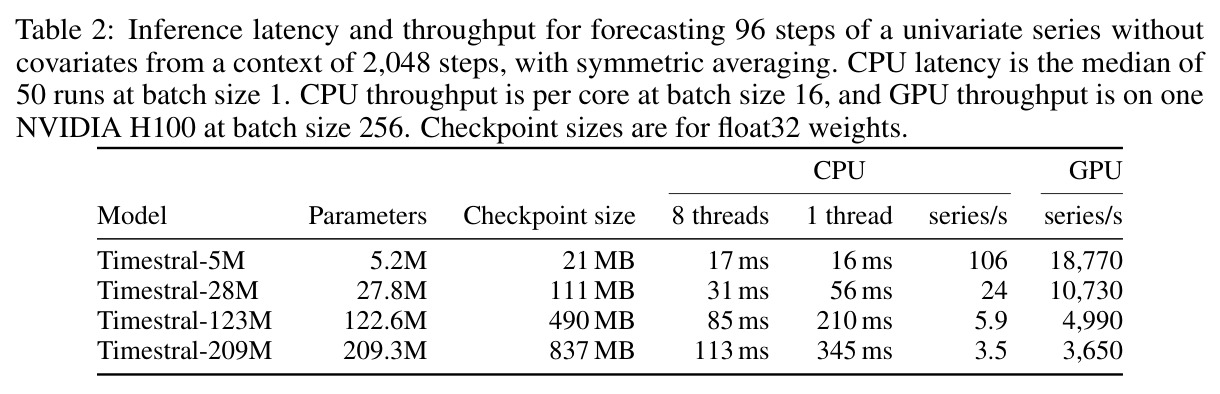
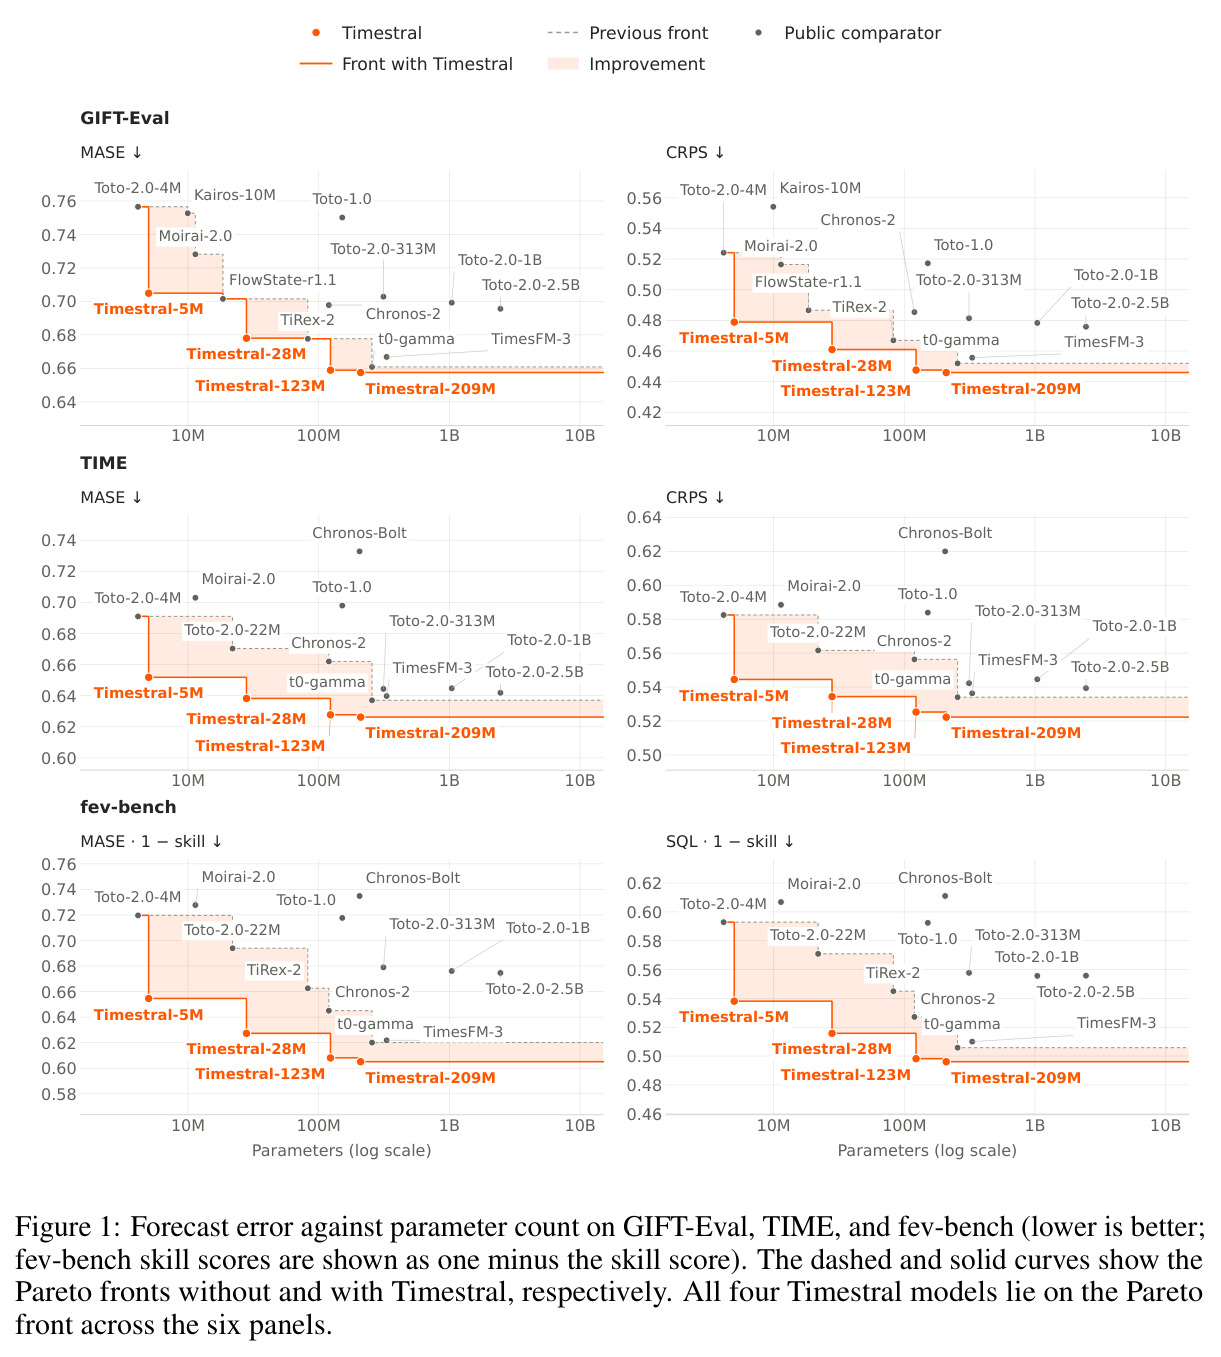
本文的目标是本文目标是构建一族统一的概率预测基础模型 Timestral:同时支持单变量、多变量与协变量条件预测,提供 5M、28M、123M、209M 四个参数规模,共享同一架构与训练配方,覆盖从边缘部署(5M 权重仅 21MB、单核 16ms)到精度优先(209M)的成本-精度权衡谱系。量化目标非常明确:在 GIFT-Eval、TIME、fev-bench 三个公开基准的全部六项指标上取得第一,且四个规模全部落在「精度-参数量」Pareto 前沿上;同时推理不依赖 GPU,单次前向最多预测 32 个 patch(1024 个时间步),CPU 8 线程下 96 步预测延迟控制在 17-113ms。
与已有工作不同的是,作者抓住的被忽视观察是:「为预测而隐藏」与「作为上下文可见」可以在表征层面解耦。CPM 用掩码输入制造长视野监督,掩码 token 既表示「待预测」又表示「缺失」,两种语义被迫共用一种表征;Timestral 则为预测位置引入独立的预测 token 流,上下文 token 始终携带观测值、严格因果地编码一次并被所有预测块共享。另一个独特切入是协变量建模的极简主义:变量角色不写入 token 嵌入,只通过注意力掩码和归一化方式表达,已知未来协变量只互相注意,从结构上杜绝未来信息泄漏。训练策略上推进 PFN 思路:预训练完全用合成数据,把主要精力放在设计生成过程(即先验)上,后训练才引入真实数据并扩展上下文。
核心方法
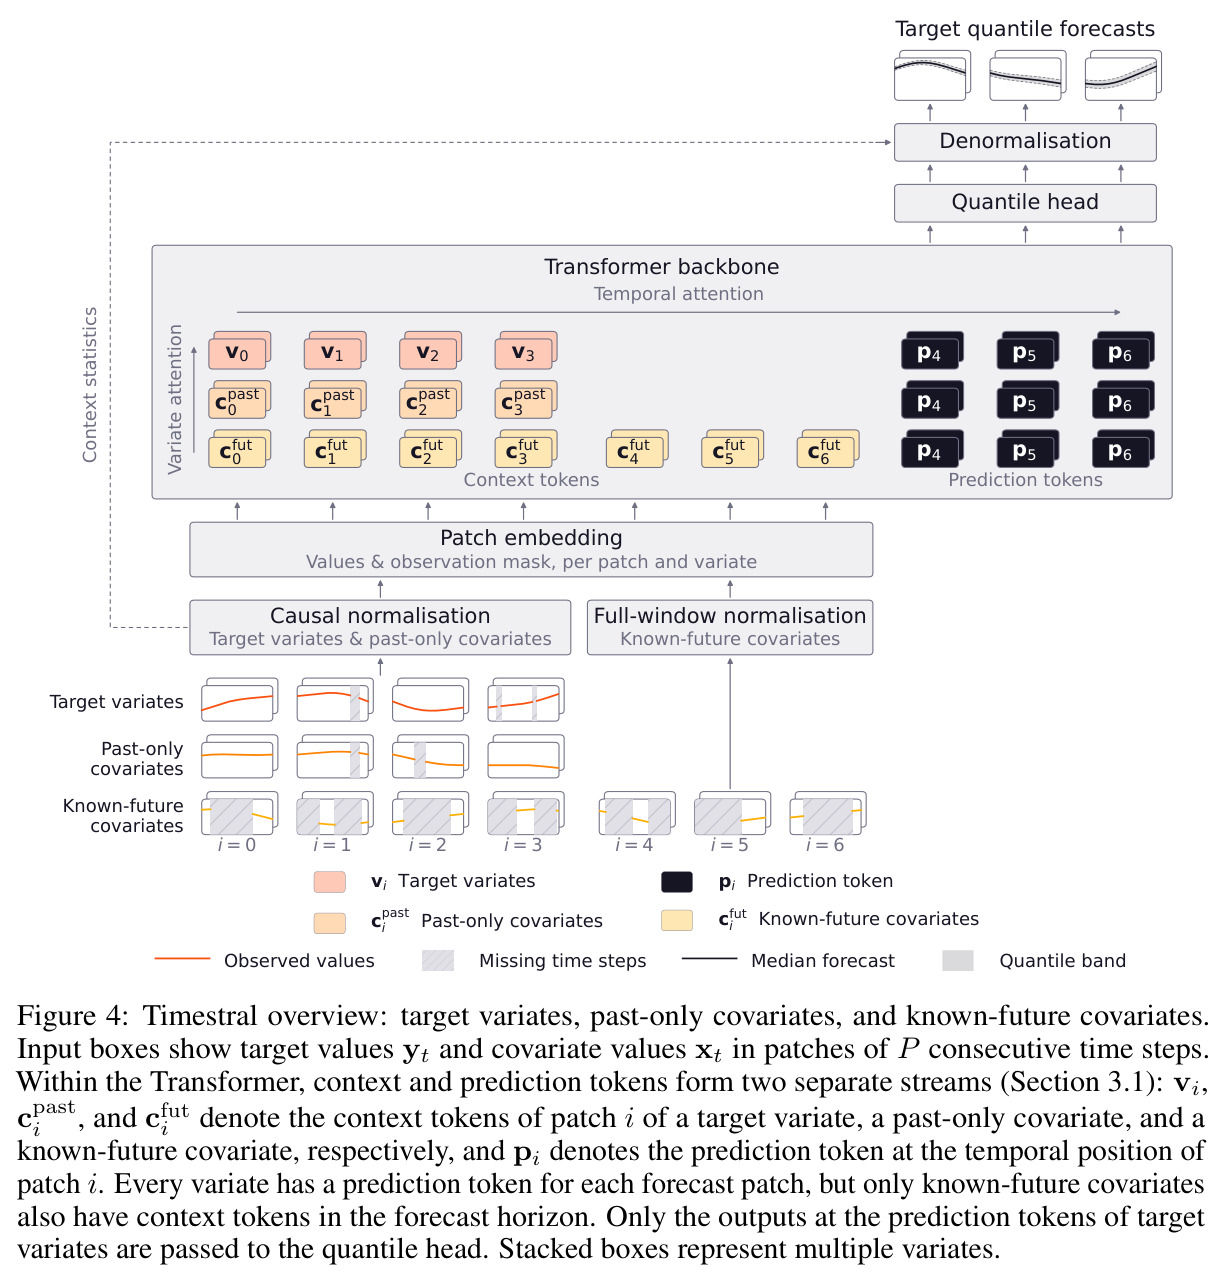
直觉上,Timestral 把「看历史」和「报未来」拆成两股 token 流:上下文流像普通因果语言模型一样逐 patch 编码观测值;预测流是一组可学习的占位 token,各自取用预测位置的时间坐标,只能看到自己所在预测块之前的上下文和块内更早的预测 token,且永远不被上下文回看。技术上:每个 patch 覆盖 $P=32$ 步,由两层残差 MLP 嵌入(输入为 32 个归一化值加 32 个缺失指示位);骨干是带 RMSNorm、SwiGLU、sigmoid 门控注意力的 pre-norm Transformer,时间注意力用旋转位置编码(RoPE,只加在每头一半维度上),每第 4 个块额外做一次变量间注意力(无任何位置编码,变量顺序无关);训练时把序列切成连续预测块,块长从分布采样,一次前向同时得到距离 $1..k$ 的分位数监督;预测头输出 21 个分位水平 $T=\{0.01,0.05,\ldots,0.95,0.99\}$,用 pinball 损失 $\rho_\tau(e)=\max(\tau e,(\tau-1)e)$ 训练。
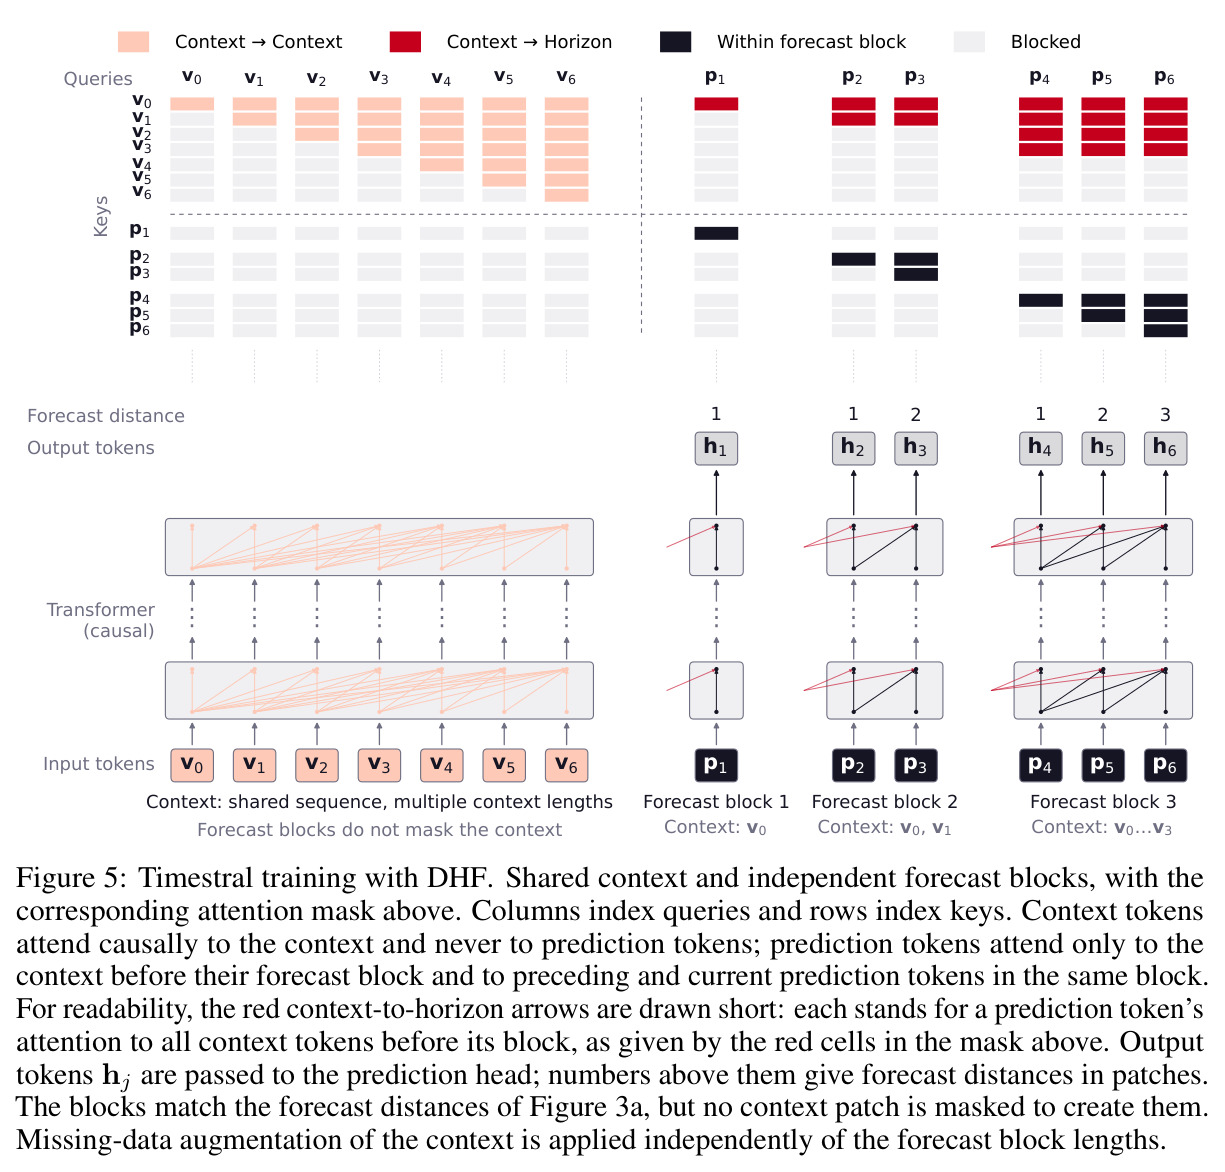
核心创新 DHF(Decoupled Horizon Forecasting)与 CPM 的本质区别在于:CPM 中距离 $d$ 的预测监督要求掩掉目标前 $d-1$ 个 patch,这些值随之从后续所有预测的上下文中消失,「更长视野」与「更少上下文」被绑死;DHF 中每个被预测的 patch 同时拥有两个 token——预测 token(接收损失)和上下文 token(保留观测值供后续块引用),上下文编码只算一次、被整条序列的所有预测块共享。由此带来三个自由度:预测距离的采样频率可独立调节而无副作用;缺失数据增广与视野彻底解耦,可在任意位置模拟变长缺口且被隐藏值仍作为目标计分;真实缺失与「为预测而隐藏」在表征上可区分(CPM 把两者表示成一样)。代价是预测块铺满整条序列,训练 token 数约翻倍。加上角色感知的协变量注意力——已知未来协变量的上下文 token 可看全窗口但只互相注意——预测得以在任意起点利用未来已知信息而不泄漏目标未来值。
方法步骤详情
完整流程:输入是按 patch 组织的多变量序列。第一步归一化:目标变量与过去-only 协变量用因果统计(截至当前 patch 的观测值均值/方差)标准化再做 inverse-asinh 变换,已知未来协变量用全窗口统计,二值变量(如节假日旗标)保持原值。第二步 patch 嵌入:两层残差 MLP 将 32 个值与 32 个缺失指示位编成一个 token,缺失处置零并由指示位区分「真零」。第三步上下文编码:token 以因果注意力流经 Transformer。第四步插入预测块:覆盖 patch $b..b+k-1$ 的块加入预测 token $p_b..p_{b+k-1}$(共享同一可学习嵌入、靠 RoPE 时间位置区分),掩码限定其只能看块前上下文与块内历史预测 token。第五步分位数头:预测 token 输出经两层残差 MLP 映射为每步 21 个分位数,中位数直出、其余用 softplus 正增量累加防交叉;反归一化时块内更早 patch 的未知统计用预测中位数替代。第六步以等权 pinball 损失训练:预训练纯合成数据、上下文 8192 步,后训练混入真实数据、上下文扩到 32768 步。
技术新颖性
新颖性有三层。架构层:DHF 是首个将预测位置做成独立 token 流、同时保持上下文严格因果的时序预测方案,兼收因果模型(一次前向覆盖多上下文长度)与双向编码器(专用预测位置、无需为每个起点重编码上下文)两种范式的长处,直接替代 TiRex/Toto-2.0/TimesFM-3 所依赖的 CPM 掩码训练。协变量层:变量角色仅由注意力掩码和归一化方式表达,不占嵌入容量;「已知未来协变量只互相注意」的约束使防泄漏成为结构性保证而非训练技巧;过去-only 协变量不看目标变量则体现了外生性建模选择。数据层:预训练 100% 合成、后训练才引入真实数据并扩上下文,是对 Chronos-2「纯合成即可学会多变量与协变量」结论的进一步压榨,并把 PFN 的先验设计理念落到生成过程工程上。
实验结果
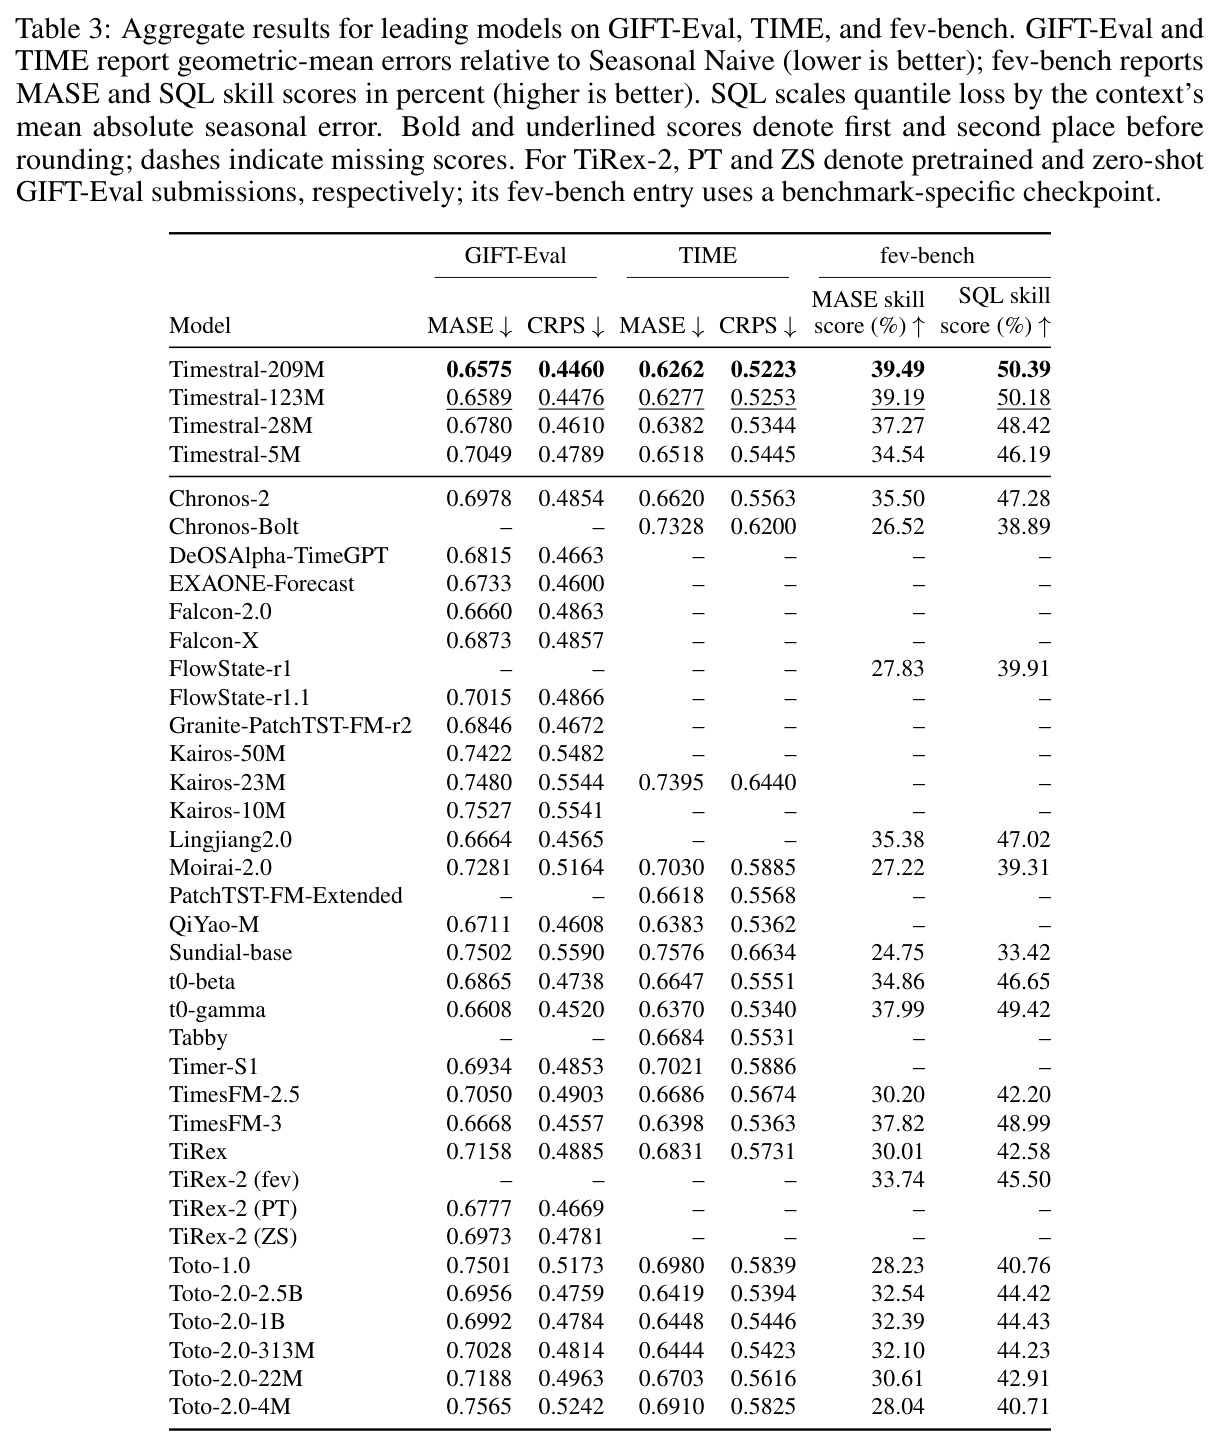
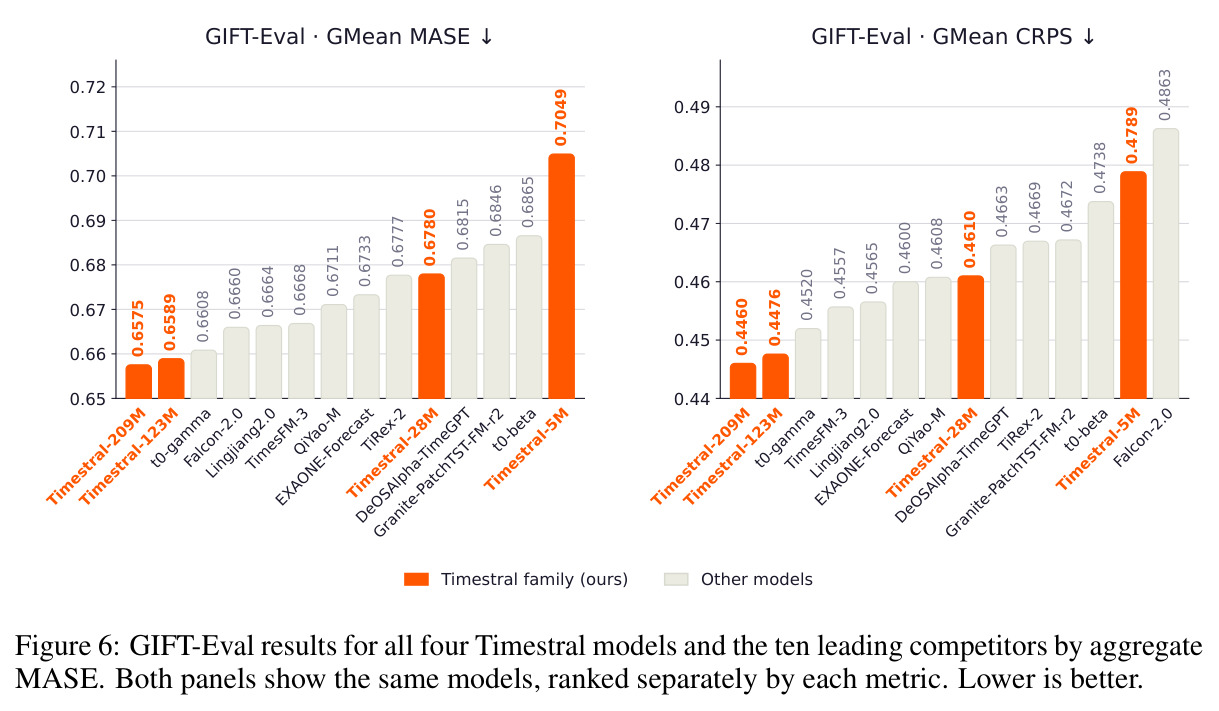
三大基准全部 SOTA,且四个规模都在 Pareto 前沿。GIFT-Eval:209M 的几何平均 MASE 0.6575、CRPS 0.4460,123M 为 0.6589/0.4476,包揽前二,优于此前最佳 t0-gamma(0.6660/0.4520);28M(MASE 0.6608)虽排第九,却在全部六项指标上超过约为其 4 倍大小的 Chronos-2 和约 90 倍的 Toto-2.0-2.5B。TIME:209M 达 MASE 0.6262、CRPS 0.5223,123M 为 0.6277/0.5253,同样前二。fev-bench(skill 越高越好):209M 的 MASE skill 39.49%、SQL skill 50.39%,123M 为 39.19%/50.18%;最惊人的是 5M 版本(MASE skill 34.86%)超过全部 Toto-2.0 模型(30.61%-32.54%),参数只有 2.5B 版的约 1/480。工业基准 IND-Eval 上 209M/123M/28M 包揽前三。推理效率:CPU 8 线程出 96 步预测延迟 17ms(5M)到 113ms(209M),单核吞吐 3.5-106 序列/秒,一块 H100 吞吐 3650-18770 序列/秒;上下文从 2048 扩到 32768 步延迟涨约 9-12 倍。
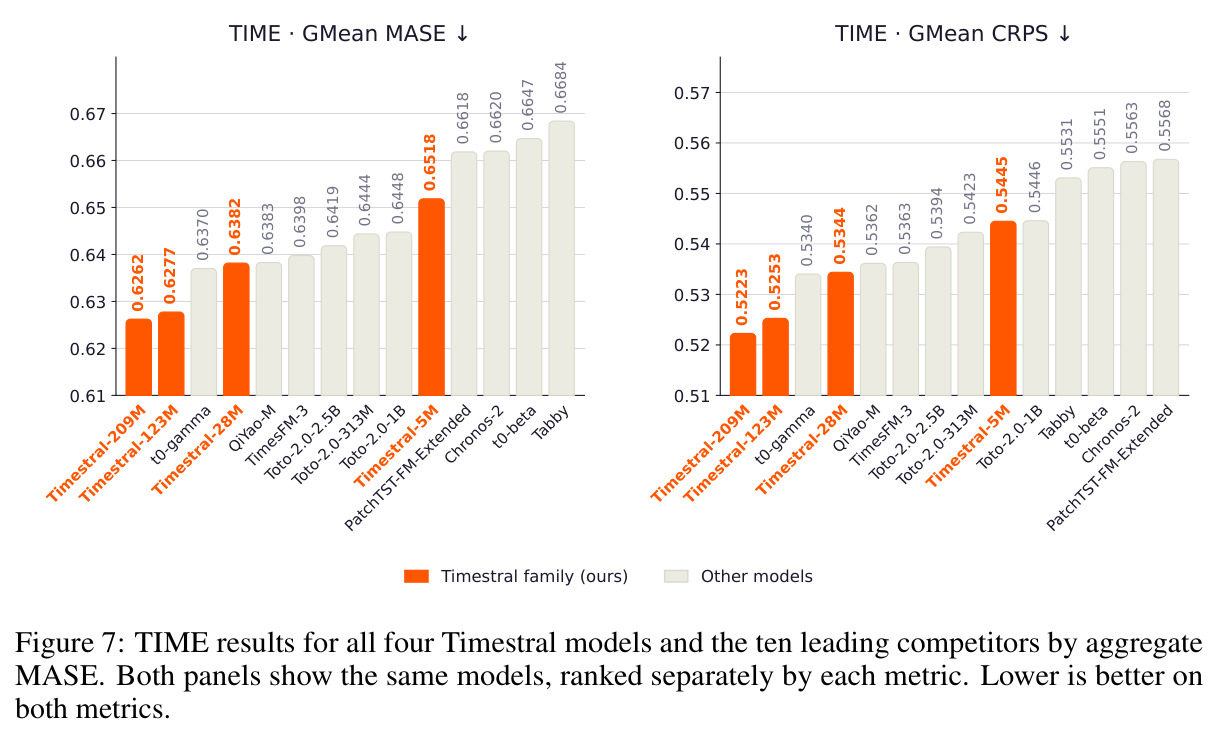
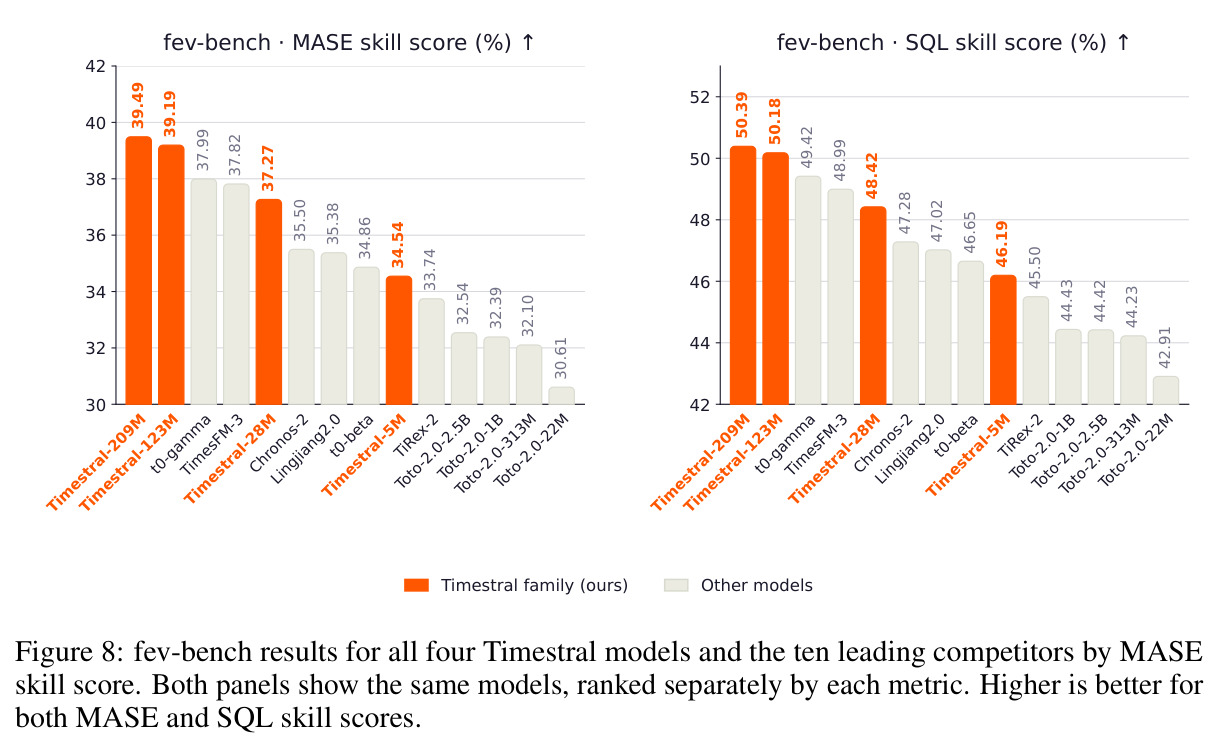
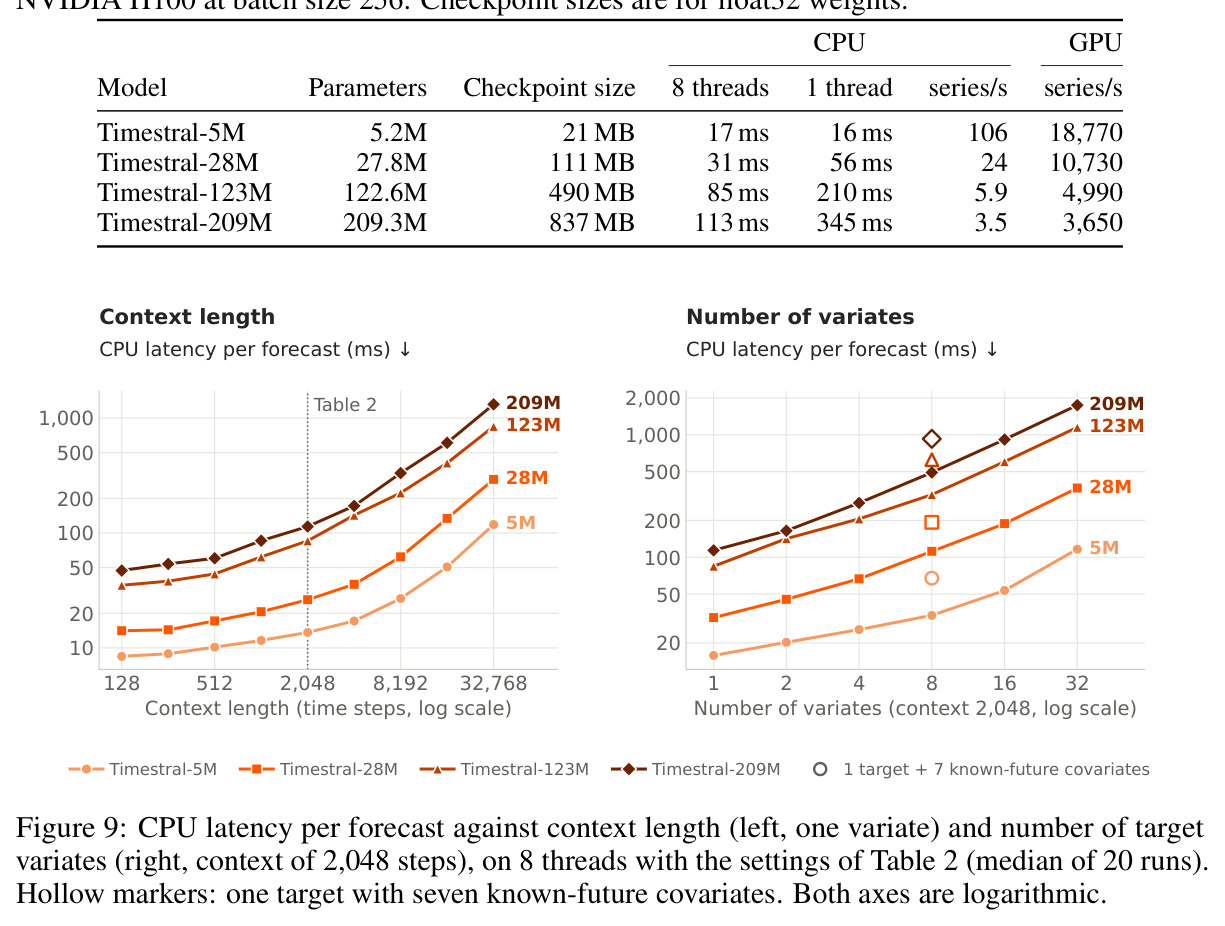
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GIFT-Eval 概率预测 | GMean MASE(越低越好) | Timestral-209M:0.6575 | t0-gamma(此前最佳):0.6660 | 降低约 1.3%,且 123M(0.6589)也已超过所有非本家族模型 |
| GIFT-Eval 概率预测 | GMean CRPS(越低越好) | Timestral-209M:0.4460 | t0-gamma:0.4520 | 降低约 1.3% |
| TIME 概率预测 | GMean MASE(越低越好) | Timestral-209M:0.6262 | t0-gamma:0.6370 | 降低约 1.7% |
| TIME 概率预测 | GMean CRPS(越低越好) | Timestral-209M:0.5223 | t0-gamma:0.5340 | 降低约 2.2% |
| fev-bench 概率预测 | MASE skill score(越高越好) | Timestral-209M:39.49% | t0-gamma:37.99% | 提升约 1.5 个百分点;5M 版(34.86%)超过全部 Toto-2.0 模型(30.61%-32.54%) |
| fev-bench 概率预测 | SQL skill score(越高越好) | Timestral-209M:50.39% | t0-gamma:49.42% | 提升约 1.0 个百分点 |
| IND-Eval 工业基准 | 综合排名 | 209M/123M/28M 包揽前三 | Chronos-2、Toto-2.0 系列、TimesFM-3 等 | 领先幅度大于公开基准 |
局限与改进
作者承认或可从文中读出的局限:单次前向最多预测 32 个 patch(1024 步),更长视野需逐块把前块预测中位数当条件喂入,误差会沿块累积;作为技术报告,训练算力、数据配比、合成生成器细节均未公开,结果难以归因;三个基准都以聚合均值呈现,未报告分数据集的最差情形与统计显著性。我自己的观察:模型只输出 21 个分位数、无采样轨迹,对极端事件的尾部不确定性刻画有限;上下文 32768 步时延迟增长 9-12 倍,协变量开销显著(1 个目标加 7 个已知未来协变量比 8 个目标慢 1.7-2.0 倍),实时场景需掂量;纯合成预训练的先验对分布外真实领域的迁移边界没有消融实验;因果归一化统计在长非平稳序列后期会滞后于分布漂移。
独立分析的弱点
独立分析几处弱点。其一,块间自回归依赖预测中位数做条件,长视野下校准会系统性漂移,改进方向是块级多轨迹采样或对前块输出做分布传播而非点估计。其二,论文没有做 DHF 与 CPM 的严格控制变量对照:训练 token 翻倍的算力若换成一倍 CPM 训练加更多数据,结论是否仍成立不得而知,缺少消融使核心主张的证据链偏弱,改进方向是公开同算力消融。其三,变量注意力无任何位置或语义编码,无法利用传感器名称、领域层级等元信息,可引入文本对齐的变量编码器。其四,因果归一化用「截至当前 patch」的统计量,长序列非平稳时标准化滞后于分布漂移,可用在线更新统计或滑动窗口归一化。其五,缺失信息只进入 patch 嵌入的第一层 MLP,超长缺口下上下文 token 可能退化为近似占位符,可在多层间重复注入缺失指示。
未来方向
作者提出的方向:继续放大模型(123M 到 209M 精度仍在提升,说明尚未饱和);把上下文表征用作分类、异常检测等任务的时序嵌入;将模型嵌入现有监控流水线或与语言模型组成 agentic 工作流。基于成果可延伸的方向:把 DHF 的双流 token 思想推广到不规则采样、多分辨率与事件数据;协变量框架扩展到「部分已知」或带噪声的未来信息;利用 PFN 解释做后验预测分布的覆盖率诊断与校准评估;对 5M/28M 做量化与边缘设备部署研究(5M 权重仅 21MB、单核 16ms);以及把变量间注意力替换为图结构先验,注入领域知识。
复现评估
开源情况好于一般技术报告:四个规模的权重全部发布在 HuggingFace(float32 检查点 21MB-837MB),GitHub 提供推理代码,配合 torch.compile 与 bfloat16(论文实测与 float32 预测差异小于 0.2%),另有产品网页。推理复现非常容易:无需 GPU,5M 在单核 CPU 上 16ms 出一次预测,普通笔记本即可跑通;GIFT-Eval、TIME、fev-bench 均为公开基准,评测结果可复核。训练复现基本不可行:合成数据生成器、真实/合成配比、优化器超参与总算力都未披露,论文也明确只描述「模型设计与基准结果」。想在自有数据上做后训练(post-train)则需自行摸索混合比例与上下文调度。总体判断:拿来用很容易,从头复现训练很难。
论文图表
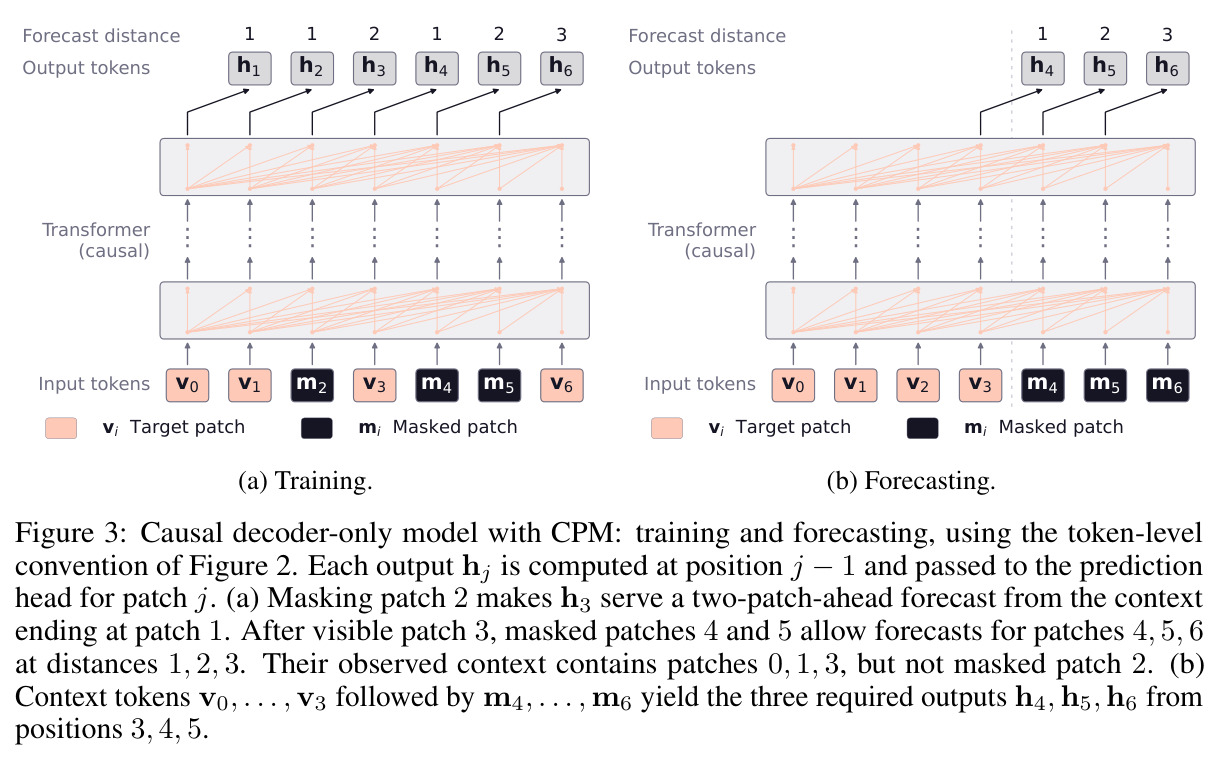
展示 CPM 如何通过掩掉连续 patch(如 $m_2$、$m_4$、$m_5$)制造多视野监督,以及推理时用掩码块覆盖预测视野;关键在于被掩 patch 不再作为后续预测的上下文。
这是本文批判的现有方法,其「视野-上下文耦合」缺陷是全文动机所在,也是与 Figure 5 对照的参照物。