TimeBraid:统一时间序列与语言的理解与预测模型 TimeBraid: Unifying Time Series and Language for Understanding and Forecasting
用全局残差注意力对齐预训练语言模型与时序基础模型,单模型双向完成时序理解与预测。
前置知识
时间序列基础模型与 patch 化
在海量时序语料上预训练、可零样本跨域预测的模型(TimesFM、Chronos、Moirai、Sundial 等)。它们把连续序列按固定长度切成 patch,每个 patch(如 32 个数值)映射为一个 embedding,像 ViT 处理图像块一样自回归预测后续 patch。高效但会压缩局部数值细节。
TimeBraid 的感知与预测专家直接用时序基础模型初始化,patch 表征既是能力来源也是数值保真瓶颈,论文多处讨论(如 CaTS-Bench 数值保真短板)都依赖这个概念。
Mixture-of-Transformers (MoT)
一种多模态架构:不同模态各有一套完整的 Transformer 块(注意力、MLP 均不共享参数),模态之间仅在注意力处交换信息——每个模态的 query 额外关注其他模态的 key/value。相比单一共享主干,它保留各模态专属参数,减少任务间干扰。
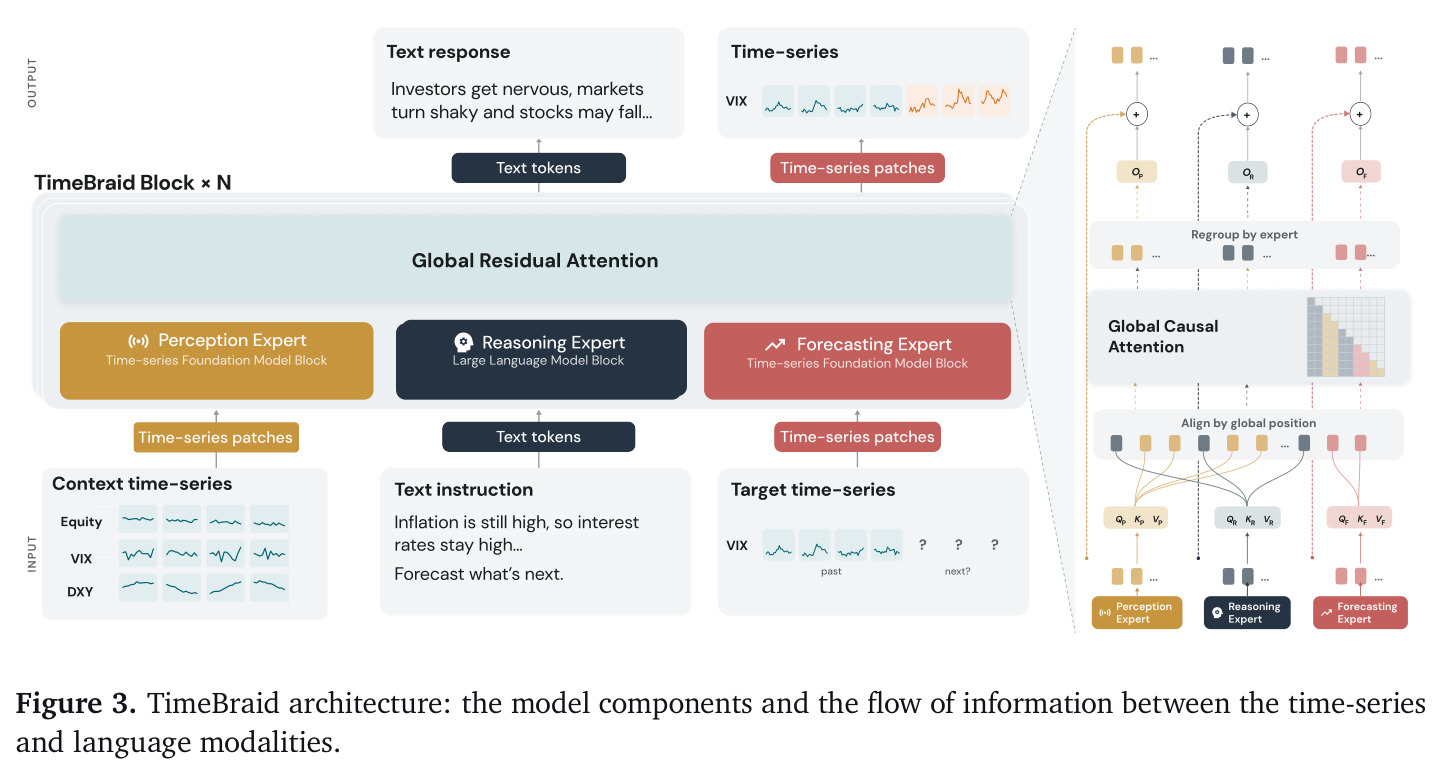
TimeBraid 的三专家设计(感知/推理/预测专家)就是 MoT 的实例化,理解其配对层与全局残差注意力机制必须先懂 MoT 的参数隔离与注意力共享思想。
RevIN 可逆归一化
针对时序非平稳性的归一化方法:用窗口统计(均值 $\mu$、标准差 $\sigma$)把输入序列归一化,预测输出后再逆变换恢复量纲,从而应对分布漂移。因果/滚动版本只使用历史统计量,避免泄露未来信息,适合自回归预测。
目标段的滚动 RevIN 是 TimeBraid 输入处理的关键,也是联合训练不稳定的根源(回归 loss 尖峰),作者正是在其上叠加 asinh 鲁棒变换与损失帽来解决稳定性问题。
Pinball 损失(分位数回归)
分位数 $q$ 下的损失 $\mathcal{L}_q=\max(q\,e,(q-1)\,e)$,其中 $e=y-\hat y^{(q)}$ 为预测误差。最小化它使预测值成为该分位数的最优估计;同时预测多个分位数(如 $q\in\{0.1,\ldots,0.9\}$)即可刻画完整的预测分布与不确定性。
TimeBraid 的时序目标是点回归加 pinball 项(式 3),预测评测指标 CRPS 也源于概率预测,不懂分位数损失就读不懂它的损失设计与 CAF/CRPS 评测。
RoPE 旋转位置编码
把位置信息以复数旋转的形式注入 query/key,使注意力得分只依赖 token 间的相对位置差,具备一定长度外推能力,被 LLaMA 等主流 LLM 采用。本文在全局残差注意力中把两种模态的 token 放到同一根全局时间轴 $\tau$ 上施加 RoPE,使跨模态注意力能感知时间先后。
式 (2) 中的 $\text{RoPE}_\tau$ 与三套位置编码设计(语言塔原生 RoPE、时序塔段内局部位置、全局层时间轴位置)是架构细节的核心,是跨模态交互'按时间对齐'的基础。
研究动机
时间序列是生理、电网、市场、气候等动态系统的数值记录,本身缺乏语义语境,难以被识别和解释,而当前的多模态统一模型(GPT、Gemini 类全模态系统)几乎完全缺失这一模态。已有工作把时序接入大模型的方式都是「外挂」:ChatTS 等沿用 LLaVA 式 MLP projector 把时序编码进语言空间;ChatTime 把数值当作离散 token 塞进 LLM 词表;TimeOmni-VL 把序列渲染成像素图;Time-LLM 等只给时序模型加文本分支。这些做法引入表征鸿沟——把一种几何硬塞进另一种几何,造成语义错位并损伤预训练能力,而且每个系统只覆盖理解或预测的单向接口。后果直观可见:GPT-5.4 在 TSAQA 时序问答上仅 63.10%,而专用时序基础模型在「根据新闻预测」的场景里完全无法利用文本,在 Ctrl-F 上全部停留在 33.33% 的随机水平。
本文的目标是本文要构建一系列统一时间序列-语言模型 TimeBraid(1.2B、2.5B、6.7B 三个尺寸),在单一权重内同时服务序列-文本接口的双向:理解(感知、问答、推理、情境描述)与生成(上下文预测、可控预测、单模态预测、价值填补)。设计目标有二:其一,做不受任务格式约束的「全任务学习者与实践者」,输入输出接受任意数量、任意顺序的时序段与文本段交错组合;其二,充分继承预训练大语言模型的语言知识、指令遵循与推理能力,以及预训练时序基础模型的连续信号感知与零样本预测能力,而不是从头重学。验收标准是在 GIFT-Eval、Time-MMD、CAF、TSAQA、TemporalBench、CaTS-Bench 等 12 个理解与预测基准上,与参数量远大于自己的通用模型和任务专用模型保持竞争力。
与已有工作不同的是,独特切入是「不搬家、建会客厅」:现有方法总是挑一个预训练宿主,把另一个模态搬进它的表征空间;TimeBraid 让语言与时序各自保留原生预训练表征,在两者之间新建一个对双方几何都不偏袒的共享注意力空间来融合。灵感来自生物感知的分工-整合结构:特化感官各自感知不同信号、大脑负责整合决策,对应 MoT 三专家架构(感知/推理/预测专家)加全局残差注意力。同时,作者把统一视觉-语言模型的两条关键经验——连续信号经离散词表会掉保真度、理解与生成偏好不同表征——首次系统移植到时序:全程在连续空间输入输出、不做量化,并实验检验时序是否需要像视觉那样为理解和生成分塔(结论是不需要)。这使它成为首个双向、非量化、保留预训练能力的时序-语言统一配方。
核心方法
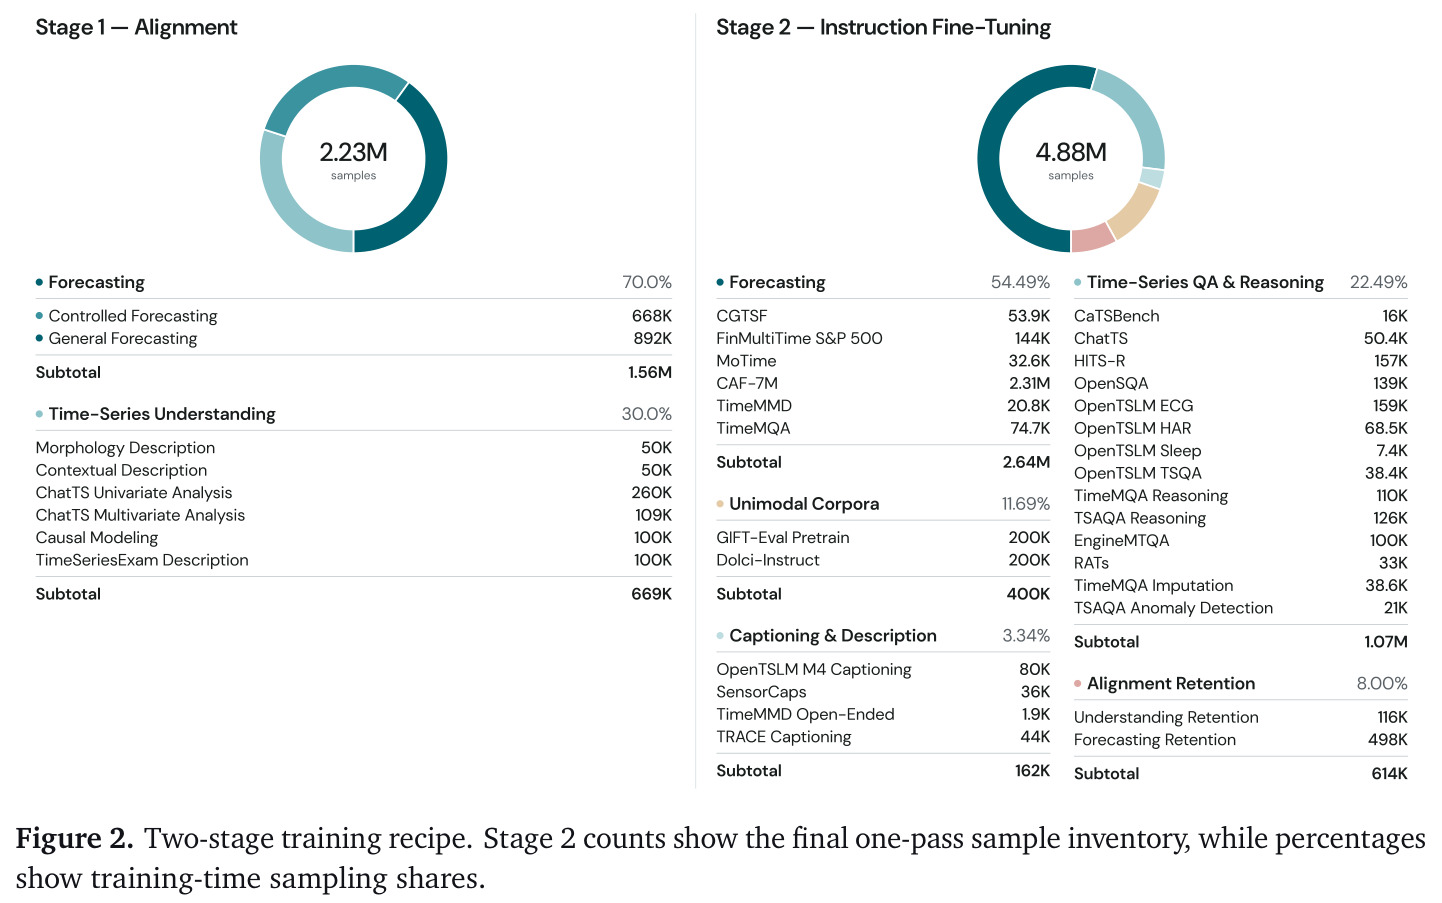
直觉上,TimeBraid 像一个分工明确又共享意识的团队:三个预训练专家各司其职——推理专家是 LLM,负责指令、问题与文本回答;感知专家是时序基础模型,把上下文序列编码成 patch 表征;预测专家也是时序基础模型(可与感知共享同一底座,即双塔),自回归生成目标序列。专家之间通过插入在各配对层的「全局残差注意力」通信:每层先用各自原生块处理自己的 token,再把两侧隐状态投影到共享宽度 $d$ 的空间,按全局时间位置 $\tau$ 重排成一个混合序列做因果自注意力,文本 token 与 patch token 由此双向逐 token 交换信息,输出经零初始化投影加回各自流(初始为恒等映射,训练安全起步)。训练采用两阶段课程:先在 2.23M 构造配对样本上对齐两种模态,再用约 4.88M 异构指令混合做监督微调,覆盖预测、问答推理、描述、单模态与保留的对齐数据。
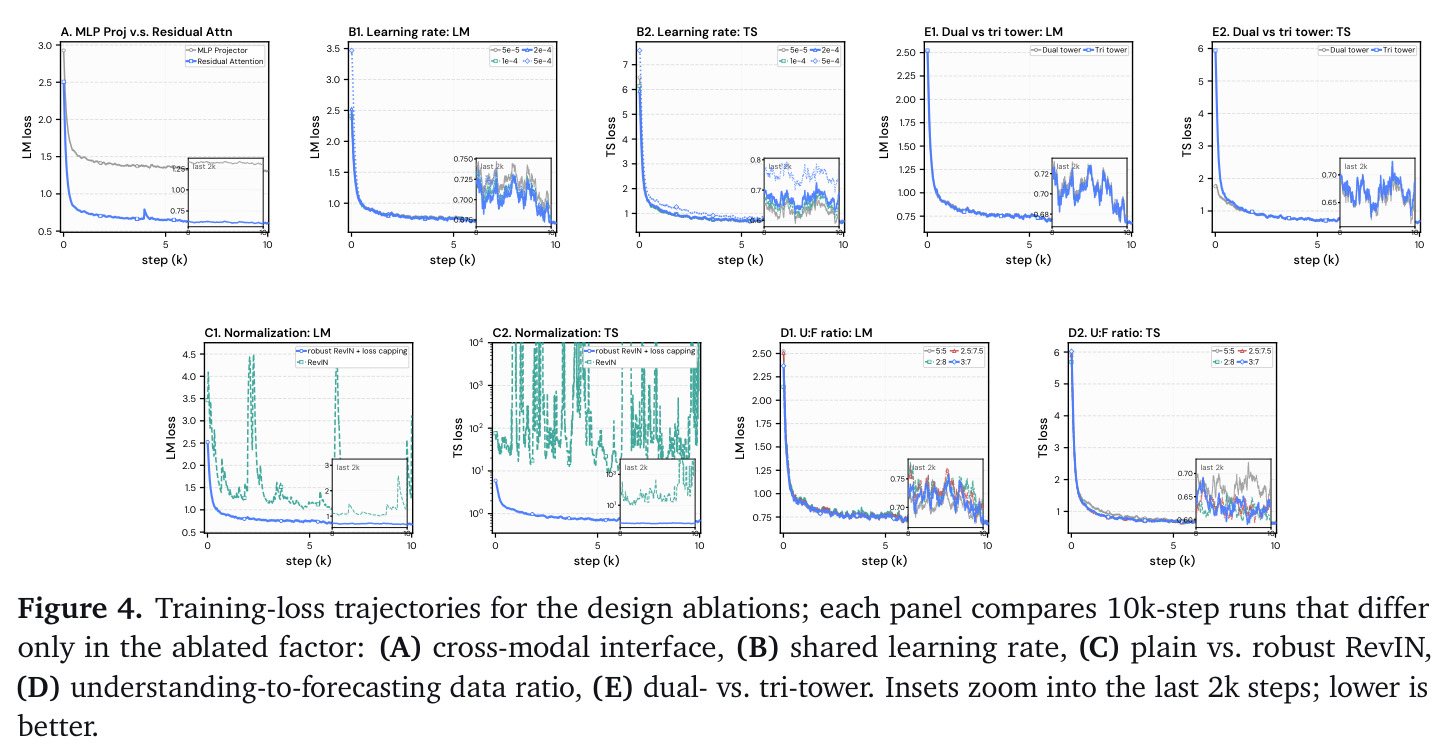
核心创新一:跨模态交互发生在新建的共享空间而非语言空间。消融 RQ1 表明,若沿用 VLM 式 MLP projector 把 patch 投进语言空间,语言 loss 早早停在约 2 倍水平不再下降,且 patch 常退化为均值方差等全局统计量;而共享空间让两个预训练模型平起平坐地对齐。核心创新二:三专家 MoT 架构——感知与预测用不同归一化处理输入但可共享同一时序底座;与视觉统一模型不同(其理解/生成需解耦表征),消融 RQ2 显示双塔与三塔的 loss 轨迹几乎重合,说明时序的感知与生成可以共享表征。核心创新三:稳定联合优化。非平稳段上回归 loss 会尖峰数个数量级并经共享更新摧毁语言表征,作者用 $y=\text{asinh}((x-\mu)/\sigma)$ 鲁棒归一化压缩尾部、加损失帽 $s=\min(1,\,c/\text{stopgrad}(\ell))$ 封顶离群响应,双管齐下,是联合训练能成立的关键前提。
方法步骤详情
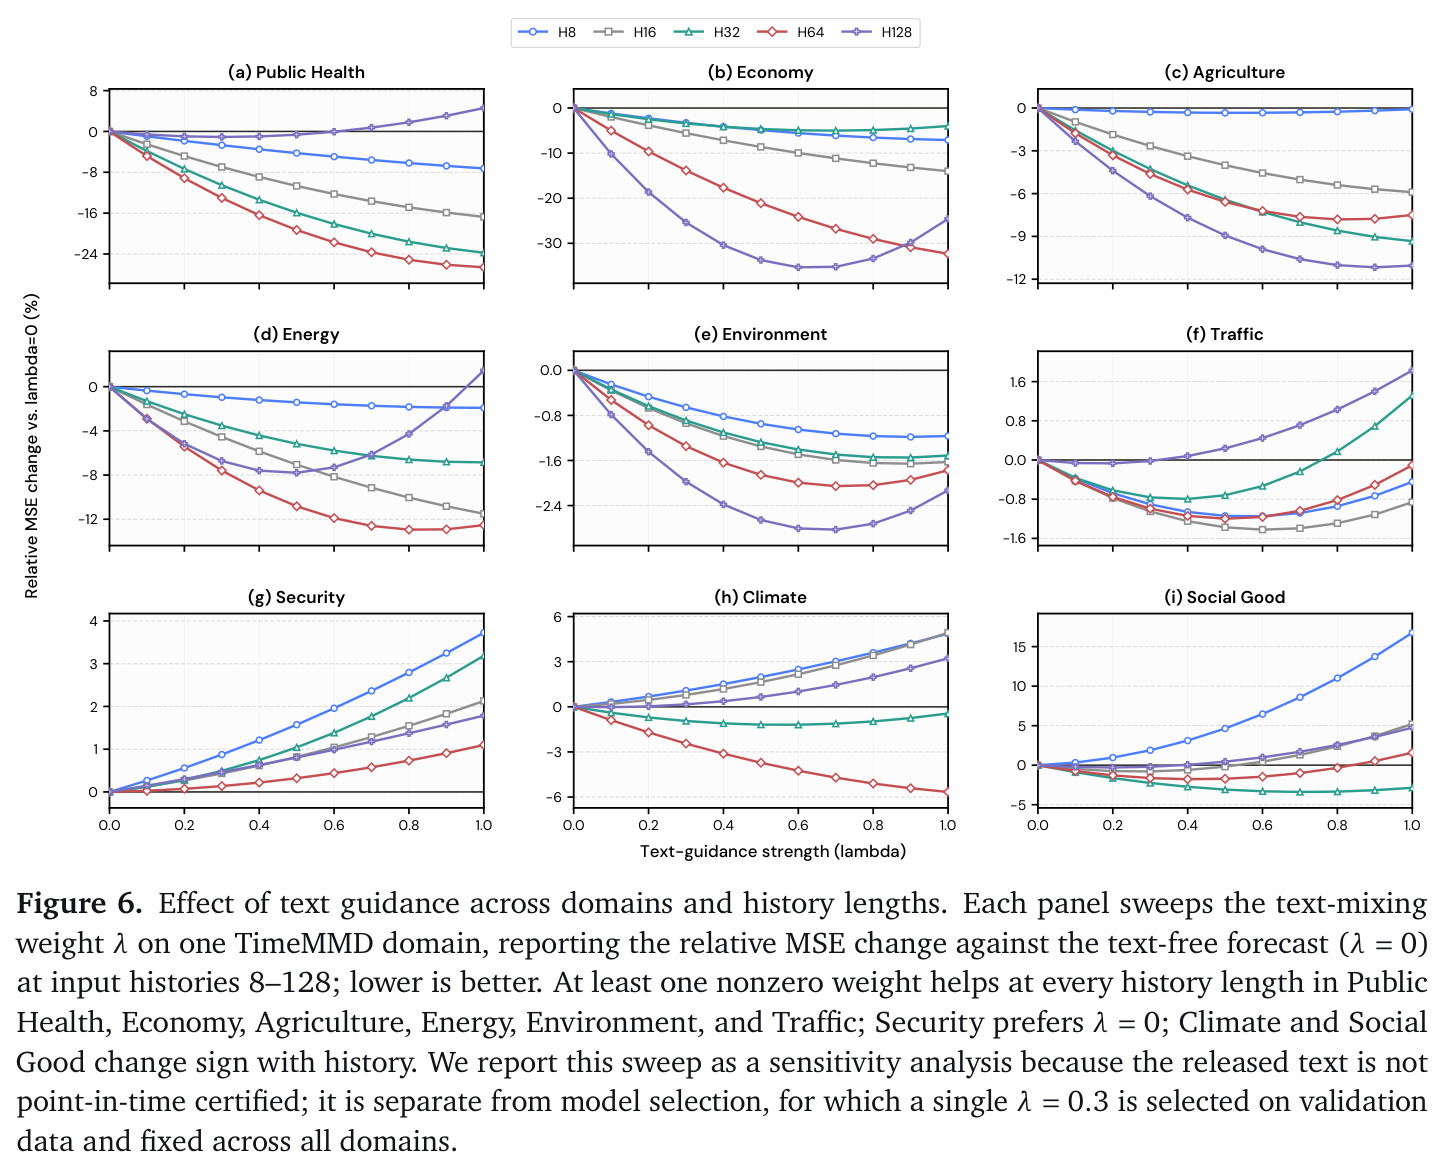
第一步,对齐数据:2.23M 对,理解:预测=3:7——理解侧 669K(形态/情境描述各 50K、ChatTS 式可编程描述 369K、因果建模 100K、TimeSeriesExam 模板 100K),预测侧 1.56M(可控预测 668K:同一历史用可编程算子合成多个未来并标注触发条件;通用预测 892K:未来感知标注但未来绝不进输入)。第二步,统一提示:样例渲染为聊天记录,时序段以 包裹并前置 长度/均值/标准差块;上下文段全段归一化,目标段用历史前缀统计做滚动 RevIN;文本走 LLM 分词,时序切定长 patch。第三步,搭三专家 MoT:配对层按式 (1)(2) 把两侧隐状态经 RMSNorm ($\phi_r$、$\psi$) 与 $W_{Q_r},W_{K_r},W_{V_r}$ 投影到共享宽度 $d$,按全局时间位置 $\tau$ 重排做带全局 RoPE 的因果注意力,$W_{O_r}$ 零初始化后加回原流。第四步,联合损失 $\mathcal{L}=\mathcal{L}_{CE}+\alpha\mathcal{L}_{TS}$,$\mathcal{L}_{TS}$ 为点回归加 $q\in\{0.1,\ldots,0.9\}$ 的 pinball 项,$\alpha=0.5$,并配合 asinh 鲁棒归一化 $y=\text{asinh}((x-\mu)/\sigma)$ 与损失帽 $s=\min(1,\,c/\text{stopgrad}(\ell))$。第五步,训练:AdamW、学习率 $2\times10^{-5}$、500 步 warmup、batch 128、BF16;对齐阶段上下文 2560 训 1 epoch,SFT 上下文 4096 训 30k 步,混合 4.88M 样本(预测 54.49%、QA 推理 22.49%、描述 3.34%、单模态 11.69%、对齐保留 8.00%)。第六步,推理:分别在仅时序与文本+时序条件下查询得 $\hat y_{ts}$、$\hat y_{text+ts}$,按 $\hat y_\lambda=(1-\lambda)\hat y_{ts}+\lambda\hat y_{text+ts}$ 调制文本强度,验证集选定 $\lambda=0.3$。
技术新颖性
与最接近工作的本质区别:ChatTime 把数值离散化进 LLM 词表、TimeOmni-VL 把序列渲染成图、Chronicle 用 324M 参数从头学联合空间(两边预训练能力全弃)、ChatTS/Time-LLM 只做理解单向——TimeBraid 是唯一让两个模态各留原生预训练表征、经轻量投影与共享注意力融合、同时覆盖双向接口的方案。技术新颖性体现在:(a) 配对层交错设计——时序塔层数少于语言塔,每个时序层恰好配对一个语言层,多余语言层不配对,保证深度对齐而不浪费算力;(b) 双流宽度不同($d_r$ 各异)也能同场注意力:靠流特定 RMSNorm $\phi_r$ 与 per-head QK RMSNorm $\psi$ 归一后投影到共享宽度 $d$;(c) 全局位置 RoPE 把两种模态放到同一根时间轴上,模态内局部位置与全局时序位置解耦;(d) 零初始化 $W_{O_r}$ 让联合训练从恒等映射安全热启动;(e) 类 CFG 的推理期文本引导插值用于回归预测,是把生成模型技巧迁移到时序条件预测的新用法。围绕六个研究问题的消融(RQ1–6)本身就是对这一新模型类设计空间的首次系统测绘。
实验结果
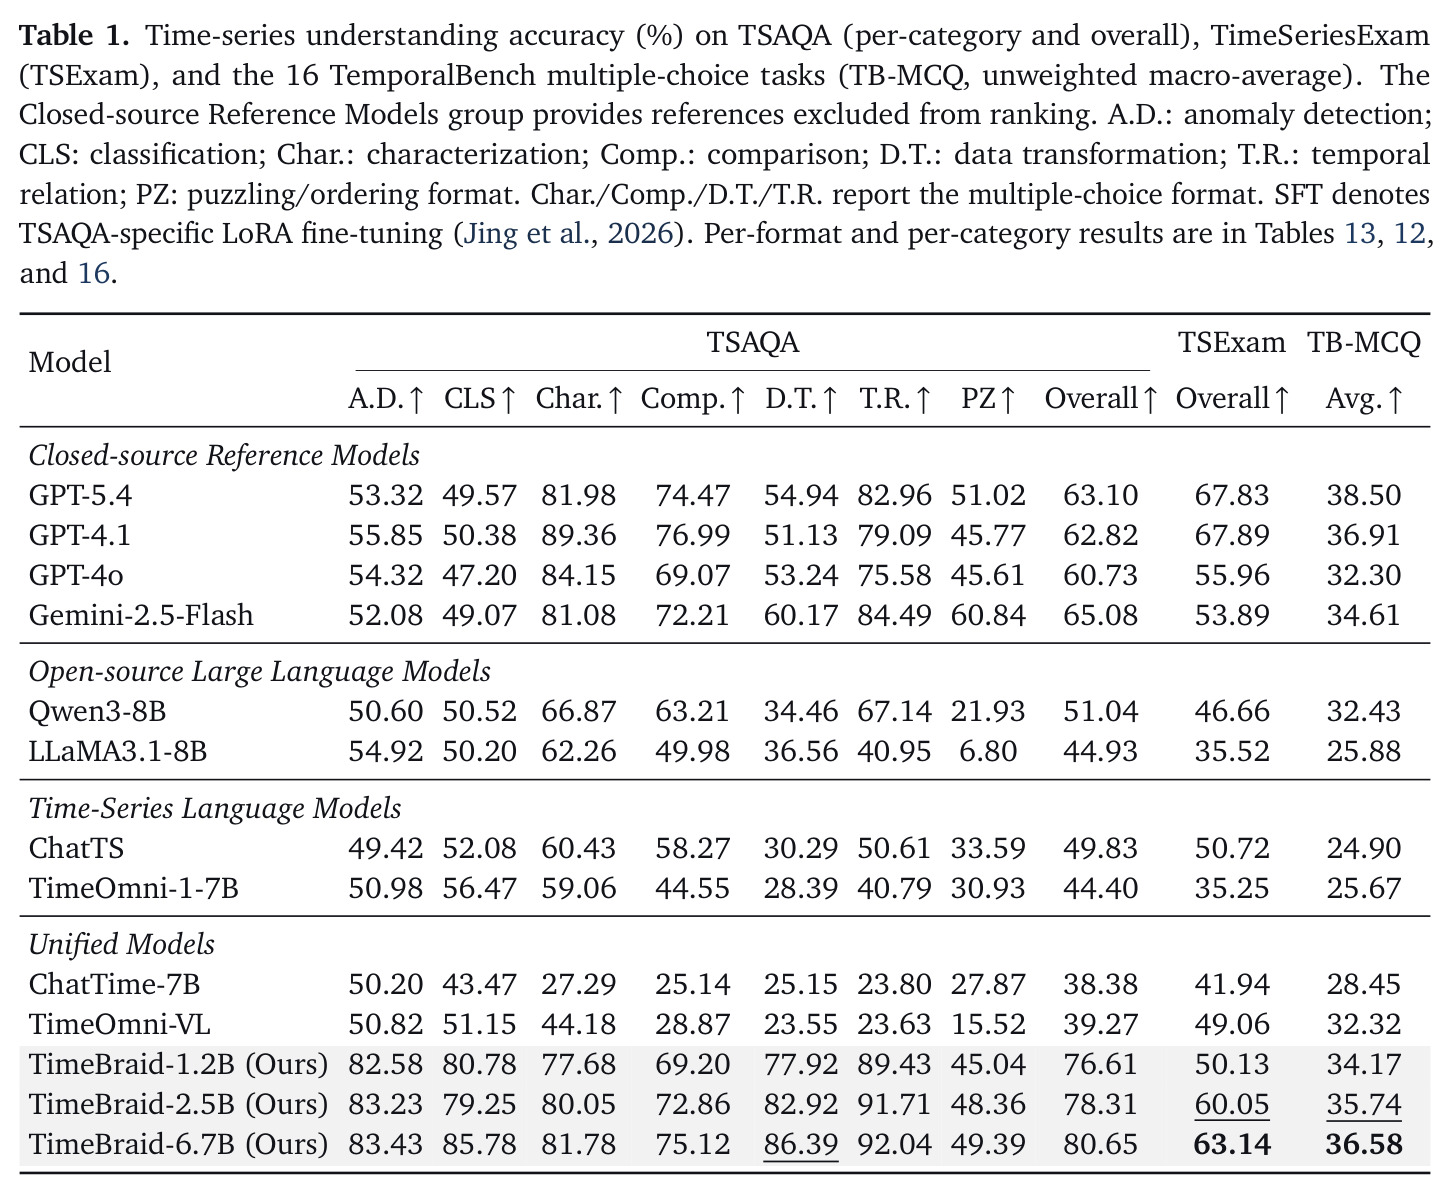
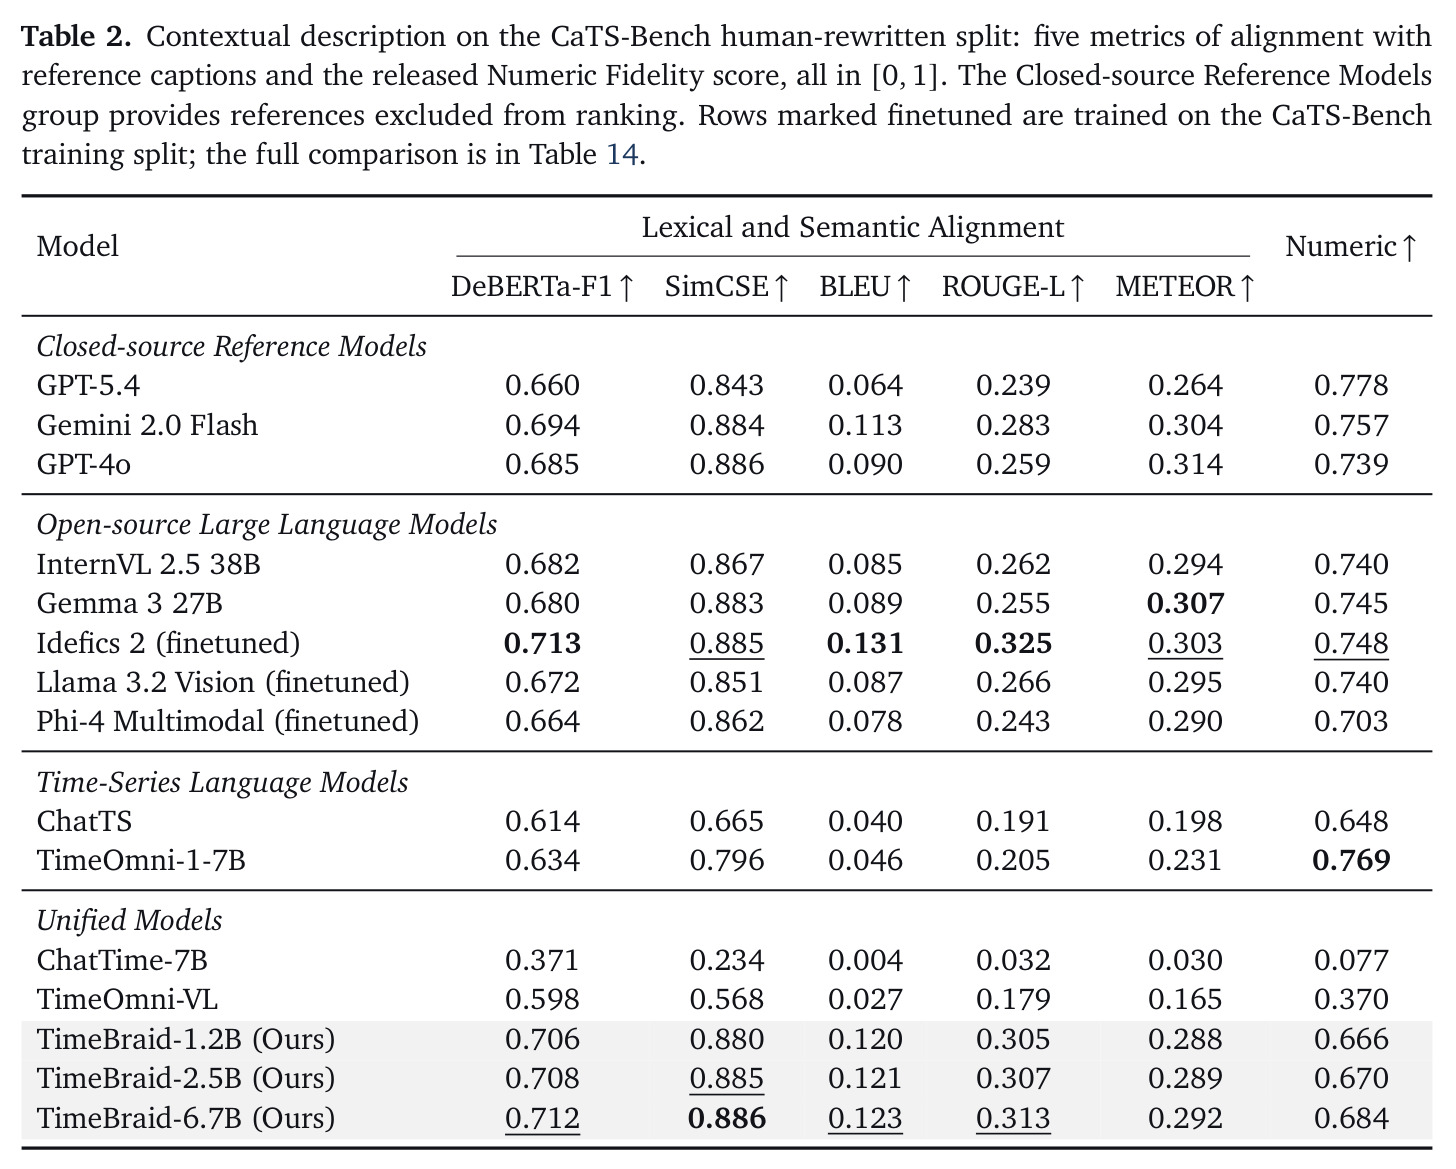
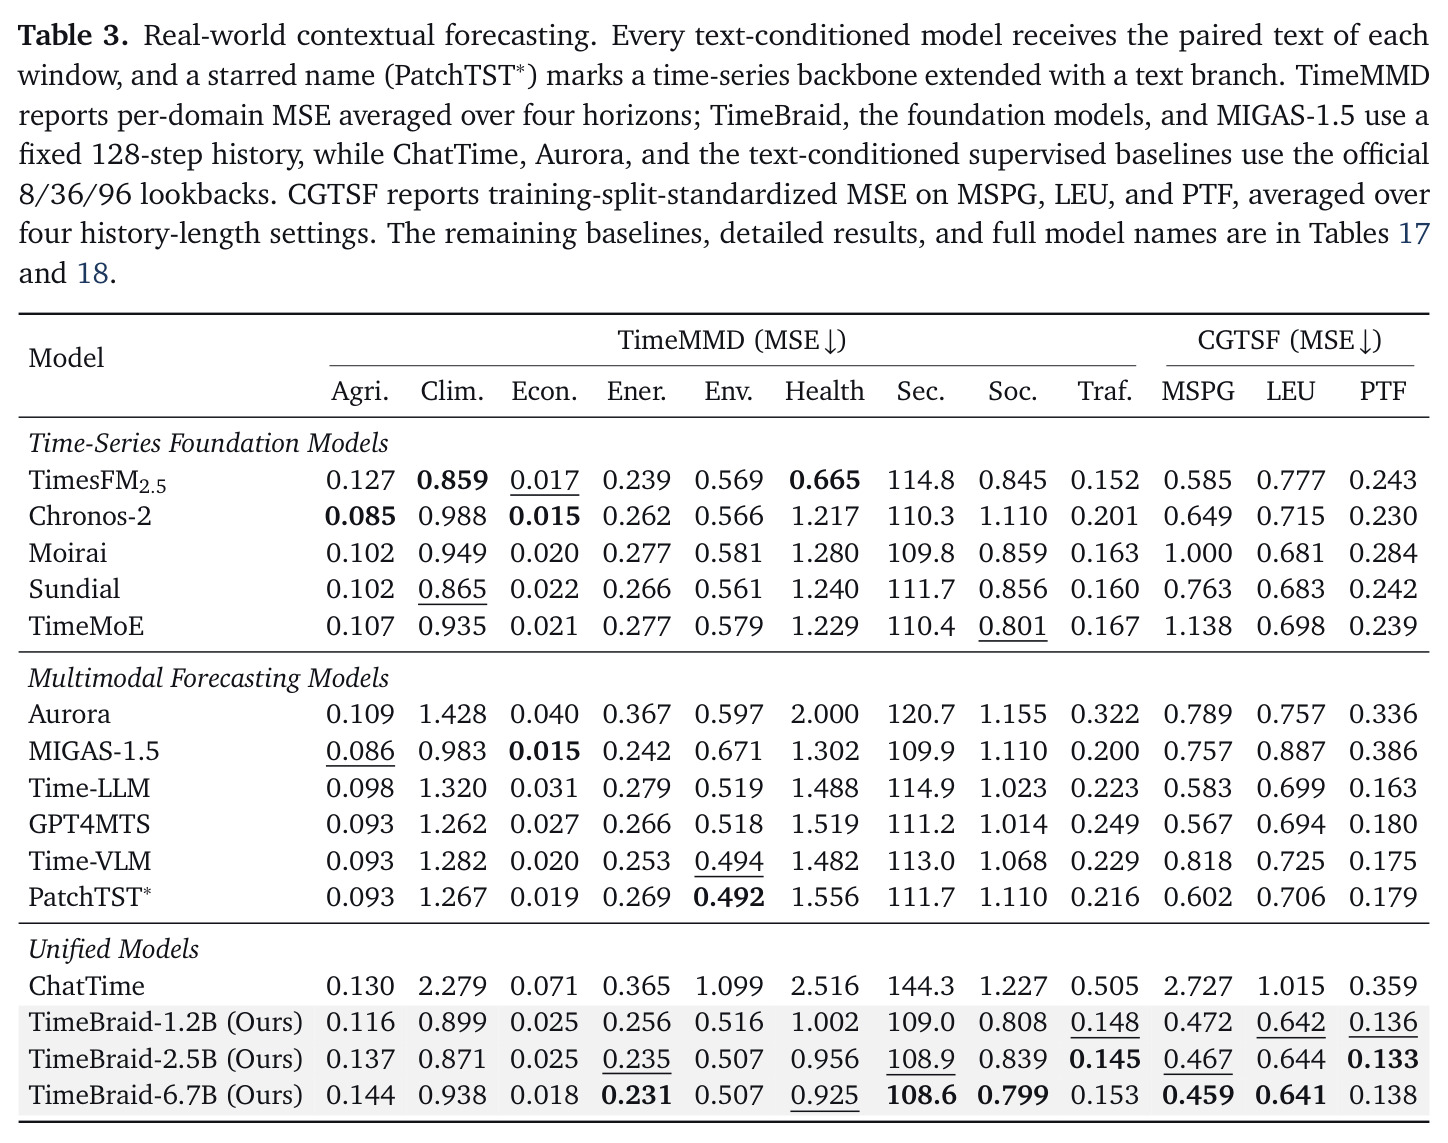
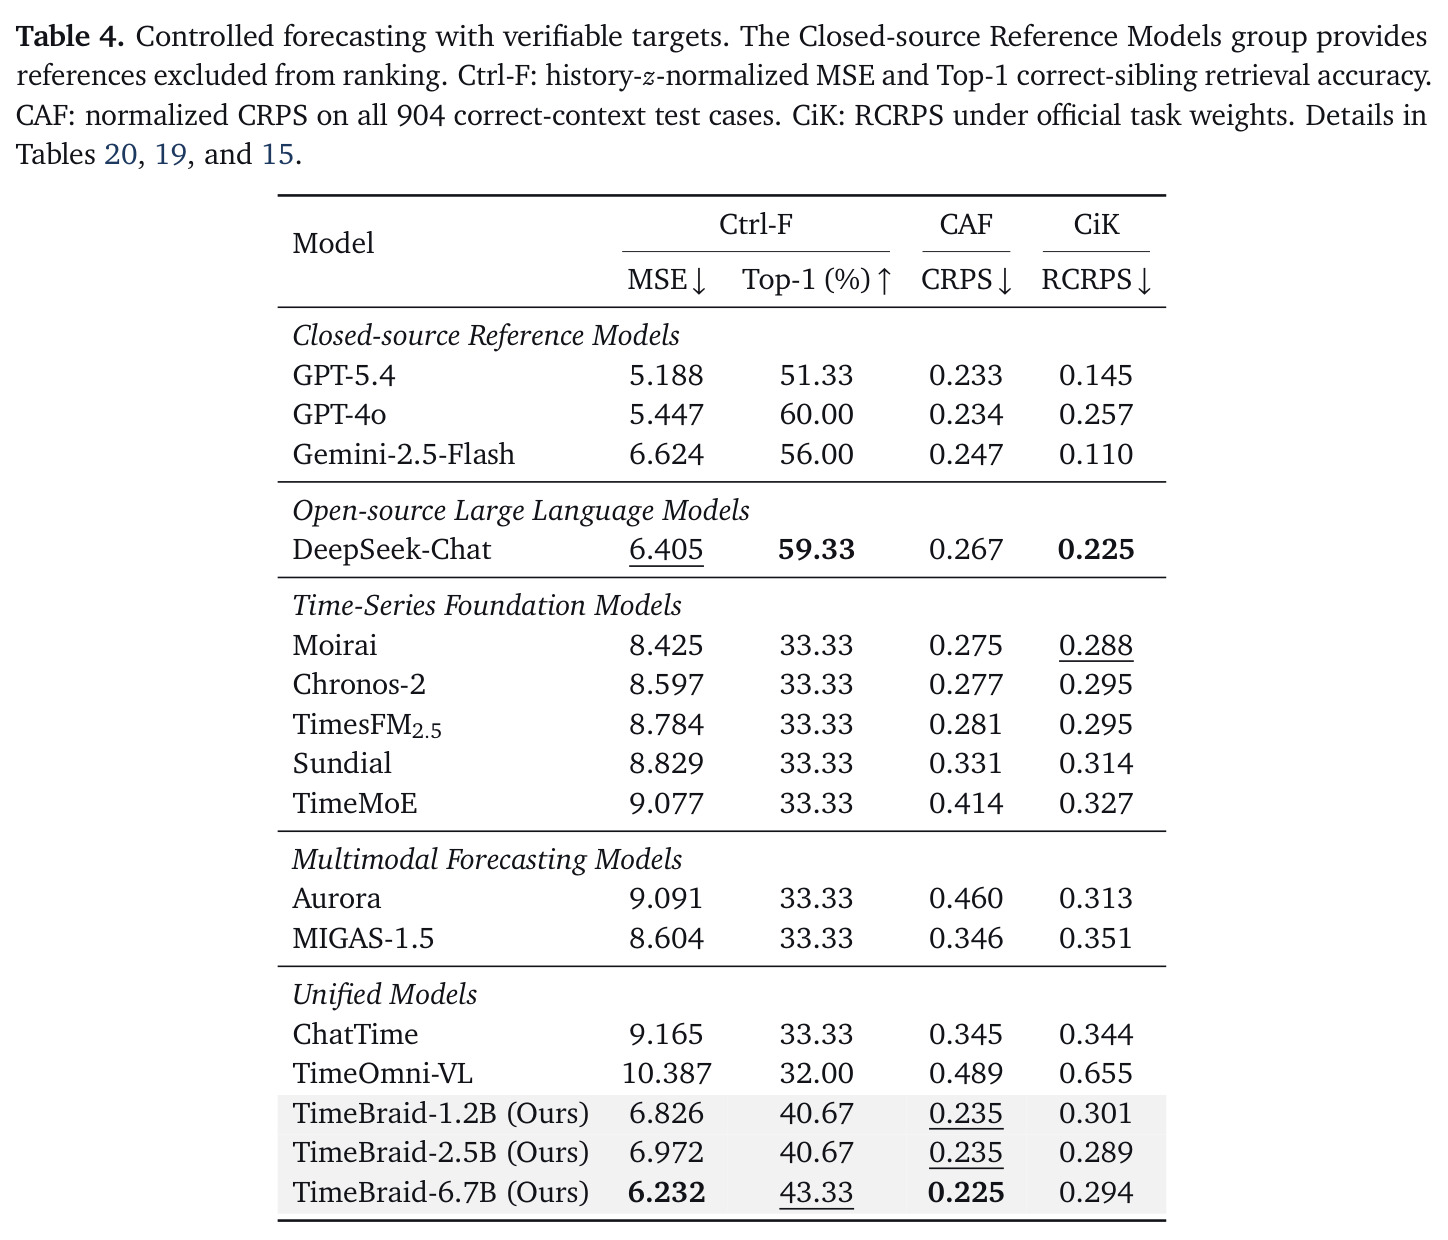
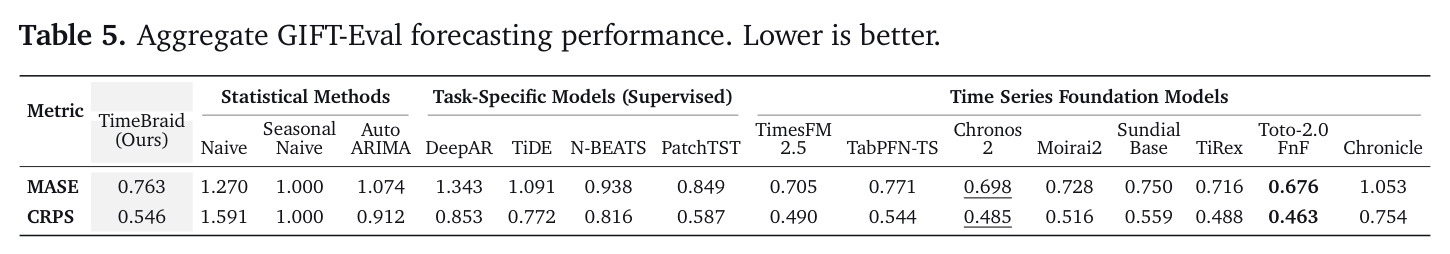
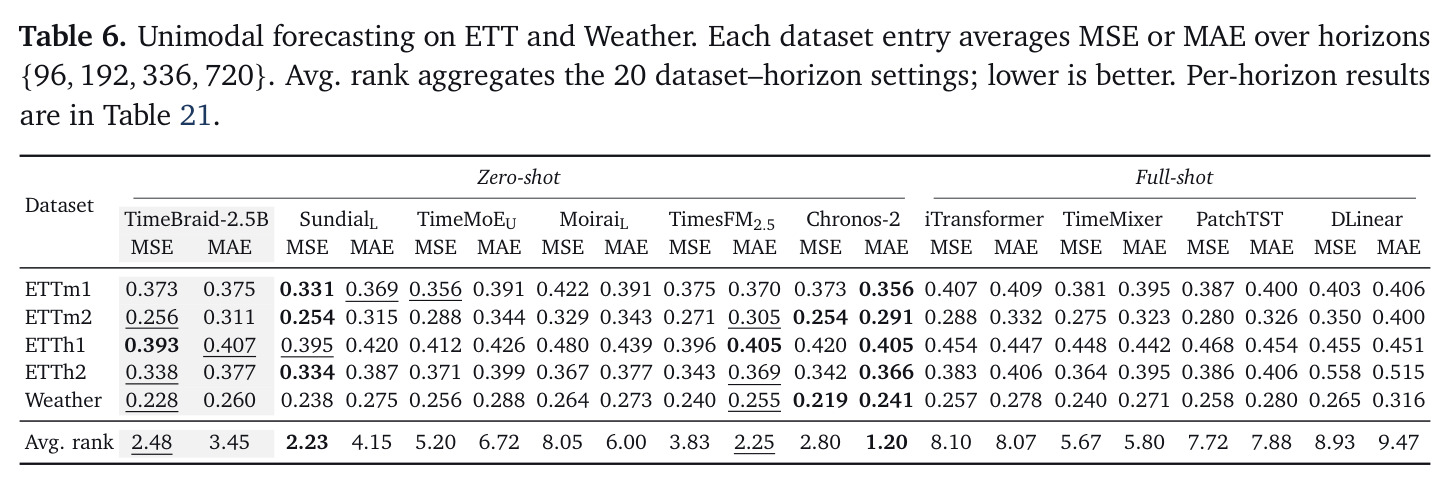
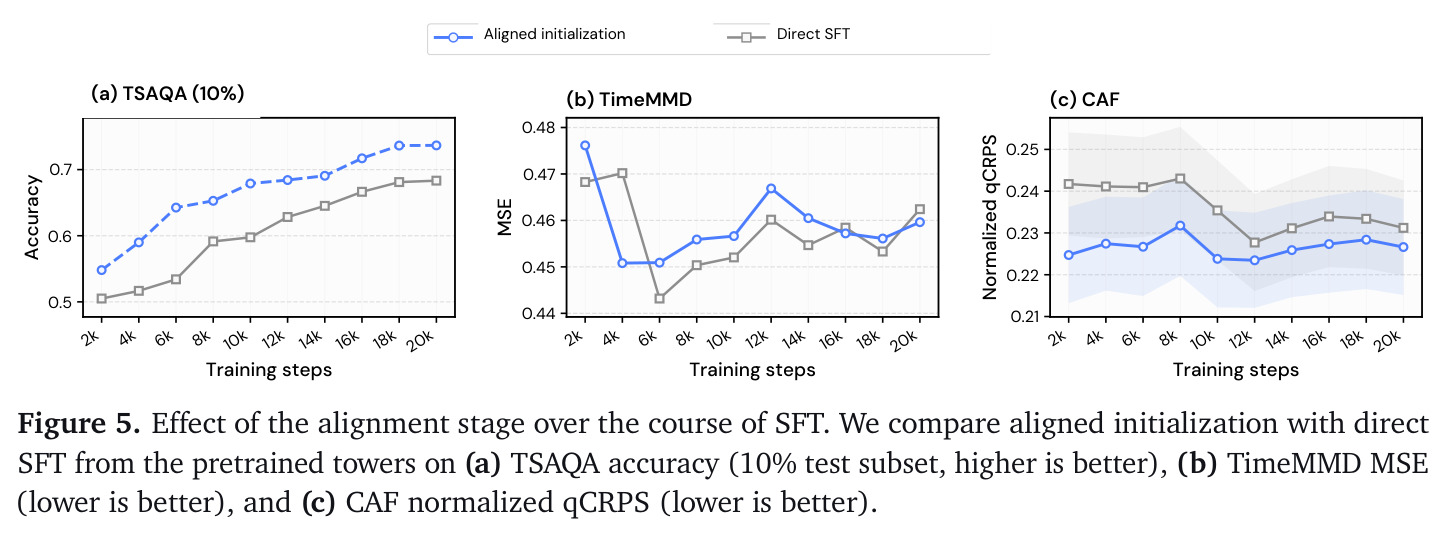
理解侧:TSAQA 总体准确率 TimeBraid-6.7B 达 80.65%(1.2B/2.5B 为 76.61%/78.31%),远超 GPT-5.4 的 63.10%,接近基准专用微调的 LLaMA3.1-8B(85.26%);同类统一模型 ChatTime-7B 仅 38.38%、TimeOmni-VL 39.27%。TSExam 得 63.14%,TB-MCQ 36.58% 与 GPT-5.4 的 38.50% 相差不到 2 分。CaTS-Bench 描述:DeBERTa-F1 0.712 居第二(仅次于基准内微调的 Idefics2 0.713),SimCSE 0.886 全场最佳;数值保真 0.684 是短板(GPT-5.4 0.778),归因于 32 个原始值压缩成一个 patch embedding。预测侧:TimeMMD 九域中八域进前三、平均 MSE 排名最佳,Health 0.925、Security 108.6、Socio 0.799、Energy 0.231 均为最佳;CGTSF 的 MSPG/LEU/PTF MSE 0.459/0.641/0.138 全面第一。自建 Ctrl-F 上 Top-1 43.33%(随机 33.33%),是唯一遵循文本条件的非 LLM 模型,但落后 GPT-4o 的 60.00%;CAF pooled CRPS 0.225 最低(GPT-5.4 0.233)。GIFT-Eval MASE 0.763 胜过统计与监督基线(PatchTST 0.849),不及 TiRex 0.676、TimesFM2.5 0.705;ETT+Weather 长程零样本预测中 2.5B 版 MSE 平均排名 2.48 第二(Sundial 2.23 最佳)。消融确认:残差注意力远优于 MLP projector、双塔等于三塔、鲁棒归一化+损失帽消除量级尖峰、3:7 数据比为帕累托点、对齐阶段在理解与 CAF 上持续有益。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TSAQA 时序理解问答 | 总体准确率 (%) | 80.65(TimeBraid-6.7B) | GPT-5.4 63.10;基准专用微调 LLaMA3.1-8B 85.26 | 超 GPT-5.4 17.55 个百分点;与专用微调模型差距仅 4.6 个百分点 |
| TB-MCQ(TemporalBench 16 任务) | 宏平均准确率 (%) | 36.58 | GPT-5.4 38.50 | -1.92,与最强闭源模型基本持平 |
| CaTS-Bench 情境描述 | SimCSE / DeBERTa-F1 | 0.886 / 0.712 | GPT-5.4 0.843 / 0.660 | SimCSE 全场最佳(+0.043);DeBERTa-F1 第二,仅次于基准内微调 Idefics2 的 0.713 |
| TimeMMD 上下文预测 | 各域 MSE(越低越好) | 8/9 域进前三,平均排名最佳;Health 0.925、Security 108.6、Socio 0.799、Energy 0.231 均为最佳 | TimesFM2.5、Chronos-2 等时序基础模型与 Aurora、Time-LLM 等多模态模型 | 如 Health 0.925 vs Chronos-2 1.217(-24%);Security 108.6 vs Chronos-2 110.3 |
| CGTSF 股价上下文预测 | MSE(MSPG/LEU/PTF) | 0.459 / 0.641 / 0.138 | TimesFM2.5 0.585 / 0.777 / 0.243 | 三只股票全面第一,Macro MSE 与 Macro MAE 双冠军 |
| Ctrl-F 可控预测(自建基准) | Top-1 正确检索准确率 (%) | 43.33 | 全部时序基础模型与多模态模型 33.33(随机水平);GPT-4o 60.00 | +10 个百分点于随机,唯一遵循文本条件的非 LLM 模型 |
| CAF 情境辅助预测 | pooled CRPS | 0.225 | GPT-5.4 0.233;时序基础模型 0.275–0.414 | 全场最低 |
| GIFT-Eval 零样本预测 | MASE | 0.763 | PatchTST 0.849、ARIMA 1.074;最强专用模型 TiRex 0.676、TimesFM2.5 0.705 | 胜过全部统计与任务专用监督基线,落后最强专用基础模型 |
| ETT+Weather 长程预测 | 20 个设置的平均 MSE 排名 | 2.48(TimeBraid-2.5B,零样本) | Sundial 2.23(最佳);监督 iTransformer 8.10、PatchTST 7.72 | 零样本第二;MAE 排名 3.45 第三 |
局限与改进
作者承认的局限:一,没有持续预训练阶段——公开的交错时序-文本语料尚不成熟,配方直接从对齐跳到 SFT,世界知识广度受限;二,感知数值精度有限——patch 分词把大量原始值压进单个 embedding,保留形状与动态但丢失局部细节,模型会幻觉特定点的数值、误读长序列/高频/低信噪比波形,CaTS-Bench 数值保真 0.684 落后通用模型;三,当文本与历史矛盾时预测控制力下降——预测专家继承了底座的转移动力学,偏向历史一致的续写,对要求突然水平跳变或机制断点的指令遵循松散;四,缺乏大规模高质量的真实文本条件预测数据与多模态多变量数据;五,面对高度复杂噪声文本无法完全转化为有效预测信号,需要与 agent 结合。我的补充观察:推理期 $\lambda$ 调制需两次前向、成本翻倍,且逐域最优 $\lambda$ 差异巨大(Security 最优为 0)而最终只用单一 0.3;可控预测与 LLM 仍有约 17 个百分点差距(43.33% vs GPT-4o 60.00%),推理深度是硬伤;4096 的上下文长度也限制了长序列多段复杂组合的输入。
独立分析的弱点
第一,patch 化信息瓶颈是理解上限的根本约束:32 个值压成一个向量,数值保真天花板被架构锁死。改进方向是变长/分层 patch、对关键点值加数值残差旁路,或增设轻量的逐点重建辅助头。第二,文本-历史冲突处理弱:预测数据占 SFT 采样 54.49%,模型实际学到「信任历史」的先验。改进方向是构造故意的文本-历史矛盾样本并训练可信度裁决,或推理时依据文本与历史的一致性分数自动调节 $\lambda$。第三,$\lambda$ 全局统一为 0.3,但逐域最优差异极大(Security 最优 0、Economy 偏好大 $\lambda$),应学习输入条件化的 $\lambda$ 预测器,或用多预测一致性自动选择。第四,缺少持续预训练意味着世界知识主要靠 4.88M 指令样本注入,覆盖面窄,可构建新闻-市场、报告-电网等大规模交错预训练语料补足。第五,双塔共享底座虽被证明无损失,但底座组合空间(不同 TSFM、不同 LLM、规模匹配)完全未探索。第六,评估以 MSE 类点指标为主,概率预测的校准与分布质量除 CAF 外少有检验,对风险敏感场景(金融、医疗)证据不足。
未来方向
作者明确提出:加入大规模持续预训练以灌输更广的世界知识;用更均衡的数据配方缩小与专用时序基础模型的单模态预测差距;与 agent 结合,让前沿 LLM 先做推理与指令转换再交给预测系统,以应对复杂噪声文本;继续探索模型组合(tri-tower、不同时序/语言底座的搭配)。基于其成果还可延伸:把时序作为与语音、图像、视频并列的第四模态纳入全模态统一模型,检验共享注意力配方能否扩展到更多模态;发展反事实预测与决策闭环——Figure 1 展示的「若促销/若关店」场景若与世界模型或强化学习结合,可走向真正的决策支持;针对 Ctrl-F 上 LLM 仍领先约 17 个百分点的推理差距,引入思维链或工具调用增强时序推理;训练数据已用结构因果模型合成多变量交互,可扩展到真实因果发现与信号关系推断任务;以及面向流式数据的在线预测与持续更新机制。
复现评估
复现友好度中上。论文标题页标注提供 Code、Model、Data(Alignment 与 SFT)链接,发布 1.2B/2.5B/6.7B 三个尺寸,小尺寸版本显著降低门槛。数据绝大多数基于公开数据集与程序化合成:ChatTS 式可编程描述、结构因果模型、可编程算子合成可控未来,构造规则在 Appendix A 有详细描述,可复刻性较好;自建评测 Ctrl-F 基于 GIFT-Eval 测试集历史构造,规则明确。算力是主要障碍:全参数训练(语言塔+时序塔+残差注意力层),对齐阶段上下文 2560 训 1 epoch、SFT 上下文 4096 训 30k 步、全局 batch 128、BF16,SFT 混合含 2.31M 的 CAF-7M 样本、总量约 4.88M,估计需要数十张高端 GPU 运行数天至数周,学术实验室单卡难以全量复现。细节风险点:损失帽阈值 $c$ 等稳定化超参收在 Appendix C,鲁棒归一化与损失帽对训练能否收敛至关重要,遗漏任何一项都可能复现失败。建议路径:先用小底座+缩减数据验证损失曲线形态(对照 Figure 4),再放量训练。
论文图表
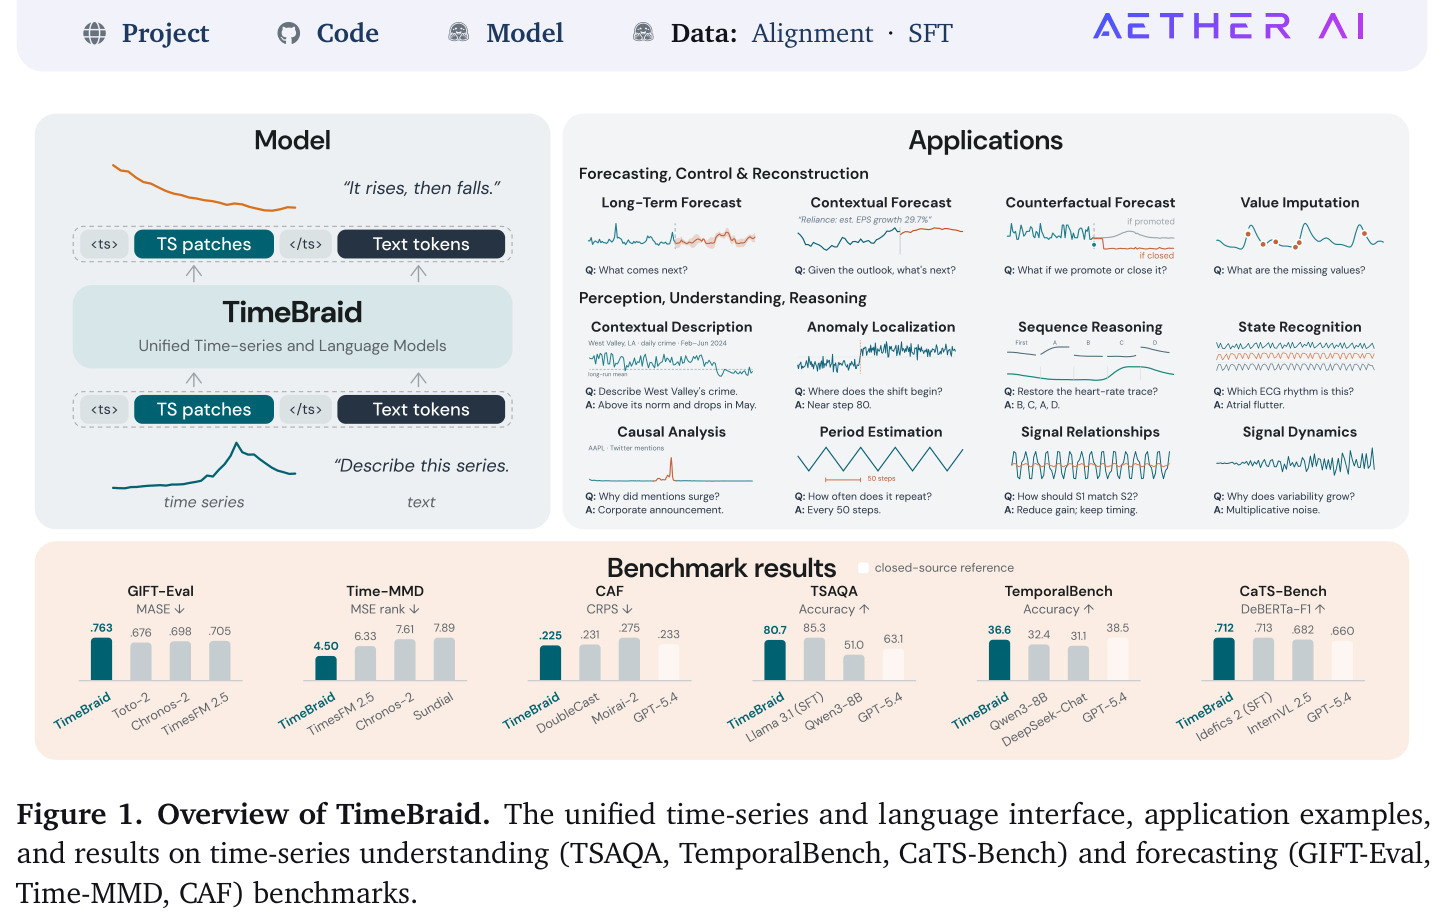
一页式总览:左侧展示统一接口(<ts> 包裹的时序 patch 与文本 token 一起进入 TimeBraid);中间按应用分类举例——感知与情境理解(描述 West Valley 犯罪率、ECG 节律识别)、推理(异常定位、周期估计、信号关系与动态)、上下文/反事实预测(依据新闻预测、若促销/若关店会怎样)、价值填补与重建;右侧是六个基准上的柱状对比(GIFT-Eval MASE、Time-MMD MSE 排名、CAF CRPS、TSAQA、TemporalBench、CaTS-Bench DeBERTa-F1),显示 TimeBraid 与 GPT-5.4、专用基础模型同场竞技。
这是论文的门面图,一眼看清「一个模型吃下任意时序+文本组合、吐出理解或预测」的产品形态与整体战绩,适合作为读正文前的地图。