无需校准数据的MoE解码通道选择 Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
MoE通道选择无需校准数据:top-k优于校准阈值,权重读取器17.8%读取保留98.1%精度
前置知识
Mixture-of-Experts (MoE)
混合专家模型在Transformer的FFN层放置多个独立前馈网络(专家),由路由器为每个token只激活少数专家(如Qwen3-Thinking:128个专家选8个),以远小于稠密模型的单token计算量承载更大参数容量。推理时未激活专家权重无需读取,但被激活专家的权重仍要整块读入显存到片上。
本文的全部讨论对象是被激活专家内部的通道级稀疏化,理解MoE的路由与专家结构是一切的前提。
门控MLP与通道
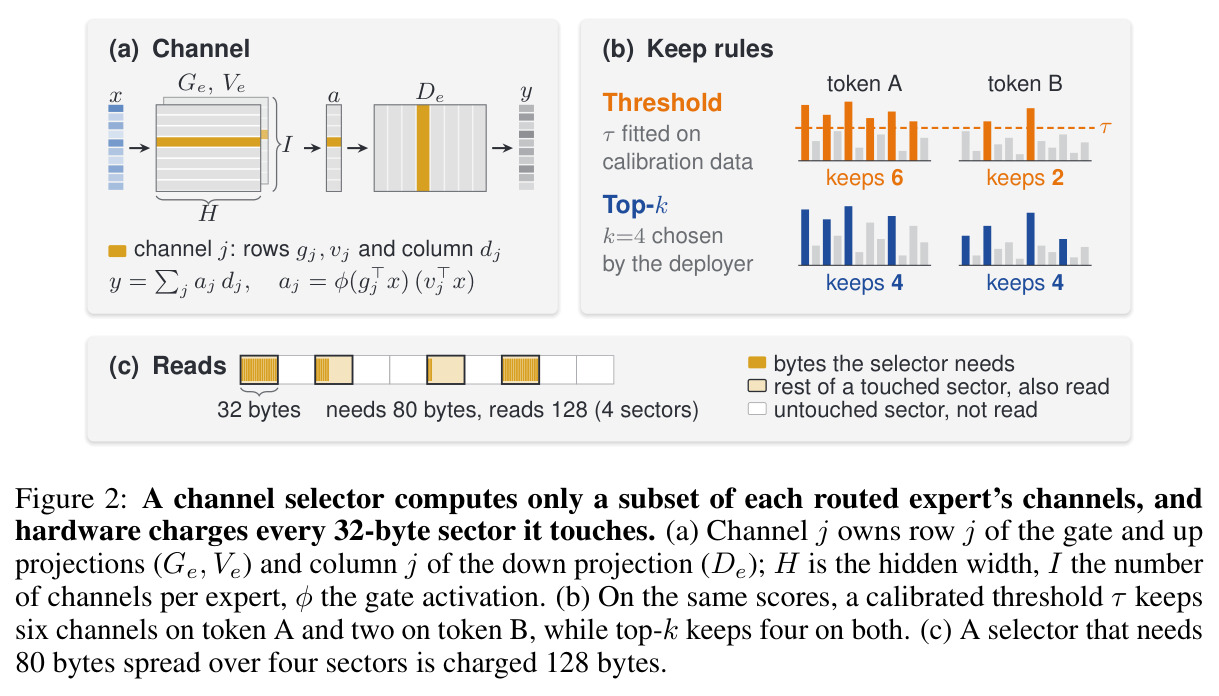
专家是一个门控MLP:中间第$j$个通道拥有门控/上行投影$G_e,V_e$的第$j$行和下行投影$D_e$的第$j$列,其输出为$a_j d_j$,其中激活$a_j=\phi(g_j^\top x)(v_j^\top x)$,总输出$y=\sum_j a_j d_j$。通道选择即预测哪些通道对当前token的输出贡献大,只读这些通道的权重行/列。
论文的打分公式(1)、恢复公式(2)和按32字节扇区的读取计费都以通道为单位,不懂这个分解就读不懂方法。
keep rule:校准阈值 vs top-k
打分器给每个通道打分后需要一条保留规则:校准阈值在离线校准数据上拟合每层固定截断$\tau$,使通过通道数的平均值等于目标读取预算;top-k则直接保留每个token分数最高的$k$个通道,本身无需任何校准数据。两者的取舍(固定预算 vs 按需分配)是本文的核心争点。
论文第一部分贡献就是证明校准阈值既固定不了读取量、也不带来一致的精度收益,从而推翻其存在理由。
显存带宽受限的解码
交互式解码(batch约为1)每步计算量极小,延迟主要由把被激活专家权重从GPU显存(DRAM)搬到片上SRAM的时间决定。GPU按32字节扇区读取,哪怕只需80字节也要为触及的4个扇区支付128字节,因此压缩读取字节几乎等价于压缩时延,这也是论文用reads(占总模型专家读取的百分比)作统一成本度量的原因。
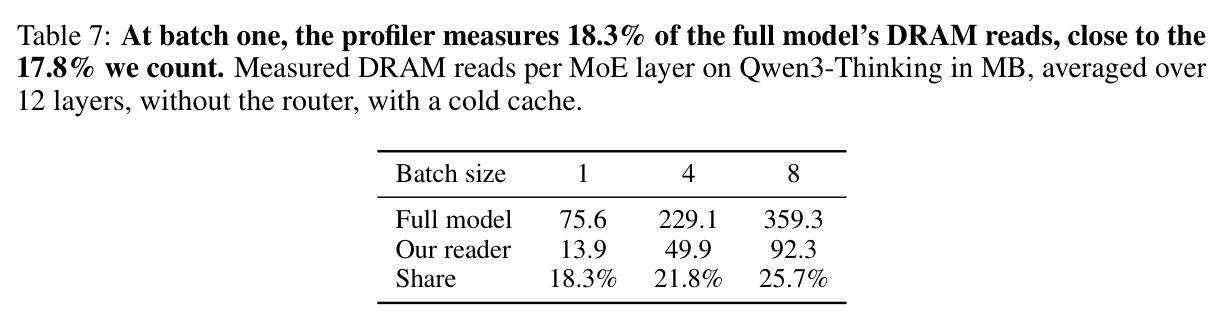
所有精度/速度结论都挂在sector计费的reads上,作者还用GPU profiler核实了这个度量。
Hadamard旋转与三元Sketch
权重和激活中的离群值会让低比特编码严重失真。用随机化Hadamard矩阵$R$按128坐标分块旋转权重可把大数值摊匀;由于$R$正交,$g_j^\top x=(Rg_j)^\top(Rx)$结果不变。旋转后每块以$\{-1,0,1\}$三元码加FP16缩放因子存储,单块从256字节压到约30字节,整个sketch约占BF16检查点的7%。
读取器读前打分全部依赖这个sketch,是实现零校准、低成本筛选的关键组件。
低秩恢复
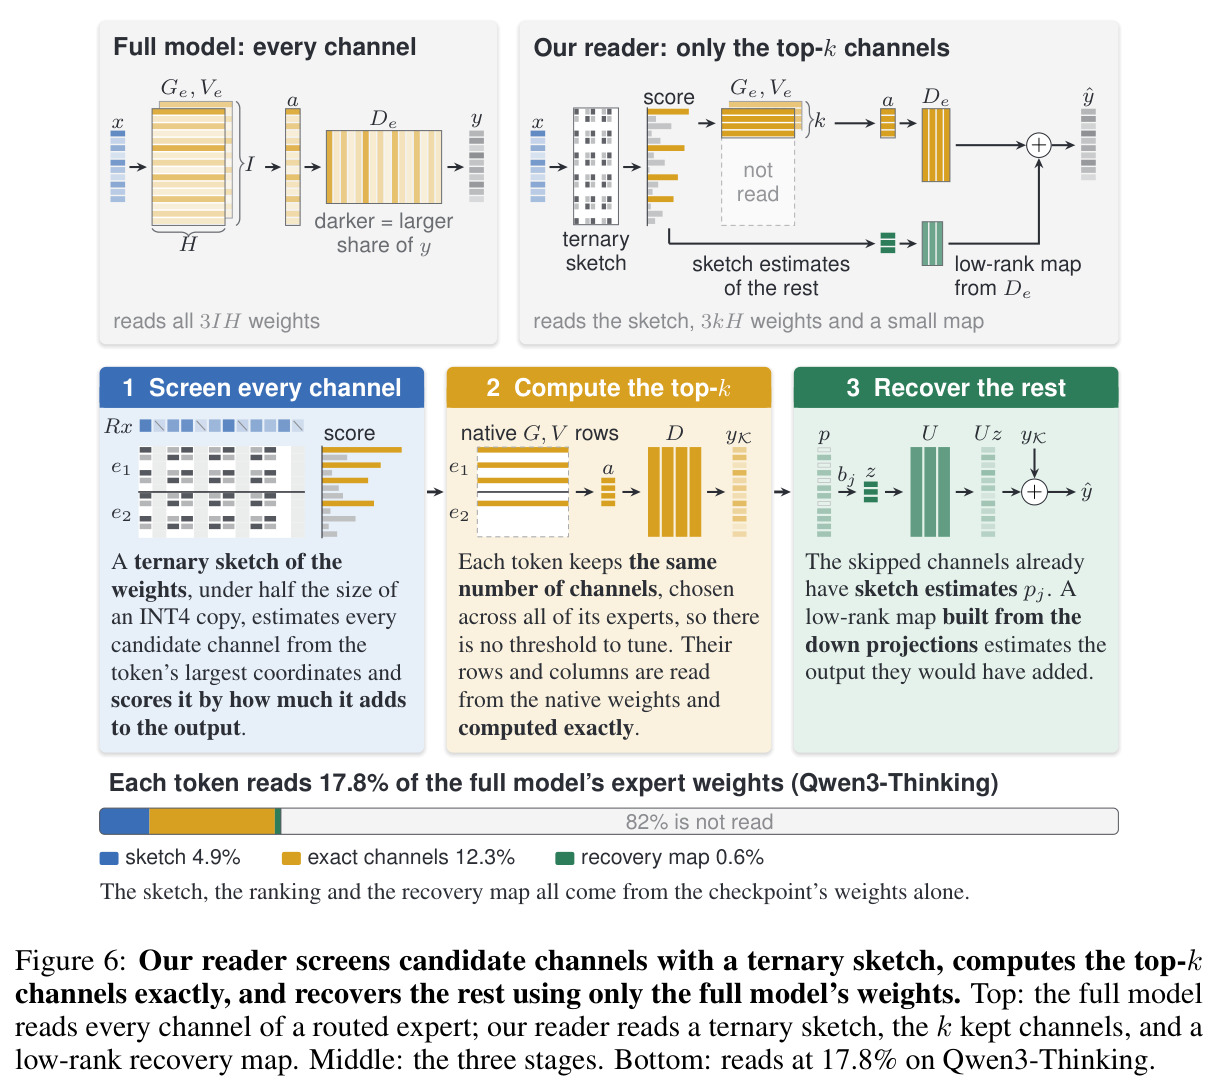
被跳过的通道单个贡献小,但每层数千个相加不可忽略。把一层所有专家的下行投影列堆叠做SVD,取前32个左奇异向量$U$并预存每列系数$b_j=U^\top d_j$,就能用$Ub_j\approx d_j$把跳过通道的sketch激活估计折算成输出补偿,无需读取完整的下行列。
这是读取器第三步,也是最体现仅用权重构建的部分,与R-Sparse、GRAIL等需要校准数据拟合恢复的方案形成直接对照。
研究动机
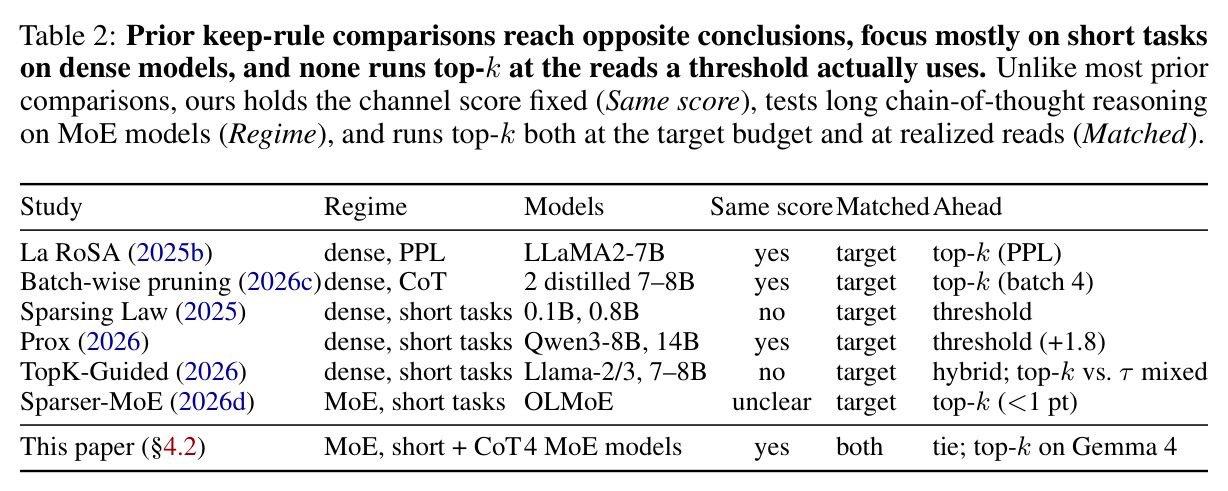
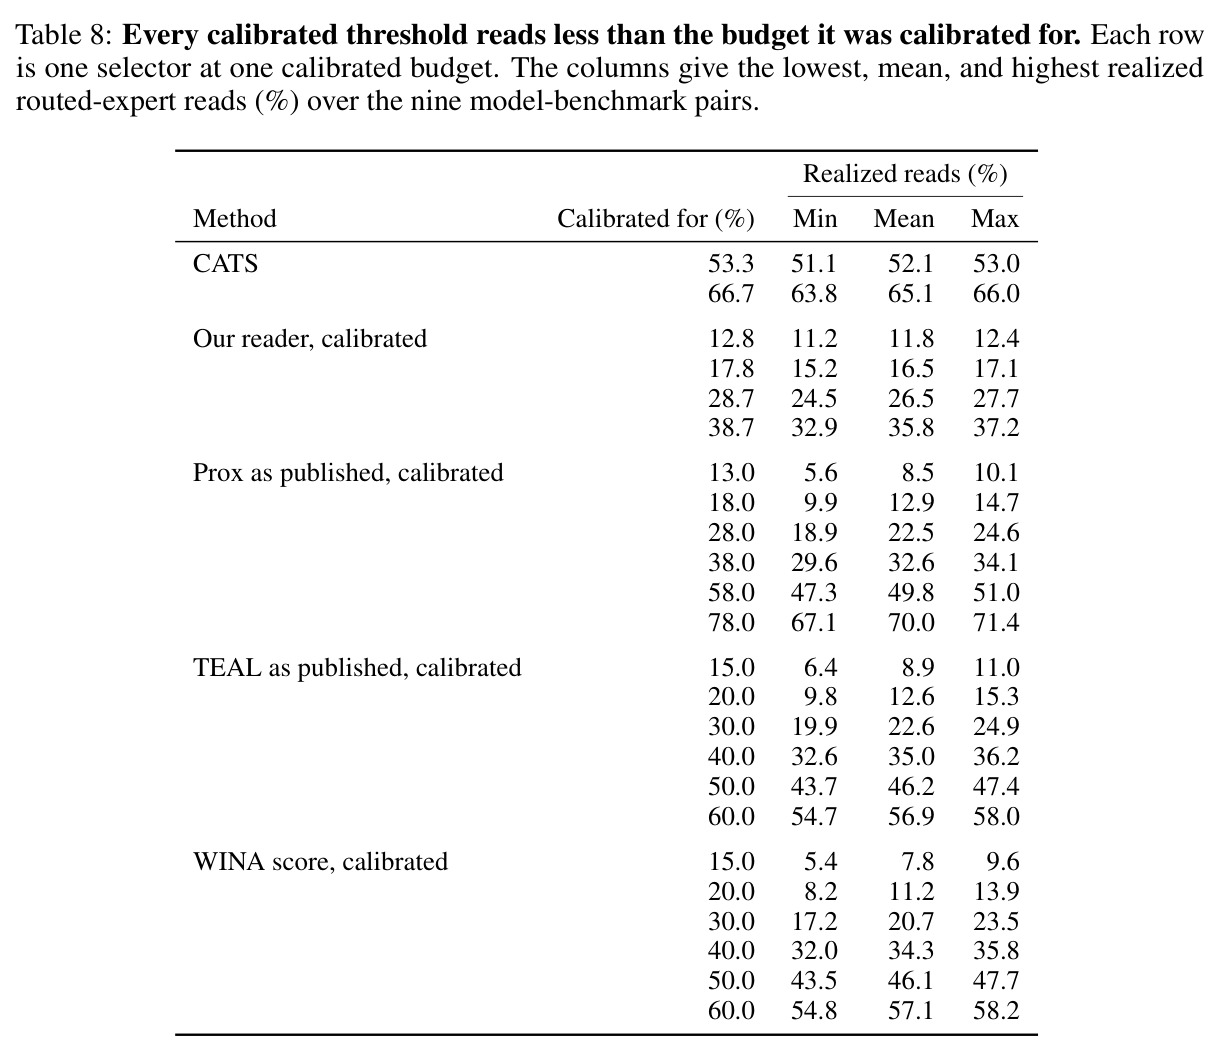
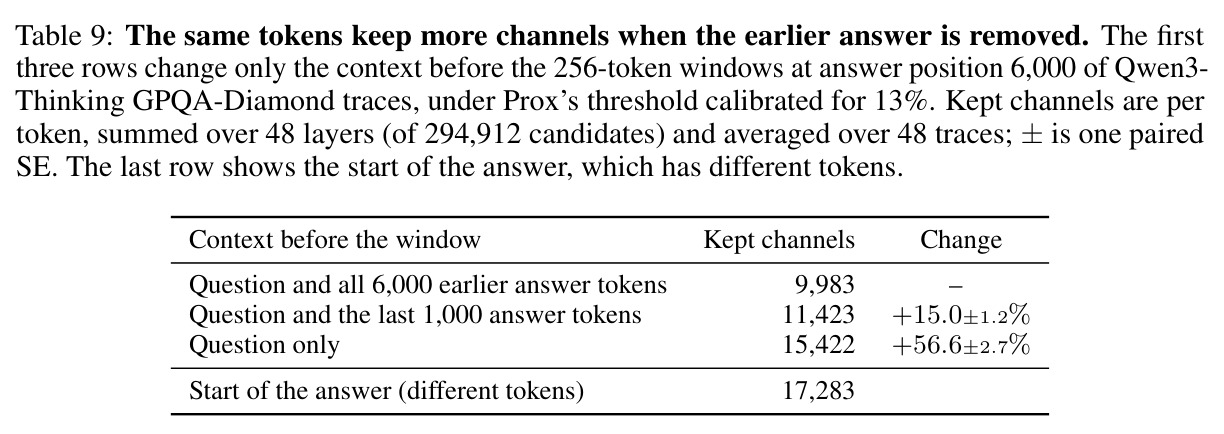
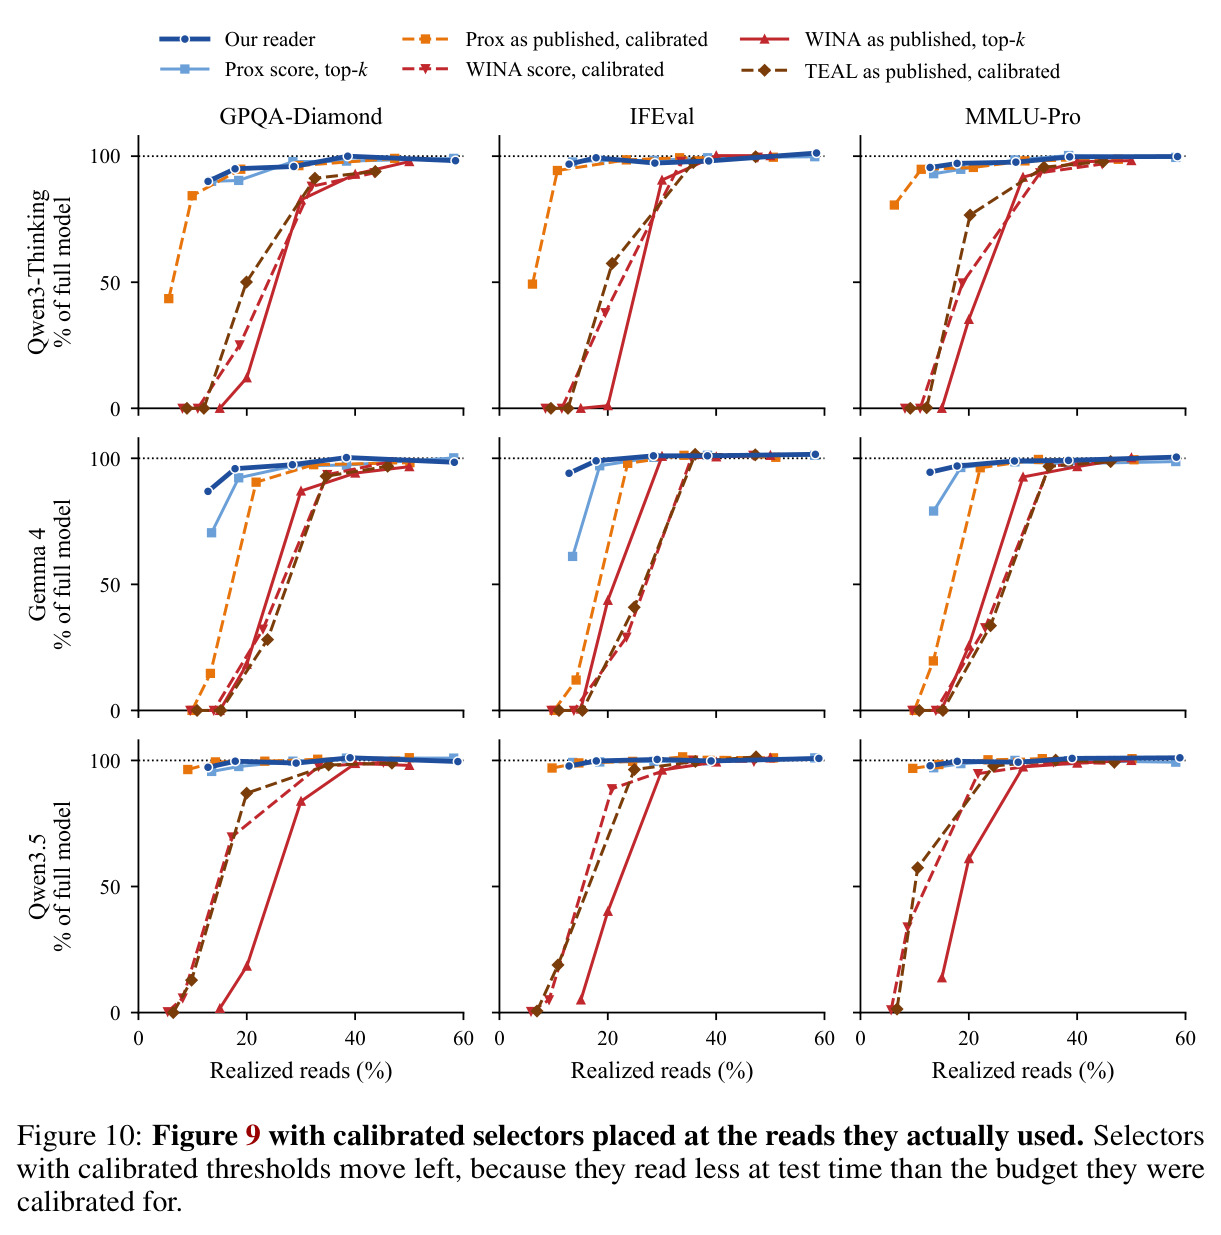
MoE模型在交互式解码(batch为1或几)时,延迟瓶颈是从GPU显存读取被路由专家的权重;而每个被激活专家的门控MLP里大部分中间通道对单个token贡献很小,可以跳过。于是出现了各种通道选择器,其中多数用离线校准数据拟合每层固定阈值,使校准数据上的平均读取量等于目标预算(Prox、TEAL、WINA校准版等)。本文指出这种做法有两个根本问题。其一,校准阈值固定不了读取量:通过固定截断$\tau$的通道数随输入变化,作者的全部72组基准运行中校准选择器的实际读取全部低于预算——Prox按18%预算校准后实际平均只读12.9%、最低9.9%;kept通道数与token的需求几乎无关(与需求Spearman相关仅-0.13至-0.19),却与已生成答案的长度强相关(与位置相关-0.57),Qwen3-Thinking答案写到6000 token时kept数降到校准值的71%。其二,校准也不带来一致的精度收益:重稀疏下Gemma 4在校准阈值上触发重复循环,Prox按18%预算校准后实际读取13.3%时GPQA-Diamond仅得11.7分,而读取几乎相同(13.5%)的top-k版得56.3分,792个答案中674个撞上32768-token长度上限。此外,此前六项阈值vs top-k的研究结论互相矛盾,且大多在稠密模型与短任务上进行,缺乏可信结论。
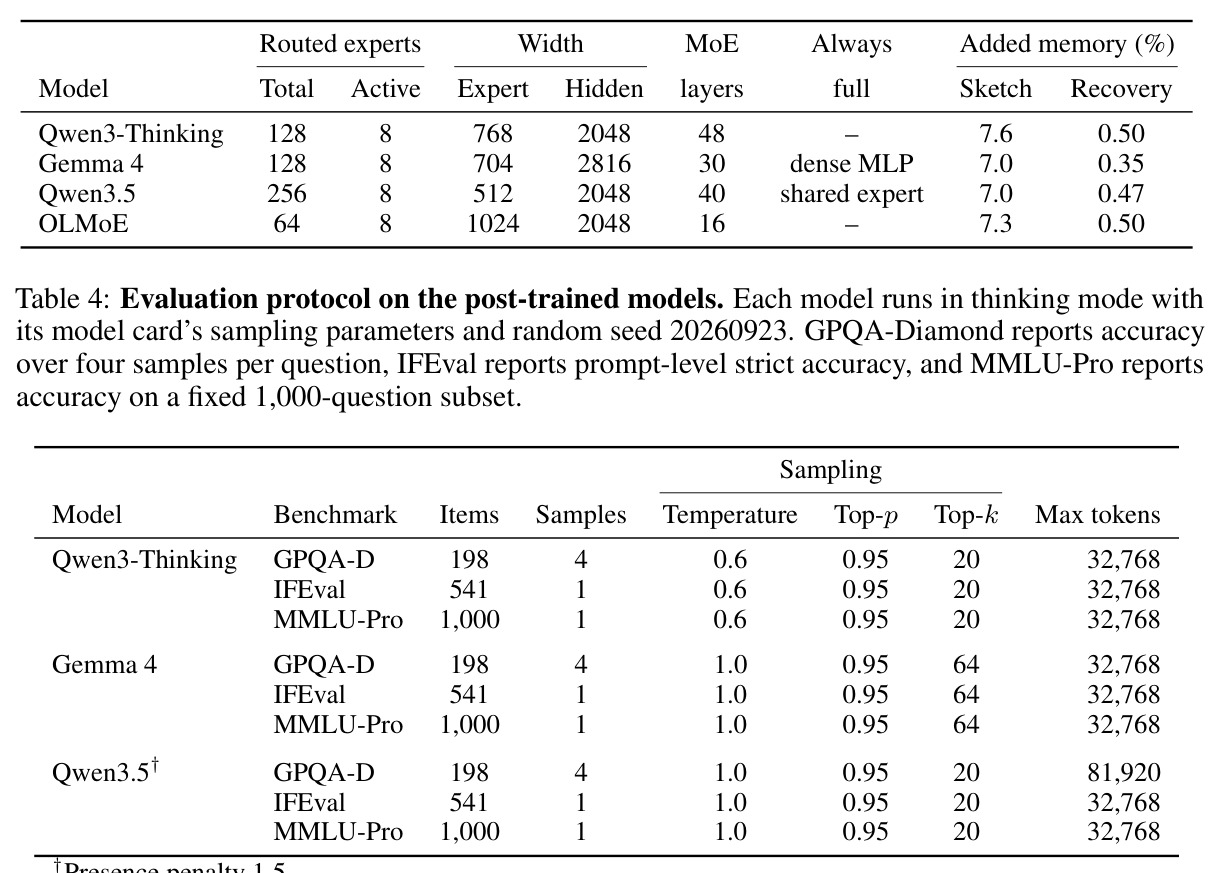
本文的目标是本文的目标分两层。实证层面:严格检验为MoE解码通道选择器校准一个阈值是否必要。校准被期望提供两样东西——可预知的读取预算、以及在该预算下通过按需分配通道带来的精度增益;作者要逐一证明这两样都没兑现,得出通道选择无需校准数据的结论。做法是把同一打分器的阈值版与top-k版在同一分数、同一预算下配对比较(13%和18%预算下43组),并用32字节sector精确计费、GPU profiler验证实际读取,另在阈值版的实际读取量上重跑top-k版做matched稳健性检查。系统层面:既然keep rule用top-k即可,选择器的质量就取决于读前打分的准确度和对被跳过通道的处理;作者要构建一个完全不依赖校准数据、只用模型自身权重的读取器(reader)——三元sketch粗筛全部候选通道、精确计算跨专家的top-k、低秩映射恢复被跳过通道——在12.8%到17.8%的极低读取率下保持精度,并用自研Triton内核在vLLM中实现真实加速。
与已有工作不同的是,本文的独特切入角度有三。第一,比较方法学上的纠正:此前六项阈值vs top-k的研究中五项测稠密模型、多为短任务,两项在换keep rule的同时换了打分函数,且没有一项把top-k放到阈值实际读取量上做matched比较;本文固定打分函数、在MoE模型的长链式推理上、同时在名义校准预算和实际读取两个口径下配对比较,首次给出干净答案。第二,对校准为何失效给出机理解释而非现象罗列:kept通道数跟随的是已生成的答案(位置相关-0.57)而非token需求(-0.13),删除前文答案后同样的token多保留57%通道(+56.6±2.7%),而把每层计数固定为常数在等读取下反而使KL散度下降3.3±1.0%(Qwen3-Thinking),说明阈值的逐token波动基本无益。第三,系统构建上的极简主义:与R-Sparse、GRAIL、ReComp等在校准数据上拟合低秩补偿不同,本文的sketch、打分所需的下行范数$\|d_j\|$、恢复基$U$全部从检查点权重一次构造,没有任何拟合到目标模型或数据的参数,并用NVIDIA Nsight Compute核实读取计数(实测18.3% vs 计数17.8%),把成本度量本身也钉死在硬件事实上了。
核心方法
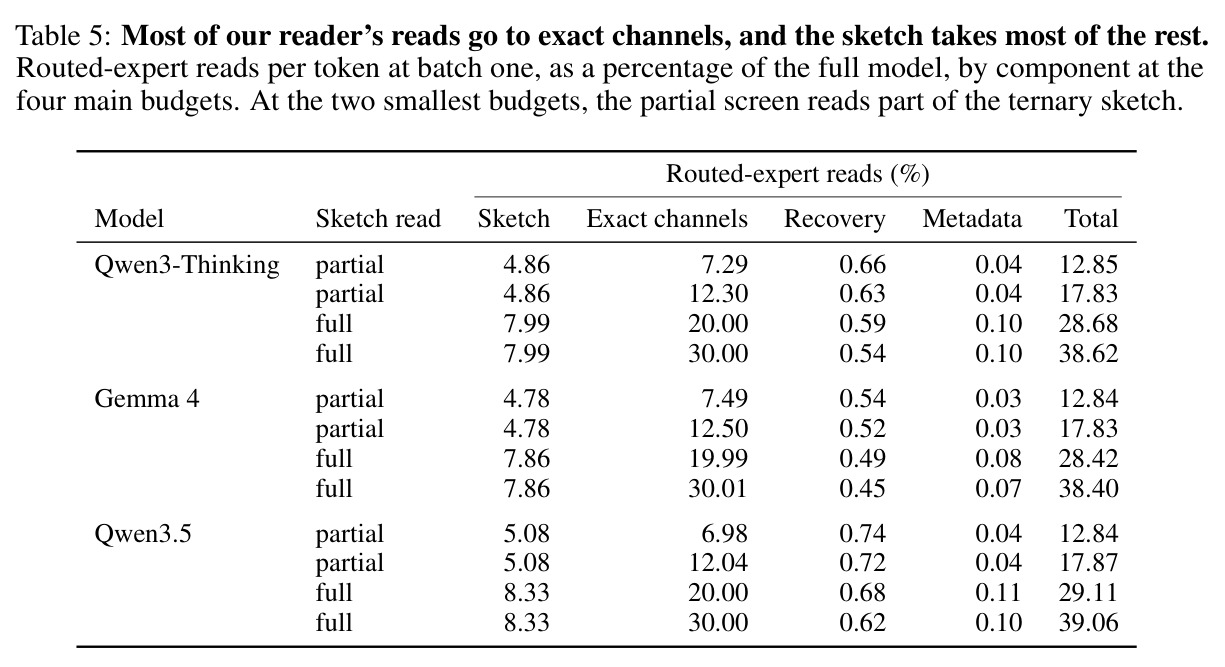
直觉上,通道选择器=打分函数+保留规则。本文先论证保留规则应选top-k:校准阈值既不固定读取量也不带来一致的精度收益,校准数据可以完全去掉;剩下的力气应花在读前把分数打准、以及处理被跳过的通道上。技术上读取器分三步(Figure 6)。第一步筛选:加载时把每个专家的门控行$g_j$、上行行$v_j$按128坐标分块做随机Hadamard旋转,存成三元码(约占BF16检查点7%);解码时把输入$x$旋转一次,用sketch估计每个候选通道的激活$\hat g_j\approx g_j^\top x$、$\hat v_j\approx v_j^\top x$。第二步精确top-k:用输出量纲分数$s_j=w_j\|d_j\|\,\phi(\hat g_j)|\hat v_j|$打分($w_j$为该通道所属专家的路由权重、$\|d_j\|$为预计算的下行列范数),在该token全部8个专家共6144个通道(Qwen3-Thinking)中精确取前$k$个并读取其原生权重。第三步恢复:把跳过通道在筛选阶段已算出的激活估计$p_j=\phi(\hat g_j)\hat v_j$乘以低秩映射$Ub_j$($U$为下行投影列的top-32左奇异向量,$b_j=U^\top d_j$)折算成输出补偿。最终17.8%的读取构成为:sketch 4.9%、精确通道12.3%、恢复映射0.6%,其余82%权重不读。
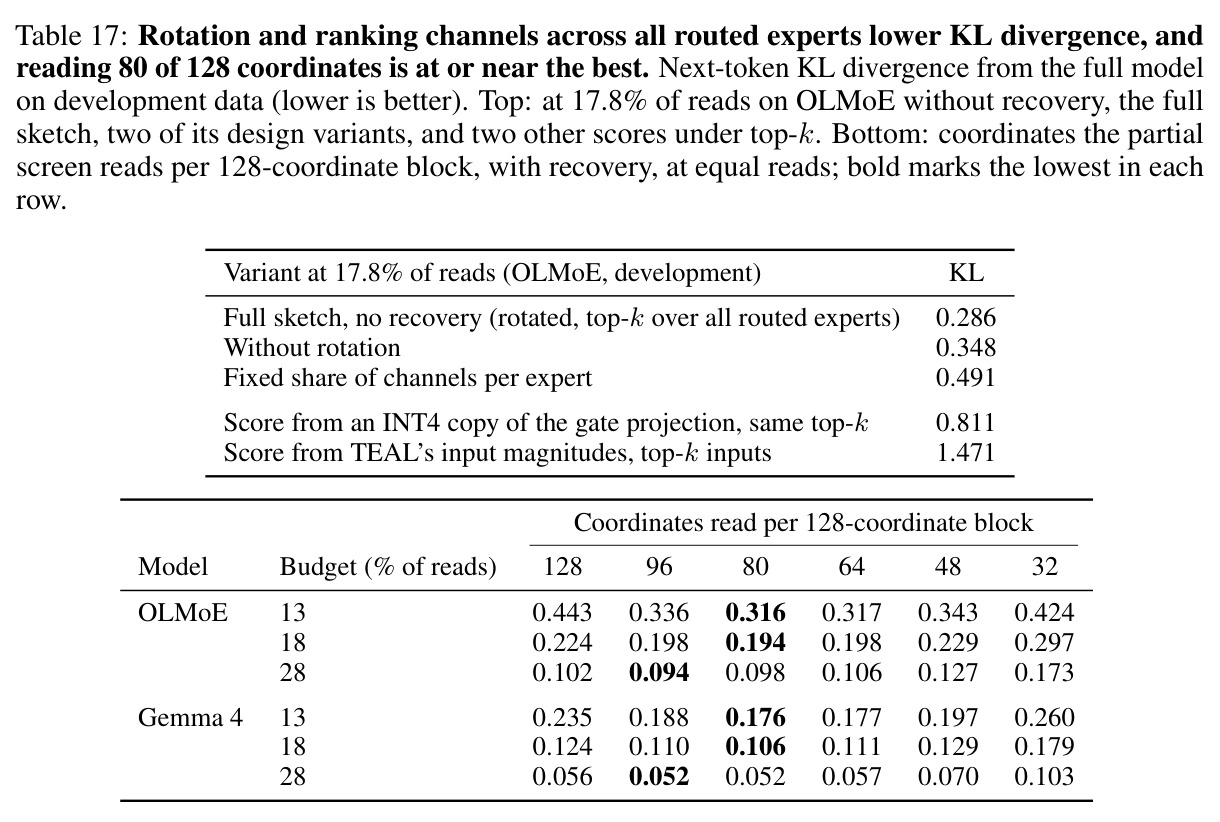
核心创新有两层。第一层是结论性的:校准在通道选择里没有存在价值。作者证明校准阈值做不到它被期望做的两件事——预算不可控(72组运行全部低于预算,用模型自己的推理文本重新校准也无济于事,Gemma 4上读取10.5%至15.2%仍全部塌方),以及精度不一致(同分数下top-k版在43组比较中40次持平或占优,23组生成任务比较中阈值版全胜)。这把设计空间从怎么校准直接简化为不用校准。第二层是构建性的:读取器完全由权重构建。与Prox用INT4副本打分等已有低比特筛选器不同,其分数$s_j=w_j\|d_j\|\,\phi(\hat g_j)|\hat v_j|$以路由加权下行范数缩放、处于输出量纲,使不同专家的通道可直接比较,从而支持跨全部专家的全局top-k——一个专家可拿走很多通道而另一个拿不到;跳过通道的恢复复用筛选阶段已有的估计$p_j$,只补一个预计算的秩32近似$U\sum_{j\in S}w_j b_j p_j$,与GRAIL、ReComp在校准数据上拟合补偿有本质区别。作者还用实验证明打分比keep rule更重要:把打分换成INT4门投影副本或TEAL输入幅度,KL散度恶化到本文sketch筛选的2.8倍和5.1倍。
方法步骤详情
完整流程如下。加载时一次性完成四件事:(1)把每层每个专家的$G_e,V_e$各按128坐标分块与随机Hadamard矩阵$R$相乘,每块存三元码+FP16 scale+块均方量化误差$\rho_b$,单块从256字节降到约30字节,sketch约占检查点7%;(2)预计算每个下行列范数$\|d_j\|$;(3)把一层所有专家的下行列堆叠做SVD取前32个左奇异向量$U$,并存系数$b_j=U^\top d_j$(约+0.5%内存);(4)转置全部下行投影$D_e$使列变行,保证保留通道的下行权重在内存中连续。解码时每个token每层执行:(1)把$x$旋转一次得$Rx$;在12.8%和17.8%两个最低预算下做部分筛选——每块只读$|Rx|$最大的80/128个坐标的三元码,换取20%到50%更多的精确通道;(2)对全部候选通道计算$s_j=w_j\|d_j\|\,\phi(\hat g_j)|\hat v_j|$并跨专家精确取top-k;从28.7%预算起读全sketch并利用$\rho_b$按跳过后的期望平方输出误差排序;(3)只对保留的$k$个通道读原生$G,V,D$行/列、精确计算$a_j$,输出第一部分$\sum_{j\in K}w_j d_j a_j$;(4)输出第二部分$U\sum_{j\in S}w_j b_j p_j$,其中$p_j$筛选阶段已算好,无需重读任何门控/上行权重。128坐标旋转块、80坐标部分筛选、秩32恢复这三个超参只在OLMoE开发集上选了一次,之后在所有模型上复用。
技术新颖性
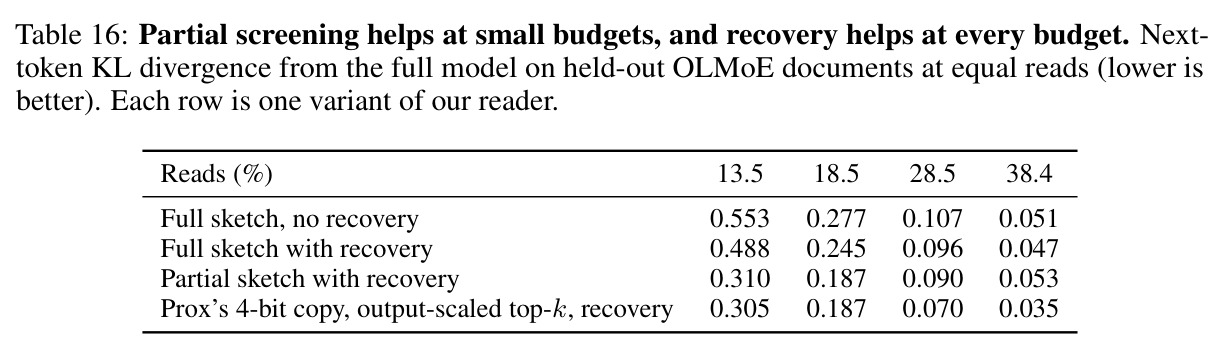
新颖性可从三个层面评估。测量学层面:本文最持久的贡献可能是方法学——对每个方法在其最优权重布局下按32字节sector计费、用Nsight Compute实测DRAM流量核账(batch 1时18.3% vs 计数17.8%)、按问题聚类的配对标准误、以及同分数双规则的配对实验设计,使一个长期含糊的争论首次有了干净答案;已有六项keep-rule研究无一做到这一点。结论层面:校准无用是对一系列已发表选择器(Prox、TEAL、WINA、CATS、R-Sparse、GRAIL)校准组件的系统性证伪,并揭示了一种新的失效模式——重稀疏下校准阈值触发Gemma 4的重复循环崩溃且表现为悬崖而非渐变(11.7分 vs 56.3分),与剪枝在稳定困惑度下放大循环、2-bit量化使推理循环的现象互相印证。算法层面:单个组件均非首创——Hadamard旋转来自QuaRot/QuIP#、三元码来自Ternary Weight Networks、低秩补偿与R-Sparse/GRAIL同族——但组合方式是新的:所有部件仅从权重构造、打分统一到输出量纲、跨专家全局top-k、恢复复用筛选估计,且消融证明每个部件物有所值(花0.6至0.7个百分点的读取在恢复上比花在更多精确通道上更能降低KL;部分筛选在13.5%读取下把KL从0.488降到0.310)。
实验结果
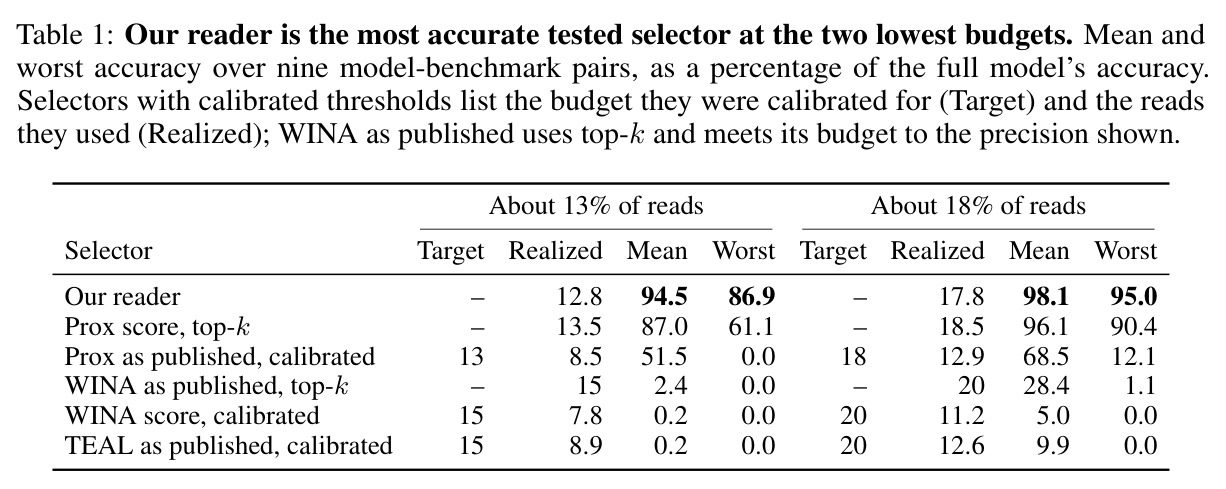
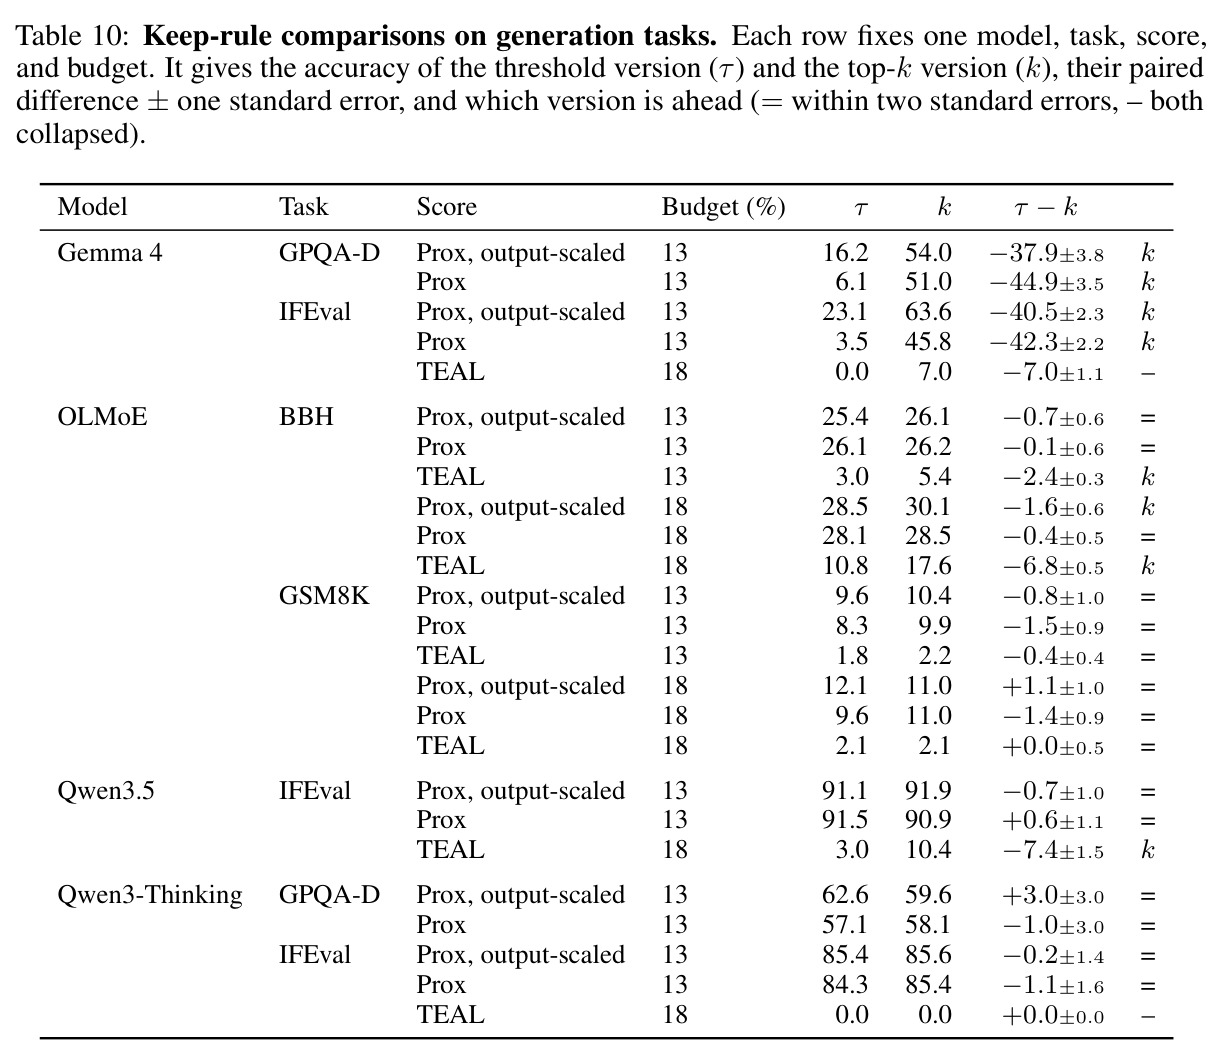
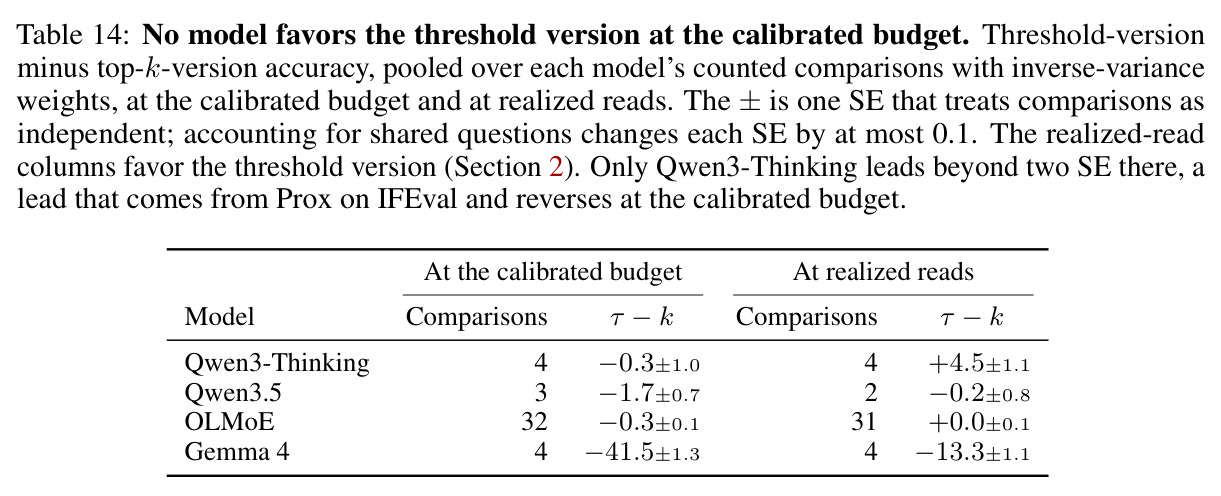
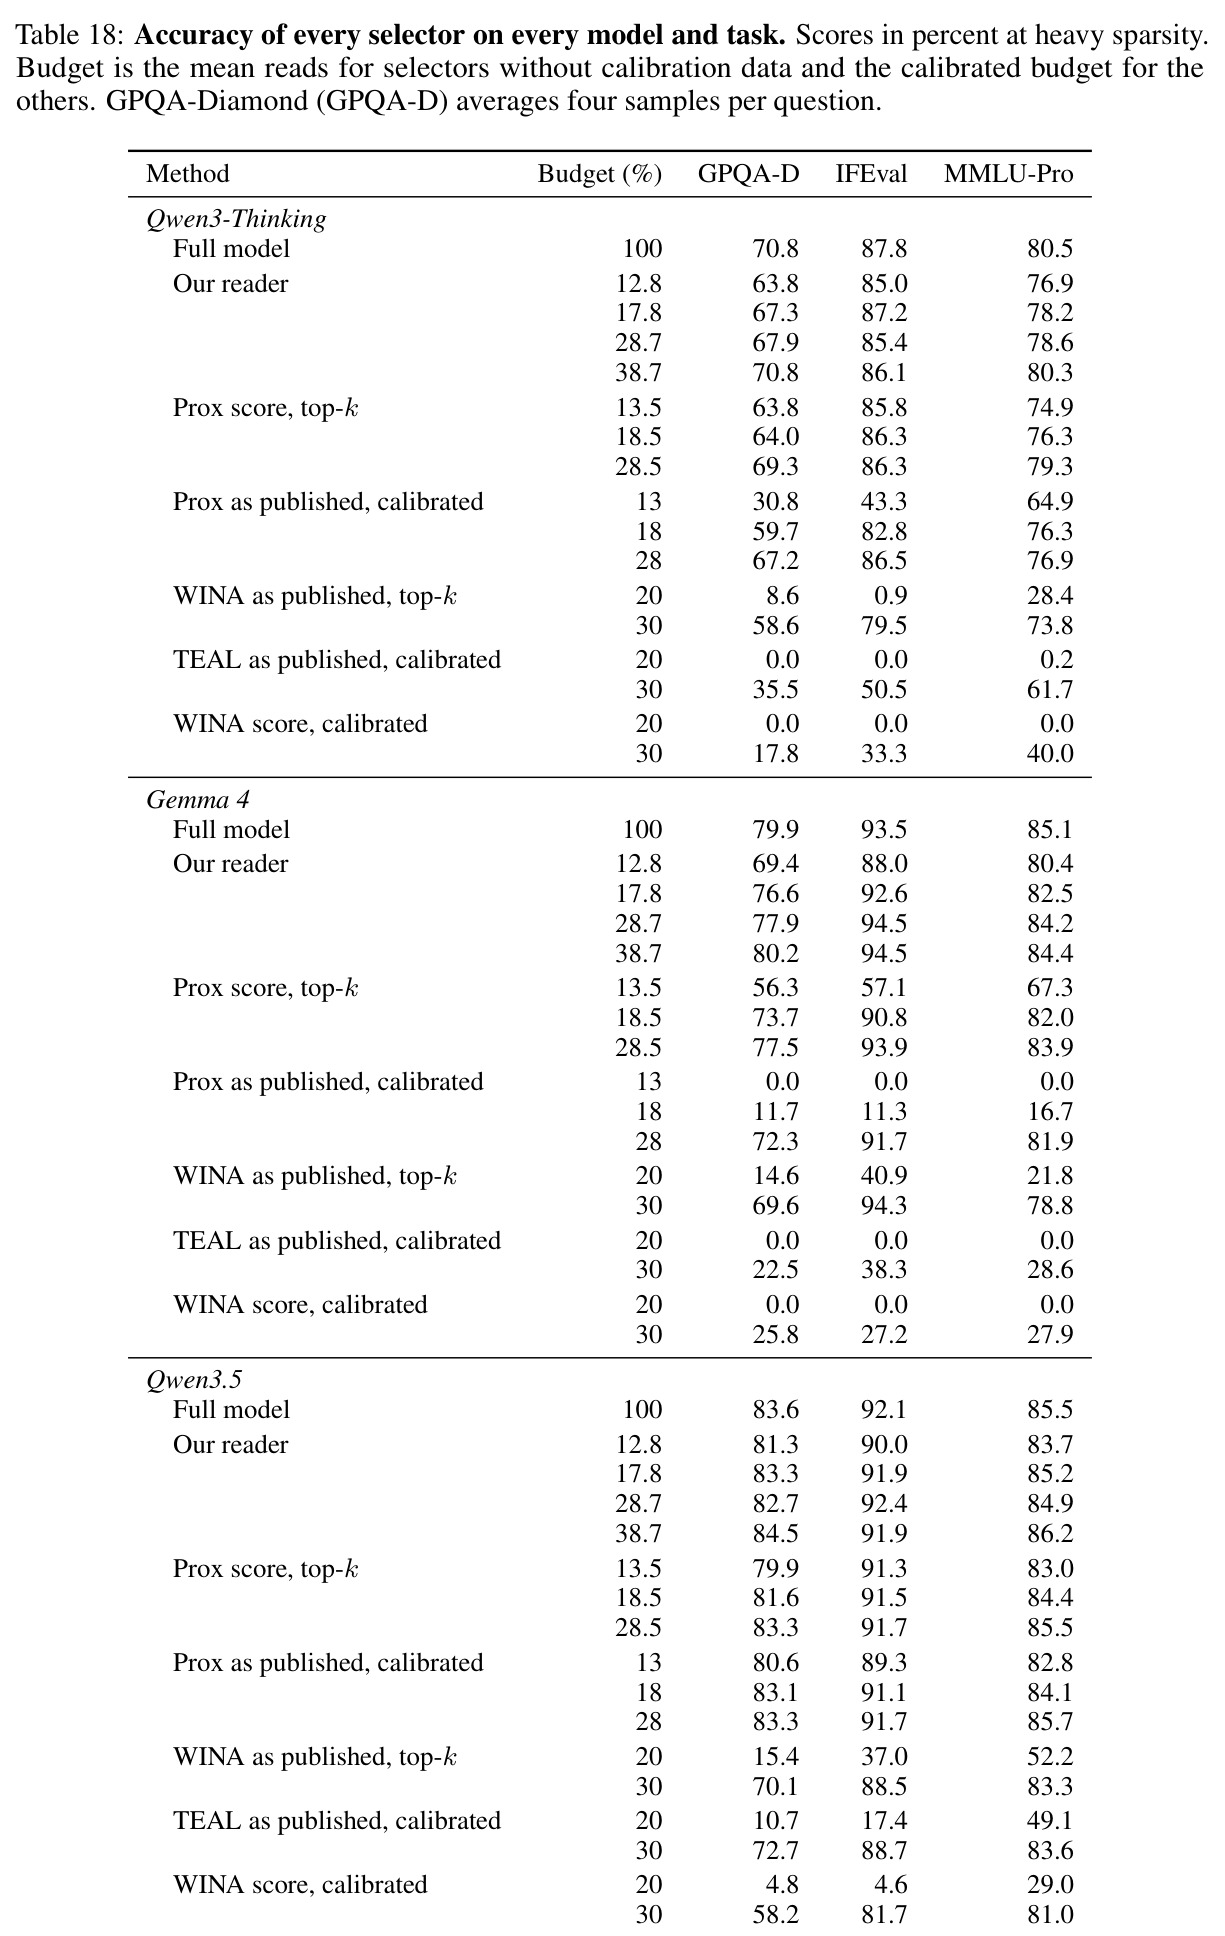
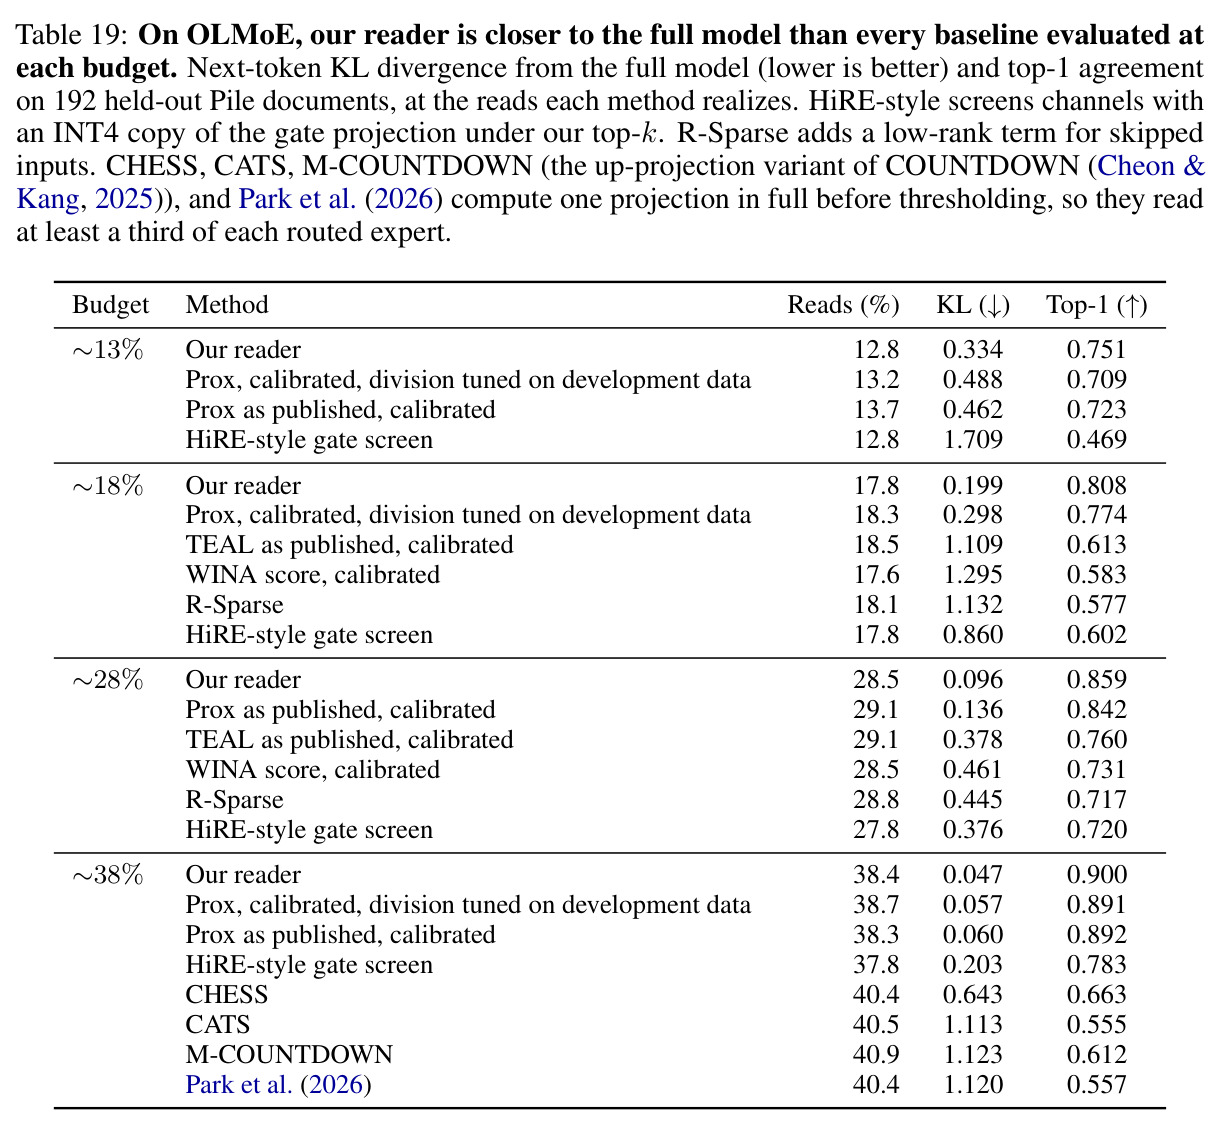
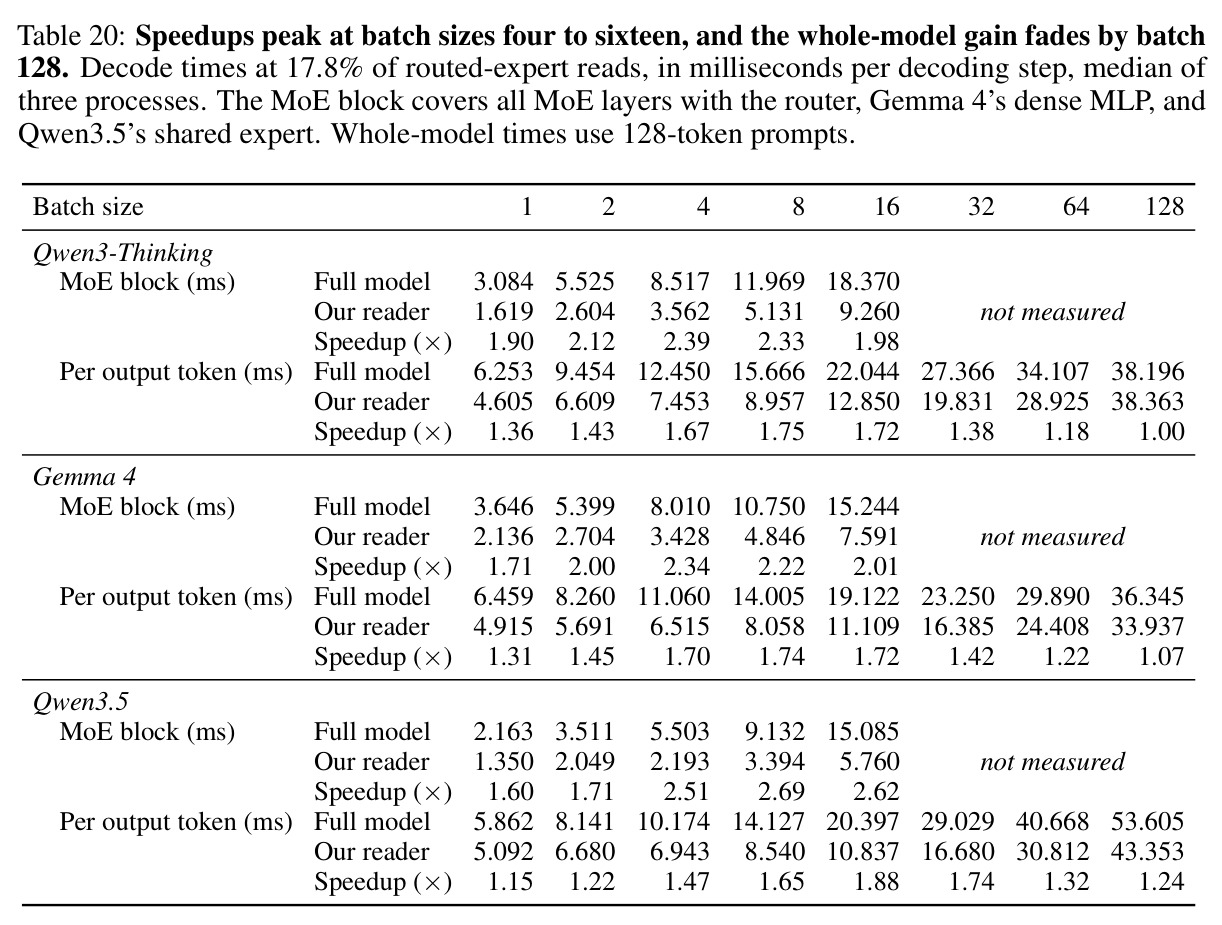
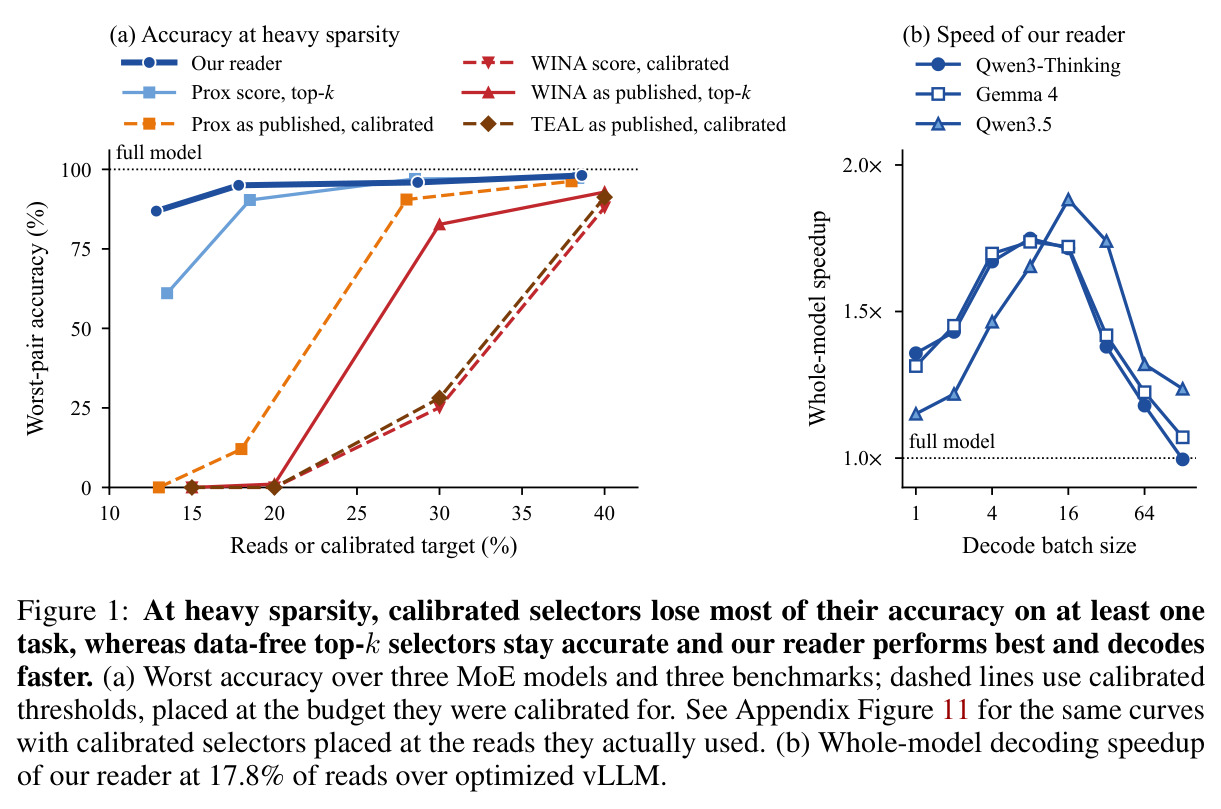
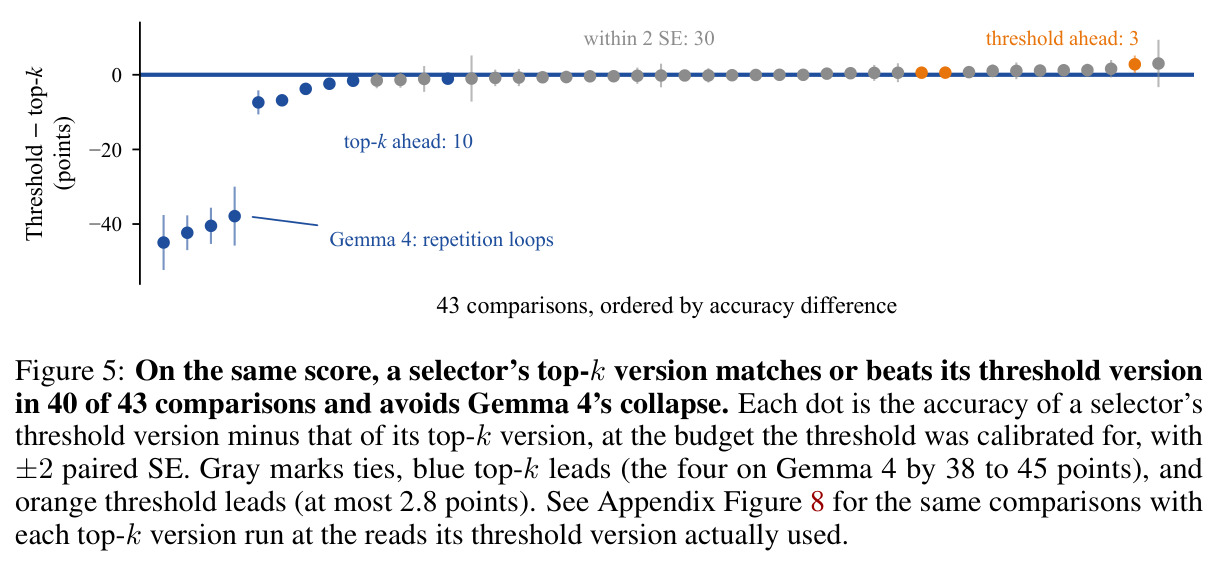
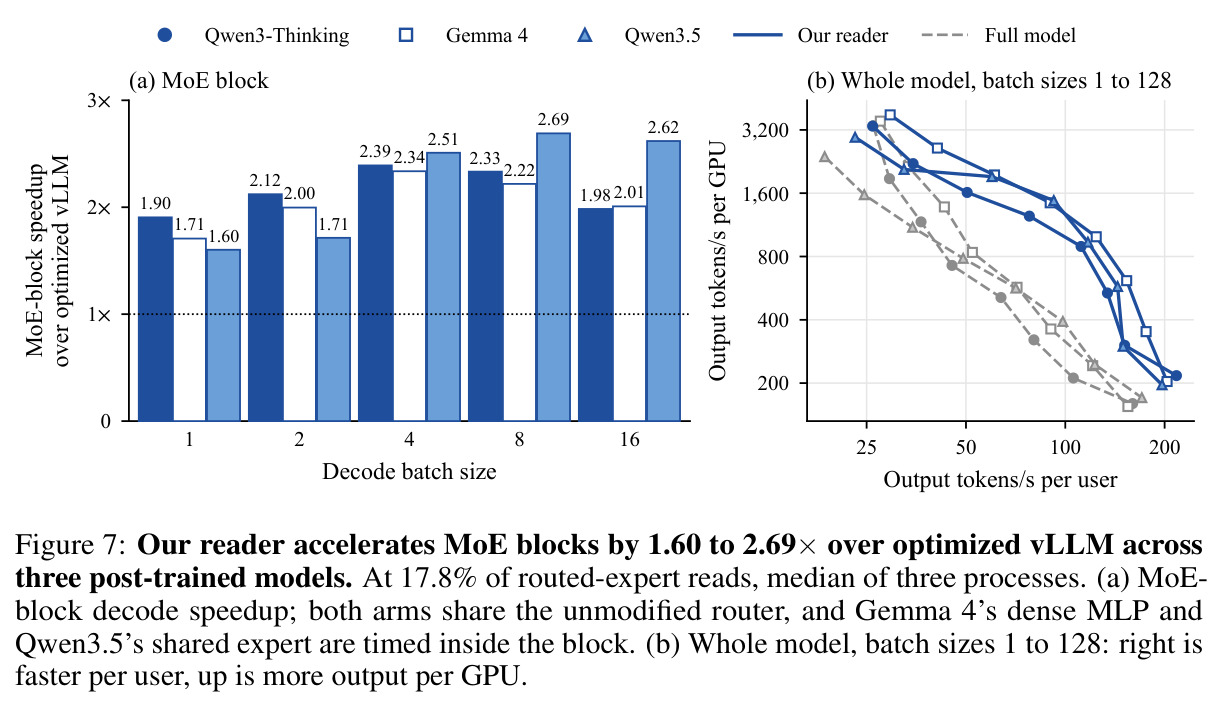
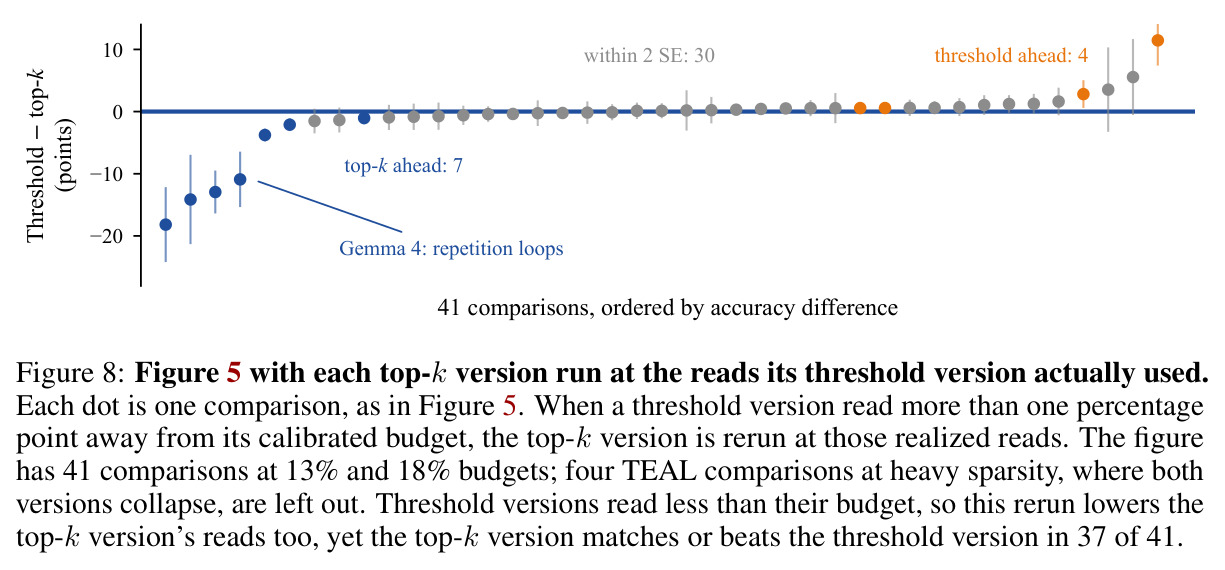
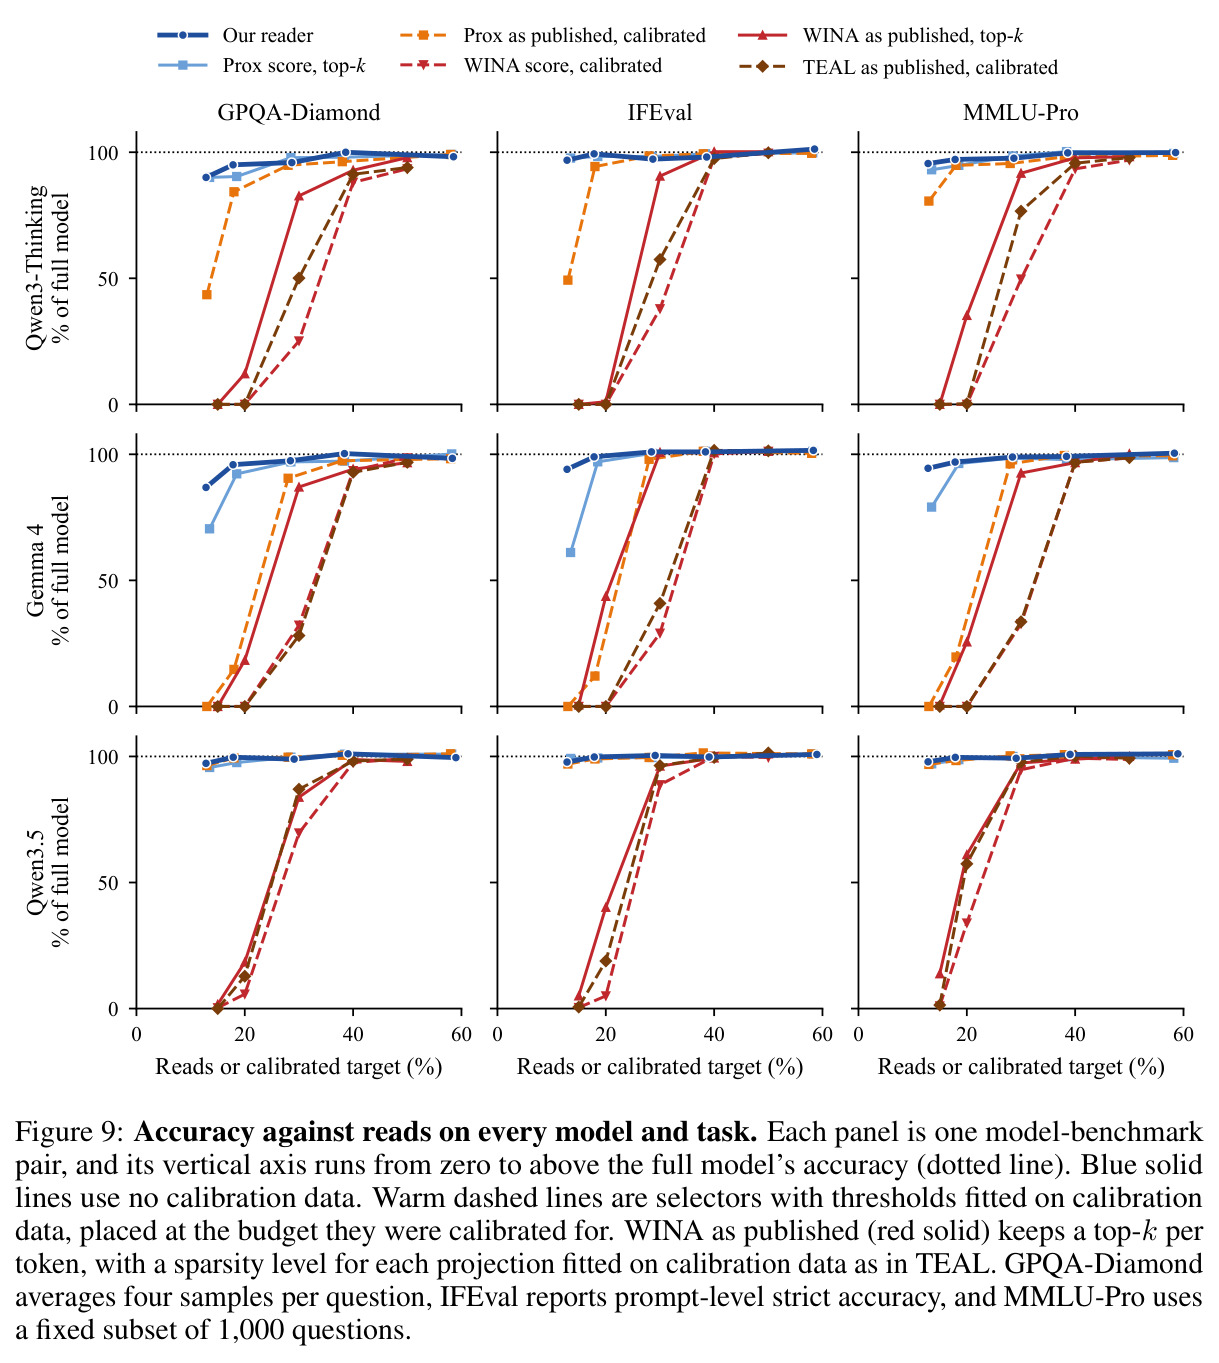
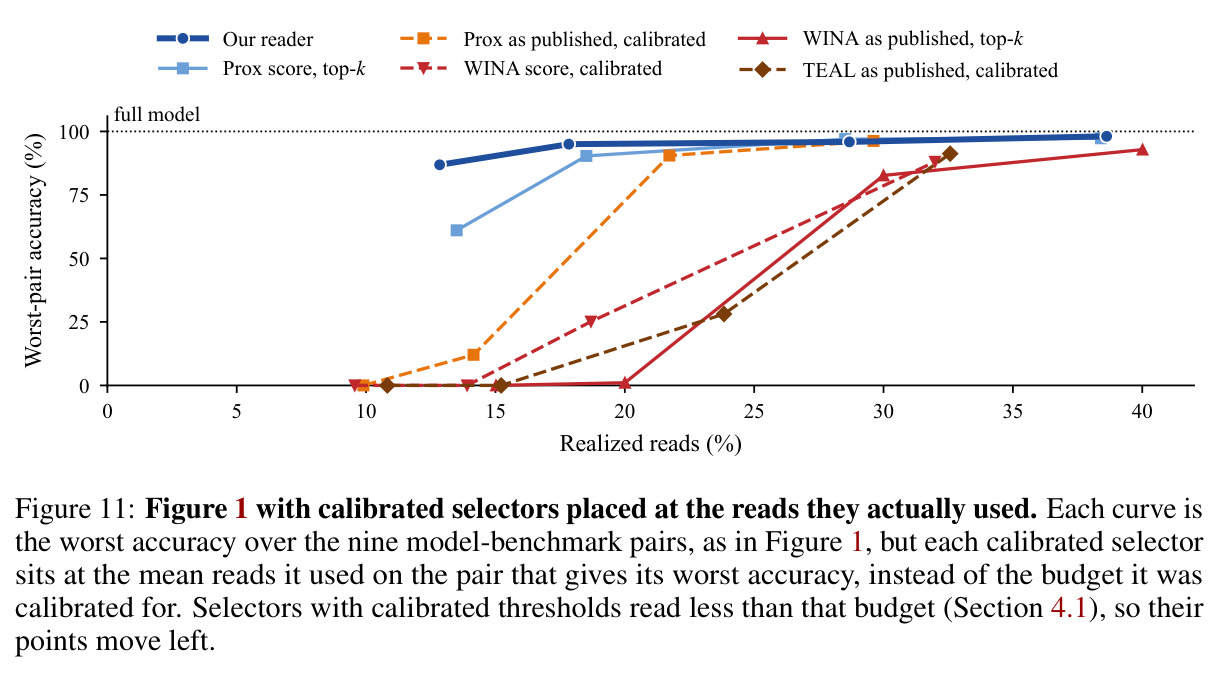
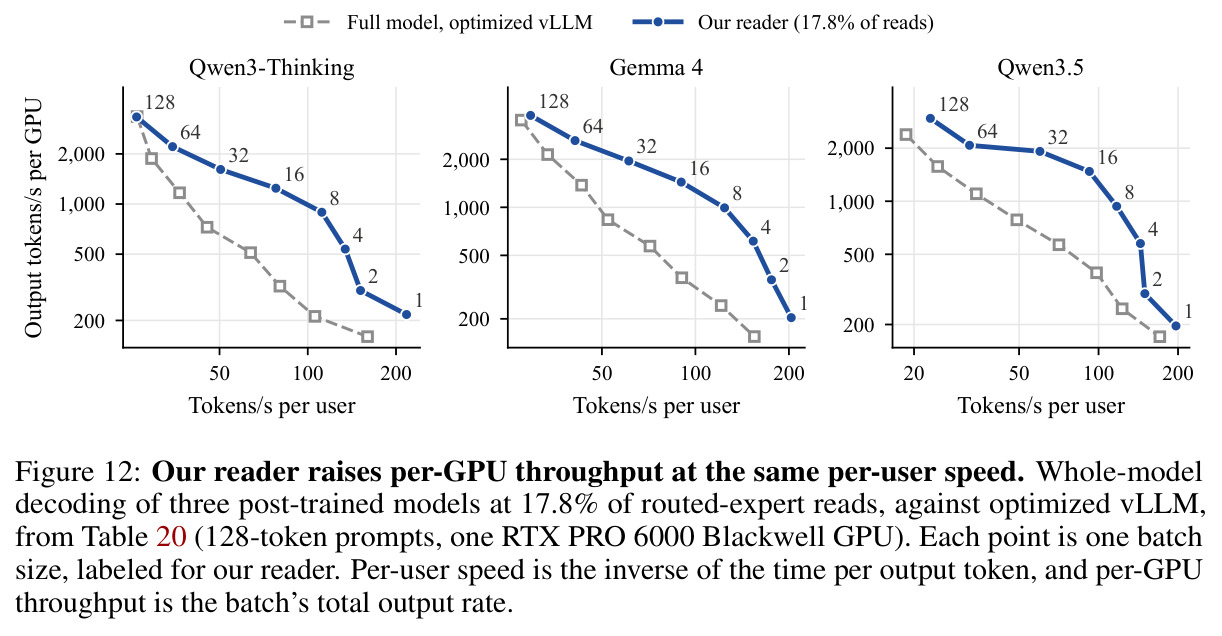
结果分四块。(1)读取漂移:Prox按18%校准后在9个模型-基准对上实际只读8.5%至14.7%(均值12.9%),其中约1.7个百分点是其公开的输入/通道预算切分规则按sector计费后就固有的;扩展到全部24个阈值设定、216组运行全部低于预算;校准数据换成模型自身推理文本也无济于事(附录D.1)。(2)keep规则:13%/18%预算下43组同分数配对比较,top-k版30平10胜3负(负时差距不超过2.8分);23组生成任务比较中阈值版全败;在阈值版实际读取量下top-k版仍37/41持平或占优;Gemma 4上top-k领先38至45分,源于阈值版重复循环(Prox阈值版792个GPQA-D答案674个撞限,top-k版仅145个)。(3)读取器精度:三模型×三基准平均,12.8%读取时达全模型精度的94.5%(最差对86.9%),17.8%时98.1%(最差对95.0%);同期Prox发布版在相近读取(12.9%)只有68.5%(最差对12.1%),WINA发布版20%读取只有28.4%,TEAL/WINA校准版在20%读取接近0至9.9%;OLMoE上读取器KL散度0.199@17.8%,优于九个先前选择器(次优0.298,除Prox外其余至少4倍)。(4)速度:Triton内核在17.8%读取下,MoE块batch 1加速1.90×/1.71×/1.60×(Qwen3-Thinking/Gemma 4/Qwen3.5),峰值2.69×(Qwen3.5 batch 8);整模型batch 1为1.15×至1.36×,batch 8至16峰值1.75×/1.74×/1.88×,batch 128回落到1.00×至1.24×;每用户100 tokens/s下单GPU总输出达3.3至4.3倍。另一重要发现:KL散度下降不等于基准提升——校准层预算在推理文本上把KL降15.7±1.9%却无基准收益,校准恢复映射在18组比较中0次胜过仅用权重的恢复映射。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 三模型×GPQA-Diamond/IFEval/MMLU-Pro 平均(读取预算约18%) | 占全模型准确率的百分比 | 98.1(最差模型-基准对95.0) | Prox发布版(校准阈值,实际读取12.9%):68.5(最差对12.1);WINA发布版(top-k):28.4 @20%;TEAL校准版:9.9 @20% | 平均+29.6 pp;最差对+82.9 pp |
| Qwen3-Thinking GPQA-Diamond(读取12.8%) | accuracy(每题4样本平均) | 63.8(全模型70.8) | Prox校准@13%预算:30.8(实际读取8.5%) | +33.0 pp |
| Gemma 4 GPQA-Diamond(13%预算) | accuracy | 本文读取器69.4 @12.8%;Prox top-k版51.0 @13.0% | Prox校准阈值版6.1 @11.4%(答案全部撞长度上限) | 仅把通道阈值换成top-k即+43.9至+44.9 pp,代价只有+1.5至1.6 pp读取 |
| keep规则配对比较(4个MoE模型,13%/18%预算) | 43组中胜/平/负(阈值版−top-k版) | top-k版10胜30平3负;23组生成任务阈值版0胜 | 阈值版仅3组领先且差距不超过2.8分 | 在实际读取口径下top-k版仍37/41持平或占优 |
| OLMoE 对比9个先前选择器 | next-token KL散度(越低越好)@约17.8%读取 | 0.199(top-1一致率0.808) | 最优基线Prox(调优划分,校准)0.298/0.774;TEAL 1.109、WINA分数版1.295、R-Sparse 1.132、HiRE-style 0.860 | KL较最优基线降约33%,其余基线至少4倍于本文 |
| MoE块解码速度(17.8%读取,RTX PRO 6000 Blackwell) | 相对优化vLLM的加速比 | batch 1:1.90×/1.71×/1.60×;峰值2.69×(Qwen3.5 batch 8) | 优化vLLM(其fused-MoE核已跑出GPU achievable带宽1.63TB/s的83%至88%) | 1.60×至2.69× |
| 整模型解码速度(17.8%读取) | 每输出token时延加速比 | batch 1:1.15×至1.36×;batch 8至16峰值1.75×/1.74×/1.88× | 优化vLLM(默认或调优配置取更快者) | batch 128时回落至1.00×至1.24× |
| 服务吞吐(每用户100 tokens/s) | 单GPU总输出token速率倍数 | 3.3至4.3× | 全模型=1× | 同样体验下单卡服务约3.3至4.3倍用户 |
局限与改进
作者承认的局限:(1)内核只把一部分节省的读取转化为速度——batch 1时Qwen3-Thinking的MoE块只搬全模型18.3%的内存流量却只快1.90×而非约5×,因为kernel启动等固定开销不随读取减少,且内核只针对单一预算、单一GPU类型调优;(2)部分筛选读80/128坐标的比例在OLMoE上选择、仅在Gemma 4上复核;(3)只改动解码期被路由专家,共享专家/稠密MLP/注意力不受影响;(4)sketch与恢复映射分别增加约7%和0.5%的BF16检查点常驻内存,在量化检查点上占比更大;(5)测试模型最大35B。我的补充观察:其一,12.8%读取时最差对仍有13.1%的精度损失(86.9%),Gemma 4 IFEval全模型93.5分时读取器88.0分,重稀疏下的损失不可忽略,部署方仍需人工按模型/任务选预算;其二,Qwen3.5上per-token计数变化在等读取下反而有益(GPQA-D +7.1±2.7分),说明固定k的一刀切并非所有模型的最优计数策略,论文的数据只支持校准阈值不是获取这种变化的可靠方式;其三,崩溃的悬崖行为只是猜想加经验证据,没有理论刻画;其四,批量增大后收益递减(batch 128仅1.00×至1.24×),对高吞吐服务器场景吸引力有限;其五,评测仅3个生成基准加OLMoE的likelihood任务,代码/数学/多语言等场景未测,且所有校准基线都用UltraChat或Pile拟合,未测试校准数据分布与任务高度匹配时阈值是否表现更好。
独立分析的弱点
独立分析的弱点与改进方向:(1)固定开销主导小batch收益——MoE块batch 1仅1.90×,与省下81.7%读取的理论空间相去甚远;改进方向是把筛选、top-k、恢复与路由、注意力更深度融合或跨流重叠(论文已把恢复放到第二CUDA流),或进一步用CUDA graph消除启动开销。(2)sketch显存代价与量化检查点冲突——4-bit检查点加sketch约占BF16 routed字节的34%;改进方向是让sketch直接作用于量化权重并优化其自身压缩(论文已展示GPTQ 4-bit上KL 0.045@18.9%可行,但sketch未压)。(3)预算仍是人工超参——top-k的k由部署者固定,不同模型/层最优k可能不同(Qwen3.5偏好逐token变化);改进方向是从权重量(如各层激活能量集中度$E=1-\|y-y_K\|^2/\|y\|^2$)自动导出每层k,仍不碰数据。(4)重复循环崩溃只在Gemma 4上出现且机理不明——更稀疏的模型上top-k也未必幸免;改进方向是加轻量运行时循环检测与回退。(5)恢复假设秩32够用且通道贡献可加——对中间维度更大的专家未验证;改进方向是按层自适应秩。(6)prefill不受益,长上下文时注意力占比上升使整模型收益缩水(8k至32k上下文仅1.08×至1.54×);改进方向是与KV缓存稀疏、注意力稀疏方法组合。(7)评测基准较窄,未含长文本理解、代码生成等,泛化性有待第三方检验。
未来方向
作者明确提出的方向:(1)整batch联合选择通道(batch-shared selection),让收益延续到更大batch;(2)把Triton内核从单一预算、单一GPU推广;(3)与其他稀疏层级组合——专家跳过/合并(REAP等)、静态剪枝量化、注意力稀疏都可与读取器叠加;作者还提示两点普适规律值得延伸:短likelihood评测会掩盖长生成的失效(REAP在专家合并中看到同样对比),以及KL下降不必转化为基准提升(校准层预算在推理文本上降KL 15.7±1.9%却无收益)。基于成果可延伸的方向:(1)崩溃悬崖的机理建模——刻画错误稀疏度与循环启动概率的关系,推广到剪枝/量化模型并设计运行时防护;(2)以KL为目标的选择器优化可能错位,应建立以长生成质量为直接目标的评测协议;(3)把输出量纲打分+跨专家全局top-k推广到共享专家、稠密FFN与注意力投影;(4)需要感知稀疏的预训练——MoC、HiRE已证明训练时植入top-k可行,与本文免校准读取器结合可能进一步压低预算;(5)逐token需求预测——论文的oracle分析显示知道每token损失可把KL减半,而岭回归预测器只解释约20%方差,更强的预测器是明确收益空间;(6)在35B以上模型、多模态与更多任务上验证,以及把读取计数工具本身发展成社区标准。
复现评估
复现条件很好。代码完全开源(github.com/AidenGeunGeun/calibration-free-moe),包含读取器、Triton内核、vLLM 0.29.0补丁、全部基线适配(Prox、TEAL、WINA、CATS、R-Sparse、HiRE-style、CHESS、M-COUNTDOWN、Park et al.等)、评测脚本,以及从评测输出重算论文每个数字的脚本;附录B给出模型、基准、采样参数(固定随机种子20260923)、校准协议、统计口径(问题聚类配对标准误)与硬件。模型(Qwen3-30B-A3B-Thinking-2507、Gemma-4-26B-A4B-it、Qwen3.5-35B-A3B、OLMoE-1B-7B)、基准(GPQA-Diamond 198题×4样本、IFEval 541条、MMLU-Pro固定1000题、GSM8K、BBH)与校准数据(UltraChat/Pile)全部公开。算力需求适中:基准运行为单卡RTX PRO 6000 Blackwell、双A6000或四张A5000/RTX 3090;Prox校准单卡3至19分钟;读取器的sketch与恢复映射构造是加载时一次性的纯权重运算。精度实验复现难度低;速度实验依赖Blackwell GPU与特定软件版本(PyTorch 2.13、Triton 3.7.1),其他硬件上加速比会不同,但读取计数和KL指标可精确复核(论文公布了profiler实测18.3%供对照)。主要陷阱:复现比较时必须对基线按sector计费重设预算,并在校准预算与实际读取两个口径下分别跑top-k,否则结论会失真。
论文图表
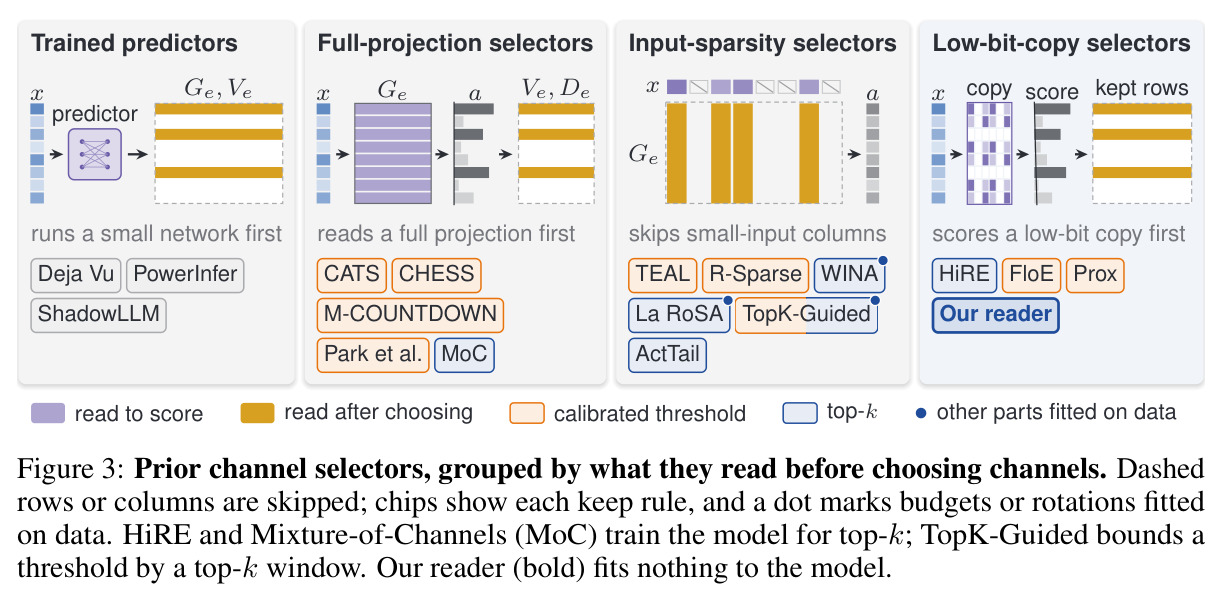
把先前选择器分为四族:训练预测器(Deja Vu、PowerInfer、ShadowLLM等)、全投影选择器(CATS、CHESS、M-COUNTDOWN等)、输入稀疏选择器(TEAL、R-Sparse、WINA、La RoSA等)、低比特副本选择器(HiRE、FloE、Prox及本文读取器);每个芯片标注keep rule(校准阈值/top-k)以及哪些部件在校准数据上拟合。
给出本文读取器在选择器谱系中的位置——唯一一个没有任何部件拟合到数据的方法,清晰呈现其差异化定位。
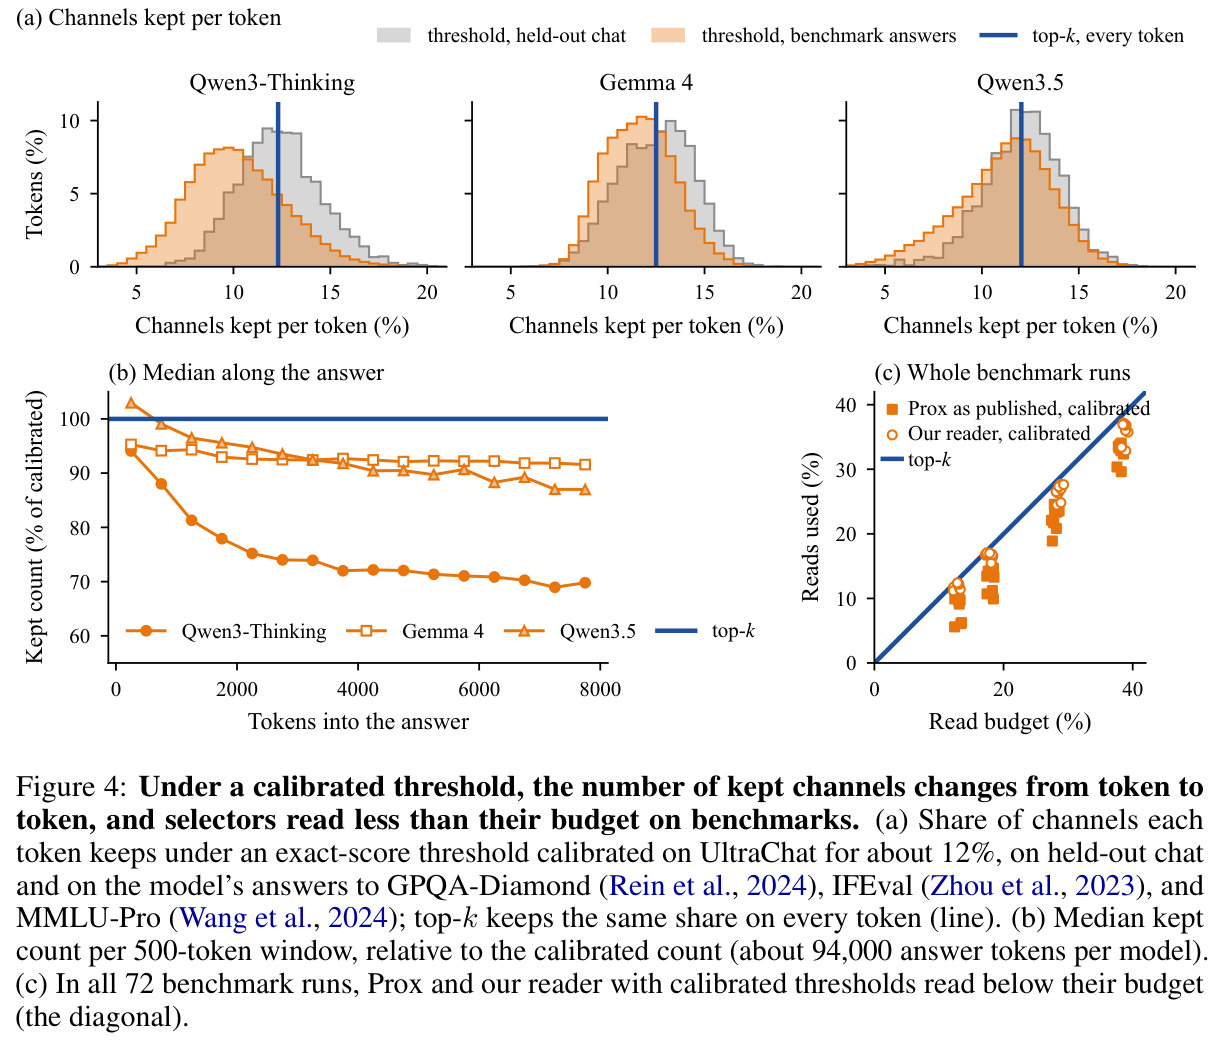
(a)UltraChat上校准到约12%的精确分数阈值下,held-out chat的平均kept数符合目标但token间波动大(Qwen3-Thinking中间90%为9.0%至16.2%),基准答案上中位数跌到10.0%;top-k则是每token相同的直线。(b)kept数随答案增长下降(约6000 token处三模型分别为71%/92%/88%)。(c)全部72组运行中Prox与读取器校准版的实际读取均低于预算(全部落在对角线下方)。
论证校准阈值固定不了读取量的核心证据,直接动摇校准的第一个存在理由。