AutoVend:面向长时程自动售货运营的 LLM 智能体基准 AutoVend: Benchmarking LLM Agents on Long-Horizon Autonomous Vending Operations
单个智能体经营20台异构售货机180天,五个模型四个跑不过规则基线。
前置知识
POMDP(部分可观测马尔可夫决策过程)
一种序贯决策框架:智能体每步在无法完全观测的真实状态 $s_t$ 下选择动作 $a_t$(此处为工具调用),只能通过观测核 $Z(o_{t+1}|s_{t+1},a_t)$ 获得部分信息。AutoVend 中商品热度、价格弹性等需求参数与未满足需求都被隐藏,智能体每天只能看到经营摘要和工具返回结果。
论文的任务形式化直接建立在 POMDP 上。理解'隐藏需求参数'为何迫使智能体必须在线估计需求、迭代修正策略,以及为何同一模型多次运行结果差异大,都需要这个框架。
多项 Logit 选择模型(MNL)
离散选择模型:顾客在可选商品外加一个'不购买'选项中做选择,每个选项的选中概率与其效用(吸引力)占比成正比。AutoVend 用商品吸引力 $w_{m,k,t}$ 决定选择分布,每天的购买尝试次数 $N_{m,t}$ 服从泊松分布,销量取采样需求与货架库存的最小值,未满足的需求直接流失。
模拟器全部的需求生成、参数校准与保真度验证都围绕该模型展开;不熟悉 MNL 就无法理解 Equation 2-4 的含义,也无法判断'数据接地'是否可信。
报童模型与 order-up-to 补货策略
运营研究经典库存理论:报童模型在需求不确定下按临界比率权衡缺货损失与持有/过期成本确定订货量;order-up-to 策略周期性把库存补到由滚动需求均值与波动推得的目标水位。AutoVend 的规则基线将两者结合:用 30 天滚动需求设定目标、每周补货,并计入 3 天提前期。
这条规则基线是论文的核心对照组——'四个模型跑不过它'的结论完全依赖它。理解其机制才能判断这是基线太强还是 LLM 太弱。
MCP(Model Context Protocol)
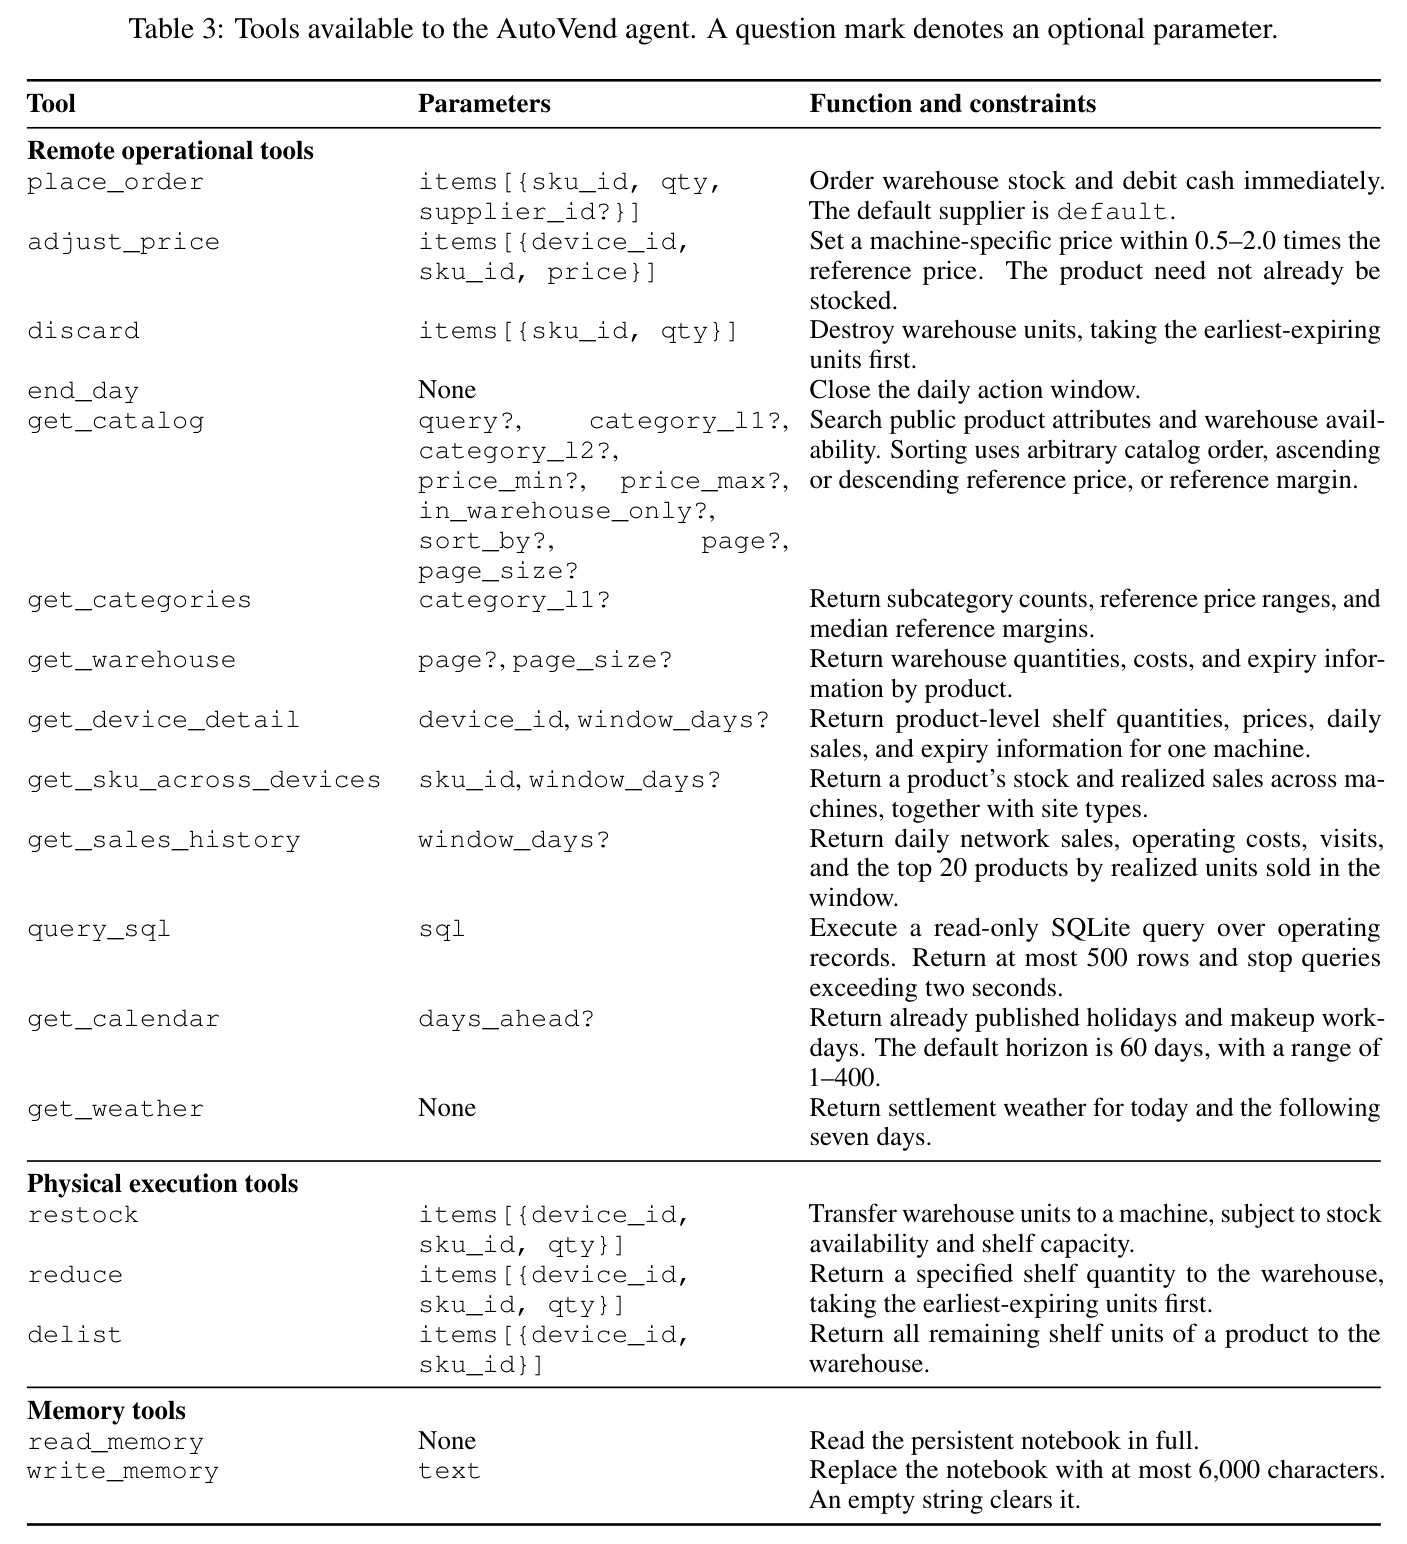
Anthropic 提出的模型-工具连接协议,让 LLM 通过标准化接口调用外部环境的功能。AutoVend 把网络化售货运营可做的远程操作(下单、调价、丢弃、结束当日)与物理执行(上架、下架、退货)以及持久记忆(笔记本读写)共 18 个工具暴露为 MCP 工具,每个工具调用返回查询结果或执行反馈。
智能体与环境的全部交互都经由 MCP 工具完成,动作空间、'物理执行需付费上门'的计费方式、批量操作逐项校验等机制都定义在工具规格里。
WAPE 与 TVD
WAPE(加权绝对百分比误差)$= \sum_t|v_t-\hat v_t|/\sum_t v_t$,衡量模拟销量与真实销量的相对偏差;TVD(总变差距离)衡量两个离散分布的差异,取值 0 到 1,越小越接近。论文用 WAPE 比较总量、TVD 比较子类别份额、Spearman 相关比较机内排序。
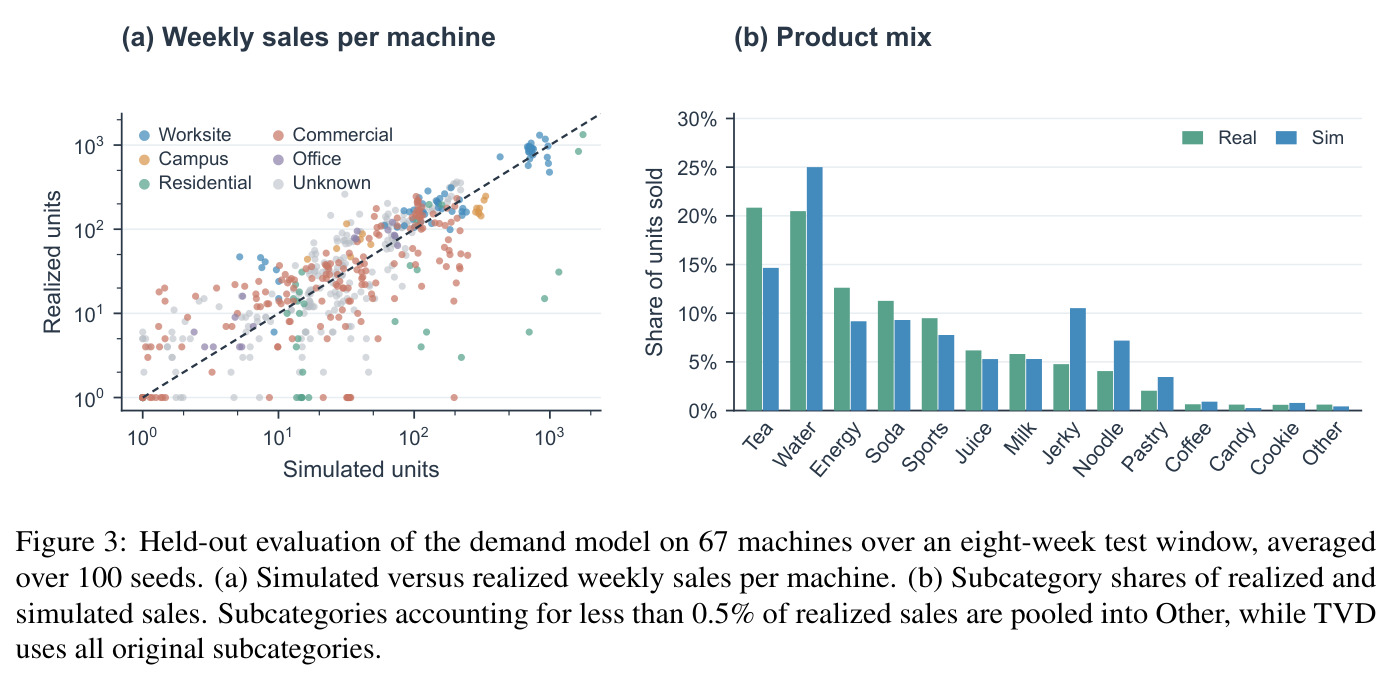
Figure 3 的需求模型验证完全由这些指标支撑,是与朴素/持续性参考对比、判断模拟器可信度的量化依据。
长时程经济累积评测
与'完成任务即结束'的基准不同,这类评测固定一段模拟日历时间(如 180 天),期间成本持续累积、环境按日演化(天气、节假日、订单到货),无论智能体是否行动时间都在推进,最终性能表现为累积的经济结果——终端净资产——而非任务完成率或单次对话质量。
AutoVend 属于此类。论文最核心的发现——'局部指标改进不等于经济增长'——只有在成本持续累积、反馈跨天滞后的长时程设定下才会暴露。
研究动机
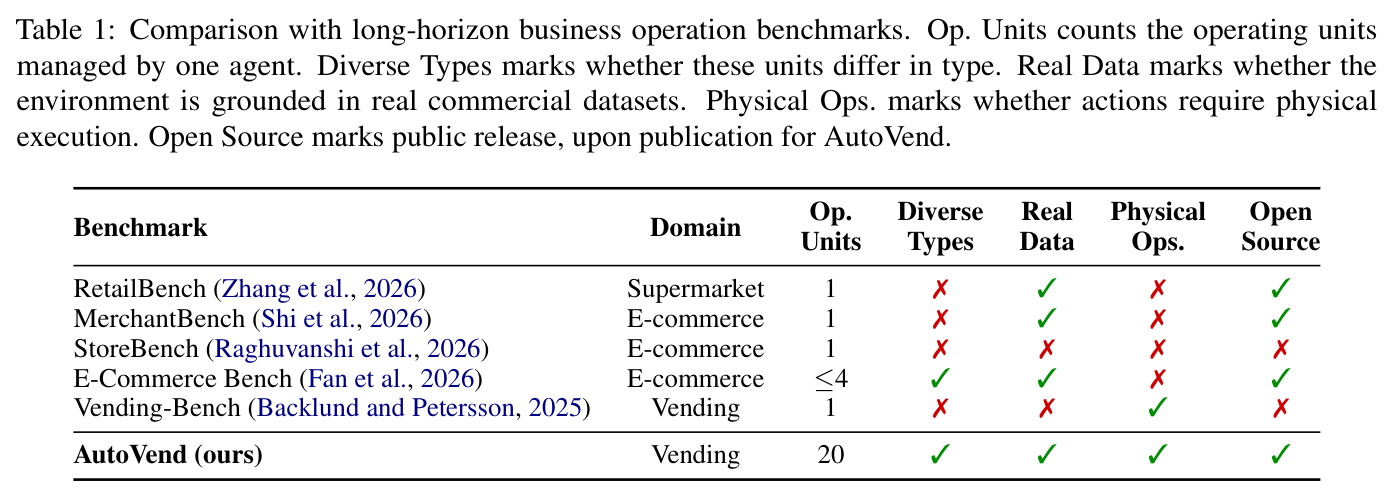
现有智能体商业评测大多止步于'一次交互完成':WebShop、AgenticShop 评测买方的商品发现与个性化购物,ECom-Bench 等评测客服对话。卖方侧基准虽开始关注持续经营,但覆盖面有限:RetailBench 只覆盖 1 家超市,MerchantBench 与 StoreBench 各 1 个线上店铺,E-Commerce Bench 最多 4 个共享仓库的线上店,Vending-Bench 只有 1 台售货机。它们的共同缺口是:决策在 Web 平台上下达,后果却不依赖物理执行——没有共享库存下的跨站点分配,没有采购提前期约束下的线下履约,更没有'每次补货都要派员工上门、按机按天收 35 元'的执行成本。而真实 O2O 零售中,线上决策能否变成持续经济回报恰恰取决于这些约束:20 台机器共享一个仓库,分给一处的货别处就用不上;30/90 天保质期叠加仓储租金与上门费,会让'多补货、勤补货'直接变成亏损源。
本文的目标是本文要构建一个把线上决策与物理执行绑定在一起的长时程卖方评测环境 AutoVend:让单个 LLM 智能体通过 MCP 工具接口,经营分布在工作区(6 台)、校园(2 台)、住宅(4 台)、商业区(6 台)、办公楼(2 台)的 20 台售货机,共享一个仓库与 1,372 种商品(18 个子类别),以 40,000 元初始现金运营 180 个模拟日,自主决定选品、定价、采购与上门补货。环境内置 3 天采购提前期、每机每天 35 元上门费、0.03 元/件/天仓库租金、每机每天 4 元机器租金与 80 元固定费用、售出过期品每件罚款 1,000 元。具体目标有三:用 99 台真实售货机六个月、220,128 件销量记录校准需求模型并验证其保真度;在同一冻结环境中评测五个前沿 LLM 与规则库存基线;通过运营画像与轨迹诊断定位智能体在跨站点协调、物理执行与策略改进上的具体短板。
与已有工作不同的是,本文的独特切入是把'长时程经济累积'与'付费物理执行'同时压进一个基准。此前卖方基准要么只有线上店铺(MerchantBench、StoreBench、E-Commerce Bench),要么虽有物理动作但仅 1 台机器且无真实数据(Vending-Bench)。AutoVend 让每一次货架操作都必须付费上门,使'采购了货'与'顾客能买到货'成为两个独立的能力维度;仓库由 20 台机器共享,任何分配都是零和的资源调度;需求参数对智能体隐藏,观测销量又依赖其自身决策,逼出在线学习能力。评测端还首次把'每美元推理成本的净资产增长'(API Efficiency)作为一等指标,发现按回报排名与按成本效率排名会给出完全不同的答案:GPT-6.1 Sol 回报最高但 API 花费约为 DeepSeek 的 80 倍。
核心方法
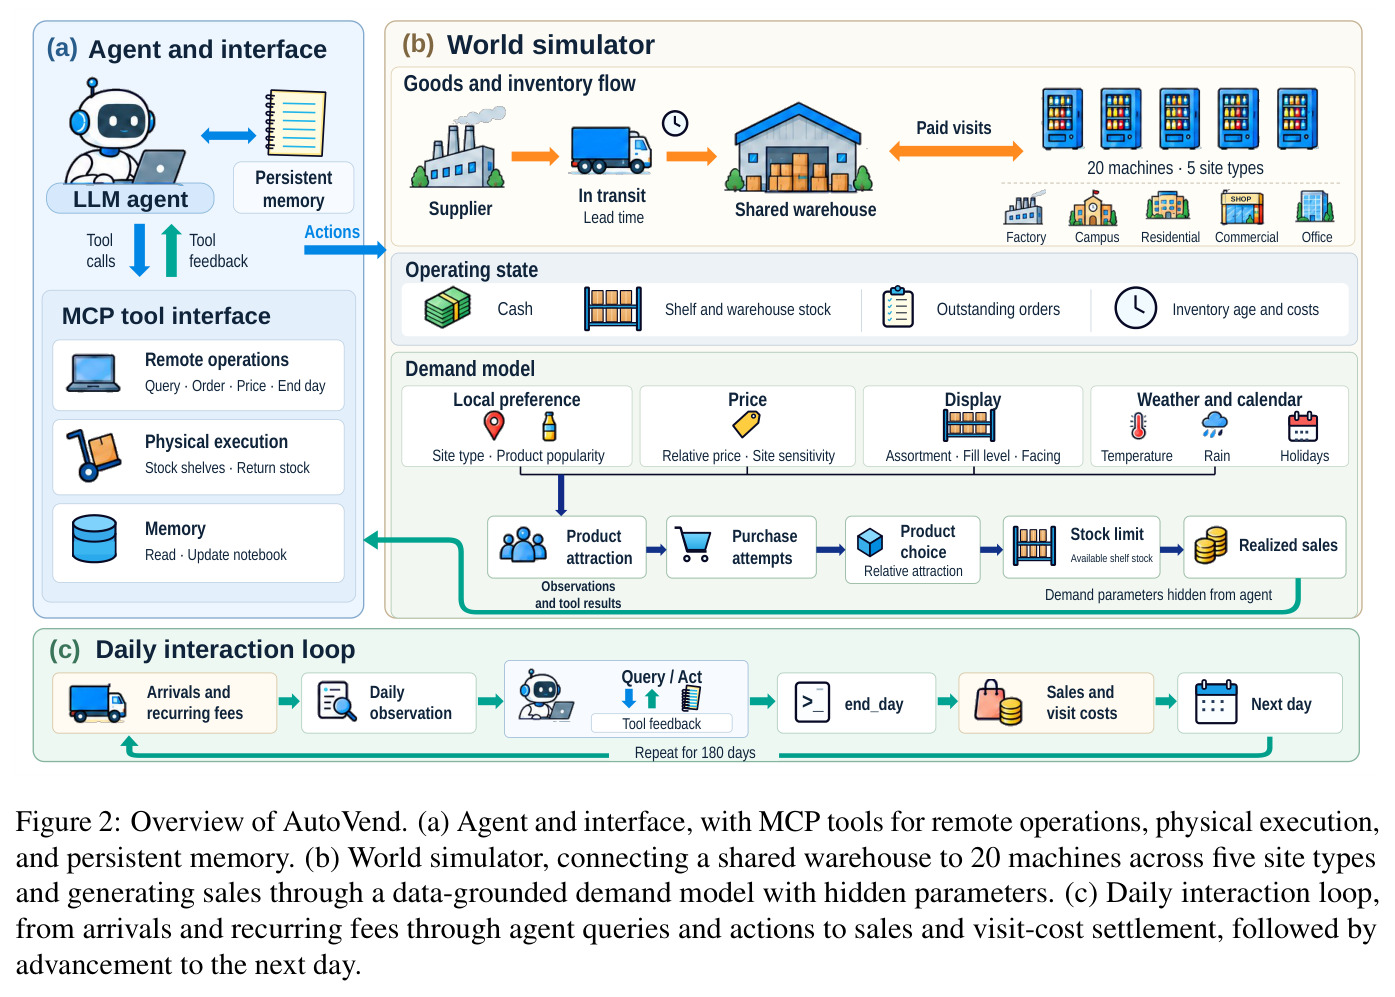
AutoVend 把售货网络经营形式化为部分可观测马尔可夫决策过程(POMDP):状态 $s_t$ 包含日期、现金、库存、在途订单、各机器选品与价格及隐藏的需求条件,动作 $a_t$ 是一次工具调用。目标是最大化终端净资产 $NAT = B_T + \sum_k c_k h_{k,T}$,即期末现金加上按成本计价的未过期库存(货架、仓库、在途各处均计)。技术路线分三块:(1) 世界模拟器:20 台机器共享仓库,容量各 200 件,采购下单即扣款、3 天到货;需求由带'不购买'选项的多项 Logit 模型逐机生成,含 30/90 天保质期、过期罚款与各级租金;(2) 智能体接口:18 个 MCP 工具分远程操作、物理执行、持久记忆三组,每天一个交互循环——读日报、查询、行动、end_day 结算;(3) 评测协议:净资产为主指标,辅以选品得分、损耗率、定价遗憾、货架利用率、资本效率、工具调用数与 API 效率,并与报童+order-up-to 的规则基线对比。每个模型跑 3 次,同一冻结世界、同一随机种子,波动只反映智能体决策及其诱发的需求抽样差异。
核心创新是'决策—库存—执行'三重耦合,对应论文强调的三个相互依赖的能力。跨站点资源协调:分配给一台机器的货会减少其他机器可用的仓库库存,局部决策必须考虑全网后果(Eppen 1979 的集中化效应);物理执行规划:仓库里的货不上货架就卖不出去,补货要么提前 3 天下单,要么付 35 元上门费现场上架,还要权衡 0.03 元/件/天仓储费与 30/90 天过期风险;持续策略改进:需求参数隐藏,观测销量又依赖自身选品定价,必须从反馈中迭代修正。需求侧的吸引力公式 $w_{m,k,t} = b_{m,k}\, F_{m,t}^{\eta}\, \min(1, q_{m,k,t}/\phi)\, (p_{m,k,t}/\bar p_k)^{-\varepsilon_{\ell(m)}} E_{m,k,t}$ 把货架饱满度(更满更吸引顾客,$\eta=0.5$)、陈列深度(低于 $\phi=5$ 件吸引力按比例打折)、站点级价格弹性($\varepsilon$ 取 2.4–3.5)与天气假日乘子 $E_{m,k,t}$ 全部编码,且对智能体隐藏,从而同时考验估计与规划能力。
方法步骤详情
第一步,数据校准:用 99 台真实售货机六个月、220,128 件销售记录估计商品热度(经验贝叶斯向子类别均值收缩)、站点饮品/零食偏好与规模系数,标定超散布冲击($r=2.74$)与持续性(自相关 $\rho=0.21$),使典型真实货架的期望销量等于该机器历史日均销量。第二步,需求生成:每机每天按吸引力权重做多项 Logit 选择加泊松采样,销量取需求与货架库存的最小值,未满足需求流失。第三步,日循环:每天先结算到货与经常性费用,智能体读取日报(现金、净资产、损益、库存、假日),用 query_sql 等查询经营记录,用 place_order(即时扣款、3 天到仓)、adjust_price(限参考价 0.5–2.0 倍)、restock/reduce/delist(触发 35 元上门费)、discard 操作,end_day 结算并进入下一天;跨天记忆靠上限 6,000 字符的持久笔记本。第四步,验证:在 67 台机器八周窗口重建真实货架并回放,100 个种子下 WAPE 0.473(朴素 0.606、持续性 0.561),总量误差小于 0.7%,子类别 TVD 0.153。
技术新颖性
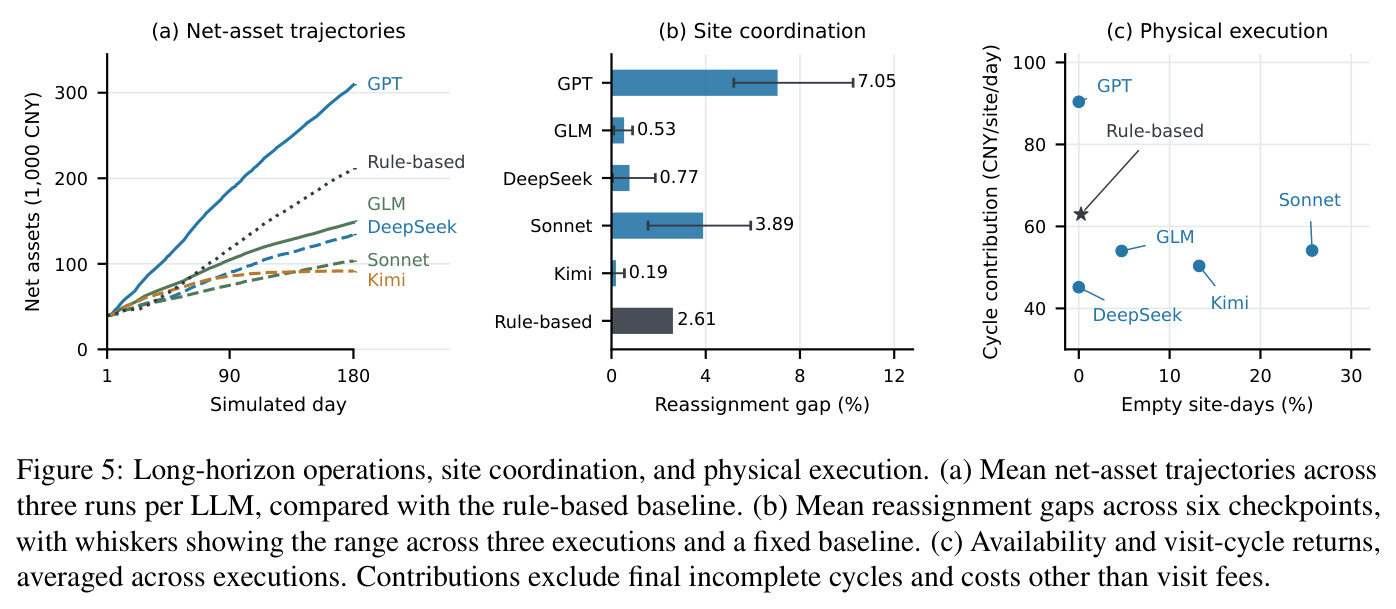
与已有基准相比,AutoVend 在五个维度上同时做到唯一(Table 1):20 个运营单元、单元类型异构、真实数据接地、动作需要物理执行、开源(发表后)。Vending-Bench 有物理动作但仅 1 台机器且无真实数据;E-Commerce Bench 有最多 4 个共享仓库的店但没有物理执行成本;RetailBench 单超市无执行。技术上的新颖点有三:一是把运营研究经典的报童/补货理论引入 LLM 智能体评测,构造临界比率加周期 order-up-to 的可解释强基线;二是诊断指标设计——reassignment gap 在固定各机选品的前提下重排站点位置,量化'选对了货但放错了地方'的未实现价值;visit-cycle return 把'周期毛利减上门费除以周期时长'拆开执行质量;三是把 API Efficiency(每美元 API 花费的净资产增长)作为一等指标,揭示回报与成本效率的排名不一致(DeepSeek 31,010 对 GPT 1,117 CNY/USD),这是既有商业基准都没有的视角。
实验结果
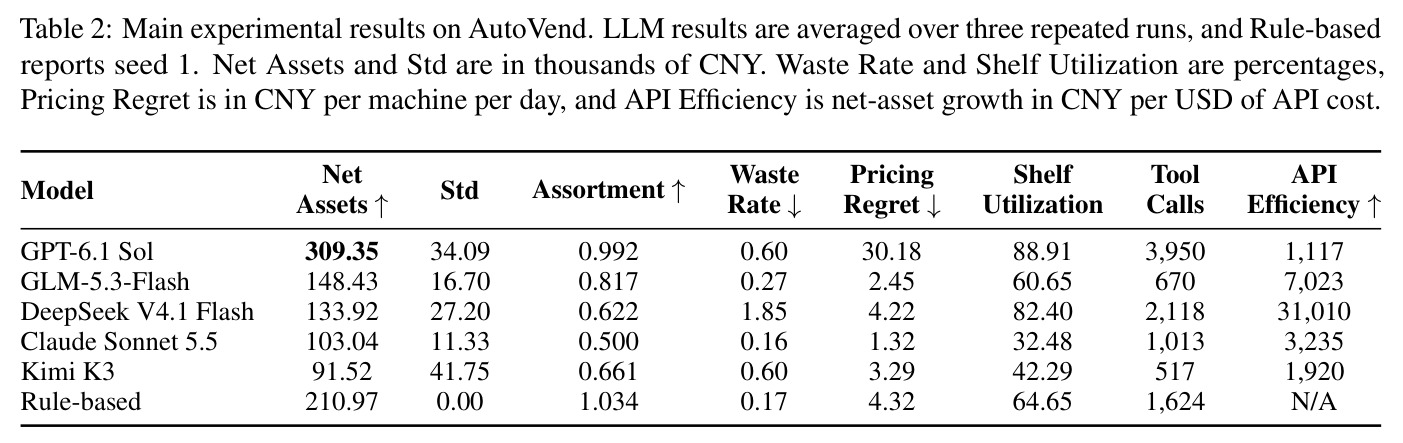
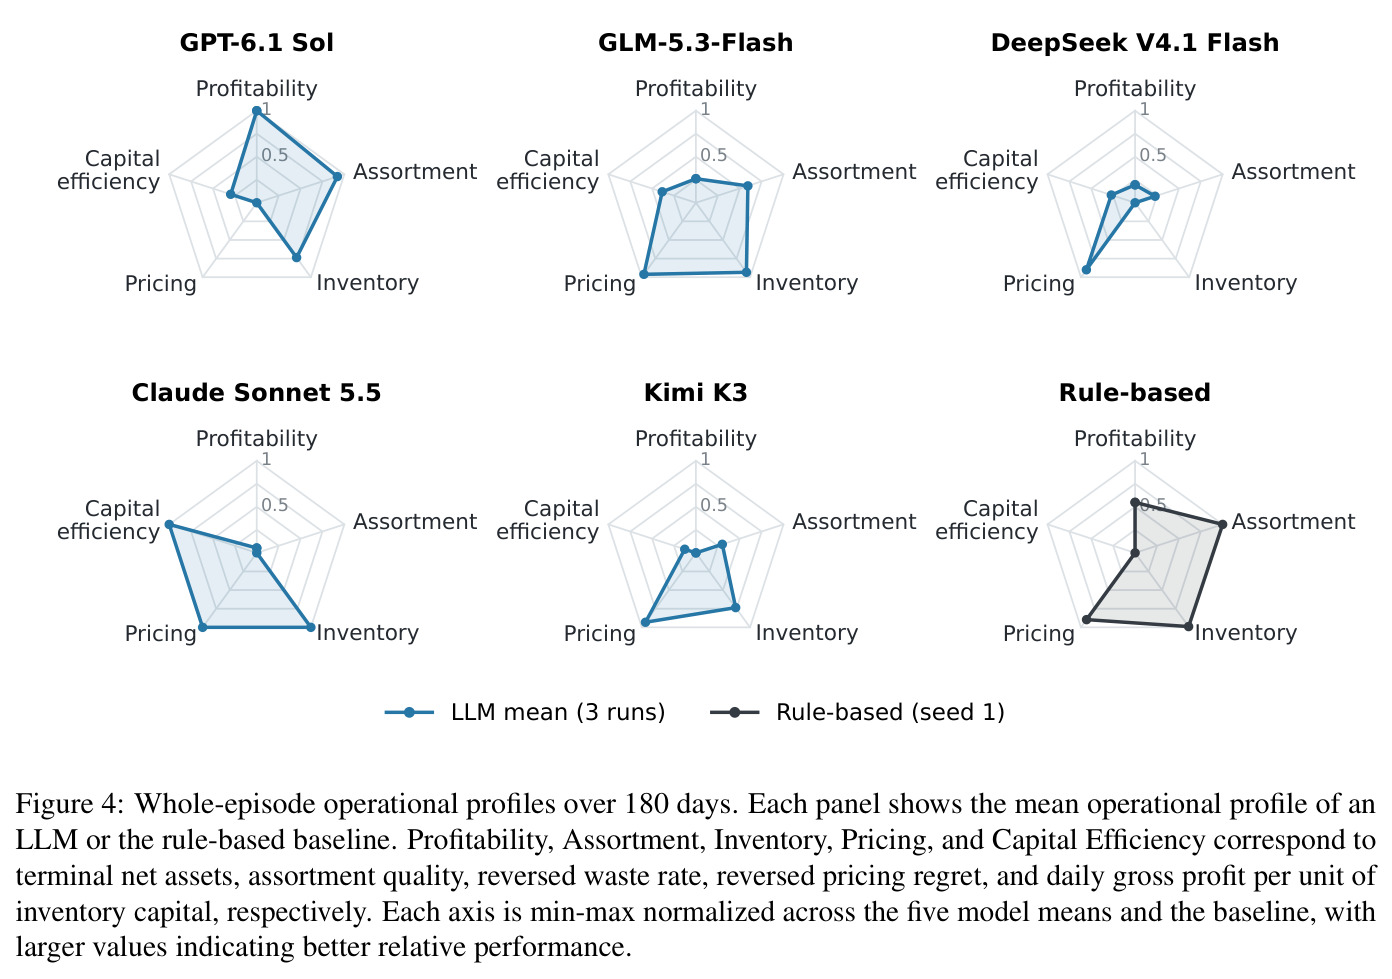
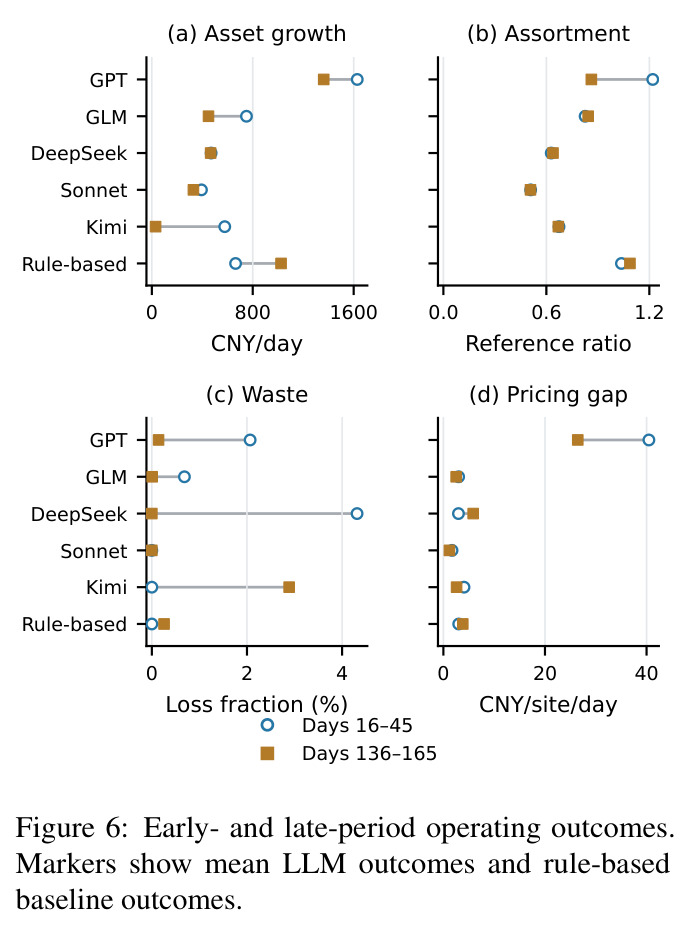
总体结果:五个模型各跑 3 次、180 天后,只有 GPT-6.1 Sol(309.35 千 CNY)超过规则基线(210.97 千 CNY),GLM 148.43、DeepSeek 133.92、Claude 103.04、Kimi 91.52 千 CNY 均不及基线;所有运行都盈利,但仅 GPT 三次全部超基线。分维度看:选品得分全部低于基线(GPT 0.992 最高、Claude 仅 0.500);损耗率 Claude 0.16% 最低、DeepSeek 1.85% 最高,且 Claude 低损耗伴随 25.21% 站点日空架、DeepSeek 仅 1.67%;定价遗憾 Claude 1.32 最佳、GPT 高达 30.18;Kimi 变异系数 45.6%,其余约 11%。GPT 重分配差距 7.05%(基线 2.61%),回报仍有未实现的协调价值;后期对比早期,五模型均值日资产增长全部下降、15 次运行中 13 次下降。典型失败:Kimi 一天 49 条分配因未校验库存全被拒;仓内已有 2,158 件无销量商品仍下单 80 件;一次补货仅 5.14 元毛利却付 35 元上门费。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 长时程网络运营(20 机 × 180 天) | 终端净资产(千 CNY,3 次运行均值) | GPT-6.1 Sol:309.35 | 规则基线(报童+order-up-to):210.97 | 仅 GPT 超基线(约 +46.7%);GLM 148.43、DeepSeek 133.92、Claude 103.04、Kimi 91.52 均不及基线,五模型中四者落败 |
| 选品质量 | Assortment 得分(对启发式参考组合) | GPT 0.992(最佳 LLM) | 规则基线 1.034 | 全部五个 LLM 均低于基线,最差的 Claude 仅 0.500 |
| 库存损耗控制 | Waste Rate(%,损耗成本/有效销售成本) | Claude 0.16%、GLM 0.27% | 规则基线 0.17% | 顶级 LLM 可持平或优于基线,但 DeepSeek 高达 1.85%;Claude 低损耗伴随 25.21% 站点日空架,DeepSeek 仅 1.67% |
| 定价效率 | Pricing Regret(CNY/机/天,对价格搜索参考) | Claude 1.32、GLM 2.45 | 规则基线 4.32 | Claude/GLM 优于基线;净资产最高的 GPT 遗憾却高达 30.18 |
| 推理成本效率 | API Efficiency(CNY 净资产增长 / USD API 花费) | DeepSeek 31,010 | GPT 1,117 | 单位成本回报约 28 倍差距;GPT 的 API 花费约为 DeepSeek 的 80 倍而资产增长仅 2.9 倍,效率排名与净资产排名不一致 |
| 需求模型保真度(预留 8 周、67 机、100 种子) | WAPE(机-周加权绝对百分比误差) | 0.473,总量误差 < 0.7% | 朴素参考 0.606、持续性参考 0.561 | 子类别 TVD 0.153(对照 0.206/0.238),机内产品销量 Spearman 中位数 0.577 |
局限与改进
作者承认的局限:每个模型只跑 3 次、单一冻结环境与随机种子,运行间波动反映的是智能体决策与需求抽样而非环境差异,规则基线只报告 seed 1(其三种子间为 208.73±2.26 千 CNY,变异系数 1.1%);诊断指标各有盲区,如 visit-cycle return 排除了上门费以外的成本,重分配差距小也不代表协调强(DeepSeek、Kimi 差距小但选品差);轨迹案例只说明'存在这些失败行为',不说明其普遍性或因果效应;早期与后期的对比因环境与库存状态变化,无法因果判定反馈本身是否改进了决策。我的补充:价格与环境响应参数'按设计不验证',模拟器与现实的 sim-to-real 差距未量化;180 天远短于真实零售的季节周期;仅 5 个模型、1 个 harness(Pi)、固定提示词与最高推理档位,结论可能对提示与工程配置敏感;业务域仅售货机,向超市、外卖等更复杂履约场景外推需谨慎。
独立分析的弱点
第一,统计功效不足:3 次运行在变异系数高达 45.6%(Kimi)的分布下几乎无法区分 148.43 与 133.92 千 CNY 这类差距,改进方向是增加种子数并报告置信区间或配对检验。第二,基线可比性存疑:规则基线在选品上得 1.034 高于所有 LLM,但它是为该环境手工设计的启发式,缺少'调参预算对齐'的对照,无法排除基线偏强或偏强于特定机制的可能。第三,诊断指标与总指标脱节:GPT 定价遗憾 30.18 元/机/天却回报最高,说明五个维度与净资产之间的因果链未量化,论文只对 DeepSeek 给出了文字案例的会计分解,改进方向是给出把各维度差异映射到净资产的可加分解。第四,记忆接口过于简陋(6,000 字符笔记本),长时程学习能力的上限可能被接口而非模型能力卡住,且各模型对同一接口的使用策略差异未被控制。第五,需求估计只能靠只读 SQL 拼凑统计,缺少标准化的在线估计工具,导致'估计能力'与'决策能力'混在一起无法分别评分。
未来方向
作者提出的方向:把结论推广到不同的运营条件与受控干预,例如显式的状态校验(下单前自动做产品级库存检查,针对 Kimi 式 49 条分配全被拒)与持久化策略更新(把单日纠错固化为规则,针对 GLM 式'当天纠错、隔天复发')。基于成果可延伸的方向:(1) 训练侧——用该模拟器做强化学习或专家迭代,直接优化终端净资产而非过程奖励;(2) 架构侧——系统比较记忆、反思与经验沉淀机制对跨日策略保留的影响;(3) 环境侧——加入竞争性多智能体(Vending-Bench 2 Arena 式)、供应链扰动与季节性需求,检验鲁棒性;(4) 评测侧——把 API Efficiency 与回报组合成帕累托前沿分析,纳入更多模型尤其是开源小模型;(5) 理论侧——把 reassignment gap、visit-cycle return 等诊断指标与运营研究中的最优性条件对接,给出结构化的性能上界与差距来源分解。
复现评估
复现难度中等偏上。开源情况:Table 1 标注'发表后开源',附录 A/B 给出完整系统提示词、每日用户提示模板与 18 个工具的参数与约束说明,可据此重建接口协议;但按附录 C,作者只发布校准后的模拟器参数而不发布 99 台机器的原始订单数据,需求模型只能按论文公式重建、无法重新校准。算力与环境:本地无需 GPU,但需要五个前沿模型的 API(GPT-6.1 Sol、Claude Sonnet 5.5、DeepSeek V4.1 Flash、Kimi K3、GLM-5.3-Flash),并使用 Pi harness 以最高推理档位驱动;成本主要是推理费——GPT 单次 180 天运行的 API 花费约为 DeepSeek 的 80 倍,复现 15 次 LLM 运行加基线种子的预算将集中在 GPT 与 Claude 上。模拟器确定性可控(固定种子下基线为 208.73±2.26 千 CNY),环境逻辑在论文中描述充分,熟练团队按论文与附录重建核心环境估计在一至两周量级,完整对齐校准参数则需要更多打磨。
论文图表
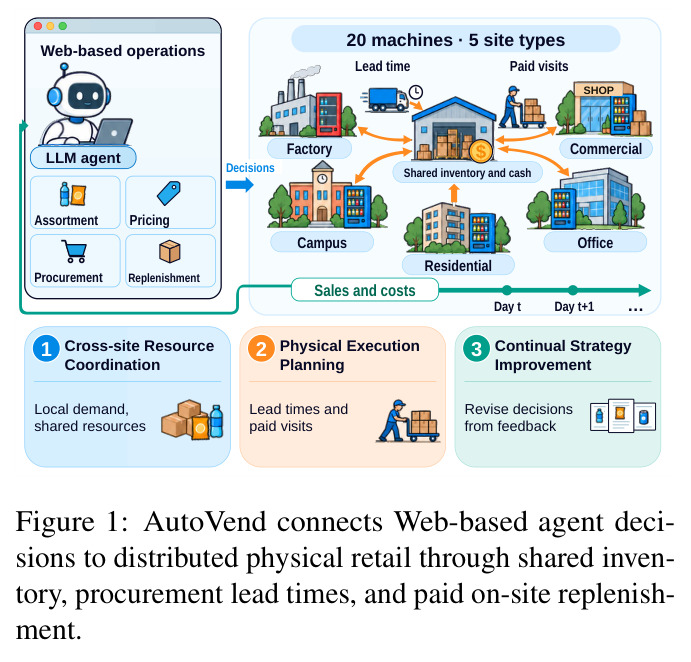
概念总览图:左侧是 LLM 智能体通过 Web 运营界面做出的三类决策(选品 Assortment、定价 Pricing、采购与补货 Procurement/Replenishment),右侧是 5 类站点 20 台机器构成的物理零售网络;中间用共享库存、采购提前期(第 t 天下单、之后到货)与付费上门补货三条纽带,把跨站点资源协调、物理执行规划、持续策略改进三个能力维度与销量成本反馈闭环连接起来。
它一图概括了 AutoVend 区别于既有基准的核心命题——线上决策必须经过共享库存、提前期与付费物理执行才能变成持续经济回报,是理解论文动机与三大能力框架的最短入口。