OR-License:评估大模型智能体作为真实世界运筹学从业者 OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
用368万美元真实运筹项目建基准:11个前沿模型无一达到专家交付水平
前置知识
运筹学(Operations Research, OR)
用数学建模(线性/整数规划、网络流、车辆路径、排产调度等)求解工业决策问题的学科。真实 OR 项目流程包括需求获取、问题建模、算法选型、求解器实现与验证交付。Gurobi 2024 行业报告显示 82% 的从业者持有硕士或博士学位,专业门槛极高。
本文核心问题是 LLM 能否完成 OR 专家从原始商业材料到可执行方案的全流程工作,理解 OR 项目的真实形态才能明白基准为何这样设计。
LLM 编码智能体(coding agent)
以大语言模型为核心、在终端与文件系统环境中自主工作的系统:能写代码、调用求解器、读取执行日志并迭代修复,代表如 Claude Code、Codex。本文将其作为统一评测载体,并通过 Bash 命令 ask 与客户模拟器 ORSim 交互。
OR-License 评测对象正是这类智能体而非单轮问答模型,结果反映的是跨数小时的长程自主工作能力。
严格可行性与隐藏验证器
优化问题中可行解指满足全部硬约束的决策。本文为每个官方测试用例配备隐藏的程序化验证器 $\mathrm{verifier}_{i,c}(y)$,逐一校验提交决策的硬约束与决策变量间关系;任何一个用例失败,整个实例即记为不可行。
严格可行性是 DAQ 指标的门控条件,理解它才能明白为什么所有模型的得分都被不可行交付大幅拉低。
幂平均(power mean)
一组数的广义平均,本文形式为 $\mathrm{DAQ}_\alpha=\left(\frac{1}{N}\sum_i Z_i^{1/\alpha}\right)^\alpha$。$\alpha=1$ 退化为算术平均;$\alpha$ 越大,低分个体对总分的拖累越强,用于检验模型排名对惩罚低分的敏感度。
论文在 $\alpha\in[1.0,3.0]$ 的 21 个档位上构建可靠性-质量曲线,验证 11 个模型排名的稳定性,这是理解主结论的关键。
组合优化与求解器实现
车辆路径、生产计划、裁剪下料等真实 OR 任务多为 NP 难组合优化问题,专家需选用 Gurobi 等求解器或自设计启发式,把业务规则翻译成约束与目标函数,再实现为可执行代码并核对测试用例。
基准中 10 类问题都要走'建模—实现—验证'链条,论文的失败模式分析(约束、状态转移、目标函数等八类错误)正是围绕这条链展开。
研究动机
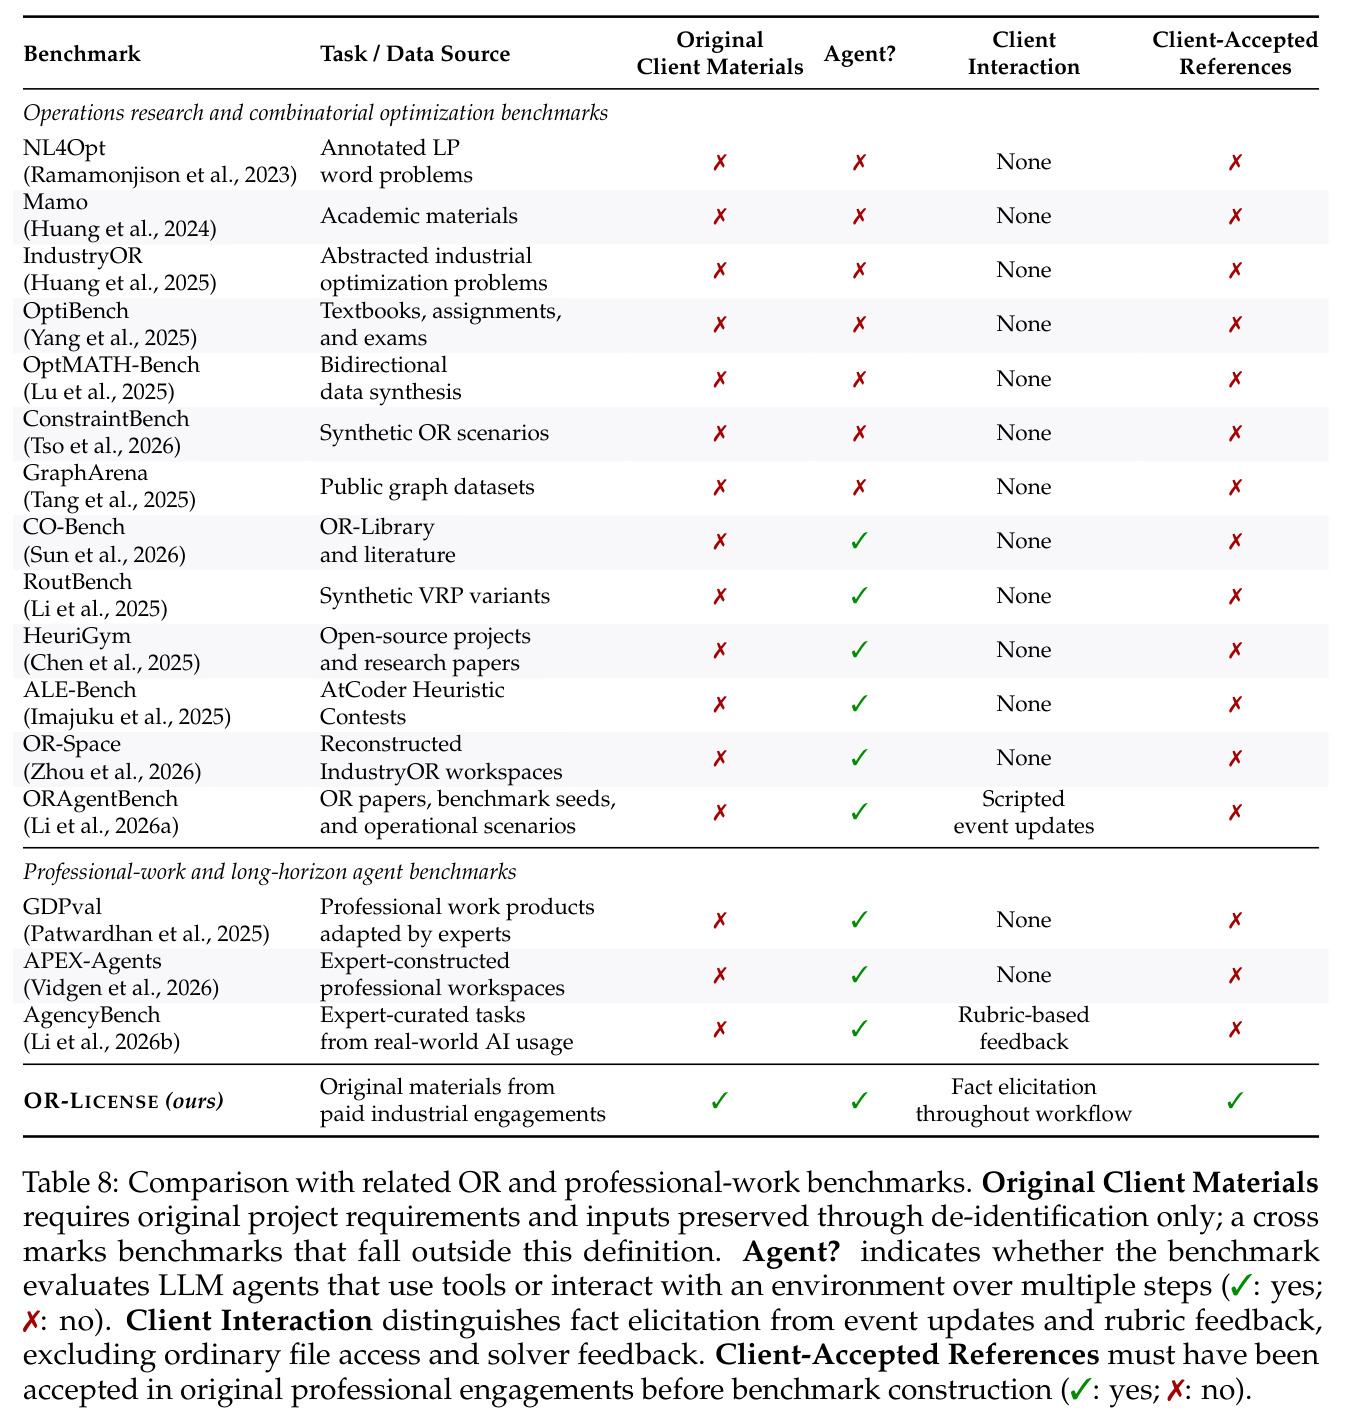
现有 LLM 运筹学评测存在三个系统性缺口。其一,任务来源失真:OptiMUS、ORLM、ReSocratic、OptMATH 等工作多用学术题目、合成数据或重构任务,掩盖了真实客户项目中需求模糊、数据格式杂乱、术语不统一的操作复杂性。其二,信息获取环节缺失:多数基准直接给出自包含的完整题面,把'从客户材料中识别缺失信息并主动询问'这一真实项目必备环节排除在外,GDPval 的作者也公开承认这一局限。其三,参照系缺乏专业锚点:评测多用基准构建者自己写的参考答案和内部校验,而非真实交付中已被客户接受的专家方案。与此同时,真实 OR 交付门槛极高——Gurobi 2024 报告显示 82% 从业者持有硕士或博士学位,单个项目费用在 6.71 万至 13.16 万美元之间。在简化任务上刷出的高分,无法回答'LLM 智能体能否接下真实付费 OR 项目'这一核心问题。
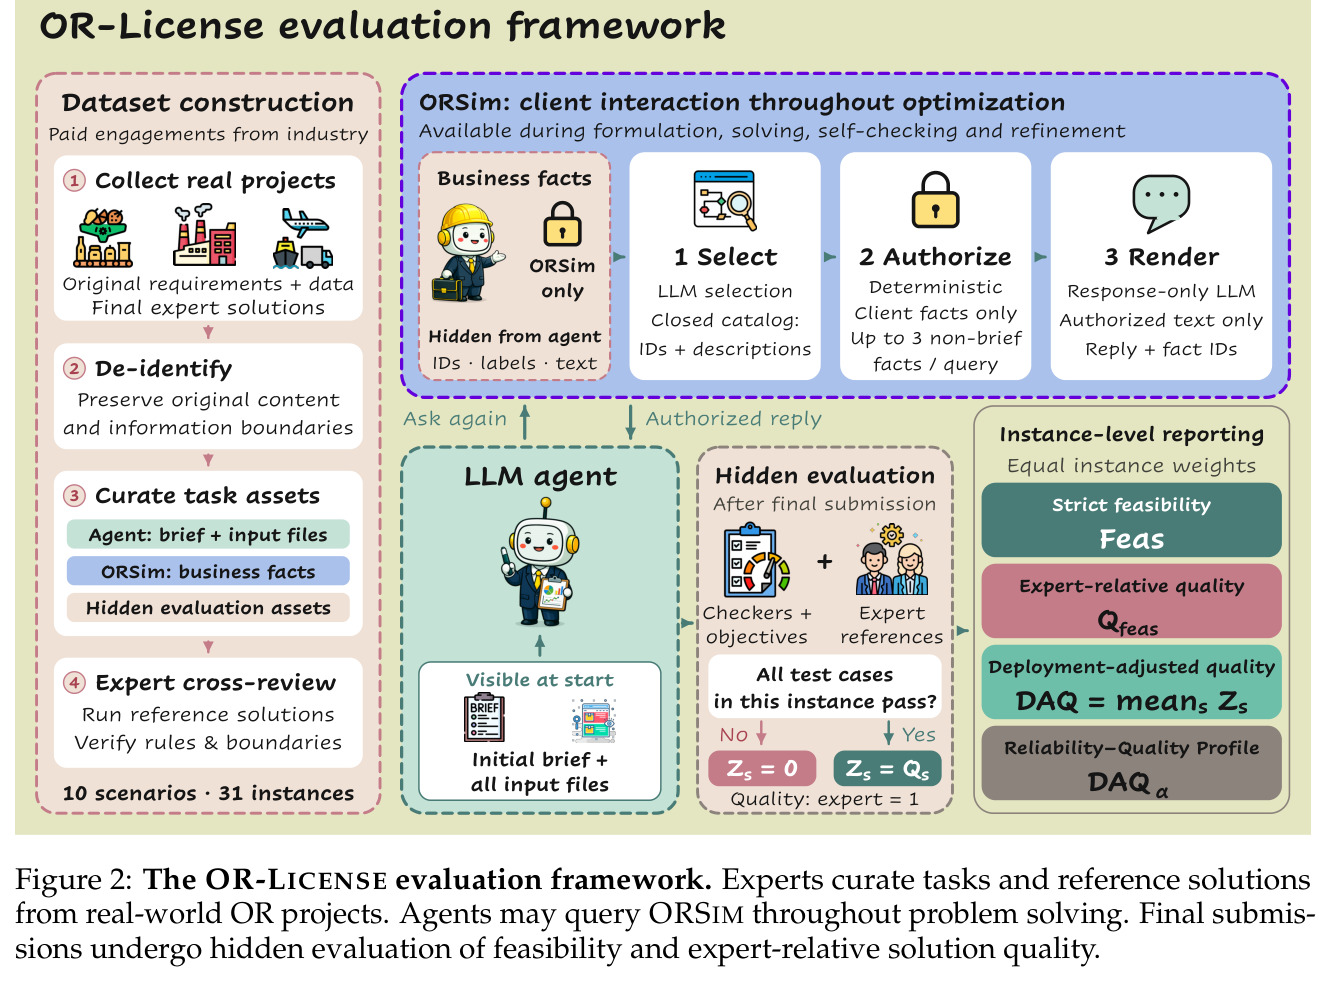
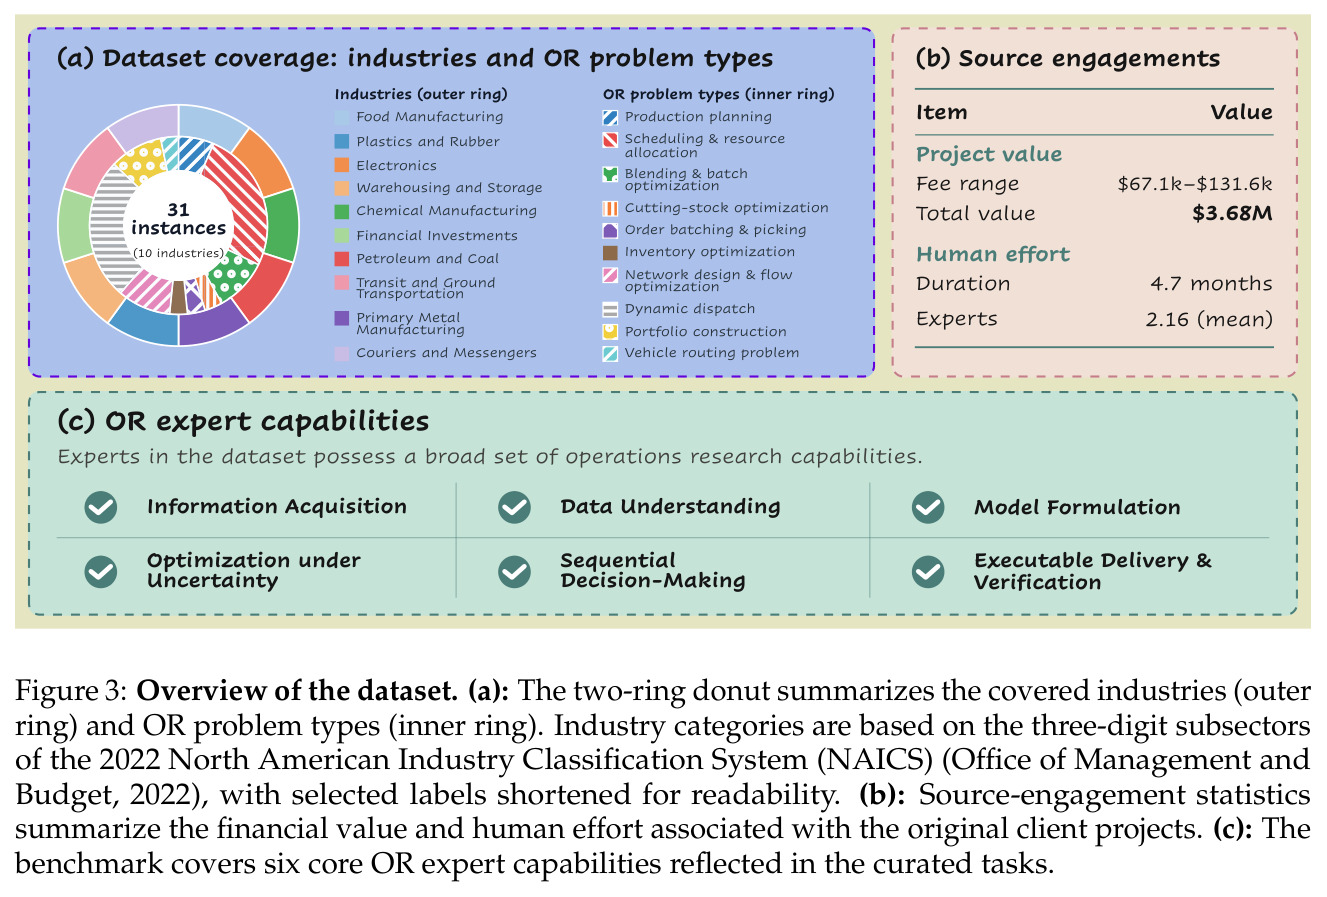
本文的目标是本文构建端到端基准 OR-License,直接检验 LLM 智能体能否像 OR 从业者一样从原始客户材料出发交付专家级方案。具体目标分三层:数据上,从总价值 368 万美元的真实付费 OR 项目中精选 10 个行业场景、31 个实例,去标识化后保留原始需求文档、输入数据、交付格式和信息边界;交互上,提供 ORSim 客户模拟器,让智能体在建模、求解、自查、修正全流程中都能向'客户'查询业务事实,但模拟器只透露客户掌握的信息、绝不提供 OR 专业知识;评测上,以客户验收过的原始专家方案为参照,由隐藏验证器逐一检查严格可行性并独立重算目标函数值,用部署调整质量 DAQ 汇总得分——不可行交付记零分。最终回答三个问题:模型与专家差距多大(RQ1)、信息获取发生在何时(RQ2)、失败模式是什么(RQ3)。
与已有工作不同的是,本文的独特之处在于把'真实商业交付'作为基准设计的第一性原理而非事后包装。三个切入角度均是新的组合:第一,数据不是改编题而是真实付费项目原件,只做去标识化,保留需求中的模糊性、信息边界与交付物格式,并以客户验收过的原始专家方案为参照,这是首个有真实商业效力背书的 OR 基准;第二,把信息获取从'开局问答'扩展到'全生命周期',ORSim 允许智能体在写求解代码前(S1)、看到求解反馈后(S2)、生成首个候选解前(S3)、形成完整候选解前(S4)、自查通过前(S5)、最终提交前(S6)六个阶段随时提问,并记录提问时点与问题是否真正解决;第三,DAQ 指标刻意模拟部署现实——方案不可行再好的目标值也是零分,由此把'完成可行交付'与'可行解上优化目标'两个能力维度分开计量。轨迹层面还引入 HCAEU 科研链标注,把'假设—解释—实验—证据—更新'的探究行为量化为可比较的指标。
核心方法
OR-License 的整体思路是'真实项目 + 可控客户 + 隐藏评测'三件套。直觉上,它复刻一个 OR 外包项目的完整生命周期:智能体扮演承接方,拿到去标识化的业务简报和输入文件;客户(ORSim)持有额外业务事实,只在被问到且属于客户知识范围时透露;后台专家则握有验证器和参照方案,等智能体提交后统一裁决。技术上分四步:任务形式化把每个实例定义为在决策空间 $\mathcal{Y}_{i,c}$ 上最大化 $\sigma_i f_{i,c}(y)$ 且需通过隐藏验证器的优化问题,$\sigma_i\in\{+1,-1\}$ 区分最大化/最小化;数据构建由至少三年专业经验的 OR 专家完成去标识化与资产整理,并交叉审查需求、评测器、参照解三者一致;ORSim 采用'选择 LLM → 确定性控制器 → 渲染 LLM'三段式架构,每次查询最多披露 3 条非简报事实;评测对每个模型-任务对跑 5 次运行,以 Claude Code 为主评测壳(另有 Codex 壳对照于附录 D.7),ORSim 通过 Bash 命令 ask 暴露给智能体。
核心创新是信息边界的程序化执行。ORSim 把'谁能说什么'与'怎么措辞'彻底解耦:模拟器侧选择 LLM 只负责从封闭事实目录(仅有 ID 和描述,对被测智能体不可见)中语义检索候选事实;确定性控制器校验所有权、可见性与每查询披露上限(至多 3 条非简报事实);响应式 LLM 拿到已授权文本后只做自然语言渲染,无权决定披露什么——语义匹配的灵活性与信息边界的严格性由此兼得。第二个关键设计是参照系锚定:专家参照不是为评测新写的,而是基准构建前就被真实客户接受的原始交付,使'专家 = 1'的质量刻度有商业含义。第三是 $\mathrm{DAQ}=\mathrm{Feas}\times Q_{feas}$ 的分层结构:质量 $Q_i$ 对最小化实例取 $J^{expert}_i/J^{agent}_i$、最大化实例取 $J^{agent}_i/J^{expert}_i$,等于 1 即打平专家;不可行实例置 $Z_i=0$。再用幂平均族 $\mathrm{DAQ}_\alpha$ 检验排名对低分惩罚的鲁棒性。
方法步骤详情
第一步,任务定义:场景 $s$ 对应一个行业,含若干实例,各有决策结构、业务规则、目标与测试用例集 $\mathcal{C}_i$;智能体收到业务简报和全部输入文件,需为每个用例产出可执行决策 $\hat{y}_{i,c}$。第二步,数据构建:资深 OR 专家从付费项目中整理出 10 场景 31 实例(单项 6.71–13.16 万美元,均值 2.16 名专家、4.7 个月),去标识化后撰写简报、标注可披露客户事实并交叉审查一致性。第三步,ORSim 交互:智能体随时用 ask 命令提问,选择 LLM 从封闭目录检索、控制器校验披露规则(每次至多 3 条非简报事实)、渲染 LLM 生成回复。第四步,隐藏评测:验证器逐用例检查 $F_i=\mathbb{1}[\forall c,\ \mathrm{verifier}_{i,c}(\hat{y}_{i,c})=\mathrm{pass}]$,目标值独立重算折算为相对专家的 $Q_i$,实例等权平均出 Feas、$Q_{feas}$ 与 $\mathrm{DAQ}$。第五步,轨迹分析:提问归入 S1–S6 六阶段,标注 HCAEU 科研链完成度,错误按八类归类。
技术新颖性
与已有工作的本质区别有三。对 OptiMUS、ORLM、ReSocratic、OptMATH、ARS 等建模增强路线:它们的输入是自包含题面,OR-License 则把'读懂不完整的商业材料'本身作为被测能力,保留原始需求的歧义与术语。对 OR-Space、ORAgentBench 等多阶段智能体基准:后者虽扩展到多文件可执行环境和多步流程,但任务仍是重构的、参照解非真实交付;OR-License 的 31 个实例全部来自客户付费并验收的项目(总额 368 万美元),质量参照有商业效力背书。对 GDPval、APEX-Agents、AgencyBench 等职业工作基准:它们覆盖面广但承认信息获取环节缺失;ORSim 首次把'客户事实'与'OR 专业知识'的所有权边界做成可审计的程序规则,并把提问行为本身(时点、是否解决真问题)作为评测对象。指标层面,DAQ 的零分门控与 $\alpha\in\{1.0,1.1,\dots,3.0\}$ 的 21 档幂平均曲线把'交付可靠性'从'优化强度'中剥离,是部署导向评测的一个方法论贡献。
实验结果
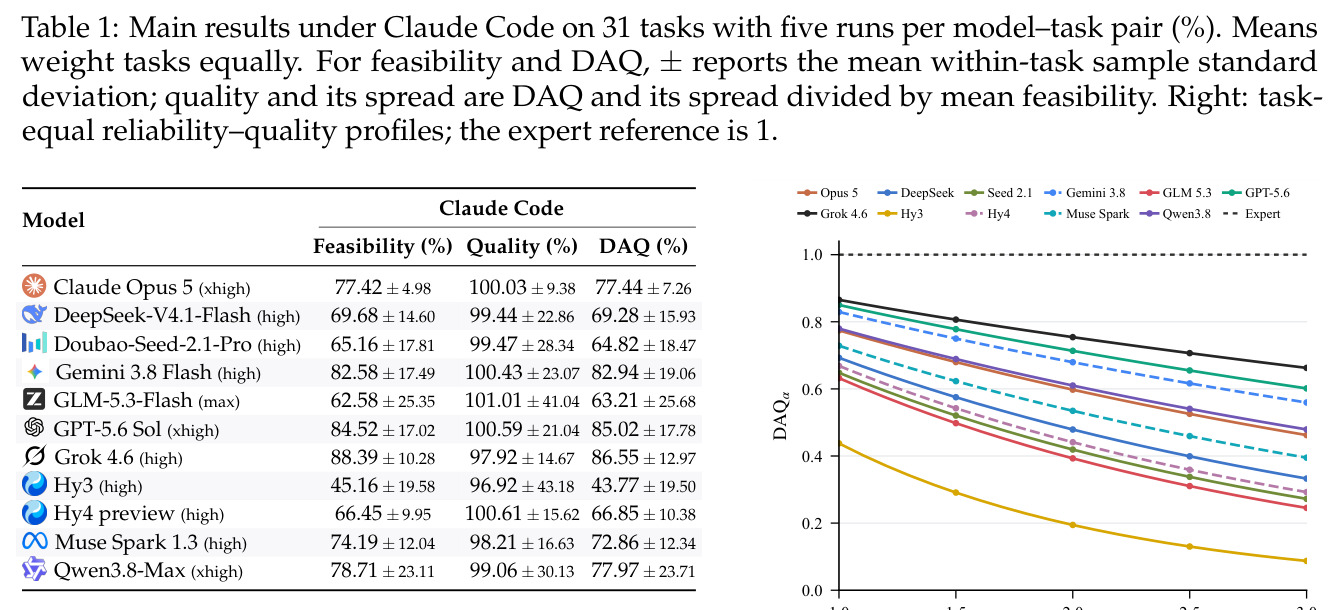
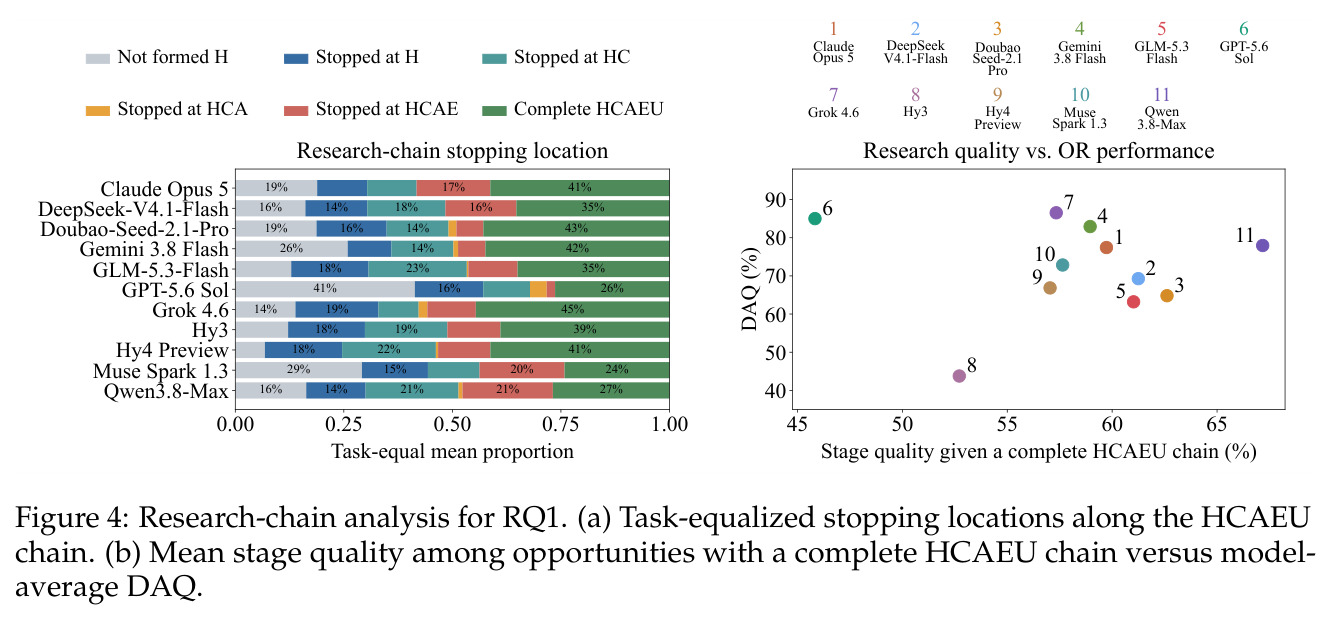
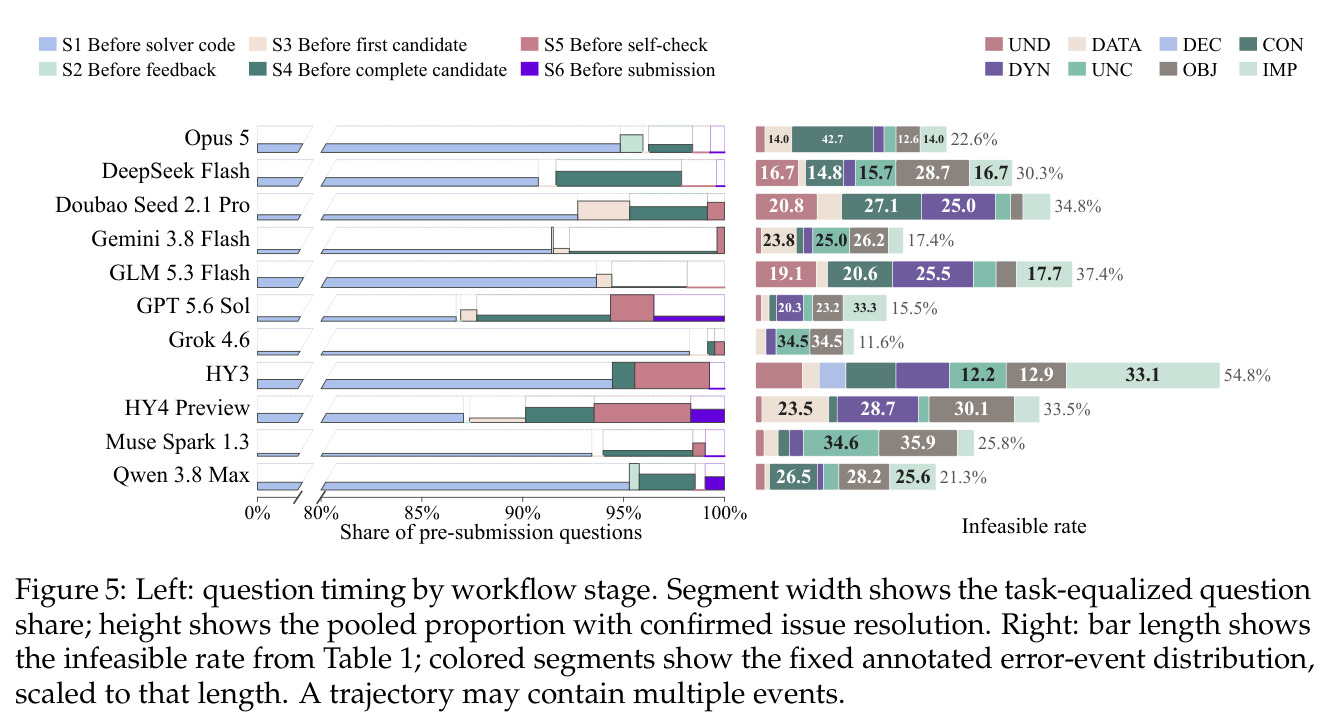
RQ1:11 个模型(Claude Code、每任务 5 次)可行性跨度 43.23 个百分点(Hy3 45.16% 至 Grok 4.6 88.39%),可行解条件质量仅差 4.09 个百分点(96.92%–101.01%)——差距在能否完成可行交付而非优化强度。5 个模型条件质量超专家 100%(GLM-5.3-Flash 达 101.01%),但 DAQ 无一达标:最高的 Grok 4.6 仅 0.8655,13.45 分缺口中 11.61 分来自不可行交付零分、仅 1.84 分来自目标差,约 86% 失分源于交付失败;$\alpha$=1.0–3.0 的 21 个惩罚档位上排名完全不变。HCAEU 科研链完成率仅 24%(Muse Spark 1.3)至 45%(Grok 4.6);GPT-5.6 Sol 有 41% 的研究机会未形成假设。RQ2:提问高度前置,S1 占提问的 86.7%–98.3%,确认解决率仅 10.6%–37.0%;后期提问更有效,DeepSeek-V4.1-Flash 在 S4 达 56%,Hy4 Preview 在 S5 达 71%。RQ3:实现类错误(IMP)仅在 2/11 模型居首;Claude Opus 5 的 CON 类错误占 42.7%,Grok 4.6 与 Muse Spark 1.3 的 OBJ+UNC 错误合计 69.0% 与 70.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 端到端 OR 交付(31 实例,Claude Code 主壳,5 次运行) | DAQ(部署调整质量,专家=1) | 最强模型 Grok 4.6 达 0.8655 | 客户验收的人类专家参照 1.0 | 仍落后专家 13.45 分,其中 11.61 分来自不可行交付零分 |
| 严格可行性(全部官方用例通过隐藏验证器) | Feas(任务等权百分比) | Grok 4.6 最高 88.39%,最低 Hy3 45.16% | 专家参照 100% | 无模型全可行,跨度 43.23 个百分点 |
| 可行解目标质量(仅计可行实例) | Qfeas(相对专家目标,100%=打平) | GLM-5.3-Flash 101.01%、Gemini 3.8 Flash 100.43%、Hy4 Preview 100.61% 等 5 个模型超 100% | 客户验收专家方案 100% | 条件质量已追平甚至反超专家,但被可行性门控大幅拉低 |
| 证据链科研完成率(HCAEU 全链) | 任务均权完整链比例 | Grok 4.6 最高 45% | 理想值 100% | 全部 11 个模型低于 50%,最低 Muse Spark 1.3 仅 24% |
| 客户信息获取时序与问题解决 | 各阶段提问占比与确认解决率 | S1 占提问 86.7%–98.3%,S1 解决率仅 10.6%–37.0% | 后期提问解决率 S4 约 56%、S5 约 71% | 后期提问更有效但模型极少使用,存在行为错配 |
局限与改进
作者承认的局限包括:实例规模只有 31 个、10 个行业,统计功效有限,表中 ± 报告的是任务内样本标准差而非基准均值的标准误;条件质量按模型各自的可行子集计算,超过 100% 的分数不能直接跨模型比较优化能力;轨迹标注依赖人工的三档评分,主观性难免。我的补充观察:其一,去标识化可能改变任务难度与信息结构,真实项目里客户-承包商的多轮谈判、预算与组织政治被简化为事实目录;其二,ORSim 的选择-控制-渲染架构虽严谨,但选择 LLM 的语义检索质量会影响'该问的能不能问到',其可靠性评测放在附录,主结果对 ORSim 缺陷的敏感性需读者自行判断;其三,DAQ 把不可行记零分符合部署直觉,但也使指标几乎被可行性主导,模型在求解算法上的精细差异(条件质量仅差 4.09 分)被压缩,主表也未提供与经典 OR 求解器或启发式算法基线的对照;其四,每模型-任务仅 5 次运行,面对高达 ±25% 的任务内波动,部分相邻排名的置信区间很可能重叠。
独立分析的弱点
独立分析四个弱点。第一,可行性天花板效应:最强模型已到 88.39%,剩余失败可能集中于少数最难实例(如动态调度、不确定优化),实例等权的均值会掩盖'某几类问题全军覆没'的结构性短板;改进方向是按问题类型与错误类别分层报告通过率,目前 Figure 5 右图只给事件占比、未给分类通过率。第二,ORSim 单向披露:客户只会回答、不会主动追问或中途变更需求,真实项目的需求蠕变与目标冲突完全缺席;改进方向是加入需求演化事件,测试智能体在规格变更下的重规划能力。第三,科研链标注只覆盖'可见的'研究机会,GPT-5.6 Sol 未形成假设的 41% 既可能是能力不足、也可能是问题确实无需探究;改进方向是做消融实验——若强制智能体执行 HCAEU 流程,DAQ 是否显著提升,把相关性升级为因果。第四,成本-质量权衡缺席:正文比较完全不看费用,Grok 4.6 拿到 88.39% 可行性若花 10 倍 token,部署结论会完全不同;改进方向是报告 DAQ/token 或 DAQ/美元的帕累托前沿,让不同预算的团队各取所需。
未来方向
作者在结论中指出的方向:可靠的远程 OR 智能体需要持续的信息缺口识别——当中间求解结果或执行反馈显示业务假设可疑时,主动回头向客户求证,并把新事实纳入经过验证的修正;以及证据链接的自我改进——让 HCAEU 链中的'更新'真正落到模型或代码上,而不是停在解释层面。基于本文成果还可延伸:其一,把 31 实例的轨迹数据变成训练信号,用过程奖励模型给 HCAEU 各环节打分,做拒绝采样或强化学习微调,直接优化确认问题解决率;其二,扩展情境覆盖:加入需求变更、多方利益冲突、数据质量陷阱等更阴暗的真实因素,并纳入超大规模实例以测试求解器工程极限;其三,方法论迁移:ORSim 的'事实所有权 + 程序化披露边界'范式可推广到法律尽调、医疗问诊、软件需求澄清等专业领域,DAQ 的零分门控思想适用于任何'可用性先于优良性'的交付型任务;其四,把可靠性-质量曲线发展成模型选型工具,按业务对最差情况的容忍度选取惩罚指数 $\alpha$,而非只看单一均值。
复现评估
复现难度中等偏上。开源方面:论文首页给出 Website、Code、Dataset 三个入口,31 个实例的去标识化素材(业务简报、输入文件、交付格式)应随数据集发布;但按协议隐藏验证器与专家参照解必须保密,第三方无法完整重建评测裁决环节,只能依赖官方榜单复核。算力方面:无需训练、纯推理评测,但规模不小——11 个模型 × 31 任务 × 5 次 = 1705 次智能体运行,每次都是含求解器执行的长程编码会话,附录 D 记录了各智能体的平均成本,用商业 API 复现主表预计需数千至上万美元推理开销;本地部署 DeepSeek-V4.1-Flash、Qwen3.8-Max 等开源模型还需多卡推理集群。工程方面:需要搭建 Claude Code/Codex 评测壳、ORSim 服务(选择与渲染两个 LLM 加确定性控制器)和答案校验管道。对普通研究者,跑单模型单任务是可行的;完整复现 11 模型主表则预算敏感;HCAEU 与八类错误的人工标注部分依赖作者方案,第三方重复需重新培训标注员并报告一致性。
论文图表
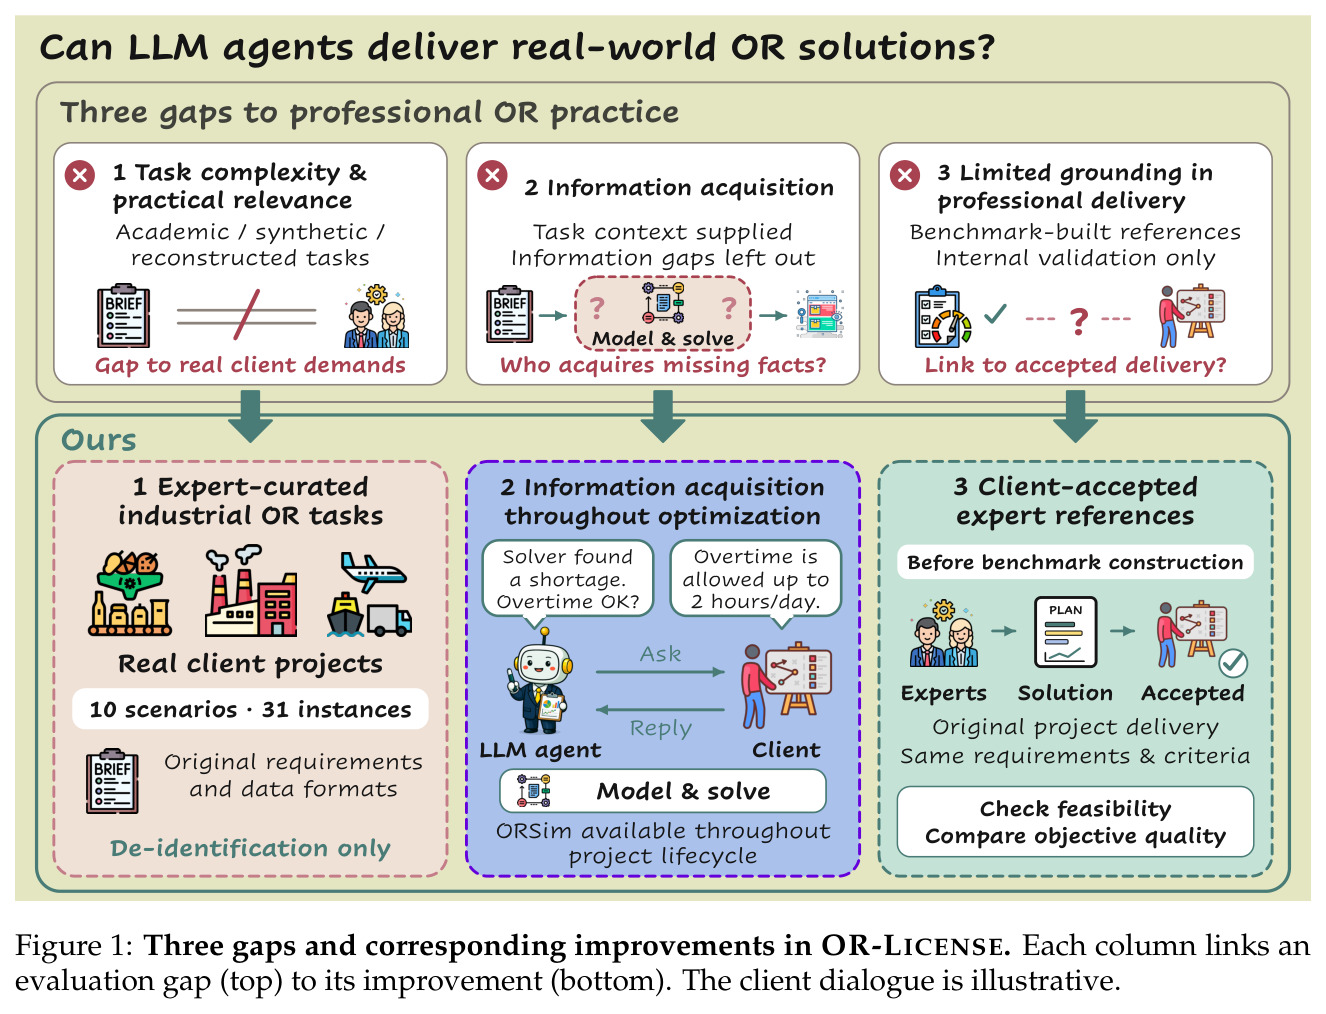
三列对照图:上排是现有评测的三个缺口(任务复杂度与实践相关性——学术/合成/重构任务;信息获取——任务上下文直接给定;专业交付锚定缺失——基准自建参照、仅内部校验),下排是 OR-License 的对应改进(专家精选的工业 OR 任务、覆盖优化全流程的 ORSim 信息获取、构建基准前已被客户接受的专家方案原件),并配了'加班是否被允许'的客户对话示意,直观展示智能体提问、客户回复的交互模式。
一图读懂论文的动机结构与三大贡献的对应关系,是理解全文逻辑的入口。