超越估计:用维纳统计结构简化像素空间流模型的训练 Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models
把维纳估计的计算结构而非估计值本身做成可训练解码通路,加速像素空间流模型训练
前置知识
流匹配与速度场(Flow Matching / velocity field)
流匹配训练一个网络 $v_\theta(z_t,t)$ 来学速度场:数据 $x$ 与高斯噪声 $\epsilon$ 按线性插值 $z_t = tx + (1-t)\epsilon$ 混合,监督目标是真实速度 $v = x - \epsilon$,训练损失为 $\mathcal{L}_{FM} = \mathbb{E}\|\hat v_\theta - (x-\epsilon)\|_2^2/d$。相比扩散模型路径更直、采样更快;像素空间版本直接在 RGB 像素上运行,不需要预训练 VAE。
本文全部建立在速度目标之上:冻结维纳基、WiD 的统计通路和像素头预测的都是这个速度场,不懂 $z_t$ 与 $v$ 的定义就看不懂所有公式。
维纳估计(Wiener estimator)
经典线性最小均方估计:若 $x\sim\mathcal{N}(\mu_x,C_x)$、$\epsilon\sim\mathcal{N}(\mu_\epsilon,C_\epsilon)$,观测 $z=\alpha x+\beta\epsilon$,则闭式解 $E[x|z]=\mu_x+\alpha C_x C_z^{-1}(z-\mu_z)$。对图像用非中心化二阶矩 $\tilde M=E[xx^\top]$ 可得解析速度估计 $V_W(z_t,t)=\tilde A_t(\tilde M)z_t$,其中 $\tilde A_t(C)=tC-(1-t)I\,(t^2C+(1-t)^2I)^{-1}$。
它是全文统计先验的来源:冻结基、WiD 的可训练维纳通路、诊断时用的解析响应,全部由这一个闭式估计构造出来。
DCT 与 patch PCA(结构化二阶统计基)
两种把全图 $(3\times 256^2)^2$ 规模矩矩阵压缩到 $768^2$ 条目的实用构造:全局 DCT-II 在每个频率只保留 3×3 的 RGB 二阶矩(忽略跨频率耦合);共享 patch PCA 对所有 16×16 RGB patch 池化,特征分解共享的 768×768 矩阵得到正交基 $U_0$ 和谱 $\lambda_0$,每个 patch 复用。
论文用这两种基验证统计先验的通用性,WiD 的实现选择 patch PCA,因为它与像素解码器工作在同一 patch 空间,方便做系数接口。
像素解码器架构(PixelDiT / DeCo)
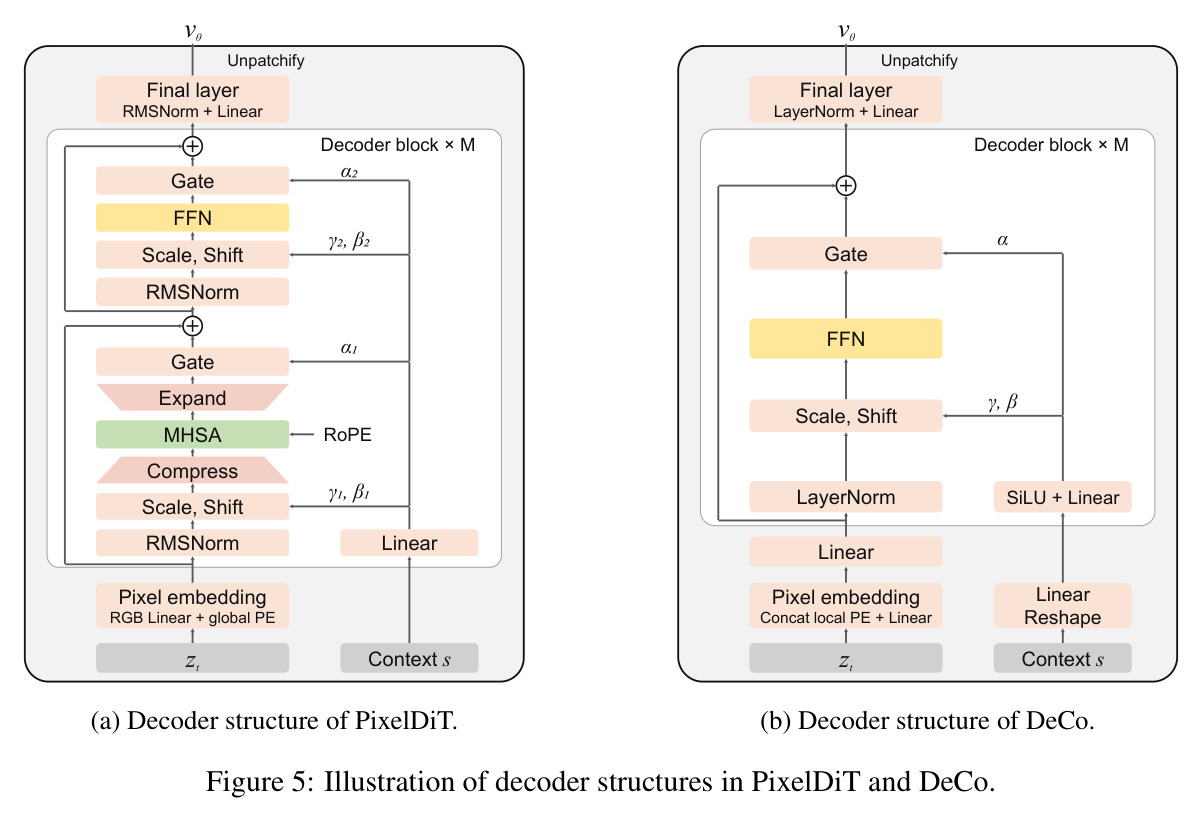
把去噪网络拆成两部分:上下文主干 $B$ 提供语义条件特征 $s=B(z_t,t,y)$,像素解码器 $D$ 把含噪像素映射为速度 $\hat v=D(z_t,s)$。PixelDiT 解码器内部是带 Compress/Expand 的 MHSA+FFN 块(RMSNorm、QK 归一化、全局位置编码),DeCo 解码器主要是上下文 Scale/Shift/Gate 调制的 MLP。
WiD 的接入点就是这个 $B$-$D$ 接口:统计坐标注入 $D$ 的输入嵌入、系数修正从 $D$ 的输出返回,理解接口才能理解方法挂在哪、为何不动主干。
REPA 表示对齐
一种加速扩散/流模型训练的辅助损失:把去噪网络某一中间层的表征线性投影后,与冻结的 DINOv2-B 语义特征做对齐(本文权重 0.5),让网络表征更快获得语义结构,从而加快收敛。
主实验全部在 REPA 配方下进行,需要知道它是叠加在速度损失之外的额外目标;论文证明 WiD 与它正交且可叠加增益。
FID / GenEval / DPG-Bench 评测指标
FID 用 Inception 特征衡量生成分布与真实分布的距离(越低越好),类条件生成常配合 sFID、IS、precision/recall;GenEval 按单对象、双对象、计数、颜色、位置、属性等细粒度指令打分;DPG-Bench 用 1065 条 DALL-E 3 风格提示评测图文语义一致性,平均分越高越好。
论文所有量化结论都用这些指标表达:类条件看 FID-10K/50K 与最终 FID,文生图看 GenEval 总分与 DPG 平均分,读表时需知方向。
研究动机
像素空间流模型直接在 RGB 像素上学习速度场,省去了预训练自编码器,管线更简单,但学习本身又难又慢:去噪网络必须在高维(256×256×3 约 19.7 万维)含噪像素上同时学习自然图像的结构,优化缓慢且不稳定,Li & He (2026) 的 JiT 和 Ma et al. (2026) 的 DeCo 都明确指出这一点。最朴素的 plain DiT-B/16 速度预测在 ImageNet 256×256 上训练 40 epochs 后 FID-10K 高达约 220(Figure 1a),几乎不可用。现有改进分两条路:一是预测空间方法,改参数化目标让学习更容易,如 JiT 的干净图像预测、AsymFlow 的秩不对称速度预测;二是架构方法,把上下文建模与稠密像素预测分配给专门组件,如 DeCo 的频域解耦 MLP 解码器、PixelDiT 的像素 Transformer 解码器。但这些工作都只在『怎么参数化目标、怎么组织计算』上做文章,没有正面利用像素任务本身蕴含的先验:自然图像在空间和颜色上强相关,而加入的高斯噪声是各向同性的,这种不对称意味着存在一个闭式线性去噪器——维纳估计。此前统计估计只被用来分析已训练去噪器的行为(如 Wang & Vastola 2024 的高斯分数近似、Lukoianov et al. 2025 的局域性解释),从未被主动用于辅助训练。
本文的目标是本文的目标是一个训练问题:能否通过显式提供统计估计来简化像素空间速度学习?具体分三步递进。第一步,验证粗粒度的二阶统计是否足够:用 DCT 或共享 patch PCA 构造冻结的维纳基,给 plain DiT 提供一个解析速度基线,让网络只学残差(式 8),看能否救活失败的基线。第二步,诊断这些基的贡献机制:用 affine 拟合把预测误差分解为线性成分与剩余成分(式 9),检验冻结基是只提供了更好的线性起点,还是也帮助网络更有效地学习剩余的非线性预测;同时用 JVP 响应的余弦相似度检验解码器的哪条输入通路更接近维纳行为(式 10)。第三步,把估计背后的计算结构(统计坐标变换、噪声依赖增益、逆变换)作为可训练组件整合进像素解码器,得到 Wiener-informed Decoding(WiD),要求:不修改原生解码块、参数开销小(约 1%)、在原速度目标下联合训练、兼容 REPA、跨解码器架构有效,并最终在类条件与文生图任务上同时加速训练并提升生成质量。
与已有工作不同的是,本文的独特切入是一个视角转换:统计去噪器的作用『不止于估计值本身(beyond the estimate)』。此前统计工具在扩散/流研究中的角色是解释性的——分析学到的去噪器何时表现为线性高斯响应、局域性来自数据统计还是架构;而训练侧的改进(参数化、解码器架构、预条件化)都不碰统计先验。本文用三个诊断把两边接起来:(a) 冻结维纳基带来的误差下降,大部分发生在拟合线性成分之外(Figure 2a),说明基不只是外挂了一个线性答案,还改变了网络对剩余预测的学习方式;(b) 冻结基与原生像素解码给出相似但互补的增益,两者叠加仍有额外收益(Figure 2b);(c) 解码器的直接像素通路的 JVP 响应比语义通路更对齐维纳响应,且差距随训练扩大(Figure 2c),支持解码器是整合统计结构的自然接口。由此,方法从『把估计加到输出』推进到『用估计的计算结构去组织解码器内部的计算』——这与 EDM 等预条件化方法只做输入输出缩放也有本质区别。
核心方法
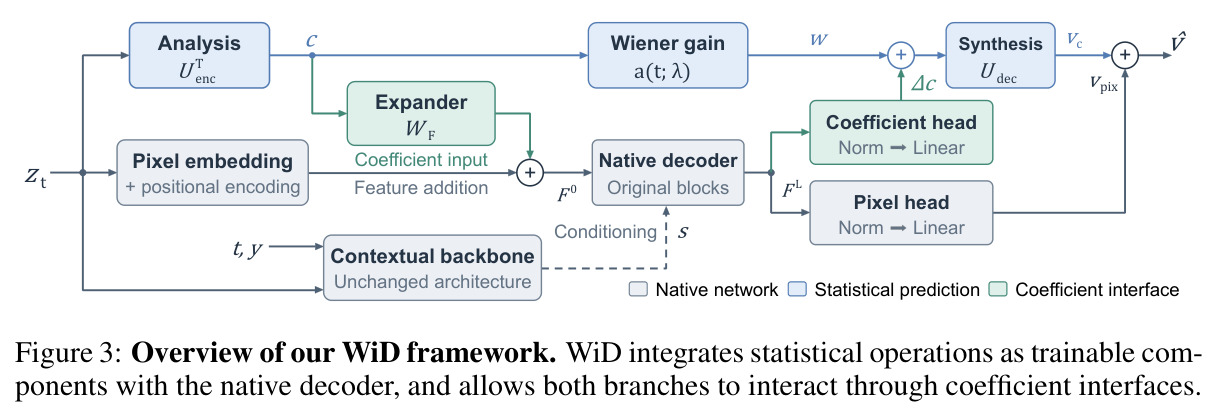
先说直觉:既然维纳估计 $V_W(z_t,t)=\tilde A_t(\tilde M)z_t$ 能从二阶统计免费算出一个速度的粗略答案,那就别让网络从零开始学,而是把它做成网络内部的一条『统计通路』,让网络在一个有意义的起点上学习修正。技术路线分三个组件(Figure 3)。其一,可训练维纳预测路径:实现上选共享 patch PCA 基(与像素解码器同处 patch 空间),分析变换 $U_{enc}$ 把每个含噪 patch $z_{t,i}\in\mathbb{R}^m$($m=3p^2=768$)变成统计系数,按噪声依赖增益 $a(t;\lambda)$ 逐系数缩放,再经综合变换 $U_{dec}$ 映回像素。其二,系数接口:增益前的同一份系数经线性扩展器 $W_F$ 注入解码器的原生像素嵌入,解码器除原生像素输出外还预测一份系数空间修正 $\Delta c$,三路求和为最终速度。其三,统计初始化:所有新增参数(含谱 $\lambda$ 和两个变换)用数据统计初始化,使初始总预测恰等于 patch PCA 维纳估计、初始特征与原解码器完全一致。全部参数在原速度损失下联合训练,不改动任何原生块,参数只增约 1%。
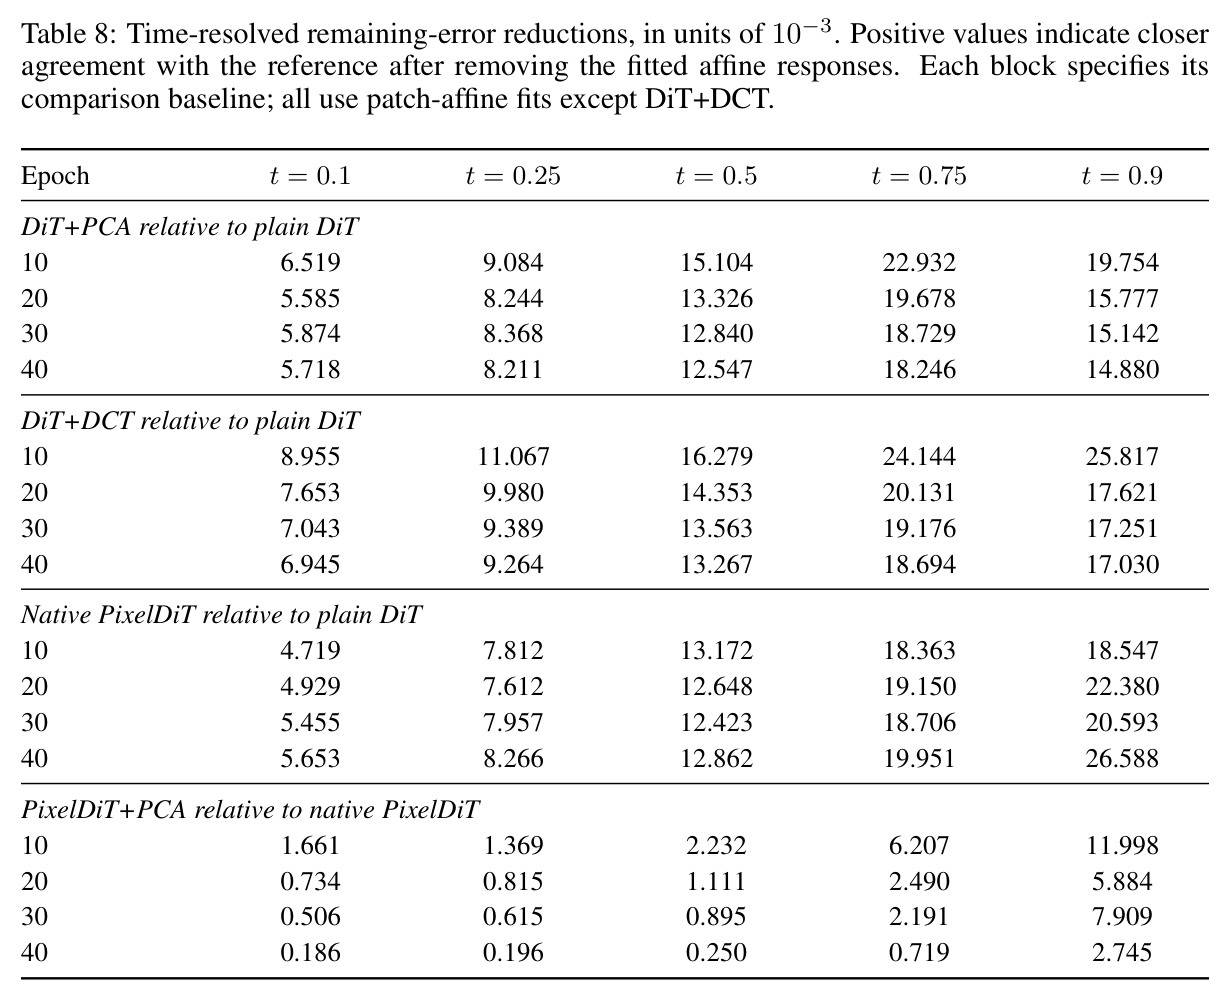
核心创新点可以概括为『从估计到计算组织』的跃迁,与已有方法的本质区别有三层。第一层区别于残差式用法:先前做法(以及本文自己的第一组实验,式 8)把冻结维纳估计加在网络输出上、网络补残差;但诊断表明误差下降的大头在拟合线性成分之外(Table 8),冻结基还帮助网络更有效地组织对剩余预测的学习——所以真正该复用的是估计背后的三步计算(分析变换、噪声级增益、综合变换),而不是它的输出。第二层区别于参数化与预条件化方法:JiT/AsymFlow 改预测目标、EDM/预条件流匹配改输入输出尺度,都会改变训练目标的形态;WiD 完全保留原生速度目标和原生解码块,只是给解码器注入一套可训练的统计坐标系,并通过双向系数接口(输入端特征注入 + 输出端修正返回)让统计坐标同时参与特征处理与速度预测。第三层区别于经典统计去噪的工程移植:BM3D、Deep Wiener Deconvolution 也把维纳操作嵌进可学习管线,但都用于复原任务;本文将其用于生成式速度学习,且变换与谱完全可训练、不施加正交或可逆约束,让统计结构随训练演化——这解释了 WiD 的增益比冻结基更持久(Figure 1c)。
方法步骤详情
方法完整流程如下。第一步,统计估计:从 51,200 张随机采样的 ImageNet 训练图(约占训练集 4%),用与训练完全相同的预处理(RGB center crop 到 256×256、缩放到 $[-1,1]$,无其他增广),估计所有非重叠 16×16 RGB patch 的共享 768×768 非中心化二阶矩 $\tilde M$,特征分解得基 $U_0$ 与谱 $\lambda_0$;单 GPU 配 12 个 DataLoader worker 只需约 1 分钟。第二步,初始化:$U_{enc}$、$U_{dec}$ 初始化为 $U_0$,谱在对数空间参数化、初始为 $\log\lambda_0$;系数修正头和原生像素输出投影零初始化;输入端把原 RGB 投影对半拆分,$E=0.5E_0$、$W_F=0.5\,L(E_0)U_0$($L$ 为 patchwise lift),保证 $L(E)z_{t,i}+W_F U_{enc}z_{t,i}^\top = L(E_0)z_{t,i}$(式 14),即初始特征与原解码器逐位一致、初始总预测等于 patch PCA 维纳估计,训练起点不劣化。第三步,前向传播(每个 patch $i$):分析得 $c_i = U_{enc}z_{t,i}$;维纳增益 $w_i = a(t;\lambda)\odot c_i$,其中 $a_j(t)=\frac{t\lambda_j-(1-t)}{t^2\lambda_j+(1-t)^2}$;统计预测 $U_{dec}w_i$。同时系数经 $W_F$ 展成宽度 $h$ 的像素级特征,与原生像素嵌入相加:$F_i^0=E(z_{t,i})+\mathrm{reshape}(W_F c_i)$,再经原生解码块 $T$ 与上下文条件 $s$ 得 $F^L=T(F^0,s)$。第四步,双头输出:系数头 $\Delta c_i = W_\Delta\,\mathrm{vec}(N_\Delta(F_i^L))+b_\Delta$($N_\Delta$ 归一化粒度跟随原生输出头),总预测 $\hat v_i = U_{dec}w_i + \Delta c_i + H_{pix}(F^L)_i$,即维纳分支预测 + 系数修正 + 原生像素预测三者之和。第五步,训练与采样:把各 patch 预测拼合,用原始速度损失 $\mathcal{L}_{FM}=\mathbb{E}\,\|\hat v_\theta(z_t,t,y)-(x-\epsilon)\|_2^2/d$ 监督两者之和,所有引入参数与网络联合训练;REPA 等辅助目标沿用原配方;采样时用同一个总速度场。
技术新颖性
技术新颖性体现在四个层面。其一,问题定位新:这是第一个把统计去噪器的『计算结构』而非『估计值』用于生成训练组织的工作,把维纳估计从分析工具升级为架构组件,呼应了 BM3D『变换—维纳滤波—逆变换』的计算组织思想但服务于流匹配训练。其二,诊断方法本身可复用:用 affine 拟合族(包含冻结基为零偏置特例)把预测误差分解为线性与剩余两部分(式 9),用去掉平行分量的 JVP 余弦相似度比较两条输入通路与解析响应的对齐度(式 10、17),这套『把网络响应对齐到解析响应』的分析框架对后续研究有独立价值。其三,接口设计精巧:系数接口是双向的——统计系数注入原生嵌入参与特征处理,解码器又返回系数空间的修正;配合守恒式初始化(输入特征恒等式 14、输出零初始化、初始预测=维纳估计),保证训练从原生配方的等价点出发、只会变好,这是它能无缝叠在 PixelDiT/DeCo 原配方上的关键。其四,参数化自由:$U_{enc}$、$U_{dec}$ 独立演化、不施加正交或互逆约束,谱在对数空间训练,让统计结构从数据先验出发随学习自适应,增益因此比冻结基更持久。开销极小:参数 +0.94%(797.38M→804.86M)、FLOPs +1.33%(311.19→315.32 GFLOPs)。
实验结果
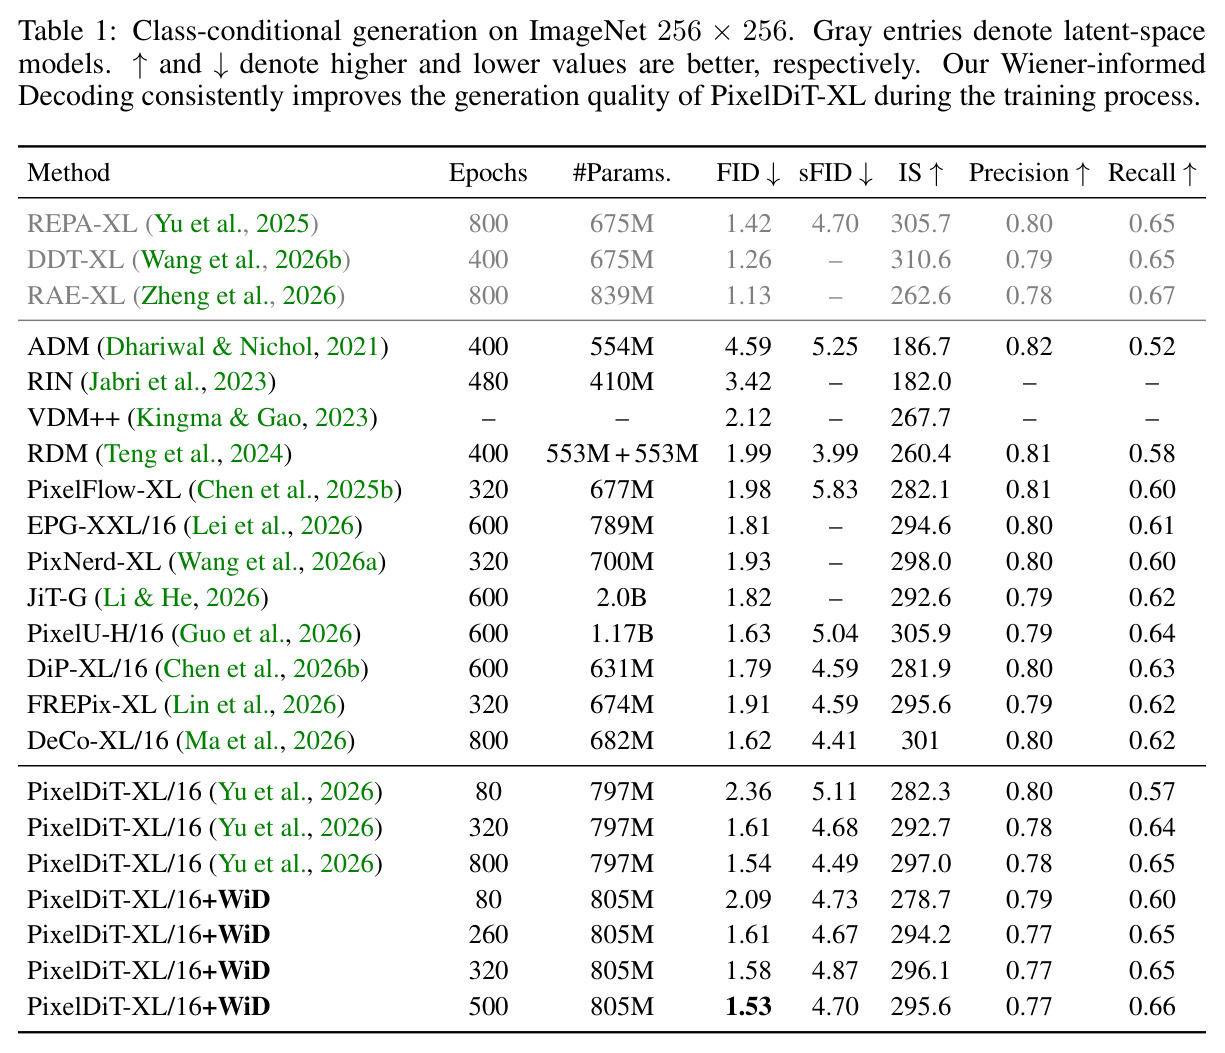
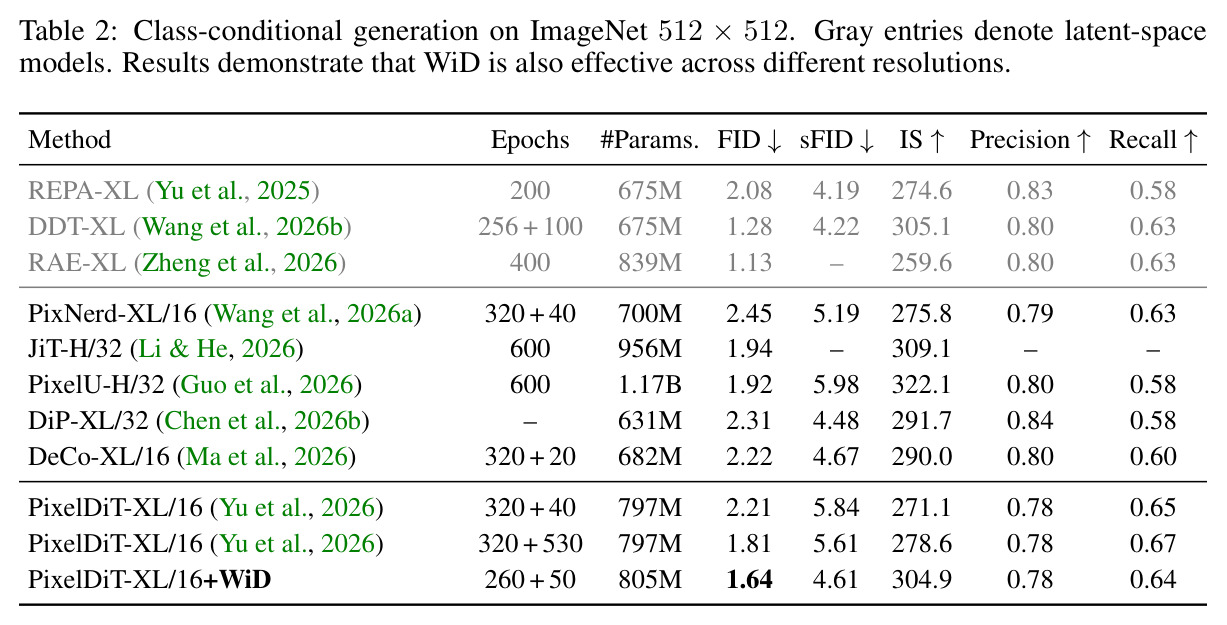
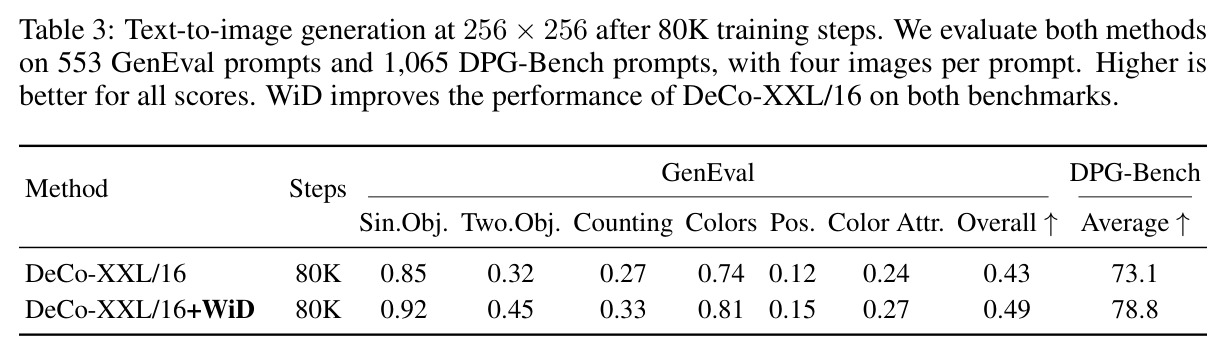
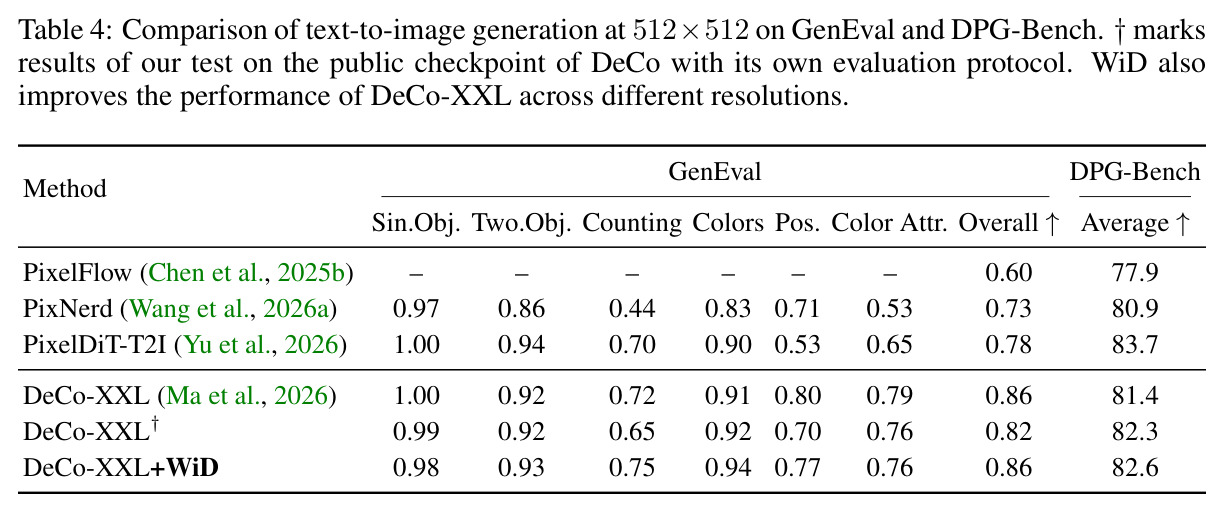
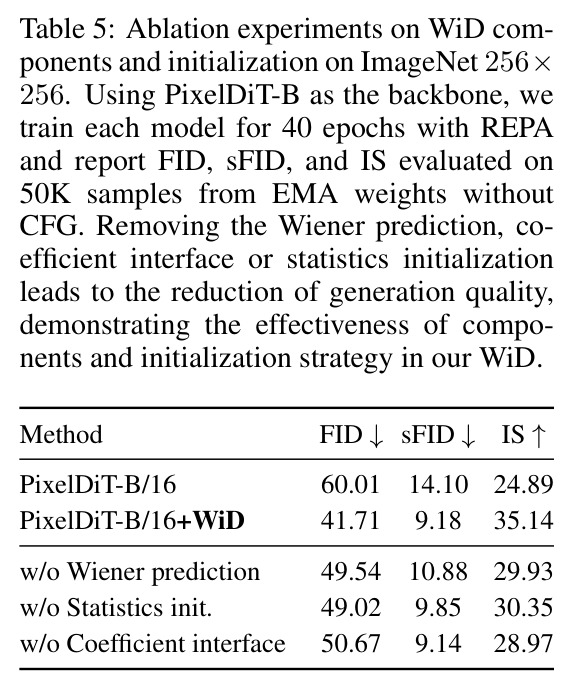
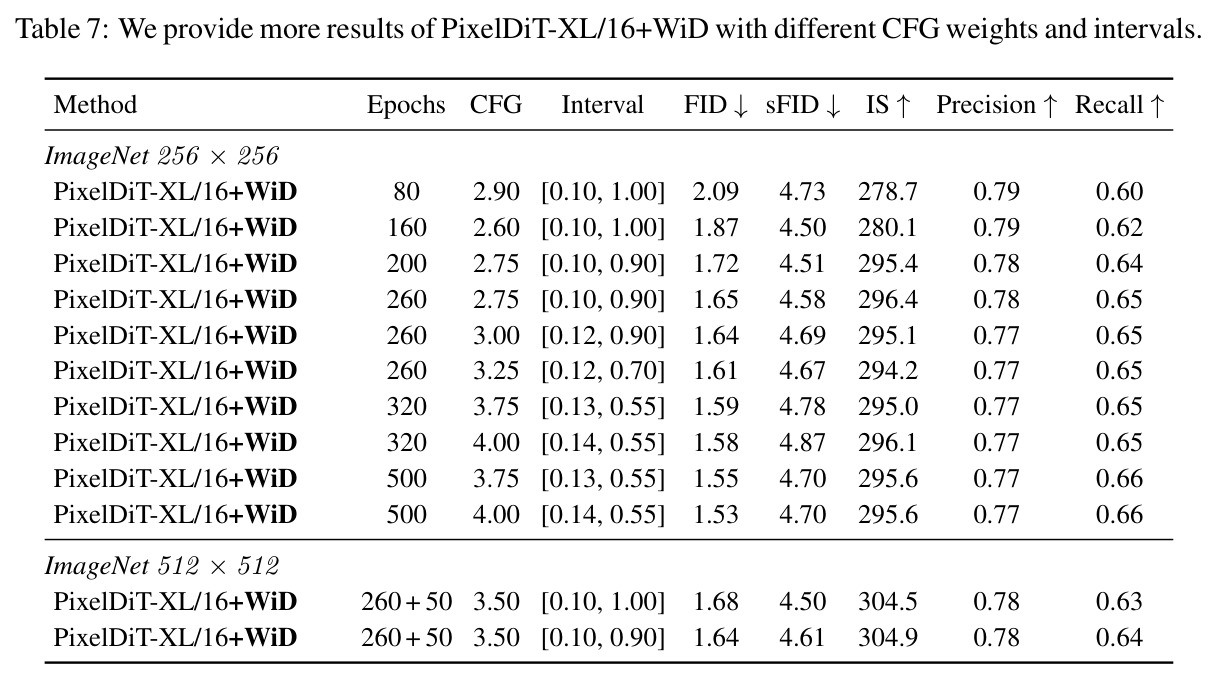
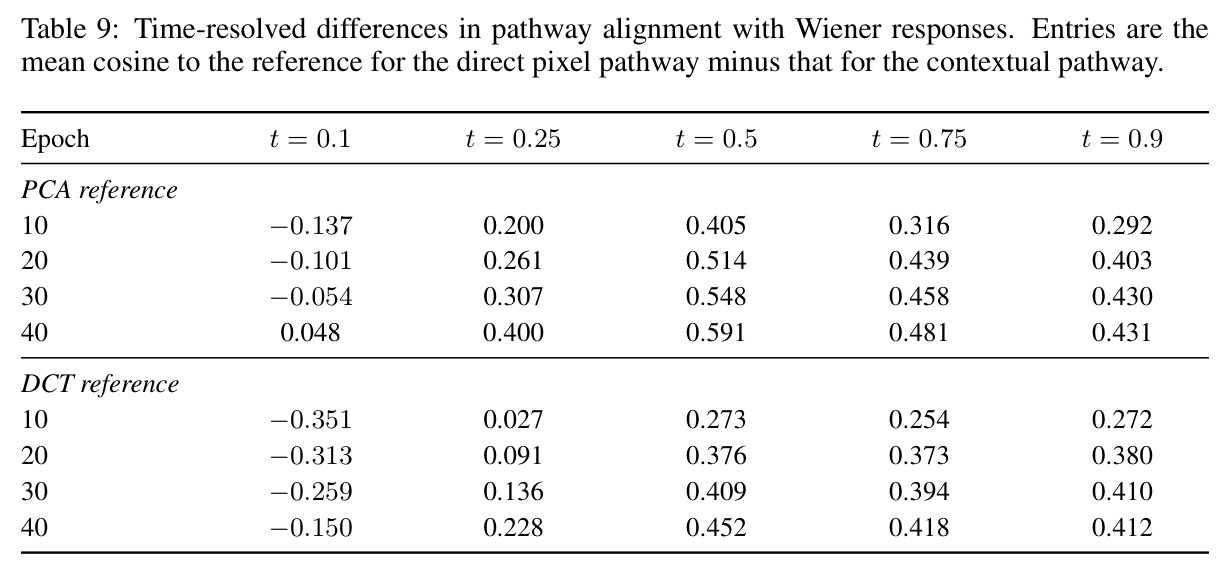
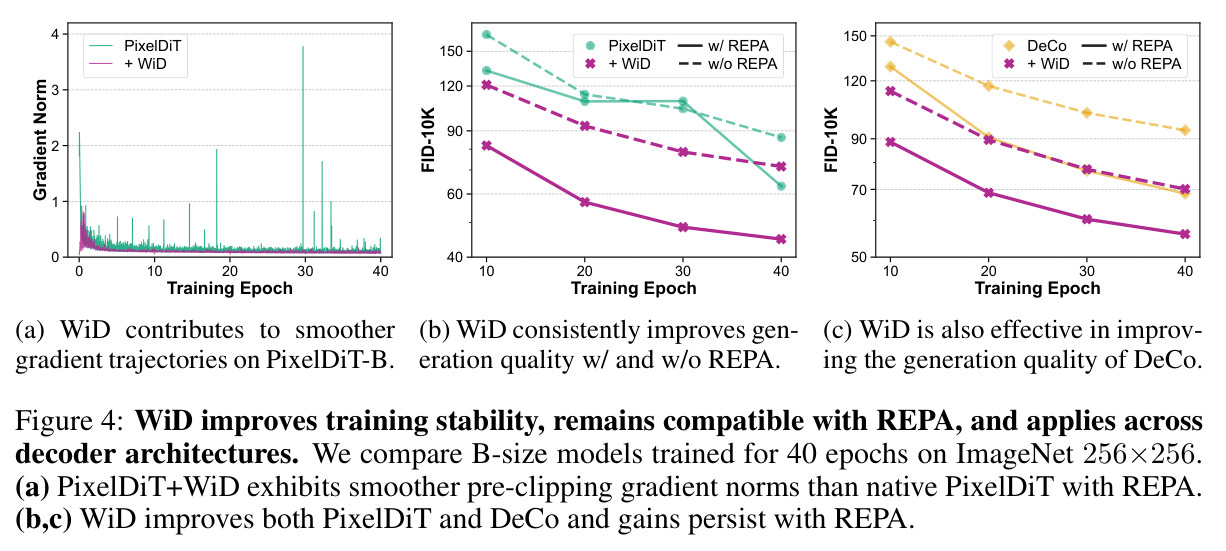
实验按『观察—主结果—消融—诊断』逐层展开,数字非常具体。(1) 冻结基救活基线(Figure 1a/1b):同一 DiT-B/16 速度预测设置,40 epochs 无 REPA 的 FID-10K 从约 220 降到约 90–100(DCT 与 PCA 基都有效),带解析基的 DiT 达到 DeCo、JiT、PixelFlow 等当代像素方法的成绩区间——粗统计先验确实缓解了像素训练。(2) 主结果 ImageNet 256×256(Table 1):PixelDiT-XL/16+WiD(805M)80 epochs FID 2.09 vs 原生 2.36;260 epochs FID 1.61 追平原生 320 epochs 的 1.61;500 epochs FID 1.53(sFID 4.70、IS 295.6、recall 0.66)vs 原生 800 epochs 的 1.54,节省 37.5% 训练轮数;Table 7 补充 160/200 epochs 的 1.87/1.72 也优于官方 1.97/1.94。(3) ImageNet 512×512(Table 2):从 260-epoch 256 分辨率 checkpoint 微调 50 epochs 得 FID 1.64、sFID 4.61、IS 304.9,显著优于原生 320+530 epochs 的 1.81/5.61/278.6。(4) 文生图 DeCo-XXL/16(Table 3/4):80K 步早期 GenEval 总分 0.49 vs 0.43(双对象 0.45 vs 0.32、计数 0.33 vs 0.27)、DPG 78.8 vs 73.1;全量训练后 GenEval 0.86(计数 0.75 vs 复现基线 0.65、颜色 0.94 vs 0.91)、DPG 82.6 vs 复现 82.3,仅 +14M(约 1.3%)参数。(5) 消融(Table 5,PixelDiT-B/16 + REPA,40 epochs,FID-50K 无 CFG):原生 60.01 → 完整 WiD 41.71;去掉维纳预测 49.54、去掉统计初始化 49.02、去掉系数接口 50.67,三个组件缺一不可。(6) 稳定性与通用性(Figure 4):梯度范数轨迹更平滑、大幅尖峰更少;与 REPA 叠加继续增益;在解码器设计完全不同的 DeCo-B(含频域辅助损失)上同样有效。(7) 诊断(Figure 2、Table 8/9):剩余误差下降占改进大头,DiT+PCA 在 40 epochs t=0.75 处剩余误差下降 18.246×10⁻³;像素通路对维纳响应的对齐在 t=0.25–0.9 全面高于上下文通路(40 epochs t=0.5 达 0.591)且随训练扩大,t=0.1 是例外。(8) 开销:参数 +0.94%、FLOPs +1.33%,推理吞吐 238.8→227.6 samples/s(PixelDiT-XL)、文生图 7.50→7.04 images/s(DeCo-XXL)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet 256×256 类条件生成(PixelDiT-XL/16) | FID-50K(CFG + guidance interval) | PixelDiT-XL/16+WiD:500 epochs FID 1.53(sFID 4.70,IS 295.6) | PixelDiT-XL/16:800 epochs FID 1.54(sFID 4.49,IS 297.0) | 同等质量节省 37.5% 训练轮数;80 epochs 时 2.09 vs 2.36 |
| ImageNet 256×256 类条件生成(收敛途中) | FID-50K | 260 epochs FID 1.61 | 原生 PixelDiT-XL/16 320 epochs FID 1.61 | 提前 60 epochs(约 19%)达到同等质量 |
| ImageNet 512×512 类条件生成(PixelDiT-XL/16) | FID-50K | FID 1.64 / IS 304.9(260+50 epochs 微调) | 原生 PixelDiT-XL/16:FID 1.81 / IS 278.6(320+530 epochs) | FID 降低 0.17,IS 提升 26.3,训练量减少约 82% |
| 文生图(DeCo-XXL/16,256×256,80K 步) | GenEval 总分 / DPG-Bench 平均 | 0.49 / 78.8 | DeCo-XXL/16:0.43 / 73.1 | GenEval +0.06(双对象 +0.13、计数 +0.06、颜色 +0.07),DPG +5.7 |
| 文生图(DeCo-XXL/16,512×512,全量训练) | GenEval 总分 / DPG-Bench 平均 | 0.86 / 82.6(计数 0.75、颜色 0.94) | DeCo-XXL 复现 0.82 / 82.3(官方报告 0.86 / 81.4) | 计数 +0.10、颜色 +0.03(vs 复现基线),DPG +0.3~+1.2 |
| 组件消融(PixelDiT-B/16 + REPA,40 epochs) | FID-50K(无 CFG) | 完整 WiD 41.71;去维纳预测 49.54;去统计初始化 49.02;去系数接口 50.67 | 原生 PixelDiT-B/16:60.01 | 完整版降低 18.30;三个组件各自贡献约 8~11 FID |
| DiT-B/16 冻结维纳基救援实验(40 epochs,无 REPA) | FID-10K(无 CFG,读图近似值) | DiT + DCT/PCA 冻结基:约 90~100 | plain DiT-B/16 速度预测:约 220 | 粗统计先验把几乎失败的基线拉入当代像素方法水平区间 |
局限与改进
作者在附录 C 承认的局限:工作主要聚焦像素空间图像生成的速度学习;统计去噪视角对其他流生成任务(latent 空间、语言、音频、视频)可能有帮助但尚未探索;未来计划把维纳知情结构直接融入 diffusion transformer。我自己的观察补充如下。其一,WiD 依赖『主干+像素解码器』的架构接口,对无解码器的 plain DiT 只能用冻结基或残差式做法,方法本身无法直接挂载。其二,相当一部分增益体现在训练加速而非最终质量:500 epochs 的 1.53 相对原生 800 epochs 的 1.54 提升极小,且冻结基的 FID 增益随训练收窄(Figure 1c),可训练版在超长训练后还剩多少优势未知。其三,512×512 只是从 256 checkpoint 微调 50 epochs,未验证高分辨率从头训练;文生图最终指标改善幅度也小(GenEval 总分与官方报告持平、DPG 仅 +0.3~+1.2),主要优势集中在早期训练阶段。其四,统计构造是结构性近似:共享 patch PCA 忽略跨 patch 协方差,全局 DCT 忽略跨频率耦合,维纳增益固定为线性高斯解的形式 $a_j(t)$,对偏离高斯假设的数据没有适应性。其五,评测对 CFG 权重与 guidance interval 较敏感(Table 7 中 320 epochs 从 1.58 到 1.65 不等),跨方法比较时这点需要留意。
独立分析的弱点
独立分析几个弱点并给出改进方向。(1) 统计先验绑定数据集:51,200 张图估出的 patch PCA 是 ImageNet/BLIP3-o 的经验统计,换到医疗影像、遥感、漫画线稿等域分布差异大的场景需要重新估计,且论文没有研究统计质量(样本数、预处理)对增益的影响。改进方向:在线/滑动窗口更新统计,或做域自适应的谱校准,并给出『统计先验失配度』的诊断指标。(2) 基的表达力受限:共享 patch 基只编码 patch 内 768×768 二阶矩,无法建模跨 patch 长程结构(这部分仍靠主干),增益形式上固定为逐系数噪声依赖缩放 $a_j(t)$;Table 9 显示 t=0.1 低噪声区像素通路反而更不对齐维纳响应,说明线性高斯近似在该阶段失效。改进方向:分组/分频率谱、用小型可学习增益网络替代标量谱、引入跨 patch 低秩耦合项。(3) 收益随训练边际递减:核心数字是省 37.5% 训练轮数,但最终 FID 提升仅 0.01,统计先验更像『收敛加速器』而非『质量天花板抬升器』。改进方向:在采样器/调度端也利用统计结构,或与数据质量、模型规模协同研究增益的 scaling 行为。(4) 接口与架构耦合:系数头的归一化粒度要逐一跟随原生输出头(PixelDiT 用 per-pixel RMSNorm、DeCo 用非仿射 LayerNorm),输入初始化也要按各解码器的位置编码方式单独推导(式 15),迁移到新架构有工程成本。改进方向:抽象成统一的『统计适配器』层,自动从原生模块推断初始化与归一化。(5) 推理端开销无法关闭:吞吐下降约 4.7%~5.8%(238.8→227.6、260.2→245.1 samples/s),训练完成后统计通路仍占计算。改进方向:训练后把维纳通路与系数头蒸馏/合并回原生架构,或允许推理时旁路统计分支。
未来方向
作者在附录 C 提出的方向:把统计去噪视角推广到其他流生成任务,包括 latent 空间生成、语言、音频和视频生成;计划把维纳知情结构直接融入 diffusion transformer 本体(而非只挂在外围解码器上),探索面向 flow-matching 的下一代基础架构。基于本文成果可以自然延伸的方向还有:(1) 与预条件化理论统一——WiD 的逐系数增益 $a_j(t)=\frac{t\lambda_j-(1-t)}{t^2\lambda_j+(1-t)^2}$ 本质是噪声依赖的预条件算子,可以推广为一族可学习预条件并给出与 EDM 类方法的统一分析;(2) 高阶统计——用四阶矩、高斯混合或按频段分组的局部谱替代纯二阶矩,逼近自然图像的非高斯结构;(3) 视频时空 patch 的统计基,把运动先验编码进时空 PCA 谱;(4) 从理论上刻画统计坐标与 attention/token mixer 的分工边界,回答『统计结构应该放在网络哪一层』;(5) 把 JVP 对齐度(Figure 2c 的度量)发展成训练健康度的在线诊断信号,用于早期预警优化异常;(6) 与 REPA 类表示对齐做联合理论分析——目前只验证了兼容性,两者的增益机制(统计结构 vs 语义对齐)如何互补值得建模;(7) 数据分布漂移下的持续统计更新,支撑长周期、多域的持续训练场景。
复现评估
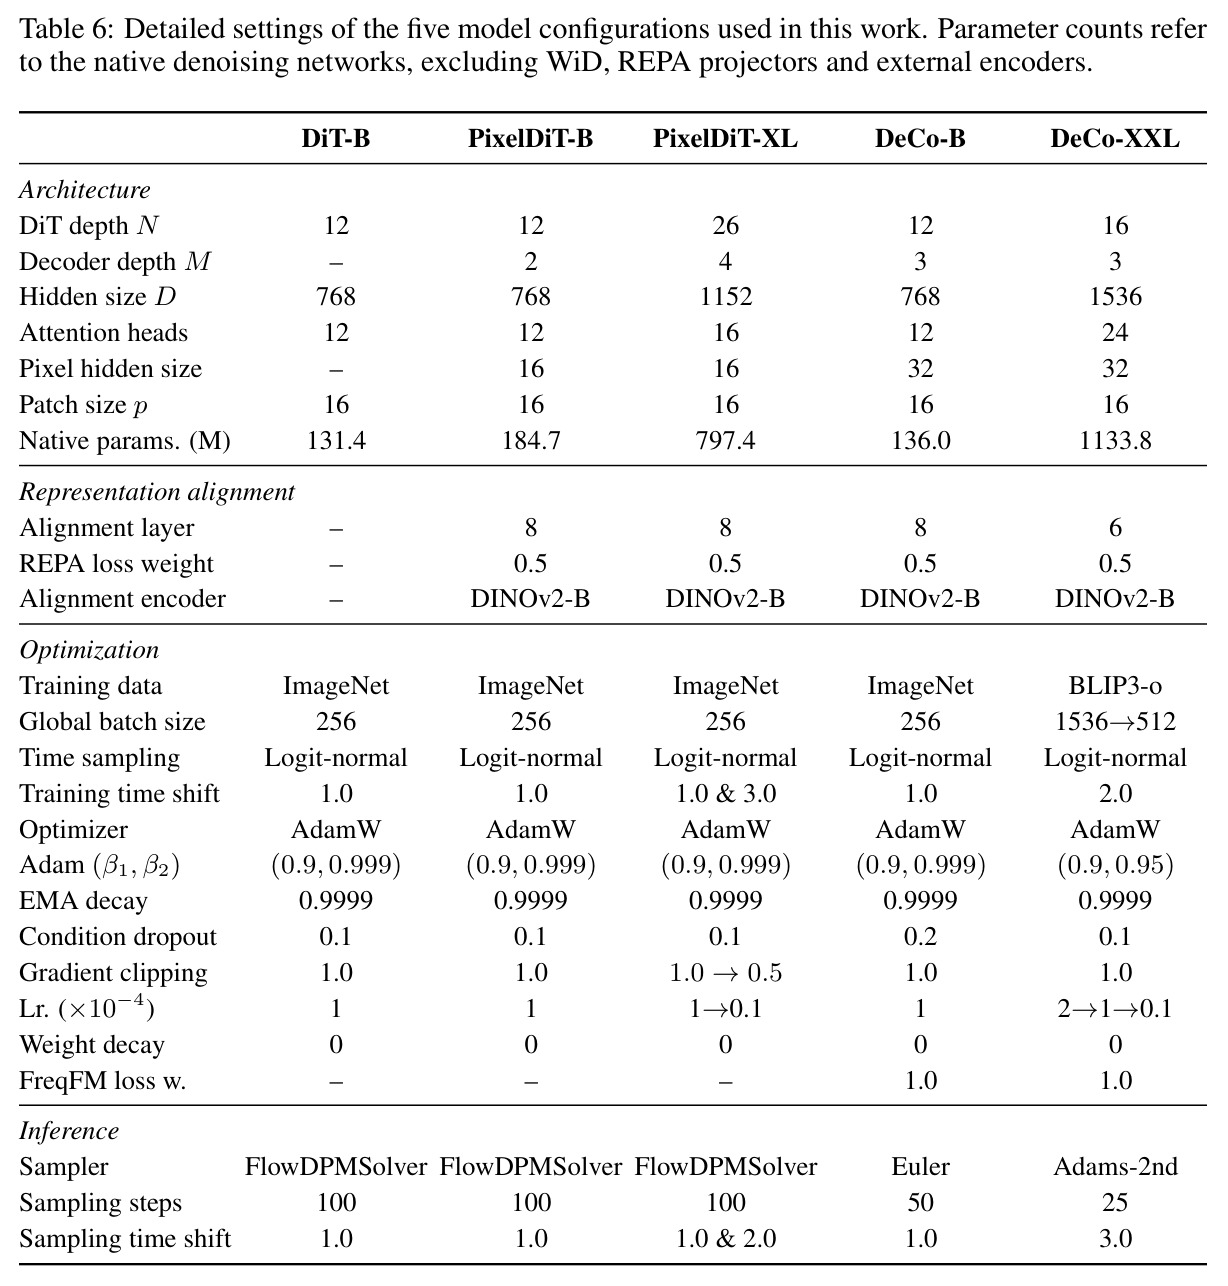
复现条件总体较好但算力门槛高。开源情况:标题页已给出 GitHub 仓库(NUS-HPC-AI-Lab/WiD),作者承诺接收后发布训练代码、模型 checkpoint、训练日志和统计先验;正文与附录对方法的公式化描述(第 3、4 节)和实现细节(附录 A.1/A.2)相当完整。数据与统计先验:只需 51,200 张训练图(ImageNet 约 4%、文生图数据约 1‰,含 26,400 张 Long-Caption、19,200 张 Short-Caption、5,600 张 JourneyDB),单 GPU 配 12 个 CPU worker 约 1 分钟即可重算,随机种子已固定,统计先验本身也会随代码发布。超参与评测透明度高:Table 6 列出五个配置的全部架构与优化超参(深度、隐藏维、batch、学习率调度、EMA、梯度裁剪、sampler/步数/time-shift),Table 7 给出各 epoch 的 CFG 权重与 guidance interval,评测种子固定(256 分辨率用 1600、512 用 10000),训练 checkpoint 保存各 rank 的 RNG 状态以支持断点续训。算力需求:PixelDiT-XL/16 在 256 分辨率前 320 epochs 用 8×H200、后 180 epochs 用 8×B200;512 分辨率与 DeCo-XXL 用 8×H200——学术实验室复现 XL/XXL 全量结果成本很大,但 B 尺寸消融(40 epochs)用少量 GPU 即可验证方法有效性。综合评估:方法组件简单(PCA + 几个线性层 + 初始化规则),小规模复验难度低;全量复现属于中等偏高难度,瓶颈在 GPU 资源而非实现复杂度。
论文图表
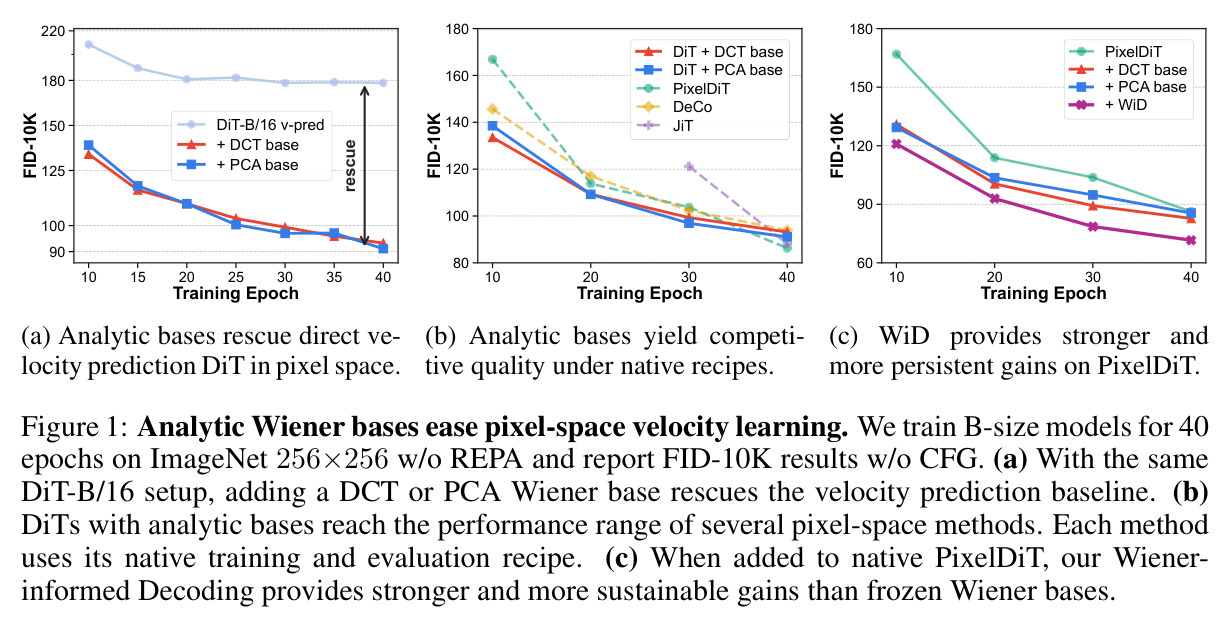
三栏 FID-10K 随训练 epoch 变化的曲线图(B 尺寸模型,ImageNet 256×256,40 epochs,无 REPA、无 CFG)。(a) 同一 DiT-B/16 设置下,加入 DCT 或 PCA 冻结维纳基可以救活直接速度预测基线(FID 从约 220 降到约 90~100);(b) 带解析基的 DiT 在各自原生训练/评测配方下达到与 DeCo、JiT、PixelFlow 等当代像素方法相当的水平;(c) 在原生 PixelDiT 上,WiD 提供比冻结 DCT/PCA 基更强、更持久的增益。
这是全文的动机实验:用最简单的『加冻结基』操作证明粗统计先验确实缓解像素空间训练,并在 (c) 预告可训练版 WiD 相对冻结基的持续优势,是理解论文叙事起点的一张图。
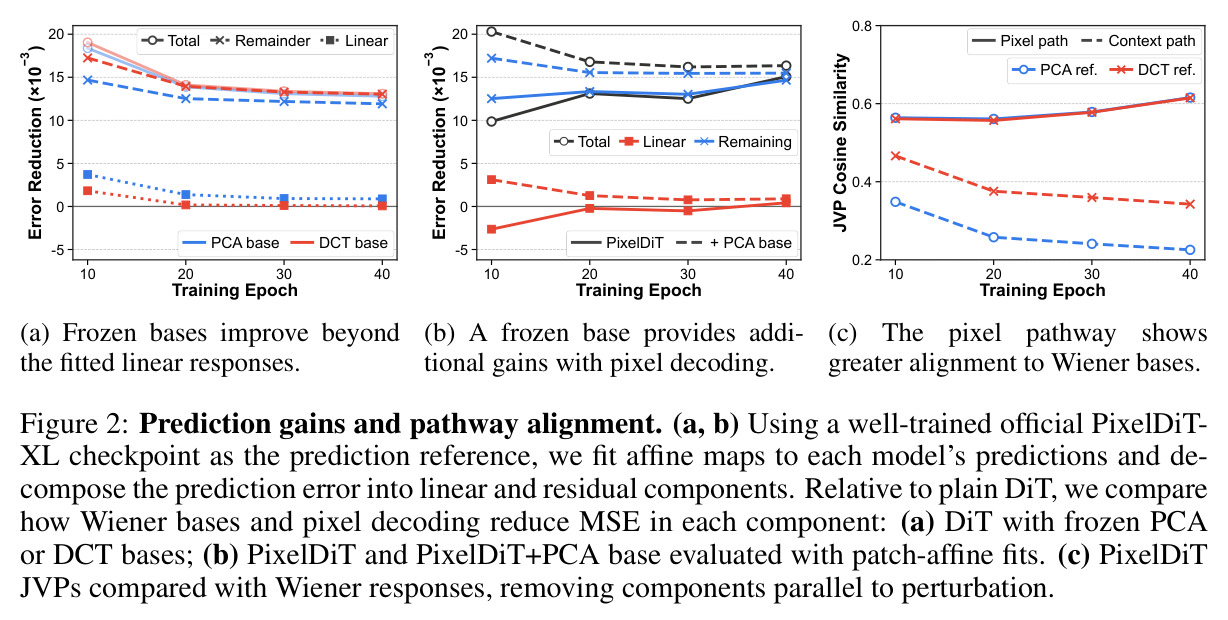
三个诊断子图。(a,b) 以官方 320-epoch PixelDiT-XL checkpoint 为预测参考,对每个模型的速度输出做 affine 拟合并把误差分解为线性与剩余两部分,再比较相对 plain DiT 的 MSE 下降:(a) DiT 加冻结 PCA/DCT 基,(b) 原生 PixelDiT 与 PixelDiT+PCA 基——改进主要来自剩余成分,冻结基与像素解码互补。(c) 对比 PixelDiT 的直接像素通路与上下文通路对同一各向同性扰动的 JVP 响应与维纳响应(去掉平行分量后)的余弦相似度,像素通路更对齐且差距随训练扩大。
这张图是『beyond the estimate』核心论点的直接证据:说明统计基的价值超出其显式线性预测、且解码器是整合统计结构的自然接口,直接推动了从冻结基到 WiD 的方法跃迁。