Iris-3B:超越隐空间——像素空间扩散的训练、转换与微调 Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning
从零预训练3B像素空间文生图模型并转换FLUX.2 Klein,细粒度下游任务未见像素先验优势
前置知识
潜在扩散模型(Latent Diffusion)与 VAE 瓶颈
潜在扩散把扩散去噪过程放进预训练变分自编码器(VAE)的低维隐空间中运行,使高分辨率图像的训练与采样成本大幅下降。代价是 VAE 独立于生成器训练、重建有损,其误差会与生成器误差叠加,编码时被丢弃的细节生成器永远无法恢复。
本文的全部动机来自对这一瓶颈的质疑:在深度估计、超分等细节敏感任务上,隐空间骨干必须经有损编解码器输出,作者正是要检验像素空间骨干能否绕开它。
像素空间扩散与 PiT 像素头
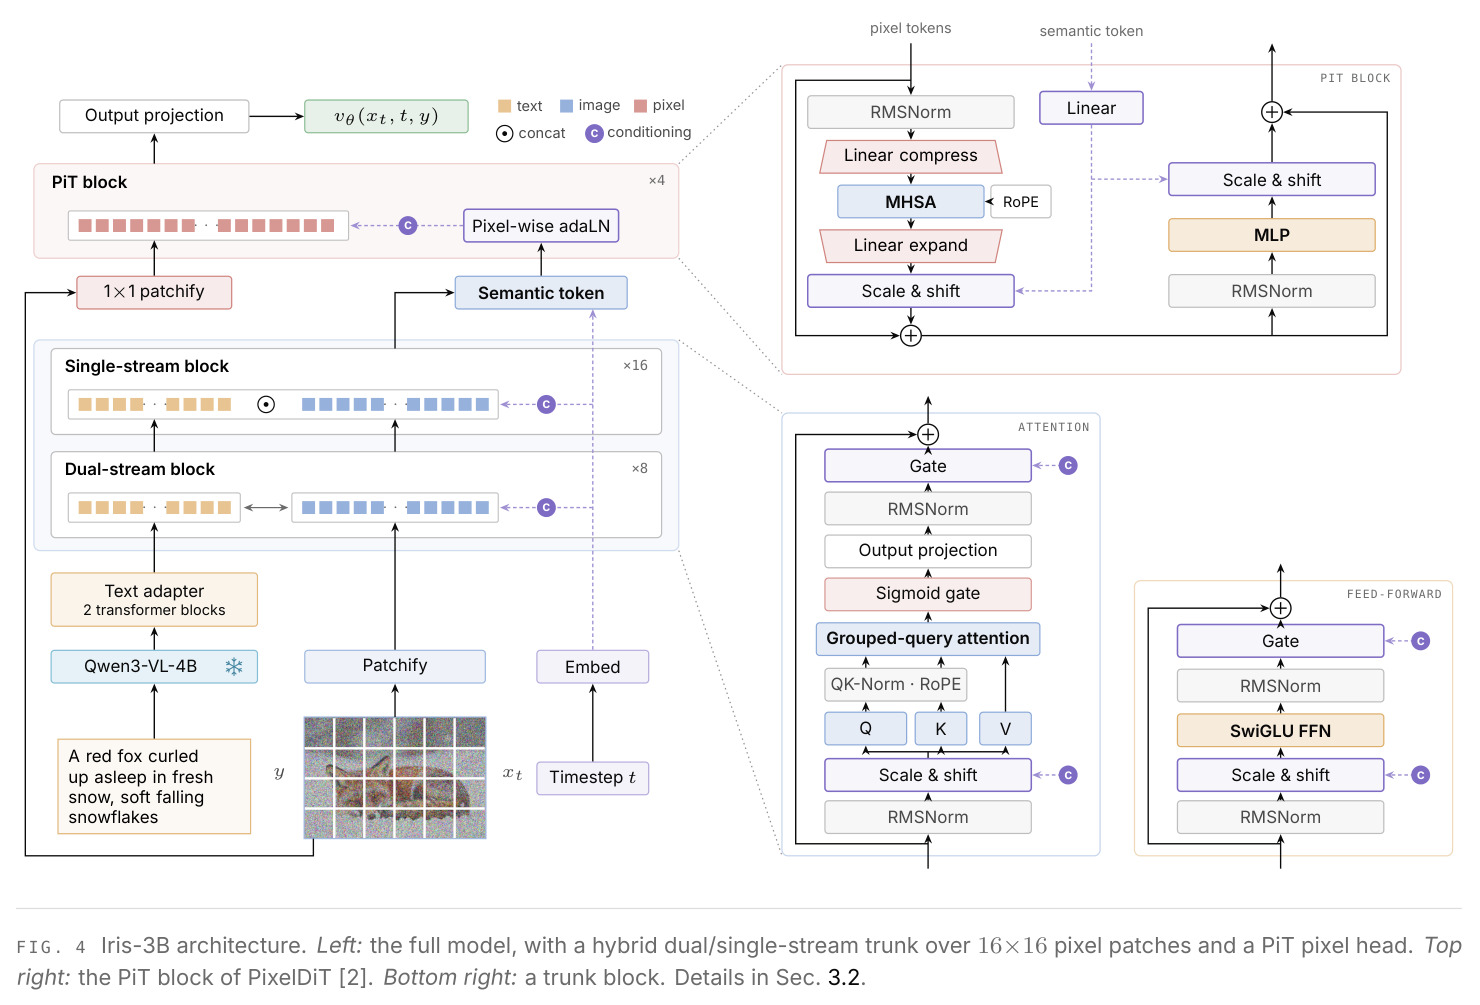
像素空间扩散直接在 RGB 像素上做去噪,不经任何压缩。PixelDiT 提出的像素 transformer(PiT)头把图像切成 16×16 patch,主干在 patch 级做注意力;头部的 4 层像素 transformer 把每个 patch 的像素压缩成一个 1280 维 token 参与跨 patch 注意力,再逐像素展开并经逐像素 MLP 解码。
Iris-3B 的可扩展性正来自这个 PiT 头,而它的『patch 间只通过压缩 token 通信』设计也是论文发现的 patch 网格伪影的根因,理解它才能读懂核心负结果。
流匹配(Flow Matching)与 v-prediction
流匹配在干净数据 $x_0$ 与噪声 $\epsilon$ 之间的直线路径 $x_\sigma = (1-\sigma)x_0 + \sigma\epsilon$ 上插值,训练网络预测速度场 $v = \epsilon - x_0$,损失为 $\mathcal{L} = \mathbb{E}\|v_\theta(x_\sigma, \sigma, c) - (\epsilon - x_0)\|_2^2$。相比噪声预测,它在高维 patch token 下训练更稳定。
Iris-3B 的预训练目标和 256² 消融中『x vs v 预测目标』的对比都建立在这个框架上,噪声水平还用了 shifted logit-normal 分布(shift s=2/3/4)。
REPA 表示对齐
REPA 在训练扩散 transformer 时,额外用一个投影层把中间特征与冻结的 DINOv2 编码器特征做余弦相似度对齐(负余弦作为 $\mathcal{L}_{\text{REPA}}$,权重 λ=0.5),可显著加速训练并提升语义质量。变体包括换 DINOv3 教师、加卷积投影的 iREPA、以及把外部教师换成自监督目标的 Self-Flow。
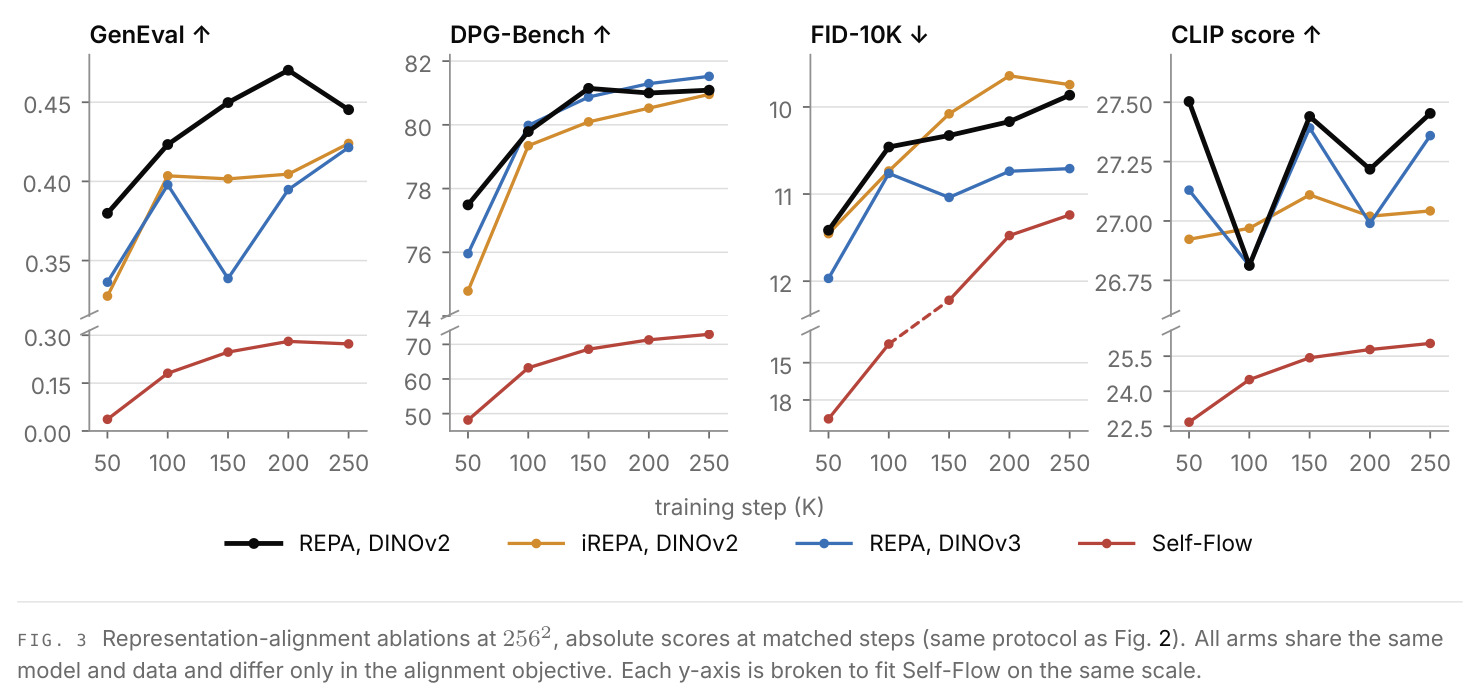
256² 消融选配方时系统比较了这四种对齐,结论是 REPA+DINOv2 最强,这是 Iris-3B 扩展配方的关键组成部分。
单目深度估计的评测协议
单目深度估计从单张 RGB 图预测每个像素的深度。常用零-shot 评测在 NYUv2、KITTI、ETH3D、ScanNet、DIODE 等真实数据集上,预测先按每图 2%/98% 分位数做尺度平移对齐,再算 AbsRel(相对绝对误差,越低越好)与 δ1(误差小于 1.25 倍的比例,越高越好);SEE(soft edge error)衡量深度边缘的锐利程度,对细粒度细节最敏感。
论文深度实验全部沿用 Marigold V2 的这套官方评测代码与指标,理解 AbsRel/δ1/SEE 才能解读三臂对比表。
真实世界超分与 Real-ESRGAN 退化
真实世界超分要处理未知复杂退化。Real-ESRGAN 提出二阶退化流水线(模糊、噪声、JPEG 压缩等的随机组合叠加两轮),可以在线合成逼真的低质-高清训练对。基于生成先验的修复方法(StableSR、SeeSR、SUPIR、HYPIR 等)把低质图输入预训练文生图模型,用像素+感知+对抗损失让单步前向直接输出修复结果。
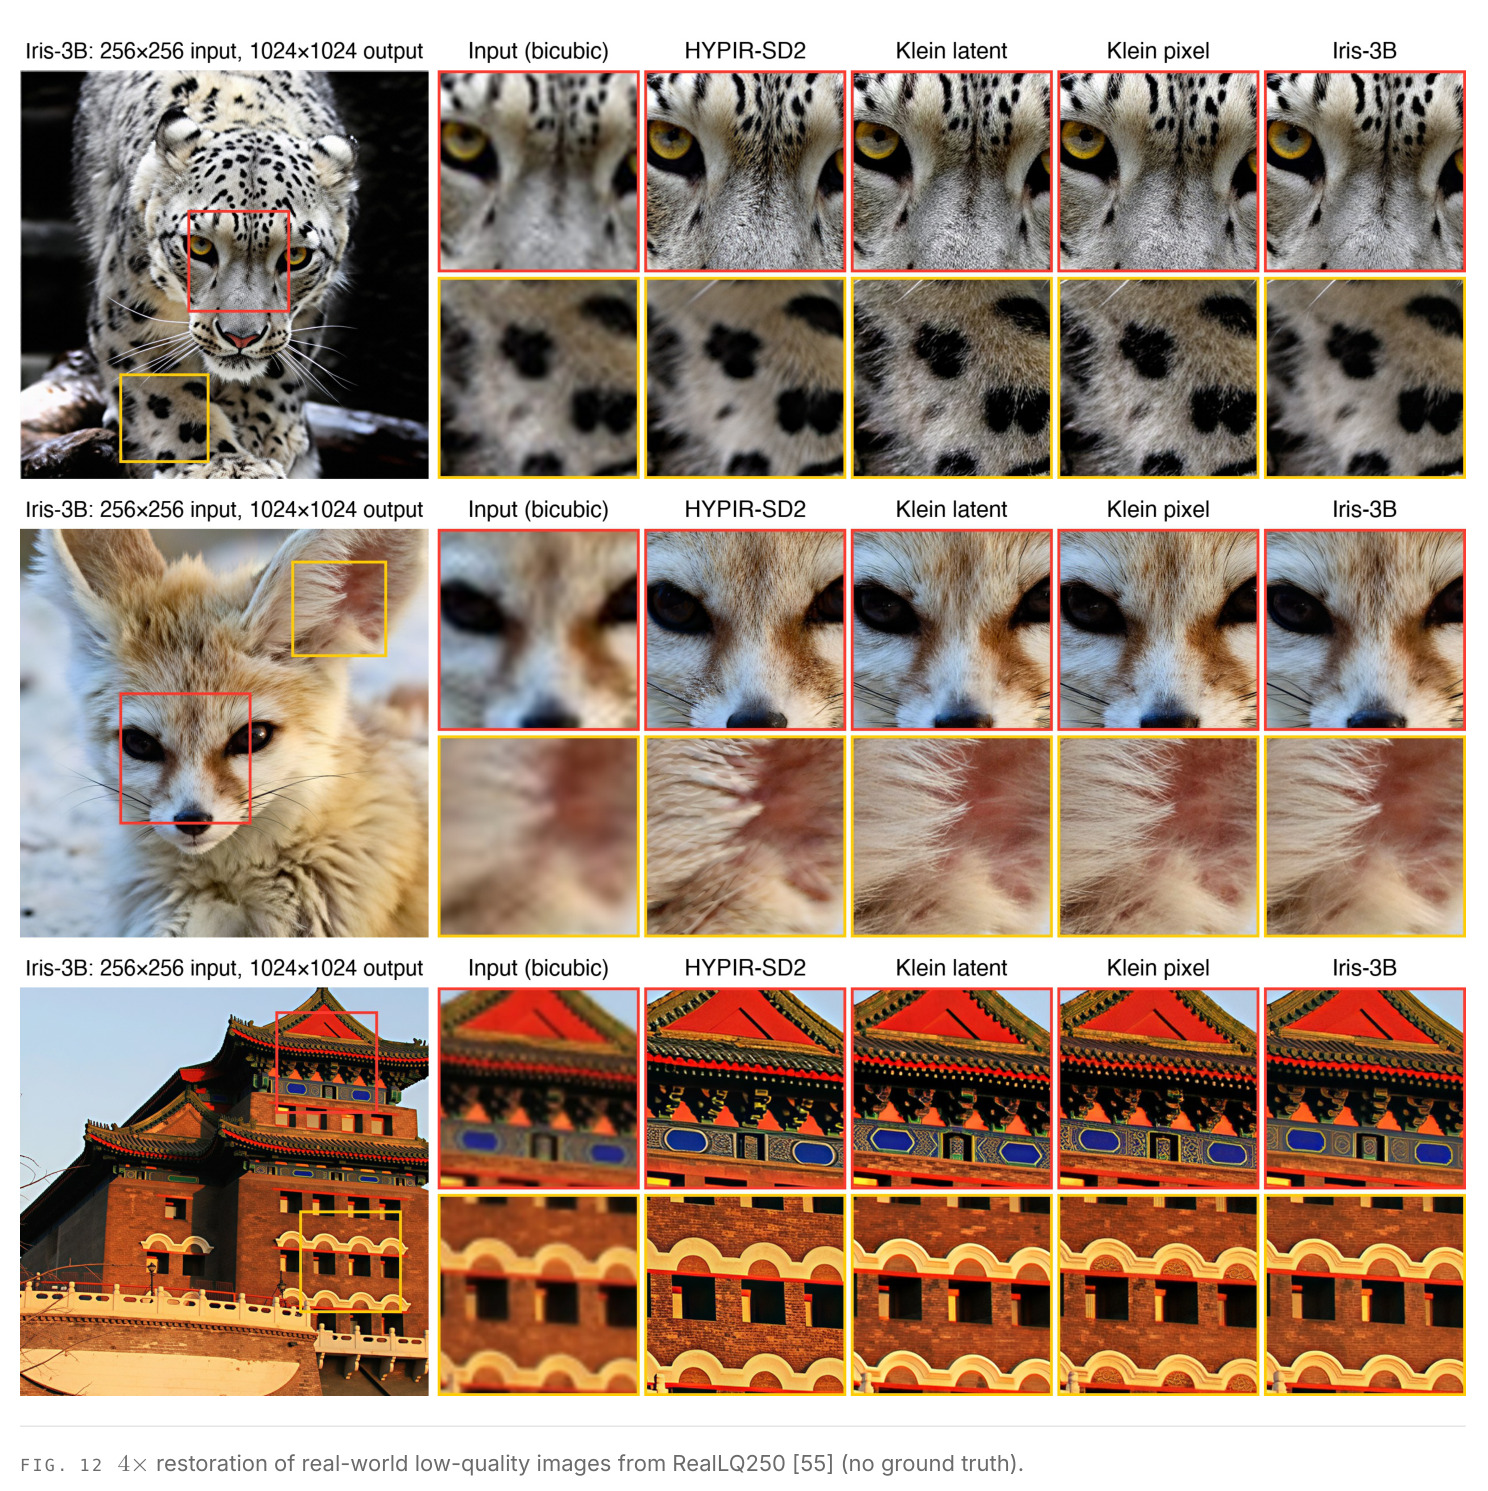
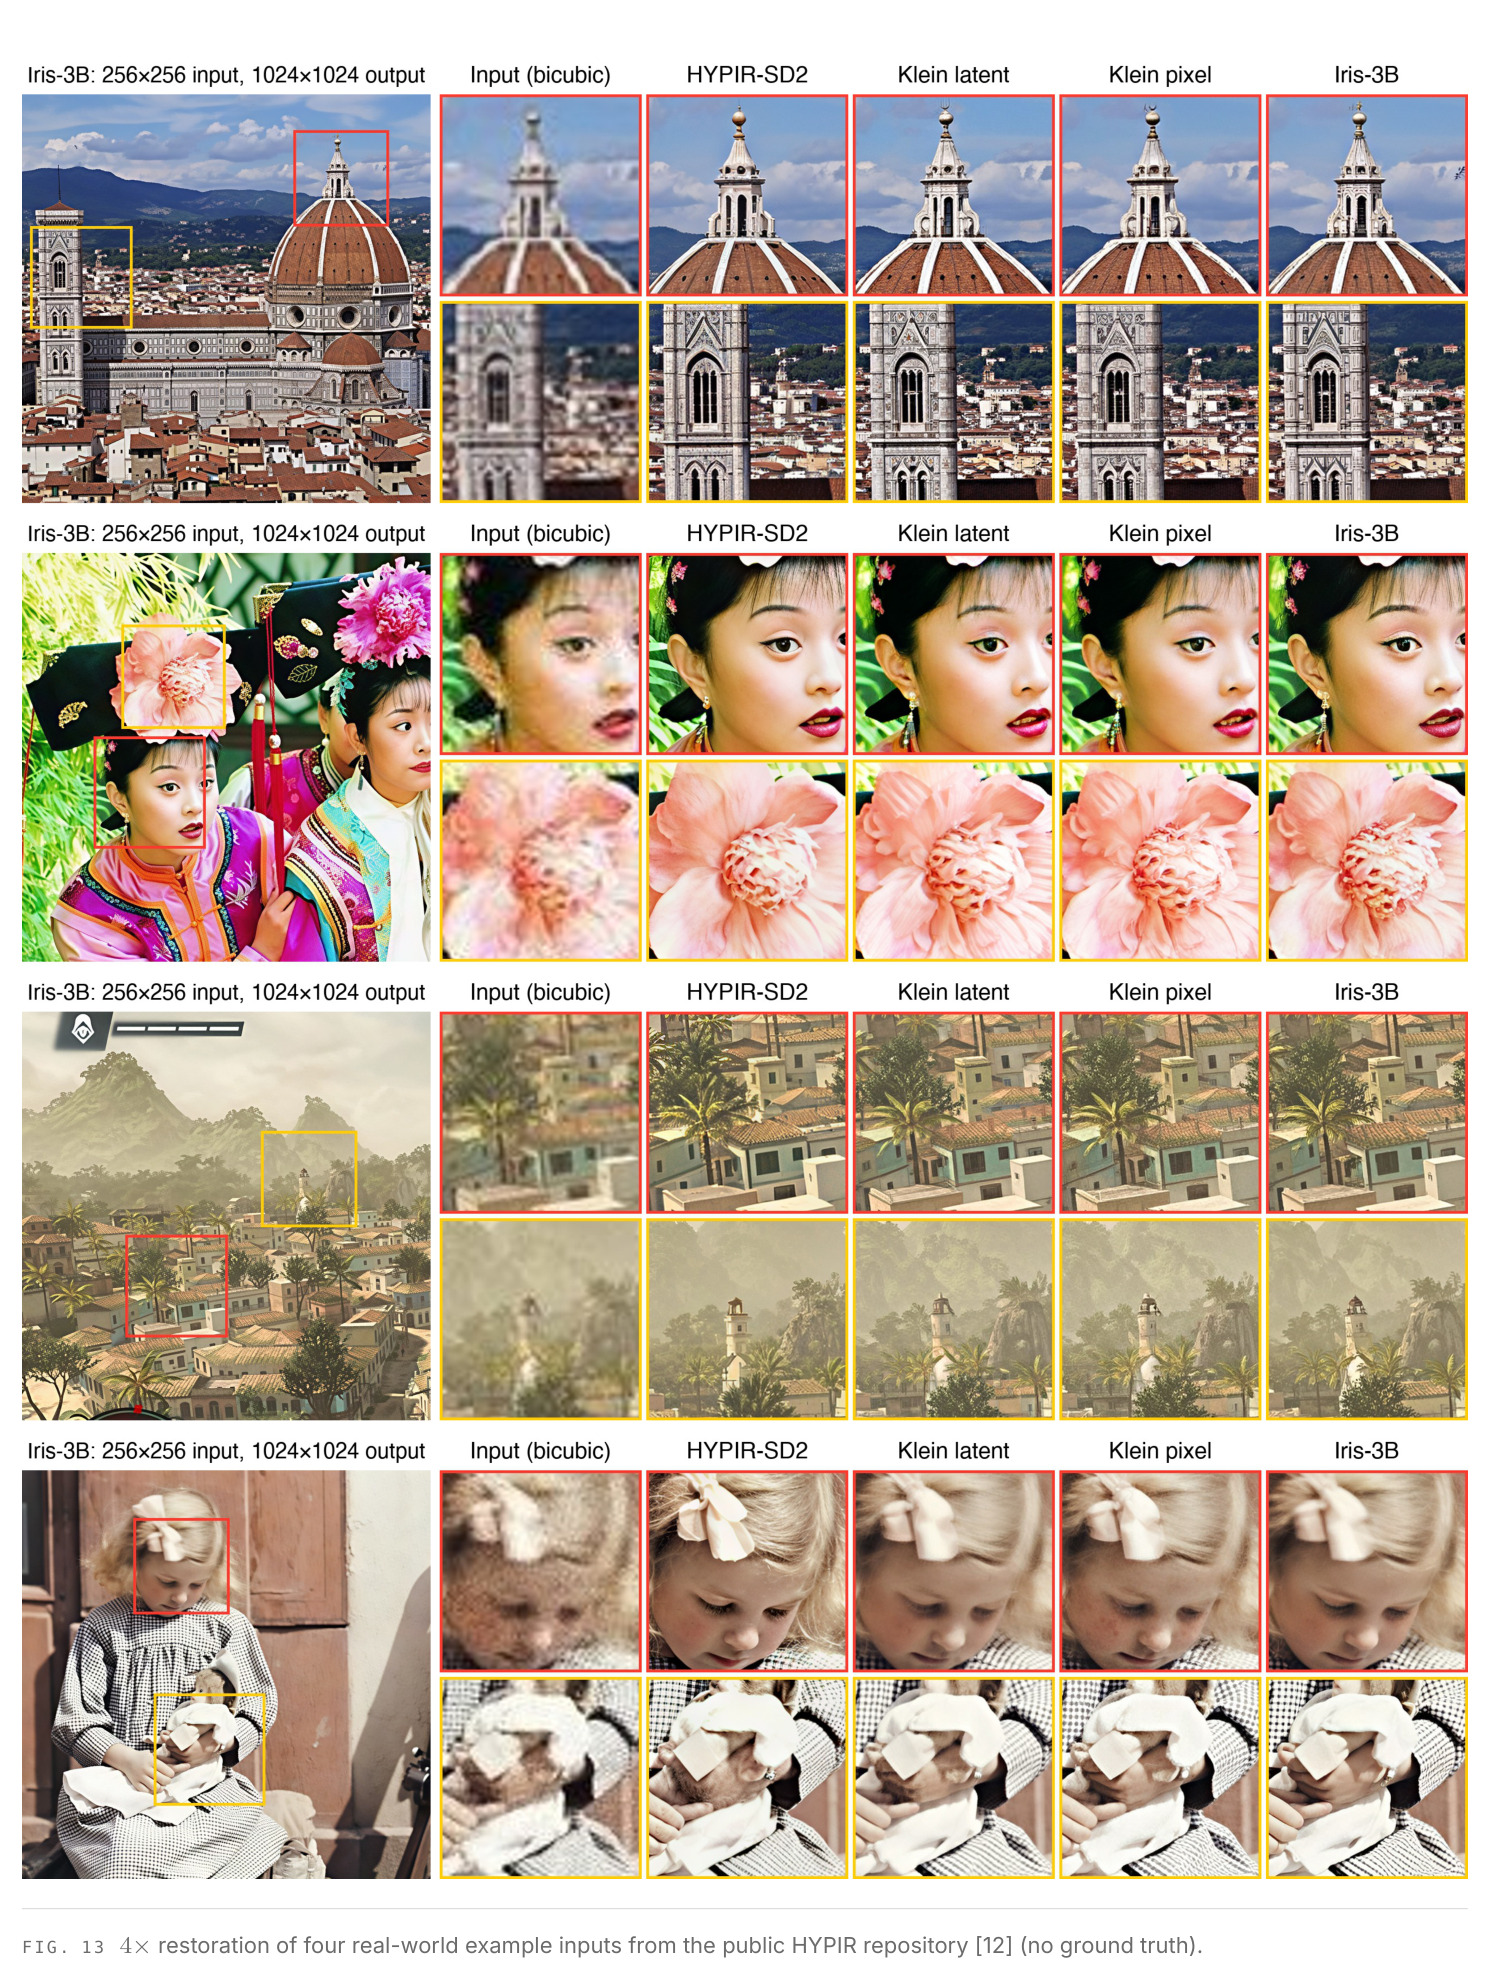
论文的修复/超分实验用 Real-ESRGAN 二阶退化在 DIV2K 上在线造数据,并按 HYPIR 的单步配方微调,评测用 PSNR/SSIM/LPIPS/NIQE/MUSIQ/DeQA 六项指标。
研究动机
潜在扩散通过 VAE 把生成过程压缩到低维隐空间,已成为高分辨率文生图的主导范式,但这份效率是有代价的:自编码器独立于生成器训练且重建有损,两者误差会叠加而无法联合优化,编解码器丢弃的任何细节都超出生成器的能力边界。对单目深度估计、图像修复/超分这类密集预测任务,这个编解码器是结构性瓶颈而非美学问题——当骨干是隐空间模型时,深度图或修复照片的每个输出都必须经过一个针对『重建自然图像』优化的自编码器解码。微调后的生成器恰恰定义了这两个任务的最先进水平(如 Marigold 系列的深度估计、HYPIR/SUPIR 的修复),说明生成先验对密集预测极有价值,于是很自然地期望像素空间生成器应该迁移得更好。然而现有像素空间工作(JiT、PixelDiT、DiP、PixNerd、PixelGen、AsymFlow 等)只用生成或理解质量评判模型,从未检验它们作为其他任务骨干的表现。
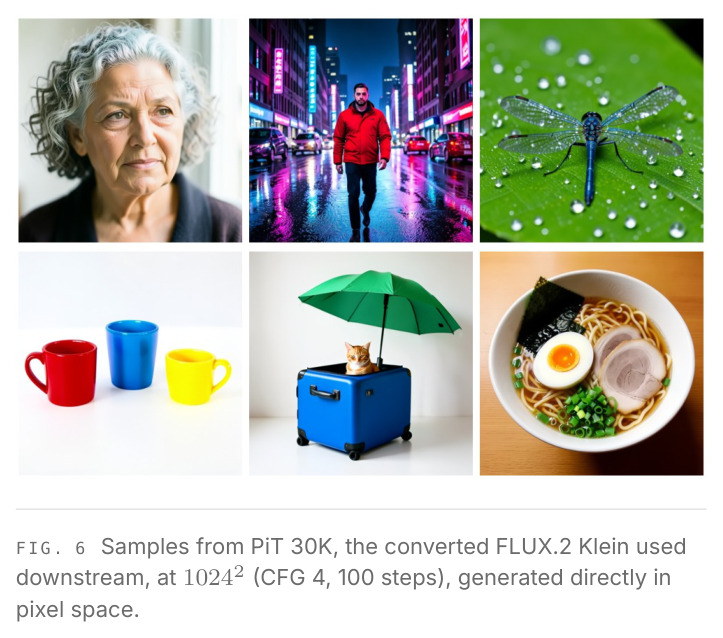
本文的目标是本文要严格检验『像素空间生成先验在细节关键任务上优于隐空间先验』这一假设,并且用文献提供的两条路线同时获得像素骨干。其一,从零预训练 Iris-3B——30 亿参数的像素空间文生图 transformer,经 256→512→1024 分辨率课程训练,且先用 1.3B PixelDiT 在 256² 上消融预测目标(x vs v)与表示对齐策略(REPA、iREPA、DINOv3 教师、Self-Flow),用数据决定要扩展什么配方;其二,把预训练隐空间模型 FLUX.2 Klein base 4B 转换到像素空间,从而得到同一父模型的像素/隐空间孪生,让下游对比尽可能受控;其三,用同一配方、同一数据、同一预算把两类模型分别微调到单目深度估计(五个零-shot 基准)和图像修复/超分(DIV2K 4×),与隐空间对应版本打分对比。同时发布 Iris-3B 的权重与训练代码,证明像素空间预训练可以扩展到 3B 并达到与隐空间模型有竞争力的生成质量。
与已有工作不同的是,本文的独特切入是首次把『像素空间 vs 隐空间』之争从生成质量评测搬到下游密集预测的受控对照实验中。此前没有任何工作回答『像素空间生成先验是否让深度估计或修复更好』这一问题。为逼近干净对比,作者设计了双重路径:FLUX.2 Klein 转换路线提供同一父模型、同一微调配方的匹配对比(隐 Klein vs 像素 Klein),Iris-3B 从零预训练路线排除『转换损耗』这一混杂;并有意把 256² 消融、转换障碍诊断、深度/修复全流程配方连同失败模式一起公开。更难得的是作者事先声明这是负结果——实验并未证实像素空间优势,论文的重心放在诚实记录残余混杂(模型规模、预训练数据、算力差异、单次运行无显著性检验)而非掩饰,这种『负结果+可复现配方』的写法在该领域极为少见,对任何在像素/隐空间骨干之间权衡的研究者都有直接参考价值。
核心方法
论文同时铺设两条通往像素空间骨干的路线再做下游对照。直觉上:若像素空间真有优势,从零预训练的模型应最充分体现;隐空间转换路线则提供同父模型的严格孪生。第一条路线从零预训练 Iris-3B:先在 256² 用 1.3B PixelDiT 消融选定配方(v-prediction+DINOv2 REPA),再按 FLUX.1 式混合布局扩展到 3B——16×16 patch 切分,8 个 MMDiT 双流块加 16 个单流块、宽度 2560,4 块 PiT 像素头解码,冻结 Qwen3-VL-4B-Instruct 做文本编码,经 256/512/1024 三阶段课程加 SFT 共约 6.12 亿样本。第二条路线把 FLUX.2 Klein base 4B 的 VAE 换成 16×16 像素 patch 接口,用『增益匹配岭回归初始化+按权重 RMS 比例缩放主干学习率』两个修正完成转换,取 30K 步 PiT 头版本(PiT 30K)作下游像素父模型。最后隐 Klein、像素 Klein、Iris-3B 三模型分别按同一单步直接回归配方微调深度估计、按 HYPIR 单步配方微调修复,与隐空间孪生对比。
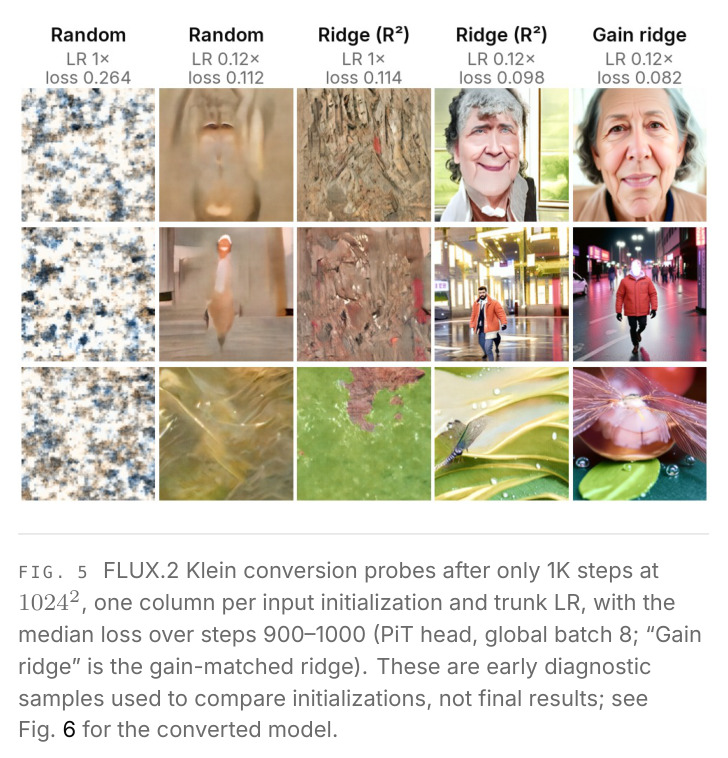
核心思想分三层。第一,证明像素空间文生图可端到端扩展到 3B 并匹敌隐空间模型:关键构件是 PixelDiT 的 PiT 头——4 层像素 transformer 把每个 16×16 patch 的像素压缩成 1280 维 token 参与跨 patch 注意力,再逐像素展开解码,兼顾效率与细节;配合共享偏置 adaLN(每流一次共享投影加逐块学习偏置),同等 FLOPs 省 28% 参数。第二,诊断并解决隐转像素的接口障碍:主干只在 VAE 隐嵌入上训练过,随机初始化输入投影喂入的是从未见过的分布——对 FLUX 即便最优的逐 patch 线性映射也只能解释隐嵌入方差的 14%。作者提出增益匹配岭回归初始化:拟合从 16×16 RGB patch 到父模型隐 token 嵌入的线性映射,正则强度按『噪声通过映射的增益与父模型隐路径一致』选取而非最大化留出 R²(后者会放大像素噪声并留下色偏);再加 0.12× 头学习率的主干 LR 缩放(按父模型与 Z-Image 的权重 RMS 之比),两者合用才能在 1K 步内把 patch 噪声变成照片级、符合提示词的图像。第三,用匹配配方对照实验诚实验证像素先验假设,得到并公开负结果。
方法步骤详情
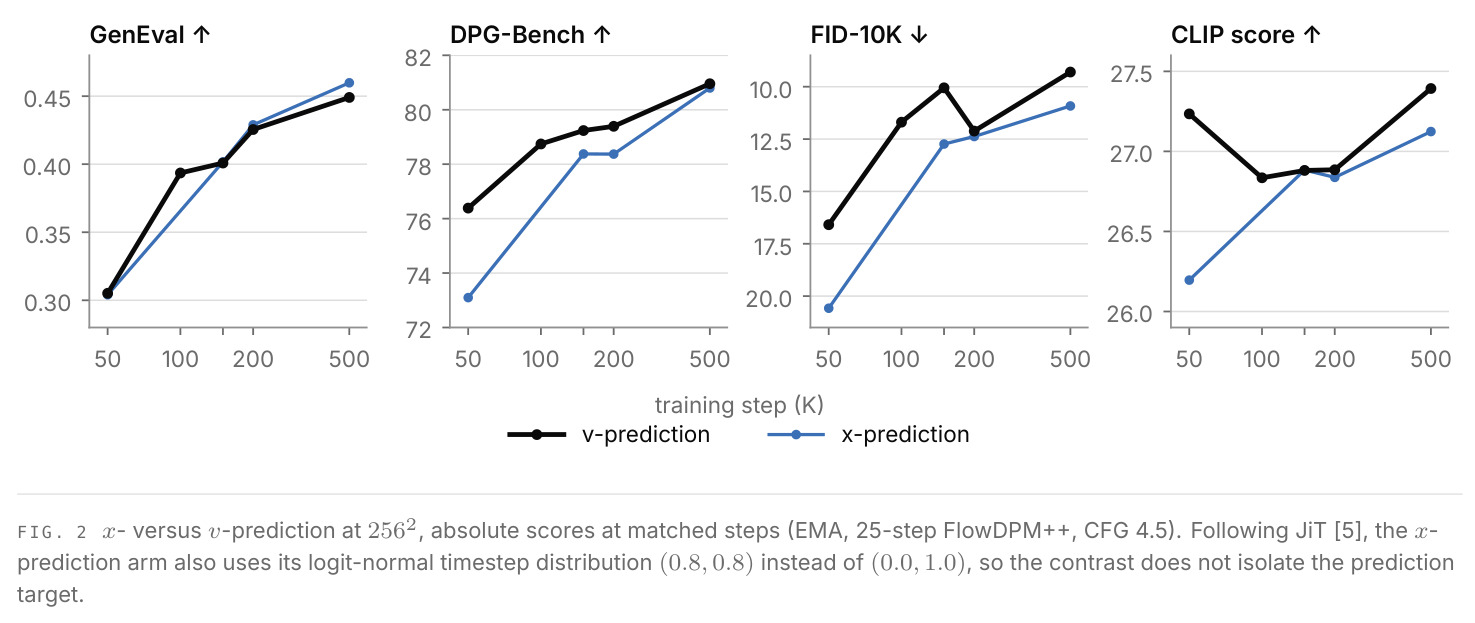
全流程五步。①256² 消融:1.3B PixelDiT 复现,统一协议(EMA、25 步 FlowDPM、CFG 4.5),每次只改一个因素:x vs v 预测中 v 稳定且 GenEval 打平、x 在 DPG/FID 更差,保留 v(x 臂同时改用 logit-normal(0.8,0.8) 时间步,未隔离目标);表示对齐中 REPA+DINOv2 全程领先,DINOv3 教师更差、Self-Flow 全崩,保留前者。②扩展到 3B:总损失 $\mathcal{L}=\mathcal{L}_{\text{flow}}+\lambda\mathcal{L}_{\text{REPA}}$,噪声 $\sigma=\sqrt{su/(1+(s-1)u)}$(s=2/3/4),Muon+AdamW 优化,LR 1e-4(1024 阶段减半),课程 36.7 万+16.3 万+9.5 万步加 SFT 4 万步。③转换:去 VAE 换 patch 接口,增益匹配岭初始化+主干 LR 缩放,batch 112、1K 步 warmup,取 30K 步 PiT 头版本。④深度微调:单步前向、相对对数深度按 2%/98% 分位归一化、掩码 L1+5 倍梯度 L1,LR 3e-5、batch 32、10K 步,仅合成数据 9:1。⑤修复微调:HYPIR 单步配方,损失 $\mathcal{L}_{\text{SR}}=\|\hat{y}-y\|_2^2+5\mathcal{L}_{\text{LPIPS}}+0.5\mathcal{L}_{\text{adv}}$,LR 1e-5、1024² 裁剪,FLUX 两臂 10K 续 30K 步,Iris-3B 另训 10K 步。
技术新颖性
新颖性有四。其一,Iris-3B 是首个开源 3B 级像素空间文生图 transformer,证明 PiT 头加混合双/单流主干可扩展到该规模(GenEval 0.798、DPG 86.52、OneIG-EN 0.540 与 Qwen-Image 持平);共享偏置 adaLN 同 FLOPs 省 28% 参数。其二,隐转像素接口障碍的因果诊断是新的:已发表转换把过程描述得直接,本文发现小 batch 下随机初始化接口根本不收敛——最优逐 patch 线性映射仅解释隐嵌入 14% 方差;增益匹配岭初始化(正则按噪声增益与父模型隐路径一致选取,而非最大化 R²)加 0.12× 主干 LR 缩放,两者单独各把 1K 步损失减半、合用才产生连贯图像。其三,256² 消融系统比较四种表示对齐,发现 DINOv3 教师劣于 DINOv2、Self-Flow 完全失败,是对表示对齐文献有信息量的负结果。其四,首次定量刻画像素扩散模型的 patch 网格伪影(边界曲率比:隐模型 0.97–0.99、像素 Klein 1.31–1.44、Iris-3B 2.14–2.25),归因于 PiT 头 patch 间仅靠压缩 token 通信。
实验结果
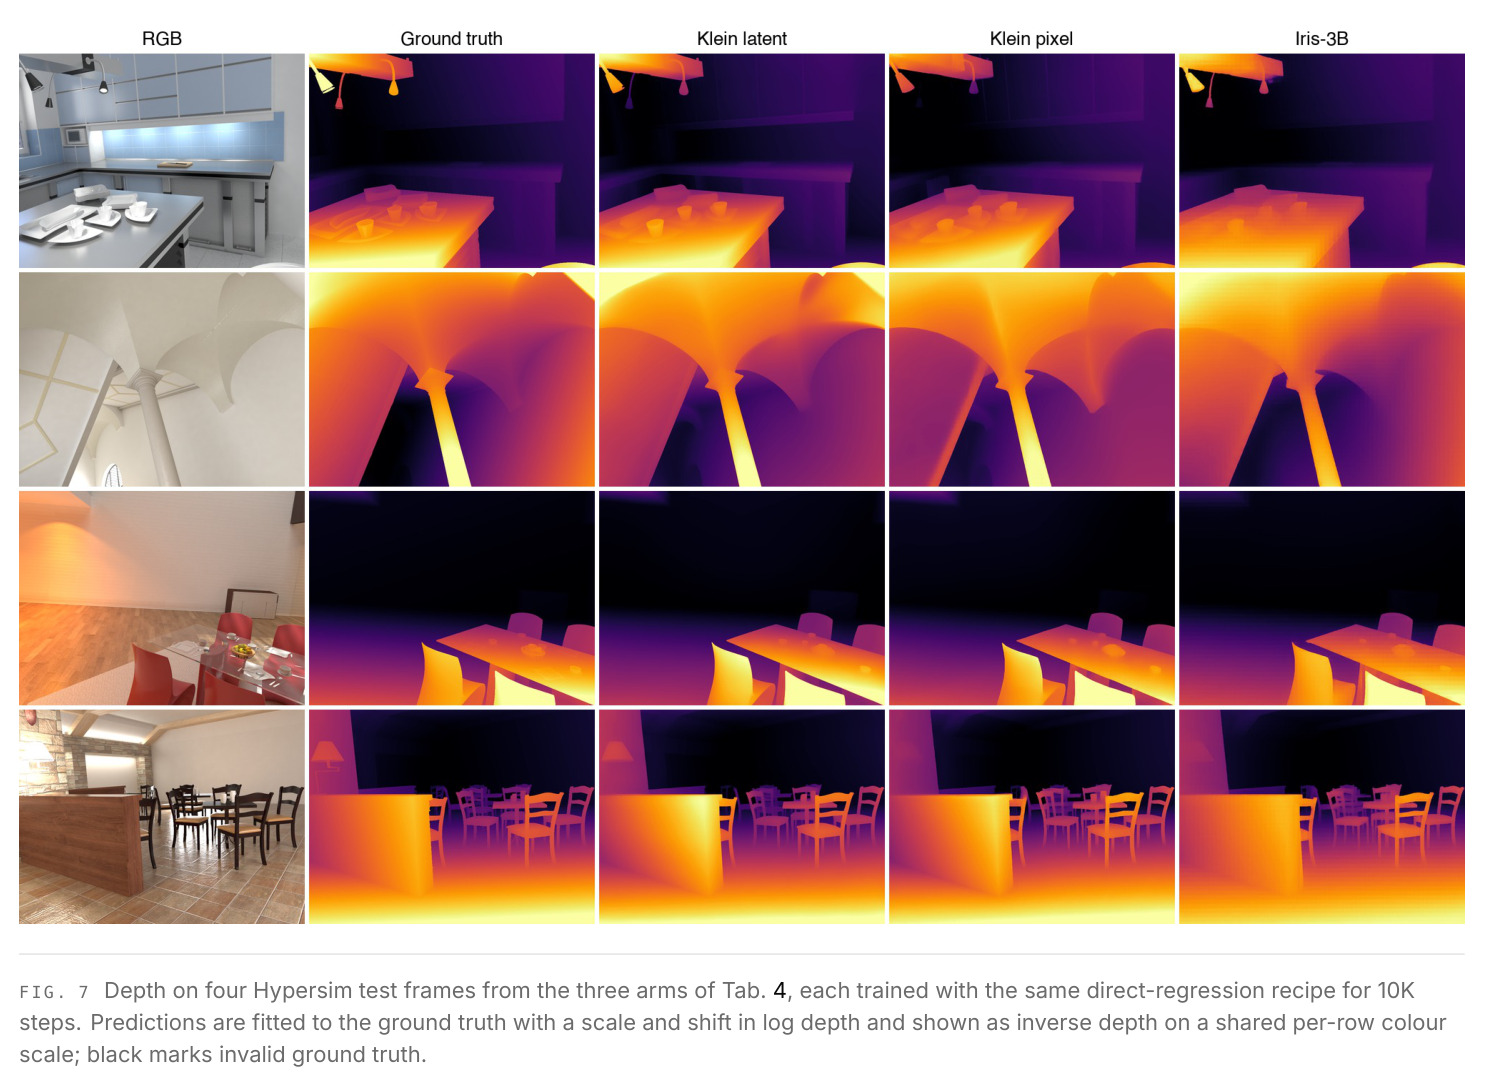
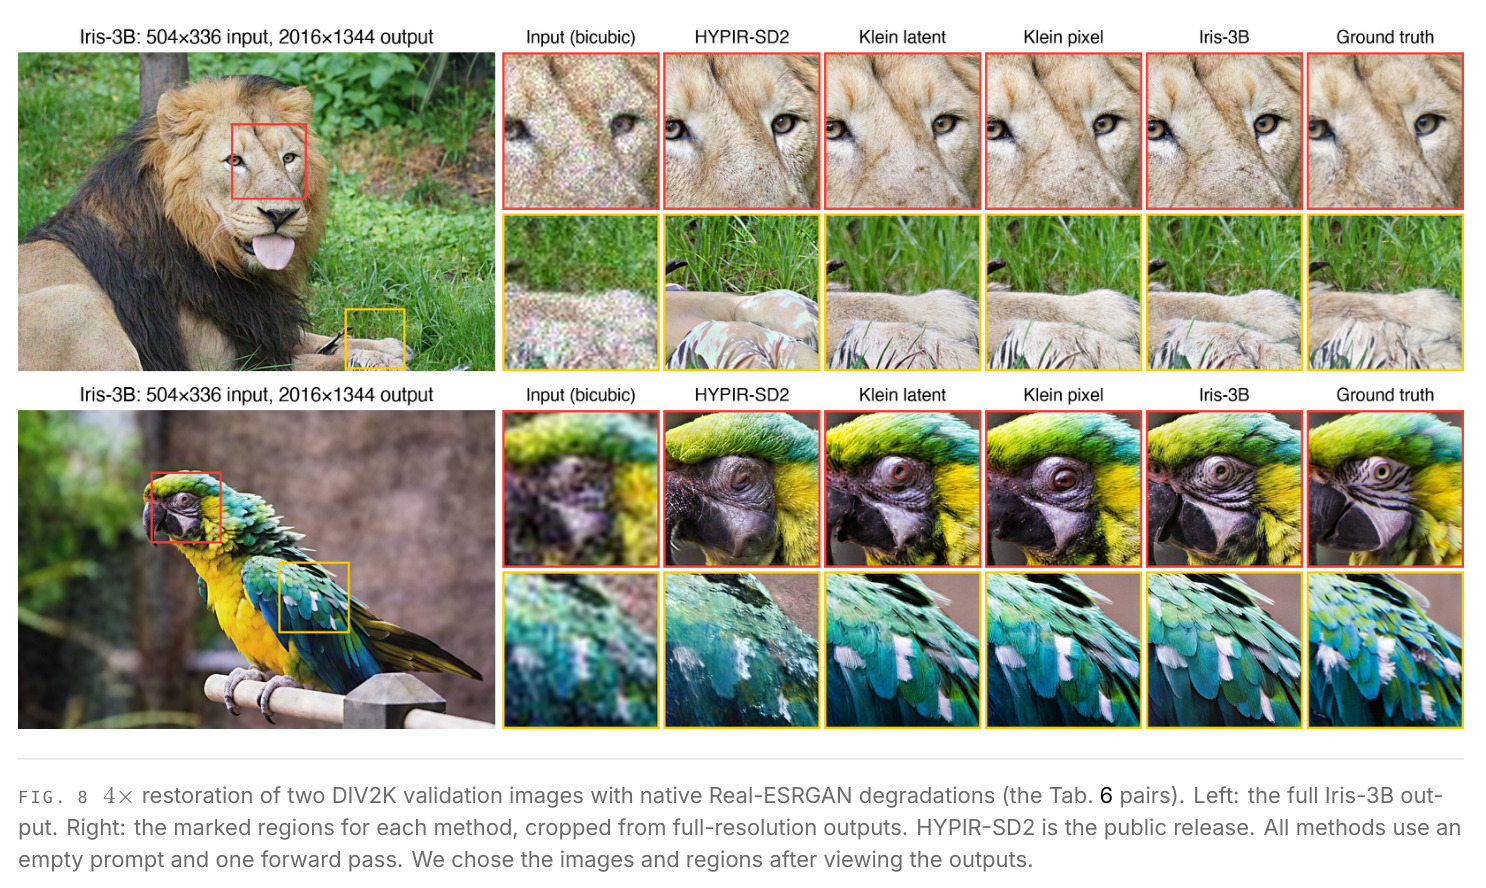
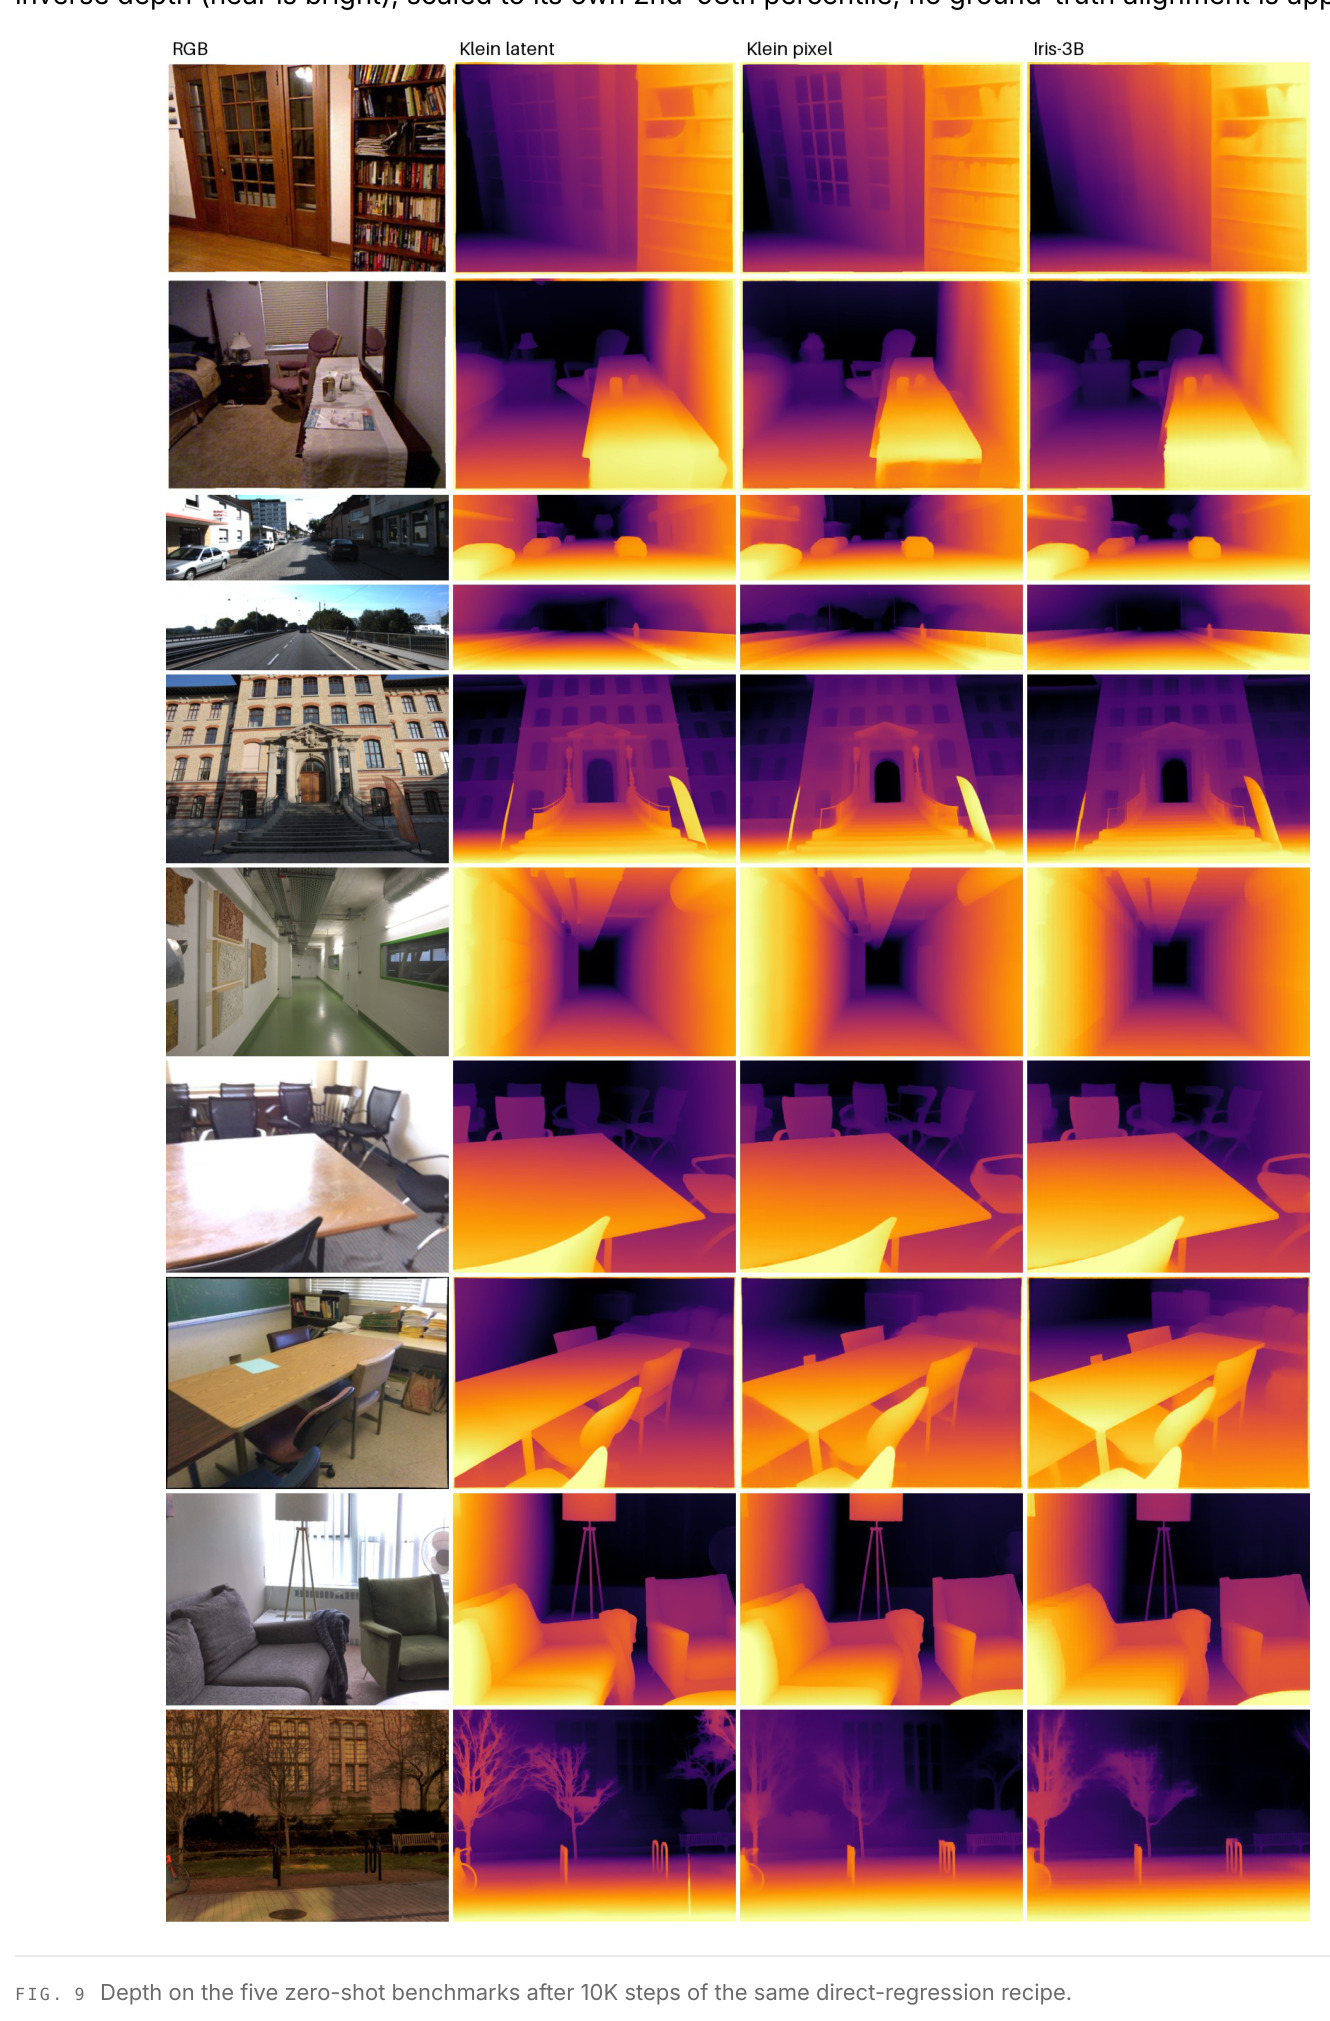
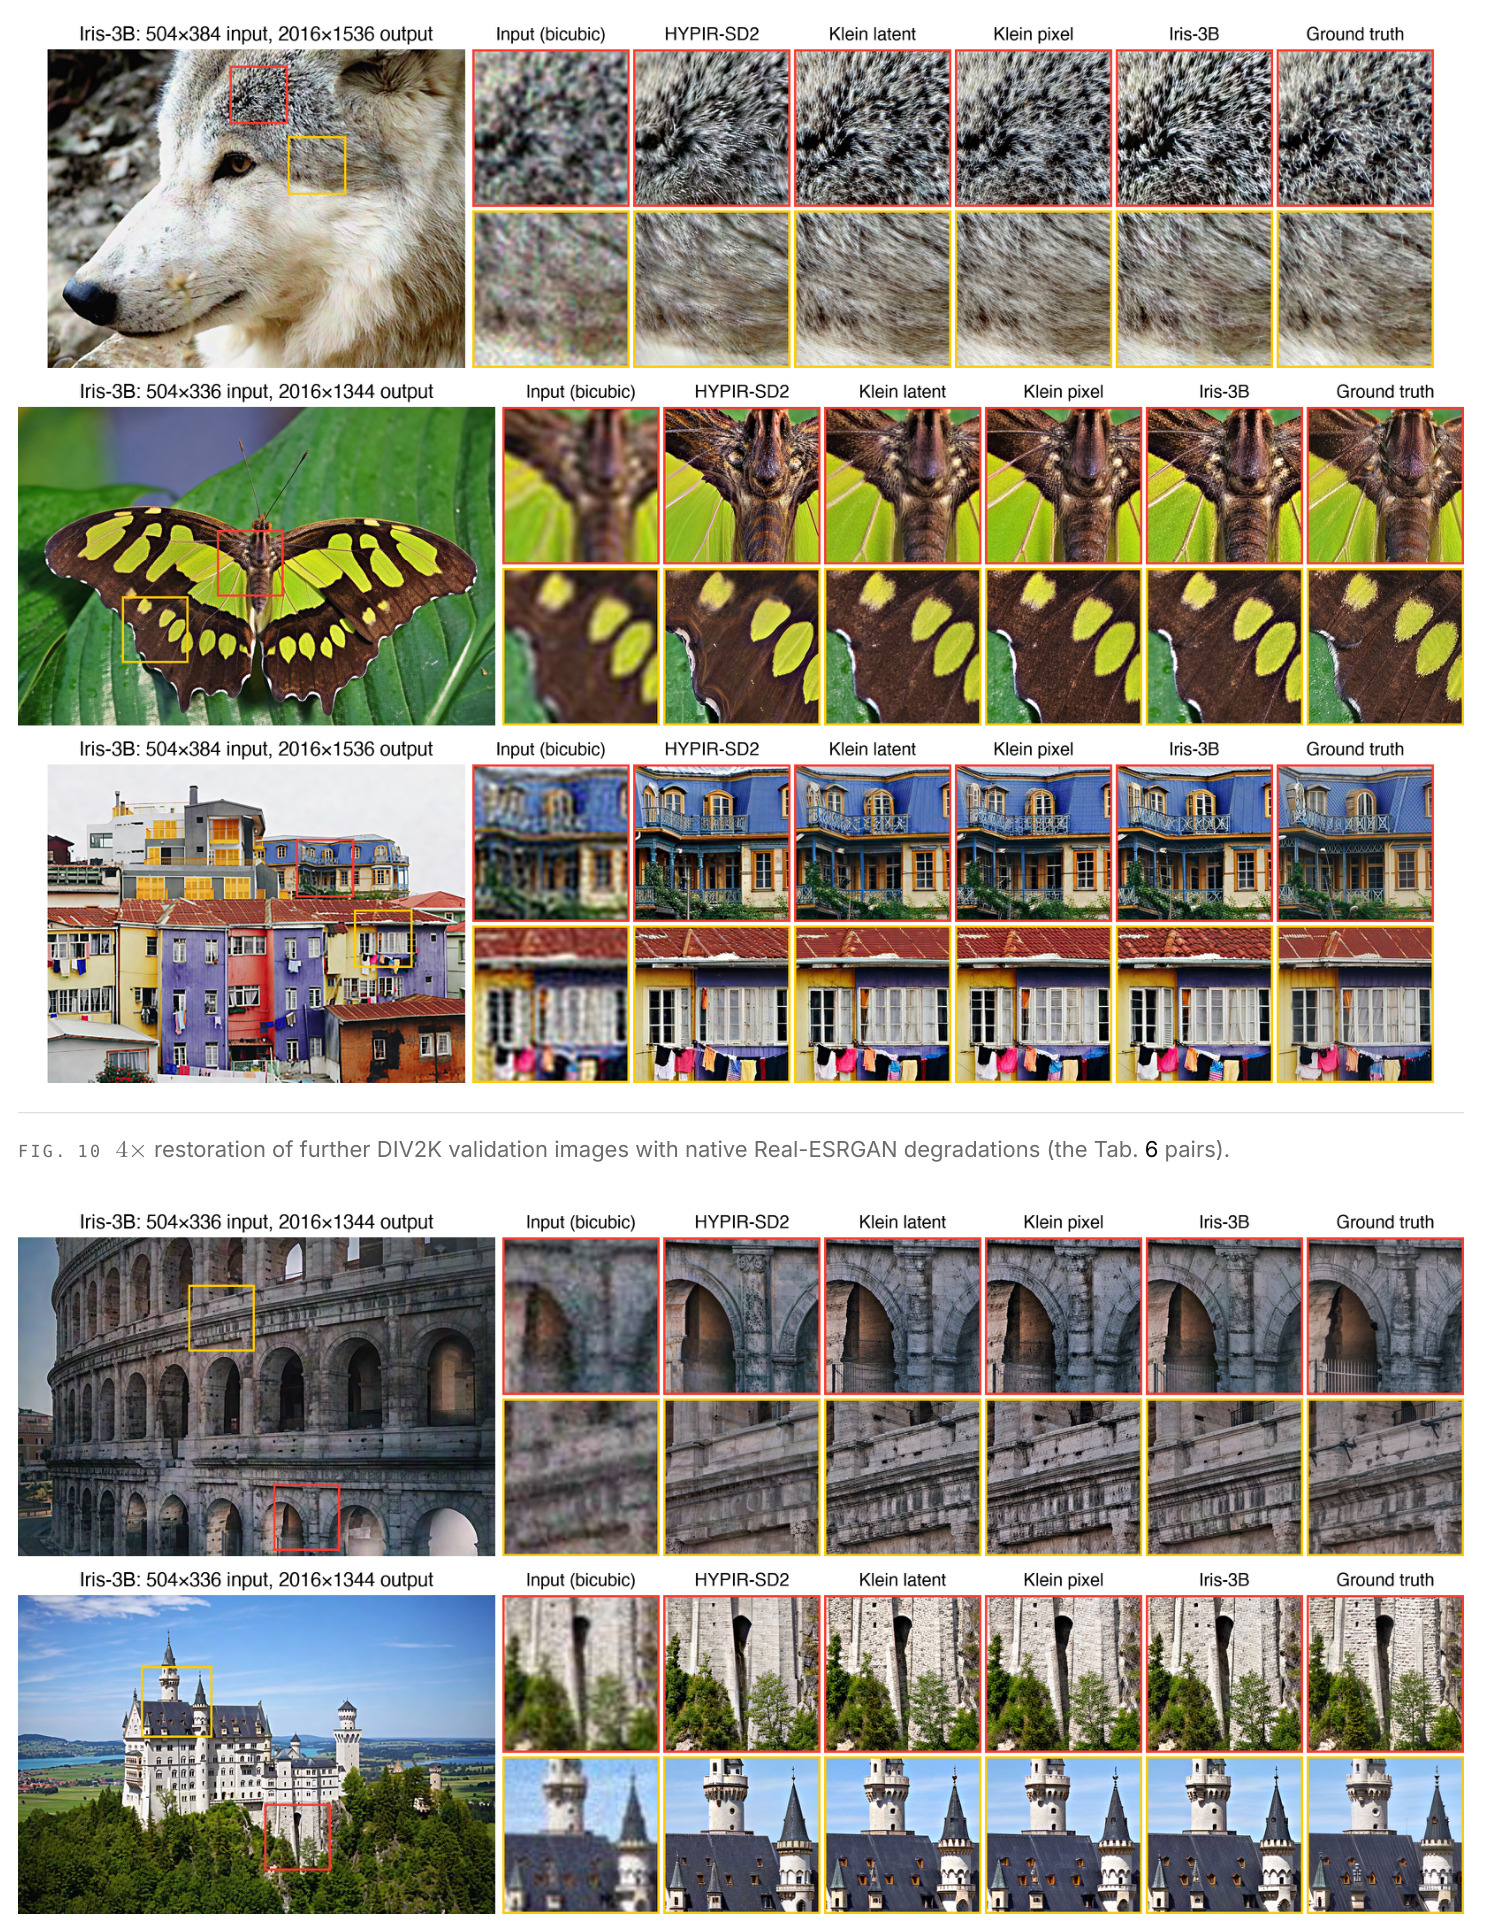
核心结论是负结果:像素空间生成先验未带来显著提升。文生图:Iris-3B 在 1024² 达 GenEval 0.798、DPG 86.52、LongText 0.857、OneIG-EN 0.540,明显超过 FLUX.1-dev(0.66/83.8/0.607/0.434),DPG 与 i1 持平,但 GenEval 落后 i1、Z-Image(0.84)与 Qwen-Image(0.87),长文本渲染是最大短板。深度(三臂同配方 10K 步、五基准零-shot):Iris-3B 平均 AbsRel .071/δ1 .946 与隐 Klein(.072/.947)持平,KITTI、DIODE 更好、SEE 最低(.496 vs .528),但 NYUv2/ETH3D/ScanNet 更差;转换像素 Klein(.081/.934)除 KITTI 外全面落后。修复(DIV2K 4×):像素 Klein(PSNR 20.87/SSIM 0.504/NIQE 4.11)多数指标劣于隐 Klein(20.99/0.557/3.26),LPIPS 持平;Iris-3B(20.68/0.481/0.292)不占优但 MUSIQ 68.01 全表最高。附加发现:像素模型深度预测均有 patch 网格伪影(边界曲率比 Iris-3B 2.14–2.25、像素 Klein 1.31–1.44、隐模型 0.97–0.99 无网格),与 PixelUMM 独立报告一致。作者强调各臂均为单次短预算运行、无显著性检验,差异应读作『无优势』而非可靠劣势。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生图 | GenEval @1024²(官方评测器) | Iris-3B 0.798 | FLUX.1-dev 12B 0.66;i1 3B 0.84;Z-Image 6B 0.84;Qwen-Image 20B 0.87 | 较 FLUX.1-dev 大幅提升,但落后 i1/Z-Image/Qwen-Image(后两者用 prompt 改写) |
| 文生图 | DPG-Bench @1024² | Iris-3B 86.52 | FLUX.1-dev 83.8;i1 86.7;Qwen-Image 88.3 | 领先 FLUX.1-dev,与 i1 持平,落后 Qwen-Image |
| 文生图 | OneIG-Bench(英文 overall)@1024² | Iris-3B 0.540 | Qwen-Image 0.539;Z-Image 0.546;FLUX.1-dev 0.434 | 与 Qwen-Image 持平、略低于 Z-Image |
| 单目深度估计(零-shot 五基准平均) | AbsRel ↓ / δ1 ↑ | Iris-3B .071 / .946 | 隐空间 FLUX.2 Klein .072 / .947;像素转换 Klein .081 / .934 | 与隐空间持平(无像素优势),明显优于转换像素模型 |
| 单目深度估计(Hypersim 测试集) | SEE ↓(soft edge error, kernel 3) | Iris-3B .496 | 隐空间 Klein .528;像素 Klein .526 | 边缘误差三者最低,但基准间互有胜负 |
| 图像修复 4×(DIV2K 验证集) | PSNR ↑ / SSIM ↑ | 像素 Klein 20.87 / 0.504;Iris-3B 20.68 / 0.481 | 隐空间 Klein 20.99 / 0.557 | 均为负提升:两个像素模型都不如隐空间孪生 |
| 图像修复 4×(DIV2K 验证集) | MUSIQ ↑(无参考质量) | Iris-3B 68.01;像素 Klein 67.03 | 隐空间 Klein 67.11;HYPIR-SD2 67.53;OSEDiff 67.75 | Iris-3B 为表内所有方法最高(该对比不匹配) |
| 深度预测伪影(patch 网格) | patch 边界曲率比 ↓(1=无网格) | Iris-3B 2.14–2.25(网格最强) | 隐空间 Klein 0.97–0.99(无网格);像素 Klein 1.31–1.44 | 负向发现:像素模型的 patch 化设计引入系统性网格伪影 |
局限与改进
作者坦承并经核实的局限:(1) Iris-3B 按构造没有隐空间孪生,与隐 Klein 的深度对比混合了表示空间、规模、数据与算力四个变量,正面假设只能间接检验;(2) 两个匹配对比共享转换父模型 PiT 30K,其先验因短程转换大概率弱于完全预训练的隐 Klein,转换臂劣势可能反映转换损耗而非像素空间本身,且转换模型的 GenEval/DPG/FID 未测量;(3) 每臂均为单次短预算运行(深度 10K 步、修复 10–30K 步)且无显著性检验;(4) Iris-3B 修复臂与两 FLUX 臂不匹配:checkpoint、batch(40 vs 8)、调度不同,推理还加小波颜色校正与分块;(5) x vs v 对比同时改了时间步分布(x 臂用 logit-normal(0.8,0.8)),未隔离预测目标;(6) Iris-3B 算力与数据适中,生成质量非 SOTA。我们补充:深度训练只用合成数据,patch 网格在真实图像上的影响未量化;修复评测全用空 prompt,文本条件未利用;增益匹配初始化只在 batch 8、1K 步探针上验证。
独立分析的弱点
独立分析出以下弱点。其一,最干净的实验缺席:检验像素先验本应做同数据、同算力预训练的像素/隐空间孪生对比,但作者没有训练隐空间版 Iris-3B,与隐 Klein 的对比被规模、数据、算力混杂——应补等算力隐空间对照。其二,下游预算过短:深度仅 10K 步、修复 10–30K 步,若像素优势需更长微调才能兑现会被系统性低估——应做 10K/50K/200K 步的预算扫描。其三,patch 网格伪影与立项动机冲突:PiT 头中 patch 间只经 1280 维压缩 token 通信,Iris-3B 网格比高达 2.14–2.25,而『更细细节』恰是选像素空间的理由——换 PixelUMM 式卷积/PixelShuffle 重叠感受野输出头是应有之义。其四,修复评测全用空 prompt,浪费了文生图先验的语义能力,与 SeeSR 等利用语义提示的方法相比既不公平也不利己;真实退化只有定性图无统计。其五,x vs v 消融混入时间步分布变化,『v 不劣于 x』可信但『x 更优』无法排除,应补只改预测目标的对照。其六,深度训练只见合成数据(Hypersim/VKITTI2),网格伪影在真实图像上的影响未量化。
未来方向
作者提出三个方向。第一,改进 Iris-3B:用强化学习与少步蒸馏提升生成质量与采样速度。第二,移除 patch 网格:PiT 头中 patch 边界两侧像素从不在像素分辨率上共同处理,换感受野重叠的输出头(PixelUMM 研究的卷积头与 PixelShuffle 头)是自然修复方案,深度估计是其直接试金石。第三,无 VAE 的编辑与参考图生成:编辑要求未改动区域逐像素精确复现,恰是有损隐空间最该吃亏的场景——PixelUMM 已展示以原始像素 patch 作参考条件,而 Iris-3B 本就经 Qwen3-VL 读提示词,加入编辑数据即可得到全像素空间编辑模型;若配以同数据同算力预训练的隐空间对照,可消除本文全部混杂,在像素优势理论上最大的场景正面检验假设。可延伸的方向:把『增益匹配岭初始化+主干 LR 缩放』推广到 SD3、Qwen-Image 等其他隐模型转换并量化损耗曲线;更大算力下重跑深度/修复匹配实验并做显著性检验;探查 REPA-DINOv3 劣于 DINOv2、Self-Flow 失败的机理;研究 patch 网格与下游性能的因果联系。
复现评估
复现友好度分层明显。最大利好是 Iris-3B 权重与训练代码完全开源(github.com/speridlabs/iris-3b),3B 级像素空间文生图模型完整开源极为罕见。数据层面:预训练数据只描述为大型英文图文对集合(真实照片+合成图+渲染文字图),未给出规模与来源清单,从零预训练无法严格复现;下游数据全公开——深度用 Hypersim、Virtual KITTI 2 与五个标准基准,修复用 DIV2K 加 Real-ESRGAN 二阶退化,评测沿用 Marigold V2 与 HYPIR/PyIQA 公开实现。转换所需 FLUX.2 Klein base 4B 需向 Black Forest Labs 获取。算力未披露,但由 3B 参数、约 6.12 亿样本、1024² 阶段 batch 512 推断预训练需多节点 H100 级集群;下游微调门槛低——深度 batch 32×10K 步、修复 batch 8×30K 步,单节点 8 卡可行。转换配方(增益匹配准则、0.12× 主干 LR、batch 112/warmup 1K 步)有公式级描述。总体:评测与微调易复现,转换中等,从零预训练仅适合大算力实验室。
论文图表
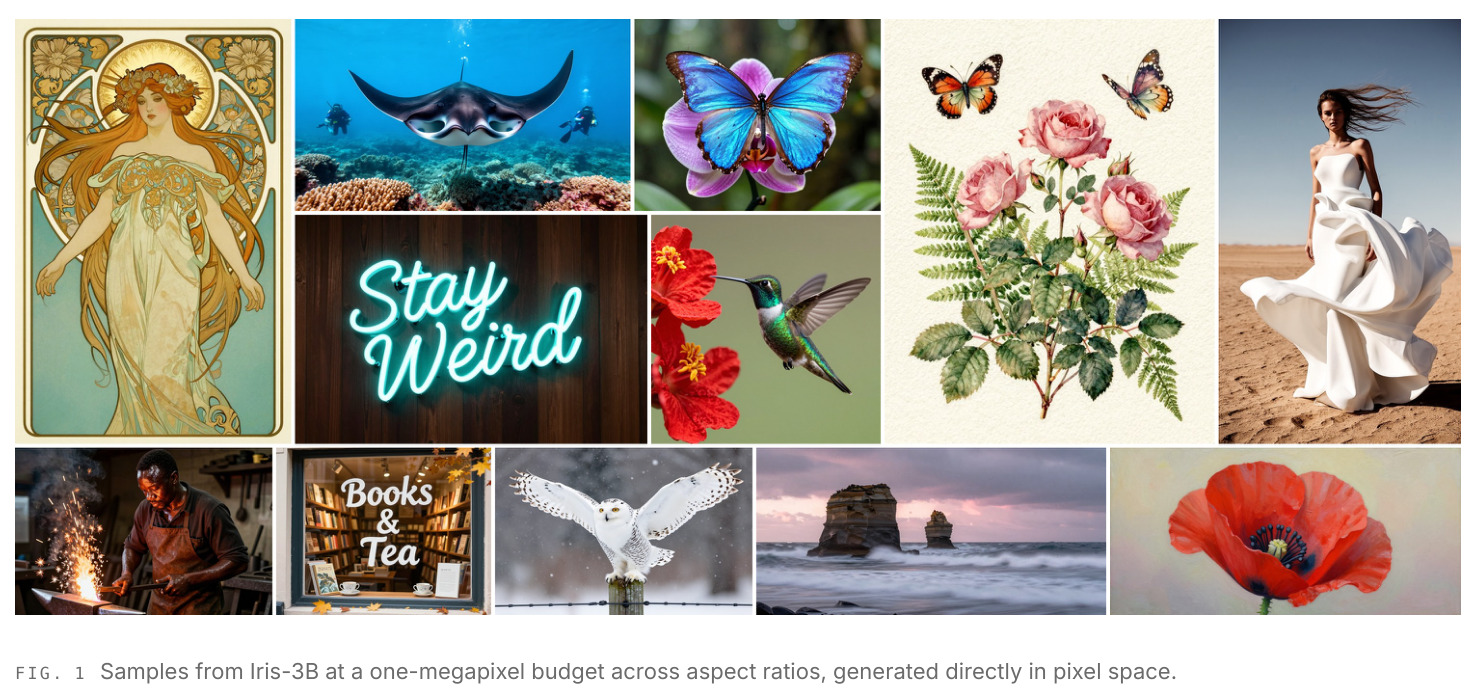
Iris-3B 在约一百万像素预算、多种宽高比下直接在像素空间生成的样本图集,展示人物、动物、风景、风格化绘画等多种题材的生成质量。
让读者直观感受这个 3B 像素空间模型的实际输出水平,是理解『像素空间预训练在 3B 规模可行』这一正面结论的第一手证据。
附录 C:DIV2K 修复对比的续图,设置同前。
继续扩充定性证据,与 Tab. 6 的定量结果互为支撑。
Iris-3B 训练课程表:256 阶段 0–367K 步(batch 1024,3.758 亿样本)、512 多宽高比 367K–530K 步(1.669 亿)、1024 多宽高比 530K–625K 步(batch 512,4860 万)、SFT 625K–665K 步(2050 万,LR 4e-5)。
给出完整的预训练课程与算力规模,是复现 Iris-3B 训练的最关键配置信息。
Iris-3B 与 FLUX.1-dev(GenEval 0.66/DPG 83.8/LongText 0.607/OneIG 0.434)、i1(0.84/86.7/0.922)、Z-Image(0.84/88.1/0.935/0.546)、Qwen-Image(0.87/88.3/0.943/0.539)在四个官方基准上的对比:Iris-3B 为 0.798/86.52/0.857/0.540。
量化支撑『像素空间预训练在 3B 规模可达有竞争力的文生图质量』这一结论,也明确指出与顶级隐空间模型的差距所在。
下游实验覆盖矩阵:FLUX.2 Klein 同时有像素/隐空间两臂可用于深度与修复(2×2 匹配对比),Iris-3B 按构造没有隐空间孪生(n/a),只能与 FLUX.2 Klein 系做跨父模型比较。
一图看清论文对比设计的结构与其固有的混杂来源,是理解全部局限性讨论的钥匙。
三臂深度结果:隐 Klein 平均 AbsRel .072/δ1 .947(Hypersim SEE .528)、像素 Klein .081/.934(.526)、Iris-3B .071/.946(.496);各基准上互有胜负。
核心负结果的主表:像素空间先验既未超过(Iris-3B 持平)也未接近(转换模型落后)隐空间基线,所有后续局限性讨论都围绕它展开。
patch 网格伪影定量:隐 Klein 在四个基准上为 0.97–0.99(无网格),像素 Klein 1.31–1.44,Iris-3B 2.14–2.25(网格最强)。
首次定量刻画像素扩散模型的 patch 化设计缺陷,直接指向 PiT 头的架构改进方向,是论文最有原创性的测量之一。
修复主表:隐 Klein PSNR 20.99/SSIM 0.557/LPIPS 0.275/NIQE 3.26/MUSIQ 67.11/DeQA 4.06;像素 Klein 20.87/0.504/0.274/4.11/67.03/4.04;Iris-3B 20.68/0.481/0.292/3.94/68.01/3.87;另与 R-ESRGAN、StableSR、DiffBIR、SeeSR、SUPIR、InvSR、OSEDiff、S3Diff、HYPIR-SD2 九个公开方法对比。
支撑第二个负结果(修复上像素模型不更好)的主表,同时展示像素模型与开源修复方法整体处于同一竞争力区间。