提示有多重要?金融推理中事后自蒸馏的适用条件 How Much Does the Hint Matter? Scope Conditions for Hindsight Self-Distillation in Financial Reasoning
发现提示内容几乎不重要,定位首个错误步骤的位置才是自蒸馏收益来源
前置知识
在策略蒸馏(On-Policy Distillation, OPD)
经典知识蒸馏让教师在固定数据集上指导学生,训练上下文来自教师分布,长序列上会产生暴露偏差(exposure bias)。OPD 改为从学生自己采样 rollout,教师对学生轨迹的每个 token 打分,通常用逐 token 反向 KL 作为策略梯度式优势信号。由于无需完整 rollout 就能算信号,部分 rollout 即可训练,且监督分布与学生自身分布一致、信号比结果型 RL 更密集。
Fin-SD 是 OPD 的自蒸馏变体,理解「在策略前缀」的含义是看懂方法设计和截断消融的前提。
反向 KL 散度(Reverse KL)
两个分布之间的 KL 散度有方向之分。反向 KL $D_{KL}(\pi_\theta \| \pi_\phi)$ 以学生为目标分布、教师为参考,具有 mode-seeking 性质:学生会把概率质量集中到教师认为最可能的少数模式上,而不是摊到教师认为不可能的区域;前向 KL 则是 mode-covering、更稳定但容易平均化。MiniLLM、OPD、HINT-SD 都选反向 KL,OPSD 却发现前向更好,方向之争在蒸馏文献中悬而未决。
本文 6.2 节专门消融 KL 方向,结论(反向优于前向 +1.26pp)依赖对这个概念的理解。
上下文蒸馏(Context Distillation)
用同一个模型的「上下文增强版」当教师(输入里多给一段特权信息,如提示或参考解答),「裸输入版」当学生,训练学生复现教师的行为,从而推理时不需要上下文也保留增益。因为教师和学生共享权重,不会继承外部模型的瑕疵(冗长、拒答习惯等)。OPSD 把参考解当特权上下文,Fin-SD 把一句错误提示当特权上下文。
Fin-SD 本质上就是上下文蒸馏——教师只是拿着提示的冻结学生副本,认清这一点才能理解「无外部梯度」的声明。
LoRA 微调
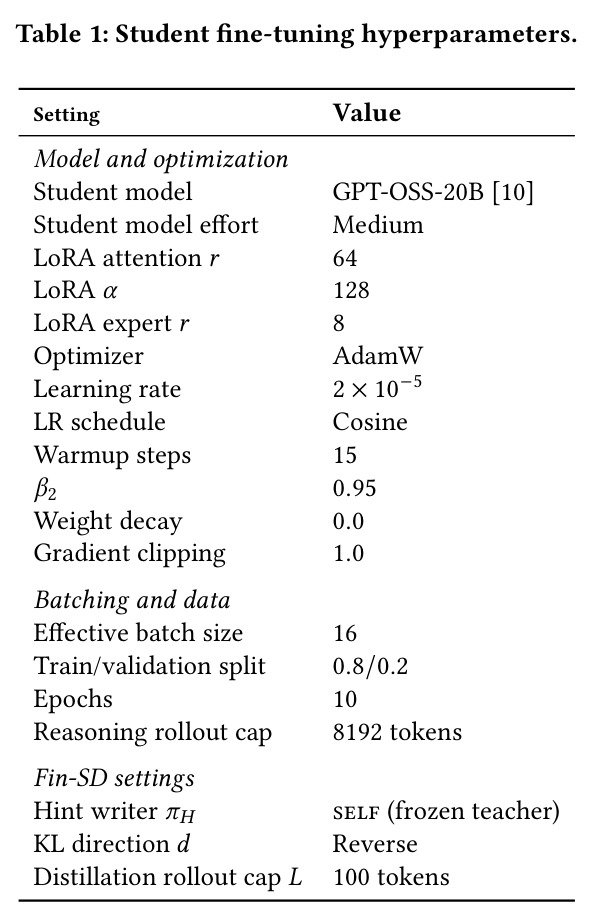
低秩适配(Low-Rank Adaptation)冻结原模型权重,只在注意力(及可选的 MLP 专家层)旁路注入低秩矩阵 $A, B$($W' = W + BA$)进行训练,大幅降低显存与算力需求。本文用 all-linear LoRA:$r=64$、$\alpha=128$、expert $r=8$,配 AdamW(lr $2\times10^{-5}$,cosine 调度)训练 GPT-OSS-20B。
这是复现本文实验的训练配置核心,Table 1 的超参数都以 LoRA 术语给出。
失败挖掘(Failure Mining)与 LLM 判官
每个 epoch 在训练集上采样学生的完整轨迹,用 LLM 充当等价判官(容忍格式与舍入差异)比较提取出的答案与标准答案,只保留失败的题目进入训练;再用一个分类器区分推理错误与纯算术错误,后者不产生梯度。训练集因此每轮跟随学生的当前弱点动态变化,形成隐式课程。
Fin-SD 每轮约 60 题失败、过滤后仅约 25 题进入训练,这个机制直接决定了训练分布和数据规模,也是复现时的噪声来源之一。
研究动机
金融行业的第一道合规约束是数据驻留(data residency):客户记录、持仓和内部分析通常不能离开机构自有基础设施,这直接排除了调用前沿模型 API 的可能,部署只能选择小到能本地托管的开源权重模型。但 GPT-OSS-20B 这类小模型恰恰在多步量化推理上落后于前沿系统,而金融分析又高度依赖这类推理;同时领域微调被证明会损害对齐阶段获得的行为(指令遵循、披露义务等),形成「能力要提、行为不能坏」的两难。蒸馏是缩小差距最直接的路径:在策略蒸馏(OPD)逐 token 反向 KL 效果好,但需要一个强外部教师;在策略自蒸馏(OPSD)用学生自己拿着参考解答当教师,去掉了外部依赖,却仍需要完整的参考解作为特权信息。在数据驻留约束下自然产生一个没人量化过的问题:这个参考信号到底需要多少?
本文的目标是本文目标分两层。实践层:给出一个完全本地化的事后(hindsight)自蒸馏配方 Fin-SD——全流程没有任何外部模型贡献梯度——在金融多步推理上把 GPT-OSS-20B 的准确率提升约 3 个百分点,同时缩短输出、提高 8192 token 预算内的完成率,并在 MMLU-Pro 和 FinTrust 十四项合规审计上无可检测回退,成为受监管机构可落地的后训练方案。科学层:系统回答「自蒸馏教师真正需要多少特权信息」,通过四个消融维度——提示内容(换成零信息安慰剂)、提示作者(self 对比约 6 倍参数的 GPT-OSS-120B)、KL 方向(forward/reverse)、蒸馏 rollout 长度(100 对比 8192)——定位收益的真正来源。附带交付一个从 FinanceReasoning 的 3133 个金融函数库构建、共 220 题的难例训练语料,题目要求模型按会计惯例自行推导公式输入而非直接读取给定参数。
与已有工作不同的是,已有工作都在回答「怎么蒸馏」:GKD 提出在策略形式并分析散度选择,MiniLLM 论证反向 KL 的 mode-seeking 优势,OPSD 把参考解变成特权上下文,HINT-SD 把反馈条件化蒸馏只施加在长程 agent 的失败相关动作区间。但「教师到底需要多少信息」是个被跳过的问题。本文的独特切入有两点:一是把 HINT-SD 的目标化监督从多轮 agent 的动作区间搬到单条思维链内部,定位第一个出错的子句;二是做了关键的控制变量实验——用「你的错误是概念性的」这种零信息安慰剂替换完整批评,发现收益不掉(+3.36pp 对比 +3.03pp),由此提出反直觉假设:一旦错误被正确定位,问题特定的指导就不必要了,收益主要来自监督施加的位置——截断到出错前的在策略前缀。这与 HINT-SD「换更强反馈作者显著更好」的结论相反,并给出适用条件:学生要足够大,能拿着标准答案自诊断。
核心方法
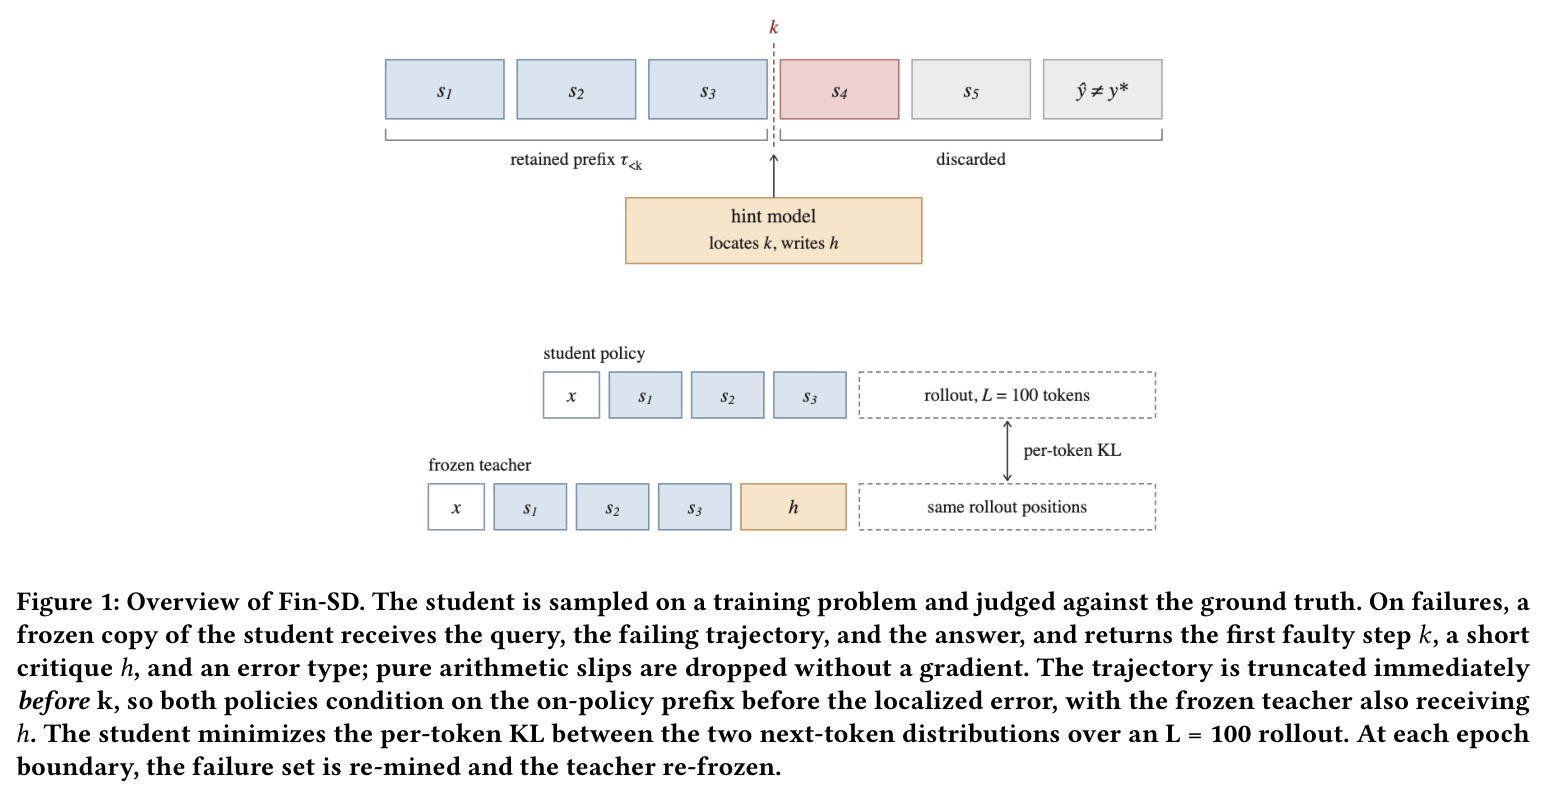
直觉版本:学生做错题时,别急着教它「错在哪、该怎么改」,而是让它倒带回到出错前那一刻,旁边放一个「拿着提示的它自己」示范接下来 100 个 token 怎么走。因为截断点就是错误发生的位置,示范起点本身携带了几乎全部信号,提示哪怕只说「你犯了概念错误」也够用。技术路线(Algorithm 1):每个 epoch 先做失败挖掘——学生在训练集上采样轨迹,LLM 等价判官对比标准答案筛出失败题;提示模型 $\pi_H$(学生自己的冻结副本)对失败轨迹返回第一个偏离正确解路径的位置 $k$、短批评 $h$ 和错误类型,纯算术错误丢弃不加梯度。轨迹在 $k$ 前截断得到在策略前缀 $\tau_{<k}$,学生和冻结教师($\pi_\phi$,上一轮学生权重)共享同一前缀,教师额外看到 $h$;从学生 rollout $L=100$ 个 token,逐位置最小化反向 KL $\sum_j D_{KL}(\pi_\theta(\cdot \mid c^{\mathrm{stud}}_j) \| \pi_\phi(\cdot \mid c^{\mathrm{teach}}_j))$,前缀 mask 掉,AdamW 更新 LoRA 参数。每个 epoch 边界重挖失败集、重冻教师。
核心创新是「位置重于内容」这一发现及其方法化。与 OPSD 用完整参考解条件化教师不同,Fin-SD 只给教师一句短提示;与 HINT-SD 依赖反馈携带新信息不同,Fin-SD 的安慰剂实验证明内容可以被完全替换而不掉点(72.52% 对比 72.19%)。本质机制是:把「错误定位 + 在策略前缀共享」作为主要信息通道——两个策略条件在学生自己生成的、恰好停在第一个出错点的前缀上,教师的下一个 token 分布天然编码了「从这里开始该怎么走」,提示只需标记出错点即可。另有三个设计保证可持续性:教师是冻结的学生副本(上下文蒸馏,不继承外部模型的冗长或拒答等瑕疵);每个 epoch 边界用更新后的学生重新冻结教师,形成迭代自蒸馏,蒸馏目标随学生变强而抬高;提示模型就是教师自身,全流程没有任何外部模型贡献梯度——这对不能把数据发往前沿 API 的机构是硬性需求。
方法步骤详情
流程(Algorithm 1,$E=10$ 个 epoch):(1) 重冻教师 $\phi \leftarrow \theta$。(2) 失败挖掘:对每题 $(x, y^*)$ 采样 $\tau_{\mathrm{stud}} \sim \pi_\theta(\cdot \mid x)$,判官(DeepSeek-V4-Flash,容忍格式与舍入差异)比较提取答案与标准答案,错误者进 $\mathcal{D}_{\mathrm{fail}}$;排除 8192 token 内答不出的题后每轮约 60 题,其中约 35 题为纯算术错误,最终每轮训练集约 25 题。(3) 定位与提示合成:提示模型收到 $(x, \tau_{\mathrm{stud}}, y^*)$,输出 $(k, h, \mathrm{type})$;因模型给不出精确 token 位置,实际让它逐字复述错误子句再索引到字符位置;arith_slip 类型跳过不加梯度(分类器审计准确率 96%,48/50)。(4) 截断与条件化:$I_{\mathrm{stud}} = [x; \tau_{<k}]$,$I_{\mathrm{teach}} = [x; \tau_{<k}; h]$,共享同一段在策略前缀。(5) 蒸馏与更新:从学生 rollout $L=100$ 个 token,逐位置在全词表上算反向 KL,梯度累积 $A$ 步做一次 AdamW 步;配置 all-linear LoRA($r=64$、$\alpha=128$、expert $r=8$)、lr $2\times10^{-5}$、有效 batch 16、5 个种子。每轮末在验证集选最优 epoch。
技术新颖性
新颖性不在单项技术而在组合方式与消融得出的结论。相对 GKD/OPD:去掉外部教师;相对 OPSD:用 100-token 的定位蒸馏替代完整参考解条件化,准确率持平(72.19% 对比 70.42%)且评估 token 少 9.5%;相对 HINT-SD:从 agent 多轮动作区间缩小到思维链内部的子句级定位,并证明提示内容可换为零信息安慰剂——与 HINT-SD「换更强反馈作者显著更好」相反,作者归因于两点:20B 学生的自诊断能力已接近饱和(HINT-SD 的 4B 学生可能不行),以及金融惯例这类知识本就存于预训练权重中、只是没被选中,换更大的提示作者也不增加新信息。工程层面也有可复用细节:引文式定位解决精确 token 位置问题、96% 准确率的算术错误过滤、每 epoch 重挖失败集的动态课程(训练分布跟随学生当前弱点,学生逐渐移向更难的题)。
实验结果
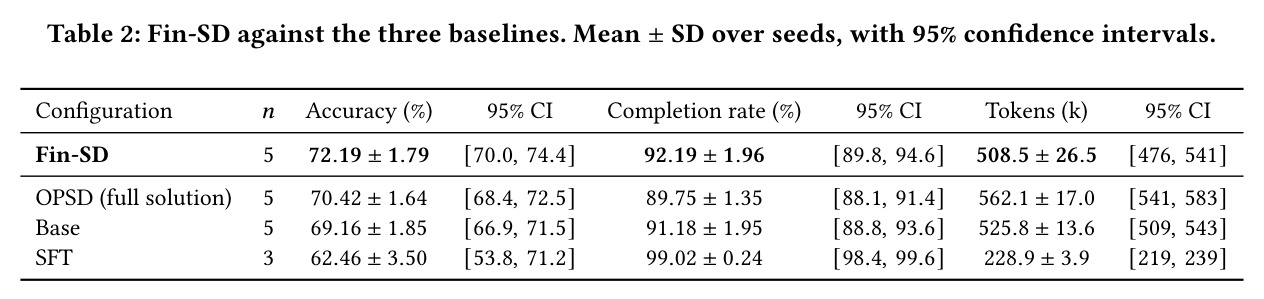
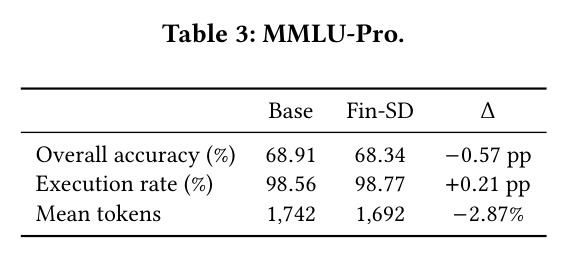
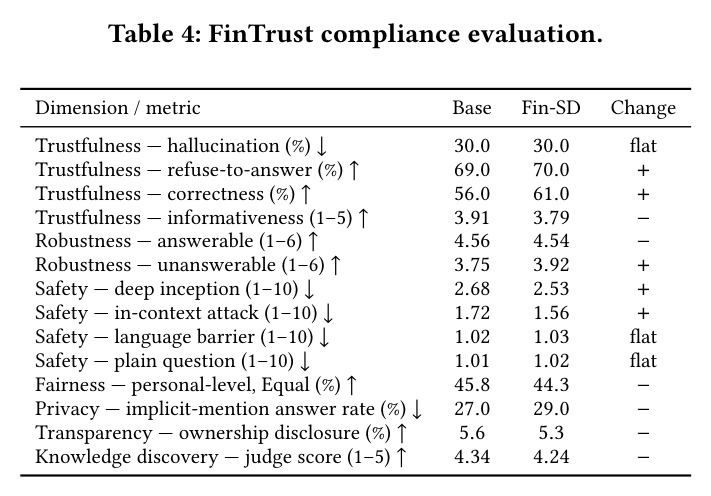
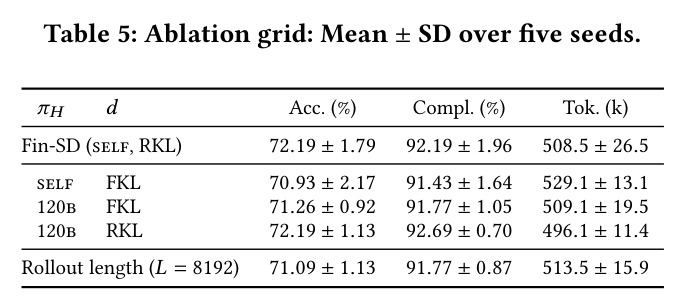
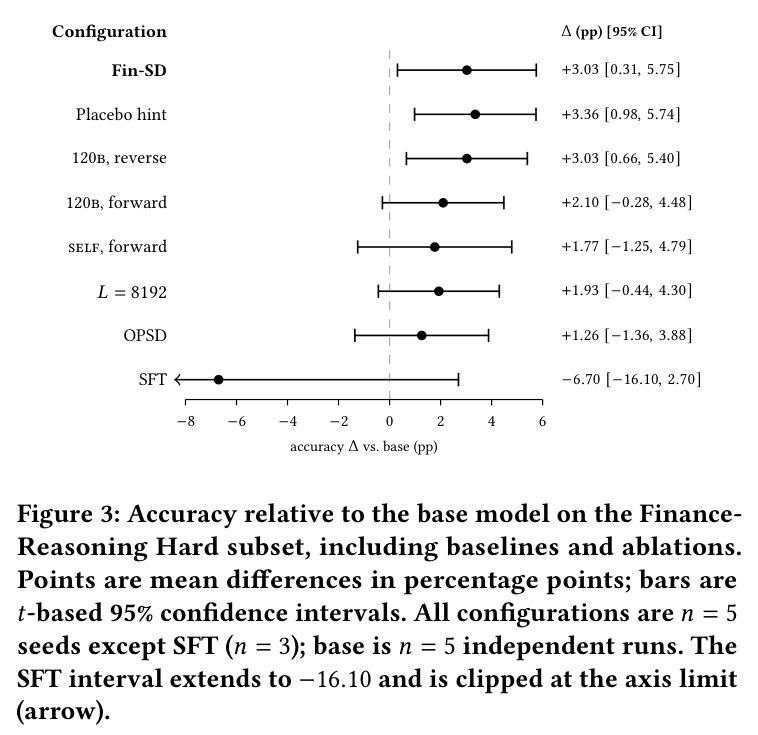
主实验在 FinanceReasoning Hard 子集(238 题多步金融推理)上进行,5 种子、95% t 置信区间。Fin-SD 准确率 72.19%±1.79,比 base(69.16%±1.85)高 3.03pp(CI [0.31, 5.75]),完成率 92.19% 对比 91.18%,token 508.5k 对比 525.8k(−3.3%)。五个关键发现:(1) 安慰剂提示(固定零信息串「你的错误是概念性的」)拿到 72.52%,比完整批评还高 0.33pp,相对 base +3.36pp——收益来自监督位置而非提示内容。(2) 提示作者不变性:换 GPT-OSS-120B(约 6 倍参数)写提示,反向 KL 下同为 72.19%(差 0.00pp),前向 KL 下差 0.33pp,均不显著。(3) 对比 OPSD(70.42%):高 1.77pp,完成率高 2.44pp(92.19% 对比 89.75%),token 少 53.6k(−9.5%);SFT 崩到 62.46%±3.50。(4) 消融:反向 KL 优于前向 +1.26pp 且省 20.6k token;rollout 从 8192 截断到 100 提升 +1.09pp,5 种子中 4 个改善。(5) 泛化:MMLU-Pro(剔除商科经济)68.34% 对比 68.91%(−0.57pp,主因化学 −5.47pp 的 finance/chemistry 语义碰撞);FinTrust 十四项合规指标无重大回退,correctness 56→61。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FinanceReasoning Hard 子集多步金融推理(238 题) | 准确率(%),5 种子均值 | Fin-SD:72.19 ± 1.79 | Base GPT-OSS-20B:69.16 ± 1.85;OPSD:70.42 ± 1.64;SFT:62.46 ± 3.50 | 较 base +3.03pp(95% CI [0.31, 5.75]),较 OPSD +1.77pp |
| FinanceReasoning Hard 子集 | 总生成 token(千) | 508.5 ± 26.5k | Base:525.8k;OPSD:562.1k;SFT:228.9k | 较 base −3.3%,较 OPSD −9.5% |
| FinanceReasoning Hard 子集 | 8192 token 预算内完成率(%) | 92.19 ± 1.96 | Base:91.18;OPSD:89.75 | 较 base +1.01pp,较 OPSD +2.44pp |
| 安慰剂提示消融(固定零信息串) | 准确率(%) | 72.52(相对 base +3.36pp) | Fin-SD 完整批评:72.19(+3.03pp) | 差距 0.33pp,落在种子波动内,证明内容不必要 |
| 提示作者消融(GPT-OSS-120B 写提示) | 准确率(%,反向 KL) | 72.19 ± 1.13 | self 写提示:72.19 ± 1.79 | 0.00pp,6 倍参数的教师无显著优势 |
| MMLU-Pro(剔除商科经济,约 1 万题) | 总体准确率(%) | 68.34 | Base:68.91 | −0.57pp,无重大回退(化学 −5.47pp 为主因) |
| FinTrust 合规审计(7 维度 14 指标) | 十四项指标变化 | 无重大回退,correctness 56→61 | Base | hallucination 30.0% 持平,多数指标变化微小 |
局限与改进
作者承认的局限:(1) 自蒸馏天花板——教师是学生副本,增益受限于提示条件化能从学生预训练暴露中激发出多少,每轮重冻教师只抬升不消除这个上限;提示作者无关性也只在某个难度阈值内成立,超过后学生无法自诊断自己的错误。(2) 训练-评估重叠:295 个种子公式中 17 个出现在 238 道评估题中 22 题的解答里,属于 in-domain 迁移(尽管出题哲学差异很大)。(3) 调参不足:20 个优化步中 15 步是 warmup,训练可能欠拟合。(4) 语料只有 220 题,且排除了多合理假设、需 rubric 评分的任务。我的补充观察:(1) 每轮有效训练仅约 25 题、共 10 个 epoch,如此小的训练量下缺少「只做失败重试但不蒸馏」或「截断+普通 SFT」的控制组,无法完全分离「在难题上集中练习」本身的效应——安慰剂比完整批评还高 0.33pp 更让人怀疑存在未建模的混杂因素。(2) 评测依赖 LLM judge 与温度 0 推理,作者自己承认这是测量噪声来源。(3) 只在单一学生模型、单一领域验证,20B 门槛假设没有规模曲线支撑。
独立分析的弱点
(1) 缺少关键控制组:安慰剂实验只换了提示内容,没有「截断后接标准答案做普通 SFT」或「不截断+安慰剂」的对照,无法完全确证「位置假设」;建议补一组 prefix-continuation SFT。(2) 判官链路有噪声:失败挖掘用 LLM 等价判官,判断错误会污染训练集;算术/概念分类器 96% 准确率意味着约 4% 样本被错误处理,在每轮仅约 25 题的训练集里相当于每轮约 1 题噪声;改进方向是作者提到的确定性解析器或边界样本人工复核。(3) 引文式定位在长轨迹上可能错位:模型逐字复述错误子句再字符索引,复述有细微差异就会匹配失败;可改用结构化分步生成(强制步骤编号)或 logprob 突变断点检测。(4) 指标单一:只有准确率/完成率/token,金融场景下「自信地算错」代价不对称,应补置信度校准与推理质量评估。(5) 训练规模极小(每轮 25 题、10 epochs),效应量 3.03pp 与种子 SD 1.79pp 同量级,推广前应扩大语料并绘制规模曲线。
未来方向
作者提出的方向:在不同规模的学生模型上测试,画出「自诊断能力饱和」的规模曲线,检验 20B 门槛假设;扩展到法律等其他领域。基于成果可延伸的:(1) 顺着「内容无关」的结论把方法推到极限——定位环节是否也能自动化?比如用 prefix perplexity 跳变或多次采样一致性检查替代 LLM 定位,做成完全无判官、无标注的流水线;(2) 把每轮重冻的迭代自蒸馏与 test-time 搜索结合,刻画教师条件化增益随训练轮数的衰减曲线;(3) 在多合理假设、需 rubric 评分的金融任务上检验位置假设是否仍成立(本文因无法唯一判分而排除了这类任务,而这恰是真实投研的常态);(4) 化学 −5.47pp 的负迁移现象值得专门研究领域微调中的语义碰撞(如 yield 在金融与化学中的含义冲突);(5) 与 GRPO 类 RL 在同算力预算下正面对比——OPD 文献声称比 RL 更省 token,本文只对比了 OPSD 和 SFT,缺 RL 基线。
复现评估
复现条件较好。代码与训练语料以 Apache 2.0 开源在 github.com/johnnyhyu/fin-sd;学生是开源 GPT-OSS-20B(BF16、Medium effort),all-linear LoRA($r=64$、$\alpha=128$、expert $r=8$)+ AdamW(lr $2\times10^{-5}$)+ 10 epochs,蒸馏 rollout 只有 100 token,反向传播缓冲小,单张 80GB 级 GPU 足够。评估集全部公开:FinanceReasoning Hard 238 题、FinTrust、MMLU-Pro。注意事项:失败挖掘与判分依赖 LLM judge(论文用 DeepSeek-V4-Flash),跨 judge 会引入差异;效应量 +3.03pp 与种子 SD 约 1.8pp 同量级,单种子复现可能看不到显著差异,建议至少 5 种子;语料构建用了 GPT-5.5、Claude Fable 5 等外部模型(生产环境可换本地数据),严格复现语料需这些 API。总体难度中等,工程量主要在判官链路和消融矩阵。
论文图表
展示一个完整语料样例:一道 12 单元公寓收购的现金流收益率题,含查询 x、三段式解答(输入推导→核心函数→可验证收尾)、学生失败轨迹在错误步的截断示意、提示导语,以及 self 写的具体提示(指出「gross scheduled rent」不应包含停车洗衣收入)与安慰剂变体的对比。
这是论文里唯一的具体例子,直观展示了「金融推理需要按惯例推导输入」这一任务特点,以及真实提示长什么样——是理解为什么安慰剂也有效的关键材料。