基于语言正则化的在策略自蒸馏(VRSD) Self-Distillation with Verbal Regularization
给自蒸馏教师加“反思”系统提示以削弱特权信息的捷径偏置,平均Pass@1提升3.9个百分点
前置知识
知识蒸馏与在策略蒸馏(OPD)
让模型(学生)模仿教师输出的训练范式。传统 off-policy 蒸馏在教师生成的固定文本上做 token 级交叉熵;on-policy 蒸馏则让学生采样自己的回答,在每个位置用 KL/JSD 类散度把学生的 next-token 分布拉向教师在同一前缀上的分布,监督更密集,也避免了学生自身前缀与教师固定文本之间的分布失配。
本文的 VRSD 是在策略蒸馏的变体,所有损失推导与梯度分析都建立在这个框架之上,不懂 OPD 就无法理解监督信号从哪来。
在策略自蒸馏(OPSD)
学生与教师是同一个模型,仅条件不同:学生只看到问题 $x$ 生成回答;自教师额外看到特权信息 PI(如验证过的正确解答 $c$),在学生回答的每个前缀 $y_{<t}$ 上给出 next-token 分布 $q_t=\pi_\theta(\cdot|x,c,y_{<t})$,学生被训练去匹配这些分布,从而免去单独的大教师模型。
VRSD 直接改进 OPSD,唯一改动是把教师分布换成加了系统提示的版本,理解 OPSD 是读懂动机和方法的前提。
特权信息(PI)与捷径偏置
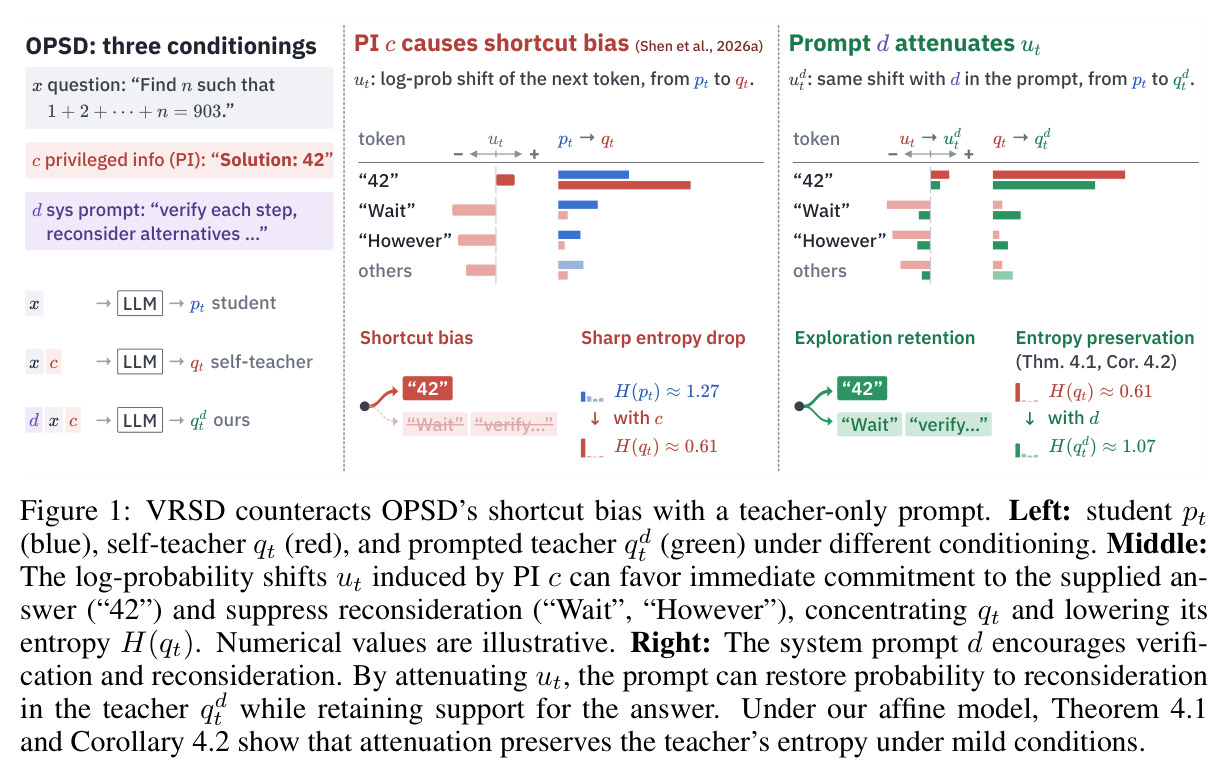
PI 指训练时可得、推理时不可得的信息,如标准答案。近期工作发现教师看到 PI 后产生捷径偏置:log-prob 偏移 $u_t(v)=\log[q_t(v)/p_t(v)]$ 在“直接给答案”的 token 上为正、在“Wait/However”等反思 token 上为负,教师分布熵骤降(论文示例从约 1.27 降到 0.61),蒸馏会把抢答行为和低熵传给学生。
捷径偏置正是本文要解决的问题,VRSD 的全部设计与理论都围绕如何削弱它展开。
广义 Jensen-Shannon 散度(JSD)
两个分布与它们的凸组合 $m_t=\alpha q_t+(1-\alpha)p_t$ 之间 KL 散度的归一化组合:$J_\alpha(q_t\|p_t)=[\alpha D_{\mathrm{KL}}(q_t\|m_t)+(1-\alpha)D_{\mathrm{KL}}(p_t\|m_t)]/[\alpha(1-\alpha)]$。$\alpha\in(0,1)$ 控制偏斜,$\alpha=1$ 退化为反向 KL。OPSD 用它作蒸馏损失,其梯度系数 $A_t(u)=\alpha^{-1}\log[(1-\alpha)+\alpha e^u]$ 随 PMI 单调递增。
论文的关键论证——被 PI 强化的 token 获得更大蒸馏梯度、从而把捷径传给学生——依赖 JSD 梯度的这一性质。
点互信息(PMI)
本文指条件点互信息 $u_t(v)=\mathrm{PMI}(v;c|x,y_{<t})=\log[\pi_\theta(v|x,c,y_{<t})/\pi_\theta(v|x,y_{<t})]$,度量“看到特权信息 $c$ 后 token $v$ 的对数概率变化多少”:正值表示 $c$ 支持 $v$,负值表示压制。AntiSD 首先用它分析自蒸馏,VRSD 进一步把它作为理论建模对象。
仿射衰减模型 $u_t^d=\gamma_t u_t+\kappa_t$ 和全部熵定理都定义在 PMI 之上,它是全文理论的核心变量。
香农熵与分布集中
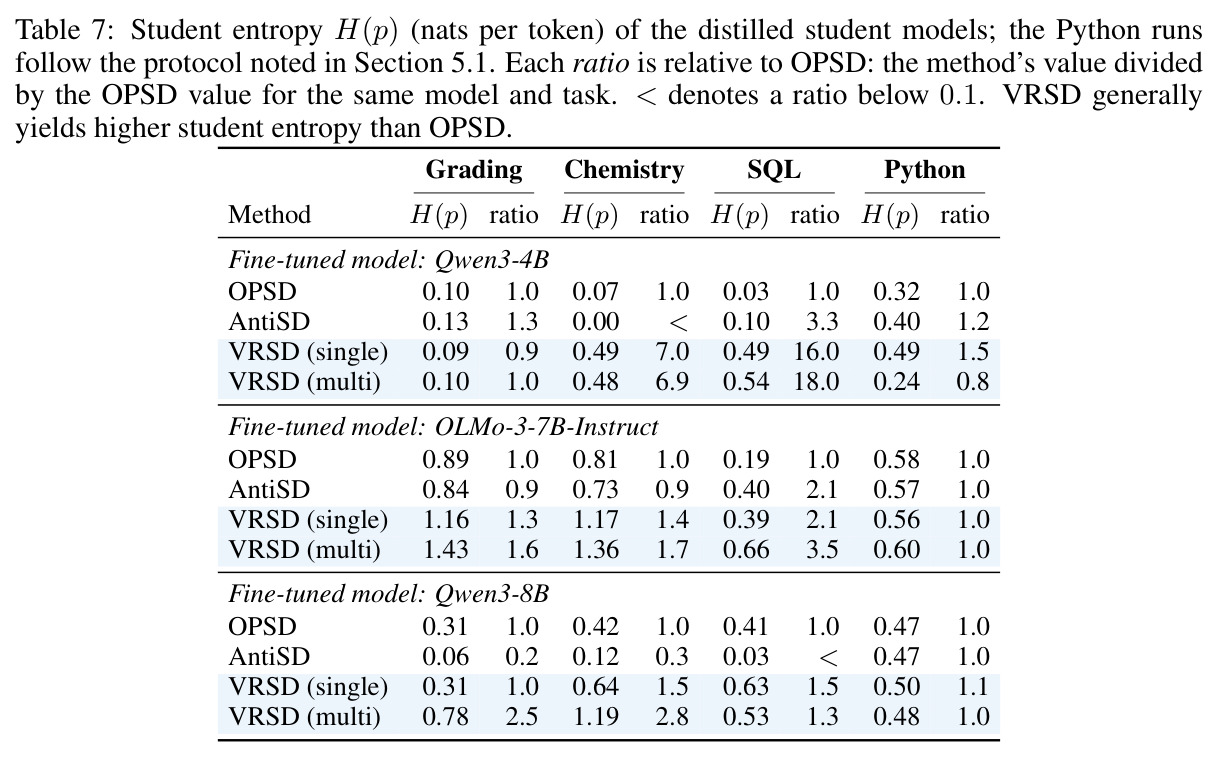
熵 $H(p)=-\sum_v p(v)\log p(v)$(nats)度量分布的不确定性,分布越尖熵越低。LLM 训练后熵过低意味着输出近乎确定、丧失探索替代推理路径的能力。本文证明在协方差条件下,提示引起的 PMI 衰减能保持教师熵,并实证学生熵随之提高。
熵是连接理论(定理 4.1)与实验(图 3、表 7)的主线指标,也是“防坍缩”主张的量化载体。
Pass@1 / Maj@16 / Worst@16
对每个问题采 16 个回答(温度 0.6、top-p 0.95)后的三种指标:Pass@1 是平均正确率;Maj@16 是 16 个回答多数投票答案的正确率;Worst@16 是 16 个回答全部正确的题目占比,衡量最坏情况一致性。
主结果表(Table 1)用这三个指标分别刻画 VRSD 在均值、投票和最坏情况三个维度的收益。
推理忠实性与截断干预
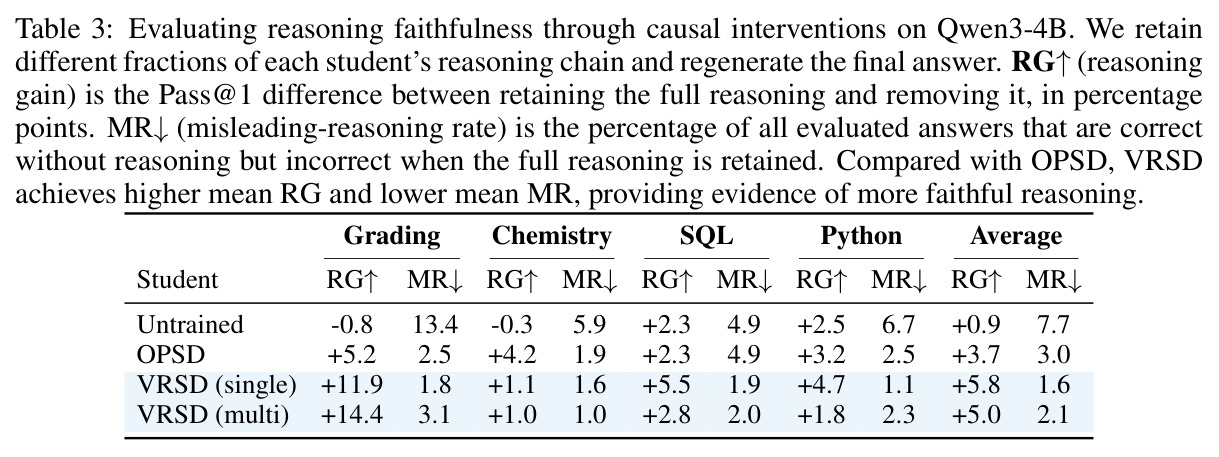
Lanham 等(2023)的方法:把模型思维链截掉不同比例后让其重新生成最终答案。若保留完整推理比删除推理显著提升正确率(reasoning gain, RG 大),说明答案确实依赖推理;若保留推理反而把本来正确的答案改错(misleading-reasoning rate, MR 高),说明推理在误导。
第 5.6 节用该干预证明 VRSD 学生更依赖(而非绕过)自己的推理链,是方法有效性的因果层面证据。
研究动机
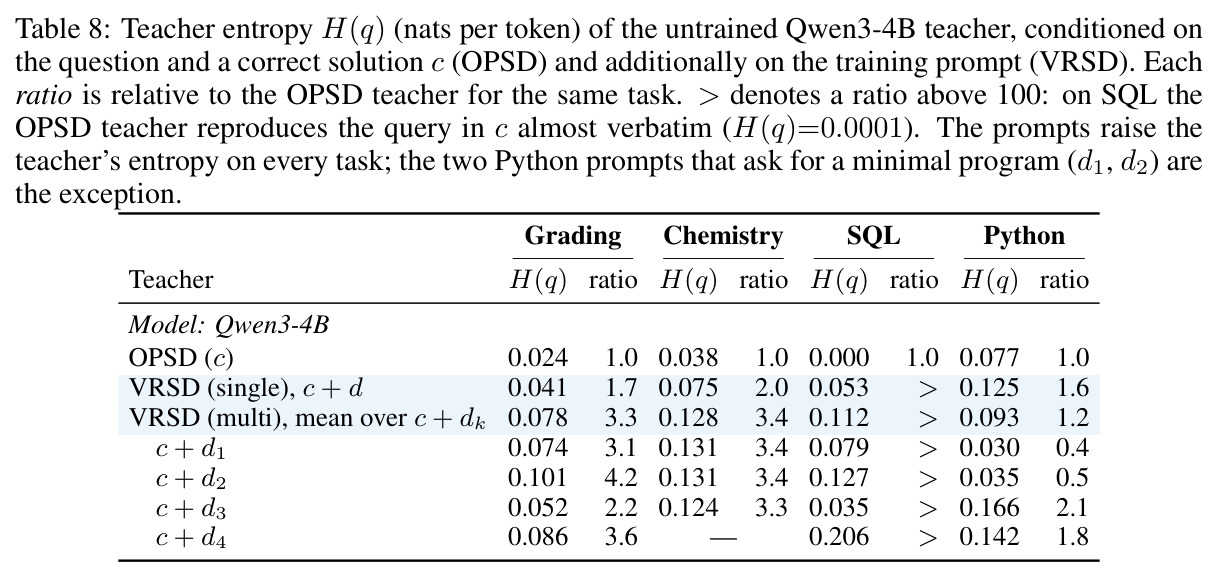
OPSD(在策略自蒸馏)让同一个模型兼任学生与教师:学生只看到问题 $x$ 生成回答,自教师额外看到特权信息 PI(如从正确 rollout 提取的验证解答 $c$,例如“Solution: 42”),在学生回答的每个前缀上给出 next-token 分布供学生学习。问题在于 PI 会诱发捷径偏置:如图 1 的例子,条件化 $c$ 后,“42”这类直接给出答案的 token 的对数概率上升,而“Wait”“However”等反思性 token 下降,教师分布熵从约 1.27 坍缩到 0.61。由于广义 JSD 损失的梯度系数 $A_t(u)=\alpha^{-1}\log[(1-\alpha)+\alpha e^{u}]$ 随 PMI 分数 $u_t(v)=\log[q_t(v)/p_t(v)]$ 严格递增,被 PI 强化的结论 token 获得更大的梯度权重,学生被显式训练成“抢答”,同时继承低熵分布;又因为后续训练的 rollout 来自学生自身策略,替代推理路径被采样到的概率越来越低,探索能力持续受损。附录 J 的行为分析给出更直观的证据:SQL 任务上 OPSD 教师续写半成品回答时几乎逐字复制特权查询($H(q)=0.0001$),Python 任务上教师则甩掉中间理由直接跳到代码实现。
本文的目标是本文的目标是:在保留 PI 答案监督收益的同时,抑制其导致的过早承诺与分布坍缩。具体而言,作者希望(1)不改变模型架构、不修改蒸馏目标(仍是广义 JSD)、也不替换 PI 本身,而是仅通过改变自教师的条件化来调节教师如何使用 PI——手段是训练期教师专用的系统提示 $d$,要求教师验证中间步骤、考虑替代推理路径、在提交答案前重新审视先前的推理;(2)从理论上刻画这种“语言正则化”何时能够对抗教师端的熵坍缩,给出可检验的熵保持条件;(3)在多个模型和任务上系统验证:学生精度提升、输出分布熵得以保持、提示鼓励的推理模式迁移到学生、且答案对推理链的因果依赖(忠实性)增强,最终让 VRSD 可以即插即用地并入现有 OPSD 流水线。
与已有工作不同的是,已有工作从三个方向缓解捷径偏置:Purified OPSD 通过比较有无比照问题来过滤参考解答驱动的 shortcut 训练目标;AntiSD 在 GRPO 之外叠加“劝退匹配特权教师”的更新;PS-OPSD 把完整解答替换为结构化指导;ATESD 自适应控制向教师泄露多少参考推理。这些方法要么改训练目标,要么改 PI 内容。VRSD 的独特切入是第四个方向——正则化教师使用 PI 的方式:保留完整参考解答,利用模型既有的指令遵循能力,用仅教师可见的系统提示削弱 PI 对 token 偏好的影响。与 OPCD(把系统提示当作被蒸馏的行为规范)不同,这里的提示不是蒸馏内容而是正则化器。理论上,作者把提示效应建模为对 PI 诱导的 PMI 偏移做仿射衰减 $u_t^d(v)=\gamma_t u_t(v)+\kappa_t$($\gamma_t<1$),并沿衰减路径导出教师熵变化的积分-协方差表达式,把“提示防坍缩”从经验现象升级为有条件的可证命题。
核心方法
直觉:教师看到标准答案后像“抄答案的考生”,会跳过验证直接作答;VRSD 给它一张只有教师能看的“考试纪律备忘录”(系统提示),提醒它先验证、再考虑别的可能,从而把“答案信息”与“怎么用答案”解耦。技术路线完全建立在 OPSD 之上:给定 $(x,c)$,学生采样 $y\sim\pi_\theta(\cdot|x)$;前缀 $y_{<t}$ 处学生分布 $p_t=\pi_\theta(\cdot|x,y_{<t})$,自教师分布 $q_t=\pi_\theta(\cdot|x,c,y_{<t})$;VRSD 唯一的改动是把损失中的 $q_t$ 替换为提示教师分布 $q_t^d=\pi_\theta(\cdot|d,x,c,y_{<t})$,JSD 目标(式 2)与 stop-gradient 机制不变;提示 $d$ 和 PI $c$ 都不进入学生推理时的输入,也不引入任何新模块或新损失项。提供两种变体:VRSD (single) 所有 rollout 共用一个综合提示 $d$;VRSD (multi) 把每个问题的 rollout 尽量均分给 $K$ 个侧面提示 $d_1,\dots,d_K$(化学 $K=3$,其余任务 $K=4$),每个 rollout 的教师分布为对应的 $q_t^{d_k}$。
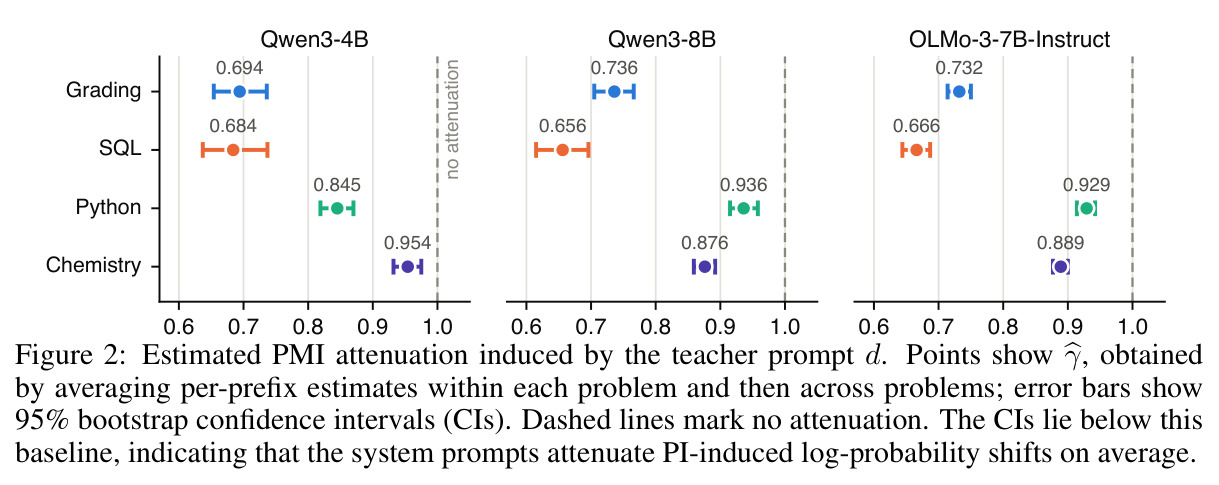
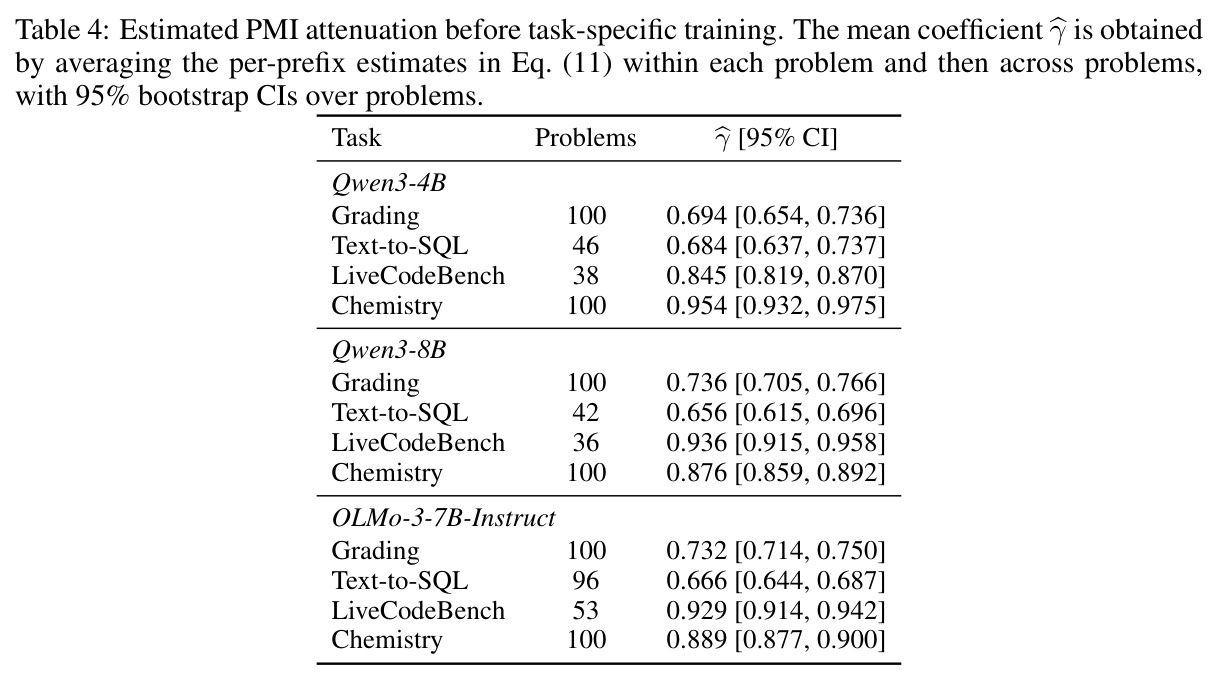
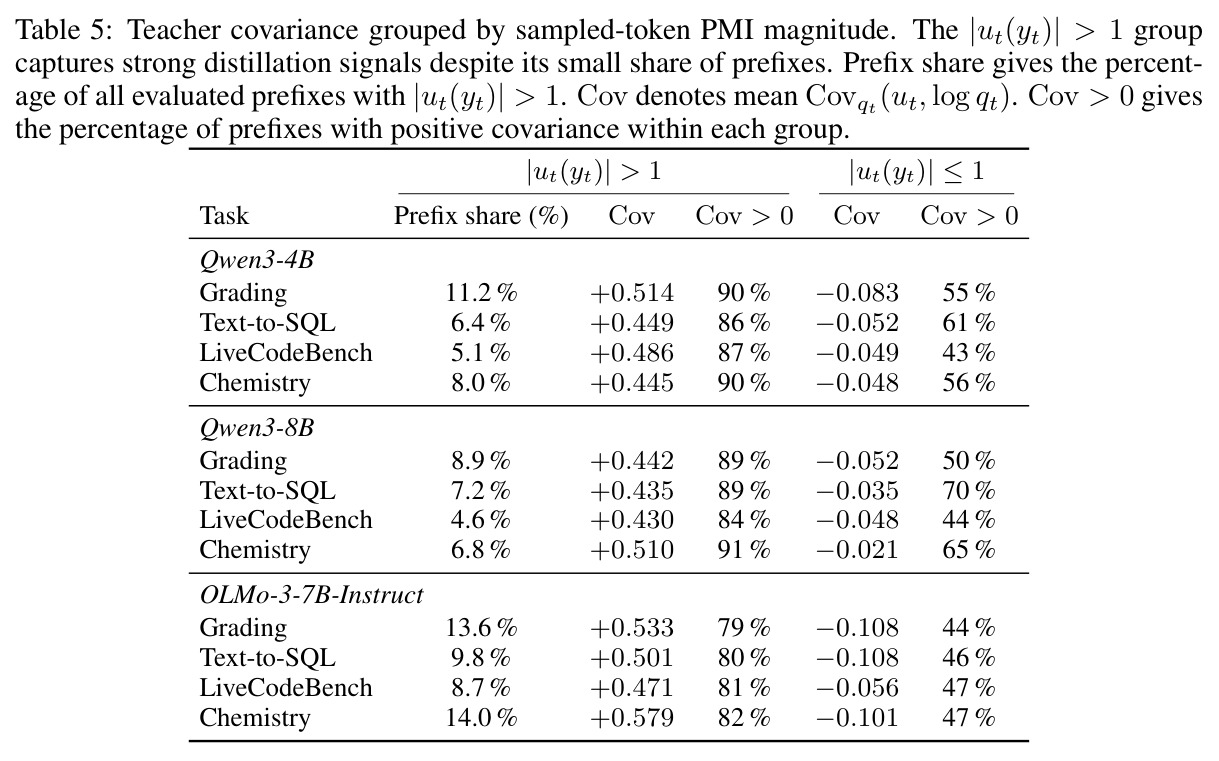
核心创新是把“如何使用特权信息”与“特权信息本身”解耦,并给出统一的理论语言。先用条件点互信息量化 PI 的影响:$u_t(v)=\log[q_t(v)/p_t(v)]=\mathrm{PMI}(v;c|x,y_{0$,则对足够接近 1 的 $\gamma_t$ 必有 $H(q_t^d)>H(q_t)$。实证支撑:表 4 中全部 12 个模型-任务组合的 $\hat\gamma$ 的 95% 置信区间都落在 $(0,1)$(如 Qwen3-4B 评分任务 0.694 [0.654, 0.736]);表 5 显示在 $|u_t(y_t)|>1$ 的前缀(占 5–14%)上平均协方差为 0.43–0.58、79%–91% 的前缀协方差为正。
方法步骤详情
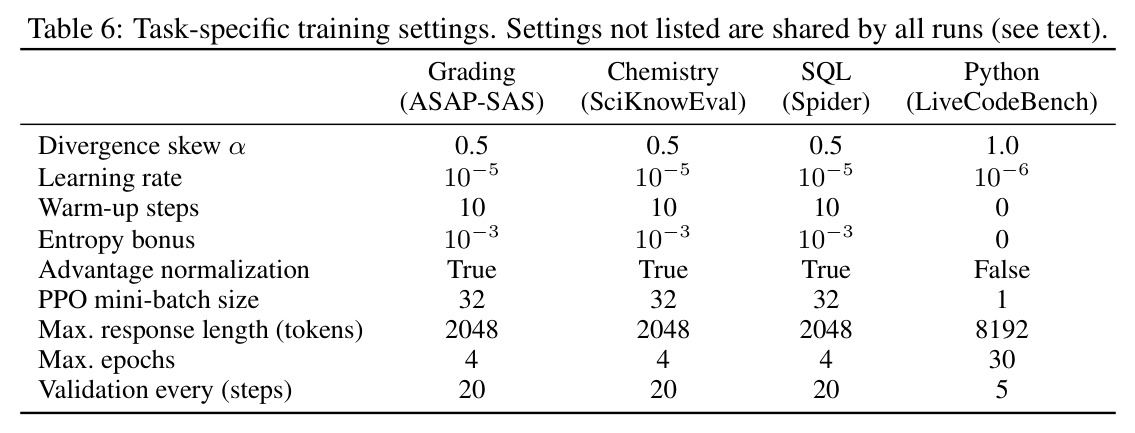
完整流程:(1)构造数据对:每个问题 $x$ 配对特权信息 $c$——取同一问题某次成功 rollout 中的验证解答(失败 rollout 配正确解答,正是 OPSD 训练设定);(2)学生采样:不加 $c$、不加 $d$,每问题采 8 条 rollout,训练温度 1;(3)教师打分:同一模型在同一前缀做 teacher forcing,分别得到 $p_t$、$q_t$(加 $c$)与 $q_t^d$(加 $c$ 和 $d$ 或 $d_k$)的全词表分布;(4)计算归一化广义 JSD 损失(式 1–2),教师分布加 stop-gradient,把学生逐步拉向提示教师;除 Python 用反向 KL($\alpha=1$)外其余任务 $\alpha=0.5$;(5)多提示变体把 rollout 均分给 $K$ 个侧面提示,各 rollout 用对应的 $q_t^{d_k}$ 监督;(6)训练配置:每批 32 个 prompt,prompt 长 2048,评分/化学/SQL 用学习率 $10^{-5}$、熵奖励 $10^{-3}$、最多 4 个 epoch、每 20 步验证、连续 4 次验证无提升早停;Python 按 OPSD 代码配方用学习率 $10^{-6}$、无预热、响应上限 8192、30 epoch;评分/化学/SQL 在 2×H100(80GB)训练,Python 用 2×H200(141GB);(7)推理阶段学生输入与普通 OPSD 学生完全一致,不加提示、不加 PI。另附系数估计:按式 (11) 的加权最小二乘斜率在每个前缀估计 $\hat\gamma_t$,先对问题内前缀平均再跨问题平均,用 bootstrap 得 95% CI。
技术新颖性
技术新颖性有四点。(1)干预位置新:既有去捷径方法动损失(Purified OPSD 过滤目标、AntiSD 对抗更新)或动数据(PS-OPSD 换 PI、ATESD 控制泄露量),VRSD 首次只动教师的条件化输入,用自然语言指令充当“正则化器”,零额外参数、零额外损失项,可与任何 OPSD 实现即插即用。(2)理论建模新:把 prompt 的效果形式化为对 PMI 的仿射衰减,通过沿衰减路径积分协方差得到熵变化的精确刻画(定理 4.1),并给出仅依赖可测量 $\mathrm{Cov}_{q_t}(u_t,\log q_t)$ 的充分条件(推论 4.2),使“提示防坍缩”可被事前检验。(3)验证方法新:用加权最小二乘斜率加 bootstrap CI 实证确认衰减假设(表 4),再用截断干预(表 3)从因果上验证学生推理忠实性,形成“现象—理论—干预”的完整闭环。(4)设计发现新:把不同侧面提示分配到不同 rollout 的多提示设计,稳定优于把所有指令拼接进单提示(后者在 4 个任务中的 3 个低于 OPSD),说明监督信号的“多样性分配”本身就有价值,这是一个反直觉且实用的发现。
实验结果
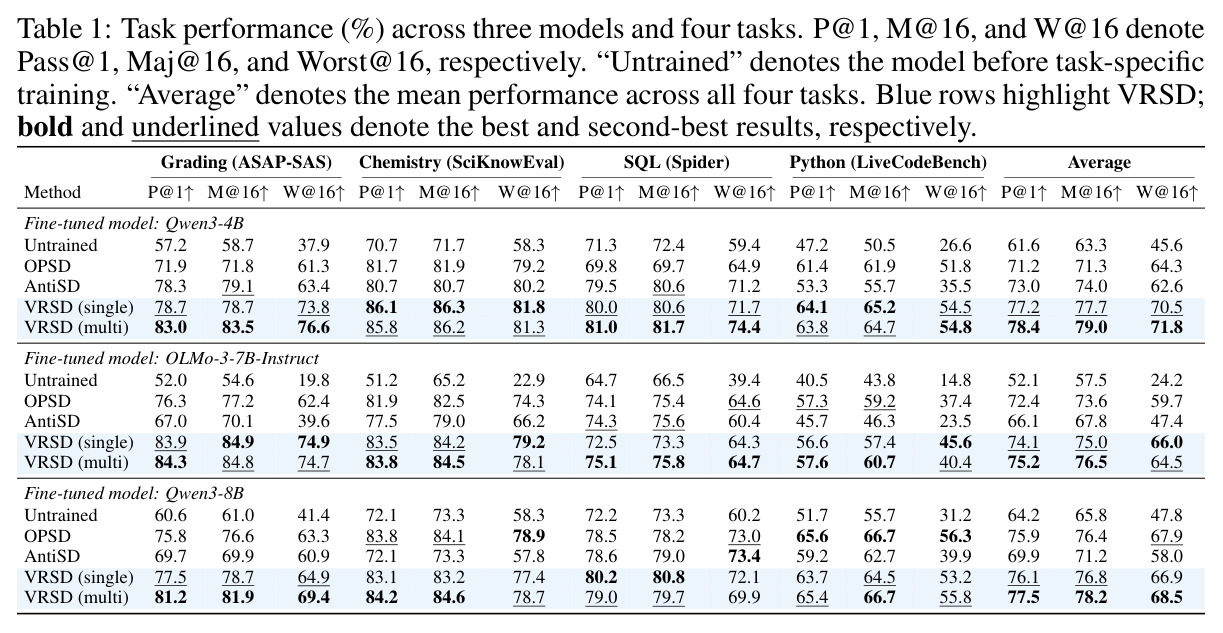
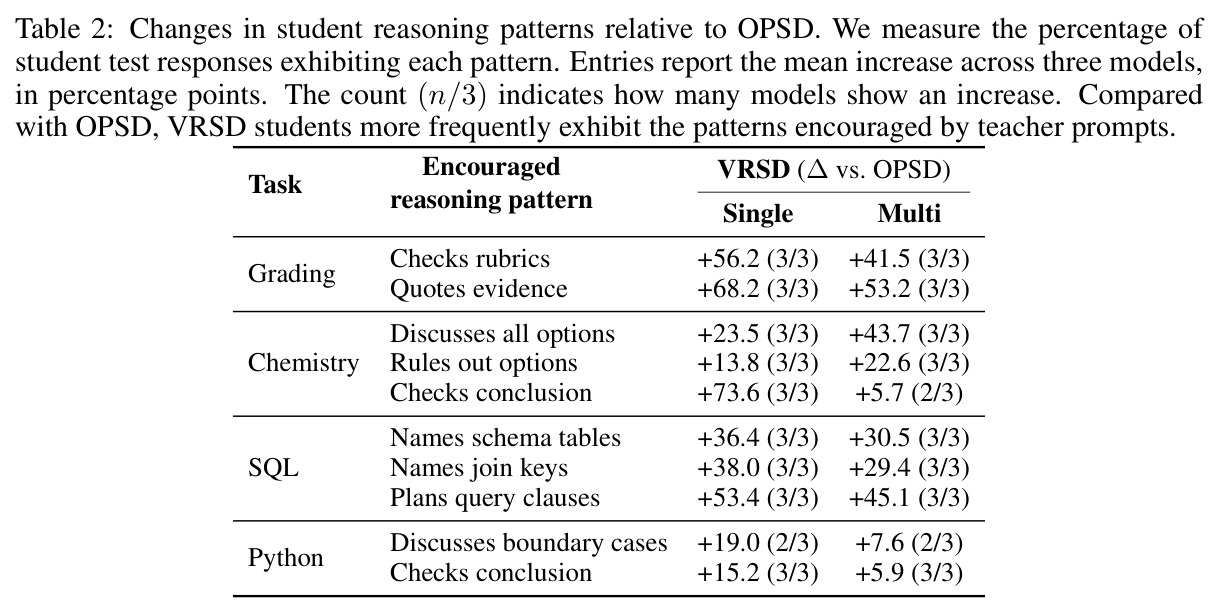
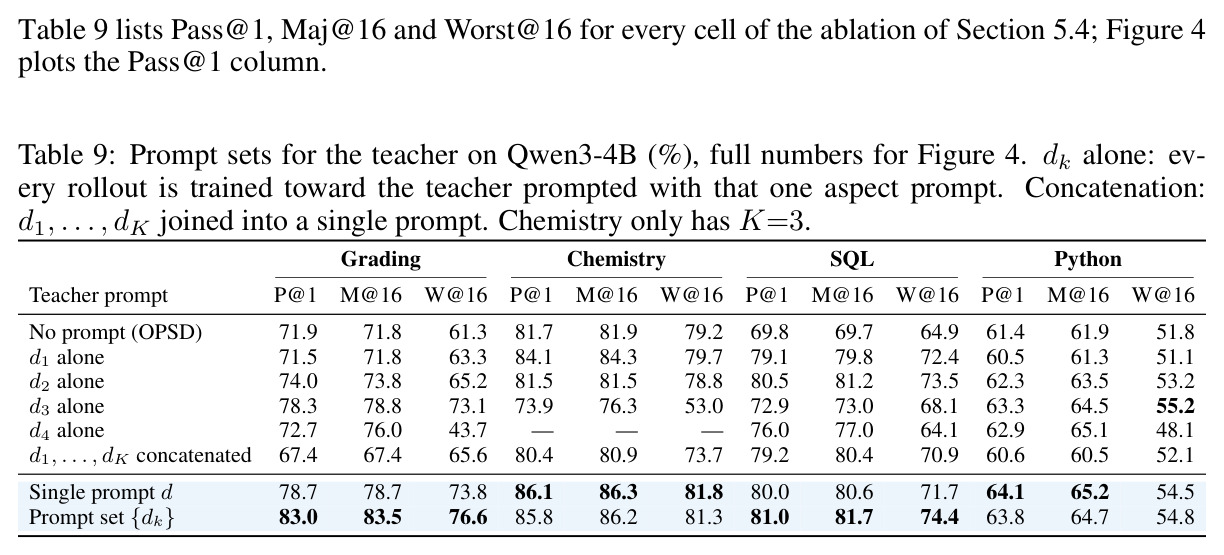
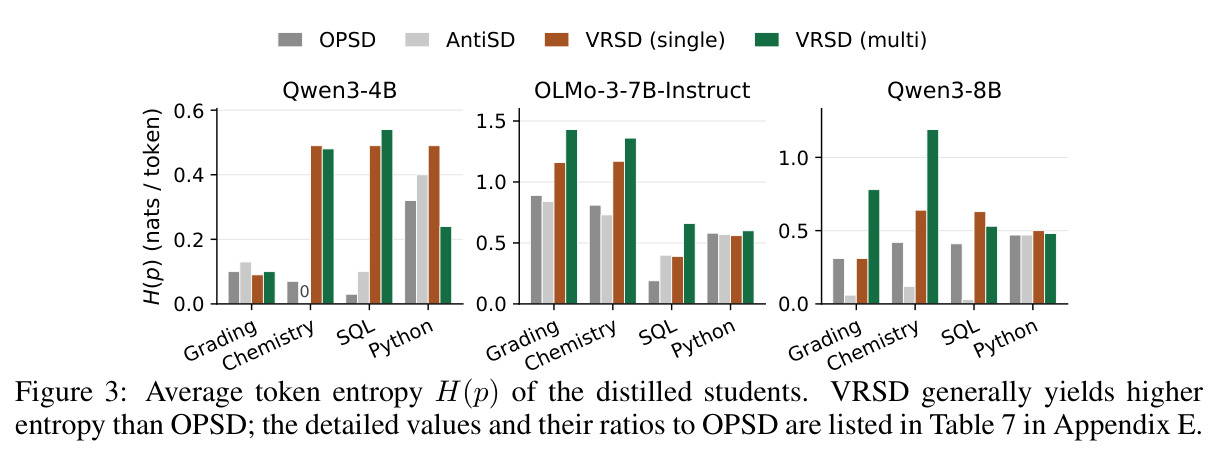
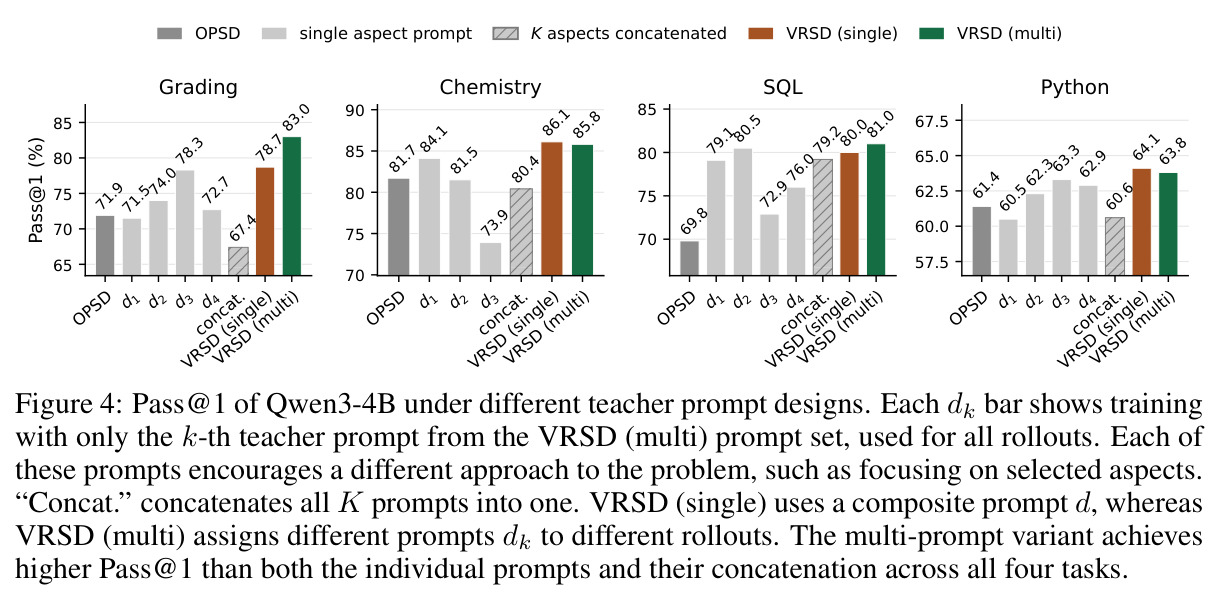
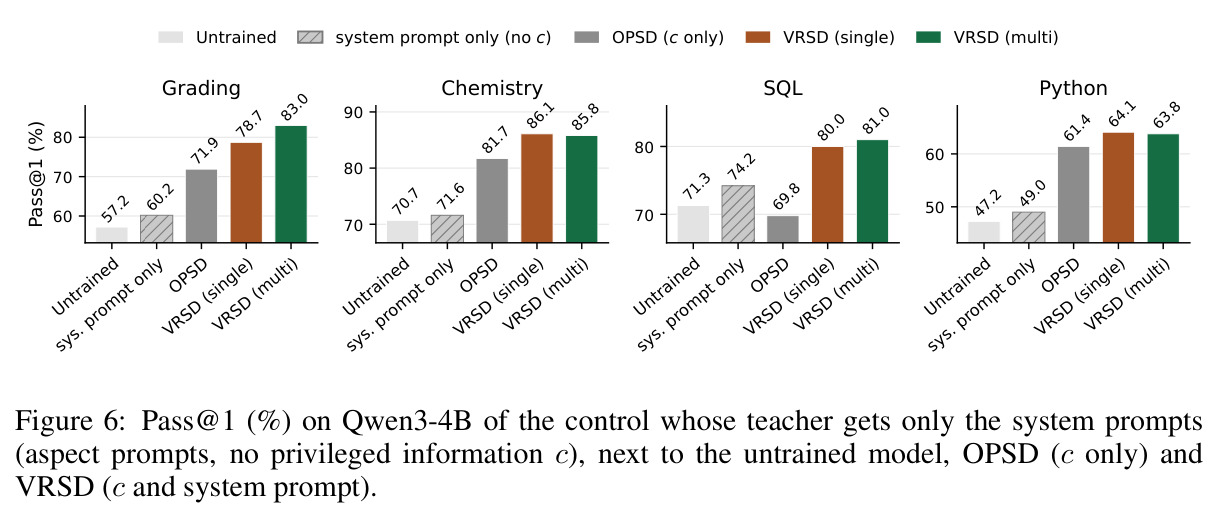
主实验(表 1):在 3 个模型(Qwen3-4B、Qwen3-8B、OLMo-3-7B-Instruct)× 4 个任务(ASAP-SAS 评分、SciKnowEval 化学、Spider SQL、LiveCodeBench Python)共 12 个设置中,VRSD 在 11 个上 Pass@1 超过 OPSD,平均提升约 3.9 个百分点;VRSD (multi) 的平均 Pass@1 相对 OPSD 分别 +7.2(78.4% vs 71.2%,Qwen3-4B)、+2.8(75.2% vs 72.4%,OLMo)、+1.6(77.5% vs 75.9%,Qwen3-8B);Maj@16 全部持平或更优,三模型平均 Worst@16 全部提升(Qwen3-4B 64.3→71.8)。最典型案例是 Qwen3-4B SQL:OPSD(69.8%)甚至低于未训练模型(71.3%),VRSD (multi) 达到 81.0%。对照方法 AntiSD 不稳定,如 Qwen3-4B Python 仅 53.3%(OPSD 61.4%)。学生熵(图 3、表 7):24 组对比中 19 组 VRSD 熵更高;Qwen3-4B SQL 上 OPSD 的 $H(p)=0.03$,VRSD single/multi 为 0.49/0.54(16–18 倍),且伴随 Pass@1 从 69.8% 升到 81.0%。提示消融(图 4、表 9,Qwen3-4B):VRSD (multi) 在四个任务上都超过最强单提示 0.5–4.7 个百分点;把 $d_1..d_K$ 拼接进一个提示在 3 个任务上低于 OPSD(评分 67.4% vs 71.9%);单综合提示则在全部任务上优于拼接与 OPSD。推理模式迁移(表 2):评分任务“引用学生证据”模式平均 +68.2(single)/ +53.2(multi)个百分点,化学“检查结论” +73.6(single),SQL“规划查询子句” +53.4,绝大多数在 3/3 个模型上成立。忠实性干预(表 3,Qwen3-4B):平均 reasoning gain 为 OPSD +3.7、VRSD single +5.8、multi +5.0;评分任务上两个变体把 RG 翻倍以上(+11.9/+14.4 vs +5.2);MR 在 8 组比较中的 7 组低于 OPSD(平均 1.6/2.1 vs 3.0)。控制实验(图 6):教师只看系统提示不看 $c$ 时,学生仅比未训练高 1–3 个百分点(评分 60.2% vs 57.2%),证明信号来自 $c$、提示只是正则化器。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 总体(3 模型 × 4 任务平均) | Pass@1 | VRSD (multi) 较 OPSD 平均 +3.9pp,11/12 设置更优 | OPSD | +3.9pp |
| 短答案评分 ASAP-SAS(Qwen3-4B) | Pass@1 | 83.0%(VRSD multi) | OPSD 71.9%(未训练 57.2%) | +11.1pp |
| 文本到 SQL Spider(Qwen3-4B) | Pass@1 | 81.0%(VRSD multi) | OPSD 69.8%(低于未训练的 71.3%) | +11.2pp |
| 化学 SciKnowEval(Qwen3-4B) | Pass@1 | 85.8%(VRSD multi) | OPSD 81.7% | +4.1pp |
| 代码生成 LiveCodeBench(Qwen3-4B) | Pass@1 | 63.8%(multi)/ 64.1%(single) | OPSD 61.4% | +2.4~+2.7pp |
| 学生分布熵(Qwen3-4B SQL) | H(p)(nats/token) | 0.54(multi)/ 0.49(single) | OPSD 0.03 | 16~18 倍 |
| 最坏情况一致性(Qwen3-4B 四任务平均) | Worst@16 | 71.8%(VRSD multi) | OPSD 64.3% | +7.5pp |
| 推理忠实性(Qwen3-4B 四任务平均) | Reasoning Gain(RG) | +5.8pp(single)/ +5.0pp(multi) | OPSD +3.7pp | +2.1pp(single) |
局限与改进
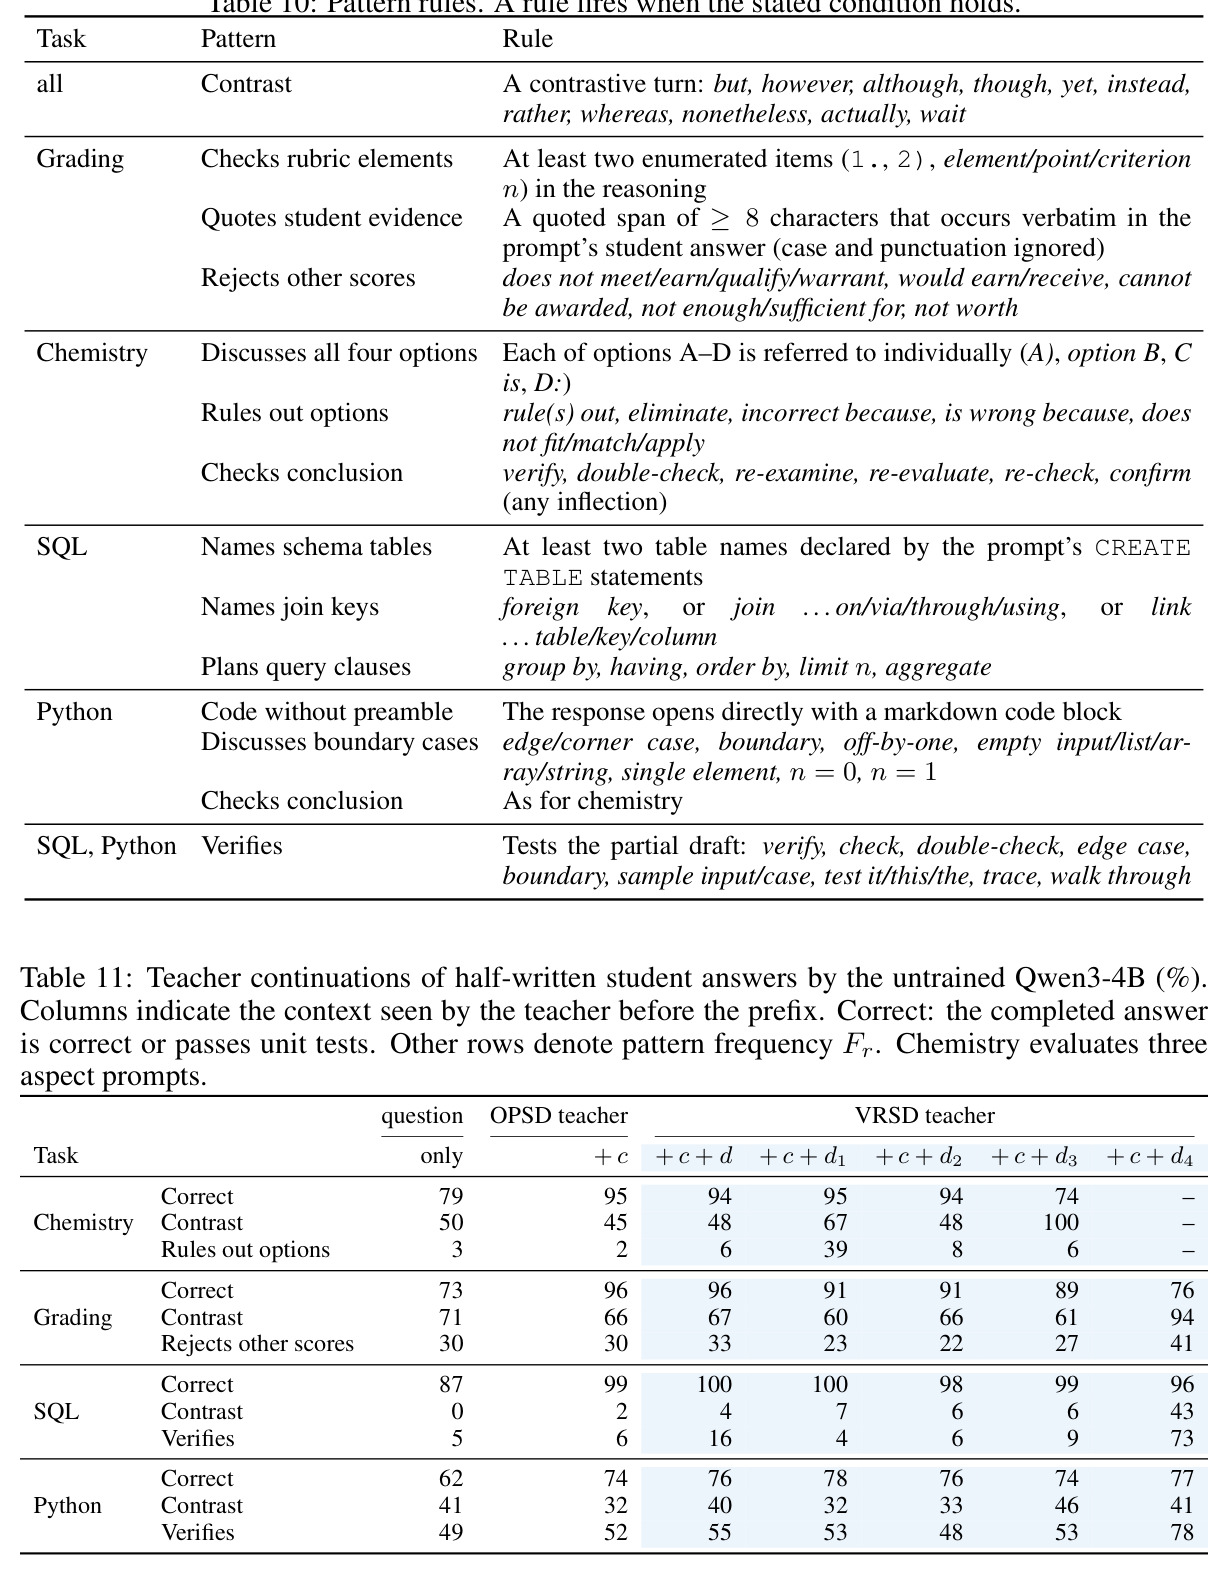
作者承认的局限:(1)依赖人工整理的任务特定提示,需要人工判断该鼓励哪些推理行为,提示未必适合每个问题,也未必随学生能力在训练中演化而持续有效;(2)语言指令只能通过模型对措辞的响应间接控制衰减强度,无法直接、精确地调节 PI 引起的 log-prob 偏移。我的补充观察:(1)衰减并不均匀——LiveCodeBench 与化学的 $\hat\gamma$ 高达 0.845–0.954,在答案无法被直接粘贴进回答的任务上提示的调节作用明显偏弱;(2)高熵并非无条件是好事:Qwen3-4B Python 上 VRSD (multi) 的熵(0.24)反而低于 OPSD(0.32)且 Pass@1 略降,熵—精度权衡未被显式优化,而且理论上只证明了教师端熵保持,学生端只是经验相关;(3)唯一失败设置是 Qwen3-8B Python 的 single 变体(63.7% 低于 OPSD 的 65.6%),提示模型越强、捷径问题越轻时收益可能递减;(4)实验仅覆盖 8B 以下模型与 4 个有自动验证器的任务,开放式生成与多轮 agent 场景未验证;(5)提示对教师自身有副作用:化学 d3、评分 d4 这类“自我反驳”提示使续写正确率从 95/96 跌到 74/76,单独使用它们时学生 Worst@16 崩溃(53.0/43.7),提示设计需要在反思与正确性之间仔细平衡。
独立分析的弱点
独立弱点分析:(1)提示工程不可扩展——每个任务需人工撰写 $K$ 个侧面提示(全文共 15 个),换领域就要重写。改进方向:用 LLM 自动生成并进化提示,或以教师熵/PMI 统计量为反馈在线搜索提示组合。(2)控制间接且不可调——$\gamma_t$ 只是经验上小于 1,无法按前缀或训练阶段调节衰减强度。改进方向:跳过语言这层间接机制,直接在 token 级对 $u_t$ 做重加权(如 AntiSD 式目标)或对 logits 做显式衰减,并利用定理 4.1 的协方差判据在线决定衰减的位置与强度。(3)依赖指令遵循能力——OLMo-3 与 Qwen3 都是强指令模型;对未经指令微调的基座模型或更小模型,提示可能失效甚至有害。改进方向:先做轻量指令对齐再自蒸馏,或改用非语言手段(注意力掩码、答案遮蔽窗口)实现同等正则化。(4)评估面窄——4 个有自动验证器的任务、最多 8B、16 次采样;个别设置的 Worst@16 仍劣于 OPSD(Qwen3-8B Python single 53.2 vs 56.3)。改进方向:在环境反馈式 PI(agent 轨迹、人类反馈)上验证,并按验证集在 OPSD/AntiSD/VRSD 之间自适应选择或组合。(5)训练-推理条件失配的残余风险——教师训练时带反思提示而学生没有,学到的分布与学生自身策略仍有轻微条件差异;可在训练中周期性评估提示的边际收益,失效后撤除。
未来方向
作者提出的方向:(1)自动化提示选择与适配——跨问题、跨训练阶段动态调整提示,使其随学生能力演化持续有效;(2)直接估计并调整 PI 诱导的 log-prob 偏移——绕过语言指令的间接性,用熵分析(定理 4.1/推论 4.2)指导在何处、以多强衰减特权解答的影响。基于本文成果可延伸的方向:(3)把仿射衰减推广为逐 token、非线性或随训练调度的衰减,研究最优 $\gamma_t$ 调度并显式优化熵—精度权衡;(4)把学生端熵动力学纳入理论——目前只有教师端熵保证,学生端熵保持是经验观察;(5)在多教师 OPD、agentic RL、环境反馈式 OPSD(如 HERO、反馈型自蒸馏)流水线中检验语言正则化的通用性;(6)与 RLVR/GRPO 的熵坍缩问题建立联系——VRSD 或可作为 RL 训练前的自蒸馏预热阶段,缓解可验证奖励训练后期的探索丧失;(7)用同一“条件化解耦”框架研究其他 PI 源(自洽回答、人类偏好、可复用技能库)的偏置与矫正,并实证提示正则化与 Purified OPSD、AntiSD 的组合是否互补。
复现评估
复现条件相当好。代码开源:训练脚本、评测框架与模式检查工具在 GitHub(lijiazheng99/VRSD);论文逐字给出全部系统提示(附录 I,含 single 与 multi 在 4 个任务的原文)、完整训练超参(附录 D 表 6:学习率、批大小、epoch、早停准则等)、推理模式提取的确定性 regex 规则(表 10),以及估计 $\hat\gamma$ 的 PyTorch 风格伪代码(算法 1)。数据全部公开:ASAP-SAS(Kaggle)、SciKnowEval、Spider dev、LiveCodeBench;模型公开可得:Qwen3-4B、Qwen3-8B、OLMo-3-7B-Instruct。PI 由模型自身的正确 rollout 生成,无需人工标注。算力门槛中等:评分/化学/SQL 用 2×H100(80GB),Python 用 2×H200(141GB),学术实验室可以负担;理论部分的复现($\hat\gamma$ 估计、协方差检验)只需 teacher forcing 前向传播加 bootstrap,成本很低。主要工程量在搭建四个任务的自动验证器与 on-policy rollout 采样管线。综合评估:复现难度中偏低,且每个设置按验证集选最优检查点、评估用 16 次采样,结果可信度较高。
论文图表
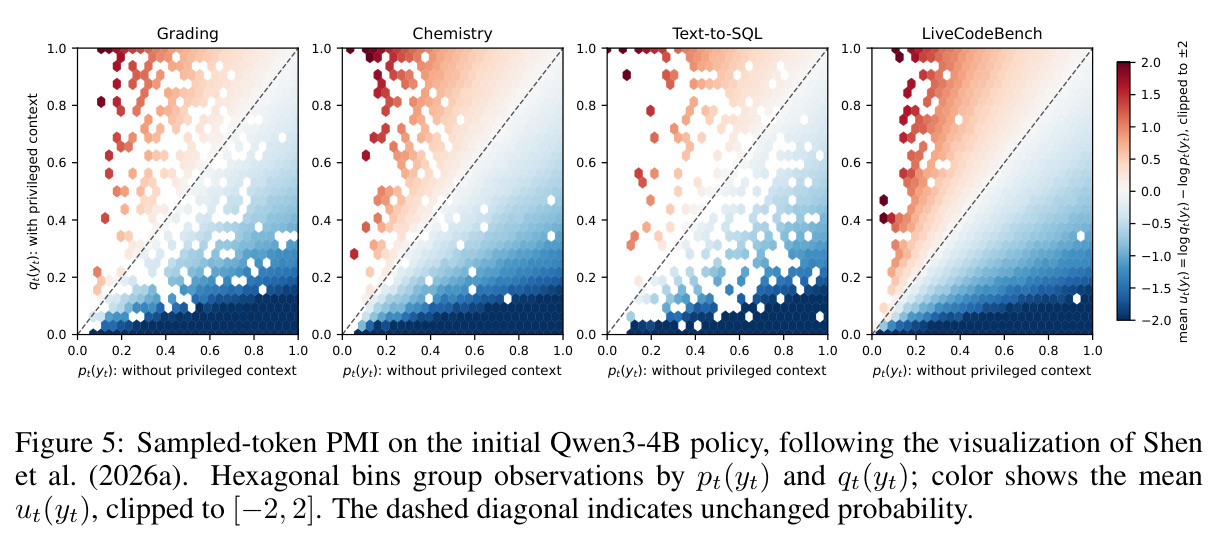
按学生分布概率 $p_t(y_t)$ 与教师分布概率 $q_t(y_t)$ 分 bin 的六边形热图,颜色编码平均 PMI $u_t(y_t)$(截断到 ±2);显示 PI 同时强化一部分采样 token、压制另一部分,且大部分大 PMI 前缀的采样 token 为负 PMI。
直观呈现 PI 引起 log-prob 偏移的 token 级证据,是理解捷径偏置现象以及定义 $|u_t|>1$ 分析组的基础。
同一个半成品化学题前缀的两种续写对比:OPSD 教师(+c)快速排除后直接给出答案 C;加排除提示 d1 的教师逐项分析 A–D、给出具体化学理由(如极性基团会增强亲水性)后作答,两者都正确但推理结构完全不同。
定性展示“提示如何改变教师生成行为”,把抽象的 PMI 衰减翻译成可读的文本差异,是机制最直观的说明。
推理模式统计的确定性 regex 规则全集:如对比转折词表(but/however/wait 等)、引用 ≥8 字符的学生原文、化学逐项排除短语(rule(s) out、eliminate 等)、SQL 外键与 join 关键词、Python 边界情形词汇(off-by-one、empty input 等),全部不依赖模型裁判、仅在推理段内匹配。
保证表 2 的模式统计零成本可复现、无评判模型偏差,是行为分析结果可信度的方法学保障。